

Le chiffre clé d'Inkling 2 Mini, c'est le coût par tâche : Artificial Analysis le note à 20, à égalité avec Qwen3.8-27B, à 0,59 $ par tâche contre 3,53 $ et 9,0 minutes par tâche contre 34,5. C'est un modèle en boucle de 26,4B de paramètres sous Apache 2.0 qui tient dans environ 20 Go. L'échange porte sur la connaissance : le labo le juge moins capable qu'Inkling 2 Small sur la plupart des évaluations, et il affirme des faits erronés avec plus d'assurance.
Pour les équipes de support, cela en fait un moteur rapide et bon marché qui a tout de même besoin d'être ancré dans votre centre d'aide et testé sur des tickets passés, ce qui est exactement le travail qu'eesel fait autour de n'importe quel modèle que vous choisissez.
Qu'est-ce qu'Inkling 2 Mini ?
Inkling 2 Mini est le petit frère d'Inkling 2 Small dans la deuxième génération de Thinking Machines Lab, annoncé le 20 novembre 2026. Il a 26,4B de paramètres totaux, prend du texte et des images en entrée, écrit du texte en sortie, et sort avec des poids ouverts. Sa fiche de modèle Hugging Face indique Apache 2.0 et un contexte de 1M de tokens.
Je construis des fonctionnalités et des agents IA chez eesel, donc quand un nouveau modèle arrive, je lis comment il est construit avant de lire le tableau de benchmarks. Mini est inhabituel sur ce point, ce que je détaille plus bas. C'est aussi pour cela qu'eesel a un outil en ligne de commande : avec la CLI eesel, un agent de codage IA peut téléverser des connaissances approuvées comme des articles d'aide exportés et des réponses enregistrées, modifier les instructions de l'agent de support, et poser des questions de test avant que quoi que ce soit passe en direct, quel que soit le modèle en dessous. Connecter le helpdesk lui-même nécessite toujours qu'une personne avec un accès admin l'approuve.
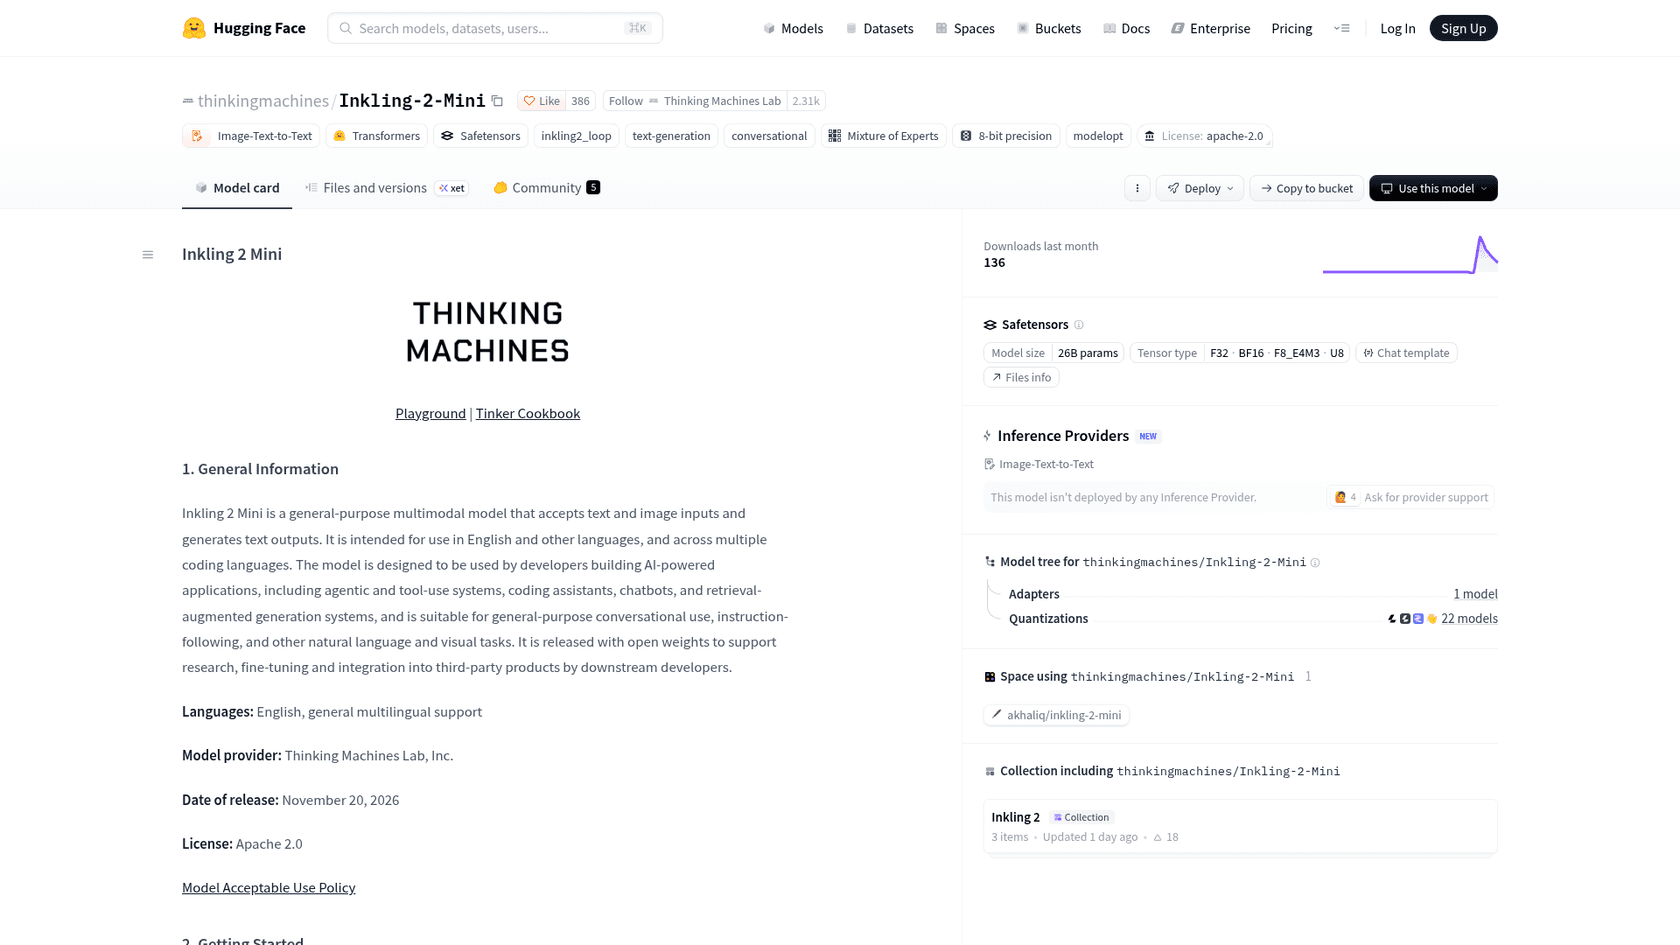
Les chiffres qui comptent sur la fiche : 3,4B de paramètres actifs par token, un checkpoint d'environ 20 Go, et une variante de recherche appelée TML-d24-varloop-research qui permet de choisir combien de passages en boucle le modèle exécute. La fiche indique un NVIDIA DGX Spark ou du silicium Apple avec 32 Go de mémoire comme matériel cible.
Un point à signaler tôt. Le texte d'annonce dit 3,4B de paramètres actifs, tandis que son tableau de spécifications et Artificial Analysis disent 5,4B. Les deux ont raison à leur façon : 3,4B sont stockés et actifs, et 5,4B est le compte une fois ajoutées les couches qui tournent trois fois.
Comment Inkling 2 Mini se compare-t-il à Inkling 2 Small ?
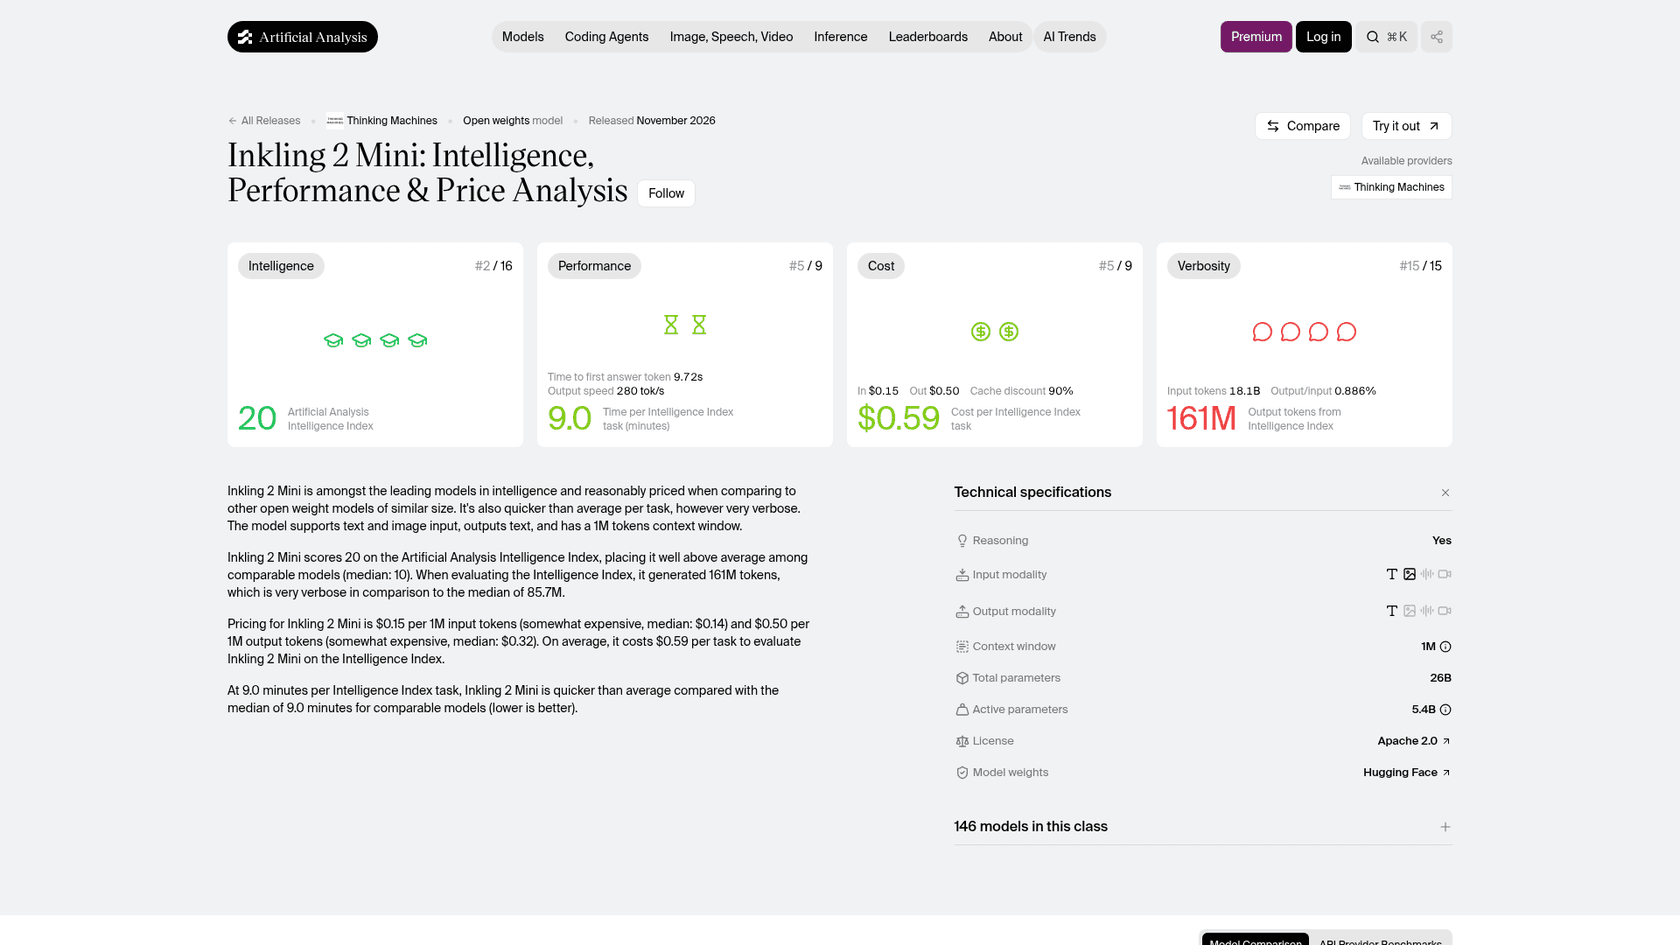
Mini est plus petit, moins cher par tâche et plus rapide, et il est plus faible sur la plupart des tests. Les spécifications viennent de chaque fiche de modèle, les prix de la page de prix de Tinker, et les scores et vitesses des pages Small et Qwen3.8-27B d'Artificial Analysis, plus la page Mini montrée ci-dessous.
| Inkling 2 Mini | Inkling 2 Small | Qwen3.8-27B | |
|---|---|---|---|
| Sortie | 20 nov. 2026 | 5 nov. 2026 | août 2026 |
| Paramètres totaux / actifs | 26,4B / 3,4B (5,4B avec boucles) | 594B / 17B | 27B |
| Entrée | Texte, image | Texte, image | n/d |
| Contexte (fiche) | 1M | 1M | n/d |
| Licence | Apache 2.0 | Apache 2.0 | n/d |
| Entrée / cache / sortie par 1M | $0.15 / $0.015 / $0.50 | $0.30 / $0.03 / $1.00 | $0.50 / n/d / $3.00 |
| AA Intelligence Index v5.0.1 | 20 | 31 | 20 |
| Vitesse de sortie (AA) | 280 tokens/s | 118 tokens/s | 53 tokens/s |
| Temps avant le premier token de réponse (AA) | 9,7s | 39,7s | 144,1s |
| Minutes par tâche de l'index AA | 9,0 | 21,2 | 34,5 |
| Coût par tâche de l'index AA | $0.59 | $1.18 | $3.53 |
| Tokens de sortie dans l'exécution de l'index | 161M | 154M | non comparé |
La colonne Qwen est le propre relevé d'Artificial Analysis, et « n/d » signifie que je n'ai pas vérifié cette cellule. Deux réserves sur la colonne Mini. D'abord, Mini n'est pas sur la liste d'inférence serverless de Tinker, et Artificial Analysis ne montre aucune API publique pour lui, donc son coût par tâche est le tarif de sampling de Tinker appliqué aux tokens mesurés, pas un prix que vous pouvez acheter aujourd'hui. Ensuite, Mini a écrit 161M de tokens dans l'exécution de l'index, plus que les 154M de Small et presque le double de la médiane de 85,7M qu'Artificial Analysis cite pour des modèles comparables. Cela dit clairement que le modèle est très verbeux.
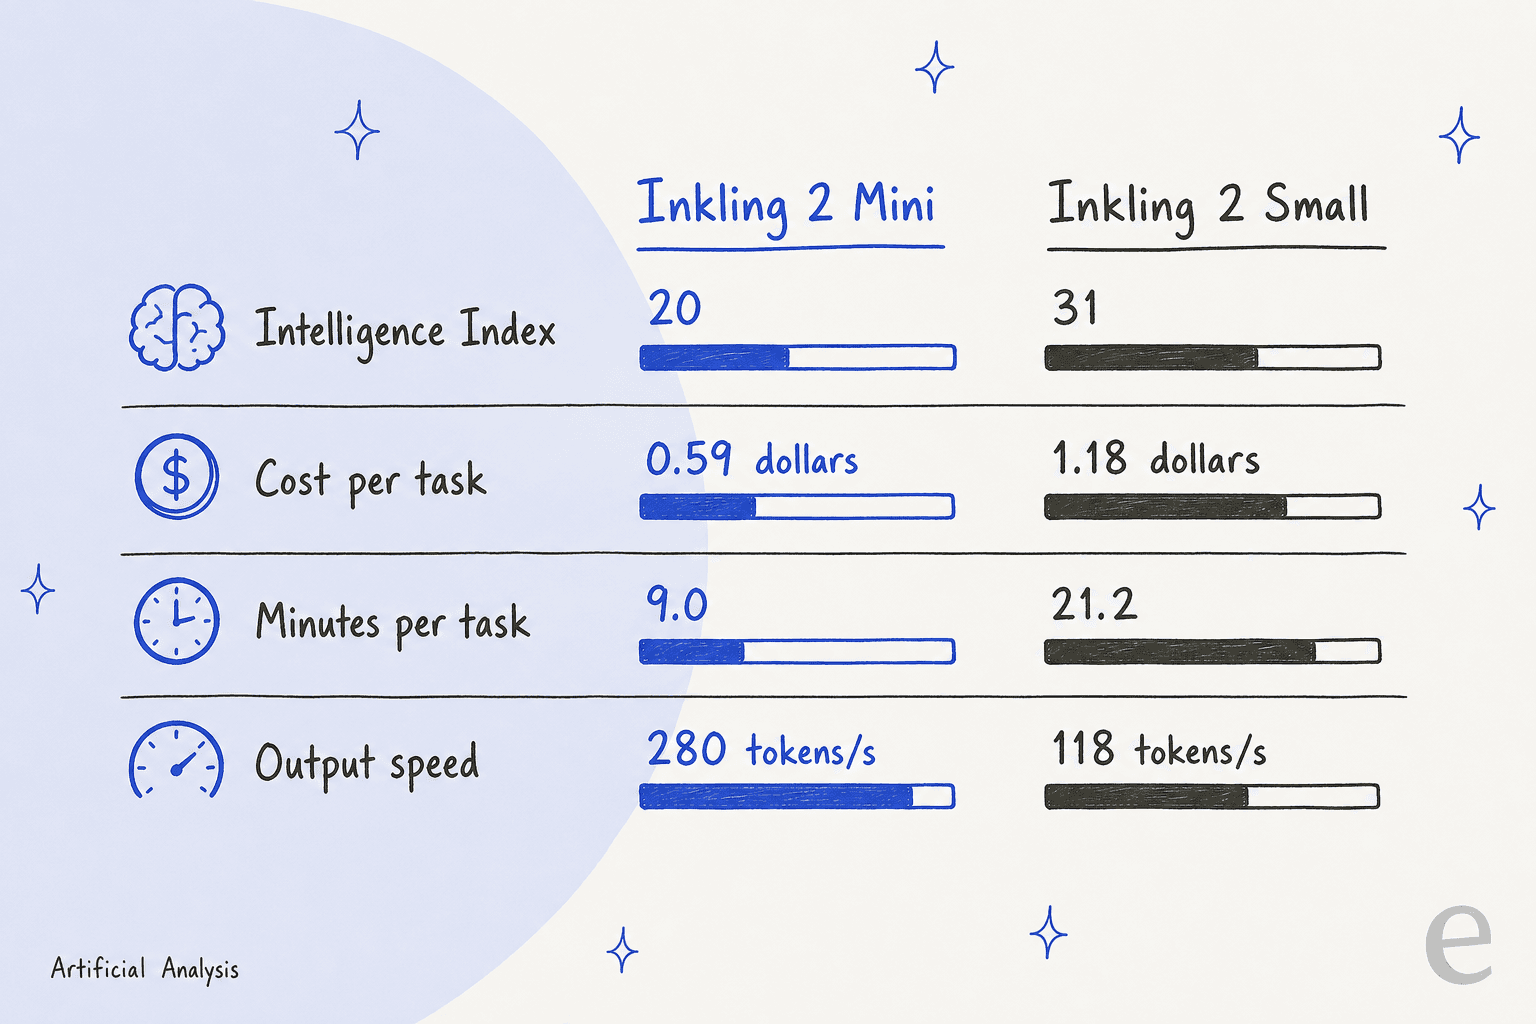
Mini note 11 points en dessous de Small et coûte moitié moins par tâche. La propre fiche du labo le dit plus crûment : le modèle est « moins capable qu'Inkling 2 Small sur la plupart de nos évaluations », avec les plus grands écarts sur le rappel factuel. L'exception est le travail agentique long, où le labo dit que Mini « s'approche » de Small sur son test PMPP-Hard. Les membres plus anciens de la famille sont couverts dans les articles sur Inkling, Inkling-Small et Inkling 2 Small.
Une correction au portrait de Small que j'ai écrit plus tôt. Au lancement, les poids de Small étaient fermés. Ils sont depuis apparus sur Hugging Face sous Apache 2.0, et Artificial Analysis liste maintenant DeepInfra, Nebius et Together comme hébergeurs, avec des chiffres de vitesse et de coût qui ont bougé en conséquence. J'utilise ci-dessus les chiffres actuels.
Comment fonctionne un modèle en boucle ?
Un transformeur en boucle réutilise les mêmes couches plus d'une fois par token. Inkling 2 Mini stocke 24 couches en quatre blocs de six, et les deux blocs du milieu tournent trois fois, si bien que chaque token passe par 48 applications de couche. La fiche du modèle dit que boucler les couches du milieu a battu boucler les dernières couches sur 27 des 28 évaluations.
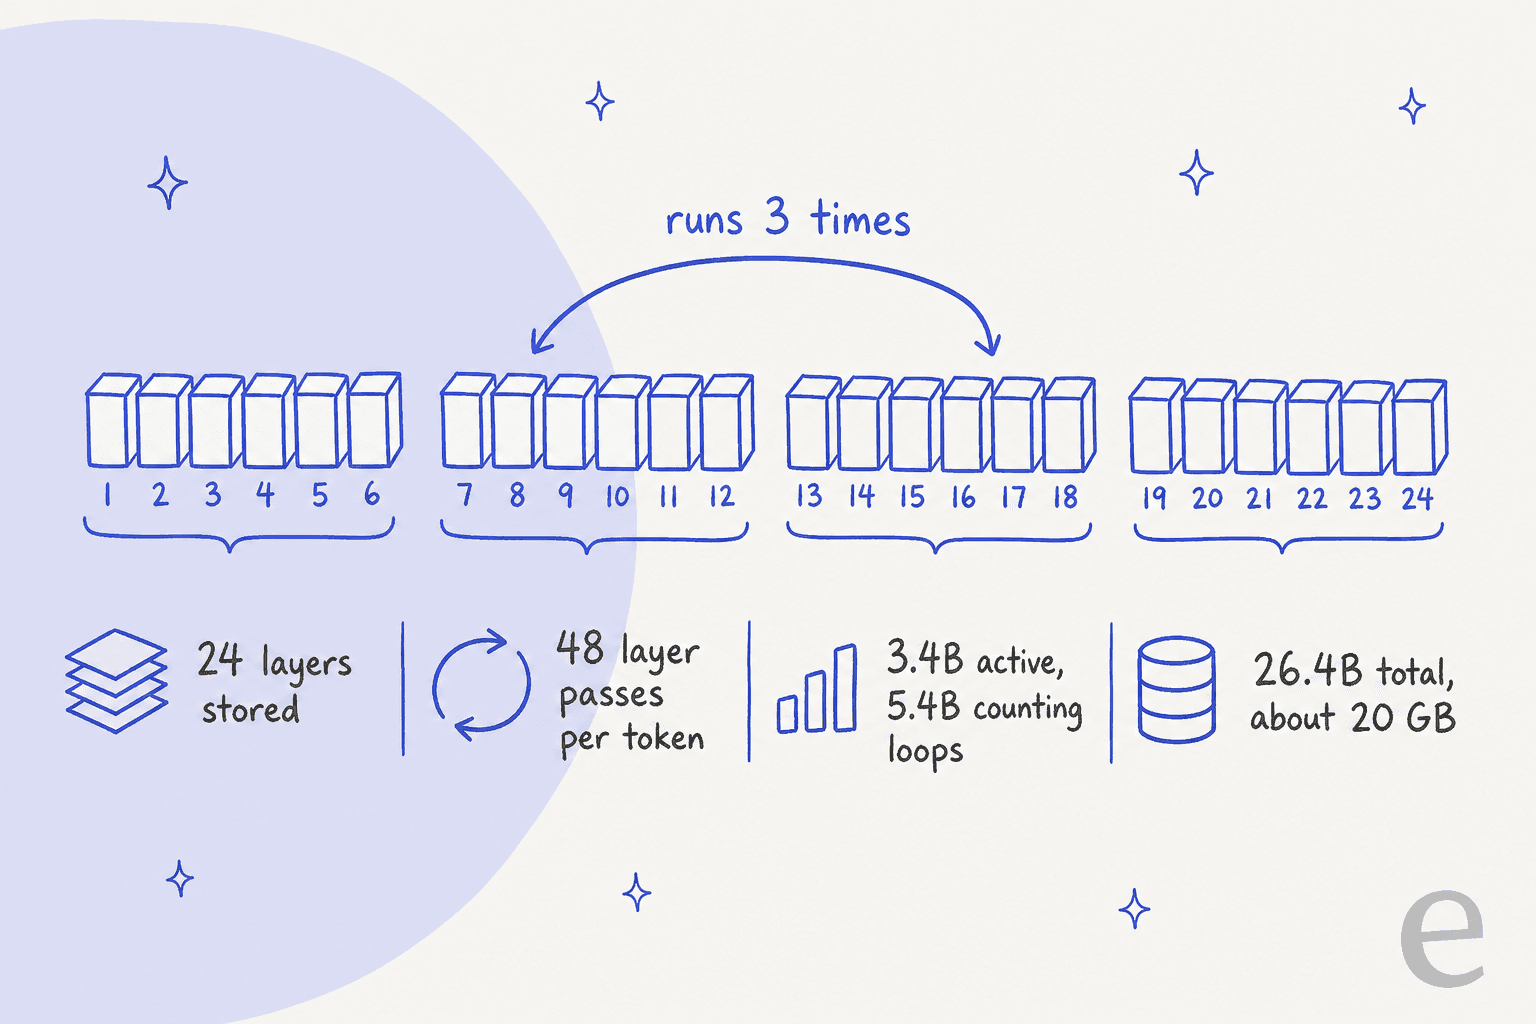
Le point, c'est la mémoire. Les téléphones, ordinateurs portables et petits serveurs sont limités par le nombre de poids qu'ils peuvent stocker, pas par la quantité de calcul qu'ils peuvent faire. Réutiliser des couches achète de la réflexion supplémentaire par token sans agrandir le fichier. Trois autres détails de la fiche :
- Entraînement. Les couches d'experts ont été entraînées en NVFP4 (4 bits) depuis le pré-entraînement jusqu'à l'apprentissage par renforcement, et les quatre dernières couches en 8 bits, si bien que les poids livrés correspondent aux poids entraînés sans étape de conversion.
- Réduction. Le labo a élagué le modèle de 384 à 128 experts par couche à mi-parcours de l'entraînement, puis l'a soigné avec 1T de tokens de distillation à partir d'un modèle Inkling interne plus grand.
- Le piège. Boucler n'ajoute pas de connaissance. Le labo écrit que la connaissance est surtout fonction du nombre total de paramètres, donc les faits ne s'améliorent pas avec plus de passages.
Cette dernière ligne est celle à garder en tête pour le reste de cet article.
Combien coûte Inkling 2 Mini ?
Sur Tinker, Inkling 2 Mini sample à 0,15 $ par 1M de tokens d'entrée, 0,015 $ par 1M de tokens d'entrée en cache et 0,50 $ par 1M de tokens de sortie. Le fine-tuning (« train ») coûte 0,75 $ par 1M de tokens à 64K de contexte et 1,50 $ à 256K. Inkling 2 Small coûte exactement le double côté sampling. Les prix viennent de la page de prix de Tinker du fournisseur ; je n'ai utilisé aucun prix tiers.
Trois choses changent la facture réelle :
- Le serverless n'est pas ouvert pour Mini. La page de prix limite l'inférence serverless à Inkling 2 Small, Inkling et Inkling-Small, et la page OpenRouter ne montre aucun prix. Aujourd'hui, les voies réalistes sont le sampling Tinker ou votre propre matériel.
- La sortie verbeuse mange l'économie. Le prix par token est la moitié de celui de Small, mais Mini écrit à peu près autant de tokens par tâche, donc l'écart par tâche avec Small est d'environ 2x, le même ratio que les prix par token. Les tokens de sortie sont l'unité qui décide de la facture.
- Le local, c'est une autre facture. Sur votre propre machine, le coût est le matériel et le temps, pas les tokens, ce qui est le cas pour lequel le labo a construit Mini.
Pour une vision budgétaire du support, le guide coût de l'IA dans le service client montre comment le prix du modèle se situe à côté des sièges, des résolutions et de la configuration.
Où Inkling 2 Mini pèche-t-il ?
La connaissance, les chats à plusieurs tours et les sessions de terminal. Le labo rapporte ses propres lacunes, ce qui mérite d'être crédité. Sur sa propre fiche, le taux de non-hallucination AA-Omniscience de Mini est de 63,4%, donc quand il ne connaît pas une réponse sur ce test, il devine au lieu de le dire un peu plus d'un tiers du temps. La fiche place aussi Mini derrière Qwen3.8-27B sur MultiChallenge (50,0%) et ComplexConstraints (33,4%), et à égalité à un faible 5,6% sur Terminal Bench 4.0.
Les premiers utilisateurs ont remarqué le même schéma. Un testeur de Hacker News a lancé un prompt de codage avec les outils désactivés :
"The model burned through 19200 thinking tokens on this task (which was the hard limit I had set) and didn't finish."

Le même utilisateur a dit qu'avec la recherche autorisée, il est arrivé à une solution mais a quand même utilisé le mauvais nom de hook. Un autre commentateur a été plus direct sur les benchmarks d'agents :
"Big fan of open weights but those Terminal Bench numbers are pretty abysmal."
Le fil de lancement a atteint 473 points et 72 commentaires sur Hacker News, et la plupart des éloges portaient sur la taille et la vitesse, pas sur la précision. La lecture du labo est que Mini « surmonte le déficit de connaissance » en utilisant la recherche et les outils, ce qui correspond à ce que ce testeur a vu : il s'est amélioré une fois qu'il a pu vérifier des choses.
Là où Mini prend vraiment la tête, c'est sur le travail agentique qui consiste surtout en recherche et appels d'outils. Le labo rapporte 79,2% sur SWE-bench Verified (bash seulement), contre 77,8% pour Qwen3.8-27B, plus 79,0% sur BrowseComp et 82,7% sur MCP Atlas. Ce sont les chiffres du labo, exécutés sur son propre harnais, donc j'attendrais des exécutions externes avant de les traiter comme établis. Gemini 3.8 Flash, DeepSeek V4 Flash et Kimi K3 sont les options hébergées plus grandes si vous n'avez pas besoin de poids locaux.
Peut-on faire fonctionner Inkling 2 Mini sur un ordinateur portable ?
Oui, et c'est le vrai titre pour la plupart des développeurs. La fiche du modèle dit qu'un DGX Spark ou une machine Apple avec 32 Go ou plus de mémoire unifiée suffit, et il existe des builds GGUF quantifiés pour llama.cpp, Ollama et des applications similaires. Le labo cite aussi une étude d'efficacité de Stanford sur un DGX Spark, où Mini a obtenu 0,703 sur sa mesure d'intelligence par watt contre 0,430 pour Qwen3.6-35B-A3B.
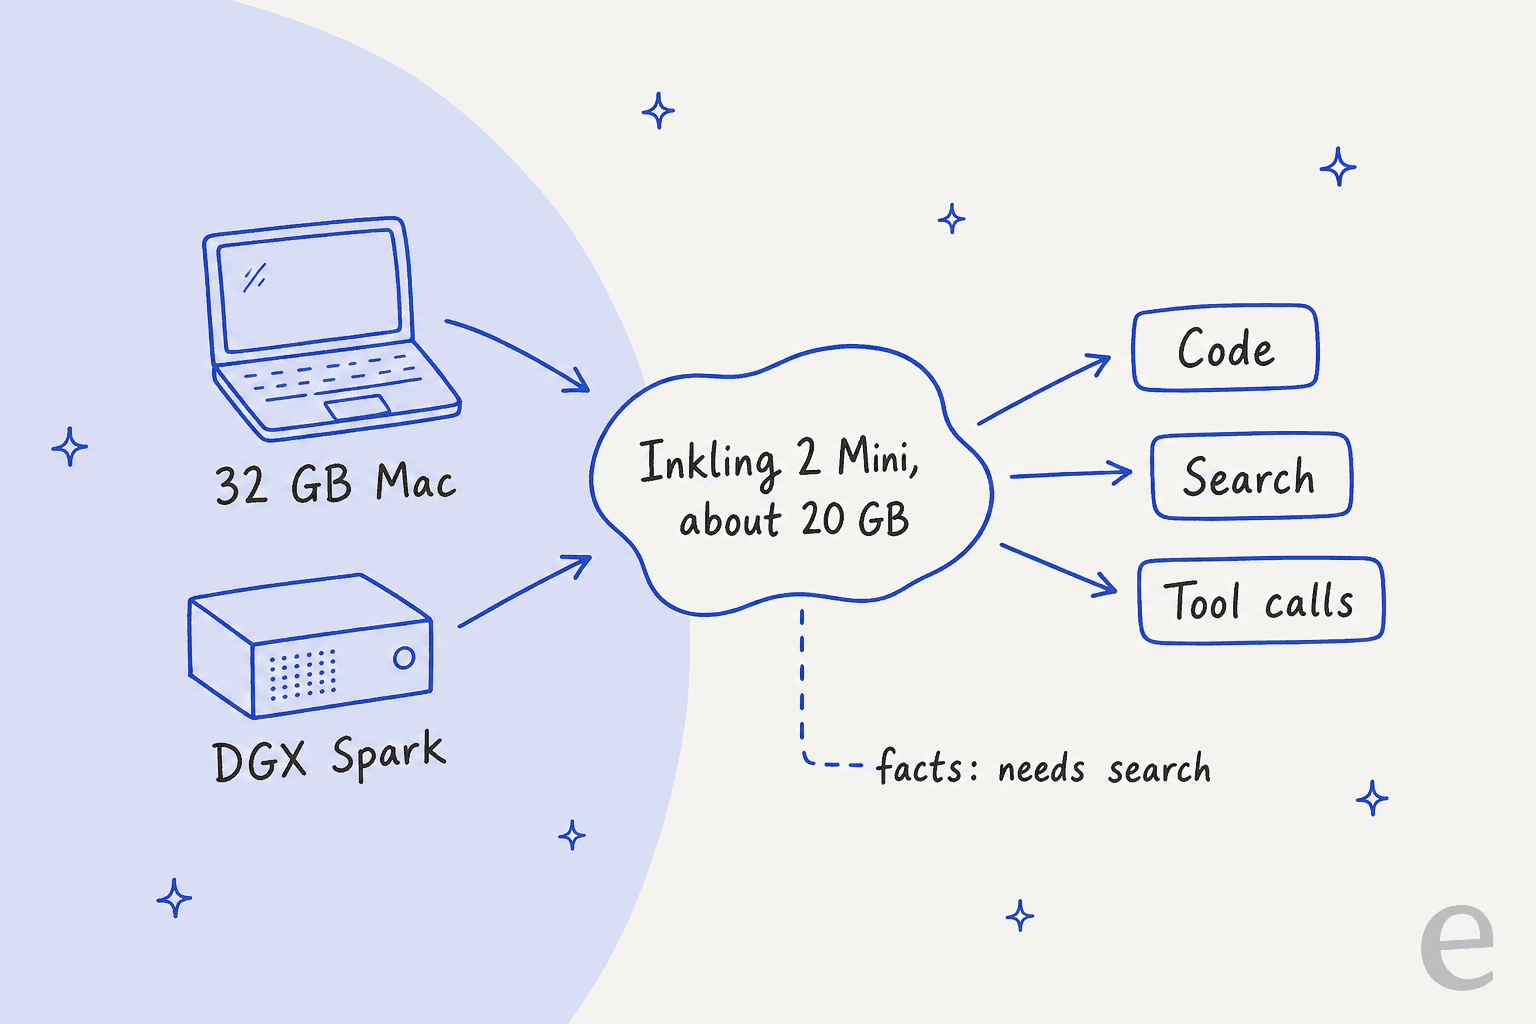
La vitesse réelle est moins claire. Le labo n'a pas publié de chiffre de tokens par seconde pour sa démo sur ordinateur portable. Un utilisateur de Hacker News avec une machine plus ancienne a rapporté :
"I'm getting 20 tokens/s running the 4-bit version on my 2021 M1 Max MacBook pro with 64Gb."
Un autre commentateur a noté que llama.cpp a eu besoin d'une pull request séparée pour ajouter le support des boucles, donc un runtime obsolète pourrait ne pas charger le modèle. Pour d'autres runtimes, voir alternatives à llama.cpp. Les 280 tokens par seconde listés par Artificial Analysis sont une mesure hébergée, pas ce qu'un ordinateur portable fera.
Inkling 2 Mini vaut-il le coup pour le support ?
Cela vaut le coup de le tester comme moteur, pas comme agent. Un agent de support, c'est un modèle plus votre documentation, vos outils, vos règles de transfert et un moyen de le vérifier avant que les clients ne le voient. L'argument de Mini (bon marché, rapide, fort avec les outils) convient aux parties riches en outils, et sa faiblesse (des faits erronés affirmés avec assurance) est la partie que vous ne pouvez pas laisser sans supervision. Une hallucination dans une réponse de remboursement coûte bien plus que les tokens économisés.
C'est pourquoi eesel traite le modèle comme interchangeable. Un coéquipier IA pour le helpdesk rejoint votre file existante, apprend de votre centre d'aide et de vos tickets passés, et est simulé sur des tickets historiques avant de passer en direct, si bien qu'un nouveau moteur est jugé sur vos questions, pas sur le tableau d'un labo. SamCart est un bon exemple de cette configuration. Elle fait tourner un agent sur les tickets Freshdesk et un autre sur le chat de son site, les deux répondant à partir d'environ 280 articles du centre d'aide. Sur les tickets, l'agent répond seulement jusqu'à ce qu'un coéquipier prenne le relais, et une demande de parler à une personne termine son tour. Rien de tout cela ne dépend du modèle en dessous.
Si vous voulez essayer Mini vous-même, donnez-lui d'abord une tâche bornée :
- Choisissez une tâche étroite, comme rédiger des réponses à partir d'un ensemble fixe d'articles.
- Limitez la sortie et les tours, comme le recommande la fiche du modèle, car le réglage de raisonnement minimal ne le désactive pas complètement.
- Rejouez des tickets passés et comparez à vos réponses humaines, comme dans les tests de simulation d'agents de support IA et les tests d'agents de support IA.
- Limitez ce qu'il peut faire, en utilisant les idées de permissions des agents de support IA.
- Surveillez-le après le lancement, avec les traces décrites dans observabilité des agents de support IA.
Pour une liste plus large, meilleurs modèles IA pour les tickets de support et meilleurs agents IA de support client comparent modèles et produits sur des tests spécifiques au support, et le guide agent IA pour Freshdesk montre à quoi ressemble une option native au helpdesk.
Vous voulez un modèle que vous pouvez changer sans reconstruire votre configuration de support ? Essayez eesel : ça fonctionne comme une nouvelle recrue qui se branche sur votre helpdesk en quelques minutes, connaît déjà votre centre d'aide, et est testée sur vos tickets passés avant de parler à un client.
Que lire d'autre ?
Vous suivez la famille Inkling ? Voici les lectures les plus proches :
- L'avis sur Inkling 2 Small, la comparaison la plus proche de cet article.
- L'avis sur Inkling-Small et l'avis sur Inkling pour la première génération.
- Alternatives à Inkling-Small si vous choisissez entre petits modèles ouverts.
- Entrées du glossaire sur les grands modèles de langage, le fine-tuning, les agents IA et le RAG.