

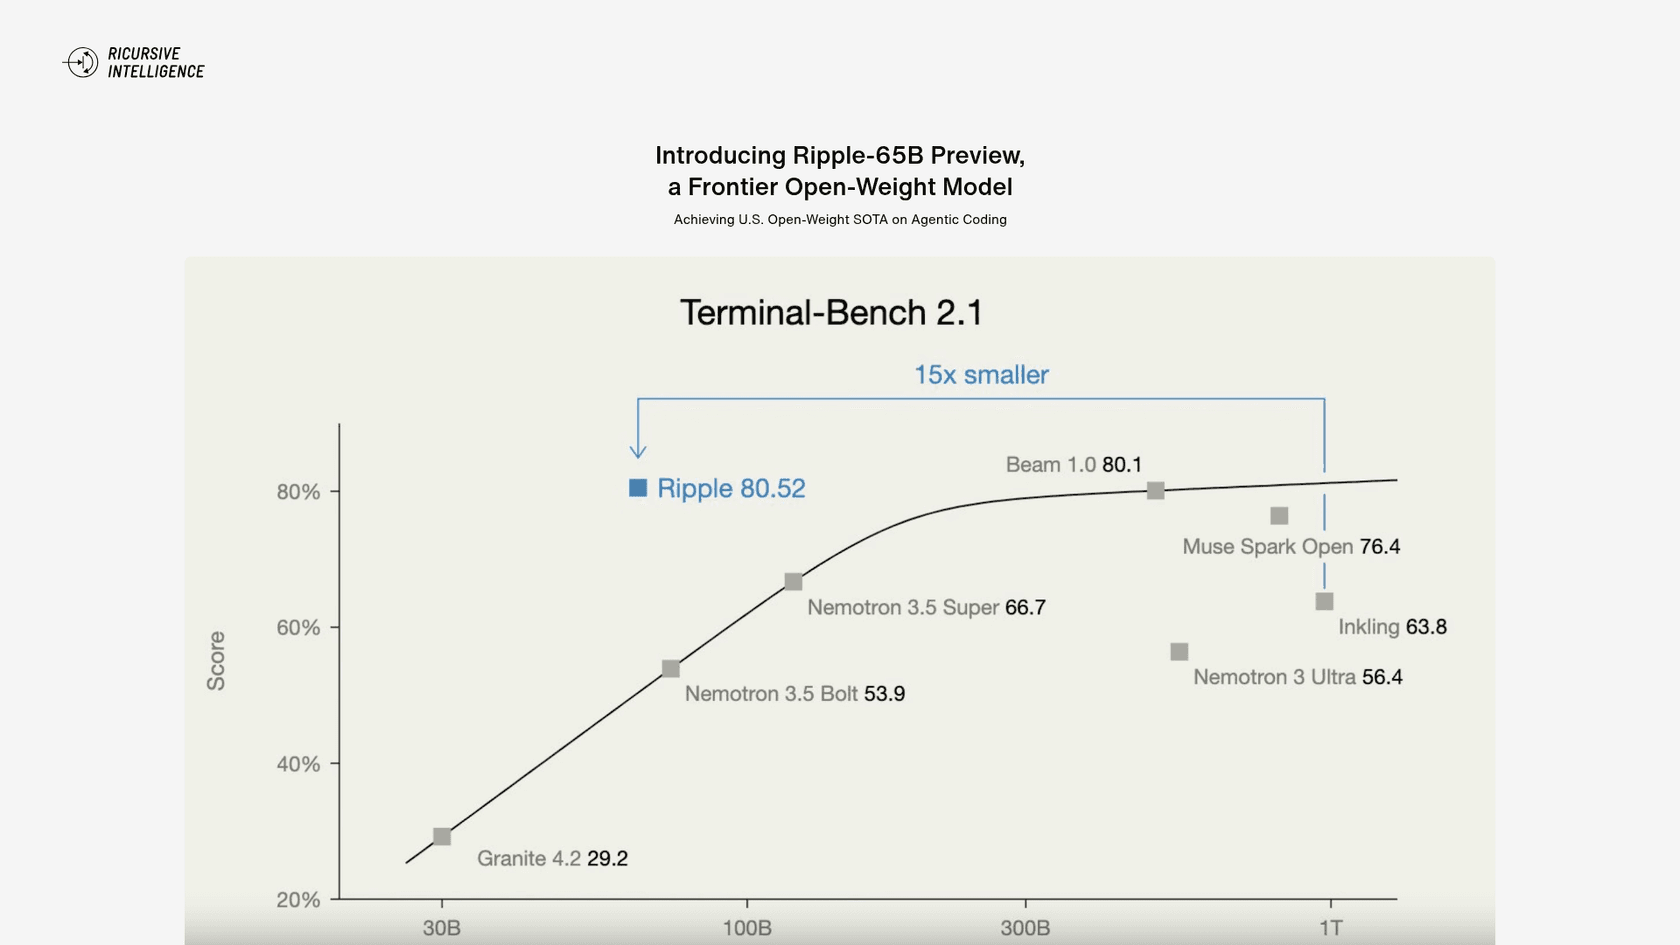
Ripple-65B est le meilleur modèle ouvert fabriqué aux États-Unis que l'on puisse faire tourner sur une seule machine, mais ce n'est pas le meilleur modèle ouvert de code dans l'ensemble. Il obtient 80.5 sur Terminal-Bench 2.1, un poil au-dessus de Beam de Reflection (80.1), un modèle presque huit fois plus gros. Hors de cette ligne, Beam mène sur cinq tests de code et d'agents, et son API offre 1M de tokens de contexte là où celle de Ripple en offre 16,384.
Mon verdict : 3.5/5. Choisissez Ripple pour des poids américains sous Apache 2.0 qui tiennent sur un DGX Spark ; appelez Beam si vous voulez juste une API. Pour un agent de support, un coéquipier prêt à l'emploi comme eesel vous évite le choix du modèle, et sa CLI permet à un agent de code de charger vos documents d'aide et de tester les réponses avant la mise en ligne.
Qu'est-ce que Ripple-65B, en une minute ?
Ripple-65B Preview est un modèle de langage à poids ouverts publié le 4 novembre 2026 par Ricursive Intelligence, un laboratoire qui conçoit de l'IA pour la conception de puces. Ricursive l'a entraîné de zéro et le décrit comme "a general-purpose variant of the proprietary model that powers our AI chip design platform." Si vous voulez le tour complet des spécifications, l'explication de Ripple-65B de mon collègue le couvre ; cet article est le verdict.
La fiche technique, issue de la model card :
| Spécification | Ripple-65B Preview |
|---|---|
| Paramètres | 65B au total, tous actifs (dense, pas un mélange d'experts) |
| Couches | 80, avec 4 couches à fenêtre glissante pour 1 couche globale |
| Données d'entraînement | 12T tokens, texte uniquement, surtout anglais et code |
| Contexte (annoncé) | Jusqu'à 1M de tokens |
| Licence | Apache 2.0 |
| Checkpoints | BF16 instruct, NVFP4 instruct (expérimental), base, modèle brouillon DFlash2 |
| Raisonnement | Réfléchit toujours dans des balises <think>, sans interrupteur ni niveaux d'effort |
| Coût total de R&D | $32M, selon Ricursive |
Cette dernière ligne est celle dont tout le monde parle. Ricursive affirme que $32M couvrent la totalité de son coût de recherche et développement depuis zéro, et parle de "one-tenth the cost of the previous open-weight SOTA on agentic coding." La note de bas de page montre que ce "one-tenth" est l'estimation propre de Ricursive de la facture de calcul de Beam, construite à partir d'un article de presse et du calendrier d'entraînement de Reflection ; considérez-le comme une comparaison approximative et non auditée.
Comment l'ai-je testé ?
Je construis les intégrations derrière les agents IA d'eesel, donc je lis une model card comme je lirais une spécification d'API avant de la brancher en production : quels sont les chiffres, d'où viennent-ils, et ce qui casse quand on l'appelle vraiment. Une chose que des années d'agents eesel sur de vrais helpdesks m'ont montrée, c'est qu'un classement ne dit pas ce que fait un modèle sur vos propres tickets, c'est pourquoi chaque déploiement eesel est simulé sur des tickets passés avant la mise en ligne.
Pour Ripple, je n'avais pas d'accès API pour lancer mon propre jeu de tests le jour du lancement, donc cet avis repose uniquement sur des sources primaires :
- Le billet de lancement de Ricursive, plus sa model card sur Hugging Face avec les scripts d'inférence.
- Les fiches en direct sur OpenRouter, GMI Cloud et Together AI, vérifiées le 5 novembre 2026.
- Le premier jour de réactions des développeurs sur Hacker News et X.
Ripple n'est pas encore sur Artificial Analysis, donc chaque benchmark ci-dessous est un chiffre de Ricursive lui-même. Je dirai de quelle page vient chacun, car, comme vous le verrez, les deux pages ne concordent pas toujours.
Comment Ripple-65B se compare-t-il à Beam et aux autres modèles ouverts américains ?
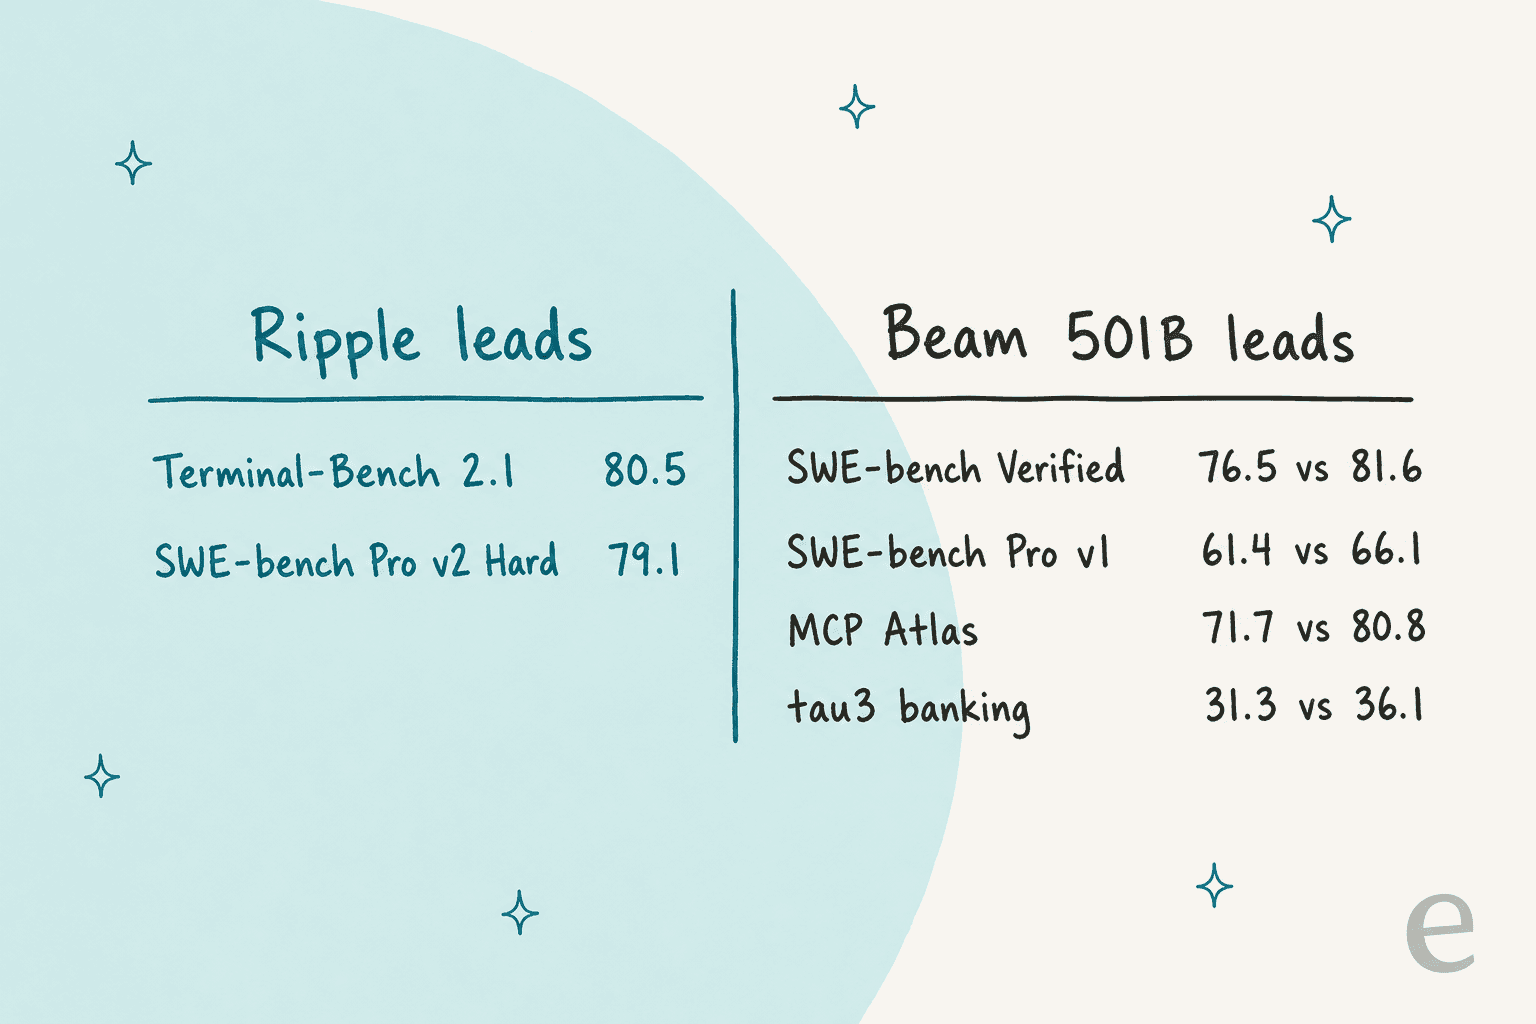
Sur les deux lignes que Ricursive met en avant, Ripple gagne. Sur la plupart des autres, non. Voici le tableau instruct de la model card, réduit aux lignes de code et d'agents qui comptent pour l'acheteur d'un modèle de code :
| Benchmark | Ripple-65B | Beam 501B | Muse Spark Open 816B | Inkling 975B | Nemotron 3 Ultra 550B |
|---|---|---|---|---|---|
| Terminal-Bench 2.1 (auto-déclaré) | 80.5 | 80.1 | 76.4 | 63.8 | 56.4 |
| SWE-bench Pro v2.0 Hard | 79.1 | 76.5 | 52.3 | 2.0 | 30.7 |
| SWE-bench Verified | 76.5 | 81.6 | 78.7 | 77.6 | 71.9 |
| SWE-bench Pro v1.0 | 61.42 | 66.1 | 58.2 | 54.3 | 46.9 |
| DeepSWE 1.1 | 44.3 | 43.3 | 60.0 | 1.8 | 0.2 |
| MCP Atlas | 71.67 | 80.8 | 89.2 | 76.0 | 62.2 |
| τ³-bench banking | 31.27 | 36.1 | 14.4 | 23.7 | 22.6 |
| SciCode | 39.4 | 49.2 | 58.5 | 46.1 | 44.6 |
Deux choses sautent aux yeux. D'abord, l'avance sur Beam à Terminal-Bench est de 0.4 point, ce qui est une égalité dans toute lecture honnête. Ensuite, Beam bat Ripple sur cinq lignes de code et d'agents, et Muse Spark Open, que j'ai couvert dans mon avis sur Muse Spark Open, prend DeepSWE, MCP Atlas et SciCode.
Cela dit, un modèle de 65B qui égale un 501B sur sa meilleure ligne reste un vrai résultat. Beam a 23B de paramètres actifs par token et Ripple a les 65B actifs, donc la comparaison est moins déséquilibrée que ne le suggère « 8x plus petit », mais en termes de mémoire, Ripple est bien plus facile à héberger.
Quels chiffres croire ?
Ricursive est franc sur le côté désordonné. La model card dit que les scores des concurrents sont "official model card scores where available", et le reste vient de ses propres exécutions internes. Elle note aussi que les scores Terminal-Bench 2.1 sont sortis "universally lower (with the exception of Muse Spark Open)" sur le harnais officiel Terminus 2, donc elle publie les deux.
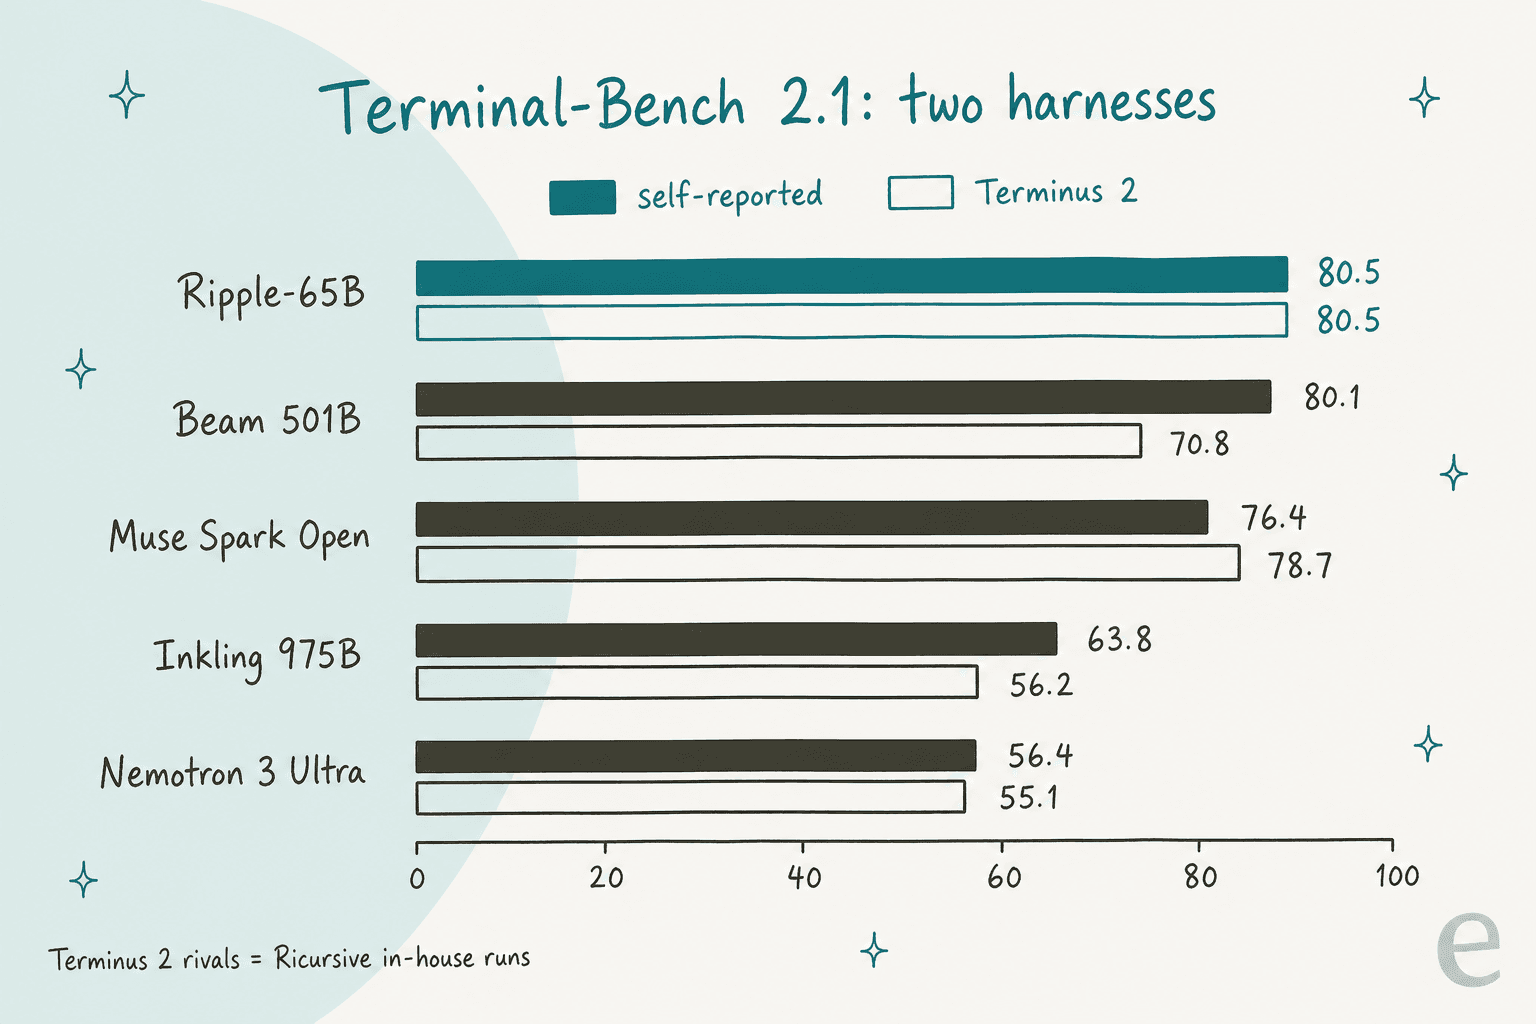
Sur le même harnais Terminus 2, l'avance de Ripple sur Beam grimpe à presque 10 points (80.5 contre 70.8). C'est le chiffre le plus intéressant de la sortie, et aussi celui que je vérifierais en premier, car le chiffre de Beam y est une exécution de Ricursive, pas de Reflection.
L'autre bémol : le graphique de lancement et la model card divergent sur certains scores de concurrents. Sur SWE-bench Pro v2.0 Hard, le billet de lancement montre Muse Spark Open à 72.4 et Inkling à 39.6, alors que la model card indique 52.3 et 2.0. Les chiffres de Ripple concordent sur les deux pages. C'est un lancement en préversion et cela sera sans doute réconcilié, mais d'ici là, je considérerais les colonnes des concurrents comme approximatives.
Combien coûte Ripple-65B ?
Ripple est peu cher à appeler, avec un gros bémol. Les prix ci-dessous sont les fiches de chaque fournisseur, vérifiées le 5 novembre 2026 :
| Voie | Entrée / 1M | Sortie / 1M | Lecture en cache / 1M | Contexte |
|---|---|---|---|---|
| GMI Cloud | $0.20 | $0.60 | $0.05 | 1,000,000 indiqué |
| OpenRouter (servi par GMI) | $0.20 | $0.60 | $0.05 | 16,384, sortie max 14,745 |
| Together AI | Bientôt | Bientôt | n/a | 1M indiqué |
| Poids Hugging Face | Gratuit (Apache 2.0) | Votre matériel | n/a | Jusqu'à 1M sur 2x B200 |
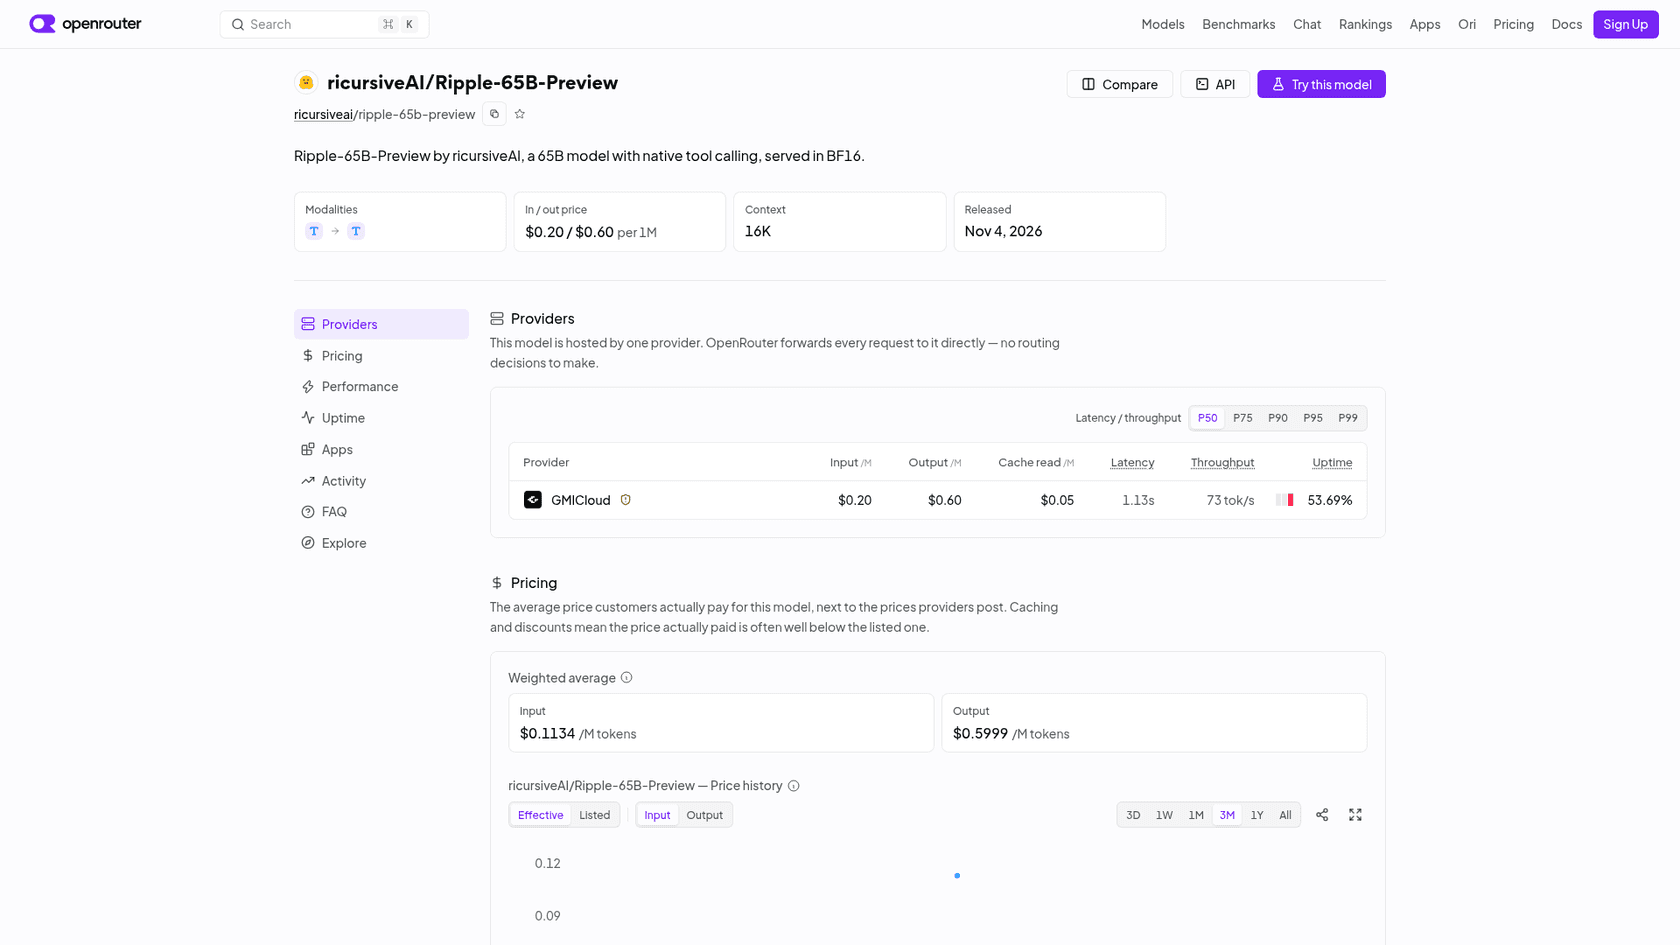
Le bémol, c'est cette fenêtre de 16K. Un agent de code comme Claude Code ou les outils de mon guide sur le code IA en terminal peut dépasser 16,384 tokens avant d'avoir fini de lire le dépôt. Via OpenRouter aujourd'hui, Ripple a la vue trop courte pour le code agentique pour lequel il a été conçu. Quand j'ai capturé la page, elle montrait aussi un seul fournisseur à 53.69% de disponibilité et 73 tokens par seconde, ce qui est normal au deuxième jour mais pas quelque chose à mettre en production pour l'instant.
Voici le prix d'une session de 10M de tokens en entrée et 1M en sortie face aux rivaux ouverts, avec les prix catalogue d'OpenRouter :
| Modèle | Entrée / sortie par 1M | Coût pour 10M en entrée + 1M en sortie | Contexte sur OpenRouter |
|---|---|---|---|
| Ripple-65B Preview | $0.20 / $0.60 | $2.60 | 16,384 |
| Beam 1.0 501B | $0.25 / $1.00 | $3.50 | 1,048,576 |
| Qwen3.8 27B | $0.15 / $1.875 | $3.38 | 1,024,000 |
| DeepSeek V4.1 Flash | $0.045 / $0.50 | $0.95 | 1,048,576 |
| Inkling | $1.00 / $4.05 | $14.05 | 524,288 |
| Muse Spark Open | $1.25 / $4.25 | $16.75 | 1,048,576 |
Ripple est donc $0.90 moins cher que Beam sur cette session, avec 64 fois moins de contexte. Pour la plupart des acheteurs d'API, ce compromis n'en vaut pas la peine. DeepSeek V4 Flash reste le choix économique, et Qwen 3.8 est la comparaison non américaine évidente que Ricursive a laissée hors de son graphique. Tout comme Kimi K3.
Peut-on vraiment le faire tourner sur son propre matériel ?
Oui, et c'est là que Ripple mérite sa place. Un modèle dense de 65B est assez petit pour tenir sur une machine, et Ricursive fournit les scripts pour le faire. Ce que le marketing du jour de lancement escamote, c'est ce que chaque voie exige de vous :
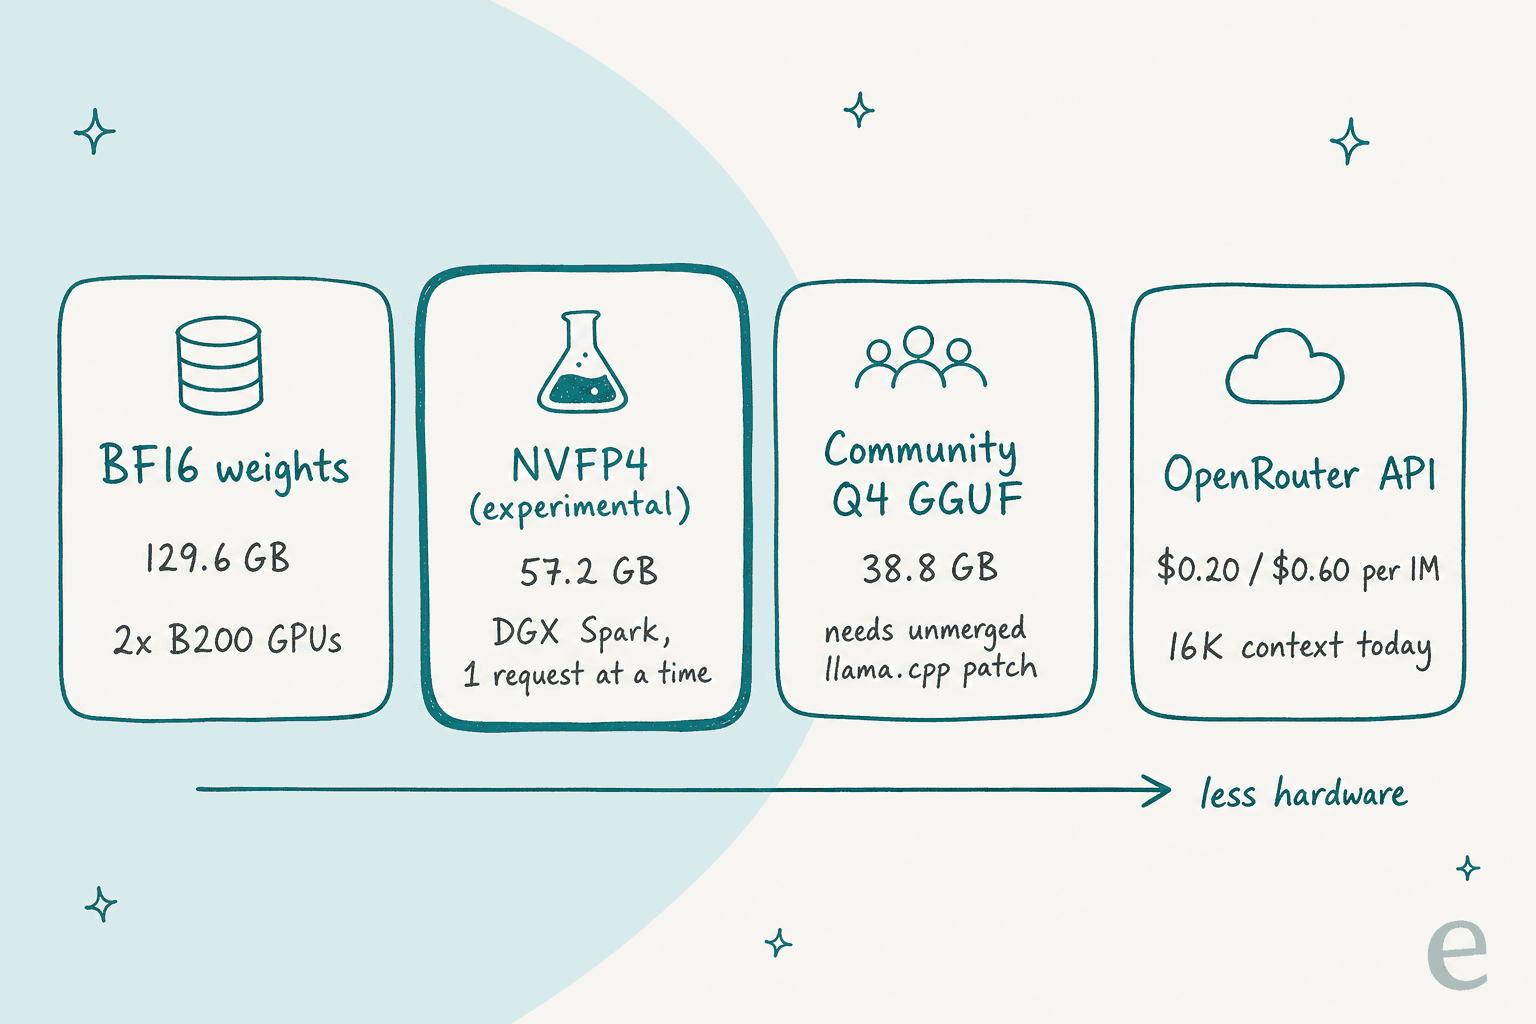
- BF16 sur 2x B200. Le README du serveur utilise SGLang 0.5.19 avec le modèle brouillon DFlash2 et 1M de contexte par défaut. La fiche cite
250tokens par seconde à un lot de 8. - NVFP4 sur un DGX Spark. Le checkpoint NVFP4 est étiqueté expérimental, garde l'attention en BF16, et le script local traite une requête à la fois avec un contexte de 128K.
- GGUF communautaire. La quantification d'AtomicChat fait
38.8 GBen Q4_K_M, mais llama.cpp, Ollama et LM Studio standard ne peuvent pas la charger tant qu'un correctif llama.cpp n'est pas fusionné. - Pas de build MLX. Le cofondateur de Ricursive a écrit qu'on peut l'exécuter "on a MacBook Pro", mais aucun guide officiel ne couvre encore Apple Silicon.
Un commentateur de Hacker News a bien résumé le compromis des modèles denses :
"it's a 65B dense model and inference will be prohibitively slow on consumer grade hardware"

Et l'autre côté, de la part de quelqu'un qui a le bon matériel :
"Speaking as someone who has High-Memory Mac Studios, it is great that there is finally a model that will run at usable speeds with high quality."
Deux écueils mineurs pour qui l'intègre dans un agent. Le modèle de chat "does not implement a thinking on/off switch or reasoning-effort levels", donc chaque réponse paie une passe de raisonnement. Et forcer un appel d'outil exige des schémas stricts : la fiche prévient que "Non-strict required calls produced extra argument fields." Le point d'accès d'OpenRouter n'accepte pour l'instant que tool_choice à none ou auto.
Que disent les développeurs ?
La réaction du premier jour se partage nettement. Le coût d'entraînement est salué par presque tout le monde, et le cadrage « état de l'art » est contesté. Côté X :
"this is like the avengers of open model SOTA"
C'était swyx réagissant au chiffre de $32M de R&D totale. Sur Hacker News, où le fil a atteint 182 points, la plainte la plus commentée portait sur la catégorie étroite :
"Category narrowing to this degree really has diluted the term "SOTA" quite a lot"
Plusieurs commentateurs ont souligné que le graphique ne compare que des modèles ouverts américains et laisse de côté Qwen. L'un a placé le chiffre Terminal-Bench de Ripple à côté de celui d'Alibaba :
"This model scores 80.5 on Terminal Bench 2.1 For reference Qwen 3.8 Flash Next (which is bigger than this model but probably cheaper to run due to MoE) scores 84.3, and Qwen 3.8-27B scores 73.0."
Et le commentaire qui, à mes yeux, explique à qui ce modèle s'adresse vraiment :
"There are several situations where some of us are explicitly prohibited from using models from companies not under the jurisdiction of the United States."
C'est le vrai marché. Si votre équipe sécurité a exclu les poids de laboratoires chinois, les alternatives à cette taille étaient rares, et Ripple est désormais le modèle ouvert américain le plus puissant qui tienne sur une seule station de travail.
Faut-il utiliser Ripple-65B pour un agent de support ?
Je n'en ferais pas mon premier choix, et la raison figure dans le tableau même de Ricursive. τ³-bench banking est ce qui, sur la fiche, ressemble le plus à un test de service client : un agent qui suit des politiques et appelle des outils pour un client de banque. Ripple y obtient 31.27, derrière les 36.1 de Beam. Ajoutez le raisonnement toujours actif (premières réponses plus lentes), le post-entraînement léger "with a focus on agentic coding" et le contexte hébergé de 16K : il est conçu pour un autre travail. Mon guide du meilleur LLM pour le support détaille ce qui compte ici.
Le point plus important, c'est qu'un modèle est une infrastructure. Pour une équipe de support, le plus dur est tout ce qui l'entoure : lire le helpdesk, apprendre des tickets passés, savoir quand passer la main. C'est à cela que sert eesel. C'est un coéquipier IA que vous embauchez pour un poste, comme le coéquipier IA pour helpdesk, plutôt qu'un modèle que vous hébergez. Trois clients montrent comment cela se passe :
- SE Ranking fait tourner un agent eesel par produit sur Zendesk et a traité
4,650conversations en un mois, en confiant à l'équipe les remboursements, les prolongations d'essai et les questions de niveau 2. - Timengo l'utilise sur Freshdesk pour rédiger des réponses à des tickets techniques à partir d'environ
5,300tickets passés et articles d'aide, et eesel ne répond jamais seul à un client là-bas. - SamCart fait tourner des agents séparés sur Freshdesk et le chat du site, en répondant à partir d'environ
280articles du centre d'aide.
Si vous aimez piloter des outils depuis un terminal, la CLI eesel permet à un agent de code comme Claude Code, Codex ou Cursor de téléverser des connaissances approuvées, comme des articles d'aide et des politiques exportés, puis de poser des questions de test à l'agent avec eesel chat et de vérifier les réponses avant toute mise en ligne. Connecter le helpdesk lui-même demande toujours à quelqu'un disposant des droits d'administrateur de l'approuver. Plus sur ce schéma dans le guide de la CLI d'agent IA, et l'explication du serveur MCP couvre l'autre point d'entrée.
Les réserves avant de changer
- Le contexte hébergé est de 16K. Suffisant pour un chat, trop petit pour du travail d'agent à l'échelle d'un dépôt tant que GMI ou Together ne l'élargissent pas.
- Les benchmarks ne sont pas encore indépendants. Pas d'entrée Artificial Analysis, et le graphique de lancement et la model card divergent sur certains scores de concurrents.
- L'installation locale est centrée sur NVIDIA. Les voies officielles demandent des B200 ou un DGX Spark ; les utilisateurs de Mac attendent des builds communautaires.
- Il réfléchit toujours. Impossible de désactiver le raisonnement pour des réponses rapides et simples.
- C'est une préversion. Ricursive qualifie le post-entraînement de "relatively light", et le build NVFP4 est expérimental.
Verdict : qui devrait faire tourner Ripple-65B ?
Ma note : 3.5/5. Ripple est un premier modèle impressionnant d'une équipe d'entraînement de cinq personnes, et le chiffre de $32M de coût total compte pour l'avenir des modèles ouverts. Mais la victoire phare est une égalité à 0,4 point, et un acheteur qui compare les modèles sur leurs mérites trouvera Beam devant sur davantage de lignes.
- Utilisez-le si vous avez besoin de poids Apache 2.0 d'un laboratoire américain, que vous avez un DGX Spark ou deux B200, et que votre agent vit dans un terminal. C'est une vraie niche, et Ripple y règne.
- Passez votre chemin si vous appelez une API. Beam 1.0 coûte
$0.25/$1.00avec une fenêtre de 1M, et DeepSeek V4 Flash est bien moins cher si l'origine du laboratoire vous importe peu. - Attendez un mois si vous êtes sur Mac. Une fois le support llama.cpp fusionné et des chiffres réels de tokens par seconde publiés, le cas local sera bien plus clair.
Pour le paysage plus large, mon avis sur Inkling couvre le plus gros modèle ouvert américain. L'avis sur GLM-5.3 Flash couvre une option chinoise moins chère.
Le comparatif des alternatives à Kimi K3 classe les modèles ouverts côte à côte. Côté fermé, Claude Sonnet 5.5 reste le modèle par défaut de la plupart des agents de code, avec GPT-5.6 juste derrière.
Essayer eesel
Si vous êtes ici parce que vous choisissez un modèle pour alimenter un agent de support, vous pouvez sauter cette étape. eesel est un coéquipier IA qui se branche sur Zendesk, Freshdesk ou Gorgias, apprend de vos tickets passés et de votre centre d'aide, et est testé sur vos vraies conversations avant de répondre à qui que ce soit. SE Ranking est passé de la configuration à 4,650 conversations par mois sur trois produits. Les offres démarrent à $299/month pour 500 crédits sur la page des tarifs, avec un essai gratuit. Essayez eesel et lancez-le d'abord sur votre propre file de tickets.
