

Le tarif de Ripple-65B est de $0.20 par million de tokens d'entrée et $0.60 par million de sortie, avec l'entrée en cache à $0.05, et il n'y a qu'un seul hébergeur derrière : GMI Cloud, en direct ou via OpenRouter. Pour une session d'agent de code avec 1M de tokens d'entrée (80 % en cache) et 50K de sortie, cela donne environ $0.11, un cinquième de moins que Reflection Beam et à peu près au niveau de GPT-5.6 Luna. L'auto-hébergement est rarement rentable : deux B200 louées coûtent environ $7,300 par mois, ce qui ne bat l'API qu'à environ 91 tâches par heure, sans interruption. Si vous chiffriez Ripple pour faire tourner une file de support, le modèle est la partie peu chère ; le coéquipier IA de helpdesk d'eesel couvre le reste, et sa CLI permet à un agent de code de charger vos documents d'aide et de tester les réponses avant la mise en production.
Combien coûte Ripple-65B ?
Ricursive Intelligence a publié Ripple-65B Preview le 4 novembre 2026, un modèle de code dense de 65B sous licence Apache 2.0 (la présentation de Ripple-65B explique ce qu'il est et comment il se classe). Les poids ne coûtent rien. L'accès hébergé coûte la même chose partout où il existe, parce que partout où il existe, ce sont les GPU d'une seule entreprise.
| Voie | Entrée / 1M | Sortie / 1M | Entrée en cache / 1M | Contexte | Statut (5 nov. 2026) |
|---|---|---|---|---|---|
| GMI Cloud (direct) | $0.20 | $0.60 | $0.05 | 1,000,000 | En ligne, BF16, aucune offre gratuite listée |
| OpenRouter | $0.20 | $0.60 | $0.05 | 1,048,576 dans l'API (la page indique 16K) | En ligne, GMI Cloud est le seul fournisseur |
| Together AI | Non listé | Non listé | Non listé | 1M dans le panneau de spécifications | « Bientôt disponible » |
| Poids sur Hugging Face | Gratuit | Gratuit | n/d | Jusqu'à 1M | Apache 2.0, aucun fournisseur d'inférence hébergé |
Quelques détails comptent plus que le tarif affiché :
- L'unité facturée est le token, dans les deux sens. La sortie coûte trois fois l'entrée. Un agent de code qui lit beaucoup et écrit peu se situe du côté des $0.20 ; un agent qui écrit de longs diffs paie davantage des $0.60.
- Le cache est un levier important. GMI facture $0.05 par token d'entrée en cache et ne liste aucun frais d'écriture en cache. Le panneau de tarifs d'OpenRouter affichait une moyenne pondérée d'environ $0.11 par million de tokens d'entrée réellement payés, parce que les prompts répétés touchent le cache.
- Il n'y a pas d'offre gratuite. OpenRouter n'a pas de variante
:free, et la page du modèle de GMI n'en montre aucune.
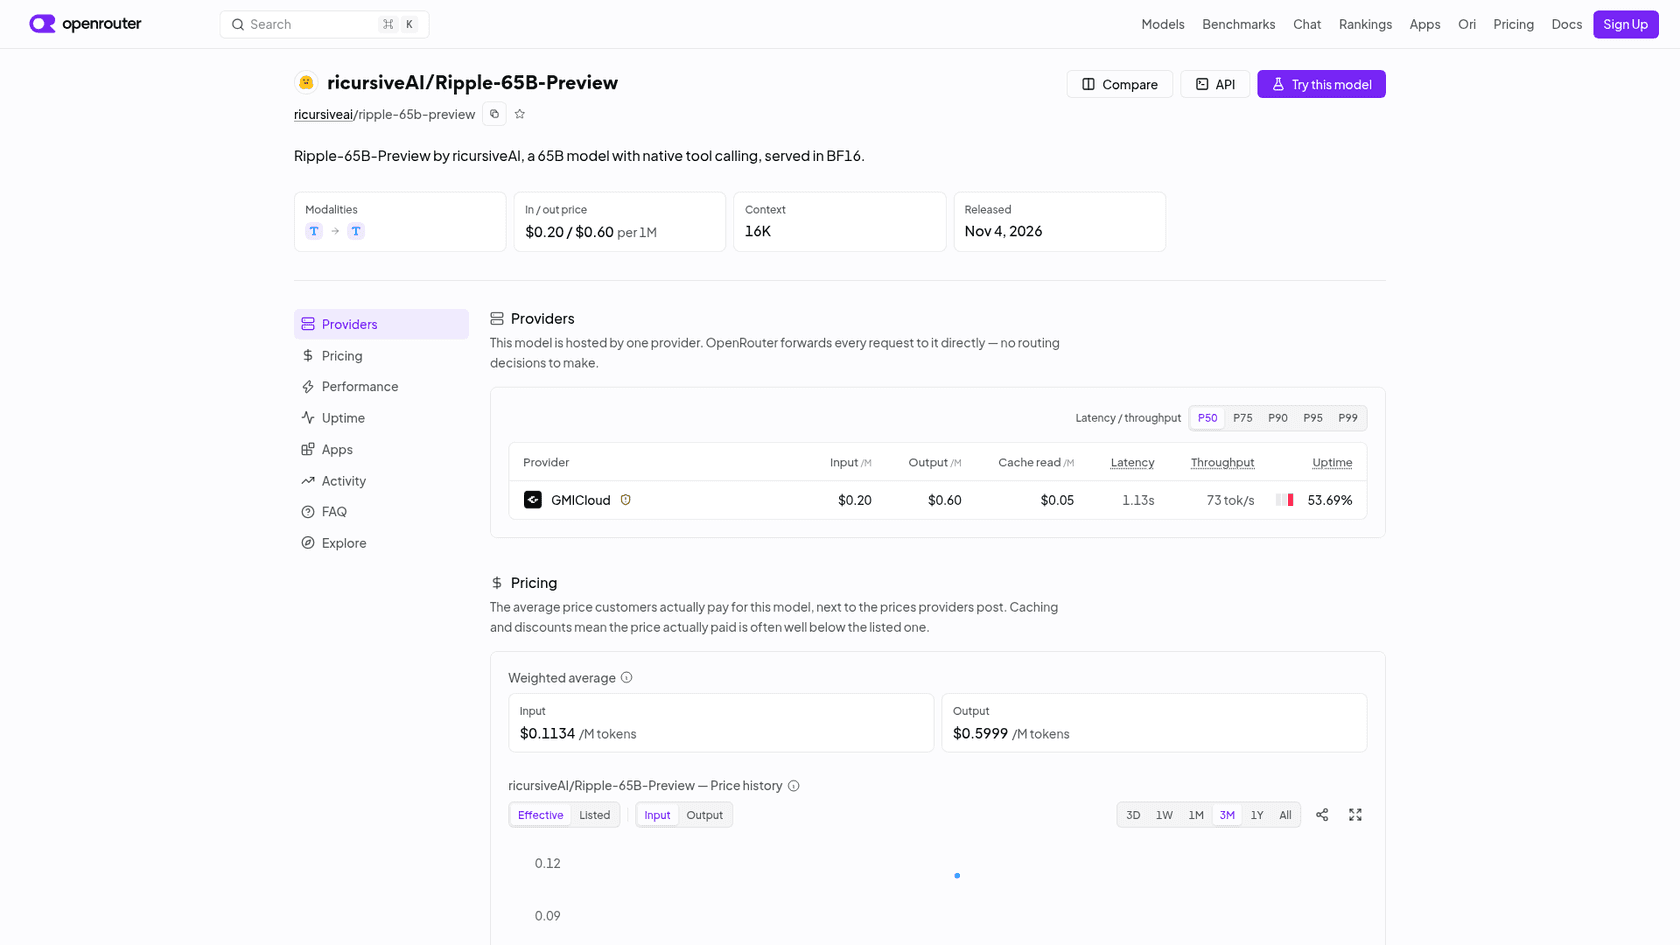
La fenêtre de contexte a changé pendant que j'écrivais ceci
Le matin du 5 novembre, l'API des endpoints d'OpenRouter plafonnait Ripple à 16,384 tokens de contexte et 14,745 tokens de sortie. Dans l'après-midi, la même API indiquait 1,048,576 tokens de contexte et 131,072 de sortie, alors que la page du modèle ci-dessus affichait toujours « 16K ». La page de GMI disait 1,000,000 depuis le début. Mon interprétation : la fenêtre plus grande est en cours de déploiement, et la page n'a pas rattrapé. Avant de budgéter un agent qui a besoin d'une longue fenêtre de contexte, envoyez un long prompt et vérifiez qu'il n'est pas tronqué.
Où acheter Ripple-65B aujourd'hui ?
Pour l'instant, à un seul endroit avec deux portes d'entrée. OpenRouter transmet chaque requête à GMI Cloud, au même prix, donc le choix est une question de commodité : OpenRouter si vous routez déjà plusieurs modèles avec une seule clé, GMI en direct si vous voulez son endpoint compatible OpenAI sans intermédiaire.
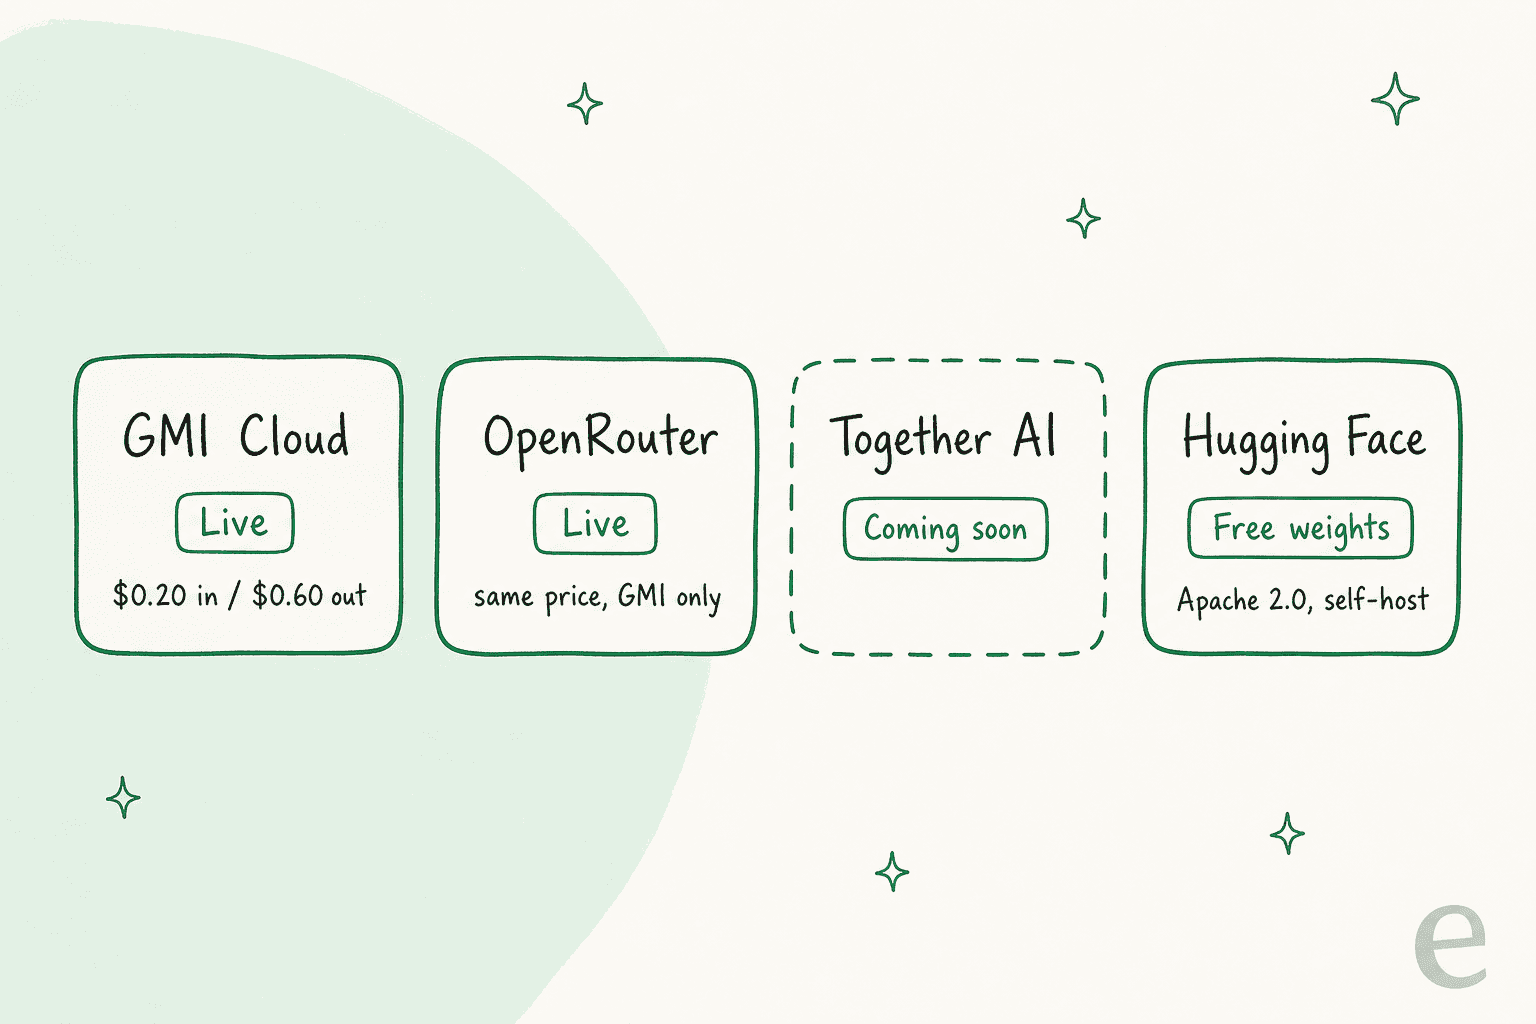
Un seul hébergeur a un coût qui n'apparaît pas dans la grille tarifaire : la capacité. Le taux de disponibilité d'OpenRouter pour l'endpoint GMI se situait entre 51 % et 60 % sur la veille quand je l'ai vérifié le 5 novembre, ce qui est normal pour un modèle ajouté la veille, mais pénible pour tout ce qui est en contact avec les clients. Ricursive a indiqué que Ripple arrivera chez Together AI et Fireworks ; la page de Together indique toujours « bientôt disponible » avec un bouton « Notify me » et sans prix.
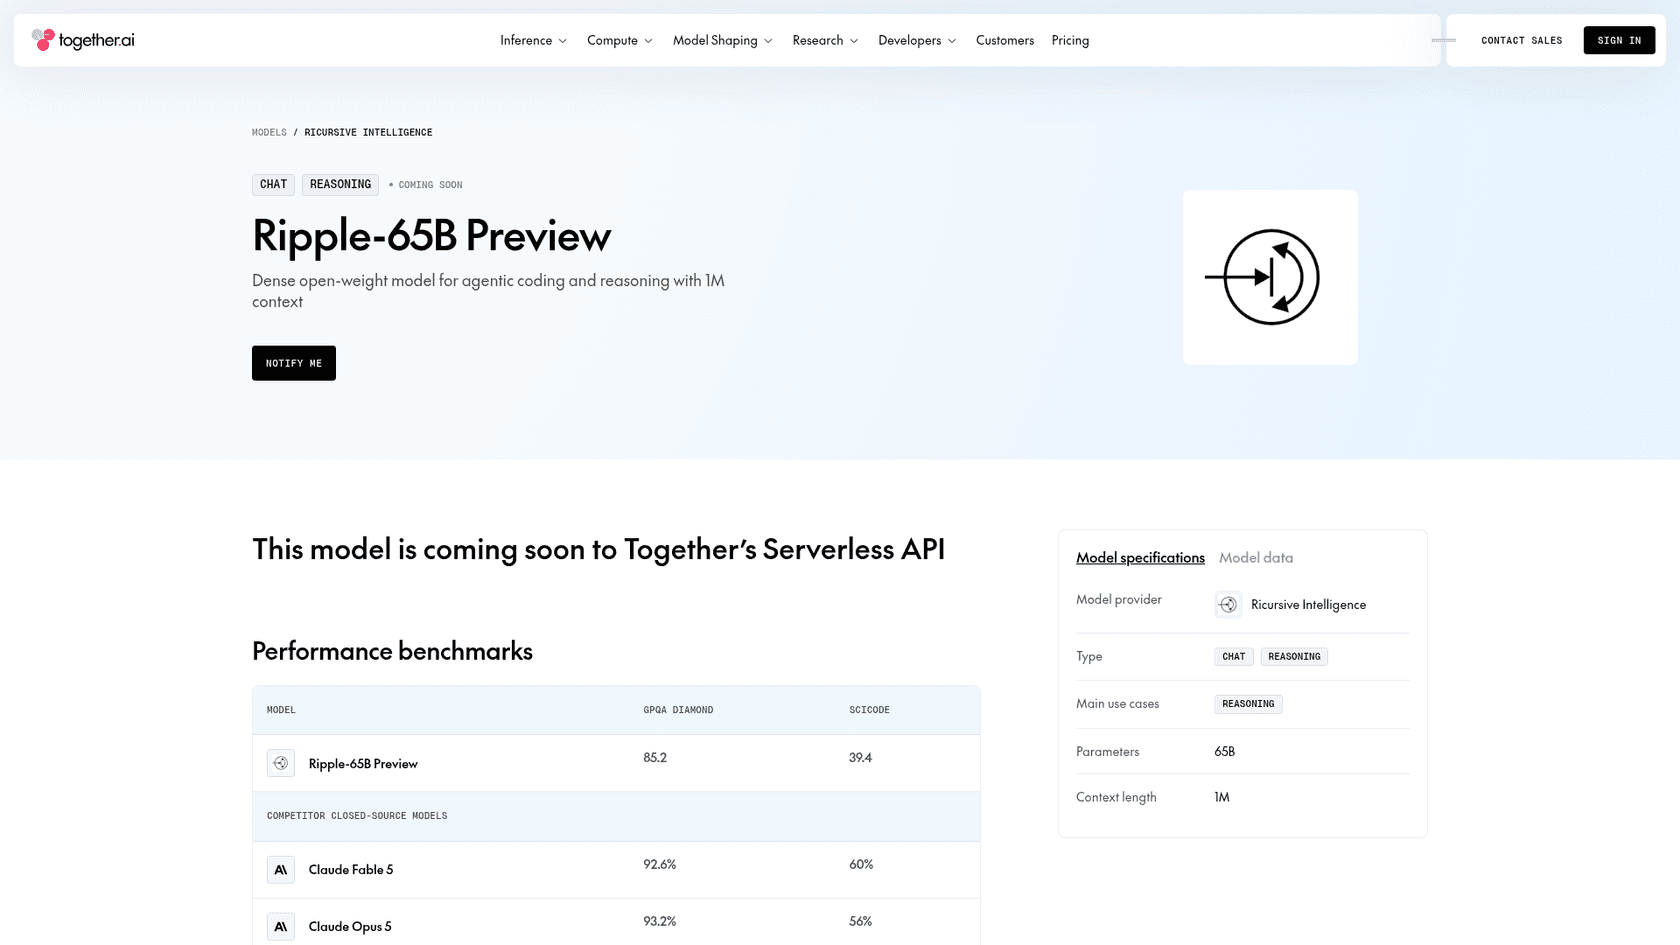
Si vous avez besoin aujourd'hui d'un second fournisseur pour le basculement, vous n'en avez pas. C'est le meilleur argument pour attendre quelques semaines avant de confier du trafic de production à Ripple, et cela n'a rien à voir avec le prix.
Que coûte une tâche d'agent de code sur Ripple-65B ?
Les prix par million ne disent pas grand-chose tant qu'on n'a pas chiffré un vrai travail. Voici donc un acheteur : une session d'agent IA de code qui envoie 1M de tokens d'entrée sur l'ensemble de ses tours, dont 80 % de succès de cache, et écrit 50K tokens de sortie. C'est un profil réaliste pour un agent qui lit un dépôt, lance des tests et corrige quelques fichiers.
Sur Ripple, le calcul est court :
- 200K d'entrée neuve × $0.20 par million = $0.04
- 800K d'entrée en cache × $0.05 par million = $0.04
- 50K de sortie × $0.60 par million = $0.03
- Total : environ $0.11 par tâche, soit $110 pour 1,000 tâches
Sans cache, la même tâche coûte $0.23, plus du double. Voici la même tâche sur des modèles voisins, d'après les tarifs publics d'OpenRouter du 5 novembre 2026 :
| Modèle | Entrée / 1M | Sortie / 1M | Cache / 1M | Coût par tâche | Pour 1,000 tâches |
|---|---|---|---|---|---|
| DeepSeek V4.1 Flash | $0.045 | $0.50 | $0.018 | $0.048 | $48 |
| Ripple-65B Preview | $0.20 | $0.60 | $0.05 | $0.110 | $110 |
| GPT-5.6 Luna | $0.20 | $1.20 | $0.02 | $0.116 | $116 |
| Reflection Beam 501B | $0.25 | $1.00 | $0.05 | $0.140 | $140 |
| Qwen3.8 27B | $0.15 | $1.875 | $0.0375 | $0.154 | $154 |
| Inkling Small | $0.45 | $1.20 | $0.10 | $0.230 | $230 |
| Nemotron 3 Ultra 550B | $0.60 | $2.40 | $0.12 | $0.336 | $336 |
| Muse Spark Open | $1.25 | $4.25 | $0.15 | $0.583 | $583 |
| Claude Sonnet 5.5 | $2.00 | $10.00 | $0.10 | $0.980 | $980 |
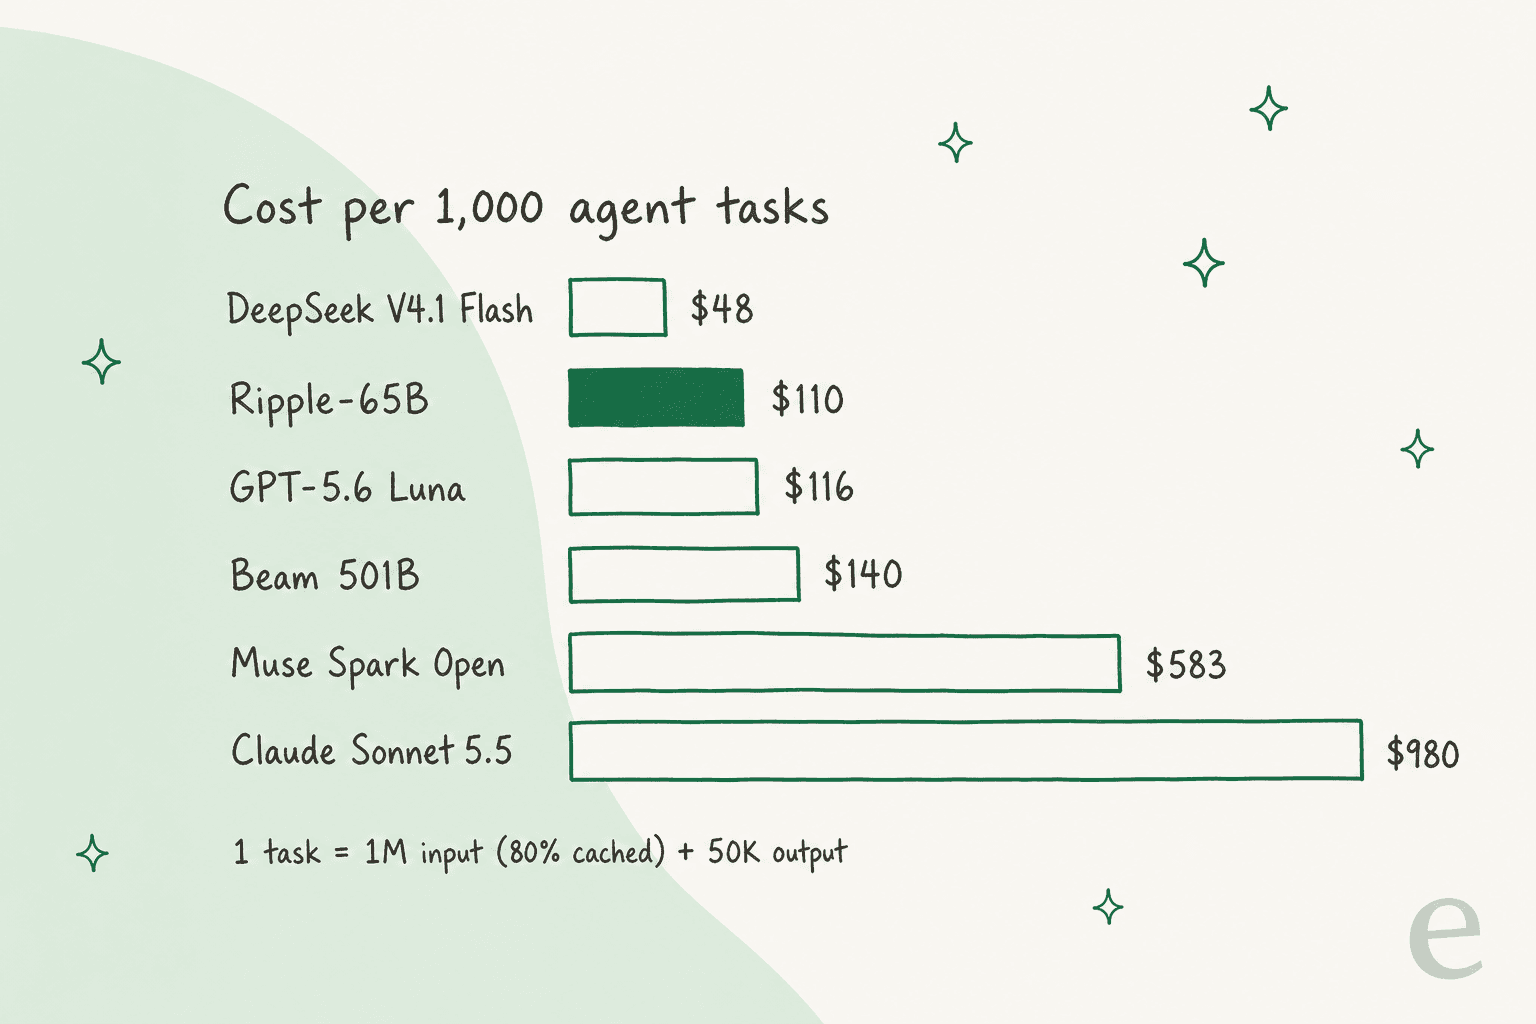
Deux choses ressortent. D'abord, Ripple est le modèle à poids ouverts d'origine américaine le moins cher du tableau, environ 21 % sous Beam, le modèle auquel il est à égalité sur Terminal-Bench 2.1 (80.5 contre 80.1 selon la fiche du modèle). Si vous ne pouvez utiliser que des modèles américains, c'est la comparaison qui compte, et Ripple la gagne sur le prix.
Ensuite, ce n'est pas le modèle le moins cher, tout court. DeepSeek V4.1 Flash fait la même tâche pour moins de la moitié, et GPT-5.6 Luna est à moins d'un cent. Donc « pas cher » n'est une raison de choisir Ripple que si vous avez déjà réduit la liste aux poids ouverts américains. Pour un panorama plus large, mes analyses des tarifs de Kimi K3.1 Pro et des tarifs de DeepSeek V4.1 Flash font le même genre de calcul.
Envie de mettre vos propres chiffres ? Ce simulateur rechiffre un mois de travail d'agent sur chaque modèle. Réglez votre volume de tâches et la répartition des tokens, et il montre où se place Ripple et si un serveur 2x B200 loué battrait l'API.
Quand l'auto-hébergement de Ripple-65B bat-il l'API ?
Plus tard qu'on ne le croit. Apache 2.0 rend l'auto-hébergement légal et gratuit côté licence, et un modèle dense de 65B est assez petit pour tenter. Mais l'API est déjà tarifée au plus juste, donc votre matériel doit rester bien occupé pour être compétitif.
Ricursive publie deux façons de l'exécuter, toutes deux sur la fiche du modèle Hugging Face et son dépôt NVFP4 :
- Centre de données : BF16 sur deux GPU NVIDIA B200 avec SGLang et un modèle brouillon DFlash2, qui selon la fiche atteint "250 tok/s on 2xB200 batch=8 prior to quantization or custom kernels."
- Bureau : une version NVFP4 expérimentale sur un NVIDIA DGX Spark, limitée à une requête à la fois et 128K de contexte.
Voici ce que chacune coûte face à l'API :
| Option | Coût | Ce que cela apporte | Seuil de rentabilité face à l'API |
|---|---|---|---|
| API Ripple | $0.20 / $0.60 par 1M | Paiement au token, un seul hébergeur | n/d |
| 2x B200, louées | GMI Cloud "from $5.00/GPU-hour" = $10/heure, environ $7,300 pour un mois de 730 heures | 1M de contexte, service par lots | ~66,000 tâches par mois, soit ~91 par heure 24 h sur 24 |
| DGX Spark, acheté | $6,950 sur la place de marché NVIDIA (128 GB) | Une requête à la fois, 128K de contexte | ~63,000 tâches sur la durée de vie de la machine |
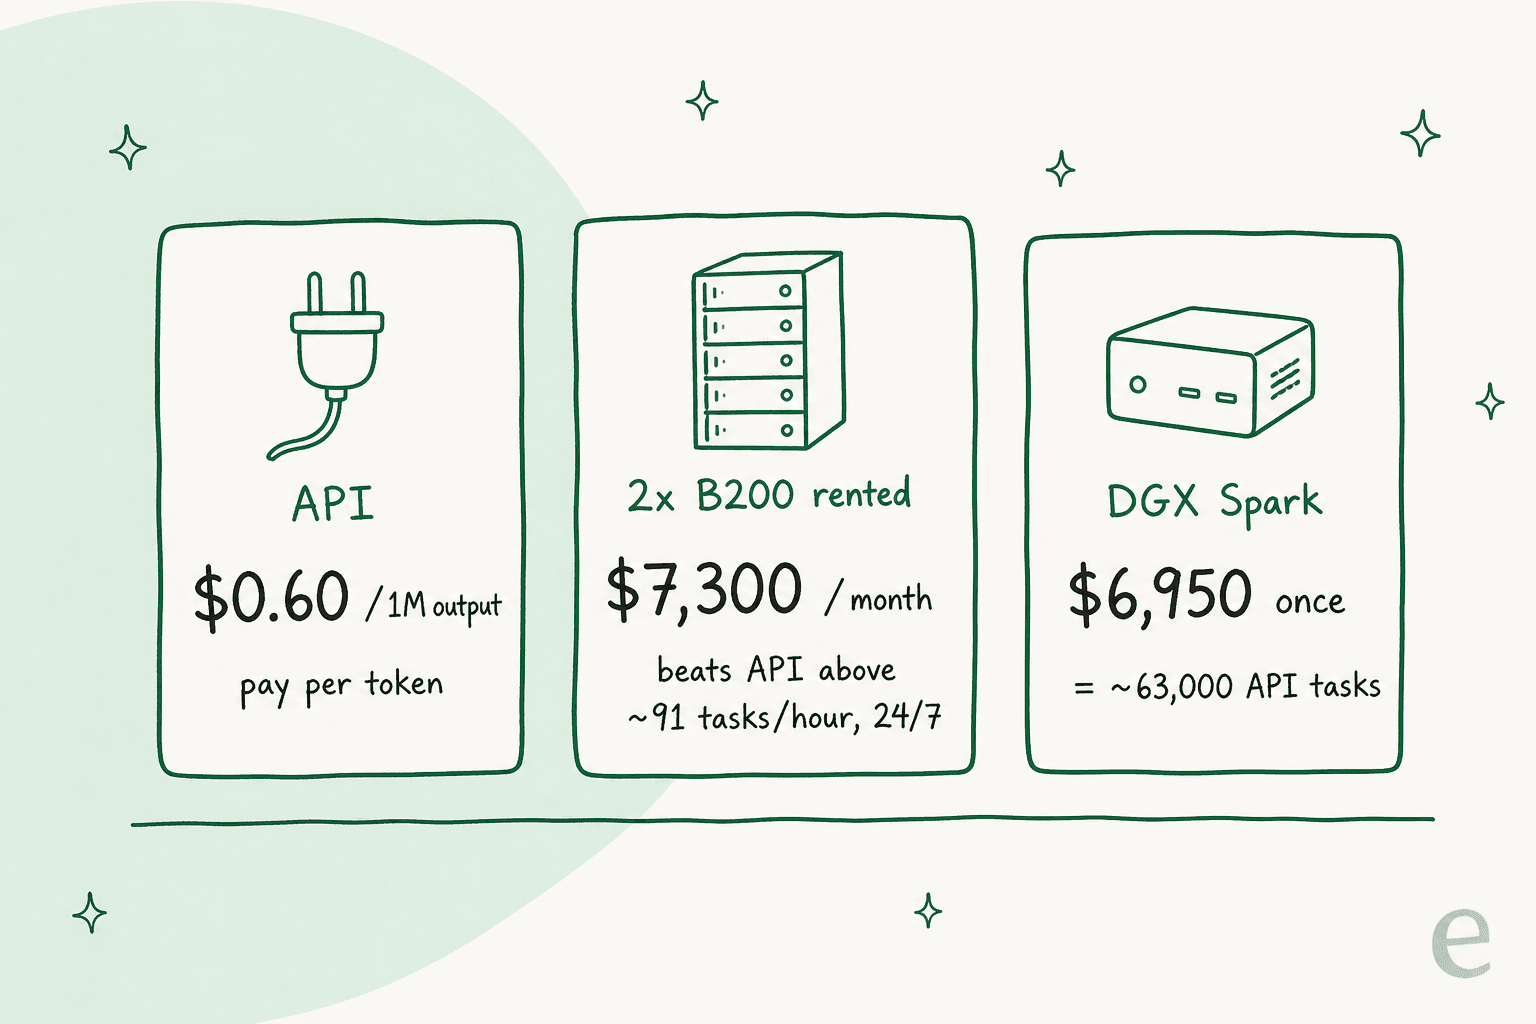
Le calcul des B200 dépend de la façon dont on lit ces 250 tok/s. Si c'est par requête, huit requêtes simultanées donnent environ 2,000 tokens de sortie par seconde, soit 144 de mes tâches d'exemple par heure au mieux, donc il faut que le serveur soit occupé à environ 63 %, chaque heure du mois, rien que pour égaler l'API (et cela avant le temps de prefill, les nuits creuses et les heures d'un ingénieur). Si c'est le total sur les huit, le serveur plafonne vers 18 tâches par heure et n'atteint jamais l'API. Ricursive ne précise pas. Les B200 sont aussi marquées "limited availability" sur la page de GMI, et $5.00 est un prix "from".
Le DGX Spark est un tout autre achat. À $6,950, il équivaut à environ 63,000 tâches d'agent sur l'API, soit 11.6 milliards de tokens de sortie, et il traite une requête à la fois. Personne ne l'achète pour économiser sur Ripple. On l'achète pour que le code et les données ne quittent jamais les locaux, et quelques commentateurs de HN ont défendu exactement cela :
"There are several situations where some of us are explicitly prohibited from using models from companies not under the jurisdiction of the United States. It doesn't mean these models are competitive when looked at from a global view but it is also not an irrelevant differentiation."

D'autres étaient moins sûrs de la vitesse en local. Un modèle dense de 65B lit tous les poids pour chaque token, contrairement à un modèle à mélange d'experts qui n'en active qu'une partie :
"But as is, it's probably hard to become popular amongst hobbyists and local model enthusiasts like Qwen's 27B class models or MOE models because it's a 65B dense model and inference will be prohibitively slow on consumer grade hardware, and seems like the goal/mission of the company behind this model is to automate chip design."
Mon avis : auto-hébergez Ripple quand les règles vous y obligent, ou quand vous pouvez garder deux B200 occupées la plus grande partie de la journée. Pour tous les autres, l'API à $0.60 est le moyen le moins cher de l'exécuter, et l'avis sur Ripple-65B donne le détail des benchmarks pour décider s'il vaut la peine d'être utilisé.
Pourquoi Ripple-65B est-il tarifé si bas ?
En partie à cause de la taille. Avec 65B de paramètres denses en BF16, il tient sur deux B200, alors que des rivaux comme Inkling (975B) et Muse Spark Open (816B) demandent bien plus de mémoire par copie. En partie à cause du positionnement : Ricursive est un nouveau laboratoire qui arrive dans un domaine de modèles chinois moins chers, et son argument est l'efficacité. Il a dit que tout le modèle venait d'un petit budget :
"Ripple was built on a $32 million compute budget, one-tenth the cost of the previous open-weight SOTA on agentic coding. We're grateful to the open-source community, whose tools and research helped make this possible."
C'est un coût d'entraînement, pas un coût de service, et il ne fixe pas le prix de l'API ; c'est GMI Cloud qui le fait. Mais cela explique pourquoi le lancement a misé sur le rapport qualité-prix plutôt que sur les scores bruts. Considérez le prix actuel comme un prix de lancement d'un seul hébergeur. Quand Together AI et Fireworks le listeront, le tarif pourrait bouger dans les deux sens, et un second fournisseur comptera plus pour la fiabilité que pour le coût.
Ripple-65B est-il assez peu cher pour votre file de support ?
Les tokens, oui. Une réponse de support est un travail bien plus petit qu'une session de code, souvent quelques milliers de tokens d'entrée et quelques centaines de sortie, donc 10,000 réponses par mois à 3,000 tokens en entrée et 300 en sortie coûtent moins de $8 sur Ripple. Le prix n'est pas l'obstacle.
L'adéquation, si. Ripple est un modèle de code avec un post-entraînement léger, et ses scores sur les lignes proches du support dans le propre tableau de Ricursive sont moyens : 31.27 sur τ³-bench banque (Beam : 36.1) et 71.67 sur l'usage d'outils MCP Atlas (Muse Spark Open : 89.2), d'après la fiche du modèle. Et le modèle représente les 5 % peu chers d'un agent de support. Le reste, c'est la synchronisation de la base de connaissances, les règles d'escalade, les garde-fous contre les réponses inventées, et un moyen de vérifier les réponses avant que les clients les voient. C'est le vrai coût de toute décision de build vs buy, et il se paie en mois d'ingénierie, pas en tokens.
C'est la partie dont s'occupe eesel. Le coéquipier IA de helpdesk d'eesel rejoint votre helpdesk existant, apprend de votre centre d'aide et de vos anciens tickets, et est testé sur des tickets historiques avant de répondre à qui que ce soit, parce que j'ai vu des bots sûrs d'eux donner de mauvaises réponses sur des files réelles. Timengo, qui vend des logiciels de messagerie sécurisée et de Digital Post au Danemark, fait rédiger à eesel des réponses techniques en danois à partir d'environ 5,300 anciens tickets, en préparant environ 300 tickets Freshdesk par mois. SE Ranking exécute un agent eesel par produit sur Zendesk, et ils ont traité 4,650 conversations en un mois.
Si vous êtes venu à Ripple parce que vous vivez dans un terminal, la CLI d'eesel vous sera familière : un agent de code peut téléverser des connaissances approuvées comme des articles d'aide et des macros exportés, ajuster les instructions du coéquipier et lancer des questions de test avant que rien ne passe en production. La connexion du helpdesk lui-même demande toujours l'approbation d'un administrateur. Il existe un guide sur la gestion des agents IA depuis le terminal.
Ripple-65B vaut-il la peine d'être payé ?
Voici où j'atterris après l'avoir chiffré de toutes les façons possibles :
- Payez l'API si vous testez un modèle de code à poids ouverts d'origine américaine. À environ $0.11 par tâche d'agent avec cache, c'est le moins cher de sa catégorie et 21 % sous Beam.
- Attendez quelques semaines s'il doit porter du trafic de production. Un seul hébergeur, une disponibilité quotidienne de 51 à 60 % et une fenêtre de contexte qui a changé en pleine journée sont des problèmes de semaine de lancement, et un second fournisseur réglera la plupart d'entre eux.
- Auto-hébergez seulement quand des règles gardent les données en interne ou que vous pouvez garder deux B200 occupées environ deux tiers de chaque heure.
- Cherchez ailleurs si le prix fait toute la décision. DeepSeek V4.1 Flash coûte moins de la moitié, et le comparatif des meilleurs assistants de code IA couvre le domaine plus large.
Essayer eesel
Si vous chiffriez un modèle ouvert pour décharger votre équipe de tickets, la facture de tokens n'a jamais été la partie coûteuse. Le coéquipier IA de helpdesk d'eesel se branche en quelques minutes sur Zendesk, Freshdesk, Gorgias et d'autres, apprend de vos anciens tickets et vous montre comment il y aurait répondu avant la mise en production. Les offres démarrent à $299 par mois, avec une offre gratuite pour tester.

Essayez eesel gratuitement.