

En bref
LongCat 2.5 mérite d’être testé si vous cherchez un agent de programmation bon marché qui peut aussi lire des captures d’écran et des vidéos. C’est le modèle à 1.6T paramètres de Meituan, avec prise en charge native des images et des vidéos en entrée, proposé à 0,30 $ en entrée et 1,20 $ en sortie par million de tokens, soit le même tarif que DeepSeek V4.1 Flash en heures pleines. Le hic se trouve dans le propre tableau de benchmarks de Meituan : DeepSeek V4.1 Flash remporte la plupart des tests de programmation au même prix, et les poids de LongCat 2.5 sont toujours annoncés comme "coming soon". Utilisez-le pour des tâches d’agent qui sollicitent beaucoup la vision, et gardez les données clients à l’écart tant que Meituan n’a pas publié de politique de traitement des données. Pour le support, un coéquipier de service d’assistance comme eesel, que vous testez sur d’anciens tickets, est plus sûr.
Qu’est-ce que LongCat 2.5 ?
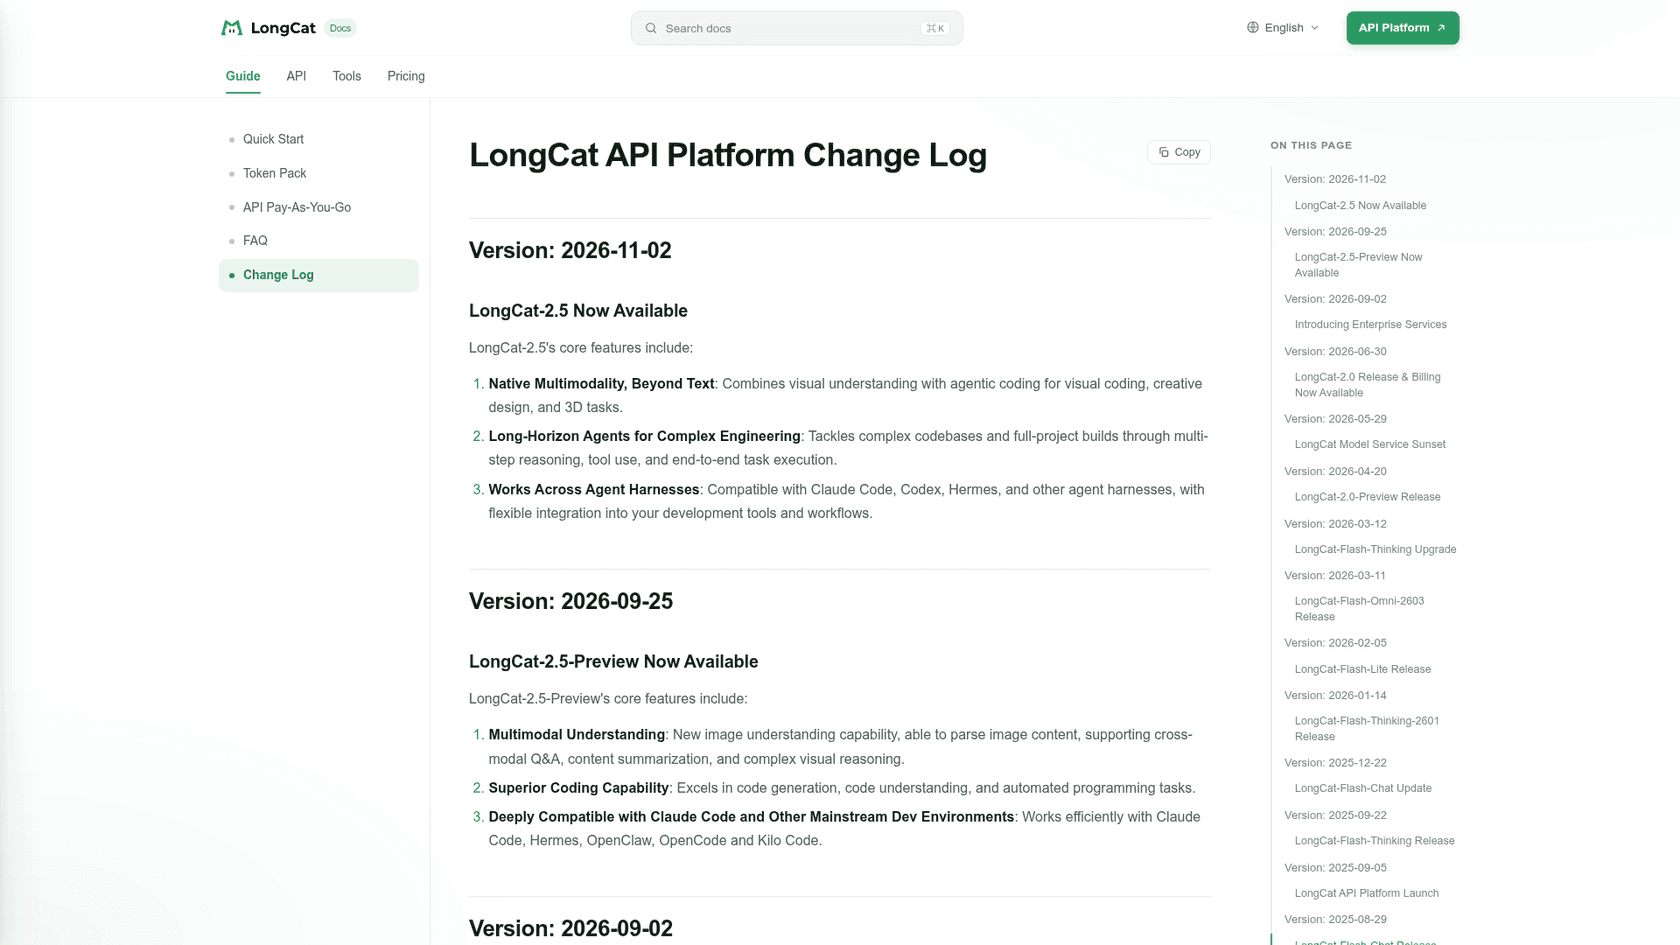
LongCat 2.5 est le dernier modèle de l’équipe LongCat de Meituan. Il est devenu généralement disponible sur la LongCat API Platform le 2 novembre 2026, cinq semaines après l’arrivée d’une version préliminaire le 25 septembre. Le journal des modifications de Meituan met en avant trois fonctionnalités : "Native Multimodality, Beyond Text", "Long-Horizon Agents for Complex Engineering" et "Works Across Agent Harnesses".
Si vous avez manqué l’épisode précédent : LongCat 2.0 était un modèle de fondation à mélange d’experts de 1.6 billion de paramètres, avec environ 48B paramètres actifs par token, publié sous licence MIT avec ses poids sur Hugging Face. C’était un modèle exclusivement textuel conçu pour la programmation agentique.
Je suis ingénieur logiciel dans l’équipe qui construit les agents IA d’eesel, alors je lis les annonces de modèles avec une question en tête : que faudrait-il que je change pour vraiment faire tourner ce truc ? Cet article s’appuie sur le blog technique de LongCat 2.5 de Meituan, la documentation et le journal des modifications de la plateforme, son annonce de lancement sur X, et les retours des développeurs qui ont utilisé la version préliminaire gratuite.
Qu’est-ce qui a changé depuis LongCat 2.0 ?
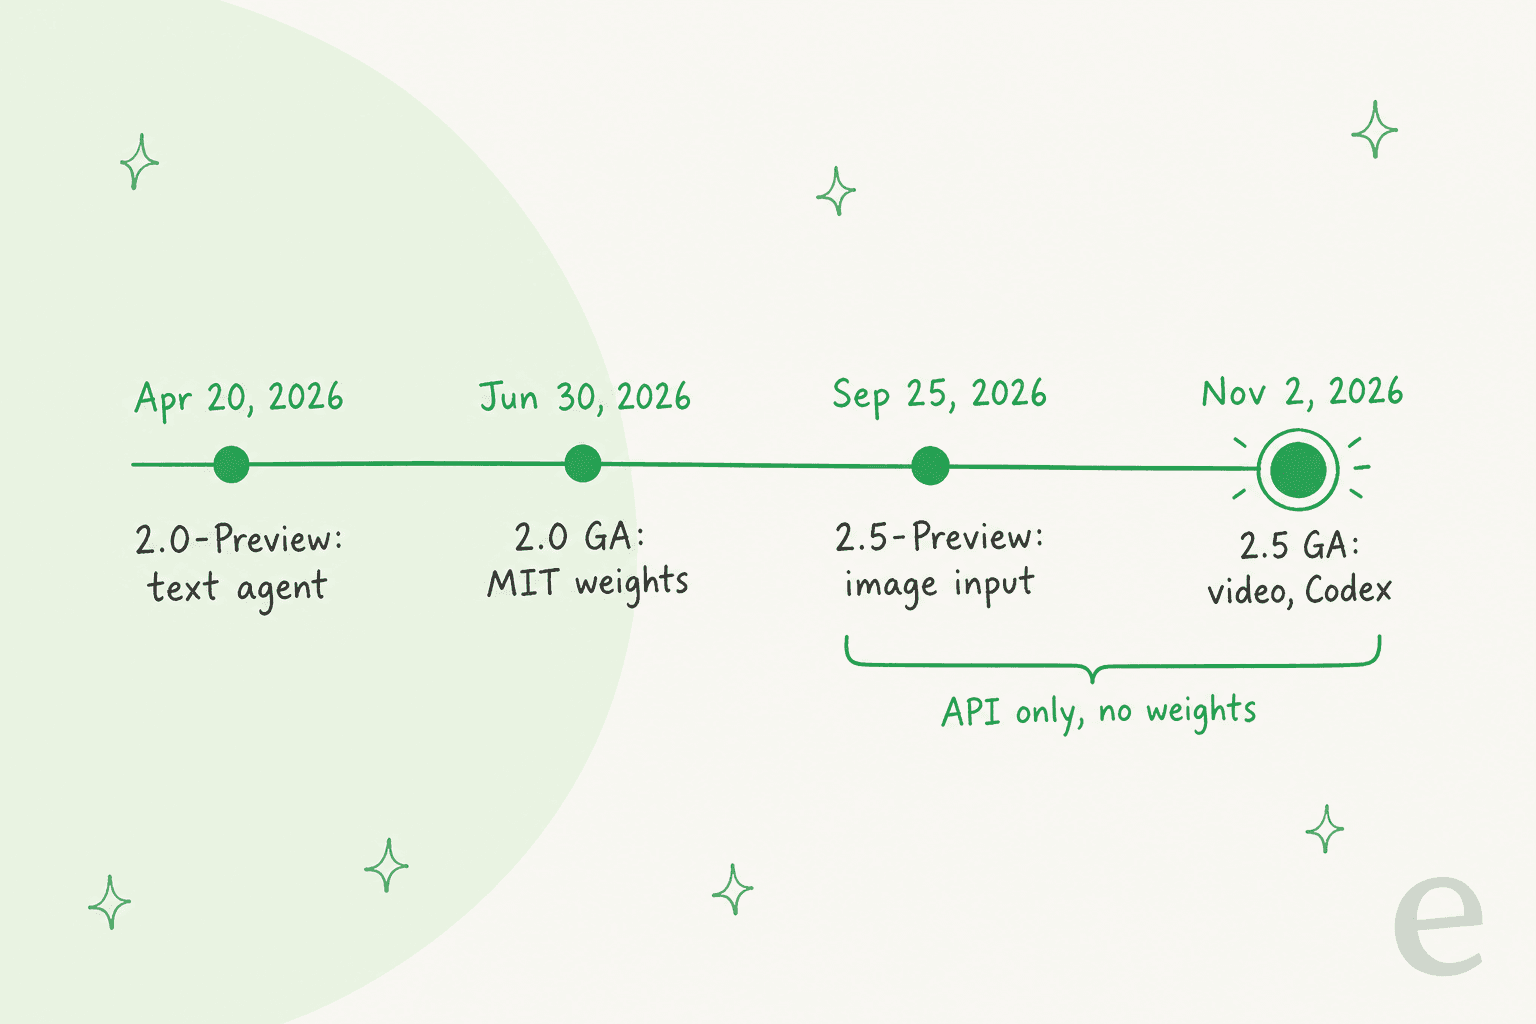
Même corps, nouveaux sens. Le blog technique de Meituan indique que 2.5 possède "1.6 trillion total parameters and approximately 48 billion activated per token" et "builds on LongCat-2.0". Ce n’est donc pas un nouveau modèle plus gros. C’est l’architecture à mélange d’experts de 2.0, enrichie de capacités visuelles et de beaucoup plus d’entraînement aux tâches d’agent. Voici la chronologie.
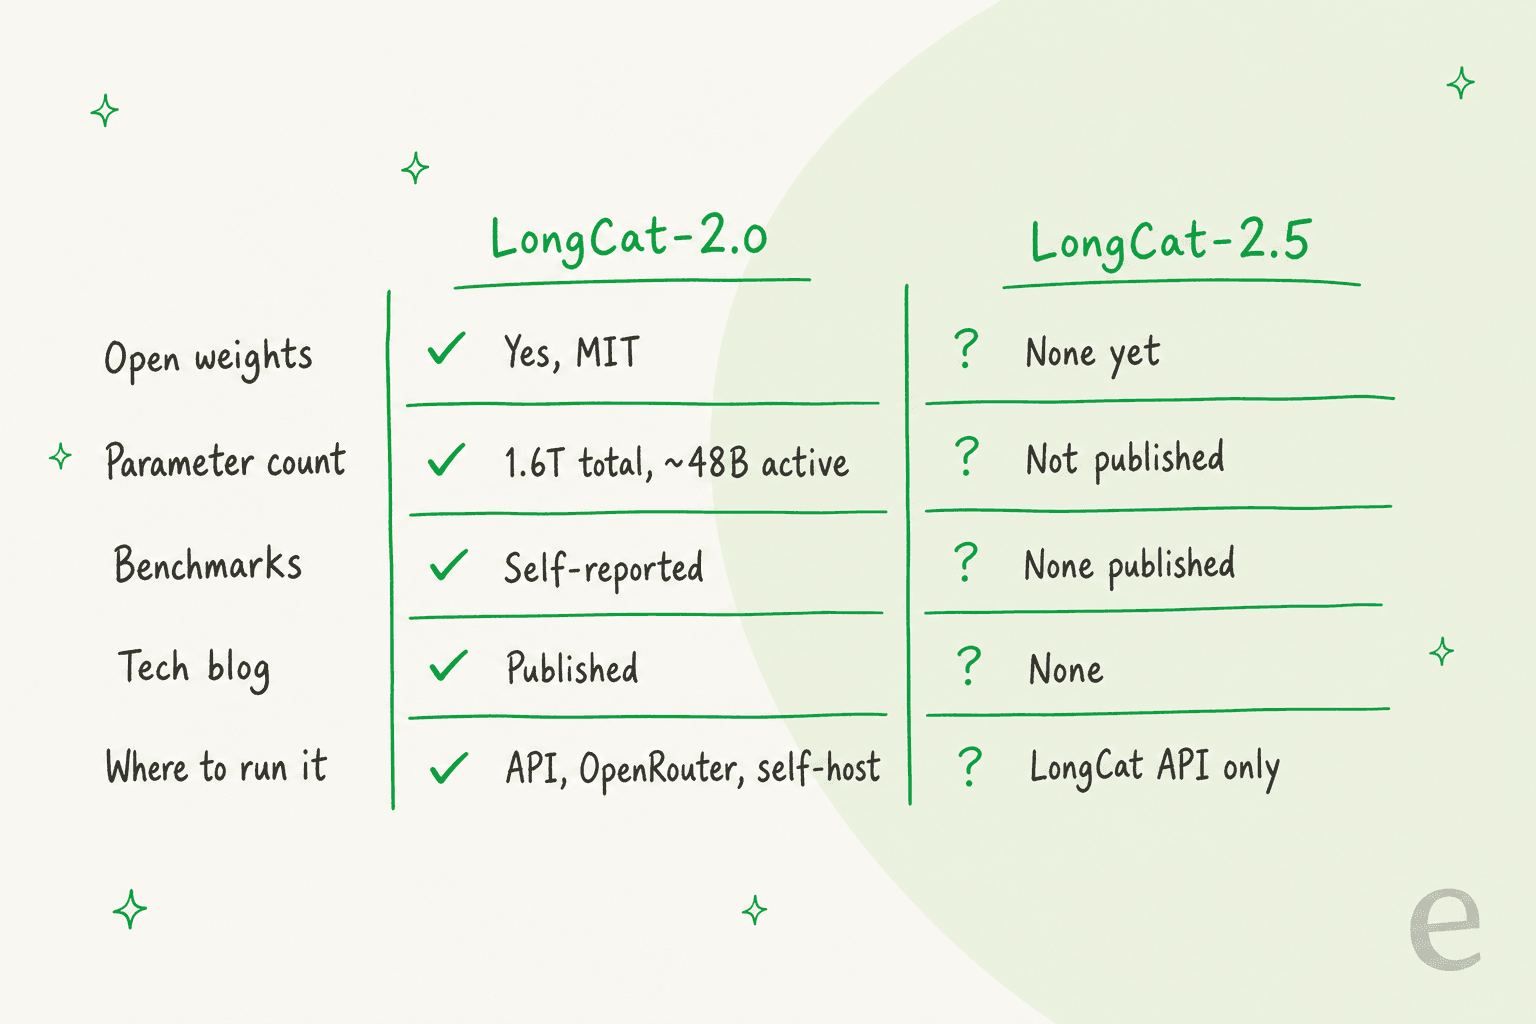
2.0 est passé de la version préliminaire aux poids sous licence MIT en une dizaine de semaines. 2.5 est disponible depuis cinq semaines, versions préliminaire et générale confondues. Son blog technique affiche "GitHub Coming soon" et "HuggingFace Coming soon", et rien n’est encore apparu sur Hugging Face ou GitHub. "Coming soon" est une mention, pas une date, et Meituan n’a donné aucun calendrier.
Images et vidéos en entrée
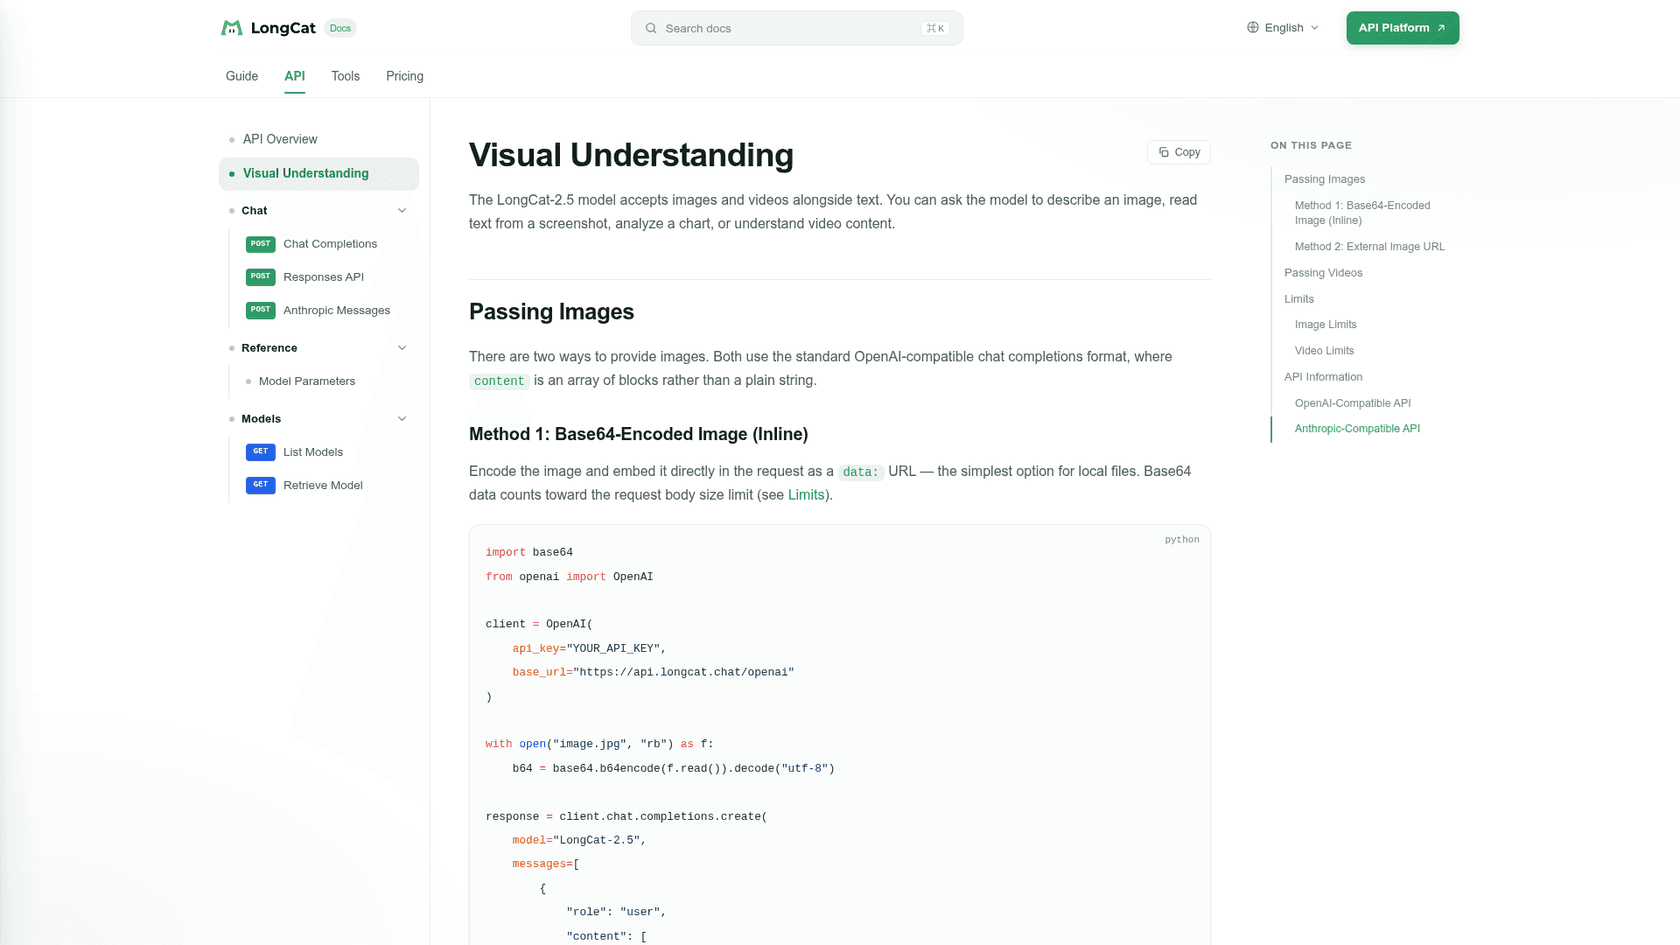
C’est la fonctionnalité phare. La documentation sur la compréhension visuelle indique "The LongCat-2.5 model accepts images and videos alongside text", et les limites sont généreuses :
| Entrée | Formats | Taille limite | Par requête | Mode d’envoi |
|---|---|---|---|---|
| Images | PNG, JPG, JPEG, WebP, GIF | 10 MB chacune | Jusqu’à 50 | URL de données Base64 ou URL publique |
| Vidéo | Non précisés | 100 MB chacune, moins de 3 600 secondes | Jusqu’à 10 | URL publique uniquement |
La version préliminaire annonçait seulement la compréhension des images. La vidéo est arrivée avec la version généralement disponible. La sortie reste exclusivement textuelle : c’est donc un modèle qui lit des captures d’écran et des enregistrements d’écran, pas un modèle qui crée des images. Les fichiers SVG et HEIC ne sont pas pris en charge, et une image dont le rapport largeur/hauteur dépasse 200:1 provoque une erreur. Il n’y a pas non plus de ligne tarifaire distincte pour les images ou les vidéos sur la page des tarifs : vous payez les tokens en lesquels elles sont converties.
Pourquoi c’est important pour la programmation : le journal des modifications le présente comme adapté à "visual coding, creative design, and 3D tasks". Concrètement, vous pouvez coller une capture d’écran d’une mise en page défectueuse et demander à l’agent de corriger le CSS. C’est la même direction qu’a prise DeepSeek V4 Flash Vision, et c’est une vraie lacune que présentait 2.0.
Comment fonctionne la partie visuelle
La plupart des modèles de vision greffent un encodeur d’images sur un modèle textuel. LongCat 2.5 transforme les images en tokens du même type que les mots. Le blog technique indique qu’il "represents visual signals as multi-level discrete tokens", si bien que l’architecture centrale lit un seul flux mêlant tokens de texte et d’image. Un tokenizer fixe permet de calculer les tokens d’image une seule fois et de les mettre en cache hors ligne, ce qui explique pourquoi Meituan a pu retirer entièrement l’encodeur visuel de l’entraînement.
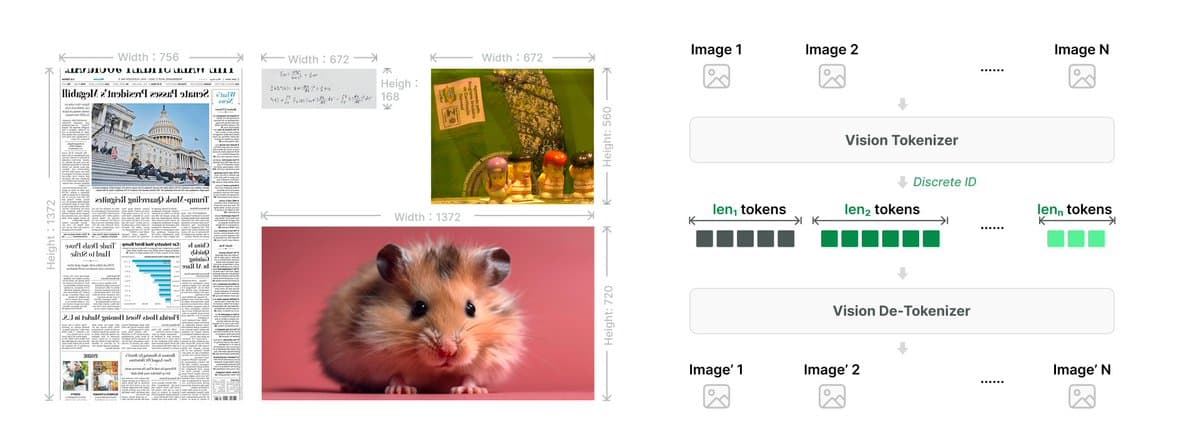
La conséquence pratique, c’est la résolution native : une capture d’écran haute produit davantage de tokens au lieu de devenir une vignette écrasée. Côté agent, Meituan décrit un "large-scale long-horizon reinforcement learning" sur des tâches créées à partir de pull requests GitHub filtrées, avec des pénalités pour "repetitive reasoning and repeated tool calls". Gardez cette dernière formulation en tête pour la section sur la communauté.
Codex rejoint la liste des environnements d’exécution
La version préliminaire citait Claude Code, Hermes, OpenClaw, OpenCode et Kilo Code. La version généralement disponible ajoute Codex, et la documentation présente désormais un nouveau point de terminaison Responses au format OpenAI (POST /openai/v1/responses), nécessaire à Codex. Ce point de terminaison apporte des niveaux d’effort allant de none à xhigh, des appels d’outils parallèles activés par défaut et une sortie avec schéma JSON. La barre latérale des outils répertorie 13 guides de configuration au total, de Cline à Hermes Agent.
Un vrai contexte de 1M, sur le papier
Le marketing de 2.0 annonçait un contexte de 1M alors que sa configuration livrée plafonnait à 256K. Pour 2.5, il n’y a pas de configuration à vérifier, seulement l’API, et la page des paramètres du modèle définit la fenêtre de contexte comme 1 048 576 tokens d’entrée et de sortie cumulés par requête. C’est sur la sortie que la documentation se contredit :
- La page des paramètres du modèle autorise
max_tokensjusqu’à 262 144. - Le guide de démarrage rapide et la FAQ indiquent tous deux une sortie maximale de 128K.
- La propre configuration Claude Code de Meituan fixe la sortie à
131072, soit 128K.
Je prévoirais 128K en sortie et considérerais tout ce qui dépasse comme un bonus à tester.
Que disent les benchmarks de LongCat 2.5 ?
Les chiffres de Meituan montrent un bond important par rapport à 2.0 et un modèle proche des modèles de pointe de 2025-2026 sur les tâches d’agent. Son propre tableau raconte une histoire moins flatteuse à ce niveau de prix. Tous les chiffres ci-dessous proviennent du tableau d’évaluation du blog technique, avec des tests effectués par Meituan en mode raisonnement.
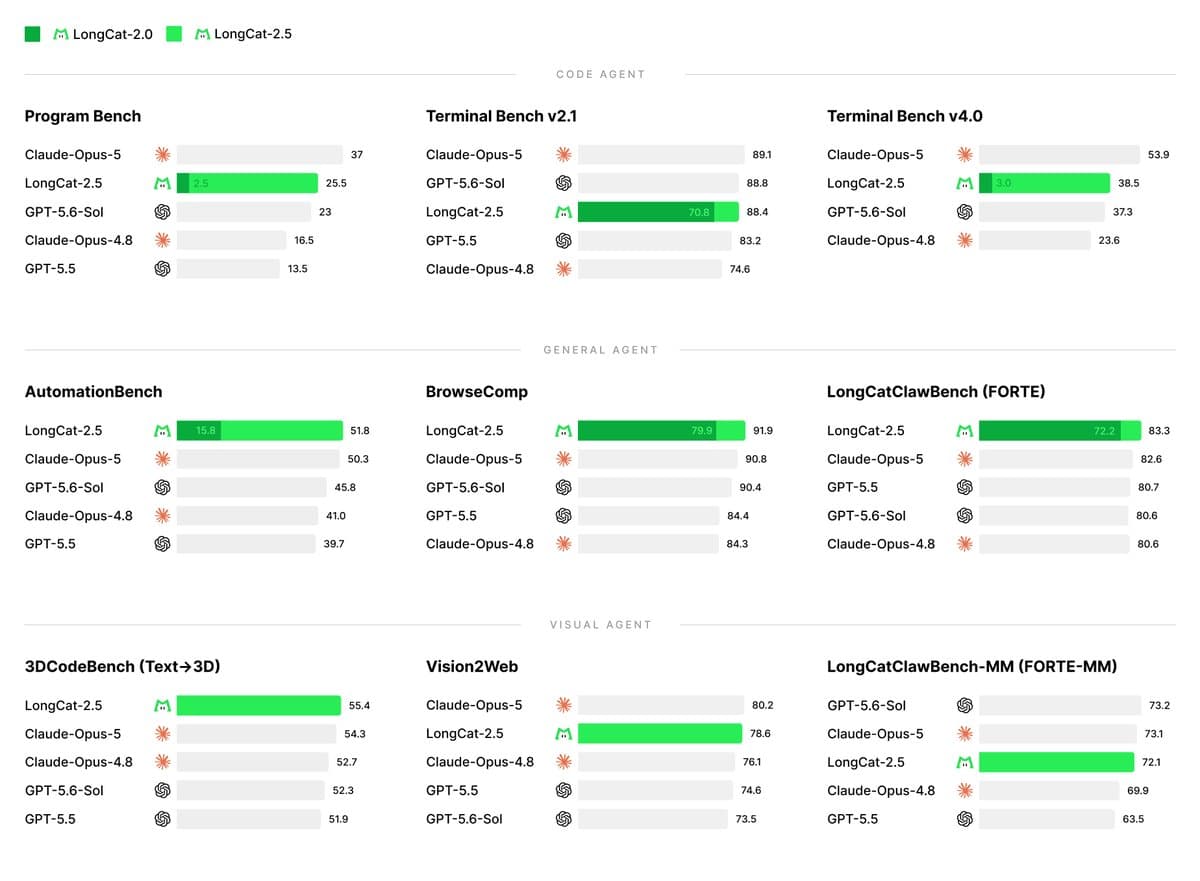
Le bond de 2.0 à 2.5 est réel sur le papier. Terminal Bench 4.0 passe de 3.0 à 38.5, AutomationBench de 15.8 à 51.8, et DeepSWE v1.1 de 9.7 à 64.6. Voilà ce qu’apportent des mois d’entraînement d’agents sur des tâches de longue haleine.
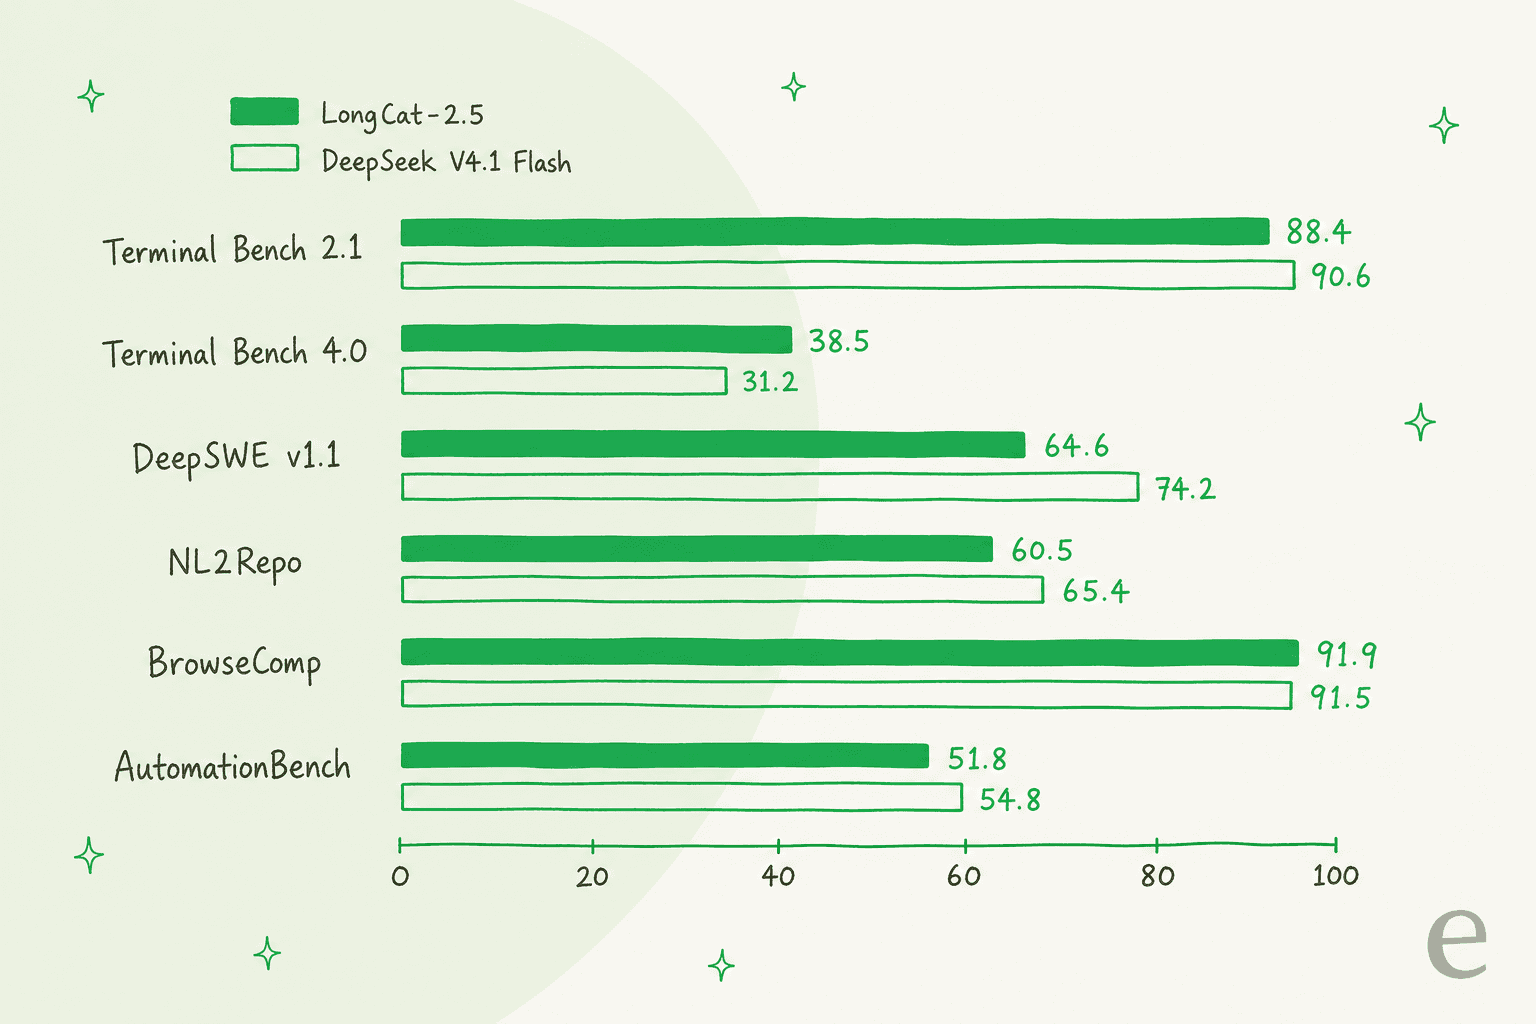
Le hic, c’est le choix des modèles comparés. Les graphiques mis en avant comparent le modèle à GPT-5.5, GPT-5.6-Sol, Claude Opus 4.8 et Claude Opus 5. Pas de Claude Opus 5.5, pas de GPT-6.1 Sol et pas de Kimi K3.1 Pro. Le tableau complet plus bas sur la page ajoute bien GLM-5.3, Kimi K3 et DeepSeek V4.1 Flash, et cette dernière colonne est celle que je lirais en premier, parce que c’est le modèle proposé exactement au même prix.
| Benchmark (tableau de Meituan) | LongCat 2.5 | LongCat 2.0 | DeepSeek V4.1 Flash | Kimi K3 | Claude Opus 5 |
|---|---|---|---|---|---|
| Terminal Bench v2.1 | 88,4 | 70,8 | 90,6 | 88,3 | 89,1 |
| Terminal Bench v4.0 | 38,5 | 3,0 | 31,2 | 12,6 | 53,9 |
| DeepSWE v1.1 | 64,6 | 9,7 | 74,2 | 67,5 | 68,8 |
| NL2Repo | 60,5 | 40,9 | 65,4 | 58,0 | 75,3 |
| BrowseComp | 91,9 | 79,9 | 91,5 | 91,2 | 90,8 |
| MCP Atlas | 83,1 | 61,8 | 84,4 | 84,2 | 85,8 |
| VideoMME | 85,2 | - | - | 90,0 | - |
Source : blog technique de LongCat-2.5. Les scores des autres modèles mêlent des chiffres que Meituan a repris de rapports publics et ses propres tests, dont le blog précise qu’ils "are indicative only".
Pour le dire simplement : sur les propres tests de programmation de Meituan, DeepSeek V4.1 Flash gagne plus souvent qu’il ne perd. LongCat 2.5 mène sur Terminal Bench 4.0, Program Bench, les questions-réponses sur les bases de code de SWE Atlas et BrowseComp, et c’est celui des deux qui dispose de scores vidéo publiés. Sur les tâches de programmation de longue haleine au cœur du lancement, le modèle DeepSeek, moins cher en heures creuses, est devant.
Aucun évaluateur indépendant n’a encore rattrapé son retard. Artificial Analysis ne répertorie que LongCat 2.0 et LongCat Flash Lite, et l’API des modèles OpenRouter renvoie un seul modèle Meituan, meituan/longcat-2.0. Un écart utile à examiner : Artificial Analysis a mesuré LongCat 2.0 à 50,2 % sur Terminal-Bench 2.1, alors que le tableau de Meituan attribue à 2.0 un score de 70.8. Les environnements d’exécution diffèrent, mais un écart de 20 points justifie de faire votre propre test plutôt que de vous fier à l’une ou l’autre colonne.
Combien coûte LongCat 2.5 ?
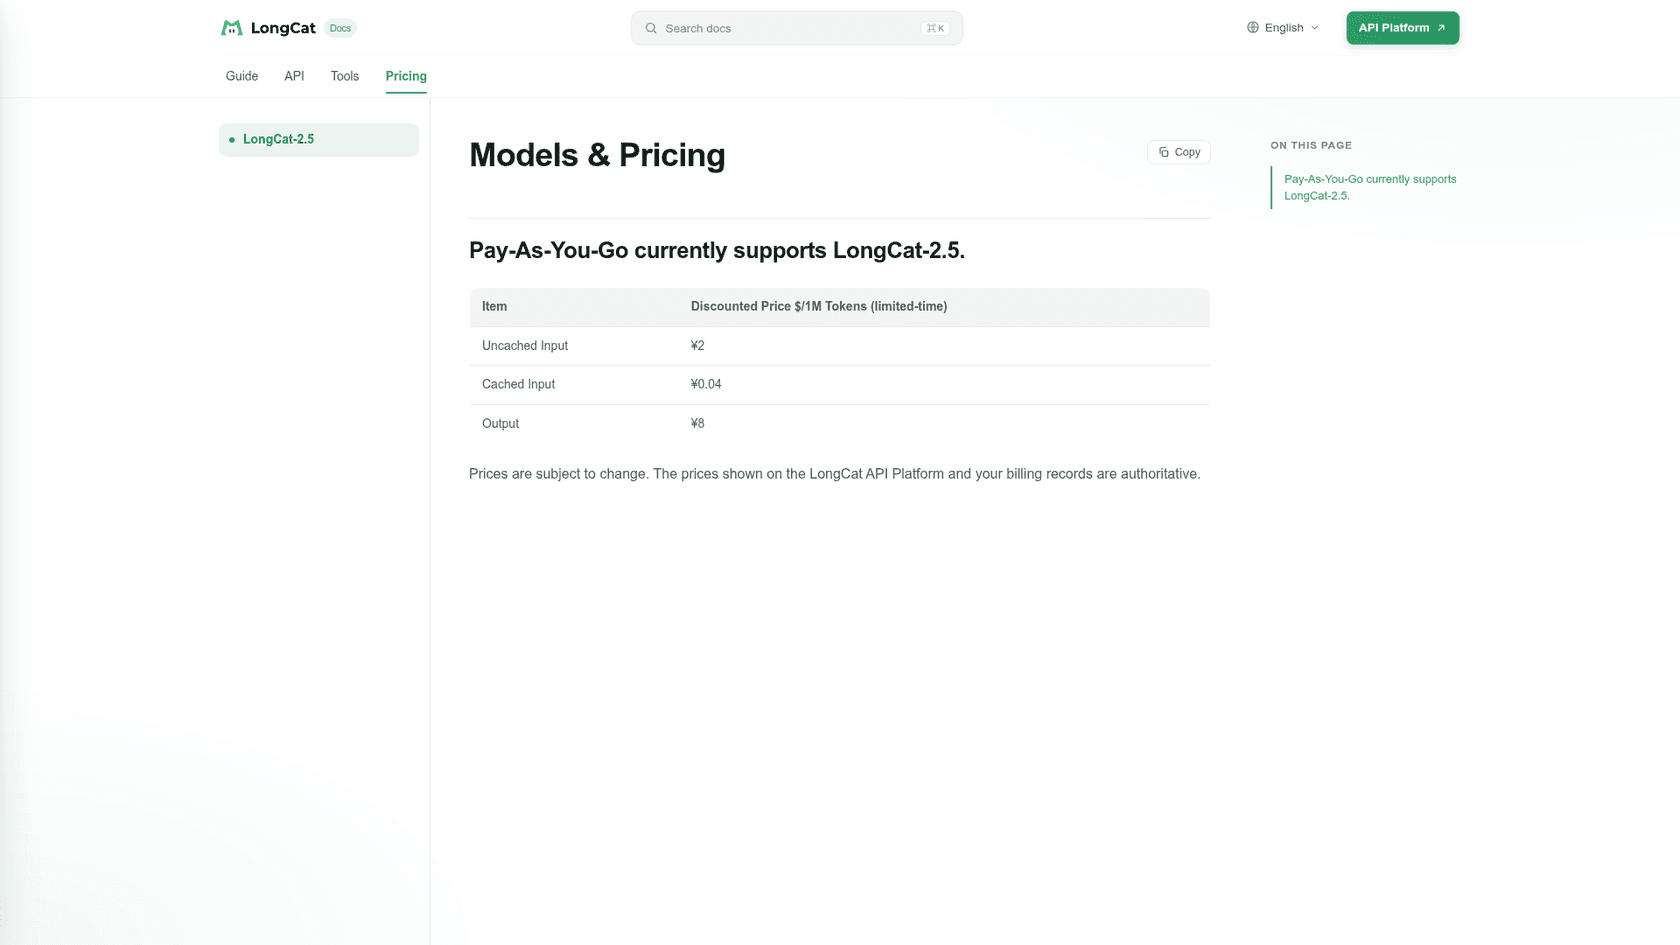
LongCat 2.5 coûte 0,30 $ par million de tokens d’entrée et 1,20 $ par million de tokens de sortie, avec l’entrée en cache à 0,006 $. Chaque chiffre de la page porte la mention "Discounted Price (limited-time)".
| Élément | USD par 1M tokens | CNY par 1M tokens |
|---|---|---|
| Entrée hors cache | 0,30 $ | ¥2 |
| Entrée en cache | 0,006 $ | ¥0.04 |
| Sortie | 1,20 $ | ¥8 |
| Supplément lié à la longueur du contexte | Aucun | Aucun |
| Supplément pour les images ou vidéos | Aucun indiqué | Aucun indiqué |
Source : tarifs de LongCat-2.5 et API Pay-As-You-Go.
Deux choses ressortent. L’entrée en cache coûte 2 % du prix hors cache, ce qui compte beaucoup pour les agents de programmation qui renvoient les mêmes fichiers à chaque tour. Et il n’y a aucun palier tarifaire selon la longueur : une requête de 900K tokens coûte donc le même prix par token qu’une requête de 9K.
Voici l’exemple chiffré de Meituan : une requête avec 600 000 tokens d’entrée hors cache, 400 000 tokens d’entrée en cache et 500 000 tokens de sortie coûte 0,7824 $. Seuls les appels réussis (HTTP 200) sont facturés, le solde prépayé n’expire jamais et il n’y a aucun engagement minimum.
Que se passe-t-il quand la réduction prend fin ?
Personne ne le sait, et c’est le vrai risque tarifaire. La page de 2.5 n’affiche que la colonne des tarifs réduits. Une ancienne page tarifaire de LongCat 2.0, qui n’est plus liée depuis le site, affiche toujours le tarif catalogue de 2.0 à côté de la même réduction : 0,75 $ en entrée, 0,015 $ en cache et 2,95 $ en sortie. Si 2.5 finit par passer au tarif catalogue de 2.0, le coût de sortie sera multiplié par environ 2.5. Meituan n’a pas dit qu’il le ferait, et n’a pas dit non plus qu’il ne le ferait pas.
Comment son prix se compare aux autres
| Modèle | Entrée / 1M | En cache / 1M | Sortie / 1M | Contexte / sortie max. | Page tarifaire du fournisseur |
|---|---|---|---|---|---|
| LongCat 2.5 (promo) | 0,30 $ | 0,006 $ | 1,20 $ | 1M / 128K | LongCat |
| DeepSeek V4.1 Flash (heures pleines) | 0,30 $ | 0,006 $ | 1,20 $ | 1M / 384K | DeepSeek |
| DeepSeek V4.1 Flash (heures creuses) | 0,15 $ | 0,003 $ | 0,60 $ | 1M / 384K | DeepSeek |
| Qwen 3.8 Max | 2,00 $ | 0,25 $ | 6,00 $ | 1M / 131K | QwenCloud |
| Kimi K3.1 Pro | 2,00 $ | 0,20 $ | 10,00 $ | 1M | Kimi |
| Kimi K3 | 3,00 $ | 0,30 $ | 15,00 $ | 1M | Kimi |
La ligne intéressante, c’est DeepSeek. Le tarif promotionnel de LongCat 2.5 est identique au centime près au tarif de DeepSeek V4.1 Flash en heures pleines, et DeepSeek le divise par deux en heures creuses. 2.5 n’est donc pas bon marché d’une manière qui le rendrait unique. Il se situe dans la même tranche de prix que le modèle économique le plus utilisé de la catégorie, qui dispose de scores indépendants, d’une sortie maximale plus longue et d’un guide d’utilisation de l’API publié. L’avantage de LongCat sur lui doit venir de la vidéo en entrée et de la qualité de programmation que vous mesurez vous-même.
Le paiement est devenu plus simple
Les recharges de 2.0 se faisaient uniquement via Alipay et WeChat Pay, ce qui excluait la plupart des équipes occidentales. La page Pay-As-You-Go mentionne désormais les cartes de crédit et de débit ainsi que Google Pay pour le site en USD, et hors de Chine continentale, vous pouvez vous inscrire par e-mail sans vérification d’identité. Les Token Packs (un quota fixe valable 30 jours, vendu lors de ventes flash à 10:00, 16:00, 21:00 et 23:00, heure de Pékin) existent toujours, mais leurs volumes et leurs prix ne sont visibles qu’une fois connecté à la console.
Les entreprises vérifiées bénéficient aussi de remises sur volume pour leurs dépenses Pay-As-You-Go :
| Dépenses mensuelles (site en USD) | Dépenses mensuelles (site en CNY) | Réduction |
|---|---|---|
| 75 $ ou plus | ¥500 ou plus | 10 % de réduction |
| 300 $ ou plus | ¥2 000 ou plus | 20 % de réduction |
| 1 200 $ ou plus | ¥8 000 ou plus | 30 % de réduction |
| 6 000 $ ou plus | ¥40 000 ou plus | 40 % de réduction |
Source : FAQ de LongCat.
Comment faire fonctionner LongCat 2.5 dans Claude Code ou Codex ?
Vous faites pointer l’environnement d’exécution vers le point de terminaison de LongCat au format Anthropic ou OpenAI et définissez le nom du modèle sur LongCat-2.5. Le guide Claude Code place cette configuration dans ~/.claude/settings.json :
{
  "env": {
    "ANTHROPIC_AUTH_TOKEN": "your_longcat_api_key",
    "ANTHROPIC_BASE_URL": "https://api.longcat.chat/anthropic",
    "ANTHROPIC_MODEL": "LongCat-2.5",
    "ANTHROPIC_SMALL_FAST_MODEL": "LongCat-2.5",
    "ANTHROPIC_DEFAULT_SONNET_MODEL": "LongCat-2.5",
    "ANTHROPIC_DEFAULT_OPUS_MODEL": "LongCat-2.5",
    "CLAUDE_CODE_MAX_OUTPUT_TOKENS": "131072",
    "CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC": 1
  }
}
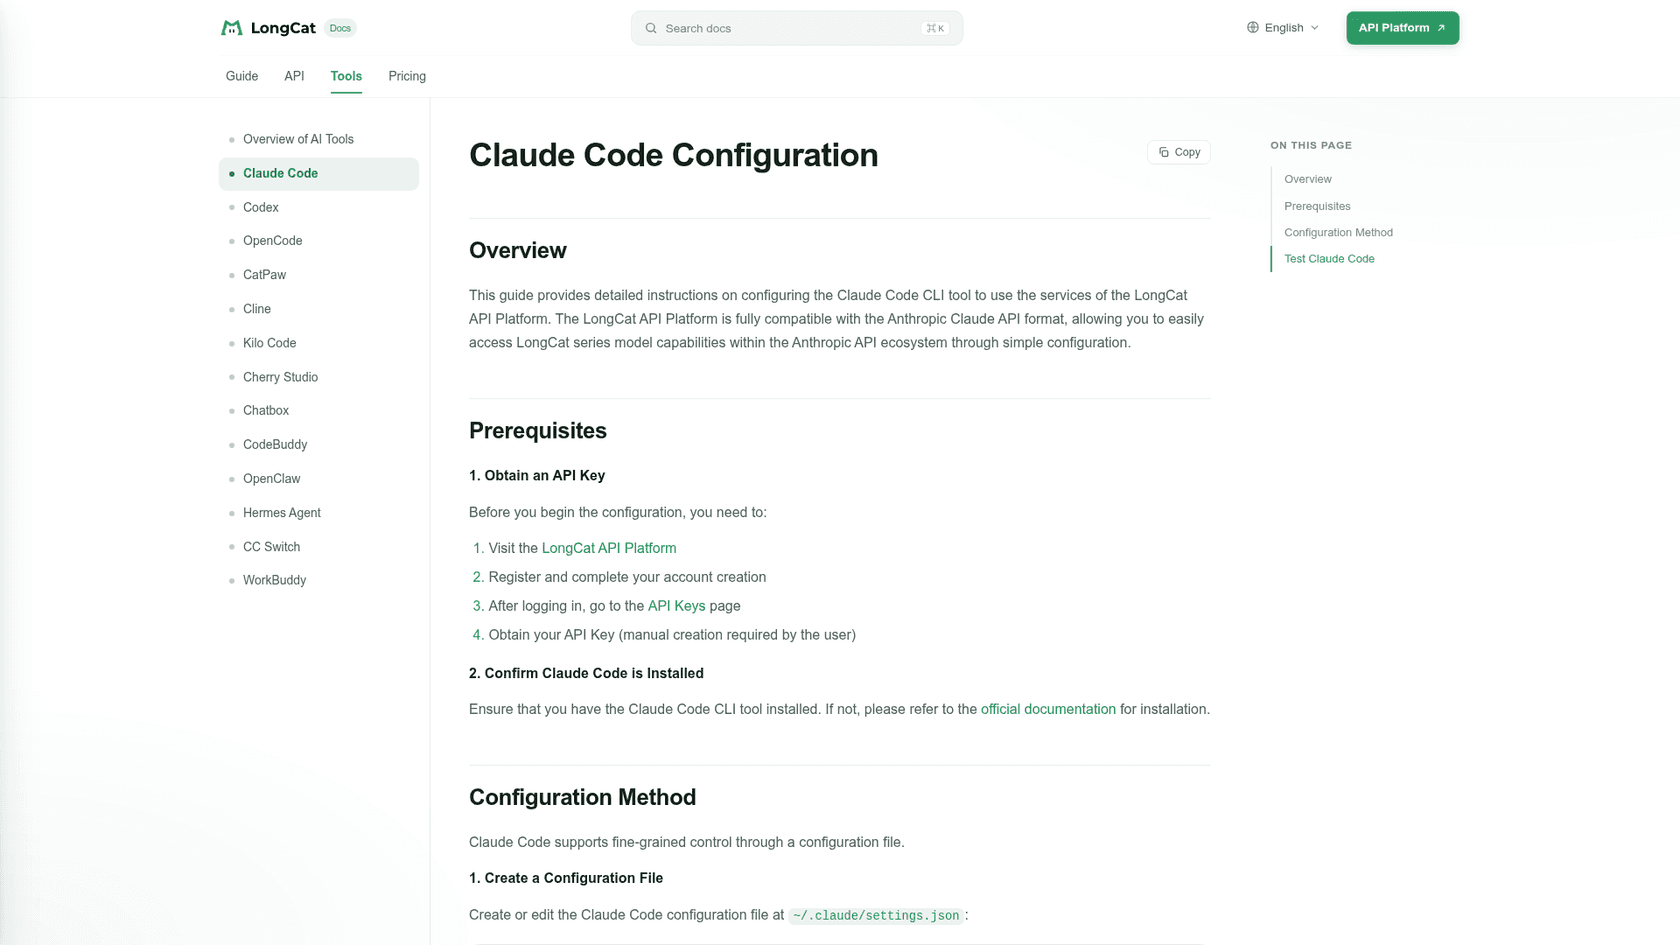
Remarquez que chaque emplacement de modèle pointe vers le même modèle, y compris celui « petit et rapide » que Claude Code utilise normalement pour les appels peu coûteux en arrière-plan. C’est acceptable à 1,20 $ en sortie, mais cela signifie que vous perdez la différenciation de vitesse qu’apporterait un vrai petit modèle.
Pour Codex, vous définissez model = "LongCat-2.5", model_reasoning_effort = "high", l’URL de base https://api.longcat.chat/openai/v1 et wire_api = "responses" dans ~/.codex/config.toml, avec la clé dans ~/.codex/auth.json.
Trois particularités que je voudrais connaître avant la première exécution :
- La température est fixe. Elle est de 1.0 avec le raisonnement activé et de 0.7 sans raisonnement, et les autres valeurs sont remplacées silencieusement plutôt que rejetées (paramètres du modèle). Si votre environnement d’évaluation fait varier la température, il ne fait pas ce que vous pensez.
- Les limites de débit ne sont pas publiées. Les limites s’appliquent par clé API et renvoient une erreur 429 avec
retry_after: 60, mais aucun chiffre de requêtes par minute ou de tokens par minute n’apparaît dans la présentation de l’API. - Les anciens identifiants de modèle peuvent disparaître. LongCat 2.0 et 2.5-Preview ont disparu de tous les tableaux de modèles pris en charge sans avis de retrait daté. Si vous avez fixé votre configuration sur
LongCat-2.0, testez-la aujourd’hui.
Si vous voulez une vue d’ensemble des agents de programmation en terminal avant d’en choisir un, le comparatif des CLI de programmation agentique les compare côte à côte.
Que disent les développeurs de LongCat 2.5 ?
La version préliminaire a été accessible gratuitement dans OpenCode pendant deux semaines, il y a donc plus de retours d’expérience que d’habitude pour un modèle sorti la veille. Le thème qui revient le plus est celui des boucles sur les tâches longues.
"Longcat is fantastic until it get stuck in loops. I think around 200k tokens of context it loses it. I have been compacting and continuing."

Cela concorde avec l’ajout par Meituan de pénalités pour "repetitive reasoning and repeated tool calls" pendant l’entraînement. Vérifier si la version généralement disponible a corrigé cela serait mon premier test. Pour nuancer, les personnes qui l’ont cantonné à un rôle précis l’ont apprécié :
"Longcat is ok as cheap vision agent, tiny tasks, commit. But definitely not as planner, creative writing."
Un développeur a lui-même soumis la version préliminaire gratuite à Terminal-Bench 2.1 et obtenu 48,7 % pass@1, avec la meilleure efficacité en tokens des quatre modèles testés, à environ 0.54M tokens par essai (r/opencode). Il s’agit d’une version préliminaire, d’un environnement d’exécution différent et d’une configuration différente de ceux du score de 88.4 de Meituan : considérez donc cela comme une vérification de cohérence, pas comme un verdict.
Sur Hacker News, le fil du lancement s’est concentré sur le prix et le choix des concurrents :
"Same price as DS4.1F ... On benchmarks they seem comparable. The wild cards are the cache hit rate and speed."

"LongCat-2.5's chart skips Opus 5.5 and every current frontier model. This always happens, and people defend it because they say it's not fair to compare them. But it absolutely is!"
Et un rappel que le chat grand public est moins abouti que l’API : un commentateur de HN a constaté que le lien du chat longcat.ai redirigeait vers une page de connexion sur un autre domaine et que les réponses étaient en mandarin par défaut. Si vous testez uniquement via l’application de chat, vous ne testez pas ce que l’API vous offre.
Faut-il utiliser LongCat 2.5 pour le support client ?
Pas comme modèle derrière une file de tickets de support, du moins pas encore. La raison n’est ni le prix ni la qualité. Ce sont les données. La FAQ de LongCat et les pages de facturation ne disent rien sur la durée de conservation des prompts ni sur l’éventuelle utilisation du trafic API pour l’entraînement. Quand un prompt contient le nom, la commande et l’adresse d’un client, ce silence suffit à trancher : c’est le même obstacle que j’avais signalé dans l’article sur 2.0.
Il y a aussi un point plus général. Un modèle, c’est de l’infrastructure. Pour bien répondre aux tickets, il vous faut aussi les connexions à la base de connaissances, les règles d’escalade, le ton et un moyen de vérifier les réponses avant que les clients les voient. Cela représente beaucoup de choses à construire au-dessus d’une API : c’est le compromis abordé dans développer ou acheter pour le support par IA.
C’est ce manque que comble eesel. eesel est une plateforme de coéquipiers IA, et son coéquipier IA de service d’assistance rejoint votre outil d’assistance existant, apprend à partir de votre centre d’aide et de vos anciens tickets, et répond dans votre file de tickets. Avant sa mise en service, il est testé sur vos tickets historiques pour que vous puissiez lire ce qu’il aurait répondu. J’ai vu des bots au ton assuré donner de mauvaises réponses dans de vraies files de tickets : c’est précisément pour cela que chaque déploiement d’eesel passe par une simulation sur d’anciens tickets avant de toucher à un ticket réel.
SE Ranking illustre bien ce que cela donne en pratique. L’entreprise gère trois produits sur Zendesk avec un agent eesel pour chacun, et en un mois, ces agents ont traité 4 650 conversations, dont 2 100 chats en direct auxquels eesel a répondu en premier, en s’appuyant sur environ 16 800 pages de connaissances. SamCart utilise un agent pour les tickets Freshdesk et un autre pour le chat de son site web, qui répondent à partir de 280 articles du centre d’aide.
Et si vous vous intéressiez à LongCat 2.5 parce que vous aimez travailler depuis Claude Code ou Codex, eesel vous y rejoint. L’eesel CLI (@eesel/cli) vous permet de connecter un outil d’assistance, de lire et de modifier les instructions permanentes de l’agent, d’approuver ou de refuser des actions, et de lire ce que l’agent a fait à chaque exécution, le tout depuis le terminal. Chaque commande produit du JSON et les opérations d’écriture prennent en charge --dry-run, ce qui permet à un agent de programmation de le piloter en toute sécurité. Chaque espace de travail est aussi un serveur MCP que vous pouvez ajouter à Claude Code. L’agent de programmation configure le coéquipier de support ; il n’a pas besoin d’en devenir un.
À qui s’adresse LongCat 2.5 ?
Mon avis, après avoir lu toutes les pages publiées par Meituan :
- Essayez-le si vous utilisez des agents de programmation avec un budget serré et en voulez un capable de lire des captures d’écran ou des enregistrements d’écran. À 0,30 $ / 1,20 $ avec l’entrée en cache à 2 %, un après-midi de tests sur votre propre dépôt coûte quelques dollars. Comparez-le directement à DeepSeek V4.1 Flash au même prix.
- Attendez si vous avez besoin de poids ouverts, d’une licence ou d’auto-hébergement. Meituan annonce les poids comme "coming soon", et même alors, un modèle de 1.6T nécessite un nœud multi-GPU. Aujourd’hui, LongCat 2.0 est le seul des deux que vous pouvez télécharger.
- Passez votre tour pour l’instant si vos prompts contiennent des données clients ou réglementées. Sans politique publiée sur la conservation ou l’entraînement, pas de feu vert, quel que soit le prix.
- Choisissez plutôt DeepSeek si votre travail consiste entièrement en programmation de longue haleine. Au même prix, le propre tableau de Meituan place DeepSeek V4.1 Flash devant sur DeepSWE, NL2Repo et Terminal Bench 2.1, et il est moins cher en heures creuses. Si vous avez besoin de scores mesurés indépendamment, Kimi K3.1 Pro et Qwen 3.8 Max coûtent plus cher, mais ont été testés.
Pour résumer équitablement : LongCat 2.5 est une véritable amélioration par rapport à 2.0, avec une vision intégrée plutôt que greffée, à un prix qui n’a pas bougé. Ce n’est simplement pas le choix évident à ce tarif pour de la programmation pure, et c’est dans son propre tableau de benchmarks que vous pouvez le constater.
Essayez eesel
Si vous vous êtes intéressé à LongCat 2.5 en espérant qu’un modèle bon marché décharge votre équipe de ses tickets, épargnez-vous toute la plomberie technique. Le coéquipier IA de service d’assistance d’eesel se connecte à Zendesk, Freshdesk, Gorgias et aux autres en quelques minutes, apprend à partir de vos anciens tickets et vous montre comment il y aurait répondu avant sa mise en service. Les forfaits commencent à 299 $ par mois, avec une offre gratuite pour tester.

Essayez eesel gratuitement.
Comment LongCat 2.5 se compare-t-il à Kimi K3 et à Qwen 3.8 Max ?