

Résumé (TL;DR)
Nanbeige 4.3 est un modèle ouvert de 33 milliards de paramètres, gratuit sous licence Apache 2.0, qui surpasse Qwen3.8-27B sur 18 des 20 benchmarks publiés par son laboratoire, avec les avances les plus marquées en codage agentique : 65,5 contre 42,5 sur DeepSWE et 23,8 contre 6,3 sur Terminal-Bench 4.0. Il est sorti sur Hugging Face le 24 octobre 2026, et Nanbeige le qualifie d'« enseignant » : le véritable objectif est un modèle Nanbeige4.3-3B distillé qui n'est pas encore disponible.
Le bémol concerne la mémoire. Il s'agit d'un modèle dense classique de style Llama, donc son cache de contexte coûte environ 0,2 Mo par jeton. À 128K de contexte, cela représente environ 28 Go de cache en plus des 21 Go environ de poids 4 bits, ce qui exclut la plupart des GPU grand public.
Et si vous l'envisagez pour du support client, lisez les petits caractères : sur le graphique JobBench de Nanbeige, il a obtenu un score de 21,1 sur les tâches de service client contre 31,6 pour Qwen. Un agent de support dépend entièrement de la configuration de votre helpdesk et non d'un score de codage, c'est pourquoi des équipes comme smava utilisent un coéquipier de helpdesk IA prêt à l'emploi par-dessus des modèles comme celui-ci plutôt que d'en construire un elles-mêmes.
Qu'est-ce que Nanbeige 4.3 ?
Nanbeige 4.3 est la quatrième génération (et quelques) de modèles du Nanbeige LLM Lab, l'équipe d'IA au sein de BOSS Zhipin, la plateforme de recrutement chinoise gérée par Kanzhun Limited. La série compte pour l'instant un modèle public, Nanbeige4.3-33B, ainsi que son modèle de base non ajusté. Les deux ont été mis en ligne le 24 octobre 2026, et le laboratoire a annoncé la sortie sur X le lendemain, où le post a récolté 2 248 j'aime.
Je conçois des intégrations et des API chez eesel, donc un nouveau modèle ouvert suscite toujours chez moi la même première question : que faudrait-il pour réellement faire fonctionner cela derrière un produit concret ? C'est sous cet angle que nous allons l'analyser.
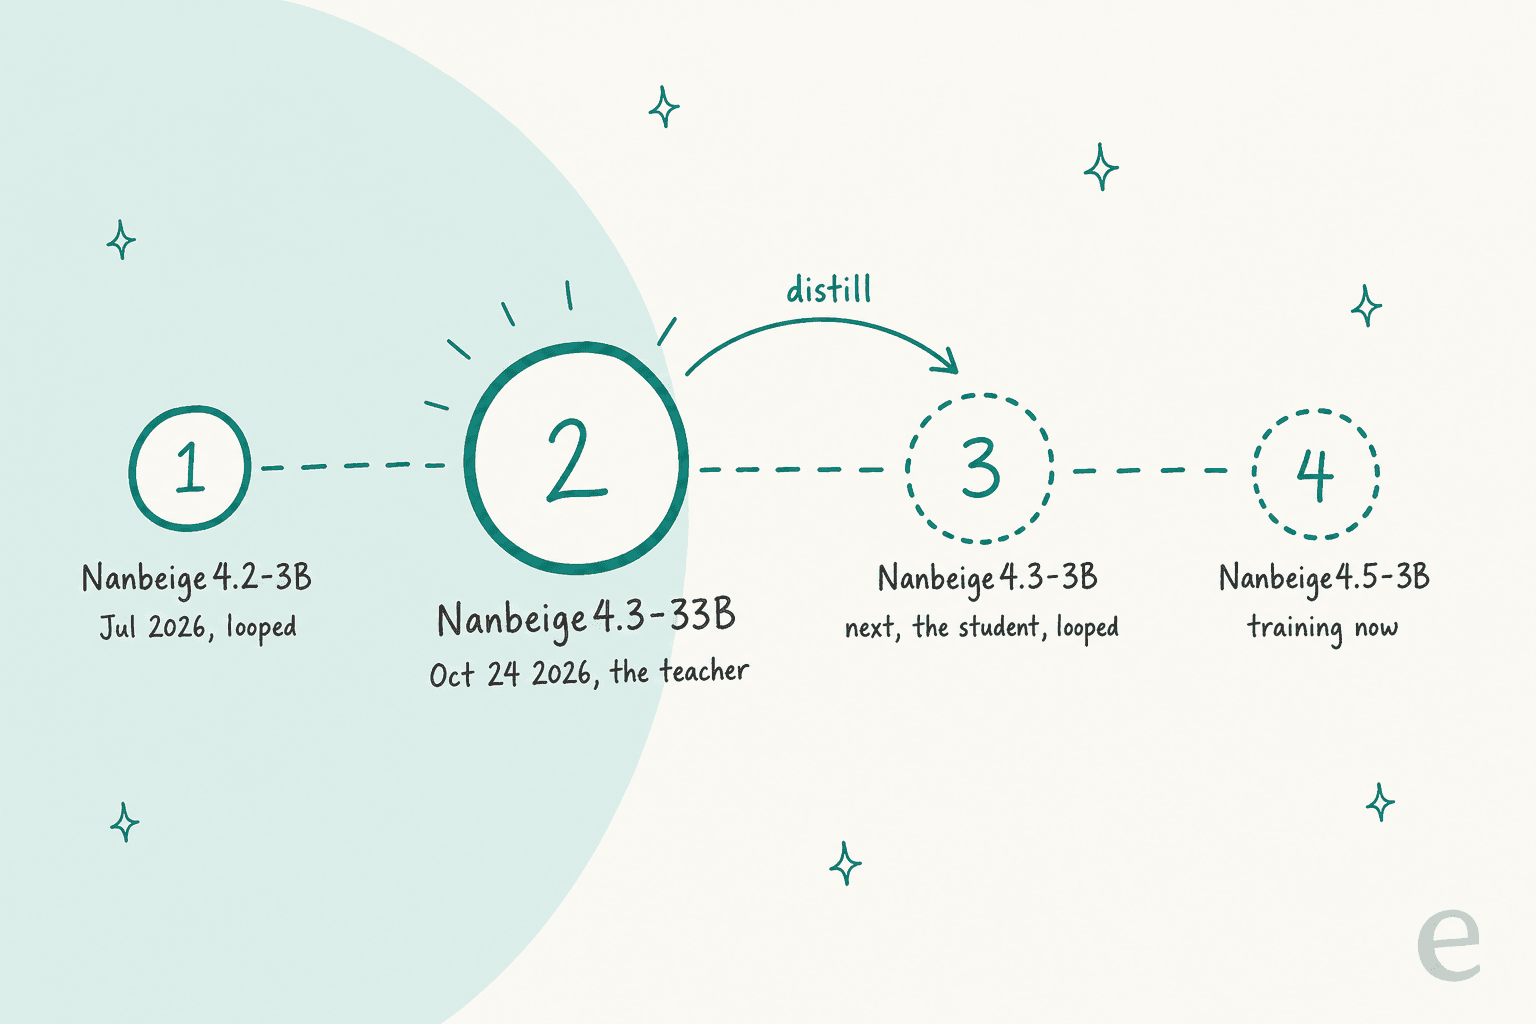
L'aspect le plus intéressant n'est pas sa taille. Nanbeige s'est fait un nom avec les petits modèles de langage : Nanbeige4.2-3B, un « Looped Transformer » de 3B qui réutilise ses couches pour réfléchir davantage par jeton (la même idée qui a attiré l'attention autour de GPT-6 Astra), compte plus de 116 000 téléchargements le mois dernier. Alors pourquoi sortir un 33B ? La fiche du modèle y répond directement : la stratégie consiste à « construire d'abord un agent enseignant à haute capacité », puis à distiller ses compétences dans de petits modèles, ce qui commencera selon le post de lancement « avec le Nanbeige4.3-3B ».
En d'autres termes, le 33B est une étape intermédiaire. Il est utile en soi, mais le modèle qui compte réellement pour Nanbeige est l'étudiant 3B.
Les spécifications en un coup d'œil
Toutes les informations ci-dessous proviennent de la fiche du modèle et du fichier de configuration dans le dépôt.
| Spécification | Nanbeige4.3-33B |
|---|---|
| Paramètres | 33,1 milliards, denses |
| Architecture | LlamaForCausalLM, 52 couches, 56 têtes d'attention, 8 têtes clé-valeur |
| Fenêtre de contexte | 524 288 jetons (512K) |
| Entrée / sortie | Texte uniquement, anglais et chinois |
| Licence | Apache 2.0 |
| Taille des poids | 66,2 Go en BF16 répartis sur 14 fichiers |
| Variantes | Modèle Instruct et modèle Base |
| Mode réflexion | Activé par défaut, commutable avec enable_thinking |
| Appel d'outils | XML recommandé, JSON pris en charge |
| Fonctionne sur | Transformers, vLLM, SGLang |
Une réponse sous le post de lancement a évité un téléchargement inutile à beaucoup de monde :
« 33B dense, texte uniquement sans vision au cas où cela ferait gagner du temps à quelqu'un »
Quelle est la performance de Nanbeige 4.3 sur les benchmarks ?
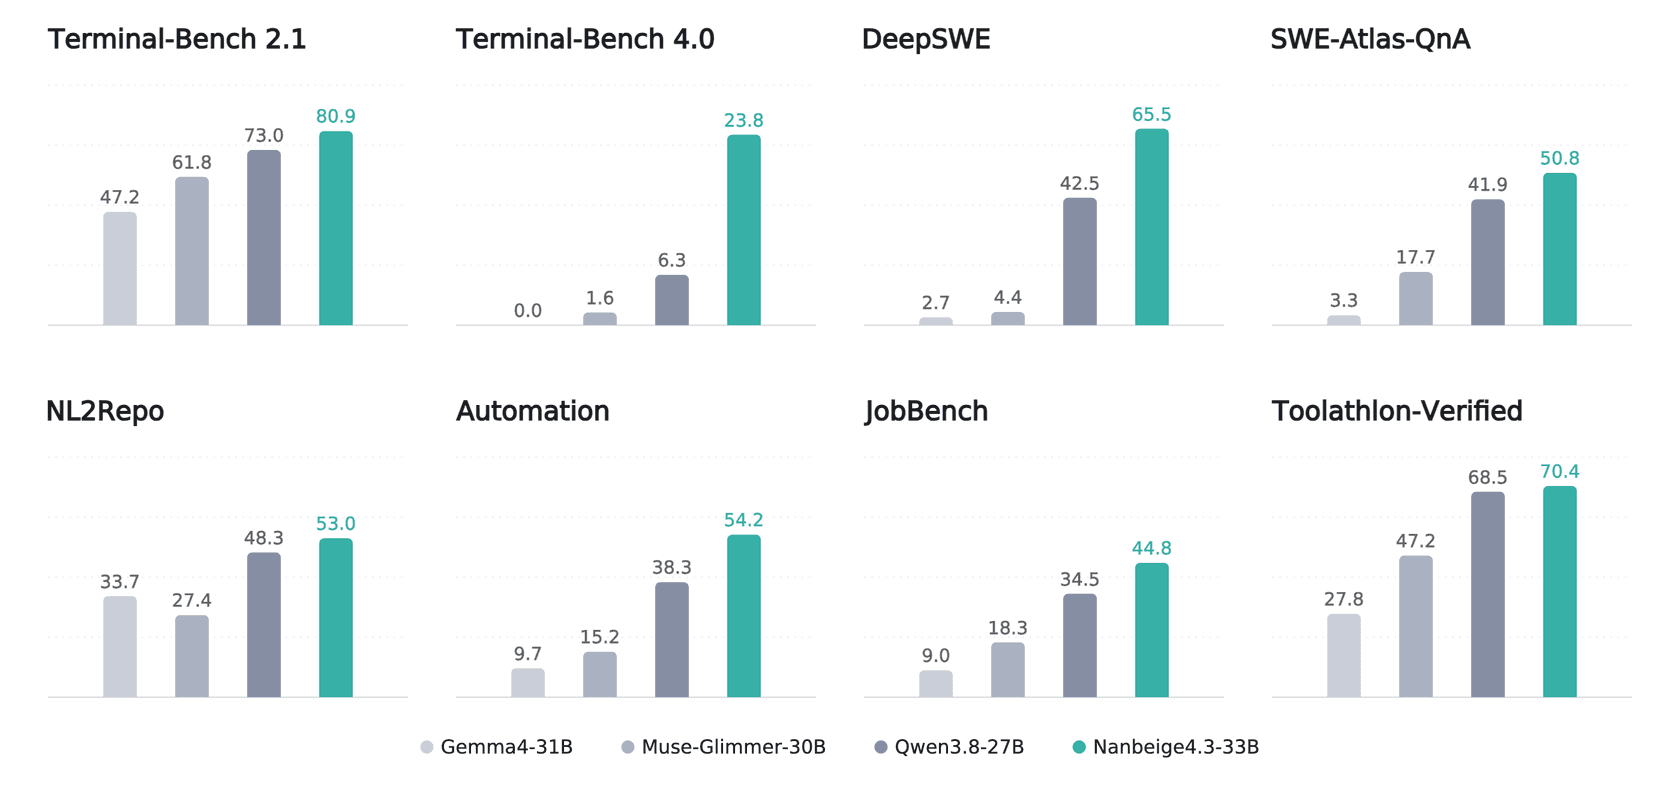
Très bonne, sur le papier. Nanbeige l'a comparé à trois modèles ouverts de taille similaire, tous à leur niveau d'effort de réflexion le plus élevé, et a publié 20 scores. Nanbeige4.3-33B dépasse ses trois rivaux sur 17 d'entre eux et surpasse Qwen3.8-27B, son concurrent le plus proche, sur 18. Voici le tableau complet de la fiche du modèle :
| Benchmark | Nanbeige4.3-33B | Qwen3.8-27B | Muse-Glimmer-30B | Gemma4-31B |
|---|---|---|---|---|
| Terminal-Bench 2.1 | 80,9 | 73,0 | 61,8 | 47,2 |
| Terminal-Bench 4.0 | 23,8 | 6,3 | 1,6 | 0,0 |
| DeepSWE | 65,5 | 42,5 | 4,4 | 2,7 |
| SWE-Bench Pro | 60,3 | 61,7 | 36,9 | 51,2 |
| SWE-Atlas-QnA | 50,8 | 41,9 | 17,7 | 3,3 |
| NL2Repo | 53,0 | 48,3 | 27,4 | 33,8 |
| Scicode | 52,6 | 46,7 | 44,9 | 45,5 |
| SkillsBench | 61,1 | 56,4 | 39,7 | 28,9 |
| Automation Bench | 54,2 | 38,3 | 15,2 | 9,7 |
| JobBench | 44,8 | 34,5 | 16,6 | 9,0 |
| GDPval | 84,8 | 86,4 | 75,8 | 71,4 |
| Claw-Eval (pass^3) | 78,3 | 75,2 | 57,3 | 44,2 |
| Toolathlon-Verified | 70,4 | 68,5 | 47,2 | 27,8 |
| DeepPlanning | 63,3 | 49,2 | 21,4 | 19,4 |
| EnterpriseOps-Gym | 41,0 | 40,2 | 30,5 | 27,3 |
| YC-bench | 1 025 437 $ | 641 290 $ | 513 978 $ | 265 152 $ |
| Tau3-Bench | 48,8 | 48,5 | 33,7 | 18,6 |
| GPQA Diamond | 89,5 | 89,2 | 83,5 | 91,3 |
| AIME 2026 | 95,2 | 94,5 | 94,7 | 89,2 |
| AA-LCR | 84,0 | 82,0 | 83,3 | 72,0 |
Les chiffres du codage sont les plus marquants. Terminal-Bench 4.0 est une version plus récente et bien plus difficile du test en ligne de commande, et Nanbeige affiche un score de 23,8 là où le second meilleur modèle de sa catégorie obtient 6,3. DeepSWE confirme cette tendance : 65,5 contre 42,5. Si vous utilisez un agent de codage en terminal comme Claude Code ou OpenClaw avec un modèle local, c'est l'écart que vous remarquerez. Mon guide sur la CLI de codage agentique explique comment ces structures diffèrent.
Trois nuances importantes avant de citer ce tableau :
- Ce sont les tests du laboratoire. Nanbeige a utilisé le même cadre et les mêmes paramètres pour chaque modèle, ce qui est équitable, mais aucun testeur indépendant n'a encore répété ces tests. Artificial Analysis répertorie les modèles Nanbeige plus anciens, mais pas encore celui-ci.
- Le cadre de test est important. Terminal-Bench 2.1 a été exécuté sur Terminus 2, DeepSWE sur mini-swe-agent v2.4.6, NL2Repo à l'intérieur de Claude Code. Votre configuration d'agent influencera ces chiffres.
- Quelques incohérences dans les détails. Le graphique à barres et le tableau sont en désaccord sur deux cellules (le JobBench de Muse-Glimmer est de
18,3dans le graphique et de16,6dans le tableau). C'est un détail, mais il est bon de le savoir si vous le citez.
Où Nanbeige 4.3 est-il moins performant ?
Si l'on regarde au-delà des lignes de codage, l'avance se réduit rapidement. Face à Qwen3.8-27B en particulier (un petit frère de Qwen3.8 Max), il est à la traîne sur SWE-Bench Pro (60,3 contre 61,7) et GDPval (84,8 contre 86,4), et il est pratiquement à égalité sur Tau3-Bench, le benchmark qui simule un agent d'IA au service des clients d'une compagnie aérienne ou d'un détaillant (48,8 contre 48,5).
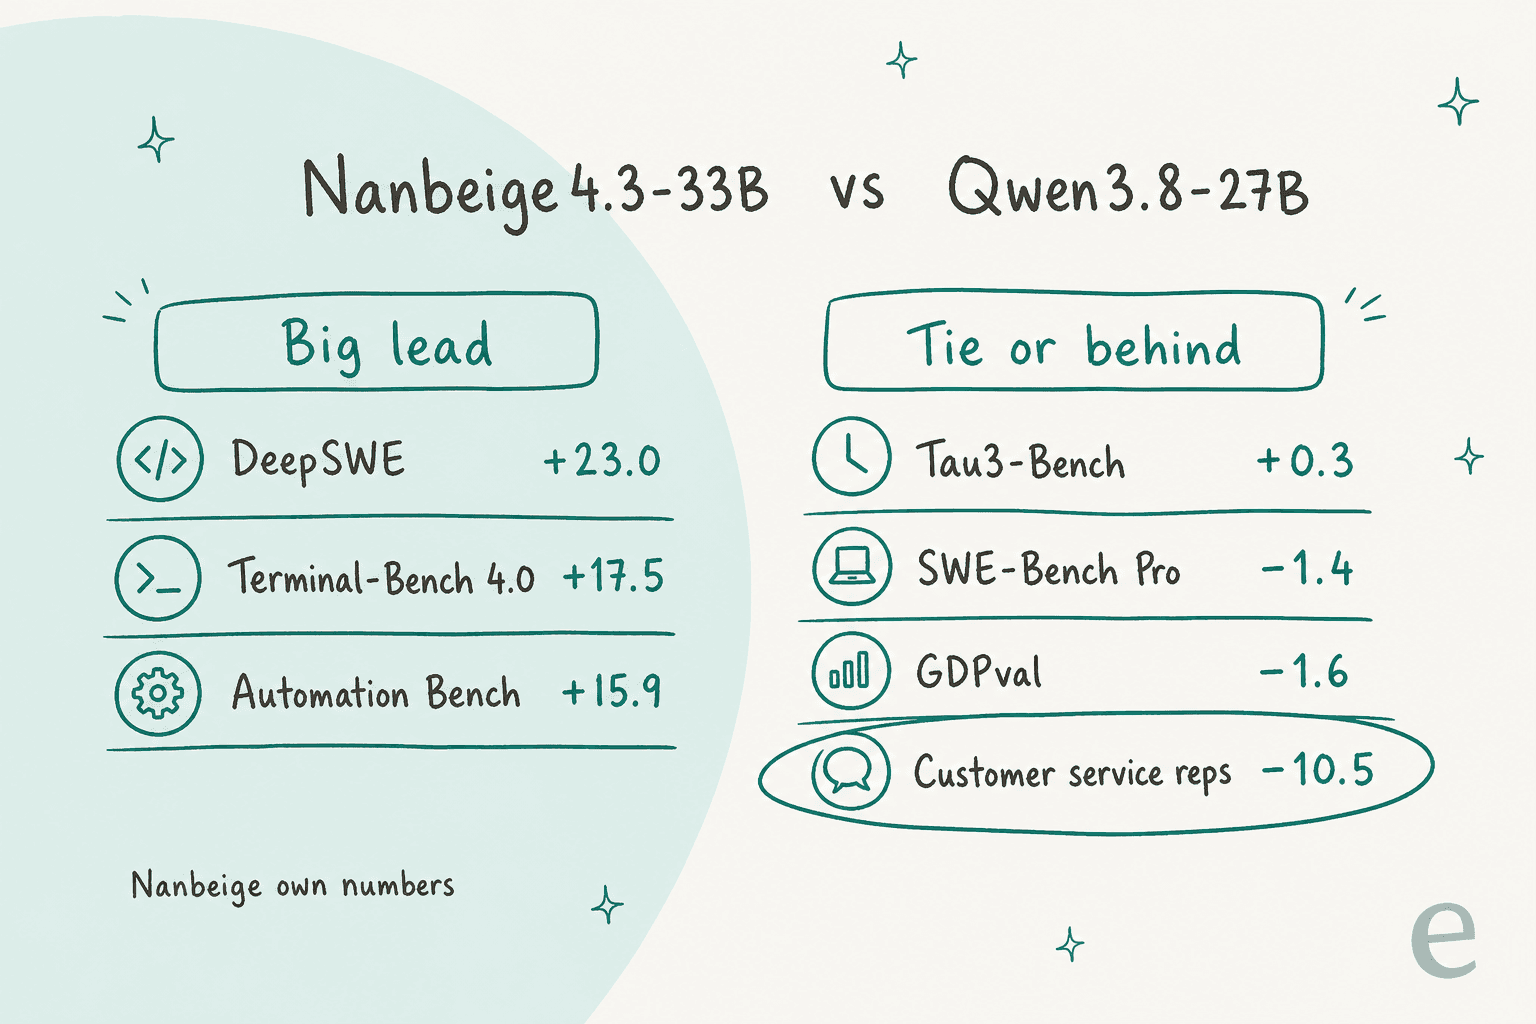
Le point qui attire mon attention se trouve dans le graphique JobBench, qui détaille le score sur 35 professions. Nanbeige gagne sur la plupart d'entre elles, avec une large avance pour les administrateurs web (72,0 contre 36,0) et les rédacteurs techniques (72,1 contre 53,7). Mais sur les tâches de représentant du service client, il obtient 21,1 contre 31,6 pour Qwen, et il perd également sur les métiers de secrétariat et d'assistanat administratif (28,8 contre 47,5).
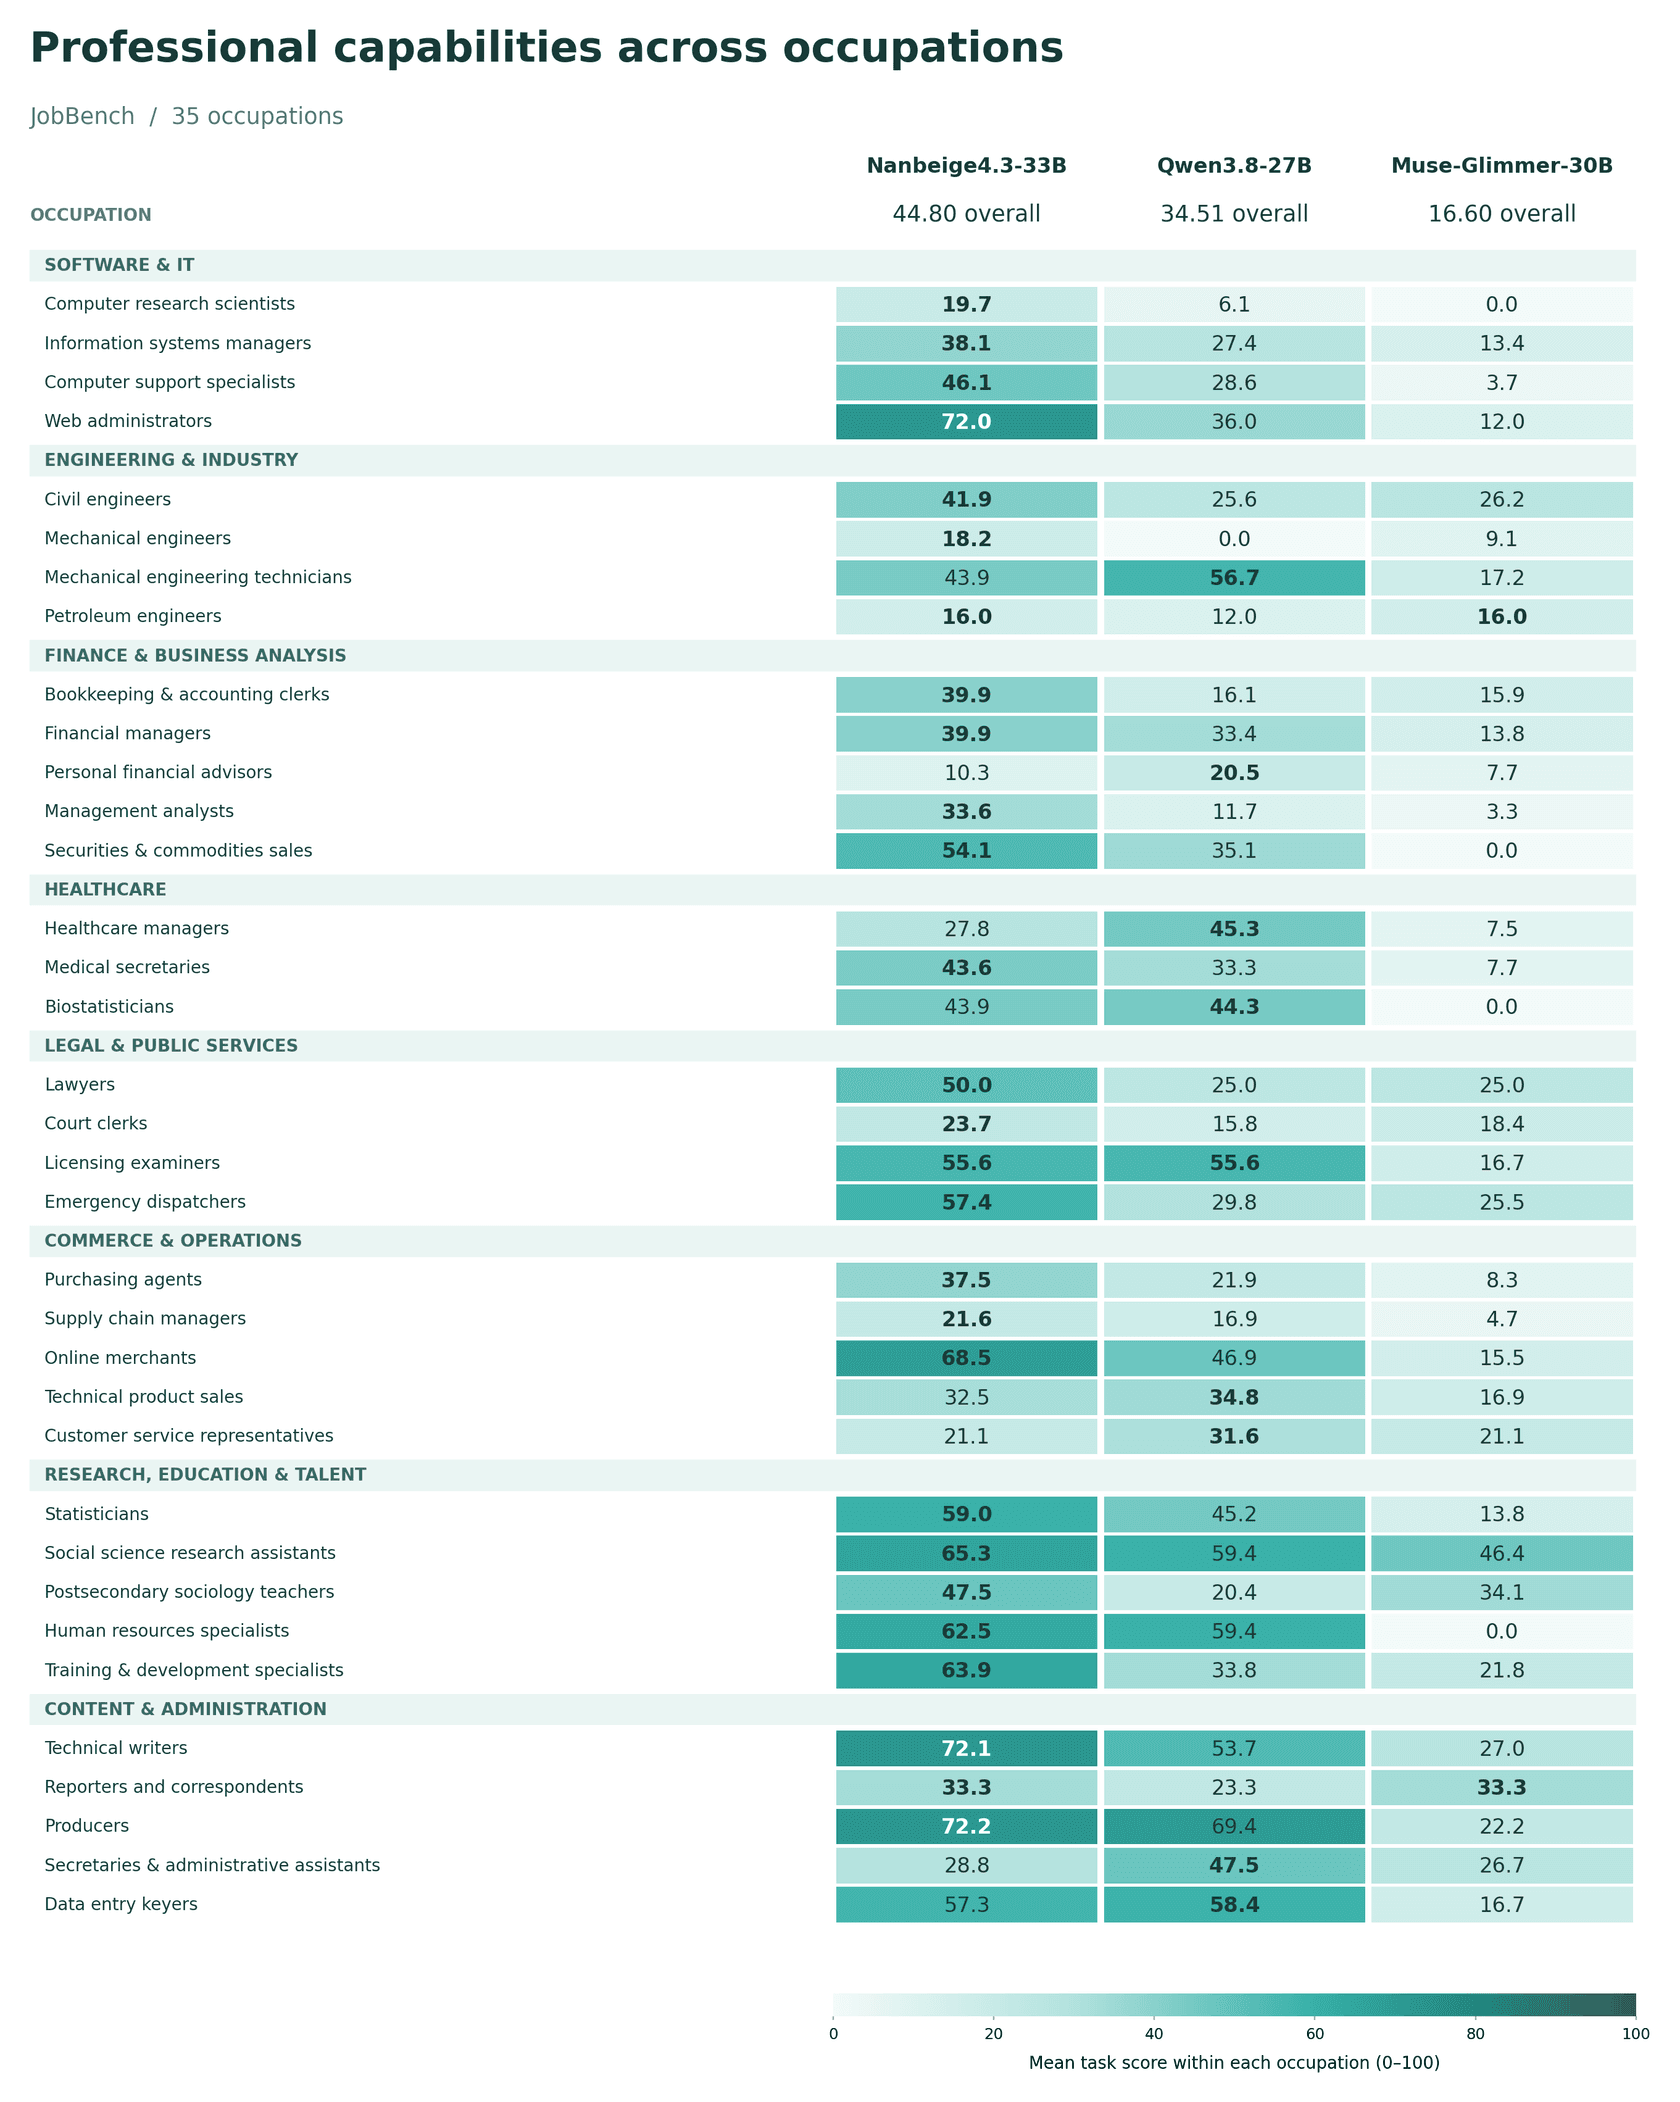
Cela correspond à ce que je constate dans le domaine du support. Être excellent pour écrire du code dans un terminal ne se traduit pas automatiquement par une réponse pertinente à un client mécontent d'un remboursement, c'est aussi pourquoi un agent IA et un chatbot ne sont pas le même type d'achat. La qualité du support dépend bien plus des informations que le modèle peut consulter que du modèle lui-même. Dans mon comparatif des modèles pour les tickets de support, le même modèle a perdu 68 points sur le benchmark Tau de Sierra dès que la réponse se trouvait dans des documents plutôt que dans un outil.
Nanbeige a exécuté Tau3-Bench avec le dépôt officiel, mais son score ne figure pas sur le classement public de Sierra, donc ne le comparez pas directement aux chiffres de ce classement.
De quelle quantité de mémoire Nanbeige 4.3 a-t-il besoin ?
C'est la partie que le post de lancement passe sous silence. Les poids sont gérables : un GGUF 4 bits communautaire de bartowski pèse 20,79 Go en Q4_K_M et 35,2 Go en Q8_0. Le problème, c'est le contexte.
Nanbeige4.3-33B est un transformeur dense classique avec attention par groupe de requêtes (grouped-query attention) : 52 couches, 8 têtes clé-valeur de 128 dimensions chacune. Chaque jeton conservé en contexte coûte 2 × 52 × 8 × 128 × 2 octets, soit 212 992 octets par jeton en 16 bits. C'est ce chiffre qui détermine le choix de votre GPU, pas le nombre de paramètres.
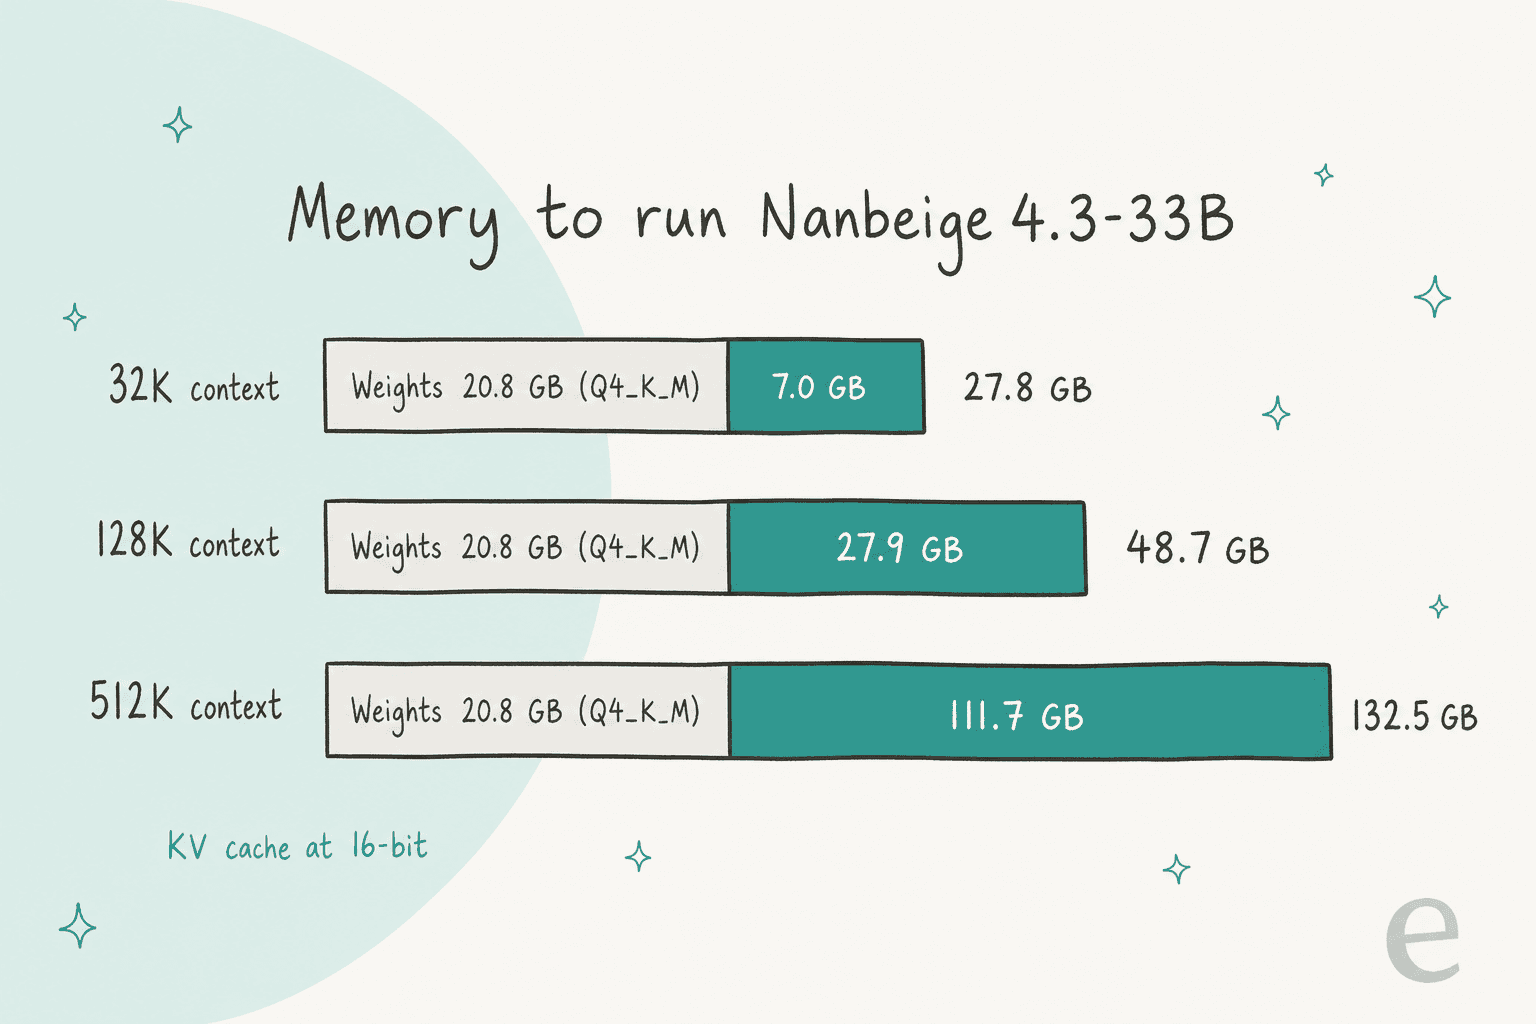
| Longueur de contexte | Cache KV (16 bits) | Cache KV (8 bits) | Total avec poids Q4_K_M (cache 16 bits) |
|---|---|---|---|
| 32K | 7,0 Go | 3,5 Go | ~27,8 Go |
| 128K | 27,9 Go | 14,0 Go | ~48,7 Go |
| 256K | 55,8 Go | 27,9 Go | ~76,6 Go |
| 512K | 111,7 Go | 55,8 Go | ~132,5 Go |
L'annonce d'un « contexte de 512K » est donc bien réelle, mais l'utiliser en totalité nécessite du matériel de serveur. Les exemples de service de Nanbeige pour vLLM et SGLang fixent le parallélisme de tenseur à 4, ce qui signifie quatre GPU.
Les utilisateurs l'ont remarqué en un jour. Le fil de discussion le plus commenté sur le dépôt est une demande d'optimisation du cache KV, où des intervenants soulignent que certains rivaux de la même catégorie de taille nécessitent plusieurs fois moins de cache pour le même contexte. C'est une critique justifiée face à la mention « rentable » de la fiche du modèle : sur un contexte long, un 33B dense est tout sauf économique.
L'avantage de cette conception classique est la compatibilité. Comme il s'agit d'une architecture Llama standard, au moins 30 conversions communautaires (GGUF, MLX pour Apple Silicon, NVFP4, FP8) sont apparues sur Hugging Face en deux jours, et il fonctionne sur les versions de base de vLLM et SGLang avec les analyseurs de raisonnement et d'appel d'outils de Qwen.
Comment faire fonctionner Nanbeige 4.3 ?
Il n'y a pas d'API hébergée par Nanbeige, et OpenRouter ne proposait pas le modèle au 26 octobre 2026. Vous devez télécharger les poids et les exécuter. La fiche du modèle propose trois solutions :
- Transformers pour des tests rapides. Chargez
Nanbeige/Nanbeige4.3-33Bavectrust_remote_code=Trueetdevice_map='auto'. - vLLM pour le service. L'exemple de la fiche utilise
--tensor-parallel-size 4,--reasoning-parser qwen3et--tool-call-parser qwen3_coder. - SGLang, avec les deux mêmes analyseurs et
--tp-size 4.
Deux commutateurs de modèle de chat (chat-template) sont plus importants qu'ils n'en ont l'air :
enable_thinkingest activé par défaut. Désactivez-le pour des réponses rapides.preserve_thinkingconserve le raisonnement des tours précédents. Nanbeige recommandeTruepour l'utilisation d'outils et les agents de codage, etFalsepour le chat classique. Leurs scores de benchmarks ont été obtenus avec cette option activée.
Les paramètres recommandés diffèrent également selon la tâche : une température de 1,0 avec jusqu'à 65 536 nouveaux jetons pour le travail d'agent et d'outils, et une température de 0,6 avec jusqu'à 262 144 nouveaux jetons pour le raisonnement et le chat.
Si vous comparez les options locales, les autres modèles ouverts que j'ai traités récemment, comme Gemma 4, Mistral Large 4 et DeepSeek V4 Flash, font des compromis différents entre la taille, le coût du contexte et l'accès hébergé. Ma liste des agents IA open-source présente les structures auxquelles vous pourriez les connecter, et le comparatif des assistants de codage IA couvre l'aspect hébergé. Pour un accès API plutôt qu'un auto-hébergement, Kimi K3 et MiniMax 3 sont les options évidentes à explorer.
Quelle est la suite pour Nanbeige ?
L'équipe de Nanbeige répond directement aux questions sur la page Hugging Face du modèle, et trois réponses dessinent la feuille de route. Lorsqu'on lui a demandé si le 33B réutilisait la conception en boucle du 4.2, un membre de l'équipe Nanbeige a répondu par la négative, en expliquant pourquoi :
« D'après nos expériences, l'architecture Looped Transformer offre un meilleur compromis qualité-calcul pour les modèles de petite taille. Nos prochains petits modèles, tels que Nanbeige4.3-3B et Nanbeige4.5-3B, utiliseront l'architecture Looped Transformer et offriront des performances améliorées. »
Ce même membre de l'équipe a précisé qu'un rapport technique sera publié avec le Nanbeige4.3-3B, qu'un module de décodage spéculatif DFlash2 est prévu pour une génération plus rapide, et que les poids FP8 « arrivent bientôt ». En septembre, le laboratoire avait également déclaré sur X que le Nanbeige4.5 était déjà en cours d'entraînement.
Mon analyse : si vous faites tourner de petits agents sur du matériel modeste, le modèle à attendre est le Nanbeige4.3-3B, pas celui-ci. Le 33B est la preuve que l'enseignant est solide. Reste à savoir si l'étudiant 3B conservera l'essentiel de cet avantage en codage, dans un modèle capable de tenir sur un ordinateur portable : c'est la véritable question, et personne ne peut y répondre avant sa sortie.
Devez-vous utiliser Nanbeige 4.3 ?
Tout dépend de ce que vous construisez, et le tableau des benchmarks vous donne déjà l'essentiel de la réponse :
- Agents de codage sur votre propre matériel : oui, essayez-le. Les avances sur Terminal-Bench 4.0 et DeepSWE sont assez importantes pour résister aux variations des cadres de test, et la licence Apache 2.0 évite les maux de tête juridiques. Prévoyez le budget pour le cache KV, ou limitez le contexte entre 32K et 64K.
- Travail sur de longs documents avec un seul GPU : probablement pas. Une requête de 128K nécessite environ 49 Go avec des poids 4 bits.
- Ajustement (fine-tuning) de votre propre agent : le modèle Base est un bon point de départ. Nanbeige indique qu'il surpasse Gemma4-31B-Base sur les huit benchmarks de base testés, y compris MMLU-Pro (
66,9contre59,3). - Support client : pas au vu de ces chiffres. Il perd face à Qwen sur les tâches de service client et fait seulement jeu égal sur Tau3-Bench, et un modèle seul ne répond de toute façon pas aux tickets. Ma sélection du meilleur agent IA pour le service client examine plutôt l'ensemble de la configuration.
Utiliser l'IA sur de vrais tickets de support, pas sur des benchmarks
C'est sur ce dernier point que je concentre mon travail quotidien. Un modèle comme Nanbeige4.3-33B est une infrastructure. Pour répondre à un vrai ticket, il faut encore un système qui s'intègre à votre helpdesk, lise vos macros et vos anciens tickets, sache quels clients doivent être dirigés vers un humain et respecte les règles sur ce qu'il n'est jamais autorisé à dire. C'est précisément le rôle de l'agent de helpdesk IA d'eesel, l'un des coéquipiers IA prêts à l'emploi que vous recrutez pour un rôle spécifique. Il fonctionne au sein d'outils comme les configurations Zendesk AI plutôt que de les remplacer, et c'est le calcul du coût par ticket qui finit généralement par emporter la décision.
L'entreprise eesel AI propose une tarification transparente à 0,40 $ par ticket ou session de chat, et 4,00 $ par article de blog, avec un essai gratuit de 50 $ sans frais mensuels minimums ni frais de plateforme.
smava, une plateforme de comparaison de prêts basée à Berlin, illustre bien ce que cela donne en pratique. eesel a traité environ 27 000 tickets Zendesk en un mois pour smava et sa marque sœur Finanzcheck, en catégorisant environ 14 600 tickets et en préparant environ 15 300 projets de réponses à partir d'environ 820 macros et articles de centre d'aide. Les clients qui ont déjà un conseiller de crédit sont ignorés pour qu'ils puissent échanger avec leur conseiller, et eesel n'envoie jamais les réponses directement aux clients : un agent humain approuve chaque projet. Rien de tout cela n'apparaît dans un benchmark de codage, et pourtant tout cela détermine si l'IA aide ou nuit à l'entreprise.

Avant la mise en service, eesel teste votre configuration par rapport à des centaines de vos anciens tickets pour que vous puissiez voir ses réponses avant qu'un client ne les reçoive, ce qui est bien plus parlant que n'importe quel benchmark cité par un vendeur. J'ai détaillé le fonctionnement de ces tests dans un article séparé. SamCart a suivi la même voie sur Freshdesk, avec un agent pour les tickets par e-mail et un autre pour le chat de son site web, tous deux répondant à partir d'environ 280 articles de centre d'aide. Si vous préférez travailler depuis le terminal comme vous le feriez avec un modèle local, la CLI eesel vous permet, ainsi qu'à un script ou à un agent de codage comme Claude Code, de connecter des intégrations, de modifier les instructions permanentes de l'agent, d'approuver ou de refuser ses actions en attente et de lire son journal d'activité, le tout au format JSON.
Essayez eesel
Nanbeige 4.3 est un moteur ouvert puissant pour les agents de codage. Si ce dont vous avez réellement besoin cette semaine, c'est d'un agent pour gérer votre file d'attente de support, le coéquipier de helpdesk IA d'eesel rejoint votre Zendesk, Freshdesk ou Gorgias en quelques minutes, apprend de vos anciens tickets et de votre centre d'aide, et rédige ou envoie des réponses selon les règles que vous avez fixées. eesel AI coûte 0,40 $ par ticket/session de chat et 4,00 $ par article de blog. C'est gratuit pour commencer avec 100 crédits et sans carte bancaire, ce qui vous permet de le tester sur de vrais tickets avant de vous décider. Essayez eesel.
Foire aux questions
Qu'est-ce que Nanbeige 4.3 ?
Nanbeige 4.3 est une série de modèles du Nanbeige LLM Lab de BOSS Zhipin (Kanzhun). Sa première version, Nanbeige4.3-33B, est sortie sur Hugging Face le 24 octobre 2026 sous licence Apache 2.0. Il s'agit d'un modèle de texte dense de 33 milliards de paramètres avec une fenêtre de contexte de 512K, conçu pour le codage agentique et les tâches de bureau, et il est destiné à enseigner à un modèle plus petit, le Nanbeige4.3-3B. Il se situe dans la même catégorie de modèles ouverts que Gemma 4 et Qwen.
L'utilisation de Nanbeige 4.3 est-elle gratuite ?
Oui. Les poids de Nanbeige4.3-33B et Nanbeige4.3-33B-Base sont publiés sous licence Apache 2.0, ce qui permet un usage commercial. Vous payez plutôt pour le matériel : les poids BF16 seuls pèsent 66 Go, et un GGUF 4 bits pèse environ 21 Go avant toute mémoire de contexte. Pour avoir une idée du coût des modèles hébergés, consultez les tarifs de DeepSeek V4 Flash.
De quelle quantité de VRAM Nanbeige 4.3 33B a-t-il besoin ?
Environ 21 Go pour les poids 4 bits, plus environ 0,2 Mo de cache KV par jeton en 16 bits. Cela représente environ 28 Go au total pour un contexte de 32K, 49 Go pour 128K, et plus de 130 Go pour la totalité des 512K. Les exemples vLLM et SGLang de Nanbeige utilisent un parallélisme de tenseur à 4 voies. Si vous avez besoin de quelque chose qui tient sur une seule petite carte, les petits modèles de langage précédents de la gamme Nanbeige sont de 3B.
Nanbeige 4.3 est-il meilleur que Qwen3.8-27B ?
Sur le tableau de Nanbeige, Nanbeige4.3-33B surpasse Qwen3.8-27B sur 18 des 20 benchmarks, avec les écarts les plus importants sur DeepSWE (65,5 contre 42,5) et Terminal-Bench 4.0 (23,8 contre 6,3). Qwen gagne toujours sur SWE-Bench Pro et GDPval, et aucun laboratoire indépendant n'a encore revérifié les chiffres. Le grand frère de Qwen est traité dans le test de Qwen3.8 Max.
Puis-je utiliser Nanbeige 4.3 pour le support client ?
Vous le pouvez, mais ses propres chiffres ne sont pas convaincants. Sur JobBench, il a obtenu un score de 21,1 sur les tâches de représentant du service client contre 31,6 pour Qwen3.8-27B, et son score Tau3-Bench est une égalité de 48,8 contre 48,5. Un agent de support a également besoin que votre helpdesk, vos macros et vos règles de transfert soient intégrés, ce qu'un agent de helpdesk IA comme eesel gère pour vous.
Nanbeige 4.3 dispose-t-il d'une API ?
Nanbeige livre les poids, pas une API hébergée. La fiche du modèle explique comment l'exécuter vous-même avec Transformers, vLLM ou SGLang, et OpenRouter ne le répertoriait pas au 26 octobre 2026. Si vous préférez appeler un modèle ouvert hébergé, Kimi K3 et GLM-5.3 Flash sont tous deux disponibles via des API.
Quand le Nanbeige4.3-3B sortira-t-il ?
Nanbeige n'a pas donné de date. Un membre de l'équipe Nanbeige a déclaré sur la page Hugging Face du modèle que le rapport technique de la série 4.3 sera publié en même temps que Nanbeige4.3-3B, et que le 3B utilisera la conception Looped Transformer de Nanbeige4.2-3B. Pour en savoir plus sur les modèles en boucle, consultez l'explication sur GPT-6 Astra.