

Qu'est-ce que Reflection AI Beam ?
Beam est le premier modèle de Reflection AI, un laboratoire lancé en 2024 par deux anciens chercheurs de Google DeepMind. En interne, c'est un modèle de mélange d'experts (MoE) épars, avec 501 milliards de paramètres au total, 23 milliards actifs sur un token donné. L'objectif d'entraînement était le travail de code et de raisonnement, avec en plus des charges de travail d'agents.
Cela le place aussi dans la même catégorie que Kimi K3, Qwen3.8 Max et DeepSeek V4 Flash.
Il se situe aussi à côté de l'autre pari open-weight américain de cette année, Inkling.
Je construis des agents IA pour gagner ma vie, donc j'ai tendance à lire un article de lancement comme la fiche technique d'une voiture avant l'essai : les chiffres qui comptent sont ceux qui finissent sur votre facture et dans vos logs de latence. Avec Beam, ce qui rend les chiffres intéressants, c'est surtout la façon dont ils ont été obtenus :
- Pré-entraînement :
23.8Ttokens, exécuté de bout en bout en moins de quatre semaines sur6,144GPU NVIDIA GB300, selon l'article de lancement de Reflection. - Apprentissage par renforcement :
10.5KGPU GB300 pendant quatre semaines, générant plus de100 millionde rollouts sur près d'un million d'environnements d'entraînement. - Architecture :
52couches, attention locale et globale entrelacées, et experts routés à grain fin avec une utilisation quasi uniforme (l'expert le plus sollicité tourne à seulement1.04xla charge moyenne). - Entrée : texte uniquement. Les entrées image, audio et fichier ne sont pas prises en charge par l'API, selon la documentation de compatibilité OpenAI.
- Licence : Apache 2.0, promise « ce mois-ci » avec des versions quantifiées FP8 et NVFP4, selon le fil de lancement de Reflection.
Le lancement a attiré beaucoup d'attention. La publication officielle sur X a dépassé 8,492 likes, tandis que le fil Hacker News a atteint 549 points et 174 commentaires dans ses premiers jours.
Ce qui est utilisable aujourd'hui par rapport à ce qui a été annoncé
La plupart des articles sur le lancement sautent cette partie, ce qui est dommage, car c'est elle qui décide si Beam entre dans vos plans de ce mois. L'annonce décrit le modèle que Reflection a entraîné, et la documentation développeur décrit le modèle que vous pouvez réellement appeler. Pour l'instant, ce n'est pas la même chose.
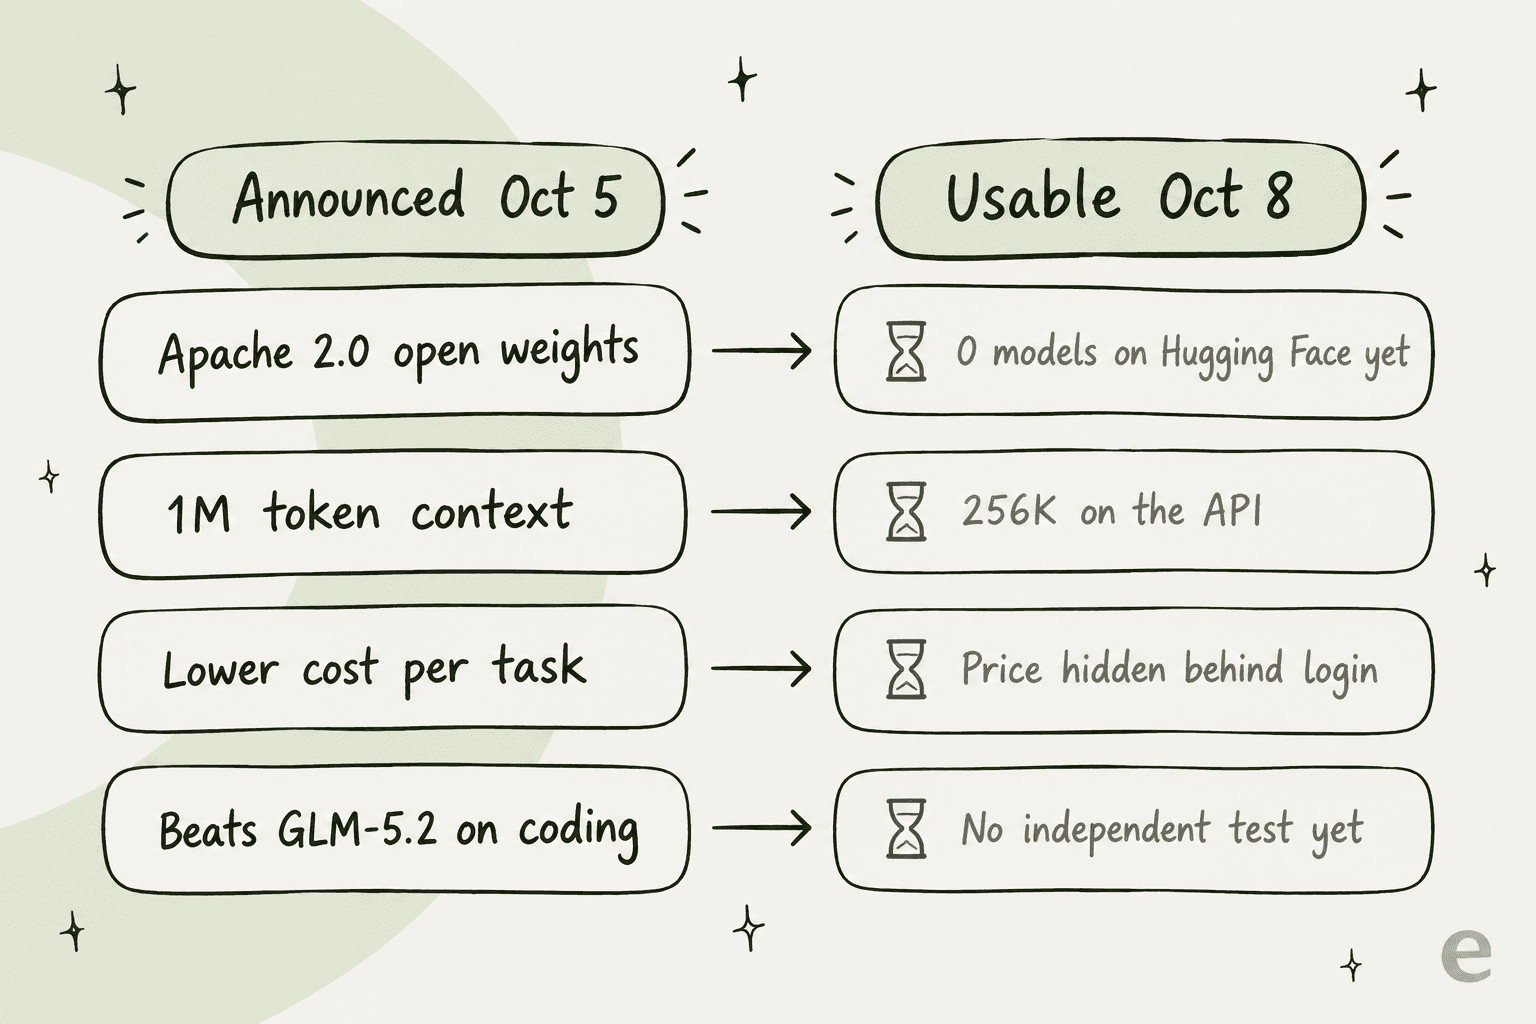
| Ce que dit le lancement | Ce que disent l'API et la doc (8 oct. 2026) | |
|---|---|---|
| Poids | Apache 2.0 « ce mois-ci » | L'organisation Hugging Face de Reflection compte 0 modèle |
| Fenêtre de contexte | Contexte effectif étendu à 1M tokens | 256K de contexte, 128K de sortie max, « may change during beta » (Models) |
| Accès | Accès anticipé pour « a select group of users » | Liste d'attente ; clés seulement une fois l'accès activé (Authentication) |
| Prix | « Lower cost » grâce à l'efficacité | Aucun tarif public ; la page de tarifs est derrière la connexion |
| Limites de débit | Non mentionnées | Limites par organisation et quota quotidien de tokens, sans chiffres publiés (Rate limits) |
| Raisonnement | Effort contrôlable | Toujours actif, cinq niveaux de low à max, medium par défaut (Reasoning) |
| Date limite des connaissances | Non indiquée | 30 juin 2026 |
La fenêtre de contexte est l'écart que je signalerais le plus. Si votre plan est un flux de longs documents ou de dépôts entiers construit autour de « 1M tokens », l'API bêta vous limite aujourd'hui au quart de cela. Je n'appellerais pas ça une promesse rompue, puisque la capacité d'entraînement et les limites de service sont deux choses différentes, mais cela change ce que vous pouvez construire en octobre.
L'utilisateur de Hacker News adrian_b a énoncé l'échéance sans détour :
"They claim that they will release the model as open weights later this month. That means that they have the 31th of October as the deadline to make true their claims."

Comment fonctionne Beam : 23B travaillent, 501B stockés
La conception MoE est pratiquement toute l'histoire de Beam, donc elle mérite une minute en langage simple. Un modèle de mélange d'experts répartit ses poids en de nombreux petits réseaux « experts », et pour chaque token un routeur en choisit une poignée, puis seuls ces experts font du calcul. C'est la raison pour laquelle un modèle de 501B peut coûter par token à peu près autant à exécuter qu'un modèle dense de 23B.
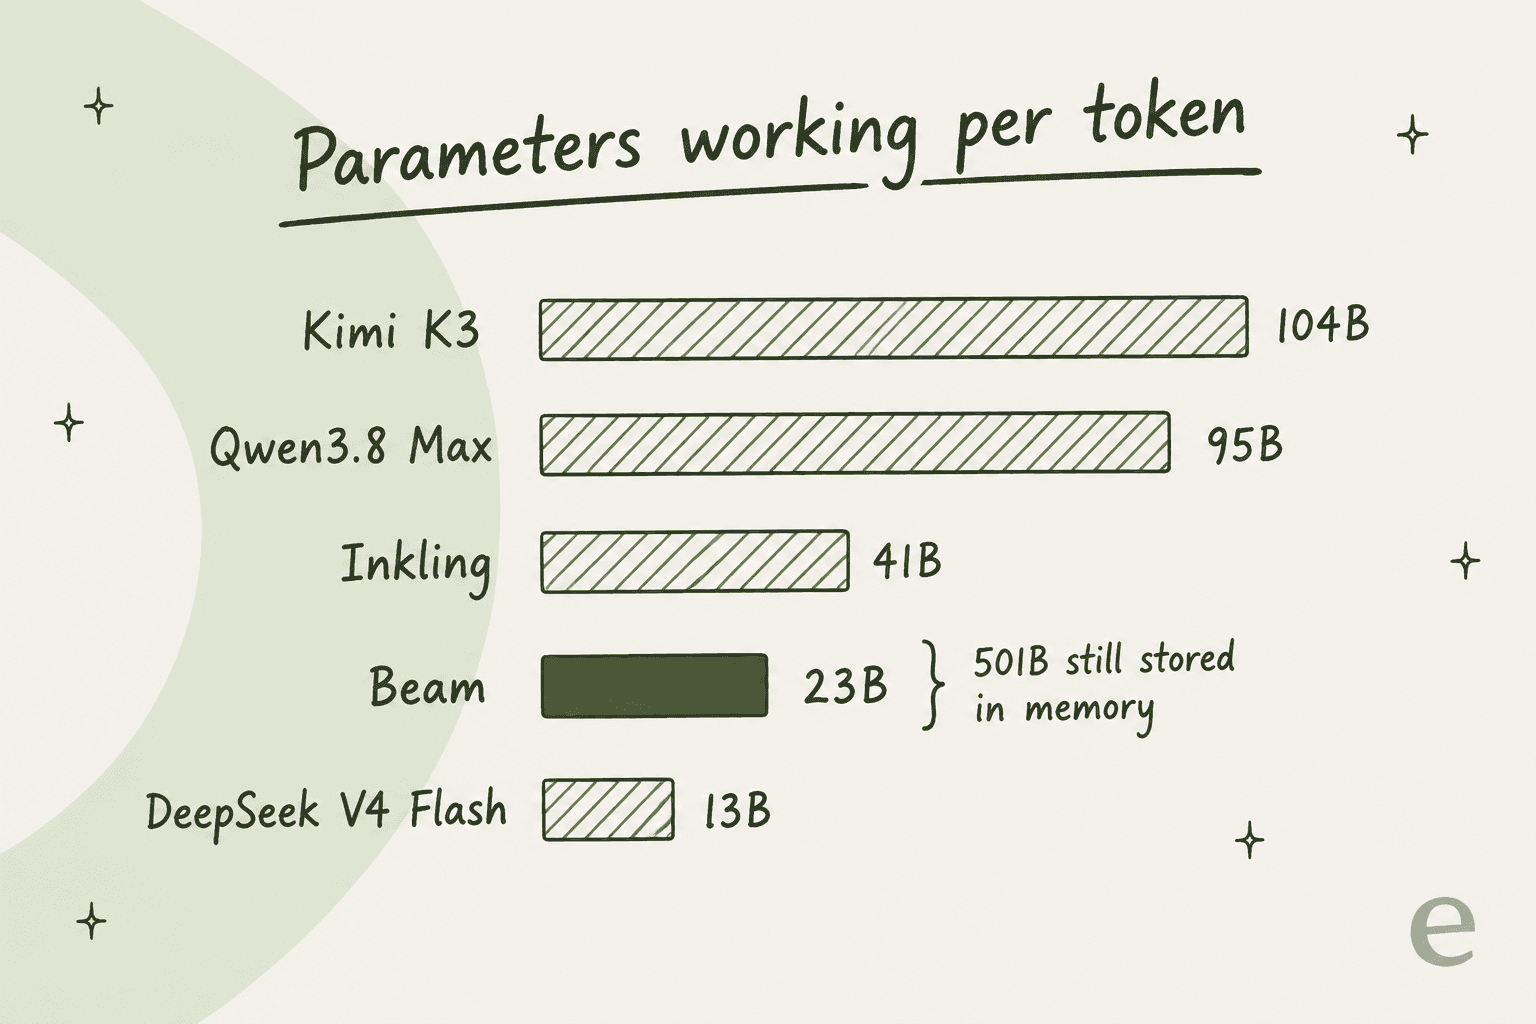
Le piège que beaucoup manquent est celui-ci : les paramètres actifs fixent votre facture de calcul, les paramètres totaux fixent votre facture de matériel. Les 501B doivent tous rester en mémoire, car au token suivant le routeur peut choisir n'importe quel expert. Par token, Beam est donc peu coûteux à exécuter, mais pas petit à héberger. Face à Kimi K3 avec 2.8T au total et 104B actifs, Beam est plus léger sur les deux plans, et face à DeepSeek V4 Flash, qui n'active que 13B, il fait plus de travail par token.
La longueur du raisonnement est l'autre levier. Reflection a entraîné Beam avec une pénalité de longueur qui récompense les bonnes réponses et décourage les tokens inutiles, puis a exposé ce compromis via le paramètre reasoning_effort. Dans leurs graphiques d'efficacité, le score est tracé en fonction du nombre de tokens que dépense chaque modèle :
Sous le graphique, Reflection énonce elle-même une réserve honnête : les estimations de calcul omettent le prefill du prompt, les coûts d'attention et la surcharge de service, donc elles « represent an approximate compute comparison rather than measured inference cost. » Autrement dit, ce que vous voyez est la forme de l'efficacité, pas une facture.
Benchmarks de Beam : où il se situe vraiment
Reflection a publié un large tableau de benchmarks et, à son crédit, il inclut des modèles qui battent Beam. Voici les lignes que je regarderais pour le travail d'agents et de code, et chaque chiffre vient du tableau de Reflection lui-même. « NR » signifie not reported (non communiqué).
| Benchmark | Beam | GLM-5.2 | Kimi K3 | Qwen3.8 Max | DeepSeek V4.1 Flash | Inkling |
|---|---|---|---|---|---|---|
| SWE-bench Verified | 80.9 | NR | NR | NR | NR | 77.6 |
| SWE-bench Pro v1 | 65.5 | 62.1 | NR | 67.7 | NR | 54.3 |
| Terminal Bench v2.1 | 80.1 | 81.0 | 88.3 | 86.6 | 90.6 | 63.8 |
| DeepSWE v1.1 | 44.4 | 44.0 | 68.0 | 51.0 | 74.2 | NR |
| MCP Atlas | 78.7 | 77.8 | 82.3 | 84.5 | NR | 76.0 |
| tau3 banking | 38.0 | 37.1 | 37.1 | 55.2 | NR | 25.0 |
| HLE (no tools) | 36.2 | 40.5 | 46.9 | 43.6 | 39.1 | 29.7 |
| GPQA Diamond | 90.5 | 91.2 | 93.5 | 92.6 | 90.9 | 87.2 |
En lisant les lignes d'un bout à l'autre, le tableau est assez clair : Beam rivalise avec GLM-5.2 et bat nettement Inkling, mais reste derrière Kimi K3, Qwen3.8 Max et DeepSeek V4.1 Flash partout où ceux-ci ont communiqué. Le cadrage de Reflection va dans ce sens, en disant que Beam est « competitive with larger open models like GLM 5.2 and approaching Qwen 3.8-Max on coding and agentic tasks, » tandis que « frontier open models like Kimi K3 remain ahead on raw capability. »
Le 80.9 en tête sur SWE-bench Verified mérite une note, et un utilisateur de X nommé LuChai l'a bien formulée :
"The 80.9 on SWE Bench Verified is the standout, but worth flagging that GLM-5.2 and Qwen 3.8 Max are both NR there"
Il n'y a pas non plus d'arbitre indépendant pour l'instant. Au 8 octobre, Beam n'est pas listé sur Artificial Analysis (sa liste de 696 modèles n'a aucune entrée Beam), et il est absent du classement tau-bench de Sierra. Pour le contexte, Artificial Analysis note actuellement Qwen3.8 Max à 45.4, Kimi K3 à 43.6 et GLM-5.2 à 33.7 sur son Intelligence Index. Si Beam se situe vraiment près de GLM-5.2, je m'attendrais à le voir quelque part dans les 30 une fois testé, et Mistral Large 4, une autre sortie occidentale récente, est un étalon utile pour cela.
Autre point que j'ai aimé : Reflection montre que son entraînement RL a continué à s'améliorer sans plateau, un bon signe pour le prochain modèle de la série.
Combien coûtera Reflection AI Beam ?
Réponse courte : personne en dehors de la liste d'attente ne le sait encore. La plateforme Reflection et sa page /pricing n'affichent qu'un écran de connexion. Selon les conditions commerciales, les frais sont « set forth in the pricing documentation » sur la plateforme, et cette documentation est derrière la même connexion.
La documentation sur les erreurs et la facturation révèle une chose, à savoir la forme de la facturation :
- Un solde de crédits ou prépayé (
402 insufficient_credits,prepaid_balance_exhausted) - Une carte vérifiée avant que certaines organisations puissent créer des clés d'API (
403 payment_method_required) - Des paliers de facturation et un quota quotidien de tokens fixés par votre forfait
Faute de prix de Beam à citer, voici la fourchette dans laquelle Beam devrait se situer pour que son histoire d'efficacité compte. Ci-dessous, les tarifs d'API des éditeurs eux-mêmes pour les modèles du tableau comparatif de Reflection, par 1M de tokens :
| Modèle | Entrée | Entrée en cache | Sortie | Source |
|---|---|---|---|---|
| Kimi K3 | $3.00 | $0.30 | $15.00 | Kimi platform |
| Qwen3.8 Max | $2.00 | $0.25 | $6.00 | Qwen Cloud |
| GLM-5.2 | $1.40 | $0.26 | $4.40 | Z.ai pricing |
| DeepSeek V4.1 Flash | $0.30 | $0.006 | $1.20 (peak) | DeepSeek pricing |
| Reflection Beam | Non publié | Non publié | Non publié | Liste d'attente uniquement |
Supposons que Beam se situe près de GLM-5.2 en qualité. L'argument d'efficacité ne paie alors que s'il est tarifé au niveau ou en dessous des $1.40 / $4.40 de GLM-5.2, et il doit encore se justifier face à DeepSeek V4.1 Flash, qui score plus haut sur la plupart des lignes de Reflection pour une fraction de ces tarifs. Pour voir comment ces chiffres se traduisent par tâche, consultez mes analyses plus détaillées des tarifs de GLM et des tarifs de Qwen3.8 Max.
L'auto-hébergement change le calcul, mais pas la facture de matériel. Une réponse sur X à un post du type « run it on your desk » a formulé la contrepartie sans détour :
"m5 studio 512GB is like $20 grand... this is realistically a $40k investment, to use 6 month old AI."
Conditions sur les données à lire avant d'envoyer des données réelles
Les conditions de Reflection séparent le service en deux types. Sur les Standard Services payants, vous concédez votre contenu à Reflection « solely to operate and provide the Services. » Sur les services gratuits ou Discounted Services, la licence est bien plus large et inclut le droit de « create derivative works of, and otherwise exploit » votre contenu. Dans les deux cas, le contenu est conservé 30 jours pour la sécurité et la conformité, et le contenu signalé jusqu'à 12 mois. Si vous testez Beam avec des conversations clients sur un forfait d'accès anticipé à tarif réduit, c'est la clause que je lirais deux fois.
Comment utiliser Beam dès maintenant
Une fois sorti de la liste d'attente, l'API est facile à intégrer. Reflection propose un endpoint compatible OpenAI à https://api.reflection.ai/openai/v1, ce qui signifie que le code construit sur les SDK OpenAI fonctionne après avoir changé l'URL de base et la clé. L'ID du modèle est Beam-501B-A23B.
Quelques pièges de la documentation valent d'être connus avant de construire :
- Seuls Chat Completions et Models sont pris en charge. Pas de Responses API, d'embeddings, de batch, de files ni d'assistants.
- Les séquences
stopsont acceptées mais ignorées. La génération ne s'arrêtera pas dessus, ne comptez donc pas dessus pour le parsing. - Le raisonnement ne peut pas être désactivé. Choisissez
lowpour la vitesse,maxpour les tâches difficiles. Le texte de raisonnement revient dans un champ séparé,reasoning_content. nest fixé à 1 et les logprobs sont désactivés. Si votre harnais d'évaluation échantillonne plusieurs complétions par appel, il lui faut une boucle.- Le tool calling et les sorties structurées fonctionnent, y compris
parallel_tool_callsetjson_schema.
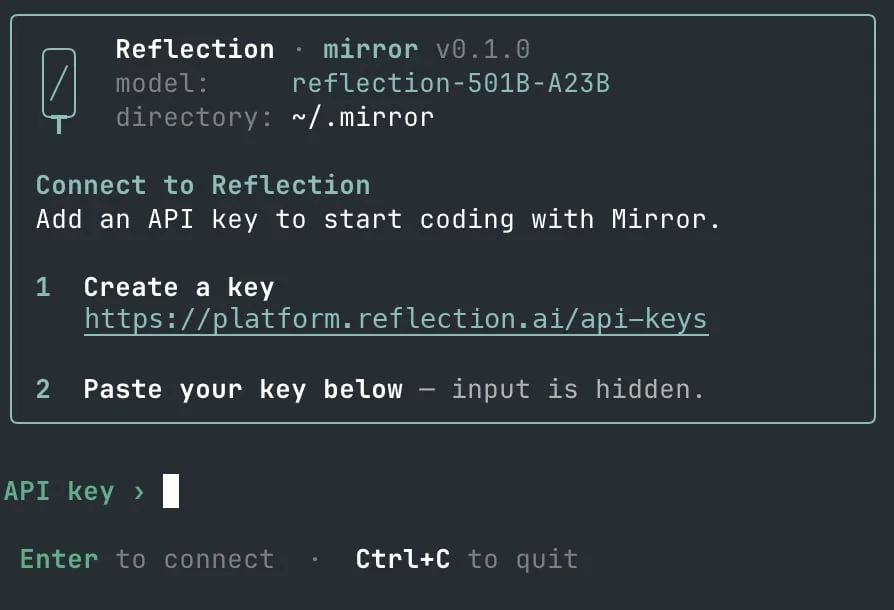
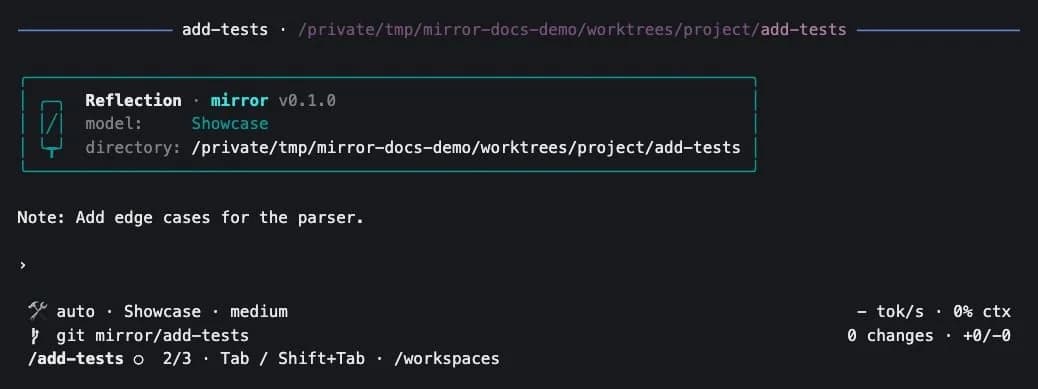
Pour le travail de code, Reflection fournit son propre agent de terminal, la Mirror CLI, avec Beam comme modèle par défaut. Elle est encore en bêta précoce et prend en charge les worktrees parallèles et les instructions AGENTS.md, ainsi que des connexions MCP à des outils comme Linear et Notion. Le guide de démarrage rapide de Reflection explique aussi comment brancher Beam sur Pi, OpenCode et Hermes Agent, utile si vous vivez déjà dans l'un d'eux.
Si vous choisissez encore un harnais, ce volet est couvert dans mes articles sur l'agent de code Pi et la CLI de code agentique.
Les démos de Reflection misent fortement sur cet angle d'agent. Ma préférée est la carte en direct du métro de New York, où Beam a cherché dans la documentation de la MTA et trouvé comment gérer l'authentification, puis a trouvé la géométrie du métro et construit à la fois le frontend et le backend :
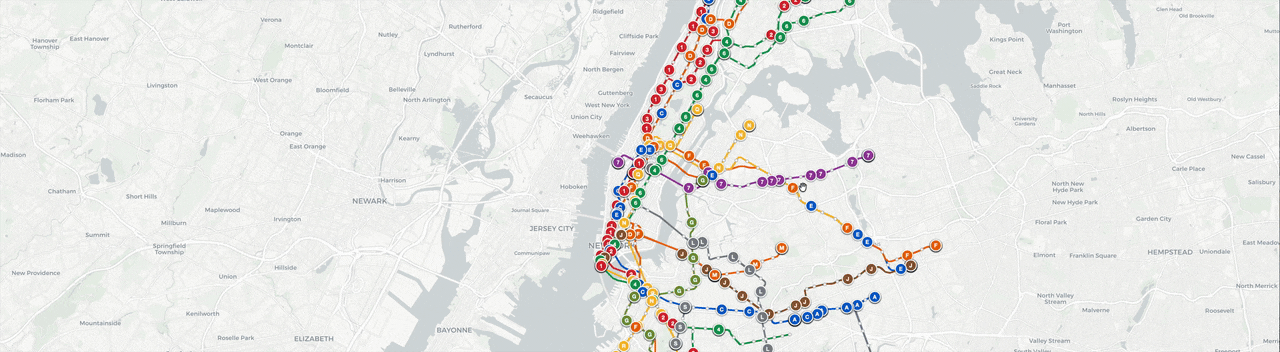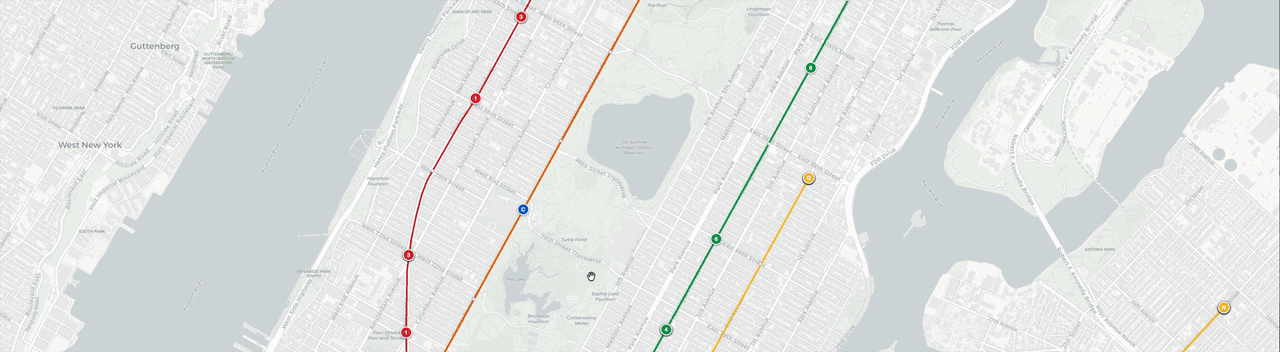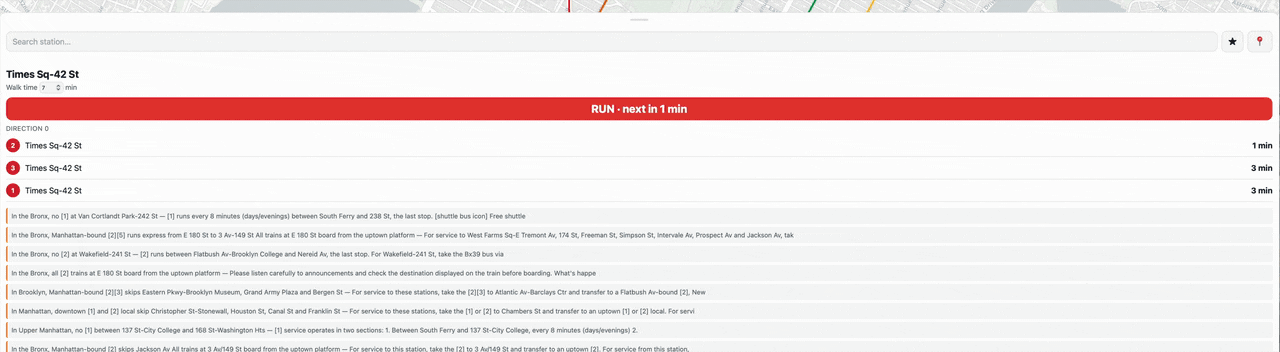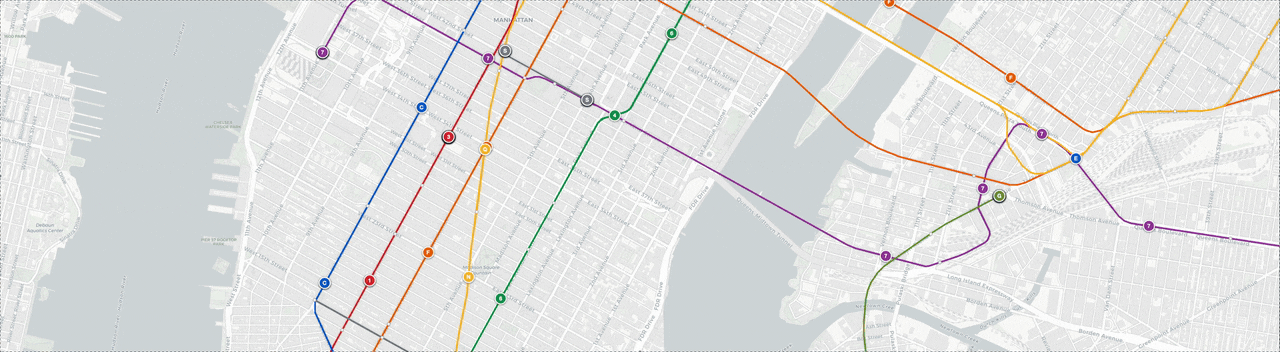
Une démo a nécessité une correction après le lancement. La démo « Land or Water » de Reflection affirmait d'abord que l'énigme n'avait que quelques jours, donc qu'elle ne pouvait pas figurer dans les données d'entraînement. Après qu'un utilisateur de HN a signalé qu'elle était plus ancienne, un membre de l'équipe Reflection a répondu que la légende avait été modifiée. C'est un détail et il a été traité ouvertement, mais il vaut la peine de le garder en tête en lisant les démos.
Ce que disent les développeurs sur Beam
J'ai parcouru le fil Hacker News et r/LocalLLaMA, ainsi que X et LinkedIn, et les trois mêmes thèmes revenaient sans cesse.
« Show me the weights. » Tant que les poids ne sont pas sortis, beaucoup de gens ne compteront simplement pas Beam comme ouvert. Les modérateurs de r/LocalLLaMA ont supprimé le fil de lancement pour exactement cette raison :
"Until such time that weights become available, this is off-topic for LocalLLaMA."

« It's a generation behind, but it's American. » La plupart des commentateurs placent Beam autour de GLM-5.2, qui est un modèle de juin. L'enthousiasme tient davantage à l'endroit où il a été construit, et pour les équipes qui ne peuvent pas utiliser de modèles d'origine chinoise, c'est toute la décision :
"I'm in a similar situation to you where we can't use Chinese AI models but we want to host on-prem due to data sovereignty concerns. ... I'm also keeping an eye on Reflection Beam"
« Nice efficiency claim, now let someone check it. » Même les avis positifs viennent avec cette réserve. Tyler Folkman, Chief AI Officer chez JobNimbus, a résumé comment les praticiens vont le dimensionner :
"Nobody outside Reflection has verified any of this yet. ... When Beam's weights ship, I'm sizing them for my boxes by active parameters and quantized footprint, not the leaderboard."

Reflection a aussi été saluée pour sa franchise. Un commentateur HN a félicité Reflection d'admettre que Kimi K3 est devant « instead of making false claims. » Je suis d'accord, car un article de lancement qui nomme les modèles qui le battent est plus rare qu'il ne devrait l'être.
Beam est-il un bon modèle pour le support client ?
C'est la question qui m'importe le plus, car mes journées sont consacrées à l'IA qui répond aux tickets de support. La bonne nouvelle est que Reflection a communiqué un score sur un benchmark qui ressemble vraiment au travail de support.
tau3 banking vient du tau-bench de Sierra. Il place le modèle dans un helpdesk bancaire simulé avec 698 documents de politique et lui demande de résoudre des demandes clients via des outils. Une tâche n'est réussie que si le compte du client se retrouve dans le bon état, ce qui signifie qu'une réponse polie mais fausse vaut zéro. Chaque tâche nécessite environ 18.6 documents et 9.5 appels d'outils.
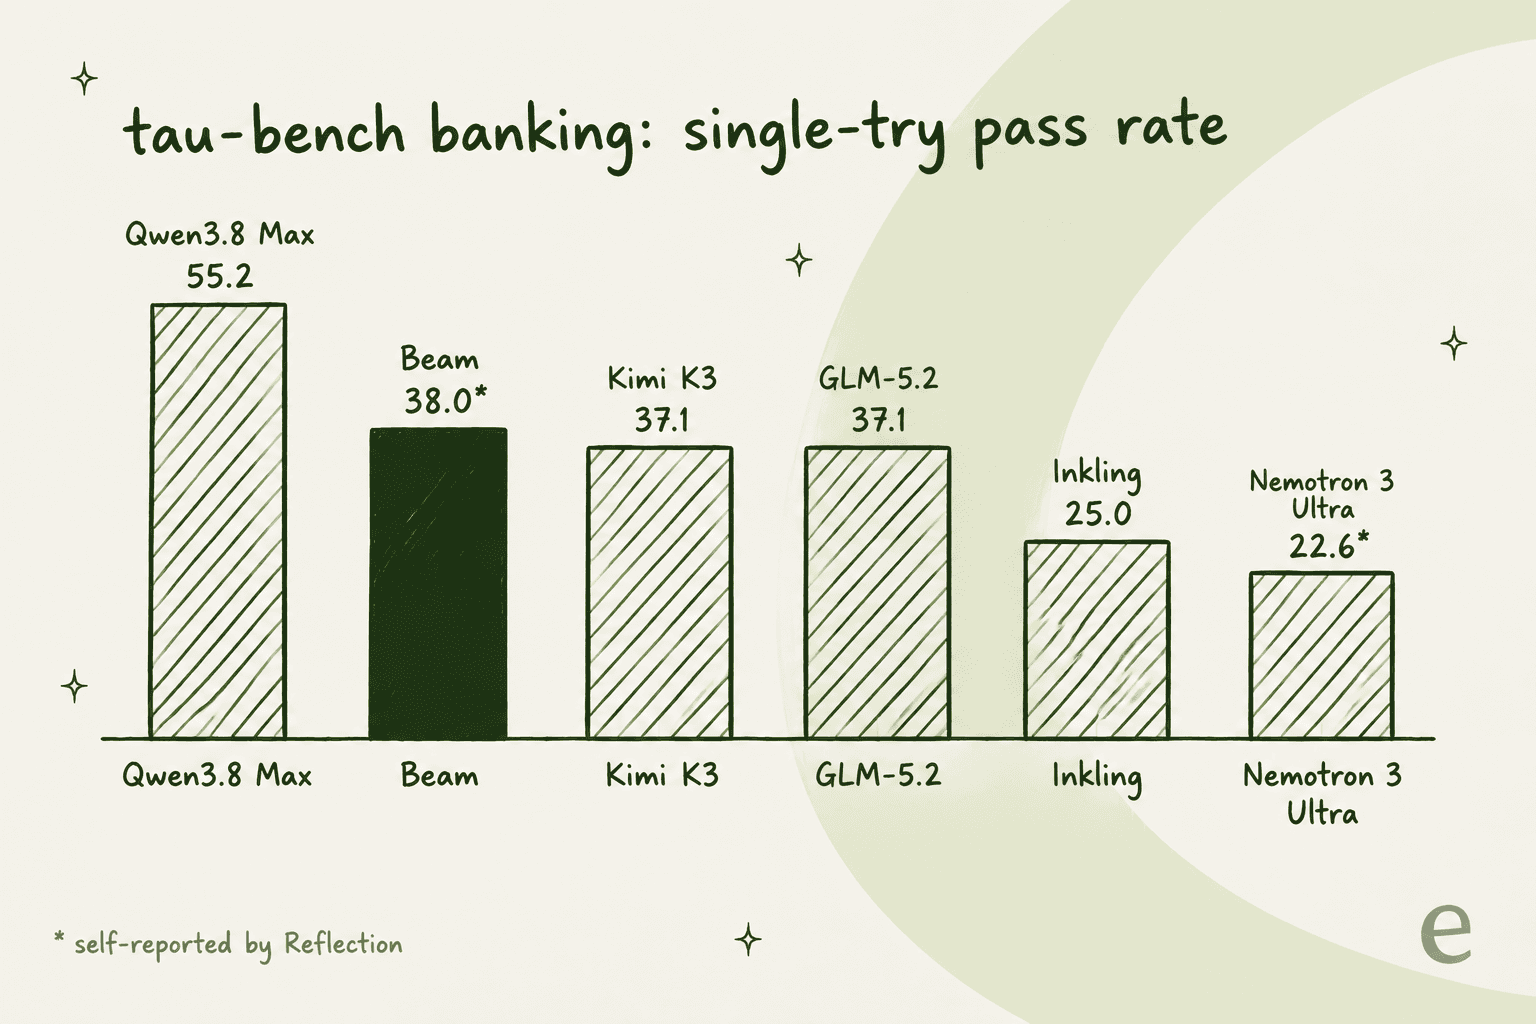
Les 38.0 de Beam sont à peu près au niveau de Kimi K3 et de GLM-5.2 (tous deux 37.1 sur le classement de Sierra) et bien derrière Qwen3.8 Max à 55.2. Reflection ne dit pas quelle configuration de test a donné ses 38.0, donc je le traiterais comme proche plutôt qu'exact. Tout le peloton baisse aussi dès qu'on demande de la constance : sur le classement de Sierra, Qwen3.8 Max passe de 55.2 à 35.1 quand une tâche doit réussir les quatre essais.
Ce dernier chiffre est la vraie leçon pour les équipes de support, et je l'ai traité en détail dans mon analyse du meilleur modèle d'IA pour les tickets de support : même le meilleur modèle ne réussit un ticket riche en politiques à chaque fois qu'environ un tiers du temps. Changer de modèle ne règle pas cela.
Ce qui le règle, c'est la couche autour du modèle, c'est-à-dire ancrer les réponses dans votre vraie base de connaissances et vos anciens tickets et escalader à un humain les réponses à faible confiance, plus des tests sur votre propre historique avant toute mise en ligne. Mon guide de mise en œuvre détaille cet ordre de déploiement.
J'ai vu cet échec se produire dans de vraies files. Une équipe de télématique automobile sur Zendesk avait un bot qui disait avec assurance aux clients « yes, we support your car model » pour des marques absentes de leur base de données, simplement parce qu'un article d'aide disait « we support all models. » Aucun score de benchmark ne l'aurait détecté, mais une simulation sur leurs propres anciens tickets, si.
Donc pour le support en particulier, Beam est un candidat raisonnable comme moteur une fois qu'il aura un prix et que les poids seront sortis, surtout si votre entreprise exclut les modèles d'origine chinoise. À lui seul, il n'est toutefois pas un agent de support. Pour cette partie, il vous faut un agent helpdesk IA qui connaît votre file, et mon tour d'horizon des helpdesks IA compare ceux qui le font.
Qui est Reflection AI ?
Reflection a été cofondée en 2024 par Misha Laskin (CEO) et Ioannis Antonoglou, tous deux anciens chercheurs de Google DeepMind. Dans son article de lancement, Laskin attribue son propre passage de la physique à l'IA à AlphaGo en 2016.
Beaucoup d'argent est derrière. L'article de Reflection annonçait une levée de $2 billion en 2025 auprès d'investisseurs dont NVIDIA, Sequoia, Lightspeed, DST, CRV et Eric Schmidt, et sa salle de presse indique une valorisation pre-money de $25 billion pour son tour d'avril 2026. Dans l'article de lancement, Laskin plaide aussi pour le choix de l'ouvert :
"Open also means safer. The best defence is a distributed one."
Antonoglou a ajouté sur X que l'équipe est « already training the next, larger model. » Beam est donc explicitement le premier d'une série.
Une précision est aussi apparue sur HN : ce Reflection n'a aucun lien avec le modèle « Reflection 70B » de 2024. Un commentateur a corrigé la confusion dans le fil de lancement, et la personne qui l'avait soulevée s'est rétractée.
Alors, faut-il attendre Beam ?
Voici où j'atterrirais, selon le lecteur :
| Si vous êtes... | Mon verdict |
|---|---|
| Une équipe qui a besoin d'un modèle ouvert conçu aux États-Unis (gouvernement, secteurs régulés, politique « sans origine chinoise ») | Inscrivez-vous dès maintenant sur la liste d'attente et prévoyez une évaluation début novembre |
| En train de construire des agents de code avec un petit budget aujourd'hui | Utilisez DeepSeek V4 Flash ou GLM dès maintenant, retestez Beam quand il sera sur Artificial Analysis |
| À la recherche du modèle ouvert le plus puissant | Kimi K3 ou Qwen3.8 Max, selon le tableau de Reflection lui-même |
| En projet d'auto-hébergement | Attendez les poids FP8 et NVFP4, puis dimensionnez selon la mémoire pour 501B, pas selon le calcul pour 23B |
| En train de choisir un modèle pour une file de support | Choisissez d'abord l'agent, puis le modèle ; voir ci-dessous |
eesel pour les équipes de support qui suivent la course aux modèles
Si vous êtes arrivé ici parce que vous choisissez un modèle pour répondre aux clients, le raccourci est que vous n'avez pas à parier votre file sur un seul lancement. Le coéquipier helpdesk IA d'eesel se branche sur Zendesk, Freshdesk ou Gorgias et apprend de vos anciens tickets et de votre centre d'aide, puis lance une simulation sur votre historique réel de tickets avant de répondre à qui que ce soit. Quand un modèle meilleur ou moins cher sort, le coéquipier s'améliore et vous n'avez rien à reconstruire.

Cela fonctionne aussi pour le public du terminal qui lit un article sur Beam. Avec la CLI eesel, vous pouvez piloter le même coéquipier depuis un shell, pour des choses comme connecter un helpdesk, modifier ses instructions permanentes, approuver ou refuser les actions en attente et lire son journal d'activité. Chaque commande renvoie du JSON, et un flag --dry-run montre l'appel exact avant son envoi. De plus, chaque workspace est un serveur MCP, si bien qu'un agent de code comme Claude Code peut le piloter directement.
Les résultats arrivent généralement vite quand l'agent s'appuie sur vos propres données. Voici comment Gridwise l'a formulé après son essai :
"In the first month, eesel is resolving 73% of our tier 1 requests."

Essayez eesel gratuitement avec 100 crédits, sans carte, ou consultez les forfaits payants sur la page des tarifs.