

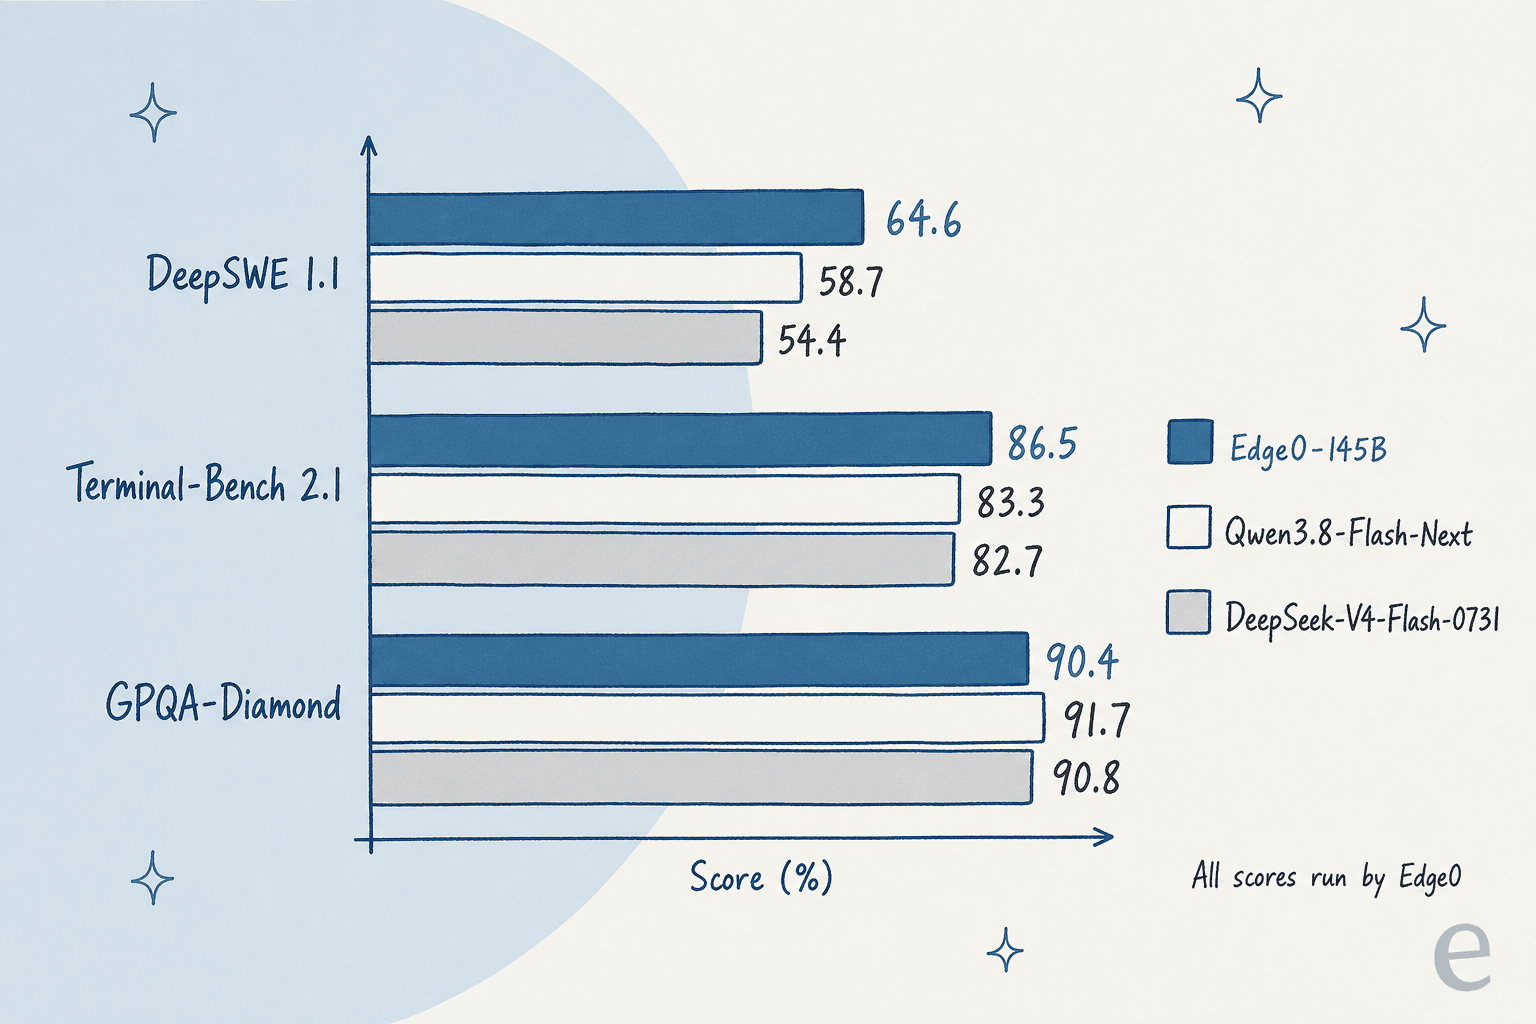
Edge0-145B est un modèle de 145 milliards de paramètres conçu pour tourner sur une seule carte graphique grand public, et l'ingénierie derrière est réelle. Dans ses propres tests, Edge0 obtient 86.5 sur Terminal-Bench 2.1 et 64.6 sur DeepSWE 1.1, devant son modèle de base, Qwen3.8-Flash-Next.
Les annonces de lancement ont toutefois besoin de nuances. Le chiffre de "29 Go" laisse de côté environ 31 Gio de RAM système, le support macOS n'est pas dans la sortie, et les poids portent une licence qui restreint les services commerciaux. Mon verdict : 3/5, ça vaut le coup de le tester sur une machine NVIDIA, mais pas encore le coup de reconstruire votre pile autour.
Pour les équipes de support qui recherchent la confidentialité, le modèle compte moins que ce que le bot a le droit de lire. eesel répond uniquement à partir de vos connaissances validées, et avec le CLI eesel, n'importe quel agent de code peut téléverser ces connaissances et poser des questions de test avant que quoi que ce soit ne soit mis en service.
Comment j'ai évalué Edge0-145B
Edge0 a publié la sortie le 13 novembre, donc cet avis a été écrit deux jours après. Je construis des intégrations et des API chez eesel, donc je lis des sorties comme celle-ci de la même façon que je lis la documentation de n'importe quel fournisseur : l'article de lancement vous dit ce qu'ils veulent vous faire croire, et le README vous dit ce qui est réellement livré. J'ai travaillé à partir de trois sources, dans cet ordre de confiance :
- Les propres fichiers de sortie d'Edge0. Le README GitHub, la fiche du modèle sur Hugging Face, et le fichier de provenance de licence dans le dépôt. Ceux-ci portent les chiffres mesurés.
- L'article de lancement d'Edge0. Utile pour l'intention et les démos, mais là où il contredit le README, je fais confiance au README.
- Les premiers utilisateurs. Le fil de lancement sur Hacker News a dépassé 330 points et 100 commentaires, avec quelques personnes l'essayant sur leur propre matériel.
Je n'ai pas lancé ma propre suite de benchmarks, et aucun laboratoire indépendant comme Artificial Analysis n'avait de page pour Edge0-145B le 14 novembre. Traitez chaque score ci-dessous comme venant d'Edge0. Si vous voulez d'abord le paysage plus large des modèles, les articles de mes collègues sur DeepSeek V4 Flash et Qwen 4 Max couvrent les deux familles auxquelles Edge0 se compare.
Qu'est-ce qu'Edge0-145B ?
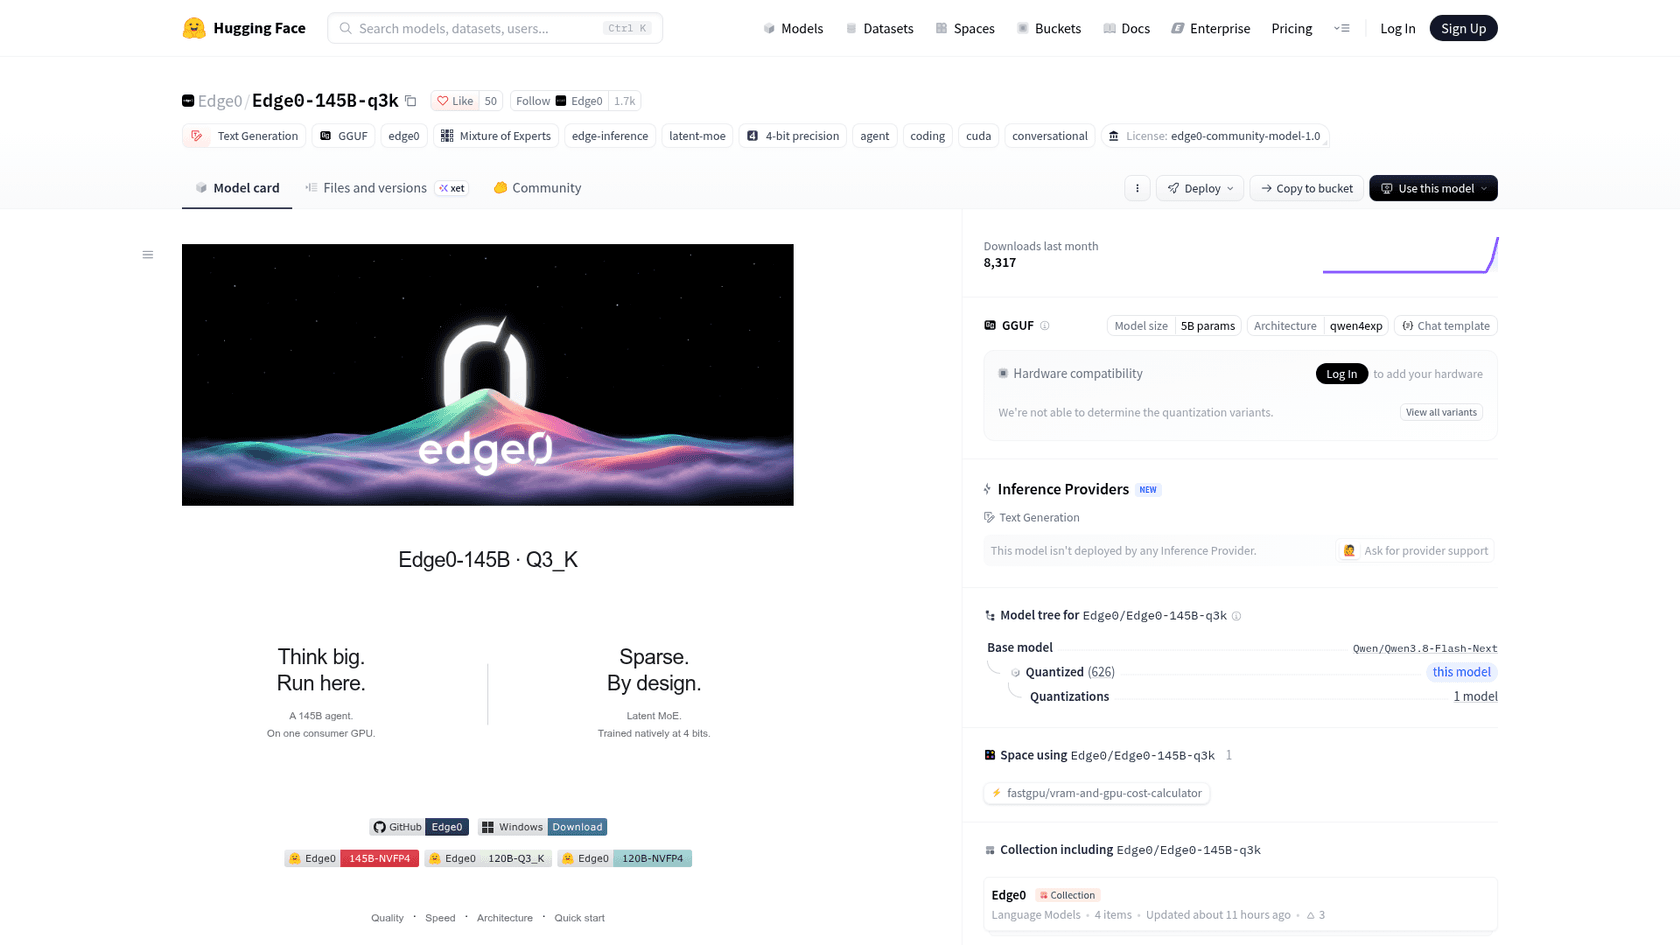
Edge0-145B est un modèle de mélange d'experts latent d'Edge0, une équipe qui a précédemment livré le modèle pour téléphone Edge0-35B en septembre et les modèles vocaux Audio8. Il a 145 milliards de paramètres au total mais seulement environ 10.12 milliards actifs par token, ce qui explique comment il tient sur du matériel qui ne pourrait jamais contenir un modèle dense de 145 milliards.
Voici ce que dit la fiche du modèle à son sujet :
| Spécification | Edge0-145B | Edge0-120B |
|---|---|---|
| Paramètres totaux / actifs | 145B / 10.12B | 120B / non indiqué |
| Couches et experts | 48 couches, 512 experts, 10 routés + 1 partagé par token | Identique |
| Largeur latente des experts | 1,792 | 1,280 |
| Fenêtre de contexte | 256K (KV int8, 32K résidant) | 256K |
| Builds sur Hugging Face | Q3_K (40.81 Gio), NVFP4 (47.79 Gio) | Q3_K (27.98 Gio), NVFP4 (32.96 Gio) |
| Modèle de base | Qwen3.8-Flash-Next | Qwen3.8-Flash-Next |
| Moteur | edge0-strata (fork de Strata) | edge0-strata |
Deux lignes de ce tableau racontent la plus grande partie de l'histoire. Le modèle de base est Qwen, et le moteur est un fork du projet open source Strata. Edge0 le dit clairement dans le README, même si l'article de lancement ne mentionne jamais Qwen. C'est cet écart que la plupart des premiers commentateurs ont relevé :
"Based on Qwen3.8-Flash-Next and Strata. They made some interesting tweaks and did some fine tuning on the model, but it's interesting how much marketing speak was layered on their website to hide this fact."

Être un dérivé n'est pas un défaut. La plupart des bons modèles ouverts partent aujourd'hui de la base de quelqu'un d'autre, et la vraie question est de savoir si les changements d'Edge0 apportent quelque chose. Sur ce point, la réponse semble être oui.
Ce qu'Edge0-145B fait bien
Trois choses se sont démarquées, et elles concernent toutes l'ingénierie plutôt que l'intelligence brute.
La conception des experts est astucieuse
Edge0 partage deux grandes matrices entre chaque groupe de 64 experts, et chaque expert ne garde qu'un petit ensemble de ses propres paramètres. La fiche du modèle détaille le résultat : chaque expert est un enregistrement fixe de 1,630,720 octets, donc le moteur peut garder quelques milliers des experts les plus sollicités sur la carte graphique et diffuser le reste depuis la mémoire système. Le coût de cette diffusion suit le nombre d'experts qui restent résidents, pas la taille du modèle.
Edge0 a aussi entraîné le modèle sous cette forme dès le départ, nativement en 4 bits, plutôt que de réduire un modèle cloud après coup. Le décodage spéculatif via une tête brouillon de 1.26 milliard répartit le coût de chaque lecture de poids sur plusieurs tokens de sortie. Rien de tout cela n'est magique, mais c'est un travail soigné, et c'est pour cela qu'un modèle de 145 milliards tourne du tout sur une carte de 24 Go.
Ses scores de code et d'agent dépassent son modèle de base
Le tableau de benchmarks d'Edge0 montre les plus grands gains là où ils comptent pour les agents locaux :
| Modèle | DeepSWE 1.1 | Terminal-Bench 2.1 | HLE | GPQA-Diamond | IFBench | AA-LCR |
|---|---|---|---|---|---|---|
| Edge0-145B | 64.6 | 86.5 | 35.4 | 90.4 | 80.6 | 79.3 |
| Edge0-120B | 51.3 | 75.3 | 31.0 | 87.4 | 79.3 | 81.0 |
| Qwen3.8-Flash-Next | 58.7 | 83.3 | 35.9 | 91.7 | 81.3 | 79.1 |
| DeepSeek-V4-Flash-0731 | 54.4 | 82.7 | 33.8 | 90.8 | 79.2 | 79.7 |
| Qwen3.8-27B | 42.2 | 73.0 | 30.8 | 89.2 | 79.5 | 82.0 |
| Claude Opus 4.6 (Max) | n/a | 78.2 | 40.0 | 91.3 | 62.5 | 78.0 |
Le schéma est honnête d'une certaine façon : Edge0-145B dépasse sa base sur les deux benchmarks d'agent et reste légèrement en retrait sur la connaissance et le raisonnement (GPQA, HLE, IFBench). C'est ce à quoi on s'attendrait d'un fine-tuning visant les agents de code. Terminal-Bench en particulier tend à refléter la capacité d'un modèle à piloter un shell, et un premier utilisateur l'a remis en contexte :
"This score is roughly on par with 5.6 Terra max, which in my direct experience is perfectly capable of driving a cloud agent harness that can do pretty complex knowledge work."
Si vous préférez comparer avec les modèles hébergés actuels, les avis de mes collègues sur GPT-6.1 Terra et Claude Opus 5.5 ont les chiffres indépendants que le tableau d'Edge0 n'a pas.
Il est rapide sur le bon matériel
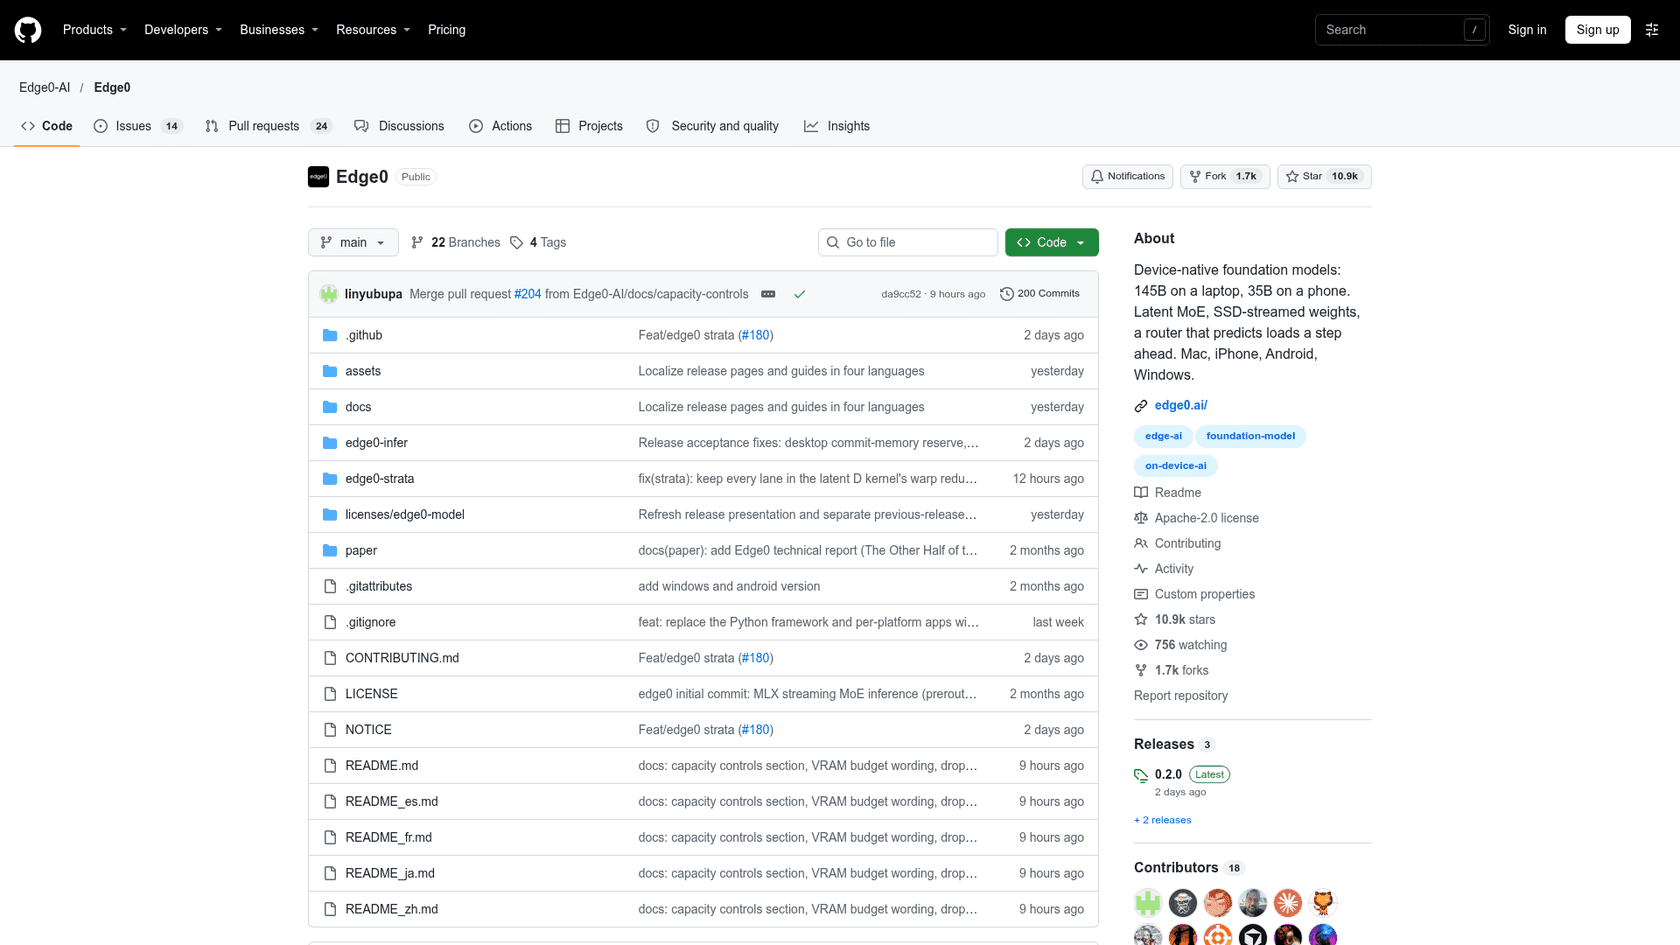
Sur la propre machine RTX 5090 D 24 Go d'Edge0, la build Q3_K a atteint 121.2 tokens par seconde en décodage agent et 3,554.9 tokens par seconde sur un préremplissage de 16K tokens. C'est assez rapide pour qu'une boucle de code locale paraisse interactive. Les démos de lancement (une scène de ville dans Blender, un programme de drone, une carte KiCad) montrent à quoi sert cette vitesse : des dizaines de cycles de planification, d'exécution et de vérification sans facture par token. La page GitHub d'Edge0 a le tableau de vitesse complet et une vidéo de présentation de deux minutes.
Où Edge0-145B montre ses limites
Ici, l'article de lancement et les fichiers de sortie racontent des histoires différentes. Chaque point ci-dessous vient des propres documents d'Edge0.
"29 Go de mémoire maximale" n'est pas toute l'empreinte
L'article de lancement met en avant 29 Go de mémoire maximale et dit que le modèle tourne sur un ordinateur portable de 48 Go. Le même article décrit plus loin une bibliothèque d'experts d'environ 40 Go en RAM système et environ 48 Go de données de vocabulaire sur le SSD. Les chiffres mesurés du README tranchent la question :
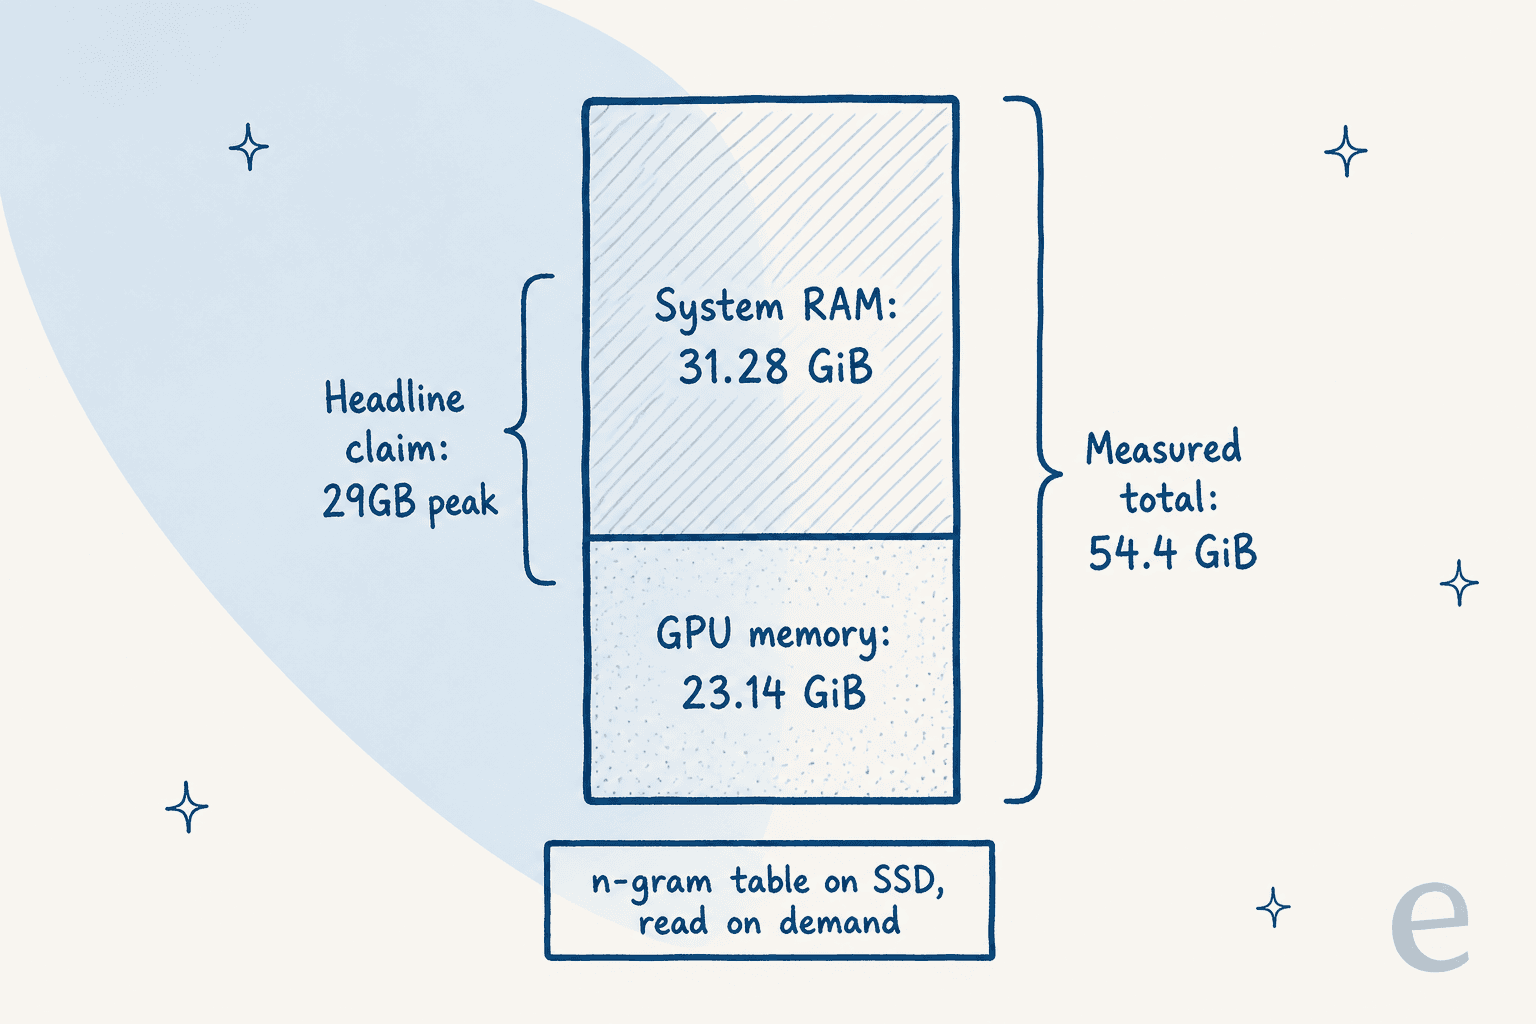
Avec la résidence des experts activée, la build Q3_K a utilisé 23.14 Gio de mémoire GPU plus 31.28 Gio de RAM système. La build NVFP4 a utilisé 23.25 Gio plus 38.27 Gio. Le chiffre de 29 Go ressemble à une seule tranche de cela, le plus probablement le côté GPU plus une marge, présenté comme le total.
Pour être juste envers Edge0, il a aussi fait tourner le modèle dans un budget plus serré : 16 Gio de VRAM et 20 Gio de RAM, avec des experts non mis en cache lus depuis le SSD. Cela a tout de même fonctionné, à 36.8 tokens par seconde en chat et 44.9 en mode agent. Donc une machine plus petite peut le faire tourner, juste beaucoup plus lentement. Un lecteur de Hacker News qui avait espéré le faire tourner sur un MacBook de 48 Go a résumé la déception :
"If we're talking about ~70GB combined RAM footprint then that's not going to cut it. Still very interesting though."
macOS est dans l'article de lancement, pas dans la sortie
L'article de lancement dit que le support dès le premier jour couvre macOS, Windows et Linux, y compris les puces Apple de la série M. Le tableau des plateformes du README dit quelque chose de plus restreint : les modèles 145B et 120B tournent sur Linux ou Windows avec un GPU NVIDIA et CUDA 13, et les colonnes macOS, iOS et Android sont vides pour eux. Edge0 a bien publié un résultat sur un Apple M2 Ultra (57.0 tokens par seconde en décodage agent) et ajoute que cela "n'établit pas la disponibilité de la sortie sur macOS". L'application de bureau Edge0 Chat n'est pour l'instant que sous Windows.
Voici ce que cela signifie en pratique :
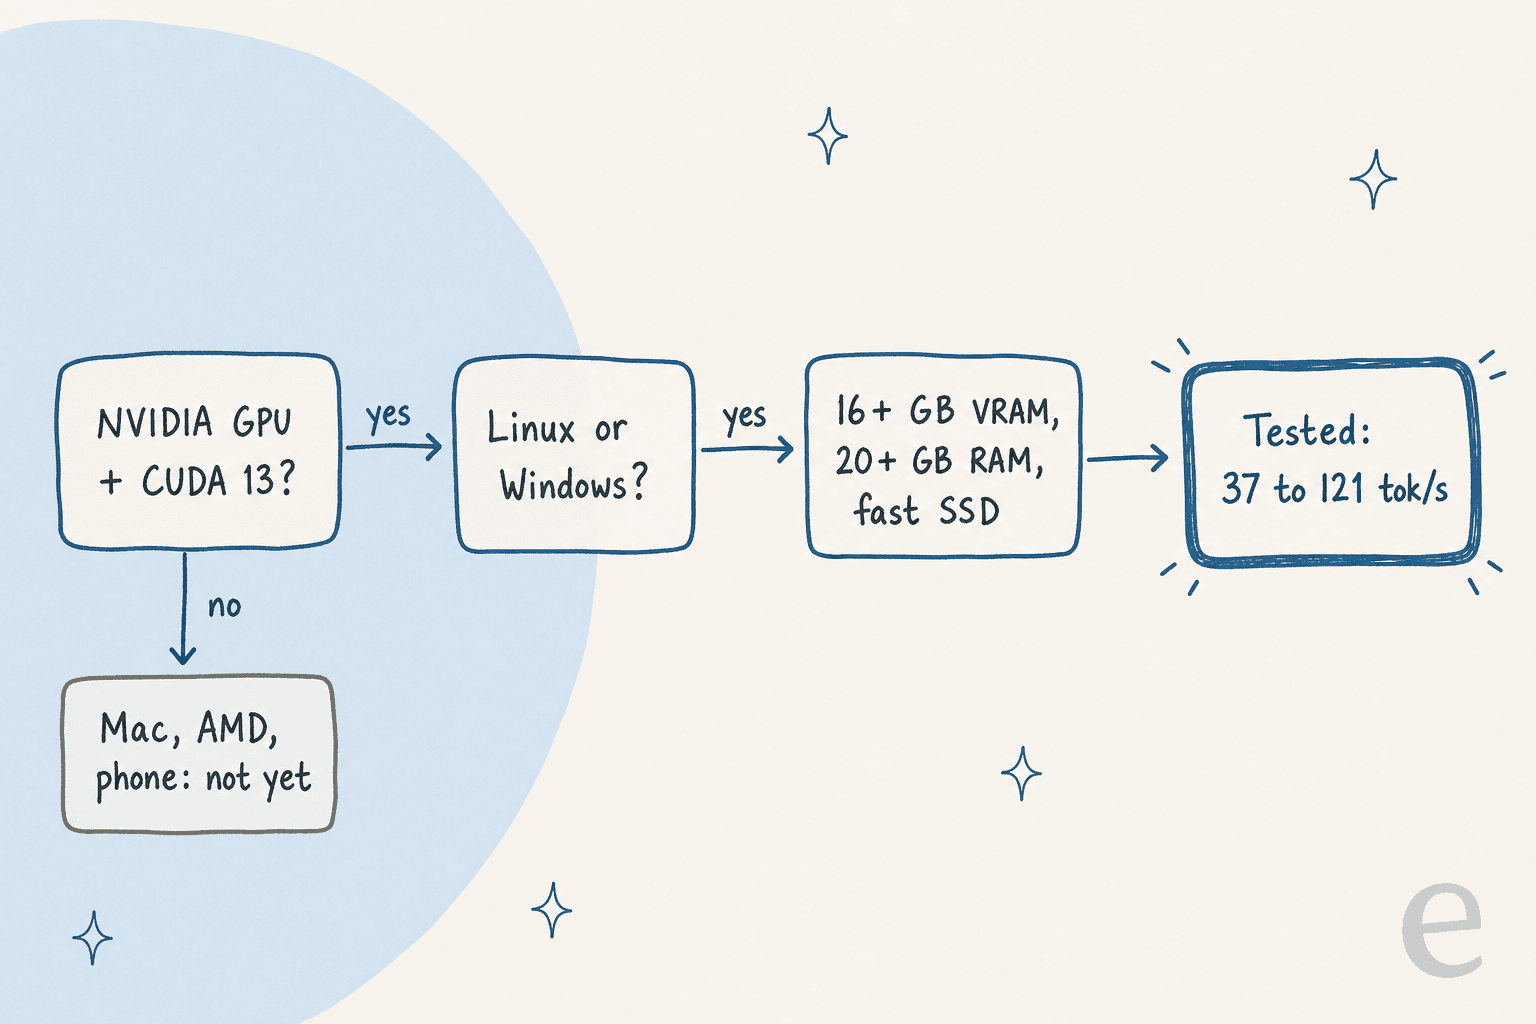
Les utilisateurs Mac peuvent toujours faire tourner l'ancien Edge0-35B sur Metal. Pour le 145B, il vous faut aujourd'hui une machine NVIDIA.
Les benchmarks sont autodéclarés, et ils ne s'accordent pas totalement
Chaque score d'Edge0, Qwen, DeepSeek et Claude dans le tableau vient des évaluations internes d'Edge0. Edge0 dit que la configuration complète et les étapes de reproduction sont "en cours de publication avec notre rapport technique", et le seul rapport technique publié jusqu'ici couvre le modèle 35B. Les chiffres bougent aussi entre les documents : l'article de lancement liste Edge0-120B à 53.6 sur DeepSWE et 81.3 sur Terminal-Bench, tandis que le README liste 51.3 et 75.3.
Les premiers retours d'utilisation pratique sont mitigés. Un testeur sur une NVIDIA DGX Spark n'a pas pu obtenir de réponse utile :
"It spent 8,000+ tokens at default thinking and never produced a coherent answer."
Un seul test n'est pas un verdict, mais c'est une raison d'attendre un classement indépendant avant de faire confiance au tableau. L'avis sur DeepSeek V4.1 Flash de mes collègues montre à quoi cela ressemble quand un laboratoire a fait tourner les chiffres lui-même.
"Open source" vient avec un piège commercial
L'article de lancement dit qu'Edge0 "ouvre le code source" des modèles. Le code du framework est en Apache 2.0, et Strata reste en MIT. Les poids sont différents. La fiche du modèle les place sous la Edge0 Community Model License 1.0, les matériaux de Qwen restant sous la Qwen Community License. L'usage personnel, la recherche, la modification, l'usage interne et l'usage commercial des sorties sont autorisés. Vendre ou regrouper le modèle, faire tourner un service de modèle commercial, ou proposer un assistant de code ou de bureautique commercial, nécessite une licence écrite séparée.
Pour un amateur ou une équipe d'outillage interne, c'est acceptable. Pour quiconque prévoit de construire un produit dessus, lisez la licence avant le README. L'avis sur Hugging Face sur notre blog couvre comment ces licences personnalisées apparaissent à travers tout le hub.
Edge0-145B face aux alternatives
Voici comment je le placerais à côté de ce qu'un développeur envisagerait réellement cette semaine :
| Si vous voulez... | Choisissez | Pourquoi |
|---|---|---|
| L'agent de code local le plus fort sur une seule carte NVIDIA | Edge0-145B | Meilleurs scores autodéclarés Terminal-Bench et DeepSWE de sa classe, 91.7 à 121.2 tok/s sur des cartes de 24 Go |
| La même famille avec moins de surprises | Qwen3.8-Flash-Next | Le modèle de base, un support d'exécution plus large, des scores proches en raisonnement |
| Un modèle local sur un Mac dès aujourd'hui | Edge0-35B ou un autre modèle ouvert compatible Metal | Edge0-145B n'a pas encore de runtime macOS |
| Des benchmarks indépendants et pas de matériel | DeepSeek V4 Flash ou Kimi K3.1 Pro | Hébergés, mesurés par des tiers, prix bas par token |
| La qualité de pointe, et vous êtes prêt à la payer | Claude Opus 5.5 ou GPT-6 Sol | Toujours en tête sur le raisonnement le plus difficile |
Si c'est le coût qui vous pousse vers le local, faites d'abord le calcul. Les guides sur les prix de l'API Anthropic et les prix de l'API OpenAI vous aident à comparer les factures par token à un GPU qui consomme aussi environ 120W pendant qu'il travaille.
Mon verdict sur Edge0-145B
| Domaine | Note | Remarque |
|---|---|---|
| Ingénierie | 4.5/5 | Les experts à matrices partagées et la diffusion depuis SSD sont une vraie avancée pour l'inférence locale |
| Scores de code et d'agent | 4/5 | Forts, mais seulement autodéclarés |
| Honnêteté des annonces de lancement | 2/5 | 29 Go, macOS et "open source" ont tous besoin de nuances |
| Facilité d'installation | 2.5/5 | Compiler depuis les sources, NVIDIA plus CUDA 13 uniquement, application Windows seulement |
| Licence | 2.5/5 | Correcte pour un usage interne, restrictive pour des produits |
Au global : 3/5. Si vous avez une RTX 4090 ou 5090 et voulez un agent de code local, cela vaut un après-midi. Si vous êtes sur Mac, en train de planifier un produit, ou avez besoin d'une preuve indépendante, attendez le rapport technique et un classement tiers. Les développeurs qui utilisent déjà Claude Code peuvent l'essayer via son point de terminaison local compatible Anthropic, même si je n'ai pas testé cette combinaison moi-même.
Ce que cet avis signifie pour les équipes de support
L'argument qui atteindra les responsables du support est la confidentialité : faire tourner le modèle sur votre propre matériel, et les données des tickets ne quittent jamais le bâtiment. Je comprends l'attrait. Lors des appels commerciaux, la question des données est souvent la première. Un évaluateur technique dans une entreprise de matériel semi-conducteur nous a demandé si le bot se rabattrait sur "un autre ChatGPT" quand il ne connaissait pas une réponse, et si cela pouvait être désactivé. Un acheteur danois de télématique s'inquiétait des numéros de carte et des mots de passe présents dans les tickets.
Aucune des deux préoccupations ne portait vraiment sur l'endroit où tourne le modèle. Les deux portaient sur ce que l'IA a le droit de lire et de dire. Un modèle local qui répond à partir de son entraînement général est toujours "l'autre ChatGPT" dont cet évaluateur s'inquiétait. Ce qui a résolu le problème pour eux, c'est un agent qui répond uniquement à partir de connaissances validées et le dit quand il ne sait pas, plus la masquage des champs sensibles.
C'est ainsi que fonctionne eesel, et c'est pourquoi je présenterais Edge0 comme de l'infrastructure, tandis qu'eesel est l'employé. Vous embauchez un collègue IA pour le helpdesk qui rejoint votre helpdesk existant, apprend de votre centre d'aide, de vos macros et de vos réponses passées, et est simulé sur des tickets historiques avant de parler aux clients. La licence d'Edge0 bloquerait aussi la plupart de ce qu'un fournisseur de support fait avec un modèle, puisqu'un service de modèle commercial nécessite un accord séparé.
Deux clients montrent à quoi ressemble une mise en place soignée. Dokument 24, un service danois de documents juridiques, fait rédiger par eesel des réponses en danois sous forme de notes internes à partir d'environ 2 600 pages web et d'éléments Zendesk, et la note le précise quand la connaissance ne couvre pas une question. smava, une entreprise allemande de comparaison de prêts dans la finance réglementée, fait passer environ 27 000 tickets Zendesk par mois dans eesel, qui en a catégorisé 14 600 et préparé 15 300 réponses brouillon en attente de l'approbation d'un conseiller.
Pour en savoir plus sur le fait de garder les bots ancrés dans la réalité, voyez notre guide sur les hallucinations IA dans le support, l'explication sur MCP pour le support client, et le récapitulatif des plateformes de chatbot open source si l'auto-hébergement est une exigence absolue.
Essayez eesel
Si vous lisez un avis sur Edge0-145B parce que votre équipe de support veut de l'IA sans confier les tickets à une boîte noire, commencez par la partie qui décide vraiment de la confidentialité et de la précision : ce que l'agent lit et quand il transfère. eesel se connecte à Zendesk, Freshdesk et aux autres grands helpdesks, répond uniquement à partir de vos connaissances validées, et vous laisse regarder comment il répond à de vrais tickets passés avant sa mise en service. Les tarifs sont un forfait de crédits mensuels fixe, pas par siège.
Les développeurs peuvent piloter le même espace de travail depuis le CLI eesel. Un agent de code, même un pointant vers un modèle local, peut téléverser des connaissances validées comme des articles d'aide exportés et des réponses enregistrées, ajuster les instructions du collègue IA, et poser des questions de test pour vérifier les réponses. Connecter le helpdesk lui-même nécessite toujours une personne avec un accès admin pour l'approuver.
Essayez eesel gratuitement, ou réservez une démo pour le voir tourner sur vos propres tickets.