

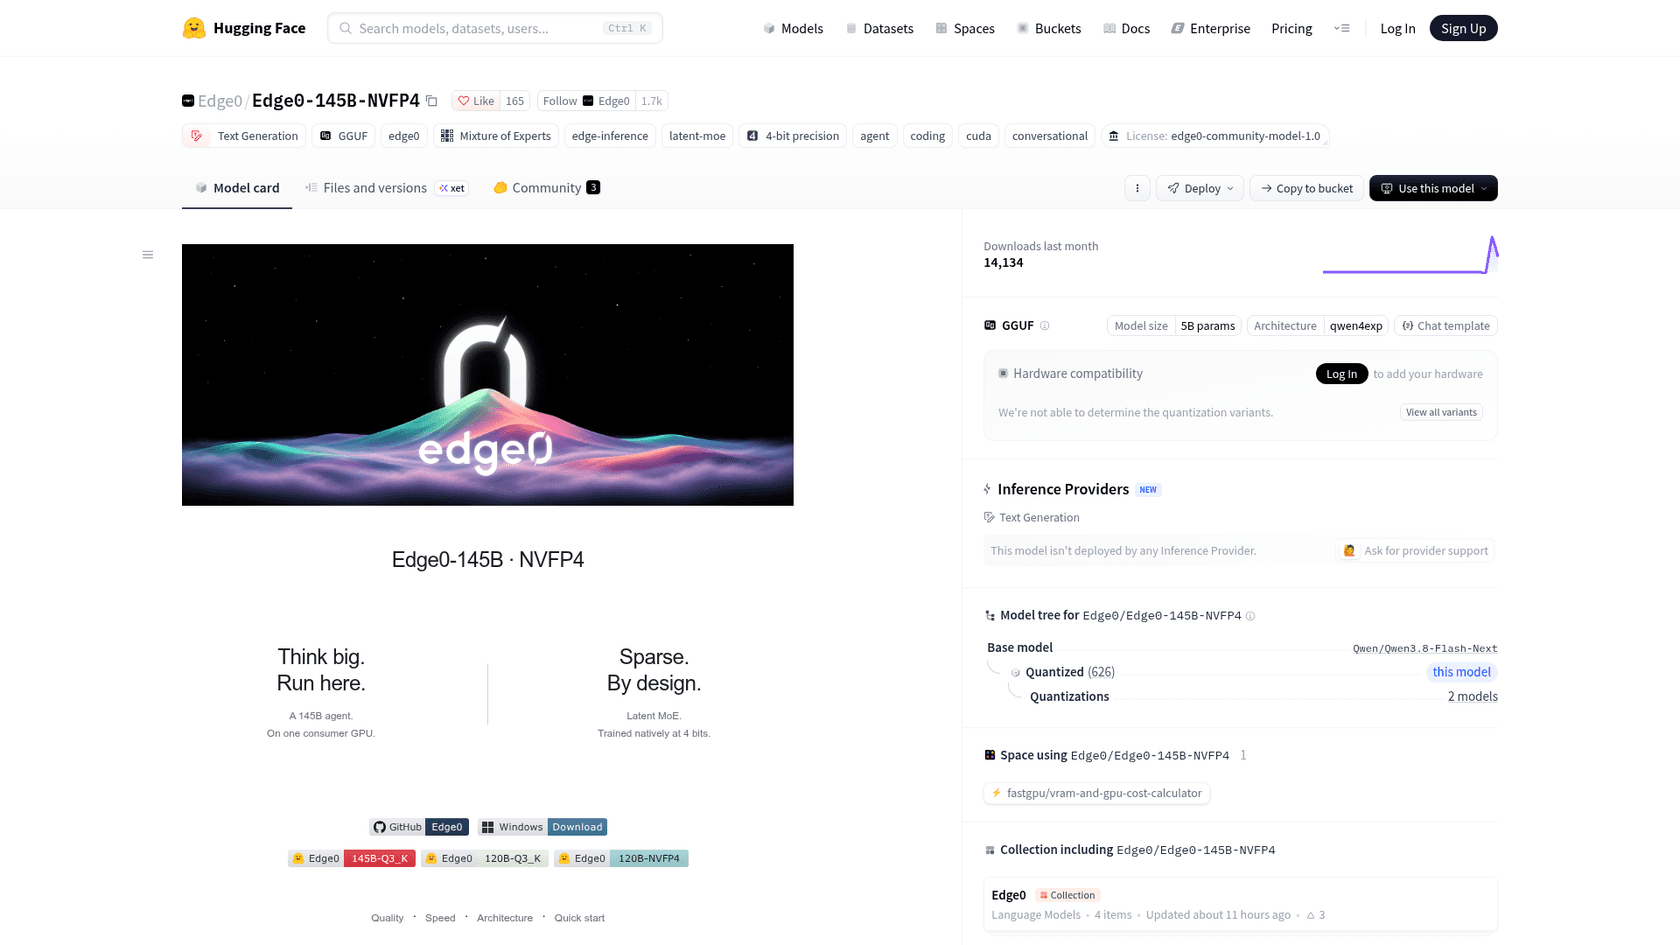
Edge0-145B est un modèle gratuit de code et d'agents à poids ouverts de 145B qui tourne sur une seule carte NVIDIA avec 16 GiB de mémoire plus 20 GiB de RAM système, en gardant les experts « chauds » sur la carte et en lisant le reste depuis la RAM et le SSD. C'est une version fortement retravaillée de Qwen3.8-Flash-Next, et dans les propres tests d'Edge0, il bat cette base en code. Deux choses que le post de lancement glisse dessus : macOS n'est pas encore pris en charge, et la licence bloque les services de modèle commerciaux sans accord séparé. Si ton objectif est de l'IA sur les tickets de support plutôt qu'une carte graphique locale, eesel fait ça avec des modèles hébergés, et le CLI eesel laisse un agent de code envoyer des articles d'aide approuvés et tester les réponses avant que quoi que ce soit ne passe en direct.
Qu'est-ce qu'Edge0-145B ?
Edge0-145B est un modèle de langage à poids ouverts d'Edge0, annoncé le 12 novembre 2026 aux côtés d'un petit frère, Edge0-120B. Le post de lancement d'Edge0 le présente comme le premier modèle de 145 milliards de paramètres conçu pour tourner sur un ordinateur personnel, avec des capacités de code, de raisonnement et d'agent proches des modèles cloud.
Je construis les agents IA du produit d'eesel, donc je lis ce genre de lancement d'abord pour le mécanisme, ensuite pour le marketing. Ça s'est révélé important ici, car la model card Hugging Face et le repo GitHub racontent une histoire plus précise que le post de lancement. Je n'ai pas de carte RTX sur mon bureau, donc tout ce qui suit vient de ces documents et des notes de version, pas d'un test personnel. Pour un verdict sur la qualité, le test d'Edge0-145B de mon collègue entre là-dedans séparément.
Voici ce qu'Edge0 a publié sur le modèle lui-même :
| Caractéristique | Edge0-145B |
|---|---|
| Paramètres totaux | 145B, dont environ 10.12B actifs par token |
| Modèle de base | Dérivé de Qwen3.8-Flash-Next |
| Architecture | Mélange d'experts épars latent, 48 couches, 512 experts par couche |
| Experts par token | 10 routés plus 1 partagé |
| Contexte | 256K tokens (cache KV en int8, 32K gardés sur la GPU) |
| Builds | Q3_K à 40.81 GiB, NVFP4 à 47.79 GiB |
| Décodage spéculatif | Draft head intégré de 1.26B |
| Moteur | edge0-strata, lancé via edge0-infer |
| Plateformes aujourd'hui | Linux et Windows, carte NVIDIA avec CUDA 13 |
| Licence | Edge0 Community Model License 1.0 plus la Qwen Community License |
Le modèle de base est la partie que le post de lancement enterre. La model card liste Qwen/Qwen3.8-Flash-Next comme base, et les remerciements créditent à la fois Qwen et le moteur d'inférence ouvert Strata. C'est une pratique normale dans les poids ouverts, et c'est utile à savoir : si tu fais déjà tourner Qwen3.8-Flash-Next, Edge0-145B est une version réarchitecturée et réentraînée d'un modèle que tu connais, pas une famille sans rapport.
Comment un modèle de 145B tient-il sur une seule carte ?
Il ne tient pas, pas en entier à la fois. L'astuce, c'est que seuls environ 10B des 145B paramètres travaillent sur un token donné, donc le moteur n'a besoin que de ceux-là près de la carte. Edge0 combine quatre idées pour y arriver :
- Matrices d'experts partagées. Dans un modèle de mélange d'experts classique, chaque expert stocke son propre ensemble complet de poids. Edge0 projette chaque token vers une largeur « latente » plus petite, et les grandes matrices de projection sont partagées entre experts. Chaque expert ne garde qu'un petit enregistrement (environ 1.6 Mo), donc des milliers d'entre eux tiennent dans la mémoire de la carte.
- Trois niveaux de stockage. Les experts fréquemment utilisés vivent sur la carte. Le reste reste dans la RAM système. Une table de correspondance de 51.2B de paramètres, que le modèle consulte rarement, reste sur le SSD et est lue à la demande.
- CPU et GPU ensemble. La carte calcule les experts qu'elle détient déjà pendant que le CPU gère les autres en parallèle.
- Décodage spéculatif. Un petit draft head de 1.26B propose plusieurs tokens, et le modèle principal les vérifie en une seule passe, ce qui répartit le coût de lecture des poids sur plus de sortie.
Edge0 a aussi entraîné le modèle sous cette forme dès le départ, plutôt que de compresser un modèle cloud après coup. L'architecture explique à la fois la bonne nouvelle (il tourne sur une carte gaming) et le piège (il dépend fortement de la vitesse de la RAM système et du SSD), ce dont parle la section suivante.
De quel matériel as-tu vraiment besoin ?
C'est là que le post de lancement et les fichiers de version ne sont pas d'accord. Le titre du post de lancement est « 29 Go de mémoire au pic » sur « un ordinateur portable personnel compatible, comme un MacBook Pro ». Les fichiers donnent une image plus complète.
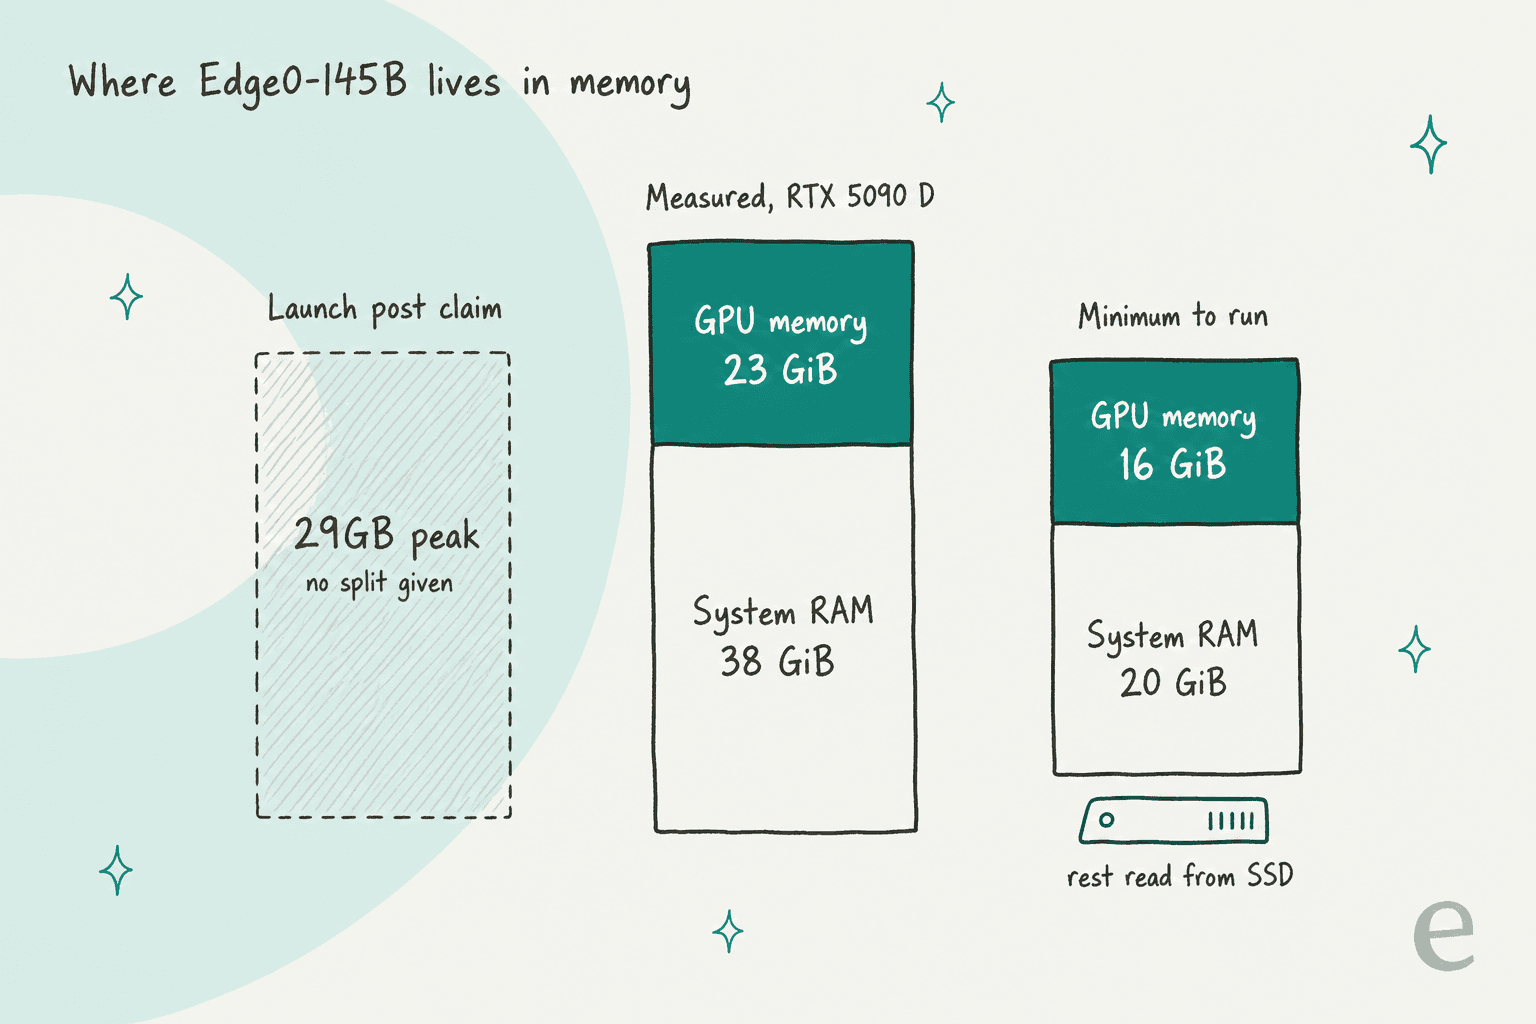
Les notes de version v0.2.0 fixent le minimum pour Windows x64 : une carte NVIDIA de capacité de calcul 7.5 ou plus récente (séries RTX 20, 30, 40 ou 50), au moins 16 GiB de mémoire GPU, 20 GiB de mémoire système, et le CUDA Toolkit 13. Sur Windows Arm64, la cible est la RTX Spark N1X.
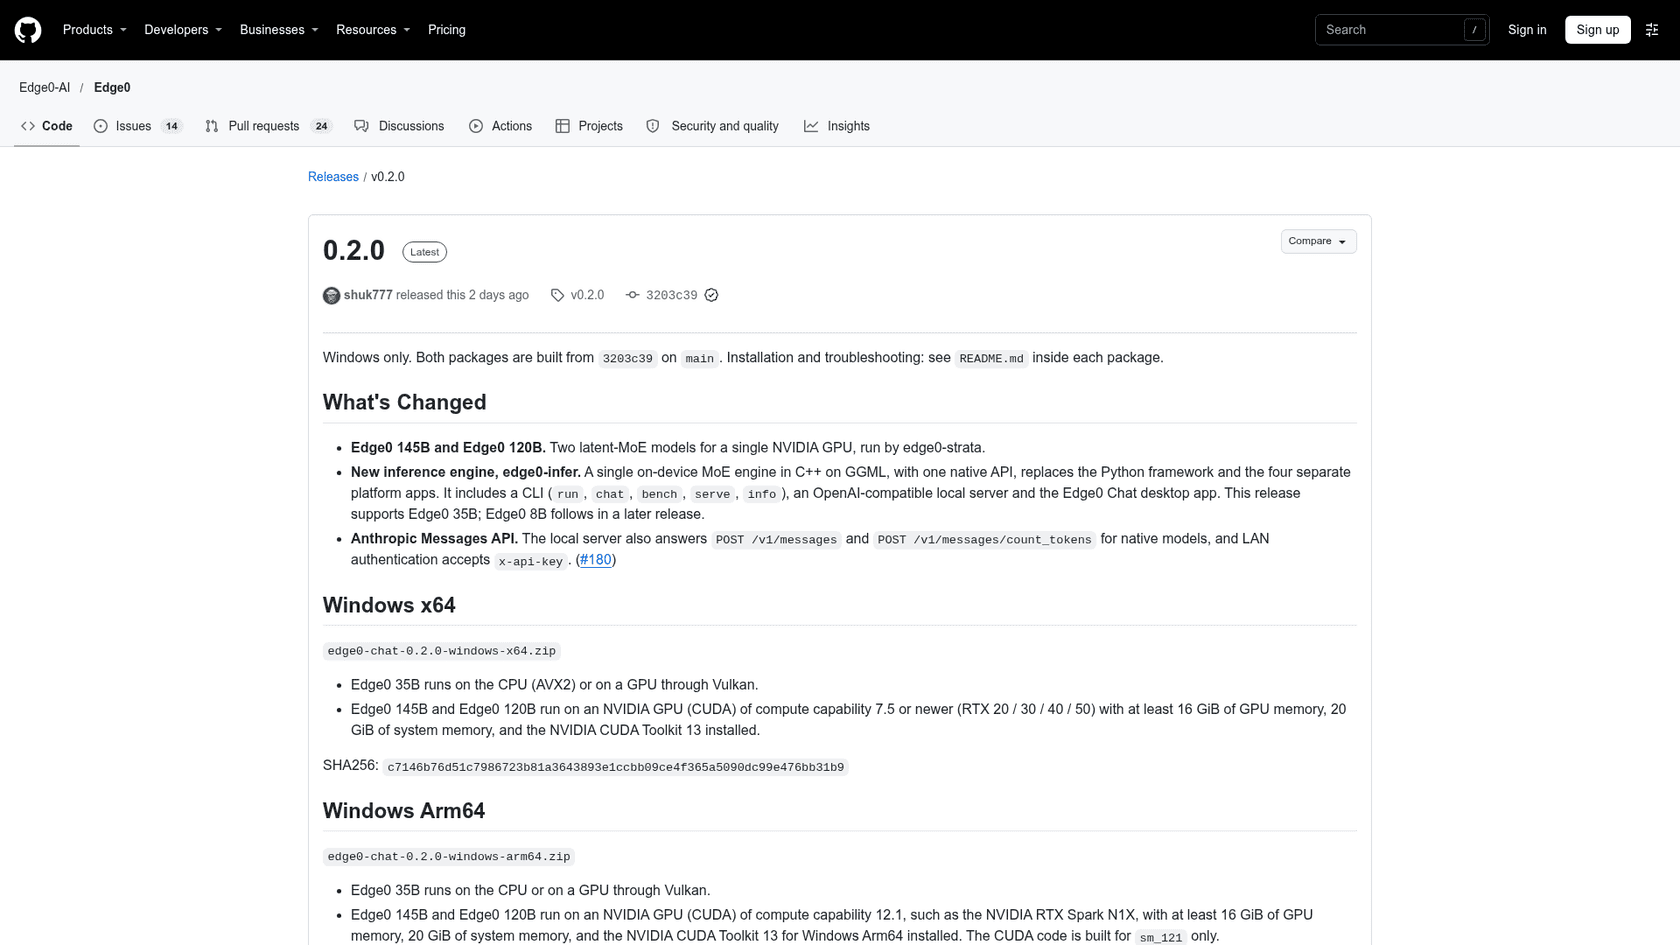
À pleine vitesse, il en utilise plus. La model card dit qu'avec la résidence activée, le build NVFP4 a utilisé 23.25 GiB de VRAM plus 38.27 GiB de RAM hôte sur une RTX 5090 D 24 Go, et le build Q3_K 23.14 GiB plus 31.28 GiB. Les chiffres de 16 GiB plus 20 GiB viennent de la même carte avec des limites appliquées, à vitesse plus faible.
L'affirmation sur le Mac est le plus gros écart. Le tableau des plateformes du README GitHub marque macOS comme non pris en charge pour les modèles 145B et 120B, et la model card dit que son benchmark sur Apple M2 Ultra « does not establish macOS release availability ». Des lecteurs sur Hacker News l'ont relevé dès le premier jour :
"The blog post mentions Mac repeatedly, saying things like 'day-one support covers macOS'. But the released stuff so far seems to be CUDA only."

Donc si tu es sur Apple Silicon, le plus petit Edge0-35B est le modèle d'Edge0 qui tourne aujourd'hui. Pour quelque chose de plus gros sur un Mac, un modèle hébergé comme Qwen 3.8 Max ou DeepSeek V4.1 Flash est la voie pratique pour l'instant.
Choisis ta machine pour voir où tu en es :
Ma machine peut-elle faire tourner Edge0-145B ?
Quelle est la vitesse d'Edge0-145B ?
Rapide sur la bonne carte. Le tableau de vitesse de la model card, entièrement issu des mesures propres d'Edge0, en tokens par seconde :
| Machine | Build | Prefill 16K | Décodage chat | Décodage agent |
|---|---|---|---|---|
| RTX 5090 D 24 GB | Q3_K | 3,554.9 | 99.7 | 121.2 |
| RTX 5090 D 24 GB | NVFP4 | 3,165.7 | 79.6 | 98.3 |
| RTX 4090 24 GB | Q3_K | 3,179.4 | 69.9 | 91.7 |
| RTX Spark N1X 60 GiB | NVFP4 | 922.4 | 40.1 | 46.0 |
| Apple M2 Ultra (Metal) | Q3_K | 800.3 | 60.9 | 57.0 |
| 16 GiB VRAM + 20 GiB RAM | Q3_K | 335 | 36.8 | 44.9 |
Le « décodage agent » va plus vite que le chat parce que la sortie d'un agent (code, appels d'outils) est plus prévisible, donc les suppositions du draft head tombent juste plus souvent. Deux remarques pratiques : le build Q3_K est plus petit et plus rapide que NVFP4 sur la même carte, et la RTX 5090 D est une variante marché chinois de la 5090, donc une 5090 standard devrait être au moins aussi rapide.
Edge0-145B est-il bon, selon Edge0 ?
Dans les évaluations internes d'Edge0, Edge0-145B devance sa base Qwen sur les deux tests d'agent et de code, et traîne légèrement derrière sur les connaissances :
| Modèle | DeepSWE 1.1 | Terminal-Bench 2.1 | GPQA-Diamond | IFBench | HLE | AA-LCR |
|---|---|---|---|---|---|---|
| Edge0-145B | 64.6 | 86.5 | 90.4 | 80.6 | 35.4 | 79.3 |
| Qwen3.8-Flash-Next | 58.7 | 83.3 | 91.7 | 81.3 | 35.9 | 79.1 |
| DeepSeek-V4-Flash-0731 | 54.4 | 82.7 | 90.8 | 79.2 | 33.8 | 79.7 |
| Qwen3.8-27B | 42.2 | 73.0 | 89.2 | 79.5 | 30.8 | 82.0 |
| Claude-Opus-4.6 (Max) | n/a | 78.2 | 91.3 | 62.5 | 40.0 | 78.0 |
Trois réserves avant de s'appuyer sur ces chiffres. D'abord, Edge0 les a fait tourner elle-même, et un rapport technique complet avec étapes de reproduction est promis mais pas encore sorti. Ensuite, la comparaison cloud se fait avec Claude Opus 4.6, qui a deux générations de retard sur les actuels Claude Opus 5.5 et Claude Fable 5.2. Enfin, les pages d'Edge0 elles-mêmes ne concordent pas sur le 120B : le post de lancement lui donne 53.6 sur DeepSWE et 81.3 sur Terminal-Bench, tandis que le README GitHub indique 51.3 et 75.3.
Terminal-Bench reste un signal utile pour le travail d'agent, comme l'a noté un développeur :
"TerminalBench scores often correspond to real world performance for coding agents that rely heavily on bash."
Si tu veux une façon plus large de juger les modèles sur tes propres tâches, mes notes sur le benchmarking des agents IA de support et le panorama des outils de suivi des LLM couvrent la méthode.
Comment installer et faire tourner Edge0-145B ?
Il y a deux voies, et les deux ont besoin de la configuration NVIDIA ci-dessus.
L'app bureau (Windows seulement). Télécharge edge0-chat-0.2.0-windows-x64.zip depuis la page des releases, télécharge un dossier de modèle depuis Hugging Face, ouvre Edge0 Chat et choisis le dossier. Edge0 dit que les fonctions principales de l'app marchent hors ligne, sans compte ni quota d'usage.
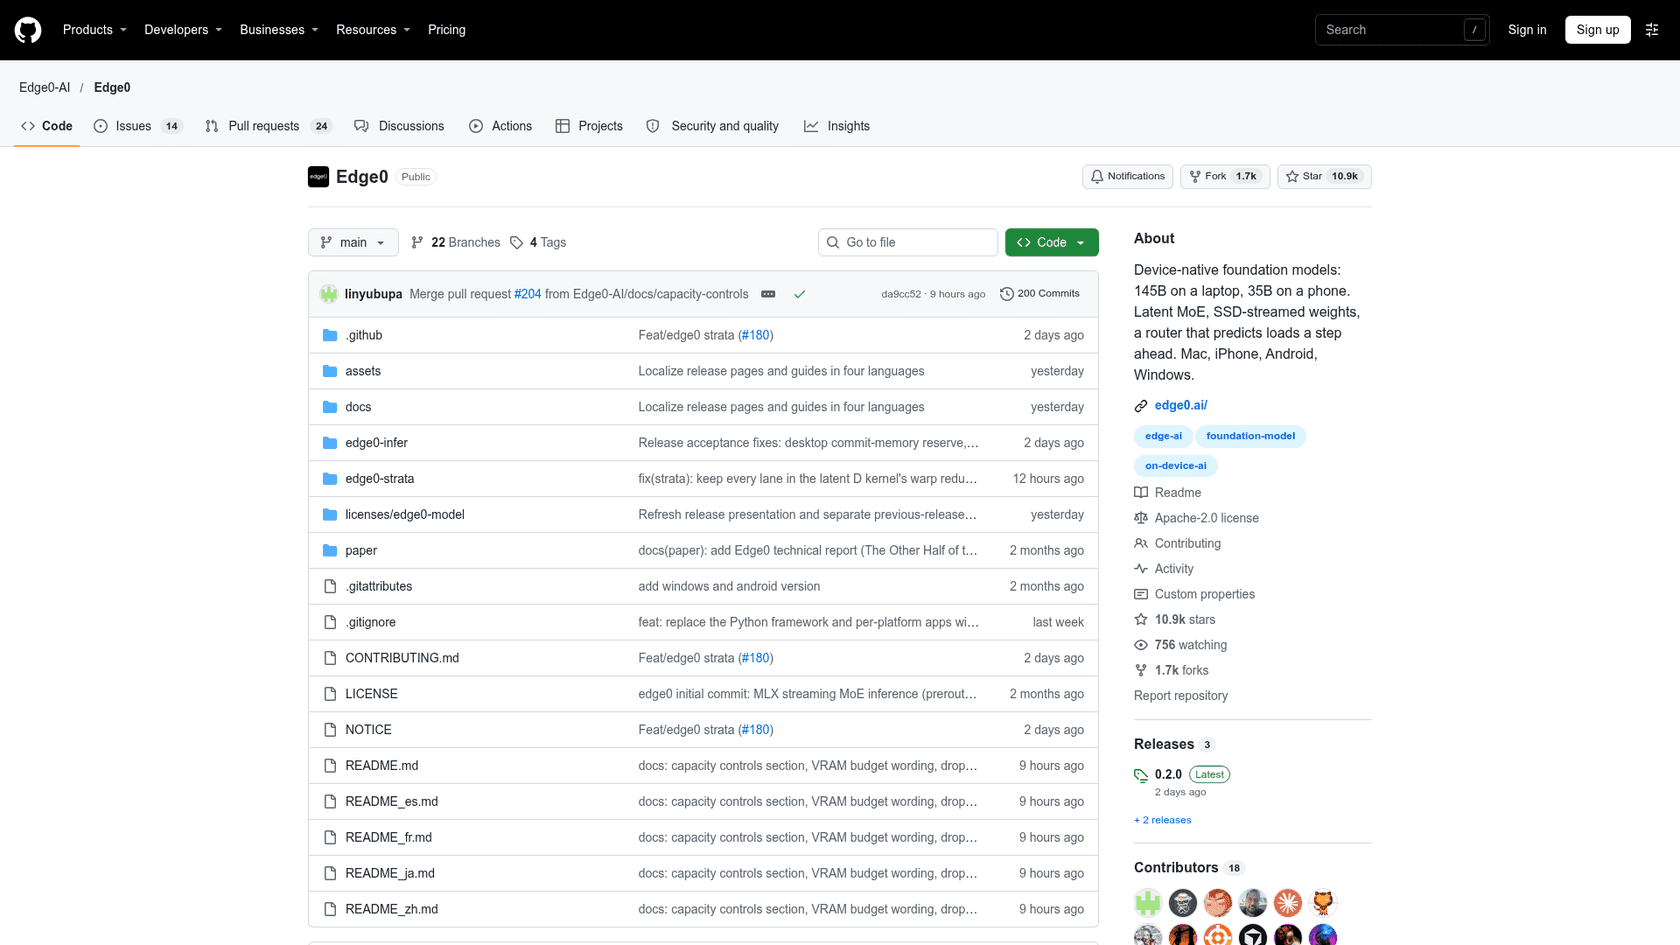
La ligne de commande (Linux ou Windows). Clone le repo, compile le moteur edge0-strata et edge0-infer depuis les instructions du repo, puis pointe-le vers un dossier de modèle :
git clone https://github.com/Edge0-AI/Edge0.git edge0
build/cpu/bin/edge0-infer serve --model /path/to/Edge0-145B-Q3_K
Une fois les poids chargés, ça affiche Listening: http://127.0.0.1:8000 et sert des endpoints compatibles OpenAI et Anthropic sous le nom de modèle edge0_145b. edge0-infer chat ouvre une session interactive à la place.
Deux réglages comptent le plus si la mémoire est serrée. --mmap-experts lit les experts non mis en cache depuis le SSD plutôt que de les garder en RAM, et --resident-budget-gib 20 plafonne le cache d'experts en RAM à 20 GiB, ce qui nécessite un fichier de profil d'experts statique. Les deux se trouvent dans le model.json du dossier de modèle, donc l'app et le CLI les récupèrent.
L'utiliser depuis un agent de code
Comme le serveur local parle le format Anthropic Messages, les outils qui acceptent une base URL personnalisée peuvent, en principe, pointer dessus. Pour Claude Code, ça veut dire régler ANTHROPIC_BASE_URL sur http://127.0.0.1:8000 et choisir edge0_145b comme modèle, le même schéma que pour n'importe quel endpoint personnalisé. Mes guides sur les variables d'environnement de Claude Code et la sélection de modèle couvrent les variables.
OpenClaw et d'autres outils compatibles OpenAI peuvent utiliser l'endpoint /v1/chat/completions. Je n'ai testé aucune des deux voies moi-même, donc prends ça comme la voie documentée plutôt que vérifiée.
Que permet la licence ?
Le post de lancement qualifie Edge0-145B d'« open-source ». La licence est plus étroite que ce mot le suggère, un point soulevé en quelques minutes sur Hacker News :
"This is not open source, this is open weights"
Selon la model card, l'Edge0 Community Model License 1.0 autorise :
- L'usage personnel, la recherche et la modification
- Le partage non commercial et l'usage interne dans une entreprise
- L'usage commercial des sorties générées par le modèle
Elle exige une licence écrite séparée d'Edge0 pour :
- Vendre ou regrouper commercialement le modèle
- Exploiter un service de modèle commercial
- Proposer un assistant de code ou de bureau commercial indépendant construit dessus
La licence communautaire de Qwen s'applique en plus, puisque le modèle est dérivé de matériaux Qwen. Le code du moteur lui-même est en Apache-2.0. En pratique : correct pour la machine personnelle d'un développeur ou un outil interne, pas correct comme moteur d'un produit que tu vends sans en parler d'abord à Edge0. Mon panorama des agents IA open source liste des outils aux conditions plus souples si c'est un frein.
Qu'est-ce qu'Edge0-145B signifie pour les équipes de support ?
L'attrait pour le support est évident : des données client qui ne quittent jamais ton matériel, et aucune facture au token. C'est une vraie préoccupation dont j'entends parler. Lors d'un appel commercial eesel, un évaluateur technique d'une entreprise de matériel voulait l'assurance que l'IA répondrait seulement depuis des connaissances approuvées, pas depuis le web ou des données d'entraînement générales, avant d'aller plus loin.
Mais un modèle local répond à une question différente. Là où tourne le modèle décide où les données sont traitées. Ce qu'il dit à un client dépend de la couche qui l'entoure : quels articles d'aide et tickets passés il peut lire, ce qu'il fait quand il ne trouve pas de réponse, quand il transfère à une personne, et si quelqu'un l'a testé au préalable sur des conversations réelles. Un modèle de 145B sur une carte RTX arrive sans rien de tout ça, et la licence exclut d'en faire un assistant de support commercial sans accord.
Cette couche, c'est le travail du coéquipier IA d'eesel pour le helpdesk. Il rejoint la file que tu fais déjà tourner dans Zendesk ou Freshdesk, répond depuis tes propres connaissances, et est simulé sur les tickets passés avant de passer en direct.
SE Ranking fait tourner un agent eesel par produit sur Zendesk à travers trois produits, traitant 4,650 conversations par mois depuis environ 16,800 pages de connaissances, avec les remboursements et les demandes d'une personne transférés à l'équipe. Innr, une entreprise néerlandaise d'éclairage connecté, fait rédiger par eesel des réponses Freshdesk dans la langue du client à partir de 1,500 articles d'aide et de tickets passés.
Si tu pèses des modèles pour ton propre contenu de support, mes guides sur connecter Claude à ton helpdesk, MCP pour le support client et les transferts d'agents IA vont plus loin qu'une model card ne peut.
Devrais-tu essayer Edge0-145B ?
Oui, si tu as une carte RTX avec 16 GiB ou plus, 32 GiB ou plus de RAM et un SSD rapide, et que tu veux un modèle de code local solide sans facture au token. Utilise le build Q3_K, fais-le tourner dans Claude Code ou ton agent habituel sur une tâche que tu as déjà résolue, et compare avec ton modèle cloud.
Attends, si tu es sur un Mac, sur AMD, ou si tu prévois de l'embarquer dans un produit commercial. Les deux premiers ont besoin d'un support de plateforme qui n'est pas sorti, et le troisième a besoin d'une conversation de licence. En attendant, Qwen3.8-Flash-Next est la base à surveiller, et mes textes sur Qwen en général et Kimi K3 couvrent les alternatives ouvertes les plus proches.
Essaie eesel pour de l'IA sur ta file de support
Si la raison pour laquelle tu as regardé Edge0-145B était de l'IA qui répond à tes clients, eesel t'y amène sans acheter de carte graphique. C'est un coéquipier IA de helpdesk qui se branche sur Zendesk, Freshdesk et d'autres helpdesks, répond seulement depuis ton centre d'aide et tes tickets passés, et est testé sur des conversations historiques avant de toucher une conversation en direct, comme le fait tourner SE Ranking sur trois produits. Regarde les tarifs ou essaie eesel gratuitement.
Questions fréquentes
Qu'est-ce qu'Edge0-145B ?
Quel matériel faut-il pour Edge0-145B ?
Puis-je faire tourner Edge0-145B sur un Mac ?
Edge0-145B est-il open source ?
Combien coûte Edge0-145B ?
Puis-je utiliser Edge0-145B avec Claude Code ?
edge0-infer serve expose des endpoints compatibles OpenAI et Anthropic sur 127.0.0.1:8000 sous le nom de modèle edge0_145b, donc les outils qui acceptent une base URL personnalisée peuvent pointer dessus. Mets ANTHROPIC_BASE_URL sur le serveur local et choisis le modèle, comme dans mon guide des variables d'environnement de Claude Code. Vérifie la licence avant de l'utiliser dans un produit commercial.
Comment Edge0-145B se compare-t-il à Qwen3.8-Flash-Next ?