

llama.cpp v1.0.0 est sorti le 13 novembre 2026, et le titre est une promesse, pas un saut de vitesse : un changement cassant dans l'API publique en C signifie désormais un saut de version majeure. C'est surtout important si vous construisez sur libllama. Les utilisateurs de serveur sentiront d'abord la sécurité : llama-server refuse désormais d'exposer des outils sur une adresse réseau sans clé API. Installez-le avec une ligne depuis llama.app, ou utilisez la nouvelle application Llama de 1 Mo. Vous voulez plutôt de l'IA sur votre file de support ? eesel la fait tourner sur des modèles hébergés, et la CLI eesel permet à un agent de code de charger des articles d'aide et de tester des réponses au préalable.
Qu'est-ce que llama.cpp ?
llama.cpp est un moteur open source qui exécute des grands modèles de langage et des modèles de vision sur votre propre matériel, écrit en C/C++ pur sans dépendances. Le README décrit l'objectif comme une inférence LLM "avec une configuration minimale et des performances de pointe sur une large gamme de matériel", en local comme dans le cloud.
Quelques chiffres donnent l'échelle. Le dépôt GitHub affiche 135,055 étoiles et 25,608 forks sous licence MIT, a été créé le 10 mars 2023, et l'annonce de la v1.0 dit qu'il prend désormais en charge plus de 150 variantes d'architecture de modèle. Le projet est dirigé par ggml-org, l'équipe menée par Georgi Gerganov qui fait partie de Hugging Face.
Je construis les intégrations et les API du produit d'eesel, donc la banderole de lancement m'intéresse moins que ce qu'un numéro de version fait au code qui en dépend. C'est l'angle de tout cet article. J'ai lu les notes de version, la politique de versionnage et les pull requests derrière les changements ; je ne l'ai pas benchmarké moi-même sur ma propre machine, donc les chiffres de vitesse ci-dessous viennent des chiffres propres aux mainteneurs.
Le moteur central en dessous est ggml, une bibliothèque de tenseurs avec des backends pour presque toutes les puces que vous pouvez nommer :
| Backend | Fonctionne sur |
|---|---|
| Metal | Apple Silicon |
| CUDA | GPU NVIDIA |
| HIP | GPU AMD |
| Vulkan | La plupart des GPU |
| SYCL | GPU Intel |
| OpenCL | GPU Qualcomm Adreno |
| Hexagon | Snapdragon |
| CANN | NPU Huawei Ascend |
| WebGPU | Navigateurs et tout appareil compatible WebGPU |
| CPU (AVX, NEON, RVV) | x86, Arm et RISC-V |
Cette portée explique pourquoi tant d'outils d'IA locale s'appuient dessus. Si vous avez utilisé une application de chat de bureau pour des modèles ouverts, il y a de bonnes chances que llama.cpp faisait le travail. C'est aussi pourquoi les modèles à poids ouverts comme Gemma 4 et Qwen3.8-Flash-Next publient généralement des fichiers GGUF, le format de modèle de llama.cpp, dès le premier jour.
Que promet vraiment l'étiquette v1.0 ?
Elle promet des frontières stables, pas de nouvelles fonctionnalités. Dans l'annonce sur Hugging Face, l'équipe dit que llama.cpp et ggml "refléteront les incompatibilités d'API et d'ABI par des sauts de version majeure". Les règles s'appliquent désormais à tout projet ggml-org :
| Saut de version | Quand cela arrive |
|---|---|
| Majeure (2.0.0) | Changement cassant dans l'API publique en C dans ./include |
| Mineure (1.1.0) | Fonctionnalité rétrocompatible, mise à jour de backend, nouveau support de modèle ou ajout d'API |
| Correctif (1.0.1) | Correction de bug sans changement d'API |
Voici ce que la plupart des articles passent sous silence : la promesse couvre les en-têtes C publics, libllama et libggml. Elle ne dit rien des options de ligne de commande de llama-server, de l'interface web, ou de l'application de bureau. Cette distinction décide si v1.0 change quoi que ce soit pour vous.
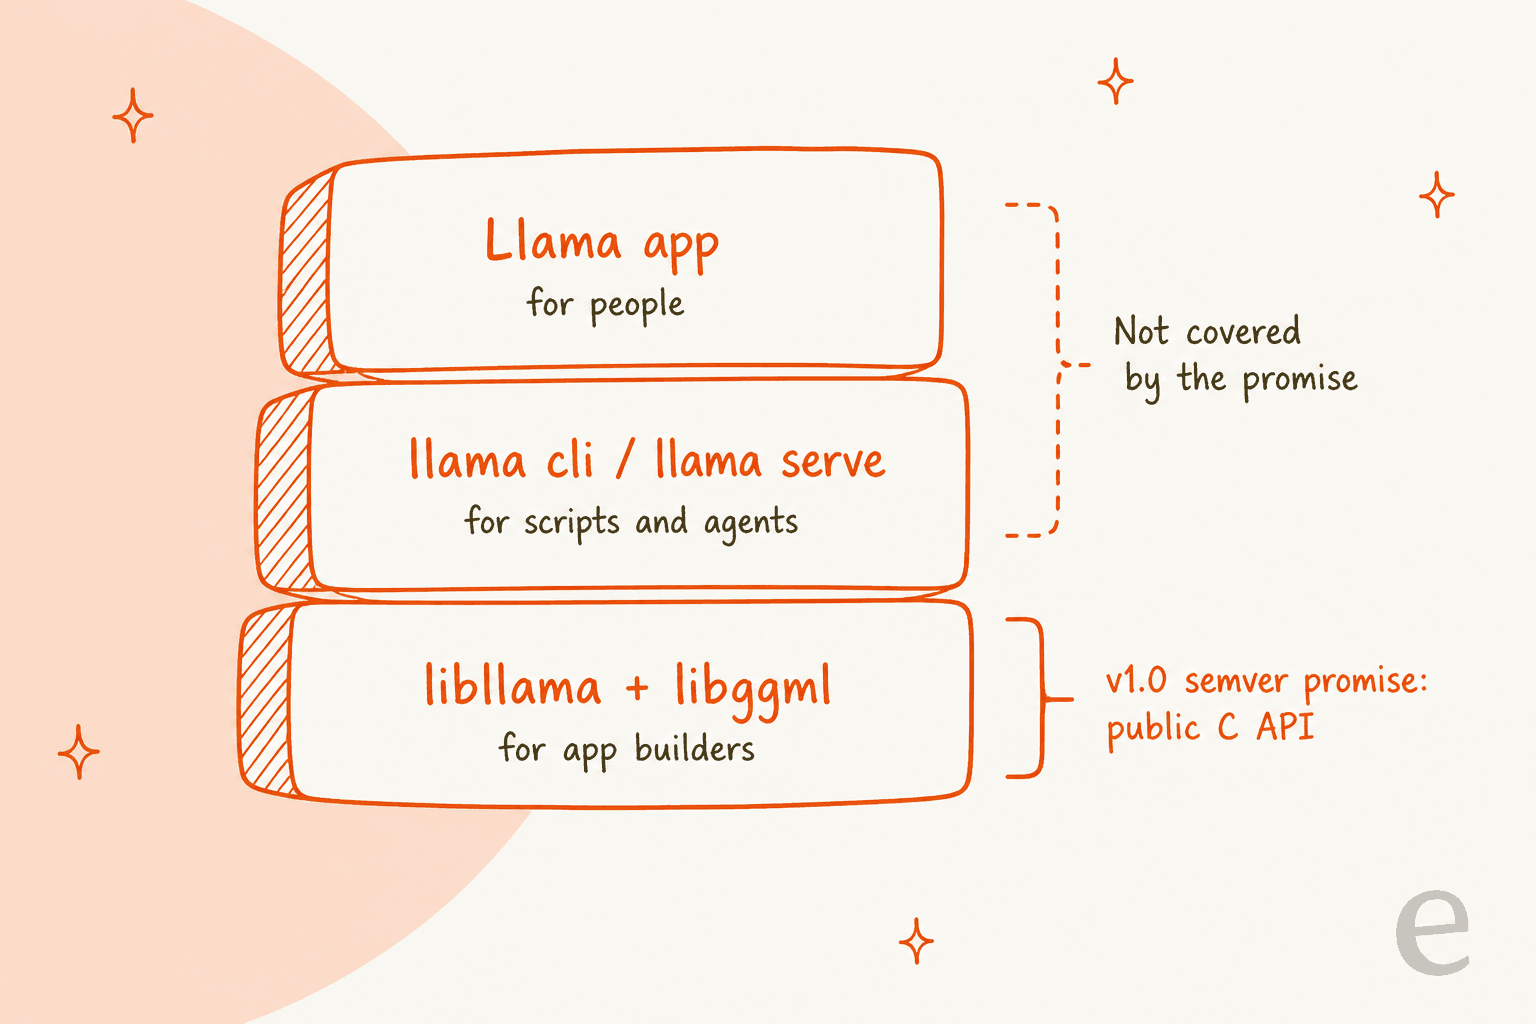
Si vous intégrez llama.cpp dans une application, c'est la version que vous attendiez depuis trois ans. Les mainteneurs de paquets la voulaient aussi. Dans la discussion sur le versionnage, une personne qui l'empaquette pour Debian a écrit que le versionnage sémantique "nous permettra, sous Debian, de le distribuer comme bibliothèque dans des chemins de recherche publics", car les changements cassants peuvent désormais être signalés par des sauts de version de bibliothèque. C'est ainsi que llama.cpp cesse d'être quelque chose que vous vendorisez dans votre dépôt, et devient une bibliothèque système.
Si vous ne faites tourner des modèles que via un serveur ou une application, v1.0 est surtout un jalon de nettoyage. Utile, mais pas une raison de reconstruire votre stack.
Les builds nocturnes continuent
Un détail trompe beaucoup de gens. llama.cpp publie toujours des builds nocturnes étiquetées par nombre de commits, comme b12387, et en a publié cinq le 14 novembre seul, selon la page des releases. Le tag v1.0.0 est une voie séparée, plus lente. Les notes de versionnage disent qu'un tag de release n'est coupé que lorsque la copie interne de ggml de llama.cpp correspond au ggml publié, donc tout ce qui est construit depuis le tag peut être lié en toute sécurité à un ggml au niveau système.
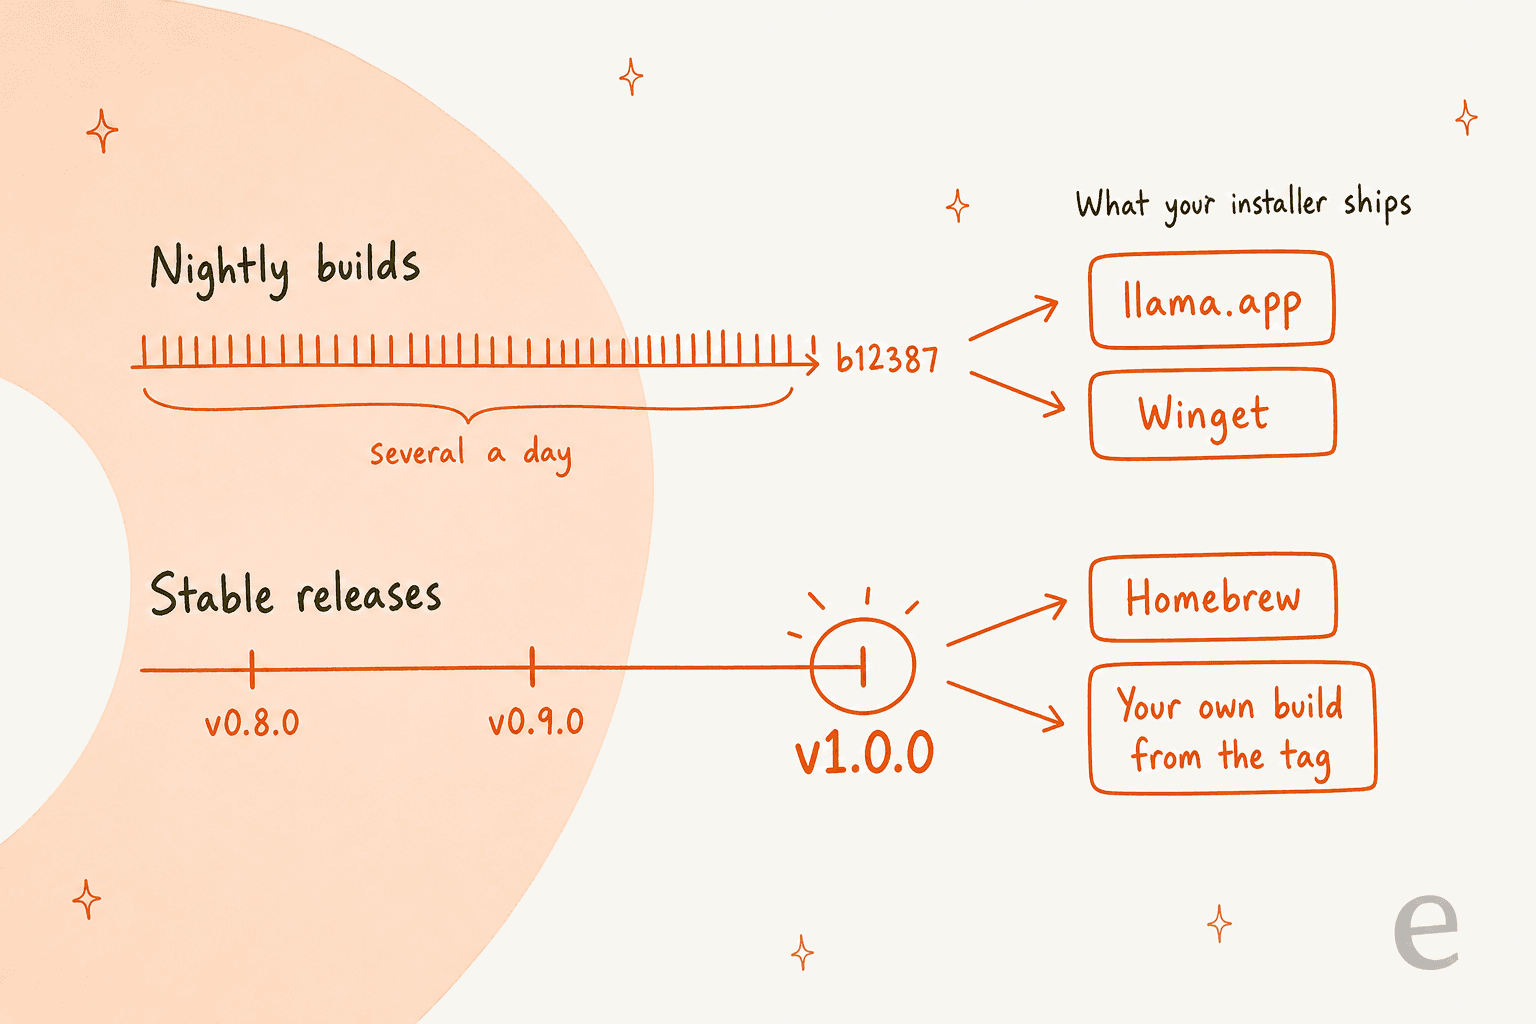
La voie sur laquelle vous êtes dépend de la façon dont vous avez installé. Selon ces mêmes notes, l'installeur llama.app et Winget publient les builds nocturnes, pas les releases officielles (marqué comme un TODO à corriger), tandis que la formule Homebrew se construit désormais depuis le tag de release. Donc « je suis en v1.0 » n'est vrai que si vous l'avez vérifié.
Qu'est-ce qui a changé dans llama.cpp v1.0.0 ?
Les notes de version couvrent des centaines de commits depuis v0.9.0. Voici les changements à connaître, regroupés par qui ils touchent.
| Zone | Changement | Qui est concerné |
|---|---|---|
| API en C | Supprime llama_set_warmup, 35 fonctions obsolètes et --defrag-thold ; déplace l'API NextN (décodage spéculatif) de llama-ext.h vers llama.h | Toute personne liant libllama |
| Mémoire | Caches FP8 KV via -ctk/-ctv f8_e4m3 | Utilisateurs à long contexte avec peu de VRAM |
| Mémoire | Cache d'experts MoE en mémoire hôte avec une part CPU configurable | Gros modèles mixture-of-experts sur petits GPU |
| Modèles | Kimi-K3.1-Pro, Ripple-65B-Preview, xing4_0, TTS drama-3 ; vision Kimi-K3.1 et MageVL-Cowork | Toute personne testant de nouveaux modèles ouverts |
| Serveur | Endpoint /v1/audio/speech ; correctifs de sécurité pour CORS, DNS rebinding et SSRF | Toute personne faisant tourner llama-server |
| Interface web | Groupes de chat, éditeur markdown en direct, mise en page mobile, miniatures PDF | Les gens utilisant le chat intégré |
Nouveaux modèles dès le premier jour
Les nouvelles architectures correspondent à des lancements récents que j'ai déjà couverts : Kimi-K3.1-Pro, que les notes décrivent comme K3 avec ses couches d'attention complète remplacées par DSA, et Ripple-65B, ajouté comme nouvelle architecture dense de 65B. Si vous avez lu ma revue de Kimi K3 ou la revue de Ripple-65B, ce sont les mêmes modèles, désormais exécutables localement depuis des fichiers GGUF.
Caches FP8 KV
Le cache KV est la mémoire qu'un modèle utilise pour se souvenir de la conversation jusqu'ici, et sur de longs contextes il peut rivaliser avec le modèle lui-même. La PR #28392 ajoute des caches FP8 OCP avec des échelles optionnelles par tenseur. Tout le monde ne sait pas encore quelle option 8 bits choisir :
"Sounds like now, 8 bit KV cache is ok for coding, but the question is which one? I see f8_e4m3, q8_0. Would be great to get more info about that."

Ma lecture : les notes de version ne répondent pas à cela, donc testez les deux sur une longue session de votre propre travail avant de basculer une configuration de code.
Le cache d'experts MoE
C'est le changement que je surveillerais le plus. Les modèles mixture-of-experts n'utilisent qu'une tranche de leurs poids par token, donc la PR #30966 garde les experts actifs en mémoire GPU et peut traiter les échecs de cache sur le CPU. Le run de calibrage de l'auteur sur Qwen3.8-Flash-Next montre pourquoi la part CPU compte : avec un cache de 6,464 Mio, le décodage est passé de 24,2 tokens par seconde sans part CPU à 47,6 avec une part de 0,95. Avec un cache plus grand de 19,392 Mio, les chiffres s'inversent et une part CPU élevée devient plus lente. La PR fournit un script de calibrage, scripts/moe-cache-tune.py, pour trouver votre propre point idéal plutôt que de deviner.
C'est le même tour de passe-passe derrière les géants mono-GPU comme Edge0-145B, désormais intégré au moteur principal.
Qu'est-ce qui a changé dans la sécurité de llama-server ?
C'est le changement le plus susceptible de casser une configuration qui fonctionnait, le jour de la mise à jour. La PR #32113 signifie que activer des outils ou MCP avec un --host autre que loopback et sans clé API est désormais refusé avec une erreur. Vous devez ajouter --api-key, ou l'activer explicitement avec --allow-unauthenticated-tools.
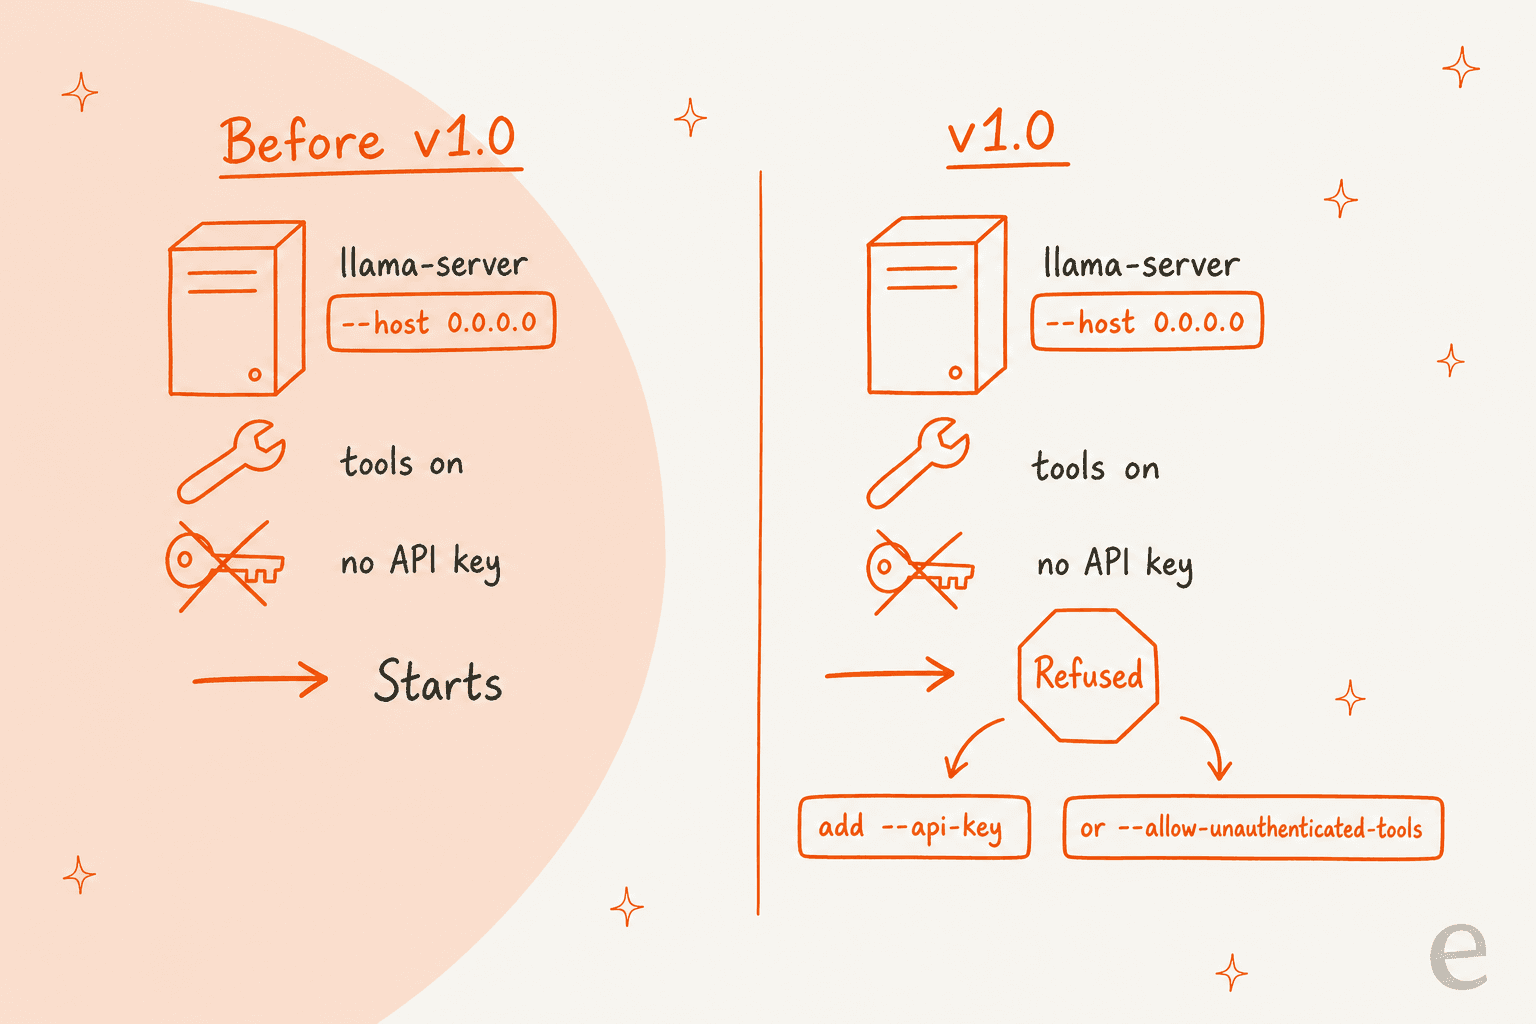
Le mainteneur qui l'a écrit a été franc sur le compromis dans la description de la PR :
"None of those are actually vulnerability, but since people nitpick this too much, we now forced to hurt the UX a bit"
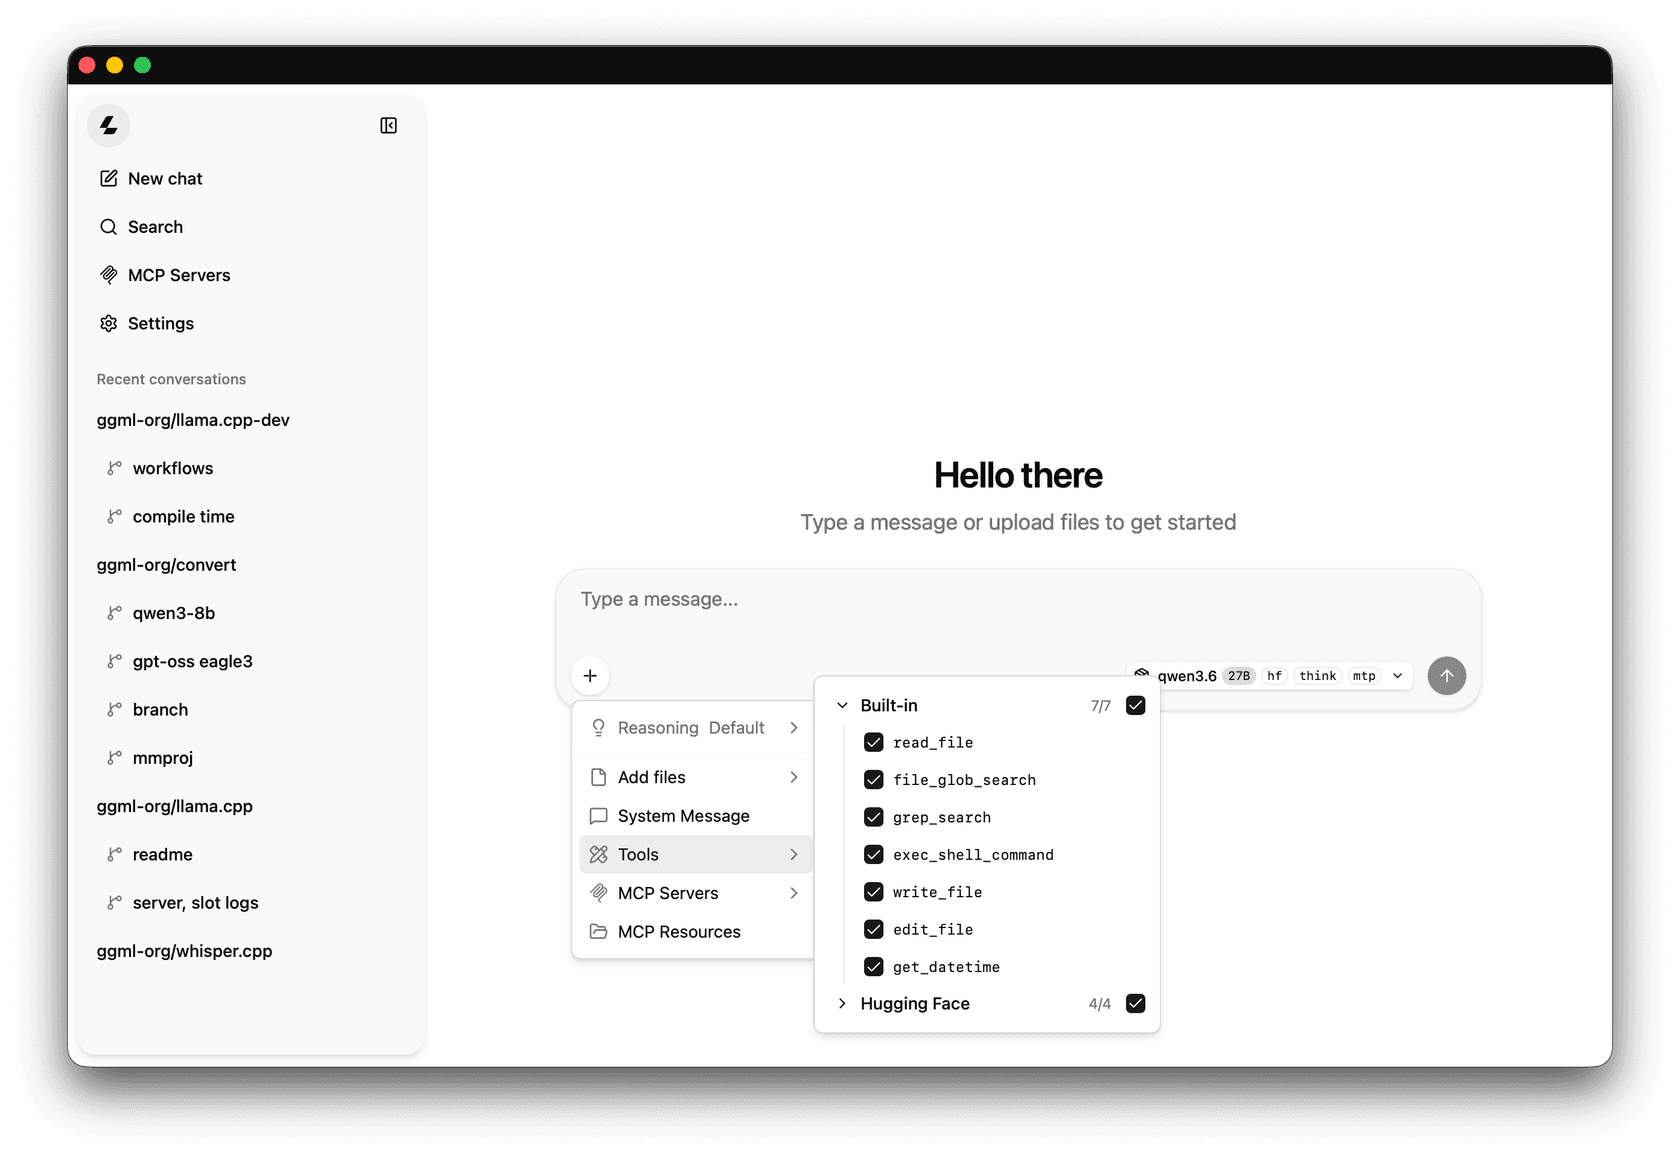
Je choisirais quand même le réglage par défaut le plus strict. Les outils dans llama-server peuvent lire des fichiers et exécuter des commandes shell, et l'ensemble intégré dans l'interface web inclut read_file, exec_shell_command et write_file. Laisser cela ouvert sur un réseau local sans clé est le genre de configuration qui tient jusqu'à ce que quelqu'un d'autre sur le Wi-Fi le trouve. La même release restreint aussi le HF_TOKEN aux hôtes huggingface.co, corrige la gestion de --cors-origins et le DNS rebinding, ajoute une option --media-allow-private-urls, et annule les appels d'outils MCP quand un client se déconnecte.
Si vous branchez un modèle local sur quelque chose capable d'agir, mes notes sur les serveurs MCP pour agents IA et la sécurité dans Claude Code couvrent le même principe : l'accès aux outils est la vraie surface d'attaque, pas le modèle.
Est-ce que llama.cpp v1.0 change quelque chose pour vous ?
Choisissez votre usage, et vous aurez la version courte.
Comment utilisez-vous llama.cpp ?
--host autre que loopback et des outils ou MCP activés, v1.0 refuse de démarrer sans --api-key. Ajoutez une clé plutôt que --allow-unauthenticated-tools. Revérifiez aussi toute valeur --cors-origins, car le port est désormais validé strictement.llama_set_warmup et aux 35 fonctions obsolètes, renommez llama_set_embd_state_src en llama_set_ctx_state_src, et épinglez sur v1.x. À partir de là, un changement cassant dans l'API en C signifie un 2.0.libggml au niveau système et utiliser les sauts de version de bibliothèque pour signaler les changements cassants.Comment installer et exécuter llama.cpp ?
Il existe trois voies, et la nouvelle est la plus conviviale. Toutes les commandes ci-dessous viennent du README et de llama.app.
1. L'application de bureau Llama (Mac et Windows). La même équipe distribue désormais Llama, une application de barre de menu sur Mac et une application de barre des tâches sur Windows 11. Le site la présente comme un téléchargement de 1 Mo, 4 Mo installée, gratuite, open source et capable de fonctionner hors ligne. Elle vérifie votre matériel et choisit la quantification, la taille de contexte et le décodage spéculatif pour chaque modèle, et les modèles se déchargent après cinq minutes d'inactivité.
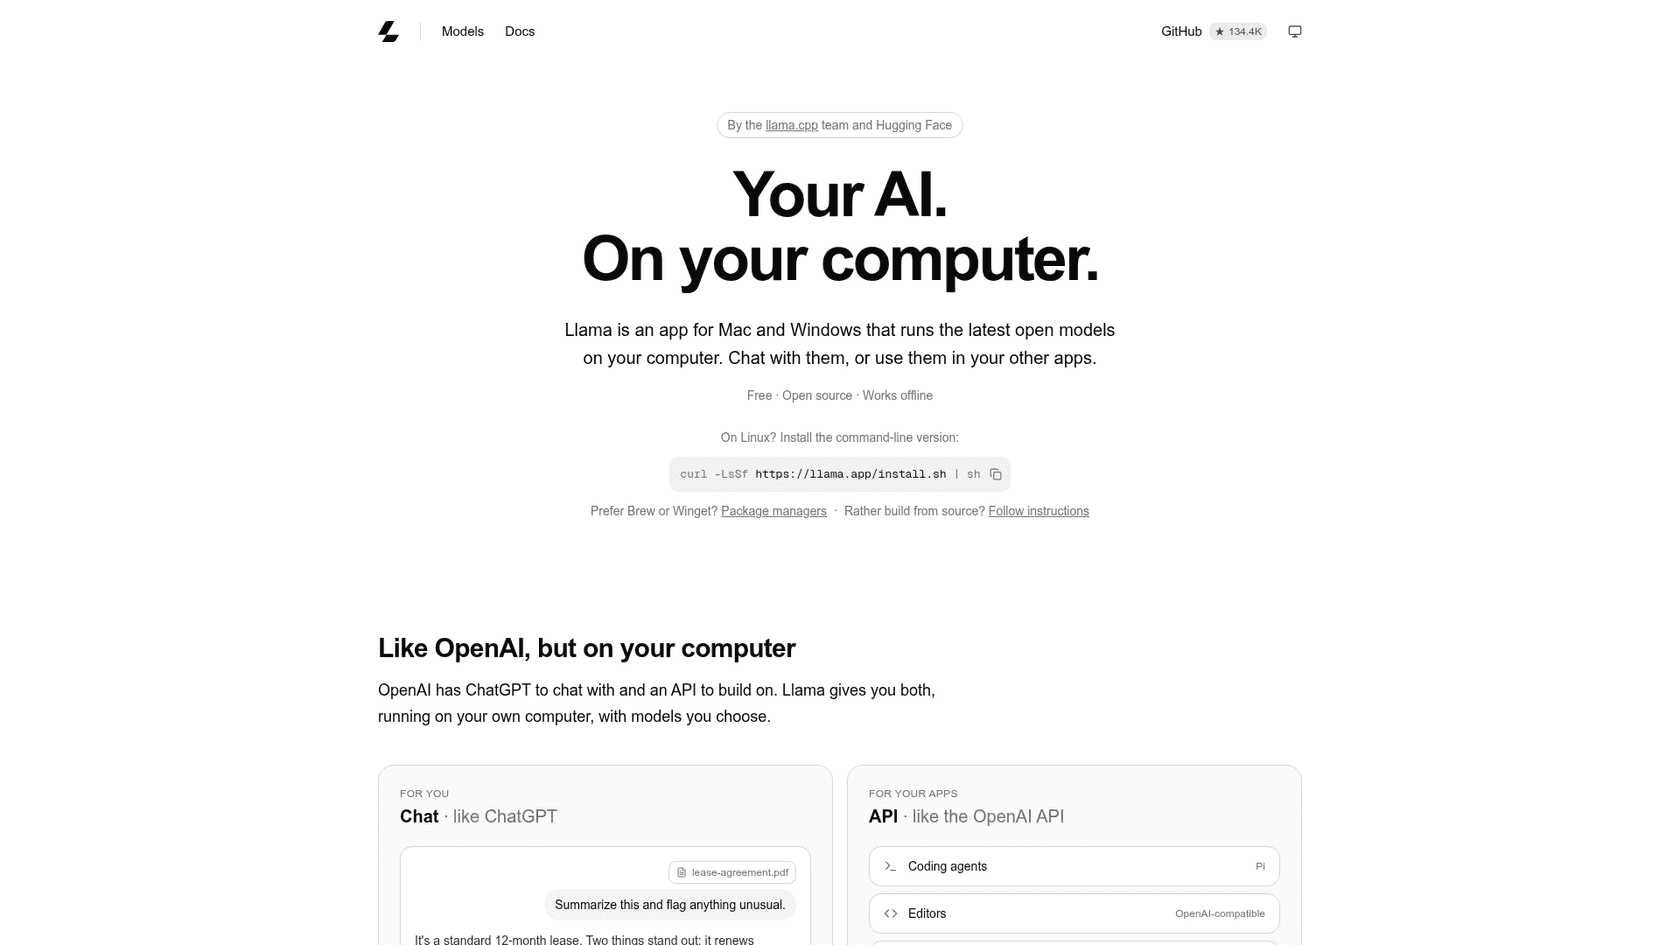
Elle suggère un modèle de départ selon la mémoire : Gemma 4 pour un Mac de 16 Go, GPT-OSS à 24 Go, et Qwen 3.8 à 32 Go. Sur Mac, vous pouvez aussi l'installer avec brew install --cask llama-app.
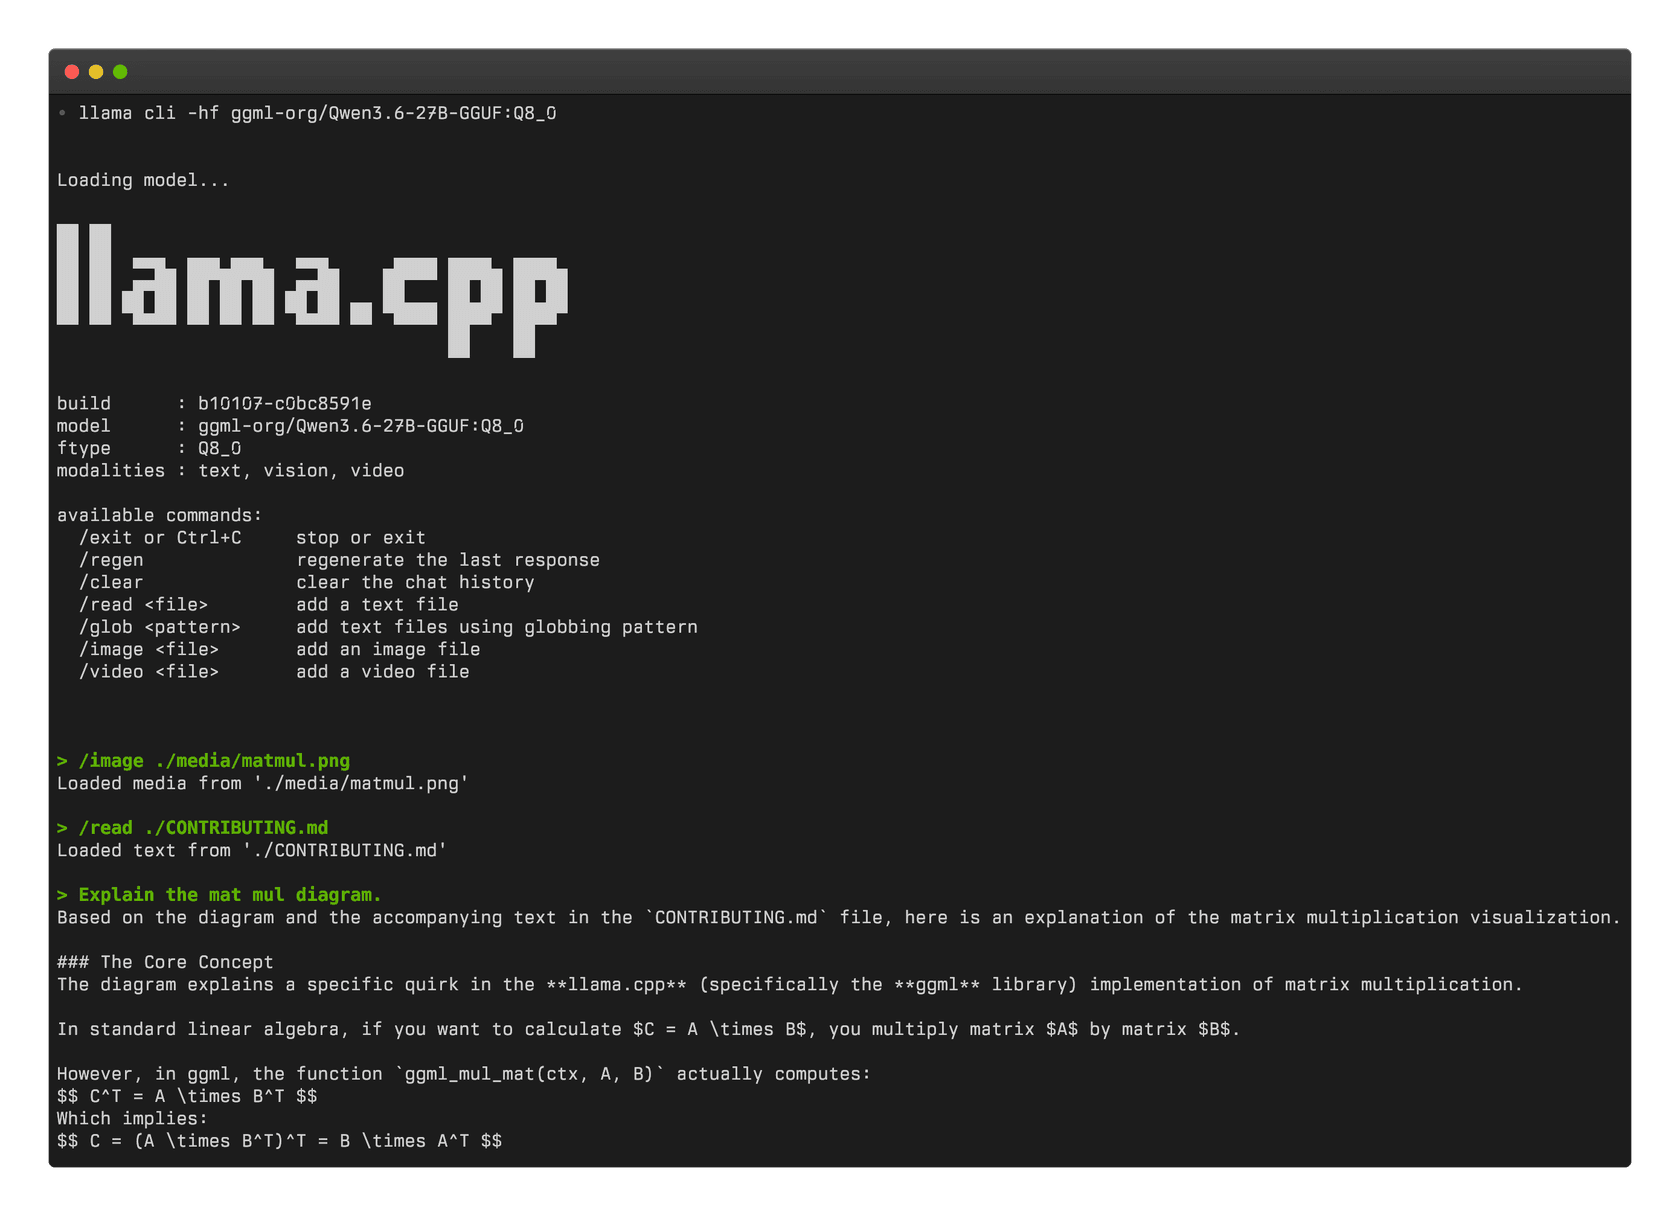
2. La ligne de commande (tout système). Une ligne installe le binaire unifié llama :
curl -LsSf https://llama.app/install.sh | sh
Sous Windows PowerShell, c'est irm https://llama.app/install.ps1 | iex. Ensuite, téléchargez un modèle depuis Hugging Face et discutez, ou lancez un serveur compatible OpenAI :
llama cli -hf ggml-org/Qwen3.5-0.8B-GGUF
llama serve -hf ggml-org/Qwen3.5-0.8B-GGUF
3. Gestionnaires de paquets ou code source. L'annonce de la v1.0 liste Docker, Debian, Homebrew, conda-forge, MacPorts, Winget et un XCFramework pour iOS et macOS, plus des binaires précompilés pour Linux, macOS, Windows, Android et iOS. Construire depuis le code source est détaillé dans le guide de build.
Brancher des agents de code dessus
L'application Llama expose son API sur localhost:9931/v1, et le site dit qu'elle parle des endpoints compatibles à la fois OpenAI et Anthropic, avec streaming, appel d'outils, sortie structurée et vision. Cela veut dire que des outils comme Cursor, OpenClaw ou Claude Code peuvent pointer vers un modèle local en changeant juste l'URL de base, le même schéma que celui décrit dans mon guide sur les variables d'environnement de Claude Code. Je n'ai pas testé cette voie moi-même sur v1.0, traitez-la donc comme la route documentée.
Une vérification rapide de la qualité : un petit modèle local n'égalera pas un modèle frontière hébergé sur du code difficile. Mes comparaisons de DeepSeek V4 Flash et Qwen 3.8 Max sont un meilleur guide de ce que chaque niveau peut faire.
Qu'est-ce qui manque encore ?
Trois lacunes se dégagent de la release et des réactions qu'elle a suscitées.
- Pas d'application de bureau Linux. Llama n'existe que sur Mac et Windows ; les utilisateurs Linux ont la ligne de commande. Un commentateur sur l'annonce a posé exactement cette question.
- Traitement des prompts sur d'énormes entrées. Un autre commentateur sur le même billet a dit que llama.cpp "a encore besoin d'amélioration sur le traitement d'énormes prompts", c'est-à-dire l'étape de prefill avant le premier token. La release contient du travail sur le prefill (un chemin FlashAttention Vulkan pour Intel, des matmuls à peu de lignes pour CUDA), mais sans chiffre marquant à mettre en avant.
- Les installeurs ne sont pas encore en v1.0. Comme vu plus haut, l'installeur llama.app et Winget publient toujours des nightlies. C'est acceptable pour la plupart des utilisateurs, mais cela veut dire que la promesse de stabilité de v1.0 ne vous atteint que si vous construisez depuis le tag ou utilisez Homebrew.
Rien de tout cela n'est une raison de passer à côté. Ce sont des raisons de vérifier sur quel build vous êtes avant de vous fier à la promesse.
Qu'est-ce que llama.cpp signifie pour les équipes de support ?
L'attrait est évident : des données clients qui ne quittent jamais votre matériel, et aucune facture au token. C'est un sujet que j'entends dans les appels commerciaux d'eesel. Un acheteur d'une entreprise danoise de télématique B2B a dû passer une revue de sécurité interne stricte avant tout essai, et sa première question était de savoir si les données de tickets contenant des numéros de carte et des mots de passe resteraient dans son environnement.
Un modèle local répond à une partie de cela. Il ne répond pas au reste : quels articles d'aide l'agent peut utiliser, quand il transfère un ticket à une personne, comment savoir qu'il a raison avant que les clients ne le voient. Ce sont les questions derrière la plupart des revues de sécurité IA en support que j'ai vues, et la checklist de sécurité fournisseur et le guide SOC 2 et RGPD les couvrent en détail.
Cette couche, c'est le travail du coéquipier IA d'eesel pour helpdesk. Il rejoint la file que vous faites déjà tourner sur Zendesk ou Freshdesk, répond à partir de vos propres connaissances, et est simulé sur des tickets passés avant de passer en direct. smava, une entreprise berlinoise de comparaison de crédits, l'utilise sur 27,000 tickets Zendesk par mois, avec 15,300 brouillons de réponse préparés en allemand à partir de 820 macros et articles de centre d'aide. SE Ranking fait tourner un agent eesel par produit sur Zendesk, avec les remboursements et les demandes de contact humain transférés à l'équipe.
Si vous pesez vos options de modèles pour votre propre contenu de support, mes guides sur connecter Claude à votre helpdesk, les transferts d'agent IA et la prévention des hallucinations IA en support vont plus loin qu'une note de release.
Faut-il passer à llama.cpp v1.0 ?
Oui, si vous liez libllama : c'est la première release avec une promesse de compatibilité écrite, donc épinglez sur v1.x et arrêtez de courir après les changements cassants dans les builds nocturnes. Faites le nettoyage une fois, et c'est réglé.
Oui, avec précaution, si vous faites tourner llama-server sur un réseau : ajoutez une clé API avant de mettre à jour pour que le nouveau contrôle d'outils n'arrête pas votre service.
Aucune action nécessaire si vous utilisez une application de bureau. Vous êtes probablement déjà sur une build nocturne qui inclut tout ce qu'il y a dans v1.0, et la nouvelle application Llama de Hugging Face est la façon la plus simple d'essayer des modèles locaux si vous ne l'avez pas encore fait. Pour des alternatives hébergées, mon tour d'horizon des alternatives à Hugging Face et ma liste d'outils de suivi des LLM sont de bonnes prochaines lectures.
Essayez eesel pour de l'IA sur votre file de support
Si vous avez regardé llama.cpp parce que vous voulez de l'IA qui répond aux clients, eesel vous y mène sans choisir une quantification ni dimensionner un GPU. C'est un coéquipier IA pour helpdesk qui se connecte à Zendesk, Freshdesk et d'autres helpdesks, répond uniquement à partir de votre centre d'aide et de vos tickets passés, et est testé sur des conversations historiques avant de toucher à une conversation en direct, comme smava le fait tourner sur 27,000 tickets par mois. Avec la CLI eesel, votre agent de code peut charger des articles d'aide et des macros exportés, poser des questions de test et vérifier les réponses ; connecter le helpdesk lui-même nécessite toujours quelqu'un avec un accès administrateur. Essayez eesel gratuitement.
Questions fréquentes
Qu'est-ce que llama.cpp ?
Qu'est-ce qui a changé dans llama.cpp v1.0.0 ?
Est-ce que llama.cpp est gratuit ?
Est-ce que llama.cpp v1.0 casse ma configuration existante ?
llama_set_warmup et l'option --defrag-thold ont disparu. Si vous exécutez llama-server sur une adresse réseau avec outils ou MCP activés et sans clé API, v1.0 refuse de démarrer jusqu'à ce que vous ajoutiez --api-key, ou que vous l'activiez explicitement avec --allow-unauthenticated-tools. Mon guide sur MCP pour le support client explique pourquoi l'accès aux outils mérite cette barrière.Quelle est la différence entre llama.cpp et l'application Llama ?
localhost:9931/v1. Des outils comme Claude Code ou OpenClaw peuvent pointer vers cet endpoint local.Est-ce que llama.cpp peut faire tourner un chatbot de support client ?
Est-ce que llama.cpp v1.0 est la version que je reçois depuis l'installeur ?
llama --version, et consultez mon article sur les tarifs Hugging Face si vous comptez héberger des modèles vous-même.
Comment installer llama.cpp ?
curl -LsSf https://llama.app/install.sh | sh; sur Windows, lancezirm https://llama.app/install.ps1 | iex. Homebrew, Winget, Docker, conda-forge et des binaires précompilés fonctionnent aussi. Ensuite,llama cli -hf ggml-org/Qwen3.5-0.8B-GGUFtélécharge un modèle depuis Hugging Face et lance un chat.