

Meta a sorti Muse Spark 1.2 le 5 août 2026 en l'annonçant comme une version de code. Lisez les chiffres indépendants et c'est la seule chose qu'elle n'est presque pas. Sur Artificial Analysis, Terminal-Bench a bougé de 2,2 points tandis que l'indice agentique a bougé de 9,6 et l'Elo GDPval de 254. L'effondrement sur les agents généralistes qui plombait 1.1 a été corrigé, et Meta l'a mentionné en une seule phrase.
Deuxième point à retenir : les principaux graphiques de code de Meta changent deux variables à la fois. Muse Spark 1.2 est mesuré dans Muse Code, le nouvel agent de terminal de Meta, tandis que 1.1 est mesuré sur mini-swe-agent. Les modèles ont aussi été entraînés conjointement avec ce harnais. L'écart que vous voyez est donc un modèle plus un harnais, et le graphique ne peut pas les séparer pour vous.
Troisième point : le prix, et c'est la partie la plus intéressante de la sortie. Le même modèle a deux IDs : 1,25 $/4,25 $ par million de tokens, ou 0,10 $/0,20 $ si vous laissez Meta entraîner sur votre trafic. Cela représente environ 16x sur un mélange normal. Chez eesel, je construis des agents IA pour des files de support, et le schéma que je signalerais est un schéma que j'ai vu faire échouer des contrats : le modèle n'a jamais été le goulot d'étranglement. Un acheteur a un jour mené une évaluation méthodique de 67 tests de notre agent, jugé les réponses de connaissance solides, et est parti quand même parce que le widget de chat était lent et se bloquait. Des tokens moins chers ne règlent pas ce qui entoure les tokens.
Ce que Meta a réellement sorti le 5 août
Deux choses sont arrivées ensemble, de la part de Matthias Reso et Josh Walters sur le blog développeurs de Meta : le modèle, et l'agent conçu pour l'exécuter.
Muse Spark 1.2 est le modèle. La description de Meta elle-même est inhabituellement sobre : elle qualifie 1.2 de « a moderate improvement over Muse Spark 1.1 », optimisé pour « multi-file refactors, long debugging sessions and tasks that run well past a single prompt ». L'article de recherche est encore plus direct et présente la sortie comme « our next step toward the frontier, with larger and much more capable models on the way. » Personne chez Meta ne prétend ici avoir un modèle de pointe, et je les croirais sur parole. C'est une posture différente du reste de l'offensive IA de Meta, où le travail grand public reçoit de plus grandes promesses.
Muse Code est l'agent, en bêta. Il s'installe en une commande, s'exécute dans votre terminal, lance des sous-agents en parallèle et journalise tout ce qu'il fait. C'est l'élément nouveau de cette sortie, et je pense que c'est celui que la plupart des articles ont négligé. Si vous n'avez jamais utilisé un outil de code IA en terminal, c'est la catégorie qu'il rejoint.
Trois choses sont reprises de Muse Spark 1.1 sans changement : la fenêtre de contexte de 1 048 576 tokens, la grille tarifaire standard et les poids fermés. Ce qui a changé hors du modèle, c'est la disponibilité. Meta a étendu l'aperçu public au-delà des États-Unis, ce qui, pour quiconque a essayé d'atteindre 1.1 depuis l'extérieur des États-Unis, était le vrai titre.
Artificial Analysis a déjà marqué Muse Spark 1.1 comme obsolète et le redirige vers 1.2, ce qui montre comment Meta veut que la lignée soit lue.
Où Muse Spark 1.2 s'est réellement amélioré
Voici la partie que j'écrirais sur le tableau blanc. Meta a vendu ceci comme un modèle de code. Les chiffres de code sont ceux qui ont le moins bougé.
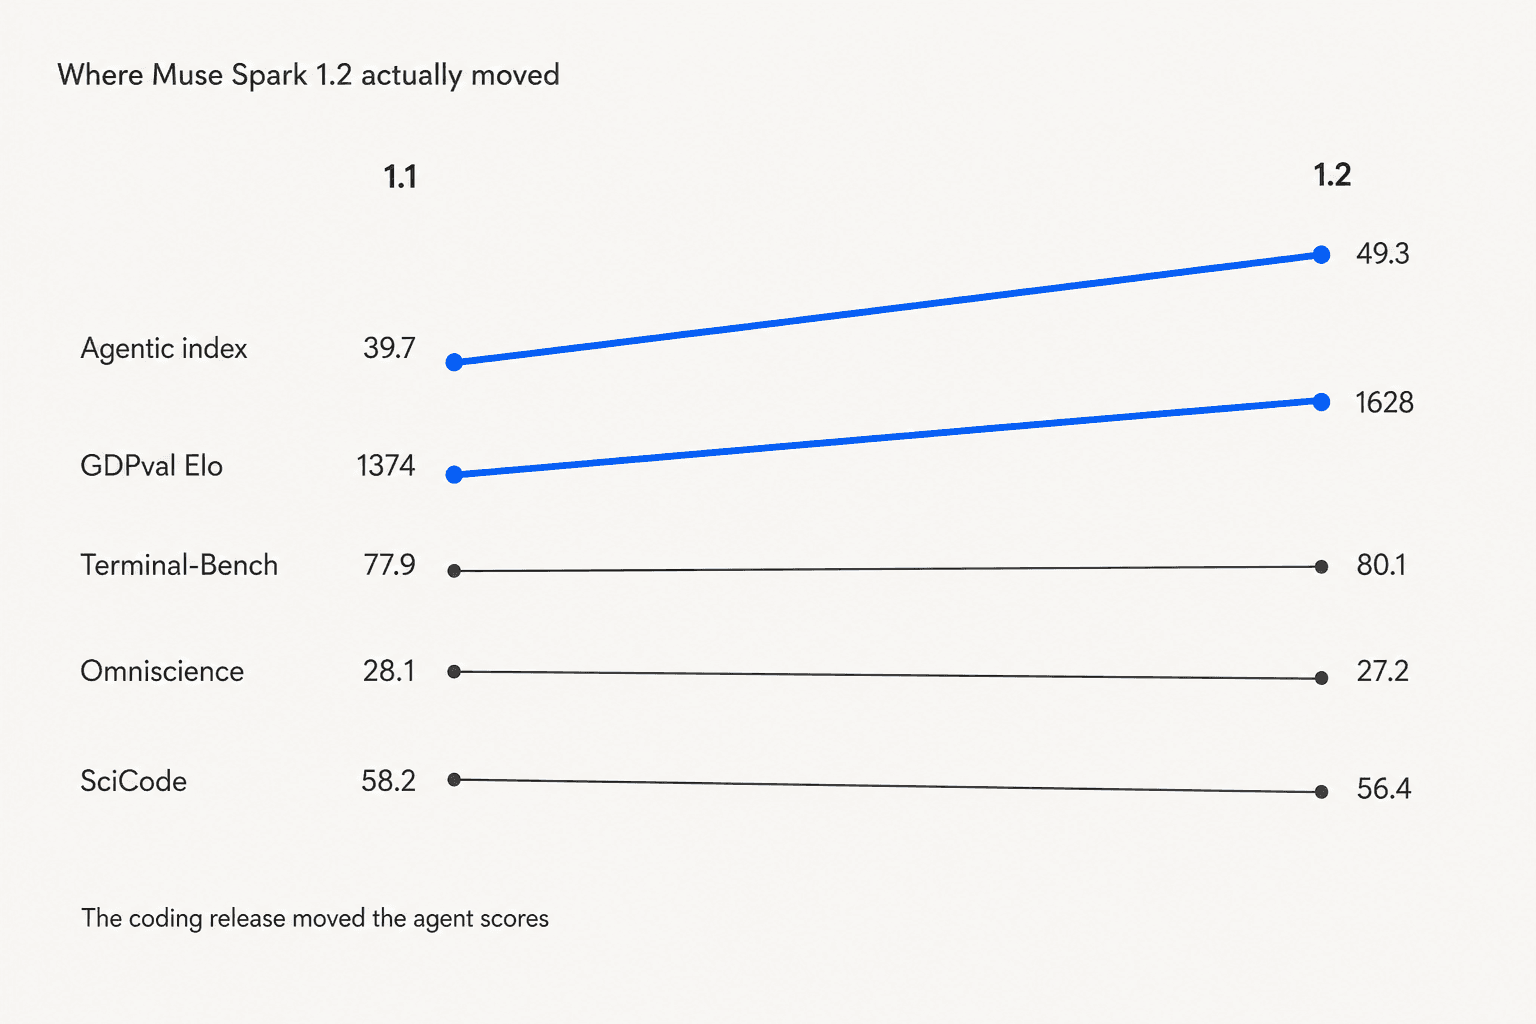
Tout provient d'Artificial Analysis, qui a exécuté les deux versions sur le même harnais, ce qui donne sa valeur à la comparaison :
| Benchmark | Muse Spark 1.1 | Muse Spark 1.2 | Variation |
|---|---|---|---|
| Indice agentique | 39.7 | 49.3 | +9.6 |
| GDPval-AA v2 (Elo) | 1374 | 1628 | +254 |
| Intelligence Index | 53.2 | 56.8 | +3.6 |
| tau-3 Banking | 31.8% | 34.9% | +3.1 |
| CritPt | 15.1% | 17.7% | +2.6 |
| Terminal-Bench 2.1 | 77.9% | 80.1% | +2.2 |
| AA-LCR (contexte long) | 81.3% | 83.3% | +2.0 |
| GPQA Diamond | 89.8% | 90.4% | +0.6 |
| Humanity's Last Exam | 46.2% | 45.5% | -0.7 |
| AA-Omniscience Index | 28.1 | 27.2 | -0.9 |
| SciCode | 58.2% | 56.4% | -1.8 |
SciCode, un benchmark de code, a reculé. Terminal-Bench, le benchmark de code que Meta a mis en avant, a bougé environ cinq fois moins que l'indice agentique. Pendant ce temps, GDPval-AA v2, l'évaluation qui note des comparaisons par paires en aveugle de livrables professionnels réels, a bougé de 254 points Elo, ce qui a fait passer le modèle du bas de ce classement à la deuxième place derrière Opus 5 sur le graphique de Meta.
J'ai souligné dans ma critique de Muse Spark 1.1 que le plus étrange de ce modèle était la contradiction en son centre : Meta commercialisait un modèle d'agent, et les évaluations agentiques indépendantes étaient ses pires résultats. C'est le trou que 1.2 comble. Mais ce n'est pas le trou que désigne l'article de lancement de Meta.
Pour situer la compagnie qu'il fréquente désormais, 56,8 place Muse Spark 1.2 treizième sur vingt dans ce classement, derrière Claude Opus 5 à 63,1 et Grok 4.6 à 60,9, et juste devant GPT-5.6 Terra à 56,6.
Le chiffre des hallucinations se lit deux fois
Une ligne de plus de la même source, parce que c'est le genre de chose qu'un score d'indice unique cache. Artificial Analysis décompose AA-Omniscience en précision et taux d'hallucination :
| Mesure | Muse Spark 1.1 | Muse Spark 1.2 |
|---|---|---|
| Précision | 52.0% | 45.4% |
| Taux d'hallucination | 50.0% | 33.3% |
1.2 hallucine environ un tiers de moins et donne environ un huitième de bonnes réponses en moins. Il a appris à décliner. C'est une vraie amélioration pour tout ce qui a un client à l'autre bout et une vraie régression pour tout ce qui exige une réponse, et le résultat net est un indice composite légèrement moins bon. Si vous choisissez un modèle pour un workflow où une mauvaise réponse coûte cher, ce compromis est probablement le chiffre le plus pertinent de cet article, et il ne figure dans aucun graphique de Meta. La version plus large de ce problème est dans hallucinations IA dans le support, et le côté outillage pour les détecter est dans outils de suivi de LLM.
Le piège du harnais dans les graphiques de Meta
Voici maintenant la partie qui m'a fait relire l'article de lancement.
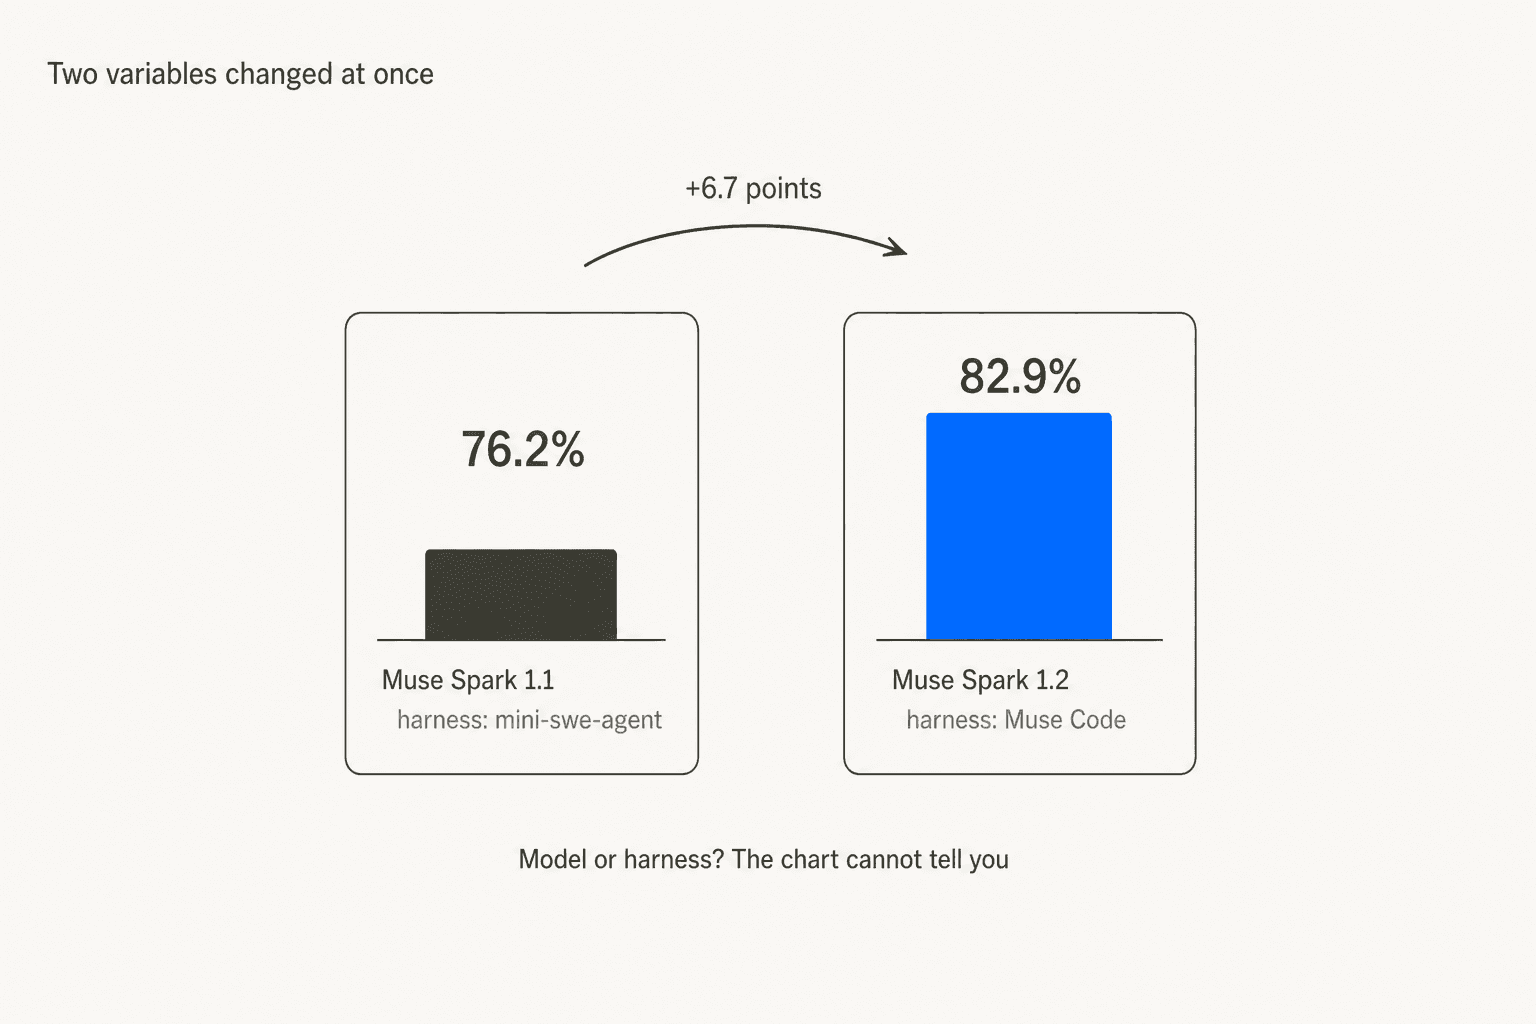
Le graphique Terminal-Bench 2.1 de Meta montre Muse Spark 1.2 à 82,9 % et Muse Spark 1.1 à 76,2 %. Dans le petit texte gris sous chaque barre, il nomme aussi le harnais dans lequel chaque modèle a tourné : 1.2 a tourné dans Muse Code, 1.1 dans mini-swe-agent. Même chose sur le graphique DeepSWE. Meta ne le cache pas, c'est imprimé juste là, mais l'œil lit les barres et pas la note de bas de page.
Meta dit aussi clairement avoir « co-trained Muse Spark 1.2 with Muse Code », y compris avec des « rejection sampled harness trajectories » et des optimisations de recette pour les objectifs, la compaction et les sous-agents. Le modèle a donc été réglé sur le harnais dans lequel il est évalué.
Le seul graphique où aucun harnais n'est nommé est le benchmark de code interne de Meta, et c'est le plus plat de la page :
| Modèle | Meta Internal Coding Bench |
|---|---|
| Opus 5 (max) | 79.4% |
| Muse Spark 1.2 | 70.6% |
| Muse Spark 1.1 | 68.3% |
| GPT 5.6 Terra (max) | 65.4% |
| Gemini 3.6 Flash (high) | 63.9% |
2,3 points, sur le graphique où le harnais cesse d'être une variable. Comparez aux 6,7 points de Terminal-Bench et aux 6,3 de DeepSWE, où il en est une. Je ne dis pas que Meta a truqué quoi que ce soit. Je dis que si vous comptez exécuter ce modèle dans votre propre outillage, le chiffre à harnais contrôlé est celui qui prédit votre expérience, et c'est le plus petit chiffre de la page.
Un commentateur du fil de lancement sur Hacker News a formulé la version générale de cela mieux que moi :
"Outputs are a little bit more deterministic if you control the harness. It is easy to benchmark across one harness, one system prompt and extract the most performance when you control the harness."

Ce n'est d'ailleurs pas un problème propre à Meta. Chaque laboratoire livre désormais un agent maison et mesure dedans, de Claude Code à Codex en passant par Grok Build. C'est simplement inhabituellement lisible ici parce que Meta a imprimé les noms des harnais sur le graphique.
Muse Code, la partie vraiment nouvelle
Muse Code s'installe en une ligne et s'exécute sous le nom muse dans n'importe quel répertoire de projet :
curl -fsSL https://dev.meta.ai/install.sh | bash
L'idée de conception est le fan-out. Vous donnez à l'agent parent un lot de tâches dans un seul prompt, et il lance un enfant capable d'écrire par tâche, chacun dans son propre git worktree, de sorte que les enfants en parallèle ne touchent jamais les mêmes fichiers.
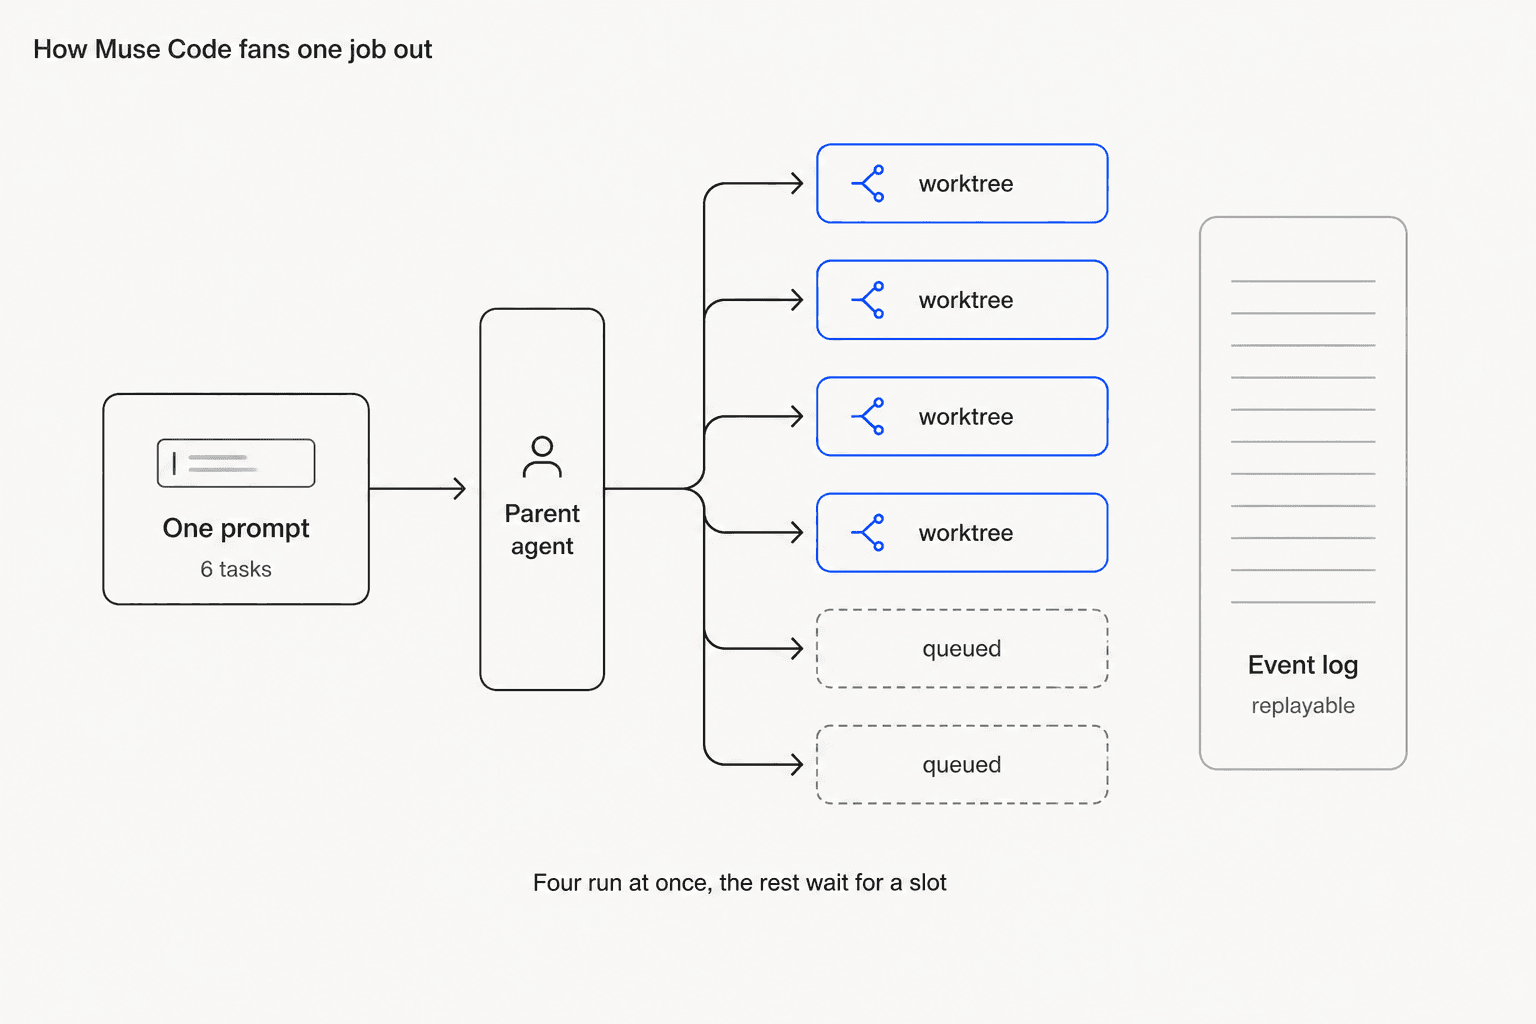
Le cookbook de fan-out de Meta déroule un lot de six tâches sur un dépôt de jeu d'exemple. Le parent lance six enfants, la limite de concurrence de l'hôte donne quatre, et les tâches cinq et six attendent en file que des places se libèrent.
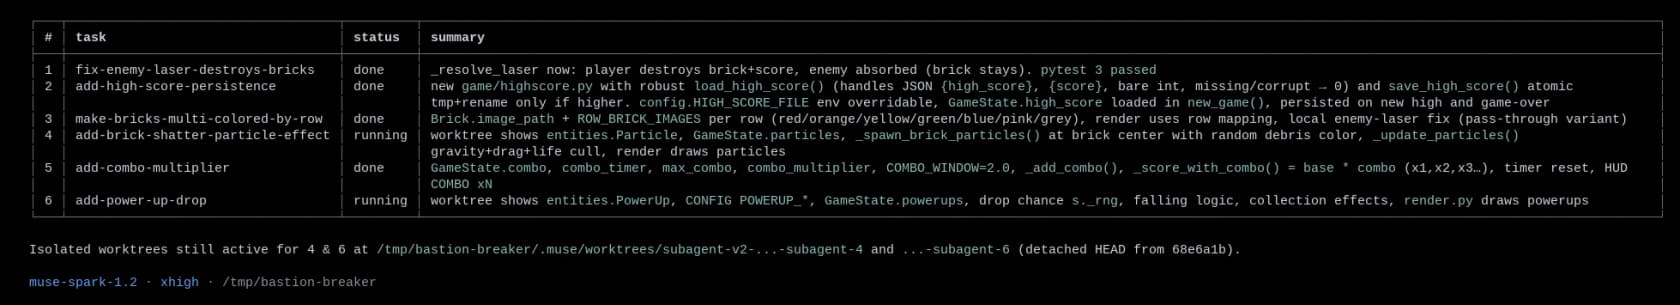
subagent_status renvoie cette liste, avec la tâche de chaque enfant, son état et un résumé d'une ligne de ce qu'il a modifié. Remarquez la barre d'état dans la capture de Meta : muse-spark-1.2 · xhigh. L'effort est réglé haut dans la démo, ce qui mérite d'être gardé en tête quand on compare les chiffres à sa propre facture. Les worktrees atterrissent sous .muse/worktrees/ en état detached HEAD, extraits du HEAD du parent, sans commande git worktree manuelle. Dans l'exécution de Meta, l'enfant qui a corrigé le bug passe toute la suite de tests dans son propre worktree tandis que le master du parent échoue encore à ce même test.
Deux autres éléments méritent d'être cités :
- Un journal d'événements rejouable. Chaque appel de modèle, exécution d'outil, approbation et modification est ajouté à du JSONL simple sur votre disque, que vous pouvez parcourir avec
jq. Le même journal alimentemuse resume, de sorte qu'une session plantée reprend à la dernière étape enregistrée au lieu d'être relancée de zéro. - Skills intégrés. Quatre playbooks sont fournis :
/plan(ancre un plan dans vos vrais fichiers, puis s'arrête pour approbation),/grilling(vous interroge avec une question qui force une décision à la fois),/grill-with-docset/taste(une checklist anti-slop de réglages visuels par défaut à éviter). Ils ne s'invoquent que explicitement, l'agent n'ira donc pas chercher/grillde lui-même, et un skill n'est chargé que pour le tour où vous l'invoquez.
Si vous voulez un regard plus long sur la façon dont cette catégorie se dessine, mon article sur la CLI de code agentique couvre le sujet. Construire le vôtre est un autre projet, et le guide du Claude Code SDK est la comparaison la plus proche de ce que Meta a construit ici.
Pour le marché des outils au sens large, il y a le comparatif des meilleurs assistants de code IA. Quiconque le met en balance avec le leader actuel devrait commencer par l'aperçu de l'assistant de code Claude AI.
Mon avis honnête sur Muse Code : l'isolation par worktree pour chaque sous-agent et un journal d'événements à rejeu exact sont de la bonne ingénierie, et la réaction d'un commentateur de Hacker News rejoint la mienne, à savoir que « Muse code is more interesting than the new model. » Savoir s'il bat le harnais que vous utilisez déjà, une bêta et un article de blog ne peuvent pas y répondre.
Tarif de Muse Spark 1.2 et l'échange contributor
Meta publie deux IDs de modèle pour un seul modèle, et l'écart entre eux est toute l'histoire.
| ID du modèle | Contexte | Entrée / Mtok | Entrée en cache / Mtok | Sortie / Mtok | Politique de données |
|---|---|---|---|---|---|
muse-spark-1.2-contributor | 1M | $0.10 | $0.002 | $0.20 | "Used to improve our products" |
muse-spark-1.2 | 1M | $1.25 | $0.15 | $4.25 | "Not used to improve our products" |
Ces libellés sont les termes mêmes de Meta, tirés de sa page du modèle. Le tarif standard est inchangé par rapport à 1.1, donc si vous payiez déjà pour l'ancien modèle, 1.2 est une mise à niveau gratuite côté prix.
Le palier contributor est limité en tokens sur une fenêtre glissante de 5 heures plutôt qu'en nombre de requêtes, et Meta dit qu'il est disponible dans certains pays. Meta note aussi qu'elle accepte désormais les demandes de rétention zéro des données via les ventes, ce qui est la porte d'entrée entreprise sur le palier standard.
Sur un mélange normal de 3:1 entre entrée et sortie, cela revient à 0,125 $ par million de tokens sur l'ID contributor contre 2,00 $ sur le standard. 16x, et le taux de change, c'est votre trafic.
Deux chiffres pour recouper tout cela. Artificial Analysis a mesuré Muse Spark 1.2 à 0,399 $ par tâche de l'Intelligence Index au tarif standard, soit 37 % de plus que les 0,292 $ de 1.1 parce que le modèle réfléchit davantage. Appliquez le même mélange de tokens à la grille contributor et vous arrivez près de 0,017 $ par tâche, ce qui serait sous DeepSeek V4 Flash à 0,027 $, le modèle le moins cher de ce classement. Ce second chiffre est mon propre calcul à partir des coûts en tokens par tâche publiés par AA, pas un résultat mesuré, et il suppose que les écritures en cache sont facturées au tarif d'entrée, ce que Meta ne publie pas. C'est la comparaison avec DeepSeek qui mérite qu'on s'y attarde, car ce modèle est à poids ouverts et vous pouvez l'exécuter là où personne n'entraîne sur vous. Ma critique de DeepSeek V4 Flash donne le tableau complet.
Même au tarif standard, l'argument de valeur tient. Muse Spark 1.2 obtient 56,8 à l'Intelligence Index pour 0,399 $ par tâche ; Claude Opus 5 obtient 63,1 pour 2,34 $. Six fois le coût pour onze pour cent d'indice en plus. Que ces onze pour cent comptent dépend entièrement de votre charge de travail, ce qui est le même argument que dans alternatives à Claude Opus 5.
Une réserve sur la facture de raisonnement : 339,82 $ des 639,27 $ qu'a coûté à Artificial Analysis l'exécution de l'indice complet sont partis dans des tokens de raisonnement que vous ne voyez jamais. Le réglage /effort de Meta les monte et les descend, et sur les tâches simples c'est le premier bouton que je tournerais. C'est le même poste caché qui rend le tarif de l'API Anthropic difficile à prévoir à partir d'une seule grille tarifaire.
Ce que disent les développeurs
Le fil de lancement a récolté 333 points et 266 commentaires, et la réaction s'est partagée selon une ligne nette : le prix est intéressant, la question de la confiance n'est pas réglée, et l'enfermement dans le harnais est réel.
Sur le prix, la lecture a été immédiate :
"If you are happy to share data for training, the contributor mode offers amazing price $0.10 / $0.20"
Quelqu'un d'autre a présenté le même fait comme une question ouverte sur la valeur des données :
"Very interesting they have a way cheaper "contributor" version "used to improve our products", how much of that is price discrimination vs the data being that valuable? Roughly DeepSeek V4 Flash pricing, though you can get V4 from providers that don't train on your data"
Le point le plus tranchant pour quiconque compte utiliser le modèle hors de l'agent de Meta est venu d'un développeur qui a essayé exactement cela :
"It's useless. Tried with OpenCode + OpenRouter and it couldn't complete an simple task. It stuck using grep/search tools. I think Muse Spark was so heavily RL'd on the Meta harness that it make it useless or very token inneficient to use in other harness like Opencode."
C'est l'essai d'une seule personne, et il va directement à l'encontre de l'affirmation de Meta selon laquelle elle a entraîné sur plusieurs harnais pour que le modèle « still generalizes to other coding agents you already use. » Je ne considérerais ni l'un ni l'autre comme tranché. Je le traiterais comme la chose précise à tester en premier, avec un petit essai payant dans votre propre outillage, avant de basculer un workflow dessus. Le même conseil vaut pour tout modèle spécialisé par domaine réglé à fond sur un seul environnement.
Un autre commentateur a mesuré sur OpenRouter un débit d'environ 150 tokens par seconde, ce qui est rapide pour cette catégorie. L'API elle-même accepte les requêtes au format OpenAI, donc la substitution se résume surtout à un changement d'URL de base, le même type de migration que dans API OpenAI vs Anthropic.
Et la mention d'un « accès mondial élargi » a reçu un démenti net d'au moins un utilisateur, qui a signalé que le palier contributor restait réservé aux États-Unis. La formulation de Meta est plus étroite que le titre : l'ID bon marché est « available in select countries », ce qui n'est pas la même promesse qu'un modèle disponible dans le monde entier.
Les poids ouverts arrivent, sans date
Quatre jours après le lancement, le Chief AI Officer de Meta a fait l'annonce que beaucoup attendaient depuis trois générations de modèles :
"1/ big announcement today: we will be releasing an open weight version of muse spark 1.2 soon. we also are releasing muse glimmer, a 30B agentic model with open weights under apache 2.0. muse glimmer can run on 24GB of VRAM without losing agentic reliability. 🧵"
Glimmer est sorti. Les poids de Spark 1.2, non, et « soon » ne porte ni licence ni date. Je planifierais avec ce qui est réellement téléchargeable aujourd'hui, c'est-à-dire Glimmer en 30B sous Apache 2.0, et je traiterais Spark à poids ouverts comme une bonne surprise s'il arrive. Meta a l'habitude de livrer d'abord l'élément voisin : le même schéma est apparu avec Muse Image.
Si les poids ouverts sont toute la raison pour laquelle vous lisez ceci, Qwen3.8 Max est l'alternative sérieuse disponible aujourd'hui. La comparaison DeepSeek vs Kimi K3 est celle que je lirais avant de choisir entre les deux autres.
Alors, qui devrait vraiment utiliser Muse Spark 1.2 ?
Où il atterrit, après une semaine avec les chiffres :
- Vaut le coup d'essayer si vous lancez de longs travaux agentiques avec un budget serré. Le bond de l'indice agentique est réel, le contexte est un vrai 1M et, à 0,40 $ par tâche au tarif standard, il coûte environ un sixième d'Opus 5. L'étude de cas d'optimisation de noyau en donne la forme honnête : sur plus de 1 000 appels d'outils et jusqu'à 24 heures, Muse Spark 1.2 a atteint +68,7 % par rapport à la base, quatrième sur six, derrière Opus 5 à +74,0 %, GPT-5.6 Sol à +71,2 % et Opus 4.8 à +69,6 %. Lisez la courbe plutôt que le point d'arrivée et il est aussi plus lent au départ : proche de 27 % à 200 appels d'outils quand Opus 5 dépassait déjà 60 %. Il y arrive. Il prend le chemin long.
- Vaut le coup d'essayer si votre code n'est pas sensible. Le palier contributor est tarifé comme un modèle à poids ouverts et Meta vous dit exactement avec quoi vous payez. Pour les projets perso, le travail open source et les prototypes jetables, c'est un oui franc.
- Probablement pas, si vous avez besoin du haut du classement. Opus 5 domine chaque graphique publié par Meta, y compris celui, interne, de Meta. GPT-5.6 Sol est aussi devant sur l'indice. Si c'est la vitesse brute qui vous manque plutôt que l'intelligence, Gemini 3.6 Flash est la réponse moins chère.
- Probablement pas, pas encore, si vous vous engagez sur un harnais. Les meilleurs chiffres de code viennent du duo avec Muse Code, Muse Code est en bêta, et le seul retour public d'une exécution ailleurs était mauvais. Cette combinaison plaide pour un test, pas pour une migration.
- Pas seul, si le travail est le support client. La baisse de précision en parallèle de la baisse d'hallucinations est exactement le compromis qui compte pour une charge de support, et aucun de ces chiffres ne se corrige depuis l'API. Les choix qui tiennent vraiment pour une file d'attente sont dans mon comparatif des meilleurs agents IA, et le cadre budgétaire est dans coût du service client IA.
Essayez eesel
C'est sur ce dernier point que je veux terminer, parce que c'est l'erreur que je vois les équipes commettre chaque trimestre. Une sortie de modèle comme celle-ci fait ressembler un projet d'automatisation du support à une décision de prix. Ce n'en est pas une. Entre muse-spark-1.2 et une IA capable de répondre en toute sécurité à un vrai client, il y a la recherche sur votre propre contenu, des seuils de confiance, des règles d'escalade et un moyen de savoir ce qu'elle fera avant qu'elle ne le fasse. C'est la différence entre un agent IA et un chatbot, et c'est là que le projet se joue vraiment.
eesel est cette couche. Il se branche sur le helpdesk que vous utilisez déjà, apprend de vos propres tickets résolus plutôt que d'une exploration web générique, et simule d'abord sur votre historique de tickets pour que vous voyiez le taux de résolution et les réponses avant qu'un seul client ne les voie. Cette étape de simulation existe parce que j'ai vu un bot à l'air sûr de lui donner discrètement de mauvaises réponses, et un taux d'hallucination de 33 % n'est pas un chiffre que l'on veut découvrir en production.

Si vous évaluez des modèles parce que votre file d'attente déborde, commencez par l'autre bout. Lancez une simulation sur vos derniers milliers de tickets, voyez ce qui est réellement dévié, puis discutez des tokens. Gratuit à essayer, sans carte pour commencer.
Deux lectures de plus si vous en êtes plus tôt dans cette décision. Mon article sur le meilleur LLM pour le support couvre bien le choix du modèle. Pour l'argumentaire business, les chiffres sont dans coût d'un agent IA vs agent humain.
Questions fréquentes
Combien coûte Meta Muse Spark 1.2 ?
muse-spark-1.2 coûte 1,25 $ par million de tokens en entrée, 0,15 $ en cache et 4,25 $ en sortie, identique au tarif de Muse Spark 1.1. L'ID muse-spark-1.2-contributor coûte 0,10 $ en entrée, 0,002 $ en cache et 0,20 $ en sortie, et la page du modèle de Meta indique que le trafic sert à améliorer ses produits. Les tokens de raisonnement sont facturés au tarif de sortie dans les deux cas.