

En bref
Muse Spark Open est le premier modèle Muse à poids ouverts de Meta, sorti le 15 octobre 2026 : 816B de paramètres au total, 42B actifs, une fenêtre de contexte de 1M de tokens, et des entrées texte, image, vidéo et audio. Il est excellent pour appeler des outils et très difficile à jailbreaker, et mène le tableau comparatif de Meta sur MCP-Atlas (89.2) et JobBench (61.8).
Il y a deux bémols. Ce n'est pas le modèle ouvert le plus intelligent : il obtient 39 sur l'Artificial Analysis Intelligence Index, derrière GLM 5.3 (45), Kimi K3 (44) et Qwen 3.8 (40), et il est derrière ces deux leaders en code. Et il est facturé comme un modèle fermé : chaque hébergeur demande 1,25 $ en entrée et 4,25 $ en sortie par million de tokens, comme l'API fermée Muse Spark 1.3 de Meta, parce que la licence donne à Meta un droit de regard sur les gros hébergeurs.
Mon verdict : 3.5/5. Choisissez-le si vous avez besoin de poids auto-hébergeables pour un agent qui utilise beaucoup d'outils et voulez un comportement prudent côté sécurité. Passez votre chemin si vous voulez le meilleur modèle ouvert pour le code ou les tokens les moins chers. Et si ce que vous voulez vraiment, c'est un agent qui répond aux tickets de support, le modèle est la plus petite partie du travail ; le coéquipier IA pour helpdesk d'eesel s'occupe du reste.
Qu'est-ce que Meta Muse Spark Open ?
Je construis des agents IA chez eesel, et la première chose que je fais avec tout nouveau modèle, c'est lire la fiche du modèle avant l'annonce de lancement. La fiche du modèle Muse Spark Open sur Hugging Face décrit un modèle à mélange d'experts de 816B paramètres qui en active 42B par token, avec 256 experts dont 8 actifs par token, une fenêtre de contexte de 1M de tokens et un encodeur de vision de 1,8B paramètres greffé pour les images et la vidéo.
C'est le cousin à poids ouverts de la gamme fermée Muse Spark, pas une famille distincte. Le nom Muse couvre aussi Muse Code, l'outil de code de Meta, et l'agent personnel Muse.
L'article de recherche de Meta le qualifie de « the most capable US open-weight model to date » et indique qu'il est livré avec un post-entraînement de sécurité supplémentaire parce qu'une fois les poids publiés, personne ne peut ajouter de garde-fous côté serveur. Le billet développeur ajoute un détail qui compte dans mon domaine : Meta l'a entraîné pour des agents au long cours « such as coding and customer service agents ».
Quelques caractéristiques pratiques tirées de la fiche :
| Caractéristique | Muse Spark Open |
|---|---|
| Paramètres | 816B au total, 42B actifs |
| Contexte | 1M de tokens |
| Entrée | Texte, image, vidéo, audio |
| Sortie | Texte |
| Effort de raisonnement | low, medium, high, xhigh (xhigh par défaut) |
| Poids | BF16 (environ 1,6 To) et NVFP4 (environ 530 Go) |
| Sortie | 15 octobre 2026 |
À noter : le raisonnement est toujours activé. La page du modèle chez Groq dit qu'il « always reasons before answering », et l'effort par défaut est le plus coûteux, xhigh. Si vous voulez des réponses courtes et peu chères, il faut demander vous-même low ou medium.
Comment je l'ai évalué
Je n'ai pas fait tourner ce modèle sur une file de support pendant un an, et je ne ferai pas semblant. Cet avis repose sur le tableau de benchmarks de Meta, les résultats indépendants d'Artificial Analysis, les données de prix et de vitesse en direct chez chaque hébergeur du lancement, le texte complet de la licence, et ce que les développeurs ont dit pendant les 72 premières heures sur Hacker News. Quand les chiffres de Meta et les chiffres indépendants divergent, je le signale.
Mon angle est celui que j'utilise chez eesel pour choisir les modèles du coéquipier helpdesk : appelle-t-il les outils de façon fiable, reste-t-il dans les règles, et combien coûte un mois de trafic réel. J'ai passé des années chez eesel à voir des modèles sûrs d'eux donner de mauvaises réponses sur des files en production, c'est pourquoi chaque déploiement eesel est d'abord simulé sur des tickets historiques. Une victoire en benchmark ne compte que si elle se retrouve là, et c'est toute l'idée des coéquipiers IA testés sur vos données avant leur mise en service.
Là où Muse Spark Open est en tête
Meta compare le modèle à sept autres modèles à poids ouverts : Inkling, Nemotron 3 Ultra, Reflection Beam, Mistral Large 4, Qwen 3.8, GLM 5.3 et Kimi K3. Voici le tableau des scores tel que Meta l'a publié.
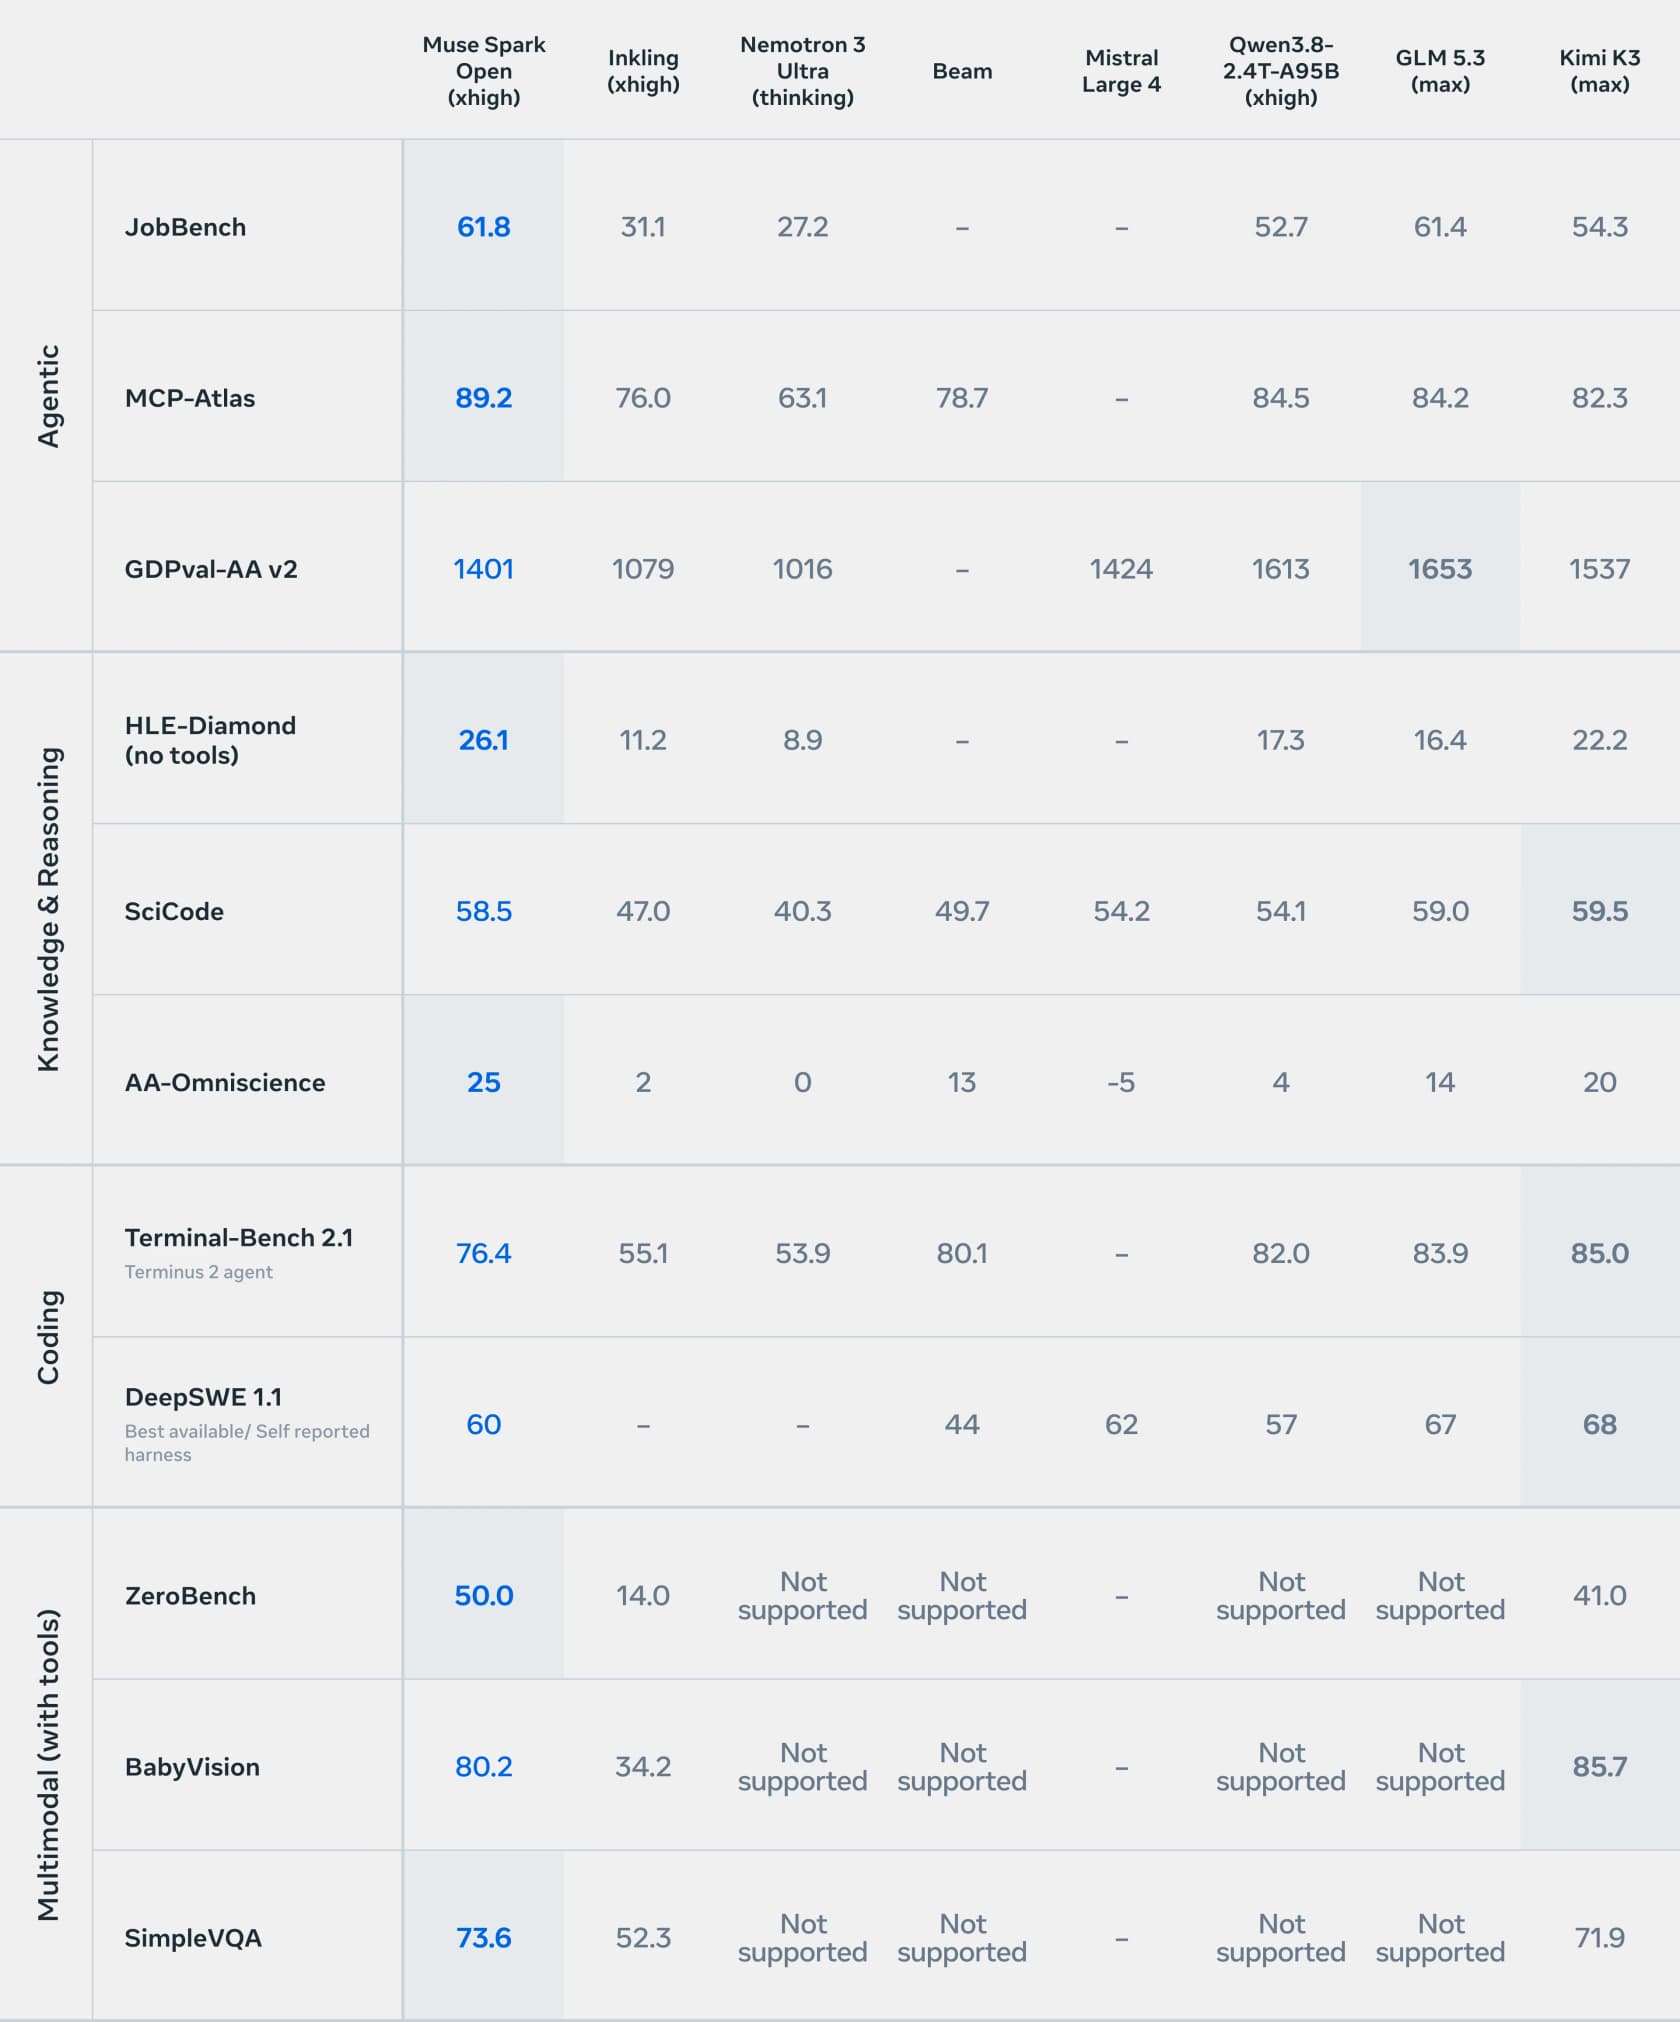
Les victoires sont réelles et se concentrent au même endroit : les agents qui appellent des outils.
- MCP-Atlas
89.2, le meilleur score du tableau. Ce test mesure l'appel d'outils exposés via des serveurs MCP, la tuyauterie que la plupart des agents utilisent désormais pour accéder à un helpdesk, un CRM ou une base de données. - JobBench
61.8, devant les61.4de GLM 5.3 et très au-dessus des54.3de Kimi K3. - HLE-Diamond
26.1sans outils et AA-Omniscience25, les meilleurs du lot sur les questions de connaissances difficiles où l'on pénalise les inventions. - Multimodal : il mène sur ZeroBench (
50.0) et SimpleVQA (73.6) face au seul autre modèle qui supporte ces tests, Kimi K3.
Les deux partenaires de lancement cités par Meta vont dans le même sens.
"Muse Spark Open consistently selected the right next tool and kept its responses compact, exactly the decisiveness production agents need."
Zimu Li, Member of Technical Staff at Factory, quoted in Meta's developer post
Les données indépendantes confirment l'efficacité. Artificial Analysis a mesuré 110M de tokens de sortie pour terminer tout son indice, sous la médiane de 130M, et relevé 130.7 tokens par seconde. C'est important parce que son cousin fermé a fait l'inverse : comme je l'ai expliqué dans mon avis sur Muse Spark 1.3, la 1.3 a consommé 120M de tokens et suscité des plaintes sur sa verbosité.
Là où il est derrière
Le même tableau qui le couronne en usage d'outils le montre perdant dans les catégories que la plupart des développeurs regardent en premier.
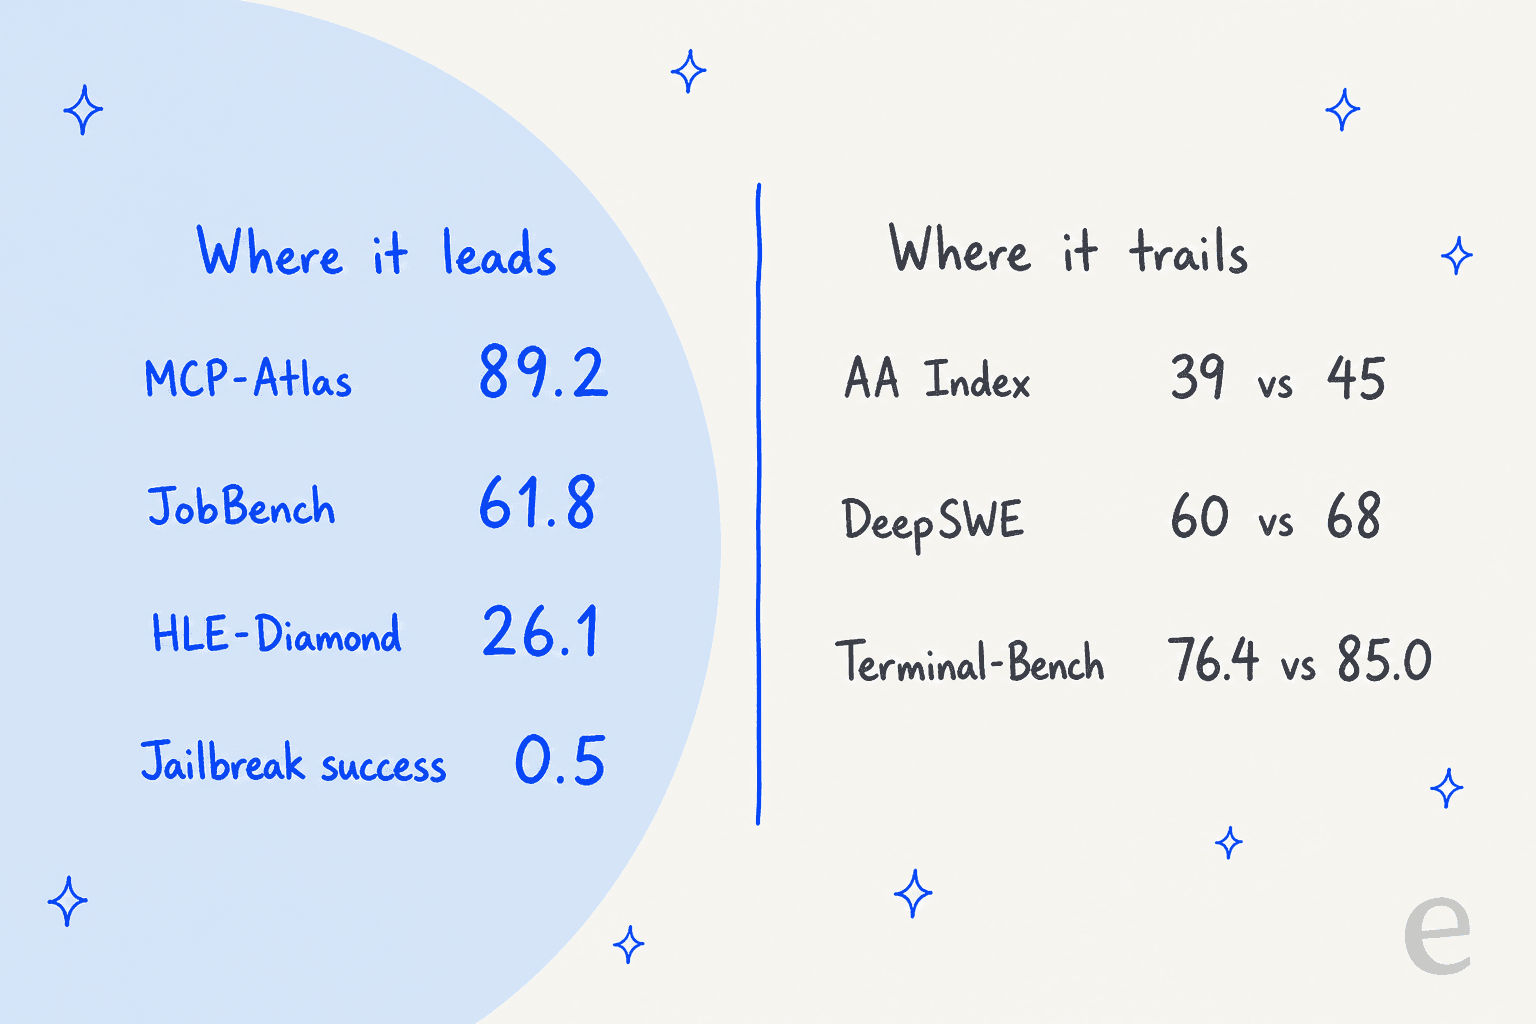
- Intelligence globale. Sur la ligne Artificial Analysis Intelligence Index du tableau de Meta, il obtient
39, derrière GLM 5.3 (45), Kimi K3 (44) et Qwen 3.8 (40), et un point devant Mistral Large 4 (38). Artificial Analysis le classe#10sur 120 modèles suivis. - Code. Sur DeepSWE 1.1, il obtient
60contre68pour Kimi K3 et67pour GLM 5.3. Sur Terminal-Bench 2.1, il obtient76.4contre85.0pour Kimi K3. Même Reflection Beam le bat avec80.1. - Tâches professionnelles réelles. Sur GDPval-AA v2, il obtient
1401, sous Mistral Large 4 (1424), Kimi K3 (1537), Qwen 3.8 (1613) et GLM 5.3 (1653).
Les développeurs l'ont remarqué. L'impression la plus citée dans le fil du lancement tenait en une phrase :
"Feels dumber than GLM 5.3 (only open model I use extensively). But is really fast (fireworks.ai)."

Un autre commentateur le situe entre ses deux cousins fermés : "somewhat worse benchmarks than Muse Spark 1.3, closer to 1.2" (modeless, Hacker News). Cela correspond à ce que disent les chiffres. Si votre travail principal est d'écrire du code, Kimi K3 ou GLM 5.3 est aujourd'hui le meilleur choix parmi les modèles ouverts.
Le compromis de sécurité dont personne ne parle
Meta met la sécurité en avant, et le chiffre phare est frappant. Sur StrongREJECT v2, un test de jailbreak adaptatif où plus bas, c'est mieux, Muse Spark Open obtient 0.5. Kimi K3 obtient 66.6, GLM 5.3 62.9, Qwen 3.8 65.6. La fiche indique aussi 99.2% de refus des jailbreaks cyber sur le benchmark interne de Meta et un taux d'honnêteté de 98.1% sur MASK.
Mais le même tableau contient un second chiffre que la plupart des articles ont ignoré. FORTRESS donne deux scores : un score de risque adversarial (ARS, à quelle fréquence il aide à nuire) et un score de sur-refus (ORS, à quelle fréquence il refuse ce qu'il devrait traiter). Plus bas, c'est mieux pour les deux.
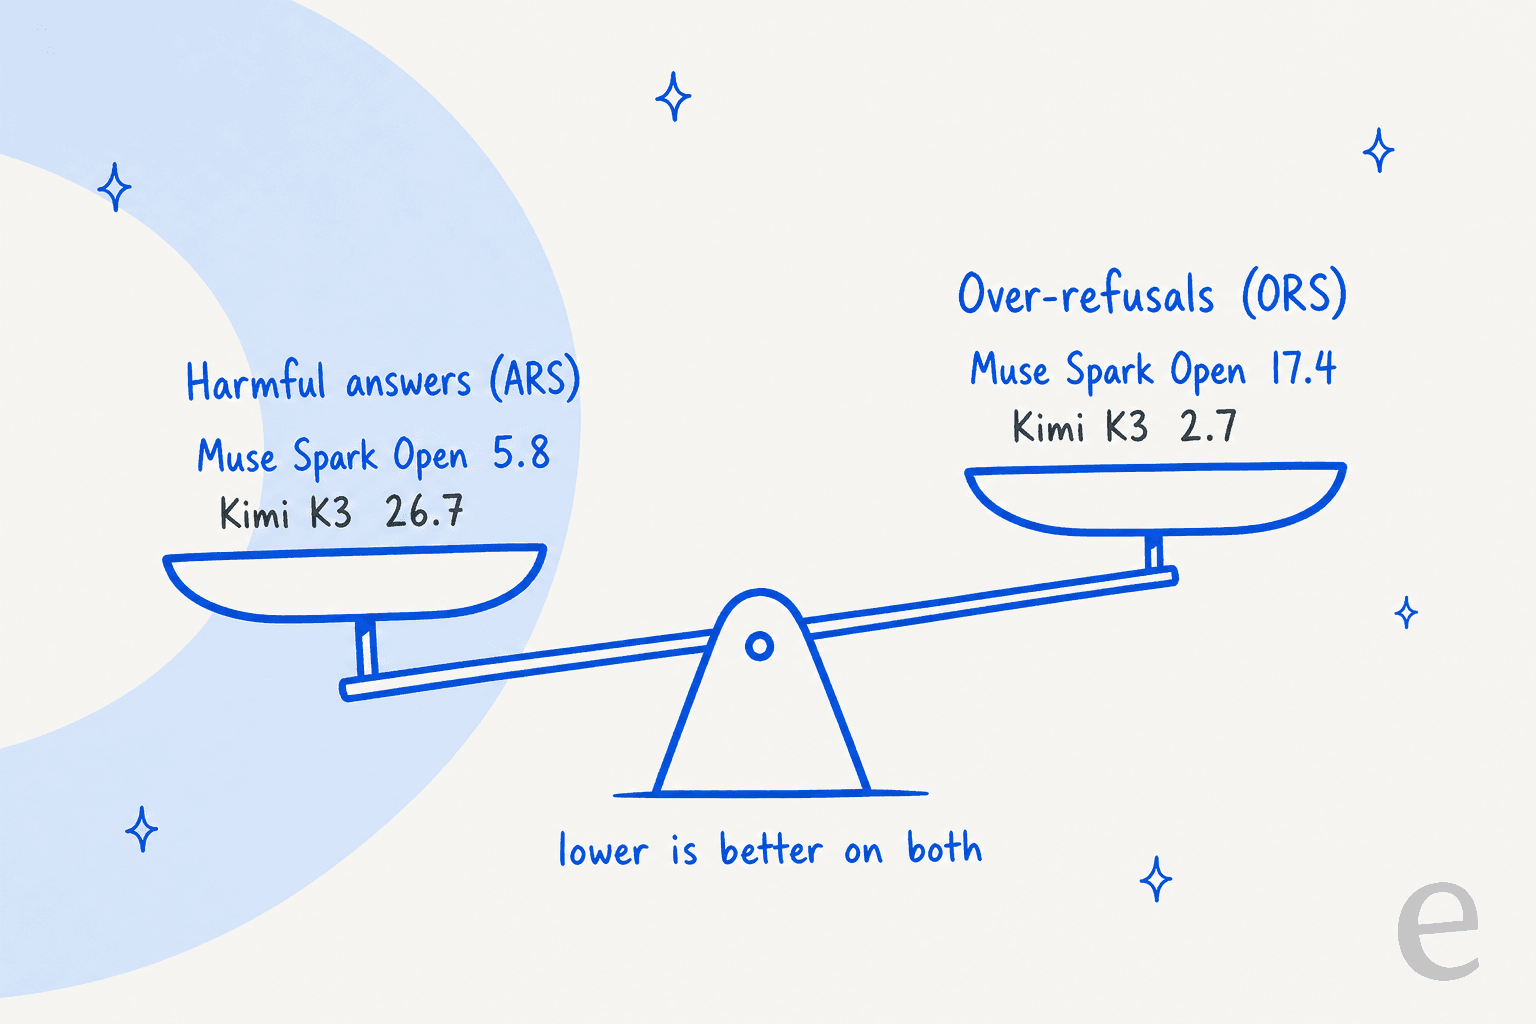
L'ORS de Muse Spark Open est de 17.4. Celui de Kimi K3 est de 2.7, celui de GLM 5.3 de 3.2. En clair : c'est le modèle du tableau le plus difficile à piéger et le plus susceptible de dire non à une demande légitime. Pour un agent de service client, c'est un vrai compromis. Une question de remboursement mal formulée, ou un client qui décrit la panne d'un dispositif médical, est exactement le genre de message anodin qu'un modèle trop prudent peut refuser. Je le testerais sur vos propres tickets en désordre avant de croire le chiffre de sécurité dans un sens ou dans l'autre.
Tarifs : poids ouverts, prix de modèle fermé
Voici ce qui m'a le plus surpris. Tous les hébergeurs du lancement sur OpenRouter facturent exactement le même tarif.
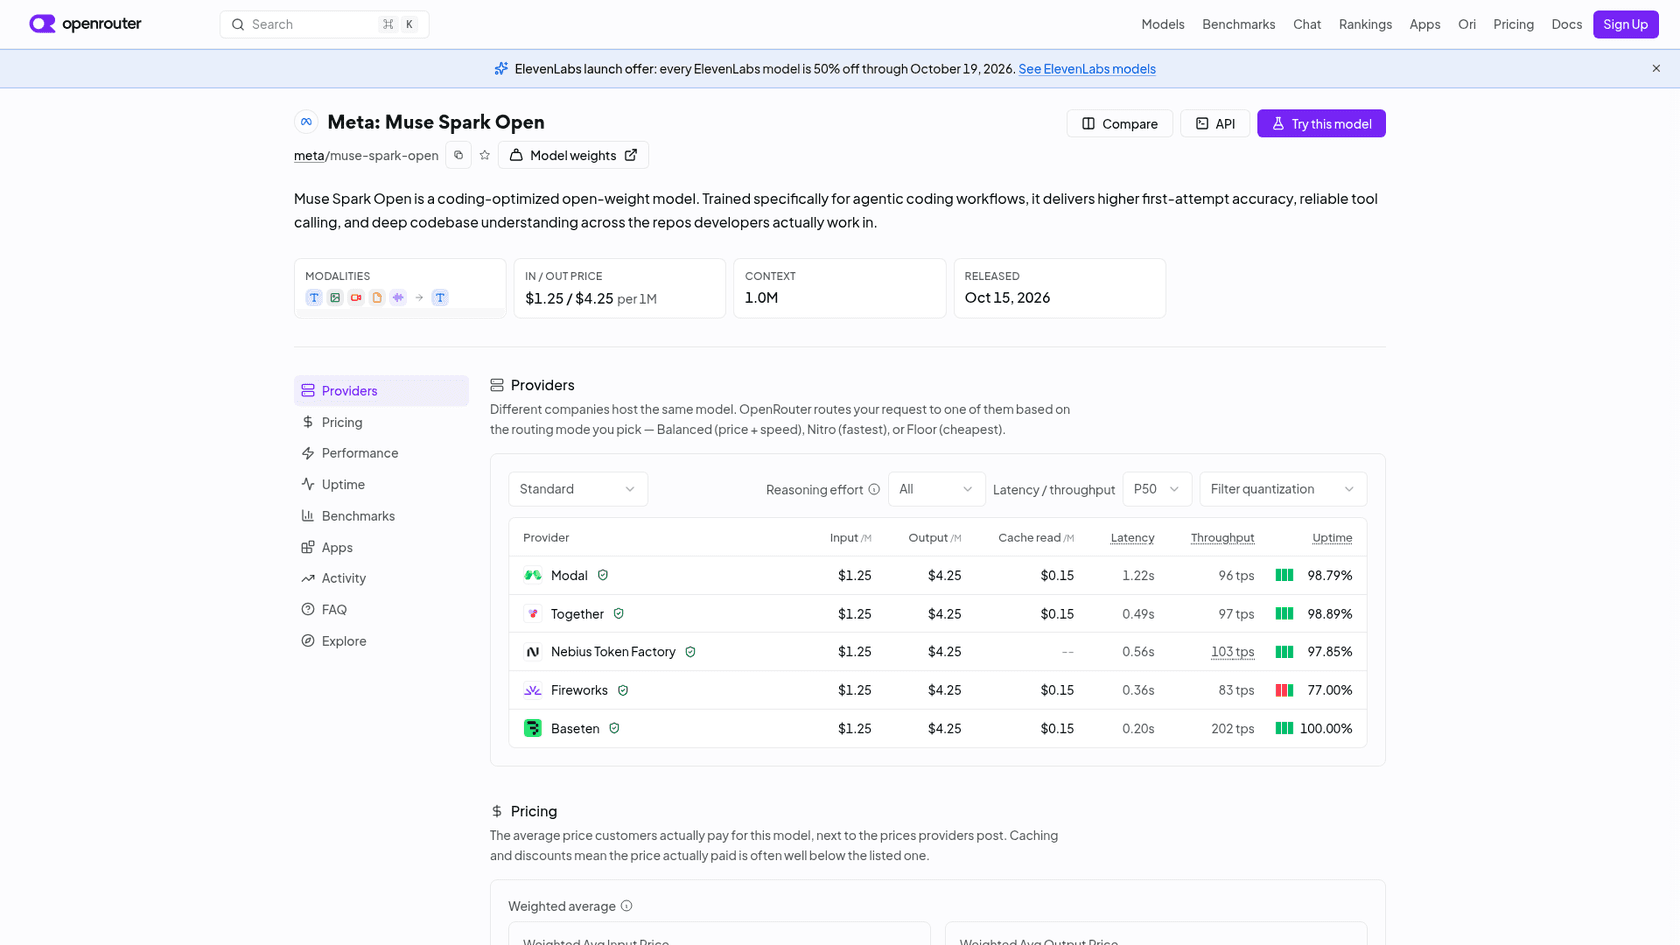
| Fournisseur | Entrée / 1M | Sortie / 1M | Entrée en cache / 1M | Notes |
|---|---|---|---|---|
| Baseten | 1,25 $ | 4,25 $ | 0,15 $ | NVFP4, contexte 1M, environ 200 tokens/s, voir tarifs Baseten |
| Fireworks AI | 1,25 $ | 4,25 $ | 0,15 $ | Fine-tuning LoRA serverless, voir tarifs Fireworks |
| Together AI | 1,25 $ | 4,25 $ | 0,15 $ | Endpoints dédiés avec SLA de 99,9 %, voir tarifs Together |
| Modal | 1,25 $ | 4,25 $ | 0,15 $ | Endpoints partagés ou dédiés |
| Nebius Token Factory | 1,25 $ | 4,25 $ | n/d | |
| Groq | Non indiqué | Non indiqué | n/d | Préversion limitée, contexte 131K, ~350+ tokens/s |
Ce tarif de 1,25 $ / 4,25 $ est identique à ce que Meta facture pour son modèle fermé Muse Spark 1.3 en xhigh. Artificial Analysis le souligne directement : le modèle est "particularly expensive when comparing to other open weight models of similar size", face à une médiane de 0,43 $ en entrée et 1,68 $ en sortie. Son coût pour exécuter une tâche de l'indice est de 0,84 $.
Pourquoi cinq hébergeurs concurrents s'alignent-ils sur le même prix ? La licence en est probablement la raison. Un développeur du fil de lancement l'a formulé ainsi :
"The model license requires large inference providers to contact Meta separately to obtain a license to serve the model... The usual effect of separate licensing is decreased price competition from public providers."
Le contre-argument honnête du même fil : un prix fixe empêche aussi les hébergeurs de servir une version cassée ou dégradée pour se sous-couper (dannyw, Hacker News). Les deux peuvent être vrais.
Que cela coûte-t-il en pratique ? Un exemple approximatif pour un agent qui lit beaucoup et écrit peu (sortie facturée 4,25 $ par million) :
| Volume mensuel | Entrée | Sortie | Facture mensuelle approx. |
|---|---|---|---|
| Petit pilote | 10M de tokens | 2M de tokens | 21 $ |
| Un agent très sollicité | 100M de tokens | 20M de tokens | 210 $ |
| Déploiement dans toute l'équipe | 1B de tokens | 200M de tokens | 2 100 $ |
Mettre en cache le contexte répété à 0,15 $ au lieu de 1,25 $ peut réduire fortement le côté entrée si votre agent réutilise la même base de connaissances à chaque appel. Rappelez-vous que le raisonnement xhigh est la valeur par défaut, donc passez à medium pour des réponses courtes.
Le faire tourner soi-même : ce que demande vraiment le matériel
L'argument qui a retenu le plus d'attention était celui d'Apple : faire tourner un modèle de classe frontière sur son bureau. L'article MLX d'Apple est honnête sur ce que cela implique. Les poids NVFP4 occupent environ 493 Go, et avec la mémoire de travail en plus, "the model cannot fit on a single machine."
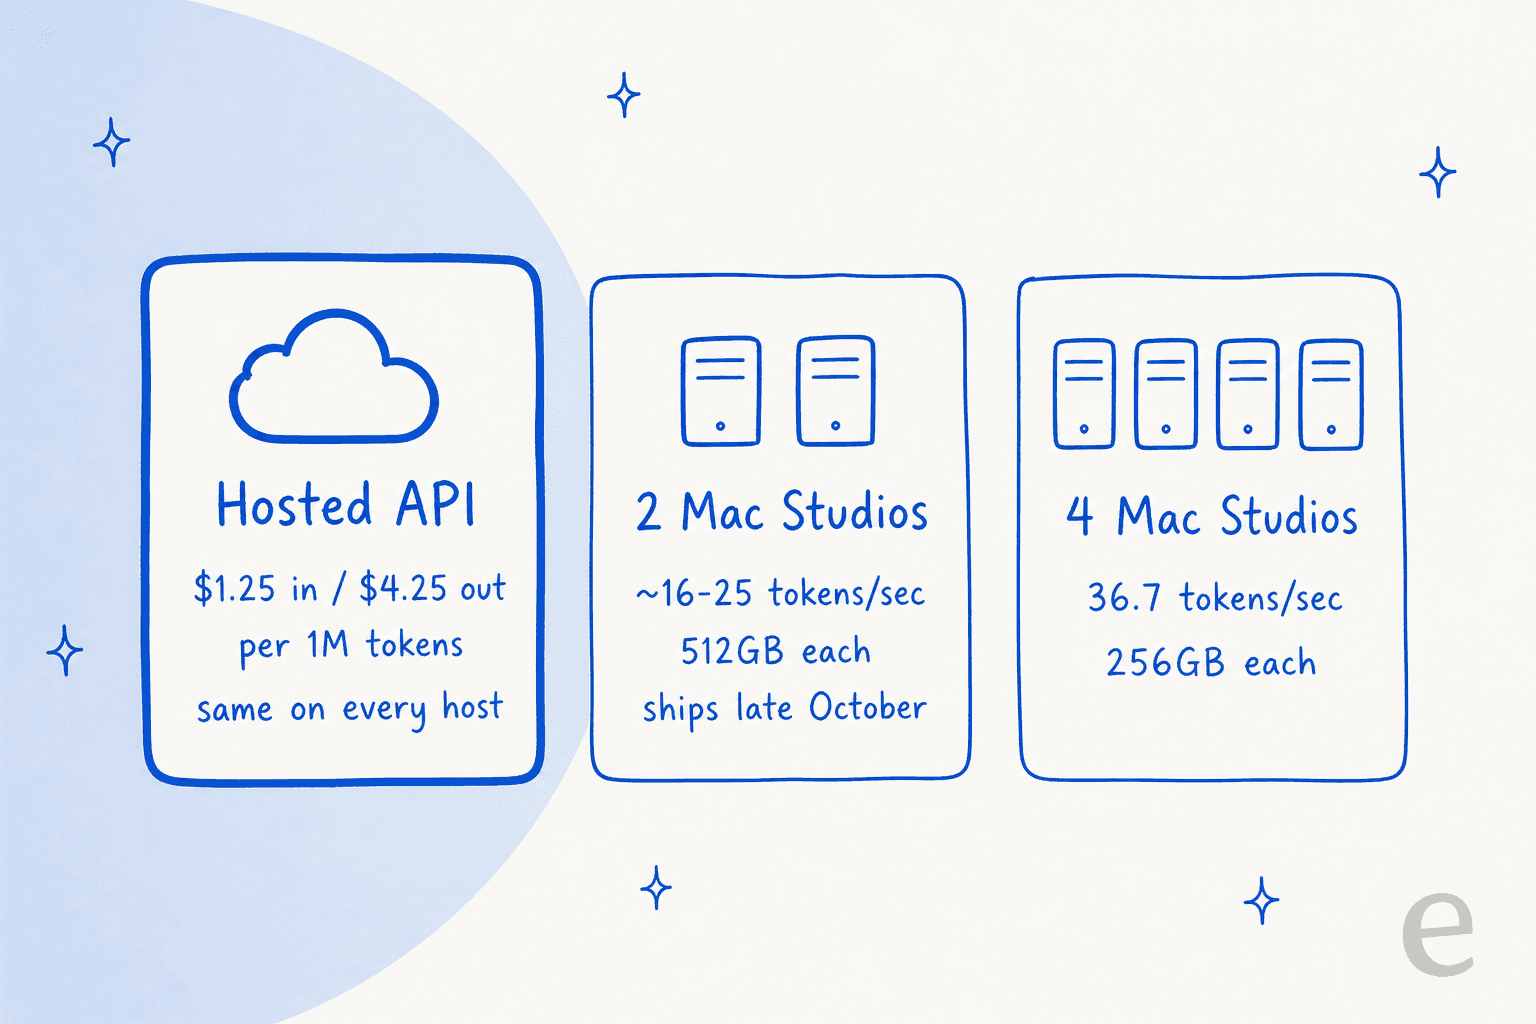
Vitesses de décodage mesurées par Apple avec un contexte de 8 192 tokens :
| Configuration | Vitesse de décodage |
|---|---|
| 2 Mac Studio (M5 Ultra), découpage en pipeline | 15.74 tokens/s |
| 2 Mac Studio (M5 Ultra), découpage tensoriel | 24.99 tokens/s |
| 4 Mac Studio (M5 Ultra), découpage tensoriel | 36.73 tokens/s |
La configuration à deux machines demande le M5 Ultra de 512 Go, que le store d'Apple indique comme "coming late October", sans prix affiché pour l'instant. Les configurations M5 Ultra démarrent à 5 499 $ avec bien moins de mémoire. Un commentateur résume la réaction :
"A single Mac Studio w/ M5 Ultra and half that RAM (256 GB) is around $11k, and the 512 GB option isn't even available yet. So.... yeah."
Côté GPU, la fiche du modèle demande au moins 700 Go de VRAM pour NVFP4 et 2 To pour BF16 ; le billet développeur de Meta indique que NVFP4 tourne sur quatre GPU Blackwell Ultra ou huit H200. La version 2 bits d'Unsloth le ramène à environ 300 Go de mémoire combinée, avec une perte de qualité.
À l'honneur de Meta, le support dès le premier jour est exceptionnellement complet : SGLang, vLLM, TensorRT-LLM, Transformers, MLX, llama.cpp et Unsloth fonctionnaient tous au lancement, avec du fine-tuning via TorchTitan, Fireworks et Together. Comme l'a noté un développeur, Meta "did the actual work of testing and documenting deployments on several platforms" (bahmboo, Hacker News).
Alors, qui devrait l'auto-héberger ? La réponse du fil rejoint la mienne : les équipes qui ont une raison contractuelle ou légale de garder les données sur leur propre matériel (mbreese, Hacker News). Pour tous les autres, à 210 $ par mois pour un agent très sollicité, une API hébergée reste moins chère pendant longtemps qu'une configuration à deux Mac que les commentateurs chiffrent déjà au-dessus de 20 000 $.
Les petites lignes de la licence
La Muse Model License est permissive en surface : usage libre, fine-tuning, distillation et revente. Les conditions qui comptent :
- Attribution dans votre produit. Vous devez "prominently display 'Built with Muse Spark Open'" dans l'interface, la documentation, le site web ou les paramètres de tout produit qui l'utilise ou utilise un dérivé, y compris les modèles entraînés sur ses sorties.
- Un seuil de 20 millions de dollars pour les hébergeurs. Si vous vendez l'accès au modèle comme service et que le chiffre d'affaires de votre entreprise dépasse
20 millions de dollarssur 12 mois, vous avez d'abord besoin d'un accord écrit séparé avec Meta. - Pas d'usage par les moins de 18 ans. La politique d'utilisation indique que le modèle "is not intended for individuals under the age of 18", et les déployeurs sont responsables si des mineurs peuvent y accéder.
- Une politique d'utilisation large. Elle interdit l'exercice non autorisé d'une profession réglementée (juridique, médicale, financière), son usage pour traiter des données personnelles sensibles sans en avoir le droit, et la présentation de ses sorties comme écrites par un humain.
Ce quatrième point compte pour les équipes de support dans les secteurs réglementés. Un agent qui rédige des réponses pour une entreprise de santé ou de finance a de toute façon besoin d'une conception avec un humain dans la boucle, et la fiche de Meta recommande elle-même "human-in-the-loop confirmation for irreversible actions." Savoir s'il est « open source » est un débat légitime ; dans le fil du lancement, plusieurs développeurs l'ont qualifié de "open-weight" au mieux (isityettime, Hacker News).
Muse Spark Open face aux alternatives
| Modèle | AA Index (tableau de Meta) | DeepSWE 1.1 | MCP-Atlas | StrongREJECT (plus bas = mieux) | Idéal pour |
|---|---|---|---|---|---|
| Muse Spark Open | 39 | 60 | 89.2 | 0.5 | Agents riches en outils, déploiements prudents |
| Kimi K3 | 44 | 68 | 82.3 | 66.6 | Code ouvert et travail en terminal |
| GLM 5.3 | 45 | 67 | 84.2 | 62.9 | Meilleur score global parmi les modèles ouverts |
| Qwen 3.8 | 40 | 57 | 84.5 | 65.6 | Usage général |
| Mistral Large 4 | 38 | 62 | n/d | n/d | Déploiements hébergés dans l'UE |
Si vous pouvez utiliser un modèle fermé, l'écart se creuse. Le haut de gamme de Meta est traité dans mon avis sur Muse Wonder, et Claude Opus 5.5 a le même traitement dans mon avis sur Opus 5.5. Les deux obtiennent bien plus de 39 sur le même indice.
Si le prix compte plus que l'usage d'outils, commencez par mon avis sur DeepSeek V4 Flash. Qwen 3.8 est l'autre modèle ouvert à regarder, traité dans mon avis sur Qwen 3.8.
Verdict : qui devrait utiliser Muse Spark Open
Note : 3.5/5.
- Choisissez-le si vous avez besoin de poids téléchargeables, si votre agent vit ou meurt selon l'outil qu'il appelle, et si vous préférez qu'il refuse trop souvent plutôt que trop rarement. Les scores MCP et le réglage de sécurité sont de vrais points forts.
- Passez votre chemin si vous écrivez surtout du code (Kimi K3 ou GLM 5.3), voulez les tokens ouverts les moins chers (le plancher de
1,25 $ / 4,25 $est fixé), ou comptiez le faire tourner sur une seule machine. - Testez avant de vous fier au taux de sur-refus sur votre propre trafic.
La leçon plus large pour les équipes de support, c'est que le modèle est rarement ce qui casse. Dans les appels commerciaux d'eesel, l'échec dont j'entends le plus parler est un bot qui a répondu à de vrais clients avec des détails inventés alors que la base de connaissances n'avait rien de pertinent. Un autre acheteur, évaluateur technique dans une entreprise de matériel, a demandé sans détour si l'IA se rabattrait sur des connaissances générales du web quand elle ne savait pas, et si on pouvait le désactiver. Ce sont des problèmes de recherche d'information, de garde-fous et de passage de relais. Passer à un modèle plus intelligent ou plus sûr ne les règle pas à lui seul. Mon guide sur l'automatisation du support avec des agents IA détaille les couches qui, elles, les règlent.
Essayer eesel pour votre helpdesk
Si vous vous intéressiez à Muse Spark Open parce que vous voulez un agent IA qui travaille sur votre file de support, le coéquipier IA helpdesk d'eesel vous évite de magasiner des GPU. Il se branche sur Zendesk, Freshdesk, Gorgias et d'autres en quelques minutes, apprend de vos anciens tickets et de votre centre d'aide, et est simulé sur vos tickets historiques avant de répondre à un seul client. Vous décidez quels tickets il traite, lesquels il rédige en notes internes, et quand il passe la main à une personne.

Si vous préférez intégrer un modèle vous-même, mon guide pour connecter Claude à votre helpdesk montre le travail que cela représente. La voie de Meta est traitée dans Muse pour le support client.
Les offres démarrent à 299 $ par mois sur la page de tarifs d'eesel, et vous pouvez d'abord essayer gratuitement. Essayez eesel et voyez ce qu'il aurait répondu sur les tickets du mois dernier.
Comment Muse Spark Open se compare-t-il à Kimi K3 et GLM 5.3 ?