

Meta Muse Spark 1.3 est un modèle réellement solide pour le code et le contexte long, sorti le 2026-09-02, et il mérite son titre : un Artificial Analysis Intelligence Index de 62 pour le niveau le plus élevé, 6e sur 636 modèles. Mais trois choses tempèrent l'enthousiasme. D'abord, le niveau qui obtient 62 est max, et le raisonnement max était encore verrouillé par des tests de sécurité au lancement, donc le niveau que vous pouvez réellement exécuter est xhigh. Ensuite, le discours de Meta sur des "agents améliorés" est en réalité une histoire de code amélioré : Opus 5 max le bat encore sur quatre des six lignes d'agents dans le propre graphique de Meta. Enfin, il est verbeux, consommant environ 3x les tokens de Muse Spark 1.2, si bien que votre facture réelle dépasse le tarif affiché.
Le tarif est la partie la plus intéressante : un point d'accès standard à $1.25 / $4.25 par million (données privées) à côté d'un point d'accès contributeur à environ $0.10 / $0.20 (Meta s'entraîne sur votre trafic). Si vous l'évaluez pour le support client, rappelez-vous qu'un modèle est une infrastructure, pas un collègue. eesel met à votre disposition un agent de support IA prêt à travailler qui fonctionne avec des modèles comme celui-ci, se branche sur votre helpdesk et se simule sur vos anciens tickets avant de répondre à qui que ce soit.
Ce que "avis" signifie ici, et ce que je n'ai pas pu tester
Je construis des intégrations et des API pour gagner ma vie, donc quand je lis le lancement d'un modèle, le communiqué de presse m'intéresse moins que ce que la chose fait une fois branchée. C'est l'angle de cet avis. J'ai lu attentivement le blog de recherche de Meta et sa méthodologie d'évaluation, relevé les chiffres sur Artificial Analysis et lu tout le fil de lancement sur Hacker News, où 261 commentaires sont arrivés en une journée.
Ce que je n'ai pas pu faire, c'est exécuter max de bout en bout, et ce n'est pas un raccourci de ma part. Le blog de Meta lui-même dit que les modes de raisonnement précédemment disponibles sortent aujourd'hui "with max reasoning coming shortly after we finish additional safety testing." Le mode qui obtient 62 n'est donc pas celui que la plupart des gens peuvent encore appeler. Quand je parle de comportement en conditions réelles, je parle de xhigh, le niveau réellement disponible, qui obtient 61. Gardez cet écart en tête pour la suite, car le marketing de Meta, lui, ne le fait pas.
Le seul graphique que Meta veut vous faire lire
Tout avis sur Muse Spark 1.3 va s'ouvrir sur ce tableau, alors je le montre puis je dis ce qu'il ne dit pas.
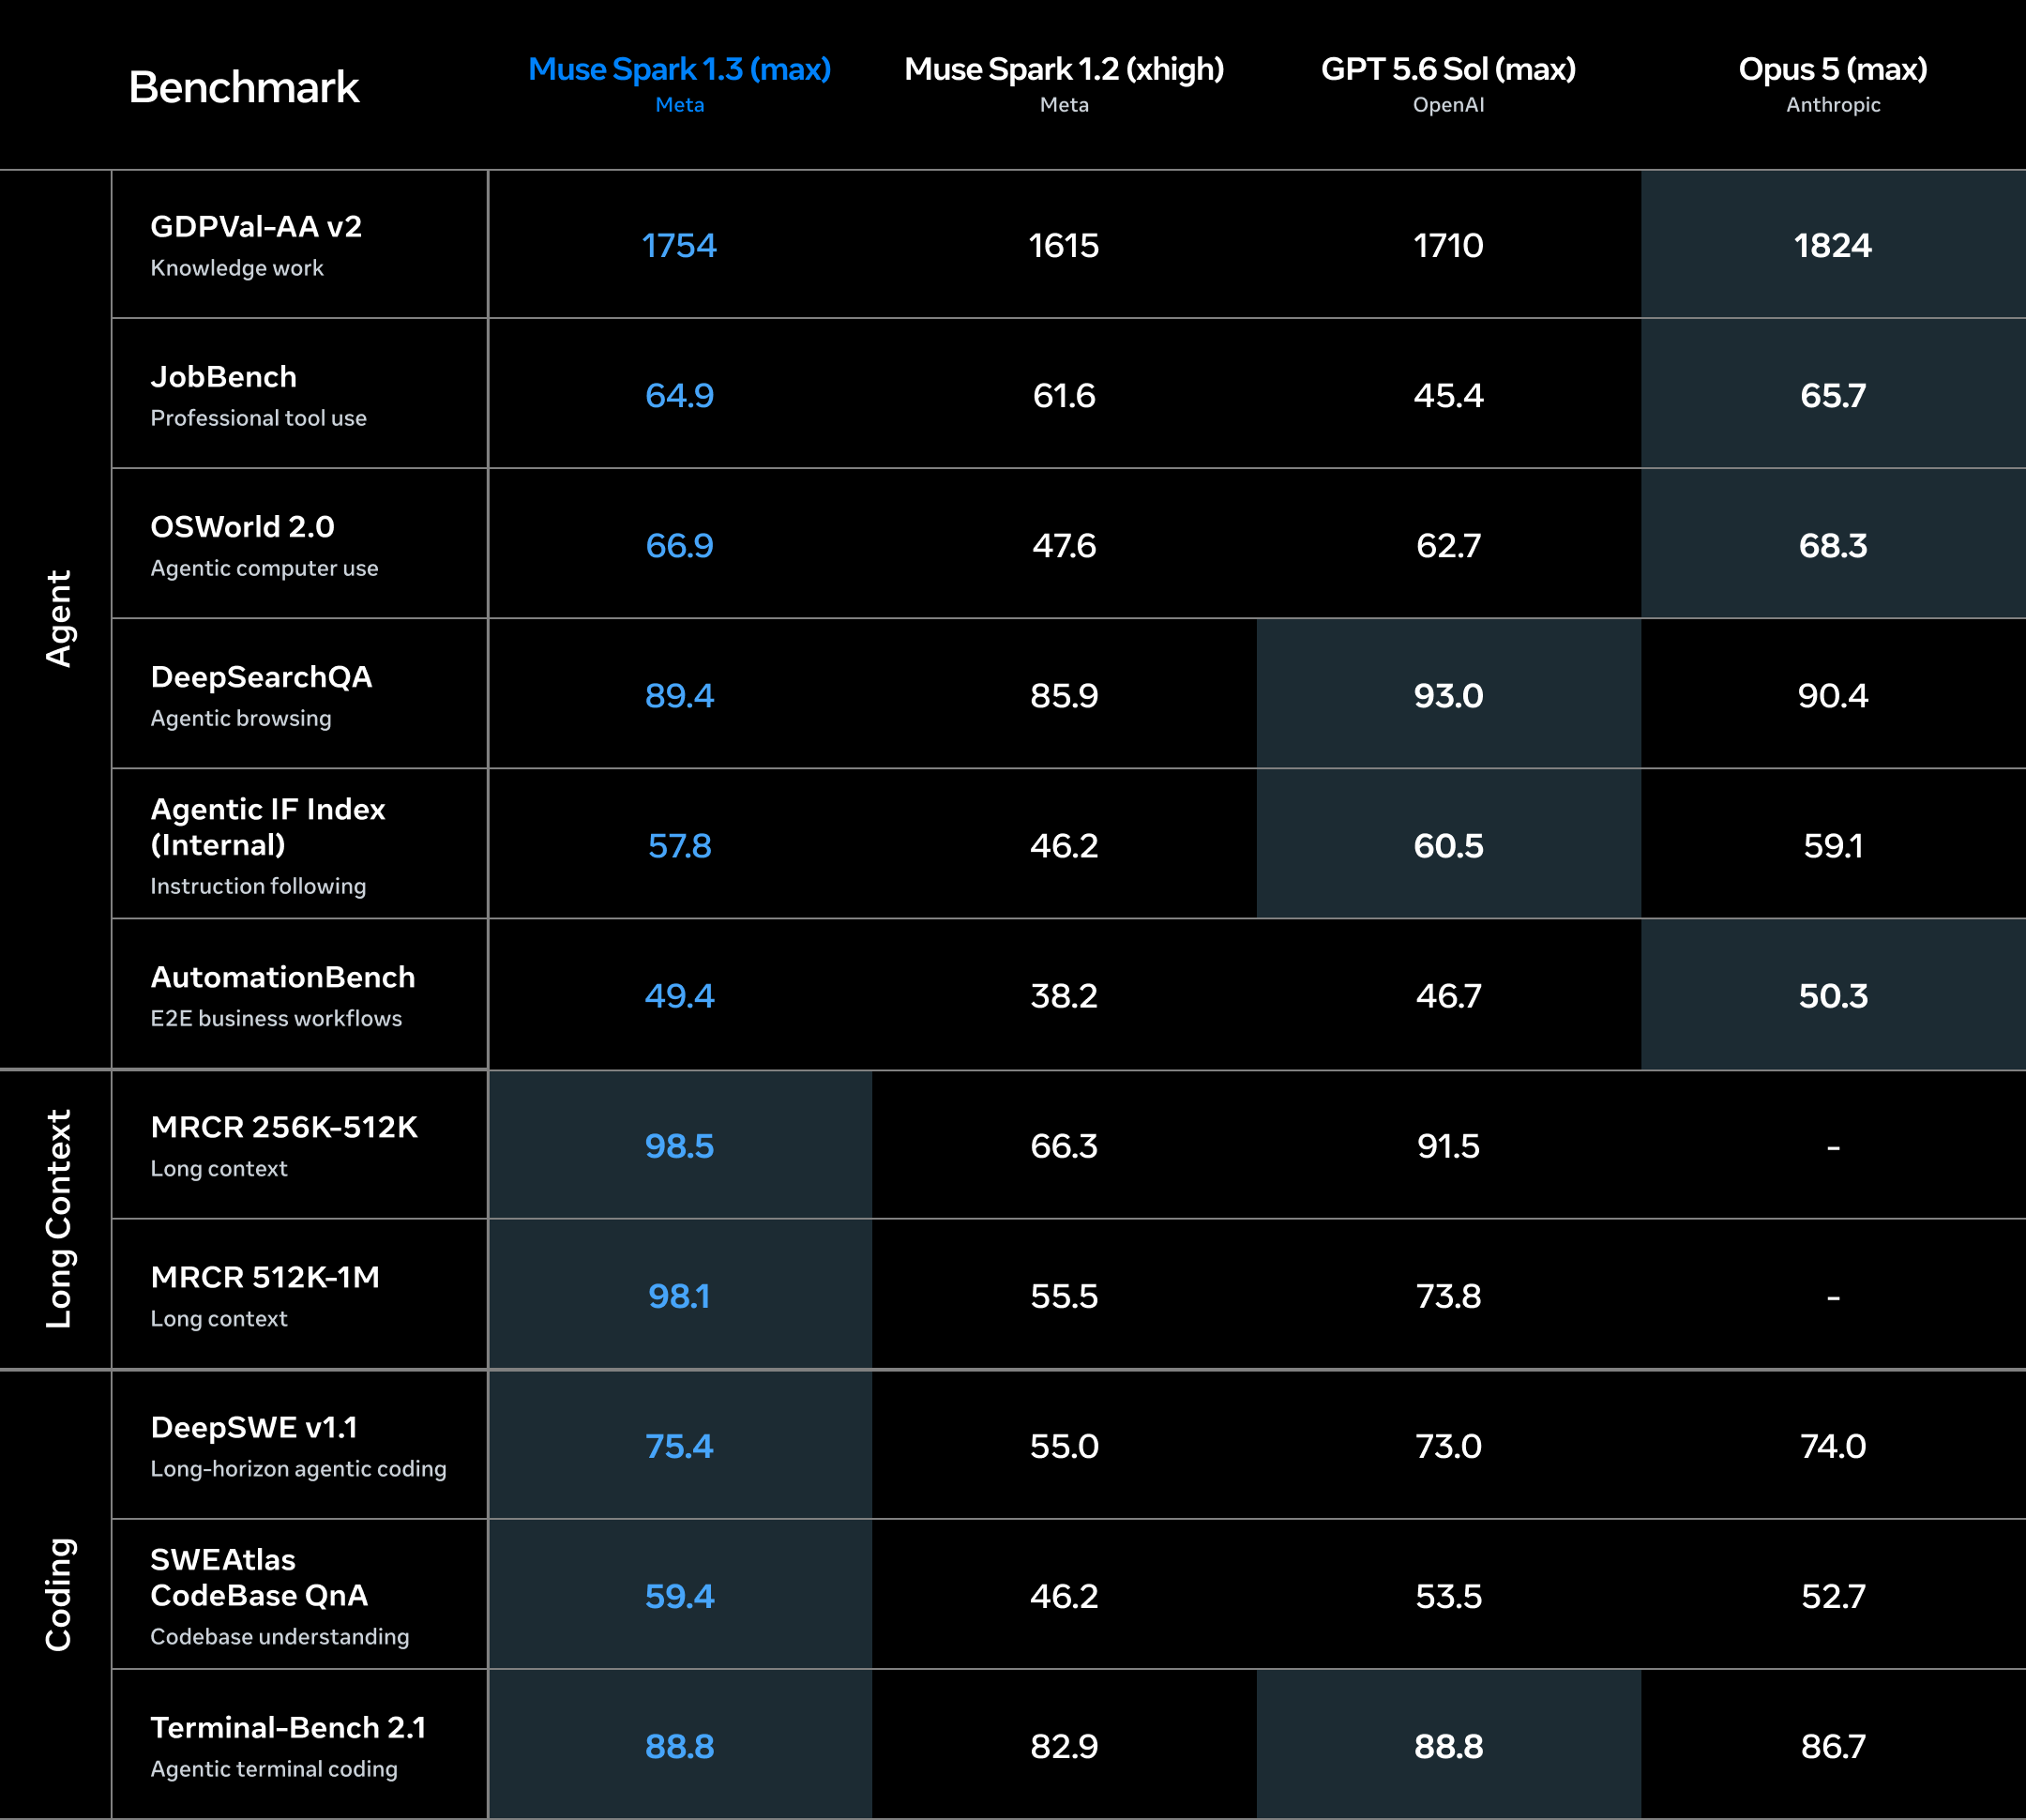
Les quatre colonnes sont Muse Spark 1.3, Muse Spark 1.2, GPT-5.6 Sol et Opus 5, sur les catégories agents, code, suivi d'instructions et contexte long. On dirait une victoire nette de 1.3. Voici l'astérisque : la colonne 1.3 est max, et la colonne 1.2 à laquelle elle est comparée est xhigh. Ce n'est pas une comparaison à armes égales. Une partie du saut que vous voyez est un changement de niveau de raisonnement, pas un changement de génération de modèle. Un commentateur HN, sunaookami, a signalé que le tableau "only shows max reasoning" alors que max est précisément le mode verrouillé, et a jugé cela malhonnête. On vous montre la meilleure version possible de 1.3 face à une version intermédiaire de 1.2.
Cela ne rend pas le modèle mauvais. Cela fait du graphique un artefact marketing, ce que sont toujours les graphiques de lancement. Lisez-le pour la direction, pas pour la taille exacte de l'écart.
Où il gagne vraiment : contexte long et code
Sans le cadrage, les vraies victoires restent réelles, et elles se concentrent à deux endroits.
En contexte long, 1.3 est excellent. Sur le test de rappel MRCR de Meta, il obtient 98.5 dans la tranche 256K-512K et 98.1 sur 512K-1M, bien devant les chiffres de 1.2 à côté. Si votre charge de travail est "lis cette énorme base de code ou ce corpus de documents et raisonne sur l'ensemble", ce rappel est une raison légitime de s'y intéresser. La fenêtre de contexte de 1M tokens n'est pas qu'une marge marketing ici ; les scores de rappel disent qu'il utilise réellement la fenêtre.
En code, les écarts par rapport à 1.2 sont la partie la plus crédible du blog de Meta parce qu'ils sont précis. Les ingénieurs de Meta rapportent environ 20% d'appels d'outils en moins et 25% de tokens en moins sur les mêmes tâches de code, avec un style plus net et moins bavard. Sur DeepSWE v1.1, il obtient 75.4 contre 55.0 pour 1.2, et il égale GPT-5.6 Sol à 88.8 sur Terminal-Bench 2.1. Un testeur de la communauté, majerep, a qualifié la version précédente de "the best free model available on OpenCode" pour des tâches précises et modérées, et les chiffres de code disent que 1.3 creuse cette avance. Si je cherchais un modèle bon marché pour piloter une boucle de code agentique, celui-ci serait sur la liste restreinte à côté de Kimi K3 et de DeepSeek V4 Flash.
Où l'histoire "agentique" est en réalité une histoire de code
Voici la découverte que je n'attendais pas en arrivant. Le titre de Meta est "improved performance across agentic and coding tasks", et la moitié agentique ne tient pas face au modèle que Meta a elle-même choisi pour la comparaison.
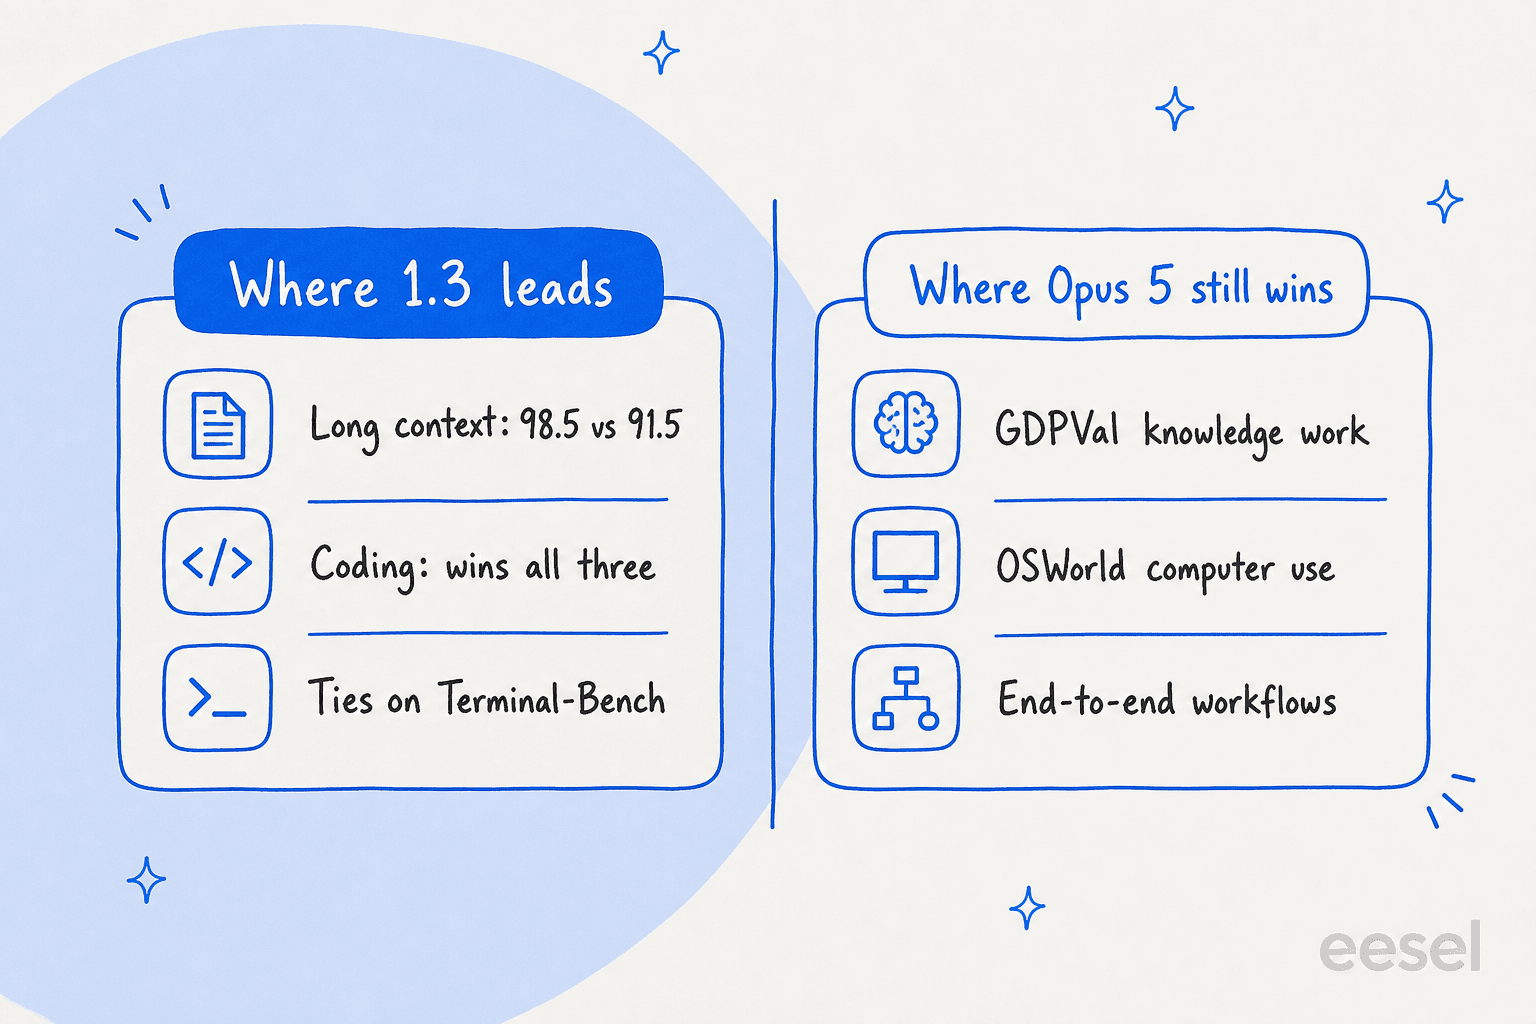
Parcourez les six lignes d'agents du tableau de Meta. Opus 5 max gagne GDPVal-AA v2 (1824 contre 1754), JobBench (65.7 contre 64.9), OSWorld 2.0 (68.3 contre 66.9) et AutomationBench (50.3 contre 49.4). GPT-5.6 Sol remporte DeepSearchQA (93.0) et l'Agentic Instruction-Following Index (60.5). Muse Spark 1.3 perd donc toutes les lignes d'agents face à l'un ou l'autre rival. Là où il domine, c'est le code et le contexte long, ce qui est une affirmation différente de "meilleur agent". La lecture honnête est que "agents améliorés" signifie surtout "code amélioré", et le code est bel et bien amélioré.
Je veux être juste, car c'est toujours un modèle du top dix et les écarts sur les agents sont minces. Mais si vous choisissez un modèle spécifiquement pour l'usage d'outils en plusieurs étapes et le contrôle d'ordinateur, le tableau publié par Meta vous dit discrètement qu'Opus 5 est le choix le plus sûr pour ce travail. Pour l'automatisation du support, où une action "agentique" erronée signifie une mauvaise réponse à un vrai client, cette distinction compte beaucoup, et c'est pourquoi nous simulons chaque agent sur d'anciens tickets avant sa mise en service plutôt que de faire confiance à une ligne de benchmark.
La taxe de verbosité que personne ne met dans le tableau
La vitesse et le prix paraissent excellents jusqu'à ce qu'on compte les tokens. Pour terminer l'Artificial Analysis Intelligence Index, Muse Spark 1.3 a émis 120 millions de tokens de sortie, contre une médiane du champ de 72 millions. Cela le classe 139e sur 636 en verbosité, ce qui signifie qu'il est plus bavard que la plupart des concurrents.
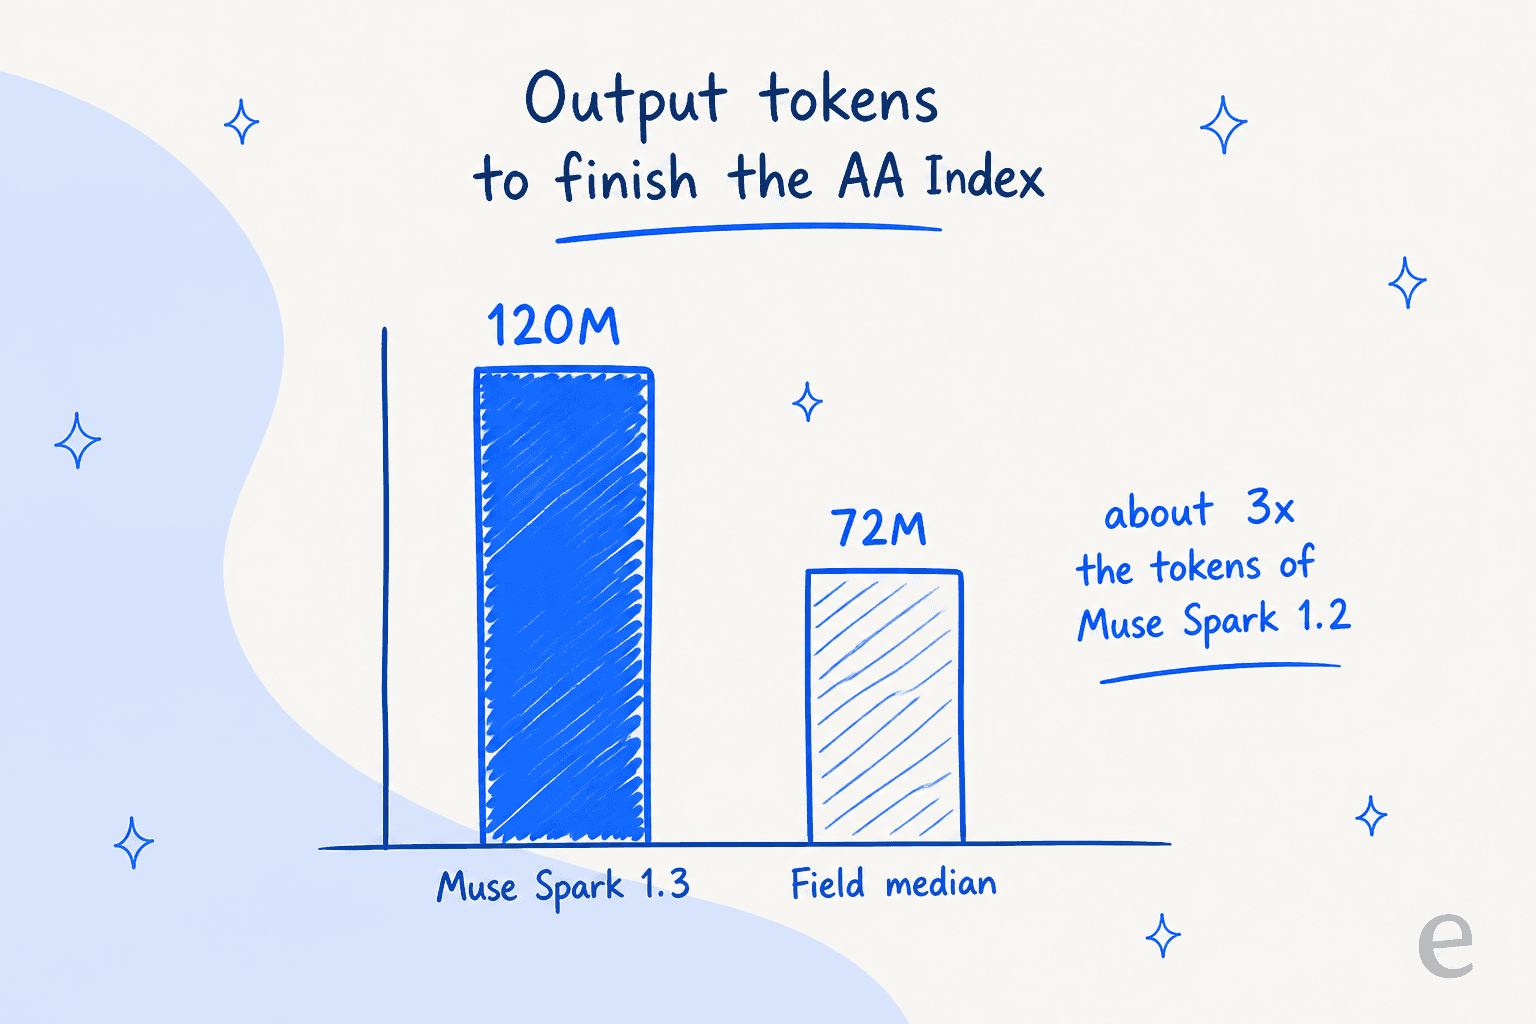
La foule de Hacker News, qui a lancé son habituel test de résistance SVG du pélican sur un vélo, a estimé de manière indépendante environ 3x la consommation de tokens de 1.2. Comme vous payez au token de sortie, la verbosité est un multiplicateur de coût direct. Un tarif de sortie de $4.25 par million qui produit trois fois plus de tokens n'est pas vraiment un modèle à $4.25 en pratique. C'est le chiffre que je mettrais à côté de la grille tarifaire avant de signer quoi que ce soit, et c'est exactement le genre de coût total caché qu'un compteur de tokens brut dissimule et qu'un prix fixe par résolution ne dissimule pas.
Le tarif, ce sont deux tarifs, et l'écart est toute l'histoire
La tarification de Muse Spark 1.3 est ce dont on parle le plus, à juste titre, car ce sont en réalité deux prix avec un péage de données entre les deux.
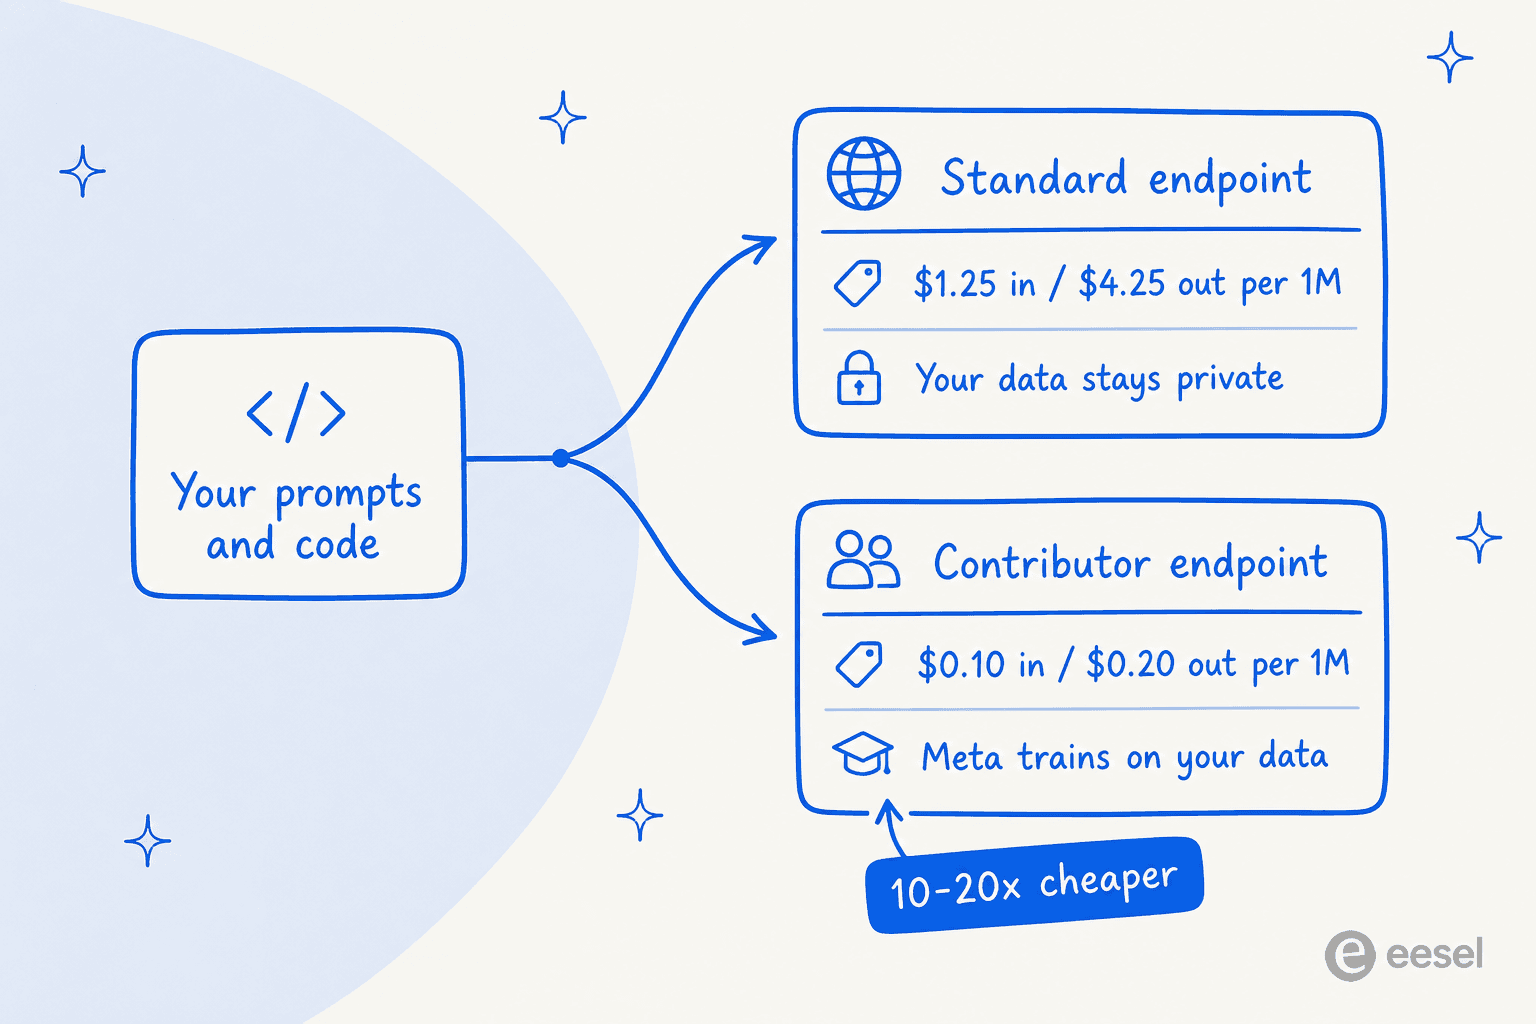
| Point d'accès | Entrée / 1M | Sortie / 1M | Meta s'entraîne sur vos données ? |
|---|---|---|---|
| Standard (xhigh) | $1.25 | $4.25 | Non |
| Contributeur | ~$0.10 | ~$0.20 | Oui |
Le tarif standard est modérément cher face à une médiane d'entrée de $1.75, et Artificial Analysis a mesuré $0.55 par tâche de l'Index. Le point d'accès contributeur est 10 à 20x moins cher parce que vous payez Meta en données plutôt qu'en dollars. L'interprétation de la communauté sur la raison de cette séparation est plus incisive que le discours de Meta lui-même :
"It's not that Meta really wants your data and they're willing to pay top dollar for it. It's that companies really don't want Meta to have their data and they're willing to pay top dollar for that."

Tout est dit en deux phrases. La prime ne paie pas un meilleur modèle ; c'est le prix pour garder Meta hors de votre trafic. Pour un projet de loisir, on hausse les épaules. Pour tout ce qui touche des données personnelles de clients, le point d'accès "pas cher" n'est pas vraiment une option, donc le chiffre sur lequel planifier est le standard à $1.25 / $4.25, multiplié par le coefficient de verbosité ci-dessus.
Ce que la communauté pense vraiment
L'opinion le jour du lancement était réellement partagée, et ce mélange est instructif. Les optimistes aiment le rapport prix-intelligence. Comme l'a noté HDBaseT, le point d'accès contributeur est "by far the cheapest, significantly cheaper per M than ChatGPT Luna, significantly smarter than Luna too." Les sceptiques n'étaient pas convaincus sur les capacités, disant de la version précédente :
"Used Muse Spark 1.2 and was not impressed at all. Fast and cheap but even GPT 5.6 Terra felt much more capable."
Et mromanuk a décrit avoir buté avec 1.2 sur une vraie application web et être retourné vers Claude, Kimi K3 ou DeepSeek V4, en espérant que 1.3 passe la barre. Le fil conducteur : rapide et bon marché est réel, la capacité de premier plan est contestée, et l'outil avec lequel vous le pilotez compte. Plusieurs commentateurs, dont meric_, ont insisté sur le fait qu'il faut l'exécuter dans le harnais Muse Code de Meta, avec lequel il a été entraîné conjointement, sinon on laisse de l'efficacité sur la table.
Qui devrait l'utiliser, et qui devrait passer son chemin
Soyons concrets, car un avis qui se termine par "ça dépend" vous a fait perdre votre temps.
- Utilisez-le si votre charge de travail est le code ou le raisonnement en contexte long, que vous pouvez travailler dans Muse Code et que vos données ne sont pas sensibles, de sorte que le point d'accès contributeur est envisageable. À cette intersection, c'est un choix solide et bon marché.
- Envisagez-le pour des agents de code sensibles au coût où vous opteriez sinon pour Kimi K3 ou DeepSeek V4 Flash. Prévoyez un budget pour la verbosité.
- Passez votre chemin, pour l'instant si vous avez besoin du meilleur usage agentique d'outils (le tableau pointe vers Opus 5), si vous avez besoin de
maxdès aujourd'hui (toujours verrouillé), ou si vous traitez des données réglementées et ne pouvez pas payer la prime standard. - Oubliez complètement le modèle brut si ce que vous voulez vraiment, c'est de l'automatisation du support client. C'est un autre produit, et j'explique pourquoi ci-dessous.
Un modèle n'est pas un collègue : ce que cela signifie pour une équipe de support
Voici le piège dans lequel je vois tomber les responsables du support chaque fois qu'un modèle comme celui-ci fait le buzz. Ils lisent "modèle agentique du top dix, ultra bon marché" et pensent pouvoir le brancher sur leur boîte de réception. Un modèle brut est une infrastructure, comme une base de données ou une API de paiement. Il est puissant et générique. Il ne connaît pas votre politique de remboursement, n'est pas relié à votre helpdesk, n'a aucun souvenir des tickets de la semaine dernière et n'a aucun frein intégré avant d'envoyer une réponse fausse mais assurée à un client payant. Meta dit même que 1.3 est meilleur pour "confirming before consequential actions", ce qui est un aveu qu'un modèle brut a besoin de ce garde-fou ajouté.
Cet écart entre un modèle et un coéquipier opérationnel est ce que eesel existe pour combler. eesel est une plateforme de coéquipiers IA, et vous embauchez des coéquipiers prêts à travailler pour des missions précises. L'effectif actuel comprend un agent de support IA et un rédacteur de blog IA. L'agent de support arrive en sachant déjà faire le travail : il s'entraîne sur votre base de connaissances et vos anciens tickets, rejoint votre file existante, rédige ou résout automatiquement et escalade proprement quand il le faut. Le modèle en dessous est un composant interchangeable ; un modèle de pointe comme Muse Spark 1.3 est exactement le type de moteur sur lequel il peut tourner, mais la valeur se trouve dans tout ce qui l'entoure.
La partie qui se rattache directement à un lancement de modèle de code comme celui-ci est la CLI eesel. Si vous aimez Muse Code parce que vous pouvez piloter un agent depuis un terminal, vous comprendrez pourquoi c'est important. La CLI est un moyen adapté aux agents d'utiliser le même coéquipier eesel et le même espace de travail que ceux du tableau de bord : une personne peut l'exécuter à la main dans un terminal, des scripts peuvent l'automatiser en CI, et des agents de code comme Claude Code, Codex et Cursor peuvent le piloter directement. C'est le même coéquipier, pas un produit séparé au rabais, donc vous pouvez gérer des sources, déclencher des exécutions et récupérer l'activité sans cliquer dans une interface. C'est la différence entre "voici une clé de modèle, bonne chance" et "voici un collègue que vous pouvez aussi scripter".
Essayez eesel plutôt qu'une clé de modèle brute
Si vous êtes arrivé à cet avis parce que vous hésitez à construire de l'automatisation de support sur un modèle de pointe bon marché, la réponse honnête est que le modèle est la partie facile et le moindre de vos problèmes. eesel vous donne l'agent de support IA déjà prêt pour la tâche : il fonctionne avec des modèles de pointe comme celui-ci, se connecte à Zendesk, Freshdesk et au reste de votre stack et, ce qui réduit réellement le risque, vous permet de le simuler sur des milliers de vos anciens tickets pour voir son vrai taux de résolution avant qu'il ne réponde à un client.
Cette étape de simulation est la leçon que nous avons apprise à la dure après des années à mettre de l'IA sur des files de support en production : nous avons vu des bots à l'assurance trompeuse donner discrètement de mauvaises réponses, c'est pourquoi rien chez eesel n'arrive à un client sans un essai à blanc sur votre propre historique. Vous pouvez commencer gratuitement et voir le chiffre sur vos propres données.
Le verdict
Muse Spark 1.3 est une vraie avancée pour le code et le contexte long, et au tarif contributeur, c'est l'une des meilleures options en valeur par token du marché. Comme "meilleur modèle agentique", il est survendu : le propre tableau de Meta montre Opus 5 gagnant les lignes d'agents, le niveau phare max est verrouillé, et la verbosité 3x signifie que le prix affiché bas n'est pas le prix que vous payez. Prenez-le pour ce qu'il est, un spécialiste du code rapide, bon marché et verbeux, avec une forte habitude du contexte long, et il est facile à apprécier. Ne confondez simplement pas un modèle puissant avec un coéquipier opérationnel. Si le travail consiste à répondre à des clients, embauchez le coéquipier, pas le moteur.