

En bref
Meta Muse Wonder est la première famille de modèles de pointe de Meta, sortie le 12 octobre 2026 en deux versions : Muse Wonder sur l'API à 4 $/20 $ par million de tokens, et Muse Wonder Full, accessible uniquement dans un abonnement Muse Code à partir de 50 $. Les scores mis en avant appartiennent à Wonder Full, pas au modèle que vous pouvez acheter au token. Wonder Full égale Claude Opus 5.5 avec six victoires chacun sur les 14 benchmarks de Meta ; Wonder tout court en gagne une, et coûte exactement le prix d'Opus 5.5.
Mon verdict : Wonder Full est le premier modèle de Meta que je mettrais sur ma liste pour les longues exécutions d'agents et le travail juridique ou financier. Wonder tout court est un bon modèle à un prix qui ne vous donne aucune raison de quitter Opus 5.5 pour l'instant. Et si vous êtes une équipe support qui lit la couverture du lancement, le modèle n'est que la plus petite partie du travail : un collègue IA comme l'agent helpdesk d'eesel tourne sur des modèles de pointe comme celui-ci et est testé sur vos anciens tickets avant de parler à un client.
Qu'est-ce que Meta Muse Wonder ?
Muse Wonder est la nouvelle série de modèles de Meta Superintelligence Labs, et Meta qualifie le duo de ses « modèles les plus capables » à ce jour. Elle se place au-dessus de la gamme de modèles Muse Spark 1.3, et c'est une chose distincte de Meta Muse, l'agent personnel grand public lancé en septembre. Voyez Wonder comme le moteur et Muse comme l'une des voitures dans lesquelles il va bientôt être installé.
Je construis des intégrations et des API chez eesel, donc je lis les pages de lancement comme la documentation de n'importe quel fournisseur : qu'est-ce que je peux réellement appeler, à quel prix, et avec quelles contraintes. J'ai passé la semaine du lancement dans la documentation des modèles de Meta, la page des tarifs et limites de débit, le tableau de benchmarks et le fil Hacker News de 362 commentaires. Cet avis repose sur ces sources, pas sur un communiqué de presse.
Voici ce que Meta propose, en un tableau :
| Muse Wonder | Muse Wonder Full | |
|---|---|---|
| ID du modèle | muse-wonder-1.0 | muse-wonder-full-1.0 |
| Où l'obtenir | Meta Model API, OpenRouter, tous les forfaits Muse Code | Forfaits Muse Code Power Usage et Maximum Usage uniquement |
| Fenêtre de contexte | 1 048 576 tokens | 1M tokens |
| Types d'entrée | Texte, image, vidéo, audio, PDF | Non documenté séparément |
| Effort de raisonnement | « minimal » à « max » | Indiqué à max (xhigh sur SWE-Marathon) |
| Prix | 4,00 $ en entrée / 0,20 $ en cache / 20,00 $ en sortie par 1M de tokens | Inclus dans un forfait mensuel de 50 $ ou 200 $ |
| Statut | Préversion | Abonnement uniquement |
Deux détails de la documentation des modèles comptent plus qu'ils n'en ont l'air. D'abord, Muse Wonder est étiqueté en préversion. Ensuite, Meta indique que « setting reasoning effort to 'max' on Muse Wonder doesn't select » Wonder Full. Il n'existe aucun paramètre d'API qui débloque le modèle supérieur.
Les benchmarks : où Wonder Full gagne et où il ne gagne pas
La page du modèle de Meta publie un tableau de 14 lignes comparant les deux modèles Wonder à Claude Fable 5.1, GPT-6 Astra et Claude Opus 5.5, tous avec raisonnement max. J'ai compté le vainqueur en gras de chaque ligne.
| Benchmark | Ce qu'il teste | Wonder Full | Wonder | Fable 5.1 | GPT-6 Astra | Opus 5.5 |
|---|---|---|---|---|---|---|
| Personal Superintelligence Index | Indice composite interne de Meta | 59.1 | 54.3 | 49.9 | 54.5 | 55.2 |
| Harvey LAB-AA | Travail d'agent juridique | 13.1 | 10.0 | 6.4 | 8.6 | 4.2 |
| Vals Finance Agent V2 | Recherche financière | 59.1 | 56.6 | 58.9 | 53.5 | 58.6 |
| HealthBench Pro | Questions de santé ouvertes | 62.3 | 60.5 | 62.1 | 65.3 | 65.6 |
| AutomationBench-AA | Workflows métier de bout en bout | 45.4 | 39.1 | 32.1 | 41.6 | 41.2 |
| GDP.pdf | Travail professionnel | 33.2 | 30.8 | 27.6 | 34.2 | 30.6 |
| JobBench | Utilisation d'outils professionnels | 75.3 | 70.5 | 73.1 | 66.1 | 75.4 |
| OSWorld V2.1 (partiel) | Utilisation d'ordinateur | 78.4 | 72.6 | 80.7 | 75.8 | 81.8 |
| MemoryBench | Mémorisation du contexte | 85.5 | 85.6 | 79.0 | 81.4 | 81.5 |
| Terminal-Bench 4.0-AA | Code dans le terminal | 57.1 | 52.0 | 52.0 | 59.1 | 59.6 |
| DeepSWE 1.1 | Code sur longue durée | 79.0 | 78.8 | 67.4 | 74.1 | 74.2 |
| SWE-Marathon | Ingénierie ultra-longue | 57.5 (xhigh) | 53.1 | 45.6 | 42.5 | 46.3 |
| ProgramBench | Programmation à partir de zéro | 59.0 | 50.0 | 55.5 | 52.5 | 70.5 |
| Artificial Analysis Index | Global | 56 | 52 | 53 | 53 | 58 |
Le décompte : Wonder Full gagne 6 lignes, Opus 5.5 en gagne 6, GPT-6 Astra en gagne 1 et Muse Wonder tout court en gagne 1 (MemoryBench, avec 0,1 point d'avance sur son grand frère). Claude Fable 5.1 n'en gagne aucune.
C'est un vrai résultat. Il y a un an, personne ne comptait Meta parmi les laboratoires de pointe, et voir Wonder Full battre GPT-6 Astra sur 11 lignes sur 14 est un grand bond. Le chiffre juridique est le plus frappant : 13,1 au benchmark d'agent juridique de Harvey est faible en valeur absolue, mais c'est plus de trois fois les 4,2 d'Opus 5.5. Si vous suivez Harvey AI, vous savez à quel point ce benchmark est dur pour tous les modèles.
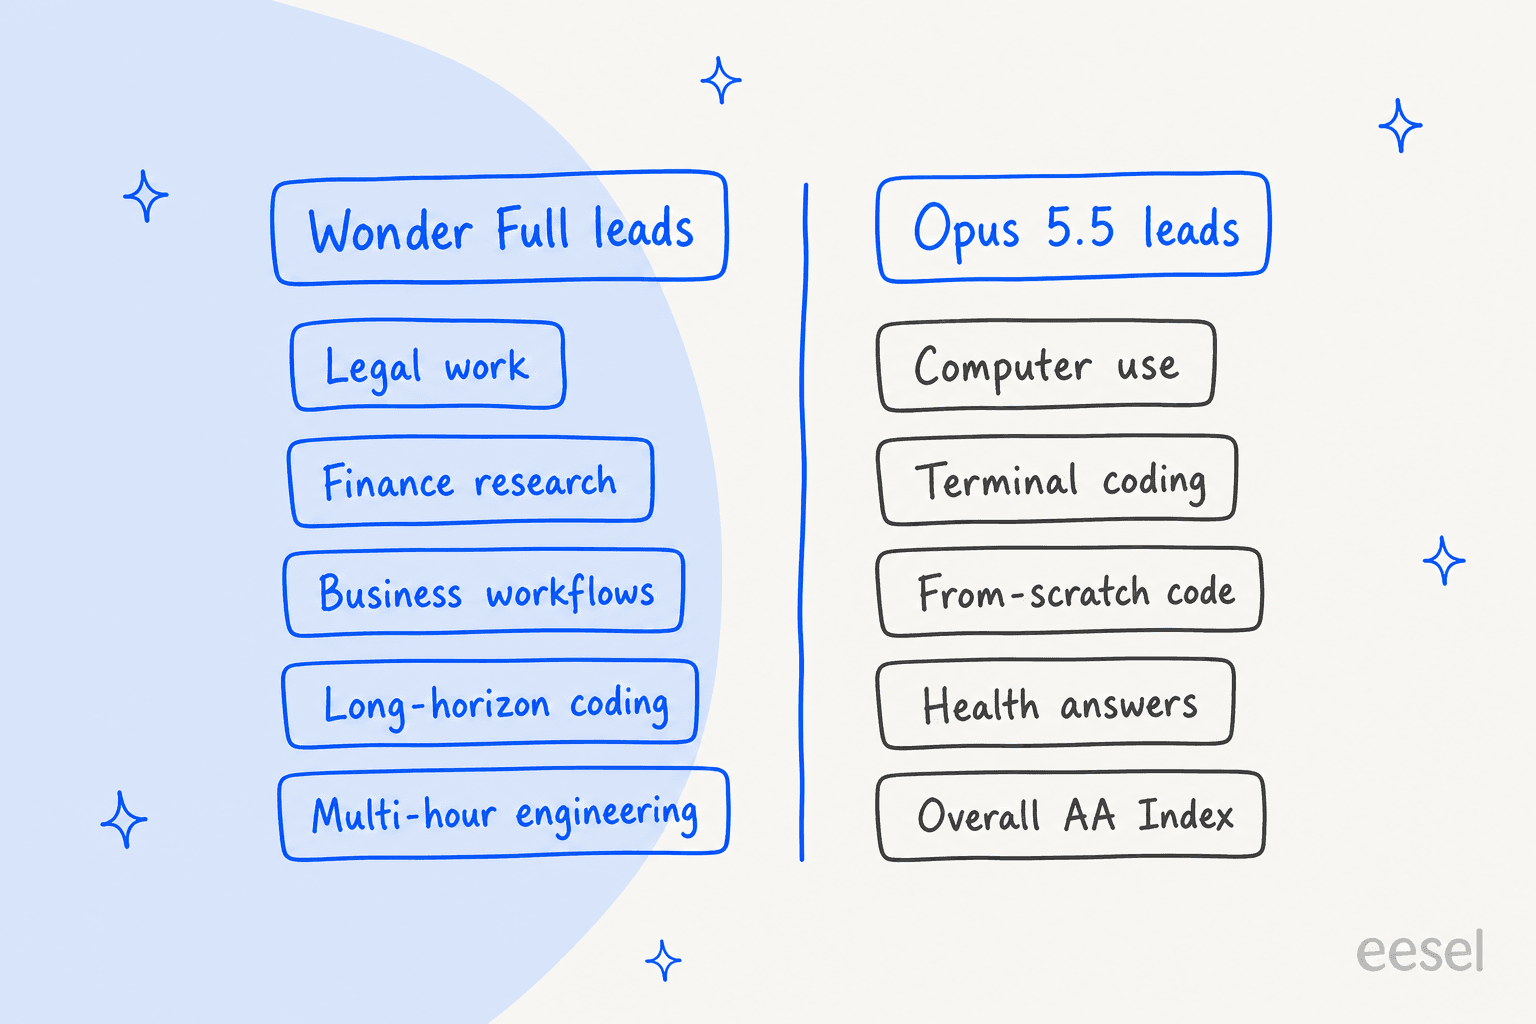
La répartition a une logique. Wonder Full gagne quand la tâche est longue et riche en documents : un livrable juridique, une note de recherche financière, un projet de code de plusieurs heures. Opus 5.5 gagne encore quand le modèle doit piloter un ordinateur ou écrire quelque chose à partir de zéro, et son avance sur ProgramBench (70,5 contre 59,0) est le plus grand écart de tout le tableau. Une réserve sur la présentation de Meta : le Personal Superintelligence Index est un indice composite interne à Meta, donc je lui accorderais moins de poids qu'aux lignes issues de tiers.
Le billet de lancement de Meta montre aussi le classement indépendant d'Artificial Analysis au 12 octobre, où Wonder Full arrive deuxième.
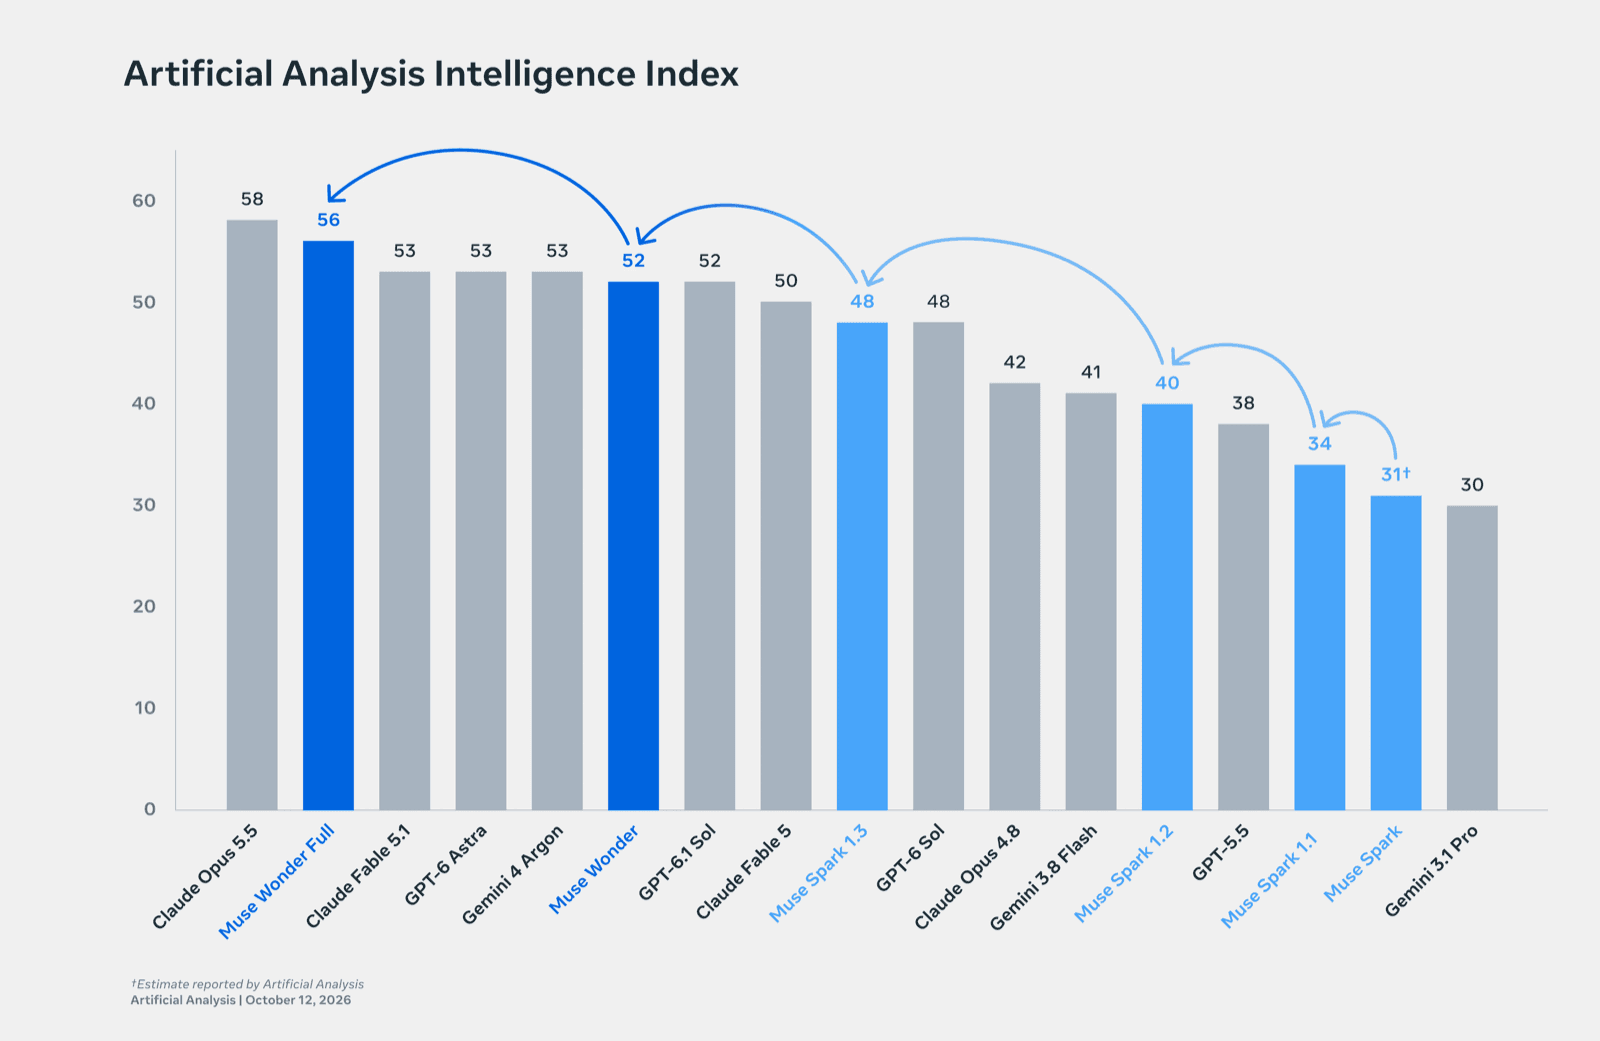
La communauté HN a réagi à cette deuxième place comme on pouvait s'y attendre :
"2nd place model on aa according to them, losing only to opus 5.5 is really really not bad"

Les classements bougent vite, cependant. Plus tard le même jour, un autre commentateur a signalé que Wonder Full avait glissé à la cinquième place du classement en direct, derrière Gemini 4 Argon. Considérez toute capture de classement comme un instantané.
Le piège : le Wonder que vous pouvez acheter n'est pas celui du graphique
C'est la partie que la plupart des articles sur le lancement passent sous silence. Regardez à nouveau le graphique AA : le modèle que vous pouvez appeler via l'API obtient 52. C'est en dessous de Fable 5.1, GPT-6 Astra et Gemini 4 Argon (tous à 53), et au niveau de GPT-6.1 Sol. Cela reste un modèle solide, environ quatre points au-dessus de Muse Spark 1.3 sur le même graphique. Mais ce n'est pas celui qui bat Opus 5.5.
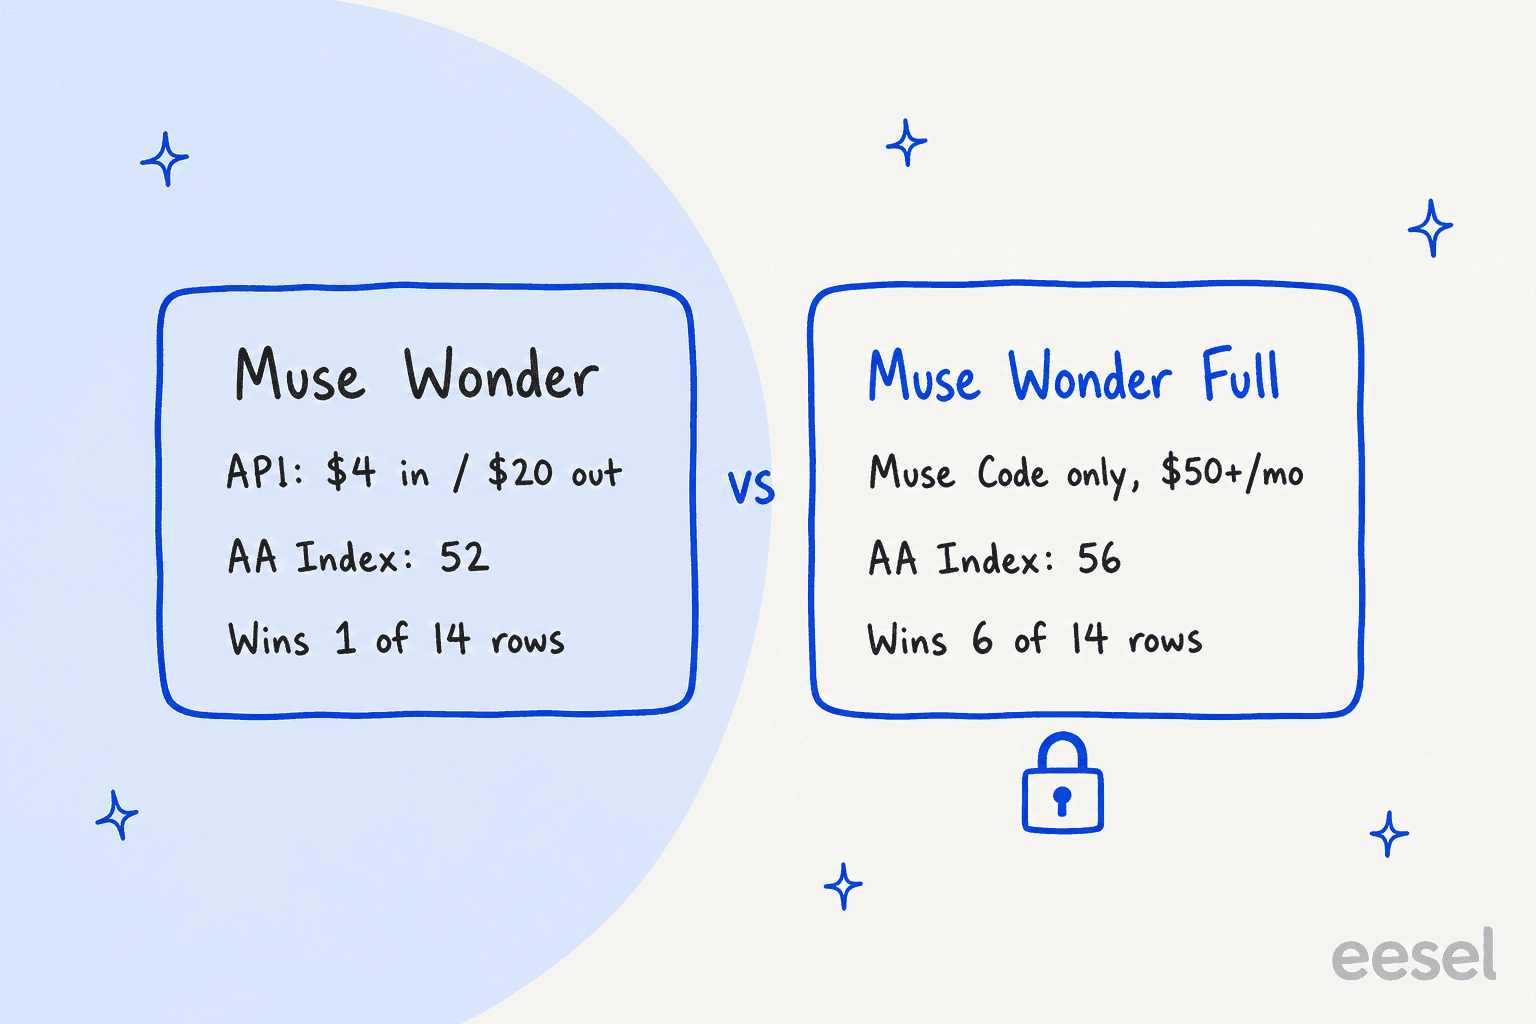
Un commentateur HN l'a repéré quelques heures après le lancement :
"Upon closer inspection, the benchmark scores for "Muse Wonder" on the main marketing page are actually for "Muse Wonder Full," which is only available on the higher-tier subscription plans. This pricing is for "Muse Wonder.""
Simon Willison a listé les modèles visibles avec sa clé d'API, et muse-wonder-1.0 était le seul Wonder de la liste. Donc si vous êtes développeur et que vous construisez un produit, la décision n'est pas « Muse Wonder Full contre Opus 5.5 ». C'est « Muse Wonder à 52 contre Opus 5.5 à 58, au même prix ». C'est plus difficile à vendre.
Tarifs de Muse Wonder
La tarification prend deux formes distinctes, qui ne se recoupent pas.
À l'usage sur la Meta Model API (d'après la grille tarifaire de Meta) :
| Usage | Muse Wonder (mode Standard) | Mode Contributor |
|---|---|---|
| Entrée | 4,00 $ par 1M de tokens | Non disponible |
| Entrée en cache | 0,20 $ par 1M de tokens | Non disponible |
| Sortie | 20,00 $ par 1M de tokens | Non disponible |
| Ancrage par recherche web | 2,50 $ par 1 000 requêtes | Non disponible |
| Limite de débit | 3 000 requêtes et 4M de tokens par minute | Non disponible |
Meta indique aussi qu'il n'y a pas de surcoût pour le long contexte, et que les tokens de pilotage injectés dans chaque prompt ne sont pas facturés. C'est une grille claire et honnête. C'est aussi un gros changement par rapport à l'habitude passée de Meta de casser les prix. Le tarif de Muse Spark 1.3 est de 1,25 $/4,25 $, et son palier contributeur descend à 0,10 $/0,20 $. Wonder n'a aucun palier remisé sur l'API.
"$4/$20 in vs out making it higher than Sol and on par with Opus."
Voici la comparaison avec les concurrents du tableau de Meta, tous aux tarifs API standard issus de la page de tarifs de chaque éditeur :
| Modèle | Entrée par 1M | Entrée en cache par 1M | Sortie par 1M |
|---|---|---|---|
| Muse Wonder | 4,00 $ | 0,20 $ | 20,00 $ |
| Claude Opus 5.5 | 4,00 $ | 0,20 $ | 20,00 $ |
| GPT-6 Astra | 10,00 $ | 1,00 $ | 50,00 $ |
| Claude Fable 5.1 | 10,00 $ | 0,25 $ | 50,00 $ |
| Muse Spark 1.3 | 1,25 $ | 0,15 $ | 4,25 $ |
Muse Wonder et Opus 5.5 coûtent la même chose au centime près, y compris le tarif en cache. Saisissez votre propre volume mensuel ci-dessous pour voir l'écart avec les autres.
Les abonnements Muse Code, le seul moyen d'accéder à Wonder Full, comprennent quatre forfaits :
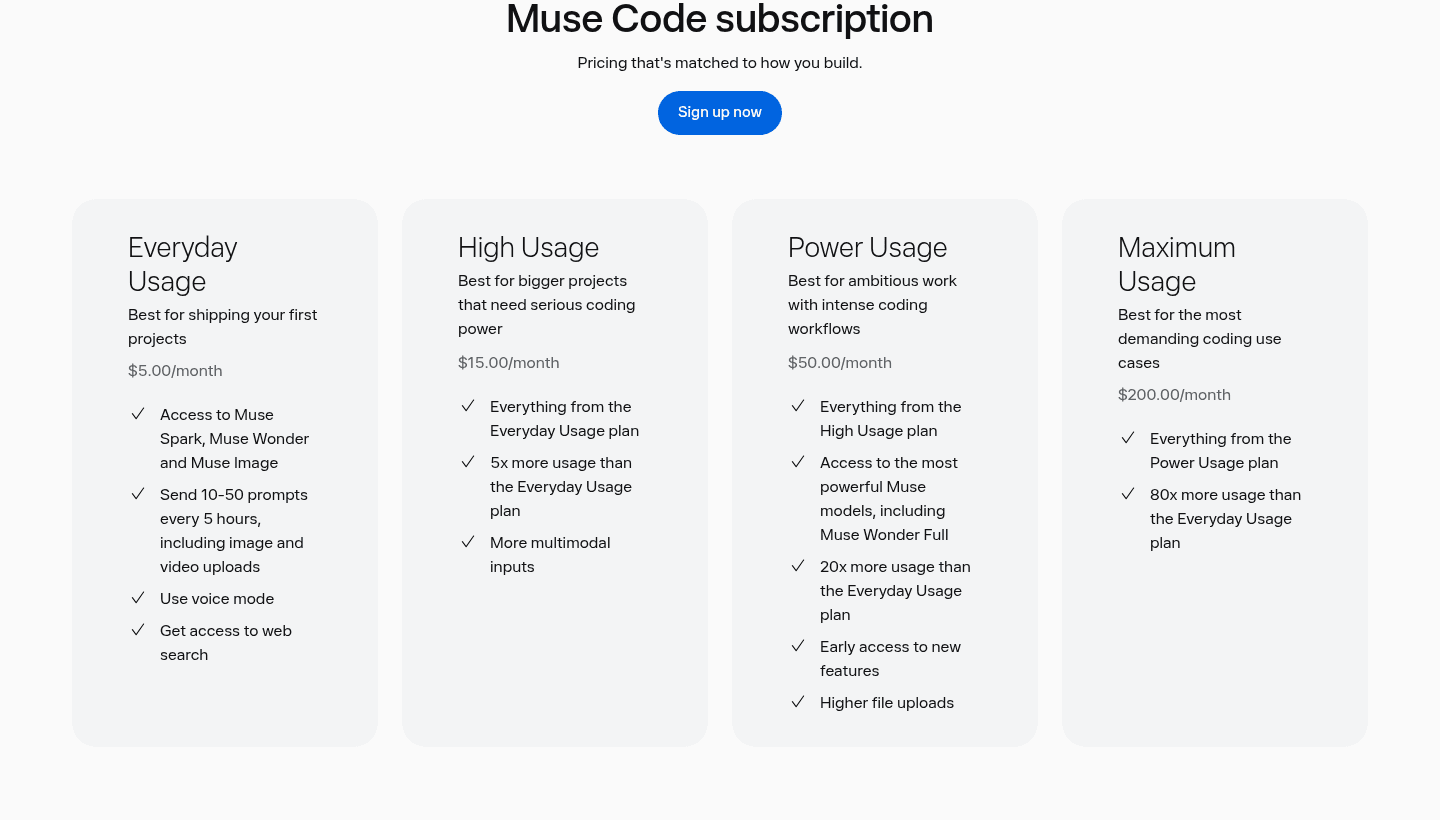
| Forfait | Prix | Usage | Wonder | Wonder Full |
|---|---|---|---|---|
| Everyday Usage | 5 $/mois | 10 à 50 prompts toutes les 5 heures | Oui | Non |
| High Usage | 15 $/mois | 5x Everyday | Oui | Non |
| Power Usage | 50 $/mois | 20x Everyday | Oui | Oui |
| Maximum Usage | 200 $/mois | 80x Everyday | Oui | Oui |
Les prix proviennent de la page Muse Code ; les règles des forfaits figurent dans la documentation des abonnements. Les petites lignes valent la peine d'être lues : il faut avoir 18 ans ou plus, la disponibilité « may vary by region », il n'y a pas de remboursement à la résiliation, et Meta peut révoquer un abonnement immédiatement en cas de violation de ses règles. Une clé d'abonnement ne fonctionne en outre que dans la CLI Muse Code, vous ne pouvez donc pas faire passer le trafic de votre application par un forfait à 50 $. Pour le coût complet de l'agent de code lui-même, voyez mon analyse des tarifs de Muse Code.
Sur le forfait d'entrée, un utilisateur précoce a trouvé les limites serrées :
"The usage limits on their basic $5 code plan to try things out are ludicrously low?"
Il a rapporté que trois courts prompts avaient consommé 17 % de son quota hebdomadaire. Comme Wonder Full commence de toute façon au palier à 50 $, je prévoirais le budget de Power Usage si Full est la raison de votre venue.
Active Memory et Active Focus : ce qui est vraiment nouveau
Meta articule Wonder autour de deux capacités nommées. Active Memory, c'est « carrying important context about you across conversations and actively retrieving the details relevant to the task at hand. » Active Focus, c'est la façon dont le modèle continue à travailler vers un objectif difficile : « trying alternative approaches, working through blockers, and adapting to new information », tout en demandant des précisions et en faisant le point « before taking important actions. »
Les deux correspondent à des lignes du tableau. MemoryBench est le seul endroit où Wonder tout court gagne nettement (85,6), et SWE-Marathon est celui où l'avance de Full est la plus grande (57,5 contre 46,3 pour Opus 5.5). Cela colle avec la documentation développeur de Meta, qui présente Wonder pour « long-running, complex tasks where capability matters more than cost per token, such as multi-file coding changes, multi-hour agent runs, and sub-agent orchestration », et renvoie tout ce qui est à fort volume ou sensible à la latence vers Muse Spark.
Les démos du lancement penchent vers le personnel plutôt que vers l'entreprise : un plan de course construit à travers plusieurs apps, des objets personnalisés commandés à partir de photos Instagram, un plan de table de mariage, une déclaration de sinistre. C'est un aperçu de la direction que prend ce modèle, vers l'agent personnel Muse, que Wonder, selon Meta, « will soon power », en commençant par les abonnés.
Côté sécurité, Meta décrit Wonder comme son « most aligned model to date », avec ses protections les plus solides contre les usages chimiques, biologiques et cyber malveillants, tout en autorisant le travail cyber défensif dans le cadre de son dispositif de mise à l'échelle. Le rapport de sécurité complet est annoncé « available soon », donc ce point ne peut pas encore être vérifié.
Données et accès : le mode Contributor est activé par défaut
C'est le réglage que je vérifierais avant tout le reste.
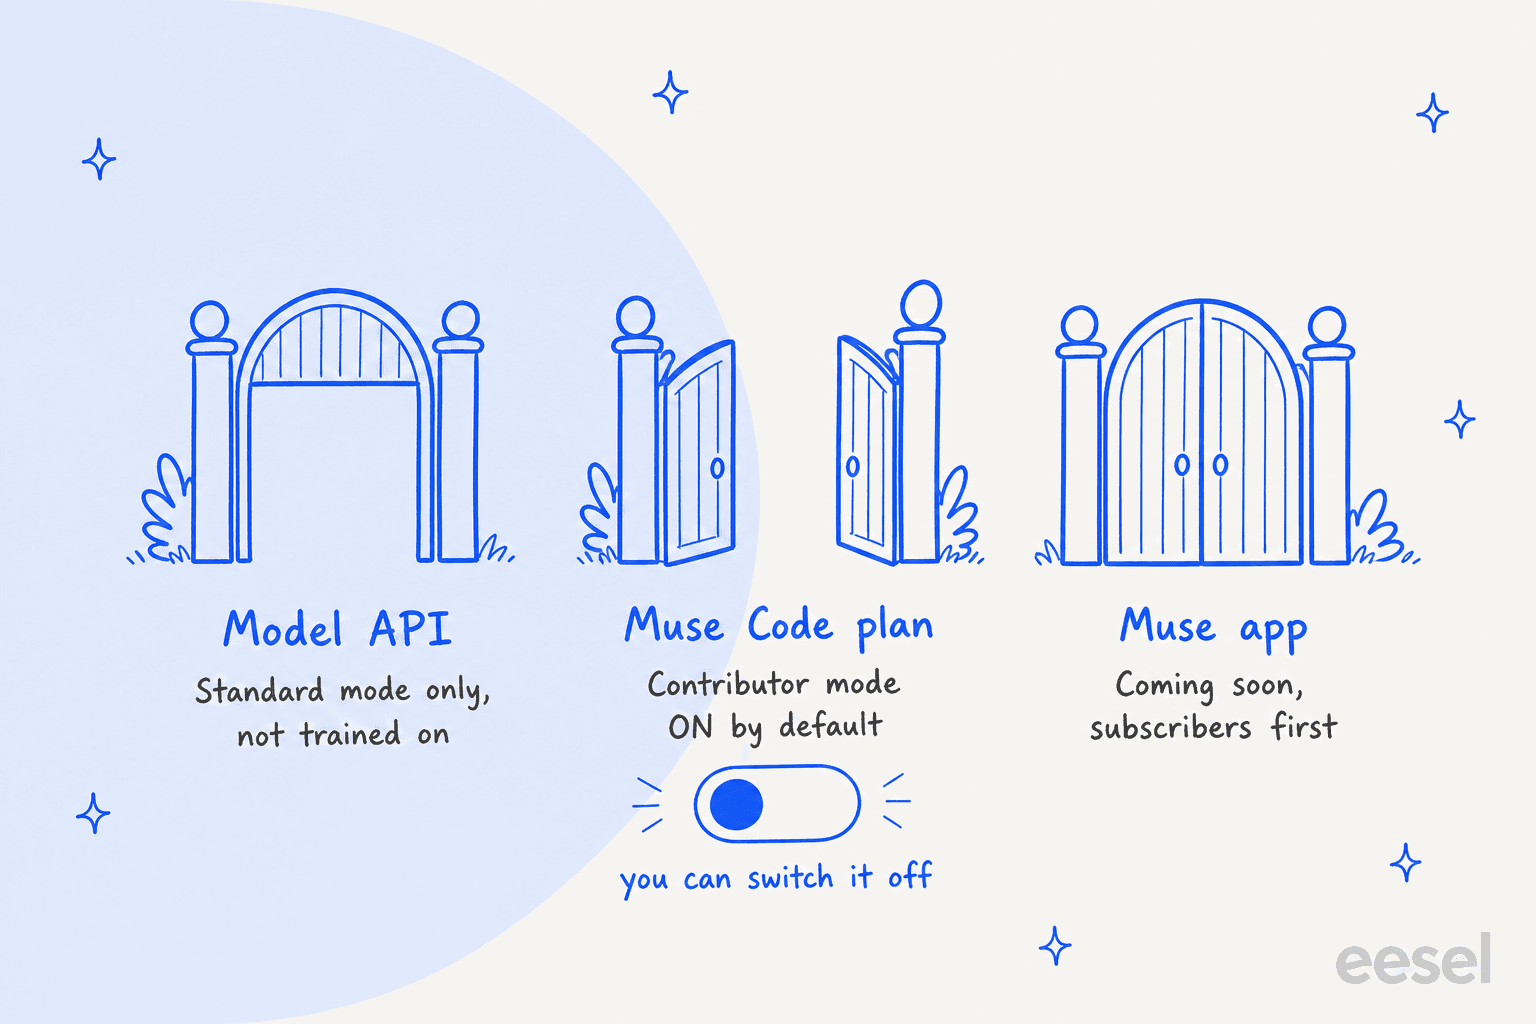
Sur l'API, Muse Wonder fonctionne uniquement en mode Standard : la documentation de Meta indique que votre contenu « is not used to train Meta models. » Dans Muse Code, c'est l'inverse. La page des abonnements dit « Muse Code subscriptions default to Contributor mode », ce qui vous donne plus d'usage « in exchange for letting Meta use your content to train future Meta models. » Le contenu, ce sont vos prompts, votre code, vos fichiers et votre contexte, ainsi que les réponses. Vous pouvez le désactiver à tout moment, et à partir de là le nouveau contenu n'est plus utilisé.
Ainsi, le chemin le moins cher vers Wonder Full, un forfait Muse Code, est aussi celui qui s'entraîne sur votre code tant que vous ne changez pas un réglage. C'est un compromis acceptable pour un projet perso. Pour le dépôt d'une entreprise, désactivez-le dès le premier jour.
Cette question revient plus souvent dans les appels commerciaux d'eesel que n'importe quel benchmark. Un évaluateur technique d'une entreprise de matériel a demandé un jour, pendant une démo, si eesel se rabat discrètement sur un autre ChatGPT quand il ne connaît pas une réponse, et si on pouvait désactiver cela. Ce qu'il voulait était simple : des réponses uniquement issues de ses connaissances validées, et ses connaissances qui restent les siennes. Le modèle de pointe sous le capot comptait bien moins pour lui que cette règle.
Ce qu'en disent les premiers utilisateurs
Le verdict de la communauté, deux jours après, c'est « chiffres impressionnants, vérifiez par vous-même ». Quelques retours pratiques se sont démarqués.
Côté vision, Wonder tout court a peiné lors du test d'un développeur :
"Image->HTML test for Muse Wonder. It's much worse than Opus 5.5. IMO it's closer to Sonnet or Haiku for this test."
Il a ensuite confirmé que c'était bien Wonder tout court, puisque Full n'était pas sur OpenRouter, ce qui est le même écart que dans la section précédente, observé en pratique.
Côté outil, un utilisateur payant a eu des problèmes d'installation avant même que le modèle compte :
"I paid them for a month to try out Muse Code, but their sandbox never worked across Mac or Linux (both very stock installs, nothing special)."
Et sur la gamme Muse en général, les utilisateurs réguliers du modèle précédent sont enthousiastes. L'un a écrit que Muse Spark 1.3 est "very fast and powerful" et son "work horse for open source development." Un autre commentateur a noté que l'abonnement est réservé à l'Amérique du Nord pour l'instant, alors que l'API est accessible via OpenRouter.
Points forts et points faibles
Points forts
- Wonder Full égale Opus 5.5 avec six victoires chacun dans le tableau de 14 lignes de Meta, et domine nettement en juridique (13,1 contre 4,2) et en ingénierie ultra-longue (57,5 contre 46,3)
- Deuxième à l'indice Artificial Analysis au lancement (56), le meilleur résultat de Meta de loin
- Grille tarifaire d'API claire : pas de surcoût long contexte, tokens de pilotage non facturés, entrée en cache à 0,20 $
- Contexte de 1M de tokens, cinq types d'entrée et des limites généreuses de 3 000 RPM / 4M TPM dès le premier jour
- Disponible sur OpenRouter, donc testable dans des outils que vous utilisez déjà
Points faibles
- Le modèle de l'API (52 à l'AA) n'est pas celui derrière les scores mis en avant, et coûte le même prix qu'Opus 5.5 (58)
- Wonder Full est réservé aux abonnements Muse Code à 50 $ ou 200 $ par mois, sans accès au token
- Les forfaits Muse Code sont par défaut en mode Contributor, qui s'entraîne sur votre contenu tant que vous ne le désactivez pas
- Statut de préversion, rapport de sécurité encore « coming soon », et positions au classement qui ont bougé le jour même
- Wonder tout court est en retard sur Opus 5.5 en utilisation d'ordinateur, en code dans le terminal et en programmation à partir de zéro
Qui devrait utiliser Meta Muse Wonder ?
Choisissez Wonder Full si vous êtes développeur indépendant ou petite équipe sur de longs projets de code, de la rédaction juridique ou de la recherche financière, et que 50 $ par mois pour Muse Code se justifient facilement. Désactivez d'abord le mode Contributor. C'est la meilleure raison à ce jour d'essayer l'agent de code de Meta, et les alternatives à Muse Code méritent un coup d'œil au même budget.
Choisissez Muse Wonder tout court sur l'API si vous avez besoin de longues exécutions d'agents avec une bonne mémoire et que vous voulez un deuxième fournisseur de pointe à côté d'Anthropic. À prix identique, je le comparerais en test A/B à Opus 5.5 sur vos propres tâches avant de lui confier du trafic de production.
Passez votre tour pour l'instant si vous avez surtout besoin d'utilisation d'ordinateur ou de génération de code à partir de zéro, où Opus 5.5 reste en tête, ou si votre charge est à fort volume et sensible au prix, cas où la documentation de Meta vous renvoie vers Muse Spark. Si vous comparez largement, mon comparatif des meilleurs assistants de code IA et mon guide des tarifs de Claude Code couvrent les autres options.
Et si vous dirigez le support, la sortie d'un modèle est le mauvais point de départ. Wonder peut alimenter un agent IA, mais il faut encore que quelqu'un le connecte à votre helpdesk, le garde dans le périmètre de vos connaissances, décide quand il passe la main et prouve qu'il a raison avant qu'il touche un client. C'est la différence entre un modèle et un collègue, et c'est pourquoi choisir le meilleur modèle pour les tickets de support n'est que la première étape. Mes notes sur l'utilisation de Muse pour Zendesk montrent tout ce qu'il faut de colle pour y arriver.
Recrutez eesel plutôt que de brancher un modèle
Muse Wonder est de l'infrastructure ; eesel est l'employé. eesel est une plateforme de collègues IA où vous recrutez des collègues prêts à l'emploi pour des missions précises, et pour l'instant ce sont deux rôles : un collègue IA pour le helpdesk et un rédacteur de blog IA.
Pour les équipes support, le collègue helpdesk se branche sur Zendesk, Freshdesk ou Gorgias, apprend de vos anciens tickets, de votre centre d'aide et de vos docs, et ne répond qu'à partir de ce que vous avez validé. Avant qu'il réponde à qui que ce soit, vous pouvez le simuler sur vos tickets historiques et voir exactement ce qu'il aurait dit. J'ai vu un bot à l'air sûr de lui donner une mauvaise réponse sur une file en production, c'est pourquoi ce test existe. Les forfaits sont un tarif mensuel fixe où un ticket équivaut à un crédit, à partir de 299 $/mois pour 500 crédits, avec 100 crédits gratuits pour essayer, selon la page de tarifs d'eesel.

Si vous lisiez sur Muse Wonder parce que vous voulez que l'IA travaille votre file de tickets, laissez tomber le shopping de modèles. Essayez eesel gratuitement et regardez-le rédiger des réponses sur vos propres tickets.