

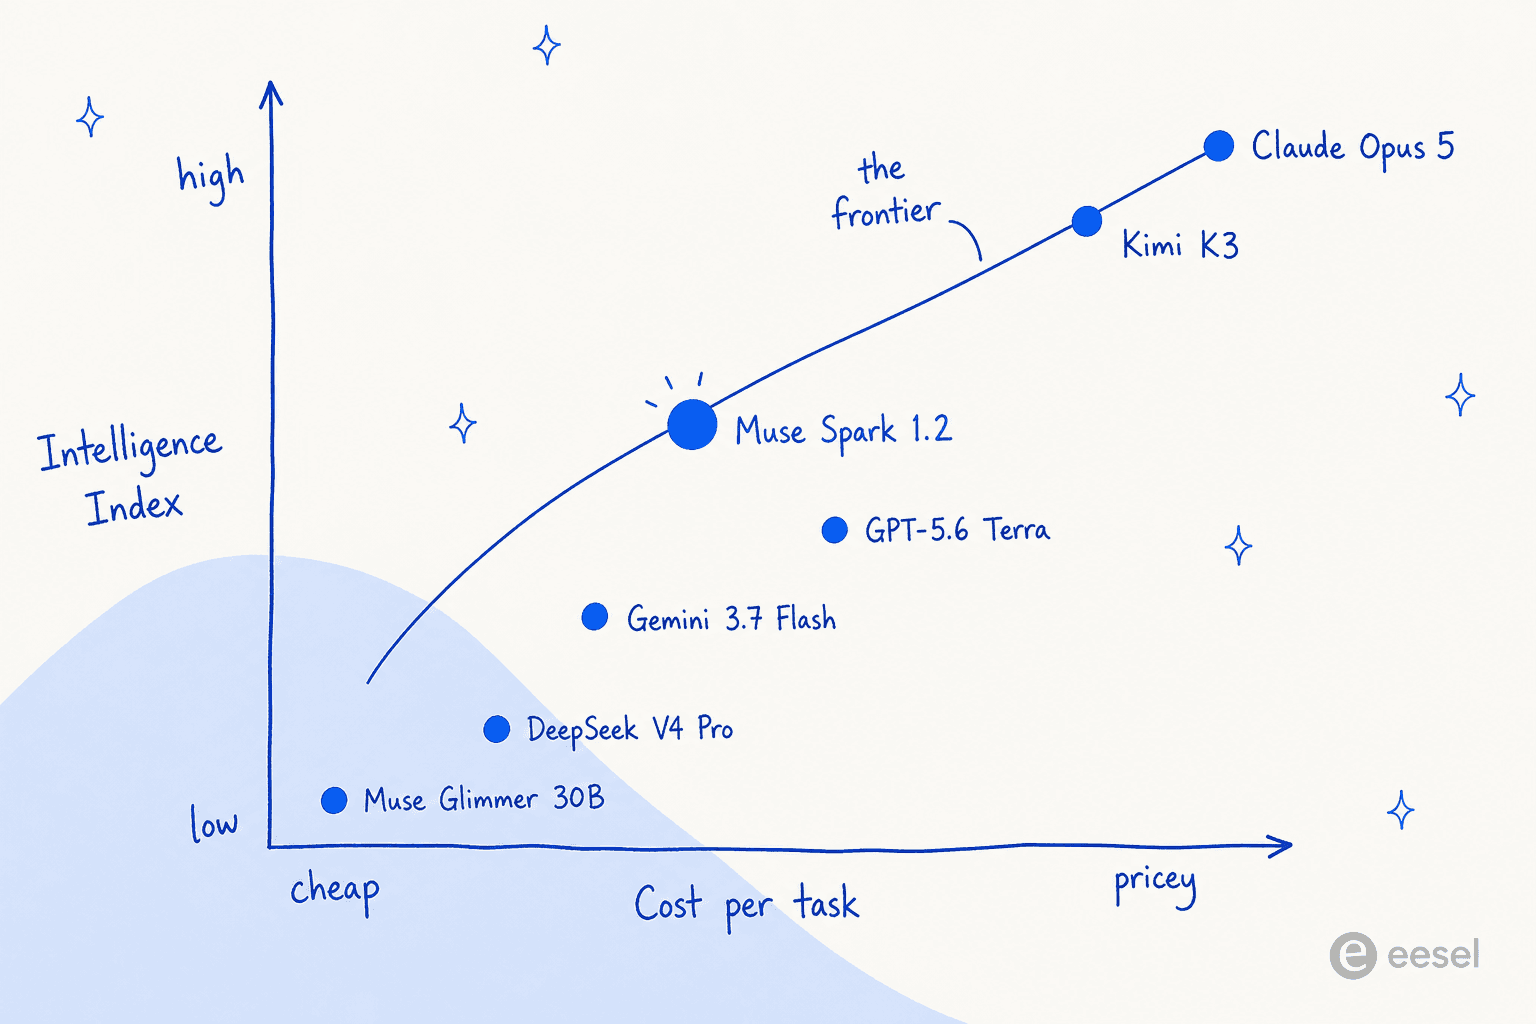
La plupart des articles sur les « alternatives à Muse Spark 1.2 » commencent par vous dire que le modèle est dépassé. Ce n'est pas le cas. Sur l'Artificial Analysis Intelligence Index, rien ne score plus haut que Muse Spark 1.2 à un coût par tâche inférieur. Il se classe 7e sur 20 avec 56,76, et ce pour 0,3992 $ la tâche. Tous les modèles au-dessus dans le classement vous coûtent plus cher.
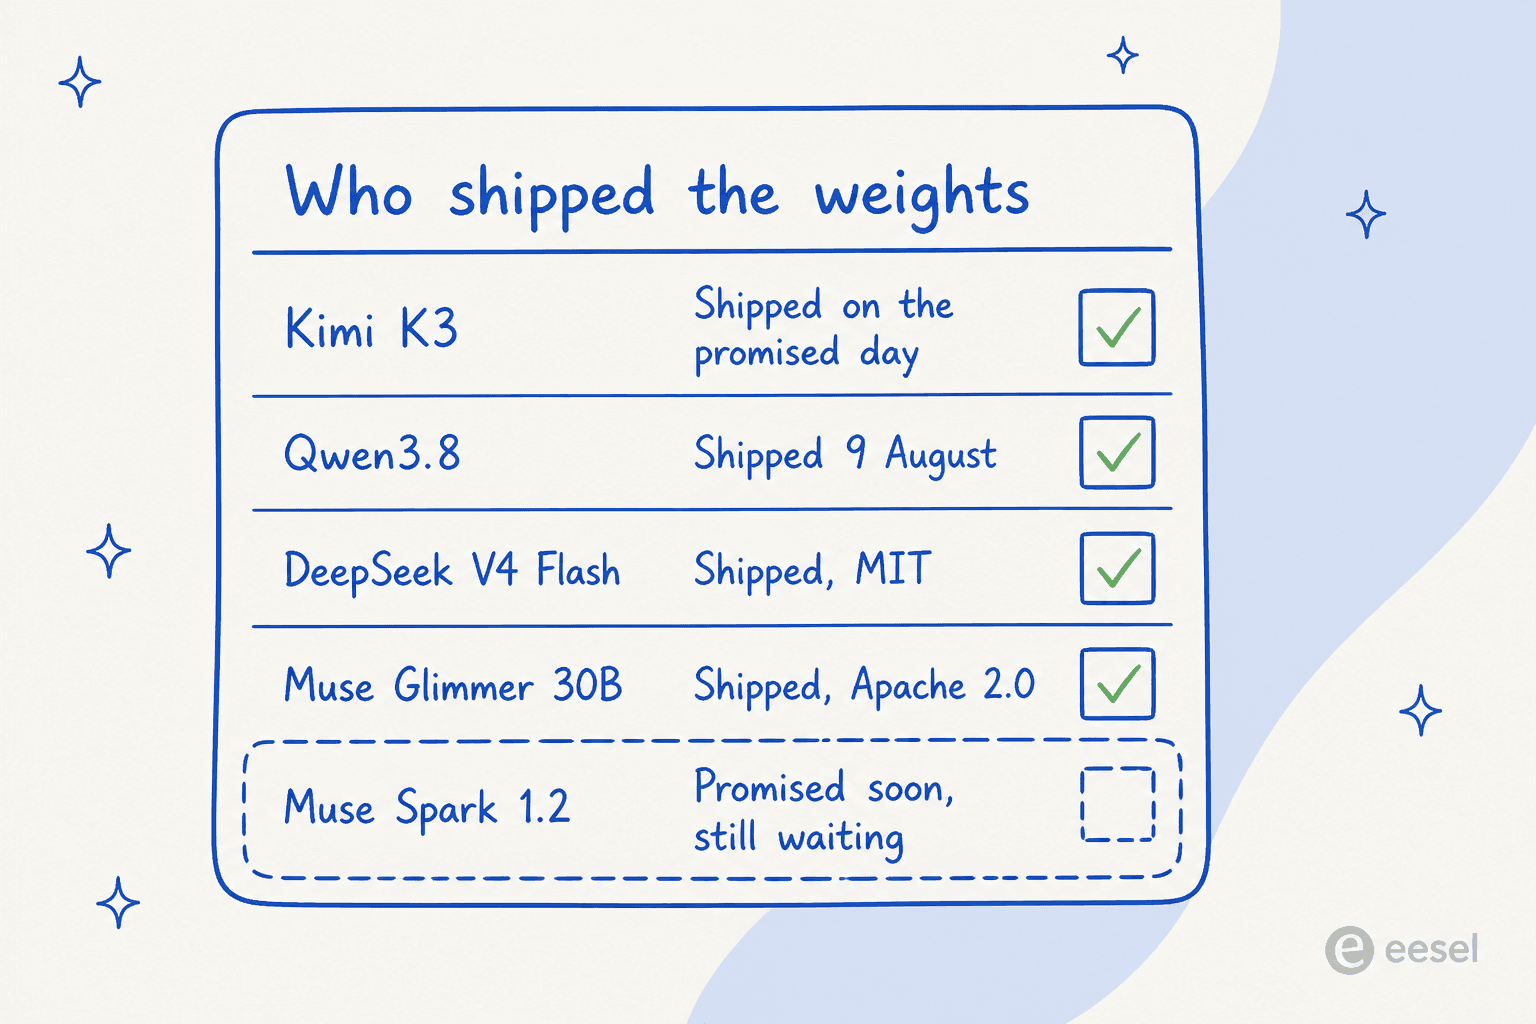
La raison honnête de partir n'a donc rien à voir avec la capacité. Le directeur de l'IA de Meta (Chief AI Officer) a promis des poids ouverts pour Muse Spark 1.2 le 10 août, sans licence ni date, et huit jours plus tard rien n'a été publié. Moonshot, de son côté, a publié Kimi K3 le jour exact où il l'avait promis. Qwen a publié le 9 août, et DeepSeek est sous licence MIT depuis des mois.
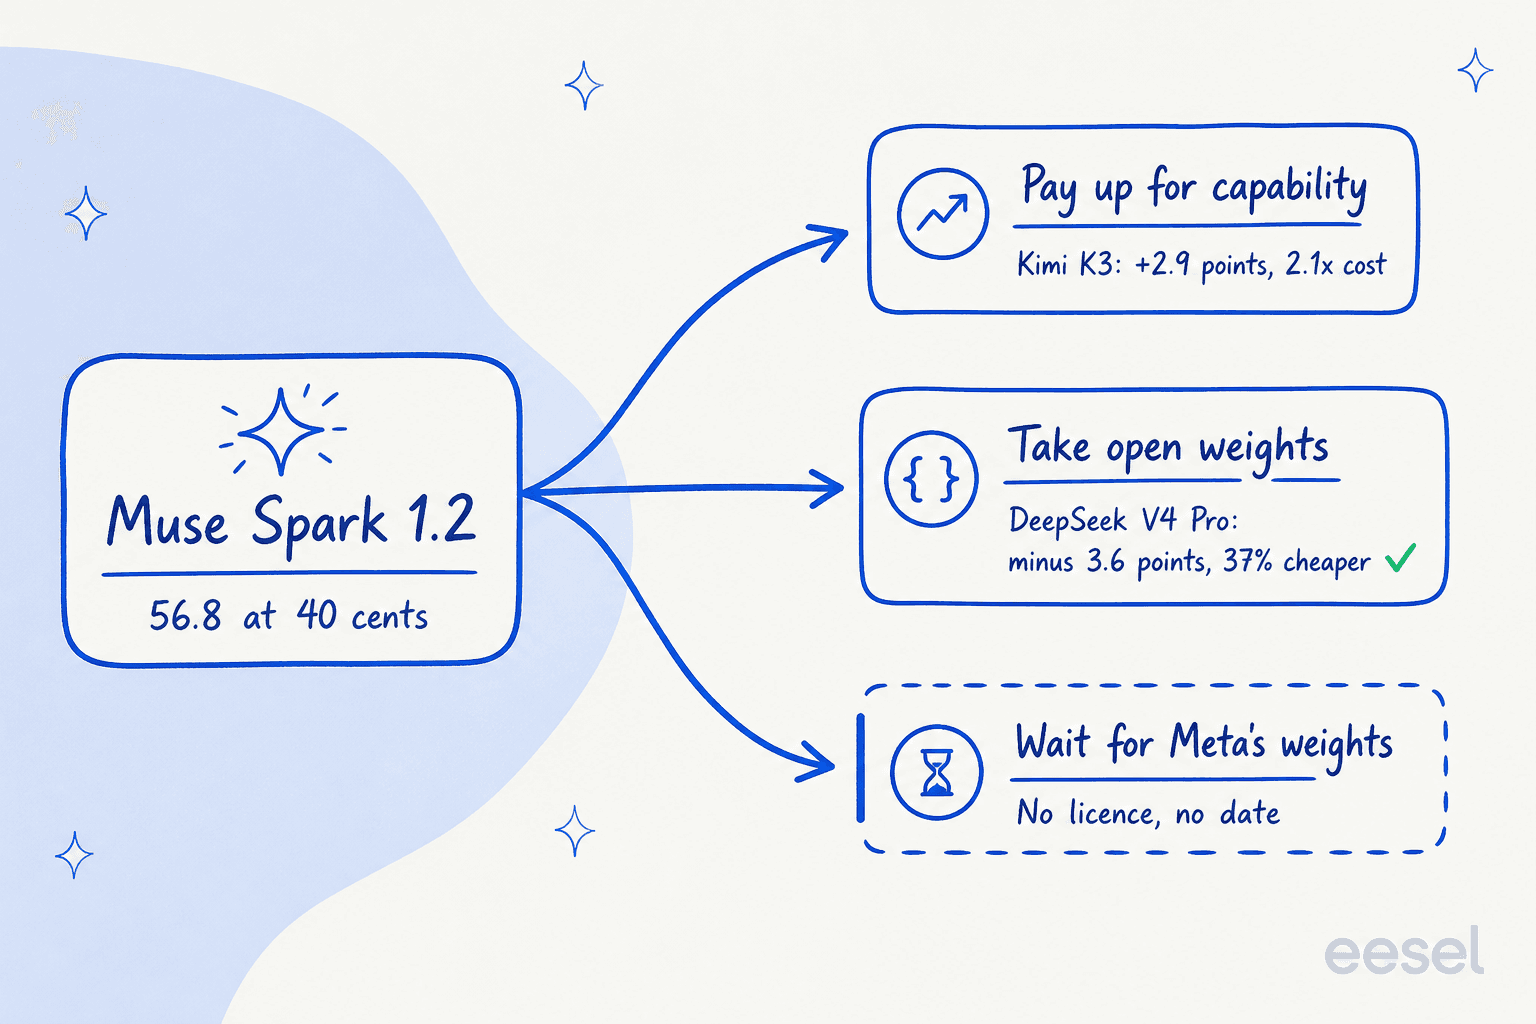
Cela divise vos options assez nettement. Payer plus pour un vrai saut de capacité, ou renoncer à des points d'indice pour des poids que vous possédez réellement. L'option qui offre les deux pour moins cher n'existe pas. Plus bas, je classe 8 alternatives sur les chiffres réels.
Une réserve avant de passer une semaine là-dessus. Si le modèle que vous choisissez doit répondre à des tickets de support, le modèle lui-même est rarement le goulot d'étranglement. Une équipe avec laquelle j'ai travaillé avait une IA qui disait avec assurance aux clients « oui, nous prenons en charge le modèle de votre voiture » pour des marques qui n'étaient même pas dans leur base de données, parce que leur centre d'aide disait « nous prenons en charge tous les modèles ». Aucun score d'indice ne corrige cette phrase. La récupération, si.
Pourquoi on regarde au-delà de Muse Spark 1.2
Je construis des intégrations et la plomberie d'API chez eesel, donc à chaque lancement de modèle mon réflexe est de sauter l'article de lancement pour aller lire la grille tarifaire, les limites de débit, puis la page du modèle. Muse Spark 1.2 est intéressant pour une raison précise : ici, le marketing et les données divergent dans le sens inverse de l'habitude. La présentation du lancement a sous-estimé sa position en rapport qualité-prix, et surestimé ce que vous finiriez par posséder.
Trois choses poussent réellement les gens à regarder ailleurs.
Les poids sont une promesse, pas un téléchargement. Le Chief AI Officer de Meta a dit qu'une version à poids ouverts arrivait « bientôt ». L'organisation Hugging Face vérifiée de Meta affiche actuellement quatre dépôts, et les quatre sont des Muse Glimmer. Une recherche de Muse-Spark sur Hugging Face ne renvoie aucun résultat, de personne.
Personne ne peut vérifier le modèle de façon indépendante. Pour la plupart du classement, Artificial Analysis publie la vitesse de sortie et la latence. Pour Muse Spark 1.2, ces deux champs sont vides. Muse Glimmer figure dans le même tableau et les a. Vous pouvez chiffrer ce modèle, mais vous ne pouvez pas mesurer sa vitesse de réponse.
L'offre pas chère vous coûte votre trafic. L'ID muse-spark-1.2-contributor est 12,5 fois moins cher en entrée, et la documentation de Meta décrit cela comme un tarif réduit, accordé en échange de l'autorisation d'entraîner sur vos prompts et vos réponses. Le calcul de cet échange, je l'ai déjà traité dans le détail des tarifs de Muse Spark 1.2.
Quatre jours avant l'annonce de Meta, un commentateur de Hacker News a défendu l'idée des poids mieux que le billet de Meta lui-même :
"Meta, please go back to publishing weights. Your models aren't top-tier, this wouldn't hurt you at all at your current position in the rankings. They wouldn't have the best open-weight models, but the best western open-weight models."

Meta a fait exactement cela quatre jours plus tard, mais pour un modèle élève de 30B. Le modèle de pointe, lui, a reçu un adjectif.
Comment j'ai choisi ces 8
J'ai classé selon trois critères, dans cet ordre.
Un score indépendant, pas les graphiques des éditeurs. Chaque chiffre d'indice de cette page vient de l'Artificial Analysis Intelligence Index v4.1.1. Il exécute neuf évaluations, donc aucun laboratoire ne choisit son propre jeu de comparaison. Cela compte ici, car les graphiques de lancement de Muse Spark 1.2 ont changé de harnais d'agent entre les versions.
Le coût par tâche, pas le prix catalogue. La verbosité est ce que les tarifs au million de tokens masquent. Muse Spark 1.2 consomme 30 430 tokens de sortie par tâche de l'indice, donc le coût réel se situe bien au-dessus de ce que laisse penser le 1,25 $ affiché. Le coût par tâche est le chiffre qui survit au contact d'une vraie facture.
L'existence des poids. Pour chaque modèle de la liste, j'ai vérifié le champ de licence sur le dépôt réel, plutôt que de me fier à un communiqué de presse. Deux des huit se sont révélés sous une licence différente de celle qu'on leur attribue d'habitude.
J'ai laissé de côté un nom évident. Il n'y a aucun modèle eesel dans cette liste, parce qu'eesel n'est pas un éditeur de modèles, et mettre mon propre employeur dans un tableau de benchmarks serait exactement ce qui rend ces articles inutiles.
Le tableau comparatif
Les scores d'indice et le coût par tâche viennent du classement des modèles d'Artificial Analysis, consulté le 18 août 2026. Les tarifs par token viennent de la page de prix de chaque éditeur, consultée le même jour.
| Modèle | Indice | Coût / tâche | Entrée /1M | Sortie /1M | Contexte | Poids | Licence | Idéal pour |
|---|---|---|---|---|---|---|---|---|
| Claude Opus 5 | 63.05 | $2.3369 | $5.00 | $25.00 | 1M | Non | Propriétaire | Le plafond le plus haut du classement |
| GPT-5.6 Sol | 60.93 | $1.2312 | $5.00 | $30.00 | 1.05M | Non | Propriétaire | Travail de pointe avec les outils OpenAI |
| Grok 4.6 | 60.92 | $0.8367 | variable | variable | 2M | Non | Propriétaire | Presque de pointe à coût moyen |
| Kimi K3 | 59.70 | $0.8375 | $3.00 | $15.00 | 1.05M | Oui | Kimi K3 License | Des poids ouverts qui battent vraiment Muse Spark |
| Qwen3.8 Max | 58.08 | $1.1320 | $2.00 | $6.00 | 1M | Base seulement | qwen3.8-max | Puissance hébergée avec une solution de repli ouverte |
| Muse Spark 1.2 | 56.76 | $0.3992 | $1.25 | $4.25 | 1.05M | Non | Propriétaire | Le modèle en place dont il est question ici |
| GPT-5.6 Terra | 56.58 | $0.5080 | $2.00 | $12.00 | 1.05M | Non | Propriétaire | Remplacement équivalent avec de meilleurs outils |
| Gemini 3.7 Flash | 56.03 | $0.4022 | $0.75 | $3.75 | 1.05M | Non | Propriétaire | La vitesse à un coût quasi identique |
| DeepSeek V4 Pro | 53.20 | $0.2521 | $0.66 | $1.98 | 1M | Oui | MIT | La licence permissive la moins chère ici |
| GPT-5.6 Luna | 52.32 | $0.0471 | $0.20 | $1.20 | 1.05M | Non | Propriétaire | Le plancher de prix des modèles hébergés |
| Muse Glimmer 30B | 35.06 | $0.0732 | local | local | 131K | Oui | Apache 2.0 | Faire tourner un modèle Meta sur votre propre GPU |
Les tarifs DeepSeek indiqués ici sont ceux des heures creuses. Les tarifs Gemini indiqués sont des tarifs de lancement, valables jusqu'au 31 décembre 2026.
Si vous tracez le coût en fonction de la capacité, la forme de la décision devient bien plus facile à voir.
Choisissez votre voie de sortie
Au lieu de lire les huit, répondez simplement à la seule question qui divise vraiment le champ.
De quoi avez-vous réellement besoin que Muse Spark 1.2 ne vous donne pas ?
Choisissez-en un. Chaque réponse a un coût, et le chiffre est indiqué.
En tête de l'Intelligence Index à 63,05, soit 6,29 points devant Muse Spark 1.2. Il propose le contexte complet de 1M au tarif standard, sans surcoût pour le contexte long.
Le compromis : 2,3369 $ par tâche contre 0,3992 $. Vous payez 5,9 fois plus pour un gain de capacité d'environ 11 %.
59,70 à l'indice, et le seul modèle à poids ouverts du classement de 20 lignes qui bat Muse Spark 1.2. Les poids sont sortis le jour où Moonshot avait dit qu'ils sortiraient.
Le compromis : 0,8375 $ par tâche, soit 2,1 fois le coût pour 2,94 points d'indice. La licence est sur mesure, pas MIT.
Sous licence MIT sans conditions particulières, 53,20 à l'indice, et le moins cher par tâche des options crédibles ici, à 0,2521 $. Il existe 662 dépôts communautaires, dont 316 quantifiés.
Le compromis : 3,56 points d'indice sous Muse Spark 1.2, et le tarif double aux heures de pointe UTC.
Le propre modèle Apache 2.0 de Meta, distillé à partir de Muse Spark, qui tient sous 20 Go à environ 4 bits. C'est le modèle Meta que vous pouvez réellement télécharger aujourd'hui.
Le compromis : 35,06 à l'indice, soit 21,70 points sous Muse Spark 1.2. Un agent local capable, pas un substitut de modèle de pointe.
1. Claude Opus 5
Idéal pour : les équipes où une mauvaise réponse coûte plus cher que la facture d'API.
Le modèle phare d'Anthropic tient la tête du classement à 63,05. C'est aussi le seul modèle ici dont l'écart avec Muse Spark 1.2 est assez large pour qu'on le remarque sans aucun harnais de benchmark.
Où il bat Muse Spark 1.2. Six points d'indice, et en pratique cela se voit sur les longues tâches en plusieurs étapes, celles où une erreur précoce s'accumule. Il offre aussi le contexte complet de 1M au tarif standard, Anthropic précisant qu'une requête de 900k tokens est facturée au même tarif par token qu'une requête de 9k. Ni OpenAI ni xAI ne le font.
Où il ne le bat pas. Le coût, et de loin. Ensuite ce que la plupart des articles passent sous silence : le taux d'hallucination AA-Omniscience d'Opus 5 a augmenté de 14 points pour atteindre 50 %. Un score d'indice plus élevé n'est pas la même chose qu'un modèle plus fiable.
Tarifs. 5,00 $ en entrée, 0,50 $ en lecture de cache, 25,00 $ en sortie par million. Le batch est à moitié prix. Les écritures de cache sont à 6,25 $ pour un TTL de 5 minutes. Si ce plafond dépasse vos besoins, Claude Sonnet 5 est désormais définitivement à 2,00 $ et 10,00 $, après qu'Anthropic a annulé la hausse prévue pour le 1er septembre.
Verdict : le bon choix quand une erreur coûte cher et que la facture de tokens ne compte pas. Passez votre chemin si vous faites de la classification à gros volume, car vous paieriez alors 5,9 fois plus par tâche pour une capacité que la tâche n'utilise jamais.
2. Kimi K3
Idéal pour : tous ceux dont le besoin réel est « des poids ouverts, et meilleurs que ce que j'ai ».
Le modèle phare de Moonshot est l'entrée la plus intéressante de cette liste, car c'est le seul modèle qui remplit les deux moitiés de ce que les gens disent attendre de Meta. Il score 59,70, donc au-dessus de Muse Spark 1.2, et les poids sont téléchargeables dès maintenant, aujourd'hui.
Où il bat Muse Spark 1.2. Près de trois points d'indice, puis 2,8 billions de paramètres que vous pouvez héberger vous-même. Ce qui mérite qu'on s'y arrête : le blog technique de Moonshot disait que les poids seraient publiés d'ici le 27 juillet 2026, et le premier commit public sur Hugging Face date du 27 juillet 2026. Une date annoncée, tenue au jour près.
Où il ne le bat pas. Deux choses. Le coût par tâche est de 0,8375 $, soit plus du double. Puis la licence, qui n'est pas ce que prétendent la plupart des articles : les métadonnées du dépôt indiquent license: other avec license_name: "kimi-k3", une licence Moonshot sur mesure. Des poids ouverts, oui. De l'open source permissif, non. Son Openness Index est de 38,89, sous les 44,44 de Muse Glimmer.
Tarifs. 3,00 $ en entrée, 0,30 $ en cache hit, 15,00 $ en sortie par million, donc dans le territoire de Claude Sonnet plutôt que dans celui des petits budgets. Mon test complet de Kimi K3 détaille le comportement de l'effort de raisonnement, qu'on ne peut désactiver à aucun niveau.
Verdict : la réponse par défaut pour quiconque attendait les poids de Meta. Vous payez environ le double par tâche et vous lisez attentivement la licence avant de déployer, mais il existe aujourd'hui et il est mesurablement meilleur.
3. Qwen3.8 Max
Idéal pour : les équipes qui veulent un modèle hébergé maintenant et une solution auto-hébergée de repli plus tard.
Le modèle phare d'Alibaba score 58,08 en hébergé, et c'est l'entrée où ma propre recherche m'a corrigé en plein brouillon. Plus tôt ce mois-ci, les poids de Qwen 3.8 étaient promis et non publiés, exactement dans la position où se trouve Muse Spark 1.2 aujourd'hui. Puis ils sont sortis le 9 août.
Où il bat Muse Spark 1.2. 1,32 point d'indice en hébergé, tandis que la base ouverte Qwen3.8-2.4T-A95B score à elle seule 57,70. Autrement dit, même la version téléchargeable bat le modèle que vous songez à quitter.
Où il ne le bat pas. Le coût par tâche est de 1,1320 $, soit près du triple. La version ouverte n'est pas non plus équivalente en fonctionnalités au produit hébergé : la fiche du modèle de Qwen indique que Max hébergé ajoute l'entrée vision, la prise en charge sans réflexion, un contexte de 1M par défaut et des outils intégrés. Et la licence est de nouveau sur mesure, qwen3.8-max, pas Apache.
Tarifs. 2,00 $ en entrée, 0,25 $ en lecture de cache implicite, 6,00 $ en sortie par million. La lecture de cache explicite est moins chère, 0,17 $, mais coûte 2,50 $ par million à créer, donc elle ne se rentabilise que sur des préfixes très répétés. Les voies d'accès pratiques sont dans comment accéder à Qwen3.8 Max.
Verdict : la meilleure couverture de cette liste, puisque vous pouvez démarrer en hébergé puis passer sur votre propre matériel sans changer de famille de modèles. Le test de Qwen3.8 Max contient les chiffres de préférence humaine, qui pointent dans une direction plus favorable que l'indice automatisé.
4. GPT-5.6 Terra
Idéal pour : un remplacement équivalent où l'outillage autour compte plus que le score.
Le modèle intermédiaire d'OpenAI arrive à 56,58, soit 0,18 point sous Muse Spark 1.2. En pratique, les deux modèles offrent la même capacité à un prix différent, et c'est pourquoi le billet de lancement de Meta se comparait à Terra plutôt qu'à GPT-5.6 Sol. Un commentateur l'avait relevé à l'époque :
"They chose to compare against Open AI's mid tier model Terra instead of Sol and still lost some benchmark against it. They left Opus in and got beat in all but one benchmark. Nothing wrong with trying to improve, but why the marketing games?"
Où il bat Muse Spark 1.2. Surtout l'écosystème. Terra s'exécute dans l'outillage que votre équipe utilise probablement déjà, et OpenAI publie des chiffres de vitesse et de latence que Meta ne publie pas.
Où il ne le bat pas. Il est 27 % plus cher par tâche, pour un score marginalement inférieur. Il y a aussi un précipice de contexte long : les prompts de plus de 272K tokens en entrée sont facturés 2x en entrée et 1,5x en sortie sur toute la requête, pas seulement sur le dépassement, selon la page du modèle d'OpenAI. Muse Spark 1.2 n'applique aucune surcharge pour contexte long.
Tarifs. 2,00 $ en entrée, 0,20 $ en cache, 12,00 $ en sortie par million, et cela avant le multiplicateur de contexte long. L'endroit exact où ce précipice mord est détaillé dans le décryptage des tarifs de GPT-5.6.
Verdict : changez pour l'outillage et pour les chiffres de latence publiés, pas pour la capacité. Si vos prompts dépassent régulièrement 272K tokens, faites le calcul avant de migrer.
5. Gemini 3.7 Flash
Idéal pour : les charges à gros volume où le débit est la contrainte.
La gamme Flash de Google score 56,03 à 0,4022 $ la tâche, ce qui la place à une erreur d'arrondi de Muse Spark 1.2 sur les deux axes. La différence, c'est que Google publie sa vitesse. Artificial Analysis la mesure à 340,1 tokens par seconde, première sur 188 modèles mesurés.
Où il bat Muse Spark 1.2. Une vitesse mesurée, plus un tarif catalogue moins élevé à 0,75 $ en entrée. C'est le seul modèle ici où vous pouvez aussi baisser volontairement la capacité : à l'effort low, il score 50,9 à 0,16 $ la tâche, et pour de la classification c'est souvent le bon choix.
Où il ne le bat pas. Il y a deux vraies réserves. Le tarif actuel est un tarif de lancement jusqu'au 31 décembre 2026 et double à 1,50 $ et 7,50 $ le 1er janvier 2027, donc tout modèle de coûts que vous construisez aujourd'hui comporte un précipice. Son taux d'hallucination a aussi régressé à 64,5 % contre 55,6 % pour la version précédente, ce que j'ai creusé dans le test de Gemini 3.7 Flash.
Tarifs. 0,75 $ en entrée, 0,075 $ en cache, 3,75 $ en sortie par million jusqu'à fin 2026. La sortie maximale est de 65 536 tokens, nettement plus serrée que le reste de cette liste.
Verdict : le meilleur choix si la latence est le vrai reproche que vous faites à Muse Spark 1.2, puisque vous ne pouvez même pas mesurer celle de Meta. Budgétez dès maintenant le changement de prix de janvier, plutôt que d'être surpris plus tard.
6. DeepSeek V4 Pro et V4 Flash
Idéal pour : les poids les moins chers avec lesquels vous pouvez faire ce que vous voulez.
C'est l'entrée qui gagne sur la licence plutôt que sur le score. V4 Pro score 53,20 à 0,2521 $ la tâche, et lui comme DeepSeek V4 Flash portent une simple licence mit dans les métadonnées de leur dépôt. Pas de conditions sur mesure. Pas de politique d'usage à côté non plus.
Où il bat Muse Spark 1.2. Le prix, et la liberté. Il est 37 % moins cher par tâche, sous licence MIT, et possède l'écosystème communautaire le plus profond de toute cette comparaison : une recherche renvoie 662 dépôts, dont 316 quantifiés. Cet écosystème rend l'auto-hébergement réaliste plutôt que théorique.
Où il ne le bat pas. Il cède 3,56 points d'indice. Il y a aussi une particularité à anticiper : DeepSeek facture le double aux heures de pointe, définies de 01:00 à 04:00 et de 06:00 à 10:00 UTC. Une file de support européenne tombera chaque jour dans cette fenêtre ; une file américaine presque jamais. Côté politique de données, les conditions de l'API payante de DeepSeek sont silencieuses sur l'usage pour l'entraînement plutôt que permissives, et l'infrastructure relève du droit de la RPC.
Tarifs. V4 Pro coûte 0,66 $ en entrée et 1,98 $ en sortie aux heures creuses, et double aux heures de pointe. V4 Flash est bien moins cher, 0,22 $ et 0,66 $ aux heures creuses, et score 51,77. Le calcul des heures de pointe est expliqué en détail dans l'article sur les tarifs de DeepSeek V4 Flash.
Verdict : si votre exigence est « poids MIT, pas cher », c'est la réponse et rien d'autre dans la liste ne rivalise. Si la charge touche des données clients réglementées, la résidence des données est la première question à régler.
7. GPT-5.6 Luna
Idéal pour : le travail à gros volume que vous n'auriez jamais dû exécuter sur un modèle de pointe.
Luna score 52,32 à 0,0471 $ la tâche. C'est 8,5 fois moins cher que Muse Spark 1.2 pour 92 % du score d'indice, et c'est le seul chiffre ici qui devrait pousser quiconque fait de la classification en masse à reconsidérer toute sa configuration.
Où il bat Muse Spark 1.2. Le coût, et de façon spectaculaire. La plupart des charges de production n'ont pas du tout un profil de pointe : étiquetage et routage, extraction, résumé ont rarement besoin de 56 points d'indice. Luna est entièrement hébergé, avec une latence publiée, ce que n'offre pas le modèle de Meta.
Où il ne le bat pas. Il est 4,44 points en dessous, et cet écart se voit sur tout ce qui est vraiment en plusieurs étapes. Un cheval de trait, pas un raisonneur.
Tarifs. 0,20 $ en entrée, 0,02 $ en cache, 1,20 $ en sortie par million, avec le même multiplicateur de contexte long >272K que le reste de la famille GPT-5.6.
Verdict : la ligne la plus sous-estimée du tableau. Avant de tout migrer vers un modèle plus cher, répartissez votre trafic et vérifiez quelle part a réellement besoin du modèle coûteux.
8. Muse Glimmer 30B
Idéal pour : faire tourner un modèle Meta sur du matériel que vous possédez, aujourd'hui.
Si vous êtes venu parce que vous vouliez des poids Meta, c'est ce qui existe réellement. Glimmer compte 29,78 milliards de paramètres sous Apache 2.0, distillé à partir de Muse Spark, avec un contexte de 131 072 tokens et une date limite de connaissances en janvier 2026.
Où il bat Muse Spark 1.2. Vous pouvez le télécharger. Meta le quantifie à environ 4 bits, ce qui place le modèle de langage sous 20 Go et le fait tenir sur une carte de 24 Go. Le coût par tâche est de 0,0732 $, et c'est le seul modèle Meta doté d'un Openness Index, à 44,44. La réaction de la communauté a été immédiate : 296 dépôts Glimmer existent désormais, et la version GGUF d'unsloth, avec 755 125 téléchargements, dépasse le propre dépôt de poids de Meta.
Où il ne le bat pas. 35,06 contre 56,76, c'est un écart de 21,70 points, et aucune commodité locale ne le comble. Une note de licence mérite aussi d'être connue : à côté du vrai texte Apache 2.0, le dépôt fournit un USAGE_POLICY.md rédigé par Meta qui restreint l'usage par les mineurs et interdit les applications militaires, d'armement et d'infrastructures critiques. Apache 2.0 n'impose aucune de ces conditions, donc la surface pratique ici, c'est Apache plus un document de politique.
Tarifs. Téléchargement gratuit, puis votre propre puissance de calcul. Un développeur qui le faisait tourner sur un Mac mini de 32 Go a été franc sur ce que cela signifie en pratique :
"I am getting good results with muse-glimmer running locally, with the caveat that everything runs slowly (e.g., give it a task and then go walk outside or do Qi Gong exercises for a while)."
Verdict : un très bon modèle d'agent local, et un mauvais substitut à Muse Spark. Traitez-le comme un outil différent, pas comme une voie de repli.
Ce que dit réellement la communauté
L'opinion sur Muse Spark 1.2 se divise nettement selon une seule ligne. Ceux qui ont lu les benchmarks attaquent son classement ; ceux qui l'ont utilisé saluent le peu de tokens qu'il gaspille. Les deux camps ont raison, et c'est pourquoi la réaction au lancement paraît si contradictoire.
La lecture sceptique la plus acérée est arrivée le jour du lancement :
"Somewhat surprised that Meta with all their resources couldn't make a model that matches Composer on any frontier. All the Sparks are dominated by some other model everywhere along the frontier. The use traces must be crucial to functionality which is why they're keeping prices so low."
Deux semaines de mesures indépendantes y ont en partie répondu. Sur le classement actuel d'Artificial Analysis, Muse Spark 1.2 n'est pas du tout dominé en rapport qualité-prix ; il se situe sur la frontière à son propre niveau de coût. La seconde moitié du commentaire, celle sur le prix comme stratégie d'acquisition de données, tient bien mieux.
Sur les poids, l'objection ne porte pas vraiment sur cette annonce. Elle porte sur la précédente :
"Meta in this case, started nicely with Llama, then switched to closed models, kicked out researchers to build data labeler CEO empire inside Meta. Now opening again, what's next? closing again?"
Et la position que j'ai vue le plus souvent n'était ni « changez » ni « restez ». C'était de prendre l'artefact ouvert et de refuser le produit hébergé :
"I'd also argue this is the case for any company releasing open weights. They're not righteous, they're marketing. That's not necessarily a bad thing! [...] I still will not use a hosted Meta product, but damn this model looks solid."
Par souci d'équilibre : la voix positive la plus forte sur l'annonce a été celle du PDG de Box, qui l'a lue comme un changement de catégorie plutôt que comme un lancement de produit :
"Meta releasing Muse Spark 1.2 as open weights is a very big deal. America now finally has its response to the open weights AI race."
Cette réaction visait pourtant la promesse. Huit jours plus tard, le téléchargement n'existe toujours pas.
Ce qu'aucun de ces changements ne corrigera
C'est la partie qui m'importe le plus, parce que je passe ma vie professionnelle sur la couche située sous ces modèles.
Si vous choisissez entre les huit pour une charge générale de code ou de recherche, le tableau ci-dessus est l'essentiel de ce dont vous avez besoin. Mais une grande part de ceux qui cherchent des alternatives à Muse Spark 1.2 essaient de réparer une automatisation de support qui donne de mauvaises réponses, et changer de modèle n'est presque jamais la solution.
L'exemple par lequel j'ai commencé est le plus net que je connaisse. Une équipe de support technique B2B avait une IA qui disait avec assurance aux clients « oui, nous prenons en charge le modèle de votre voiture » pour des marques de véhicules absentes de leur base de données. Le modèle n'était pas cassé. Leur centre d'aide disait « nous prenons en charge tous les modèles », l'IA a récupéré cette phrase, puis a répondu correctement à partir du texte qu'on lui avait donné. Passer d'un modèle à 56,8 à un modèle à 63,1 ne change rien à ce résultat, parce que l'échec s'est produit dans la récupération et non dans le raisonnement.
On voit la même chose dans les données de benchmark. La précision AA-Omniscience de Muse Spark 1.2 a en fait baissé par rapport à 1.1, de 52,0 % à 45,4 %, tandis que le taux d'hallucination s'améliorait de 50,0 % à 33,3 %. Il n'est pas devenu plus savant. Il est devenu meilleur pour s'abstenir. Pour un assistant généraliste, c'est un compromis raisonnable ; pour un agent de support, il est mauvais, car une réponse refusée reste un ticket.
Trois choses font davantage progresser la précision du support que le modèle :
- Ce que l'IA peut voir. Les tickets résolus passés, et pas seulement les articles du centre d'aide. La plupart des outils s'entraînent sur la seule documentation publiée, ce qui explique exactement pourquoi ils vous répètent « nous prenons en charge tous les modèles ».
- Ce qu'elle fait quand elle n'est pas sûre. Un routage basé sur la confiance vers un brouillon plutôt qu'une réponse en direct, de sorte qu'une réponse à faible confiance devienne une escalade au lieu d'une erreur visible du client.
- Si vous l'avez testé avant vos clients. Simuler sur vos propres tickets historiques est ce qui vous donne le vrai taux de résolution. Un score d'indice public ne vous donne que celui de quelqu'un d'autre.
J'approfondis tout cela dans les modèles d'IA pour le support, et le schéma d'échec lui-même dans les hallucinations de l'IA en support.
Essayer eesel pour le support
Si vous êtes arrivé sur une comparaison de modèles parce que votre IA de support répond mal en continu, alors le niveau du modèle est le mauvais bouton à tourner. eesel est un coéquipier IA qui se branche sur Zendesk, Freshdesk, Gorgias, HubSpot ou Front, et qui apprend de votre historique de tickets résolus dès le premier jour, pas seulement de votre base de connaissances publique.
Ce qui compte pour tout ce qui précède : avant qu'il ne touche un seul client, vous l'exécutez en simulation sur vos propres tickets passés et vous voyez le vrai taux de résolution, ventilé par thème. Gridwise a vu 73 % des demandes de niveau 1 résolues dans le premier mois. La facturation est d'un crédit par ticket (forfaits à partir de 299 $ par mois pour 500 crédits), et non au million de tokens que vous ne pouvez pas prévoir, de sorte que le calcul des heures de pointe et du contexte long de cette page cesse d'être votre problème.

Essai gratuit, sans carte, et en une journée vous saurez si le modèle a jamais été votre problème. Essayer eesel.
Alors lequel choisir
Si vous ne deviez retenir qu'une chose de cette page, que ce soit ceci : Muse Spark 1.2 n'est pas une mauvaise affaire en capacité par dollar, et changer pour le seul score vous coûtera plus que cela ne vous rapporte.
Partez plutôt pour une raison concrète. Si une mauvaise réponse coûte cher, Claude Opus 5 vous achète l'écart réel le plus grand. Si vous voulez des poids qui battent ce que vous avez aujourd'hui, Kimi K3 est le seul modèle qui fait les deux, à environ le double du coût par tâche. Si c'est précisément MIT que vous exigez, DeepSeek est la réponse et la licence y est propre. Et si le reproche est la vitesse, Gemini 3.7 Flash est le seul des deux dont quelqu'un a publié la vitesse.
Et si vous attendez toujours les poids de Meta, le bilan mérite d'être retenu. Moonshot a donné une date puis l'a tenue. Alibaba a publié en moins d'une semaine. DeepSeek est sous licence MIT depuis le début. Meta a publié le modèle élève et un adjectif.
Questions fréquentes
Quelles sont les meilleures alternatives à Meta Muse Spark 1.2 ?
Muse Spark 1.2 est-il open source ?
muse-spark-1.2 est un modèle d'API propriétaire sans poids publiés. Meta a annoncé le 10 août qu'une version à poids ouverts arrivait bientôt, sans citer de licence ni de date, et rien n'a été publié depuis. Le modèle Meta qui est ouvert, c'est Muse Glimmer 30B, sous Apache 2.0. Pour une vue d'ensemble, voir mon panorama des agents IA open source.Quel modèle à poids ouverts est le plus proche de Muse Spark 1.2 ?
Dois-je quitter Muse Spark 1.2 pour un cas d'usage de support client ?
Qu'est-ce que Muse Glimmer 30B et peut-il remplacer Muse Spark 1.2 ?
Muse Spark 1.2 propose-t-il une offre gratuite ?
muse-spark-1.2-contributor coûte 0,10 $ en entrée et 0,20 $ en sortie en échange du droit pour Meta d'utiliser votre trafic pour entraîner de futurs modèles, avec un plafond de 100 requêtes par minute. Si l'objectif est une facture basse sans cet échange de données, GPT-5.6 Luna à 0,0471 $ par tâche est l'option hébergée la moins chère du classement.
Comment le prix de Muse Spark 1.2 se compare-t-il aux alternatives ?
muse-spark-1.2coûte 1,25 $ par million de tokens en entrée et 4,25 $ en sortie, ce qui revient à 0,3992 $ par tâche de l'Intelligence Index. C'est moins cher par tâche que les tarifs de Kimi K3 à 0,8375 $ et moins cher que Claude Opus 5 à 2,3369 $. Le détail complet des tarifs de Muse Spark 1.2 se trouve dans mon décryptage des prix.