

Meta a lancé Muse Spark 1.3 le 2 septembre 2026, environ quatre semaines après la version 1.2, au sein de son agent de codage Muse Code et de l'API Meta Model. C'est un véritable bond en avant : il se situe au 6e rang sur 636 modèles dans l' Artificial Analysis Intelligence Index, avec une fenêtre de contexte (context window) de 1 million de tokens et une prise en charge des entrées texte, image et vidéo.
L'analyse honnête de ses points forts : le contexte long et le codage sont les vrais gains. Il affiche une récupération en contexte long quasi parfaite (98,5 et 98,1) et remporte chaque ligne de codage dans le tableau de bord de Meta. Sur les benchmarks d'agents purs, cependant, Opus 5 (max) mène toujours sur quatre des six tests. De plus, les chiffres phares comportent un piège : le tableau de bord de Meta compare le mode max de la version 1.3 (toujours restreint par des tests de sécurité au lancement) au mode xhigh de la version 1.2. Ainsi, une partie de la progression provient d'un changement de niveau de raisonnement et non d'un pur saut générationnel. Il est également environ 3 fois plus verbeux que la version 1.2.
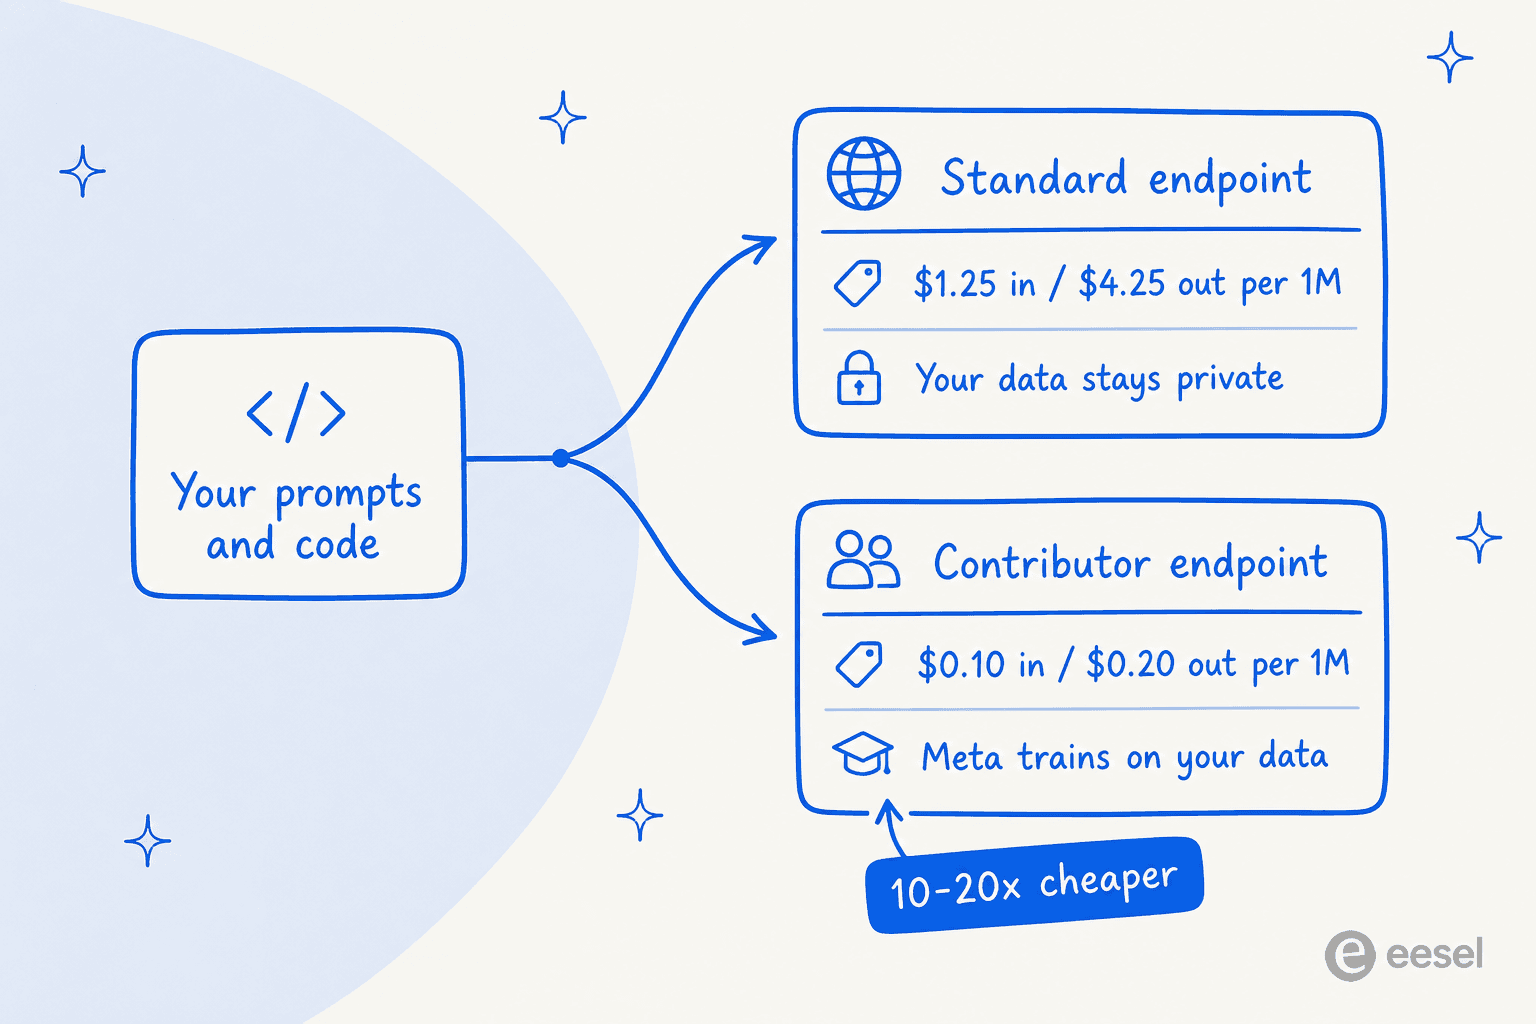
Le tarif est le sujet le plus discuté. Le point de terminaison standard est de 1,25 $ / 4,25 $ par million de tokens ; un point de terminaison « contributeur » est environ 10 à 20 fois moins cher si vous laissez Meta s'entraîner sur vos données. Quel que soit votre choix, un modèle brut reste une infrastructure et non un travailleur fini. Si ce que vous voulez réellement est un agent de support ou un rédacteur de blog qui connaît déjà votre entreprise, c'est le travail qu'un coéquipier IA comme eesel AI effectue par-dessus des modèles comme celui-ci.
Ce qu'est réellement Muse Spark 1.3
Je construis sur ces API de modèles pour gagner ma vie, donc la première chose que je fais lors d'une sortie est de séparer le modèle du marketing. Muse Spark 1.3 est le modèle de raisonnement de pointe à poids fermés (closed-weights) de Meta, et Meta le positionne comme une nouvelle étape « vers la superintelligence personnelle » dans son annonce sur le blog de recherche. Vous pouvez y accéder de deux manières : via Muse Code, le propre harnais d'agent de codage de Meta, ou directement via l'API Meta Model.
Quelques faits méritent d'être fixés avant que le bruit des benchmarks ne commence :
- Il est livré en deux variantes publiées :
max(le mode de raisonnement supérieur) etxhigh(plus rapide). Le blog de Meta note que le raisonnement max « arrive peu après la fin des tests de sécurité supplémentaires », donc le mode pleinement disponible au lancement est xhigh, et non max. - La fenêtre de contexte est de 1M de tokens, et il accepte du texte, des images et de la vidéo en entrée.
- C'est un modèle propriétaire. Artificial Analysis le répertorie comme fermé, et aucune version open weights n'a été annoncée, ce qui le place dans une catégorie différente de la gamme ouverte Llama de Meta.
Cette division des variantes compte plus qu'il n'y paraît, et j'y reviendrai, car elle joue discrètement un rôle majeur dans les chiffres de lancement.
Les benchmarks : là où 1.3 l'emporte, et là où il échoue
Meta a ouvert le lancement avec un tableau de bord comparant quatre modèles : Muse Spark 1.3, Muse Spark 1.2, GPT-5.6 Sol et Claude Opus 5, sur des tâches d'agent, de codage, de suivi d'instructions et de contexte long. Le voici directement à la source.
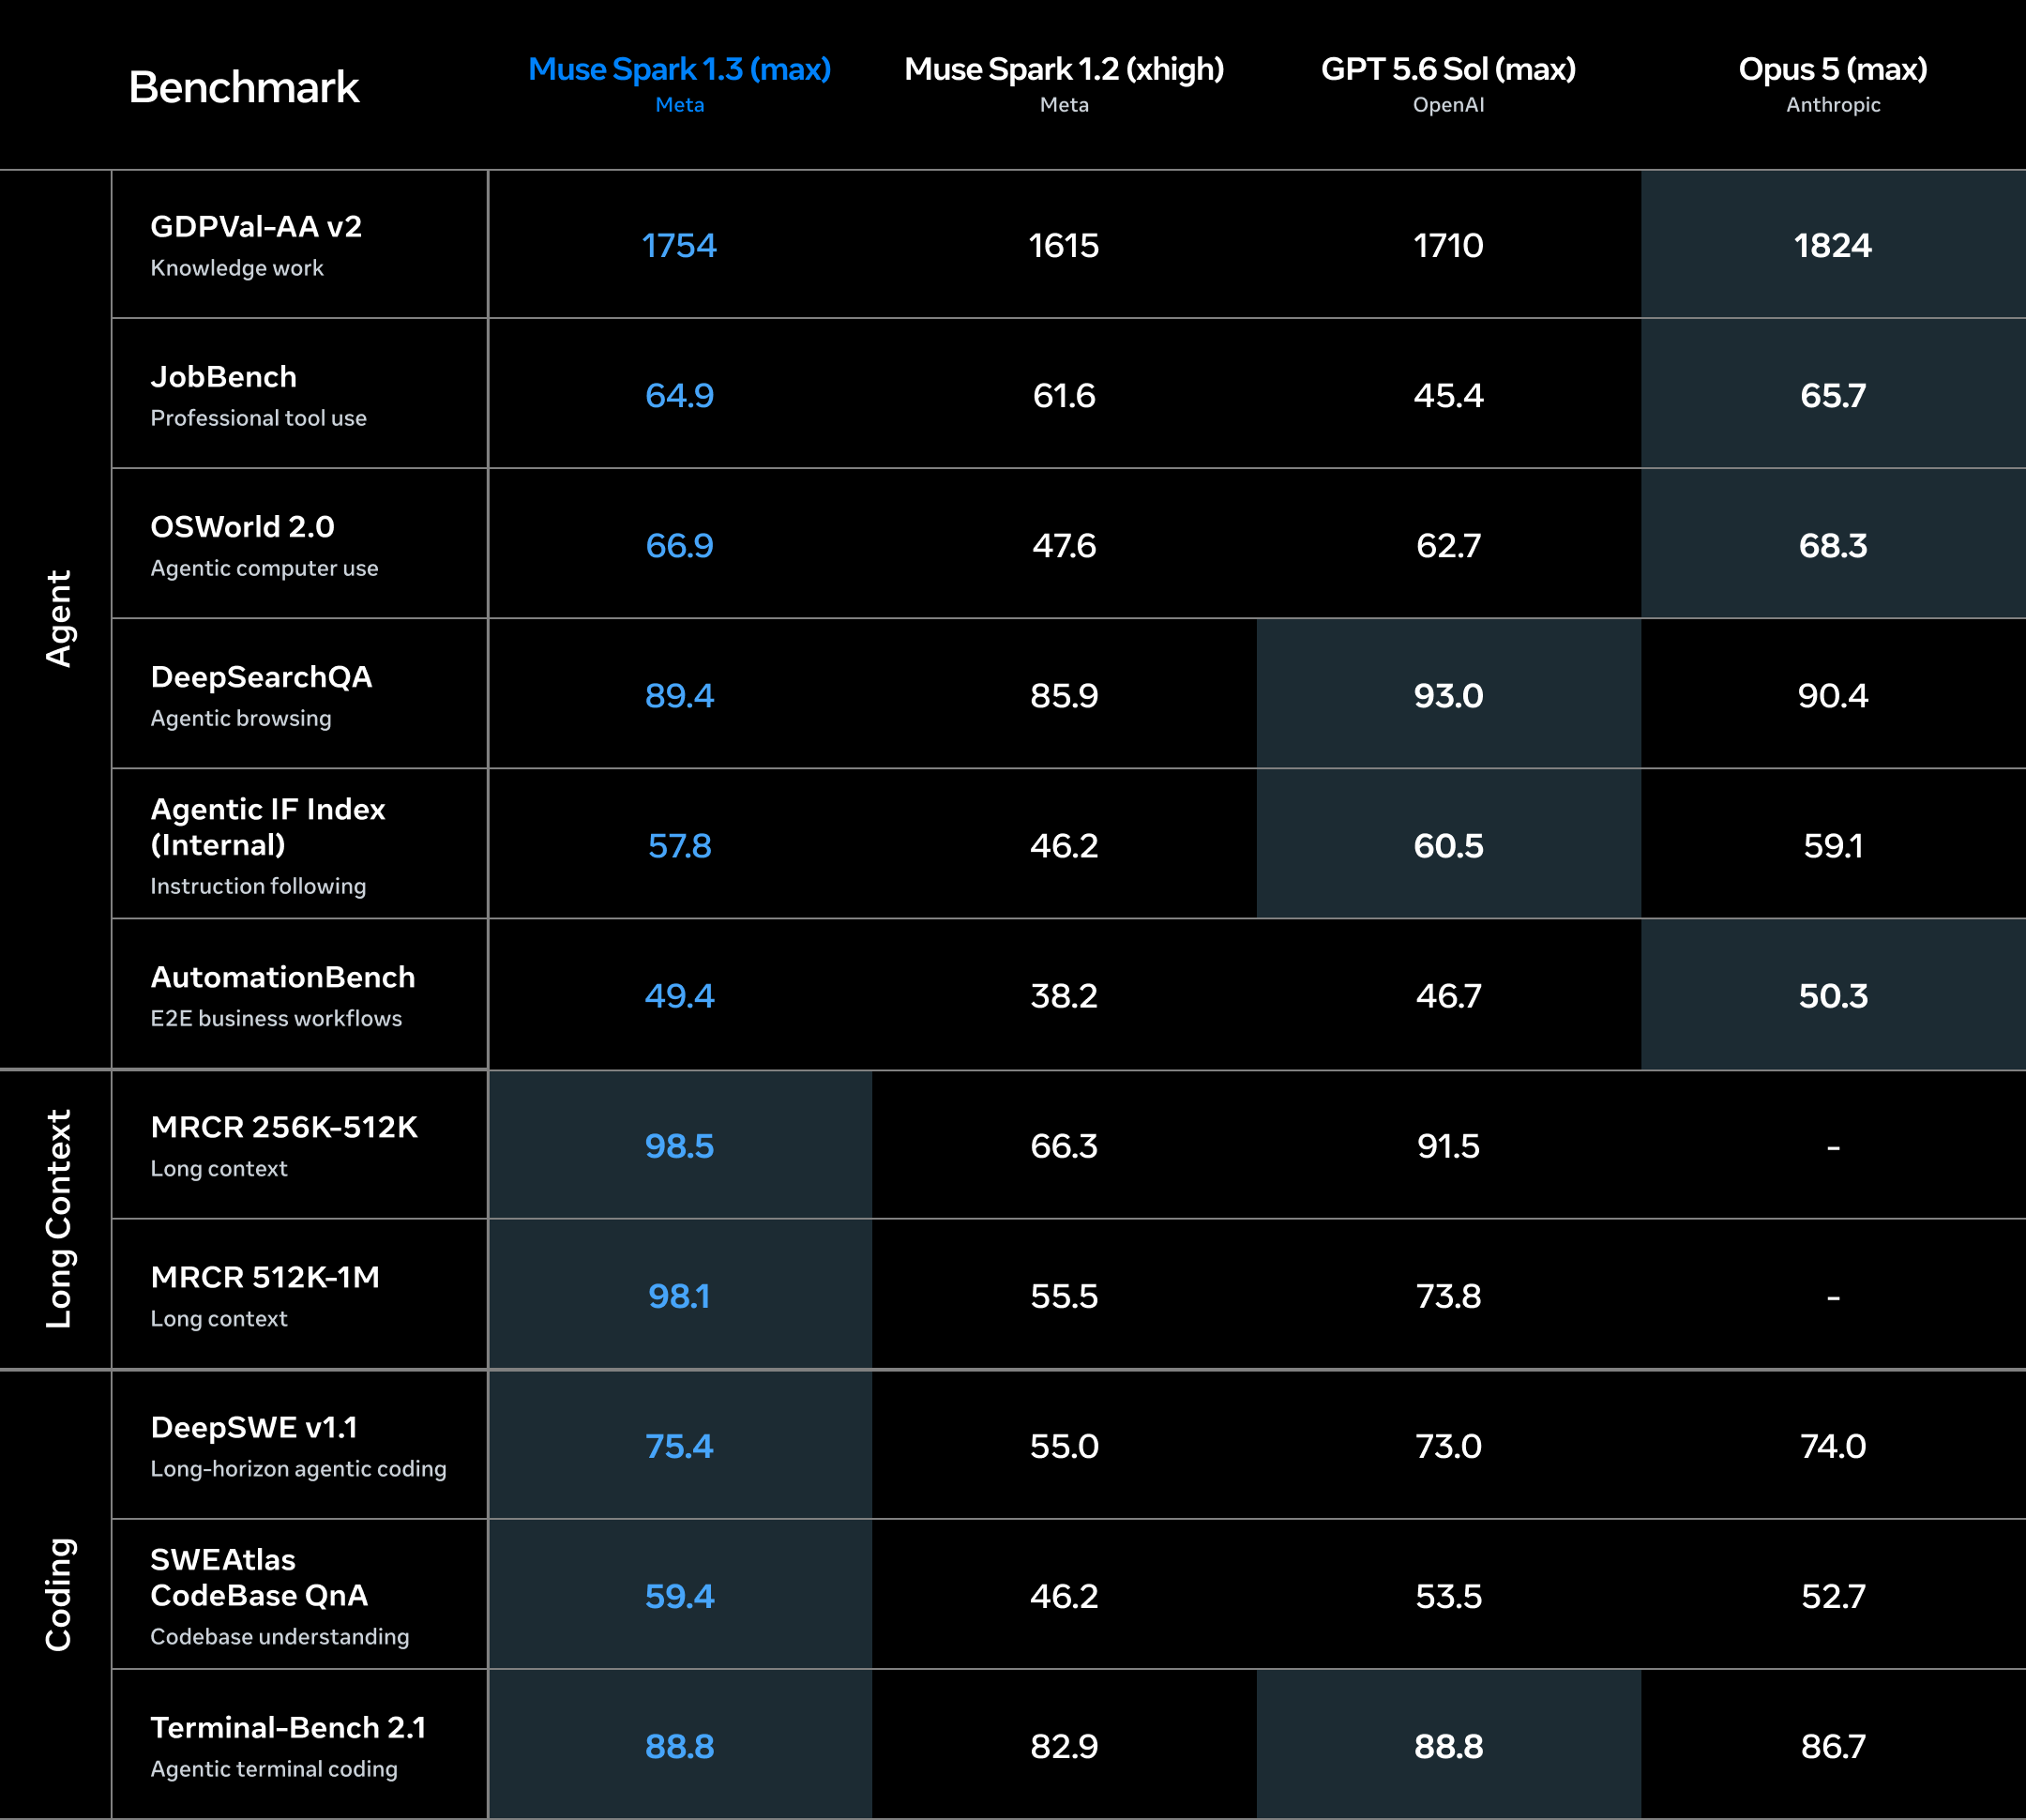
En lisant les lignes, un schéma clair apparaît, ce qui est plus utile qu'un simple chiffre global :
| Benchmark | Muse Spark 1.3 (max) | Muse Spark 1.2 (xhigh) | GPT-5.6 Sol (max) | Opus 5 (max) |
|---|---|---|---|---|
| GDPVal-AA v2 (travail intellectuel) | 1754 | 1615 | 1710 | 1824 |
| JobBench (utilisation d'outils pros) | 64,9 | 61,6 | 45,4 | 65,7 |
| OSWorld 2.0 (utilisation de l'ordi) | 66,9 | 47,6 | 62,7 | 68,3 |
| DeepSearchQA (navigation agentique) | 89,4 | 85,9 | 93,0 | 90,4 |
| Agentic IF Index (suivi d'instructions) | 57,8 | 46,2 | 60,5 | 59,1 |
| AutomationBench (flux de travail E2E) | 49,4 | 38,2 | 46,7 | 50,3 |
| MRCR 256K-512K (contexte long) | 98,5 | 66,3 | 91,5 | – |
| MRCR 512K-1M (contexte long) | 98,1 | 55,5 | 73,8 | – |
| DeepSWE v1.1 (codage agentique) | 75,4 | 55,0 | 73,0 | 74,0 |
| SWEAtlas CodeBase QnA | 59,4 | 46,2 | 53,5 | 52,7 |
| Terminal-Bench 2.1 (codage terminal) | 88,8 | 82,9 | 88,8 | 86,7 |
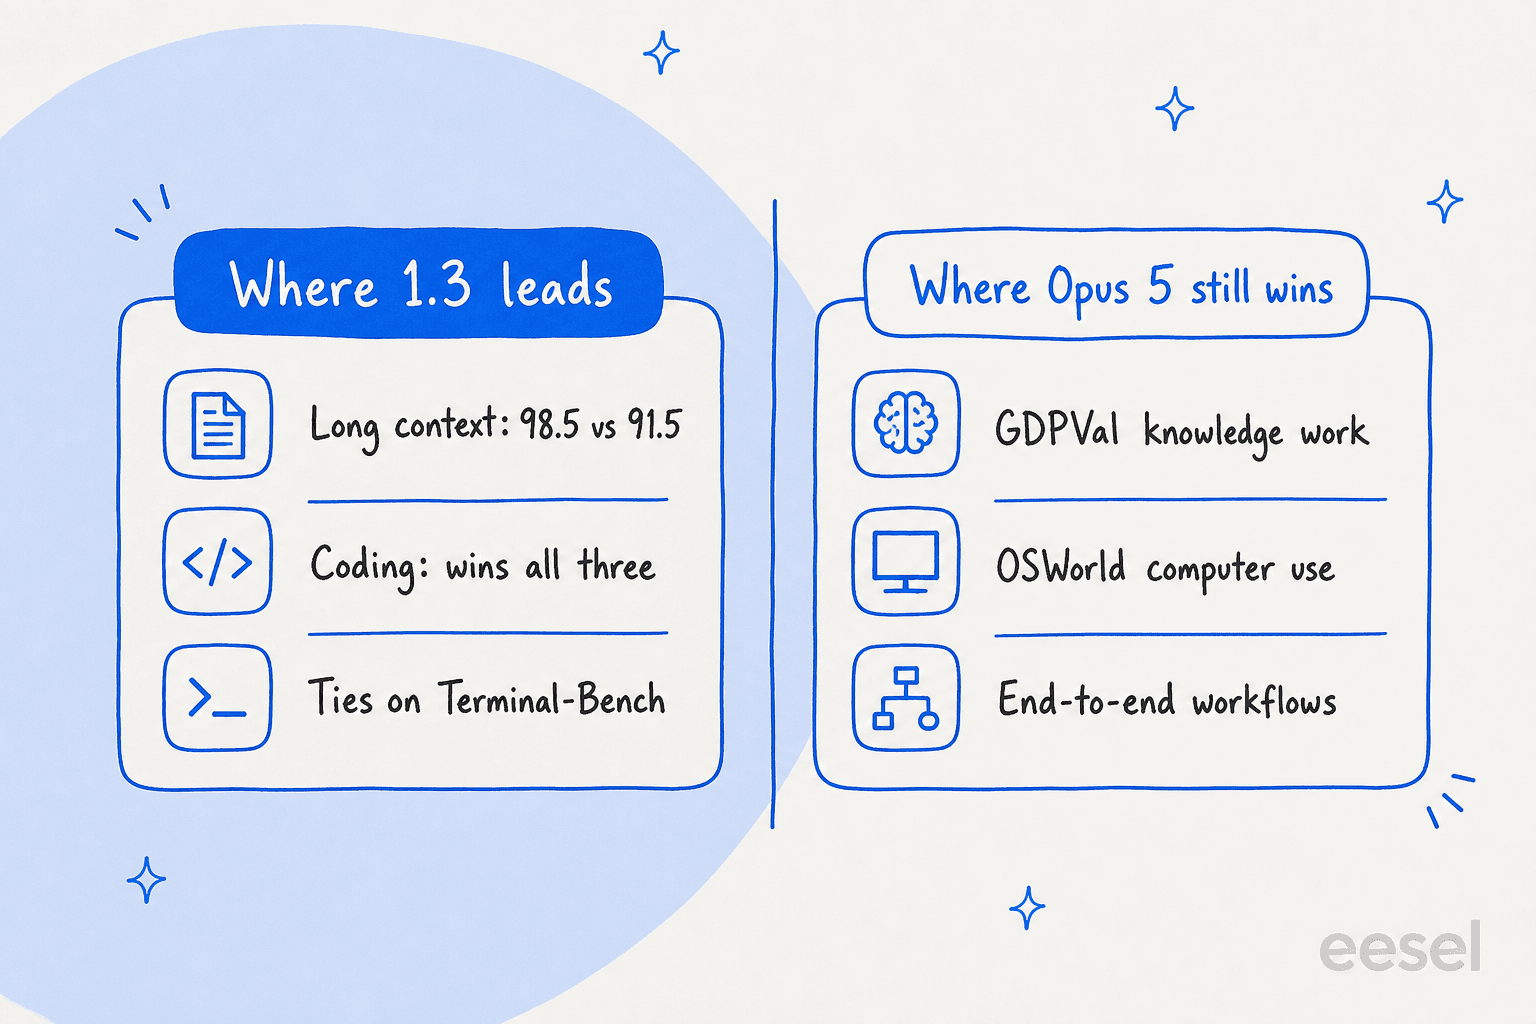
L'histoire que raconte ce tableau : Muse Spark 1.3 domine le contexte long et le codage. Ses scores de 98,5 et 98,1 sur les tests de contexte long MRCR ne sont pas seulement des victoires, ils laissent GPT-5.6 Sol (91,5 et 73,8) et son propre prédécesseur (66,3 et 55,5) loin derrière, tandis qu'Opus 5 n'a même pas publié de chiffre. En codage, il remporte DeepSWE v1.1 (75,4), la compréhension de base de code (59,4), et fait jeu égal avec GPT-5.6 Sol en tête de Terminal-Bench (88,8). C'est un résultat concret et vérifiable, qui concorde avec la propre affirmation de Meta selon laquelle la version 1.3 utilise environ 20 % d'appels d'outils en moins et environ 25 % de tokens en moins que la 1.2 pour terminer une tâche de codage.
Mais regardez honnêtement la colonne des agents. Sur les six benchmarks d'agents, Opus 5 (max) bat 1.3 sur quatre d'entre eux (GDPVal, JobBench, OSWorld, AutomationBench), et GPT-5.6 Sol remporte les deux autres (DeepSearchQA, Agentic IF). Ainsi, « amélioration agentique et du codage » est juste pour le codage, mais sur les évaluations d'agents, 1.3 est un solide deuxième, pas le leader. Sur l'ensemble, Artificial Analysis attribue à sa variante max un Intelligence Index de 62, classé 6e sur 636 modèles, contre une médiane de 17 pour les modèles comparables. C'est bien, mais le classement est assez serré pour qu'un rival puisse repasser devant en une semaine, et un commentateur sur HN a noté que Gemini 3.8 Flash avait brièvement occupé la première place le même jour.
Le piège des chiffres phares
Voici ce que j'aimerais qu'un collègue me signale. Regardez à nouveau les en-têtes de colonnes du tableau de bord : la colonne 1.3 est max, et la colonne 1.2 est xhigh. Ce sont des niveaux de raisonnement différents. Ainsi, certains bonds spectaculaires entre 1.2 et 1.3, comme OSWorld passant de 47,6 à 66,9 ou MRCR de 66,3 à 98,5, sont en partie dus à l'écart max contre xhigh, et non à un pur gain d'une version à l'autre. Une comparaison à armes égales en xhigh réduirait presque certainement ces écarts.
Ce cadrage a dérangé certains. Comme l'a dit un commentateur sur le fil de lancement :
« C'est un peu malhonnête que le benchmark ne montre que le raisonnement max. »

Le piège est d'autant plus important que le mode max qui porte ces scores phares est celui qui est encore restreint par les tests de sécurité au lancement. Ce que vous pouvez réellement appeler aujourd'hui est xhigh, qui a obtenu 61 sur l'Intelligence Index. Ce n'est pas un écart énorme par rapport à 62, mais c'est le chiffre honnête pour ce qui est disponible maintenant.
Le second astérisque est la verbosité. Artificial Analysis a mesuré que 1.3 a émis 120M de tokens de sortie pour compléter l'Intelligence Index complet (la médiane pour le secteur est de 72M), et les tests de la communauté ont estimé qu'il utilisait environ 3 fois plus de tokens que la version 1.2. Comme vous payez par token de sortie, un modèle qui « réfléchit à haute voix » trois fois plus n'est pas automatiquement moins cher simplement parce que son prix par token est bas. Il vaut la peine de simuler cela sur votre propre charge de travail avant de vous fier au prix affiché.
Tarification : la division données contre réduction
C'est là que le lancement est devenu intéressant, et c'est un mouvement typique de Meta. Il existe deux points de terminaison pour le même modèle, et la différence de prix repose entièrement sur vos données.
| Point de terminaison | Entrée / 1M | Sortie / 1M | Vos données |
|---|---|---|---|
| Standard (xhigh) | 1,25 $ | 4,25 $ | Gardées privées, non utilisées pour l'entraînement |
| Contributeur | ~0,10 $ | ~0,20 $ | Utilisées pour améliorer les produits de Meta |
Les chiffres standard xhigh sont confirmés sur Artificial Analysis, qui a également enregistré un coût de 0,55 $ par tâche de l'Intelligence Index, 182 tokens/seconde en sortie, et un temps de 38,51s avant le premier token de réponse. Les chiffres du contributeur proviennent d'utilisateurs citant la page des tarifs de Meta dans le fil de lancement, considérez donc les centimes exacts comme hautement probables plutôt que comme une vérité absolue tant que la page de Meta n'est pas plus lisible. Quoi qu'il en soit, l'écart est d'environ 10 à 20 fois.
L'analyse de la communauté sur le pourquoi de cette division était plus incisive que n'importe quel article de presse :
« Ce n'est pas que Meta veut vraiment vos données et qu'ils sont prêts à payer le prix fort pour cela. C'est que les entreprises ne veulent vraiment pas que Meta ait leurs données et qu'elles sont prêtes à payer le prix fort pour cela. »
C'est le compromis résumé en une phrase. Le point de terminaison contributeur est moins cher par million que ChatGPT Luna et même l'ancien DeepSeek V4 Flash, a noté un commentateur, ce qui est une réelle opportunité pour un projet personnel ou un script jetable. Pour tout ce qui touche aux données clients ou au code propriétaire, le surcoût du point de terminaison standard est la raison d'être du service, pas un défaut. Choisissez le point de terminaison qui correspond à la sensibilité de l'entrée, pas seulement celui avec le plus petit chiffre.
Ce que la communauté en pense réellement
Le sentiment au jour du lancement s'est exprimé sur Hacker News (391 points, 261 commentaires), et il était agréablement mitigé plutôt qu'un simple mur de battage médiatique. Les personnes ayant utilisé 1.2 dans un véritable harnais de codage ont apprécié la vitesse et le prix, et étaient curieuses de voir si 1.3 corrigeait ses habitudes :
« J'utilise en partie 1.2 pour faire de l'ingénierie inverse et réimplémenter un vieux binaire de jeu et cela a été plutôt bon et rapide... 1.2 peut se retrouver bloqué à produire des résumés de réflexion aux sonorités similaires sans progrès apparent lorsqu'on lui demande de résoudre des bugs. »
D'autres n'étaient tout simplement pas convaincus par la génération précédente, ce qui est une mise en garde saine contre une lecture des benchmarks comme une expérience vécue :
« J'ai utilisé Muse Spark 1.2 et je n'ai pas été impressionné du tout. Rapide et bon marché, mais même GPT 5.6 Terra semblait beaucoup plus capable. »
Un conseil pratique est revenu à plusieurs reprises : Meta a co-entraîné le modèle avec son propre harnais, donc le faire fonctionner dans Muse Code plutôt que dans un agent tiers a tendance à utiliser moins de tokens et de tours de parole. Si vous le testez dans le harnais d'un autre et qu'il semble coûteux, c'est en partie pour cela.
Comment Meta a conçu le comportement de l'agent
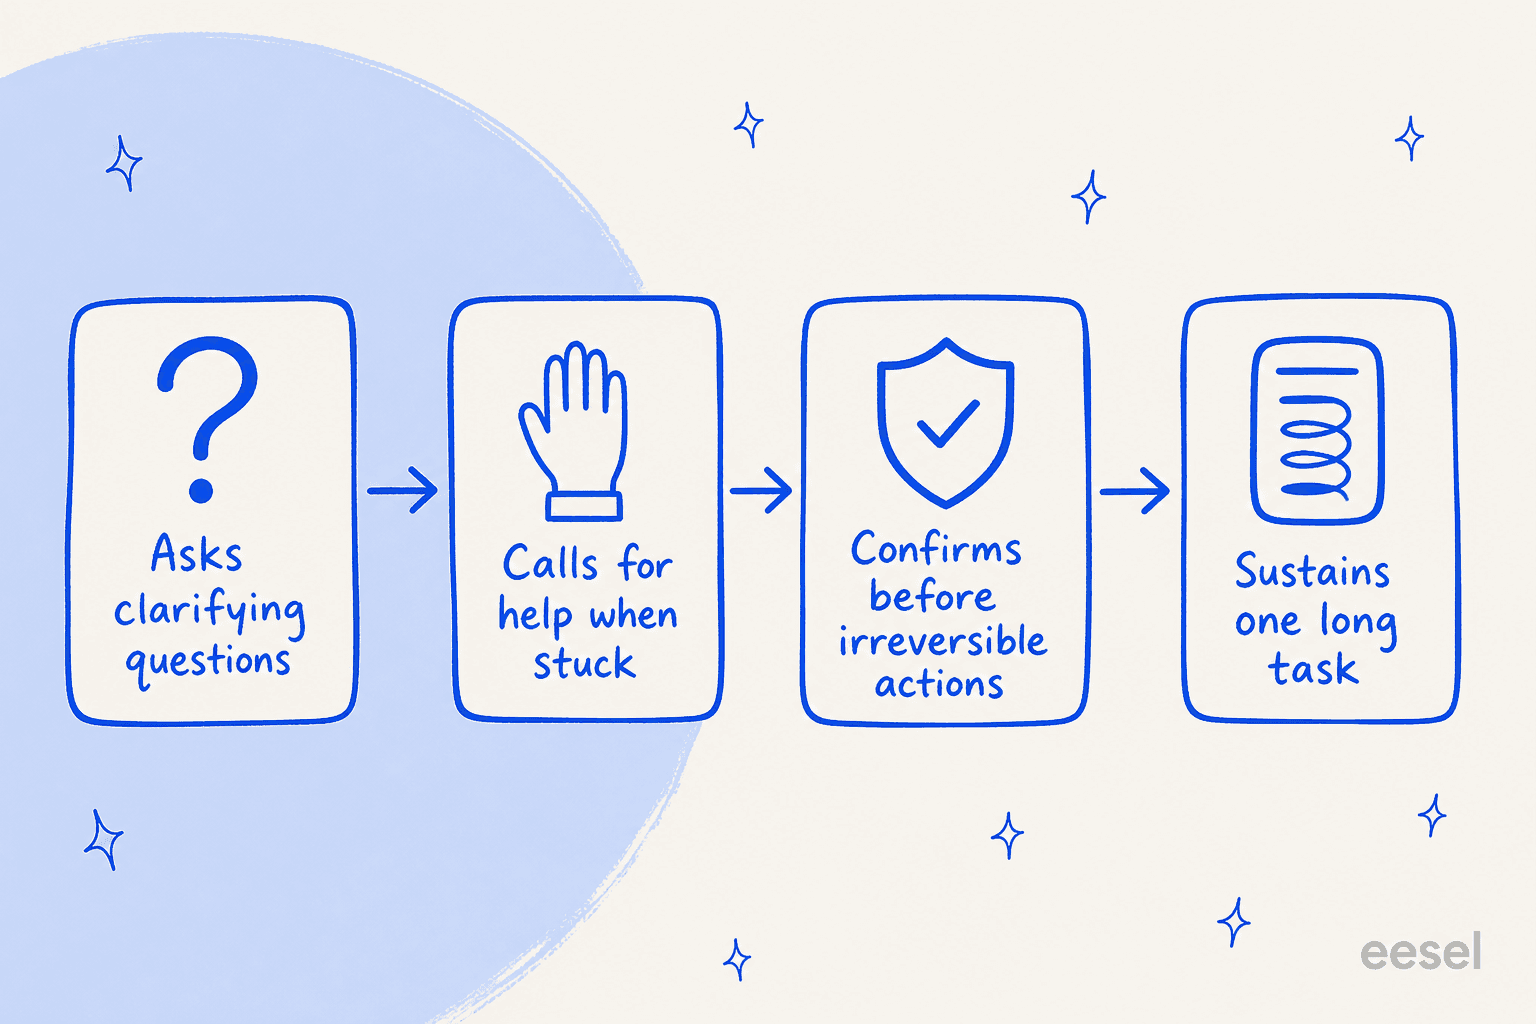
Au-delà des benchmarks, l'affirmation technique la plus intéressante concerne le comportement. Meta affirme que 1.3 a été entraîné pour se comporter moins comme un stagiaire empressé et plus comme un stagiaire prudent : poser des questions de clarification, demander de l'aide lorsqu'il est bloqué, confirmer avant des actions importantes ou irréversibles, et maintenir un seul long fil de discussion complexe sans perdre les exigences initiales.
Meta associe cela à des affirmations sur la sécurité : une plus grande résilience face aux attaques adverses, une meilleure résistance aux injections de prompts (prompt injection) et une meilleure calibration autour des actions irréversibles. Ayant passé plus de trois ans à observer des agents IA fonctionner sur des files d'attente en direct, je considère la « confirmation avant actions irréversibles » comme la ligne la plus importante de toute l'annonce. Un modèle confiant qui fait discrètement la mauvaise chose est pire qu'un modèle hésitant qui vérifie. C'est précisément pourquoi, sur les produits sur lesquels je travaille, nous simulons chaque agent par rapport à des données historiques réelles avant qu'il ne touche un client en direct, plutôt que de se fier à un score de benchmark pour prédire le comportement en production.
Cet instinct est aussi le pont vers la partie que la plupart de ces articles de lancement ignorent : un modèle puissant est une matière brute, pas un travailleur fini.
D'un modèle de pointe à un coéquipier recruté
Voici l'avis honnête d'un constructeur. Muse Spark 1.3 est un excellent moteur. Ce n'est pas, en soi, un employé. Le modèle ne connaît pas votre produit, n'est pas connecté à votre service d'assistance ou à votre CMS, n'a pas été testé contre vos cas particuliers et ne confirmera pas avant d'envoyer un e-mail à un client, à moins que vous ne construisiez tout cela autour de lui. Cet écart entre « modèle de pointe » et « chose qui fait un travail » est précisément la couche que eesel AI est destiné à combler.
La façon dont je le formulerais est la suivante : des modèles comme celui-ci sont l'infrastructure ; eesel AI est le coéquipier que vous recrutez par-dessus. Vous ne choisissez pas le modèle, vous ne configurez pas les intégrations et vous n'écrivez pas le harnais de sécurité. Vous recrutez un coéquipier prêt à l'emploi pour un rôle spécifique, et il arrive déjà doté des compétences, des intégrations et du contexte de l'entreprise pour ce travail.
Essayer eesel
Si vous lisez cet article parce que vous décidez de ce que vous allez construire avec Muse Spark 1.3, c'est le moment idéal pour eesel AI. eesel AI est une plateforme de coéquipiers IA : au lieu d'une API de modèle brut, vous recrutez un coéquipier prêt à travailler pour une tâche définie. Aujourd'hui, cette liste comprend un coéquipier de service d'assistance (helpdesk) IA qui rejoint votre file de support, consulte les commandes, et rédige ou envoie des réponses directement dans votre service d'assistance existant, ainsi qu'un rédacteur de blog IA qui effectue des recherches et rédige des articles de fond comme celui-ci.
Le différenciateur concret est la partie qu'un modèle brut ne peut pas vous donner : le coéquipier du service d'assistance est simulé par rapport à vos propres anciens tickets avant d'être activé, afin que vous puissiez voir comment il aurait géré de réelles conversations au lieu d'espérer qu'un score de benchmark se concrétise. Il se connecte à vos outils en quelques minutes, propose un plan gratuit avec 100 crédits et utilise une tarification transparente : 0,40 $ par session de ticket ou de chat, 4,00 $ par article de blog, avec un essai gratuit de 50 $ (sans minimum mensuel ni frais de plateforme). Ainsi, un modèle verbeux qui réfléchit à haute voix n'est pas un problème de coût pour vous.