

En bref
Le Strands harness est le nouvel agent IA open source d'AWS, lancé le 21 septembre 2026 sous licence Apache 2.0. L'idée est simple : au lieu de monter votre propre boucle d'agent, vous écrivez un import, vous confiez une tâche à l'agent, et il arrive avec des valeurs par défaut éprouvées pour les outils, la mémoire, les sessions et la gestion du contexte. Point crucial, vous apportez votre propre modèle : le même agent fonctionne sur Amazon Bedrock, Anthropic, OpenAI, Google ou un modèle Ollama local.
Le chiffre phare est « 28 % de coût en tokens en moins » par rapport aux harness concurrents exécutant les mêmes modèles, et AWS affirme qu'une exécution de code a coûté 77 % de moins que Claude Code tout en obtenant un meilleur score. Ce sont des chiffres réels et officiels, mais ils reposent sur des benchmarks, donc je les lirais comme des indications plutôt que comme parole d'évangile.
Si vous construisez des agents et voulez un contrôle total sur la boucle, le modèle et le déploiement, c'est une option solide et vraiment gratuite. Si vous voulez un agent IA pour le service client ou pour du contenu, prêt à travailler sans que vous ayez à assembler ni héberger quoi que ce soit, un framework est la mauvaise couche, et quelque chose comme eesel AI se rapproche davantage de ce que vous cherchez vraiment.
Je construis et déploie des agents IA qui travaillent sur de vraies files de clients, et j'ai passé assez de temps à écrire des boucles d'agent à la main pour savoir exactement quelles parties sont fastidieuses. Alors quand AWS sort, le jour du lancement, un harness préassemblé et agnostique au modèle, je le lis ligne par ligne. Voici ce qu'est réellement le Strands harness, ce qu'il apporte, et l'affirmation que je mettrais à l'épreuve avant de la citer dans un document de planification.
Qu'est-ce que le Strands harness ?
Le Strands harness est décrit par sa propre documentation comme « a state-of-the-art, fully assembled agent harness ». L'idée est d'obtenir un agent optimisé en un seul import plutôt que de l'assembler pièce par pièce. En Python, c'est pip install strands-harness puis create_harness() ; en TypeScript, npm install @strands-agents/harness puis createHarness(). Vous lui donnez une tâche et il s'exécute.
C'est la porte d'entrée « tout inclus » d'une boîte à outils open source d'AWS plus large appelée Strands Agents. Le harness s'appuie sur une brique plus ancienne et de plus bas niveau : le Strands Agents SDK, qu'AWS a publié en open source pour la première fois en mai 2025 et qui tourne déjà dans des systèmes de production d'AWS comme Amazon Q Developer et AWS Glue. Le dépôt harness-sdk montre l'élan : 7,8k étoiles et 1,2k forks au moment de la rédaction, le tout sous Apache 2.0.
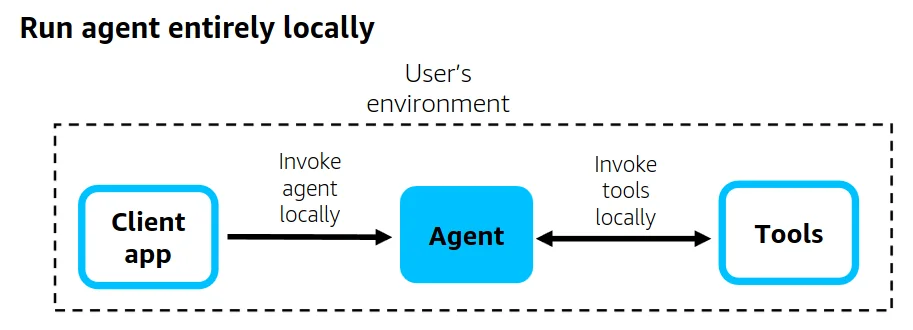
Ce qui compte, c'est ce que le harness n'est pas. Ce n'est pas un produit hébergé, pas un chatbot auquel on se connecte, ni un agent orienté client que l'on place sur son site web. C'est du code que vous installez et exécutez dans votre propre processus, sur votre propre infrastructure. Cette distinction conditionne tout ce qui suit.
D'abord, qu'est-ce qu'un agent harness ?
Si le mot « harness » porte beaucoup de poids et que vous n'êtes pas sûr de ce qu'il signifie, vous n'êtes pas seul. La documentation de Strands donne la phrase la plus claire que j'aie lue : « A language model can answer questions. An agent can do things. The agent loop is what makes that difference possible. »
Un simple grand modèle de langage ne connaît que ce que couvre son entraînement. Dès qu'une tâche demande quelque chose en dehors (lire un fichier, appeler une API, exécuter une commande), le modèle doit atteindre le monde extérieur. La boucle d'agent est la couche d'orchestration qui le permet : invoquer le modèle, vérifier s'il veut utiliser un outil, exécuter l'outil, réinjecter le résultat, et recommencer jusqu'à ce que le modèle ait une réponse finale.
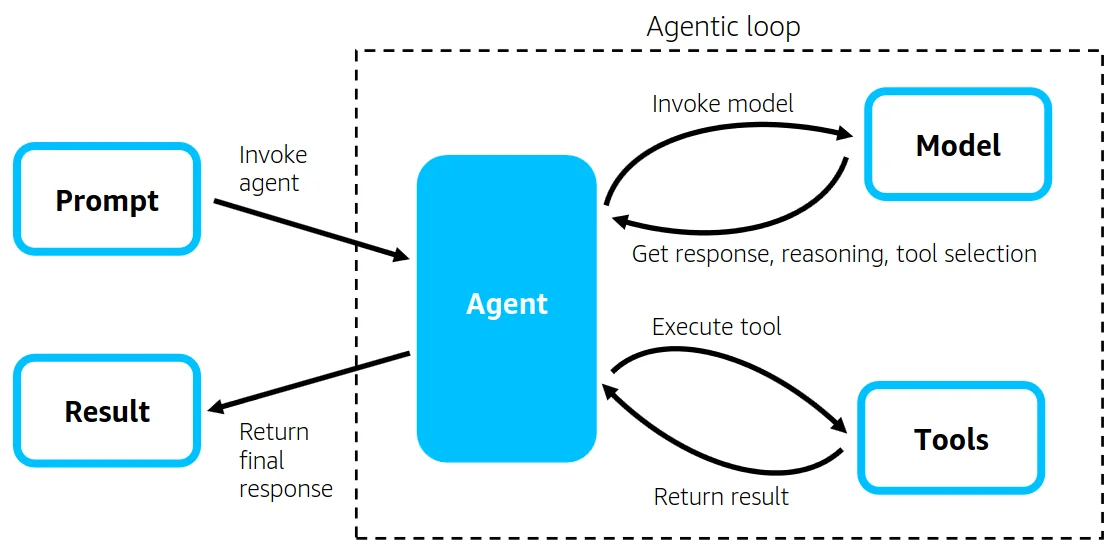
Un « harness » est l'échafaudage autour de cette boucle : le prompt système, l'ensemble des outils, la façon dont le contexte est élagué quand il grossit, la façon dont la mémoire persiste d'une exécution à l'autre et la façon dont les erreurs sont rattrapées. Vous pouvez tout écrire vous-même, et beaucoup le font. La raison d'être d'un produit comme le Strands harness est que les parties ennuyeuses et porteuses de cet échafaudage sont les mêmes pour presque tout le monde, et qu'il est délicat de bien les réaliser.
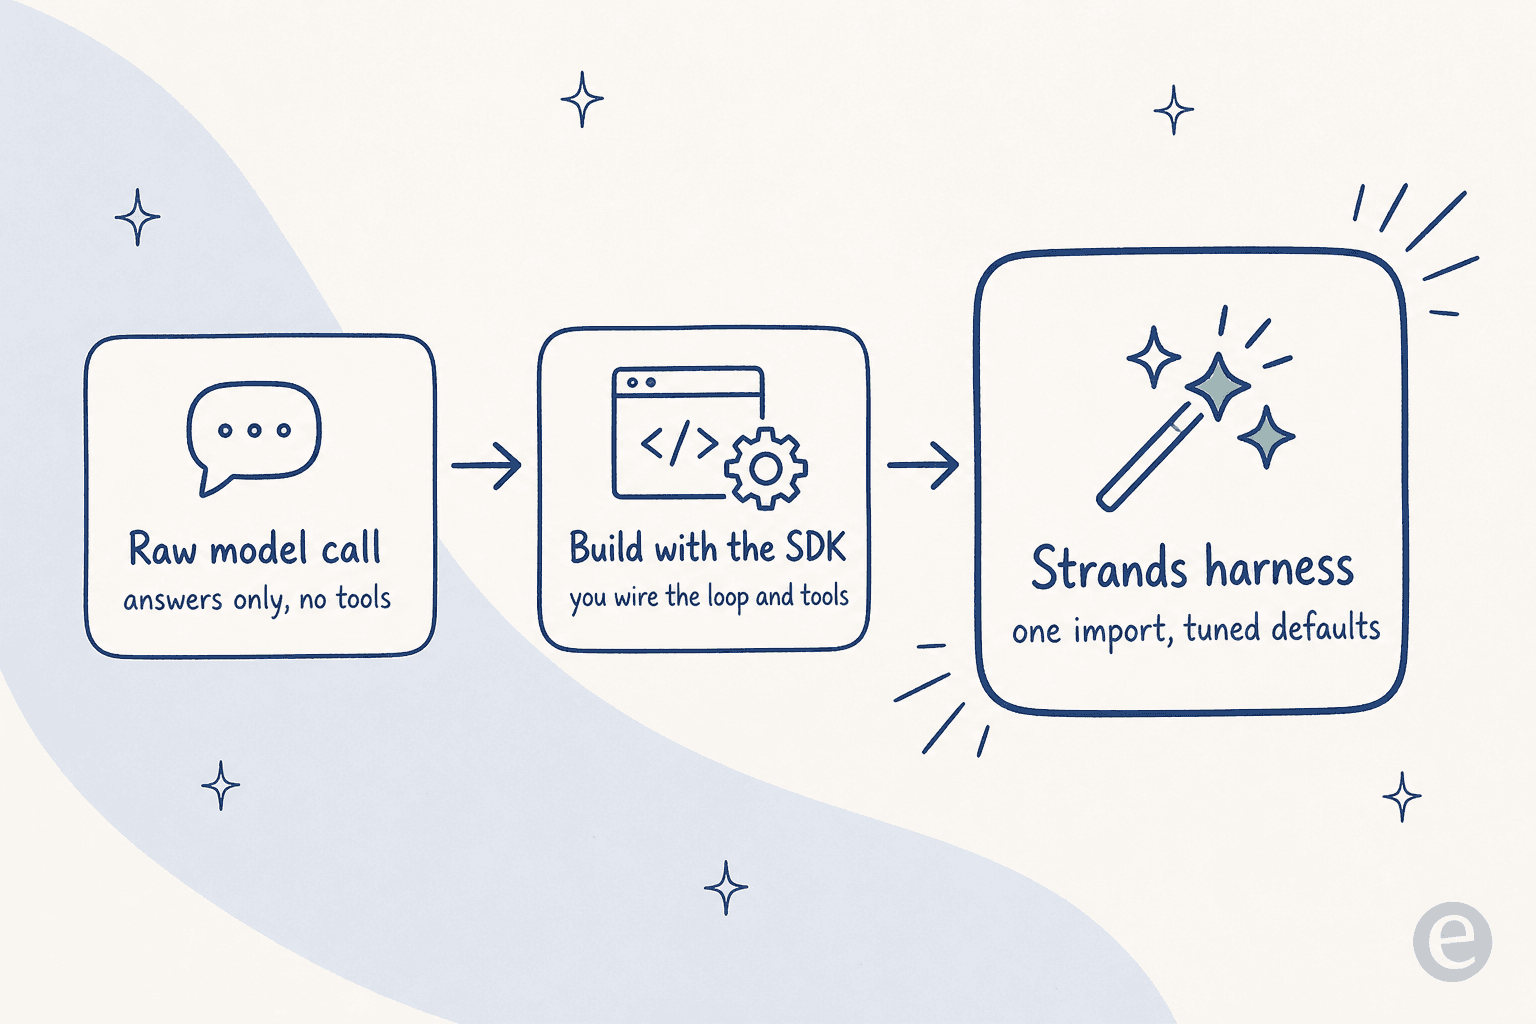
Voilà le spectre. Un appel direct au modèle répond mais ne peut pas agir. Construire avec un SDK (celui de Strands, ou quelque chose comme l'OpenAI Agents SDK ou le Claude Agent SDK) vous donne un contrôle total mais vous laisse câbler chaque pièce. Le harness est le juste milieu : vous partez de valeurs par défaut réglées et ne remplacez que ce dont votre cas d'usage a réellement besoin.
Ce que vous obtenez d'emblée
Lancez create_harness() sans argument et vous obtenez un agent pleinement fonctionnel. Ce qui rend les valeurs par défaut intéressantes, c'est qu'AWS affirme que chacune est remplaçable, et que ce que vous récupérez est un Agent Strands standard sans enveloppe cachée. Voici ce qui est fourni par défaut :
| Par défaut | Ce que ça fait |
|---|---|
| Modèle de votre choix | Fonctionne sur Bedrock (par défaut), Anthropic, OpenAI, Google ou Ollama, avec raisonnement activé |
| Prompt système réglé | Suit une philosophie « explorer d'abord, agir ensuite, confirmer avant tout ce qui est irréversible, vérifier avant de terminer » |
| Outils shell et fichiers | read, write et edit intégrés, plus exécution de commandes |
| Accès web | Un outil pour récupérer du contenu sur le web |
| Gestion du contexte | Met de côté les résultats d'outils volumineux à mesure qu'une tâche grossit et met en cache les parties réutilisées de la requête pour économiser |
| Mémoire à long terme | Conserve la mémoire d'une exécution à l'autre |
| Sessions | Reprend une conversation antérieure à partir d'un identifiant de session |
| Délégation à des sous-agents | Confie les sous-tâches ouvertes à un agent assistant intégré |
| Suivi des tâches | Tient une liste de contrôle pour le travail en plusieurs étapes |
La philosophie du prompt système est la partie que je ne survolerais pas. « Confirmer avant tout ce qui est irréversible, vérifier avant de terminer » est exactement la discipline qui sépare un agent auquel on peut faire confiance sur du vrai travail d'un agent qui fait faux avec aplomb. C'est la même leçon que j'ai apprise à la dure en faisant tourner de l'IA sur de vraies files de support : le mode d'échec n'est jamais « le bot n'a rien fait », c'est « le bot a fait quelque chose de faux, vite ». Intégrer cette prudence au prompt par défaut est un bon choix.
Apportez votre propre modèle
La fonctionnalité qui a retenu l'attention, c'est la portabilité du modèle. La documentation le dit sans détour : « the model is one object you hand to the agent; the rest of your code stays the same. » Remplacez global.anthropic.claude-sonnet-5 par un modèle d'OpenAI ou de Google et rien d'autre ne change.
C'est plus important qu'il n'y paraît, et la réaction de la communauté sur le fil de lancement de Hacker News a défendu l'argument mieux que le marketing :
"This is the very reason why I avoid to use native harness. They are optimized for the economic benefit of the provider, not for mine."

C'est le vrai argument en faveur d'un harness agnostique au modèle. Un agent de code lié à un laboratoire a intérêt à brûler plus de tokens de ce laboratoire. Un harness ouvert que vous possédez, non. C'est la même raison pour laquelle les équipes s'inquiètent de l'enfermement quand elles comparent Cursor et Windsurf ou évaluent des alternatives à Codex : le modèle que vous aimez ce trimestre n'est peut-être pas celui que vous aimerez le prochain, et vous voulez changer sans tout réécrire.
L'affirmation « 28 % moins cher », examinée
Venons-en au chiffre que tout le monde a répété. Le billet de lancement officiel s'ouvre sur « frontier performance with 28% lower token cost », mesuré comme une moyenne sur six benchmarks face à d'autres harness exécutant les mêmes modèles. AWS indique aussi que sur Terminal-Bench 2.1, avec Fable 5 d'Anthropic, le harness a coûté 77 % de moins que Claude Code et obtenu un meilleur score. Le mécanisme annoncé est sans éclat et crédible : tronquer les résultats d'outils au-delà d'un seuil, compacter le contexte quand il devient trop plein et mettre en cache les parties réutilisées de chaque requête.
C'est ici que je ralentirais. Le même fil HN qui saluait la conception agnostique au modèle a aussi pointé une faille dans la présentation du benchmark :
"Terminal Bench 2.1 is saturated. Many token saving techniques would save money and score basically the same running Fable 5 against Terminal Bench 2.1... This is at least the fourth time I've seen a project hit front page with a 'save money with same score on saturated benchmark' claim."
La critique est juste. Un unique benchmark saturé est un appui fragile pour une affirmation de coût. Mais le point de fond, à savoir que le harness, et pas seulement le modèle, détermine votre facture, est réel, et un autre commentateur l'a étayé avec une donnée concrète :
"Fable 5 on Claude Code scored 61.8% at a cost of $248.05 while Fable 5 on OpenCode beat it at 66.3% at $73.42. The same model, the same benchmark; only the harness is different with a ~5 point difference in accuracy while costing significantly less."
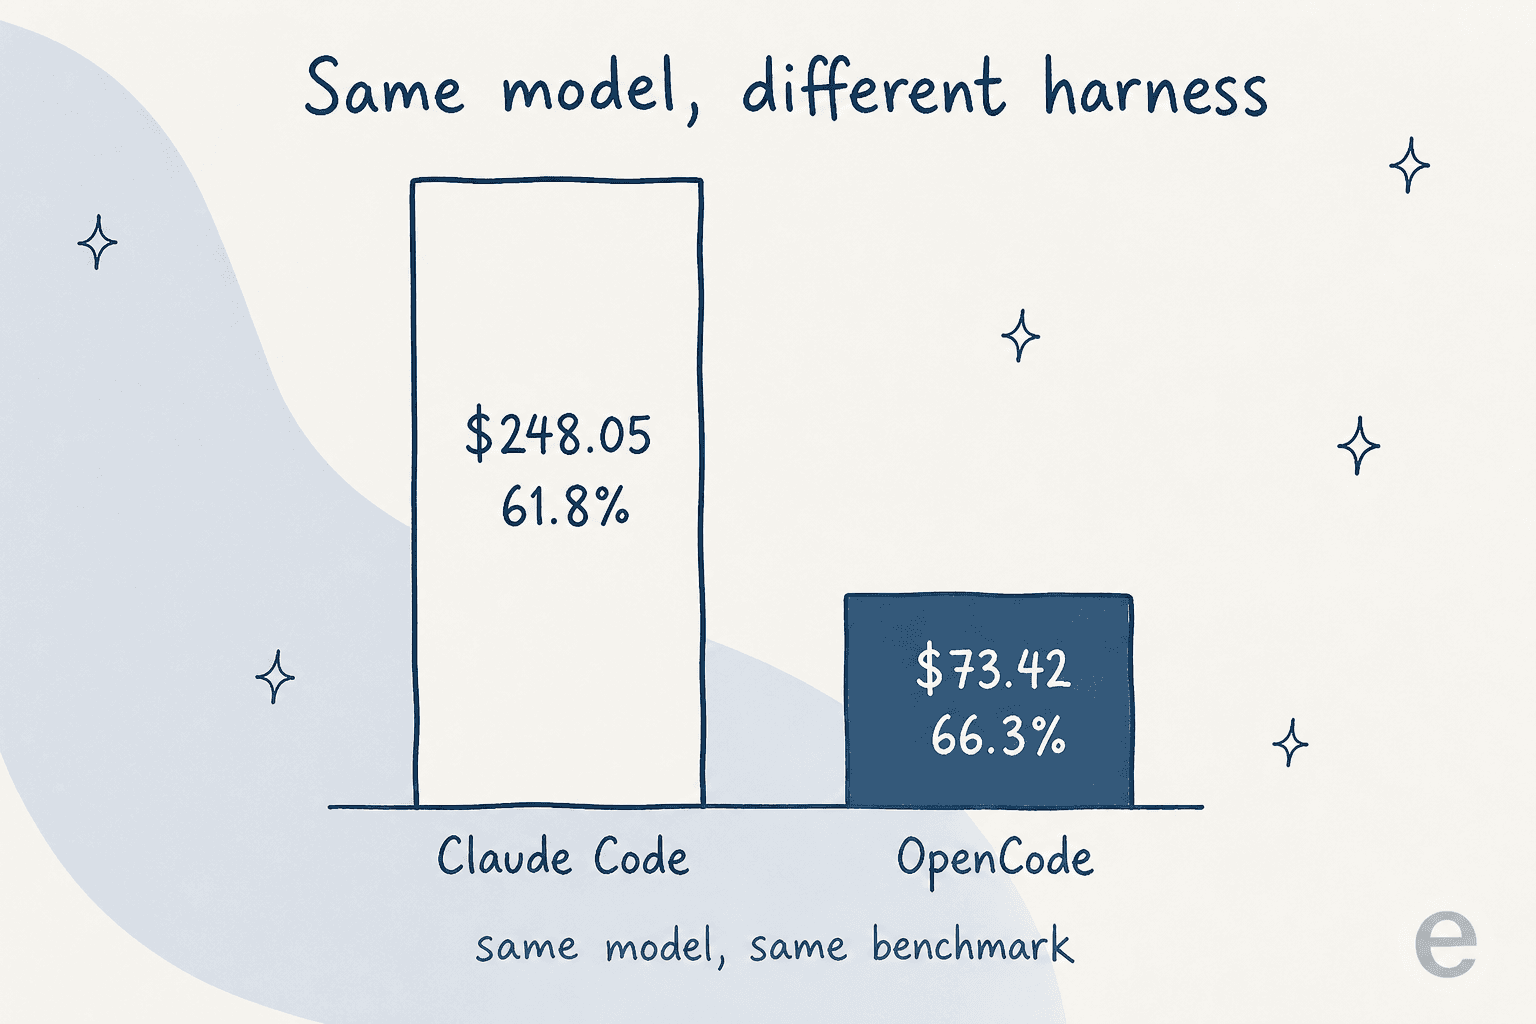
Même modèle, même benchmark, l'un coûte un tiers et est un peu plus précis. C'est toute la thèse de l'intérêt d'un harness. Ma conclusion : le titre « 28 % moins cher » va dans le bon sens et le mécanisme est solide, mais je le testerais sur mes propres tâches avant de mettre le chiffre dans un budget. Les économies en benchmark et les économies en production ne sont pas la même monnaie.
Le reste de la boîte à outils Strands
Le harness est l'une des nombreuses surfaces publiées par AWS, et quelques-unes valent la peine d'être connues si vous creusez :
- Le Strands Harness SDK est le niveau inférieur : vous possédez la boucle, transformez n'importe quelle fonction en outil avec un décorateur
@toolet connectez des serveurs MCP quand vous avez besoin d'outils externes. - Strands Shell est un shell compatible Bourne qui s'exécute dans votre propre processus, donnant à un agent grep, sed, jq et curl « without fork, exec, or a raw syscall », ce qui vous permet de déclarer précisément quels répertoires et identifiants il peut toucher.
- Strands Evals est un SDK exclusivement Python avec plus de 25 évaluateurs intégrés pour noter un agent, diagnostiquer l'étape défaillante et simuler des conversations multi-tours avant la mise en production.
- Strands Labs est la branche expérimentale, et son projet de robotique place plus de 70 robots derrière une seule interface pour un contrôle en langage naturel, un cas d'usage vraiment différent de celui des agents de code.
Il existe aussi une CLI strands (@strands-agents/cli) pour prototyper un agent depuis le terminal, le tout dans un monorepo harness-sdk après la restructuration de l'organisation autour du lancement.
Où le harness s'intègre, et où il ne s'intègre pas
Je veux être juste, car le harness est bon dans ce pour quoi il est fait. Si vous êtes développeur et construisez un agent sur mesure (un agent de recherche, une automatisation interne, un assistant de code) et voulez maîtriser la boucle, éviter l'enfermement chez un modèle et déployer sur votre propre infrastructure, le Strands harness est l'une des options les plus propres que j'aie vues. Il fonctionne partout où tourne un conteneur Linux, de votre portable à ECS.
Mais « vous déployez sur votre propre infrastructure » est aussi le revers de la médaille, et la remarque la plus tranchante de tout le fil de lancement l'a nommé :
"I'm more and more hesitant to use third party harnesses. It's so easy to take opencode or pi and build my own for exactly what I want that I'm seeing projects like this to be noisy and less valuable over time."
Le harness vous épargne le câblage, mais pas la responsabilité. C'est toujours à vous de choisir le modèle, de connecter les outils, d'héberger le conteneur, de surveiller la facture et d'entretenir le tout à mesure que les modèles et les API évoluent. Pour un développeur, c'est le métier et le plaisir. Pour un responsable du support ou des opérations qui veut simplement des tickets résolus ou des articles de blog rédigés, c'est un projet d'ingénierie complet entre lui et le résultat.
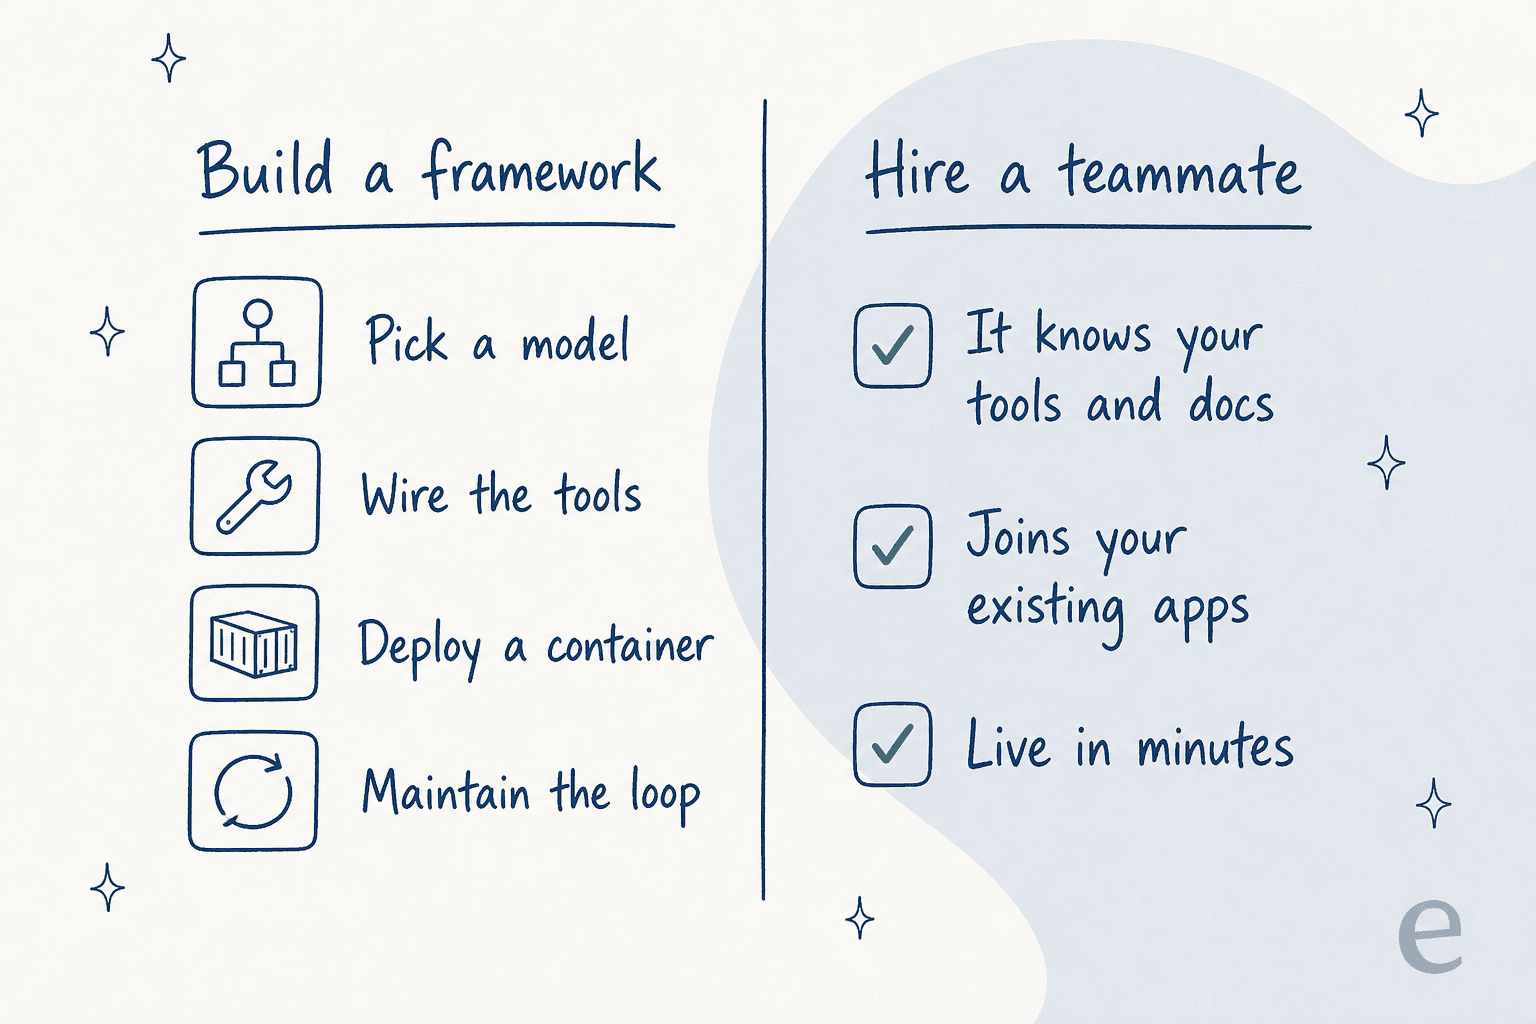
Cette séparation entre construire et embaucher est la façon honnête de décider. Si l'objectif est qu'un travail précis soit fait plutôt qu'un système construit, vous voulez le teammate, pas la boîte à outils.
Essayer eesel
La façon claire d'y penser : le Strands harness est l'infrastructure, et eesel est l'employé. AWS donne aux développeurs la boucle, les outils et le câblage de modèles pour assembler un agent. eesel AI est une plateforme de teammates IA où vous embauchez des teammates prêts à travailler pour des tâches précises, chacun arrivant avec les compétences, les intégrations et le contexte d'entreprise de son rôle. L'équipe actuelle comprend un teammate IA pour le helpdesk qui rejoint votre file de support existante et un rédacteur de blog IA qui fait des recherches et rédige des articles longs. Pas de boucle à câbler, pas de conteneur à exécuter : le teammate helpdesk s'entraîne sur vos anciens tickets et votre centre d'aide, et vous pouvez le simuler sur des tickets historiques avant qu'il ne réponde à un seul client.

Si le harness a attiré votre attention justement parce que vous aimez vivre dans un terminal, eesel a aussi une interface pour cela. La CLI eesel met le même teammate dans votre terminal : npx @eesel/cli init configure un agent, connecte un helpdesk, importe des connaissances et câble des automatisations sans ouvrir le tableau de bord. Ce n'est volontairement pas un produit séparé, donc tout ce que vous configurez dans la CLI apparaît dans le tableau de bord et inversement. Et comme chaque commande affiche du JSON, un agent de code comme Claude Code, Cursor ou Codex peut piloter toute la configuration d'un espace de travail pour vous, puis vous rendre le teammate en marche. C'est la même ergonomie agentique et scriptable qui rend le Strands harness séduisant, tournée vers un travail déjà fait pour vous.
Côté coût, eesel propose un prix mensuel fixe à partir de 299 $/mois pour 500 crédits (1 crédit par ticket ou chat) sans frais par utilisateur, de sorte que le prix suit le volume plutôt que le nombre de sièges occupés. Vous pouvez démarrer gratuitement avec 100 crédits, et la CLI peut même créer un espace de travail anonyme sans compte pour tester. Si votre véritable objectif est des tickets résolus ou des articles publiés plutôt qu'un framework à maintenir, c'est le chemin le plus court.
Questions fréquentes
Qu'est-ce que le Strands harness ?
Le Strands harness est un agent IA open source, entièrement assemblé, proposé par AWS, publié le 21 septembre 2026 sous licence Apache 2.0. Un seul import vous donne un agent avec des valeurs par défaut éprouvées pour les outils, la mémoire, les sessions et la gestion du contexte, et vous pouvez le brancher sur Bedrock, Anthropic, OpenAI, Google ou un modèle Ollama local. Il repose sur le SDK de plus bas niveau Strands Harness.
Le Strands harness est-il gratuit ?
Le harness lui-même est gratuit et open source (Apache 2.0). Vous payez toujours le fournisseur de modèle auquel vous le connectez, ainsi que le coût d'exécution du conteneur qui l'héberge. Si vous préférez un agent IA géré plutôt qu'un agent que vous hébergez vous-même, une option comme eesel AI propose un prix mensuel fixe à partir de 299 $/mois (500 crédits, 1 crédit par ticket) sans frais par utilisateur.
En quoi le Strands harness diffère-t-il de Claude Code ?
Claude Code est l'agent de code d'Anthropic, réglé pour les modèles d'Anthropic. Le Strands harness est agnostique au modèle : le même harness fonctionne avec n'importe quel grand fournisseur, vous n'êtes donc pas enfermé chez un seul laboratoire. Selon les benchmarks d'AWS, le harness a exécuté une tâche de code pour un coût inférieur de 77 % à Claude Code tout en obtenant un meilleur score, mais sur un seul benchmark.
Que signifie vraiment « 28 % de coût en tokens en moins » ?
C'est la moyenne sur six benchmarks, comparant le Strands harness à d'autres harness exécutant les mêmes modèles avec une précision comparable. Les économies viennent de la troncature des résultats d'outils volumineux, de la compaction du contexte lorsqu'il se remplit et de la mise en cache des parties réutilisées de chaque requête. C'est un chiffre officiel de Strands, mais c'est une affirmation issue de benchmarks, à considérer comme une indication.
Faut-il être développeur pour utiliser le Strands harness ?
Oui. Il est livré sous forme de paquets Python et TypeScript plus une CLI, et c'est à vous de l'installer, de le configurer et de le déployer. Si vous voulez un agent IA pour le service client ou pour le travail quotidien de l'entreprise sans écrire ni héberger de code, un teammate prêt à l'emploi convient mieux qu'un framework.