

En résumé
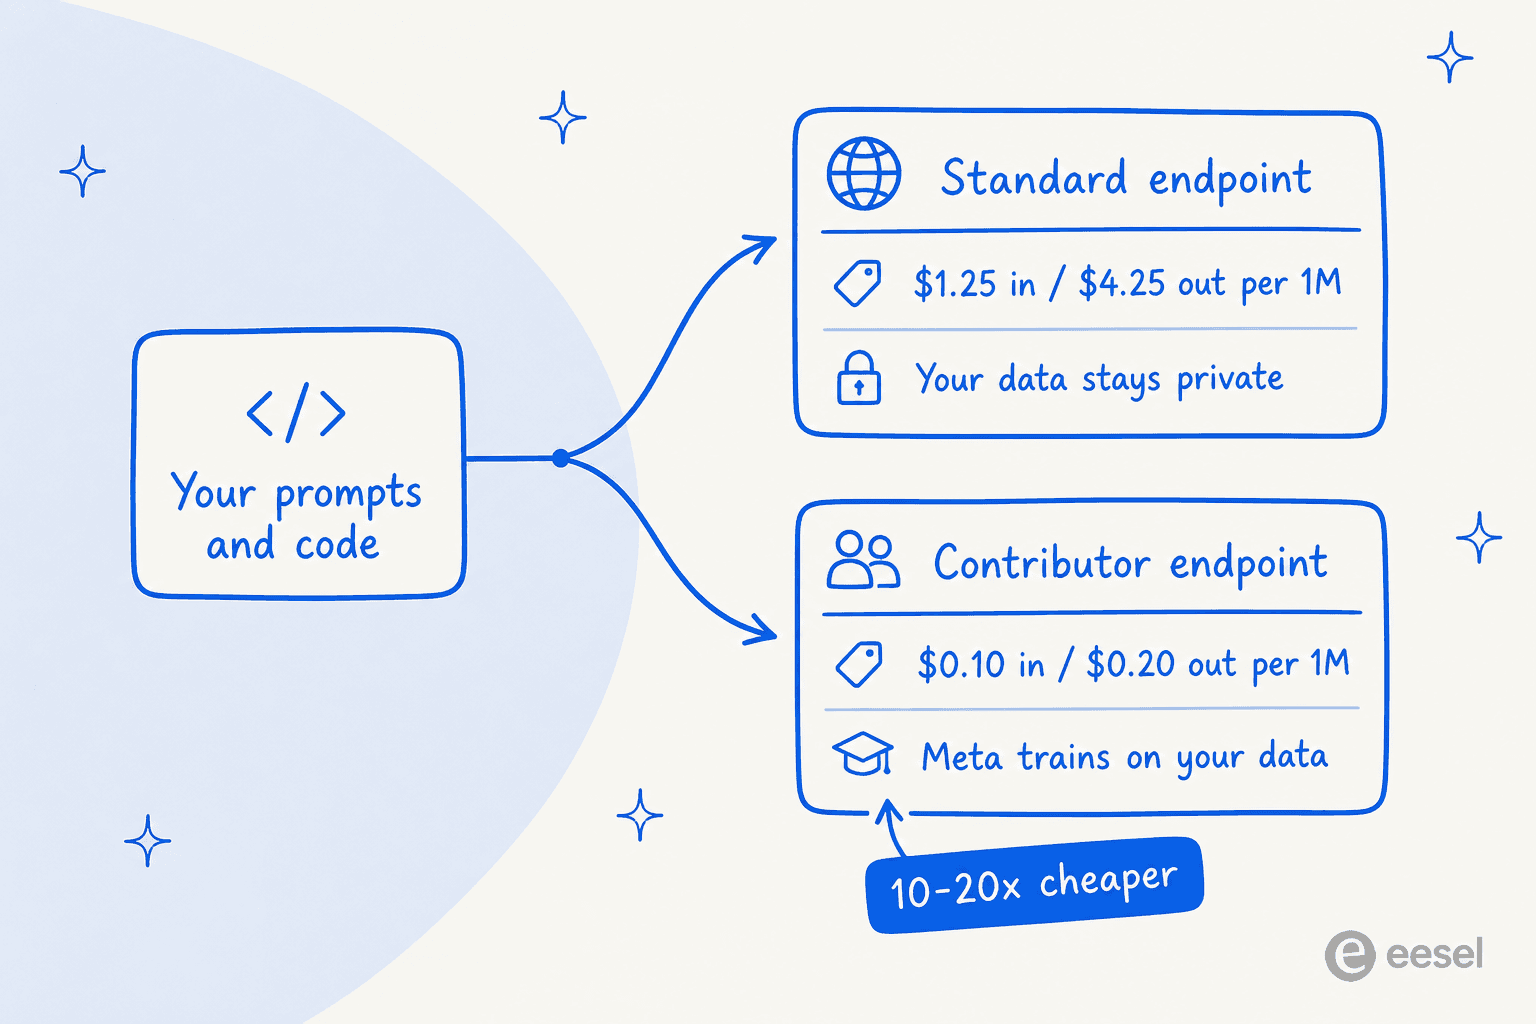
Le modèle Muse Spark 1.3 de Meta propose deux tarifs pour le même modèle, et l'écart entre eux repose entièrement sur vos données. Le point de terminaison standard coûte 1,25 $ par million de jetons d'entrée et 4,25 $ par million de jetons de sortie sur le niveau xhigh, avec votre trafic gardé privé. Le point de terminaison contributeur coûte environ 0,10 $ / 0,20 $ par million, soit 10 à 20 fois moins cher, en échange du fait que Meta s'entraîne sur ce que vous envoyez.
Le prix affiché n'est que la moitié de l'histoire. Muse Spark 1.3 est exceptionnellement verbeux, de sorte qu'un faible tarif par jeton peut tout de même engendrer une facture élevée par tâche. Artificial Analysis estime que le point de terminaison standard revient à environ 0,78 $ par million de jetons et environ 1,37 $ pour terminer une tâche de l'indice d'intelligence (Intelligence Index). Il existe également une remise sur le cache de 88 % qu'il est utile de connaître.
J'ai passé deux ans à observer des équipes choisir un modèle sur son prix d'entrée pour ensuite être surprises par la ligne de sortie sur la facture. Voici donc l'avis honnête d'un constructeur : une API de modèle brut est un centre de coûts que vous devez gérer jeton par jeton. Si ce que vous voulez réellement est un agent de support ou un rédacteur de blog qui fait son travail pour un prix prévisible, c'est là qu'intervient un coéquipier IA comme eesel, qui facture par résolution au lieu de facturer par jeton.
Ce que vous payez réellement
La première chose à comprendre est que la « tarification de Muse Spark 1.3 » n'est pas un chiffre unique. Meta propose le même modèle via deux points de terminaison sur l'API Meta Model API, et leurs prix sont très différents.
| Point de terminaison | Entrée / 1M | Sortie / 1M | Vos données | Idéal pour |
|---|---|---|---|---|
| eesel AI | 0,40 $ par session | 4,00 $ par article | Privé (Essai de 50 $ gratuit) | Support client, rédaction de contenu |
| Standard (xhigh) | 1,25 $ | 4,25 $ | Gardées privées, pas d'entraînement | Production, données clients, code propriétaire |
| Contributeur | ~0,10 $ | ~0,20 $ | Utilisées pour améliorer Meta | Projets personnels, scripts jetables, tâches par lots non sensibles |
Les tarifs standard xhigh sont confirmés par Artificial Analysis. Ils sont restés stables par rapport à Muse Spark 1.2 au lieu d'augmenter avec la nouvelle version, ce qui est une bonne nouvelle. Les chiffres du mode contributeur proviennent d'utilisateurs citant la propre page de tarification de Meta lors du lancement. Considérez les centimes exacts comme hautement probables plutôt que comme une vérité absolue tant que cette page n'est pas plus lisible. Quoi qu'il en soit, l'écart est d'environ 10 à 20 fois, et c'est la décision de tarification la plus importante que vous prendrez avec ce modèle.
L'analyse de la communauté sur la raison de cette séparation est plus tranchante que n'importe quel article de presse :
« Ce n'est pas que Meta veut vraiment vos données et qu'ils sont prêts à payer le prix fort pour les avoir. C'est que les entreprises ne veulent vraiment pas que Meta ait leurs données et qu'elles sont prêtes à payer le prix fort pour cela. » IshKebab, Hacker News
C'est le compromis résumé en une phrase. Le surcoût du point de terminaison standard n'est pas une taxe, c'est le produit lui-même. Choisissez le point de terminaison qui correspond à la sensibilité de vos données, et non celui qui affiche le plus petit chiffre.
Estimez votre facture mensuelle
Les prix affichés restent abstraits tant que vous n'y intégrez pas votre propre volume. Voici donc un calculateur. Entrez environ combien de millions de jetons vous utilisez chaque mois, choisissez un point de terminaison, et il fera le calcul pour l'entrée ainsi que pour la sortie, réputée très lourde.
Jouez spécifiquement avec le champ de sortie. Comme Muse Spark 1.3 s'appuie lourdement sur les jetons de sortie, et que la sortie coûte 3,4 fois le prix de l'entrée, cette case fait varier votre facture beaucoup plus que la case d'entrée. Ce qui nous amène à ce que le prix affiché cache.
La taxe sur la verbosité
Voici le piège qui n'apparaît sur aucune page de tarification. Muse Spark 1.3 « réfléchit » beaucoup à voix haute. Artificial Analysis a mesuré qu'il émettait 140 millions de jetons de sortie pour compléter l'indice d'intelligence complet, contre une médiane du secteur d'environ 90 millions. Les tests de la communauté au lancement l'ont même évalué à environ 3 fois l'utilisation de jetons de la version 1.2.
Vous payez par jeton de sortie. Ainsi, un modèle avec un tarif de sortie bas mais qui génère une montagne de jetons n'est pas forcément l'option la moins chère. Exécutez le même travail sur un modèle plus concis à un tarif plus élevé, et le modèle concis peut l'emporter sur la facture. C'est exactement le piège que j'ai mentionné dans le résumé, et c'est pourquoi le coût par tâche compte plus que le tarif par jeton. Artificial Analysis situe le point de terminaison standard à environ 1,37 $ pour terminer une tâche de l'indice d'intelligence une fois la verbosité prise en compte, avec une vitesse de sortie proche de 198 jetons/seconde et un temps pour le premier jeton d'environ 29 secondes.
Deux leviers permettent de faire redescendre le coût réel :
- La remise sur le cache de 88 %. Les jetons d'entrée répétés (un long prompt système, une base de connaissances que vous envoyez à chaque appel) sont facturés à une fraction du tarif d'entrée. Pour les charges de travail répétitives ou basées sur des agents qui renvoient le même contexte, il s'agit d'une économie réelle et importante.
- Le cadre de travail de Meta. Meta a co-entraîné le modèle avec Muse Code. Par conséquent, l'exécuter dans Muse Code a tendance à utiliser moins de jetons et de tours de conversation qu'un agent tiers. Si vous le testez ailleurs et qu'il semble coûteux, une partie de la raison réside dans le cadre utilisé.
Ce qu'il faut retenir pour le budget : ne fixez pas le prix de ce modèle uniquement en fonction du tarif d'entrée. Estimez honnêtement votre volume de sortie, appliquez la remise sur le cache là où votre charge de travail répète le contexte, et simulez sur une portion réelle de votre propre trafic avant de vous engager.
Le niveau max que vous ne pouvez pas encore acheter
Il existe un astérisque de tarification facile à manquer. Meta a publié ses scores de référence phares sur le niveau de raisonnement max, mais le niveau max est restreint en attendant des tests de sécurité supplémentaires au lancement. Le niveau que vous pouvez réellement appeler et payer aujourd'hui est le xhigh. Il n'y a pas encore de prix standard public pour le niveau max.
Cela compte pour deux raisons. Premièrement, si vous établissez votre budget en fonction des scores de lancement, vous vous basez sur un niveau que vous ne pouvez pas acheter. Deuxièmement, quand le niveau max sera ouvert, attendez-vous à ce qu'il coûte plus cher et qu'il soit encore plus verbeux que le xhigh, puisque plus de raisonnement signifie plus de jetons de sortie à 4,25 $ le million. Le détail complet des tests de référence explique dans quelle mesure le bond entre la 1.2 et la 1.3 est en réalité un écart entre max et xhigh plutôt qu'un pur saut générationnel. C'est une lecture utile avant de supposer que les chiffres du niveau supérieur s'appliquent à ce que vous payez.
Comparaison des prix avec le secteur
Si l'on s'en tient uniquement au prix affiché, le point de terminaison standard de Muse Spark 1.3 se situe dans la tranche abordable des modèles de pointe. Voici approximativement où il se situe par rapport aux modèles que la plupart des équipes envisagent. Il s'agit des tarifs catalogue entrée/sortie pour un niveau comparable : le coût réel varie toujours selon la verbosité et votre propre utilisation.
| Modèle | Entrée / 1M | Sortie / 1M | Notes |
|---|---|---|---|
| eesel AI | 0,40 $ par session | 4,00 $ par article | Essai gratuit de 50 $ ; pas de frais de plateforme ni de minimum mensuel |
| Muse Spark 1.3 (standard xhigh) | 1,25 $ | 4,25 $ | Très verbeux ; remise cache 88 % ; point de terminaison contributeur ~10-20x moins cher |
| Muse Spark 1.3 (contributeur) | ~0,10 $ | ~0,20 $ | Meta s'entraîne sur vos données |
| Claude Opus 5 | supérieur | supérieur | Bat la 1.3 sur la plupart des évaluations d'agents ; niveau premium |
| GPT-6 Astra | moyen | moyen | Structure de prix différente ; voir son propre détail |
| Gemini 3.8 Flash | bas | bas | A brièvement dominé le même indice le jour de la sortie de la 1.3 |
| DeepSeek V4 Flash | très bas | très bas | Ouvert, licence MIT ; le véritable plancher budgétaire |
| Kimi K3 | moyen | moyen | Un autre concurrent à poids ouverts |
L'analyse honnête : sur le point de terminaison contributeur, la version 1.3 est moins chère par million que la plupart des options de pointe hébergées, et surpasse même certains modèles budgétaires plus anciens, comme l'a noté un commentateur. Sur le point de terminaison standard, elle est proposée à un prix compétitif mais n'est pas le tarif le plus bas, et la verbosité signifie que le coût effectif grimpe plus vite que le prix affiché ne le suggère. Si votre seul critère est le prix par jeton pour un travail non sensible, le point de terminaison contributeur ou un modèle ouvert comme DeepSeek V4 Flash est difficile à battre. Si votre critère est le prix par tâche terminée sur des données réelles, le calcul devient plus intéressant, et c'est là qu'il faut prendre le temps de réfléchir.
Du prix par jeton au prix par résultat
Voici l'avis d'un constructeur, et c'est ce que la plupart des articles sur les prix omettent. Chaque chiffre ci-dessus représente un coût de matières premières, et non le coût pour accomplir un travail. Un prix au jeton vous indique le coût du moteur. Il ne vous dit rien sur la connexion du modèle à votre centre d'assistance (helpdesk), son chargement avec le contexte de votre entreprise, les tests par rapport à vos cas particuliers ou la confirmation avant l'envoi d'un e-mail à un client. Vous construisez et payez tout cela en plus.
Cet écart est l'endroit où eesel intervient. Voici comment je le présenterais : les modèles comme Muse Spark 1.3 sont l'infrastructure, et eesel est le coéquipier que vous embauchez par-dessus. Vous ne choisissez pas un niveau, ne câblez pas les intégrations et ne subissez pas la verbosité sur votre propre facture. Vous embauchez un coéquipier prêt à travailler pour une tâche définie, et il arrive déjà doté des compétences, des intégrations et du contexte d'entreprise nécessaires pour ce rôle.
Le modèle de tarification est la différence concrète. eesel facture par résolution, et non par jeton. Ainsi, un modèle qui réfléchit à voix haute 3 fois plus n'est pas une ligne budgétaire que vous devez prévoir. Le coéquipier IA pour centre d'assistance rejoint votre file d'attente de support, consulte les commandes, et rédige ou envoie des réponses directement dans votre outil existant. Le rédacteur de blog IA effectue des recherches et rédige des articles de fond comme celui-ci. Dans les deux cas, le prix que vous voyez est lié au travail accompli, et non aux jetons consommés. La tarification est de 0,40 $ par session de ticket ou chat, et de 4,00 $ par article de blog, avec un essai gratuit de 50 $ sans frais de plateforme ni minimum mensuel.
Essayez eesel
Si vous lisez un article sur les tarifs de Muse Spark 1.3 parce que vous décidez de ce que vous allez construire, c'est exactement le moment pour lequel eesel a été conçu. Vous obtenez un coéquipier IA prêt à l'emploi au lieu d'une API de modèle brute, de sorte que l'arithmétique par jeton ci-dessus n'est plus votre problème à gérer.
L'élément différenciateur concret est la partie qu'un modèle brut ne peut pas vous donner : le coéquipier pour centre d'assistance est simulé par rapport aux tickets passés avant d'être mis en ligne. Vous voyez ainsi comment il aurait géré des conversations réelles au lieu d'espérer qu'un score de référence se concrétise. Il se connecte à vos outils en quelques minutes, l'essai est gratuit, et parce qu'il facture par résolution plutôt que par jeton, un modèle verbeux qui réfléchit à voix haute n'affecte pas votre budget.
Comment estimer ma facture Muse Spark 1.3 ?