

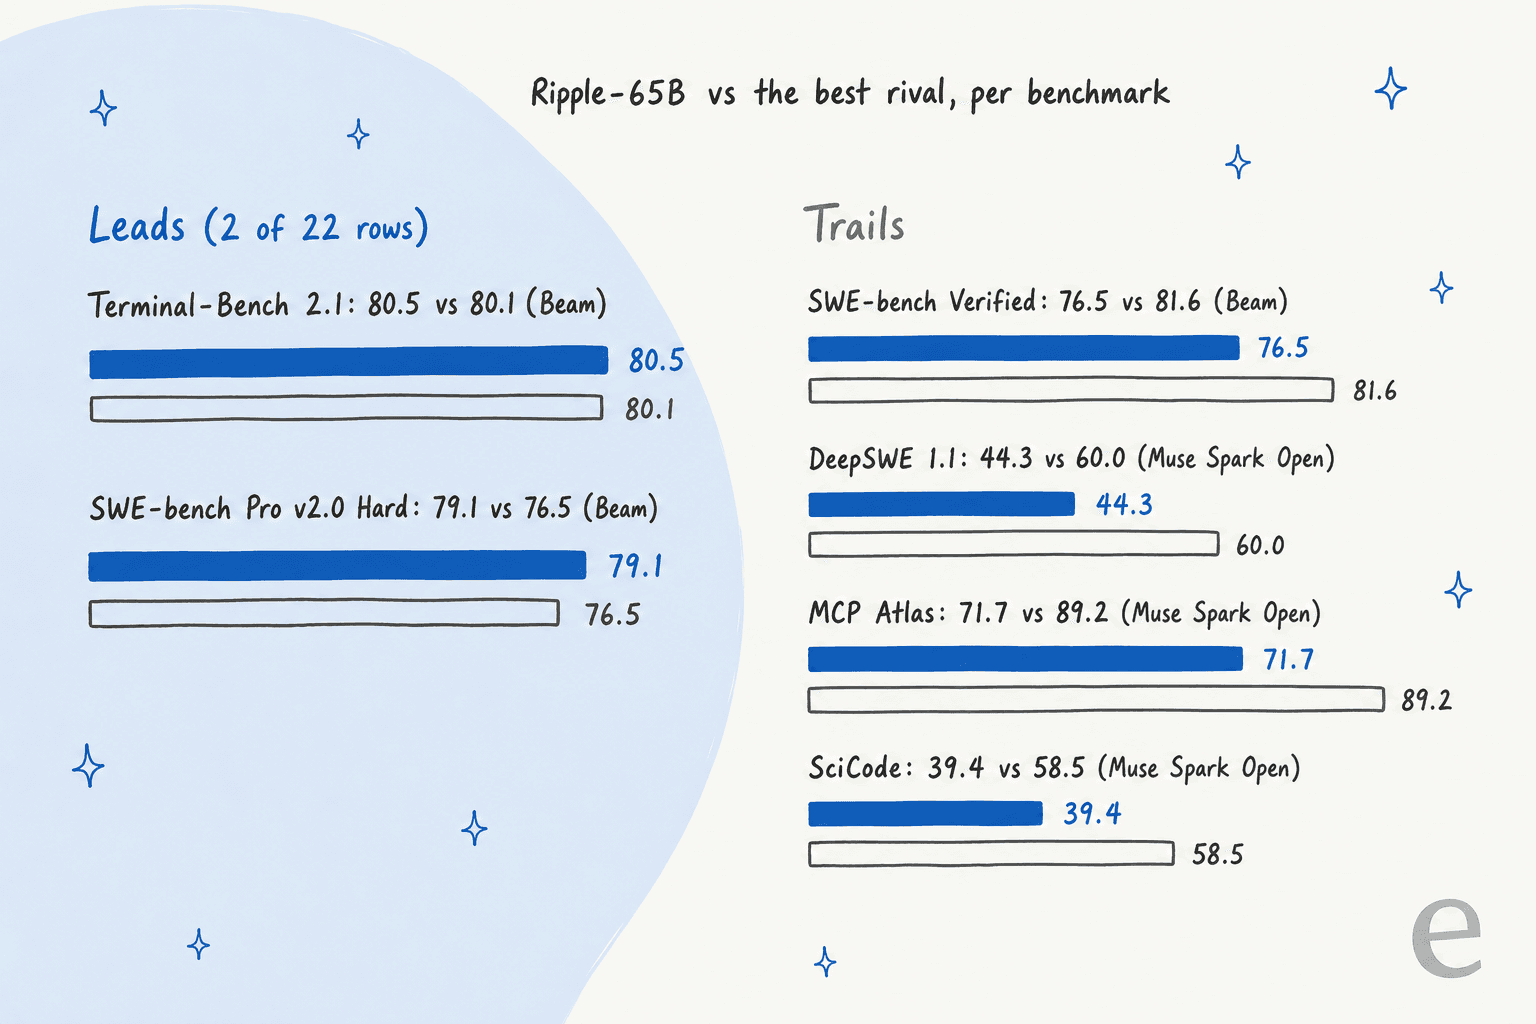
Ripple-65B Preview est un modèle dense de 65B sous Apache 2.0 qui rivalise, en code agentique, avec des modèles à poids ouverts huit à quinze fois plus gros, à $0.20 / $0.60 par million de tokens en version hébergée. Son avance est toutefois mince. Le tableau de Ricursive lui-même le place premier sur 2 benchmarks sur 22, et Terminal-Bench 2.1 est une victoire de 0,4 point sur Reflection Beam. La vraie raison de s'y intéresser, c'est qu'il tient sur un seul DGX Spark. Essayez-le si vous voulez un modèle de code que vous pouvez héberger ; attendez des tests indépendants si vous avez besoin de preuves. Pour les équipes support, le modèle est la partie facile, et eesel est le coéquipier construit par-dessus.
Qu'est-ce que Ripple-65B ?
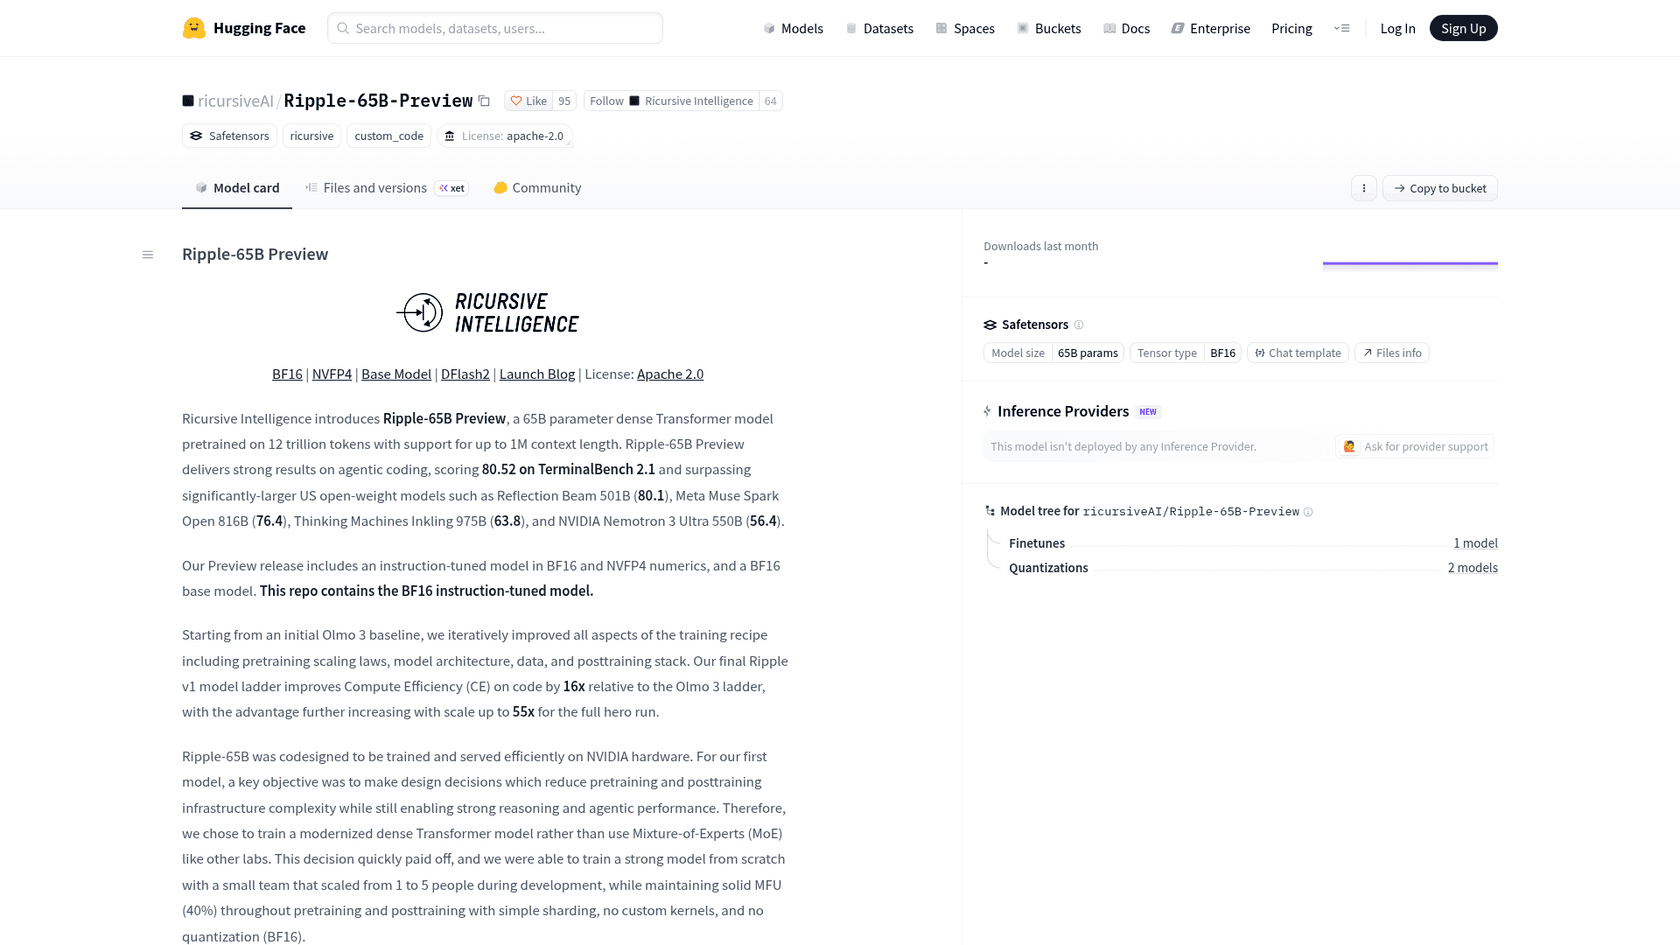
Ripple-65B Preview est le premier modèle public de Ricursive Intelligence, un laboratoire de Palo Alto cofondé par Anna Goldie et Azalia Mirhoseini, qui développe de l'IA pour la conception de puces. Il est sorti le 4 novembre 2026. Ricursive le décrit comme "a general-purpose variant of the proprietary model that powers our AI chip design platform."
La fiche technique, en bref :
- Taille : 64,8B paramètres, tous actifs à chaque token. C'est donc un modèle transformer dense, pas un mélange d'experts.
- Entraînement : préentraîné de zéro sur 12 000 milliards de tokens de texte et de code, surtout en anglais. Ni images ni audio.
- Contexte : jusqu'à 1M de tokens pris en charge, avec 2M de positions autorisées dans la configuration.
- Licence : Apache 2.0 sur tous les checkpoints, l'usage commercial est donc permis.
- Orientation : Ricursive dit que la Preview a reçu un "relatively light posttraining, with a focus on agentic coding."
Il est publié dans quatre dépôts Hugging Face : le modèle BF16 ajusté aux instructions (environ 130 Go), une version NVFP4 étiquetée "Experimental" (environ 57 Go), un modèle de base sans post-entraînement et un modèle brouillon "DFlash2" de 4B qui accélère la génération par décodage spéculatif.
Je développe des intégrations et des fonctions d'API chez eesel, donc quand un modèle comme celui-ci sort, ce que je lis d'abord, ce n'est pas le graphique de lancement. C'est le fichier de configuration, le template de chat et les scripts de service, car c'est là qu'on apprend ce qu'on peut vraiment utiliser lundi. Tout ce qui suit vient de ces fichiers, de la fiche du modèle et des pages des fournisseurs, vérifiés le 5 novembre 2026.
Qu'y a-t-il de nouveau dans Ripple-65B ?
Trois choses le distinguent des autres modèles à poids ouverts américains de cette année.
Il est dense alors que tous les autres sont passés au MoE. Reflection Beam, Meta Muse Spark Open, Inkling et Nemotron 3 Ultra utilisent tous des architectures de mélange d'experts, où seule une partie du modèle tourne par token. Ripple fait tourner les 65B à chaque fois. L'argument de Ricursive, dans la fiche du modèle, est qu'un modèle dense "reduce[s] pretraining and posttraining infrastructure complexity", ce qui a permis à une équipe passée de 1 à 5 personnes de l'entraîner avec "simple sharding, no custom kernels, and no quantization." La forme est aussi inhabituelle : fine et profonde, avec une couche cachée étroite de 5 120 de large empilée sur 80 couches, et quatre couches d'attention à fenêtre courte pour chaque couche complète.
Il prétend avoir coûté peu à fabriquer. Ricursive dit avoir dépensé $32M pour l'ensemble du projet, et le blog précise que c'est "our full R&D cost starting from scratch, including pretraining ladder development, data mixing, evals, debugging" et les entraînements finaux, pas un seul entraînement. La comparaison "un dixième du coût" est plus fragile qu'elle n'en a l'air. Sa note de bas de page s'appuie sur un article de TechCrunch selon lequel Reflection s'est engagé à $150M par mois de calcul, plus la déclaration de Reflection que Beam a pris environ huit semaines. C'est donc l'estimation par Ricursive des dépenses d'un concurrent, pas un chiffre publié par Reflection.
Il a demandé moins d'entraînements par renforcement. Ricursive dit avoir atteint son score Terminal-Bench avec 1,4M de rollouts, "roughly 70x fewer rollouts than Reflection Beam." Elle ajoute n'avoir acheté aucune donnée de post-entraînement et avoir construit ses propres pipelines de données synthétiques.
Que disent les benchmarks de Ripple-65B ?
Ripple-65B obtient 80,5 sur Terminal-Bench 2.1, le chiffre phare, qui teste si un modèle sait mener à bien de vraies tâches dans un terminal. Cela dépasse de peu Reflection Beam (80,1) et devance Muse Spark Open (76,4), Inkling (63,8) et Nemotron 3 Ultra (56,4), selon les scores auto-déclarés de chaque laboratoire.
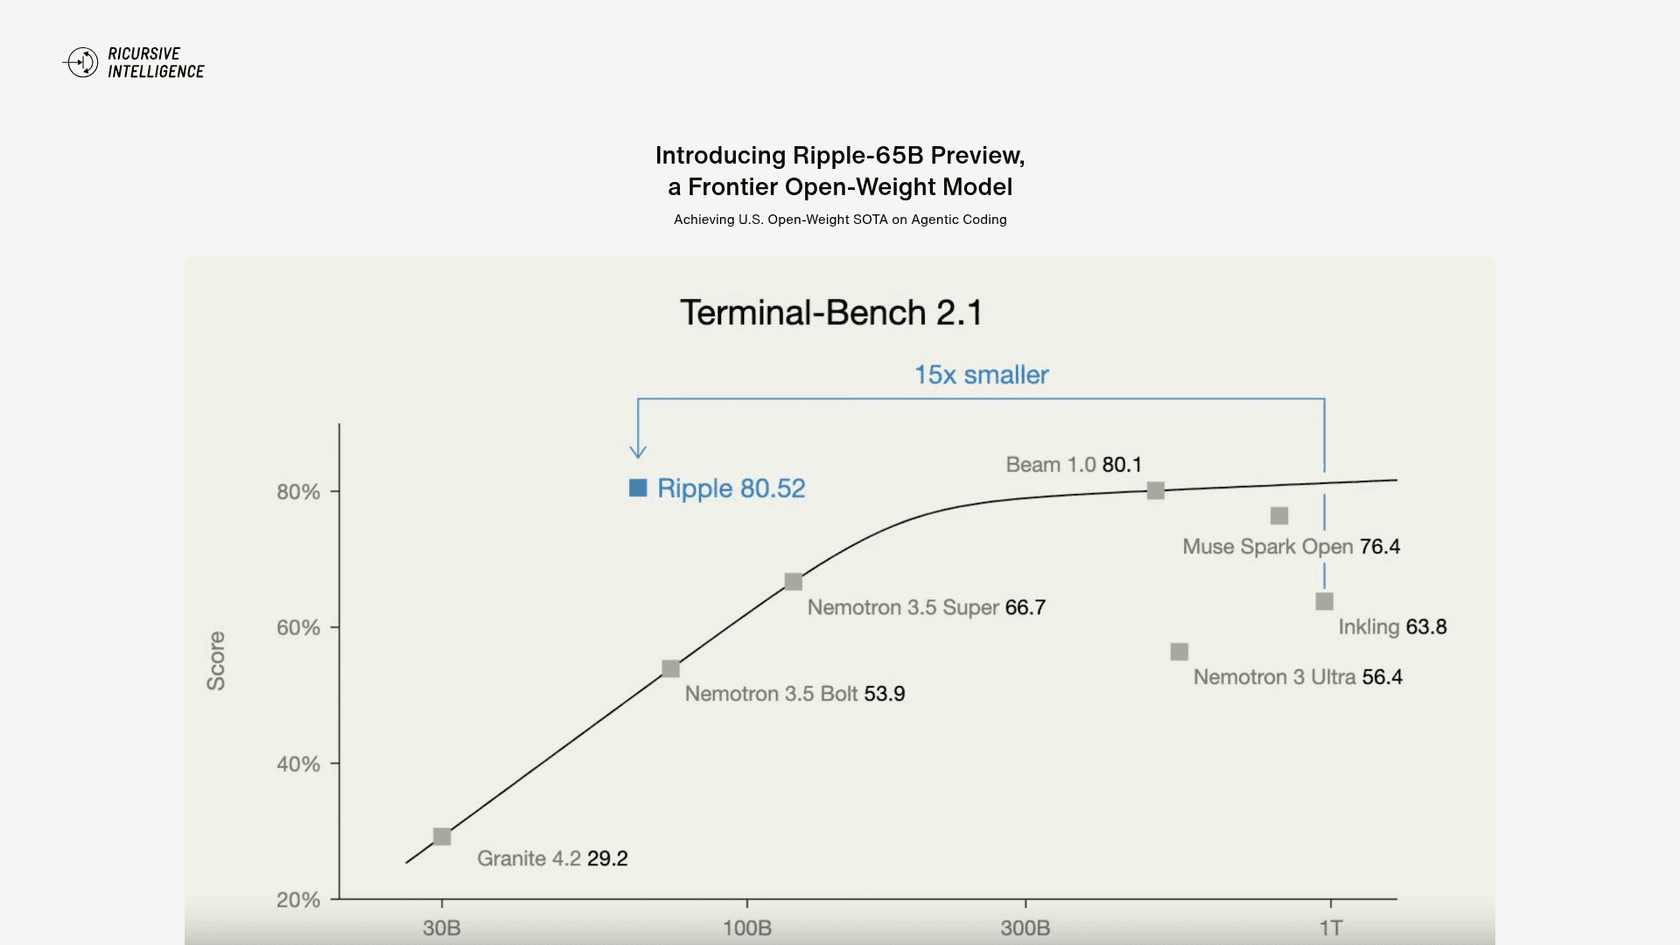
Ce graphique résume tout l'argumentaire : score contre taille, avec Ripple très à gauche de la courbe. Il place aussi sur la même ligne des modèles américains plus petits comme Nemotron 3.5 Bolt (53,9) et Nemotron 3.5 Super (66,7). À taille égale en code, Ripple est nettement devant.
Le tableau complet de la fiche du modèle raconte une histoire plus nuancée. Voici les lignes qui comptent pour les agents de code, avec les propres chiffres de Ricursive :
| Benchmark | Ripple-65B | Reflection Beam 501B | Muse Spark Open 816B | Inkling 975B | Nemotron 3 Ultra 550B |
|---|---|---|---|---|---|
| Paramètres actifs | 65B | 23B | 42B | 41B | 55B |
| Terminal-Bench 2.1 (auto-déclaré) | 80.5 | 80.1 | 76.4 | 63.8 | 56.4 |
| Terminal-Bench 2.1 (nouvelle exécution de Ricursive) | 80.5 | 70.8 | 78.7 | 56.2 | 55.1 |
| SWE-bench Verified | 76.5 | 81.6 | 78.7 | 77.6 | 71.9 |
| SWE-bench Pro v1.0 | 61.42 | 66.1 | 58.2 | 54.3 | 46.9 |
| SWE-bench Pro v2.0 Hard | 79.1 | 76.5 | 52.3 | 2.0 | 30.7 |
| DeepSWE 1.1 | 44.3 | 43.3 | 60.0 | 1.8 | 0.2 |
| MCP Atlas | 71.67 | 80.8 | 89.2 | 76.0 | 62.2 |
| SciCode | 39.4 | 49.2 | 58.5 | 46.1 | 44.6 |
| GPQA Diamond | 85.2 | 90.6 | 89.0 | 87.2 | 87.0 |
Quatre choses ressortent quand on lit le tableau de près.
- Il domine 2 lignes sur 22. Terminal-Bench 2.1 et SWE-bench Pro v2.0 Hard. Sur SWE-bench Verified et Pro v1.0, Reflection Beam est devant. Sur DeepSWE, MCP Atlas et SciCode, c'est Muse Spark Open.
- La nouvelle exécution profite surtout à Ripple. Quand Ricursive a relancé Terminal-Bench 2.1 sur le harnais officiel Terminus 2, Beam est passé de 80,1 à 70,8 tandis que Muse Spark Open montait à 78,7. La fiche indique que les scores étaient "universally lower" sur ce harnais, sauf pour Muse, et qualifie ses résultats de "a best-effort attempt at a fair comparison." C'est honnête, mais cela veut aussi dire que l'écart plus large vient des propres essais de Ricursive.
- Plusieurs scores des rivaux sont des exécutions de Ricursive, pas des leurs. La fiche marque en italique les résultats internes, qui couvrent la plupart des chiffres bas, comme le 2,0 d'Inkling sur SWE-bench Pro v2.0 Hard. Le blog de lancement de Ricursive affiche d'autres valeurs pour certaines de ces mêmes cellules (39,6 pour Inkling, 72,4 pour Muse), donc prenez ces lignes avec prudence jusqu'à la publication du rapport technique.
- Les modèles chinois à poids ouverts sont absents. La comparaison est cadrée comme "U.S. open-weight", donc pas de DeepSeek, Qwen ni Kimi dans le tableau instruct. Si votre sélection inclut DeepSeek V4.1 Flash ou Qwen 3.8 Flash Next, il faudra faire votre propre comparaison.
Aucun de ces benchmarks n'a encore été vérifié par un laboratoire extérieur. Tant que personne ne les a relancés, la lecture prudente est "un modèle dense de 65B qui rivalise avec les meilleurs modèles américains à poids ouverts en code", pas "le meilleur modèle de code à poids ouverts".
Combien coûte Ripple-65B ?
Les poids sont gratuits sous Apache 2.0. En version hébergée, Ripple-65B coûte $0.20 par million de tokens d'entrée et $0.60 par million de tokens de sortie, l'entrée en cache à $0.05. C'est identique directement chez GMI Cloud et sur OpenRouter, où GMI Cloud est le seul fournisseur.
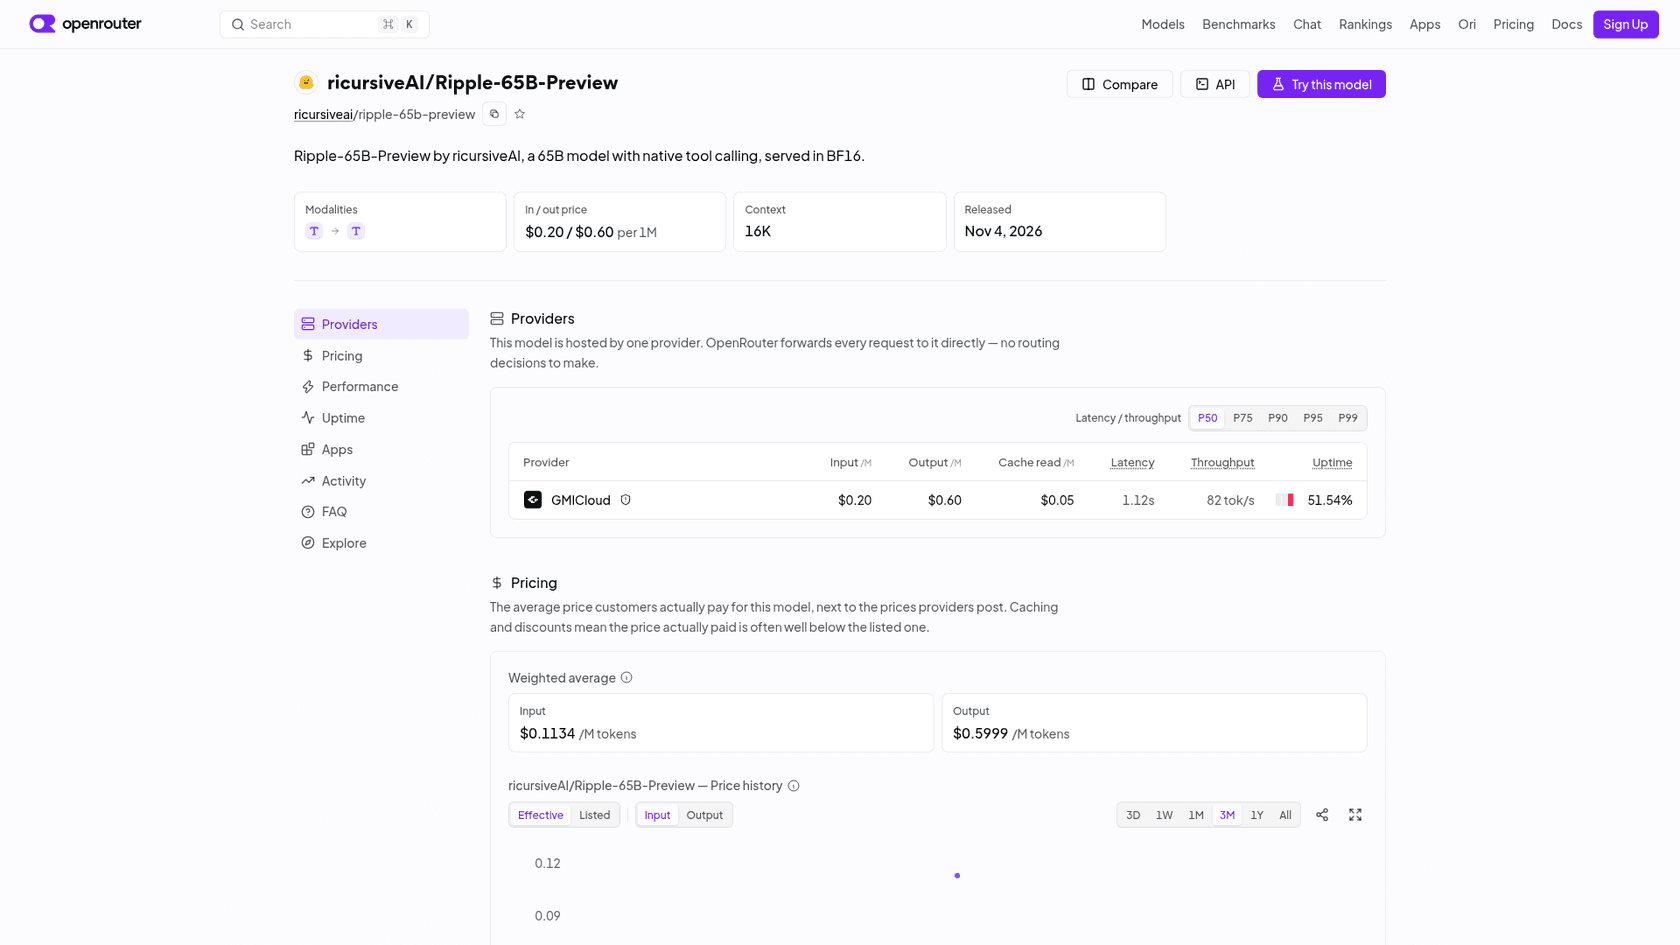
Voici comment cela se compare aux modèles voisins, d'après les prix catalogue d'OpenRouter au 5 novembre 2026 :
| Modèle | Entrée / 1M | Sortie / 1M | Entrée en cache / 1M | Contexte sur OpenRouter |
|---|---|---|---|---|
| Ripple-65B Preview | $0.20 | $0.60 | $0.05 | 16,384 |
| Reflection Beam 501B | $0.25 | $1.00 | $0.05 | 1,048,576 |
| Muse Spark Open | $1.25 | $4.25 | $0.15 | 1,048,576 |
| Inkling | $1.00 | $4.05 | $0.17 | 524,288 |
| Inkling Small | $0.45 | $1.20 | $0.10 | 524,288 |
| DeepSeek V4.1 Flash | $0.045 | $0.50 | $0.018 | 1,048,576 |
| GPT-5.6 Luna | $0.20 | $1.20 | $0.02 | 1,050,000 |
| Claude Sonnet 5.5 | $2.00 | $10.00 | $0.10 | 1,000,000 |
Ripple est l'option américaine à poids ouverts la moins chère en sortie de ce tableau. Deux points de la fiche comptent toutefois plus que le prix.
- Le contexte hébergé est de 16K. OpenRouter le plafonne à 16 384 tokens avec une limite de sortie de 14 745, alors que la fiche du modèle et la page de GMI annoncent 1M. Un agent de code qui travaille dans un vrai dépôt épuise 16K très vite : vérifiez cela avant de brancher Ripple où que ce soit.
- Un seul fournisseur, c'est une capacité réduite. Avec GMI Cloud comme seul hébergeur, le panneau de disponibilité d'OpenRouter affichait environ 51 % sur la veille quand j'ai regardé. Ricursive a aussi dit que Ripple arriverait chez Together AI et Fireworks. Le 5 novembre, la page de Together indiquait encore "This model is coming soon to Together's Serverless API."
Peut-on faire tourner Ripple-65B en local ?
Oui, sur du matériel NVIDIA, et c'est la partie la plus intéressante de la sortie. Ricursive fournit deux configurations documentées, et la fenêtre de contexte obtenue dépend de celle que vous choisissez.
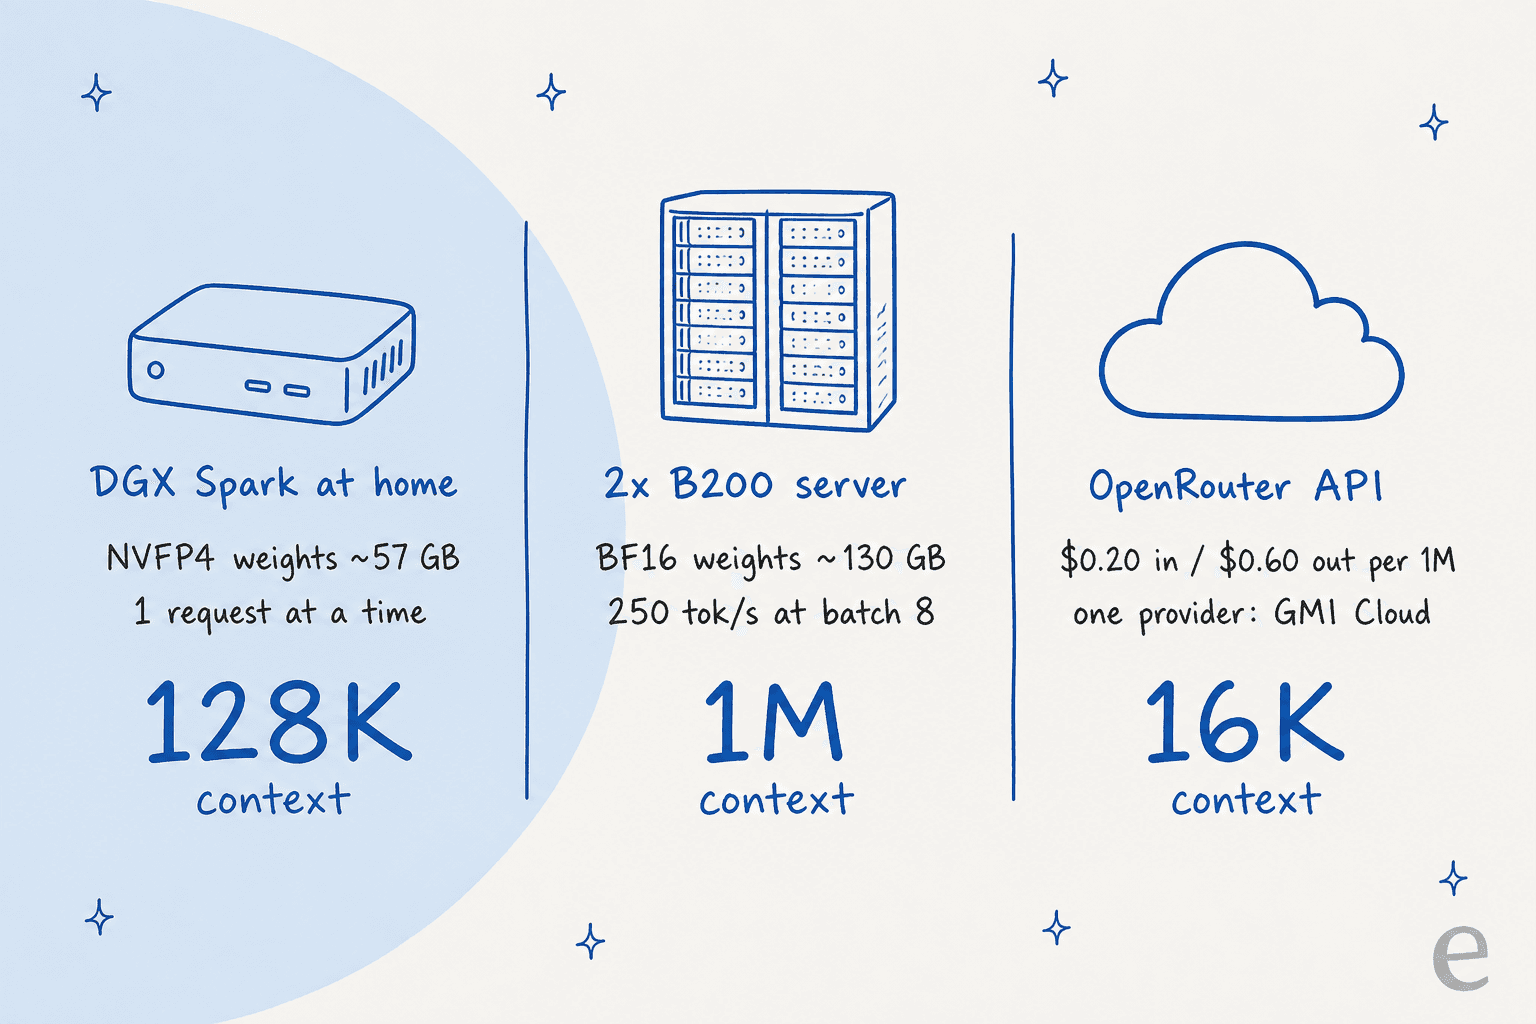
Sur un DGX Spark. Le dépôt NVFP4 inclut un notebook et un script spark.py pour la boîte d'IA de bureau de NVIDIA. Il charge les poids NVFP4 (4 bits pour les couches feed-forward, BF16 pour l'attention) plus le modèle brouillon DFlash2, et traite une requête à la fois avec un contexte de 128K. Le script refuse de s'exécuter sur autre chose qu'une puce GB10. Ricursive ne publie aucun chiffre de tokens par seconde pour le Spark.
Sur deux GPU B200. Le dépôt BF16 propose une configuration serveur sous SGLang 0.5.19 qui sert le contexte complet de 1M, Ricursive annonçant "250 tok/s on 2xB200 batch=8 prior to quantization or custom kernels." Avec quatre GPU, vous obtenez deux copies indépendantes.
Sur un Mac ou autre chose. Il n'existe pas de voie officielle. Le message de lancement du cofondateur disait "You can run Ripple-65B locally and efficiently on a MacBook Pro", mais aucune instruction pour MacBook, MLX ou llama.cpp n'apparaît dans le blog ni dans les quatre fiches de modèle. Des conversions GGUF de la communauté sont apparues sur Hugging Face en un jour ; Ricursive ne les a pas testées.
La vitesse reste la question ouverte. Un modèle dense lit tous les poids pour chaque token, il dépend donc fortement de la bande passante mémoire, point faible du Spark. Cela a été soulevé quelques heures après le lancement :
"What tok/s are you getting on the Spark? 65B dense on ~273GB/s of memory bandwidth has to crawl in an agent loop."
Le modèle brouillon est la réponse de Ricursive : le décodage spéculatif laisse le petit modèle deviner plusieurs tokens que le gros vérifie en une seule passe. Savoir si cela amène les boucles d'agent à une vitesse utilisable sur un Spark, personne ne l'avait mesuré publiquement au 5 novembre.
Comment appeler Ripple-65B depuis du code ?
GMI Cloud et OpenRouter exposent tous deux un point d'accès de chat compatible OpenAI, donc tout SDK ou framework d'agents qui parle ce format fonctionne. Sur OpenRouter, l'identifiant du modèle est ricursiveai/ripple-65b-preview :
curl https://openrouter.ai/api/v1/chat/completions \
  -H "Authorization: Bearer $OPENROUTER_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "ricursiveai/ripple-65b-preview",
    "messages": [{"role": "user", "content": "Write a bash one-liner that finds the 10 largest files in a repo."}],
    "temperature": 0
  }'
Quelques détails du template de chat à connaître avant de construire dessus :
- L'appel d'outils est natif. Les outils vont dans le prompt système et les appels reviennent en JSON dans des balises
<tool_call>, que le parseurripplede SGLang transforme entool_callsstandard. Si vous forcez un appel avectool_choice: "required", activezstrict: true, car Ricursive a constaté que "non-strict required calls produced extra argument fields." - Le raisonnement est toujours activé. Le template enveloppe la réflexion dans des balises
<think>et "does not implement a thinking on/off switch or reasoning-effort levels." Vous payez des tokens de sortie pour cette réflexion à chaque appel. - Pas de valeurs d'échantillonnage par défaut. Ricursive ne publie aucune température recommandée ; ses propres exemples utilisent 0.
Si vous comptez piloter Ripple depuis un agent de code comme Claude Code ou une CLI de code agentique, le contexte hébergé de 16K est la limite que vous atteindrez en premier. L'auto-hébergement est aujourd'hui le moyen de la contourner.
Que disent les développeurs de Ripple-65B ?
Le principal fil Hacker News a atteint 181 points et 61 commentaires le jour du lancement. Deux thèmes ont dominé : la façon de présenter les benchmarks, et la praticité d'un modèle dense de 65B à la maison.
Sur la présentation, le reproche le plus fréquent était que la comparaison s'arrête aux modèles américains :
"Category narrowing to this degree really has diluted the term "SOTA" quite a lot"

D'autres ont pointé la taille de l'avance elle-même :
"Still they score 0.42 percentage points higher than the second-best model on their chosen benchmark, so it's hardly a meaningful lead."
Le contrepoint est venu de personnes pour qui "fabriqué aux États-Unis" est une vraie exigence, pas un argument marketing :
"US Gov won't let Chinese models be hosted on any internal infra ... So there is absolutely a market for US-made or non-Chinese models there."
Sur l'exécution à domicile, les avis étaient partagés. Un commentateur s'attendait à ce que "inference will be prohibitively slow on consumer grade hardware" et voyait la sortie comme destinée aux équipes de conception de puces en environnements isolés, ce qui correspond à l'activité de Ricursive. Les propriétaires de Mac Studio très dotés en mémoire étaient plus enthousiastes, puisque 130 Go de poids tiennent bien en dessous de ce que contiennent leurs clusters. Personne n'avait publié de vitesses mesurées le matin du 5 novembre.
L'argument du coût a reçu l'accueil le plus chaleureux. swyx a qualifié la sortie de "the avengers of open model SOTA" et cité la note de bas de page selon laquelle les $32M couvrent tout l'effort de R&D, détail que la plupart ont trouvé frappant.
Faut-il utiliser Ripple-65B pour le support client ?
Probablement pas comme cerveau d'un bot de support, et la raison est l'adéquation, pas la qualité. Ripple-65B est un modèle de code avec un post-entraînement léger. Les lignes du tableau de Ricursive les plus proches du travail de support sont moyennes : 31,27 sur τ³-bench banking, qui teste des conversations de respect des règles avec un client (Beam obtient 36,1), et 71,67 sur MCP Atlas, qui teste l'usage d'outils (Muse Spark Open obtient 89,2). Le seul cas solide est le contrôle des données : si les données clients ne peuvent jamais quitter votre réseau, un modèle Apache 2.0 sur votre propre matériel est une vraie option, et Ripple est l'un des plus petits parmi les modèles performants.
Même alors, le modèle est la partie facile. Pour bien répondre aux tickets, il faut aussi des connexions à la base de connaissances, des règles d'escalade, des garde-fous contre les réponses inventées et un moyen de vérifier les réponses avant que les clients les voient. C'est tout l'enjeu du build vs buy pour le support par IA, et c'est l'essentiel du travail.
C'est ce vide que comble eesel. eesel est une plateforme de coéquipiers IA, et son coéquipier IA de helpdesk rejoint votre helpdesk existant, apprend de votre centre d'aide et de vos anciens tickets, et travaille dans votre file. J'ai vu des bots à l'air sûr d'eux donner de mauvaises réponses sur des files réelles, c'est pourquoi chaque déploiement d'eesel est d'abord testé sur des tickets historiques : vous pouvez lire ce qu'il aurait répondu avant qu'il ne touche un client.
Timengo est un bon exemple côté technique. L'entreprise vend des logiciels d'e-mail sécurisé et de Digital Post au Danemark, et eesel rédige ses réponses de support technique en danois à partir d'environ 5 300 anciens tickets et articles du centre d'aide, en préparant environ 300 tickets Freshdesk par mois. SE Ranking fait tourner trois produits sur Zendesk avec un agent eesel chacun, qui ont traité 4 650 conversations en un mois.
Et si Ripple vous a attiré parce que vous aimez travailler depuis un terminal, la CLI d'eesel correspond à cette habitude. Un agent de code peut l'utiliser pour téléverser des connaissances validées comme des articles d'aide et des macros exportés, modifier les instructions du coéquipier et poser des questions de test pour vérifier les réponses avant toute mise en ligne. Connecter le helpdesk lui-même demande toujours l'approbation de quelqu'un ayant un accès administrateur. Vous en saurez plus sur ce flux dans gérer des agents IA depuis le terminal.
Qui devrait utiliser Ripple-65B ?
Voici mon avis après avoir lu tous les fichiers publiés par Ricursive :
- Essayez-le si vous voulez un modèle de code dont vous êtes pleinement propriétaire. Apache 2.0, une voie locale sur une seule machine et $0.60 par million de tokens de sortie en hébergé le rendent peu coûteux à tester sur votre propre dépôt, et c'est un candidat naturel pour les équipes qui ne peuvent exécuter que des modèles fabriqués aux États-Unis.
- Hébergez-le vous-même si vous avez besoin d'un long contexte. La limite hébergée de 16K exclut tout travail d'agent sérieux aujourd'hui ; le contexte de 1M ne vient qu'avec vos propres GPU.
- Attendez si vous avez besoin de preuves. Il n'y a pas encore de rapport technique, les sources de benchmarks divergent sur certaines cellules et aucun laboratoire extérieur n'a relancé les chiffres. Quelques semaines de tests indépendants clarifieront beaucoup de choses.
- Cherchez ailleurs si le prix décide de tout. DeepSeek V4.1 Flash est moins cher en entrée comme en sortie, et Kimi K3.1 Pro a été testé plus largement. Pour une sélection plus large, voyez les meilleurs outils d'assistant de code IA.
Le résumé honnête : Ripple-65B Preview montre qu'une petite équipe avec un modèle dense de 65B peut atteindre la même gamme que des modèles américains à poids ouverts huit à quinze fois plus gros en code, pour $32M annoncés. C'est un vrai résultat. "État de l'art" ne tient que dans une catégorie étroite, et pour savoir si cela vaut pour votre travail, il faut l'essayer sur vos propres tâches.
Essayer eesel
Si vous êtes venu à Ripple-65B en espérant qu'un modèle ouvert puisse décharger votre équipe de tickets, vous pouvez vous épargner la construction de la couche de support. Le coéquipier IA de helpdesk d'eesel se branche en quelques minutes sur Zendesk, Freshdesk, Gorgias et d'autres, apprend de vos anciens tickets et vous montre comment il y aurait répondu avant la mise en ligne. Les forfaits démarrent à $299 par mois, avec un niveau gratuit pour tester.

Essayez eesel gratuitement.