

Qwen-UI-Agent est le meilleur agent pilotant un téléphone qui ait été publié, et vous ne pouvez pas l'utiliser. L'équipe Tongyi MAI d'Alibaba a publié le 30 juillet 2026 un article, une vidéo de démonstration et un benchmark. Le dépôt GitHub compte 2.2k étoiles et zéro version publiée. Il n'y a pas de poids sur Hugging Face, pas d'API, pas de grille tarifaire.
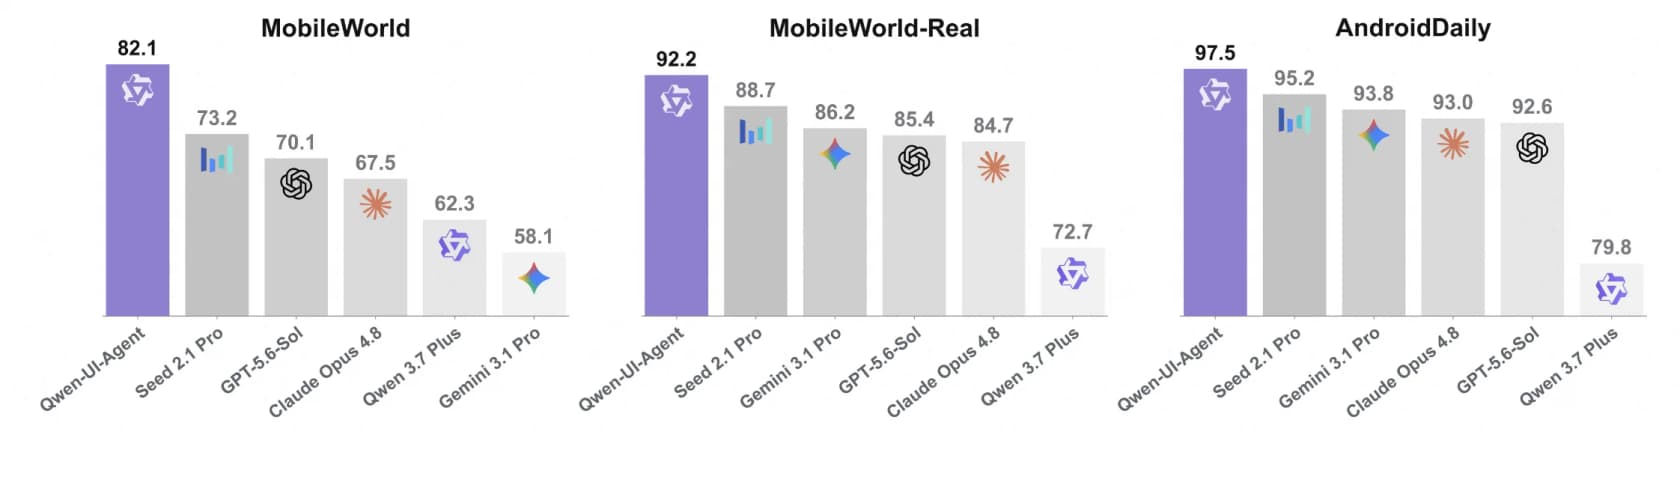
Les chiffres mobiles sont réels et importants. 82.1% sur MobileWorld, soit 14.6 points au-dessus de Claude Opus 4.8 et 38.2 points au-dessus du meilleur modèle GUI spécialisé précédent. C'est sur les chiffres ordinateur que la presse anglophone s'est trompée. Sur OSWorld-Verified, le graphique d'Alibaba lui-même place Opus 4.8 à 83.4 et Qwen-UI-Agent à 79.5. Sur le travail de bureau de longue haleine, il termine 13.9% des tâches. Sur la recherche web difficile en anglais, il obtient 64.1 contre 90.1 pour GPT-5.5.
Je construis la partie agents d'eesel, donc ce que je relis sans cesse dans cet article, ce n'est pas le classement. C'est le Tableau 10, où l'équipe a classé chaque échec sur appareil réel. 52% d'entre eux étaient la faute de l'écran, pas du modèle : publicités, paywalls, CAPTCHAs, pages blanches, un texte indicatif gris pris pour du texte saisi. C'est ce chiffre qui dit où le pilotage d'écran a sa place, et où il ne l'a pas.
Ce qu'est vraiment Qwen-UI-Agent
La plupart des modèles dont vous entendez parler répondent à des questions. Celui-ci manipule des appareils. Vous lui donnez une tâche en langage courant, il regarde une capture d'écran et produit un toucher, un balayage, une frappe ou une commande bash. Puis il regarde à nouveau.
L'article évalue trois tailles : un modèle de 27B, une variante creuse de 35B-A3B et un de 4B. Chaque chiffre phare appartient au 27B. La base est presque certainement Qwen3.5-27B, car les tableaux de capacités générales de l'article placent les deux côte à côte et les scores sont quasi identiques : 72.4 contre 73.5 sur MMMU-Pro, 83.1 contre 83.1 sur RealWorldQA. Quoi que l'entraînement GUI ait fait, il n'a pas mangé le raisonnement général du modèle, ce qu'on ne peut pas dire de la plupart des fine-tunings spécialisés.
C'est la suite de MAI-UI 1.0, le travail précédent de la même équipe, et il en hérite l'habitude de nommer les choses d'après ce qu'elles mesurent. Si vous découvrez la famille, notre présentation de Qwen couvre les modèles principaux, et l'avis sur Qwen donne la lecture business. Le modèle phare actuel d'Alibaba, Qwen3.8-Max, est une tout autre bête : plus gros, plus bavard, et pas conçu pour appuyer sur des boutons.
Ce qui en fait un agent GUI de base plutôt qu'un bot mobile, c'est l'étendue. Un modèle, quatre environnements : téléphones Android, bureau Linux, navigateurs web et un mode de recherche approfondie reposant sur des API. Des produits nommés qui font l'un de ces quatre existent. Faire les quatre dans un seul checkpoint, voilà l'affirmation.
Le tableau des benchmarks, et la partie qu'on a trop lue
Voici chaque chiffre phare publié au même endroit, avec celui qui occupe réellement la première place.
| Axe | Benchmark | Qwen-UI-Agent | Meilleur publié | Verdict |
|---|---|---|---|---|
| GUI mobile | MobileWorld (50 étapes) | 82.1% | Qwen-UI-Agent | Devant de 8.9 sur Seed 2.1 Pro |
| Mobile, appareils réels | MobileWorld-Real | 92.2% | Qwen-UI-Agent | Devant de 3.5 sur Seed 2.1 Pro |
| Mobile, tâches quotidiennes | AndroidDaily | 97.5% | Qwen-UI-Agent | Devant de 2.3 |
| Ordinateur | OSWorld-Verified | 79.5% | Claude Opus 4.8, 83.4% | Deuxième |
| Ordinateur, longue haleine | OSWorld-v2 partial | 40.0% | Claude Opus 4.8, 54.8% | Troisième, derrière GPT-5.5 |
| Ordinateur, tâches terminées | OSWorld-v2 binary | 13.9% | Claude Opus 4.8, 20.6% | Deuxième |
| Navigateur | WebArena | 73.6% | Qwen-UI-Agent | Devant de 1.7. L'humain est à 78.2% |
| Grounding | ScreenSpot-Pro (zoom) | 81.5% | Qwen-UI-Agent | Devant de 0.8 |
| Recherche approfondie, EN | BrowseComp | 64.1% | GPT-5.5, 90.1% | 26 points derrière |
| Recherche approfondie, ZH | BrowseComp-ZH | 75.0% | Apodex-1.0-mini, 80.6% | Deuxième |
Le côté mobile de ce tableau n'est pas serré. Regardez.
Regardez maintenant le même ensemble de graphiques pour l'ordinateur et le web. Les panneaux du milieu et de droite sont des victoires. Celui de gauche n'en est pas une, et la barre qui le bat est étiquetée.
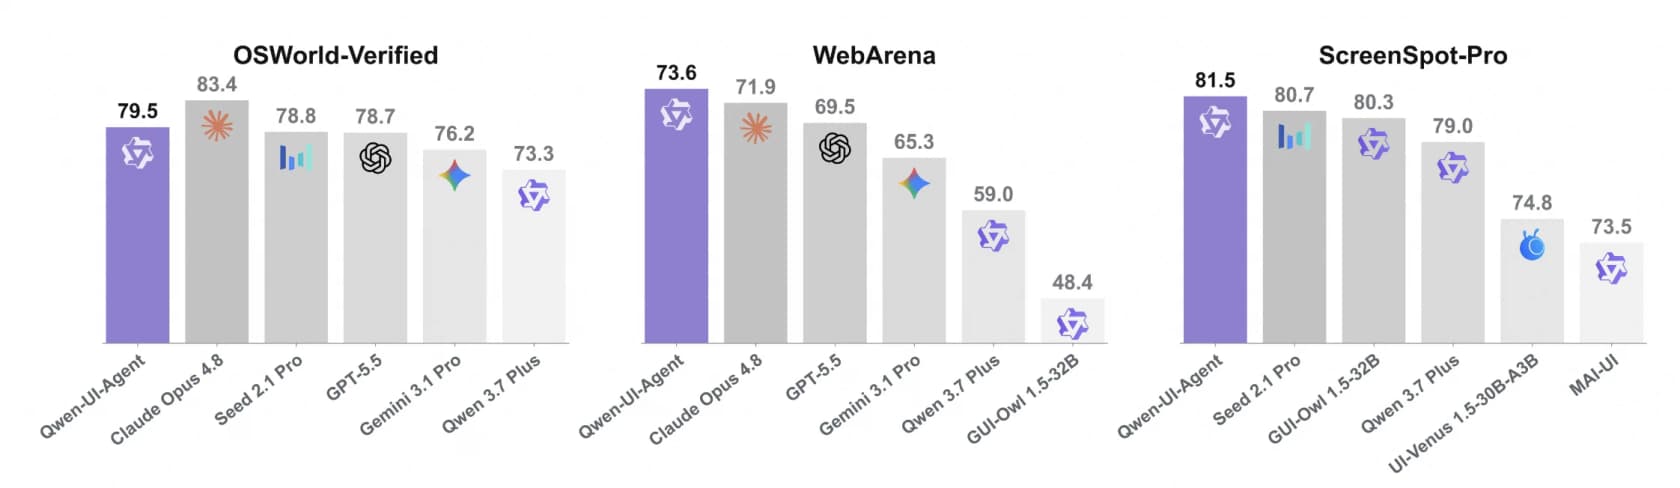
Alibaba a été franche là-dessus. L'article dit que le modèle se classe "second among all compared models and trailing only Claude Opus 4.8" sur OSWorld-Verified, et le résumé découpe soigneusement l'affirmation : état de l'art sur mobile, compétitif sur ordinateur et navigateur. L'arrondi s'est fait en aval. Un récapitulatif hebdomadaire de l'IA chinoise très partagé a annoncé les meilleurs scores sur les trois, MobileWorld, OSWorld-Verified et WebArena, "beating GPT-5.6 Sol, Claude Opus 4.8, and Gemini 3.1 Pro." Deux de ces trois sont exacts. Celui de l'ordinateur ne l'est pas, d'après le propre graphique en barres d'Alibaba.
Cela compte parce que les deux axes décrivent des métiers différents. Réserver un billet de train dans une appli est une tâche mobile. Rapprocher un tableur sur quatre fenêtres est une tâche d'ordinateur. Un modèle peut dominer l'une et perdre l'autre, et celui-ci le fait.
Choisissez la tâche, puis lisez le chiffre
Un seul espace d'actions pour les touchers et les commandes de terminal
La décision de conception que je trouve la plus intéressante n'a rien à voir avec la vision. C'est la liste d'actions.
À côté des verbes GUI attendus, click, long_press, type, drag, system_button, wait, le modèle dispose de cli_command pour exécuter du bash, api_call pour les appels de service structurés et ask_user pour s'arrêter et demander à un humain. Le tout dans un espace plat, choisi tour après tour. L'agent n'est donc jamais obligé d'exprimer "renommer quarante fichiers" en quarante clics séparés. Il peut simplement écrire la commande.
Et il le fait constamment. Sur OSWorld-v2, 55.1% des actions de l'agent sont des commandes saisies plutôt que des actions d'écran. Sur OSWorld-Verified c'est 40.7%, présentes dans 92.0% des tâches.
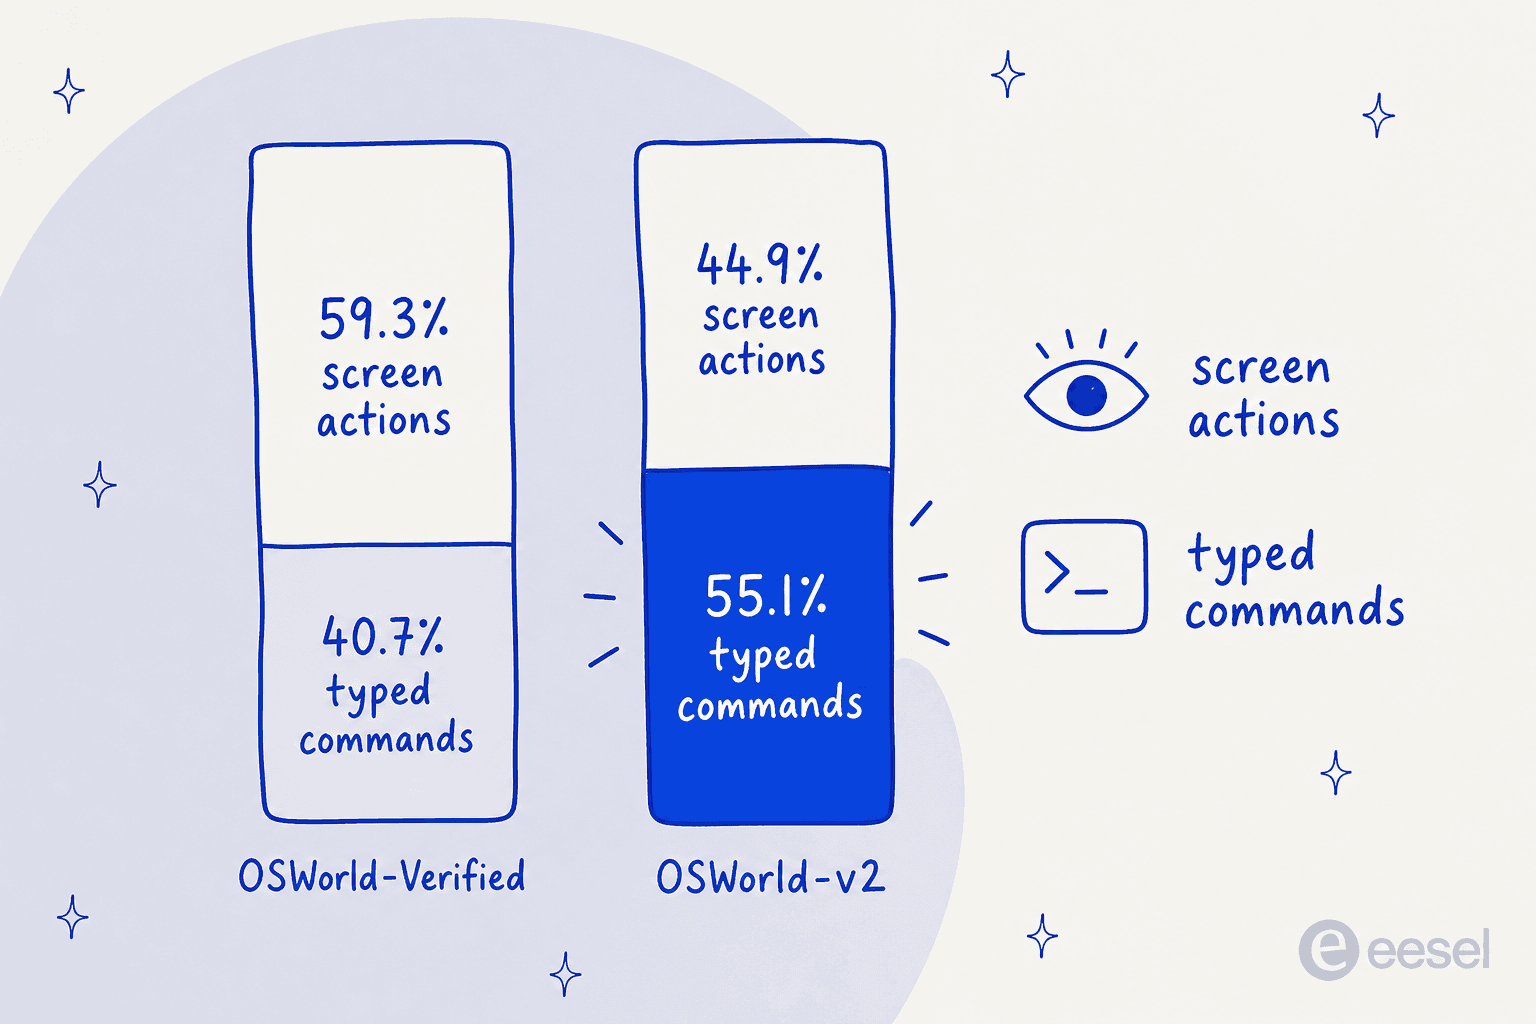
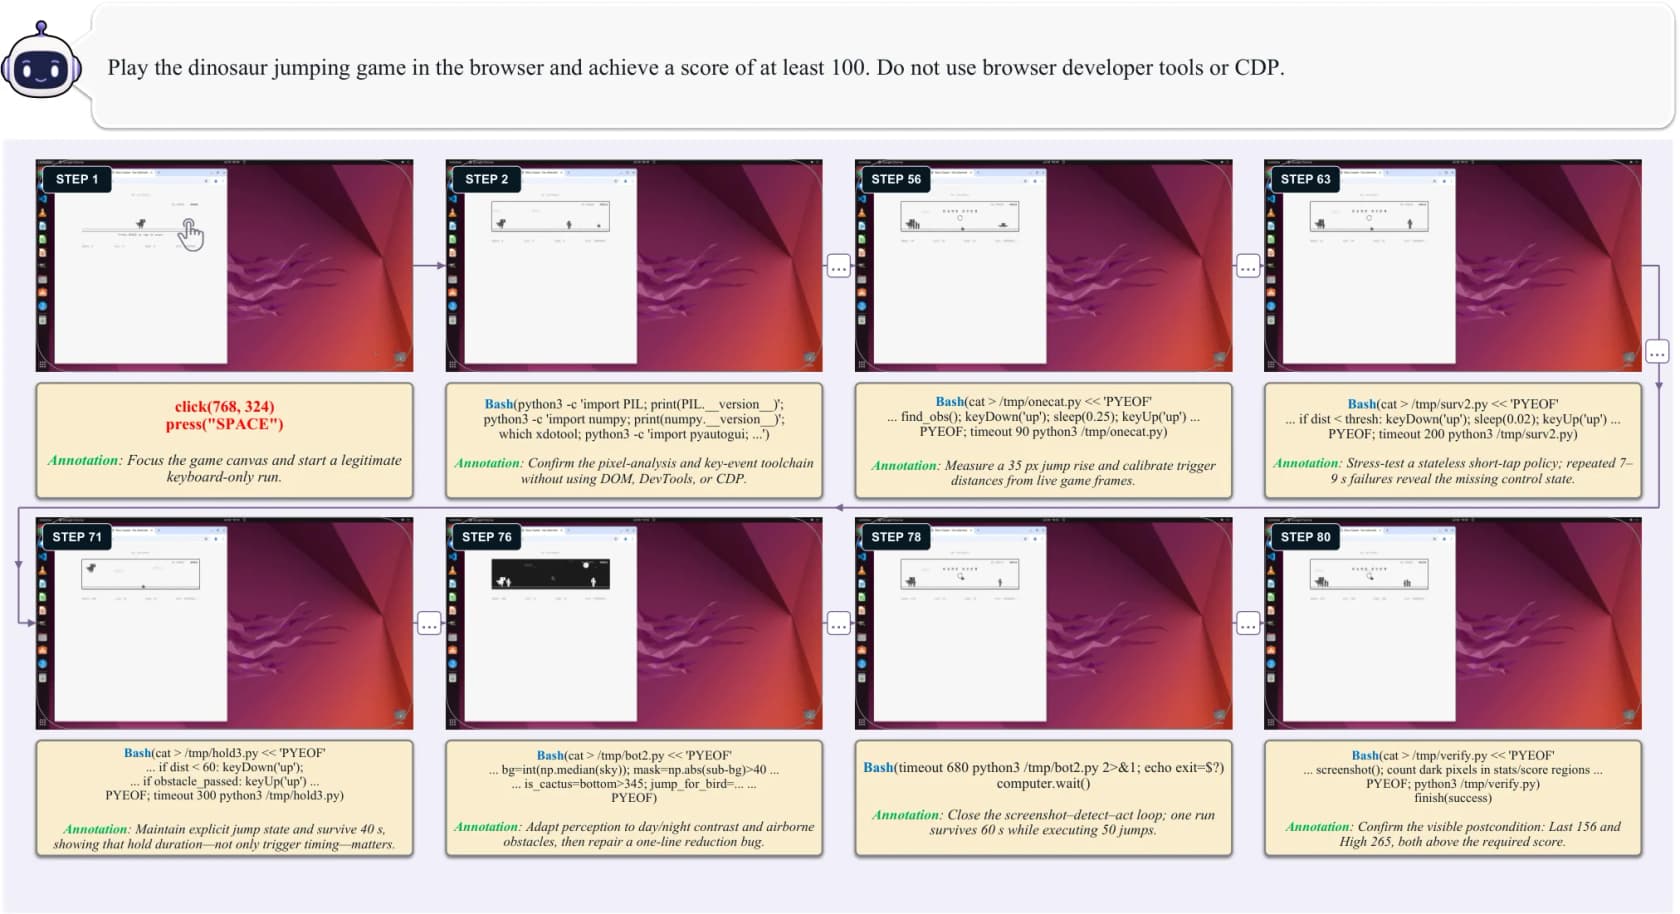
Prenez un instant pour y réfléchir. Le produit phare est un agent d'écran. Donnez-lui un clavier et un shell, et sur le benchmark d'ordinateur le plus dur, il passe la plupart de ses actions à ne pas toucher l'écran. L'expression de l'article lui-même pour ce schéma est bash comme mains, GUI comme yeux, et la trajectoire qui l'illustre le mieux est la tâche de marquer 100 au jeu du dinosaure du navigateur sans ouvrir les outils de développement. Sur 80 étapes, l'agent observe le canvas par captures d'écran, puis écrit et réécrit du Python pour chronométrer les sauts.
La seconde astuce d'efficacité est le regroupement. Au lieu d'une action par tour du modèle, il en émet plusieurs : 39.6% des actions sur OSWorld-Verified et 41.6% sur OSWorld-v2 arrivent par lots, avec une moyenne de 3.1 primitives chacun. Un exemple de l'article est une séquence de 21 actions qui remplit un e-mail et va jusqu'au sélecteur de pièces jointes, puis s'arrête, car la décision suivante nécessite une nouvelle capture d'écran. Chaque tour évité, c'est une capture, une passe d'inférence et un aller-retour en moins, précisément le coût que l'article désigne dans sa propre section de travaux futurs comme le principal obstacle à un usage pratique.
Si vous avez déjà regardé un agent de navigateur ramper dans un formulaire champ par champ, voici le remède. Chrome auto-browse a le même type de problème, et c'est pourquoi la latence par étape, et non la précision, est souvent ce qui tue une démo.
Le chiffre sur appareil réel est le plus intéressant
La plupart des agents GUI sont entraînés et notés dans des simulateurs, parce qu'un simulateur peut être réinitialisé et vérifié. Alibaba a construit l'inverse : un environnement d'exécution de plus de 100 smartphones physiques couvrant plus de 150 applis, avec un benchmark assorti.
MobileWorld-Real, ce sont 409 tâches écrites par des humains sur 104 applis Android actives, tenues à l'écart de l'entraînement. Des comptes réels, du contenu qui change, de vraies permissions, un vrai réseau. La liste des tâches se lit comme le samedi de quelqu'un : trouver le post de recette le plus enregistré, acheter les ingrédients hors assaisonnements pour une livraison à 18:45, comparer les temps de marche depuis trois hôtels jusqu'à un pont, calculer l'heure d'arrivée du train et réserver une réunion pour l'heure pleine suivante.
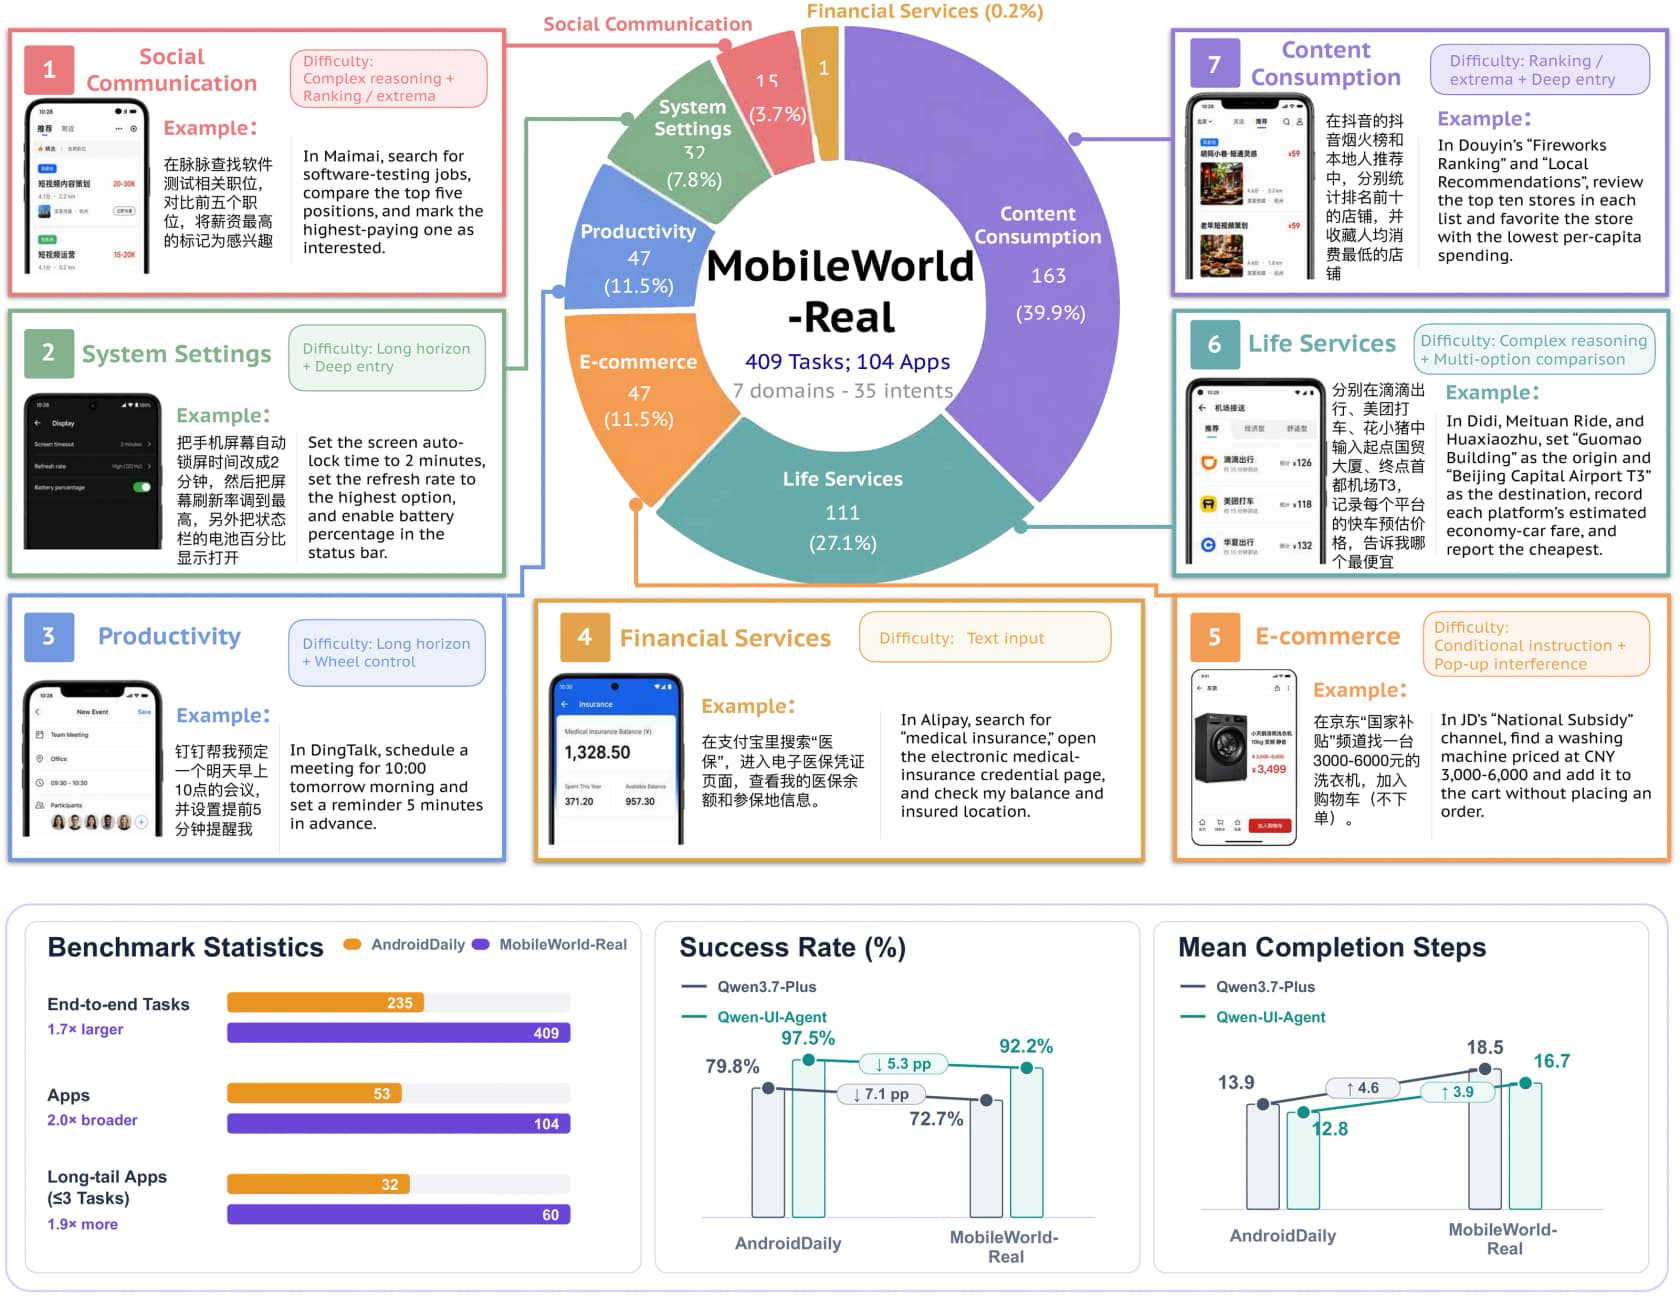
Deux réserves honnêtes s'imposent sur les 92.2%. D'abord, c'est le benchmark d'Alibaba lui-même, ce qui est normal, mais ce n'est pas un classement indépendant. Ensuite, les téléphones physiques n'exposent pas l'intérieur des applis, il n'y a donc pas de vérificateur déterministe. La notation est assurée par un agent appelé AutoJudge, qui lit la consigne ainsi que la trace complète des actions et des captures et renvoie réussite, échec ou erreur d'environnement. L'équipe a chiffré sa précision à 92.8% de correspondance exacte avec 666 exemples relus par des experts, et a cité l'erreur du juge comme première limite de l'article. Je respecte qu'ils aient commencé par là. Cela veut aussi dire que le haut de ce classement est entouré d'une marge de tolérance.
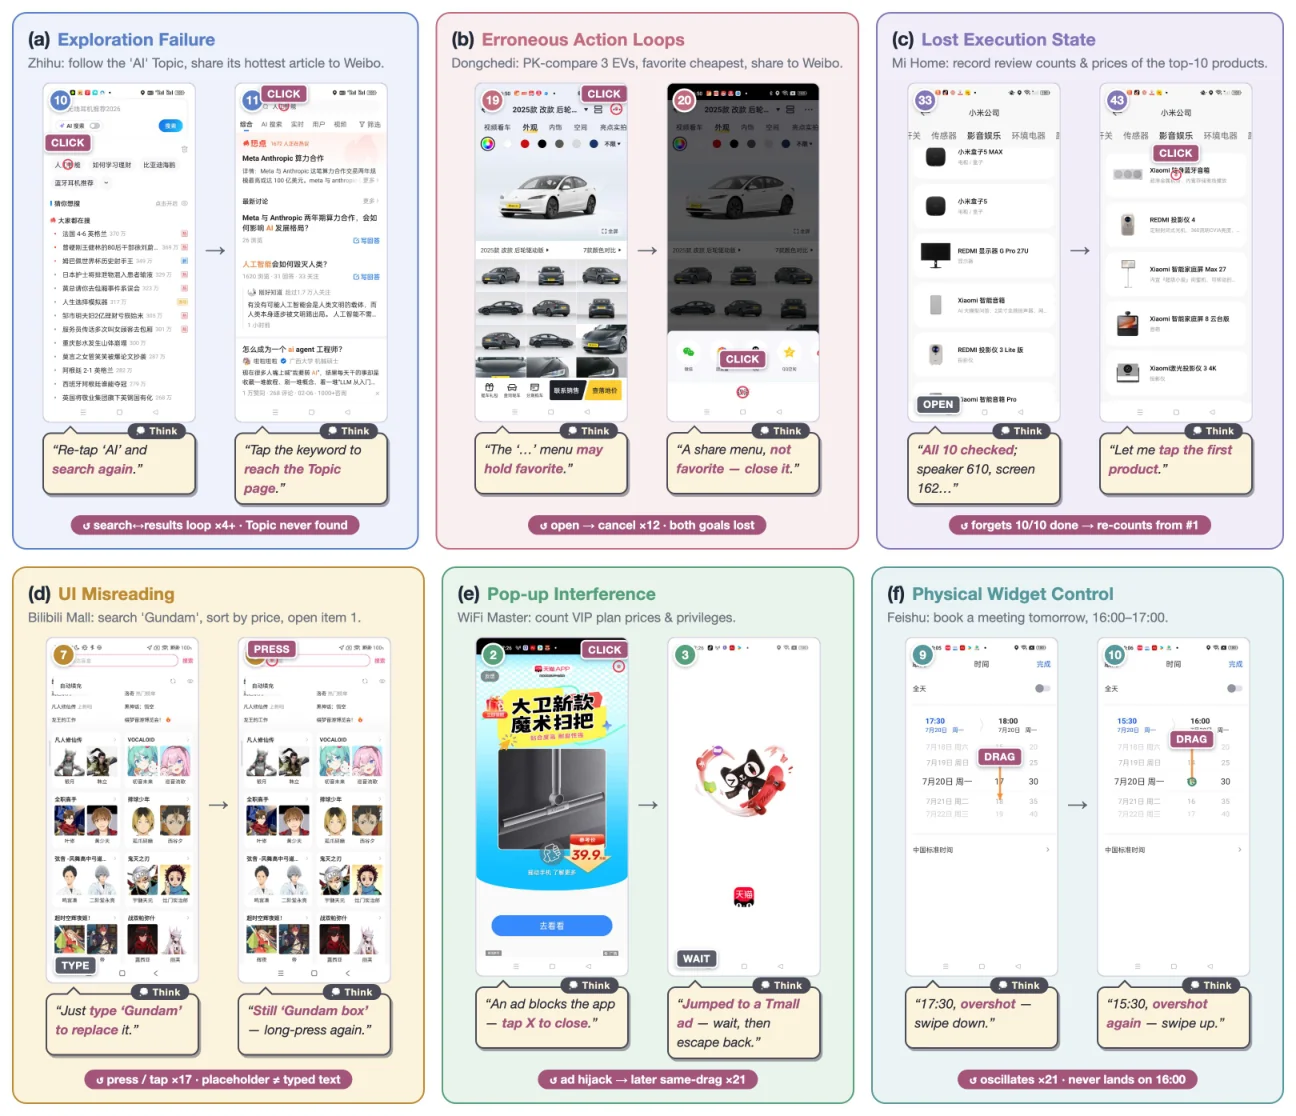
La récompense de tout ce matériel apparaît dans l'analyse des échecs, la section que je lirais en premier si je n'avais que cinq minutes. L'équipe a pris chaque trajectoire échouée de Qwen 3.7 Plus sur appareils réels et l'a classée.
| Type d'échec | Part | À quoi cela ressemble |
|---|---|---|
| Mauvaise lecture de l'interface | 24.7% | Texte indicatif gris lu comme du texte saisi, il continue donc à vider un champ déjà vide |
| Interférence de pop-ups | 18.2% | Publicités, paywalls, CAPTCHAs, pages blanches |
| Échec d'exploration | 19.5% | Ne trouve pas une fonction enfouie derrière plusieurs menus |
| Boucles d'actions erronées | 14.3% | Répète douze fois une action qui n'a rien fait |
| Contrôle de widgets physiques | 9.1% | Dépasse la cible d'un sélecteur d'heure dans les deux sens, sans jamais s'arrêter dessus |
| Perte de l'état d'exécution | 6.5% | Oublie quelles sous-tâches sont déjà faites et recommence |
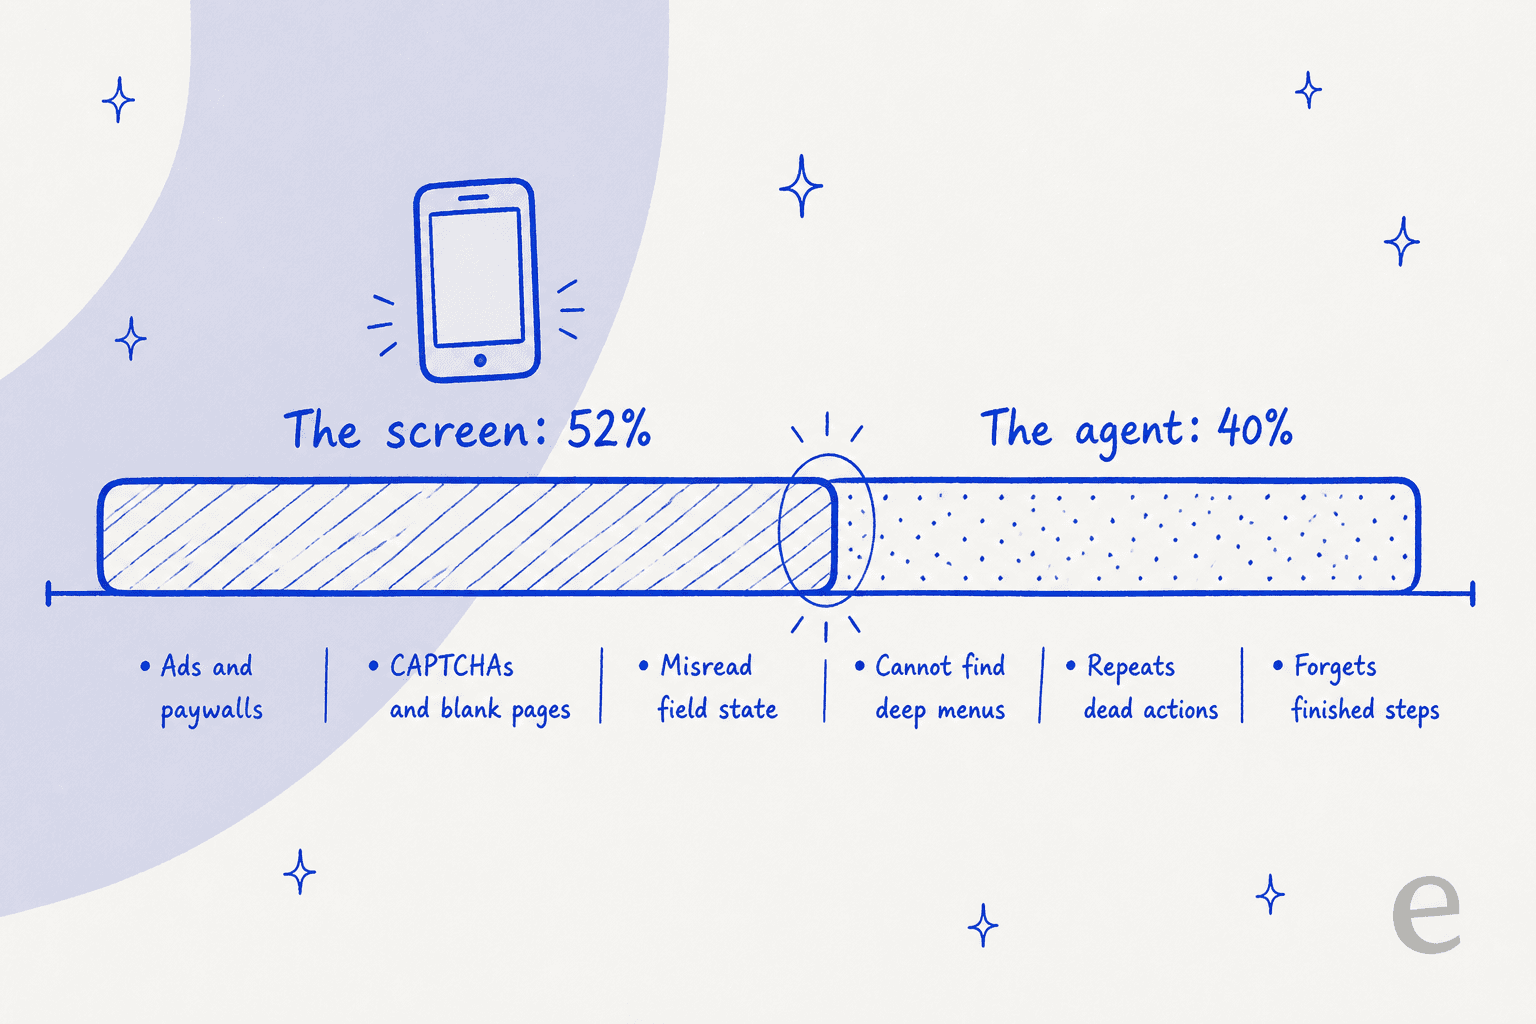
Additionnez les premières lignes et 52.0% des échecs relèvent de l'environnement plutôt que du raisonnement : une pub est apparue, une page est restée blanche, un texte indicatif ressemblait à du texte. Seuls 40.3% sont l'agent qui échoue par ses propres moyens. Le véritable adversaire d'un agent GUI, c'est l'interface, et les interfaces changent sans prévenir personne.
Peut-on vraiment l'utiliser ? Non, pas encore
C'est la partie que tous les fils d'annonce ont sautée, alors je vais être clair sur ce qui existe.
| Ce que vous pourriez vouloir | Ce qui existe aujourd'hui |
|---|---|
| Poids du modèle | Aucun. Tongyi-MAI sur Hugging Face propose MAI-UI-2B et MAI-UI-8B de décembre 2025 et janvier 2026, rien de plus récent |
| Code d'inférence | Aucun. Le dépôt compte 2.2k étoiles, 199 forks, zéro version publiée, zéro paquet |
| Une API hébergée | Aucune publiée |
| Tarifs | Aucun, car il n'y a rien à facturer |
| Une appli grand public | Non annoncée |
| Ce que vous pouvez lire | Le rapport technique, le site du projet, des vidéos de démonstration et le benchmark MobileWorld-Real |
La licence Apache 2.0 du README couvre le contenu du dépôt, pas un checkpoint, ce qui vaut la peine d'être su avant que quelqu'un ne vous dise que celui-ci est ouvert. Alibaba a l'habitude de publier des poids finalement, la lecture raisonnable est donc "pas encore" plutôt que "jamais". Mais pour l'instant, Qwen-UI-Agent est un résultat de recherche, pas quelque chose à intégrer dans un workflow. Le guide des tarifs de Qwen couvre les modèles que vous pouvez réellement appeler, et Qwen 3.7 Flash est le modèle économique que les gens font tourner en production.
Si vous êtes en phase d'achat plutôt que de lecture, l'ensemble de comparaison honnête est constitué des modèles qui répondent déjà à vos appels d'API aujourd'hui. Pour le pilotage d'ordinateur, c'est d'abord Claude Opus 5, et notre avis sur Opus 5 détaille pourquoi.
En dessous, Gemini 3.5 Pro est l'option crédible la moins chère avec vision, et GPT-5.6 est celle pour laquelle la plupart des équipes ont déjà une clé.
Si les poids ouverts sont une exigence et non une préférence, les deux à confronter sont Kimi K3 et l'offre économique de DeepSeek. Notre article sur DeepSeek V4 Flash explique pourquoi l'offre économique est celle que les gens déploient réellement.
Ce que cela signifie si vous gérez une file de support
Ici je dois déclarer un intérêt, car c'est mon travail quotidien. Je construis des fonctionnalités d'agents chez eesel, et le fantasme que vend un agent GUI à un responsable du support est précis et séduisant : une IA qui se connecte au helpdesk et traite les tickets comme une nouvelle recrue, sans projet d'intégration.
Deux éléments de cet article plaident contre le fait d'y recourir en premier.
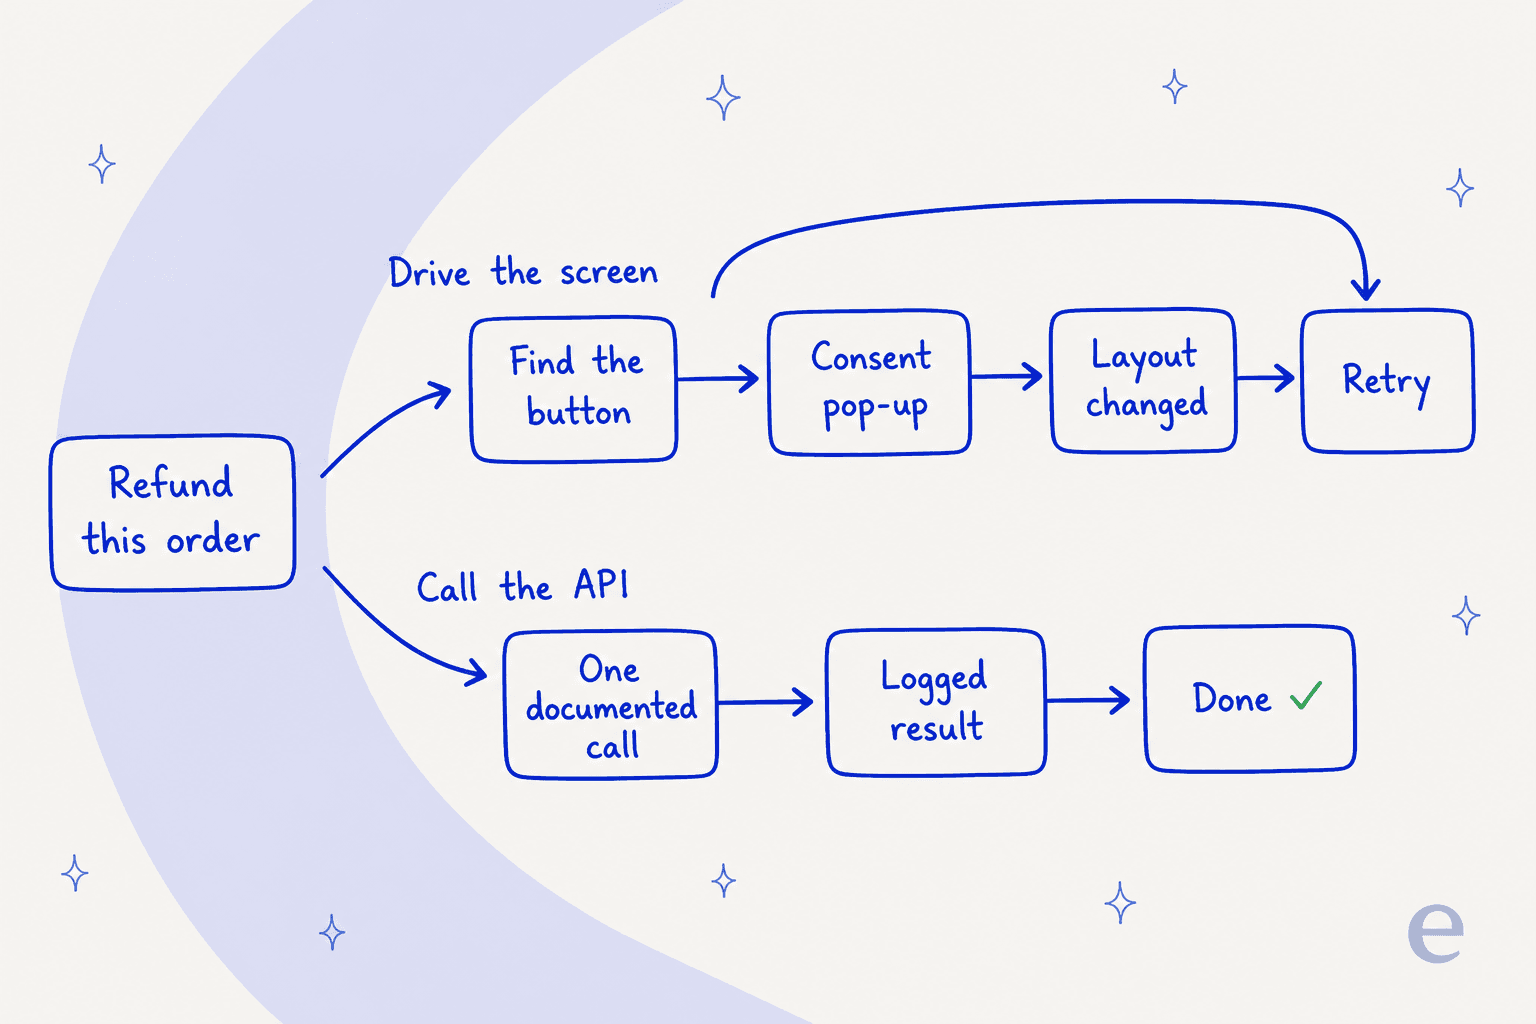
Le premier est ce tableau des échecs. Publicités, paywalls, pages blanches et états de champ mal lus sont la majorité des échecs sur appareils réels, et une interface de helpdesk présente les mêmes dangers sous une forme plus douce : une bannière de consentement, une infobulle de visite guidée, une modale qui n'apparaît que pour les admins, un tableau qui se réagence à un autre niveau de zoom. Votre flux de remboursement ne devrait pas être à une mise en production CSS de casser. Tout helpdesk digne de ce nom a une API pour une raison. L'API Zendesk fait en un appel documenté ce qu'un agent à pixels doit gagner en six clics et un peu de chance. Il en va de même pour l'API Freshdesk v2, avec des limites de débit publiées sur lesquelles vous pouvez planifier. Piloter l'écran est le bon outil pour la longue traîne de systèmes internes qui n'ont jamais livré d'API, pas pour ceux qui en ont une.
Le second est ask_user, et je le dis comme un compliment. Alibaba a mis "s'arrêter et vérifier auprès de l'humain" dans l'espace d'actions plutôt que de l'ajouter après coup, de sorte que l'agent renseigne le montant et la note Alipay puis s'arrête à l'étape de paiement. C'est exactement la forme de l'objection que j'entends le plus en support. Un responsable CX qui traite environ 7.000 tickets par mois nous l'a formulée ainsi, et cela m'est resté depuis :
"The AI will never be able to answer 100% of the questions, but if it tries and just answers 'sorry I don't know this,' I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer. I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Ce n'est pas une demande de fonctionnalité sur les écrans. C'est une demande de frontière de confiance, soit la même idée de conception qu'Alibaba a livrée sous forme d'action. Si vous allez dans cette direction, les règles de transfert sont le point de départ pratique. La mécanique du déclencheur lui-même se trouve dans les règles d'escalade. Ce qui décide d'abord dans quelle catégorie tombe une conversation, c'est généralement la classification des tickets.
La troisième chose est celle qu'Alibaba a dépensé 100 téléphones à prouver, et elle se généralise au-delà du mobile. Un chiffre de simulateur ne prédit pas le comportement dans l'environnement réel. C'est tout l'argument de leur environnement sur appareils réels, et c'est le même argument pour faire tourner un agent IA sur votre propre historique de tickets avant qu'il ne réponde à un seul ticket en direct. Nous l'avons appris à la dure il y a des années, en regardant un bot au ton assuré donner des réponses fausses avec un parfait aplomb, et c'est pourquoi rien ne passe en production chez eesel sans une passe de simulation préalable. Pour la version plus large de cet argument, l'assurance qualité du support explique comment les équipes la mesurent réellement. L'équivalent côté humain se trouve dans le coaching des agents.
Rien de tout cela n'est une critique de Qwen-UI-Agent. C'est un opérateur d'appareils, et un très bon sur téléphone. Il n'a ni modèle de ticket, ni base de connaissances, ni file d'attente, ni notion de client, il se situe donc une couche sous les outils de notre panorama des meilleurs agents IA et de la liste plus ciblée du meilleur agent IA pour le support. Un tout autre métier.
Si vous voulez la carte des catégories, les exemples d'agents IA montrent où chaque type trouve sa place. Agents IA contre chatbots trace la ligne que la plupart des acheteurs cherchent réellement, et les chatbots à base de règles couvrent la génération précédente.
Essayer eesel
Si ce que vous voulez est une IA qui traite votre file plutôt qu'elle ne clique autour, c'est ce que nous construisons. eesel se connecte via l'API du helpdesk que vous utilisez déjà, apprend de vos tickets passés et de votre centre d'aide au lieu de deviner, et lance une simulation sur votre historique réel de tickets avant qu'un seul client ne voie une réponse. Vous obtenez d'emblée le taux de réussite, les lacunes et les formulations à corriger. La facturation se fait par ticket traité, pas par poste, donc un mois calme coûte moins qu'un mois chargé.

Ce panneau d'approbation, c'est l'idée d'ask_user en production : chaque action d'outil que l'agent voulait effectuer, et si un humain l'a approuvée, rejetée ou n'a pas encore décidé.
Commencez par l'IA de helpdesk pour la vue d'ensemble, la déviation de tickets si vous visez un chiffre précis, ou les outils d'automatisation du support si vous comparez encore.
Sinon, essayez eesel gratuitement. Aucun appel requis.
Alors, où cela le place-t-il
Qwen-UI-Agent est la preuve publiée la plus solide à ce jour qu'un modèle de taille moyenne à architecture ouverte peut piloter un téléphone mieux qu'un généraliste de pointe. 82.1% sur MobileWorld contre 67.5% pour Opus 4.8 n'est pas une erreur d'arrondi, et 38.2 points au-dessus du meilleur spécialiste précédent, c'est un changement d'échelle. L'espace d'actions hybride est la bonne idée, et le regroupement la bonne optimisation. Alibaba a aussi rapporté les parties qui ne la flattent pas, ce qui est plus rare qu'il ne le devrait.
Il est aussi indisponible, non éprouvé sur les stacks d'applis occidentales, deuxième sur ordinateur, et 26 points derrière en recherche anglophone. Si vous ne lisez qu'une chose au-delà du classement, que ce soit le Tableau 10. L'écran est l'adversaire, pas le modèle, et c'est vrai que l'interface soit Douyin ou votre helpdesk. Là où une API existe, utilisez l'API. Là où il n'y en a pas, c'est ce courant de recherche qui finira par combler le vide, et c'est précisément pour cela qu'il vaut la peine d'être suivi.
En attendant, les questions qui décident de votre trimestre sont les plus banales. Votre base de connaissances IA est-elle assez bonne pour y puiser des réponses. Le routage des tickets envoie-t-il les demandes au bon endroit avant qu'une IA n'y touche.
Puis la question d'argent, c'est-à-dire le coût d'un agent IA contre un agent humain à votre volume réel, pas à celui d'un éditeur. Et la question du cadrage, car le discours des coéquipiers IA et celui de l'employé IA divergent plus que le marketing ne le laisse entendre.
Enfin, celle qu'on repousse : savoir si un système de ticketing IA vaut la migration depuis celui que vous avez. Pour le reste de la gamme d'Alibaba, les alternatives à Qwen sont le panorama et l'avis sur Qwen3.8-Max est le plus proche cousin de cet article.
Questions fréquentes
Qu'est-ce que Qwen-UI-Agent ?
Qwen-UI-Agent est-il open source ou téléchargeable ?
Que vaut l'agent UI de Qwen face à Claude et GPT ?
Combien coûte Qwen-UI-Agent ?
Un agent GUI peut-il gérer mon helpdesk à ma place ?
Que se passe-t-il si l'agent se trompe sur un vrai ticket ?
ask_user pour s'arrêter avant un paiement ou une suppression, ce qui rejoint l'idée d'un seuil de confiance en support : répondre automatiquement à ce dont l'agent est sûr et transmettre le reste. Nos guides sur les règles de transfert et les règles d'escalade expliquent comment le mettre en place.