

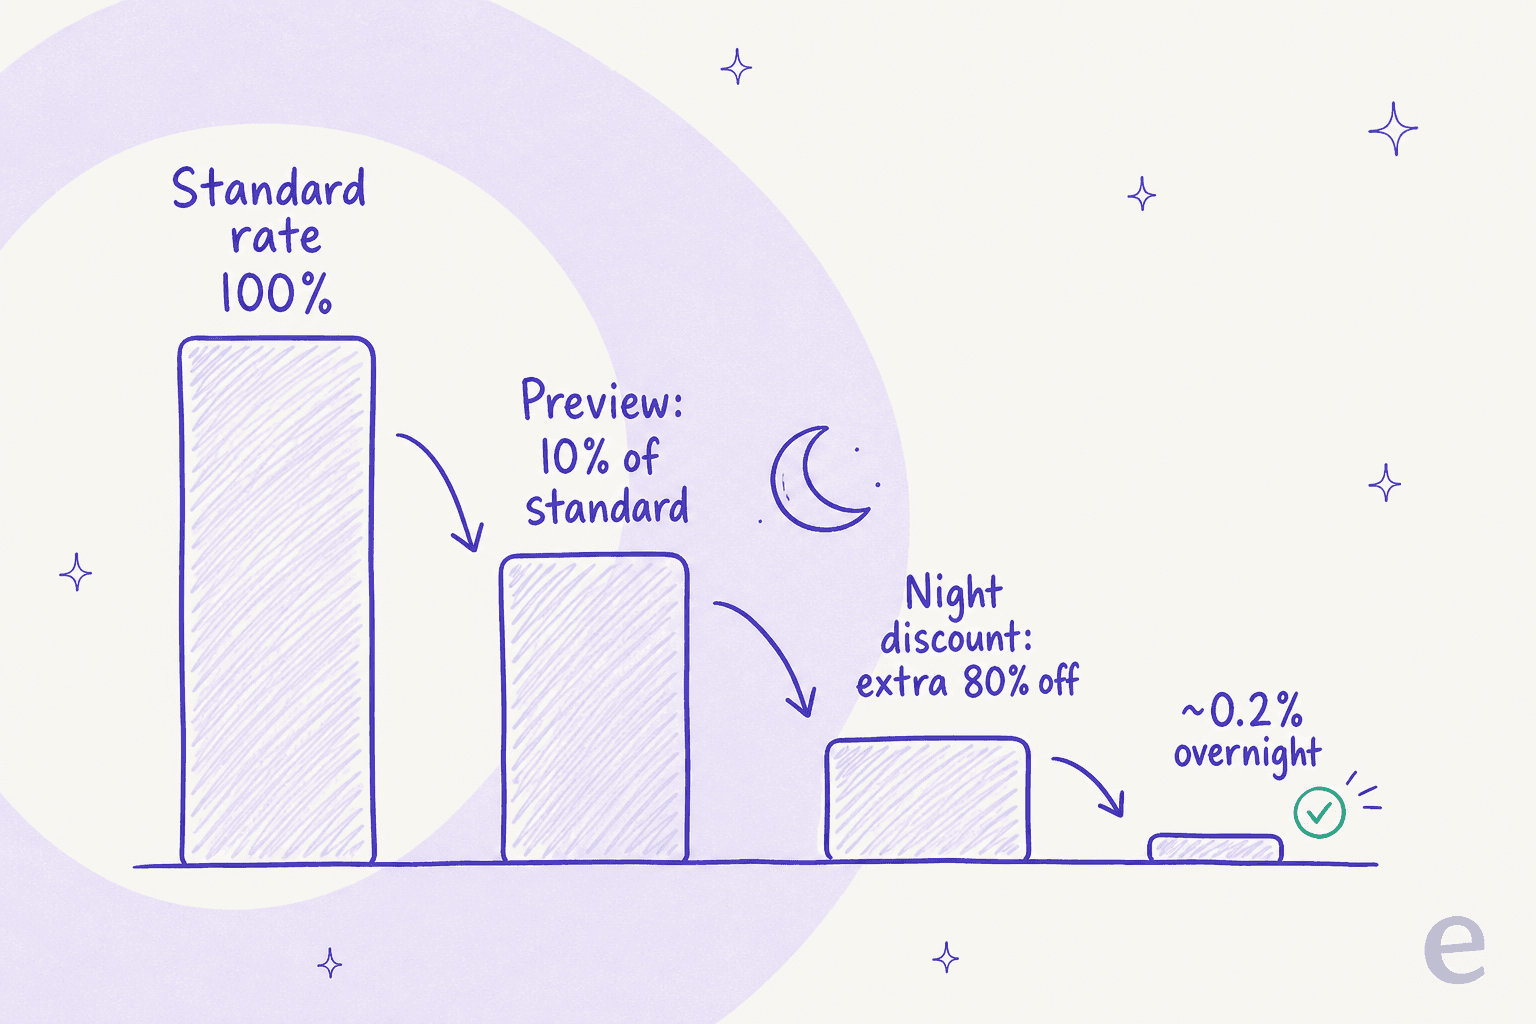
Alibaba a présenté Qwen3.8-Max en preview le 19 juillet 2026, et ce qui a vraiment fait réagir les développeurs, ce ne sont pas les 2,4 billions de paramètres, mais le prix. Pendant la preview, le modèle est vendu à 10% du tarif standard via l'abonnement Token Plan d'Alibaba et ses produits de codage Qoder et QoderWork, avec une remise de nuit supplémentaire de 80% qui fait descendre le tarif en heures creuses à environ 0,2% du standard.
Deux pièges à connaître avant de budgétiser quoi que ce soit. D'abord, il n'existe aucun tarif par token indépendant pour l'instant, ce qui est inhabituel pour un modèle de niveau Max. Tout passe par un abonnement à crédits, donc votre coût réel dépend de la vitesse à laquelle vous consommez les crédits, pas d'un tarif d'entrée/sortie clair et prévisible. Ensuite, ce 10% est un prix promotionnel de preview, pas le prix à long terme.
J'ai passé des années à voir des équipes choisir un modèle sur son tarif affiché et se faire surprendre par la facture trois semaines plus tard. Pour tout ce dont vous dépendez réellement, surtout un agent de support, le prix du modèle est le petit poste. Ce guide passe en revue le vrai tarif de Qwen3.8-Max, le coût caché de la consommation de crédits, et comment y réfléchir avant de le brancher sur quoi que ce soit.
Pourquoi je lis cette étiquette de prix avec autant d'attention
Je construis et j'écris sur l'IA chez eesel, et deux années à faire du SEO m'ont appris que le chiffre que les gens recherchent (« tarif Qwen3.8-Max ») et celui qu'ils paient réellement sont rarement les mêmes. Mon quotidien est encore plus proche de cet écart : chez eesel, nous déployons depuis des années des modèles de pointe sur de vraies files de support, et la leçon qui revient sans cesse est que le prix du token n'est presque jamais ce qui détermine le coût réel de faire tourner de l'IA sur du travail réel.
Alors quand un modèle à 2,4 billions de paramètres arrive avec 10% de réduction, mon réflexe n'est pas « pas cher, on déploie ». C'est : dans quelle unité suis-je réellement facturé, à quelle vitesse s'épuise-t-elle, et qu'arrive-t-il au prix quand la fête se termine ? C'est l'angle de tout cet article. Si vous voulez les spécifications complètes et l'affirmation « juste derrière Fable 5 », l'article explicatif sur Qwen3.8-Max et le test pratique couvrent cela. Ici, on suit l'argent.
Ce que vous payez réellement
Un peu de contexte, car le prix n'a de sens que lorsqu'on connaît le palier. Qwen (Tongyi Qianwen) est la famille de modèles d'Alibaba Cloud, et « Max » est la ligne phare propriétaire, au-dessus des paliers moins chers Plus et Turbo, et au-dessus des checkpoints en poids ouverts de Qwen3. Qwen3.8-Max est le dernier modèle Max en date, présenté en preview sous le nom Qwen3.8-Max-Preview et décrit comme un modèle Mixture-of-Experts de 2,4 billions de paramètres qui traite du texte, des images, de la vidéo et des documents.
Le fait de prix important se cache dans ce suffixe « Preview » : il s'agit d'un lancement promotionnel, pas d'un produit stabilisé. Le tarif de 10%, l'absence de prix par token et la promesse de « poids ouverts bientôt » relèvent tous de l'état de preview. C'est important, car cela fait la différence entre un prix sur lequel on peut planifier une année entière et un prix qui peut changer sous vos pieds dès le mois prochain.
L'offre preview de Qwen3.8-Max, en une phrase
Voici ce que chaque développeur a répété : pendant la preview, Qwen3.8-Max tourne à 10% du tarif standard, accessible via trois canaux :
- Token Plan, l'abonnement à crédits d'Alibaba (la voie principale pour les particuliers).
- Qoder, le produit de codage agentique d'Alibaba.
- QoderWork, la version équipe/espace de travail du même produit.
Il n'existe aucun tarif par token indépendant publié. Pour un modèle de niveau Max, c'est inhabituel, et c'est le point le plus important à comprendre sur le tarif de Qwen3.8-Max : vous n'achetez pas des tokens à un tarif fixe, vous achetez des crédits sur un abonnement et vous les dépensez avec une remise preview.
Les paliers du Token Plan Personal
Le point d'entrée grand public est le Token Plan (Personal Edition). C'est un abonnement mensuel qui accorde une réserve de crédits, plafonnée de deux façons : un quota sur 7 jours et un quota glissant sur 5 heures (pour éviter de vider les crédits d'un mois entier en une après-midi).
| Palier | Mensuel | Quota de crédits sur 7 jours | Quota de crédits sur 5 heures |
|---|---|---|---|
| Lite | ~6 $ (39 CNY) | 2 500 crédits | 700 crédits |
| Standard | ~20 $ (139 CNY) | 10 000 crédits | 3 000 crédits |
| Pro | ~70 $ (499 CNY) | 40 000 crédits | 12 000 crédits |
Source : Alibaba Cloud Token Plan. Les montants en dollars sont des conversions approximatives des prix en CNY et évoluent avec le taux de change.
C'est le crédit, pas le dollar, qui constitue ici l'unité réelle. Un « crédit » correspond à une consommation de tokens, et le nombre de tokens qu'achète un crédit dépend du modèle et de la remise appliquée par-dessus. Ce qui nous amène à la partie qui rend le prix affiché presque gratuit.
La remise de nuit qui rend ça presque gratuit
En plus du tarif preview à 10%, Alibaba ajoute une remise de nuit : 80% supplémentaires sur la consommation de crédits entre 22h00 et 08h00 (UTC+8). En combinant les deux, les exécutions en heures creuses reviennent à environ 0,2% du tarif standard.
C'est une manœuvre agressive et délibérée. Elle est conçue pour pousser les développeurs à tester la preview à moindre coût, et si votre charge de travail peut être traitée par lots (évaluations, génération de jeux de données, tâches de codage nocturnes), la programmer dans la fenêtre nocturne UTC+8 est un vrai levier de coût. Si vous êtes sur le continent américain, la nuit en UTC+8 correspond à peu près à votre journée de travail, ce qui est soit pratique, soit inutile selon votre situation.
Le piège est le même que pour toute offre promotionnelle : elle vous montre le coût de la remise, pas le coût du produit. Prototypez à 0,2%, mais budgétisez à 100%.
Le coût caché que personne n'indique sur la page de tarifs
C'est la ligne que je soulignerais dans toute discussion sur le tarif de Qwen3.8-Max. Le modèle d'abonnement à crédits est exactement ce dont les utilisateurs de Qwen se plaignaient déjà auparavant.
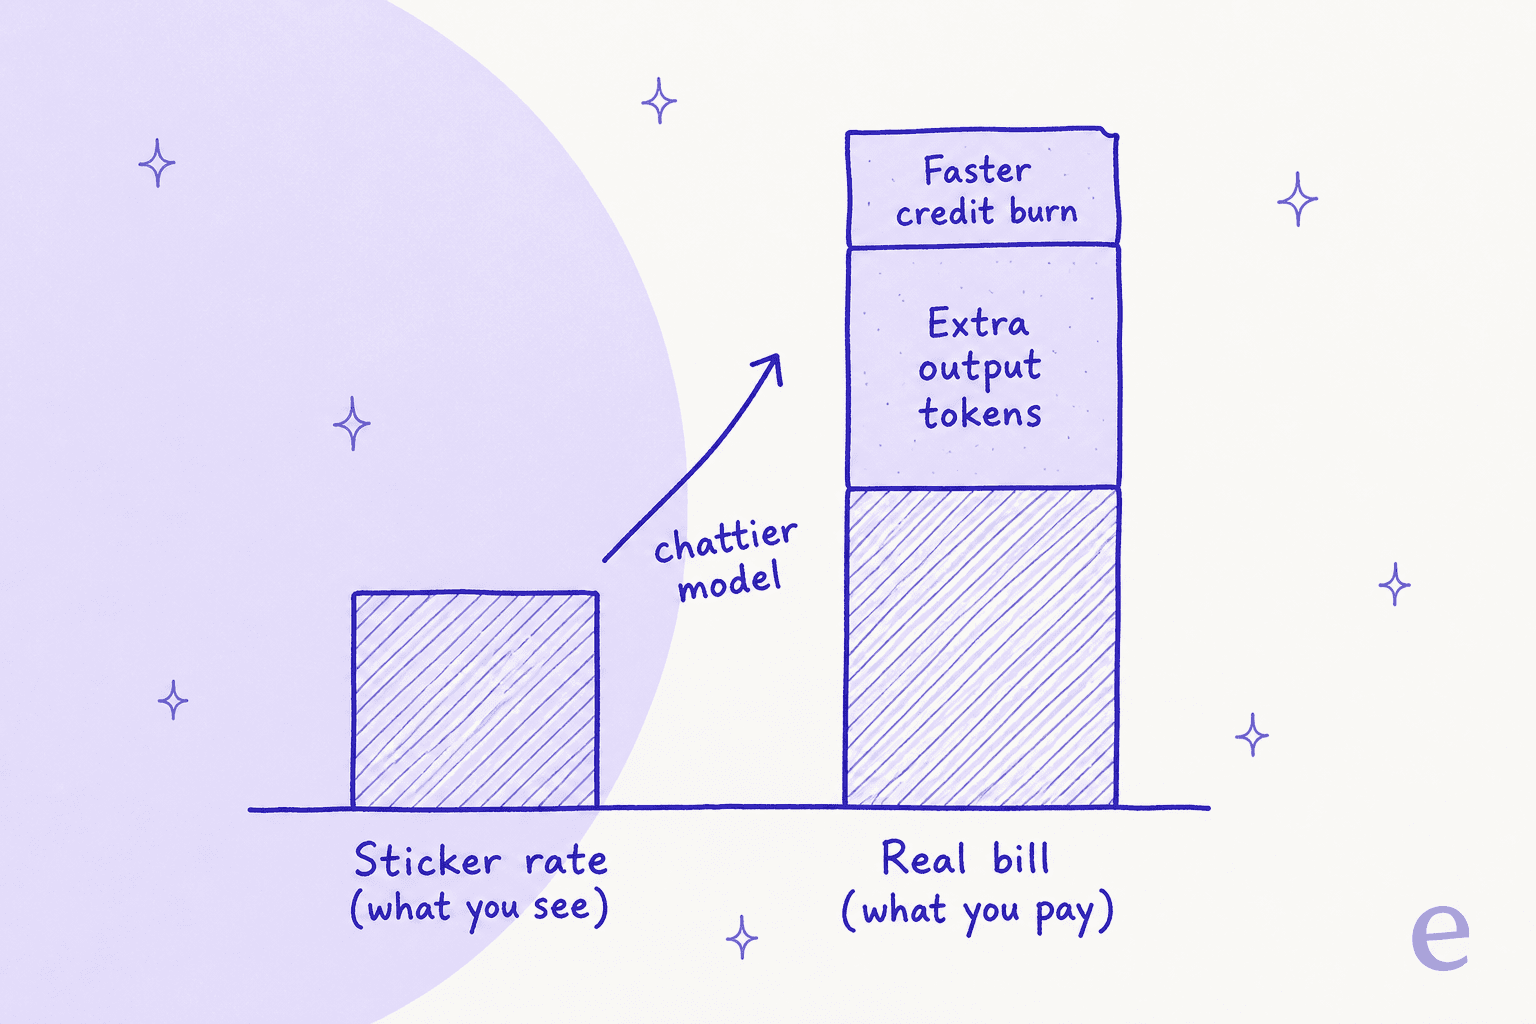
Sur la génération précédente, des utilisateurs de Reddit ont signalé des crédits qui s'épuisaient bien plus vite que prévu. Et il y a une raison structurelle à cela : les modèles Qwen ont tendance à générer plus de tokens de sortie par tâche que les modèles concurrents. Comme les tokens de sortie coûtent généralement plus cher que les tokens d'entrée et que la facturation se fait à la consommation, un modèle plus « bavard » gonfle discrètement la facture réelle même quand le tarif affiché paraît bas.
En combinant tout cela, la remise preview recouvre un modèle de facturation qui, historiquement, surprend les utilisateurs. Le tarif à 10% masque la consommation. Quand la preview se termine et que la remise disparaît avec elle, c'est cette consommation que vous allez réellement ressentir. La lecture honnête du tarif de Qwen3.8-Max est donc : bon marché à l'essai, imprévisible pour en dépendre, du moins jusqu'à ce qu'Alibaba publie un vrai tarif par token que l'on puisse anticiper.
Estimez votre propre coût de preview
Comme il n'y a pas de tarif par token clair, la chose la plus utile que je puisse vous offrir, c'est un moyen de sentir l'ampleur de la facture. Entrez une consommation mensuelle de crédits approximative et voyez comment la remise preview et la fenêtre nocturne changent ce que vous paieriez, comparé à une exécution au tarif standard.
Ce que l'estimateur transmet mieux qu'un paragraphe : la preview est étonnamment bon marché, mais « votre estimation » repose sur une remise, pas sur un prix. Modélisez aussi la colonne standard, car c'est celle dans laquelle vous vivrez plus tard.
Comment le prix se compare
En coût d'accès brut, la preview bat tout le monde, c'est tout l'objectif de sa conception. Mais la comparaison est justement là où le tarif par token manquant pose problème, car on ne peut pas aligner Qwen3.8-Max sur une grille tarifaire normale.
- Kimi K3, le fleuron à 2,8 billions de paramètres de Moonshot, tarifé à environ 3 $/15 $ par million de tokens en entrée/sortie. C'est la catégorie Sonnet, pas la catégorie bon marché, et il faut noter que c'est un tarif publié et prévisible. Kimi K3 est arrivé quelques jours avant Qwen3.8-Max, et le timing était clairement une réponse.
- Le modèle haut de gamme de Claude (Fable 5), le modèle auquel Alibaba se mesure, tarifé au-dessus de Kimi K3, également avec un tarif clairement publié.
- Qwen3.8-Max, le moins cher pour essayer, le moins clair pour budgétiser. Un abonnement à crédits avec une remise promotionnelle n'est pas le même type de chiffre que 3 $/15 $ par million de tokens.
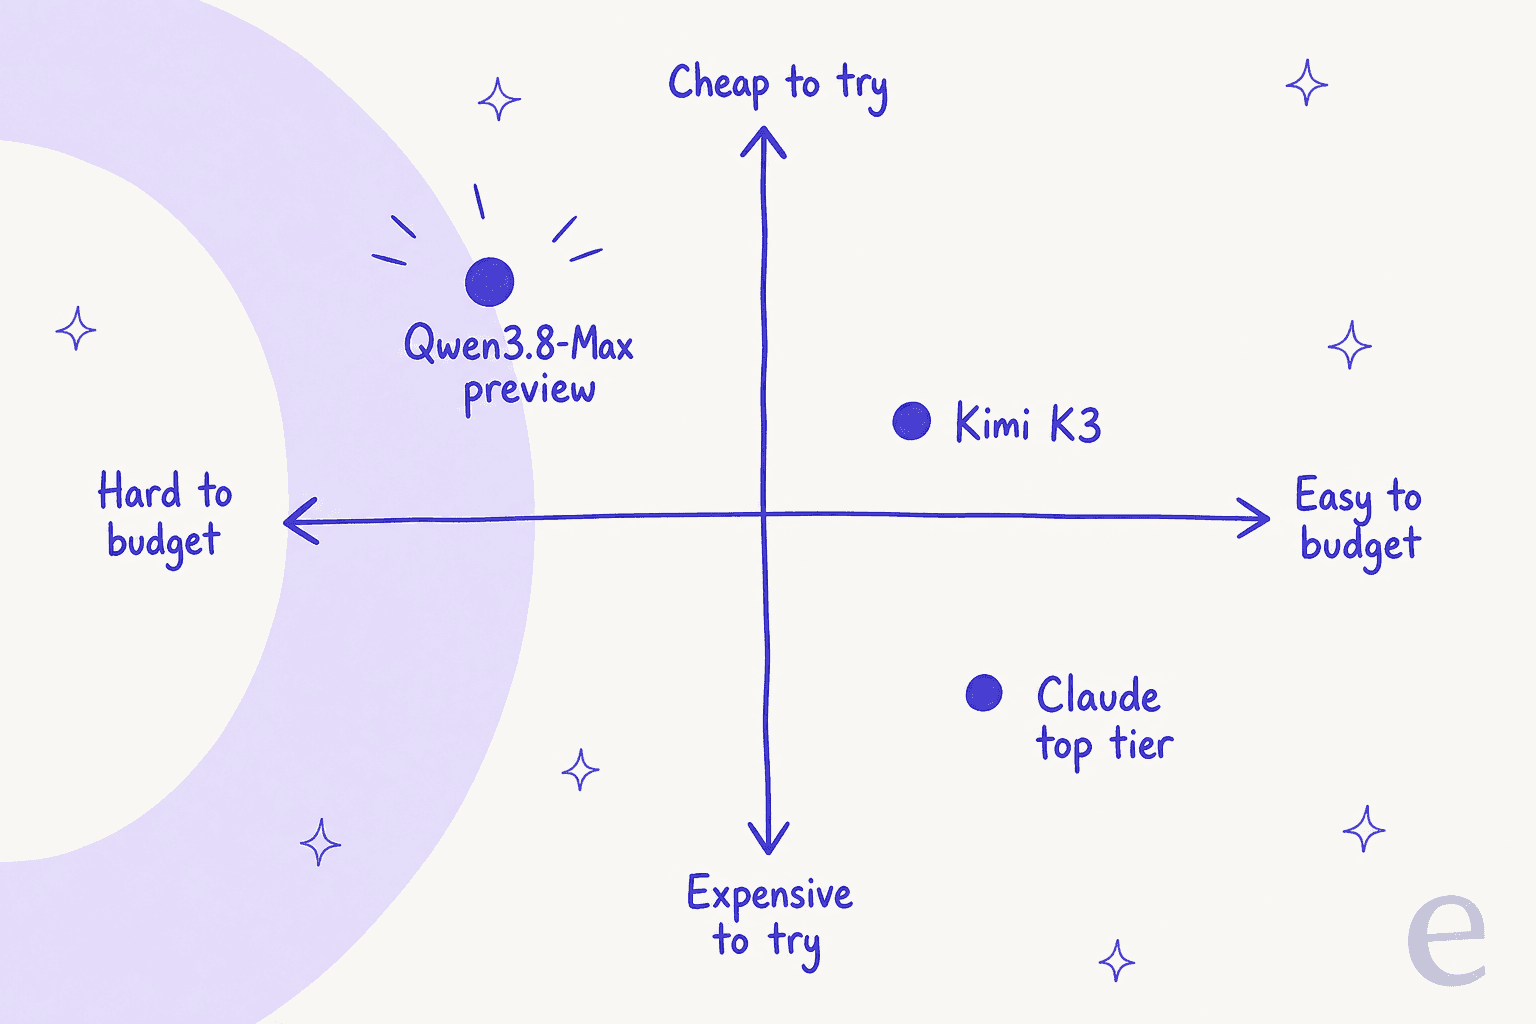
Si votre décision est « lequel est le moins cher pour expérimenter cette semaine », la preview gagne facilement. Si c'est « avec lequel puis-je anticiper une année de dépenses de production », Qwen3.8-Max est actuellement le plus difficile à évaluer, précisément parce que le tarif preview est une cible mouvante. Pour une vue plus large, le comparatif des meilleurs modèles d'IA et le guide des alternatives à Qwen sont de bonnes lectures complémentaires.
Là où le prix du modèle cesse de compter : le vrai travail
Voici la partie qui me tient le plus à cœur, car c'est l'erreur que je vois les équipes commettre à chaque nouveau modèle. Quand il s'agit de support client, le prix du modèle est le petit chiffre sur la facture.
Un modèle brut, aussi bon marché et intelligent soit-il, n'a aucune mémoire de vos tickets, aucun garde-fou et aucune connexion à votre helpdesk. Pour répondre à un vrai client, il a besoin de votre base de connaissances, de vos politiques, de règles d'escalade et d'un moyen de router vers un humain en cas d'incertitude. Construire et maintenir cette couche, c'est là que se trouve le coût réel, pas dans la différence entre 10% et 100% d'un tarif de token. Un client d'eesel a résumé clairement le choix entre construire et acheter :
"We could try to write our own LLM application, but we didn't want to invest our time into that. We wanted something we wouldn't have to maintain."
a mid-market support lead evaluating build vs buy
C'est la bonne nouvelle discrète à propos de Qwen3.8-Max, Kimi K3, ou de tout autre modèle qui dominera le classement le mois prochain. Une IA pour le service client bien construite hérite de chaque progrès de pointe sans que vous ayez à retoucher la moindre tuyauterie, et son prix est lié aux tickets résolus, pas à un solde de crédits preview à surveiller.
C'est ce vide que comble eesel AI. Il enveloppe un modèle de pointe avec vos connaissances et vos garde-fous, se connecte à Zendesk, Freshdesk et plus encore, et, l'élément qui compte pour le coût, simule sur vos tickets historiques avant toute mise en production, afin que vous voyiez d'abord le taux de résolution et les réponses exactes sur de vraies conversations passées.
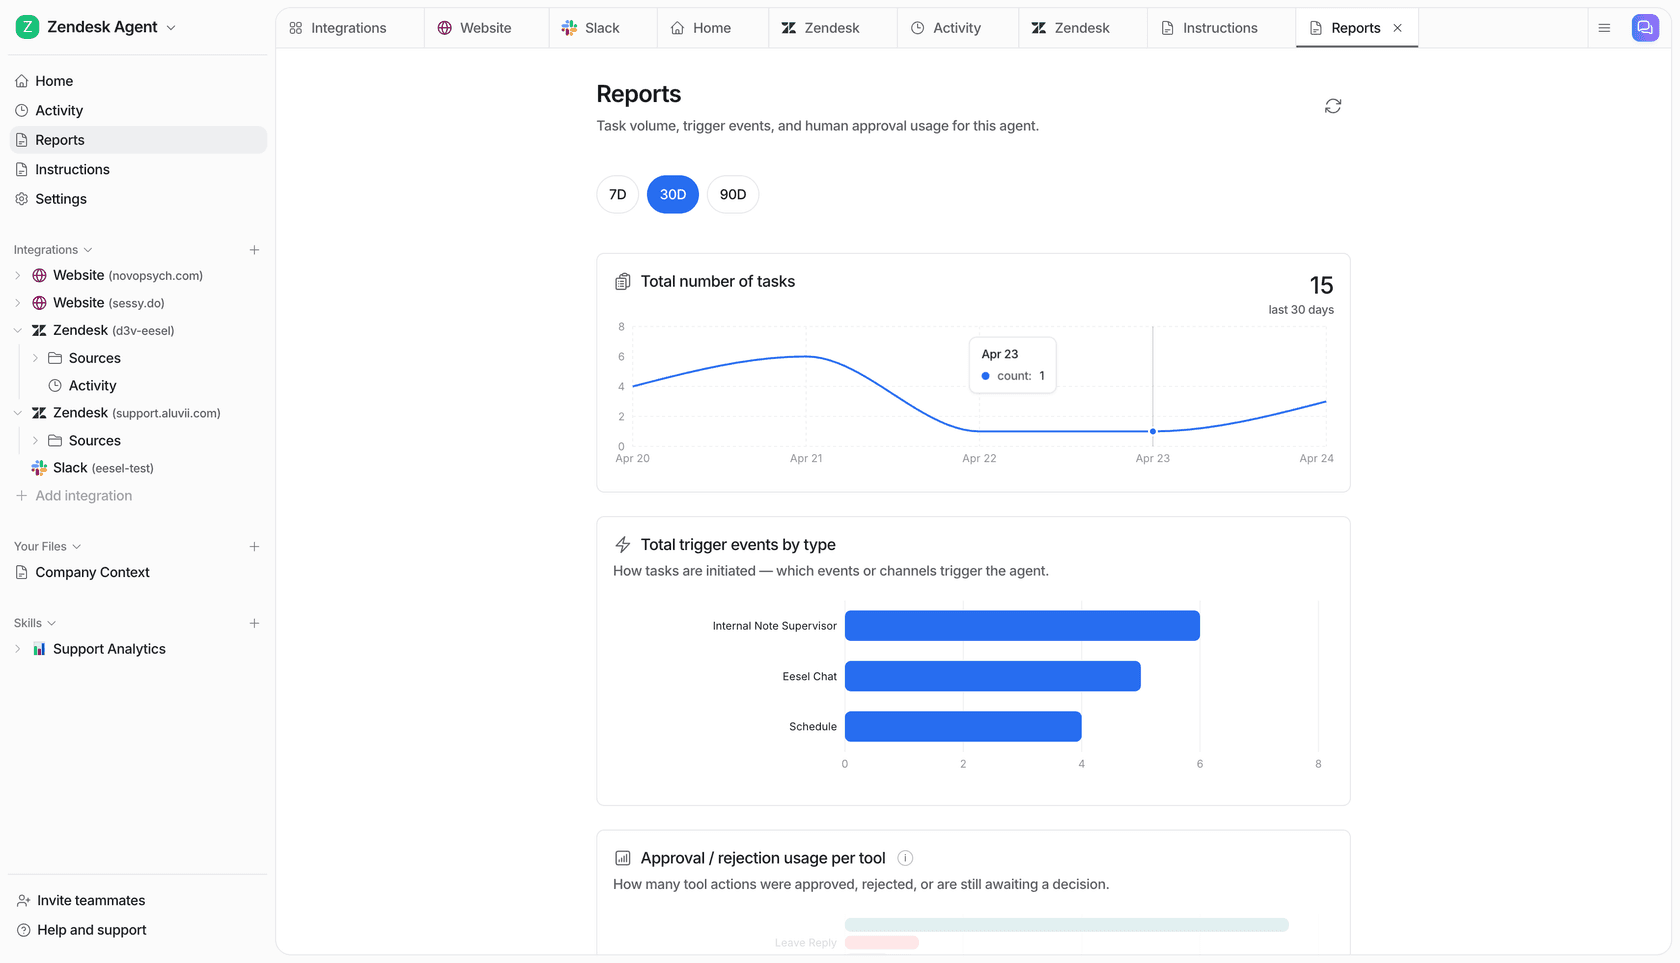
Envie d'un agent IA qui transforme n'importe quel modèle de pointe en vraie résolution de tickets ? Essayez eesel gratuitement, sans carte bancaire.
Le bilan sur les tarifs de Qwen3.8-Max
La preview est un moyen économique de tester un modèle multimodal à 2,4 billions de paramètres : 10% du tarif standard, descendant à ~0,2% la nuit. Traitez cela comme un essai, pas comme un plan. Les deux points à surveiller sont le tarif par token manquant (impossible de prévoir proprement avec un abonnement à crédits) et la consommation de crédits historique que la remise masque pour l'instant. Prototypez maintenant, budgétisez pour le vrai tarif plus tard, et si le travail concerne le support, rappelez-vous que le prix du modèle n'a jamais été le chiffre qui comptait.
Comment le tarif de Qwen3.8-Max se compare-t-il à Kimi K3 et Claude ?