

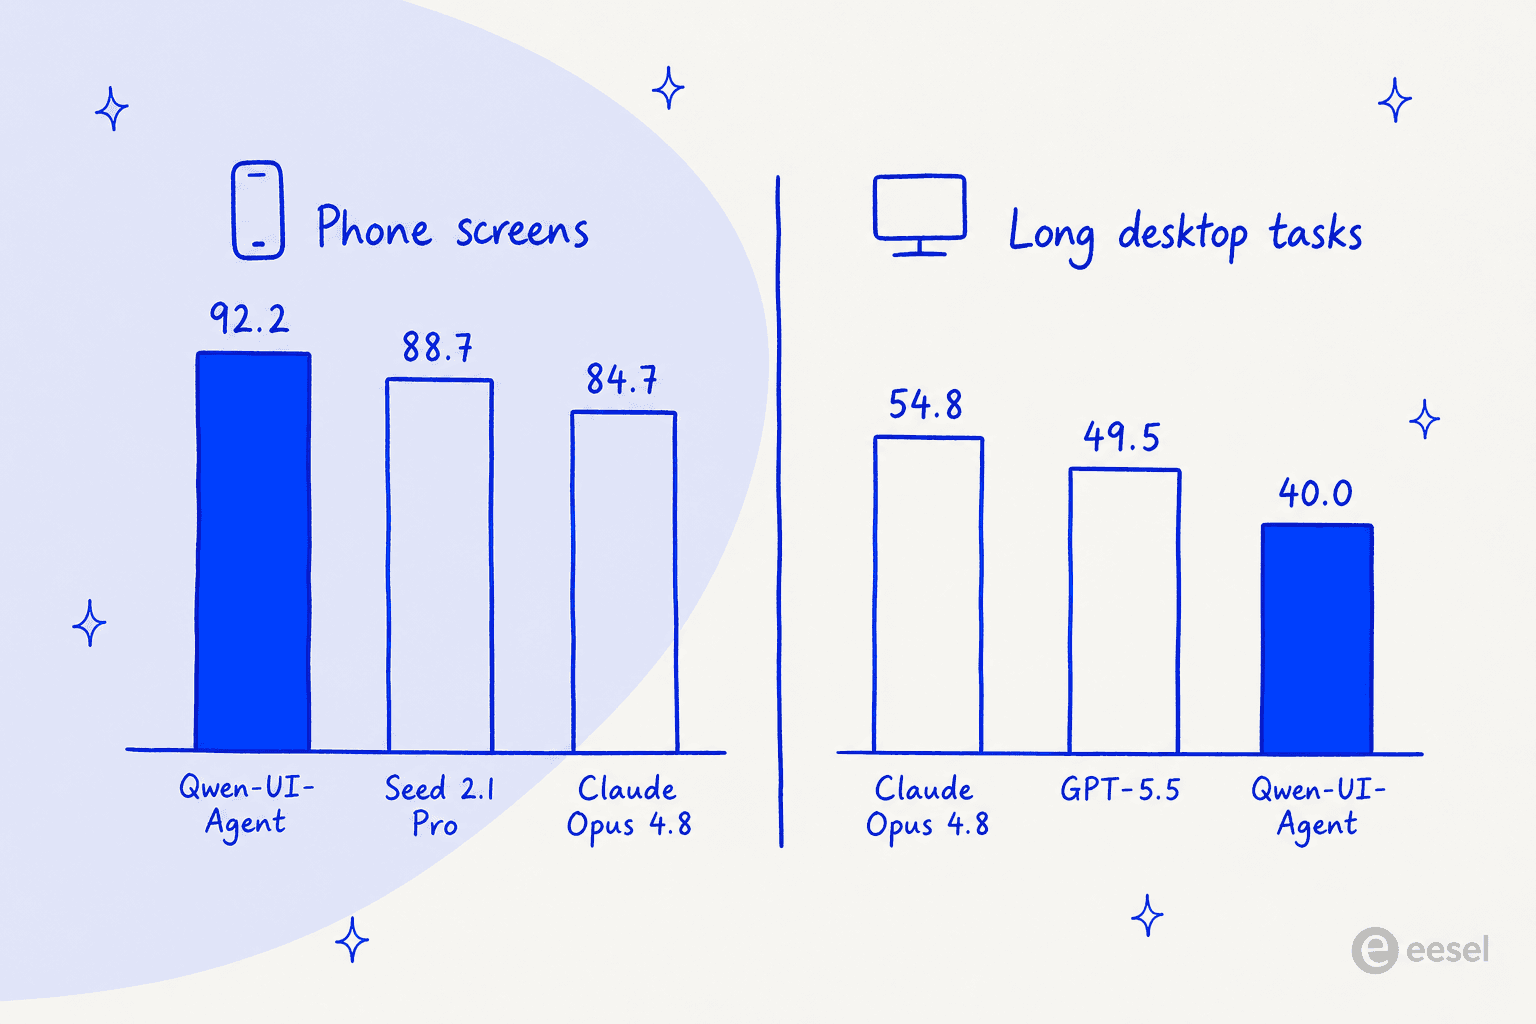
Sur téléphone, rien de publié ne le bat. 92,2 % sur MobileWorld-Real, un benchmark de 400 tâches exécuté sur des appareils Android physiques, devant Seed 2.1 Pro, Gemini 3.1 Pro, GPT-5.6 Sol et Claude Opus 4.8. C'est Qwen-UI-Agent, le nouvel agent GUI de base d'Alibaba. L'ingénierie en dessous est pourtant ce à quoi je suis le plus revenu. Un espace d'actions qui mêle clics à l'écran et commandes Bash. Des actions groupées, si bien que plusieurs choses se produisent par tour du modèle. Et de l'apprentissage par renforcement en ligne sur des trajectoires de plus de 100 étapes.
Puis il y a le chiffre de bureau, que personne ne cite. Sur OSWorld-v2, l'ensemble d'usage d'ordinateur à horizon long, Qwen-UI-Agent obtient 40,0 % de progression partielle contre 54,8 % pour Claude Opus 4.8. Donc : un agent de téléphone, compétitif sur le bureau. Pas un pilote d'écran généraliste qui se trouve être bon sur téléphone. Il vaut mieux le savoir avant de lire « état de l'art » et de supposer que cela vaut partout.
Ce qui décide si tout cela compte pour vous : vous ne pouvez pas l'exécuter. Pas de poids sur Hugging Face. Pas de point d'accès hébergé, et pas de tarifs non plus. Je construis chez eesel des agents IA qui agissent dans de vraies files de support, et après plus de trois ans à mettre des agents sur des tickets en direct, la leçon qui me reste est qu'un score vous donne un plafond et ne dit rien d'un plancher. Ce qui fait vraiment passer un agent devant un responsable support, c'est de le prouver sur son propre historique avant qu'il ne touche un client, c'est pourquoi chaque déploiement eesel commence par une simulation sur d'anciens tickets plutôt que par un lancement.
Ce qu'est vraiment Qwen-UI-Agent
Qwen-UI-Agent est un seul modèle qui pilote un logiciel comme le ferait une personne, en regardant l'écran et en cliquant dessus. Il vient de l'équipe MAI-UI au sein du laboratoire Tongyi d'Alibaba, et c'est le successeur direct de MAI-UI 1.0, qui avait livré des checkpoints 8B et 2B en décembre 2025. Si vous voulez d'abord la vue d'ensemble d'Alibaba, notre présentation de Qwen et notre avis sur Qwen couvrent la famille de modèles.
L'article est paru sur arXiv le 30 juillet 2026 et est presque aussitôt devenu l'article numéro un du jour sur Hugging Face, où il compte désormais 308 votes positifs. Le site du projet le présente comme un agent qui « réfléchit, cherche et agit sur mobile, bureau et web ».
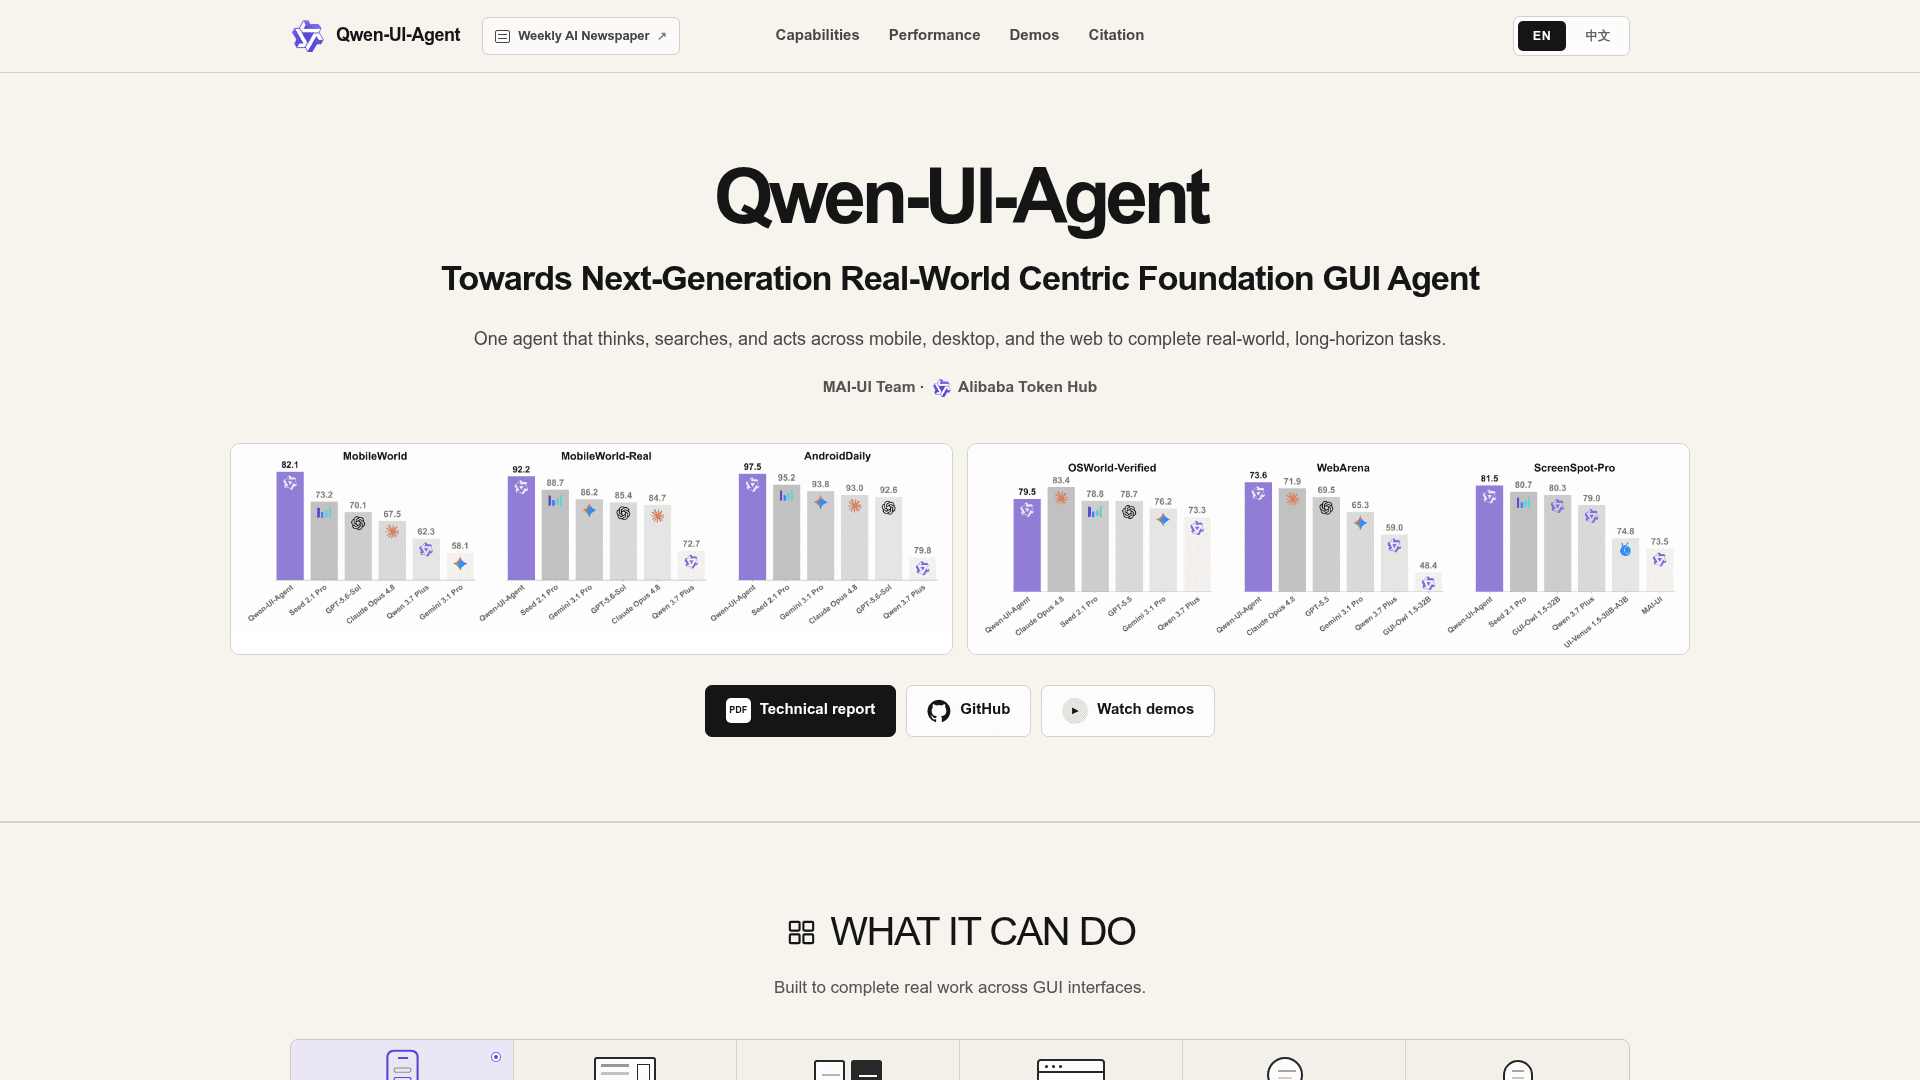
Regardez les trois boutons sous les graphiques. Rapport technique, GitHub, voir les démos. C'est toute la surface de distribution pour l'instant, et j'y reviendrai.
Quatre scénarios vivent dans un seul modèle. Usage de GUI mobile et usage d'ordinateur, plus usage de navigateur, puis ce qu'Alibaba appelle DeepSearch. Ce dernier est le comportement de recherche approfondie et il n'est pas greffé après coup. L'agent peut quitter une application, aller vérifier quelque chose sur le web ouvert, puis revenir dans l'application pour agir selon ce qu'il a trouvé. L'une des démos publiées le montre en train d'extraire des affirmations d'une vidéo sociale, de les confronter à des articles de recherche, puis de revenir écrire un commentaire qui nomme le problème précis.
Si la catégorie elle-même est nouvelle pour vous, nos articles sur les agents IA et sur les agents face aux chatbots couvrent le terrain plus vite que l'article scientifique. Pour le côté licences permissives du domaine, il y a aussi notre tour d'horizon des agents IA open source.
Comment ça marche sous le capot
C'est la partie que je trouve la plus intéressante en tant que personne qui construit des agents pour vivre, parce que trois des choix de conception ne sont pas évidents, et que les trois visent le même mode de défaillance.
GUI et CLI dans un seul espace d'actions
La plupart des agents d'écran ne savent que cliquer. Qwen-UI-Agent peut cliquer ou exécuter une commande Bash, et il choisit entre les deux dans un seul espace d'actions unifié. Le propre rapport d'Alibaba sur les tâches d'usage d'ordinateur dit que les commandes CLI et les clics GUI émergent comme les deux types d'actions dominants, ce qui est une façon polie de dire que le modèle a compris que certaines tâches coûtent bien moins cher en une commande shell qu'en trente clics.
Quiconque a déjà regardé un agent de navigateur essayer de renommer quarante fichiers en les faisant glisser comprendra tout de suite pourquoi cela compte.
Actions groupées
Plutôt que d'émettre une action, d'attendre une capture d'écran puis de réfléchir à nouveau, le modèle émet plusieurs actions au sein d'une seule décision. Alibaba rapporte qu'environ 40 % des sorties d'actions sont groupées dans les tâches d'usage d'ordinateur.
L'implication en coût est bien réelle. Chaque tour d'un agent d'écran signifie une nouvelle capture qui entre dans le contexte, et les captures sont des tokens chers. Diviser par deux le nombre de tours sur une longue tâche fait la différence entre un flux viable et un flux qui mange discrètement votre budget, ce qui est la même arithmétique que derrière le coût des agents IA à grande échelle.
Entraîné sur de vrais téléphones, pas seulement sur des simulateurs
C'est l'affirmation phare, et c'est aussi celle que je voudrais vérifier le plus si je le pouvais. Alibaba dit avoir construit un environnement mobile en direct de plus de 100 smartphones physiques couvrant plus de 150 applications, et l'avoir utilisé pour la construction de tâches, la collecte de trajectoires, l'entraînement et l'évaluation. Il a aussi construit son propre benchmark sur cette flotte, MobileWorld-Real, avec plus de 400 tâches sur plus de 100 applications.
Le but déclaré est de combler l'écart entre simulation et réel, et la conception s'attaque bien à ce qui rend les scores de simulateur trompeurs. Les vraies applications ont des indicateurs de chargement, des mises en page testées en A/B, des sessions expirées, des instabilités réseau qu'un bac à sable ne reproduit jamais.
L'entraînement exécute ensuite de l'apprentissage par renforcement en ligne sur des trajectoires de plus de 100 étapes, avec environ 10 000 environnements déployés simultanément. Tout cela est alimenté par un cycle de données de type AutoResearch, où des agents construisent les tâches, les environnements et les vérificateurs, diagnostiquent leurs propres échecs, puis planifient l'itération suivante.
Un harness pour le travail proactif
La dernière pièce est une couche de harness légère qui permet à l'agent de démarrer un travail à partir d'un signal du monde réel plutôt que d'un prompt. La démo d'Alibaba est une notification de vol annulé. L'agent la remarque, ouvre des applications de voyage en direct, compare vols et trains avec la réunion de 14 h de l'utilisateur, puis revient avec des options classées. Il ne réserve pas, ce qui mérite d'être signalé. Il présente une décision, puis s'arrête.
Cette retenue est le bon réflexe, et c'est le même que celui des bonnes pratiques de transfert d'agent IA en support. Google a pris la direction opposée avec Chrome auto-browse, qui agit dans le navigateur au lieu de demander d'abord.
Les résultats des benchmarks, lus honnêtement
C'est ici que l'histoire se scinde en deux.
Sur téléphone, il gagne nettement
| Benchmark mobile | Qwen-UI-Agent | Seed 2.1 Pro | Gemini 3.1 Pro | GPT-5.6 Sol | Claude Opus 4.8 |
|---|---|---|---|---|---|
| MobileWorld | 82.1 | 73.2 | 58.1 | 70.1 | 67.5 |
| MobileWorld-Real | 92.2 | 88.7 | 86.2 | 85.4 | 84.7 |
| AndroidDaily | 97.5 | 95.2 | 93.8 | 92.6 | 93.0 |
La marge sur MobileWorld est celle qui me frappe le plus. Près de neuf points d'avance sur le modèle suivant, et plus de 14 points d'avance sur GPT-5.6 Sol, sur un benchmark dont les tâches impliquent des échanges interactifs agent-utilisateur plutôt qu'une exécution à l'aveugle. Ce ne sont pas des écarts d'arrondi.
Sur le bureau, il est compétitif, puis il ne l'est plus
| Benchmark ordinateur et navigateur | Qwen-UI-Agent | Claude Opus 4.8 | GPT-5.5 | Gemini 3.1 Pro |
|---|---|---|---|---|
| OSWorld-Verified | 79.5 | 83.4 | 78.7 | 76.2 |
| OSWorld-v2 (progression partielle) | 40.0 | 54.8 | 49.5 | non rapporté |
| WebArena | 73.6 | 71.9 | 69.5 | 65.3 |
OSWorld-Verified est un échec de peu. Quatre points derrière Claude Opus 4.8, mais toujours devant GPT-5.5 et Gemini 3.1 Pro. WebArena, il le prend de bout en bout. Puis OSWorld-v2, l'ensemble à horizon long, ouvre un écart de 14,8 points face à Opus 4.8.
Le schéma colle avec ce que l'entraînement mobile laisse entendre. Les tâches de téléphone sont courtes, bornées et très pratiquées dans cette flotte d'appareils réels. Les longs flux de bureau sont l'endroit où les modèles dérivent, et la dérive est la chose la plus difficile à éliminer par l'entraînement. Le résumé même d'Alibaba emploie le mot « compétitif » pour l'usage d'ordinateur et « état de l'art » seulement pour le mobile. C'est une description juste, que la plupart des articles aplatissent ensuite en une seule affirmation.
Le grounding, c'est là qu'il rafle tout
Le grounding est la compétence ennuyeuse qui décide si quoi que ce soit plus haut fonctionne vraiment. Le modèle peut-il poser le curseur sur le bon pixel ? Qwen-UI-Agent mène tous les benchmarks de grounding du rapport : 81,5 % sur ScreenSpot-Pro avec zoom, 76,6 % sans zoom, 97,5 % sur SS-V2, 70,0 % sur UI-Vision.
Le chiffre sans zoom est le plus honnête ici. Le zoom est une astuce de harness qui recadre puis réexamine l'écran, donc un modèle qui ne gagne qu'avec lui s'appuie sur de l'échafaudage. Gagner sans lui signifie que la perception elle-même est réelle.
Et le modèle général en dessous ?
Alibaba rapporte aussi que l'entraînement GUI n'a pas lobotomisé le modèle de base, et publie une comparaison avec Qwen3.5-27B pour le prouver.
| Benchmark général | Qwen-UI-Agent | Qwen3.5-27B |
|---|---|---|
| MMLU-Pro | 86.5 | 86.0 |
| MMMU-Pro | 72.4 | 73.5 |
| MathVision | 82.8 | 82.0 |
| IFEval (strict) | 90.2 | 90.4 |
| Tau2-Bench | 89.9 | 89.2 |
| Terminal-Bench 2.0 | 50.1 | 41.1 |
| BrowseComp-ZH | 75.0 | 62.1 |
Terminal-Bench qui gagne neuf points et BrowseComp-ZH treize, c'est ce à quoi on s'attend d'un modèle à qui l'on a appris à utiliser un shell et à chercher. Le petit recul sur MMMU-Pro et IFEval en est la taxe, et c'est une petite taxe. Une ligne va dans l'autre sens : QwenClawBench passe de 48,5 à 44,2, ce que le rapport publie au lieu de le cacher.
Ce que les chiffres ne disent pas
Trois réserves. À l'honneur d'Alibaba, deux d'entre elles viennent d'Alibaba lui-même.
Chaque score a été reproduit dans l'environnement propre aux auteurs. La note d'évaluation sur le site du projet le dit directement, puis ajoute que certains réglages de harness, de juge, de simulateur, de runtime ou de sous-ensemble de tâches diffèrent des évaluations officielles. Plusieurs lignes de concurrents portent une dague indiquant qu'elles ont été reproduites par les auteurs plutôt que copiées du rapport du fournisseur. C'est plus de transparence que la plupart des lancements de modèles ne se donnent la peine d'en avoir, et cela signifie aussi que ce ne sont pas les mêmes conditions que celles sous lesquelles les fournisseurs ont publié.
Les démos reposent sur l'écosystème d'applications chinois. Douyin, Hema, Trip.com, Amap, Dianping, Xiaohongshu, 12306, DingTalk, Beike. L'ingénierie se généralise. Les 92,2 % précis ne se transposent pas automatiquement à une flotte de téléphones qui font tourner Slack, Shopify et Gmail. Si vos flux relèvent du SaaS occidental, considérez ce chiffre mobile comme un signal fort sur la méthode, et non comme une promesse sur vos propres applications.
Le dépôt du site trahit l'état de la sortie. Le dépôt du site du projet lui-même contient encore une consigne d'édition demandant de remplacer les cartes de ressources « bientôt disponible » par les URL finales du rapport, du code et des checkpoints au moment de la sortie, ainsi qu'une note indiquant que les chiffres de résultats en conflit dans le brouillon sont volontairement omis tant que les valeurs ne sont pas figées. C'est un projet encore en cours, et non un produit livré.
Peut-on vraiment l'exécuter aujourd'hui ?
Non. Et c'est la section que je lirais en premier à votre place.
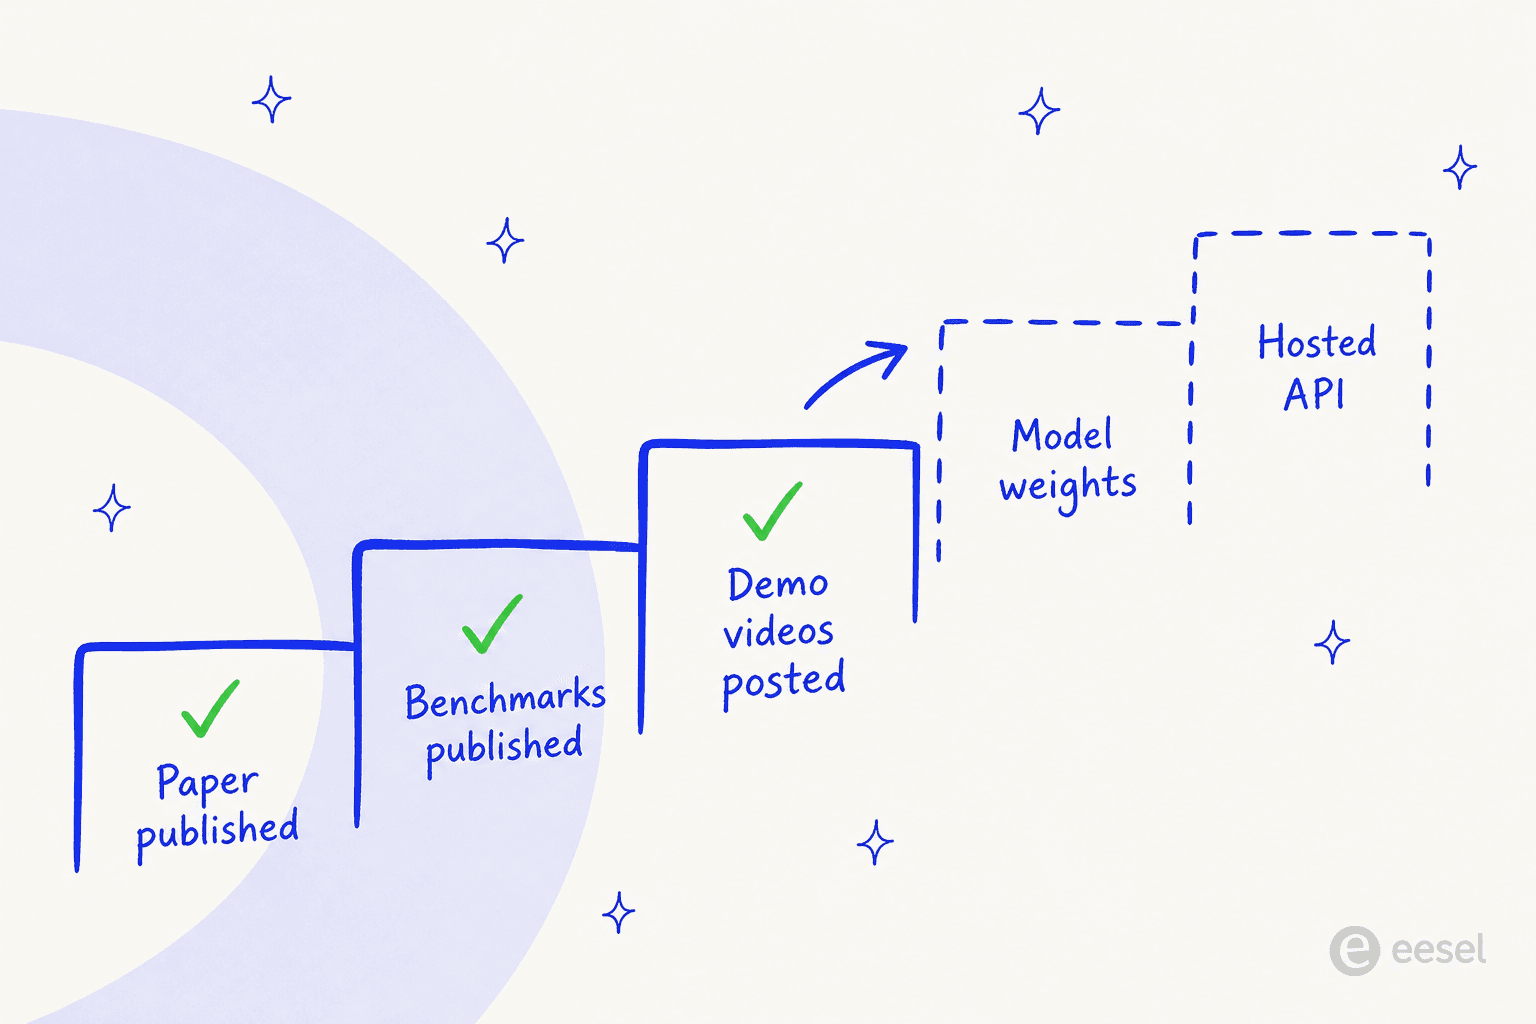
Voici ce que j'ai vérifié, le 24 août 2026 :
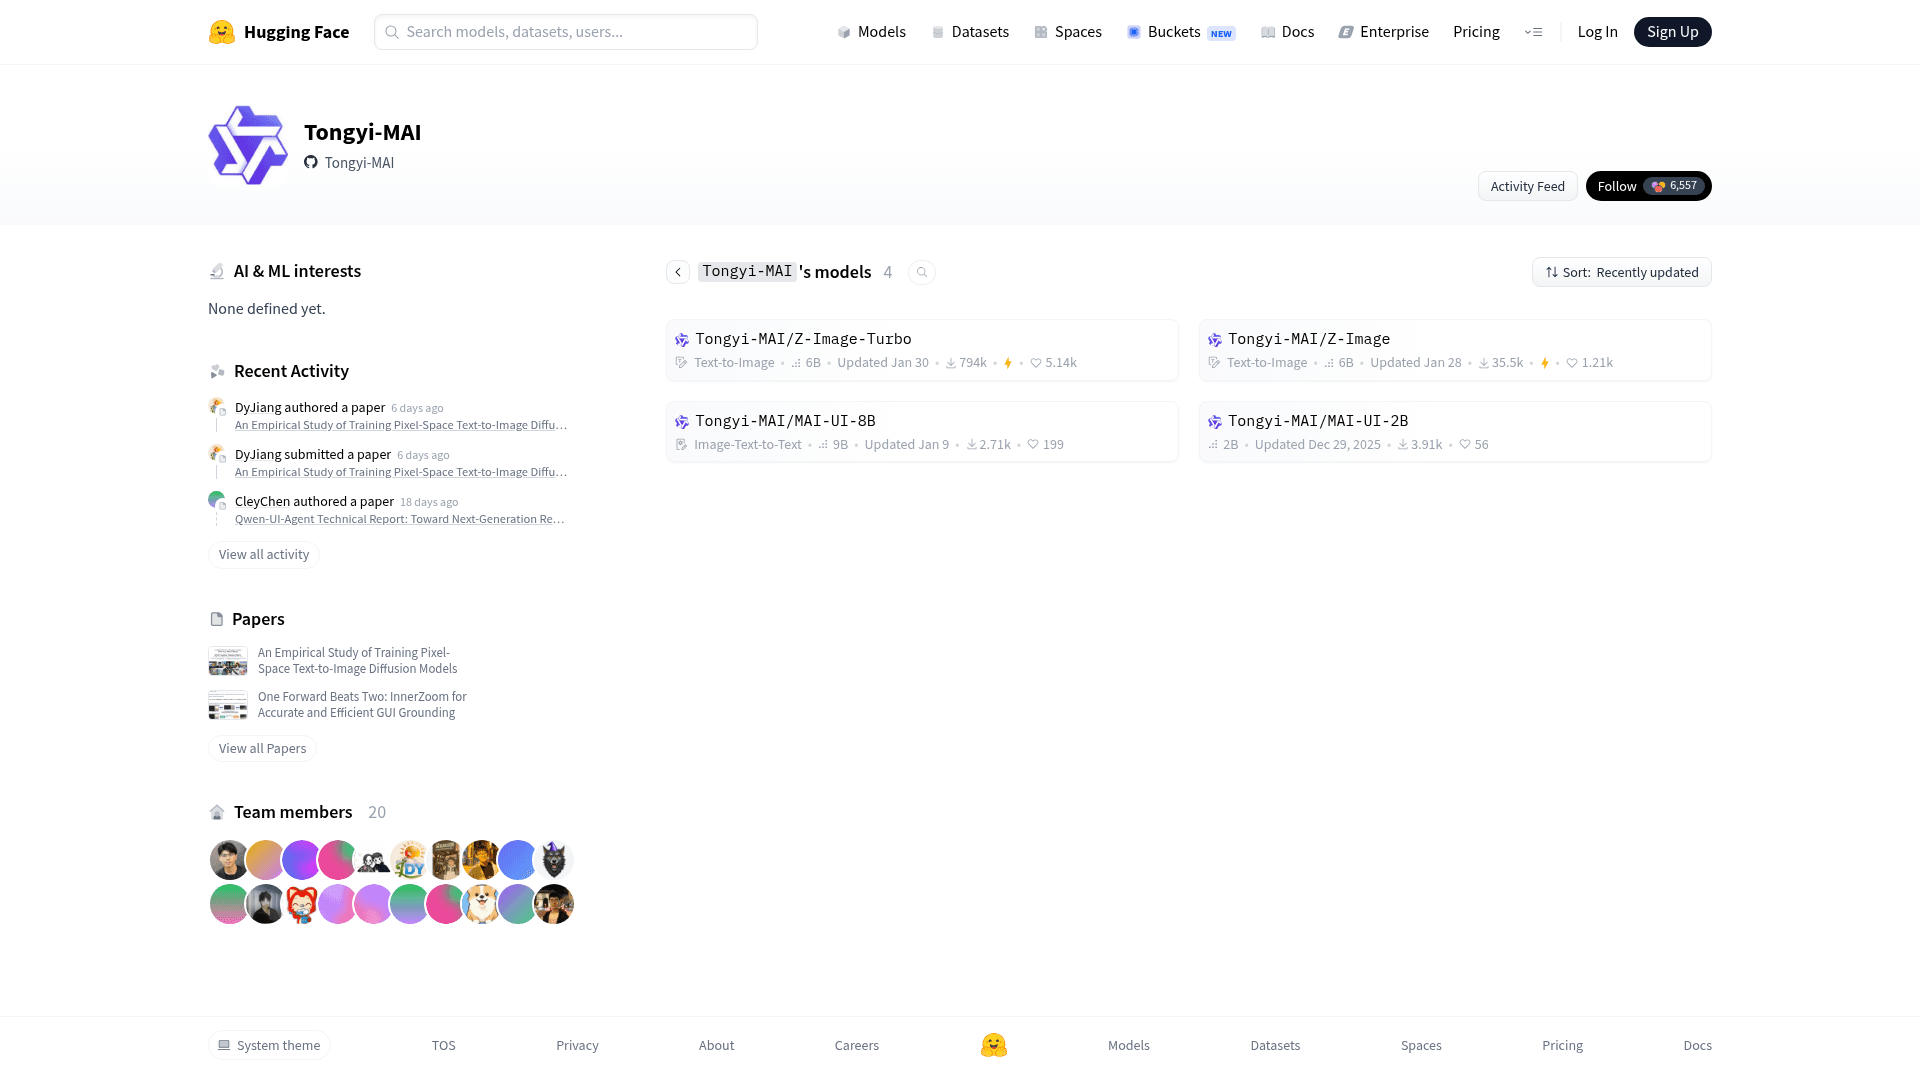
- L'organisation Tongyi-MAI sur Hugging Face liste quatre modèles : Z-Image, Z-Image-Turbo, MAI-UI-8B et MAI-UI-2B. Pas de Qwen-UI-Agent.
- La page de l'article rapporte zéro modèle, zéro jeu de données et zéro Space liés.
- Le dépôt GitHub nommé Qwen-UI-Agent ne contient que le code source du site web, et le précise en gras en haut de son readme.
- Le dépôt d'implémentation, Tongyi-MAI/MAI-UI, compte 2,2k étoiles et n'a aucune release, aucun tag et aucun lien de checkpoint pour ce modèle.
- Il n'y a aucune entrée Qwen-UI-Agent dans le catalogue de modèles d'Alibaba, donc ni point d'accès ni grille tarifaire.
Le seul signe encourageant est le précédent. La même équipe a publié MAI-UI 8B et 2B en décembre 2025, et le readme indique que le projet est sous licence Apache 2.0. Alibaba a aussi livré des poids pour sa gamme phare, comme le couvre notre avis sur Qwen 3.8 Max. Une publication ouverte est donc assez plausible. Simplement, ce n'est pas quelque chose sur lequel on peut planifier un trimestre.
Si vous avez besoin de quelque chose d'appelable ce mois-ci, la courte liste pratique passe par les alternatives à Qwen et Kimi K3. Pour une option ouverte moins chère, il y a DeepSeek V4 Flash.
Ce que cela signifie si vous gérez une file de support
Je veux être prudent dans cette section, parce que « un agent GUI obtient 89,9 sur un benchmark de support » est exactement le genre de titre qui finit dans une présentation pour le conseil d'administration.
Tau2-Bench est un vrai benchmark, et 89,9 y est un bon score. Mais regardez ce qu'il mesure face à ce dont un responsable support a réellement besoin. Lors des appels, j'entends sans cesse les mêmes exigences. Entraînez-le sur nos propres anciens tickets. Mettez une citation sur chaque réponse. Et laissez-nous voir ce qu'il aurait fait, avant qu'il ne le fasse. Un agent qui pilote l'écran ne peut structurellement pas offrir la deuxième ni la troisième. Il clique. Il n'y a pas d'objet réponse auquel rattacher une source, et il n'existe pas non plus de mode à blanc pour une souris, ce qui explique pourquoi la prévention des hallucinations en support commence par le périmètre et non par le choix du modèle.
Une équipe de support matériel à qui j'ai parlé, traitant environ 250 tickets par mois dans Zendesk en plusieurs langues, a fait des citations une exigence stricte avant que quoi que ce soit ne passe en production. Une autre, une société de services informatiques du secteur public qui perd deux agents seniors cette année, voulait que l'IA soit entraînée sur ses propres tickets résolus, précisément pour que le savoir de ceux qui partent ne s'en aille pas avec eux. Aucun des deux n'est un problème d'écran. Ce sont tous deux des problèmes de récupération et de gouvernance, plus proches des questions de quel LLM convient au support que de quoi que ce soit dans cet article, ce qui explique pourquoi le meilleur modèle d'IA pour les tickets de support est rarement le plus gros.
Le schéma qui fonctionne vraiment est ennuyeux, et il tient pour presque tous les déploiements que j'ai vus. Démarrer en mode brouillon, où l'IA rédige et un humain envoie. Puis passer à l'automatisation complète une fois que les chiffres l'ont mérité. C'est la forme du travail d'assistance d'agent IA, et c'est pourquoi la containment et la qualité d'escalade prédisent mieux le succès d'un déploiement que n'importe quel benchmark de cette page. L'assurance qualité du support est l'autre moitié de cette boucle.
Là où un agent GUI gagne vraiment sa place, c'est dans la longue traîne des opérations internes pour lesquelles personne n'a jamais construit d'API. Un panneau d'administration hérité. Un portail fournisseur, ou un outil interne de 2014. C'est une vraie valeur, et elle est sous-estimée. C'est simplement un autre travail que de résoudre des tickets clients, de la même façon que l'automatisation des flux de travail est un autre travail que la déviation de tickets.
Où eesel s'intègre
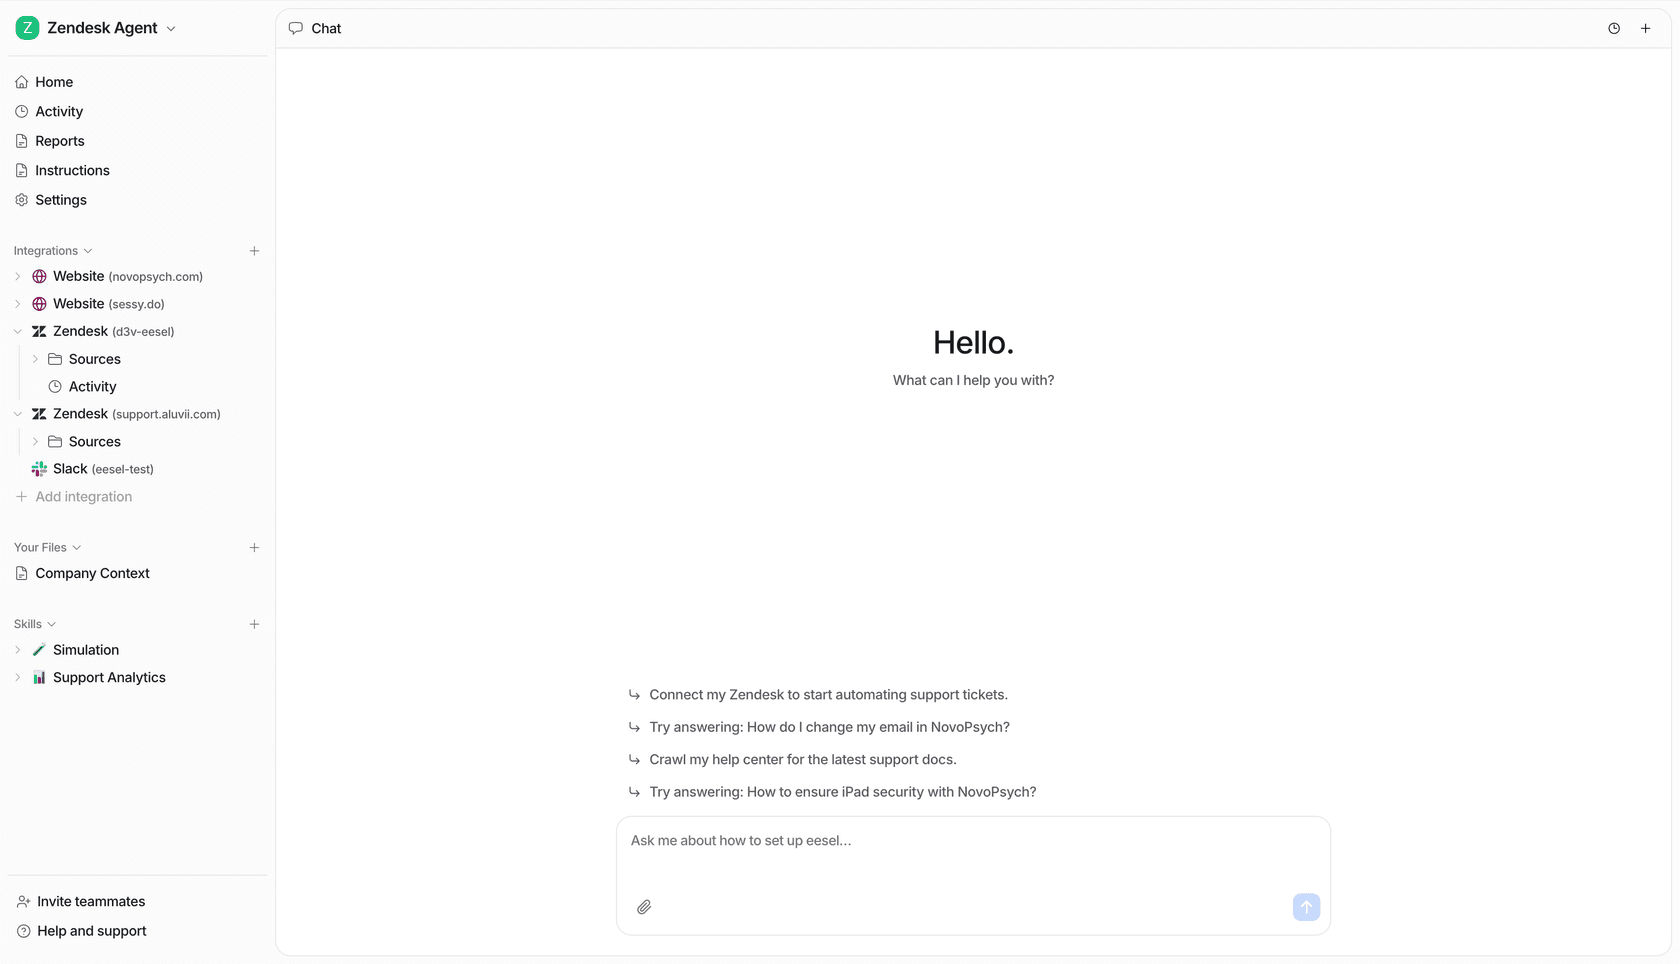
Si vous lisez un article sur les agents GUI parce que ce que vous voulez vraiment, c'est une file de helpdesk plus petite, le raccourci consiste à sauter entièrement la couche d'écran. eesel se connecte directement à Zendesk, Freshdesk, Gorgias et le reste, apprend de vos propres anciens tickets et de votre centre d'aide plutôt que d'une exploration publique, et cite la source de chaque réponse. Il se comporte moins comme un pilote d'écran et plus comme le cadre des coéquipiers IA et de l'employé IA que nous utilisons pour ce travail.
Ce qui compte le plus pour cette comparaison : vous pouvez l'exécuter en simulation sur des milliers de vos tickets historiques et lire exactement ce qu'il aurait répondu, avant qu'un seul client ne le voie. C'est l'étape « prouvez d'abord » qu'un score de benchmark ne remplacera jamais, et elle prend quelques minutes au lieu d'un cycle d'achat. Essai gratuit.
À qui s'adresse Qwen-UI-Agent
À suivre de près si vous construisez de l'automatisation mobile, faites de l'assurance qualité sur de vrais appareils Android, ou étudiez les agents GUI et voulez la méthode actuellement la mieux documentée. La boucle d'entraînement sur appareils réels et l'espace d'actions GUI plus CLI sont les deux idées les plus susceptibles de réapparaître dans la prochaine version de tout le monde.
À ignorer pour l'instant si vous avez besoin de quelque chose en production ce trimestre. Il n'y a rien à déployer. Lisez l'article, notez la technique et revenez quand un checkpoint apparaîtra. En attendant, Qwen 3.7 Flash est le modèle d'Alibaba que vous pouvez réellement appeler.
À aborder avec scepticisme si vos charges de travail sont de longs flux de bureau. Les 40,0 % sur OSWorld-v2 sont le chiffre qui devrait guider cette décision, et non les 92,2 % sur téléphone. Pour ce type de travail, Claude Opus 5 et ses prédécesseurs restent le pari le plus sûr, et notre article sur les alternatives à Opus 5 couvre le reste du terrain.
Pas du tout le bon outil si vous cherchez à automatiser le support client. Pas parce qu'il est faible. Il vise une autre surface, c'est tout. Ce dont les équipes support ont besoin, c'est de quelque chose qui se branche sur le helpdesk et apprend de votre base de connaissances et des tickets résolus.
À partir de là, le travail est le routage, la classification des tickets et des escalades de support propres lorsqu'un humain est nécessaire. Piloter l'écran n'est pas le goulot d'étranglement par ici, et le traiter comme tel est la façon dont les équipes se retrouvent avec une démo impressionnante et une file inchangée.
Le verdict
Qwen-UI-Agent est l'article sur les agents GUI le plus intéressant de l'année, et le produit le moins utilisable de cette comparaison. Les deux sont vrais en même temps.
Le résultat mobile est le vrai titre et il mérite de l'être : 92,2 % sur plus de 400 tâches sur une flotte de téléphones physiques, battant quatre modèles de pointe, n'est pas un artefact de benchmark. La méthode derrière, en particulier le mélange de commandes shell dans le flux de clics et le regroupement des actions par tour, est le genre d'idée qui se copie.
Le résultat de bureau est la vraie réserve : 40,0 % sur l'usage d'ordinateur à horizon long contre 54,8 % pour Claude Opus 4.8 est un écart large, et le travail de bureau à horizon long est de toute façon l'essentiel de ce que les gens entendent par « usage d'ordinateur » en contexte professionnel.
Et la disponibilité est le vrai blocage. Apache 2.0 dans un readme est une intention. Tant qu'un checkpoint n'apparaît pas réellement, c'est de la recherche dont s'inspirer, pas un logiciel à acheter. Si la file devant vous est une file de support et non un écran, le meilleur agent IA ne sera pas celui qui clique le plus vite. Ce sera celui que vous avez pu tester sur vos propres tickets avant de lui faire confiance.