Alternatives à Qwen-UI-Agent : 8 agents GUI que vous pouvez vraiment utiliser en 2026

Rama Adi

Katelin Teen
Dernière modification August 24, 2026
Vous ne pouvez pas quitter Qwen-UI-Agent, parce qu'il n'y a encore rien à quitter. L'équipe Tongyi MAI d'Alibaba a publié un rapport technique le 30 juillet 2026 avec d'excellents chiffres sur mobile, puis n'a livré ni checkpoint, ni API, ni prix. L'organisation Hugging Face liste quatre modèles et aucun n'est celui-ci. Chercher des alternatives, c'est donc en réalité chercher un agent GUI qui existe.
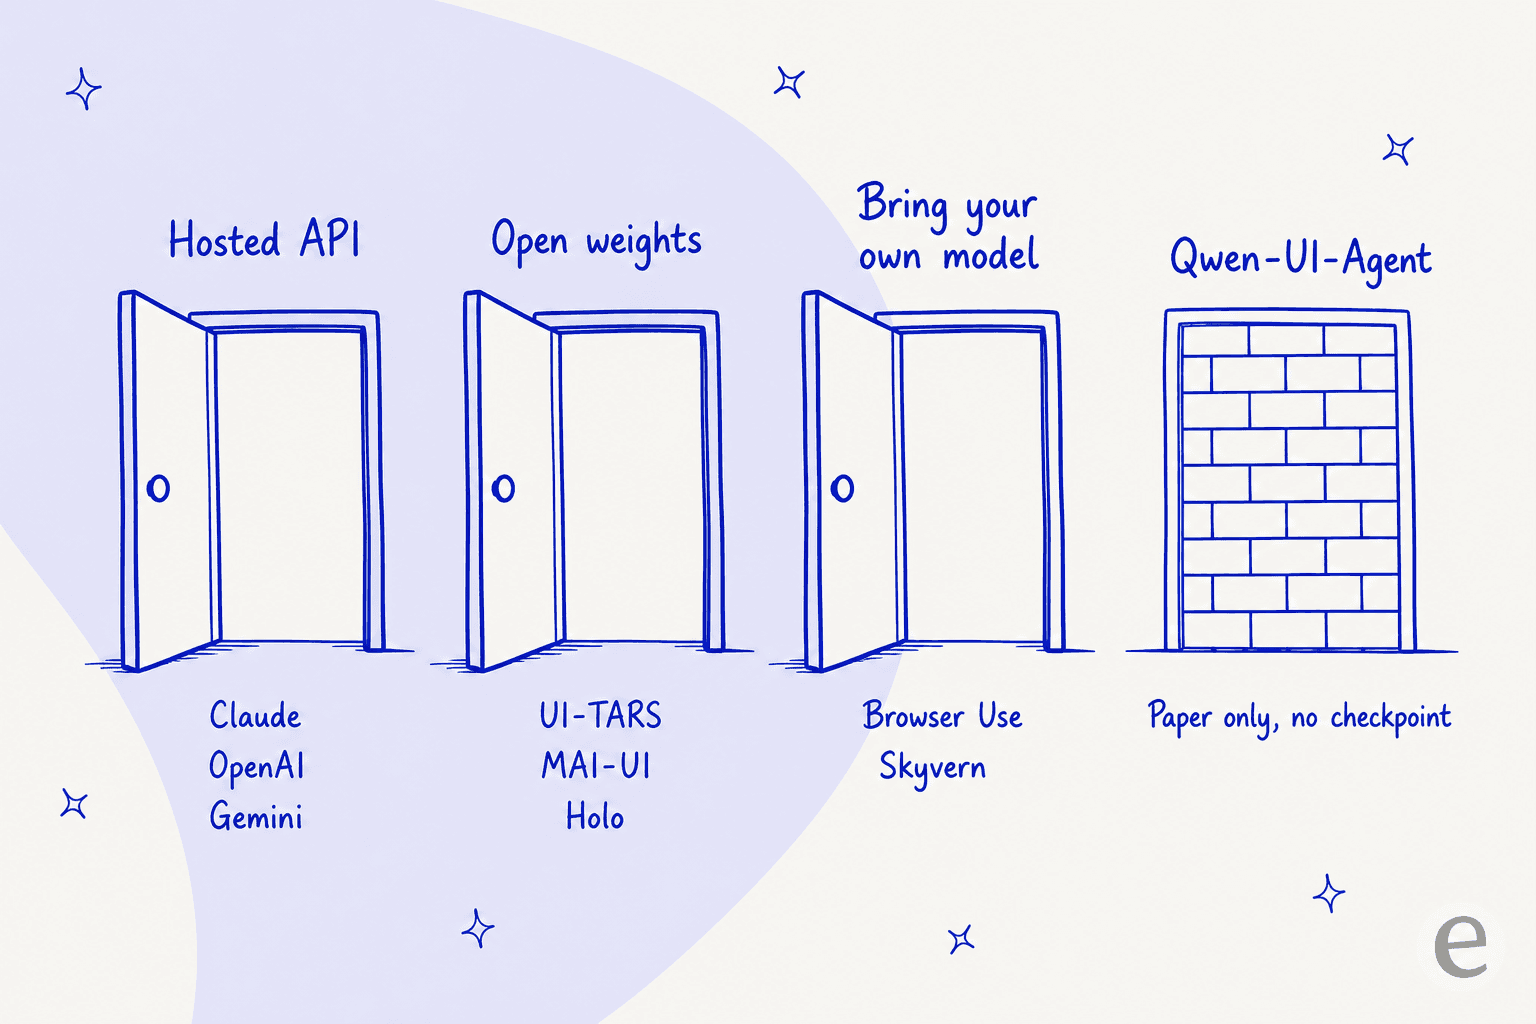
Huit existent, et ils se répartissent en trois voies plutôt qu'en classement. Les API hébergées d'Anthropic, d'OpenAI et de Google offrent les modèles les plus puissants et la meilleure infrastructure de sécurité, Google étant le seul à piloter aussi Android. Les poids ouverts d'UI-TARS, de MAI-UI et de Holo 3.1 offrent l'Apache 2.0 et un ordinateur portable que vous contrôlez, au prix d'une vraie perte de précision. Browser Use et Skyvern n'offrent ni modèle ni mystère : ils pilotent Chromium avec le LLM que vous leur indiquez, et sont le moyen le moins cher de terminer une tâche web.
Deux choses m'ont surpris. Tout agent GUI à poids ouverts que vous pouvez télécharger est une version affinée de Qwen, donc quitter Alibaba est un choix de licence et non d'architecture. Et dans les propres traces de Qwen-UI-Agent, 55,1 % de ses actions sur le benchmark de bureau le plus difficile étaient des commandes saisies, pas des clics. Le meilleur agent de pilotage d'écran au monde évite l'écran quand il le peut. Si le travail que vous aviez en tête, ce sont des tickets de support, prenez l'indice : eesel dialogue avec Zendesk et Gorgias via leurs API et vous laisse la tester à blanc sur les tickets du mois dernier, ce qu'aucune souris ne sait faire.
Ce que les gens cherchent vraiment quand ils tapent cette recherche
Je construis des intégrations pour vivre, donc mon premier réflexe avec tout nouveau modèle d'agent est d'aller chercher le point d'accès. Avec Qwen-UI-Agent, il n'y en a pas.
C'est dommage, car Alibaba livre d'habitude. Si vous arrivez de notre tour d'horizon des alternatives à Qwen ou de l'avis sur Qwen, vous savez que les modèles de texte ont des grilles tarifaires publiques et de vrais points d'accès. Celui-ci non.
Il faut être précis, car la couverture ne l'a pas été. Le site du projet compte exactement trois boutons : rapport technique, GitHub et une vidéo de démonstration. Le dépôt GitHub affiche 2,2k étoiles et zéro version, zéro tag et zéro paquet. L'organisation Tongyi-MAI sur Hugging Face publie Z-Image, Z-Image-Turbo, MAI-UI-8B et MAI-UI-2B, et c'est toute la liste. L'Apache 2.0 figure dans le README, mais une licence sur un dépôt de figures n'est pas un modèle que l'on peut exécuter.
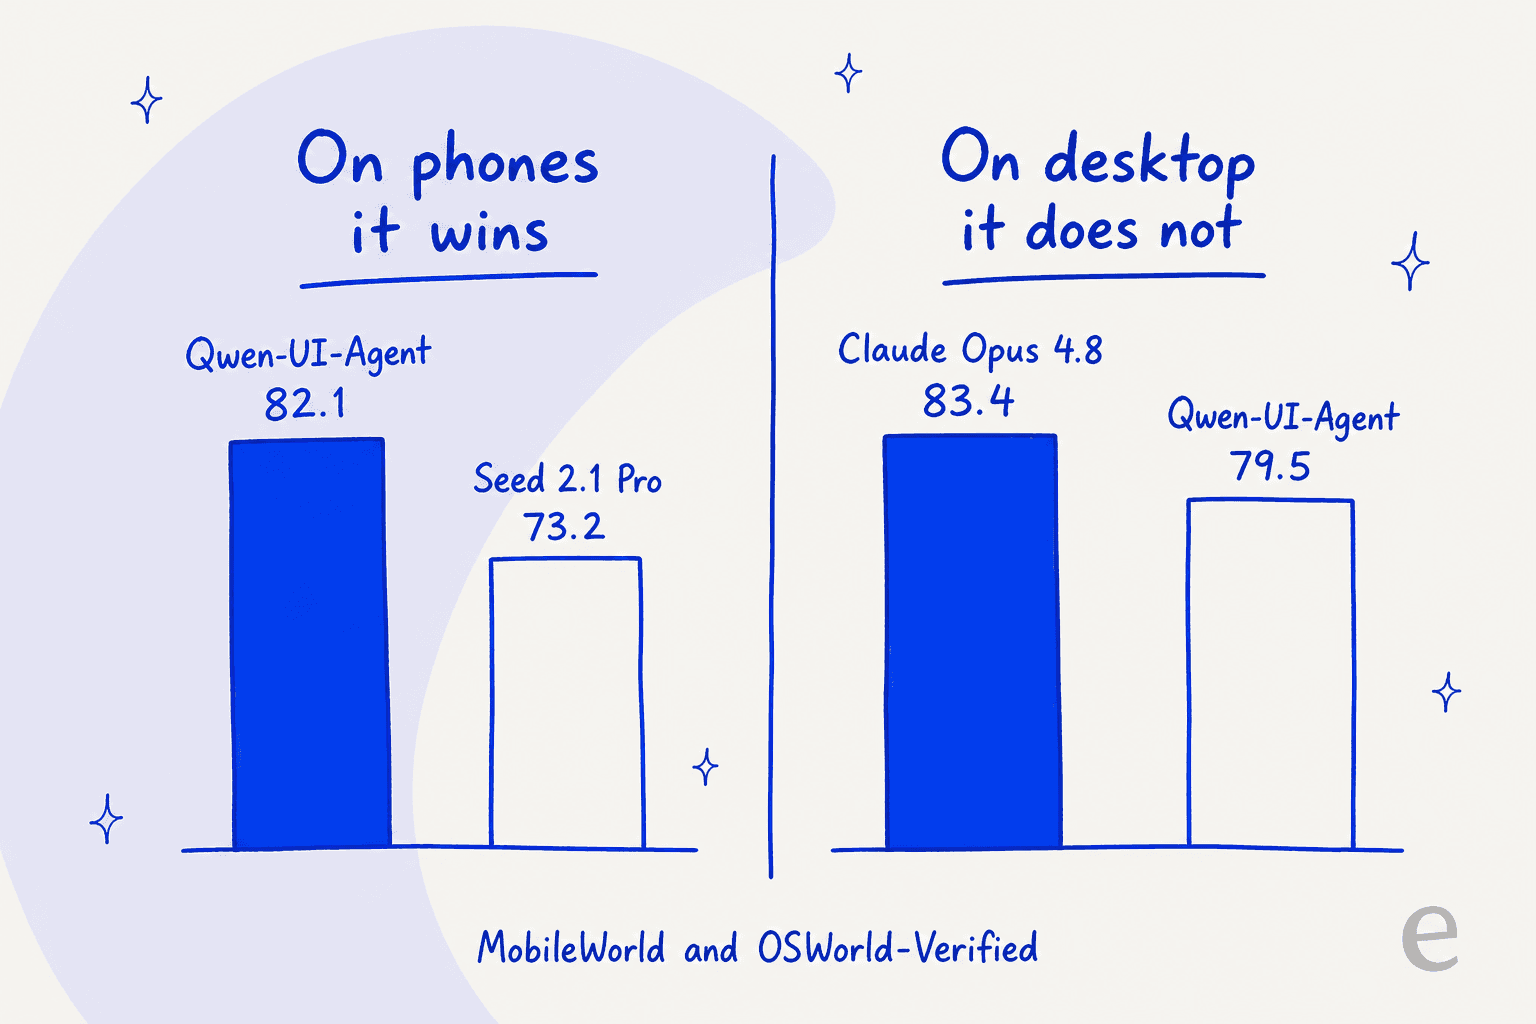
Rien de tout cela ne rend le travail moins bon. Le titre du rapport est une variante de 27B que les auteurs appellent leur modèle principal pour l'évaluation de bout en bout, d'après le rapport technique, et sur téléphone c'est largement le meilleur résultat jamais publié : 82,1 % sur MobileWorld contre 73,2 pour Seed 2.1 Pro, et 92,2 % sur un benchmark réservé de 409 tâches dans 104 applications Android réelles, exécuté sur une flotte de plus de 100 appareils physiques. Ce dernier chiffre est le plus intéressant, car il a été mesuré sur de vrais appareils et non sur des émulateurs.
Sur le bureau, l'histoire est aplatie quand on la raconte. Un récapitulatif hebdomadaire très partagé l'a formulée ainsi :
"Alibaba also released Qwen-UI-Agent, a 27B GUI agent model that claims top scores on MobileWorld (82.1%), OSWorld-Verified (79.5%), and WebArena (73.6%), beating GPT-5.6 Sol, Claude Opus 4.8, and Gemini 3.1 Pro."
Le propre graphique d'Alibaba dit autre chose pour le chiffre du milieu. Sur OSWorld-Verified, Claude Opus 4.8 obtient 83,4 et Qwen-UI-Agent 79,5, et le rapport indique clairement qu'il arrive deuxième, derrière Opus 4.8 seulement. Sur l'ensemble plus difficile à long horizon, OSWorld-v2, l'écart se creuse à 40,0 contre 54,8 pour Opus 4.8 en progression partielle. L'affirmation « bat » vaut pour le mobile et pour WebArena. Elle ne vaut pas pour le benchmark de bureau que la plupart des acheteurs citent.
Il faut aussi se rappeler que cette catégorie a un historique de promesses excessives. Adept AI a livré ACT-1, le premier agent sérieux qui cliquait sur des écrans, puis a changé de cap ; Rabbit AI a vendu un grand modèle d'actions dans un appareil grand public. Les démonstrations d'agents pilotant des logiciels ont déjà devancé la réalité, une bonne raison de relire chaque graphique de cet article deux fois.
Le cadrage honnête de tout cet article : vous ne remplacez pas un produit, vous choisissez le premier. Et le choix tient moins au score qu'à la porte par laquelle vous entrez parmi trois.
Ce que dit le classement neutre
Presque tous les chiffres de la section précédente sont déclarés par les fournisseurs, Alibaba compris. Avant la liste, voici donc le même benchmark exécuté par quelqu'un qui n'a rien à vendre.
OSWorld-Verified a un tableau géré par ses mainteneurs, où l'équipe d'OSWorld évalue elle-même les soumissions, avec des paramètres unifiés, sur les mêmes 361 tâches. Il n'est pas affiché comme tableau sur la page, il est chargé côté client depuis une feuille de calcul, voici donc les huit meilleurs résultats de ce fichier.
| Rang | Agent ou modèle | Institution | Type | Taux de réussite |
|---|---|---|---|---|
| 1 | Intelligence-Indeed Agent | Intelligence Indeed | Framework agentique | 90.19 |
| 2 | claude-fable-5[1m] | Anthropic | Modèle généraliste | 85.96 |
| 3 | Pointer Agent w/ Opus 4.7 | Pointer | Framework agentique | 83.64 |
| 4 | claude-opus-5[1m] | Anthropic | Modèle généraliste | 83.39 |
| 5 | Coasty CUA v1 | Coasty Team | Modèle généraliste | 82.81 |
| 6 | Holo3-35B-A3B | H Company | Modèle spécialisé | 82.56 |
| 7 | Pointer Agent w/ Sonnet 4.6 | Pointer | Framework agentique | 81.45 |
| 8 | Muse Spark 1.1 | Meta Superintelligence Labs | Modèle généraliste | 80.67 |
Trois choses en ressortent, et toutes ont façonné cet article.
Qwen-UI-Agent n'y figure pas et ne peut pas y figurer. La règle de soumission du tableau est que vous planifiez une réunion et que les mainteneurs exécutent le code de votre agent de leur côté. Sans checkpoint ni API, il n'y a rien à exécuter. Les seules entrées d'Alibaba dans toute la feuille de 66 entrées sont Qwen 3.7 Plus à 73,3 et GUI-Owl-1.5 32B à 55,44. Si l'on prend les 79,5 auto-déclarés d'Alibaba au pied de la lettre et qu'on les insère dans ce tableau, ils se classent 9e sur 66, hors des huit premiers.
Le leader est un harnais, pas un modèle. Cinq des douze premiers sont des frameworks agentiques qui enveloppent le modèle de quelqu'un d'autre, et l'entrée numéro un en est une, à 90,19. Si vous comptiez acheter un modèle et en finir, le tableau dit que l'échafaudage rapporte plus de points que les poids.
Un modèle à poids ouverts est bel et bien dans la course. Holo3-35B-A3B est 6e à 82,56, soit plus que l'affirmation publiée par H Company elle-même (78,85), et vérifié par quelqu'un d'autre que H. C'est le chiffre le plus crédible pour un agent GUI téléchargeable, et il a fait monter Holo dans ma liste.
À noter pour quiconque cite ces chiffres : la performance humaine sur OSWorld est de 72,36 %, et tout ce qui figure dans ces douze premiers la dépasse désormais. Et un piège de dénomination : Anthropic auto-déclare 83,4 pour Opus 4.8, alors que la ligne à 83,39 dans cette feuille s'appelle claude-opus-5[1m] et qu'aucune ligne Opus 4.8 n'y existe. Le chiffre correspond, l'étiquette non.
Comment j'ai choisi, et ce que j'ai mesuré
J'ai passé cette semaine dans les documentations, fiches de modèles, fichiers de licence et grilles tarifaires de chaque candidat, et j'ai écarté tout ce que je ne pouvais pas vérifier sur les pages du fournisseur lui-même. Six critères ont décidé de la liste.
Si vous pouvez l'obtenir aujourd'hui. Un rapport n'est pas une alternative. Soit les poids sont téléchargeables, soit il y a un point d'accès avec un prix, soit c'est éliminé.
Qui fournit l'écran. Tous ont besoin de quelque chose à piloter : une machine virtuelle, un Chromium sans interface, un appareil Android. Presque aucun ne le fournit. C'est le poste que tout le monde oublie.
Quels écrans il pilote. Navigateur, bureau et mobile sont trois produits différents sous un même nom, et les fournisseurs ne sont pas aussi honnêtes les uns que les autres sur ce qu'ils font.
À qui est le harnais qui a produit le score. Tout chiffre de cet article est déclaré par le fournisseur sauf mention contraire, et plusieurs ont été mesurés sur des benchmarks modifiés. Je le dis à chaque fois. L'ampleur de cet écart n'a rien d'hypothétique. Sur un fil Launch HN, un fondateur a été mis au défi sur une affirmation de SOTA et a répondu avec les deux chiffres dans une seule phrase :
"We've hit 82.8% on OSWorld Verfied(on the official page) and with our latest internal testing we're hitting 85.6% which we've posted"

C'est une prime auto-mesurée de 2,8 points, énoncée honnêtement, par un fournisseur dont je peux aller vérifier le chiffre sur le tableau neutre. Supposez qu'il y ait quelque chose de similaire derrière chaque graphique de cette catégorie, y compris celui d'Alibaba.
Ce que coûte une exécution. Pas le prix par million, mais le coût par exécution, dominé par le nombre d'étapes car chaque étape renvoie toute la trajectoire plus une nouvelle capture d'écran. Si vous voulez la même arithmétique appliquée aux effectifs, notre comparaison des coûts d'agents le fait. Les praticiens suivent cela de près, et leurs chiffres ne sont pas tendres :
"Numbers I was seeing: - 20 to 50 LLM calls per task - $0.50 to $3.00 per task at Claude Sonnet 4.6 prices - Half the runs drifted off-task halfway through"

Si vous pouvez tester avant la production. C'est ce qui compte le plus en pratique et ce que personne ne résout. C'est un problème à peu près résolu pour les agents de texte, comme le montre notre guide sur OpenAI Evals, et un problème non résolu dès que la sortie est un mouvement de souris.
Sur le coût, voici l'arithmétique qui a changé ma façon de penser les budgets d'agents GUI. Faites glisser le nombre d'étapes et regardez la courbe se plier.
Les huit alternatives en un coup d'œil
| Outil | Idéal pour | Comment l'obtenir | Écrans pilotés | Licence ou prix | Meilleur score publié, et à qui est le harnais | Qui fournit l'écran | Test à blanc avant la production | Défense contre l'injection | Offre gratuite |
|---|---|---|---|---|---|---|---|---|---|
| Claude computer use | Travail de bureau qui doit être juste | API hébergée, GA | Bureau, navigateur | Opus 5 $5 / $25 par MTok | 83.4% OSWorld-Verified (Opus 4.8, Anthropic) | Vous | Non | Classifieurs activés par défaut | Non |
| Gemini computer use | Une API pour mobile et bureau | API hébergée, flag d'aperçu | Navigateur, mobile, bureau | 3.7 Flash $0.75 / $3.75 par MTok | 83.0% OSWorld-Verified (3.6 Flash, Google) | Vous | Non | Optionnelle, désactivée par défaut | Non |
| OpenAI computer use | Équipes déjà sur la Responses API | API hébergée, GA | Bureau, navigateur | Sol $4 / $20, Luna $0.20 / $1.20 | 92.8% Online-Mind2Web (OpenAI) | Vous | Non | Politique publiée, à vous de l'appliquer | Non |
| ByteDance UI-TARS | Une licence permissive que vous pouvez distribuer | Poids sur Hugging Face | Bureau, navigateur, Android via modèle | Apache 2.0 | 27.5% OSWorld pour le 8B ouvert (ByteDance) | Vous | Non | Aucune | Les poids sont gratuits |
| MAI-UI 8B et 2B | Le cousin téléchargeable le plus proche | Poids sur Hugging Face | Mobile, bureau | Apache 2.0 | 65.7% ScreenSpot-Pro pour le 8B (Alibaba) | Vous | Non | Aucune | Les poids sont gratuits |
| Holo 3.1 | Poids ouverts avec solution de repli hébergée | Poids plus API hébergée | Web, bureau, mobile | Apache 2.0, API $0.25 / $1.80 | 82.56% OSWorld-Verified, 6e (tableau des mainteneurs) | Vous, ou les agents gérés de H | Non | Non documentée | 10 RPM, sans carte |
| Browser Use | Tâches de navigateur à grand volume | Bibliothèque Python plus cloud | Navigateur seul | Bibliothèque MIT, cloud dès $29/mois | 87.4% sur Odysseys (hébergé par un tiers) | Le cloud fournit Chromium | Non | Non documentée | 10 tâches/mois |
| Skyvern | Parcours connectés avec 2FA en travers | Auto-hébergé ou cloud | Navigateur seul | AGPL-3.0, cloud dès $29/mois | 85.85% WebVoyager, janv. 2025 (Skyvern) | Le cloud fournit Chromium | Non | Non documentée | 5 000 crédits |
Deux colonnes méritent qu'on s'y arrête. Personne ne propose de test à blanc, la plus grande lacune opérationnelle de toute la catégorie. Et qui fournit l'écran divise la liste nettement : les trois laboratoires de pointe vous donnent un modèle et vous souhaitent bon courage avec la machine virtuelle, tandis que Browser Use et Skyvern vous donnent un navigateur en marche et vous laissent choisir le modèle.
1. Claude computer use
Idéal pour l'automatisation de bureau où un mauvais clic coûte cher.
Comment ça marche. Vous déclarez une seule entrée d'outil et le modèle d'Anthropic renvoie des actions que votre code exécute. La version actuelle est un ensemble d'outils client, computer_toolset_20260801, qui regroupe 17 outils membres derrière une seule déclaration et n'a pas besoin d'en-tête bêta. Il fonctionne sur Fable 5, Mythos 5, Opus 5, Opus 4.8 et Sonnet 5, et notamment pas sur Haiku 4.5. Ce qui est agréable pour qui construit un vrai pipeline, c'est que vous pouvez donner au même modèle un outil bash et un éditeur de fichiers dans le même tableau tools, pour qu'il puisse quitter l'interface graphique et passer à un terminal en pleine tâche.
Deux surfaces voisines valent d'être connues si vous allez dans cette direction : Claude Managed Agents pour héberger et superviser la boucle, et la plateforme de bureau Claude si vous préférez limiter un agent à une application plutôt qu'à un système d'exploitation entier.
Ce que j'aime. Les scores sont les meilleurs publiés sur le bureau : 83,4 % sur OSWorld-Verified pour Opus 4.8, et 70,57 % sur le plus récent et plus difficile OSWorld 2.0 pour Opus 5 contre 62,6 pour GPT-5.6 Sol. Mais ce que je préfère vraiment, c'est la couche de sécurité. Déclarez l'outil officiel et Anthropic exécute automatiquement des classifieurs d'injection de prompt sur chaque capture d'écran, et quand l'un se déclenche, le modèle est orienté pour vous demander confirmation avant d'agir à nouveau. Anthropic dit que cela tourne en parallèle de l'inférence avec une latence ajoutée quasi nulle et sans coût supplémentaire. Personne d'autre dans cette liste ne livre cela activé par défaut.
Où ça s'arrête. Il n'y a aucune histoire mobile. L'environnement de référence est X11 sous Linux dans un conteneur, le vocabulaire est entièrement souris et clavier, et il n'y a ni toucher, ni balayage, ni pincement dans les 17 membres. Donc, sur l'axe précis où Qwen-UI-Agent est le plus fort, ce n'est pas un substitut. Anthropic cite aussi la latence comme première limite, dans ses propres mots peut-être trop lent par rapport à un humain faisant les mêmes clics. Et la surcharge de jetons est réelle : la définition de l'ensemble d'outils coûte environ 4 520 jetons d'entrée à chaque requête avant que vous n'ayez envoyé un seul pixel, et chaque capture d'écran en ajoute de 1 000 à 1 800. Un autre piège pour les implémenteurs : l'API ne réduit pas les images trop grandes pour vous, elle les rejette.
Tarifs.
| Modèle | Entrée / MTok | Sortie / MTok | Lecture du cache | Remarques |
|---|---|---|---|---|
| Opus 5 | $5.00 | $25.00 | $0.50 | Le mode rapide vaut exactement 2x |
| Opus 4.8 | $5.00 | $25.00 | $0.50 | Détient le score de 83,4 % |
| Sonnet 5 | $2.00 | $10.00 | $0.20 | Ensemble d'outils pris en charge |
| Fable 5 | $10.00 | $50.00 | $1.00 | Ensemble d'outils pris en charge |
| Haiku 4.5 | $1.00 | $5.00 | $0.10 | Ensemble d'outils non pris en charge |
Le traitement par lots divise par deux les deux côtés, le contexte complet de 1M se facture au tarif standard sans palier, et l'utilisation de l'ordinateur est éligible à la rétention zéro des données puisque la boucle tourne de votre côté.
Verdict : si le travail se fait sur un bureau et que le coût d'une erreur dépasse la simple gêne, c'est celui par lequel je commencerais, et les classifieurs d'injection intégrés en sont la raison. Passez votre chemin si le travail se fait sur un téléphone, car il ne le peut tout simplement pas. Si la crainte est la dépendance à un fournisseur plutôt que la capacité, notre liste des alternatives à Claude couvre le reste du terrain. Qui compare directement les deux grands fournisseurs d'API tirera plus de notre guide API OpenAI contre Anthropic que d'un graphique de benchmark.
2. Gemini computer use
Idéal pour couvrir téléphones et bureaux depuis un seul point d'accès hébergé.
Comment ça marche. Il n'y a plus de modèle dédié à l'utilisation de l'ordinateur. Google a intégré la capacité dans un outil computer_use natif qui se rattache aux modèles Flash généralistes, et l'ancien gemini-2.5-computer-use-preview-10-2025 est désormais qualifié d'aperçu hérité. L'outil lui-même ne coûte rien de plus, facturé comme des jetons ordinaires au tarif du modèle. Les coordonnées reviennent normalisées sur une grille de 0 à 999, et Google précise qu'il s'agit d'un outil côté client, donc la boucle est à vous.
Ce que j'aime. C'est la seule API hébergée de la liste avec un environnement mobile documenté, et c'est un vrai différenciateur et non une formule marketing. Il y a trois tableaux d'actions distincts : ENVIRONMENT_BROWSER avec 21 actions, ENVIRONMENT_MOBILE avec 10 que Google décrit comme optimisées pour Android et qui ajoute open_app, list_apps et long_press tout en retirant scroll et hotkey, et ENVIRONMENT_DESKTOP avec 17 pour le contrôle du curseur au niveau du système. La trajectoire sur le bureau est aussi raide : OSWorld-Verified est passé de 65,1 sur 3 Flash à 78,4 sur 3.5 Flash puis 83,0 sur 3.6 Flash, ce qui place Google à un demi-point du meilleur résultat d'Anthropic. Et c'est de loin la voie hébergée la moins chère.
Où ça s'arrête. La documentation est désordonnée d'une façon qui vous coûtera un après-midi. La page d'index des modèles ne liste toujours que l'ancien modèle 2.5 parmi les modèles d'outils et d'agents, le score OSWorld le plus élevé publié par Google appartient à un modèle que la page d'utilisation de l'ordinateur ne liste pas, et l'utilisation de l'ordinateur indique toujours « Supported (Preview) » même sur gemini-3.7-flash pourtant en disponibilité générale. Google n'a pas non plus republié Online-Mind2Web, WebVoyager ou AndroidWorld pour un seul modèle 3.x, donc la capacité mobile a un espace d'actions documenté et aucun benchmark actuel derrière. La détection d'injection de prompt existe mais est désactivée par défaut, l'inverse de la position d'Anthropic. Il n'y a aucune offre gratuite pour cela. Et le prix du modèle recommandé double le 1er janvier 2027.
Tarifs.
| Modèle | Entrée / MTok | Sortie / MTok | Remarque |
|---|---|---|---|
gemini-3.7-flash | $0.75 | $3.75 | Recommandé. Passe à $1.50 / $7.50 le 1er janv. 2027 |
gemini-3.5-flash | $1.50 | $9.00 | |
gemini-3.5-flash-lite | $0.30 | $2.50 | La voie la moins chère de tout cet article |
gemini-2.5-computer-use-preview | $1.25 | $10.00 | Aperçu hérité |
Verdict : le choix si vous voulez un seul fournisseur pour navigateur, bureau et Android, et le choix si le coût par exécution est la contrainte déterminante. Activez la détection d'injection avant toute autre chose et budgétez 2027 au tarif d'après l'augmentation. Notre décryptage des tarifs de Gemini 3 donne la grille plus large si vous modélisez sérieusement, et Gemini Agentic Vision explique comment la capture d'écran devient une cible de clic. Peser Google face au reste du terrain est le rôle de notre article sur les alternatives à Gemini.
3. OpenAI computer use
Idéal pour les équipes dont la pile s'arrête déjà à la Responses API.
Comment ça marche. computer-use-preview est obsolète et a disparu de la grille tarifaire. L'utilisation de l'ordinateur est désormais tools: [{ type: "computer" }] sur les trois niveaux de GPT-5.6, sans frais par appel pour l'outil lui-même. Le guide documente trois formes de harnais au lieu d'une, ce que j'ai apprécié : la boucle intégrée qui renvoie des actions d'interface structurées, un outil personnalisé par-dessus un harnais Playwright ou Selenium que vous avez déjà, et un harnais d'exécution de code où le modèle alterne entre cliquer et écrire de courts scripts. Le vocabulaire d'actions compte neuf types, regroupés dans un tableau actions[] plutôt qu'envoyés un par un.
Ce que j'aime. Les chiffres de navigateur sont de loin les plus solides ici : 92,8 % sur Online-Mind2Web, 67,3 % sur WebArena-Verified, 90,4 % sur BrowseComp. OpenAI publie aussi un résultat client et pas seulement un benchmark, annonçant 95 % de réussite dès la première tentative sur environ 30 000 portails de taxe foncière, passant à 100 % en trois tentatives. Et le niveau Luna rend l'expérimentation bon marché, à $0,20 en entrée et $1,20 en sortie.
Où ça s'arrête. Pas de mobile, confirmé de cinq façons : les deux environnements documentés sont des bureaux, les résolutions recommandées s'appellent bureau, il n'y a ni toucher, ni balayage, ni retour dans le vocabulaire, et chaque benchmark publié concerne le bureau ou le navigateur. Le modèle de sécurité est aussi allé dans le mauvais sens. L'outil en disponibilité générale a supprimé la poignée de main pending_safety_checks de l'époque de l'aperçu, ce qui vous laisse une politique de confirmation à trois niveaux publiée, un extrait de prompt anti-injection prêt à coller et la consigne de tenir une liste de domaines autorisés, le tout à implémenter vous-même. Bon à savoir avant de planifier autour du côté grand public : l'agent ChatGPT est retiré, et son remplaçant, le navigateur cloud de ChatGPT Work, n'acceptera pas d'identifiants, n'utilisera ni remplissage automatique ni gestionnaire de mots de passe, ne se connectera pas aux sites et ne finalisera pas de paiements. L'API d'OpenAI bat son propre agent grand public de 21,9 points sur Online-Mind2Web.
Tarifs.
| Modèle | Entrée / MTok | En cache | Sortie / MTok | Contexte long ent. / sort. |
|---|---|---|---|---|
gpt-5.6-sol | $4.00 | $0.40 | $20.00 | $8.00 / $30.00 |
gpt-5.6-terra | $2.00 | $0.20 | $12.00 | $4.00 / $18.00 |
gpt-5.6-luna | $0.20 | $0.02 | $1.20 | $0.40 / $1.80 |
Batch et Flex sont tous deux à moitié prix, le mode rapide au double, et ce sont des tarifs promotionnels jusqu'au 21 novembre 2026. L'article de lancement affichait Sol à $5 / $30 et Luna à $1 / $6, donc Luna tourne actuellement à un cinquième de son propre prix catalogue. Il y a aussi une limite de palier de contexte long à 270K jetons qu'une boucle de captures d'écran atteint plus vite qu'on ne le pense, et l'offre gratuite n'est pas prise en charge. Côté grand public, les chiffres figurent dans notre guide des tarifs d'Atlas, un produit différent à un prix différent.
Verdict : le choix orienté navigateur, et celui que je ferais si le système environnant parle déjà function calling et que vous préférez ajouter un outil plutôt qu'adopter un fournisseur. Prévoyez du temps d'ingénierie pour la couche de sécurité, car ce travail est désormais le vôtre. Voir les modèles OpenAI pour la différence entre les trois niveaux ailleurs.
4. ByteDance UI-TARS
Idéal pour une licence permissive que vous pouvez réellement distribuer dans un produit commercial.
Comment ça marche. Six checkpoints se trouvent dans l'organisation ByteDance-Seed sous Apache 2.0, sans verrou ni acceptation par clic : un 2B, deux variantes 7B, deux variantes 72B et le 1.5-7B que tout le monde utilise vraiment. Les noms des dépôts sous-estiment les tailles, puisque le « 7B » fait en réalité 8,3B paramètres et le « 72B » 73,4B. Trois modèles de prompt sont fournis, COMPUTER_USE, MOBILE_USE et GROUNDING, donc le mobile est une capacité documentée du modèle avec les actions long_press, open_app, press_home et press_back.
Ce que j'aime. Apache 2.0 sans clause non commerciale, confirmé dans le fichier LICENSE, sur les six fiches de modèles et sur le dépôt de l'application de bureau. L'écosystème autour du 8B est le plus profond de tous les agents GUI ouverts : 11 versions affinées, 13 quantifications et des builds GGUF câblés pour llama.cpp, LM Studio, Jan et Ollama. C'est pourquoi il compte environ 808 000 téléchargements par mois contre 446 pour le 72B. Vous pouvez avoir un agent GUI tournant sur un portable ce soir, commercialement, gratuitement.
Où ça s'arrête. Les benchmarks vedettes appartiennent à un modèle que vous ne pouvez pas avoir. Le tableau d'échelle de ByteDance place le 1.5-7B téléchargeable à 27,5 % sur OSWorld et 49,6 % sur ScreenSpot-Pro, contre 42,5 % et 61,6 % pour le 1.5 interne que la presse a couvert. C'est un écart de 15 et de 12 points, et curieusement le 72B fait moins bien que le 7B sur les deux. Le panneau d'évaluation communautaire de Hugging Face brouille encore les choses en attribuant 61,6 % sur ScreenSpot-Pro au 7B, contredisant les 49,6 % de ByteDance, donc traitez cette colonne comme non tranchée. UI-TARS-2 a été annoncé en septembre 2025 et n'a jamais eu de poids, ce que le rapport d'Alibaba confirme de façon indépendante en le listant comme propriétaire. ByteDance n'a publié aucun chiffre OSWorld-Verified malgré son crédit de contributeur à la correction qui l'a produit.
Le tableau de l'élan est ce que je pèserais le plus. Le dépôt du modèle a 11 374 étoiles, zéro tag, zéro version et un dernier commit du 5 septembre 2025. Le monorepo du bureau a 38 697 étoiles et un dernier commit de juillet 2026. L'outillage est vivant et la lignée de modèles est gelée. L'application installable n'existe que pour macOS et Windows, sans build Linux, et la dernière version avec installeurs est la v0.2.4 d'août 2025, tandis que /releases/latest renvoie vers une version CLI sans fichier attaché, exactement le lien sur lequel le guide de démarrage rapide vous dit de cliquer.
Si vous dimensionnez un petit modèle pour votre propre matériel plutôt que de courir après un classement, notre article sur les petits modèles de langage est un meilleur cadre pour cette décision que n'importe quel tableau de benchmarks.
Tarifs. Les poids sont gratuits. La voie hébergée est doubao-1-5-ui-tars-250428 sur Volcengine à ¥1,75 par million en entrée et ¥3,50 par million en sortie listés, même si cette page affiche ses prix côté client donc je revérifierais avant de budgéter, et Volcengine est un cloud de la région Chine. Le successeur Doubao-Seed-2.1-Pro est listé à ¥6 et ¥30, un produit différent à un prix différent. Pour un déploiement occidental, l'auto-hébergement ou un fournisseur d'inférence tiers est la voie pratique.
Verdict : prenez-le pour la licence et l'écosystème, pas pour le score, et calibrez sur 27,5 % plutôt que 42,5 %. Un risque mérite d'être nommé à voix haute : la section des limites de ByteDance signale elle-même que le modèle traite les CAPTCHA, décrit cela comme une préoccupation d'accès non autorisé, et il n'y a aucune barrière technique sur un checkpoint Apache 2.0. Si vous pesez les poids ouverts en général, notre article sur les alternatives à Kimi K2.5 couvre le prix du reste de ce champ.
5. MAI-UI 8B et 2B
Idéal pour ce qui ressemble le plus à Qwen-UI-Agent et que vous pouvez réellement télécharger, du même laboratoire.
Comment ça marche. Ce sont les deux checkpoints que l'équipe MAI d'Alibaba a effectivement publiés, mis en ligne le 25 décembre 2025 et annoncés quatre jours plus tard, tous deux Apache 2.0, tous deux sur l'architecture qwen3_vl. MAI-UI-8B fait 8,77B paramètres en quatre fragments de 16,33 GiB, et MAI-UI-2B fait 2,13B dans un seul fichier de 3,96 GiB. Ce sont les prédécesseurs directs de Qwen-UI-Agent, ce qui en fait le substitut le plus honnête de ce que le post-entraînement de cette équipe apporte réellement.
Ce que j'aime. Même laboratoire, même lignée, Apache 2.0, et assez petits pour être pratiques. Le 2B en particulier tient confortablement sur une carte de 8 Go d'après l'arithmétique des poids. Des quantifications communautaires existent pour les deux, sept pour le 8B et cinq pour le 2B. Et le benchmark MobileWorld lui-même est librement téléchargeable même si le modèle qui le domine ne l'est pas, de sorte que vous pouvez au moins évaluer honnêtement.
Où ils s'arrêtent. Lisez les fiches de modèles avec soin, car elles affichent des chiffres des modèles phares de la famille plutôt que ceux des checkpoints eux-mêmes. Les 76,7 % sur AndroidWorld de la fiche du 2B appartiennent à un modèle de 235B qui n'a jamais été publié. Les seuls chiffres résolus par taille que l'équipe ait jamais publiés sont ceux de ScreenSpot-Pro sans zoom, tirés du journal d'actualités du dépôt : 67,9 % pour un 32B qui n'est pas sorti non plus, 65,7 % pour le 8B et 57,4 % pour le 2B. Face aux 76,6 % de Qwen-UI-Agent dans le même cadre, cela fait 10,9 et 19,2 points de retard en grounding. Sur le travail de bout en bout, l'écart est bien plus laid : le meilleur résultat de MAI-UI sur MobileWorld était 41,7 % contre 82,1 %, soit 40,4 points d'écart. Le grounding est presque un problème résolu en poids ouverts. Terminer un flux en plusieurs étapes ne l'est pas.
Deux notes pratiques. Aucune valeur de VRAM n'est publiée nulle part, ni sur l'une des fiches ni dans le dépôt, donc les chiffres ci-dessus sont mon calcul à partir de la taille des poids et non une affirmation du fournisseur. Et aucun fournisseur d'inférence de Hugging Face ne sert l'un ou l'autre modèle, donc le local est la seule voie.
Tarifs. Gratuit, Apache 2.0, et tout le coût est votre temps GPU.
Pour situer comment le reste du monde des poids ouverts fixe les attentes, Mistral AI publie plus de détails par checkpoint que l'une ou l'autre de ces fiches. DeepSeek V3.2 aussi.
Verdict : le modèle le plus intéressant ici pour comprendre ce que sera Qwen-UI-Agent, et l'un des plus faibles pour travailler réellement. J'exécuterais le 8B pour apprendre l'espace d'actions et calibrer les attentes, puis j'utiliserais une API hébergée pour tout ce qu'un client voit. Il est aussi révélateur que la collection MAI-UI affiche toujours deux éléments, dernière mise à jour le 6 janvier 2026, six mois avant l'annonce de Qwen-UI-Agent.
6. Holo 3.1
Idéal pour les poids ouverts quand vous voulez aussi un point d'accès hébergé en repli.
Comment ça marche. H Company, basée à Paris, a livré cinq générations en douze mois, et Holo 3.1 est arrivé le 1er juin 2026. Ce qui le rend inhabituel, c'est que le même checkpoint est vendu de deux façons. L'API de H documente un mode boucle d'agent, où Holo est le cerveau d'un agent de navigateur ou de bureau, et un mode de localisation d'éléments, où vous fournissez une image plus une description de la cible et recevez {x, y} sur une grille de 0 à 1000. Ce second mode en fait un composant de grounding prêt à l'emploi dans l'agent de quelqu'un d'autre, ce qu'aucune des API de pointe n'offre.
Ce que j'aime. C'est la seule entrée de tout l'article dont je n'ai pas eu à croire le chiffre vedette sur parole. Holo3-35B-A3B est 6e sur le tableau OSWorld-Verified des mainteneurs à 82,56 %, devant Muse Spark 1.1 de Meta et à moins d'un point de la ligne Opus d'Anthropic, et c'est le seul modèle spécialisé à poids ouverts parmi les six premiers. L'affirmation publiée par H pour Holo3 était de 78,85 %, donc pour une fois le fournisseur s'est sous-estimé.
Au-delà, Holo 3.1 est la publication la plus permissive de H : sept checkpoints tous Apache 2.0, couvrant 0,8B, 4B, 9B et un 35B-A3B en mélange d'experts, plus des builds FP8, NVFP4 et Q4 GGUF du modèle phare. H indique que les builds quantifiés atterrissent à environ deux points du checkpoint BF16 sur OSWorld. Le mobile est le gain principal de cette génération, AndroidWorld passant de 67 % à 79,3 % sur le 35B-A3B. Et le prix hébergé est le plus bas de tous les modèles de cet article, à $0,25 en entrée et $1,80 en sortie, avec une offre gratuite à 10 requêtes par minute et sans carte.
Où ça s'arrête. La générosité de licence a un revers. Aux générations précédentes, le schéma était : petits modèles Apache 2.0 et gros modèles réservés à la recherche : Holo2-30B-A3B et Holo2-235B-A22B sont tous deux CC BY-NC 4.0, tout comme Holo1.5-72B, donc aucun n'est utilisable dans un produit sans appeler H. Et le modèle phare actuel est allé plus loin que la recherche seule. holo3-122b-a10b n'a aucun poids, API uniquement, et la liste de modèles de H le dit elle-même. Deux pages de H divergent d'un point sur le chiffre AndroidWorld de la petite variante, 71 % contre 72 %. La grille par benchmark de Holo 3.1 n'est publiée que dans une image sur la fiche du modèle plutôt qu'en texte. Son composite vedette intègre H Corporate Benchmarks, 486 tâches construites avec la propre usine d'environnements synthétiques de H, donc toute affirmation de Pareto tirée de ce graphique est en partie notée sur des devoirs non publiés. Et le produit géré Computer-use Agents de juillet 2026 ne publie aucune grille tarifaire.
Tarifs.
| Voie | Tarif | Contexte | Remarques |
|---|---|---|---|
| Poids, famille Holo 3.1 | Gratuit, Apache 2.0 | n/a | 0.8B à 35B-A3B, plus FP8, NVFP4, GGUF |
API holo3-1-35b-a3b | $0.25 ent. / $1.80 sort. par MTok | 65 536 | Function calling, offre gratuite 10 RPM |
API holo3-122b-a10b | $0.40 ent. / $3.00 sort. par MTok | 65 536 | Pas de poids, pas de function calling |
| Computer-use Agents | Non publié | n/a | Navigateur et bureau en ligne, mobile non listé |
Verdict : mon choix parmi les options à poids ouverts, et la seule que je placerais devant une API hébergée au mérite, car les 82,56 % figurent sur le tableau de quelqu'un d'autre et non celui de H. C'est aussi l'option la mieux conçue pour une équipe qui veut démarrer en hébergé puis passer à l'auto-hébergement sans changer de famille de modèles, et la seule où les mêmes poids peuvent servir de sous-routine de grounding dans un autre agent. Lisez la licence de la génération que vous choisissez au lieu de la supposer, car elle change selon les tailles et le modèle phare actuel n'a aucun poids.
7. Browser Use
Idéal pour les tâches de navigateur que vous devez exécuter mille fois sans surveillance.
Comment ça marche. C'est l'option que la plupart des gens décrivent mal, donc il faut être exact. Browser Use a commencé comme un harnais plutôt qu'un modèle : une classe Agent qui exécute la boucle observer, décider, agir contre Chromium, avec le LLM comme argument interchangeable du constructeur. Il livre désormais aussi des modèles, des points d'accès hébergés bu-* avec bu-2-0 par défaut plus un bu-30b-a3b-preview à poids ouverts. Mais le harnais précède le modèle et ne l'exige pas, et la liste de fournisseurs est inhabituellement longue : Google, OpenAI, Anthropic, Azure, Bedrock, Groq, Cerebras, DeepSeek, Mistral, OpenRouter, LiteLLM, Ollama en local et tout ce qui est compatible OpenAI via une URL de base personnalisée. Vous apportez votre propre clé partout.
Ce que j'aime. 110,3k étoiles, 12,1k forks, MIT sur la bibliothèque et un rythme de publication qui ne ralentit pas. C'est aussi la seule entrée où le cloud fournit le navigateur, ce qui supprime le plus gros coût caché de toute la catégorie. Et la tarification est inhabituellement lisible : les abonnements achètent une réserve de crédits dollar pour dollar que deux compteurs épuisent, donc on peut vraiment prévoir.
Où ça s'arrête. Navigateur uniquement, et ils sont directs à ce sujet. Chaque session est un Chromium distant atteint par CDP, la surface d'API est /runs et /browsers, et ils se positionnent contre les agents d'utilisation de l'ordinateur plutôt que comme l'un d'eux. Attention à un piège subtil dans leur documentation : macOS, Windows et Linux apparaissent comme des empreintes imitées par le mode furtif, pas comme des plateformes pilotées. Les plus de 1 000 intégrations sont des API que l'agent appelle, pas des applications qu'il pilote.
Leur histoire de benchmarks demande aussi une lecture attentive. Les 89,1 % si souvent cités sur WebVoyager provenaient d'une exécution sur gpt-4o avec un code et des prompts modifiés, 55 tâches retirées et des évaluations échouées ou inconnues corrigées à la main, et Browser Use lui-même dit dans cet article que le benchmark ne teste pas vraiment les bonnes choses. Leur titre actuel est 82 % de précision stricte sur un ensemble interne de tâches non publiques. L'affirmation la plus solide est celle hébergée par un tiers : première place sur Odysseys à 87,4 % sur 200 tâches web à long horizon. Notez aussi que la MIT ne couvre que la bibliothèque, que le cloud fonctionne selon des conditions séparées et que la documentation vous oriente vers le cloud pour les CAPTCHA, la gestion de la mémoire et l'exécution parallèle.
Tarifs.
| Formule | Mensuel | Crédits | Sessions simultanées |
|---|---|---|---|
| Free | $0 | Recharges seulement, 10 tâches/mois | 3, ou 10 après une recharge |
| Dev | $29 | $29 | 25 |
| Business | $299 | $299 | 200 |
| Scaleup | $999 | $999 | 500 |
Les deux compteurs en dessous comptent plus que la formule. L'infrastructure de navigateur est facturée $0,02 par heure de navigateur, ce qui n'est rien, tandis que le proxy géré est facturé $5 par Go, tombant à $4 sur Scaleup, et la sortie sans proxy $0,20 par Go. Un gigaoctet de trafic proxy coûte autant que 250 heures de navigateur, donc le proxy est le vrai centre de coût. Les agents hébergés tournent à 1,2x les tarifs du fournisseur sous-jacent, et apporter votre propre clé ajoute des frais d'orchestration de 0,2x, donc BYOK vous achète du contrôle plutôt que des économies. Exécuter BU 2.0 dans votre propre bibliothèque est la voie la moins chère, à $0,60 en entrée et $3,50 en sortie sans frais d'heure de navigateur. Aucune formule entreprise n'est publiée, donc les SLA et conditions de rétention passent par les ventes.
Verdict : si la cible est un site web, commencez ici plutôt qu'avec une API d'utilisation de l'ordinateur de pointe. Vous obtenez un navigateur en marche, un modèle interchangeable et une facture prévisible, et le résultat tiers sur Odysseys est le chiffre le plus crédible de cet article. Quiconque compare cela à un simple scraper devrait d'abord lire notre article sur les alternatives de web scraping, car beaucoup de tâches qui semblent agentiques ne le sont pas.
8. Skyvern
Idéal pour les parcours web connectés où le 2FA est le véritable obstacle.
Comment ça marche. Skyvern n'est pas uniquement visuel, et c'est le choix de conception qui le définit. Une capture d'écran et un arbre DOM simplifié vont ensemble au modèle, et leur propre cadrage est que l'image apporte la mise en page et le contexte visuel tandis que le DOM apporte les identifiants d'éléments que Playwright peut cibler. Puis Playwright exécute. Les identifiants sont injectés dans le navigateur et non dans le prompt, donc le modèle ne les voit jamais. Leur ablation est publiée de façon rafraîchissante : un acteur seul obtient environ 45 % sur WebVoyager, ajouter un planificateur le porte à 68,7 %, et ajouter un validateur le porte à 85,85 %.
Ce que j'aime. C'est la seule entrée ici construite autour de la réalité ennuyeuse du travail web connecté, et c'est précisément là que l'approche purement visuelle s'effondre. Un praticien qui a fait tourner quatre agents côte à côte a décrit le seuil ainsi :
"the pattern that actually mattered wasn't which agent, it was that any task with login + 3 or more steps breaks on every screenshot-driven approach. … once you drop the browser sandbox and drive the OS accessibility tree directly, you get real element handles instead of pixel guesses and the failure rate falls roughly 4x on long tasks."
La conception DOM plus capture d'écran de Skyvern est la même idée appliquée une couche plus haut. En plus : les seconds facteurs TOTP, e-mail et SMS sont gérés, il y a un coffre d'identifiants avec prise en charge de Bitwarden, 1Password et Azure Key Vault, et un bouton « Take Control » qui rend une session en direct à un humain en pleine exécution. Route Memorization est la partie astucieuse de la feuille de route, compilant une exécution réussie de l'agent en un script Playwright bon marché qui se répare tout seul quand il casse, ce qui est déjà livré sous forme de cache de code. C'est la bonne réponse au coût par étape.
Où ça s'arrête. La licence comporte une exception que vous devez lire. Le README dit que la logique centrale est AGPL-3.0 à l'exception des mesures anti-bot disponibles dans le cloud géré, donc la couche anti-bot n'est délibérément pas dans le dépôt. L'auto-hébergement est gratuit côté logiciel mais a deux falaises : la résolution automatique de CAPTCHA n'y existe pas, et l'agent fait à la place une pause de 30 secondes pour une intervention manuelle. Les affirmations sur les CAPTCHA se resserrent aussi à mesure que l'on creuse, de la résolution native sans service tiers sur la page d'accueil à des documents qui nomment des types précis puis disent que la résolution n'est pas garantie. Navigateur uniquement, dans leurs propres mots, si cela se passe dans un navigateur que Skyvern peut exécuter. Le chiffre de 85,85 % sur WebVoyager date de janvier 2025 avec GPT-4o et 8 tâches retirées, et Skyvern dit sur cette même page que le classement a évolué depuis. Leur chiffre plus récent est 64,4 % sur leur propre WebBench. Quelques-unes de leurs propres pages se contredisent aussi, sur le nombre d'actions de l'offre gratuite et la couverture de pays du proxy.
Tarifs.
| Free | Hobby | Pro | Enterprise | |
|---|---|---|---|---|
| Prix | $0 | $29/mois | $149/mois | Sur mesure |
| Crédits | 5 000 uniques | 30 000/mois | 150 000/mois | Sur mesure |
| Actions estimées | ~170 | ~1 200 | ~6 200 | Sur mesure |
| Exécutions simultanées | 1 | 10 | 25 | 100 |
| 2FA et TOTP | Non | Non | Oui | Oui |
| Proxy | Datacenter | Datacenter | Résidentiel | Résidentiel |
Le coût en crédits par étape n'est jamais publié, je l'ai donc déduit : environ 25 crédits par action donnent à peu près $0,024 par étape sur les deux niveaux payants, identique sur chacun, ce qui signifie que la montée en gamme achète du volume, de la concurrence et du 2FA plutôt qu'un meilleur tarif unitaire. Une tâche typique fait de 2 à 10 étapes, soit environ $0,05 à $0,24. Aucun tarif de dépassement n'est publié nulle part, et les exécutions échouées consomment quand même du crédit.
Verdict : le choix du spécialiste, et les spécialistes sont sous-estimés. Si le travail consiste à se connecter à un portail qui n'est pas le vôtre et à remplir un formulaire derrière un second facteur, c'est mieux conçu que n'importe quelle API générale d'utilisation de l'ordinateur. Gardez le 2FA en tête en comparant les niveaux, car il commence à $149 et non à $29. Si vous hésitez entre un agent qui apprend et des sélecteurs codés en dur, notre article sur l'agent IA contre le chatbot cadre bien ce compromis.
Le chiffre que personne ne cite du rapport Qwen-UI-Agent
Voici la découverte qui a recadré la catégorie pour moi, et elle vient des propres traces du titulaire, pas d'un concurrent.
L'espace d'actions de Qwen-UI-Agent n'est pas purement graphique. À côté de click, type, drag et long_press, il expose cli_command pour bash, api_call, ask_user et terminate. Quand le modèle exécute une tâche de bureau, il peut donc choisir entre cliquer sur un bouton et taper une commande. Et il choisit souvent la commande. Sur OSWorld-Verified, les actions CLI représentent 40,7 % de toutes les actions et apparaissent dans 92,0 % des tâches. Sur le plus difficile OSWorld-v2, cela monte à 55,1 % des actions dans 98,2 % des tâches.
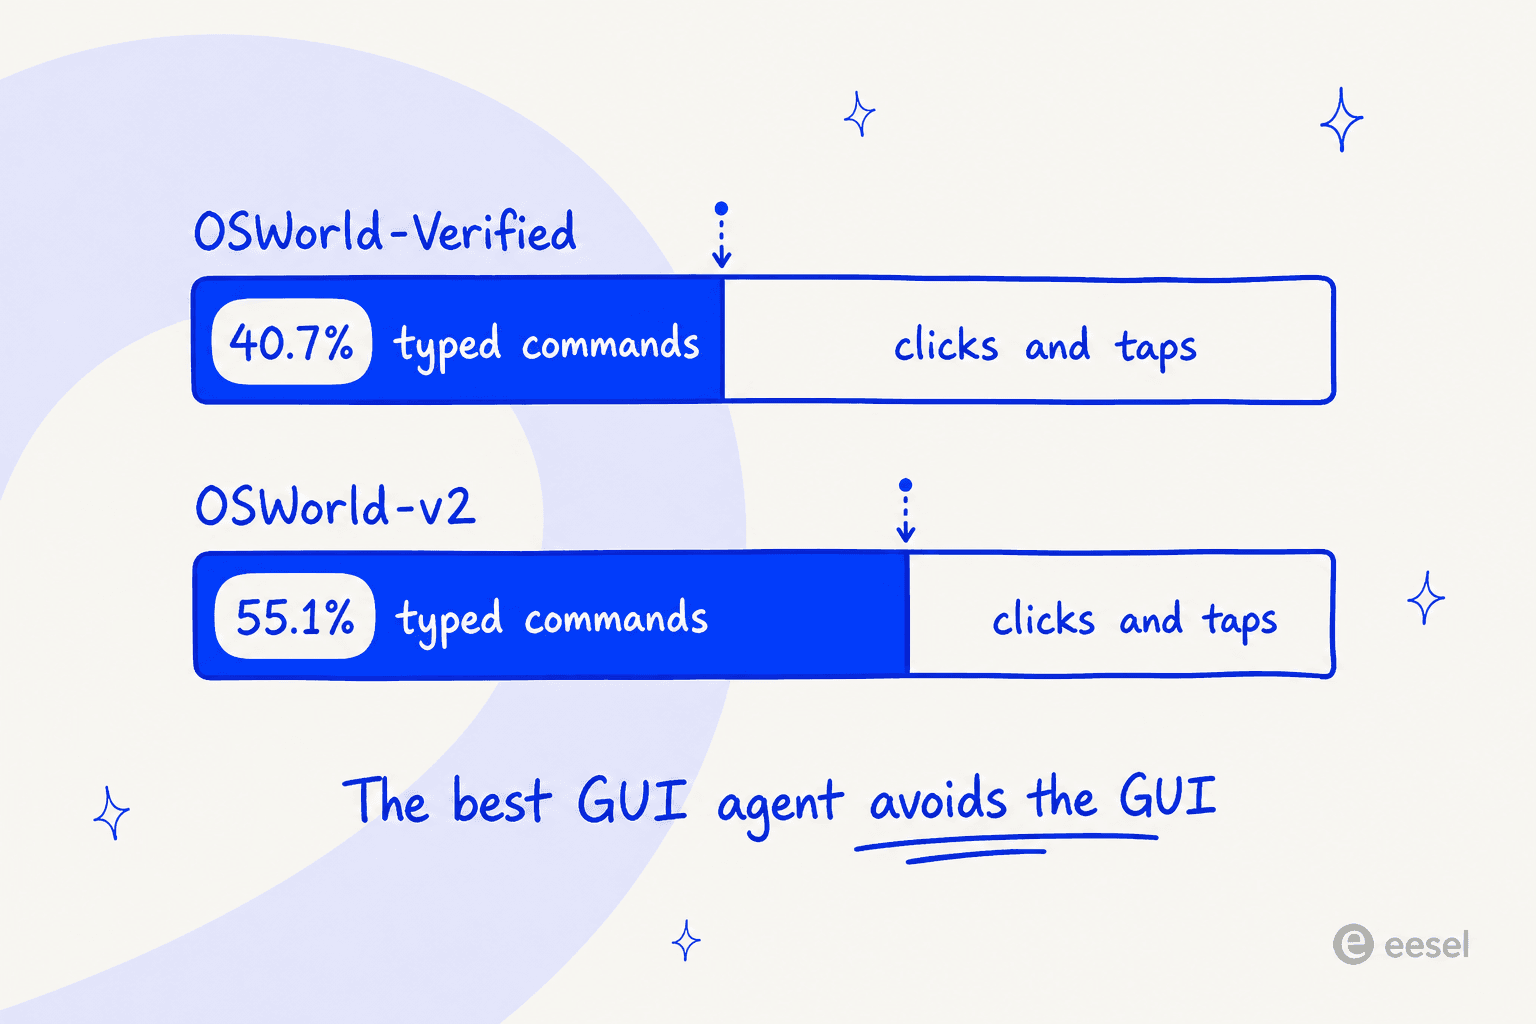
Relisez cela. Le meilleur agent de pilotage d'écran publié en 2026, avec un libre choix, consacre plus de la moitié de ses actions sur le benchmark de bureau le plus difficile à ne pas piloter l'écran.
Les chiffres de ByteDance disent la même chose dans l'autre sens. UI-TARS-2 obtient 29,6 % sur BrowseComp avec sa boîte à outils complète, et 7,0 % quand il est restreint à un fonctionnement GUI seul sans SDK. C'est leur propre ablation, et cela signifie qu'environ les trois quarts de ce score viennent de l'accès au terminal et aux outils plutôt que des pixels.
C'est aussi pourquoi les outils CLI agentiques surpassent discrètement les agents d'écran sur tout ce qu'un terminal peut atteindre, et pourquoi une automatisation axée API comme Zapier AI bat une automatisation qui clique sur des pixels dès que le point d'accès existe.
L'enseignement pratique est une question à poser avant de choisir quoi que ce soit dans le tableau ci-dessus : ce travail a-t-il une API ? Si oui, un agent de pilotage d'écran est la méthode chère, fragile et non auditable pour faire ce que vous pourriez faire avec un appel authentifié. Les agents GUI gagnent leur place sur les surfaces sans API, ce qui est une catégorie réelle et vaste : outils internes hérités, portails gouvernementaux, logiciels de bureau de 2009, tableaux de bord de fournisseurs sans histoire d'intégration. Elle est simplement beaucoup plus petite que ne le laissent croire les démonstrations.
La moitié des échecs n'a jamais été la faute du modèle
L'autre élément utile du rapport Qwen-UI-Agent est le Tableau 10, où les auteurs ont pris un modèle de référence, Qwen 3.7 Plus, et classé chacune de ses trajectoires échouées sur appareil réel plutôt que de simplement rapporter un taux de réussite. Je n'ai vu aucun autre laboratoire publier cela, et cela devrait changer votre façon de budgéter.
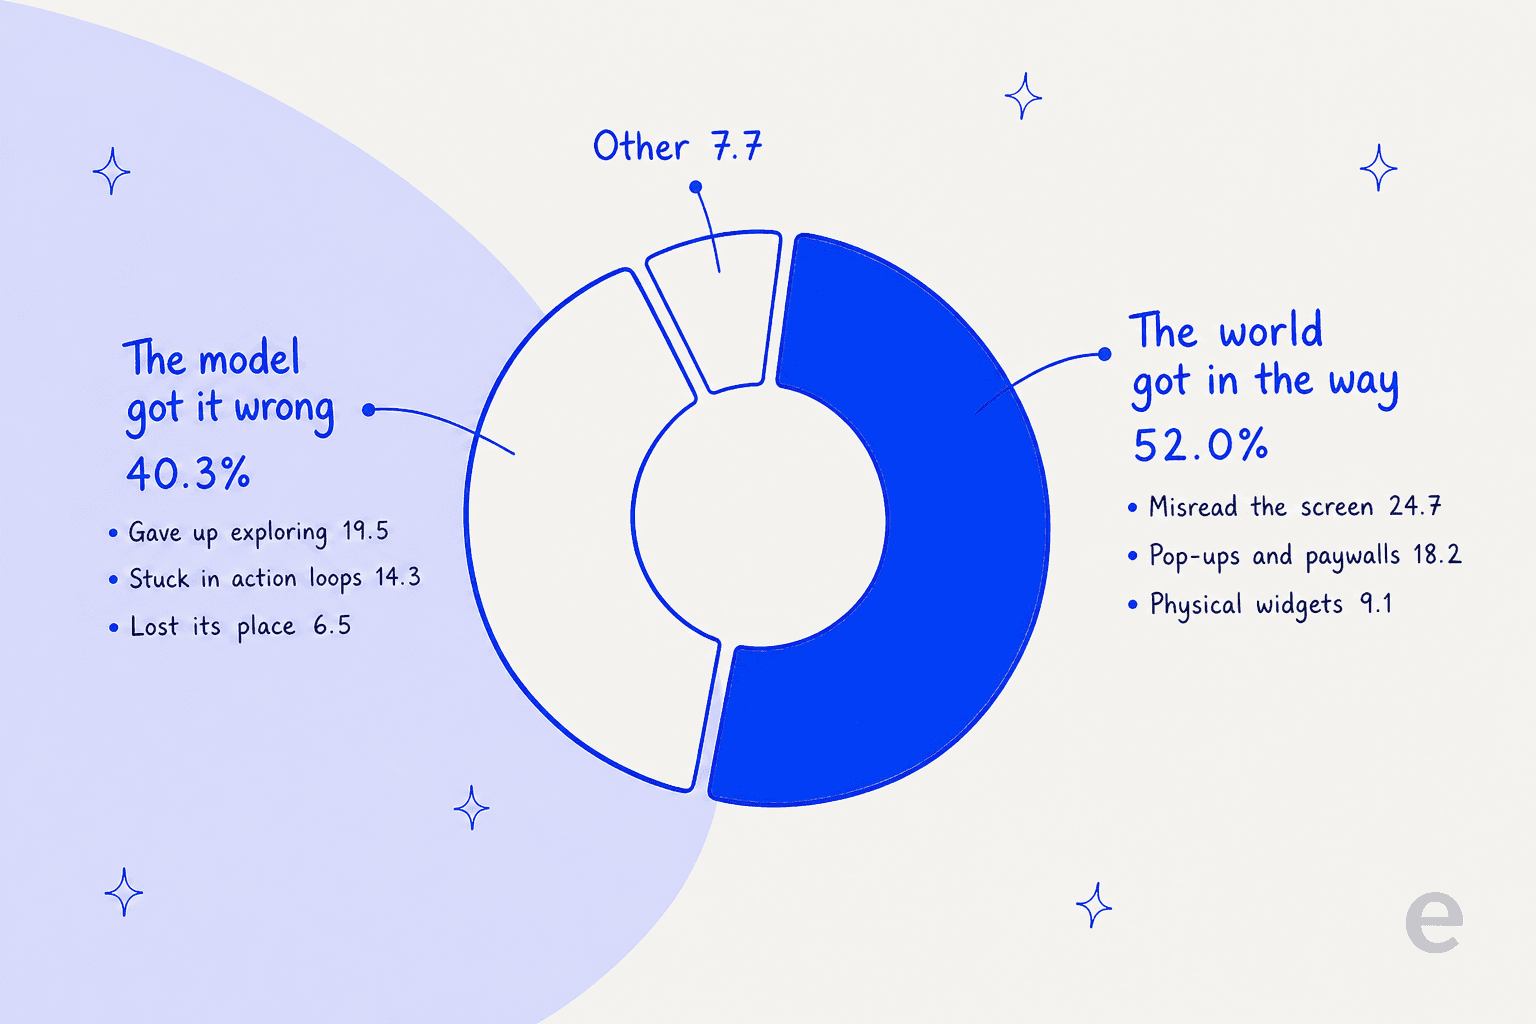
Sur les exécutions échouées de Qwen 3.7 Plus, les difficultés du scénario réel représentent 52,0 % : mauvaise lecture de l'interface à 24,7 %, interférence de fenêtres surgissantes, publicités, paywalls et CAPTCHA à 18,2 %, et problèmes de widgets physiques à 9,1 %. Les limites de capacité d'exécution représentent 40,3 % : ne pas explorer à 19,5 %, rester coincé dans des boucles d'actions à 14,3 % et perdre le fil de l'état d'exécution à 6,5 %. Qwen-UI-Agent est le modèle le plus fort, donc sa propre répartition sera différente, mais la forme de la distribution est la découverte.
La raison pour laquelle cette répartition compte est que acheter un meilleur modèle ne traite que la plus petite moitié. Une boîte de dialogue modale, un bandeau de cookies, un paywall et un CAPTCHA ne sont pas des problèmes de modèle, et ils constituent la majorité de ce qui tourne mal. C'est aussi pourquoi la ligne proxy de Browser Use et la gestion des CAPTCHA de Skyvern ne sont pas des fonctions accessoires. Elles s'attaquent à la distribution réelle des échecs, tandis qu'une API de pointe s'attaque aux 40 %.
Une réserve que je dois formuler, puisque je me suis appuyé sur les chiffres d'Alibaba tout du long. MobileWorld-Real est le benchmark propre d'Alibaba, et il est noté par AutoJudge, le juge agent d'Alibaba lui-même, que le rapport crédite de 92,8 % de précision en correspondance exacte sur 666 exemples examinés par des experts. Les auteurs citent l'erreur du juge comme leur première limite déclarée, ce qui est le bon réflexe. Les applications de démonstration viennent aussi de l'écosystème grand public chinois, donc 92,2 % sur appareils réels est un signal sur la méthode et non une promesse pour le SaaS occidental.
Toute alternative ouverte est une version affinée de Qwen
Celle-ci m'a pris au dépourvu. J'ai cherché une échappatoire architecturale à Alibaba et il n'y en a pas.
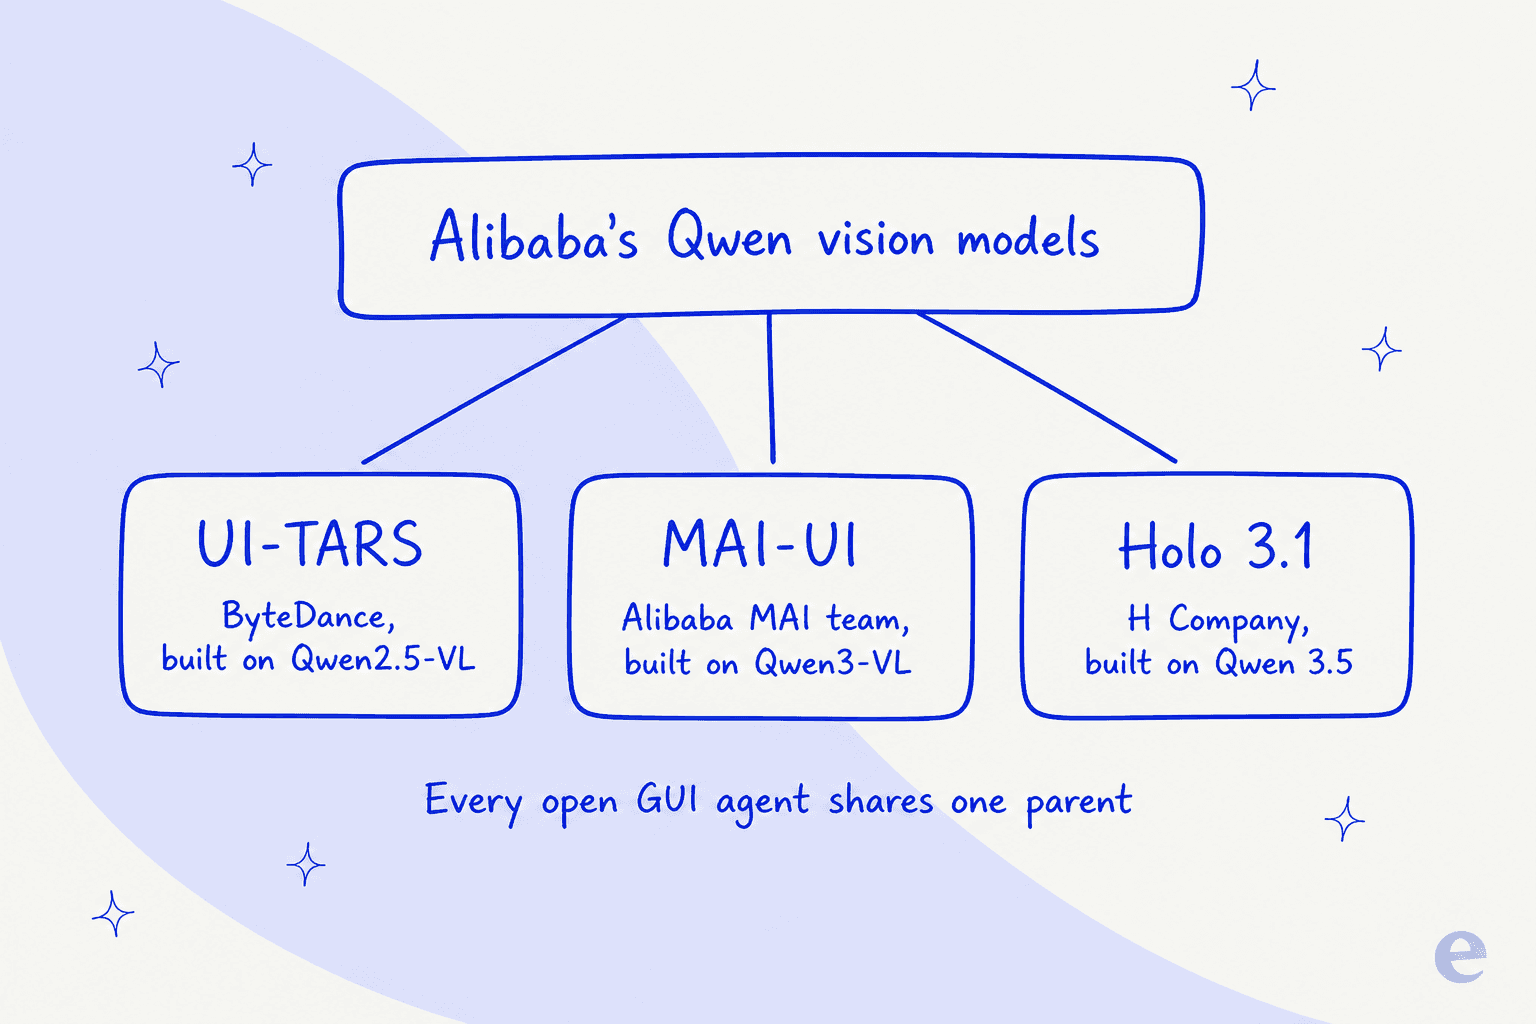
UI-TARS-1.5-7B est entraîné à partir de Qwen2.5-VL-7B, dit explicitement sur la propre page Seed de ByteDance, et son étiquette d'architecture sur Hugging Face est qwen2_5_vl. MAI-UI est qwen3_vl. Chaque génération de Holo est un dérivé de Qwen, de Qwen2.5-VL à Qwen3-VL puis à la famille Qwen 3.5, et le fichier de licence de Holo1 dit que le produit a été construit avec Qwen et que la Qwen Research License prévaut en cas de conflit. Chaque graphique de benchmark de la publication Holo 3.1 compare Holo à la famille Qwen 3.5 plutôt qu'à la lignée d'agents GUI d'Alibaba.
Donc « quitter Alibaba » en agents GUI à poids ouverts signifie changer de licence, de juridiction et d'équipe de post-entraînement, pas d'architecture de base. C'est quelque chose que l'on peut vraiment vouloir, surtout si la licence vous bloque, et l'apport de H Company lui est propre : le post-entraînement spécifique aux GUI, l'usine d'environnements synthétiques, le harnais. Mais personne ne devrait choisir l'un de ces trois en croyant avoir échappé à Qwen. La lecture honnête est que les modèles de vision d'Alibaba sont le substrat de toute cette catégorie ouverte, ce qui explique aussi pourquoi un agent GUI d'Alibaba la domine.
Ceux que j'ai laissés de côté, et pourquoi
Manus. J'ai essayé de l'évaluer et n'ai pas pu me connecter. Leur site affiche actuellement un avis indiquant que l'accès reprend à 8 h le 25 août 2026, expliquant qu'ils traitent une suppression de données planifiée pour se conformer à des exigences réglementaires dans certaines juridictions tandis que Manus se prépare à reprendre ses activités comme entreprise indépendante. Je ne peux pas recommander un produit que je n'ai pas pu ouvrir aujourd'hui. À revisiter, et notre présentation de Manus AI et le décryptage des tarifs de Manus AI le couvrent en attendant.
Seed 2.1 Pro. Le modèle d'utilisation de l'ordinateur de pointe actuel de ByteDance est réel et compétitif, avec 78,8 % sur OSWorld-Verified dans la comparaison d'Alibaba. Mais il n'est disponible que par API sur un cloud de la région Chine à ¥6 et ¥30 par million de jetons, et l'annonce de Seed 2.1 de ByteDance ne mentionne jamais UI-TARS, donc la filiation que la plupart de la couverture suppose est une inférence et non une déclaration.
GUI-Owl-1.5-32B-Instruct. Il apparaît dans tous les tableaux d'Alibaba comme le plus fort spécialiste ouvert antérieur, et avec 43,9 % sur MobileWorld contre 82,1 %, l'écart de génération est trop grand pour le recommander comme option actuelle.
Les assistants qui lisent l'écran sans jamais agir. Les outils de type Cluely regardent votre écran et conseillent, et les copilotes de navigateur comme Edge Copilot résument la page où vous êtes. Utiles, mais pas le même travail que mener une tâche à bien, donc hors sujet ici.
Tout ce qui n'a pas de prix. Le produit géré Computer-use Agents de H Company et toute plateforme d'agents « contactez-nous » que j'ai examinée. Si un fournisseur ne publie pas de tarif pour un produit mesuré, un acheteur ne peut pas comparer, et je ne vais pas faire semblant du contraire.
Si le travail, ce sont des tickets de support, l'écran est la mauvaise porte
Une bonne partie des gens qui cherchent cela n'essaient pas d'automatiser une application de bureau héritée. Ils veulent une IA qui travaille un service d'assistance, et un agent de pilotage d'écran ressemble à la voie généraliste pour y arriver.
Je m'y opposerais, et pas seulement parce que je travaille sur l'alternative. Votre service d'assistance a déjà une API. Zendesk, Freshdesk, Gorgias, Front et Jira Service Management exposent tous le ticket comme un objet que vous pouvez lire et écrire, ce qui signifie qu'un agent de pilotage d'écran choisit de localiser ce ticket en le cherchant du regard et en cliquant dessus. C'est pourquoi les outils spécialisés de tri de tickets et un agent IA de service d'assistance surpassent l'automatisation d'écran sur la même file. Chaque changement de mise en page, fenêtre modale et test A/B devient un nouveau mode de défaillance, et d'après le Tableau 10 ci-dessus, cette classe de problèmes est la majorité de ce qui casse.
Il y a aussi un problème plus subtil qu'une équipe qui l'exécute en production a découvert à la dure, et c'est la chose la plus pointue que j'ai lue de la semaine :
"we run screen-driven agents against web forms in production and the failure mode that took us longest to find wasn't navigation, it was commits that don't commit. a react controlled select can render the right value after a click while the framework's internal state never updated, so every pixel says done and the submitted payload says null. vision-only verification passes because the screen genuinely looks correct."
Chaque pixel dit terminé et la charge envoyée dit null. C'est tout le risque d'un agent piloté par pixels sur une file de tickets en une ligne, et le fournisseur mis en cause dans ce fil l'a concédé : son agent est piloté par l'écran, donc ils ne prétendent pas que les pixels puissent prouver chaque transition d'état cachée. Un appel d'API a soit renvoyé 200, soit non.
Le plus gros problème, c'est le test. Chaque fournisseur de cet article recommande une machine virtuelle isolée, une liste de domaines autorisés et un humain dans la boucle, et aucun ne propose un test à blanc sur votre propre travail passé. Ce manque n'est pas théorique. C'est la première question que pose un responsable du support, presque dans ces mots :
"The AI will never be able to answer 100% of the questions, but if it tries and just answers 'sorry I don't know this,' I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer, then the point is a little bit gone. I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
C'est un responsable CX d'une marque de compléments alimentaires en vente directe qui traite environ 7 000 tickets par mois sur Gorgias et Shopify. Un agent GUI n'a pas de réponse à cela, car un clic ne porte aucun score de confiance, et il n'a rien qui ressemble à une escalade par IA. Le choix du modèle compte beaucoup moins ici que la récupération d'information, ce dont traite notre article sur le meilleur LLM pour le support.
J'ai appris cette partie à la dure et non en théorie. Au début, trois comptes eesel payants avaient des bots qui inventaient des réponses quand la récupération revenait vide, parce que le repli strict manquait. L'un a inventé des affirmations d'abonnement sur des cellules solaires et les a envoyées à de vrais clients. Un autre, interrogé sur un produit, a répondu « Oxygen » tout droit sorti du tableau périodique. Rien dans le produit ne me mentait, il racontait simplement un succès qu'il n'avait pas obtenu, la même classe d'affirmation qu'un agent GUI annonçant avoir cliqué sur le bouton. La différence est qu'un appel d'API laisse une trace que vous pouvez vérifier et qu'une coordonnée n'en laisse pas. Cet incident explique pourquoi chaque déploiement est désormais simulé sur des tickets historiques avant d'approcher un client, et c'est l'argument le plus fort que je connaisse pour prévenir les hallucinations par conception plutôt que par prompt.
Essayez eesel pour votre service d'assistance
Si ce dont vous avez vraiment besoin, c'est d'un coéquipier IA sur votre file de tickets et non d'une souris robot, c'est ce qu'est eesel. Elle se connecte à Zendesk, Freshdesk, Gorgias, Front, Help Scout, HubSpot, Salesforce Service Cloud et Jira Service Management via leurs API et appelle des outils nommés, donc une action est un appel d'API journalisé et non une coordonnée dont quelqu'un espère qu'elle est tombée sur le bon pixel.
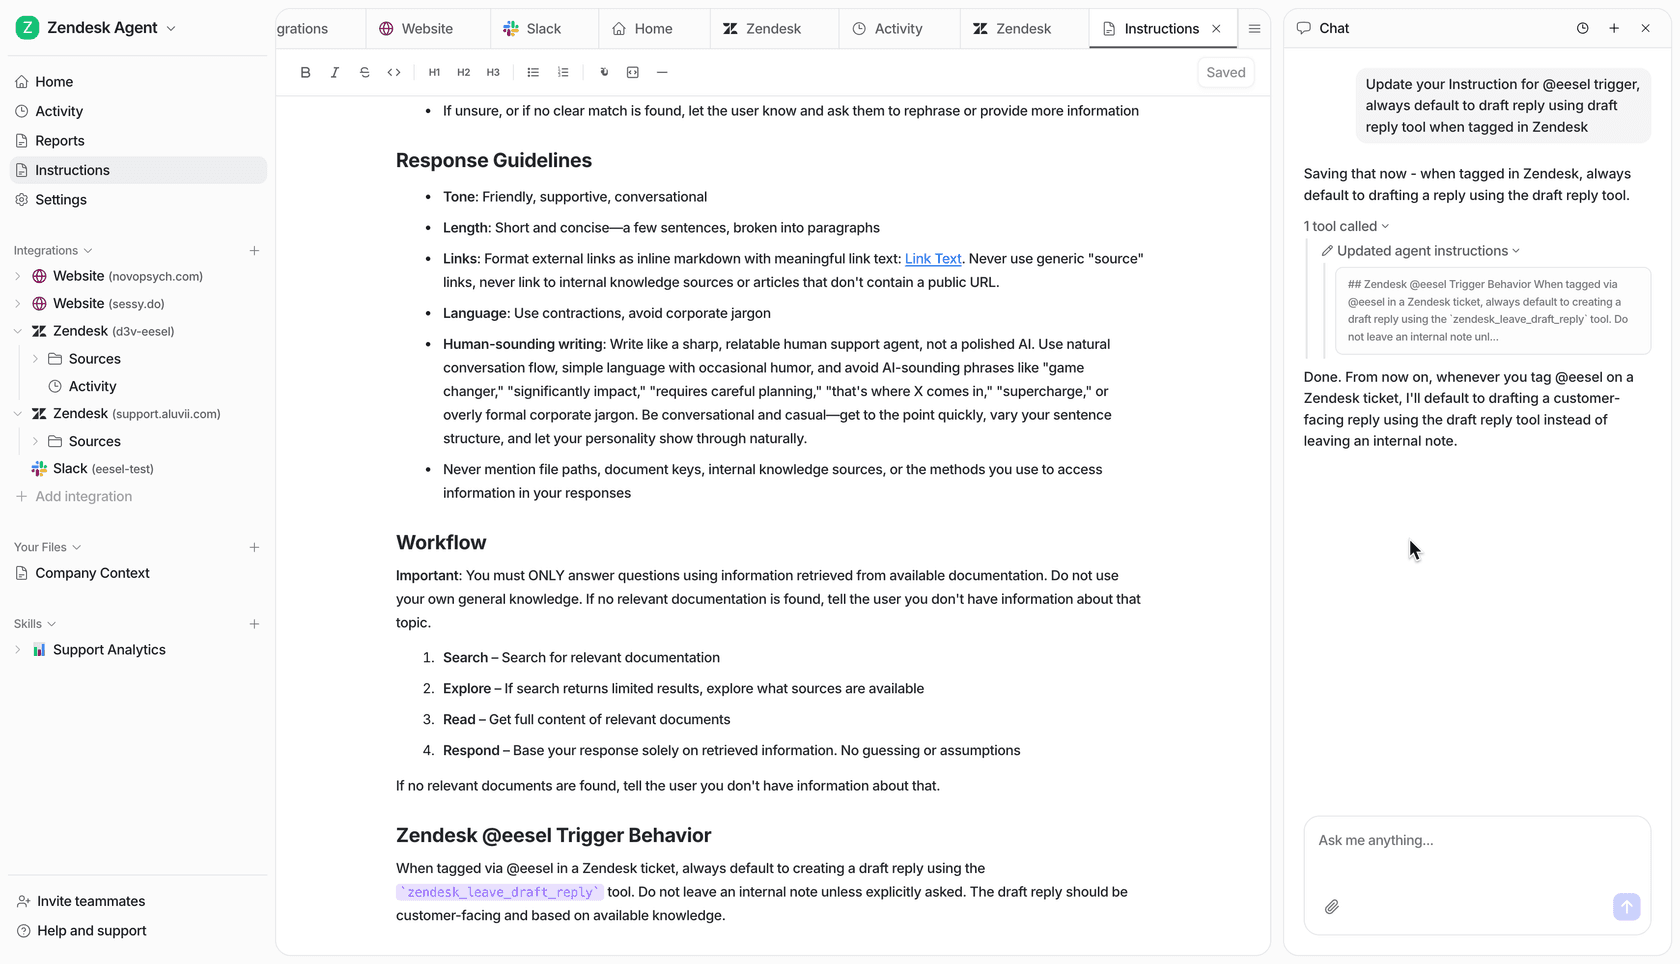
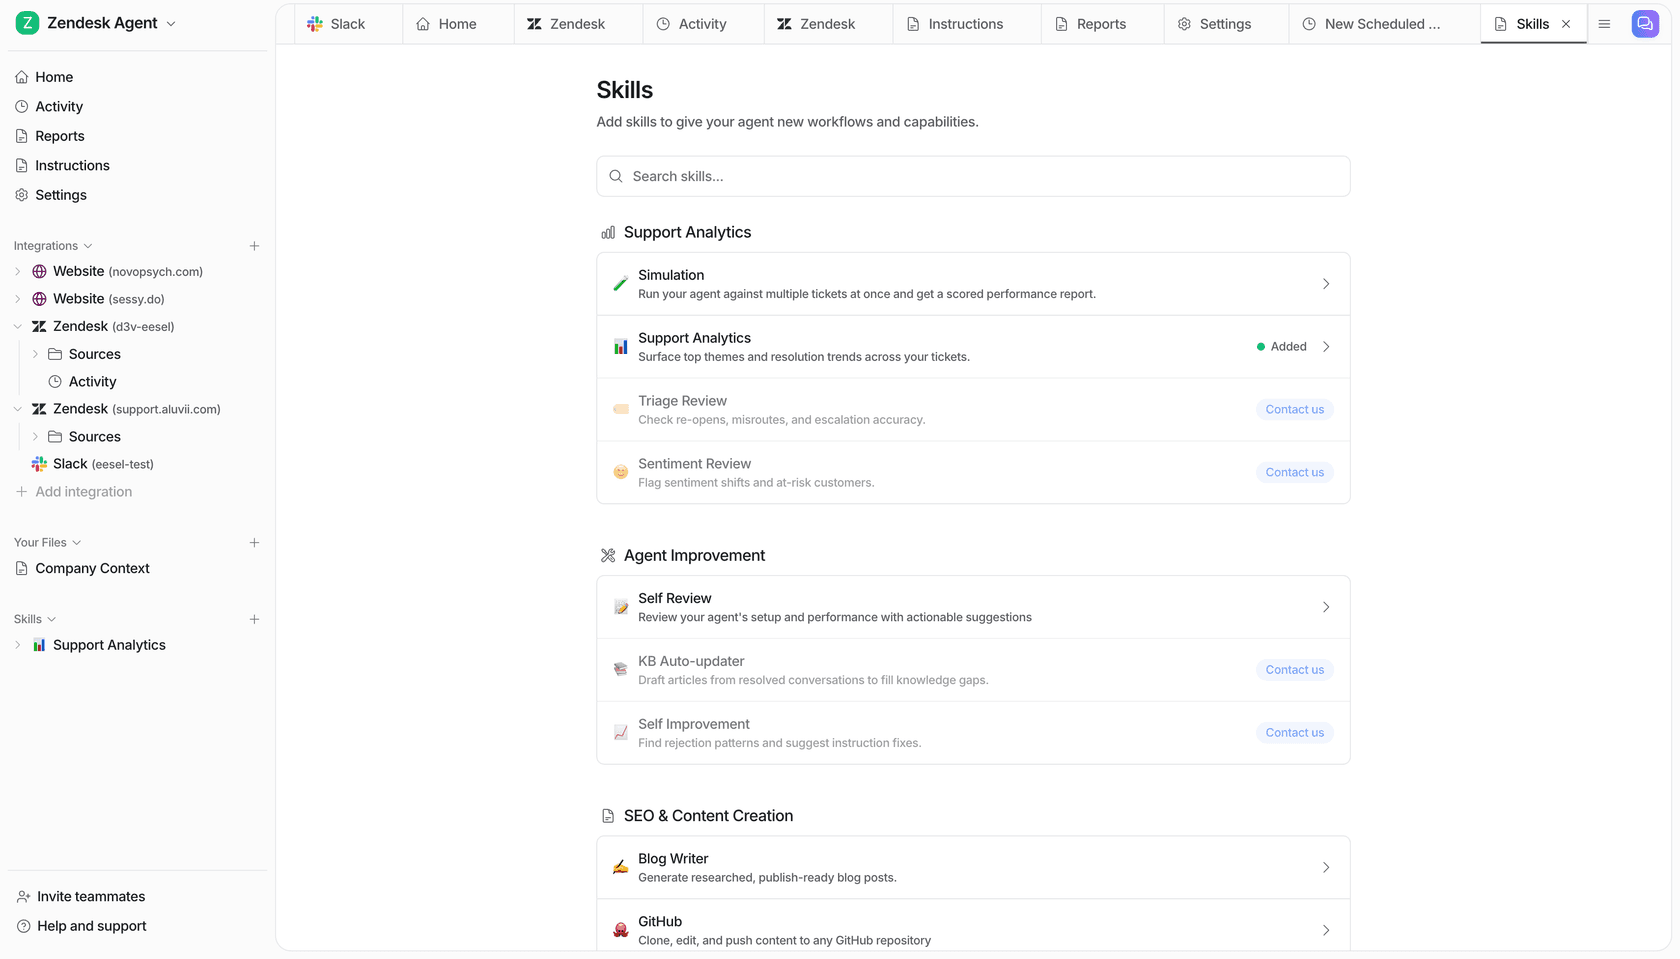
La partie qui compte le plus pour quiconque vient de lire huit sections sur des agents impossibles à tester est la Simulation. Pointez-la sur vos propres tickets passés et elle exécute le pipeline complet de l'agent dans un bac à sable sans envoyer de vraies réponses, fait noter chaque réponse par un juge, montre une comparaison côte à côte avec ce que votre équipe a réellement envoyé, marque chacune comme Parfaite, Acceptable ou Échec, et renvoie les lacunes de couverture par thème avec des corrections d'instructions suggérées. Ensuite, vous relancez. C'est le test à blanc que rien dans cet article ne propose.
La tarification fonctionne comme le widget ci-dessus le suggère : un prix mensuel fixe, à partir de 299 $/mois pour 500 crédits, où 1 crédit correspond à un ticket ou un chat quel que soit le nombre de messages échangés, sans frais de plateforme ni frais par siège. Si vous routez 200 de vos 1 000 tickets, seuls ces 200 consomment des crédits ; 1 000 crédits par mois coûtent 499 $. Comparez cela à un compteur par étape où le même ticket coûte ce que l'interface décide de vous facturer ce jour-là. Une réserve honnête : un crédit est consommé que le résultat soit parfait ou non, donc c'est par ticket traité et non par ticket résolu.
Le grounding est l'autre moitié. eesel lit votre centre d'aide, votre documentation et vos tickets passés existants plutôt que de regarder un écran, et nos guides sur la façon d'entraîner sur une base de connaissances et de connecter des bases de connaissances expliquent comment cela fonctionne en pratique.
Pour voir ce que cela donne en production, Gridwise a indiqué avoir résolu 73 % des demandes de niveau 1 le premier mois après un essai de sept jours, et Smava traite plus de 100 000 tickets par mois entièrement automatisés en allemand sur Zendesk. Si vous préférez d'abord voir le champ plus large, notre tour d'horizon de l'IA pour le service client est la comparaison honnête.
Commencez avec 100 crédits gratuits, sans carte, toutes les fonctionnalités débloquées. Essayez eesel, ou pointez-la d'abord sur les tickets du mois dernier et regardez le score avant de décider.
Comment tester un agent GUI avant qu'il touche la production ?