Les 9 meilleures alternatives à Grok Voice 3 en 2026

Rama Adi

Katelin Teen
Dernière modification October 15, 2026
Pourquoi regarder au-delà de Grok Voice 3 ?
Je commence par la partie honnête : Grok Voice 3.0 est très bon. Dans mon test de Grok Voice 3, je l'ai désigné comme mon choix par défaut pour un agent téléphonique qui doit exécuter des actions, et rien de ce qui s'est passé depuis hier n'y change quoi que ce soit. Artificial Analysis l'a placé en 1re position de son indice speech-to-speech, 1er en réussite de tâches sur appels en direct (94,8 %) et 2e sur τ-Voice, le benchmark qui simule de vrais appels de support avec des outils et un document de politique.
"SpaceXAI's Grok Voice 3.0 is the new leading Speech to Speech model, debuting at #1 on the Artificial Analysis Speech to Speech Index at 86.9, while also being competitive on latency"
Alors pourquoi les gens cherchent-ils des alternatives à Grok Voice 3 à peine un jour après le lancement ? En lisant la documentation et les tableaux de benchmark, il y a cinq vraies raisons :
- La concurrence sur un compte neuf. La concurrence du speech-to-speech monte désormais avec les dépenses cumulées : 10 sessions à 0 $, 20 à 50 $, 50 à 250 $, 100 à 1 000 $ et 200 à 5 000 $. En production, c'est correct, mais une équipe qui veut tester 50 appels simultanés dès le premier jour doit prépayer pour débloquer le palier.
- Les langues. La documentation speech-to-speech de xAI liste 20+ langues. Gemini Live en liste 70, ElevenLabs 90+.
- C'est une API, pas un centre d'appels. Vous apportez la ligne téléphonique, le déroulé de l'appel, les analyses et le chemin d'escalade. xAI vend bien un Voice Agent Builder sans code, mais beaucoup d'équipes veulent une plateforme complète.
- La latence a évolué dans le mauvais sens. Le délai avant le premier son est de 0,81 seconde, contre 0,70 seconde sur Grok Voice 2.0. C'est toujours plus rapide que tous les modèles proches de l'indice, mais ce n'est pas le Grok le plus rapide.
- Le prix. 0,08 $ la minute (4,80 $ de l'heure) se situe dans la moyenne. Gemini 3.8 Live est mesuré à 0,84 $ de l'heure.
Si aucun de ces cinq points ne vous gêne, vous pouvez vous arrêter ici et figer grok-voice-3.0. Si l'un d'eux vous gêne, la bonne alternative dépend duquel c'est, et démêler cela est l'objet du reste de cet article. Pour une vue plus large au-delà du fournisseur, mon article sur les alternatives à xAI couvre aussi les modèles de texte.
Trois types d'alternatives
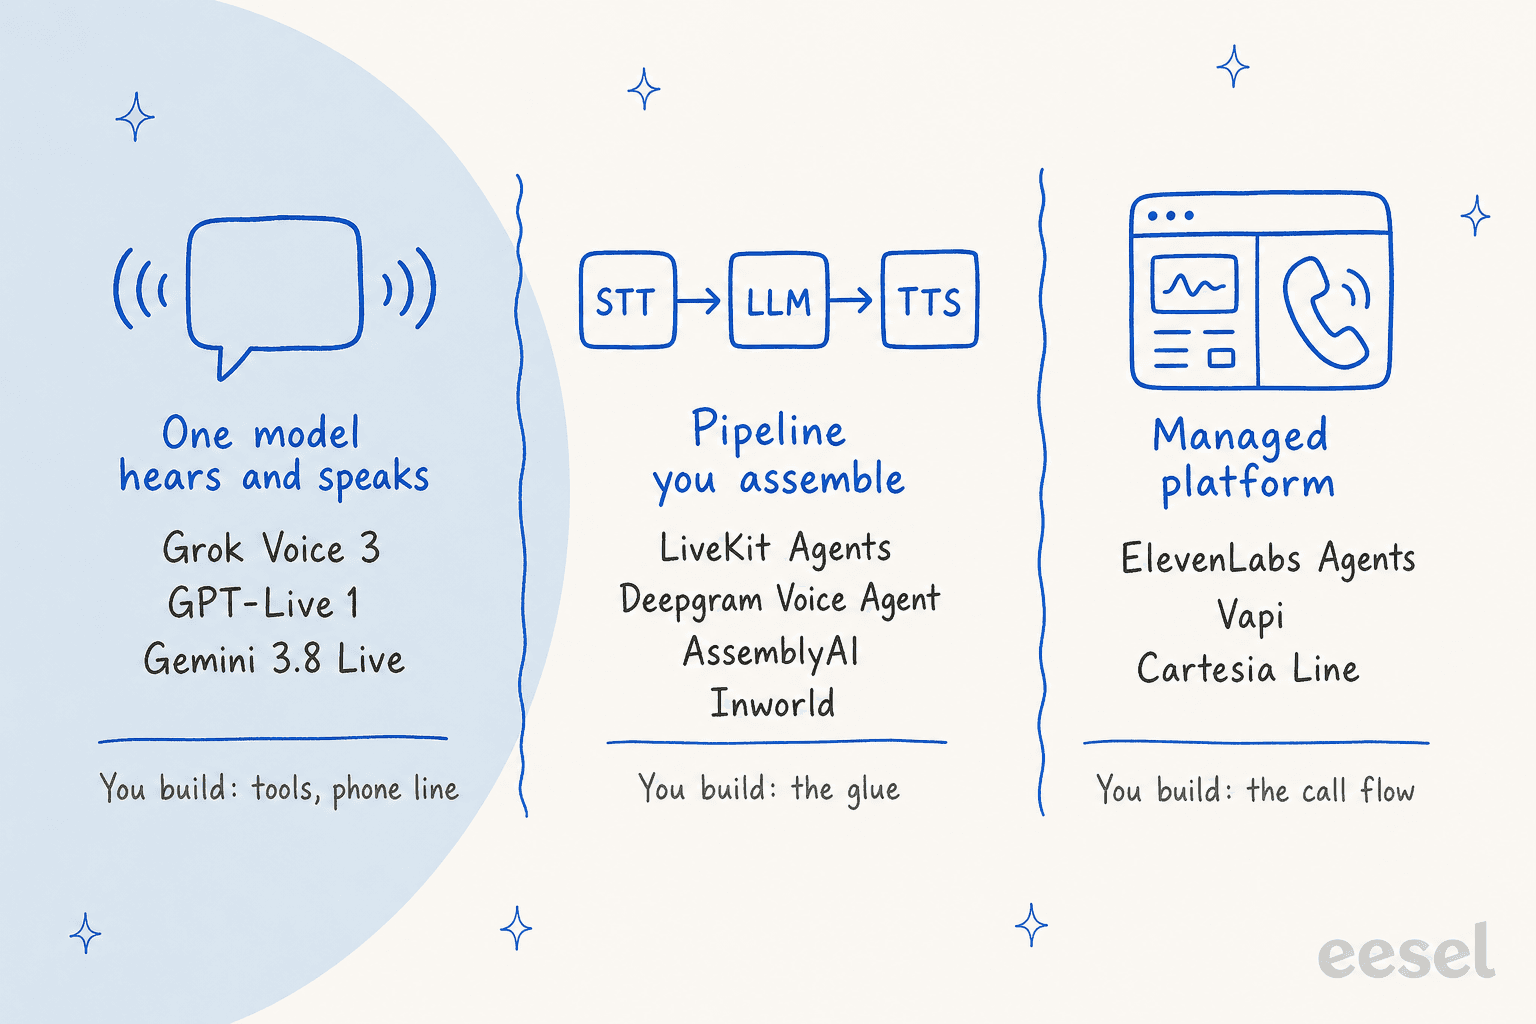
Quand j'ai demandé à ChatGPT des alternatives à Grok Voice 3, il a classé la réponse en trois catégories, et je pense que ce cadrage est ce que l'acheteur peut retenir de plus utile de cette page. Les outils ci-dessous ne sont pas interchangeables : passer d'une catégorie à l'autre change qui gère la prise de parole et la téléphonie, ainsi que les appels d'outils.
- Les modèles speech-to-speech écoutent de l'audio et répondent en audio au sein d'un seul modèle. Le moins de pièces mobiles, une interruption naturelle et les meilleurs scores de benchmark. Vous construisez quand même les outils et la connexion téléphonique.
- Les pipelines enchaînent speech-to-text, un LLM de texte et text-to-speech. Plus d'étapes, mais vous pouvez changer n'importe quelle brique, utiliser n'importe quel LLM et lire une transcription propre à chaque étape.
- Les plateformes gérées enveloppent un pipeline avec des numéros de téléphone, un constructeur, des tests et des analyses. Vous construisez le déroulé de l'appel ; elles gèrent la plomberie.
Un développeur sur Hacker News a contesté la première catégorie, et cela vaut la peine d'être gardé en tête :
"Yeah, sadly "audio to audio" seems to mean "we transcript it automatically for you internally which gets passed to the model", otherwise we'd be seeing models that are able to hear nuance in the input voice and pronunciation, which AFAIK, no model does yet."

Pour une ligne de support, c'est moins un problème que le rendu sonore. Les appelants veulent qu'on retrouve leur commande, pas qu'on apprécie leur accent.
Comment j'ai choisi ces neuf
Je construis la couche d'intégration chez eesel, c'est-à-dire le code qui relie un agent IA à un helpdesk en production, donc je lis ces outils en constructeur. Pour chacun, j'ai lu la documentation et la page de tarifs du fournisseur le 15 octobre 2026, capturé moi-même les pages produit et tiré chaque chiffre de benchmark du classement speech-to-speech d'Artificial Analysis. Les prix viennent uniquement des pages des fournisseurs.
Ce que je n'ai pas fait, c'est faire passer mille appels de production par chacun, car Grok Voice 3.0 n'a qu'un jour. Quand je cite une latence, c'est soit le délai avant le premier son mesuré par Artificial Analysis, soit le chiffre publié par le fournisseur, et je précise lequel.
La liste restreinte est partie des six outils cités par ChatGPT (OpenAI, Google, ElevenLabs, Deepgram, LiveKit, Vapi), puis j'en ai ajouté trois qui apparaissaient dans les propres tests de systèmes en cascade du benchmark ou qui ont une vraie API d'agents vocaux : Cartesia, AssemblyAI et Inworld. J'ai écarté Retell AI parce que sa niche recoupe celle de Vapi ; mon test de Retell AI en parle si vous hésitez entre les deux.
Les alternatives à Grok Voice 3 comparées
Voici tout le paysage dans un seul tableau. « Tarif affiché » est le chiffre de la page de tarifs du fournisseur, avec ce qu'il laisse de côté dans la colonne suivante.
| Outil | Type | Tarif affiché | Non inclus | Départ gratuit | Concurrence (entrée au maximum publié) | Délai avant le premier son | Langues | Téléphone | Conformité (déclarée par le fournisseur) |
|---|---|---|---|---|---|---|---|---|---|
| Grok Voice 3.0 (référence) | Speech-to-speech | $0.08/min | Votre opérateur | Aucune offre gratuite indiquée | 10 à 200 selon les dépenses cumulées | 0.81s (AA) | 20+ | SIP natif, Twilio, LiveKit | SOC 2 Type II, compatible HIPAA avec BAA, DPA RGPD |
| GPT-Live 1 | Speech-to-speech | $0.05/min | Modèle backend et usage des outils | Non | Absent de la page de tarifs | 1.24s à 1.34s (AA) | Non indiqué sur la page du modèle | SIP direct, Twilio, Telnyx, Bandwidth | SOC 2 Type 2, BAA disponible |
| Gemini 3.8 Live | Speech-to-speech | $0.005/min en entrée, $0.018/min en sortie | Search grounding au-delà de 5,000/mois | Oui, offre gratuite | Absent de la page de tarifs | 1.18s (AA) | 70 | WebSocket uniquement | Données de l'offre payante non utilisées pour l'entraînement |
| LiveKit Agents | Pipeline (open source) | $0.01/min de session d'agent | STT, LLM, TTS, téléphonie | 1,000 min d'agent/mois | 5 à 600 | Dépend des modèles | Dépend des modèles | Numéros US, SIP, Twilio, WhatsApp | SOC 2 Type II, BAA sur Scale |
| Deepgram Voice Agent | Pipeline (géré) | $0.075/min | Rien sur Standard | $200 de crédit | Jusqu'à 45 en paiement à l'usage | Non mesuré | 45+ (Nova) | Documentation de téléphonie | SOC 2 Type 2, HIPAA BAA, endpoint UE |
| AssemblyAI Voice Agent | Pipeline (géré) | $0.075/min | Rien d'indiqué | Inscription gratuite | Absent de la page de tarifs | Non mesuré | 32 | Guide du numéro de téléphone | SOC 2 Type 2, BAA |
| Inworld Realtime | Pipeline (API de type S2S) | Par brique : STT $0.15/hr, TTS à partir de $15/1M de caractères | Jetons du LLM | Départ gratuit à la demande | Non publiée | 204ms au mieux, 462ms médiane (fournisseur) | ~500 (TTS) | G.711 depuis Twilio | SOC 2 Type II, RGPD, HIPAA en option |
| ElevenLabs Agents | Plateforme gérée | $0.08/min | LLM, votre opérateur | 15 min/mois | 4 à 40, pic jusqu'à 3x | Non mesuré | 90+ | Twilio, trunk SIP | BAA sur Enterprise |
| Vapi | Plateforme gérée | $0.05/min d'hébergement | STT, LLM, TTS au prix coûtant | $5 de crédit | 4 à 30, +$10 par ligne | Non mesuré | Dépend des modèles | SIP Vapi gratuit, Twilio en direct | Option HIPAA $2,000/mois |
| Cartesia Line | Plateforme gérée | $0.06/min | $0.014/min pour un numéro Cartesia | $1 de crédit d'agent (~17 min) | 8 à 60 | Non mesuré | Dépend de la voix | Numéros Cartesia | SOC 2 Type II, HIPAA, RGPD |
La colonne de latence AA n'est remplie que pour les modèles speech-to-speech, puisqu'Artificial Analysis ne mesure le délai avant le premier son que sur ceux-là. Pour les pipelines et plateformes, la latence dépend des modèles que vous branchez, c'est la variable que vous contrôlez.
Ce que coûtent vraiment les minutes
Les tarifs affichés ne se comparent pas, car chaque fournisseur laisse de côté une brique différente. Le calculateur ci-dessous met tous les outils sur le même pied : une minute d'appel de support où l'agent parle environ la moitié du temps. Saisissez vos minutes d'appel mensuelles et les barres se reconstruisent d'elles-mêmes.
Saisissez vos minutes d'appel mensuelles pour voir la facture de chaque outil au tarif public. Tarifs issus de la page de tarifs de chaque fournisseur au 15 octobre 2026 ; GPT-Live 1, Inworld et ElevenLabs excluent une partie du coût du LLM, considérez-les donc comme des planchers.
Deux choses ressortent. D'abord, la plupart du paysage se regroupe entre 0,075 $ et 0,083 $ la minute, ce qui veut dire que Grok Voice 3.0 n'est pas cher pour ce qu'il fait. Ensuite, les deux extrêmes sur le coût (Gemini 3.8 Live et Inworld) sont aussi les deux où vous échangez quelque chose de réel : la précision sur les tâches de support pour Gemini, et un choix de LLM à construire soi-même pour Inworld. Pour situer ce que vaut une minute de voix IA face à un humain, mon détail sur l'agent IA contre le coût humain fait le calcul.
Les remplacements speech-to-speech
Ces deux-là sont les remplacements directs, même architecture que Grok, avec un seul modèle qui écoute et parle. Si votre code parle déjà le format d'événements d'OpenAI Realtime (l'API de Grok est conçue pour y être compatible), le passage se résume surtout à un endpoint et une clé.
Le benchmark qui compte le plus pour une ligne de support est τ-Voice, qui note si le problème d'un appelant simulé a réellement été réglé. C'est là que trois familles speech-to-speech se séparent :
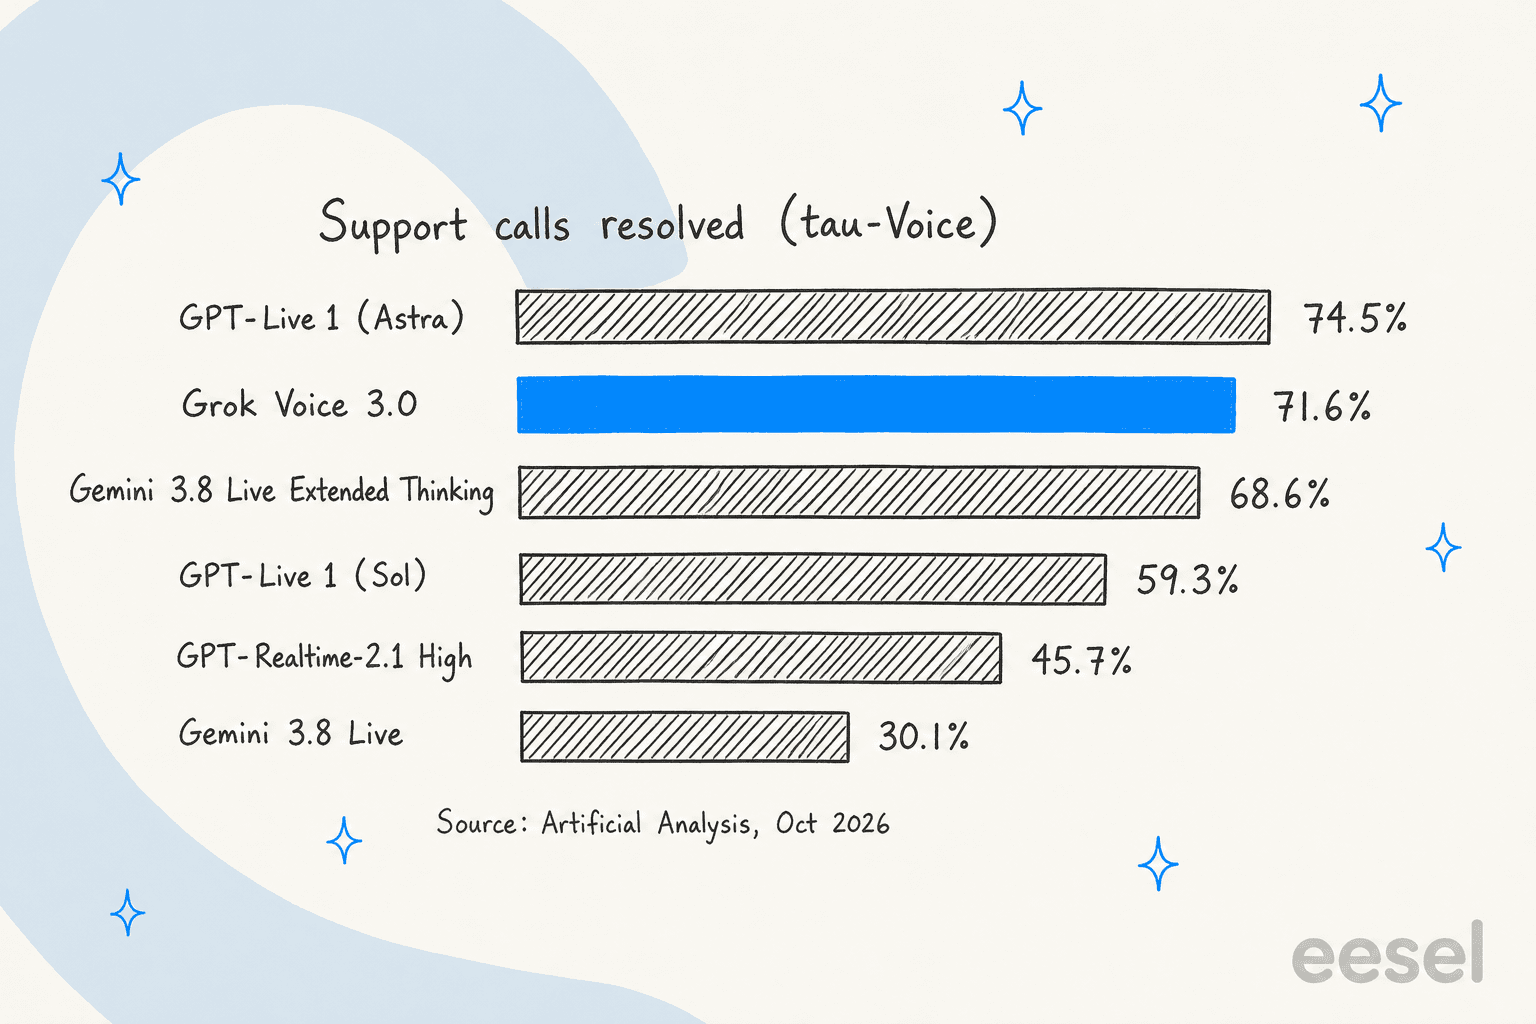
La barre du bas mérite le coup d'œil. Gemini 3.8 Live est la deuxième voix la plus appréciée dans les tests d'écoute à l'aveugle et le modèle le moins cher ici, et pourtant il résout 30,1 % des appels. Agréable et correct sont deux scores différents.
1. OpenAI GPT-Live 1 et l'API Realtime
Idéal pour : les lignes de support où terminer la tâche compte plus que tout, et les équipes déjà sur OpenAI.
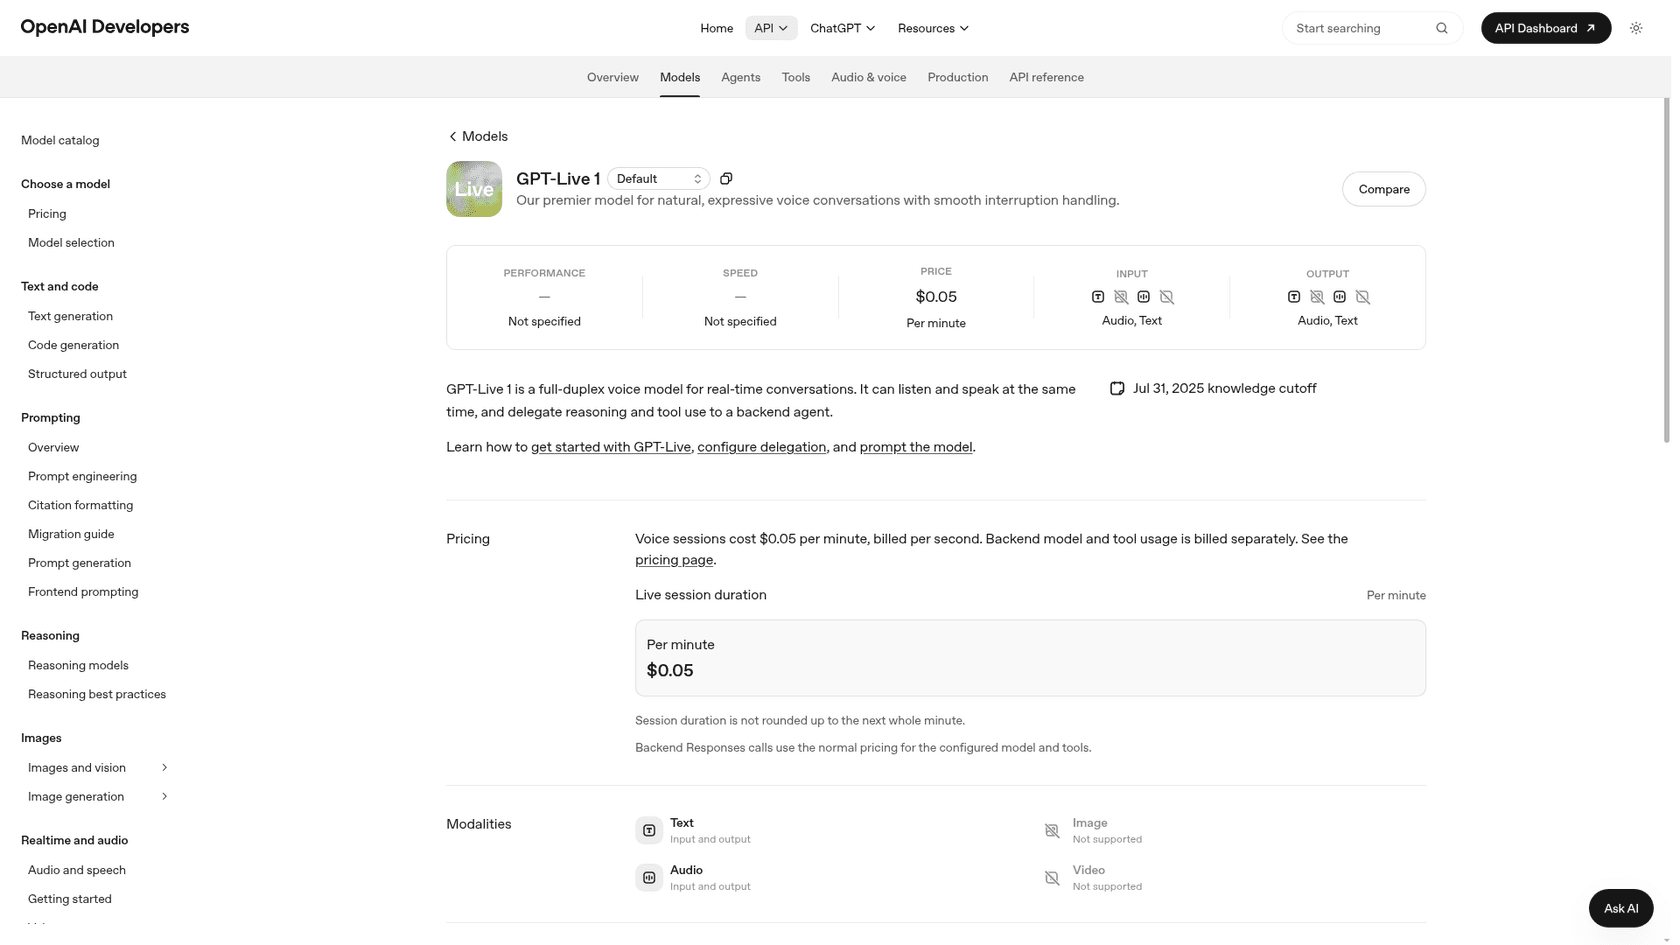
OpenAI a maintenant deux voies vocales. GPT-Live 1 est un modèle full-duplex qui, selon sa page de modèle, "can listen and speak at the same time, and delegate reasoning and tool use to a backend agent". L'API Realtime plus ancienne, avec gpt-realtime-2.1, est un modèle speech-to-speech unique qui gère les tours audio, les outils et les interruptions dans une seule session. La distinction compte pour le support : GPT-Live confie le raisonnement difficile à un modèle de texte distinct (Astra ou Sol dans le benchmark), et c'est cette configuration qui domine τ-Voice.
Les appels téléphoniques peuvent l'atteindre via un trunk SIP direct, et OpenAI publie des guides partenaires pour Twilio, Telnyx, Bandwidth, LiveKit et Daily/Pipecat dans sa documentation de téléphonie. Les développeurs sur Hacker News étaient enthousiastes au lancement :
"I was excitedly awaiting this hitting the API, because ofc there wasn't a super high fidelity option for drop-in voice interface in front of a given harness. This is blowing me away so far!"
Ce qu'il fait mieux que Grok :
- Le seul modèle qui bat Grok sur τ-Voice : 74,5 % pour GPT-Live 1 (Astra, medium) contre 71,6 %.
- L'agent backend est n'importe quel modèle que vous configurez, donc votre agent de texte actuel et ses outils peuvent se trouver derrière la voix.
- Facturé à la seconde à 0,05 $ la minute, sans arrondi à la minute entière.
Où il déçoit :
- Plus lent à commencer à parler : 1,34 s avant le premier son pour Astra et 1,24 s pour Sol, contre 0,81 s pour Grok.
- Les 0,05 $ affichés excluent le modèle backend. Artificial Analysis a mesuré la configuration Astra à 5,83 $ de l'heure, plus que les 4,80 $ de Grok.
- Artificial Analysis note que les scores τ-Voice de GPT-Live proviennent d'un seul essai, contre trois pour la plupart des modèles.
- La page du modèle ne liste pas les langues prises en charge, une lacune que un utilisateur de HN a aussi relevée.
Tarifs :
| Modèle | Prix | Remarques |
|---|---|---|
| GPT-Live 1 | $0.05/min, facturé à la seconde | Les appels Responses du backend sont facturés aux tarifs de ce modèle |
| gpt-realtime-2.1 | $32 / $64 par 1M de jetons audio en entrée / sortie | Texte $4 / $24 par 1M |
| gpt-realtime-2.1-mini | $10 / $20 par 1M de jetons audio en entrée / sortie | Texte $0.60 / $2.40 par 1M |
Le tout vient de la page de tarifs d'OpenAI. Le calcul complet est dans mon article sur les tarifs de GPT-Live 1, et il existe une liste séparée d'alternatives à GPT-Live 1 si vous arrivez par l'autre côté.
Mon avis : le remplacement le plus solide si vos appels sont riches en tâches (remboursements, réservations, changements de compte) et que vous supportez une demi-seconde de plus avant que l'agent parle. À éviter si vous avez besoin d'une liste de langues publiée ou d'un budget ferme à la minute. Si vous branchez des outils, lisez d'abord sur les appels d'outils en Realtime, car le silence pendant qu'une fonction s'exécute est le moment où les appelants raccrochent.
2. Google Gemini 3.8 Live
Idéal pour : les appels à fort volume et faible enjeu (lignes d'information, rappels de réservation, accueils multilingues) où le coût et la couverture linguistique priment sur la précision des tâches.
Google appelle Gemini 3.8 Live "the default option for most low-latency voice agent experiences", et c'est un modèle stable, pas une préversion. La Live API est un WebSocket avec état qui accepte audio, images et texte et répond en audio, dans 70 langues. Les appels de fonctions s'exécutent désormais de manière asynchrone par défaut, donc le modèle peut continuer à parler pendant qu'une recherche tourne.
Il existe aussi une variante Extended Thinking, qui raisonne en arrière-plan. Elle obtient 68,6 % sur τ-Voice, proche de Grok, mais son délai avant le premier son est de 1,35 s et Artificial Analysis l'a mesurée à 3,50 $ de l'heure. La famille Live de Google comprend aussi Live Translate pour la traduction speech-to-speech, un modèle à part.
Ce qu'il fait mieux que Grok :
- Prix : 0,005 $ la minute d'audio en entrée et 0,018 $ en sortie. Artificial Analysis a mesuré 0,84 $ de l'heure contre 4,80 $ pour Grok.
- 70 langues prises en charge contre 20+.
- Une offre gratuite sur la page de tarifs, et sur l'offre payante vos données ne servent pas à améliorer les produits de Google.
- Le deuxième meilleur score de préférence humaine du classement (Elo 1088).
Où il déçoit :
- τ-Voice de 30,1 % pour le modèle standard. Il sonne bien et ne termine souvent pas le travail.
- Les sessions sans compression de contexte sont limitées à 15 minutes en audio, et une connexion dure environ 10 minutes avant qu'il vous faille la reprise de session.
- WebSocket uniquement. Pas de SIP natif, donc une ligne téléphonique passe par un partenaire comme LiveKit.
- Le modèle a une limite de 131 072 jetons en entrée.
Tarifs :
| Élément | Offre gratuite | Offre payante |
|---|---|---|
| Entrée audio | Gratuit | $3.00 par 1M de jetons ou $0.005/min |
| Sortie audio | Gratuit | $12.00 par 1M de jetons ou $0.018/min |
| Entrée / sortie texte | Gratuit | $0.75 / $4.50 par 1M de jetons |
| Google Search grounding | Pris en charge | 5,000 gratuits/mois, puis $14 par 1,000 |
Mon avis : le bon choix quand le coût à la minute décide de tout et que l'agent informe surtout plus qu'il n'agit. Pour une ligne qui doit modifier des commandes ou émettre des avoirs, je testerais Extended Thinking face à Grok avant de faire confiance au modèle standard. Si vous utilisez déjà Gemini 3.8 Flash pour le texte, le compte de facturation commun est un petit bonus.
Les pipelines que vous assemblez
Ces quatre enchaînent speech-to-text, un LLM de texte et text-to-speech. Les étapes supplémentaires coûtent de la latence, et un développeur sur Reddit a bien résumé le compromis :
"The core problem I found with the Retell/Vapi approach was the latency that chaining 3 services sequentially together added. STT provider → LLM → TTS provider. Each hop adds latency and you're managing 3 WebSocket connections plus your own VAD and turn-taking logic."

L'envers de la médaille, c'est le contrôle. Avec un pipeline, le LLM est n'importe quel modèle de votre choix, y compris celui que votre agent de texte utilise déjà, et vous obtenez une transcription propre à chaque étape pour l'assurance qualité et les résumés d'appels. Deepgram, AssemblyAI et Inworld exploitent le pipeline pour vous sous forme d'une seule API, tandis que LiveKit vous donne le framework pour l'exploiter vous-même.
3. LiveKit Agents
Idéal pour : les équipes d'ingénierie qui veulent maîtriser la pile, changer de modèle librement et gérer leurs propres numéros de téléphone.
LiveKit Agents est un framework open source (Apache 2.0) pour ajouter un programme Python ou Node.js à un appel comme participant à part entière. Il gère les parties difficiles de la voix : diffusion de l'audio dans le pipeline, détection des tours de parole, interruptions et orchestration du LLM. Il prend aussi en charge les modèles temps réel, dont GPT-Live et Gemini Live, et la documentation de xAI cite LiveKit comme moyen pris en charge de connecter Grok. LiveKit est donc moins un remplaçant de Grok qu'une couche qui vous permet de remplacer Grok plus tard sans réécrire.
LiveKit Cloud ajoute l'hébergement et les numéros de téléphone, les simulations et l'observabilité, ainsi qu'un catalogue d'inférence hébergé pour appeler des modèles sans clés d'API séparées.
Ce qu'il fait mieux que Grok :
- Liberté de modèles : la page de tarifs liste des dizaines de LLM et de modèles STT et TTS avec des tarifs à la minute, de GPT-5 nano à 0,0002 $/min à Deepgram Flux à 0,0065 $/min.
- Téléphonie intégrée : un numéro US gratuit, des trunks SIP, ainsi que des connecteurs Twilio et WhatsApp.
- Jusqu'à 600 sessions simultanées sur l'offre Scale, publiées sur la page.
- Simulations texte et audio pour tester l'agent avant que de vrais appelants n'arrivent, gratuites jusqu'au 31 octobre.
Où il déçoit :
- Vous êtes l'intégrateur. Choisir et régler trois modèles est un vrai travail.
- La latence dépend de vos choix, et aucun chiffre indépendant de délai avant le premier son n'existe pour « LiveKit » dans son ensemble.
- HIPAA avec un BAA signé commence sur l'offre Scale, à partir de 500 $ par mois.
Tarifs :
| Offre | Prix | Minutes d'agent incluses | Sessions simultanées | À noter |
|---|---|---|---|---|
| Build | $0 | 1,000 | 5 | 1 numéro US gratuit, 50 minutes entrantes |
| Ship | À partir de $50/mois | 5,000, puis $0.01/min | 20 | Collaboration d'équipe, retour arrière instantané |
| Scale | À partir de $500/mois | 50,000, puis $0.01/min | Jusqu'à 600 | HIPAA BAA, épinglage de région |
| Enterprise | Sur mesure | Sur mesure | Sur mesure | Tarifs d'inférence au volume, SSO |
Le calculateur de LiveKit chiffre un agent téléphonique d'exemple (Gemma 4 31B, STT d'AssemblyAI, TTS de Fish Audio, un numéro US et l'observabilité) à 0,0479 $ la minute, environ 40 % sous Grok.
Mon avis : mon choix pour une équipe avec des ingénieurs qui compte changer de modèle plus d'une fois. C'est la seule option ici où passer de Grok à Gemini ou GPT-Live est un changement de configuration. À éviter si personne dans l'équipe ne veut s'occuper d'un pipeline vocal.
4. Deepgram Voice Agent API
Idéal pour : les équipes qui veulent une API de pipeline gérée à prix fixe, avec la possibilité d'apporter leur propre LLM.
La Voice Agent API de Deepgram "handles the full speech pipeline (listening, thinking, and speaking)" via un seul WebSocket. Vous configurez le modèle vocal et le fournisseur de LLM, la voix et l'endpointing, puis vous ajoutez les appels de fonctions et les transferts multi-agents. Son modèle vocal Flux est conçu pour les agents vocaux, avec détection des tours de parole et gestion des interruptions intégrées. Quand Artificial Analysis a testé la pile par défaut de Deepgram, c'était Nova-3 pour écouter, GPT-4o Mini pour réfléchir et Aura-2 pour parler.
Ce qu'il fait mieux que Grok :
- Un crédit gratuit de 200 $ sans carte, que Deepgram dit couvrir environ 43 000 minutes de transcription Nova.
- Les options « apportez le vôtre » réduisent le prix : 0,050 $ la minute si vous fournissez le LLM et la voix.
- Jusqu'à 45 connexions d'agent simultanées en paiement à l'usage simple, sans escalier de dépenses.
- SOC 2 Type 2, HIPAA avec BAA pour Enterprise et un endpoint UE dédié.
Où il déçoit :
- Le LLM par défaut dans le test d'Artificial Analysis était GPT-4o Mini, un petit modèle pour des appels de support complexes. Prévoyez d'apporter le vôtre pour tout ce qui dépend beaucoup de politiques.
- Pas de score τ-Voice ni de latence d'Artificial Analysis pour l'agent complet.
- Facturé selon la durée de connexion WebSocket, donc un socket ouvert et inactif coûte quand même de l'argent.
Tarifs :
| Palier | Paiement à l'usage | Growth |
|---|---|---|
| Standard | $0.075/min | $0.068/min |
| Standard, TTS apporté | $0.065/min | $0.051/min |
| Custom, LLM apporté | $0.059/min | Non indiqué |
| Custom, LLM + TTS apportés | $0.050/min | $0.041/min |
| Advanced | $0.163/min | $0.146/min |
Growth exige un engagement à partir de 4 000 $ par an, selon la page de tarifs de Deepgram.
Mon avis : le pipeline « une API, un prix » le plus net ici. Un bon choix pour une équipe qui a déjà un agent LLM et veut l'entourer des oreilles et de la voix de Deepgram à 0,050 $ la minute. Moins convaincant si vous voulez que le LLM par défaut fasse le raisonnement.
5. AssemblyAI Voice Agent API
Idéal pour : les équipes qui veulent le prix tout compris le plus simple et une reconnaissance vocale solide, et qui acceptent le LLM maison d'AssemblyAI.
AssemblyAI est surtout connu pour le speech-to-text, et sa Voice Agent API empile trois briques maison : le modèle vocal Universal-3.6 Pro Realtime, un LLM propriétaire "tuned for spoken conversation rather than text chat" et sa propre voix à faible latence. Le guide de démarrage fait parler un agent dans le navigateur en quatre commandes, puis le place sur un numéro de téléphone.
Ce qu'il fait mieux que Grok :
- Un prix unique de 4,50 $ de l'heure (0,075 $ la minute), avec reconnaissance vocale, LLM et voix inclus.
- Le modèle vocal prend en charge 32 langues avec prompting de termes clés, utile pour les noms de produits et les références.
- Les comptes payants peuvent refuser l'entraînement, et un BAA signé le fait automatiquement, selon la page de sécurité d'AssemblyAI.
Où il déçoit :
- Le LLM inclus est celui d'AssemblyAI. Aucun benchmark publié ne montre comment il gère une politique de support et des outils.
- Pas de score d'Artificial Analysis pour l'agent complet.
- Les limites de concurrence ne figurent pas sur la page de tarifs ; les conditions au volume passent par les ventes.
Tarifs :
| Composant | Prix |
|---|---|
| Voice Agent API (orchestration et hébergement) | $4.50/hr ($0.075/min) |
| Modèle vocal Universal-3.6 Pro Realtime | Inclus |
| LLM du Voice Agent | Inclus |
| TTS du Voice Agent | Inclus |
| Remises au volume, ingénieur déployé | Contacter les ventes |
Mon avis : un choix par défaut sensé pour une équipe qui tient avant tout à bien entendre les appelants (accents, lignes bruyantes, noms de produits) et veut une seule ligne sur la facture. Je testerais son LLM sur 30 de mes appels les plus difficiles avant de m'engager, car c'est la partie sans score public.
6. Inworld Realtime API
Idéal pour : les équipes qui veulent une API de type speech-to-speech avec le LLM de leur choix et le coût vocal à la minute le plus bas.
L'API Realtime d'Inworld ressemble de l'extérieur à un modèle speech-to-speech : une connexion WebSocket ou WebRTC qui "listens, reasons and talks back". En dessous, c'est un pipeline avec le speech-to-text d'Inworld, votre choix parmi 8 LLM hébergés et ses voix TTS-2 à la fin. L'attrait pour un utilisateur de Grok, c'est que ses événements et sa configuration de session correspondent à l'API OpenAI Realtime, donc un client migre avec un nouvel endpoint et une nouvelle clé.
Ce qu'il fait mieux que Grok :
- Pas de frais speech-to-speech en plus. Chaque brique est facturée à son propre tarif : speech-to-text à 0,15 $ de l'heure, TTS-2 Flash à partir de 15 $ le million de caractères à la demande.
- Vous choisissez le LLM, donc le raisonnement peut être aussi fort (ou aussi économique) que vous le voulez.
- Premier son mesuré par le fournisseur jusqu'à 204 ms, avec une médiane de 462 ms sur 17 tours mesurés.
- RGPD et SOC 2 Type II sur toutes les offres.
Où il déçoit :
- Les chiffres de latence sont des mesures d'Inworld, pas des mesures indépendantes.
- Le prix est une somme de briques, donc prévoir une facture demande plus de travail qu'un tarif fixe à la minute.
- HIPAA et BAA sont des options sur l'offre la plus élevée publiée.
- L'audio téléphonique arrive en G.711 depuis Twilio, donc vous apportez le numéro de téléphone.
Tarifs :
| Offre | Mensuel | TTS-2 Flash par 1M de caractères | STT 1 par heure |
|---|---|---|---|
| On-Demand | $0 | $15 | $0.15 |
| Creator | $25 | $10 | $0.10 |
| Builder | $100 | $9 | $0.10 |
| Developer | $300 | $8 | $0.10 |
| Growth | $1,500 | $7 | $0.10 |
Inworld estime à environ 1 000 caractères de parole par minute, donc la sortie vocale revient à peu près à 0,01 $ à 0,015 $ par minute où l'agent parle, plus les jetons du LLM. Plus de détails dans mon article sur les tarifs d'Inworld AI et la liste des alternatives à Inworld.
Mon avis : le pari le plus intéressant sur les coûts pour les équipes déjà satisfaites d'un LLM de texte. Il offre l'expérience développeur façon Grok avec la souplesse d'un pipeline. À reporter si vous avez besoin de chiffres de latence indépendants ou d'une ligne téléphonique clé en main.
Les plateformes gérées d'agents vocaux
Ces trois-là enveloppent un pipeline avec ce dont un responsable du support a besoin pour réellement exploiter un agent téléphonique : numéros et constructeur, tests et analyses, plus une concurrence qu'on peut acheter. Vous cédez un peu de contrôle et des frais de plateforme pour ne rien construire de tout cela vous-même. Si votre équipe envisage une plateforme, mon tour d'horizon de la meilleure IA pour le support vocal en couvre davantage, tout comme la liste des alternatives à Voiceflow.
7. ElevenLabs Agents
Idéal pour : les équipes qui veulent un agent géré avec la plus large couverture linguistique et les voix les plus naturelles.
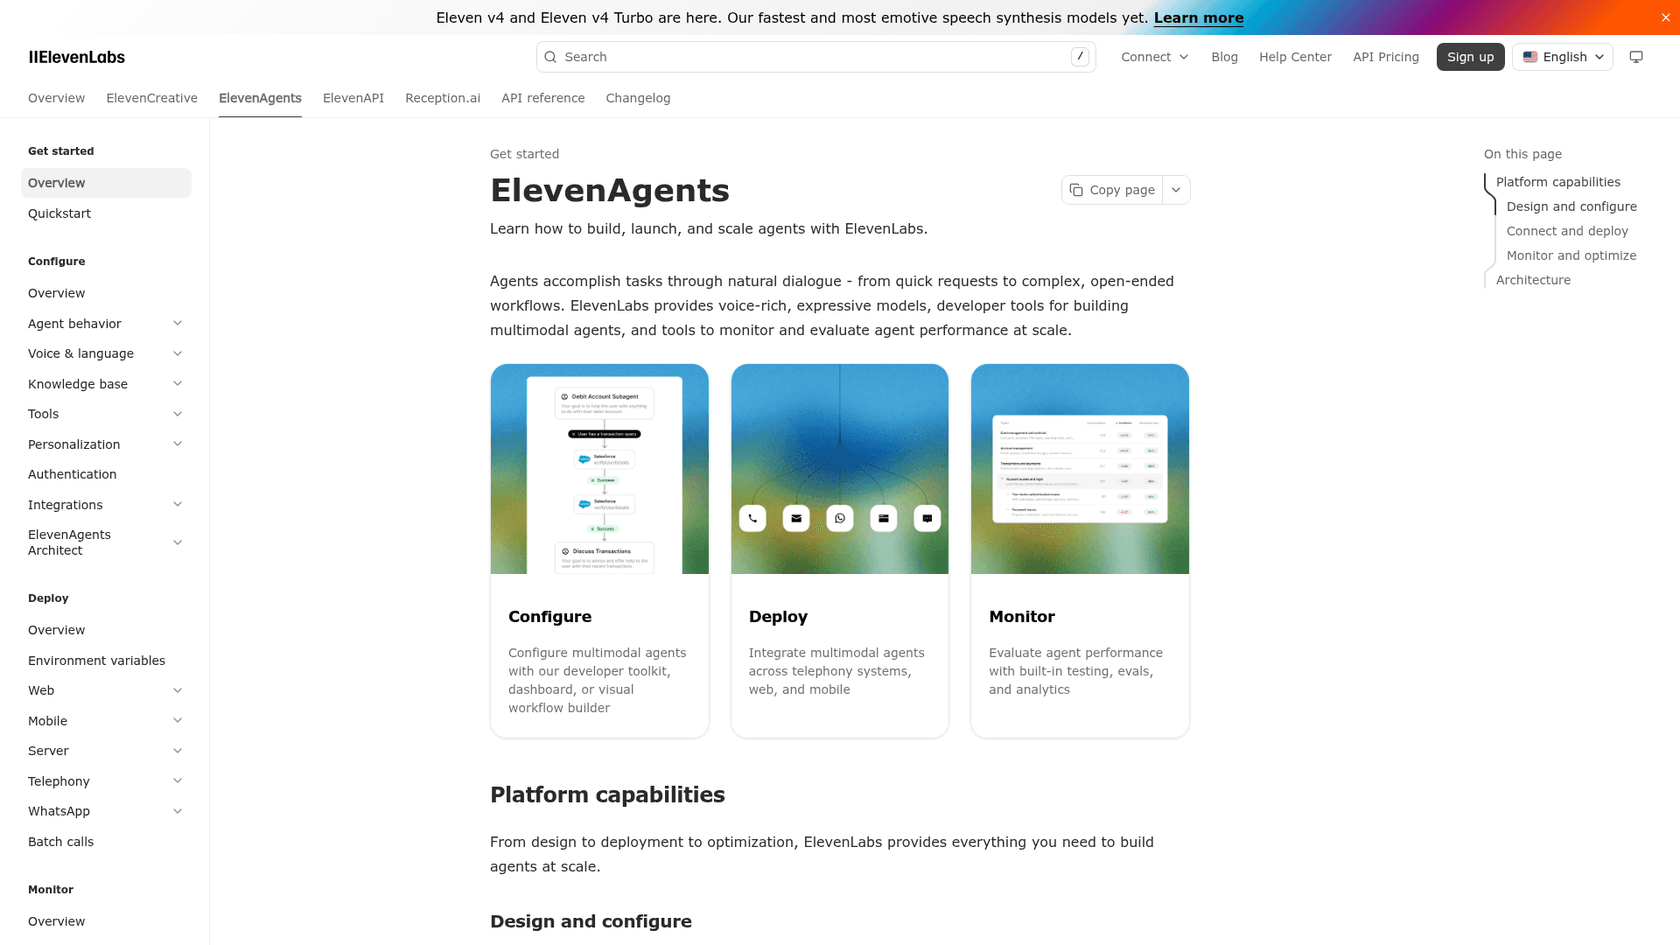
ElevenLabs s'est fait un nom avec les voix, et ElevenAgents est sa plateforme pour des "natural, human-sounding agents in 90+ languages" en voix, chat et e-mail. Vous configurez un agent avec un constructeur de workflows, lui attachez une base de connaissances et des outils, le déployez sur une ligne téléphonique, le web ou le mobile, et le surveillez avec des tests et des analyses intégrés. La pile par défaut qu'Artificial Analysis a testée était Scribe v2 Realtime, Gemini 2.5 Flash et Eleven Flash v2, et vous pouvez choisir dans une longue liste de LLM ou apporter le vôtre.
Ce qu'il fait mieux que Grok :
- 90+ langues, la plus large couverture de cette liste.
- Concurrence publiée sur chaque offre, de 4 appels sur Free à 40 sur Business, et une tarification de pic qui permet aux agents d'accepter jusqu'à 3x cette limite au double du tarif.
- Pas de frais de téléphonie : apportez Twilio ou un trunk SIP et payez directement votre opérateur.
- Un constructeur d'agents complet, pour qu'un responsable du support change le déroulé sans déploiement.
Où il déçoit :
- Les 0,08 $ la minute s'entendent avant le LLM. Le calculateur de tarifs affiche Gemini 2.5 Flash à 0,0029 $ la minute ; les modèles plus puissants coûtent plus.
- Les BAA pour HIPAA ne sont proposés que sur Enterprise.
- Pas de score τ-Voice indépendant pour l'agent complet.
Tarifs :
| Offre | Mensuel | Minutes d'appel incluses | Appels simultanés |
|---|---|---|---|
| Free | $0 | 15 | 4 |
| Starter | $6 (premier mois $1) | 75 | 6 |
| Creator | $22 (premier mois $11) | 275 | 10 |
| Pro | $99 | 1,238 | 20 |
| Scale | $299 | 3,738 | 30 |
| Business | $990 | 12,375 | 40 |
| Enterprise | Sur mesure | Sur mesure | Élevé |
Les minutes supplémentaires sont à 0,08 $ sur toutes les offres, et les minutes de pic à 0,16 $, selon la page de tarifs d'ElevenAgents. Plus de détails dans mon article sur les tarifs d'ElevenLabs et la liste des alternatives à ElevenLabs.
Mon avis : le remplacement géré le plus simple pour une équipe de support, surtout multilingue. Sur Business, 12 375 minutes incluses pour 990 $ reviennent aux mêmes 0,08 $ que Grok, avec constructeur, téléphonie et analyses en prime. À éviter si vous avez besoin de HIPAA sans contrat Enterprise.
8. Vapi
Idéal pour : les développeurs qui veulent une plateforme gérée tout en choisissant chaque modèle et en payant les fournisseurs au prix coûtant.
Vapi se situe entre LiveKit et ElevenLabs. Il exploite l'infrastructure (hébergement et téléphonie, supervision, plus tests avec simulation), et vous choisissez le transcripteur, le LLM et la voix dans son catalogue, facturés "with no markup". Sa page d'accueil cite l'équipe de support de Ring passant de zéro à la production en deux semaines. Un développeur de Reddit qui fait tourner des systèmes de production dessus a contesté l'idée qu'il ne serve qu'aux prototypes :
"Vapi is good at PoC stage and it is good at production usage, it is not a fair criticism at all - I have many production AI voice systems running on Vapi right now with no issues."
Ce qu'il fait mieux que Grok :
- N'importe quel mélange de modèles, y compris des modèles speech-to-speech, avec les fournisseurs répercutés au prix coûtant.
- La téléphonie et le SIP de Vapi sont gratuits, et la concurrence supplémentaire coûte un forfait de 10 $ par ligne et par mois.
- Des appels de test simulés avant que de vrais clients n'entendent l'agent.
Où il déçoit :
- Les 0,05 $ de frais d'hébergement s'ajoutent à chaque modèle. L'estimation de Vapi lui-même pour 1 000 minutes tombe entre 82 $ et 129 $, soit 0,082 $ à 0,129 $ la minute.
- HIPAA est une option à 2 000 $ par mois.
- Les SLA de disponibilité commencent avec le forfait Pro à 999 $ par mois.
Tarifs :
| Forfait | Mensuel | Appels simultanés | À noter |
|---|---|---|---|
| Aucun forfait | $0, $5 de crédit gratuit | 4 | $0.05/min d'hébergement, 14 jours de conservation des données |
| Core | $29 | 10 | Zéro conservation des données, SLA de support sous 2 jours ouvrés |
| Pro | $999 minimum (10 % des frais d'hébergement) | 30 | RBAC, support Slack, SLA de disponibilité de 99 % |
| Premier | Sur mesure | Élevé | SLA de disponibilité de 99,9 %, SIP dédié |
Le tout vient de la page de tarifs de Vapi.
Mon avis : le juste milieu quand vous voulez des fonctions de plateforme mais refusez d'être enfermé dans les modèles d'un seul fournisseur. Budgétez les frais d'hébergement plus trois fournisseurs, et le total tombe en général au niveau des 0,08 $ de Grok ou au-dessus.
9. Cartesia Line
Idéal pour : les équipes qui veulent un agent géré avec un contrôle au niveau du code et le forfait de plateforme le plus bas.
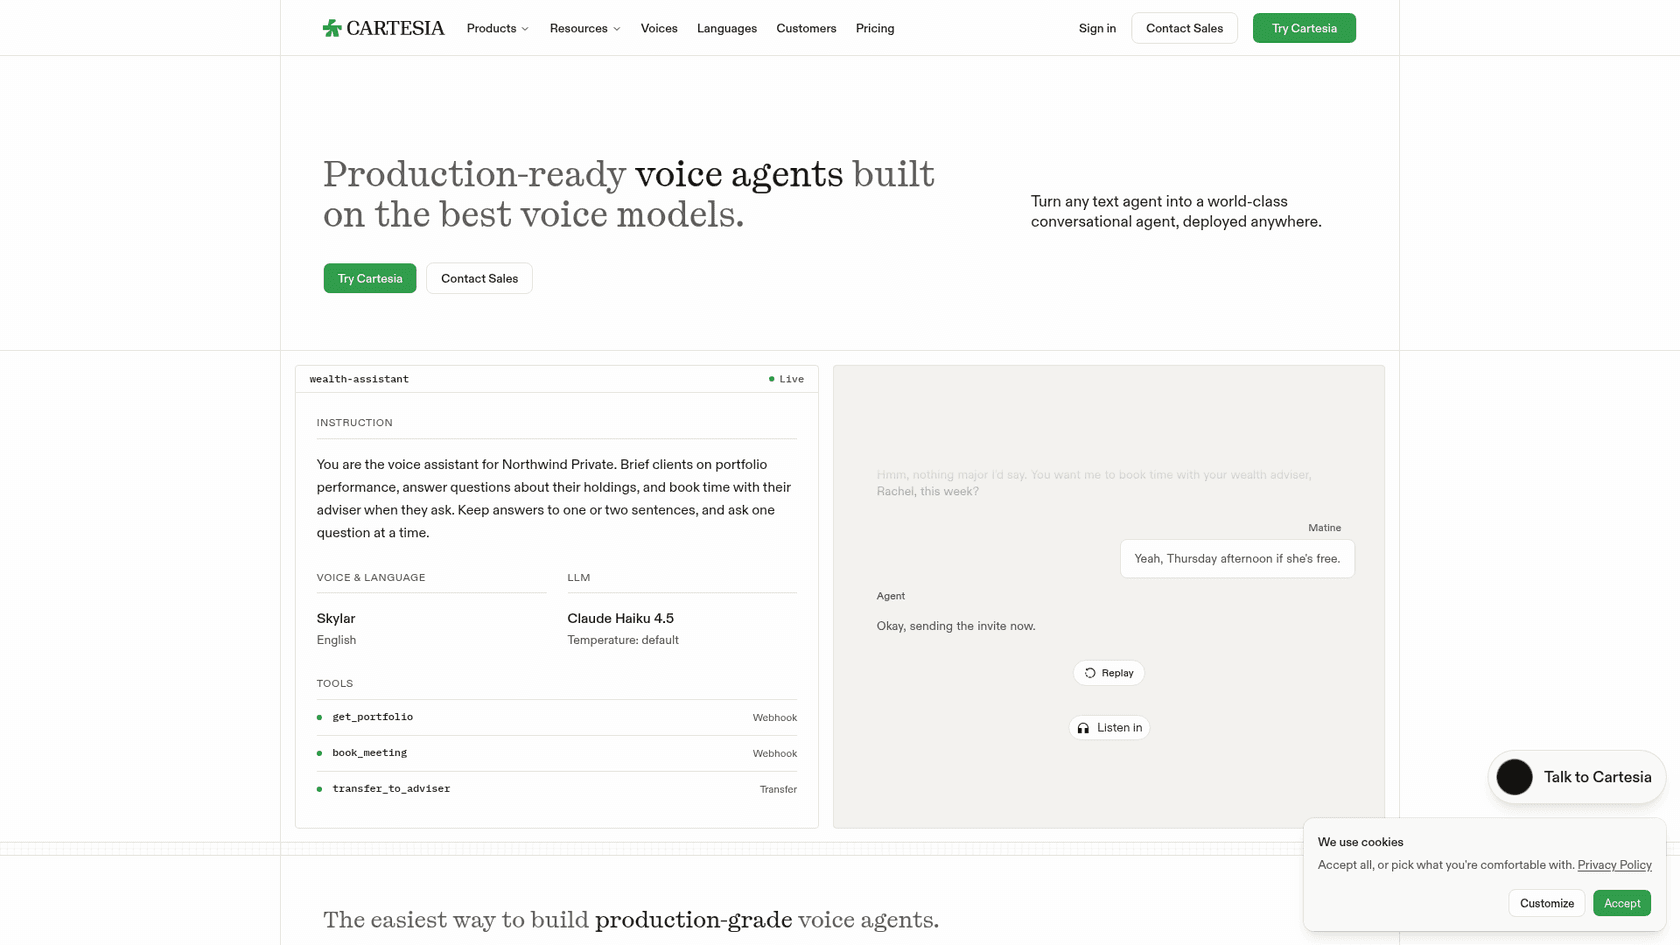
Line "brings voice to your text agents" grâce au speech-to-text Ink et aux voix Sonic de Cartesia, que j'ai couverts dans mon test de Cartesia Sonic 3. Vous écrivez la logique de raisonnement en code avec son SDK (n'importe quel LLM, n'importe quelle API) ou vous prototypez dans le constructeur sans code, puis vous déployez sur le runtime géré de Cartesia avec journaux d'appels, évaluations et déploiements versionnés que vous pouvez annuler. Il existe une CLI pour déployer et tester depuis un terminal.
Ce qu'il fait mieux que Grok :
- 0,06 $ la minute pour l'agent géré, le forfait de plateforme le plus bas de cette liste.
- L'usage du LLM est gratuit pour les agents construits dans l'interface, pour une durée limitée.
- SOC 2 Type II, HIPAA et RGPD indiqués sur son site.
- Les frais d'offre reviennent sous forme de crédit d'agent : l'offre Scale à 299 $ inclut 299 $ à dépenser en agents.
Où il déçoit :
- La promotion sur le LLM est limitée dans le temps, donc planifiez votre budget comme si vous alliez payer les jetons.
- La concurrence plafonne à 60 appels sur l'offre Scale avant Enterprise.
- Pas de score τ-Voice indépendant pour l'agent complet.
Tarifs :
| Offre | Mensuel | Crédit d'agent inclus | Appels simultanés |
|---|---|---|---|
| Free | $0 | $1 (~17 min) | 8 |
| Pro | $5 | $5 | 12 |
| Startup | $49 | $49 | 20 |
| Scale | $299 | $299 | 60 |
| Enterprise | Sur mesure | Sur mesure | Sur mesure |
Les appels coûtent 0,06 $ la minute, plus 0,014 $ la minute pour un numéro de téléphone Cartesia, selon la page de tarifs de Cartesia. Si la qualité de la voix est le critère décisif, ma comparaison Cartesia contre ElevenLabs va plus loin.
Mon avis : un choix solide pour une équipe de développeurs qui aime l'approche gérée d'ElevenLabs mais veut écrire l'agent en code. Surveillez la ligne LLM de votre facture quand la promotion prendra fin.
Comment choisir le gagnant en une semaine
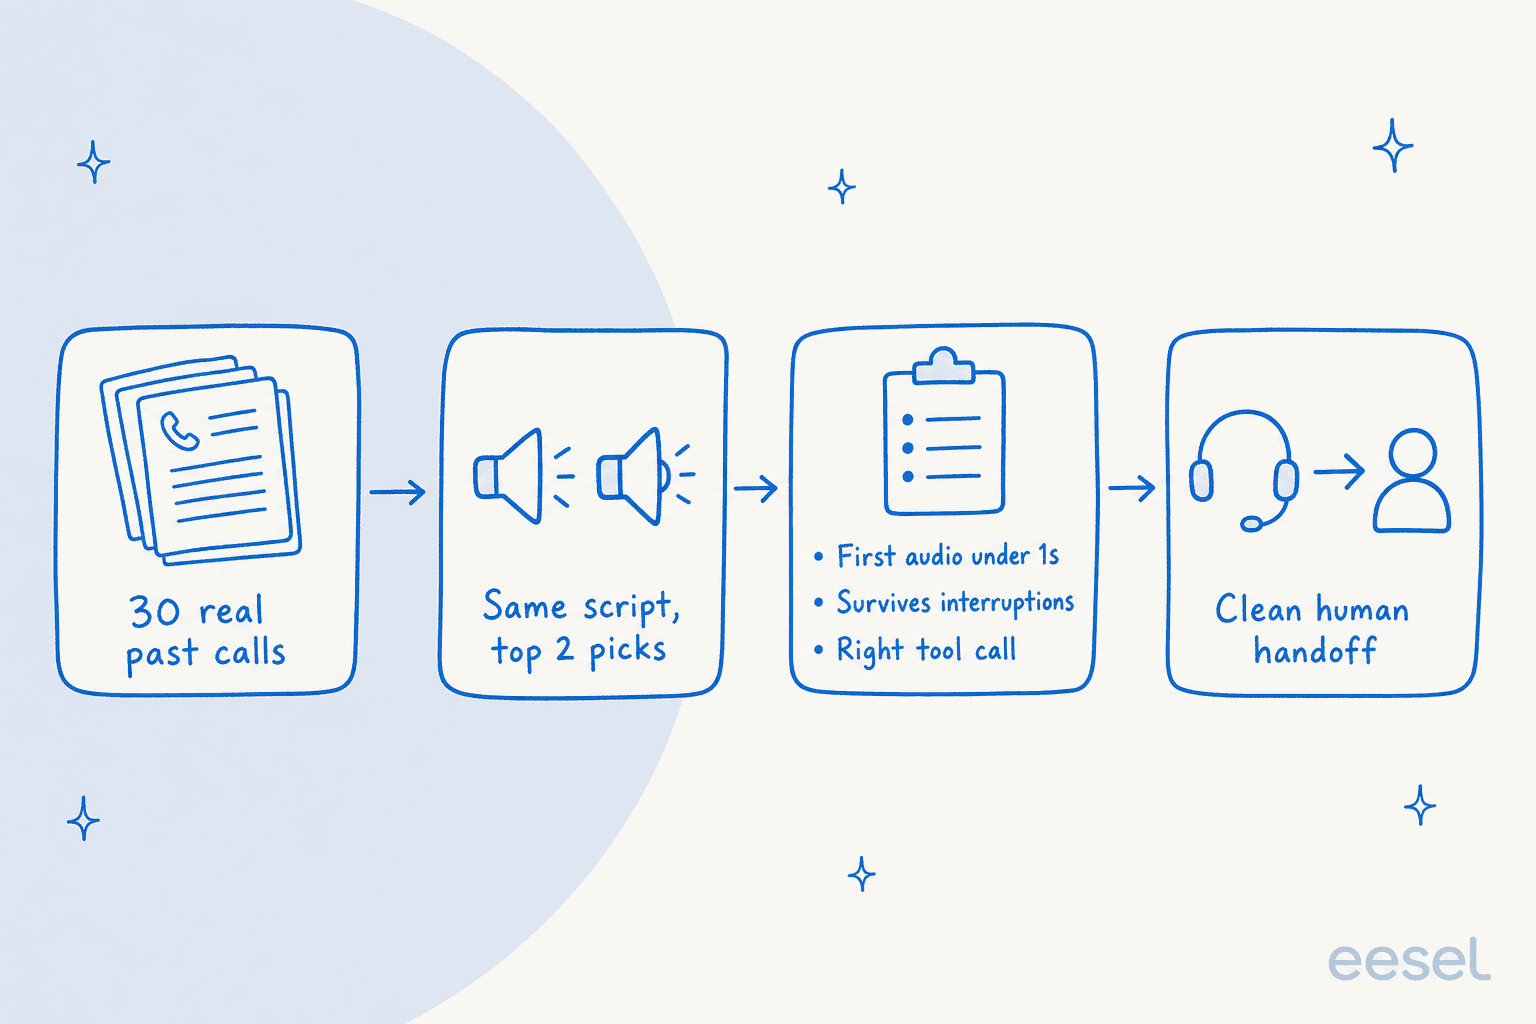
Les benchmarks resserrent la liste, puis ce sont vos propres appels qui tranchent. Le conseil de ChatGPT était de faire passer les mêmes 20 à 50 conversations de test par vos deux ou trois meilleurs candidats, et je suis d'accord, avec un changement : utilisez de vrais appels, pas des appels inventés.
- Tirez 30 vrais appels passés. Des transcriptions de votre système téléphonique, pondérées vers les appels que votre équipe juge les plus difficiles : remboursements, appelants en colère, changements de compte.
- Faites passer le même script par vos deux premiers. Grok Voice 3.0 devrait généralement en faire partie, puisque c'est la barre à franchir.
- Notez trois choses. Le délai avant le premier son (l'appelant entend-il une réponse en moins d'une seconde ?), les interruptions (s'arrête-t-il et écoute-t-il quand l'appelant l'interrompt ?) et les appels d'outils (a-t-il appelé la bonne fonction avec le bon numéro de commande ?).
- Vérifiez le transfert. Tout agent vocal échoue sur certains appels. Ce qui compte, c'est qu'il passe l'appelant à une personne avec le contexte. Mon article sur les bonnes pratiques de transfert couvre ce que ce contexte devrait contenir.
Si vous utilisez déjà les agents vocaux IA de Zendesk ou les agents vocaux de Freshcaller, incluez aussi l'option native de votre helpdesk dans le test. Parfois, la réponse ennuyeuse est celle qui gagne.
Ce que ces neuf ne règlent pas
Chaque modèle et plateforme ci-dessus est, dans ce qu'il fait, un moteur de conversation. Le benchmark τ-Voice donne à chacun un document de politique et un ensemble d'outils écrits pour le test. Sur votre ligne téléphonique, l'agent sait exactement ce que vous lui branchez et rien de plus.
C'est là que la plupart des déploiements réels de support vocal passent leur temps : décider de ce que l'agent a le droit de dire, garder les réponses à jour et le relier aux données de commandes et de comptes. Dans nos appels commerciaux, la demande la plus constante chez les acheteurs est la même : entraîner l'IA sur les tickets passés de l'équipe. Une marque de compléments alimentaires en vente directe issue de ces appels fait passer environ 7 000 tickets par mois par Gorgias et Shopify, avec un système téléphonique séparé à côté. Son agent téléphonique et sa file de tickets ont besoin des mêmes réponses.
Les équipes qui y arrivent traitent l'agent téléphonique comme un chatbot de base de connaissances doté d'une voix : une source de réponses entretenue, dans laquelle puisent tous les canaux. Si vous hésitez encore sur la question de savoir si l'IA peut répondre aux appels de support pour votre équipe, ou s'il faut automatiser le support téléphonique, commencez par les canaux texte. Ils sont moins chers par interaction, plus faciles à mesurer et construisent les connaissances dont l'agent vocal aura besoin.
Mon guide pour automatiser le support client explique l'ordre dans lequel je m'y prendrais.
Associez n'importe laquelle à eesel
L'API vocale, c'est l'infrastructure, et eesel, c'est l'employé. Le coéquipier IA pour le helpdesk d'eesel rejoint votre Zendesk, Freshdesk ou Gorgias, apprend de vos tickets passés et de votre centre d'aide, et traite la file d'e-mails et de chats qui se trouve derrière chaque ligne téléphonique. Avant sa mise en service, vous pouvez le faire tourner sur vos propres tickets passés et comparer ses réponses à ce que votre équipe a réellement envoyé.

Pour les développeurs, le point de connexion est MCP. Chaque espace de travail eesel est un serveur MCP : npx @eesel/cli mcp token de la CLI eesel affiche l'URL et un jeton valable 30 jours, de sorte qu'un agent vocal sur Grok, GPT-Live ou LiveKit puisse consulter les mêmes réponses que votre agent de tickets. La même CLI vous permet de piloter l'agent par script depuis un terminal ou de le confier à un agent de code comme Claude Code. Je n'ai pas encore essayé cette association sur une ligne téléphonique en production, donc considérez-la comme une construction prometteuse et surveillez la latence d'un appel d'outil en pleine phrase.
La tarification est un forfait mensuel fixe de crédits : 299 $ par mois pour 500 crédits, où un ticket ou un chat vaut un crédit, avec 100 crédits gratuits et sans carte pour démarrer. Essayez eesel sur une partie de votre file avant de choisir une voix, pour que la gagnante ait quelque chose qui vaille la peine d'être dit.