Les 8 meilleures alternatives à MAI-Transcribe-2 en 2026

Kira

Katelin Teen
Dernière modification September 8, 2026
MAI-Transcribe-2 est le nouveau modèle de reconnaissance vocale de Microsoft AI, et il est excellent : un taux d'erreur moyen par mot de 5,2 % sur 60 langues et un prix de lancement de 0,10 $ par heure. S'il convient à votre stack, c'est l'une des meilleures options du marché. Mais ce prix est promotionnel, c'est une préversion par lots uniquement, sans SLA, et il vit dans Azure, si bien que beaucoup d'équipes voudront un autre choix.
Voici les huit meilleures alternatives, avec la raison en une ligne de choisir chacune :
- Google Gemini 3.5 Transcribe - la précision la plus proche, et le choix évident si vous êtes déjà chez Google.
- ElevenLabs Scribe v2 - idéal pour les médias et le doublage, avec identification de 32 locuteurs et étiquetage des événements sonores.
- Deepgram - le choix pour les agents vocaux en temps réel et le streaming téléphonique.
- AssemblyAI - la transcription plus une couche intégrée de résumés, d'analyse de sentiment et de masquage de données sensibles.
- OpenAI GPT-Transcribe - le plus simple à greffer sur un pipeline OpenAI existant.
- Speechmatics - la plus large couverture de langues et un vrai déploiement sur site.
- Amazon Transcribe - le choix par défaut si vos données sont déjà dans AWS.
- OpenAI Whisper - le modèle open source gratuit que vous hébergez vous-même.
Une chose à dire d'emblée, parce que je construis des agents IA chez eesel et que cela façonne ma lecture de toute cette catégorie : une transcription précise n'est pas ce que quelqu'un voulait vraiment. C'est la matière première. Quel que soit le modèle choisi, il faut encore que quelqu'un lise le texte, trouve la réponse et résolve le ticket, et c'est un autre métier que la transcription.
Pourquoi regarder au-delà de MAI-Transcribe-2
Soyons d'abord justes envers le titulaire, car il le mérite. MAI-Transcribe-2 est en tête de la comparaison de précision FLEURS de Microsoft, transcrit une heure d'audio en une dizaine de secondes et, à 0,10 $ par heure, bat tout le monde sur le prix. En lisant les premiers retours de développeurs, les réactions étaient de celles qu'on ne peut pas simuler. Un développeur indépendant lui a soumis un extrait réel difficile :
"J'ai essayé de lui faire passer une homélie en slovaque avec beaucoup d'écho... Il s'en est bien mieux sorti qu'ElevenLabs, à 45 % du prix."
L'audio bruyant, avec de l'écho et qui n'est pas en anglais est exactement ce qui met en difficulté les modèles plus faibles, c'est donc un vrai signal. Alors pourquoi regarder ailleurs ? Pour trois raisons concrètes, dont aucune ne remet en cause le modèle lui-même.
D'abord, le prix est une cible mouvante. Ces 0,10 $ sont une promotion de lancement valable "jusqu'à la fin de l'année", et Microsoft n'a pas dit ce qui se passera ensuite. À titre de repère, l'ancien MAI-Transcribe-1.5 est toujours affiché à 0,36 $ par heure, donc un tarif standard de v2 dans cette fourchette ne surprendrait personne. Un commentateur de Hacker News a posé exactement la question que Microsoft a laissée ouverte :
"est-ce utilisable en streaming ou seulement par lots ? donnent-ils le prix après la fin de la remise de lancement (jusqu'à fin d'année) ?"

Ensuite, c'est une préversion publique livrée sans SLA, que Microsoft signale comme non destinée à la production, et l'API principale ne fonctionne que par lots avec une limite de fichier de 300 Mo. L'audio en direct nécessite une configuration Voice Live séparée. Enfin, c'est un modèle Azure : on y accède via Azure Speech, un bac à sable pour développeurs ou des routeurs tiers, pas via une application autonome. Si vous construisez ailleurs, cette gravité d'écosystème a un vrai coût.
Rien de tout cela ne fait de MAI-Transcribe-2 un mauvais choix. Cela signifie simplement que "le moins cher et le plus précis aujourd'hui" n'est pas "le bon choix pour votre projet", et c'est dans cet écart que vivent ces alternatives.
Comment je les ai comparées
J'ai passé beaucoup de temps dans ces API, à lire la documentation, les pages de tarifs et les listes de paramètres, j'ai donc retenu les critères qui changent vraiment votre architecture, pas les puces marketing. Cinq éléments comptent :
- La précision, mesurée par le taux d'erreur par mot (WER, le pourcentage de mots que le modèle se trompe). Plus bas, c'est mieux.
- Le prix par heure d'audio, normalisé pour comparer à armes égales.
- Lots ou temps réel, car un modèle uniquement par lots ne peut pas alimenter un agent téléphonique en direct, aussi précis soit-il.
- L'identification des locuteurs et les horodatages, les étiquettes de locuteur et le minutage mot à mot qui transforment un mur de texte en quelque chose d'exploitable.
- Le déploiement, c'est-à-dire si vous pouvez l'exécuter sur votre propre matériel ou si vous devez envoyer l'audio dans le cloud du fournisseur.
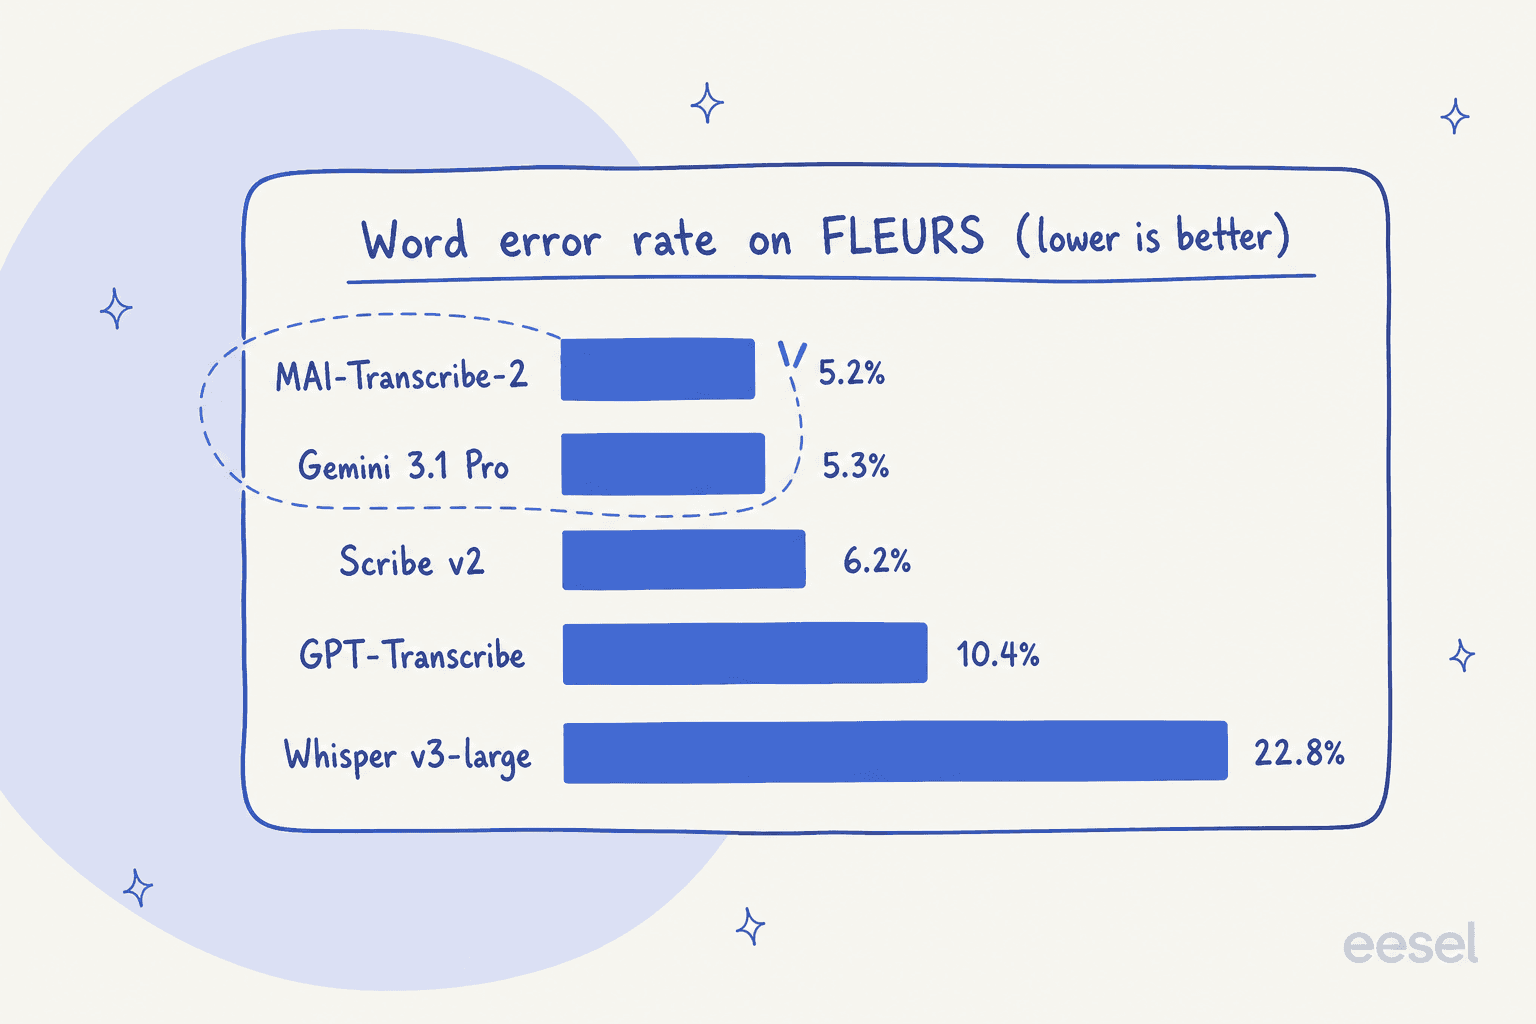
Sur la précision brute, voici où se situe le peloton dans la comparaison FLEURS de Microsoft. Il faut retenir une chose de ce graphique : le haut est une quasi-égalité, et le véritable écart se situe entre les leaders et le Whisper ouvert, plus ancien.
Les meilleures alternatives à MAI-Transcribe-2 en un coup d'œil
Avant les analyses détaillées, voici tout le peloton dans un tableau. Les prix sont par heure d'audio pour la transcription standard par lots, convertis à partir du tarif par minute ou par token publié par chaque fournisseur.
| Modèle | Idéal pour | Prix par lots/h | Streaming temps réel | Langues | Identification des locuteurs | Auto-hébergement | Offre gratuite |
|---|---|---|---|---|---|---|---|
| MAI-Transcribe-2 | Lots multilingues les moins chers | 0,10 $ (promo) | Via Voice Live uniquement | 60+ | Oui | Non | Non |
| Gemini 3.5 Transcribe | Précision la plus proche | ~0,30 $ | Oui (modèle live) | 85+ | Jusqu'à 8 | Non | Oui |
| ElevenLabs Scribe v2 | Médias et doublage | 0,22 $ | Oui (realtime) | 90+ | Jusqu'à 32 | Non | 10 000 crédits/mois |
| Deepgram | Agents vocaux en temps réel | 0,26 $ | Oui (point fort) | 40+ | Oui | Oui (Enterprise) | 200 $ de crédit |
| AssemblyAI | Intelligence audio | 0,21 $ | Oui | 99+ | Oui | Non | 185 h |
| OpenAI GPT-Transcribe | Pipelines natifs OpenAI | 0,27 $ | Sortie en streaming | 99+ | Modèle séparé | Non | Non |
| Speechmatics | Étendue des langues, sur site | 0,24 $ | Oui (<1 s) | 55+ | Oui | Oui (Enterprise) | 100 $ de crédit |
| Amazon Transcribe | Équipes déjà sur AWS | 0,36 $ | Oui | 100+ | Oui | Non | 60 min/mois (12 mois) |
| Whisper (open source) | Coût d'API nul | 0 $ (auto-hébergé) | Non (lots) | 99+ | En complément | Oui | Gratuit |
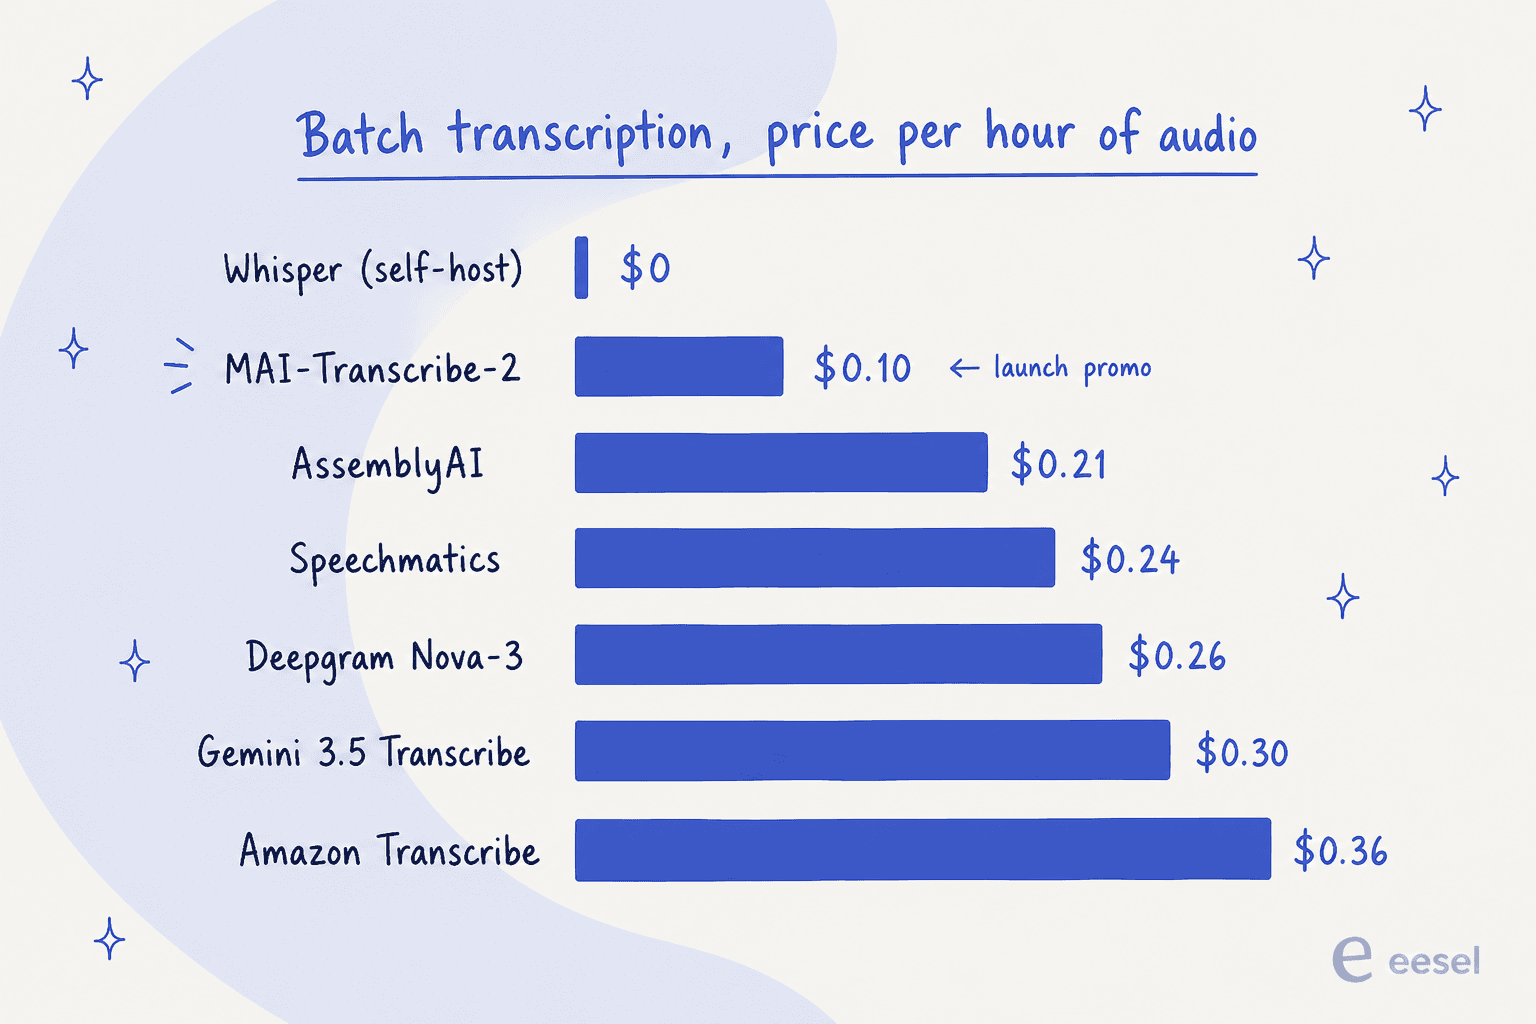
Les prix payants par lots sont bien plus resserrés que ce que la plupart des gens imaginent. Une fois la promotion de MAI-Transcribe-2 terminée, tout le peloton se retrouve à quelques centimes d'écart.
1. Google Gemini 3.5 Transcribe
Idéal pour : les équipes qui veulent la précision la plus proche de MAI-Transcribe-2 et qui construisent déjà sur Google.
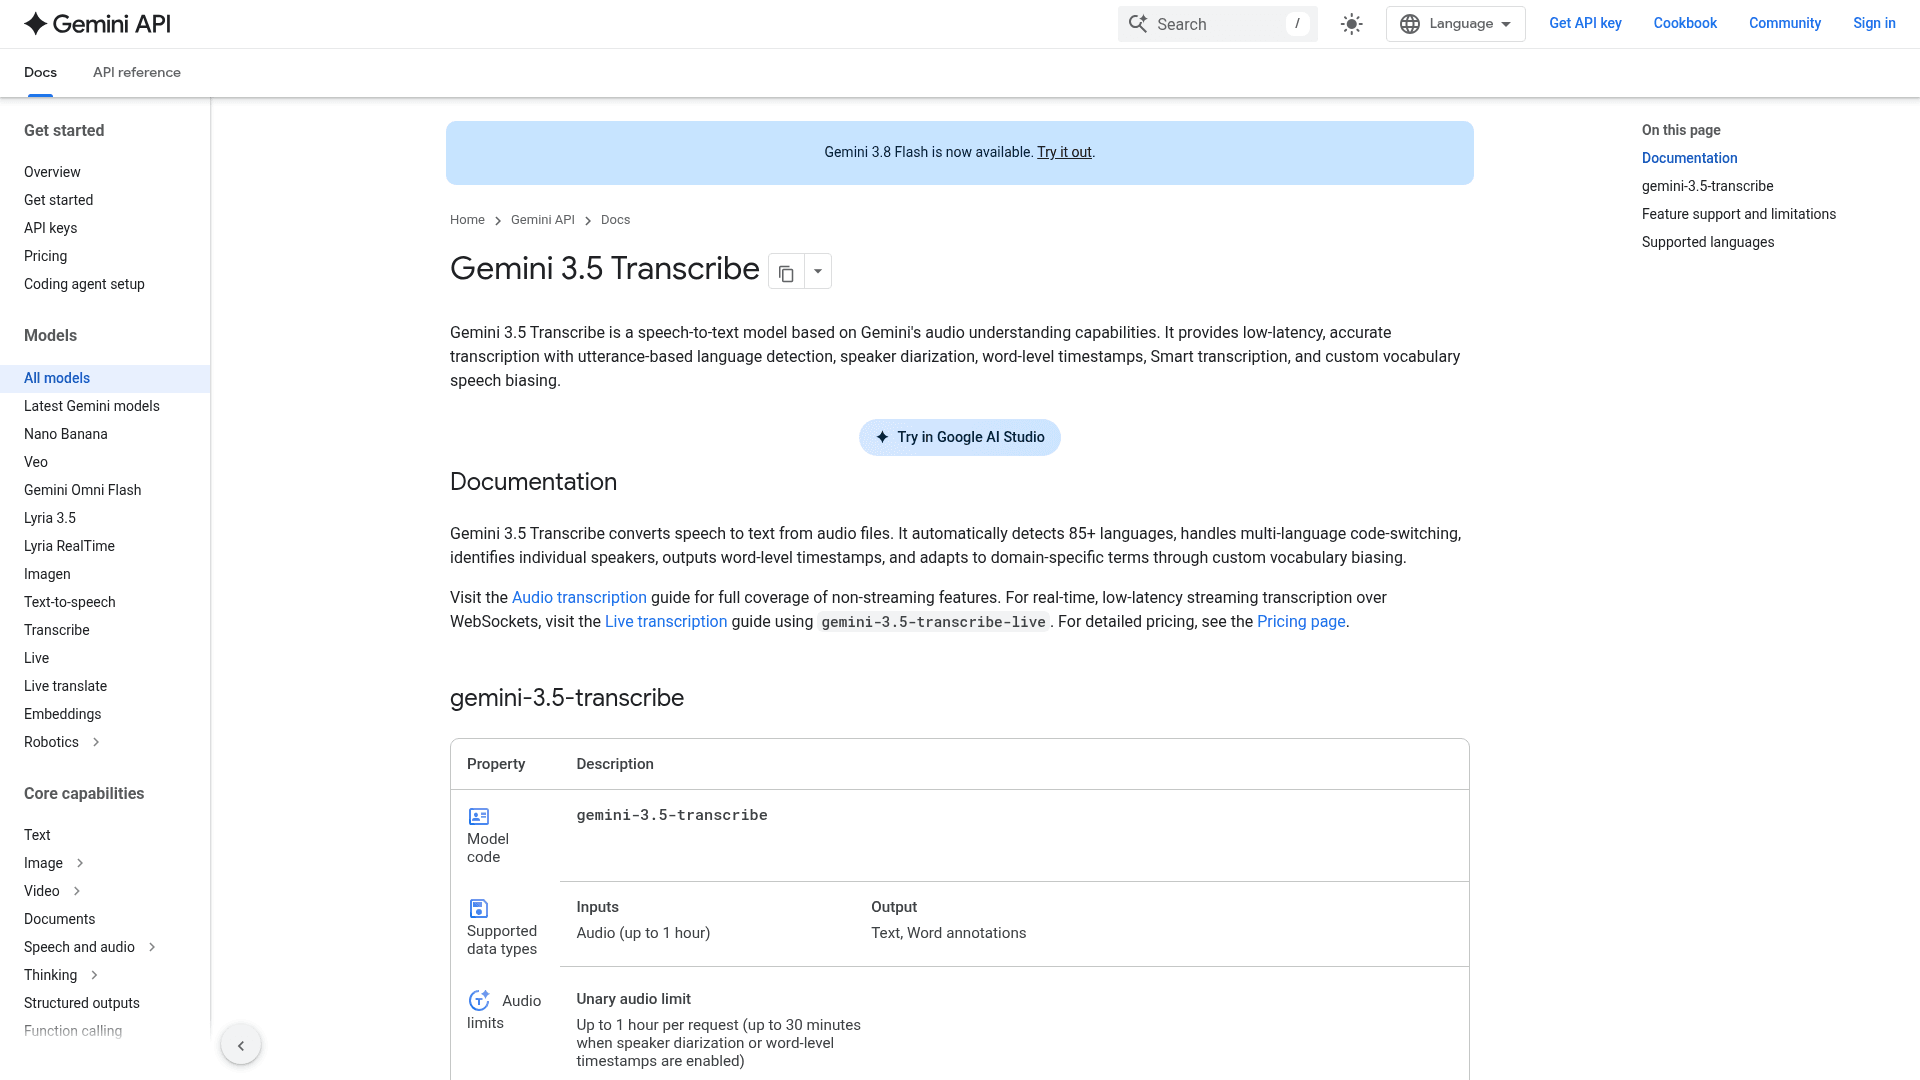
Google est l'alternative qui égale MAI-Transcribe-2 en face-à-face. Dans le tableau FLEURS de Microsoft, Gemini 3.1 Pro affiche 5,3 %, un dixième de point derrière, et Google propose aussi un modèle de reconnaissance vocale dédié, gemini-3.5-transcribe, ainsi qu'une variante de streaming gemini-3.5-transcribe-live. Cette séparation compte : le modèle de fichiers gère jusqu'à une heure d'audio par requête (30 minutes si vous activez l'identification des locuteurs ou les horodatages par mot), tandis que le modèle live fait du streaming à faible latence via WebSockets.
Vous obtenez un ensemble complet de fonctions : plus de 85 langues avec changement de langue en pleine phrase, identification jusqu'à huit locuteurs, horodatages par mot et biais de vocabulaire personnalisé jusqu'à 1 000 termes. Cela ressemble davantage à une pile complète de compréhension audio qu'à un simple point d'accès de transcription.
Côté tarif, le modèle dédié est facturé au token : l'entrée audio coûte 2,00 $ par million de tokens et la sortie texte 12,00 $ par million, soit un tarif combiné d'environ 0,005 $ par minute, ou environ 0,30 $ par heure. Il existe une offre gratuite pour tester, une belle rampe d'accès.
Notre avis : si la précision est votre seul critère et que vous n'êtes pas attaché à Azure, c'est le choix. C'est le seul modèle qui rivalise avec MAI-Transcribe-2 sur le benchmark, et une variante de streaming native comble la grande lacune que laisse MAI. Le bémol : Google n'a pas publié de WER en propre, vous faites donc confiance à la comparaison de Microsoft pour les chiffres exacts.
2. ElevenLabs Scribe v2
Idéal pour : les équipes médias, podcasts et doublage qui ont besoin d'étiquettes de locuteur riches et d'un étiquetage des événements sonores.
ElevenLabs s'est fait un nom dans la génération vocale, et Scribe est son volet reconnaissance vocale. Le modèle phare actuel est scribe_v2, avec une variante scribe_v2_realtime affichant environ 150 ms de latence. Dans la comparaison FLEURS de Microsoft, il atteint 6,2 %, un cran derrière les leaders mais en très bonne compagnie, et ElevenLabs revendique elle-même plus de 98 % de précision de transcription avec des détails de WER par langue.
Là où Scribe prend l'avantage, c'est la richesse de la sortie. Il couvre plus de 90 langues, identifie jusqu'à 32 locuteurs (le maximum ici), étiquette des événements sonores dynamiques comme les rires et la musique, et reconnaît 65 types d'entités. Pour qui découpe des sous-titres ou transcrit des enregistrements à plusieurs voix, ce niveau de détail est tout l'intérêt.
La facturation se fait à l'heure : Scribe v2 coûte 0,22 $ par heure en lots et 0,39 $ en temps réel, avec des options comme la détection d'entités (+0,070 $/h) et le prompting de termes clés (+0,050 $/h). L'offre gratuite donne 10 000 crédits par mois, mais sans licence commerciale. Un développeur a résumé l'intérêt pratique sur Hacker News :
"Le modèle Scribe d'ElevenLabs est aussi particulièrement précis, et je l'utilise pour des transcriptions de haute qualité ou je téléverse des fichiers à la main vers leur API pour obtenir l'identification des locuteurs et les horodatages."
Notre avis : Scribe v2 est le modèle à battre pour le travail média, où l'identification de 32 locuteurs et l'étiquetage audio se justifient. Il est un peu derrière en WER brut et plus cher que les options les moins chères, mais pour les équipes de contenu la qualité de sortie en vaut la peine. Pour une simple transcription d'appels de support, des modèles moins chers font le même travail de base.
3. Deepgram
Idéal pour : les agents vocaux en temps réel, les systèmes téléphoniques et tout produit qui diffuse de l'audio en direct.
Deepgram est le favori des développeurs pour la transcription en temps réel, et la réponse la plus claire à la seule chose que MAI-Transcribe-2 ne fait pas bien d'origine : le streaming en direct. Il figure dans la plupart des panoramas des entreprises d'IA vocale pour une bonne raison. Son modèle phare Nova-3 gère à la fois les lots et le streaming, et un modèle plus récent appelé Flux est conçu spécialement pour les agents vocaux, avec détection des tours de parole intégrée. Si vous branchez de la voix sur un serveur vocal ou un agent en direct, c'est ici que les développeurs commencent.
Les tarifs sont agressifs et d'une transparence inhabituelle. Nova-3 coûte 0,0043 $ par minute pour l'audio préenregistré (environ 0,26 $ par heure) et 0,0048 $ par minute pour le streaming, facturé à la seconde sans arrondi. Vous obtenez 200 $ de crédit gratuit, soit environ 750 heures, pour tester. Il couvre plus de 40 langues, gère l'identification des locuteurs et les horodatages par mot, et prend en charge le prompting de termes clés pour votre jargon.
L'autre point à signaler est le déploiement. Deepgram propose des conteneurs auto-hébergés sur son offre Enterprise, avec SOC 2, HIPAA, RGPD et résidence des données dans l'UE, de sorte que les équipes réglementées peuvent garder l'audio sur leur propre infrastructure. C'est un vrai différenciateur face aux API uniquement cloud de cette liste.
Notre avis : pour tout ce qui est temps réel, Deepgram est ma recommandation par défaut face à MAI-Transcribe-2. Moins de langues que Gemini ou Whisper, mais sa latence de streaming, sa facturation à la seconde et son option d'auto-hébergement en font le choix pratique pour les produits vocaux en direct. Si tout votre audio est constitué de fichiers enregistrés, les leaders en précision peuvent le devancer.
4. AssemblyAI
Idéal pour : les équipes qui veulent la transcription plus résumés, sentiment et masquage de données en un seul appel d'API.
L'argument d'AssemblyAI est que la transcription n'est que la première étape. Son modèle phare Universal-3.5 Pro fait la reconnaissance vocale, puis toute une couche d'Audio Intelligence se superpose : résumé, analyse de sentiment, détection de sujets, détection d'entités, masquage des PII et une LLM Gateway pour exécuter des prompts de modèles de langage sur l'audio. Si vous deviez sinon assembler trois services, AssemblyAI le fait en un.
Les tarifs sont à l'heure et parmi les plus bas ici. Universal-3.5 Pro coûte 0,21 $ par heure en asynchrone et 0,45 $ en temps réel, tandis que l'ancien Universal-2 descend à 0,15 $ par heure. Les fonctions d'intelligence sont facturées séparément à l'heure en plus, vous ne payez donc que ce que vous activez. L'offre gratuite est généreuse : 185 heures d'audio préenregistré et 333 heures de streaming, sans carte bancaire.
Une remarque honnête : AssemblyAI vante une "précision de pointe sur l'audio réel" mais n'imprime aucun chiffre FLEURS sur ses pages principales, et n'apparaît donc pas dans la comparaison de Microsoft. Vous le choisissez pour la couche d'intelligence et le prix, pas pour un WER affiché que l'on pourrait vérifier.
Notre avis : si votre produit a besoin de l'analyse, pas seulement de la transcription, comme des résumés d'appels ou un score de sentiment, AssemblyAI vous évite d'ajouter un second fournisseur. Pour la seule transcription brute, il est compétitif mais pas nettement meilleur que les leaders en précision. L'énorme offre gratuite facilite l'essai.
5. OpenAI GPT-Transcribe
Idéal pour : les équipes qui exploitent déjà un pipeline OpenAI et veulent la transcription dans le même SDK.
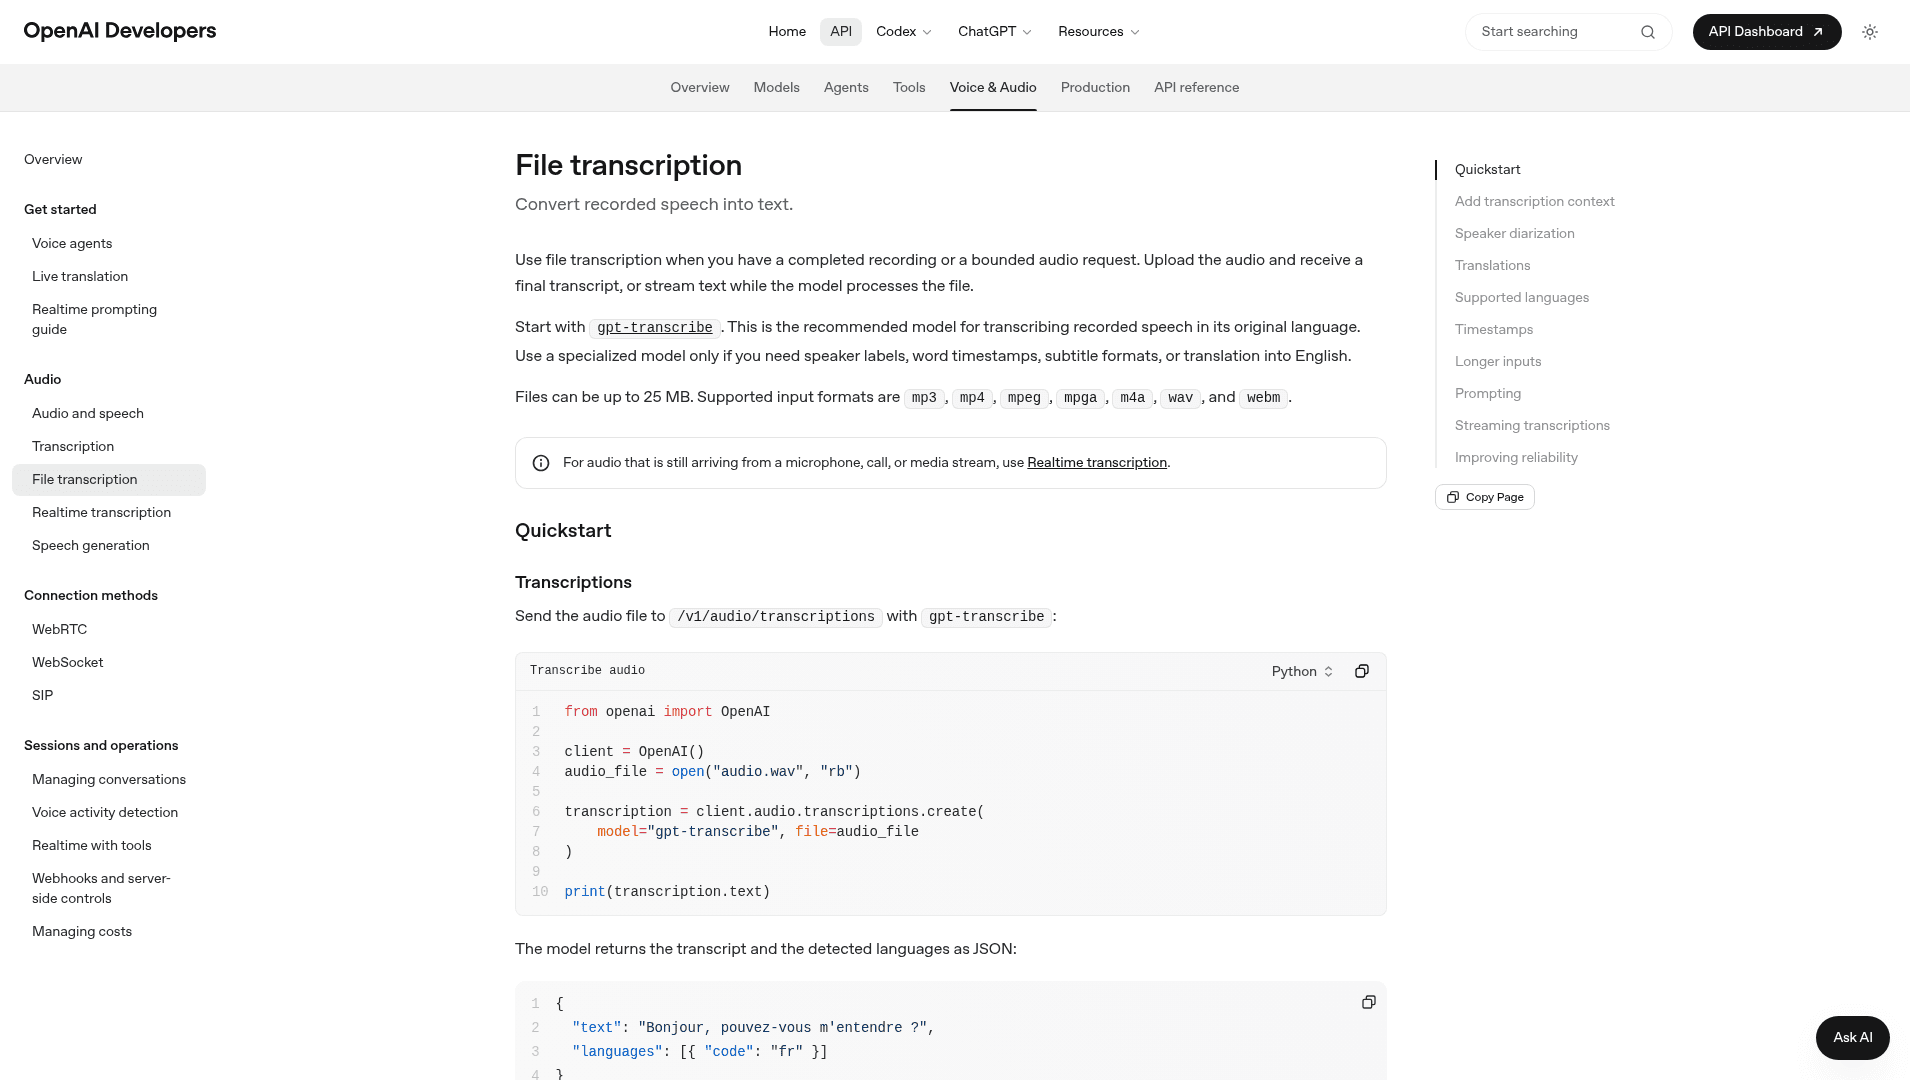
OpenAI a discrètement renouvelé sa gamme de transcription. gpt-transcribe est désormais le choix par défaut recommandé, avec gpt-4o-transcribe, gpt-4o-mini-transcribe et l'ancien whisper-1 toujours disponibles. Dans le tableau FLEURS de Microsoft, GPT-Transcribe atteint 10,4 %, bien derrière les leaders, même si les avis du monde réel sont plus chaleureux que ce chiffre ne le suggère :
"Utter utilise GPT-4o Transcribe par défaut pour la transcription cloud et, d'après mon expérience, c'est le meilleur de sa catégorie. L'écart est surtout visible sur les noms, la terminologie de niche et le vocabulaire technique."
La tarification est à la minute d'audio : gpt-transcribe coûte 0,0045 $ par minute (environ 0,27 $ par heure), gpt-4o-transcribe 0,006 $ et gpt-4o-mini-transcribe un bon marché 0,003 $. Les fichiers sont limités à 25 Mo, et environ 99 langues sont prises en charge avec détection automatique.
Le piège à anticiper : les modèles simples n'étiquettent pas les locuteurs. L'identification des locuteurs vit dans un modèle séparé, gpt-4o-transcribe-diarize, et les horodatages par mot ne sont disponibles qu'avec l'ancien whisper-1. Le bel argument de "l'API unique" comporte donc quelques astérisques selon les métadonnées dont vous avez besoin.
Notre avis : la raison de choisir GPT-Transcribe est l'intégration, pas la précision. Si vous appelez déjà OpenAI, ajouter la transcription tient en une ligne et la qualité pratique sur les noms et le jargon est appréciée. Si la précision sur de nombreuses langues est la priorité, le benchmark dit de regarder d'abord Gemini ou MAI.
6. Speechmatics
Idéal pour : la plus large couverture de langues et d'accents, et les équipes qui ont besoin d'un déploiement sur site.
Speechmatics est le spécialiste de l'entreprise, bâti autour d'une précision indépendante de l'accent et d'une philosophie linguistique "global-first". Il couvre plus de 55 langues et dialectes de transcription ainsi que 69 paires de traduction, et son modèle multilingue Melia gère le changement de langue en cours de conversation, un vrai atout pour l'audio en plusieurs langues.
Les tarifs sont à l'heure et basés sur des crédits, avec des paliers clairs. Le traitement par lots va de 0,129 $ par heure sur le modèle Melia jusqu'à 0,40 $ pour le modèle Enhanced, le palier Standard étant à 0,24 $ ; le temps réel va de 0,24 $ à 0,43 $. Il y a 100 $ de crédit gratuit et une remise automatique de 20 % au-delà de 500 heures par mois. Il obtient 4,7 sur 5 sur G2 pour 70 avis.
Le point fort est le déploiement. Speechmatics offre un véritable auto-hébergement : Private Cloud, Container, Virtual Appliance et même options On-Device, toutes de niveau Enterprise, avec SOC 2 Type II, ISO 27001, RGPD et HIPAA. Adobe Premiere et Stenograph l'exécuteraient directement sur l'appareil. Si votre audio ne peut légalement pas sortir de vos murs, c'est l'un des rares modèles de cette liste à le permettre.
Notre avis : Speechmatics est la réponse quand la conformité et l'étendue des langues priment sur un prix plancher. Ce n'est ni le moins cher ni le champion FLEURS, mais l'offre sur site et la précision indépendante de l'accent en font le choix sûr pour les entreprises réglementées et multilingues. Les petites équipes en quête de la facture la plus basse iront voir ailleurs.
7. Amazon Transcribe
Idéal pour : les équipes dont les données et l'infrastructure vivent déjà dans AWS.
Amazon Transcribe est l'option du cloud historique, et toute sa proposition de valeur tient à son caractère natif AWS. Les tâches par lots lisent et écrivent dans S3, il s'insère dans les pipelines d'événements Lambda et alimente Bedrock et Amazon Connect Contact Lens pour les résumés génératifs. Si vous êtes déjà une maison AWS, il n'y a ni nouveau fournisseur, ni facturation séparée, ni nouvelle revue de sécurité.
La tarification est à la seconde, par paliers, avec des tarifs dégressifs au volume. Le lot standard coûte 0,006 $ par minute (environ 0,36 $ par heure) et le streaming 0,01 $ par minute, avec identification des locuteurs, vocabulaire personnalisé et identification de la langue inclus. L'offre gratuite est de 60 minutes par mois pendant les 12 premiers mois. Il existe aussi un palier Transcribe Medical compatible HIPAA, à environ 0,075 $ par minute, qui identifie automatiquement les informations de santé protégées.
Il couvre plus de 100 langues et fournit les fonctions classiques : identification des locuteurs, vocabulaire personnalisé, masquage des PII et analyses Call Analytics. Ce qu'il ne publie pas, c'est un chiffre de précision, d'où son absence de la comparaison de Microsoft, et sa précision réelle a une réputation mitigée face aux fournisseurs plus récents centrés sur le modèle.
Notre avis : l'argument en faveur d'Amazon Transcribe est opérationnel, pas fondé sur la précision. Dans AWS, c'est la voie de moindre résistance, et la facturation et l'IAM unifiées valent de l'argent. En dehors d'AWS, il y a peu de raisons de le préférer aux modèles spécialisés plus affûtés et moins chers, et vous payez une prime au tarif standard.
8. OpenAI Whisper (open source)
Idéal pour : les équipes qui ont leurs propres GPU et veulent un coût nul à l'heure et un contrôle total.
Whisper est le modèle qui a rendu la transcription open source grand public, et il reste la référence de l'auto-hébergement. Il est sous licence MIT pour le code comme pour les poids, existe en six tailles, de tiny (39 M de paramètres) à large-v3 (1550 M), plus une version turbo de 809 M, et s'installe avec un simple pip install. Il n'y a aucune facture d'API, vous ne payez que le calcul, environ 10 Go de VRAM pour exécuter large-v3.
Le compromis honnête, c'est la précision et l'effort. Dans la comparaison FLEURS de Microsoft, whisper-large-v3 se situe à 22,8 %, très loin derrière les modèles modernes, ce qui illustre bien la vitesse à laquelle ce domaine a avancé. Il n'a pas non plus d'identification des locuteurs intégrée (on ajoute pyannote ou WhisperX) ni de streaming natif. Mais pour de nombreuses charges de travail la qualité suffit amplement, comme l'a dit un utilisateur qui l'héberge :
"J'exécute whisper large-v3 sur un M2 Max via un point d'accès auto-hébergé et, honnêtement, la précision est assez bonne pour que j'aie arrêté de m'embêter avec des modèles de nettoyage. Le plus gênant pour moi, c'était la latence sur les segments plus longs."
Si vous voulez Whisper sans gérer de serveurs, OpenAI héberge aussi whisper-1 en API à 0,006 $ par minute.
Notre avis : Whisper est le choix quand le contrôle des données et le coût marginal nul l'emportent sur la précision de pointe. À grande échelle, l'auto-hébergement peut battre toutes les API payantes ici. Prévoyez simplement le temps GPU, le complément d'identification des locuteurs et l'écart de précision face à un modèle de 2026 comme MAI-Transcribe-2 ou Gemini.
Lequel choisir vraiment ?
La réponse honnête est que la transcription est devenue une couche banalisée, le choix dépend donc de la tâche, pas d'un unique "meilleur" modèle, un peu comme choisir un logiciel de helpdesk IA relève de l'adéquation plutôt que d'un classement. Voici le raccourci que j'utiliserais.
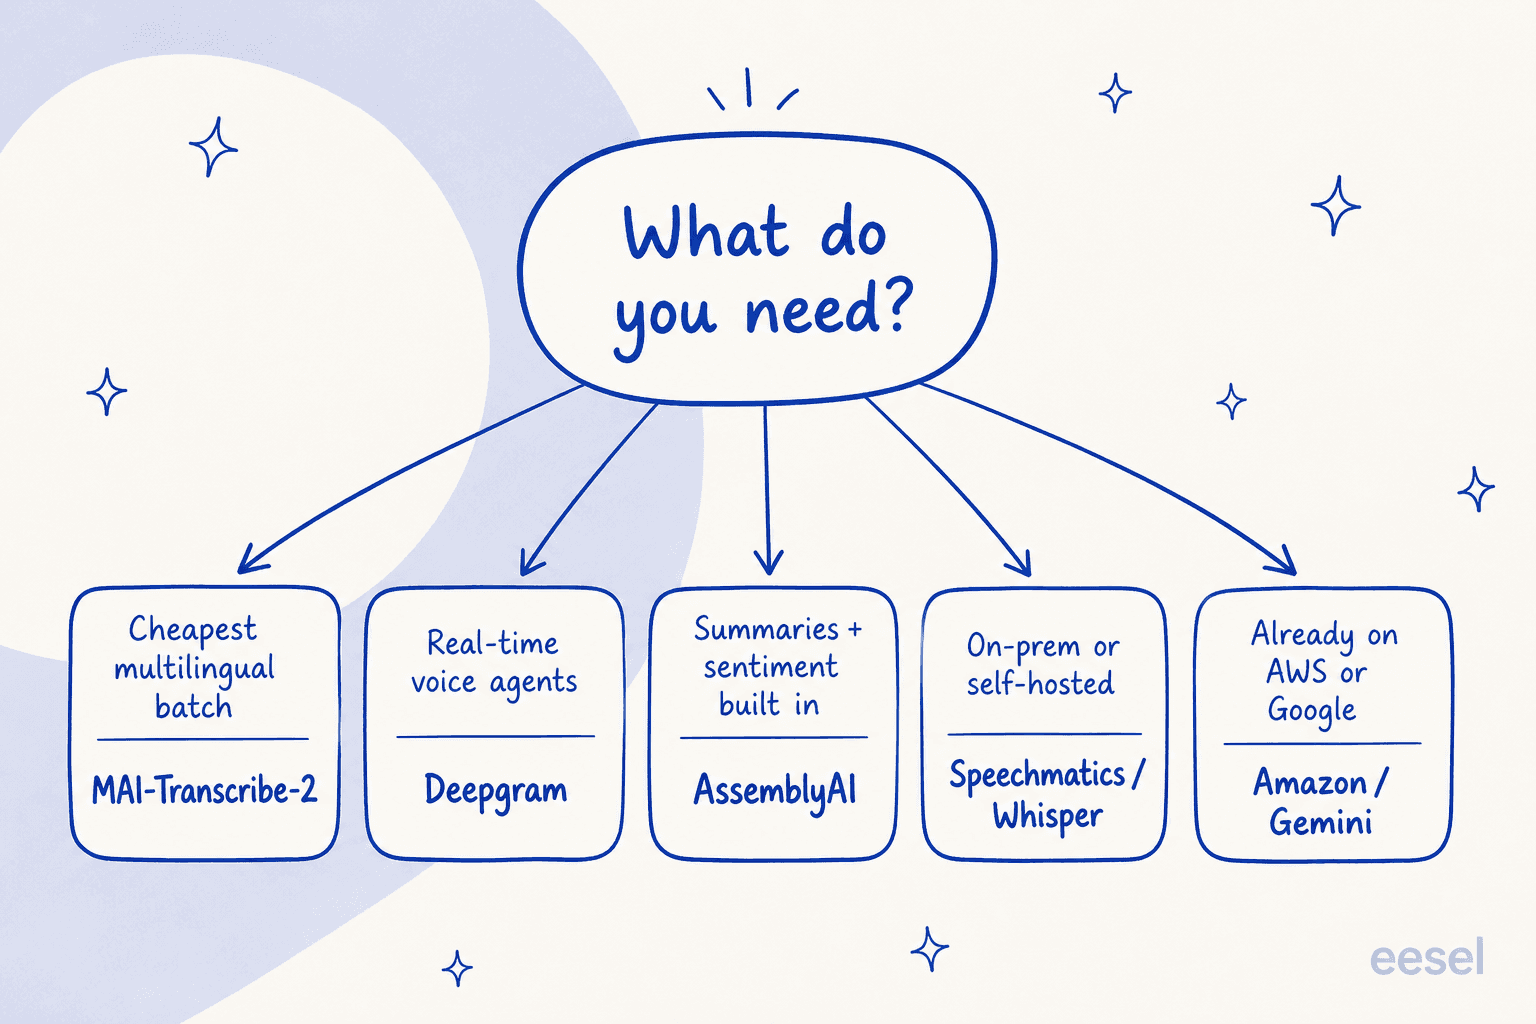
Si vous cherchez la facture la plus basse pour des lots multilingues, MAI-Transcribe-2 ou Deepgram l'emportent. Pour des agents vocaux en direct, Deepgram ou Speechmatics. Pour des résumés et du sentiment prêts à l'emploi, AssemblyAI. Si vous êtes tenu par la conformité ou le sur site, Speechmatics ou Whisper. Si vous vivez déjà dans un cloud, utilisez Amazon Transcribe ou Gemini et évitez le travail d'intégration.
Ce que le classement ne montre pas
Voici le recadrage auquel je suis sans cesse revenu pendant mes recherches, et c'est ce qui compte vraiment si vous travaillez dans le support. La transcription était autrefois la partie difficile et coûteuse. Ce n'est plus le cas. MAI-Transcribe-2 et chaque modèle de cette liste en ont fait une commodité rapide, bon marché et presque résolue. C'est formidable, mais cela signifie que la valeur s'est déplacée.
Une transcription précise d'un appel de support n'est pas ce que quelqu'un voulait. Il faut encore lire le texte, trouver la réponse dans vos documents et vos anciens tickets, puis rédiger la réponse et résoudre le ticket. Le modèle vous donne les oreilles. Il ne vous donne pas le coéquipier.
Je vois cela se jouer chez eesel depuis des années. Nous avons fait tourner de l'IA sur des files de support en direct sur des milliers de tickets réels, et la leçon qui est restée est que la précision de transcription n'a jamais été le goulot d'étranglement ; c'était la résolution. C'est aussi pourquoi nous simulons chaque déploiement sur les vrais tickets passés d'une équipe avant qu'il ne réponde à un client, pour que vous voyiez comment il aurait traité votre file plutôt que de vous fier à un benchmark. Un modèle à l'air sûr de lui qui donne de mauvaises réponses est pire que pas de modèle, et ce risque se situe dans la couche de résolution, pas dans celle de la transcription.
Essayez eesel pour transformer les transcriptions en résolutions
Chaque modèle de cette liste est une infrastructure. eesel est l'employé qui travaille par-dessus. Nous construisons des coéquipiers IA que vous embauchez pour une tâche précise, et le coéquipier IA de helpdesk est celui qui reprend exactement là où s'arrête un modèle de transcription : il lit le texte, tire la réponse de votre centre d'aide et de vos anciens tickets, puis rédige ou envoie la réponse directement dans Zendesk, Freshdesk ou Slack. Associez un modèle comme MAI-Transcribe-2 à eesel et un ticket vocal transcrit devient un ticket résolu, pas seulement un joli paragraphe.
Et comme ce sont tous des modèles pensés API d'abord, les développeurs qui les choisissent veulent généralement le même contrôle sur leur automatisation du support. eesel dispose d'une CLI publique pour exactement cela : elle pilote le même coéquipier et le même espace de travail depuis un terminal, de sorte qu'une personne peut l'exécuter à la main, qu'un script peut l'automatiser et que des agents de code comme Claude Code ou Cursor peuvent l'opérer sans interface, sans tableau de bord. Vous branchez la transcription en début de pipeline et eesel à l'extrémité qui résout. C'est gratuit à essayer, cela se connecte à votre helpdesk en quelques minutes et simule sur vos vrais tickets passés avant de répondre à un seul client.