Les 8 meilleures alternatives à Claude Sonnet 5.5 en 2026 (selon la raison de votre départ)

Kurnia Kharisma

Katelin Teen
Dernière modification September 29, 2026
Pourquoi on regarde au-delà de Claude Sonnet 5.5
D'abord, ce qui est juste. Sonnet 5.5 est un gros progrès par rapport à Claude Sonnet 5. Le tableau de lancement d'Anthropic lui donne 70,6 % sur Terminal-Bench 4.0, devant les 66,4 % d'Opus 5.5, et Zendesk a dit à Anthropic que les tickets étaient traités 20 % plus vite avec lui. Le test de Sonnet 5.5 passe tout cela en revue, et le verdict de mon collègue tient toujours : excellent à effort moyen.
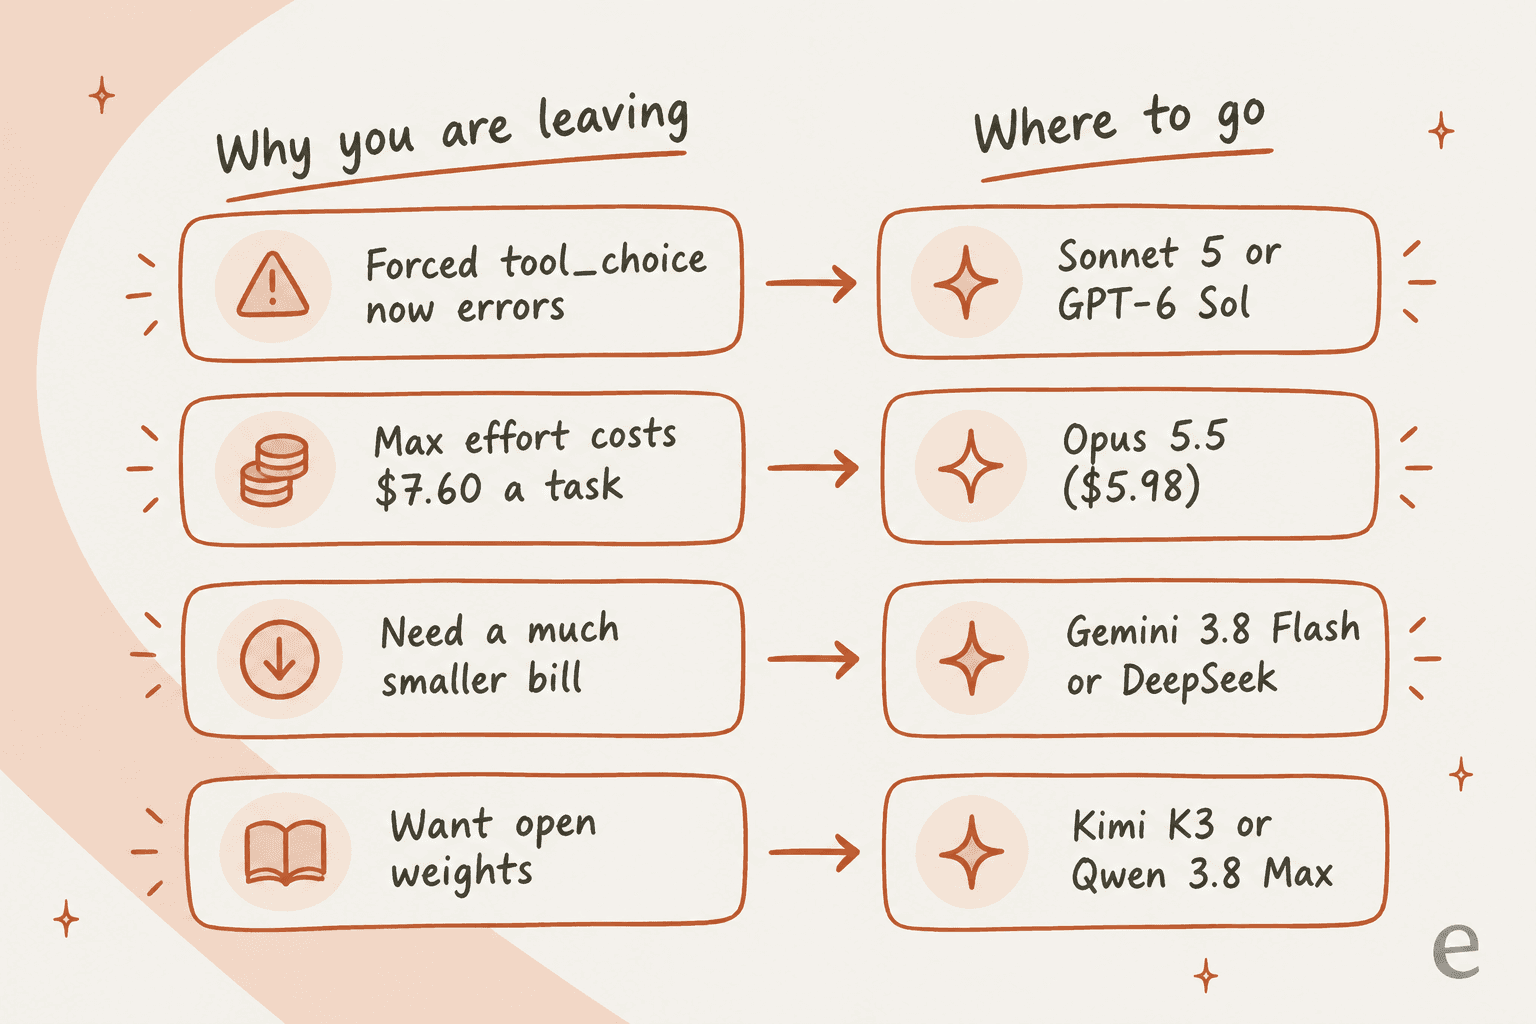
Je fais du SEO depuis deux ans, donc le comportement de recherche autour de ce modèle m'a appris quelque chose avant même tout benchmark. « Alternatives à Sonnet 5.5 » est apparu le lendemain du lancement, trop tôt pour que quiconque ait dépassé le modèle. Les gens cherchaient parce que quelque chose s'était cassé, ou parce qu'une facture les avait surpris. Ce sont les quatre raisons autour desquelles j'organise le reste de l'article.
Raison 1 : cinq changements cassants, dont un frappe surtout les bots
Anthropic liste cinq changements cassants pour le code qui tournait sur Sonnet 5. thinking: disabled renvoie maintenant une erreur 400 et vous oriente vers between_tools. L'ancien outil computer_20251124 est rejeté sur l'API Claude et sur Google Cloud. Certaines associations avec l'outil advisor sont aussi refusées.
Celui qui casse les bots en production est l'usage forcé d'outils. tool_choice réglé sur any ou sur un outil nommé renvoie une invalid_request_error 400 sur Sonnet 5.5. Anthropic suggère de garder auto, de définir strict: true ou de passer aux sorties structurées, et de « préciser dans le prompt quand l'outil s'applique ». Ça marche, mais au fond on échange une garantie contre une demande. Si votre étape de tri de tickets ou d'extraction comptait sur le fait que le modèle appelle toujours classify_ticket, vous avez maintenant un comportement à retester et non une ligne à changer. Et passer à Opus 5.5 n'aide pas ici : ses notes de migration listent la même erreur 400.
Raison 2 : l'effort maximal coûte plus cher qu'Opus
L'effort par défaut de l'API pour Sonnet 5.5 est high. Tout en haut de l'échelle, ça devient cher. Sur l'Intelligence Index d'Artificial Analysis, Sonnet 5.5 à max a obtenu 56 pour $7.60 par tâche, tandis qu'Opus 5.5 à max a obtenu 58 pour $5.98. Sonnet a simplement utilisé plus de tokens pour atteindre ce score.
"I'm a bit confused myself. On artificial analysis, sonnet 5.5 max has a cost per task of $7.60 while opus 5.5 max has $5.98. Sonnet 5.5 max was using 193k tokens per task while opus 5.5 max was using 119k."

Simon Willison a vu la même forme, mais sur un seul prompt. Son tableau d'effort allait de 1,6 centime à low à $1.28 à max, où le modèle a « burned through 128,000 thinking tokens » en environ 15 minutes sans finir (simonw sur Hacker News).
Raison 3 : les lectures de cache coûtent autant que sur Opus
Sonnet 5.5 coûte moitié moins qu'Opus 5.5 en entrée, sortie et écritures de cache. Les lectures de cache font exception, $0.20 par million pour les deux, car Opus 5.5 facture les lectures de cache à 0,05x. Dans une longue boucle d'agent, la plupart des tokens vont aux lectures de cache, l'écart se referme donc. La page des tarifs de l'API Anthropic donne les multiplicateurs.
"Cache read is the same as Opus as well where most agentic workflow cost comes from. Not quite sure where this fits well."

Raison 4 : le même tarif affiché achète un travail très différent
C'est le graphique qui m'a le plus surpris pendant mes recherches. Trois modèles partagent exactement le même prix de $2 en entrée / $10 en sortie. À effort maximal, ils produisent pourtant des factures très différentes pour chaque tâche terminée.
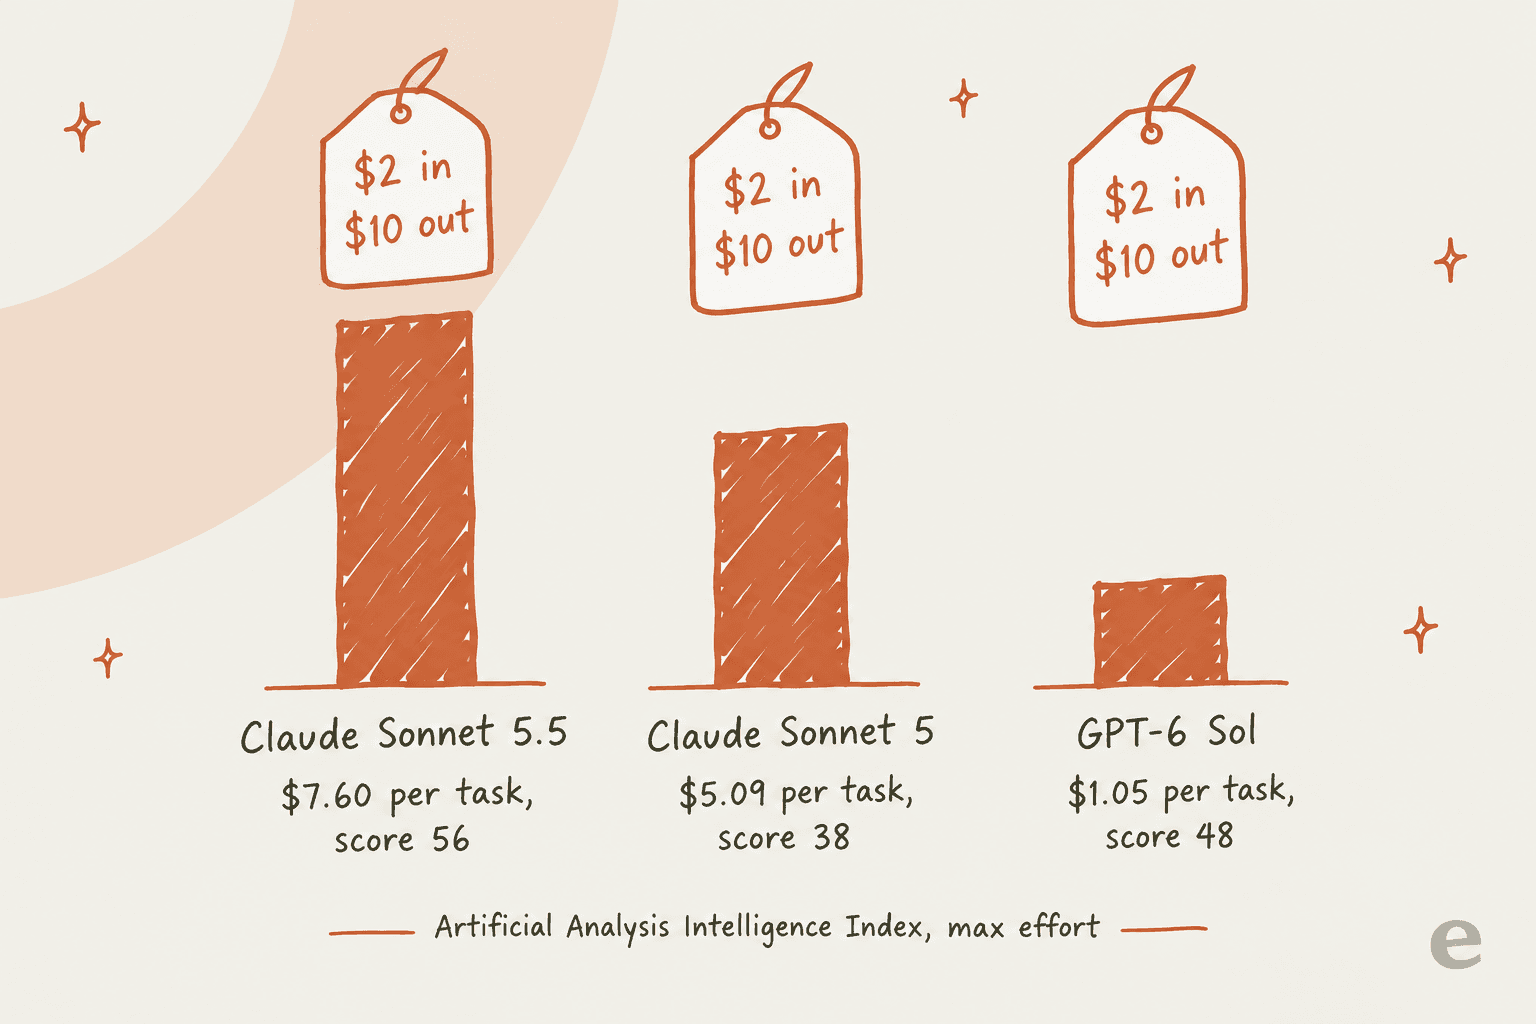
Sonnet 5.5 est le plus intelligent des trois. C'est aussi le plus cher par tâche, et de loin. Le tarif affiché au token ne dit presque rien de la facture. Ce qui compte, ce sont les tokens par tâche, une propriété du modèle qu'on ne découvre qu'en l'exécutant.
Les alternatives à Claude Sonnet 5.5 en un coup d'œil
Les prix sont par million de tokens, d'après la page tarifaire de chaque fournisseur, vérifiés le 2026-09-29. La colonne Artificial Analysis utilise l'échelle actuelle de l'Intelligence Index, avec le réglage d'effort testé par AA entre parenthèses. J'ai laissé une cellule vide plutôt que de mélanger un score de l'ancienne échelle.
| Modèle | Entrée / sortie | Lecture cache | Contexte | Score AA, coût par tâche | Choix d'outil forcé | Poids ouverts | Idéal pour |
|---|---|---|---|---|---|---|---|
| Claude Sonnet 5.5 (référence) | $2 / $10 | $0.20 | 1M | 56, $7.60 (max) | Non, renvoie 400 | Non | Code rapide en Low/Medium |
| Claude Opus 5.5 | $4 / $20 | $0.20 | 1M | 58, $5.98 (max) | Non, renvoie 400 | Non | Tâches difficiles à effort élevé |
| Claude Sonnet 5 | $2 / $10 | $0.20 | 1M | 38, $5.09 (max) | Oui | Non | Repli sans réécriture |
| GPT-6 Sol | $2 / $10 | $0.20 | 1.05M | 48, $1.05 (max) | Oui (Responses API) | Non | Même prix, facture plus basse |
| Gemini 3.8 Flash | $0.75 / $3.75 | $0.075 | 1M | 41, $1.24 (high) | Oui (mode any) | Non | Traitement par lots multimodal pas cher |
| Grok 4.7 | $2 / $6 | $0.50 | 500K | 46, $3.74 (xhigh) | Oui (required ou nommé) | Non | Longues boucles d'agents |
| Qwen 3.8 Max | $2 / $6 | $0.25 | 1M | - | Outil nommé, sans thinking seulement | Modèle de base, licence propre | Sortie moins chère, base ouverte |
| Kimi K3 | $3 / $15 | $0.30 | 1M | - | required seulement | Oui, licence propre | Poids ouverts avec vision |
| DeepSeek V4.1 Flash | $0.15 / $0.60 hors pointe | $0.003 | 1M | 39, $0.27 (max) | Mode sans thinking seulement | Oui, MIT | Le plancher de coût |
La colonne du choix d'outil forcé vient de la documentation de function calling de chaque fournisseur. Lisez-la attentivement, car c'est la colonne que la plupart des gens interprètent mal. La documentation de définition d'outils d'Anthropic liste ensemble Opus 5.5, Sonnet 5.5 et Fable 5.1 comme des modèles où any et tool renvoient une erreur 400. DeepSeek et Qwen n'autorisent les outils forcés qu'avec le thinking désactivé, et Kimi K3, qui réfléchit toujours, accepte required mais pas un outil nommé. Seuls Sonnet 5, GPT-6 Sol, Gemini 3.8 Flash et Grok 4.7 forcent un appel d'outil avec le raisonnement activé.
Comment j'ai choisi
Je suis parti des quatre raisons ci-dessus, puis j'ai posé une question pour chaque candidat : ce modèle règle-t-il une raison précise de quitter Sonnet 5.5, sans en créer une pire ? Chaque prix vient de la page tarifaire du fournisseur lui-même. Chaque coût par tâche vient d'Artificial Analysis, qui exécute le même Intelligence Index sur chaque modèle et publie ce qu'il a dépensé. Les citations de la communauté viennent de fils Hacker News et Reddit où des gens ont testé les modèles eux-mêmes.
J'ai écarté Claude Haiku 4.5 comme choix principal. C'est une vraie option à $1/$5, mais Anthropic indique son retrait le plus proche au 15 octobre 2026, dans environ deux semaines, et je ne commencerais pas une migration vers un modèle affichant cette date.
Trouvez votre alternative en dix secondes
Touchez la raison qui vous amène ici.
Pourquoi quittez-vous Claude Sonnet 5.5 ?
Choisissez-en une pour voir où j'irais.
1. Claude Opus 5.5
Idéal pour : les équipes qui font tourner Sonnet 5.5 à effort xhigh ou max et qui en paient le prix.
Je mets d'abord le choix contre-intuitif. Claude Opus 5.5 coûte deux fois plus cher au token et peut pourtant être le modèle le moins cher. À effort maximal sur Artificial Analysis, Opus 5.5 a obtenu 58 pour $5.98 la tâche, Sonnet 5.5 a obtenu 56 pour $7.60. Opus est sorti comme le premier Opus d'Anthropic à baisser de prix, $4/$20 au lieu de $5/$25, et ses lectures de cache sont facturées à 0,05x, d'où l'alignement sur les $0.20 de Sonnet.
Il récompense aussi la descente d'un cran. Le détail des tarifs de Sonnet 5.5 a montré Opus 5.5 à Medium à 51 pour $1.34 la tâche, contre Sonnet 5.5 à Xhigh à 52 pour $2.74. Presque le même score, pour environ moitié moins.
Avantages
- Plafond plus haut que Sonnet 5.5 sur l'Intelligence Index, 58 contre 56 à max.
- Moins cher par tâche que Sonnet 5.5 à effort maximal.
- Même API Claude, mêmes outils, mêmes workflows Claude Code.
Inconvénients
- Le double du prix au token de Sonnet en entrée, sortie et écritures de cache : à Low et Medium, Sonnet 5.5 gagne.
- Plus lent, ce que les gens du fil de lancement ont remarqué tout de suite.
- Rejette
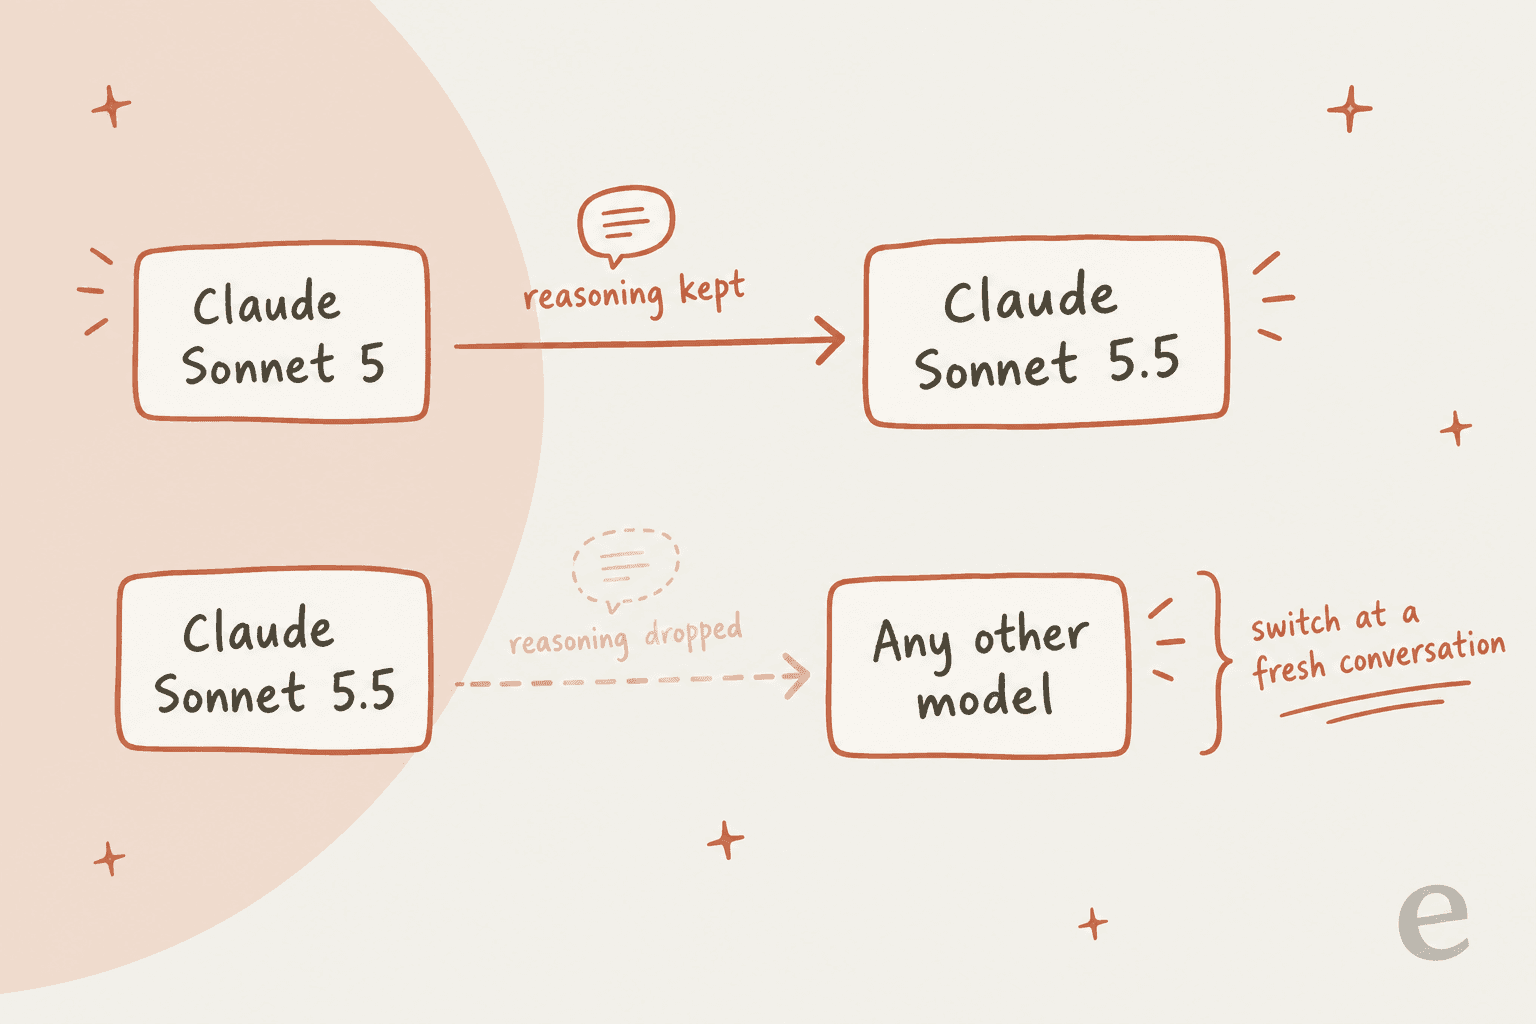
tool_choiceforcé exactement comme Sonnet 5.5, il ne règle donc pas ce changement cassant. - Sonnet 5.5 ne peut pas lire les blocs de réflexion d'Opus 5.5 et inversement : les mélanger dans une conversation abandonne le raisonnement.
Tarifs
$4 en entrée, $20 en sortie, $0.20 en lecture de cache par million de tokens, avec Batch à moitié prix. Voir l'article sur les tarifs de Claude Opus 5.5 pour chaque ligne.
Mon avis : Si votre charge vit à xhigh ou max, passez à Opus 5.5 et descendez d'un niveau d'effort. Vous paierez probablement moins et obtiendrez une meilleure réponse. Si vous travaillez à Low ou Medium, restez sur Sonnet 5.5 ; ce choix ne vous concerne pas.
2. Claude Sonnet 5
Idéal pour : tous ceux dont le code de production a cassé à cause de l'usage forcé d'outils de Sonnet 5.5 ou du changement sur thinking: disabled.
C'est la réponse ennuyeuse, mais le jour où votre pipeline se met à lancer des 400, c'est la bonne. Claude Sonnet 5 est le modèle par rapport auquel les cinq changements cassants sont mesurés, donc par définition aucun ne s'applique. Même prix de $2/$10. La page des dépréciations d'Anthropic le liste comme actif, sans retrait avant le 30 juin 2027.
Il y a un joli détail dans la documentation pour qui prévoit une migration par étapes. Sonnet 5.5 peut lire les blocs de réflexion de Sonnet 5 : une conversation qui démarre sur Sonnet 5 et monte garde donc son raisonnement. L'inverse ne marche pas.
Avantages
- Un retour arrière en une ligne : changez l'ID du modèle, rien d'autre.
- Conserve
tool_choiceforcé, les budgets de thinking manuels et l'ancien outil de computer use. - Plancher de retrait à plus de 20 mois.
Inconvénients
- Nettement moins capable. Terminal-Bench 4.0 est à 10,3 % contre 70,6 % pour Sonnet 5.5 dans le tableau de lancement d'Anthropic.
- Pas moins cher par tâche non plus. À max, il a mesuré
$5.09pour un score de 38. - N'est plus dans le tableau des modèles actuels d'Anthropic, les nouveautés arriveront donc d'abord sur 5.5.
Tarifs
$2 en entrée, $10 en sortie, $0.20 en lecture de cache par million de tokens. L'article sur les tarifs de Claude Sonnet 5 détaille les forfaits et Batch.
Mon avis : Utilisez Sonnet 5 comme parking, pas comme destination. Faites le retour arrière aujourd'hui, réparez vos appels d'outils sur une branche face à Sonnet 5.5 ou GPT-6 Sol, puis avancez. La liste des alternatives à Claude Sonnet 5 mérite un coup d'œil si vous restez garé plus longtemps.
3. GPT-6 Sol
Idéal pour : les équipes qui veulent un prix de niveau Sonnet avec des appels d'outils forcés et une facture plus petite par tâche.
GPT-6 Sol a le même tarif affiché que Sonnet 5.5 : $2 en entrée, $0.20 en cache, $2.50 d'écritures de cache, $10 en sortie (tarifs OpenAI). La différence tient au nombre de tokens dépensés. À effort maximal sur Artificial Analysis, GPT-6 Sol a obtenu 48 pour $1.05 la tâche, environ un septième de la facture à effort maximal de Sonnet 5.5. Il est moins capable au sommet : 48 contre 56.
Pour ceux qui ont besoin de l'usage forcé d'outils, le guide de function calling d'OpenAI documente required et le choix d'outil par nom de fonction. Un bémol sur la page du modèle : via Chat Completions, GPT-6 Sol ne gère le function calling qu'avec reasoning_effort sur none. Utilisez la Responses API si vous voulez outils et raisonnement ensemble.
Avantages
- Même prix au token que Sonnet 5.5, coût par tâche bien plus bas à max.
- Choix d'outil forcé documenté.
- Contexte de 1 050 000 tokens et un jeu d'outils complet de la Responses API.
Inconvénients
- Plafond plus bas : 48 sur l'Intelligence Index contre 56 pour Sonnet 5.5.
- Les prompts de plus de 272K tokens d'entrée sont facturés à 2x en entrée et 1,5x en sortie pour toute la requête.
- Changer de fournisseur, c'est du nouveau code SDK, un nouveau réglage de prompts et de nouvelles évals.
"Sonnet 5.5 is way better than GPT 6 Sol. Does that even make sense?"
Ce commentaire est un contrepoids honnête aux chiffres. Sur du code difficile, beaucoup de gens préfèrent Sonnet 5.5, et les benchmarks leur donnent raison.
Tarifs
$2 en entrée, $0.20 en cache, $10 en sortie, avec Batch et Flex à moitié prix. L'article sur les tarifs de GPT-6 Sol et la liste des alternatives à GPT-6 Sol vont plus loin.
Mon avis : Le meilleur échange direct pour un travail à gros volume et riche en outils, où « bon et pas cher par tâche » compte plus que « le meilleur ». Pour la qualité de code maximale, restez chez Anthropic.
4. Gemini 3.8 Flash
Idéal pour : le traitement par lots et multimodal à gros volume où personne n'attend le premier token.
Gemini 3.8 Flash coûte $0.75 en entrée et $3.75 en sortie par million de tokens, tokens de thinking inclus, jusqu'au 31 décembre 2026 (tarifs de l'API Gemini). C'est moins de 40 % des tarifs de Sonnet 5.5. Il accepte texte, image, audio, vidéo et PDF en entrée, ce que Sonnet n'égale pas pour l'audio et la vidéo. Sur Artificial Analysis à effort élevé, il a obtenu 41 pour $1.24 la tâche.
Deux choses à anticiper. Le prix double pour passer à $1.50/$7.50 le 1er janvier 2027. Et Artificial Analysis a mesuré son temps avant le premier token à 13,3 secondes, bien au-dessus de la médiane de la catégorie, alors que sa vitesse de sortie figure parmi les meilleures. Bien pour un traitement de nuit, mauvais pour une réponse de chat en direct.
Avantages
- Bien moins cher au token, avec Batch et Flex encore à moitié prix.
- Les types d'entrée les plus larges de cette liste.
- Une offre gratuite pour prototyper.
Inconvénients
- Le prix double dans trois mois.
- Le premier token lent l'exclut pour tout ce qu'une personne attend.
- Google dit que 3.8 « works harder » et utilise plus de tokens, et recommande toujours 3.7 Flash pour le travail axé sur l'efficacité.
Tarifs
$0.75 en entrée, $3.75 en sortie, $0.075 en lecture de cache jusqu'à la fin de l'année. Voir les tarifs de Gemini 3.8 Flash et le test de Gemini 3.8 Flash.
Mon avis : Un choix solide pour le traitement de documents, les transcriptions et tout ce qui touche à la vidéo. Budgétez dès maintenant le changement de prix de janvier, pas en décembre.
5. Grok 4.7
Idéal pour : les longues boucles d'agents où des tokens de sortie moins chers finissent par compter.
Grok 4.7 coûte $2 en entrée et $6 en sortie par million en dessous de 200K tokens de prompt (tarifs xAI). C'est une sortie 40 % moins chère que Sonnet 5.5, et la sortie est là où les modèles de raisonnement dépensent. xAI l'a construit sur un modèle de base plus grand avec un entraînement RL plus long visant des tâches de plusieurs heures, et il a presque doublé Grok 4.6 sur Terminal-Bench 4.0, 37,6 contre 20,3 dans le tableau de xAI lui-même. Sur Artificial Analysis à xhigh, il a obtenu 46 pour $3.74 la tâche.
Avantages
- Sortie à
$6, 40 % sous Sonnet 5.5. - Contexte de 500K et une API Context Compaction pour les longues sessions.
- De bons scores agentiques sur les chiffres EEBench et Briefcase de xAI.
Inconvénients
- Au-delà de 200K tokens de prompt, toute la requête est facturée à
$4/$12, pas seulement le dépassement. - Terminal-Bench 4.0 à 37,6 reste très en dessous des 70,6 de Sonnet 5.5.
- Les lectures en cache à
$0.50coûtent plus que les$0.20d'Anthropic.
Tarifs
$2 en entrée, $0.50 en cache, $6 en sortie sous 200K. L'article sur les tarifs de Grok 4.7 couvre les compteurs d'appels d'outils.
Mon avis : À tester si vos agents génèrent beaucoup de sortie et restent sous 200K de contexte. Gardez des prompts courts, car la falaise du contexte long est abrupte.
6. Qwen 3.8 Max
Idéal pour : les équipes qui veulent un prix d'entrée au niveau de Sonnet, une sortie moins chère et un modèle de base téléchargeable.
Qwen 3.8 Max coûte $2 en entrée et $6 en sortie par million sur Qwen Cloud, avec 1M de contexte, 131K de sortie maximale et jusqu'à 262K tokens de raisonnement. C'est un modèle à mélange d'experts de 2,4T de paramètres dont 95B actifs. Les poids de base sont sur Hugging Face sous le nom Qwen3.8-2.4T-A95B, sous une licence Qwen propre plutôt qu'Apache.
La licence et la liste des fonctions se lisent ensemble. Le Max hébergé ajoute l'entrée vision, un mode sans thinking et des outils intégrés que la base ouverte n'a pas. « Ouvert » signifie ici que vous pouvez faire tourner le modèle de base, pas que vous obtenez le produit hébergé.
Avantages
- Même prix d'entrée que Sonnet 5.5, sortie 40 % moins chère.
- De bons classements de préférence humaine, dont la 5e place en Texte sur LMArena en août.
- Une voie d'auto-hébergement si vous en avez un jour besoin.
Inconvénients
- La base ouverte n'a pas les mêmes fonctions que le modèle hébergé.
- Licence propre : faites-la valider par le juridique avant de livrer avec.
- Les données partent vers le cloud d'Alibaba sauf si vous auto-hébergez.
Tarifs
$2 en entrée, $6 en sortie, $0.25 de lecture de cache implicite. Voir les tarifs de Qwen 3.8 Max et le test de Qwen 3.8 Max.
Mon avis : Une bonne option intermédiaire si le prix de sortie de Sonnet est ce qui fait mal et que vous voulez pouvoir quitter un fournisseur unique plus tard.
7. Kimi K3
Idéal pour : les équipes qui ont besoin de poids ouverts avec vision native et sont prêtes à faire tourner du matériel sérieux.
Kimi K3 est le modèle phare de Moonshot AI : 2,8T de paramètres dont 104B actifs, 1M de contexte et compréhension native de l'image et de la vidéo. Les poids sont sur Hugging Face, ce qu'aucun des modèles occidentaux d'ici ne propose. Sur l'API, il coûte $3 en entrée, $0.30 en cache et $15 en sortie par million (tarifs Moonshot), avec des écritures de cache facturées à part à $3 ou $6 selon le TTL.
Cela le rend plus cher que Sonnet 5.5 sur l'API. La raison de le choisir est le contrôle, pas le coût.
Avantages
- Poids ouverts à l'échelle de la frontière, avec vision intégrée.
- 1M de contexte et sortie réglable jusqu'à 1M de tokens.
- Une voie d'auto-hébergement pour les données qui ne peuvent pas quitter votre réseau.
Inconvénients
- Plus cher que Sonnet 5.5 au token sur l'API hébergée.
- Le raisonnement ne peut être désactivé à aucun niveau d'effort.
- Le dépôt des poids fait environ 1,5 To : l'auto-hébergement est un travail de cluster.
Tarifs
$3 en entrée, $0.30 en cache, $15 en sortie. Voir les tarifs de Kimi K3 et les alternatives à Kimi K3.
Mon avis : Ne choisissez Kimi K3 que si vous allez vraiment auto-héberger. Si vous appelez l'API de toute façon, Sonnet 5.5 à Medium est moins cher et plus simple.
8. DeepSeek V4.1 Flash
Idéal pour : la facture la plus basse possible, et la seule licence ouverte permissive de cette liste.
DeepSeek V4.1 Flash coûte $0.15 en entrée et $0.60 en sortie par million hors pointe, et $0.30/$1.20 aux heures de pointe (tarifs DeepSeek). Le nom d'API est maintenant deepseek-flash. Sur Artificial Analysis à effort maximal, il a obtenu 39 pour $0.27 la tâche, au tarif de pointe, donc hors pointe cela représente environ la moitié. Les poids sont sous licence MIT.
C'est aussi le modèle sur lequel DeepSeek a déplacé son trafic V4 Pro, ce qui dit sa confiance en lui. Il prend en charge les appels d'outils, le format d'API Anthropic et la Responses API : une base de code utilisant le SDK Anthropic peut souvent le viser en changeant l'URL de base.
Avantages
- Environ 28x moins cher par tâche que Sonnet 5.5 à max, selon les chiffres d'AA.
- Poids MIT et un endpoint compatible Anthropic.
- Vision intégrée au modèle principal.
Inconvénients
- Un plafond bien plus bas : 39 sur l'Intelligence Index.
- Les conditions de l'API payante ne publient ni accord de traitement des données ni option de rétention zéro, et les données sont traitées en Chine.
- Le tarif de pointe double le prix de 01:00-04:00 et 06:00-10:00 UTC en semaine.
"I have been using DeepSeek since forever and it's so good I was able to write a compiler and native desktop applications with it."
Tarifs
Hors pointe $0.15 en entrée, $0.60 en sortie, $0.003 par succès de cache ; en pointe c'est le double. Voir les tarifs de DeepSeek V4.1 Flash.
Mon avis : Excellent pour les outils internes, la génération de code et les traitements par lots. Pour tout ce qui porte des données clients, réfléchissez à deux fois aux conditions sur les données avant de regarder le prix.
Ce que disent les développeurs de Sonnet 5.5 face au reste
Le fil de lancement sur Hacker News a atteint 556 commentaires, et le partage était net. Les gens aiment la vitesse et le bond en benchmark. Ils ne savent pas où le placer à côté d'Opus 5.5.
"Per the charts, there is largely no point to using Sonnet 5.5 at high+ as opus low generally will give similar performance at similar or lower cost. But Sonnet 5.5 at medium and below gives you a cheaper option at a performance worse than the lowest thinking Opus (low), which may be viable for "low intelligence" use cases."
Le schéma sur lequel plusieurs personnes se sont fixées n'est pas du tout « quitter Sonnet 5.5 ». C'est de répartir le travail : Opus planifie, Sonnet construit à Low ou Medium, Opus termine. Un commentateur l'a résumé ainsi : « 80% Sonnet 5.5, Opus 5.5 to finish the last 20% » (vektormemory sur Hacker News). Si cela correspond à votre configuration, le guide des sous-agents de Claude Code montre comment le mettre en place.
Il y a aussi une régression de qualité à connaître. Un développeur qui faisait tourner un benchmark adversarial a vu Sonnet 5.5 obtenir 7,4 % contre 17,8 % pour Sonnet 5, parce qu'il « returns to ask the user questions whether to keep going » (dom96 sur Hacker News). Pour un agent sans surveillance, c'est un changement de comportement à tester.
Changer est un problème de support, pas seulement de modèle
Chaque modèle de cette liste sortira une nouvelle version d'ici quelques mois, et certaines casseront quelque chose. Sonnet 5.5 est arrivé avec cinq changements cassants. Le prix de Gemini 3.8 Flash double en janvier. Haiku 4.5 a une date de retrait dans deux semaines. Quel que soit votre choix aujourd'hui, quelqu'un dans votre équipe est responsable de le retester le trimestre prochain.
C'est la partie que les acheteurs sous-estiment. Lors d'un appel commercial eesel que j'ai relu, un acheteur soucieux du budget dans une petite entreprise de matériel a dit avoir été échaudé quand le prix d'un ancien fournisseur avait « more than doubled », et il voulait un prix garanti par contrat avant de signer quoi que ce soit. La couche modèle comporte le même risque, avec une horloge plus rapide.
Pour une file de support en particulier, c'est là que j'arrêterais de choisir des modèles. eesel fait tourner des coéquipiers IA sur des files de helpdesk en direct, et chaque déploiement est simulé sur les tickets historiques de l'équipe avant de répondre à un vrai client. Quand le modèle en dessous change, cette simulation permet de trouver la régression de style d'appel d'outil forcé avant qu'un client ne la trouve. Le tour d'horizon du meilleur modèle pour les tickets de support compare les modèles sur cette tâche, et le guide du coût d'un agent de support IA couvre le côté budget.
Essayez eesel si le modèle va dans votre helpdesk
Un modèle brut, c'est de l'infrastructure. Vous le choisissez, vous câblez ses appels d'outils, puis vous écrivez les évals et les relancez quand un changement cassant arrive. eesel est l'employé par-dessus : un coéquipier IA de helpdesk qui rejoint votre Zendesk ou un autre helpdesk, apprend de vos anciens tickets et de votre centre d'aide, et est testé sur vos tickets historiques avant de répondre à qui que ce soit. Vous ne réglez jamais tool_choice, et le changement cassant d'un modèle est absorbé par eesel plutôt que par votre file de support.
Si vous venez d'un terminal, la CLI eesel pilote le même coéquipier. Installez-la avec npm i -g @eesel/cli, connectez un helpdesk avec eesel integrations connect, modifiez ses règles permanentes avec eesel instructions et lisez chaque exécution en JSON avec eesel activity. Les écritures acceptent --dry-run, et chaque workspace est aussi un serveur MCP, donc Claude Code, Codex ou Cursor peuvent l'utiliser à votre place. C'est le contrôle programmable que vous voudriez d'une API de modèle, appliqué à un coéquipier qui fait déjà le travail.

Les tarifs d'eesel sont un forfait mensuel fixe de crédits, avec une offre gratuite pour tester sur vos propres tickets. Essayez eesel et voyez votre file traitée sans avoir d'abord choisi un modèle.
Questions fréquentes
Quelle est la meilleure alternative à Claude Sonnet 5.5 ?
Existe-t-il une alternative à Claude Sonnet 5.5 qui prenne en charge l'usage forcé d'outils ?
tool_choice réglé sur any ou sur un outil nommé, et il n'est pas retiré avant le 30 juin 2027. GPT-6 Sol, Gemini 3.8 Flash et Grok 4.7 forcent aussi les appels d'outils. Attention : Claude Opus 5.5 le rejette aussi, monter dans la gamme Claude ne règle donc rien. Le guide de l'API de helpdesk IA montre où les appels d'outils forcés comptent en support.Claude Opus 5.5 est-il moins cher que Claude Sonnet 5.5 ?
Quelle est l'alternative la plus économique à Claude Sonnet 5.5 ?
Existe-t-il des alternatives open source à Claude Sonnet 5.5 ?
Puis-je passer de Claude Sonnet 5.5 à un autre modèle en pleine conversation ?
Quelle alternative à Claude Sonnet 5.5 convient le mieux à un bot de support client ?


Article by
Kurnia Kharisma
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.