

MAI-Transcribe-2 est le nouveau modèle de reconnaissance vocale de Microsoft AI, annoncé le 3 septembre 2026 et présenté comme « le modèle de reconnaissance vocale le plus rapide, le plus précis et le moins cher au monde ». D'après les chiffres de Microsoft elle-même, l'affirmation tient en grande partie : un taux d'erreur moyen par mot de 5,2 % sur 60 langues, environ 10 fois plus rapide que GPT-Transcribe sur de longs audios (selon les benchmarks propres de Microsoft) et 0,10 $ par heure d'audio comme prix de lancement.
Il faut connaître les réserves avant de construire dessus. Ces 0,10 $ sont une offre limitée dans le temps jusqu'à fin 2026, et le tarif standard n'est pas publié. C'est un modèle par lots en préversion publique (sans SLA), les fichiers sont limités à 300 Mo et le temps réel exige une configuration Voice Live distincte. Le tableau de benchmarks est aussi celui de Microsoft, dans un classement où le modèle arrive deuxième au général.
Si vous avez simplement besoin de transformer de l'audio en texte propre et multilingue via une API, c'est l'une des options les plus solides et les moins chères du moment. Mais si votre objectif est un workflow de support, rappelez-vous que la transcription est le début, pas la fin : quelqu'un doit encore la lire, trouver la réponse et résoudre le ticket. C'est le travail d'un coéquipier IA comme eesel, et c'est là que se situe désormais la vraie valeur.
Je développe des intégrations et des API chez eesel, donc je lis un lancement comme celui-ci en développeur : que fait vraiment l'API une fois passé le titre ? J'ai passé du temps sur la page du modèle MAI-Transcribe-2, la documentation Azure Speech, le playground et les premiers retours de développeurs. Voici ce que j'ai trouvé.
Ce qu'est vraiment MAI-Transcribe-2
MAI-Transcribe-2 est un modèle de reconnaissance vocale conçu en interne par Microsoft AI, le groupe derrière les modèles MAI-Voice et MAI-1. L'argument est d'une étroitesse réjouissante : il fait une seule chose, transformer l'audio en texte, et il le fait dans plusieurs langues avec un seul modèle plutôt que de vous faire choisir un moteur par langue.
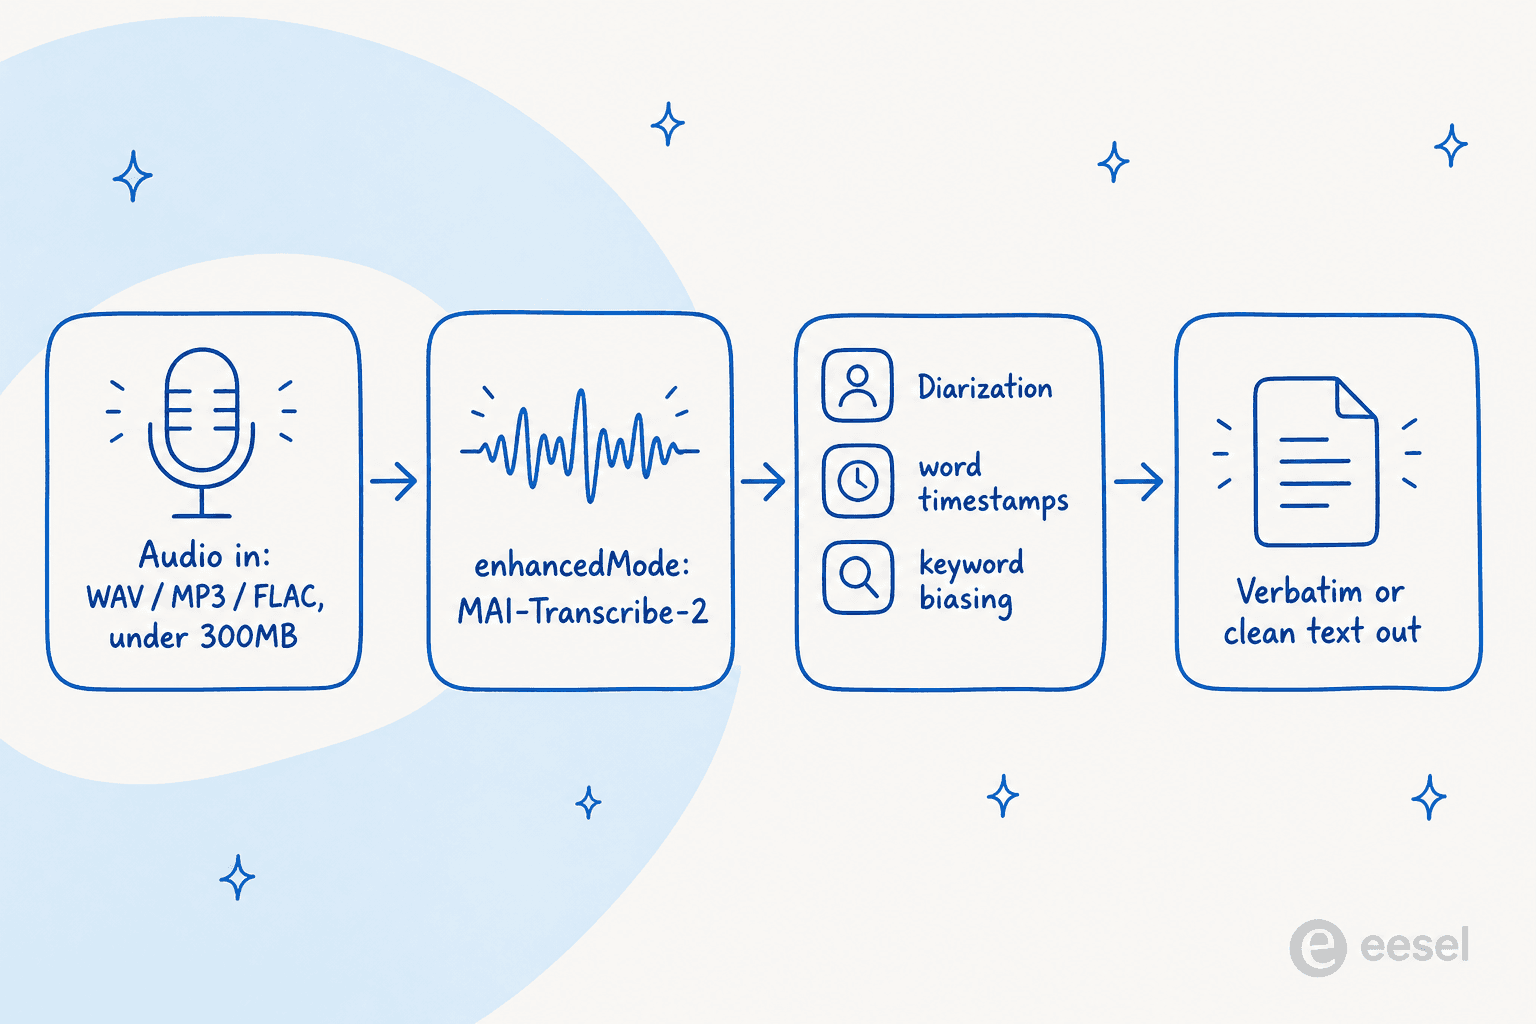
Ce que l'on obtient dépasse une simple chaîne de caractères. Le modèle gère la diarisation des locuteurs (qui parle et quand), l'horodatage au niveau du mot, le biais par mots-clés pour favoriser vos noms de produits et votre jargon, et le choix entre un style « verbatim » qui conserve chaque hésitation et faux départ pour les besoins de conformité et un style « clean » qui met en forme des sous-titres lisibles. Il succède à MAI-Transcribe-1.5 et MAI-Transcribe-1, que la documentation Azure Speech déclare obsolètes depuis le 20 août 2026.
Soyons honnêtes : c'est un modèle de Microsoft AI, donc pleinement intégré à l'écosystème Azure Speech plutôt qu'une application grand public autonome. On y accède par une API, un playground pour développeurs ou des routeurs tiers, pas par un produit final soigné. Si vous espériez une application de réunion façon Otter, ceci est la couche en dessous, pas l'application elle-même.
Le titre : le plus rapide, le plus précis et le moins cher
Microsoft n'a pas nuancé. L'article de lancement qualifie MAI-Transcribe-2 de « modèle de reconnaissance vocale le plus rapide, le plus précis et le moins cher au monde », le genre de triple affirmation qui s'effondre d'ordinaire au deuxième point. Celle-ci tient en grande partie, avec quelques astérisques.
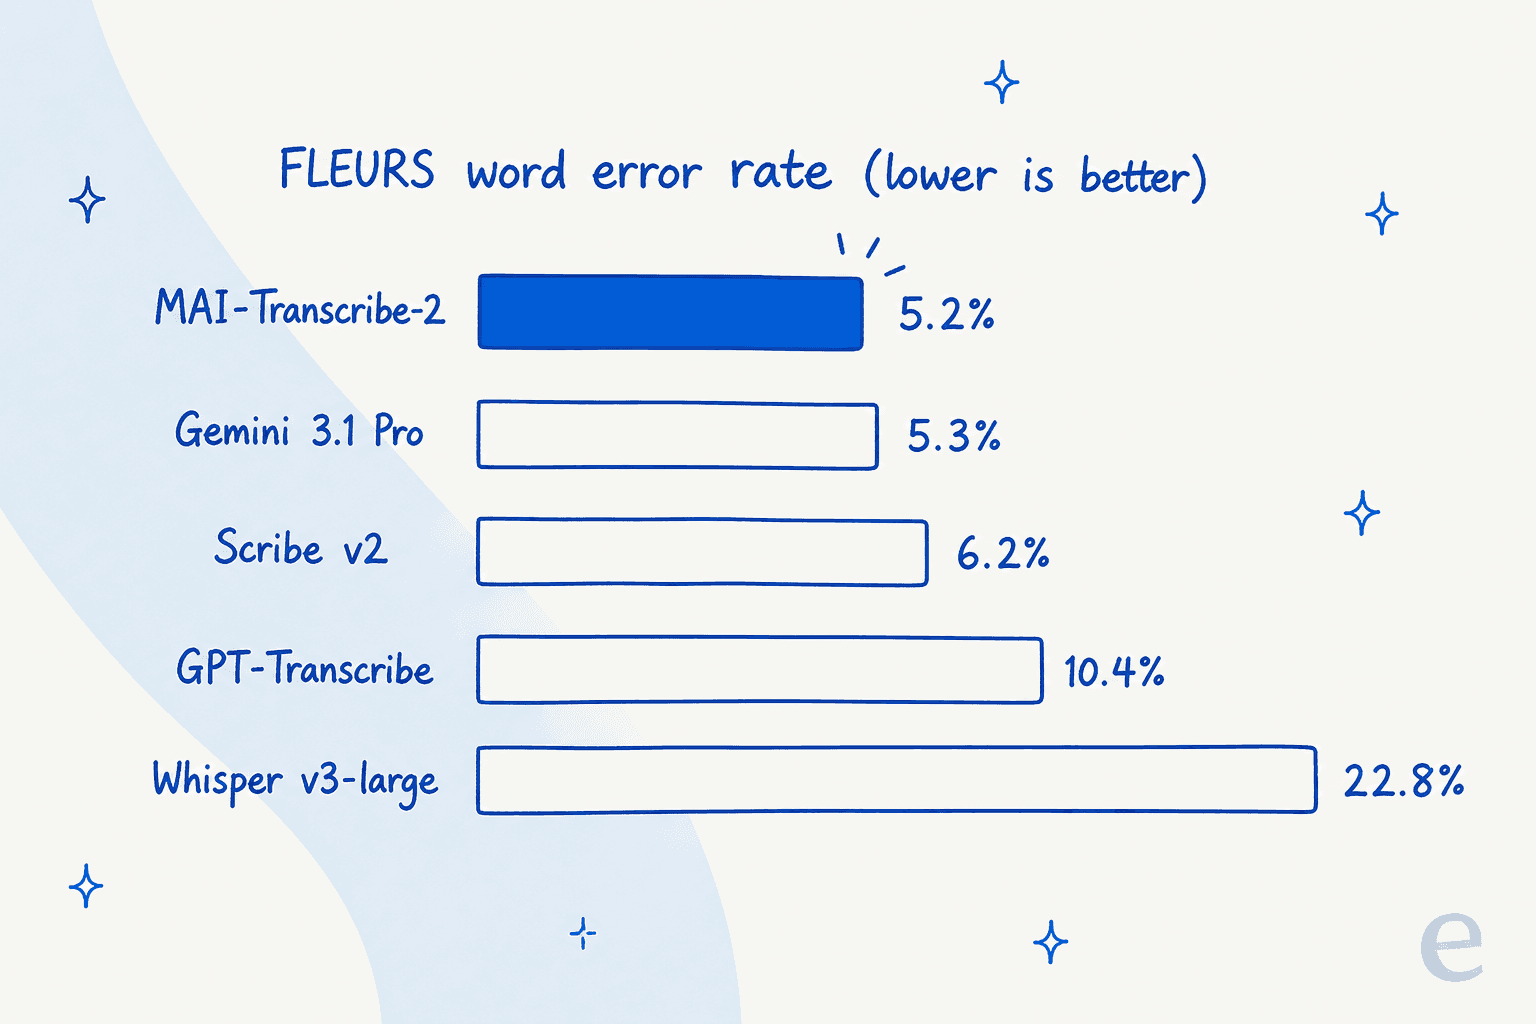
En précision, le modèle affiche un taux d'erreur moyen par mot de 5,2 % sur le benchmark FLEURS dans 60 langues, ce qui, selon Microsoft, le place n° 1 sur FLEURS et deuxième au classement du taux d'erreur par mot d'Artificial Analysis. Sur les 25 principales langues de FLEURS, il descend à 3,4 %. Voici comment la page du modèle le compare aux autres (plus bas est meilleur) :
| Modèle | WER FLEURS sur 60 langues (forced) |
|---|---|
| MAI-Transcribe-2 | 5,2 % |
| Gemini 3.1 Pro | 5,3 % |
| Scribe v2 (ElevenLabs) | 6,2 % |
| Gemini 3.5 Transcribe | 5,9 % |
| GPT-Transcribe (OpenAI) | 10,4 % |
| Whisper v3-large (OpenAI) | 22,8 % |
L'écart avec l'ancien Whisper v3-large, ouvert, est énorme, et l'avance sur Gemini 3.5 Transcribe et GPT-Transcribe est réelle. L'avance sur Gemini 3.1 Pro, en revanche, n'est que d'un dixième de point : « le plus précis » est vrai, mais de justesse en haut du tableau.
En vitesse, les chiffres sont vraiment frappants. Microsoft chronomètre une heure d'audio en environ 10 secondes d'inférence du modèle, et ses benchmarks de lancement le montrent 10 fois plus rapide que GPT-Transcribe, 7 fois plus rapide qu'ElevenLabs Scribe v2 et 5 fois plus rapide que Gemini 3.5 Transcribe, tout en se plaçant sur la frontière de Pareto précision-latence. Un commentateur de HN qui l'a essayé a résumé l'argument simplement :
"According to Artificial Analysis it is on the pareto frontier."

Une chose à garder en tête en lisant tout cela : ce sont les chiffres de benchmark de Microsoft et les points de comparaison choisis par Microsoft. Cela ne les rend pas faux, et les premiers tests indépendants vont dans le même sens. Cela signifie simplement que « le meilleur au monde » est le discours de l'éditeur, et que la deuxième place au classement général d'Artificial Analysis est une lecture plus mesurée.
Comment l'utiliser concrètement
C'est là que mon côté bâtisseur s'est réveillé, et là que le modèle devient plus intéressant que le classement. MAI-Transcribe-2 fonctionne via la Fast Transcription API d'Azure Speech, et on l'active avec un indicateur enhancedMode plutôt qu'avec un nouveau point de terminaison. Un appel minimal ressemble à ceci :
curl --location 'https://YourResourceName.cognitiveservices.azure.com/speechtotext/transcriptions:transcribe?api-version=2025-10-15' \
--header 'Content-Type: multipart/form-data' \
--header 'Ocp-Apim-Subscription-Key: <YourSpeechResourceKey>' \
--form 'audio=@"YourAudioFile.wav"' \
--form 'definition={
  "enhancedMode": {
    "enabled": true,
    "model": "MAI-Transcribe-2"
  }
}'
Ensuite, les paramètres sont clairs : diarization.enabled pour les étiquettes de locuteurs, phraseList.phrases pour le biais par mots-clés, modelOptions.transcribeStyle pour choisir verbatim ou clean, et locales si vous voulez court-circuiter la détection automatique. Les fichiers sont envoyés en WAV, MP3 ou FLAC et plafonnent à 300 Mo. C'est un envoi par lots direct, ce qui est une bonne ou une mauvaise chose selon ce que vous construisez.
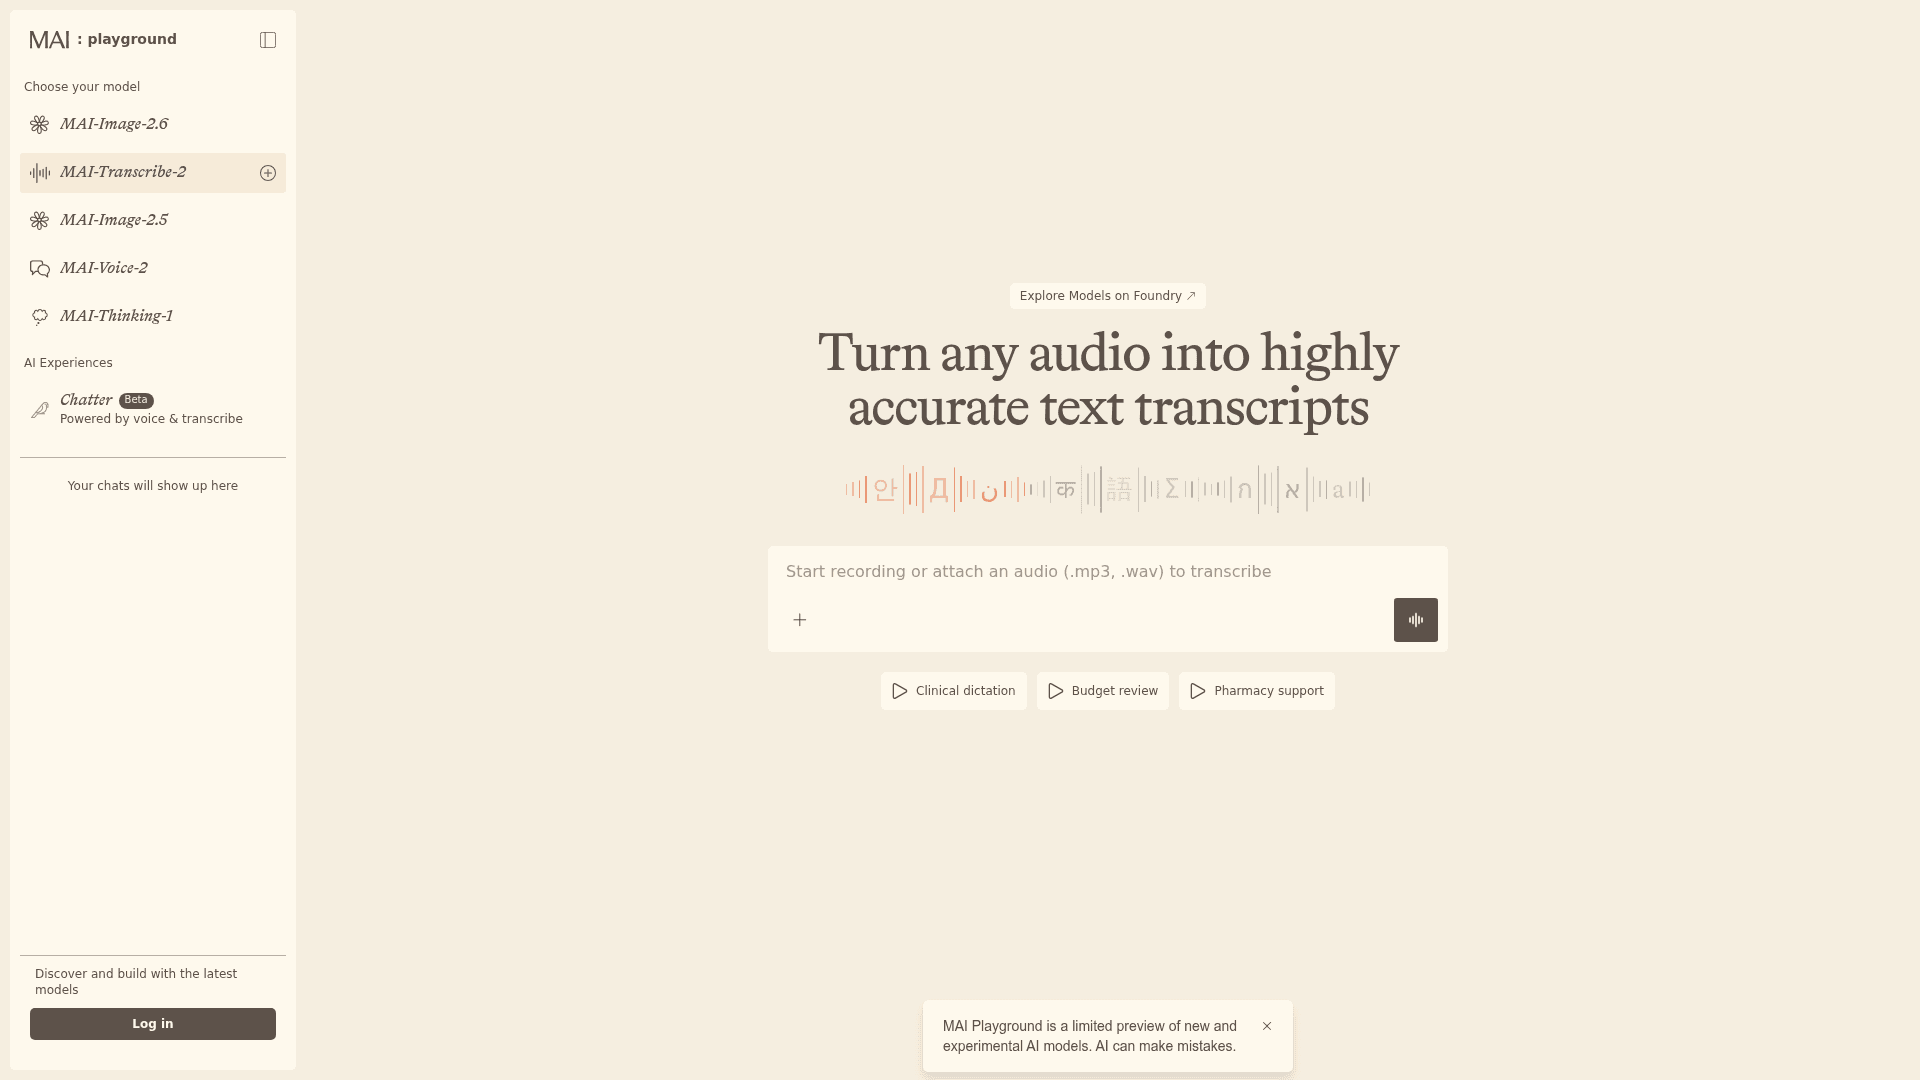
Si vous préférez cliquer plutôt que taper du curl, il y a deux portes plus simples. Le MAI Playground permet de déposer un MP3 ou d'enregistrer directement depuis le navigateur, avec des exemples de dictée clinique et d'appels de support, et le modèle est aussi listé sur OpenRouter et dans le catalogue Azure AI Foundry.
Là où il est vraiment bon, et là où sont les limites
Rendons d'abord à MAI-Transcribe-2 ce qui lui revient. La réaction indépendante la plus forte que j'ai trouvée n'était pas une simple republication de la fiche technique. Vojtech Rinik, le développeur indépendant derrière l'application Whisper Memos, y a fait passer un extrait réel difficile :
"I tried running a church homily with lots of echo in Slovak language through this... It did much better than ElevenLabs at 45% of the price."
L'audio bruyant, avec écho et dans une langue autre que l'anglais est exactement le cas qui met en difficulté les modèles plus faibles : qu'un développeur le préfère à un outil qu'il déploie déjà en dit plus que le tableau de benchmarks.
Passons aux limites, car elles comptent si vous mettez cela en production. Le prix de 0,10 $ par heure est une promotion de lancement valable « jusqu'à la fin de l'année », et Microsoft n'a pas publié ce qui suit. À titre de repère, la page du modèle affiche toujours MAI-Transcribe-1.5 à 0,36 $ par heure : un tarif standard de la v2 dans cette fourchette ne serait pas une surprise. Un commentateur de Hacker News a posé les deux questions que Microsoft a laissées ouvertes au lancement :
"is this usable for streaming or only batch? do they give the price after the launch-discount (till end of year) goes away?"
Le volet streaming a une réponse, et elle est pointilleuse : la Fast Transcription API ne fonctionne que par lots, et pour l'audio en direct il faut brancher le modèle comme modèle de transcription d'entrée dans la Voice Live API, distincte. C'est faisable, mais ce n'est pas le même appel : prévoyez-le. Il est aussi toujours en préversion publique, livré sans SLA, ce que Microsoft signale explicitement comme inadapté à la production.
La forme de l'intégration est l'autre point à vérifier. Comme c'est un modèle de transcription pur, il ne s'insère pas dans l'outillage de chat completions comme un LLM généraliste. Des développeurs sur Reddit s'y sont heurtés tôt :
"OpenRouter requires a dedicated endpoint (
/api/v1/audio/transcriptions) for pure transcription models like MAI-Transcribe-2."

Rien de rédhibitoire. C'est la texture normale d'un modèle en préversion vieux d'une semaine, et mieux vaut le dire pour ne pas être pris au dépourvu.
Ce que le graphique de benchmarks ne montre pas
Voici le recadrage auquel je revenais sans cesse. La transcription était autrefois la partie difficile et coûteuse. MAI-Transcribe-2, avec Gemini 3.5 Transcribe et ElevenLabs Scribe, en a discrètement fait une couche rapide, bon marché et presque résolue, une commodité. C'est une excellente nouvelle, mais cela signifie aussi que la valeur s'est déplacée. Une transcription précise n'est pas ce que quelqu'un voulait vraiment ; c'est la matière première de ce qu'il voulait.
Nulle part cela n'est plus clair que dans le support client. Un modèle de transcription peut transformer un appel de support ou un message vocal en texte impeccable, avec locuteurs identifiés et horodatage, en une dizaine de secondes. Et ensuite ? Le texte doit encore être lu, la réponse doit encore être trouvée dans vos documents et vos anciens tickets, la réponse doit être rédigée et le ticket résolu. Le modèle donne les oreilles. Il ne donne pas le coéquipier.
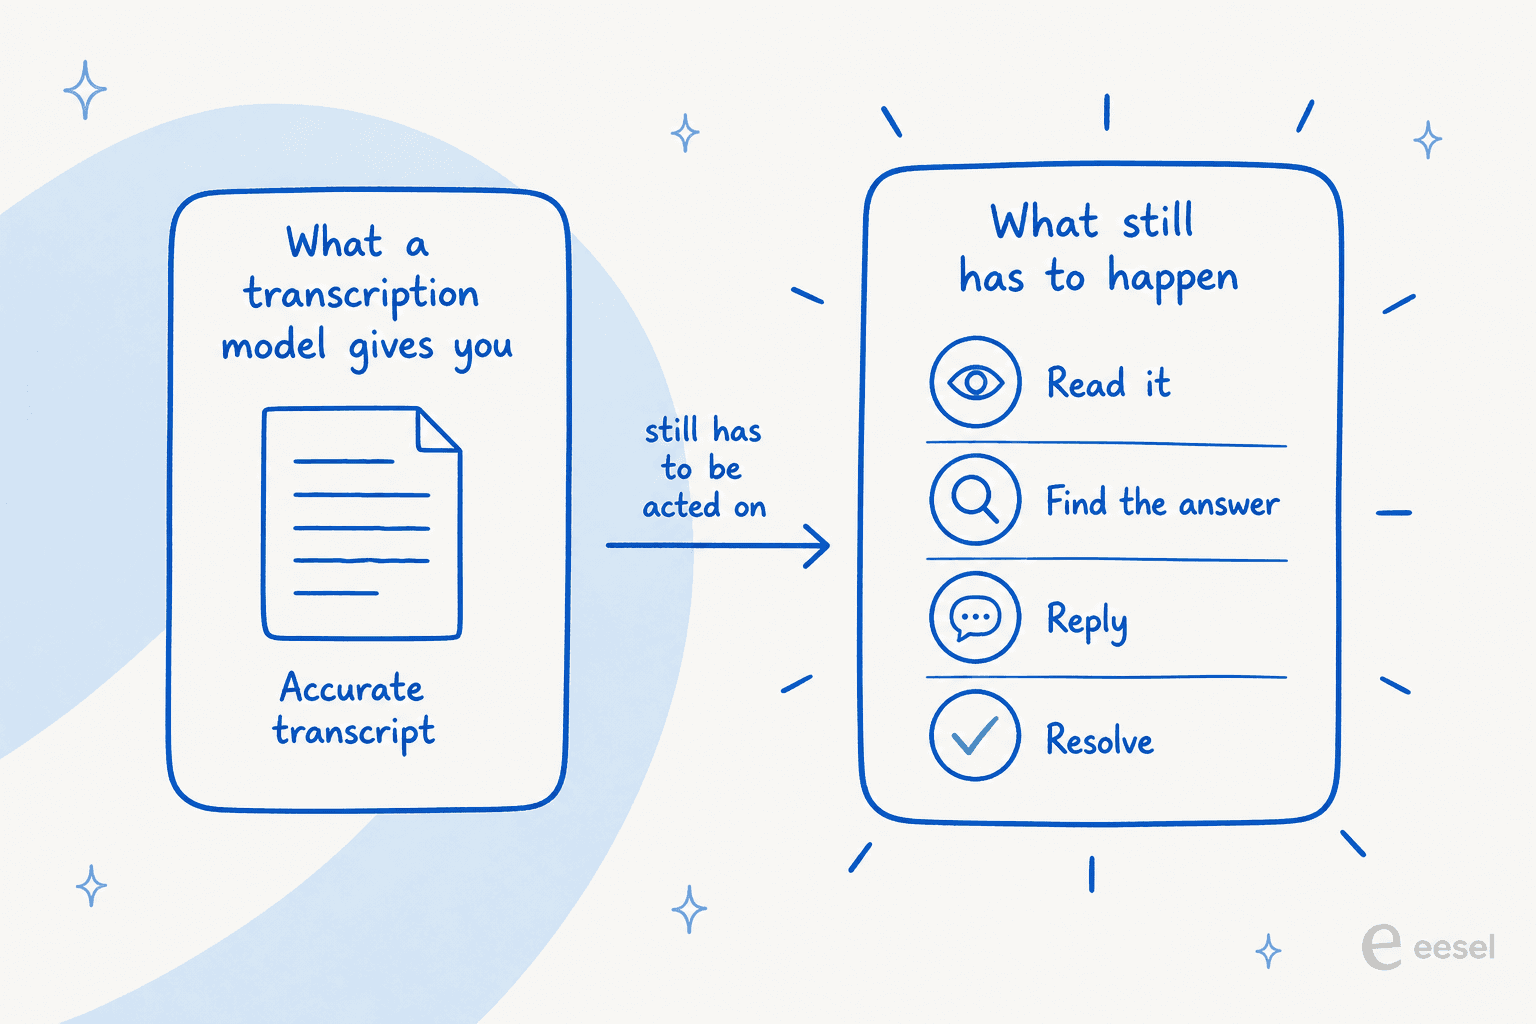
C'est la frontière honnête d'un modèle comme MAI-Transcribe-2, et ce n'est pas une critique. Il fait son travail extrêmement bien. C'est simplement un autre travail que de résoudre la conversation, et pour une équipe de support, c'est le second qui fait réellement bouger les chiffres.
Où eesel intervient
MAI-Transcribe-2 est une infrastructure. eesel est l'employé qui travaille par-dessus. Nous construisons des coéquipiers IA que vous embauchez pour une mission précise, et le coéquipier IA de helpdesk est celui qui prend le relais là où s'arrête un modèle de transcription : il lit le texte, va chercher la réponse dans votre centre d'aide et vos anciens tickets, puis rédige ou envoie la réponse directement dans Zendesk, Freshdesk ou Slack. Associez les deux et un ticket vocal transcrit devient un ticket résolu, pas seulement un paragraphe bien rangé.

Et comme MAI-Transcribe-2 est un modèle pensé d'abord pour les API, les développeurs qui s'y intéressent veulent souvent le même contrôle sur leur automatisation du support. eesel propose pour cela une CLI publique : elle pilote le même coéquipier et le même espace de travail depuis un terminal, de sorte qu'une personne peut l'exécuter à la main, qu'un script peut l'automatiser et que des agents de code comme Claude Code ou Cursor peuvent l'utiliser sans interface, sans tableau de bord. Vous pouvez brancher la transcription au début de ce pipeline et eesel à l'extrémité qui résout. C'est gratuit à essayer, cela se connecte à votre helpdesk en quelques minutes et simule sur vos vrais tickets passés avant de répondre à un client, pour que vous voyiez comment il aurait traité votre file avant de le lâcher.
Comment MAI-Transcribe-2 s'intègre-t-il dans un workflow de support client ?