

MiniCPM5-2B est le nouveau modèle ouvert de 2B d'OpenBMB, et il est vraiment frappant pour sa taille. C'est un modèle dense, texte seul, de 2,52B de paramètres, avec une fenêtre de contexte de 128K et des poids Apache-2.0, conçu pour tourner sur l'appareil : téléphones, ordinateurs portables et mini-PC, pas un centre de données. Sur la suite d'évaluation d'OpenBMB, il obtient en moyenne 53,9 sur 34 benchmarks, ce qu'ils présentent comme l'état de l'art open source de la classe 2B et, dans leur propre jeu de comparaison, devant le Qwen3.5-4B, plus gros (51,1).
Le bémol à connaître d'emblée : il est texte seul (pas de vision), les scores qui font l'effet sont annoncés par l'éditeur, et un chiffre phare est incohérent selon les sources. Des observateurs indépendants placent son Artificial Analysis Intelligence Index à 15, le plus élevé de tous les modèles à poids ouverts de 4B ou moins ; le billet de lancement d'OpenBMB revendique 23. Les deux sont cités plus bas.
Si vous construisez des choses, MiniCPM5-2B est un excellent moteur local de raisonnement et d'utilisation d'outils. Si vous cherchez à répondre à des tickets clients, rappelez-vous que le modèle n'est que le moteur. Un agent de support opérationnel a besoin, par-dessus, de la connaissance de votre entreprise, d'intégrations, de garde-fous et de tests, soit la couche que fournit une plateforme comme eesel.
Ce qu'est vraiment MiniCPM5-2B
MiniCPM5-2B est le deuxième modèle de la gamme MiniCPM5 d'OpenBMB (le groupe de modèles ouverts aussi connu sous le nom de ModelBest), sorti vers les 6 et 7 septembre 2026, après MiniCPM5-1B en mai. L'argument est étroit et clair : un petit modèle dense assez bon en raisonnement, en code et en utilisation d'outils pour être utile, et assez petit pour tourner là où se trouvent déjà les données.
Ce « là où se trouvent les données » est le point intéressant. La plupart des modèles dont vous entendez parler cette année sont des API cloud que l'on loue au token. MiniCPM5-2B prend le chemin inverse : vous téléchargez les poids et vous les exécutez sur un ordinateur portable, un téléphone ou une carte Rockchip sur une chaîne de production. La fiche du modèle sur HuggingFace le décrit comme un modèle dense de 2B « built for on-device, local deployment, and resource-constrained scenarios », destiné à « local assistants, coding agents, tool-use workflows, and reasoning scenarios where a compact model is preferred. »
Voici la page du modèle lui-même, par où vous commenceriez réellement si vous vouliez le récupérer.
Une limite honnête pour caler les attentes : c'est un modèle texte seul. Ce checkpoint n'a ni vision ni audio, et les testeurs de la communauté notent qu'il ne gère que l'anglais et le chinois. Si vous avez besoin de multimodal, OpenBMB le réserve à la gamme distincte MiniCPM-V, et la réaction « pas de vision ici » a été l'une des plus bruyantes au lancement (plus bas à ce sujet).
Les spécifications qui comptent
Pour un modèle de 2B, les surprises se trouvent dans la fiche technique. Il repose sur une architecture LlamaForCausalLM classique, offre 128K de contexte complet et est publié sous une licence réellement permissive.
| Champ | Valeur |
|---|---|
| Paramètres totaux | 2 516 756 480 (~2,52B) |
| Paramètres hors embeddings | 1 981 982 720 |
| Architecture | LlamaForCausalLM standard (pas de kernels personnalisés) |
| Couches | 42 |
| Attention | GQA, 16 têtes de requête, 2 têtes KV |
| Longueur de contexte | 131 072 tokens (128K) |
| Modalité | Texte seul (anglais / chinois) |
| Licence | Apache-2.0 (poids et dépôt) |
| Type de tenseur | BF16 (plus versions GGUF, MLX-4bit, GPTQ-4bit) |
Chaque chiffre vient du bloc « Model Information » de la fiche du modèle. Deux d'entre eux pèsent plus que les autres.
Le premier est l'architecture standard. OpenBMB a tenu à construire MiniCPM5-2B sur un simple LlamaForCausalLM pour que, selon leurs mots, « mainstream inference engines can load it directly: no custom kernels, no model-code fork. » Cela ressemble à une note de bas de page, mais c'est pourquoi la prise en charge des runtimes dès le jour 0 (plus bas) est aussi large. Un modèle qui exige un kernel sur mesure sort sur deux runtimes le jour du lancement ; un modèle à architecture standard apparaît partout en même temps.
Le second est la licence Apache-2.0 sur le dépôt et sur les poids. L'usage commercial est autorisé et aucune licence communautaire distincte ne le restreint, ce que toutes les publications « ouvertes » ne peuvent pas dire. Si vous bâtissez un produit dessus, cela compte plus qu'un ou deux points de benchmark.
Il dispose aussi d'un vrai mode de raisonnement approfondi : l'exemple transformers passe enable_thinking=True, et OpenBMB présente le budget de tokens d'une tâche à environ 21K tokens (14K de réflexion plus 7K de réponse), avec un échantillonnage recommandé de temperature=1.0, top_p=0.95.
Ses scores
Voici le titre qui a fait remarquer MiniCPM5-2B : sur l'évaluation d'OpenBMB, il obtient en moyenne 53,9 sur 34 benchmarks, qu'ils présentent comme l'état de l'art open source de la classe 2B et, dans leur jeu de comparaison, devant le meilleur modèle de classe 4B, Qwen3.5-4B à 51,1. Un modèle de 2B qui devance un 4B, voilà le genre d'affirmation qui mérite un second regard.
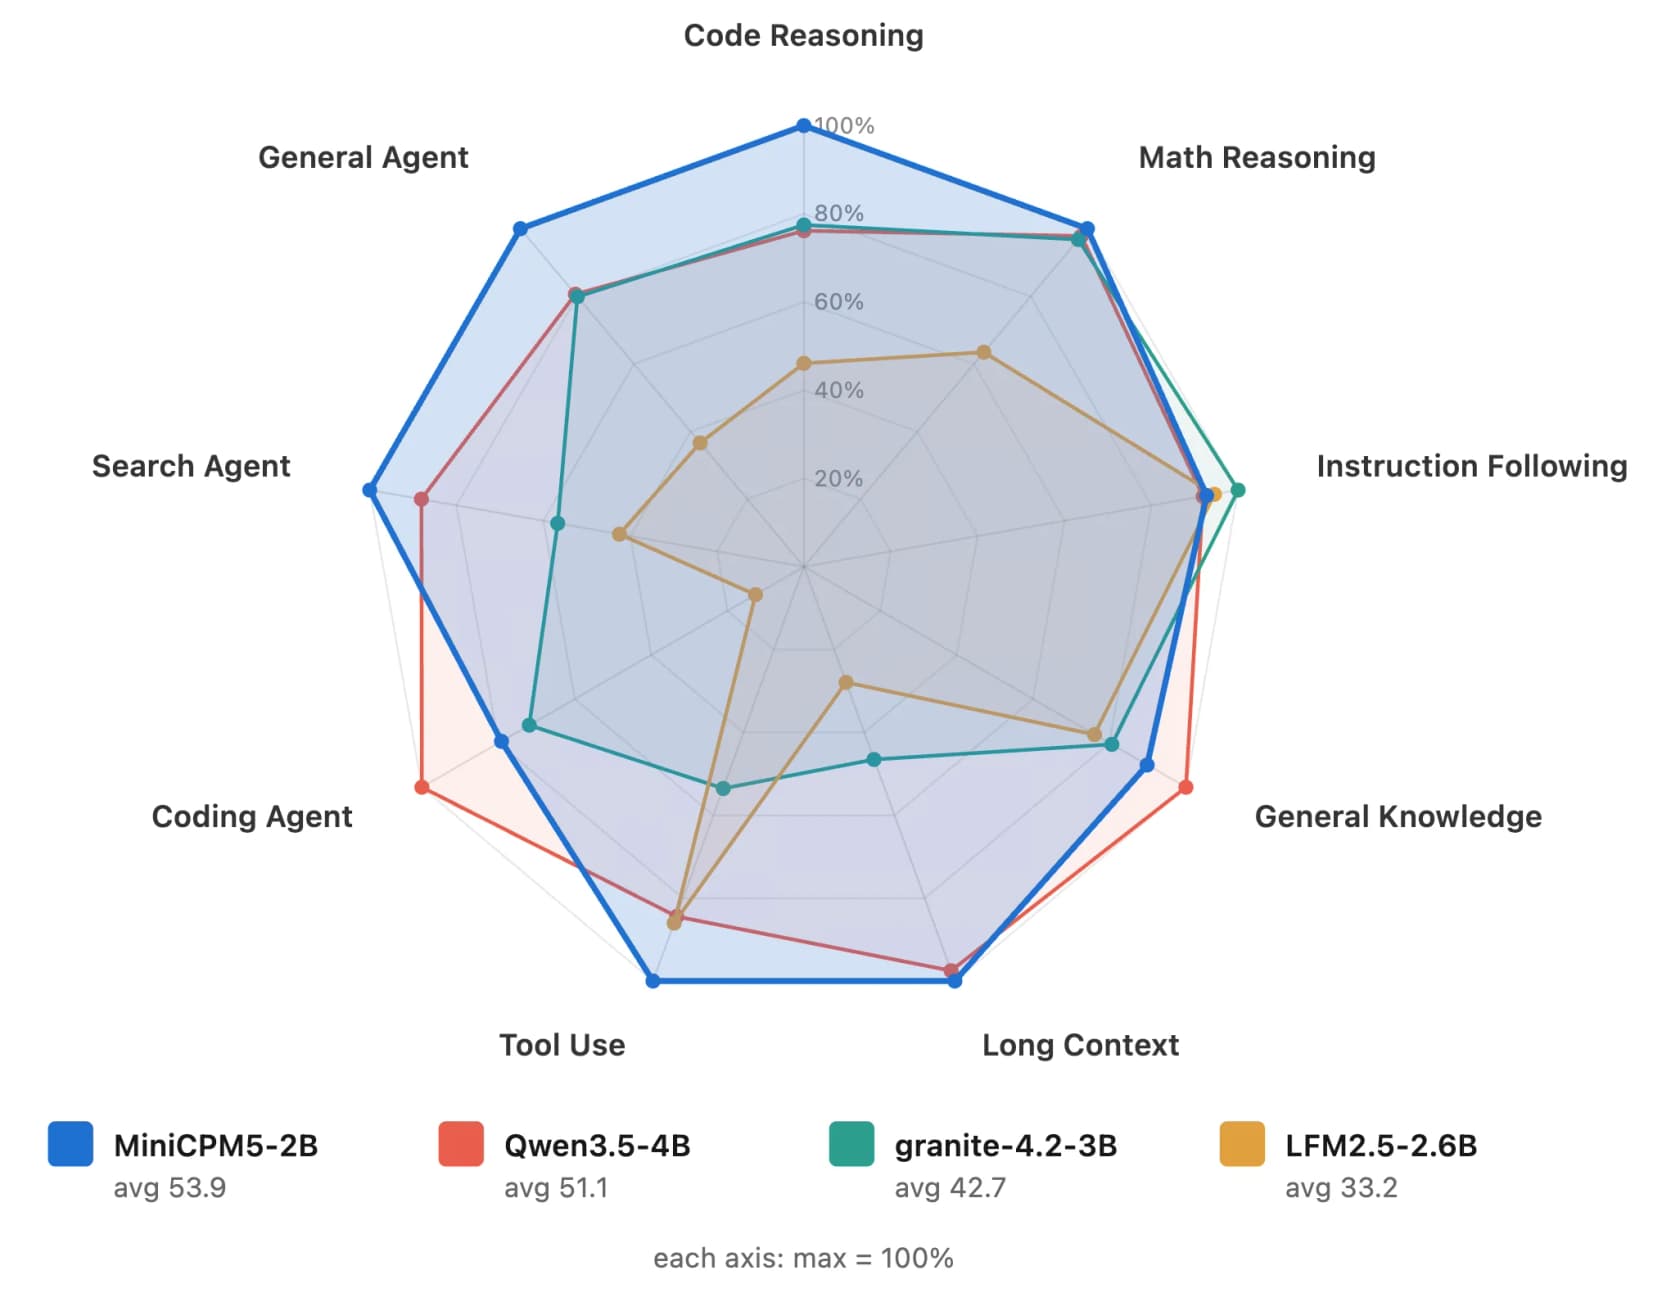
Le radar montre où l'histoire taille contre score tient et où elle ne tient pas. MiniCPM5-2B mène sur les tâches d'agents et de recherche et reste compétitif en maths et en contexte long, tandis que le modèle 4B de Qwen l'emporte encore sur le travail brut d'agent de code. C'est un profil en dents de scie, pas une avance uniforme, et c'est la façon honnête de le lire.
La table complète mérite un examen attentif, car la « moyenne de 53,9 » cache des chiffres individuels vraiment élevés :
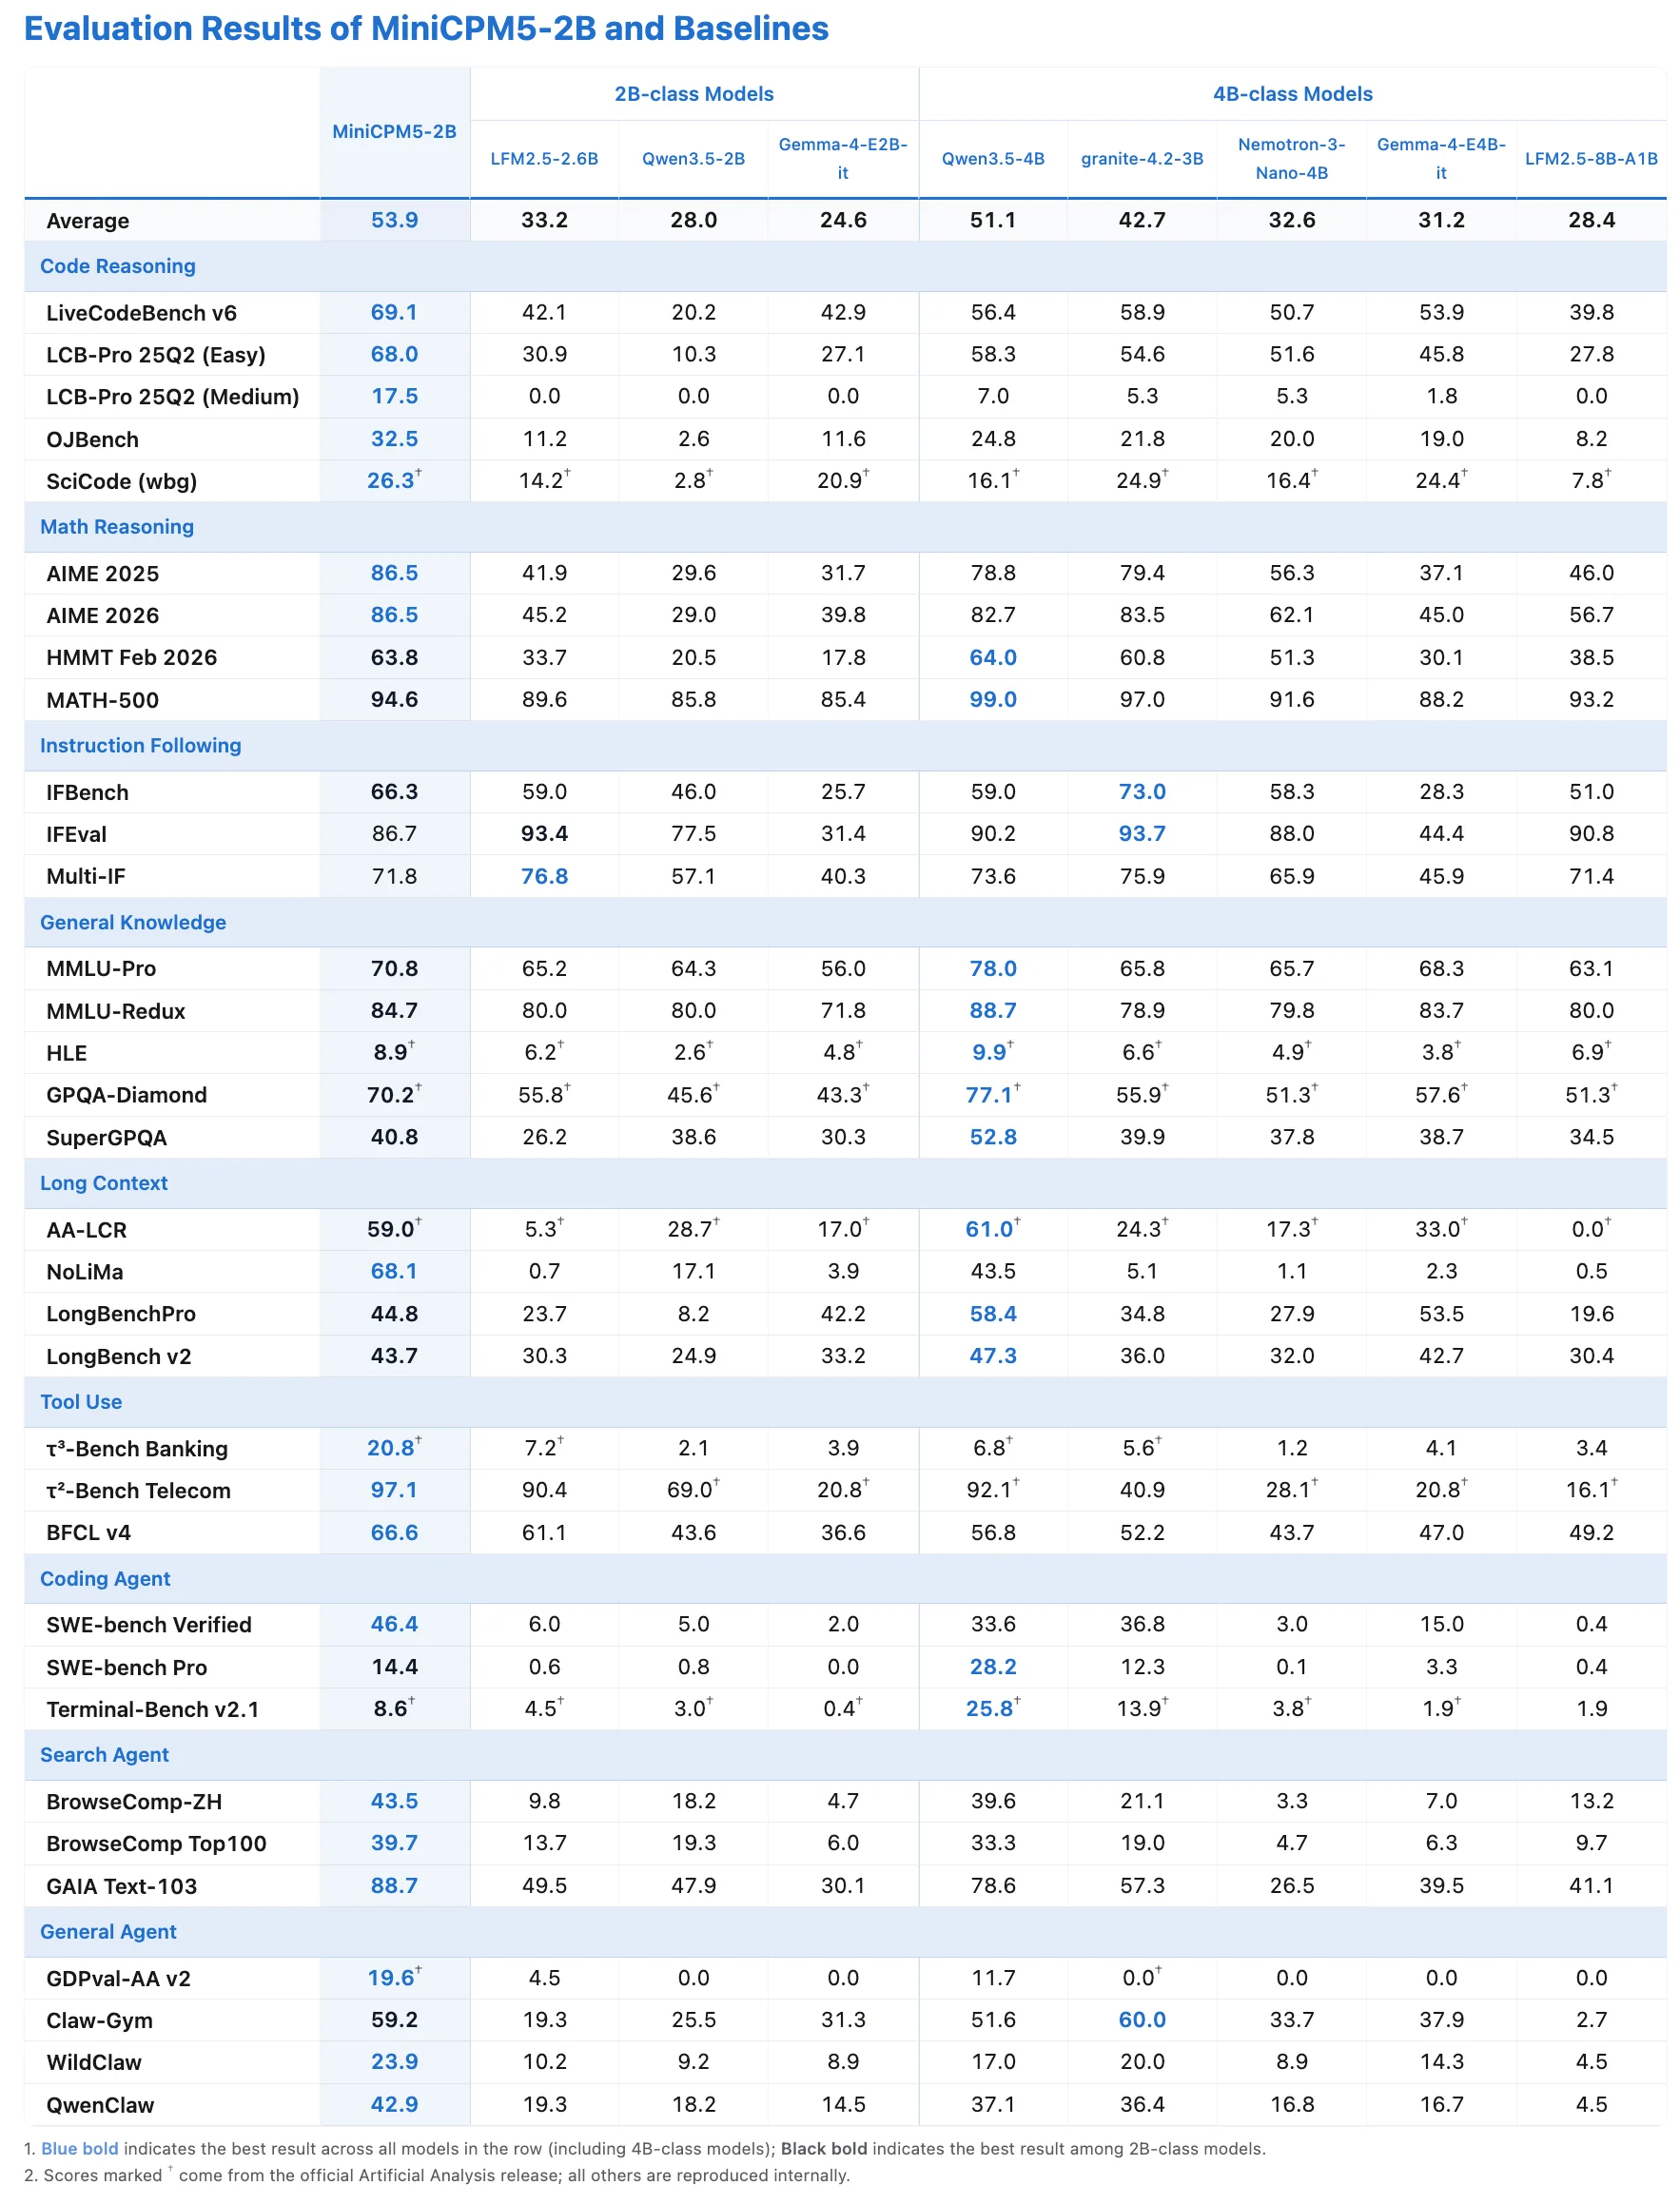
Les points forts, tous tirés de cette table : MATH-500 à 94,6, AIME 2026 à 86,5, LiveCodeBench v6 à 69,1, SWE-bench Verified à 46,4, τ²-Bench Telecom à 97,1 et GAIA Text-103 à 88,7. En connaissances générales, il atteint MMLU-Pro 70,8. Pour un modèle qu'on peut faire tourner sur un portable, ces chiffres de code et d'utilisation d'outils sont ceux qui font dresser l'oreille aux développeurs.
Deux réserves gardent cela honnête. D'abord, ce sont les chiffres annoncés par OpenBMB lui-même (certaines lignes ont été reproduites en interne, d'autres reprises de la publication officielle d'Artificial Analysis) : prenez-les comme un bon point de départ et testez sur vos propres tâches plutôt que comme un verdict indépendant. Ensuite, un chiffre phare se contredit selon les sources : le fil de lancement sur r/LocalLLaMA et dataconomy rapportent tous deux un Artificial Analysis Intelligence Index de 15, « the highest of any open weights model at 4B parameters or below », alors que le billet de lancement d'OpenBMB revendique un score de 23 plus un 20 à l'Agentic Index. Je ne peux pas concilier les deux, donc les deux figurent ici. Et notez ce qui manque : OpenBMB ne publie ni MMLU classique, ni GSM8K, ni HumanEval pour ce modèle ; si vous espériez le comparer à d'anciens classements, ces chiffres n'existent pas dans les sources officielles.
Comment OpenBMB l'a entraîné
L'autre raison pour laquelle MiniCPM5-2B est intéressant : OpenBMB a publié en open source l'essentiel de la recette, pas seulement les poids. Si vous voulez savoir comment un petit modèle devient aussi capable, la réponse est dans le pipeline.
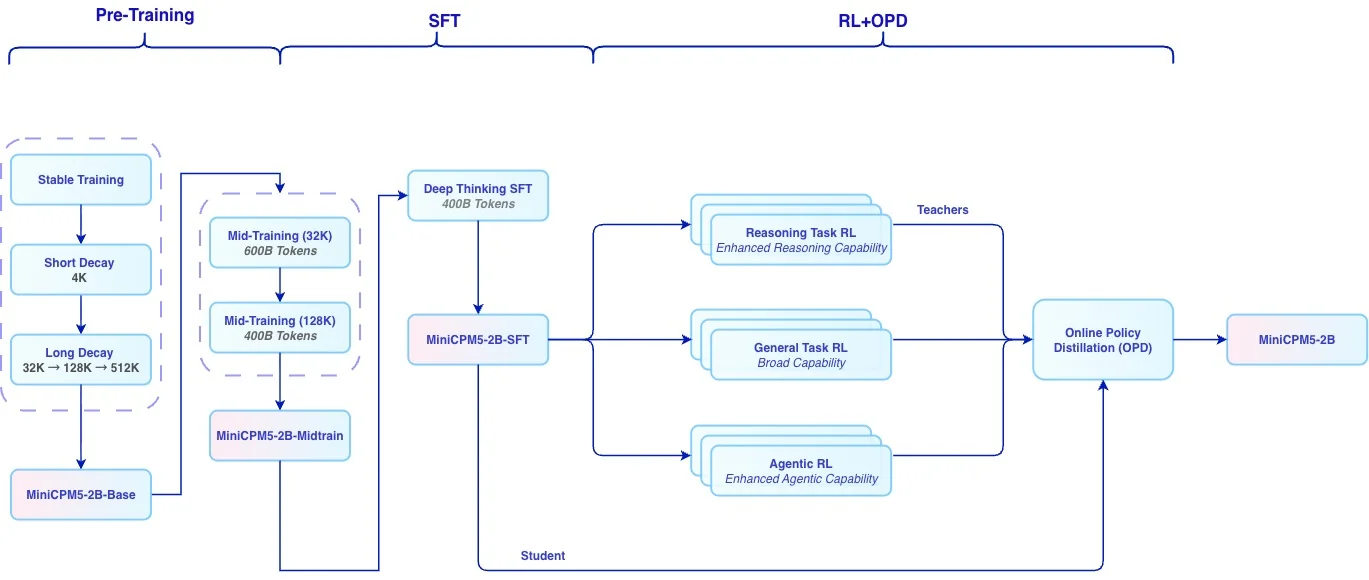
Elle se déroule en trois étapes, décrites sur la fiche du modèle. L'entraînement de base utilise Ultra-FineWeb d'OpenBMB et des jeux de données UltraData associés. L'entraînement intermédiaire adapte le modèle aux capacités visées. Ensuite, le post-entraînement fait le gros du travail : 400B de tokens de SFT de réflexion profonde, apprentissage par renforcement avec des enseignants spécialisés pour les tâches de maths, de code, d'agents et d'écriture (avec l'algorithme à critique JustRL II), et enfin On-Policy Distillation, qui fusionne 16 modèles experts dans l'unique checkpoint publié.
OpenBMB indique que la seule étape RL plus OPD a ajouté 10,96 points sur les benchmarks de raisonnement et généraux et 6,96 points sur les tâches d'agents. Que vous reproduisiez ou non ces gains, publier les jeux de données et le framework de RL est le genre de geste qui capte l'attention de la communauté des modèles ouverts, car il est reproductible plutôt qu'une boîte noire.
Le faire tourner en périphérie
Un modèle de 2B existe pour tourner là où un modèle de 200B ne le peut pas. Pour MiniCPM5-2B, la question est donc moins « quelle est son intelligence » que « que m'apporte réellement l'exécution en local ».
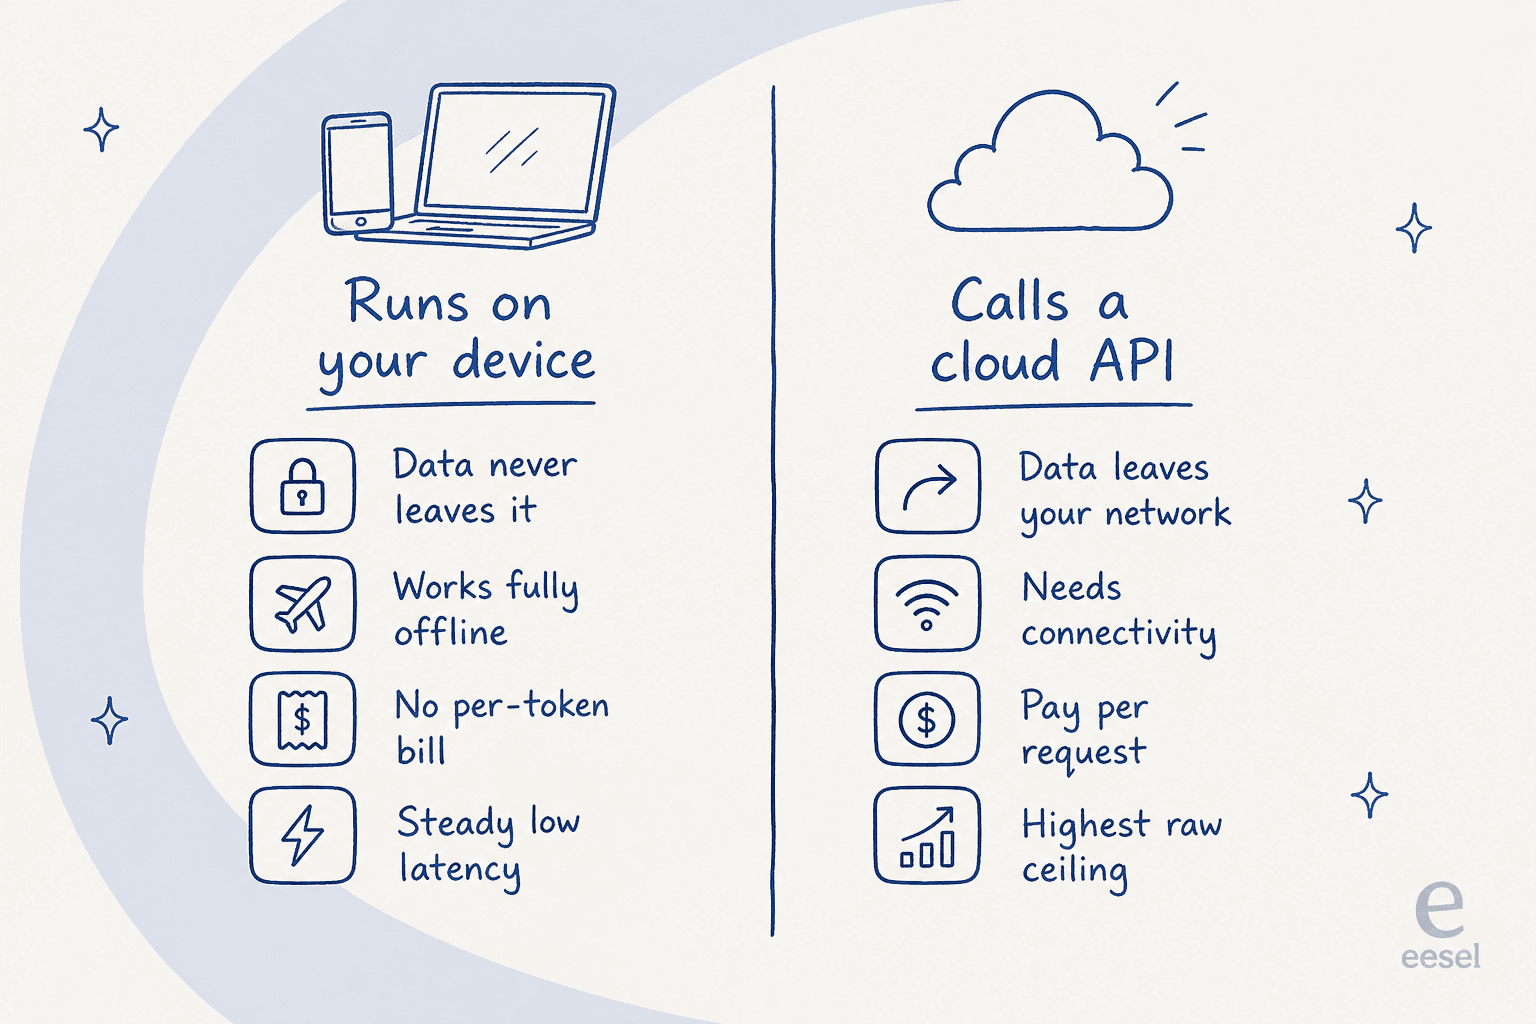
Le compromis est réel dans les deux sens. En l'exécutant sur l'appareil, vos données ne quittent jamais la machine, il fonctionne sans connexion et il n'y a pas de facture au token : pour un travail sensible à la confidentialité ou hors ligne, cette combinaison est difficile à battre. En renonçant au cloud, vous renoncez aussi au plafond de capacité d'un modèle de pointe. MiniCPM5-2B parie que, pour un nombre croissant de tâches, un petit modèle local « assez bon » et privé vaut mieux qu'un énorme modèle distant auquel il faut confier ses données.
Le côté pratique tient la route. Un listing communautaire place la version GGUF à environ 1,6 Go (un chiffre tiers, non officiel), et OpenBMB a repartagé une démo où il tourne sur un MacBook de 16 Go en effectuant une recherche web sur l'appareil. Il a aussi été adapté dès le jour 0 pour Intel Core Ultra avec OpenVINO, Arm v9 avec SME2 (où il annonce un prefill environ 1,7 fois plus rapide et un decode 1,2 fois plus rapide) et les cartes RK3588 et RK1828 de Rockchip.
Le choix d'une architecture standard évoqué plus haut paie ici. Le même checkpoint se charge dans un large éventail de runtimes dès le jour du lancement, au lieu d'arriver au compte-gouttes sur un ou deux.
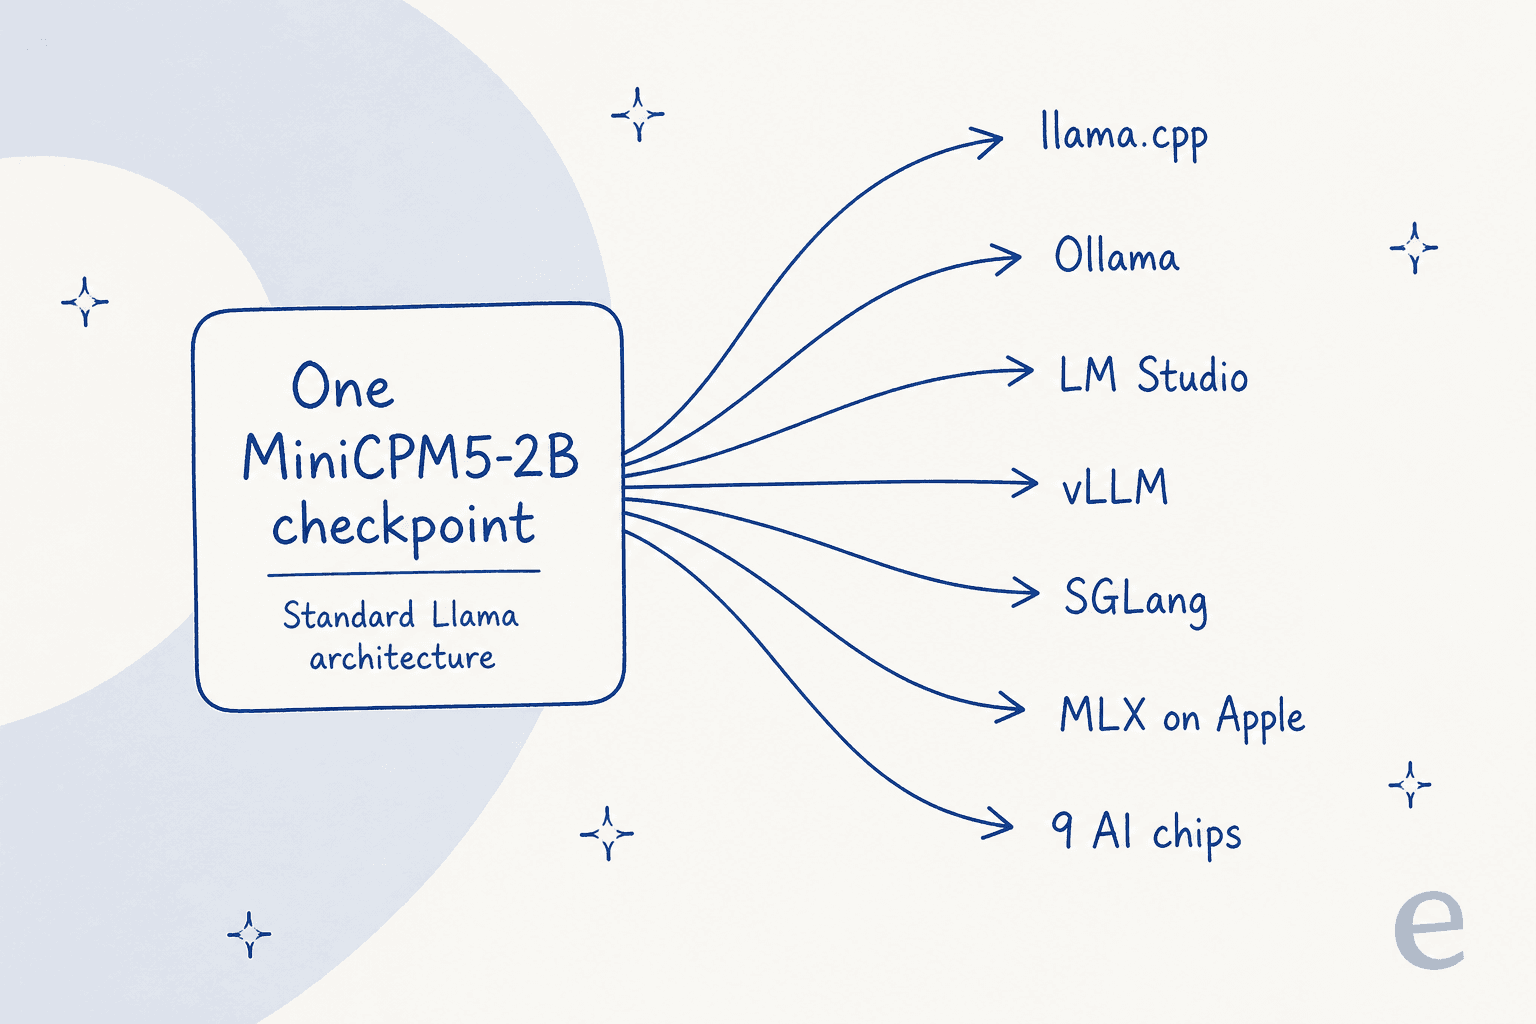
D'après le tableau de déploiement de la fiche du modèle, il tourne sur transformers, vLLM, SGLang, llama.cpp, Ollama, LM Studio, MLX pour Apple Silicon et FlagOS, qui l'adapte à neuf puces d'IA différentes. Pour l'appel d'outils, SGLang est le backend recommandé : le modèle émet des appels d'outils au style XML et le parser minicpm5 intégré de SGLang les convertit en tool_calls compatibles OpenAI. Il existe même un modèle brouillon DSpark pour le décodage spéculatif si vous voulez gagner en vitesse sans changer les sorties.
Ce que dit la communauté
Les réactions au lancement se sont regroupées en deux camps, et les deux sont des signaux utiles.
Le premier est un enthousiasme franc pour le rapport taille/capacité. Le billet officiel de lancement a dépassé 2 200 mentions J'aime en une journée, et un testeur a rapporté avoir fait tourner 32 sous-agents simultanés sur un seul DGX Spark à 931 tokens par seconde en moyenne, avec un pic à 1 364. Pour un modèle de 2B hébergé en local, ce débit donne envie de construire avec.
Le second camp est plus sceptique, et mérite d'être écouté précisément parce qu'il n'est pas du marketing. La plainte récurrente la plus forte portait sur l'absence de vision :
"Sad that there is no vision though."

Et certains développeurs ont contesté que les scores de benchmark se traduisent en travail réel, surtout dans des harnais de code :
"you get some likes here, but useful code? I don't think so"
Cet écart entre une ligne de benchmark solide et un bon comportement dans une vraie boucle d'agent ne se lit pas sur une fiche technique. C'est aussi ce qui compte le plus dès que vous essayez de mettre un modèle au travail sur des tâches réelles.
Un modèle ouvert est un moteur, pas un employé
Voici le recadrage à retenir, et c'est la partie que les bâtisseurs comme les acheteurs sautent le plus souvent. MiniCPM5-2B est un excellent moteur. Ce n'est pas, à lui seul, un travailleur. Télécharger un bon modèle à poids ouverts, c'est le début d'un projet, pas sa fin, et l'écart entre les deux dépasse le modèle.
Je travaille sur l'IA d'eesel, et c'est la distinction dans laquelle nous vivons chaque jour. Nous passons depuis des années des agents IA en production sur de vraies files de support, et la leçon récurrente est que la qualité brute du modèle décide rarement du succès d'un déploiement. Ce qui en décide, c'est tout ce qui entoure le modèle.
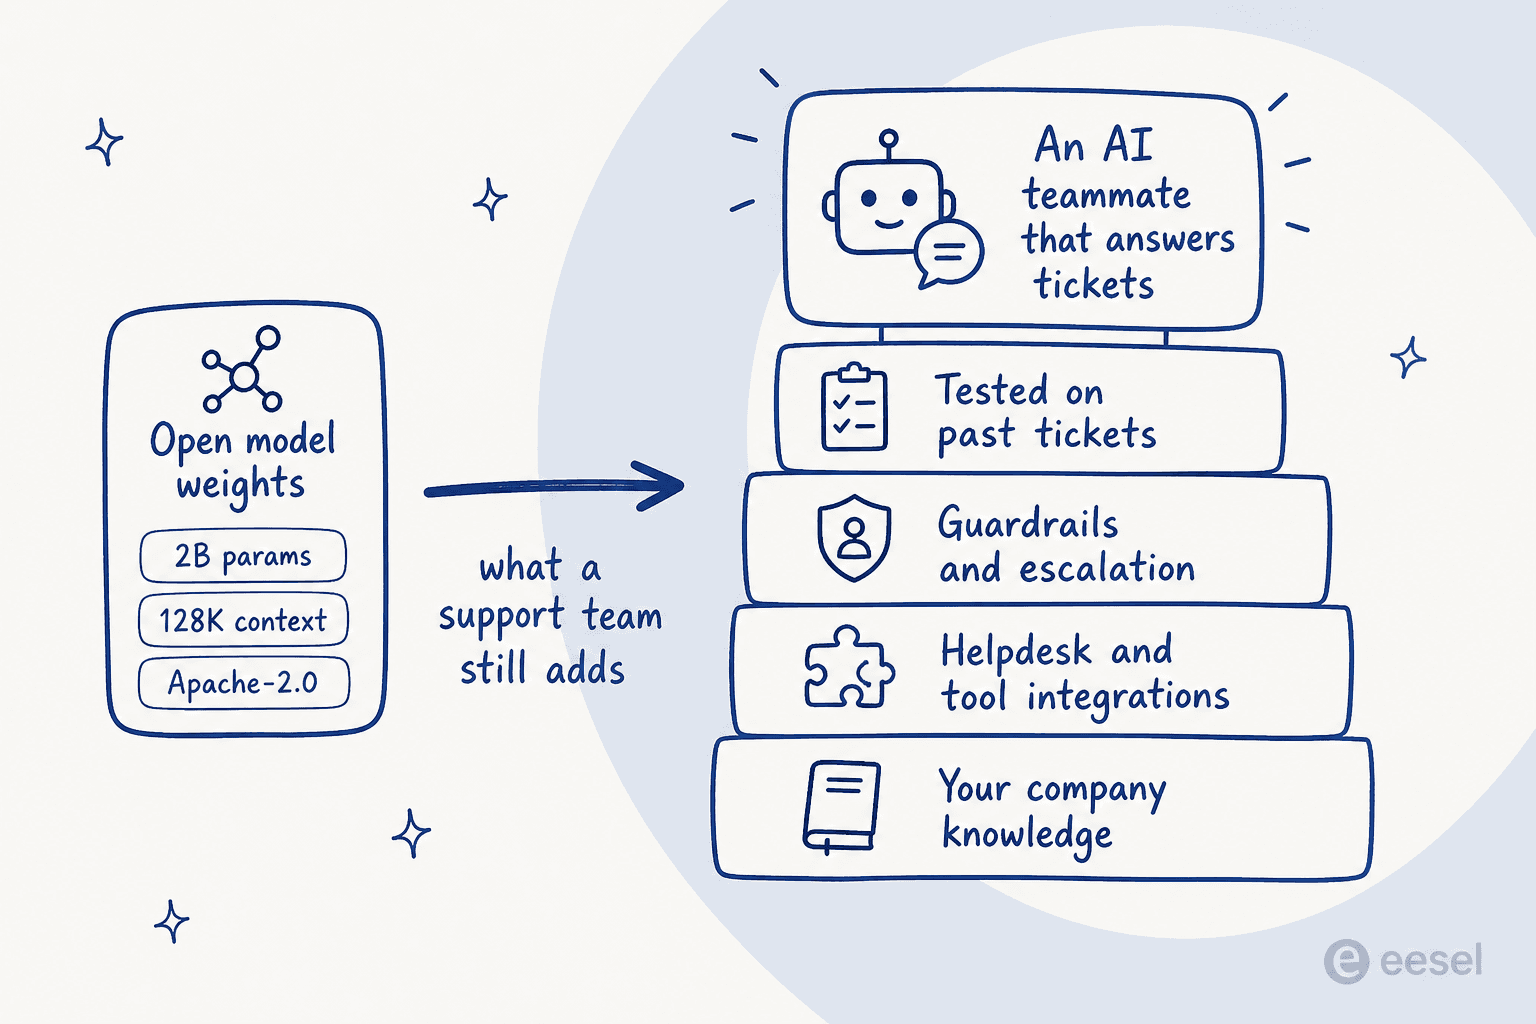
Prenons le support client comme cas concret. Pour transformer un modèle comme MiniCPM5-2B en quelque chose qui peut répondre à un vrai ticket, il faut lui fournir la connaissance réelle de votre entreprise, le brancher au helpdesk et aux outils dont il a besoin pour agir, ajouter des garde-fous pour qu'il escalade au lieu de deviner, et le tester sur de vraies conversations passées avant qu'il ne touche un client réel. C'est là que nous avons vu des bots à l'air sûr d'eux donner silencieusement de mauvaises réponses, ce qui explique pourquoi nous simulons désormais chaque déploiement sur des tickets historiques avant la mise en production. Le modèle représente peut-être 20 % de tout cela. Les 80 % restants sont l'échafaudage ennuyeux et essentiel, et il n'est pas dans le téléchargement.
Ce n'est pas un argument contre les modèles ouverts. C'est un argument pour être clair sur ce que l'on tient entre les mains. MiniCPM5-2B est un très bon moteur compact avec lequel construire. Mais si ce que vous voulez construire est un agent de support, vous pouvez soit assembler vous-même ces 80 %, soit l'embaucher tout fait.
Essayer eesel
Si votre vrai but est de répondre aux questions des clients plutôt que de faire tourner un modèle, c'est exactement le problème qu'eesel existe pour résoudre. eesel intègre à votre file d'attente existante un coéquipier helpdesk IA prêt à travailler : il apprend de vos anciens tickets et de votre centre d'aide, se branche en quelques minutes à des outils comme Zendesk, Freshdesk et Slack et, surtout, simule sur vos vrais tickets historiques pour que vous voyiez comment il se comportera avant qu'il ne réponde à qui que ce soit en direct.

Et si vous aimez travailler au plus près de la machine, comme avec un modèle local, eesel propose une CLI publique ainsi qu'un serveur MCP : le même coéquipier que vous configurez dans le tableau de bord peut être piloté depuis un terminal, automatisé dans des scripts ou confié à un agent de code comme Claude Code ou Cursor. Vous obtenez le travailleur prêt à l'emploi et la surface programmable, sans avoir à construire vous-même les 80 %. L'essai est gratuit.