

Groq 3 LPX est l'accélérateur d'inférence à faible latence à l'échelle du rack de NVIDIA pour la plateforme Vera Rubin. Il est vraiment impressionnant, mais la plupart des équipes ne peuvent pas simplement l'acheter. Il est livré dans le cadre d'un déploiement Vera Rubin, c'est une infrastructure à l'échelle du rack, et jusqu'ici seuls des clouds comme Nebius l'ont en production. Si vous cherchez des alternatives, vous vous posez donc presque sûrement l'une de ces deux vraies questions : quelle option d'inférence rapide puis-je réellement utiliser maintenant, ou sur quel silicium ma plateforme devrait-elle parier.
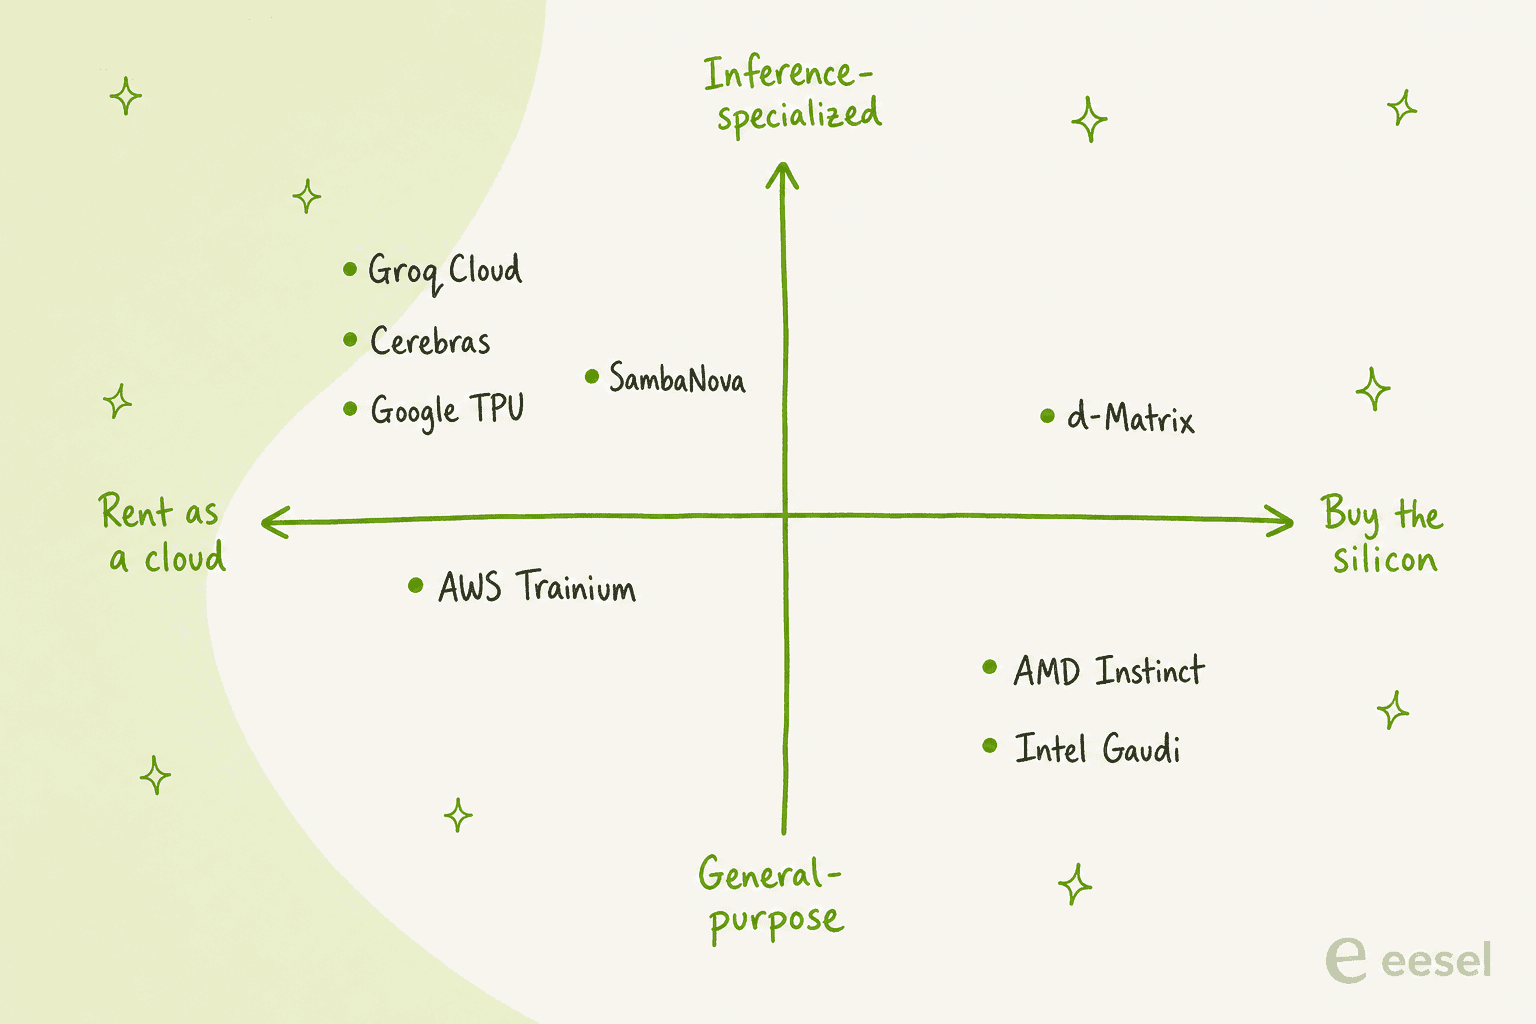
Voici les huit que j'examinerais, regroupées selon la façon d'y accéder :
- Utilisez-les dès aujourd'hui via une API : Cerebras (vitesse brute sur flux unique), SambaNova (plus grands modèles ouverts et charges d'agents) et le cloud indépendant de Groq (la LPU de Groq, sans attendre les racks NVIDIA).
- Louez du silicium d'hyperscaler : Google TPU Ironwood (Google Cloud, pensée pour l'inférence) et AWS Trainium (meilleure économie de tokens au sein d'AWS).
- Possédez le matériel : AMD Instinct (plus de mémoire par GPU, logiciel ouvert) et Intel Gaudi (bon rapport qualité-prix et Ethernet standard).
- Pariez tôt sur un spécialiste : d-Matrix Corsair (calcul en mémoire conçu pour la faible latence).
Le recadrage honnête, et ce que je veux surtout que vous reteniez : sauf si vous exploitez un cloud, vous n'achèterez aucun de ces produits. Vous les ressentirez comme des tokens plus rapides et moins chers dans les API que vous utilisez déjà, et ce que vous déployez réellement, c'est le travailleur au-dessus, comme un agent IA de helpdesk. C'est là qu'eesel se place.
Pourquoi regarder au-delà de Groq 3 LPX
Commençons par être juste envers le sortant, car c'est une pièce d'ingénierie sérieuse. Groq 3 LPX est l'accélérateur d'inférence de NVIDIA pour Vera Rubin, construit sur la conception LPU de Groq sous une licence non exclusive. Chaque rack réunit 256 puces LPU qui travaillent aux côtés de GPU Rubin, et NVIDIA cite un benchmark de 3 400 tokens par seconde sur Gemma 4 31B avec un contexte de 100K. C'est rapide, et l'architecture est astucieuse.
Alors pourquoi regarder ailleurs ? Quelques raisons très pratiques :
- Vous ne pouvez pas simplement l'acheter. LPX est une extension à l'échelle du rack de Vera Rubin NVL72, pas une carte que l'on glisse dans un serveur. C'est un engagement de centre de données, pas une décision d'achat pour la plupart des équipes.
- La disponibilité est mince. NVIDIA a annoncé la pleine production en août 2026, mais Nebius n'est que le premier cloud à le déployer. Si vous voulez de la capacité aujourd'hui, la file est courte et la liste des fournisseurs encore plus.
- Les chiffres viennent de NVIDIA elle-même. Le chiffre phare de 35 fois plus de débit par mégawatt est mesuré face à la génération précédente de NVIDIA. C'est une affirmation cohérente, mais c'est une affirmation du fournisseur, et les tests indépendants arrivent encore.
- Dépendance. LPX n'a de sens que dans une installation Vera Rubin. Si votre stack, votre cloud ou votre budget pointent ailleurs, c'est une dépendance forte.
Rien de tout cela ne rend LPX mauvais. Cela signifie simplement que « dois-je utiliser Groq 3 LPX ? » est la mauvaise question pour la plupart des gens. La meilleure est « où puis-je obtenir de l'inférence rapide ? », et elle a beaucoup de bonnes réponses.
Comment j'ai choisi, et comment lire cette liste
Je travaille côté produit, donc mon biais va vers ce que vous pouvez réellement adopter, pas vers ce qui brille le plus sur une diapositive. J'ai lu la documentation, les tarifs et les fiches techniques de chaque fournisseur, et là où un chiffre de vitesse existe, j'ai utilisé celui du fournisseur en le précisant. Trois choses ont façonné le classement :
- Pouvez-vous l'utiliser maintenant ? Une API que vous pouvez appeler cet après-midi vaut mieux qu'un rack pour lequel vous ferez la queue. L'accessibilité pèse lourd.
- Quelle est la vraie charge de travail ? Un chat rapide sur flux unique, d'énormes modèles ouverts ou un service par lots bon marché sont des métiers différents qui récompensent des puces différentes.
- Combien coûte la cohabitation ? Louer ou acheter, le logiciel auquel vous vous liez et le coût total de possession comptent plus que les FLOPS de crête.
Une réserve à énoncer clairement : l'avis de la communauté sur cette génération précise de matériel reste mince, car presque rien n'est en service depuis longtemps. Les analyses ci-dessous s'appuient donc sur les spécifications primaires et les rares vrais benchmarks existants, pas sur des années d'avis d'utilisateurs. Là où une vraie voix existe, je l'ai citée.
Voici tout le panorama d'un coup d'œil avant d'entrer dans le détail.
| Alternative | Type | Comment y accéder | Chiffre d'inférence phare (déclaré par le fournisseur) | Ordre de grandeur du coût | Idéal pour |
|---|---|---|---|---|---|
| Groq (GroqCloud) | Cloud d'inférence LPU + puces | API dès aujourd'hui, au token | La plus rapide sur modèles petits/moyens | Au token, publié | Vitesse LPU de Groq sans attendre les racks NVIDIA |
| Cerebras | Échelle de wafer (WSE-3) | API + achat de CS-4/CS-3 | ~3 000 tok/s (GPT OSS 120B) | 0,35 $ ent. / 0,75 $ sort. par M | Vitesse brute sur flux unique |
| SambaNova | RDU, mémoire à trois niveaux | API + racks sur site | ~850 tok/s (MiniMax M2.7) | 0,22 $ ent. / 0,59 $ sort. par M (gpt-oss-120b) | Plus grands modèles ouverts, agents, sur site |
| Google TPU (Ironwood) | ASIC maison | Location sur Google Cloud uniquement | 4 614 FP8 TFLOPs/puce | À partir de 12,00 $/puce-heure | Équipes déjà sur GCP, service à l'hyperscale |
| AWS Trainium | ASIC maison | Location sur AWS uniquement | Trn2 : 30-40 % de meilleur rapport prix-performance vs H200 | Inf2 à partir de 0,76 $/h | Tokens moins chers au sein d'AWS |
| AMD Instinct | GPU (CDNA) | Achat, ou via des partenaires cloud | MI355X : 288 Go HBM3E, 8 To/s | Achat d'investissement / devis | Silicium en propre, modèles gourmands en mémoire, sans dépendance |
| Intel Gaudi 3 | Accélérateur IA | Achat, ou via IBM Cloud | 128 Go HBM, 1 200 Go/s Ethernet | Positionnement « moitié moins cher » | Acheteurs sensibles au prix, environnements natifs Ethernet |
| d-Matrix Corsair | Calcul en mémoire (DIMC) | Achat de matériel uniquement | 60 000 tok/s (Llama3 8B, serveur) | Achat d'investissement | Obsédés par la latence qui parient tôt |
| Groq 3 LPX (sortant) | Rack LPU + GPU | Via des clouds (Nebius) | 3 400 tok/s (Gemma 4 31B) | Échelle centre de données | Inférence agentique à l'hyperscale |
Vous ne savez pas quelle ligne est la vôtre ? Ce sélecteur vous mène à une présélection en un clic.
1. Groq (GroqCloud) : la LPU de Groq que vous pouvez vraiment utiliser aujourd'hui
Idéal pour : les équipes qui veulent la vitesse à faible latence de la LPU de Groq via une API dès maintenant, sans attendre que les racks NVIDIA arrivent dans leur cloud.
Voici le rebondissement qui déroute beaucoup de monde. L'entreprise Groq existe toujours, exploite toujours GroqCloud et vend toujours la même vitesse LPU qui l'a rendue célèbre. Quand NVIDIA a obtenu une licence sur la technologie de Groq, c'était un accord non exclusif accompagné d'un transfert d'équipe, pas une fermeture. Groq est restée indépendante sous un nouveau PDG, et GroqCloud a continué de fonctionner sans interruption. Une réaction sur X a parfaitement saisi la confusion :
"so groq the company is now also an nvidia product line, that's going to confuse people for months"
Donc, si ce qui vous a attiré dans LPX, c'est la vitesse de la LPU, l'« alternative » la plus directe est souvent simplement l'original : GroqCloud. Vous obtenez une API compatible OpenAI, une génération de tokens déterministe à faible latence, et vous pouvez commencer aujourd'hui au lieu d'attendre un déploiement Vera Rubin près de chez vous. Sur Hacker News, l'un des commentaires les plus affûtés a lu le benchmark LPX comme la continuité de la force connue de Groq :
"Gemma 31B dense at 3k TPS seems like a pretty big deal. Groq has always been more efficient than Cerebras at running very small models and this release seems to be no exception."

Avantages : disponible aujourd'hui, API familière, forte sur les modèles petits et moyens, et la même lignée LPU que NVIDIA a licenciée. Inconvénients : la confusion de marque est réelle, et les plus grands modèles sont mieux servis ailleurs. Pour le tableau complet des coûts, nous avons détaillé séparément les tarifs de Groq et l'ensemble plus large des alternatives à Groq.
Tarifs et accès : en libre-service, paiement au token via GroqCloud. Verdict : si « Groq 3 LPX » vous a attiré pour la LPU, commencez ici avant toute autre chose. C'est le chemin le plus court vers la vraie chose.
2. Cerebras : ce qui ressemble le plus à un rival de vitesse pure
Idéal pour : la vitesse brute de tokens sur flux unique avec des modèles petits et moyens, que ce soit via l'API ou sur votre propre système.
Cerebras est l'autre nom qui revient toujours dans la conversation sur « l'inférence la plus rapide », et à juste titre. Son Wafer-Scale Engine est une puce unique de la taille d'une assiette : 4 000 milliards de transistors, 900 000 cœurs et 125 pétaflops sur un seul morceau de silicium. Cerebras parle de 19 fois plus de transistors qu'une NVIDIA B200. Toute la philosophie de conception est l'inverse d'un cluster de petites puces qui communiquent sur un réseau.
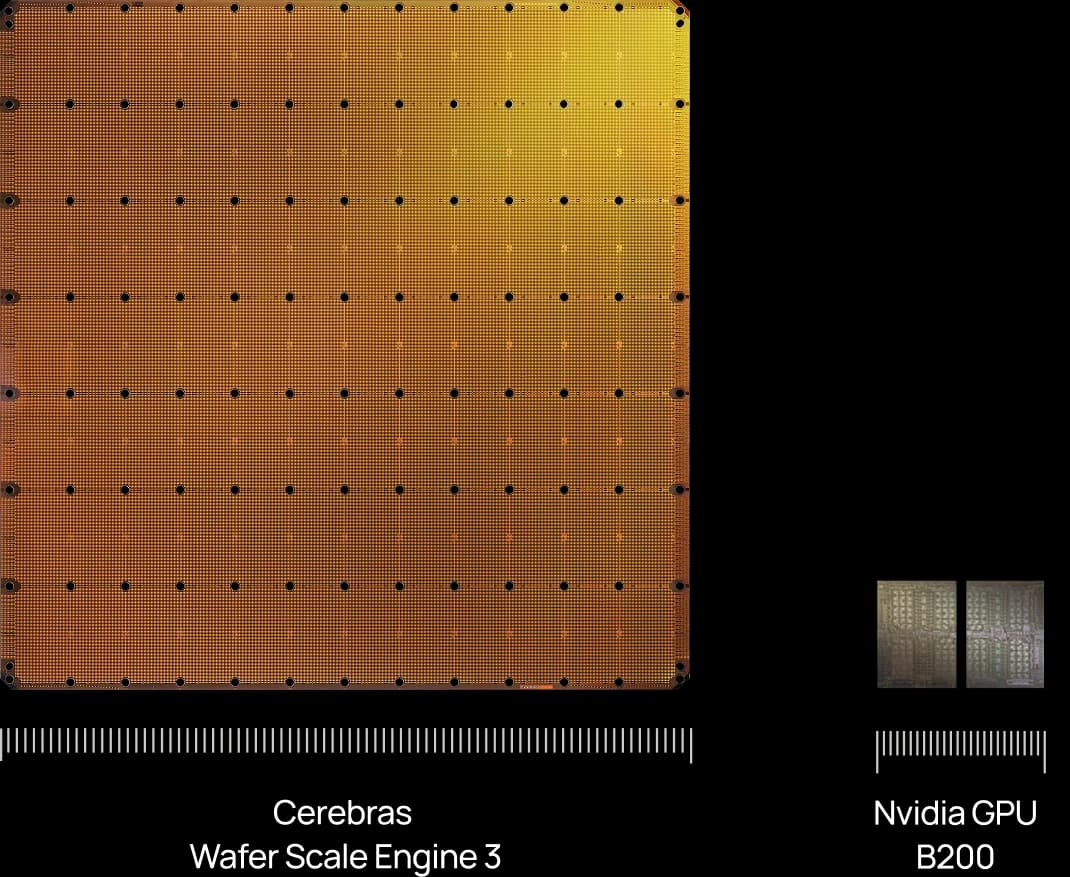
La partie que vous utilisez réellement est Cerebras Inference, un cloud compatible OpenAI qui mise très fort sur la vitesse : la page de tarifs affirme qu'il est 20 fois plus rapide qu'OpenAI et Anthropic, et le nouveau système CS-4 promet « jusqu'à 30 fois plus d'inférence par rapport aux GPU ». Concrètement, Cerebras cite environ 3 000 tokens par seconde sur GPT OSS 120B et environ 1 800 sur Gemma 4 31B.
Avantages : une vitesse sur flux unique véritablement leader de sa catégorie, une API propre payante au token et des utilisateurs cités comme OpenAI, Meta et Perplexity. Inconvénients : les systèmes à l'échelle du wafer sont un achat lourd si vous allez sur site, et la grille publique ne liste que quelques modèles, donc budgéter une charge précise passe par une discussion commerciale.
Tarifs et accès : 5 $ de crédits gratuits pour démarrer, puis un palier Developer à partir de 10 $ avec des tarifs au token publiés (GPT OSS 120B à 0,35 $ en entrée / 0,75 $ en sortie par million de tokens), plus Enterprise et des systèmes CS-4/CS-3 à la vente. Verdict : si la seule chose qui compte pour vous est le nombre de tokens par seconde sur un modèle que Cerebras sert, c'est l'alternative la plus forte de cette liste, et elle concurrence Groq de front.
3. SambaNova : conçue pour les grands modèles ouverts et les agents
Idéal pour : exécuter rapidement les plus grands modèles ouverts, garder de nombreux modèles résidents pour des charges d'agents, ou servir de l'inférence dans votre propre centre de données.
Tout le discours 2026 de SambaNova est « l'inférence premium », et son atout différenciant est la mémoire. Là où la conception de Groq parie sur une énorme bande passante SRAM avec une capacité minuscule par puce, la SN50 RDU utilise trois niveaux : 432 Mo de SRAM sur la puce, 64 Go de HBM2E et jusqu'à 512 Go de DDR5. Cela permet à plusieurs grands modèles de rester chargés et de basculer avec une latence minimale, ce que le cofondateur Kunle Olukotun appelle la « zone Boucle d'or » pour les agents.
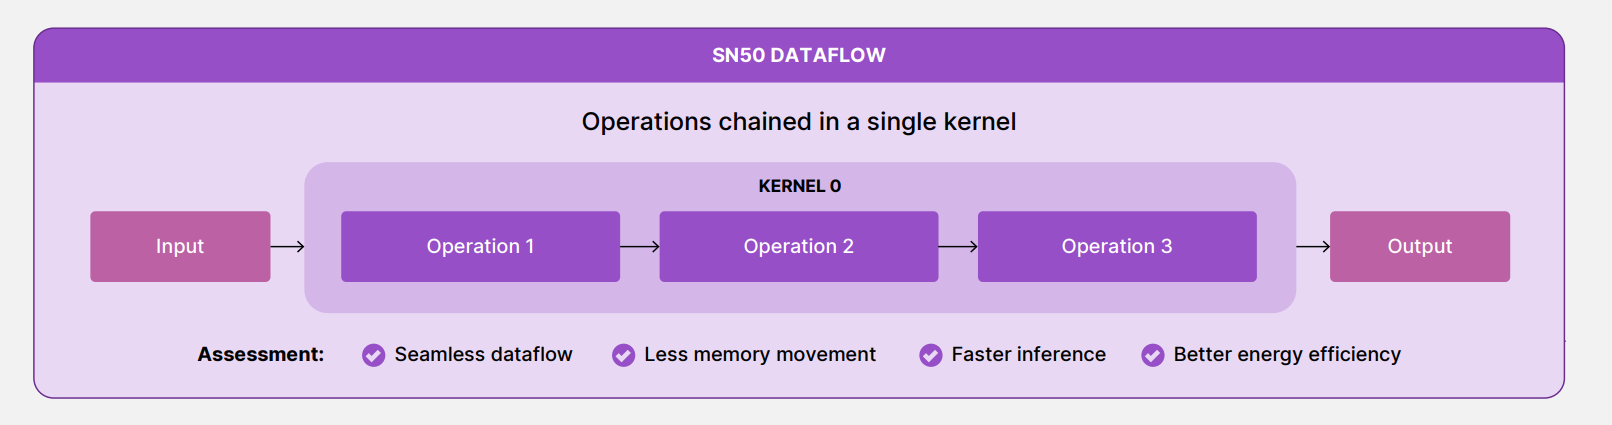
La preuve de vitesse à laquelle je fais le plus confiance vient d'un tiers : Artificial Analysis a mesuré le SN50 exécutant MiniMax M2.7 à jusqu'à 850 tokens par seconde sur contexte court et plus de 450 sur contexte long, le qualifiant du MiniMax le plus rapide au monde. Il y a aussi une nuance astucieuse : SambaNova s'associe de plus en plus à NVIDIA plutôt que de le combattre, en utilisant des GPU pour la phase de prefill, gourmande en calcul, et des RDU pour la phase de decode, limitée par la mémoire.
Avantages : la mémoire à trois niveaux convient aux modèles énormes et aux charges d'agents multi-modèles, des tarifs publiés pour les modèles ouverts, une vraie offre sur site pour les déploiements souverains et d'entreprise, et une levée d'1 milliard de dollars toute récente à une valorisation de 11 milliards. Inconvénients : c'est moins un pari pur sur « le plus rapide sur un petit modèle » que Groq ou Cerebras, et les plus gros déploiements passent par le contact commercial.
Tarifs et accès : SambaNova Cloud est une API payante au token (gpt-oss-120b à 0,22 $ en entrée / 0,59 $ en sortie par million de tokens ; DeepSeek-V3.1 à 3,00 $ / 4,50 $), avec des systèmes SambaRack pour le sur site. Verdict : le bon choix quand votre charge est composée de grands modèles ouverts ou d'un agent qui jongle avec plusieurs modèles à la fois, et encore plus si vous le voulez dans votre propre centre de données.
4. Google TPU (Ironwood) : la réponse des hyperscalers
Idéal pour : les équipes déjà sur Google Cloud, et toute personne qui a besoin d'une capacité de service à l'hyperscale plutôt que d'une seule machine à faible latence.
Si Groq 3 LPX représente « la puce de NVIDIA pensée d'abord pour l'inférence », Ironwood est la version de Google de la même idée. Google présente Ironwood comme sa TPU de septième génération et « la première conçue spécifiquement pour l'inférence », bâtie pour l'« ère de l'inférence » et les modèles de raisonnement. Chaque puce délivre 4 614 TFLOPs FP8 et 192 Go de HBM à environ 7,37 To/s, et un superpod complet relie 9 216 puces refroidies par liquide pour 42,5 ExaFLOPs partageant 1,77 pétaoctet de HBM.
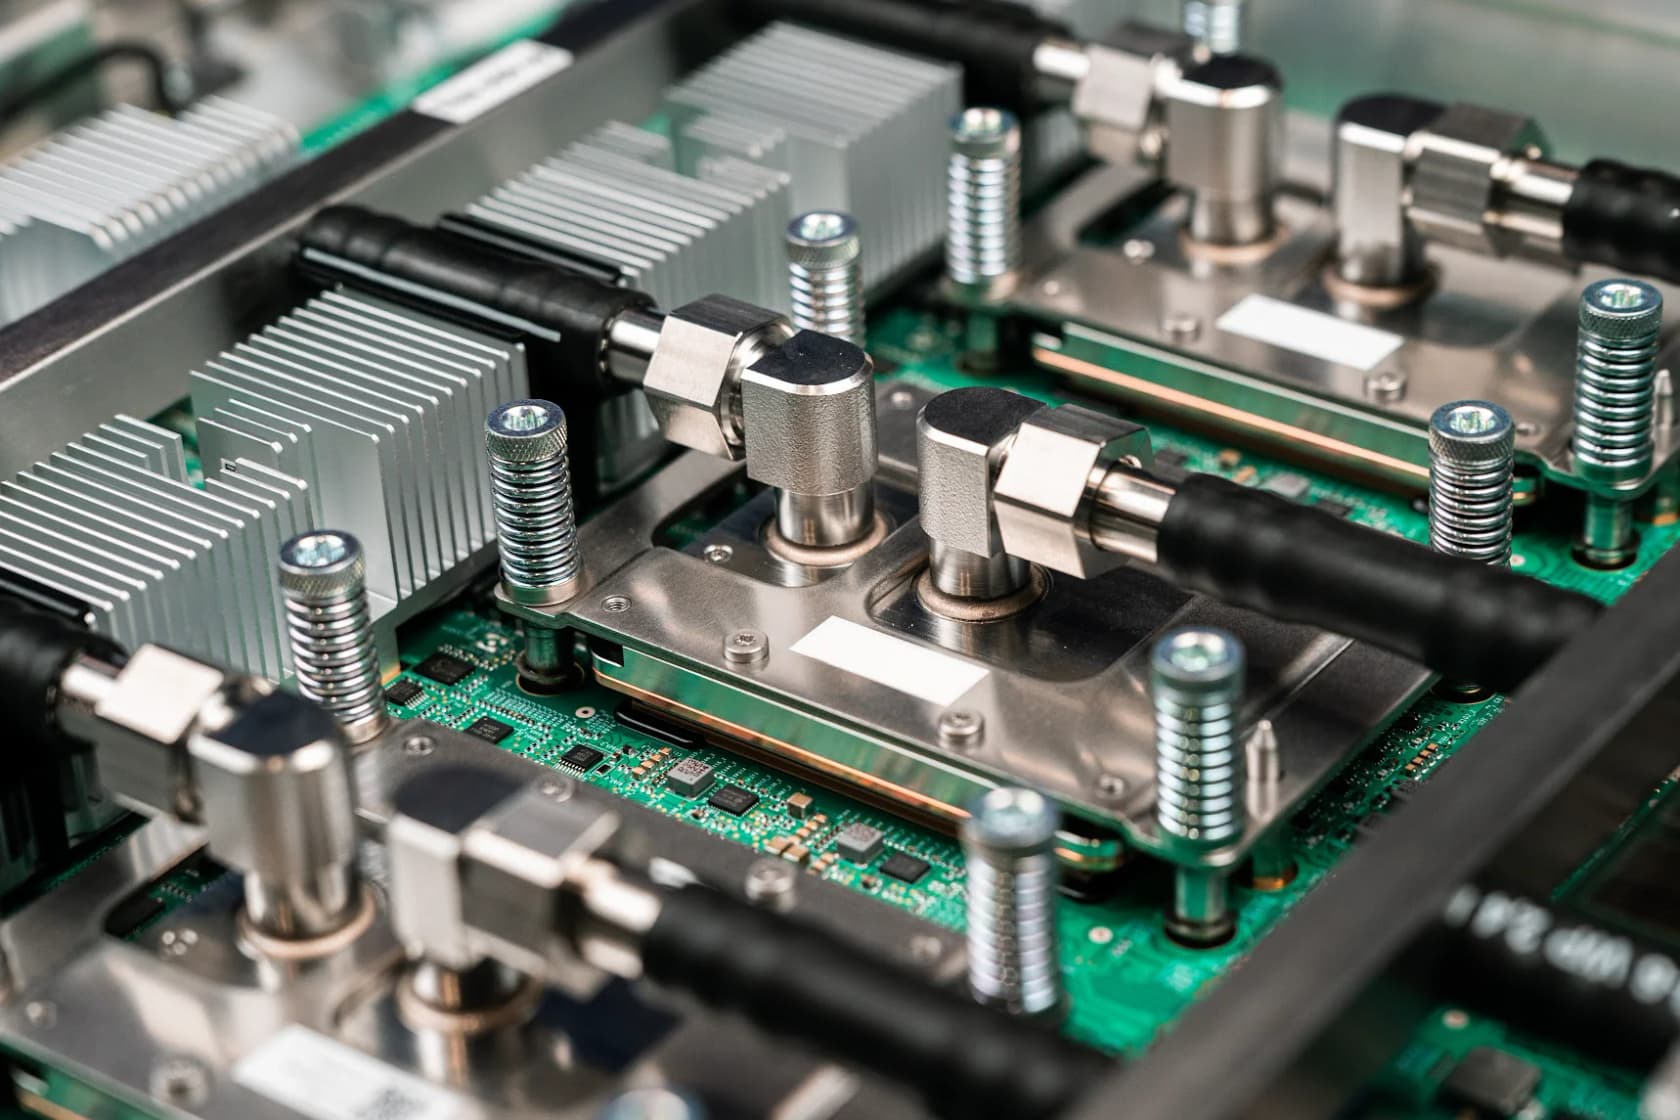
Le contraste le plus net avec Groq est le modèle d'achat : on ne peut pas acheter une TPU. C'est de la location uniquement, uniquement sur Google Cloud, facturée à la puce-heure. L'histoire d'échelle est toutefois réelle. Le client phare de Google est Anthropic, qui prévoit d'accéder à jusqu'à 1 million de TPU pour entraîner et servir Claude.
Avantages : conception pensée d'abord pour l'inférence, échelle de pod énorme, fort rapport prix-performance à grande échelle et une voie de portabilité (vLLM sur TPU permet de passer du GPU à la TPU avec des changements de configuration mineurs). Inconvénients : dépendance totale à Google Cloud, aucune carte à acheter, et l'Ironwood à la demande n'est pas bon marché.
Tarifs et accès : louée à la puce-heure, à partir de 12,00 $ à la demande dans us-central1, descendant à 5,40 $ avec un engagement de trois ans. Verdict : si vous vivez déjà sur Google Cloud ou si vous avez besoin d'une flotte de service plutôt que d'une seule machine rapide, Ironwood est l'alternative naturelle. Si vous voulez du silicium que vous contrôlez, c'est l'inverse.
5. AWS Trainium : la meilleure économie de tokens au sein d'AWS
Idéal pour : les équipes sur AWS qui veulent des tokens moins chers et se satisfont de servir via Bedrock ou EC2 plutôt que de courir après la vitesse de pointe.
L'argument d'AWS n'est pas « le plus rapide », c'est « le moins cher au token », et c'est un axe vraiment différent. Trainium est désormais positionné pour l'inférence autant que pour l'entraînement : AWS affirme que les instances Trn2 offrent 30-40 % de meilleur rapport prix-performance que ses instances P5e et P5en basées sur NVIDIA H200, et le Trainium3 annoncé (sa première puce IA en 3 nm) promet jusqu'à 4,4 fois les performances des UltraServers Trn2. L'ancienne gamme Inferentia2 revendique 40 % de meilleur rapport prix-performance et 50 % de meilleures performances par watt sur les instances Inf2.
La preuve phare est Anthropic, citée directement sur la page Trainium : un Claude 3.5 Haiku optimisé pour la latence qui tourne 60 % plus vite sur Trainium2 via Bedrock, et Project Rainier, un cluster de centaines de milliers de puces Trainium2.
Avantages : de vraies économies au sein d'AWS, une intégration profonde avec Bedrock et SageMaker, et des UltraServers à l'échelle du rack (64 puces sur Trn2, 144 sur Trn3) pour les plus gros travaux. Inconvénients : AWS uniquement et location uniquement, et fonctionne sur le Neuron SDK plutôt que CUDA, si bien que les charges PyTorch et vLLM courantes migrent facilement, mais que les kernels CUDA écrits à la main doivent être portés.
Tarifs et accès : location via EC2 ou consommation via Bedrock. Inf2 a des tarifs horaires publiés de 0,76 $ à 12,98 $ à la demande ; les UltraServers Trn2 et Trn3 sont sur devis. Verdict : si votre infrastructure vit déjà sur AWS, c'est l'option prix-performance, surtout pour un service stable où le coût par token compte plus que les dernières millisecondes.
6. AMD Instinct : posséder le silicium, garder plus de mémoire
Idéal pour : les équipes qui veulent acheter du silicium du commerce, garder de grands modèles résidents en mémoire et éviter une stack exclusivement NVIDIA.
Si vous voulez un vrai GPU que vous pouvez posséder, AMD est la principale alternative à NVIDIA, et tout son argument pour l'inférence est la mémoire. La MI355X déjà livrée embarque 288 Go de HBM3E à 8 To/s et 10,1 PFLOPs de MXFP4, et la série MI400 annoncée monte jusqu'à 432 Go de HBM4 à 23,3 To/s. AMD affirme que ses MI455X et MI430X offrent 50 % de capacité mémoire en plus que le GPU Vera Rubin de NVIDIA, ce qui compte quand un modèle plus grand ou un cache KV plus long tient sur une seule puce au lieu d'être réparti.
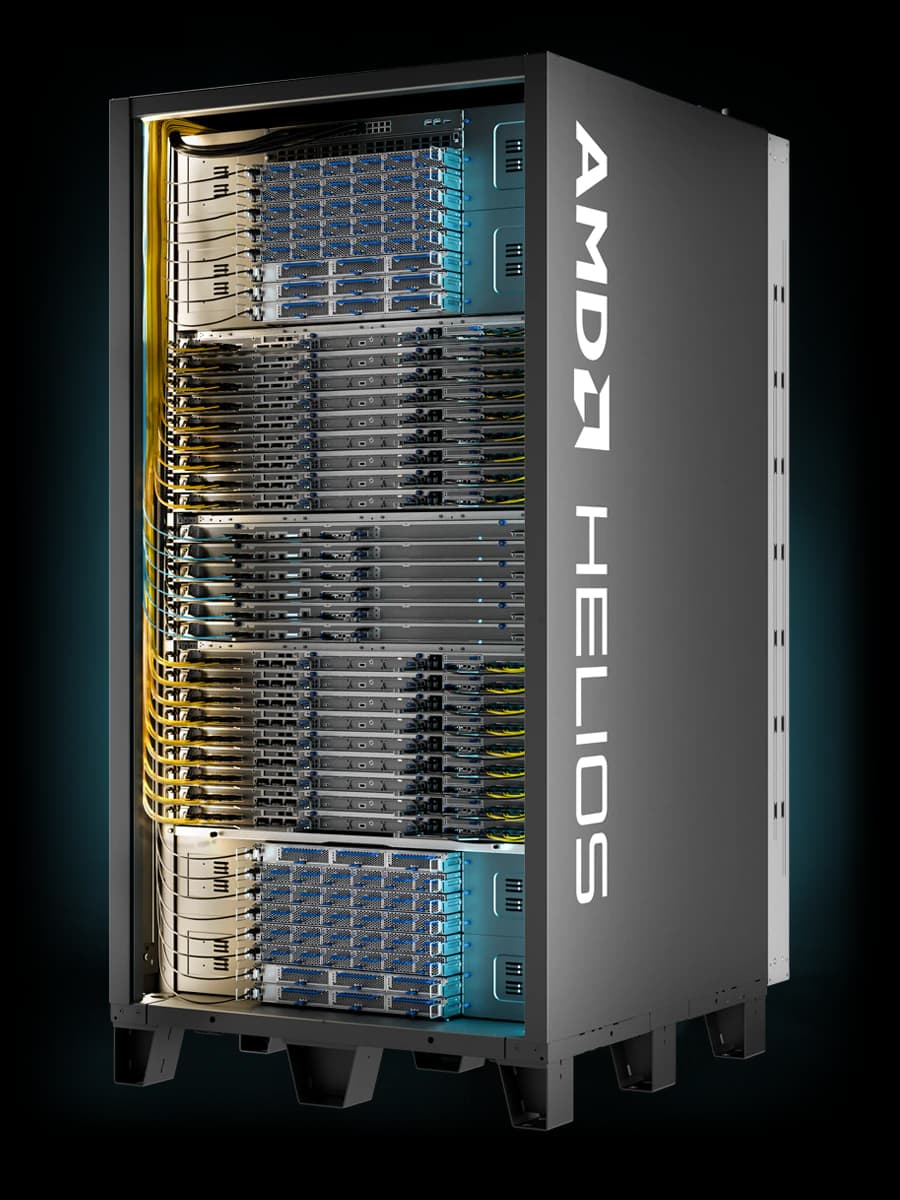
À l'échelle du rack, le système AMD Helios réunit 72 GPU MI455X pour jusqu'à 2,9 exaFLOPS de MXFP4 et 31 To de HBM4. Côté logiciel, il repose sur la pile ouverte ROCm, désormais en version ROCm 10.0, avec vLLM et SGLang pour le service.
Avantages : plus de HBM par GPU que l'équivalent NVIDIA, une pile logicielle ouverte, de vraies options à l'échelle du rack et aucune dépendance à un réseau propriétaire. Inconvénients : ROCm a beaucoup rattrapé son retard, mais le reproche honnête reste la maturité de l'écosystème face à CUDA, et certaines des meilleures spécifications concernent la génération MI400, pas encore livrée.
Tarifs et accès : achat via des OEM, ou essai de la MI300X sur l'AMD Developer Cloud via des partenaires comme DigitalOcean et Vultr. Verdict : le choix par défaut si vous voulez posséder du silicium d'inférence, faire tourner des modèles gourmands en mémoire et garder vos options logicielles ouvertes. Elle concurrence sur la capacité et l'ouverture, pas sur le fait d'être le flux unique le plus rapide.
7. Intel Gaudi 3 : rapport qualité-prix et Ethernet standard
Idéal pour : les acheteurs sensibles au coût qui veulent un accélérateur capable et préfèrent monter en charge sur de l'Ethernet standard plutôt que sur un réseau propriétaire.
Le Gaudi 3 d'Intel joue la carte du rapport qualité-prix, et son pari signature est le réseau. Chaque accélérateur Gaudi 3 intègre sur la carte 24 ports 200 GbE RoCE, pour 1 200 Go/s de bande passante bidirectionnelle sur Ethernet standard. Le discours d'Intel est franc sur l'échange qu'il veut vous voir faire : éviter les « technologies propriétaires et verrouillées comme NVLink, NVSwitch et InfiniBand » et utiliser le matériel réseau que vous possédez déjà. Côté calcul, il apporte 128 Go de HBM à 3,7 To/s et 1,8 PFLOPS en FP8.
À savoir pour la feuille de route : le Gaudi 3 est en fin de gamme. La puce d'inférence que présente Intel pour la suite est un nouveau GPU, « Crescent Island », construit sur l'architecture Xe3P avec 160 Go de LPDDR5X et un refroidissement par air, avec des échantillons clients attendus au second semestre 2026. Si vous achetez le Gaudi 3 aujourd'hui, achetez-le donc pour son rapport qualité-prix immédiat plutôt que pour une longue feuille de route.
Avantages : positionnement tarifaire agressif, beaucoup de HBM par carte et Ethernet standard qui évite la dépendance à une interconnexion propriétaire. Inconvénients : il concurrence sur le coût plutôt que sur la vitesse brute, et la feuille de route bascule clairement vers une autre gamme de puces, c'est donc un achat de valeur, pas un pari à long terme.
Tarifs et accès : achat via des OEM comme Dell, HPE et Supermicro, ou utilisation sur IBM Cloud, qui le promeut avec l'argument « moitié moins cher ». Verdict : un choix raisonnable si le budget est serré et que votre centre de données est natif Ethernet. Sachez simplement que Crescent Island est le véritable avenir d'Intel en inférence.
8. d-Matrix Corsair : le spécialiste qui parie sur la mémoire
Idéal pour : les équipes obsédées par la latence qui peuvent déployer leur propre matériel et veulent parier tôt sur une architecture d'inférence conçue sur mesure.
d-Matrix est le joker, et vise exactement le problème que cible LPX : une génération de tokens à latence ultra-faible et petits lots pour les charges agentiques et de raisonnement. Sa carte Corsair utilise le Digital In-Memory Compute, plaçant le calcul juste à côté de la SRAM sur la puce pour contourner le mur de la mémoire. Les chiffres phares sont frappants : 60 000 tokens par seconde à 1 ms par token pour Llama3 8B sur un seul serveur, et 30 000 tokens par seconde à 2 ms pour Llama3 70B dans un rack, d-Matrix revendiquant environ 10 fois la vitesse interactive et jusqu'à 5 fois l'efficacité énergétique d'un H100 (ses propres projections).
Corsair est entré en pleine production en juin 2026, et l'entreprise a levé une série C de 275 millions de dollars en novembre 2025 (à une valorisation rapportée d'environ 2 milliards), avec des soutiens comme M12 de Microsoft et Temasek.
Avantages : une architecture conçue de zéro pour l'inférence à faible latence, de fortes revendications d'efficacité et un financement sérieux derrière. Inconvénients : c'est du matériel seul sans API publique, ses chiffres sont des projections du fournisseur et non des tests indépendants, et parier sur le silicium d'une startup est un risque différent de la location chez un hyperscaler.
Tarifs et accès : achat des cartes, serveurs ou systèmes SquadRack ; il n'y a pas de point d'accès cloud en libre-service. Verdict : l'outsider le plus intéressant de cette liste. Si vous avez l'équipe pour monter du silicium et voulez être précurseur du calcul en mémoire, cela mérite un examen sérieux. Pour tous les autres, c'est à surveiller.
La vraie différence entre ces puces, c'est le pari sur la mémoire
Si vous prenez du recul sur le marketing, les huit alternatives se répartissent en trois camps selon une seule décision : la façon dont elles gèrent la mémoire. Ce choix unique explique la plupart des différences de fiches techniques que vous venez de lire.
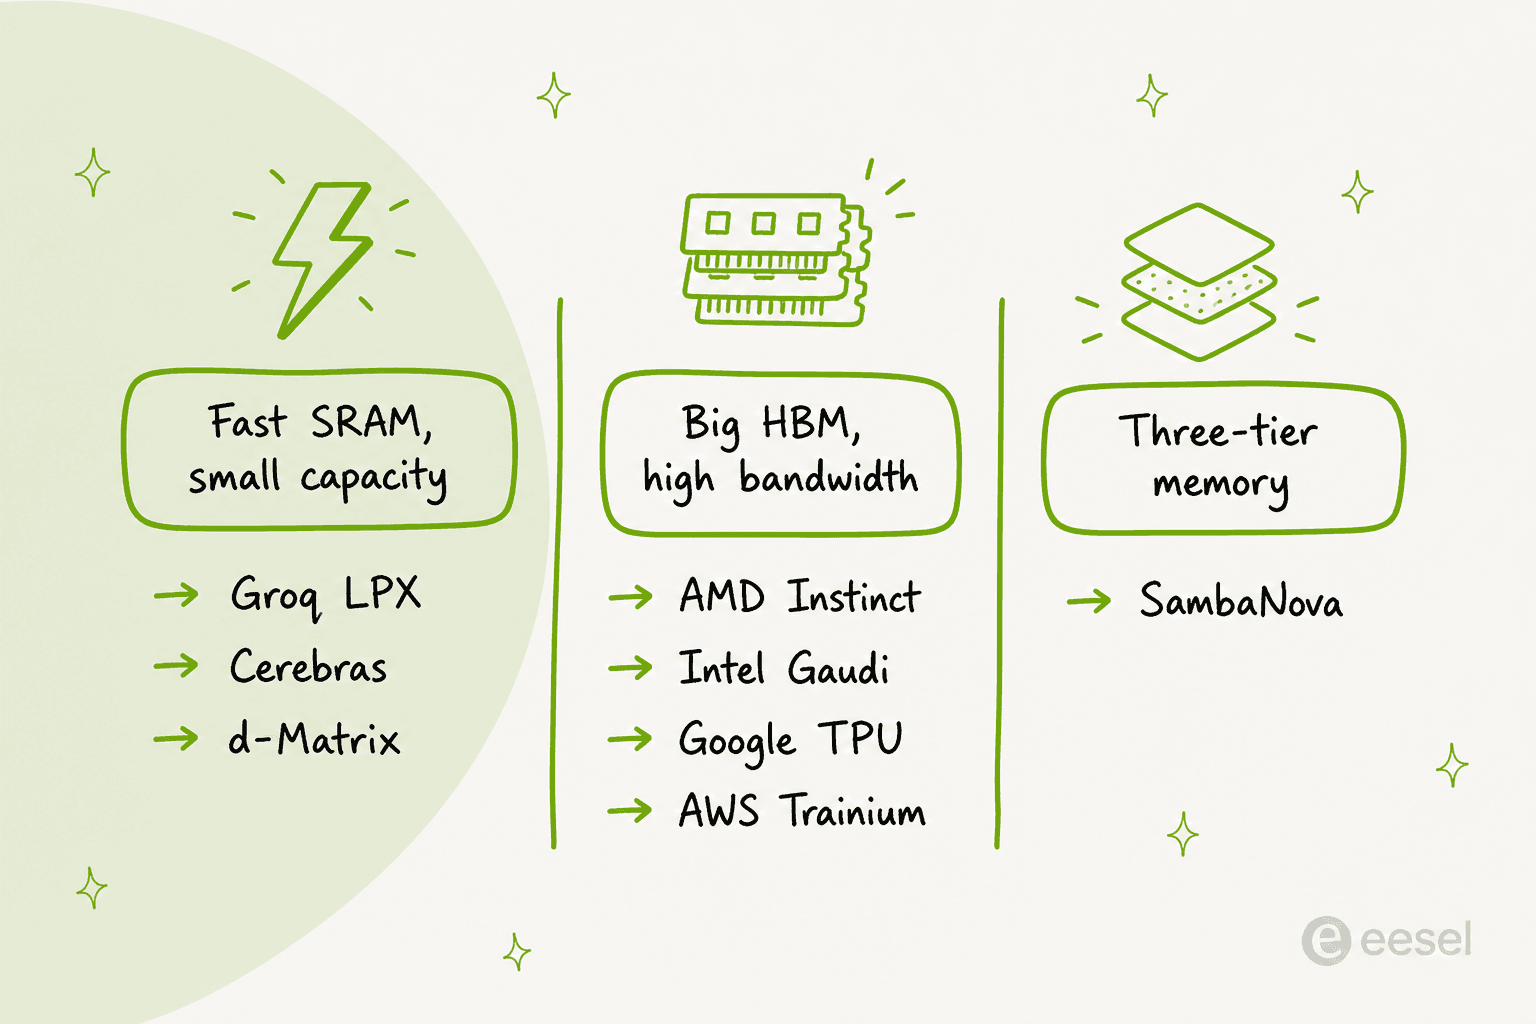
- SRAM rapide, petite capacité. Groq, Cerebras et d-Matrix gardent les données de travail dans de la SRAM ultra-rapide sur la puce. C'est ce qui rend la génération de tokens instantanée, mais chaque puce contient très peu, il en faut donc beaucoup pour un grand modèle.
- Grande HBM, haute bande passante. AMD, Intel, Google et AWS chargent beaucoup de mémoire à haute bande passante par accélérateur. Un grand modèle et un long cache KV tiennent ainsi sur moins de puces, ce qui explique pourquoi AMD insiste autant sur son avantage de mémoire par GPU.
- Mémoire à trois niveaux. SambaNova fait le compromis avec SRAM, HBM et DDR5, et peut ainsi garder de nombreux grands modèles résidents et basculer rapidement entre eux, une propriété que récompensent les charges d'agents.
Il n'y a pas ici de réponse universellement bonne. Si votre charge est un chat rapide sur un petit modèle, le camp de la SRAM gagne. Si c'est un modèle géant ou un agent multi-modèles, la capacité gagne. Nommer votre camp vous dit lesquelles des huit présélectionner plus vite que n'importe quel benchmark.
La question plus large : vous n'allez probablement pas acheter un rack
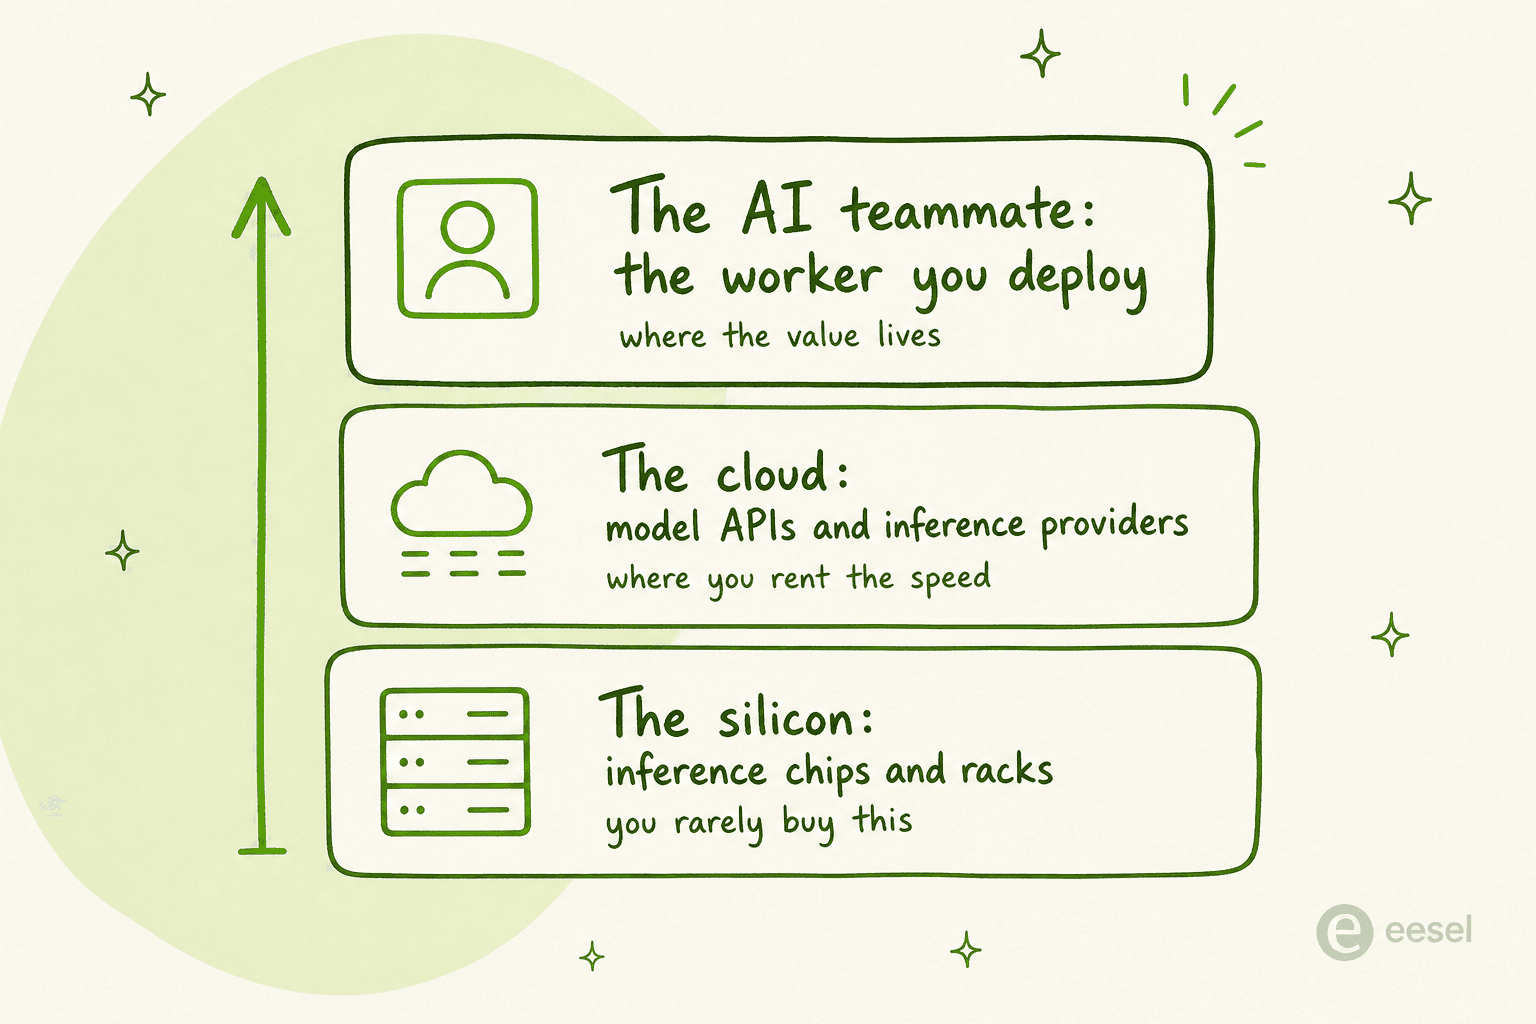
C'est la partie sur laquelle je veux être le plus direct, car il est facile de se perdre dans les pétaflops. Sauf si vous exploitez un cloud ou une très grande plateforme IA, vous n'allez acheter ni Groq 3 LPX ni la plupart de ses alternatives. C'est de l'infrastructure située plusieurs couches sous l'endroit où le travail se fait réellement. Vous la ressentirez comme des tokens plus rapides et moins chers dans les API de modèles et les clouds que vous utilisez déjà, de la même façon que vous n'avez jamais acheté un GPU pour utiliser un agent IA.
Et ce basculement des charges de travail est précisément la raison d'être de tout ce silicium. Comme l'a formulé un analyste sur X :
"Nvidia moving its Groq 3 LPX inference accelerator into full production signals a key shift from model training to continuous agentic AI workloads."
Le recadrage utile est que la puce est le moteur, et que ce que vous déployez réellement est le travailleur qui roule dessus. Une inférence plus rapide rend les agents plus réactifs et moins chers à exploiter, ce qui abaisse la barrière pour mettre en production de vraie automatisation et fait pencher le calcul des coûts contre le travail fait à la main, qu'il s'agisse d'un agent de code, d'un agent de recherche ou d'un agent IA de helpdesk qui traite votre file de support. La course au matériel vise à rendre cette couche viable à grande échelle. La valeur réside toujours dans la couche. Si vous voulez comprendre pourquoi la latence est si sensible, nous avons exploré séparément les coûts d'inférence des LLM.
Où eesel se place, et pourquoi elle se moque de la puce que vous avez choisie
Chaque puce de cette liste est de la tuyauterie. eesel est ce que vous embauchez pour faire le travail par-dessus. eesel est une plateforme de collègues IA : au lieu de provisionner de l'inférence ou de câbler un pipeline, vous accueillez un collègue prêt à travailler pour un rôle précis et vous le branchez à vos applications. L'équipe actuelle comprend un collègue IA de helpdesk qui rejoint votre file de support en étant bien plus qu'un simple chatbot de support, et un rédacteur de blog IA qui produit du contenu comme cet article.

La raison pour laquelle le choix de la puce ne vous touche pas vraiment, c'est qu'eesel fonctionne sur n'importe quelle inférence en dessous, et que ce qui décide si elle est bonne n'est pas le nombre de tokens par seconde. C'est la précision. Les années passées à faire tourner de l'IA sur de vraies files de support nous ont appris la moitié peu glamour : un collègue de support qui répond en une seconde au lieu de huit, c'est toute l'expérience pour le client qui attend, mais la vitesse n'aide que si la réponse est juste. C'est la différence entre un agent qui détourne réellement les tickets de niveau 1 et un qui ne fait que frustrer les gens, et c'est pourquoi eesel simule un déploiement sur vos anciens tickets avant de répondre à un client en direct. Tout le silicium du monde ne corrige pas une mauvaise réponse dite avec assurance. Si vous préférez déployer le collègue plutôt que de chercher un rack, vous pouvez essayer eesel gratuitement.