

Ce que Z.ai a réellement publié le 12 octobre
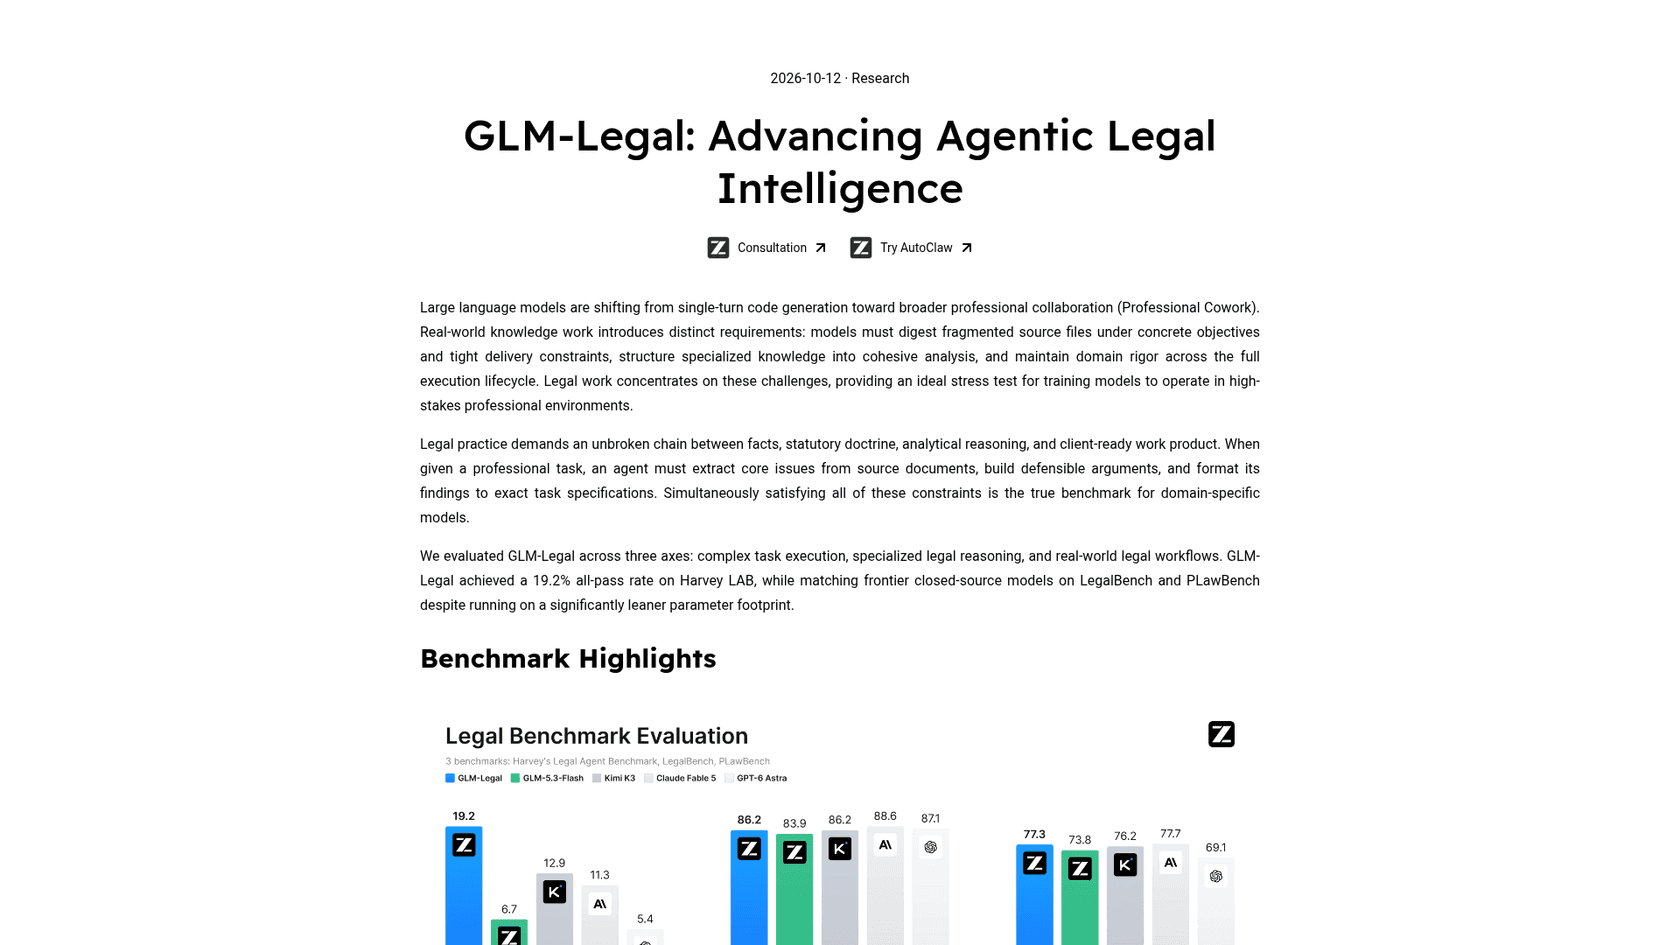
Z.ai a publié GLM-Legal sous la forme d'un article de recherche intitulé "Advancing Agentic Legal Intelligence", avec deux boutons en haut : l'un pour un formulaire de consultation, l'autre pour AutoClaw, son application d'agent de bureau. Le post de lancement sur X dépasse 7 000 mentions J'aime, et le fil Hacker News a atteint 594 points et 332 commentaires.
Voici ce qui est dans la boîte, et ce qui n'y est pas :
| Ce que Z.ai dit ou montre | |
|---|---|
| Modèle de base | GLM-5.3-Flash, un modèle à mélange d'experts de 320 Md de paramètres dont 18 Md actifs |
| Fenêtre de contexte | 1 M de tokens ; 128k de sortie maximale (fiche modèle Vals) |
| Entrée | Texte uniquement dans les tests de Vals, alors que le modèle de base gère les images |
| Travail visé | Relecture de contrats, analyse de preuves, recherche en conformité |
| Utilisateurs visés | Cabinets d'avocats, entreprises de legal tech, équipes internes, avocats indépendants |
| Accès | Essai d'API sur demande ; prise en charge d'AutoClaw "bientôt" |
| Prix | Non publié |
| Poids | Pas de téléchargement sur la page Hugging Face de Z.ai au 14 octobre |
Si vous avez suivi le lancement de GLM-5.2 ou la sortie de Flash en août, le schéma vous sera familier : Z.ai prend un modèle généraliste solide et le braque sur un métier précis. La nouveauté, c'est que ce métier est une profession réglementée et que la sortie est restreinte.
Comment GLM-Legal fonctionne sous le capot
Z.ai décrit trois étapes d'entraînement, et la troisième est la plus intéressante.
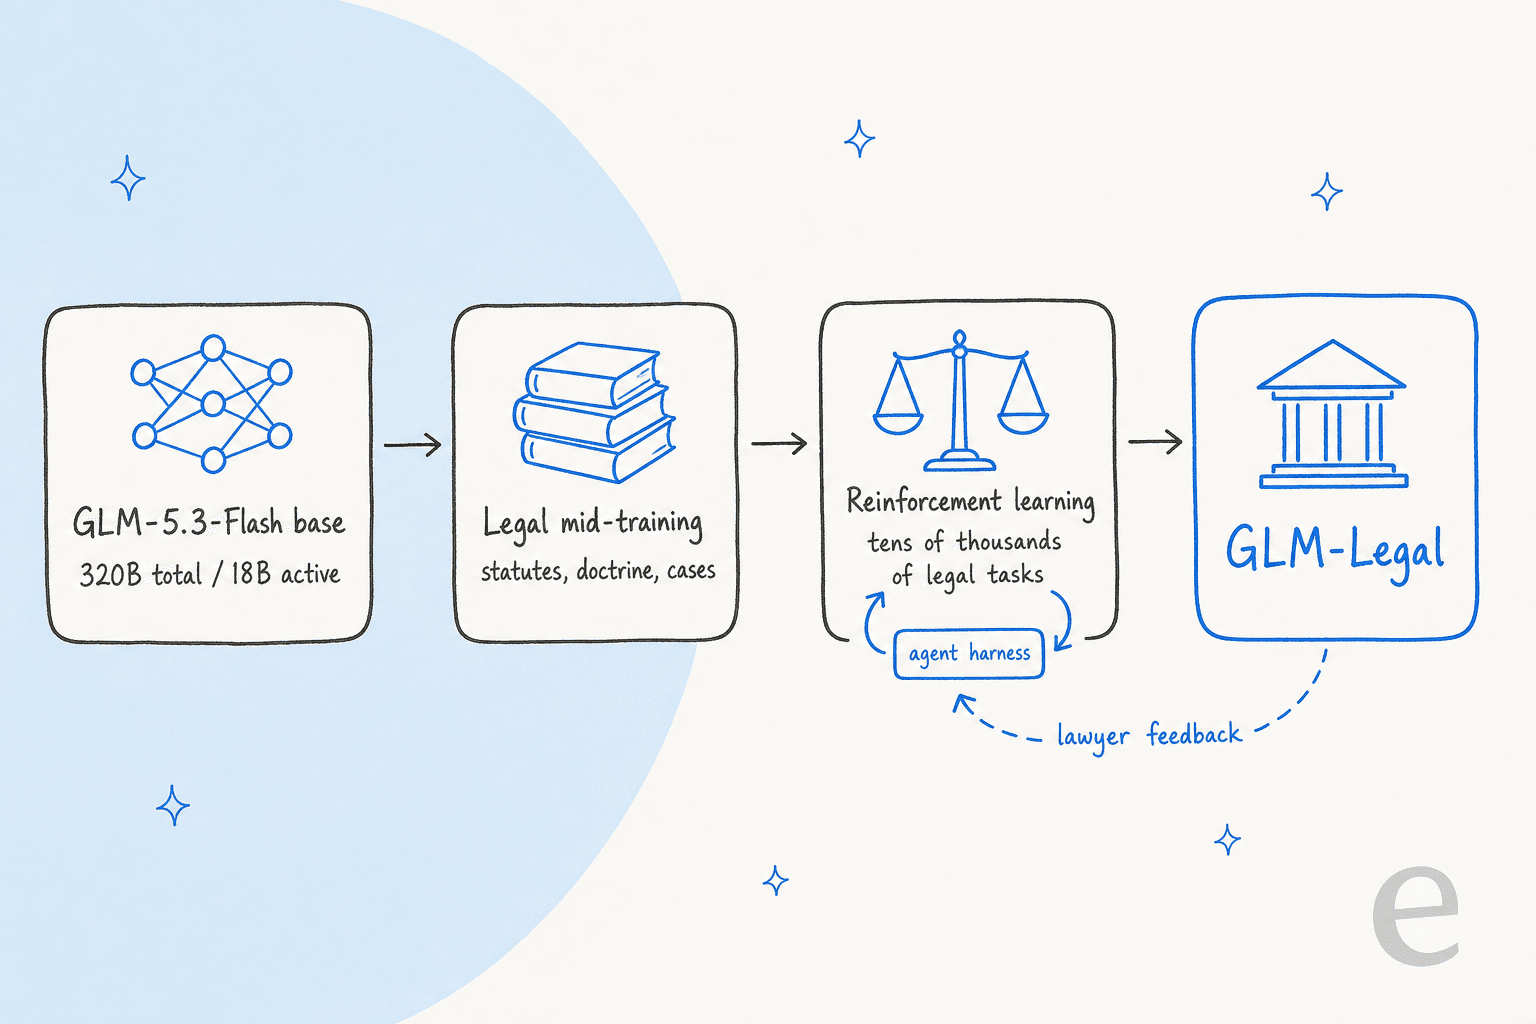
1. Pré-entraînement intermédiaire sur des textes juridiques. Z.ai a "expanded the volume of high-quality legal corpora" pour que le modèle apprenne les lois, la doctrine et la façon dont les juristes les interprètent. C'est le geste classique des LLM spécialisés par domaine et, à lui seul, il aide surtout au rappel.
2. Apprentissage par renforcement dans un harnais d'agent. C'est la partie à laquelle je prêterais attention. Le modèle a été entraîné "across tens of thousands of realistic legal environments", où il planifie une analyse, ouvre des fichiers, rédige un livrable et reçoit une note. Le harnais (le code qui donne au modèle ses fichiers et ses outils) a été entraîné en même temps. Quand le modèle échouait, Z.ai corrigeait aussi le harnais, et inversement.
Je construis des agents sur des modèles généralistes depuis des années, et la plupart des bugs que je traque ne sont pas "le modèle est bête". Ce sont "le modèle n'a pas lu le bon fichier" ou "il a mal formaté la réponse pour l'étape suivante". Entraîner ensemble le modèle et son harnais s'attaque précisément à cette classe d'échecs. Cela veut aussi dire que GLM-Legal se comportera probablement au mieux dans le harnais de Z.ai, AutoClaw, et de façon moins prévisible dans le vôtre.
3. Une boucle avec des avocats en exercice. Z.ai dit que des avocats notent les sorties à partir de questions comme "Are all critical issues and edge cases addressed?" et "Are arguments well-substantiated and citations legally sound?" Ces notes alimentent le tour d'entraînement suivant.
Rien de tout cela n'est publié sous forme d'article avec les sources de données. Un commentateur de HN a fait remarquer que, sans connaître le jeu d'entraînement, on ne peut pas exclure des tâches très proches du test. Gardez-le en tête pour la section suivante.
Les trois démos de Z.ai
L'article de lancement compare GLM-5.3-Flash et GLM-Legal sur les trois mêmes tâches. La différence tient surtout à la précision. Sur un contrat de services logiciels, le modèle de base suggère de "consider shortening the notice period". GLM-Legal dit de le ramener "from 60 to 30 days", de supprimer le délai de remédiation pour les manquements en matière de propriété intellectuelle, de confidentialité et de sécurité des données, et d'ajouter "up to 90 days of transition assistance".
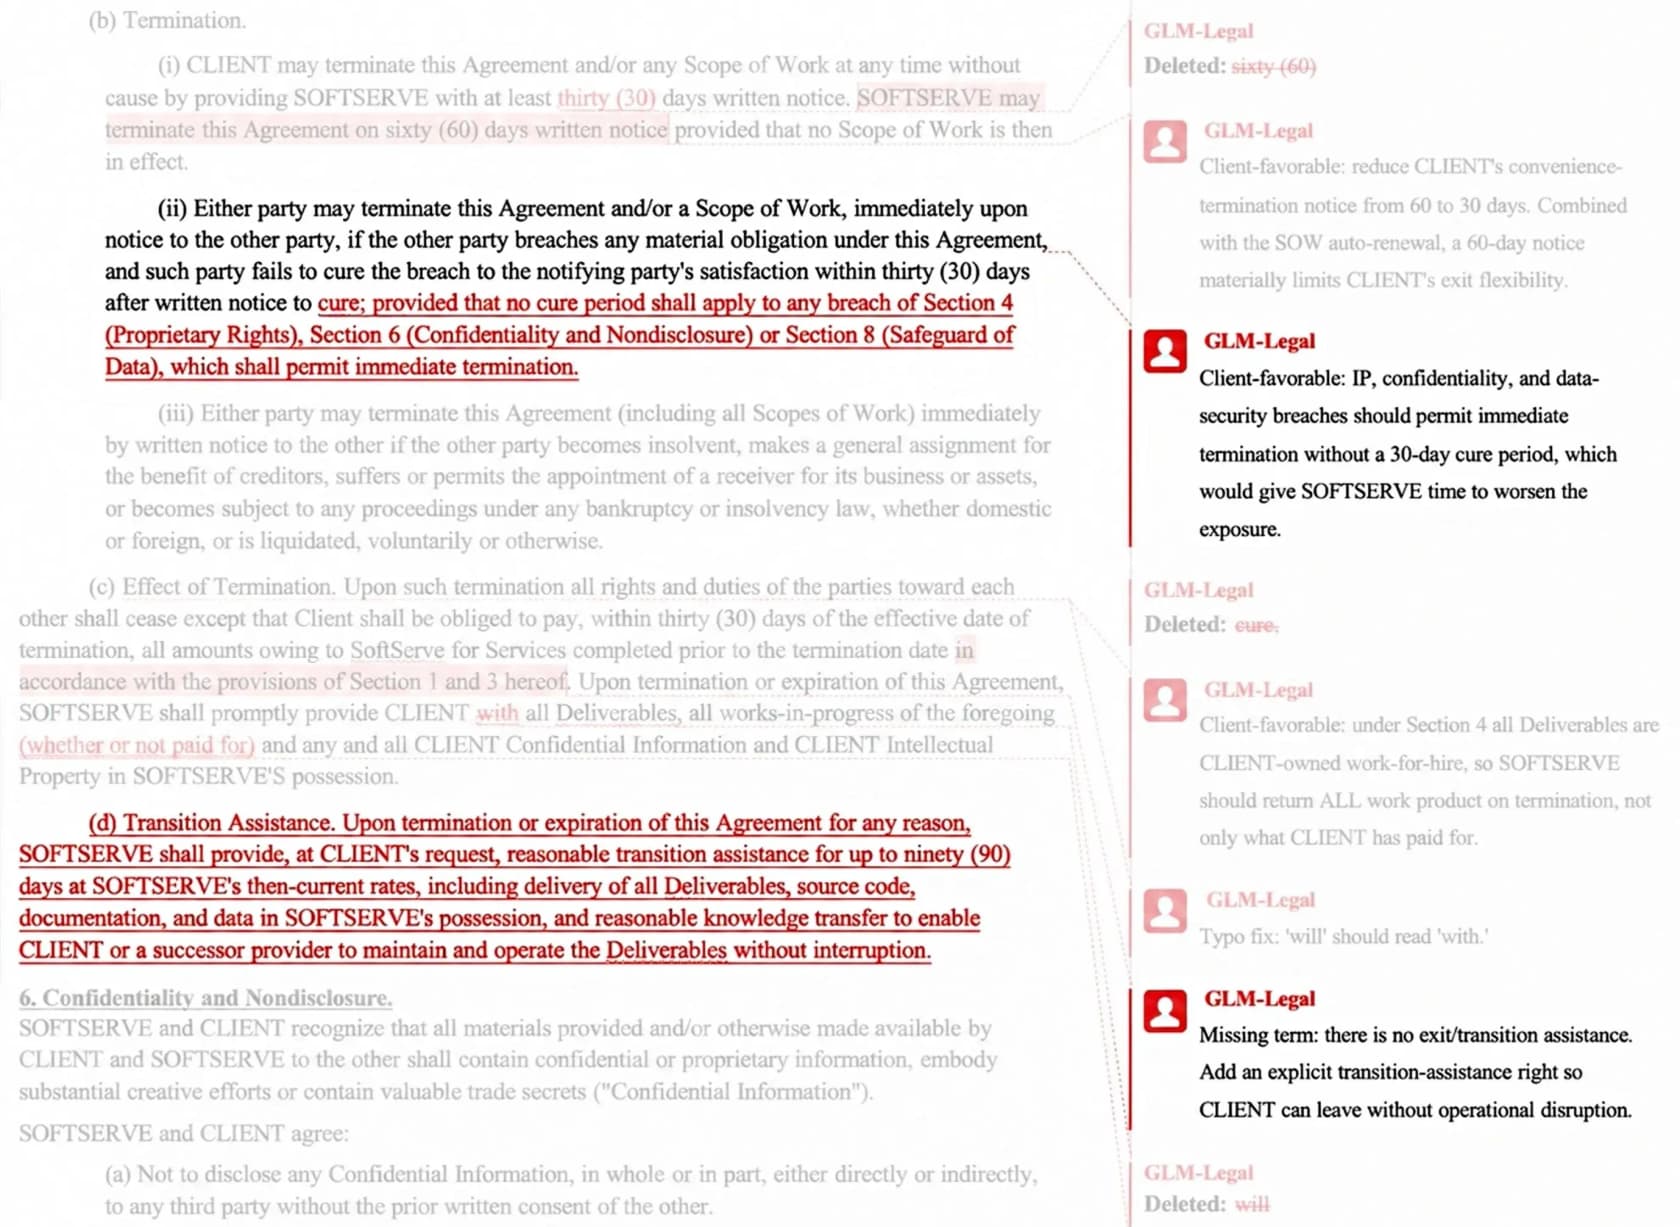
Le résultat arrive sous forme de modifications suivies et de commentaires dans un fichier Word, ce qui est le bon format : un avocat accepte ou rejette chaque modification au lieu de se fier à un résumé.
La deuxième démo lit 40 documents d'un litige sur un projet logiciel et construit une chronologie où chaque entrée renvoie à un numéro de document. GLM-Legal rapproche un rapport client indiquant "60% complete" d'un instantané interne d'environ 41 % et d'un e-mail demandant au personnel de continuer à facturer. La troisième planifie la conformité en matière de vie privée pour un lancement à Singapour, en Malaisie et en Indonésie, avec des renvois aux articles de la loi sur les données de chaque pays.
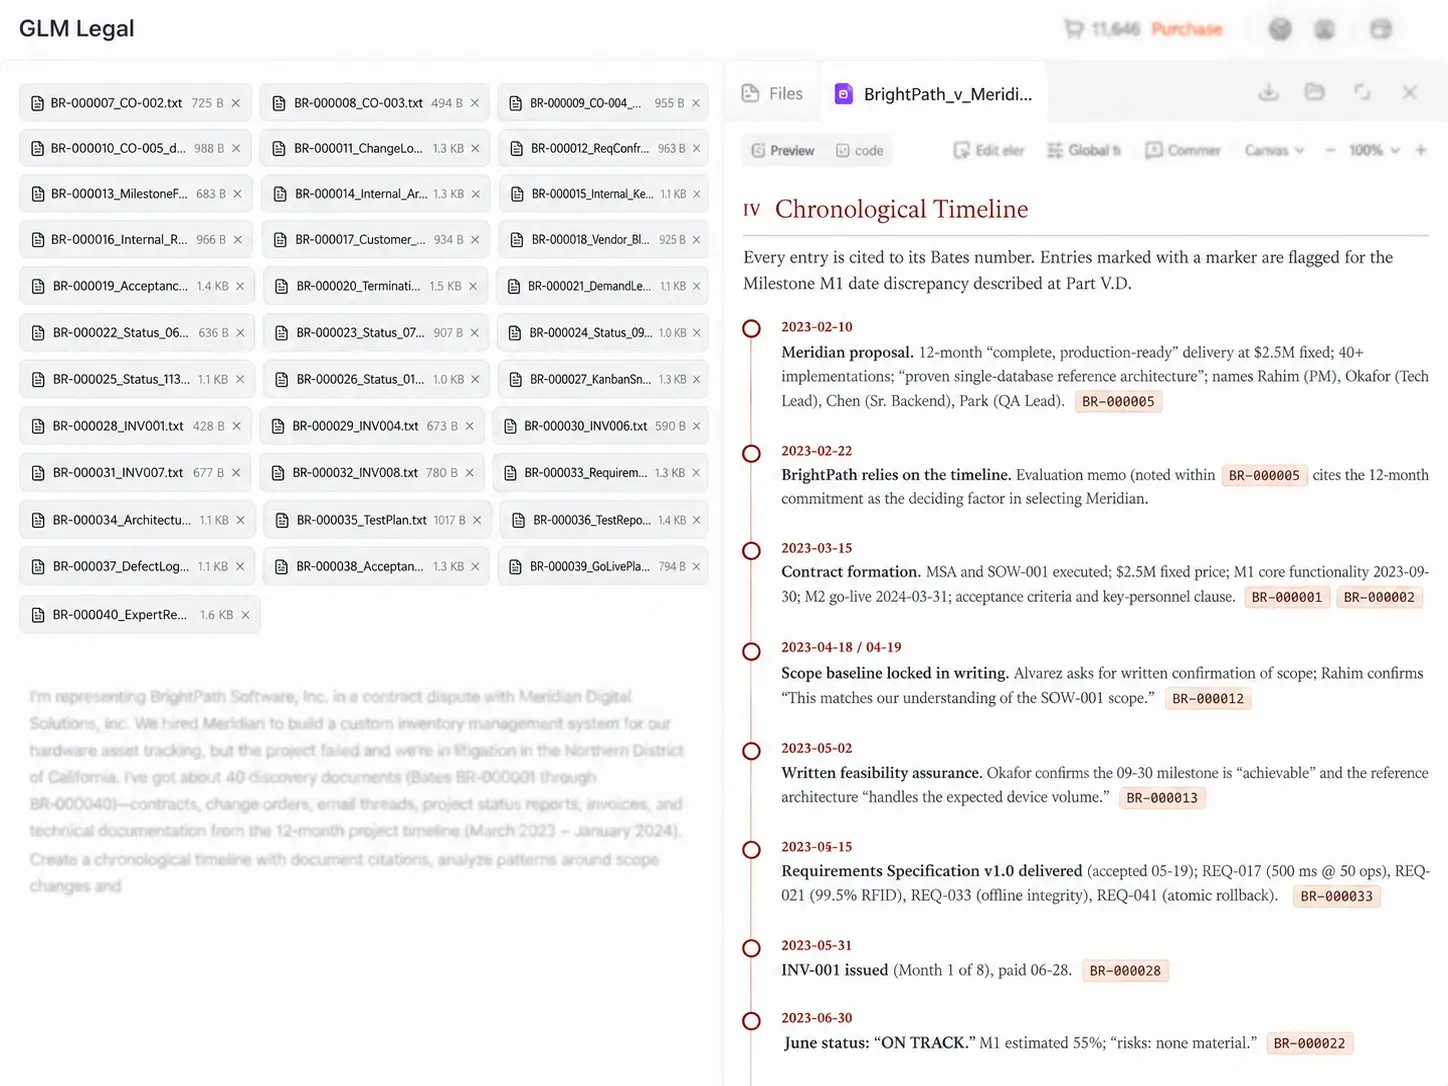
Ces exemples sont sélectionnés par définition. Reste que l'habitude qu'ils montrent (citer le document source pour chaque affirmation) est celle qui rend la sortie d'une IA vérifiable, et en travail juridique, vérifiable compte plus que brillant.
Benchmarks de GLM-Legal : ce que signifient vraiment les 19,2 %
Le graphique de Z.ai compare GLM-Legal à son propre modèle de base, à Kimi K3, à Claude Fable 5 et à GPT-6 Astra sur trois tests.
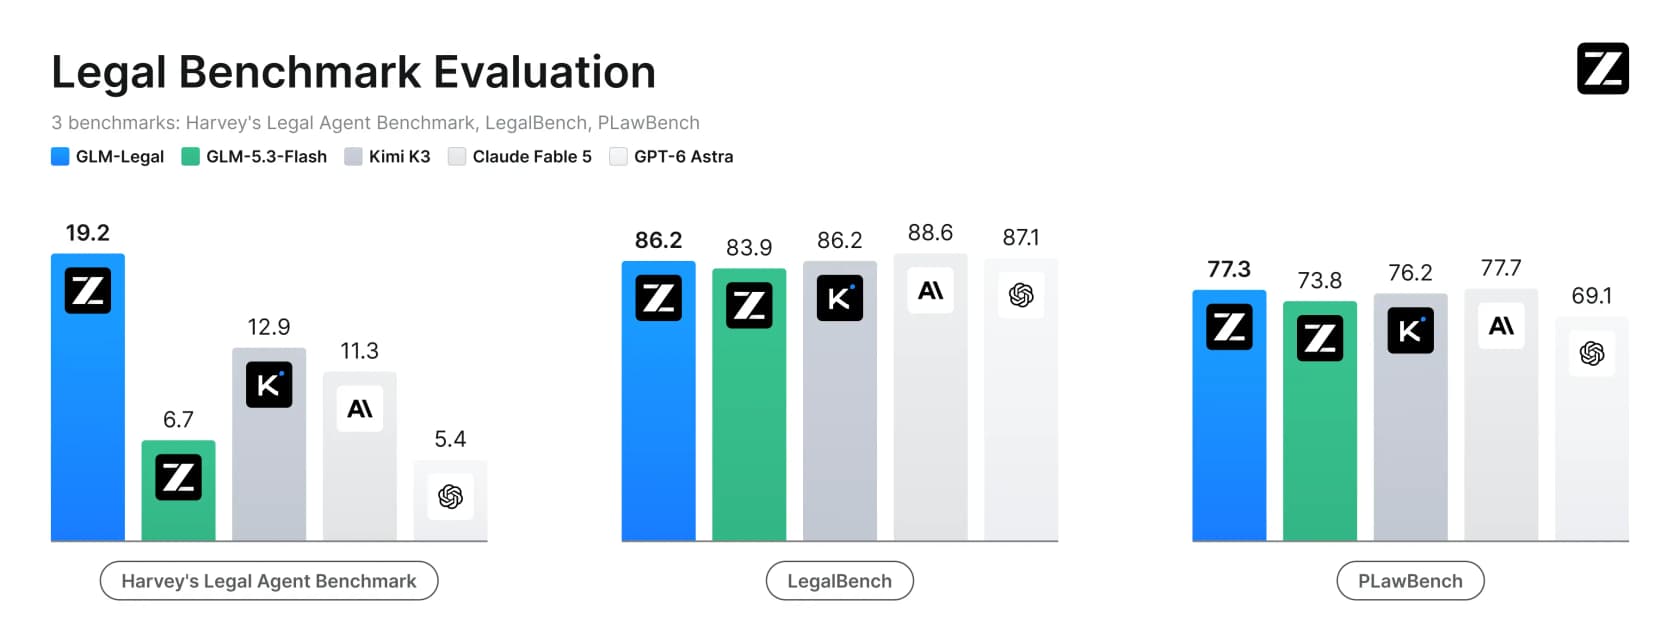
| Benchmark (graphique de Z.ai) | GLM-Legal | GLM-5.3-Flash | Kimi K3 | Claude Fable 5 | GPT-6 Astra |
|---|---|---|---|---|---|
| Harvey Legal Agent Benchmark | 19.2 | 6.7 | 12.9 | 11.3 | 5.4 |
| LegalBench | 86.2 | 83.9 | 86.2 | 88.6 | 87.1 |
| PLawBench (droit chinois) | 77.3 | 73.8 | 76.2 | 77.7 | 69.1 |
Lu de près, "matches frontier models" signifie quelque chose de plus étroit qu'il n'y paraît. GLM-Legal gagne clairement une colonne. Sur LegalBench et PLawBench, il égale Claude Fable 5 ou le suit d'un ou deux points. C'est tout de même un bon résultat pour un modèle de 18 Md de paramètres actifs, mais c'est de la parité sur les tests anciens et une avance sur un test récent.
Pourquoi les scores paraissent si bas
Le Legal Agent Benchmark de Harvey donne à un agent un dossier de fichiers, six outils (lire, modifier et écrire des fichiers, plus la recherche et un shell) et des compétences Word, Excel et PowerPoint. Chaque tâche a une grille de critères, et le chiffre phare est un taux de réussite totale : la tâche ne compte que si chaque critère est validé.
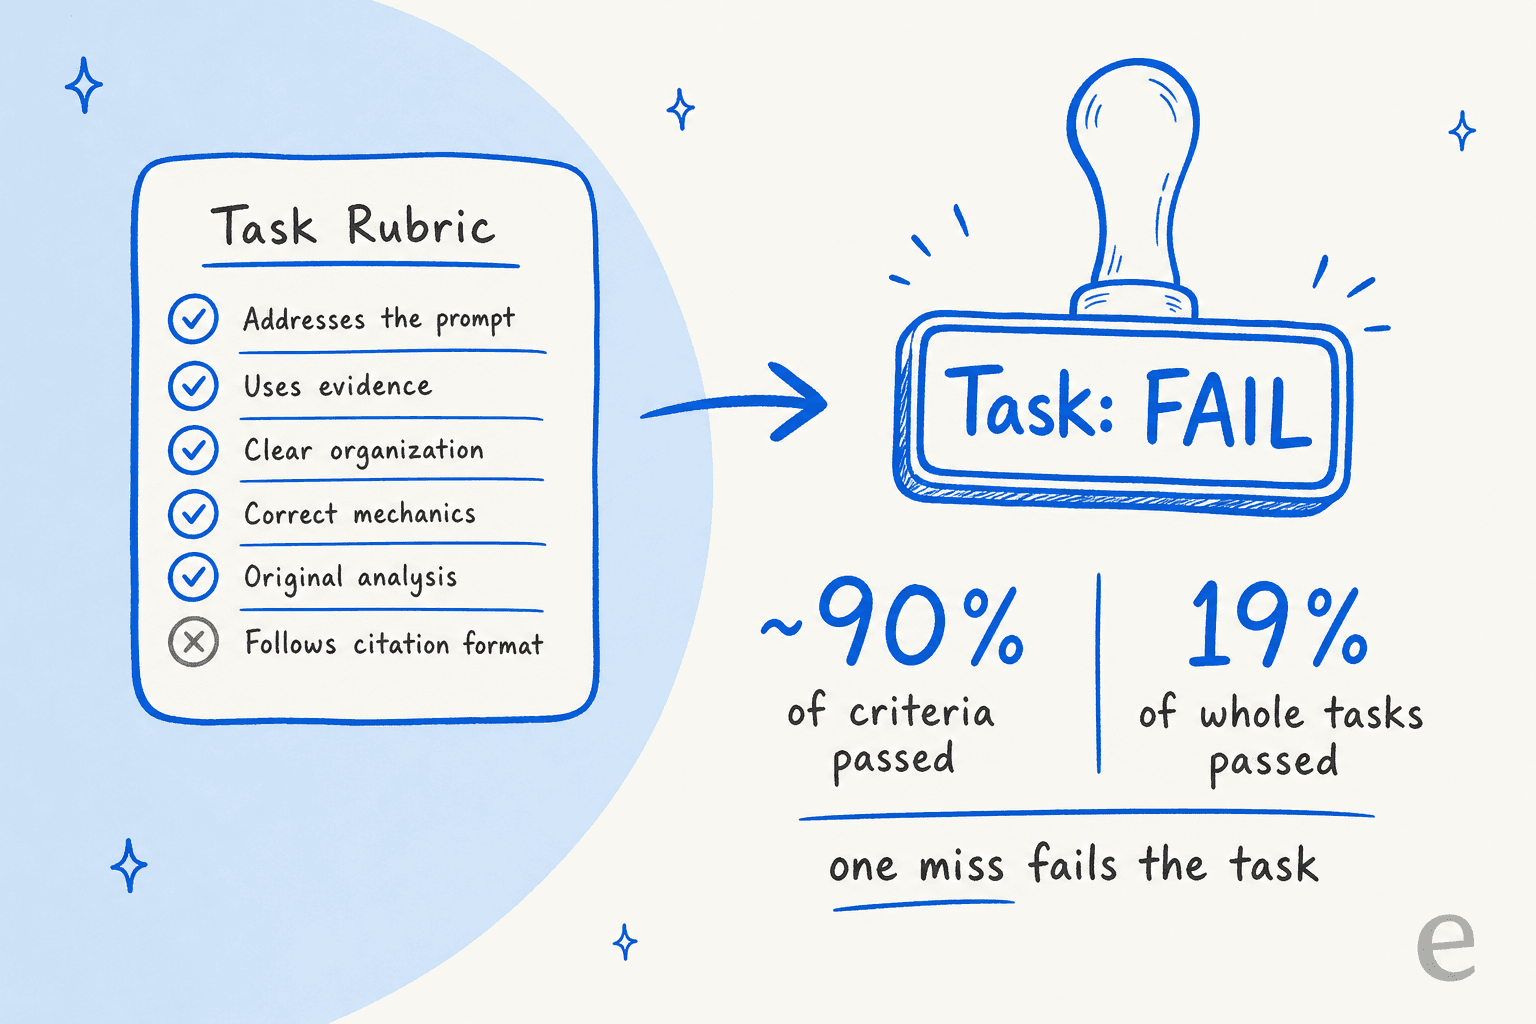
Vals note que les meilleurs modèles valident environ 90 % des critères pris individuellement, alors que le meilleur score par tâche entière est de 25,42 %. Un modèle à 19 % ne se trompe donc pas quatre fois sur cinq. Il réussit généralement l'essentiel du travail et rate une exigence. En droit, cette unique erreur peut être tout le problème, ce qui rend la notation stricte défendable.
"This is why I severely dislike using all pass rate. A model could be at like 93%, meeting practically every requirement except the broken ones and all pass would give it like 20%."

Ce qu'ajoute le classement indépendant
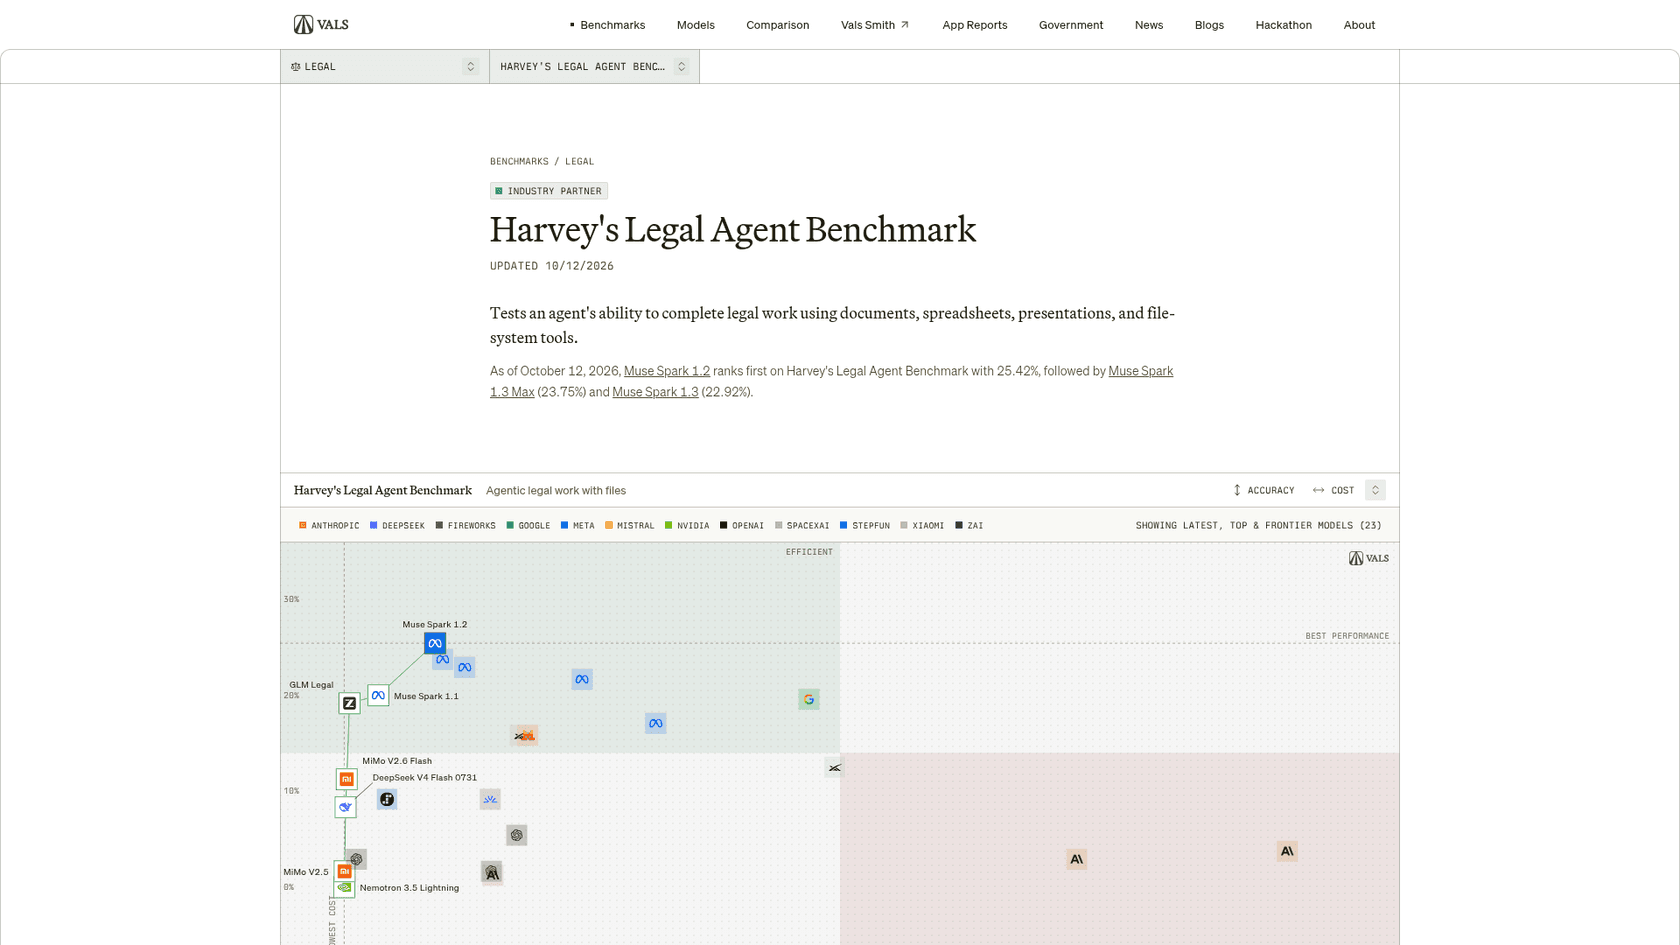
Z.ai a envoyé GLM-Legal à Vals AI pour un test indépendant, et le classement HLAB de Vals est la vue la plus utile car il inclut tout le monde :
| Rang | Modèle | Taux de tâches réussies | Coût par tâche | Temps par tâche |
|---|---|---|---|---|
| 1 | Muse Spark 1.2 | 25.42% | $2.09 | 24m16s |
| 2 | Muse Spark 1.3 Max | 23.75% | $2.26 | 14m43s |
| 3 | Muse Spark 1.3 | 22.92% | $2.76 | 17m04s |
| 4 | Muse Wonder Full | 21.67% | $5.41 | 53m21s |
| 6 | Gemini 4 Argon | 19.58% | $10.55 | 43m55s |
| 7 | GLM-Legal | 19.17% | $0.15 | 1h12m |
| 9 | Mistral Large 4 | 15.83% | $4.18 | 39m25s |
| 12 | Kimi K3 | 12.92% | $3.83 | 13m58s |
| 31 | GLM-5.3-Flash (base) | 6.67% | $0.57 | 52m17s |
| 41 | Claude Opus 5.5 | 3.75% | $21.38 | 52m55s |
Deux choses ressortent. D'abord, le bond de 6,67 % à 19,17 % correspond exactement aux 12,5 points annoncés par Z.ai : le chiffre du fournisseur tient. Ensuite, quatre modèles de Meta battent GLM-Legal et aucun ne figure sur le graphique de Z.ai. Un commentateur de HN l'a relevé le jour du lancement. Sur la page modèle de Vals, GLM-Legal obtient aussi 86,23 % sur LegalBench (14e sur 150, le meilleur résultat d'un GLM) et 41,83 % sur Legal Research Bench (24e sur 78).
Le test de Harvey a lui aussi ses détracteurs. Un commentateur de HN qui a parcouru des traces d'agents dit avoir "found multiple problematic tasks and rubrics" et renvoie à un ticket ouvert sur le dépôt de Harvey. Une marge de ±3,25 points sur un score de 19 % est large. Je traiterais GLM-Legal et Gemini 4 Argon comme à égalité, pas comme classés.
La vraie histoire : le coût par tâche, et l'attente
Si GLM-Legal était arrivé à 19 % pour 10 $ la tâche, personne n'en parlerait. Ce qui compte, c'est la facture.
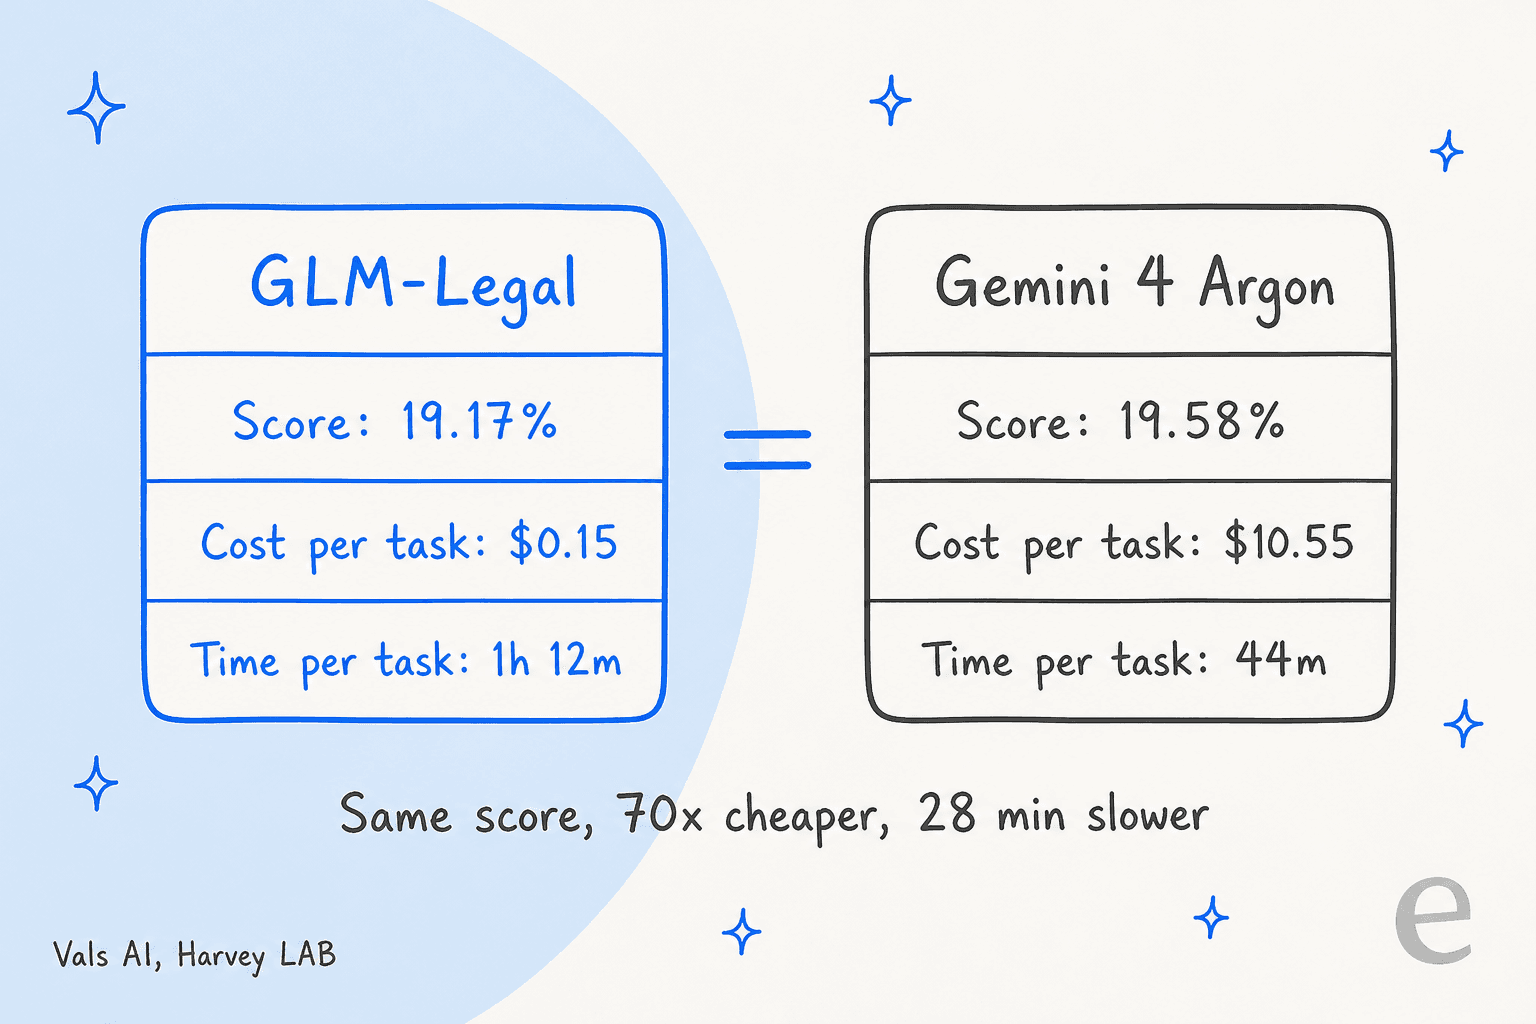
D'après les chiffres de Vals, GLM-Legal atteint le score de Gemini 4 Argon pour environ 1/70 du coût, et Vals le qualifie de modèle le moins cher du top 10. Le revers, c'est le temps : 72 minutes par tâche contre 44 pour Argon et 24 pour le leader. Pour un lot de revues de due diligence lancé la nuit, peu importe. Pour un avocat qui attend un redline avant un appel, si.
Saisissez votre propre volume mensuel de tâches pour voir comment l'arbitrage se joue :
À 500 tâches par mois, les chiffres de Vals donnent environ 75 $ pour GLM-Legal contre 5 275 $ pour Gemini 4 Argon, avec environ 600 heures d'agent contre 366. Muse Spark 1.2 se place entre les deux, autour de 1 045 $, et réussit plus de tâches que l'un comme l'autre. Si l'on ne regarde que le score par dollar, GLM-Legal gagne haut la main. Si l'on regarde les réussites par heure, c'est le modèle de Meta.
Tarifs et accès de GLM-Legal
C'est la partie du lancement qui reste surtout vide. Voici tout ce qui est public aujourd'hui :
| Question | Réponse au 14 octobre 2026 |
|---|---|
| Puis-je m'inscrire et l'utiliser ? | Non. Vous remplissez le formulaire de consultation (entreprise, taille, fonction, cas d'usage) pour demander un accès à l'API |
| Y a-t-il un prix pour GLM-Legal ? | Pas sur la page de tarifs de Z.ai |
| Combien coûte le modèle de base ? | GLM-5.3-Flash : 0,15 $ par 1 M de tokens d'entrée, 0,03 $ en cache, 0,50 $ en sortie |
| À quel tarif Vals a-t-il testé ? | 0,075 $ en entrée et 0,25 $ en sortie, la promotion de lancement de Flash qui s'est terminée le 9 septembre |
| Puis-je l'utiliser dans AutoClaw ? | "Soon", d'après l'article de lancement |
| Puis-je télécharger les poids ? | Pas aujourd'hui ; pas de dépôt GLM-Legal sur la page Hugging Face de Z.ai |
La question des poids n'est pas tranchée. La fiche modèle de Vals indique "Weights: Open", tandis que l'article de lancement de Z.ai ne mentionne jamais de licence et que plusieurs lecteurs de HN en ont conclu qu'il est fermé. Le modèle de base est ouvert, comme le détaille mon test de GLM-5.3-Flash. Tant que Z.ai ne publie ni poids ni licence, je planifierais comme si GLM-Legal était uniquement disponible par API. Pour le détail complet de la grille tarifaire du modèle de base, voir tarifs de GLM-5.3-Flash.
Cela compte pour une raison avant toutes les autres : où vont les documents des clients. Les cabinets qui n'enverront pas un contrat à l'API d'un laboratoire américain ne l'enverront guère à celle d'un laboratoire chinois, et une sortie uniquement par API ferme la voie de l'auto-hébergement qui avait rendu les précédents modèles GLM populaires auprès des équipes sensibles à la confidentialité.
"Wait, so this not an open weight model, correct? Only available via z.ai?"
Ce que disent les avocats et les développeurs
Le fil HN s'est réparti grosso modo en trois camps. Les avocats en exercice n'ont pas été impressionnés par le chiffre absolu :
"As an attorney, I am not particularly impressed about a 20% pass rate on a benchmark. The name of the game for litigation practice is about being prepared for novel situations, not relitigating past ones."
Ceux qui connaissent le benchmark ont plutôt souligné la position relative :
"To be fair to them, on this particular benchmark (Harvey's Legal Agent) 20% puts it almost top of the pack of any model, and certainly top for any remotely in its price class."
Et un troisième groupe s'est inquiété du plus vieux problème de l'IA juridique : la jurisprudence inventée. Un commentateur a noté que le lancement s'appuie sur "tracked changes and human review" mais ne dit rien sur la détection de "LLMs outright hallucinating cases or holdings". Un autre, avocat, a fait une remarque plus fine sur le redlining : "I don't just see what's there but also what is missing." Repérer une clause absente est plus difficile pour un modèle que modifier une clause présente.
Sur X, la réponse la plus populaire à l'annonce de Z.ai était simplement "We need glm illegal", avec plus de 1 200 mentions J'aime. Internet reste Internet.
GLM-Legal face aux modèles de pointe et aux produits d'IA juridique
Trois comparaisons méritent d'être distinguées.
Face aux modèles généralistes de pointe, GLM-Legal gagne sur le test d'agents de Harvey et fait à peu près jeu égal sur LegalBench. Claude Opus 5.5 coûte environ 140 fois plus par tâche dans l'exécution de Vals et obtient 3,75 %. Un modèle généraliste reste le meilleur choix si votre travail juridique est mêlé à tout le reste, ou si vous avez besoin d'une entrée image, que GLM-Legal n'a pas acceptée dans les tests de Vals.
Face à la gamme Muse Spark de Meta, GLM-Legal perd en score et en vitesse. Muse Spark 1.2 réussit un tiers de tâches en plus en un tiers du temps, pour environ 2 $ chacune. Si 2 $ par tâche vous conviennent, le modèle de Meta est aujourd'hui le choix le plus solide.
Face à des produits juridiques comme Harvey AI, ce n'est pas la même catégorie. Harvey vend les workflows, les permissions, les pistes d'audit et le déploiement à l'échelle du cabinet autour de modèles, et son tarif le reflète. GLM-Legal est une brique sur laquelle une entreprise de legal tech pourrait construire. Le commentateur de HN qui se demandait si cela touchait aux marges de Harvey pointait cela : des modèles spécialisés bon marché font de la couche produit la seule chose encore facturable. Mon test de Harvey AI détaille ce que fait réellement cette couche.
Alors, qui devrait demander la bêta ? Les équipes de legal tech qui font de la relecture de premier niveau à gros volume, la nuit (due diligence, tri de contrats, chronologies de discovery), là où un humain vérifie de toute façon chaque sortie. Là, 0,15 $ et 72 minutes sont un excellent compromis. Tous les autres peuvent attendre le prix, les poids et un avis indépendant de quelqu'un qui l'a fait tourner sur de vrais dossiers. Si vous cherchez un outil fini plutôt qu'un modèle, ma liste d'outils d'écriture IA pour cabinets d'avocats est un meilleur point de départ.
Ce que GLM-Legal change si vous dirigez une équipe support
La plupart des gens qui lisent un article sur un modèle juridique ne travaillent pas dans un cabinet d'avocats. Ils dirigent une équipe support ou ops qui répond à des questions à teneur juridique : conditions de remboursement, demandes de garantie, demandes de suppression de données, "can you send me a copy of my data under GDPR."
Un modèle juridique est le mauvais outil pour cela. Ces questions ne portent pas sur la jurisprudence. Elles portent sur votre politique, écrite dans votre centre d'aide et vos documents internes, et la bonne réponse est ce que dit votre politique, même si un modèle plus malin pouvait argumenter autrement. C'est un problème de recherche d'information avec une passation à un humain, pas un problème de raisonnement.
Je passe des années chez eesel à construire les agents qui tiennent de vraies files de support, et la leçon du benchmark de GLM-Legal est celle que nous réapprenons sans cesse : la sortie dangereuse est celle qui passe 90 % des vérifications. Une responsable support d'une marque DTC de compléments alimentaires l'a dit sans détour lors d'un appel avec nous :
"The AI will never be able to answer 100% of the questions... I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
C'est pourquoi nous faisons tourner chaque déploiement eesel sur les tickets historiques d'une équipe avant qu'il réponde à un vrai client, et pourquoi tout ce qui touche aux remboursements, aux menaces juridiques ou à la conformité des données peut être aiguillé directement vers une personne. Notre guide sur les hallucinations couvre la mise en place. Si vous servez vous-même des clients du secteur juridique, le service client IA pour le juridique approfondit ce cas.
Essayer eesel
GLM-Legal est de l'infrastructure : un modèle que vous demandez, branchez à un harnais, auquel vous écrivez des prompts, que vous surveillez et que vous payez au token. eesel est l'employé. Le coéquipier helpdesk IA rejoint votre file existante dans Zendesk, Freshdesk, Gorgias et les autres, apprend vos politiques de remboursement, de garantie et de données à partir de votre centre d'aide et de vos anciens tickets, et confie à un humain, avec un résumé, tout ce dont il n'est pas sûr. Avant qu'il réponde à qui que ce soit, vous pouvez voir comment il aurait répondu à des centaines de vos tickets historiques.

Si votre équipe préfère le piloter depuis un terminal, la CLI eesel permet de lire et de modifier les règles permanentes du coéquipier, de passer en revue les actions en attente d'approbation et de voir ce qu'il a fait et pourquoi, de sorte qu'un agent de code puisse gérer votre coéquipier support comme il gère votre dépôt. Si vous produisez plutôt du contenu, la même équipe inclut un rédacteur de blog IA.
Vous voulez une IA qui répond aux questions de politique à partir de vos propres politiques et sait quand s'arrêter ? Essayez eesel sur les tickets du mois dernier et voyez lesquels il aurait traités.