

Qwen 3.8 Flash Next est un super jouet et une dépendance de production fragile. C'est l'aperçu à poids ouverts d'Alibaba de l'architecture Qwen4, que Qwen décrit lui-même comme volontairement sous-entraînée, servi par un seul fournisseur d'API et assez bavard pour gonfler les factures de sortie. Donc si vous avez aimé le prix et la vitesse mais qu'il vous faut quelque chose de plus abouti, voici où regarder :
- Le jumeau abouti à poids ouverts : GLM 5.3 Flash, que la communauté juge prêt pour la production et qui coûte $0.075/$0.25 en promotion.
- Le plancher budgétaire : DeepSeek V4 Flash (licence MIT) ou Granite 4.2 8B auto-hébergé, à $0.06/$0.25 en hébergé.
- Rester dans la famille : Qwen 3.8 Max, le grand frère stable et hébergé.
- Géré et multimodal : Gemini 3.7 Flash ou GPT-5.6 Luna si vous voulez la fiabilité d'un grand fournisseur.
Et le point le plus important si vous cherchez une « IA pas chère » pour le support : le modèle, c'est les 10 % faciles. Transformer l'un d'eux en quelque chose qui résout réellement des tickets, ce sont les 90 % restants, et c'est un travail de plateforme, pas un choix de modèle.
Pourquoi les gens quittent Qwen 3.8 Flash Next
Je construis des agents IA chez eesel, donc je vois le segment des modèles économiques se renouveler toutes les quelques semaines, et Qwen 3.8 Flash Next a été l'un des lancements les plus bruyants de l'été. Le fil Hacker News a atteint 698 points et r/LocalLLaMA a tenu un mégafil de plus de 650 commentaires. L'enthousiasme est réel : l'activation parcimonieuse et une table N-gram de 51B déportable permettent de faire tourner un modèle de 125B sur un portable à mémoire unifiée.
Mais en lisant au-delà des graphiques du lancement, une liste claire de raisons de changer se dégage. Voici la version honnête de ce à quoi vous vous engagez :
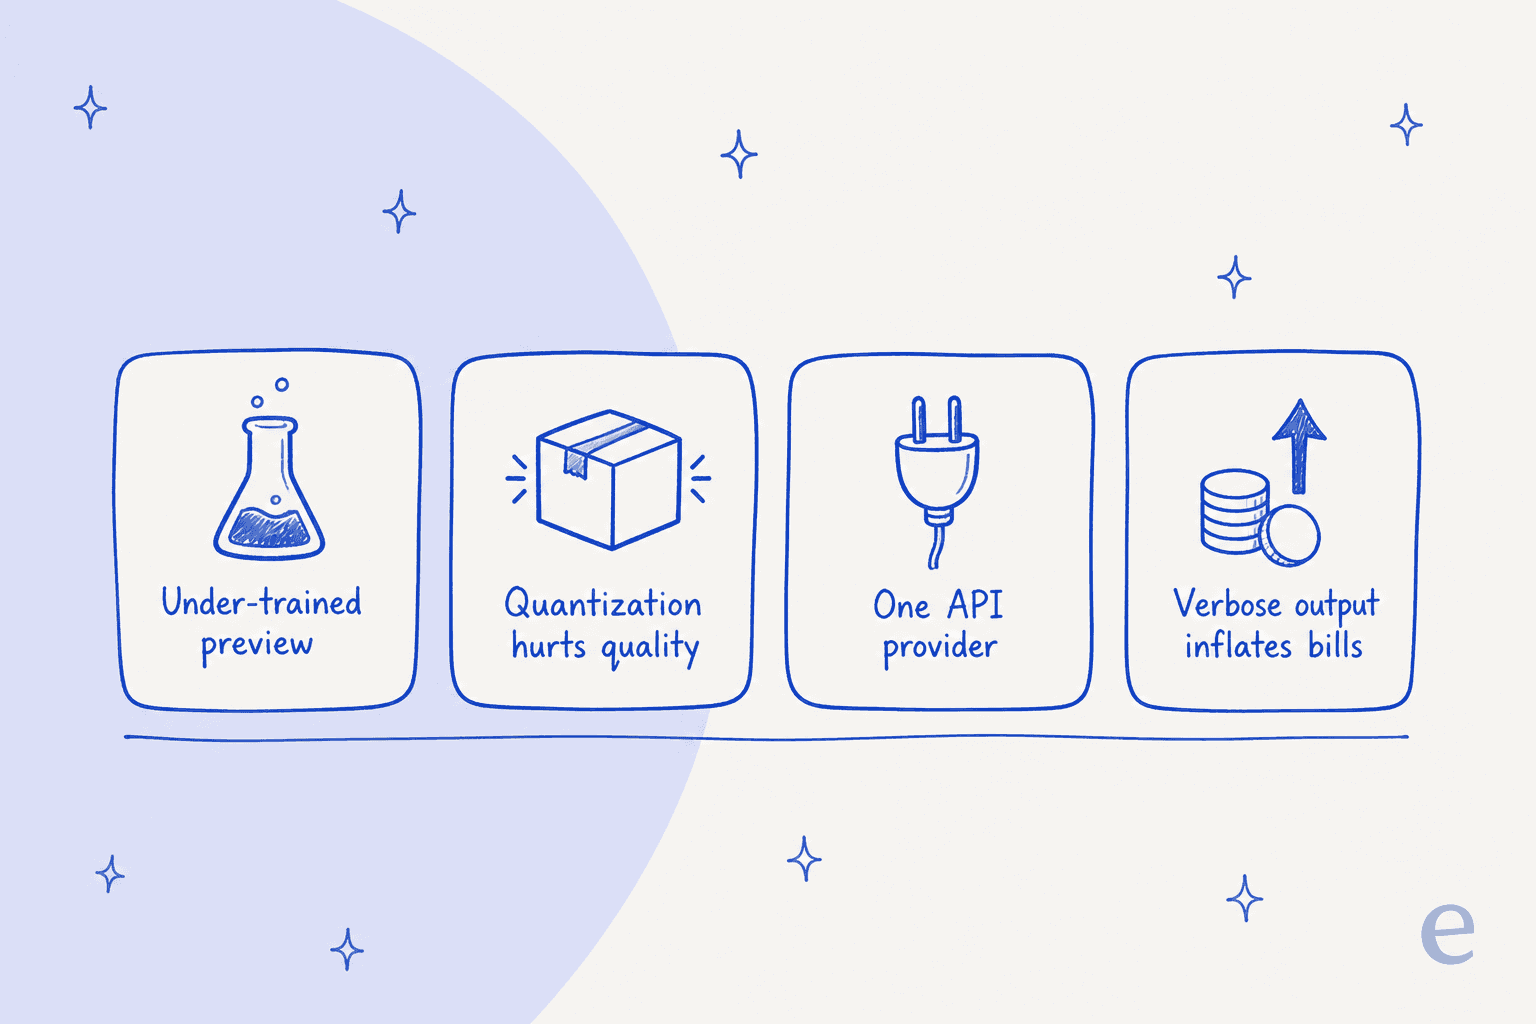
La voix la plus claire sur ce que « Next » signifie vraiment est venue du fil du lancement :
"This model is a preview of Qwen's upcoming Qwen4 architecture... They said the model is intentionally under-trained since it is mainly for R&D purposes of proving the new architecture."

Il y a ensuite la taxe de quantification. Simon Willison l'a exécuté à plusieurs niveaux de raisonnement sur un DGX Spark et a fini par préférer le plus petit modèle dense, en blâmant la quantification faible en bits nécessaire pour le faire tenir. En outre, l'API hébergée de Qwen3.8-Flash n'a actuellement qu'un seul fournisseur, Alibaba Cloud International, donc pas de basculement possible. Et les tests indépendants d'Artificial Analysis le signalent comme « very verbose » : il brûle 200M de tokens de sortie pour terminer son Index contre une médiane de 110M, ce qui gonfle discrètement toute facture axée sur la sortie.
Rien de tout cela n'en fait un mauvais modèle. Cela en fait un aperçu. Si vous voulez quelque chose sur lequel vous appuyer ce trimestre, les huit ci-dessous sont là où atterrit ce même public.
Comment j'ai choisi ces alternatives
J'ai limité la sélection aux modèles qui règlent au moins un des quatre problèmes de Flash Next ci-dessus, et j'ai privilégié les chiffres indépendants aux tableaux des éditeurs partout où ils existent. Concrètement, chaque choix devait remplir un cahier des charges :
- Des prix réels et vérifiables. Un tarif publié par token ou des poids ouverts gratuits, pas « contactez les ventes ».
- Une version qui donne l'impression d'être aboutie, ou une remarque honnête quand ce n'est pas le cas.
- Un score indépendant vérifiable là où il existe (surtout l'Intelligence Index d'Artificial Analysis), pour ne pas me contenter de citer un blog de lancement.
- Un rôle distinct. Aucun duo n'est « pareil mais un peu moins cher », chacun gagne sur un cas d'usage différent.
Une chose que je n'ai pas faite : faire comme si un benchmark était un agent de support. J'y reviens à la fin.
Les alternatives à Qwen 3.8 Flash Next en un coup d'œil
Voici toute la sélection au même endroit. Les prix sont les tarifs d'API hébergée par 1M de tokens (entrée/sortie) ; chaque modèle à poids ouverts peut aussi être auto-hébergé gratuitement si vous avez le matériel.
| # | Modèle | Idéal pour | Type | Contexte | Prix ent./sortie (par 1M) | Licence |
|---|---|---|---|---|---|---|
| 1 | GLM 5.3 Flash | Jumeau abouti à poids ouverts | Ouvert + hébergé | 1M | $0.075 / $0.25 (promo) | Poids ouverts |
| 2 | DeepSeek V4 Flash | Plancher budgétaire, MIT | Ouvert + hébergé | 1M | $0.22 / $0.66 (heures creuses) | MIT |
| 3 | Qwen 3.8 Max | Rester dans la famille Qwen | Ouvert + hébergé | 1M | $2.00 / $6.00 | Licence Qwen |
| 4 | Kimi K3 | Travail agentique de longue haleine | Ouvert + hébergé | 1M | $3.00 / $15.00 | Poids ouverts |
| 5 | Gemini 3.7 Flash | Multimodal géré | Hébergé | ~1M | $0.75 / $3.75 (promo) | Fermé |
| 6 | GPT-5.6 Luna | Fiabilité d'écosystème fermé | Hébergé | Grand | $0.20 / $1.20 | Fermé |
| 7 | Granite 4.2 | Entreprise / on-prem | Ouvert + hébergé | 128K | $0.06 / $0.25 (Replicate 8B) | Apache 2.0 |
| 8 | LongCat 2.0 | Grand MoE MIT en joker | Ouvert + hébergé | 256K | $0.30 / $1.20 (promo) | MIT |
Un exemple rapide, parce que les tarifs affichés cachent l'écart réel. Supposons qu'une charge agentique mensuelle utilise 50M de tokens d'entrée et 15M de sortie. Avec la promotion de GLM 5.3 Flash, cela fait environ $7.50 ; avec Granite 4.2 8B via Replicate, à peu près $6.75 ; avec Qwen3.8-Flash hébergé lui-même, environ $14.55 ; avec Gemini 3.7 Flash, près de $94 ; et avec Kimi K3, autour de $375. Même travail, un écart de 50x. Ce sont les tokens de sortie, et non ceux d'entrée, où les modèles de raisonnement enfouissent discrètement le coût.
1. GLM 5.3 Flash, le jumeau abouti à poids ouverts
Idéal pour : les équipes qui ont aimé la classe économique à poids ouverts de Flash Next mais qui veulent quelque chose qui semble déjà fini.
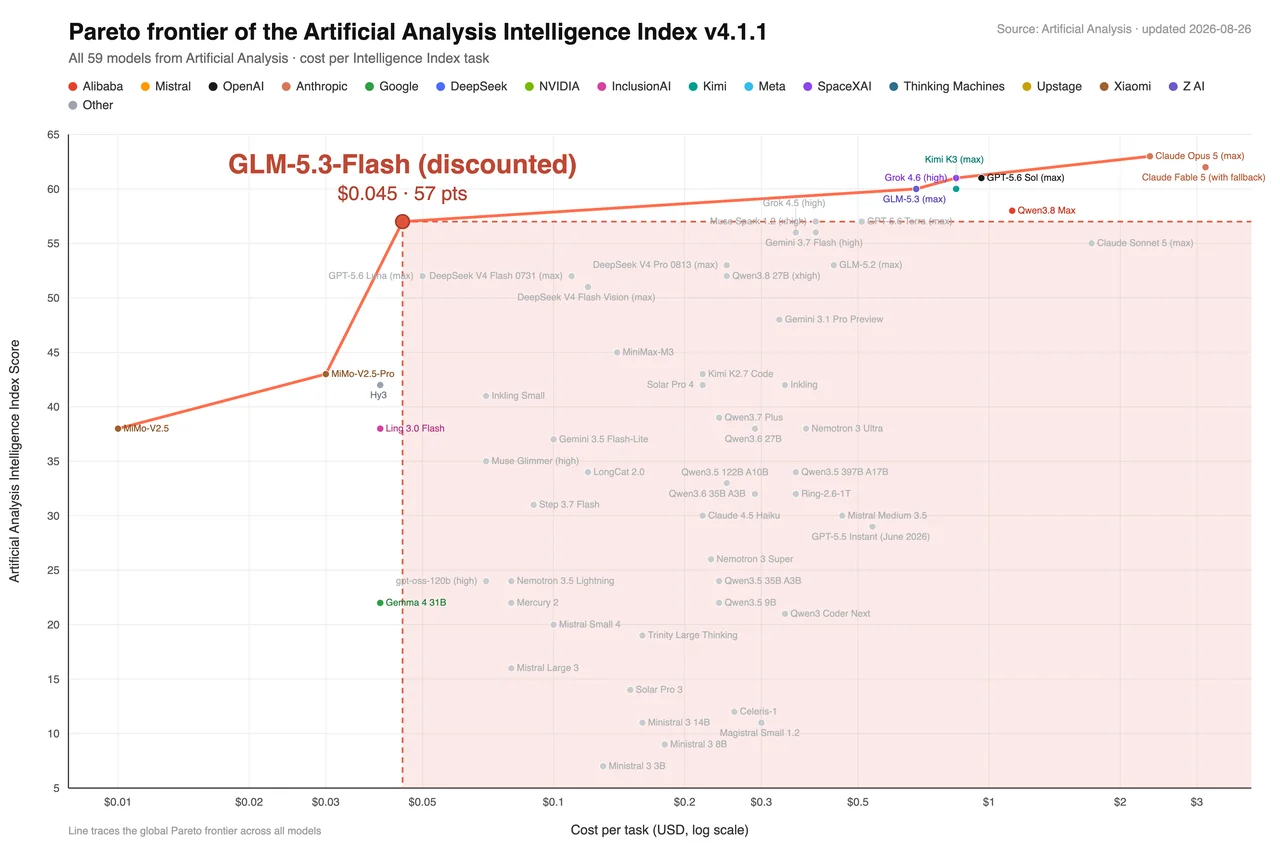
C'est celui vers lequel la communauté renvoie sans cesse les bricoleurs de Flash Next, et pour de bonnes raisons. GLM 5.3 Flash, de Z.ai (Zhipu), est sorti la même semaine, le 26 août 2026, comme premier modèle GLM-5 nativement multimodal : 320B au total dont 18B actifs dans une architecture à mélange d'experts, un contexte de 1M de tokens et des poids ouverts sur Hugging Face. Sous le nom de code « ox-alpha », il a brièvement été numéro un sur OpenRouter en volume de tokens.
Point crucial : il obtient des scores de modèle abouti. Artificial Analysis lui attribue un Intelligence Index de 57 pour environ $0.045 par tâche, et les premiers testeurs ont été directs sur la valeur :
"Noticeably cheaper even than Gemini Flash 3.7, while being only slightly worse performing. That's actually really impressive."

Points forts : niveau production malgré le prix bas, réellement multimodal, poids ouverts et un GLM Coding Plan dédié à $18/$80/$168 par mois si vous vivez dans un IDE.
Points faibles : il ne fait que réfléchir, vous ne pouvez donc pas désactiver le raisonnement pour gagner en latence, et l'API officielle est lente (environ 49 tokens/seconde), si bien que les gros utilisateurs passent par des fournisseurs comme Databricks pour la vitesse.
Tarifs : promo $0.075 en entrée / $0.25 en sortie par 1M (tarif public $0.15/$0.50), entrée en cache $0.015, la promotion courant jusqu'au 9 septembre 2026.
Verdict : si vous voulez l'expérience Flash Next sans l'astérisque « aperçu », commencez ici. C'est ce qui se rapproche le plus d'une mise à niveau équivalente dans cette liste.
2. DeepSeek V4 Flash, le plancher budgétaire
Idéal pour : les obsédés du prix qui veulent aussi une licence permissive.
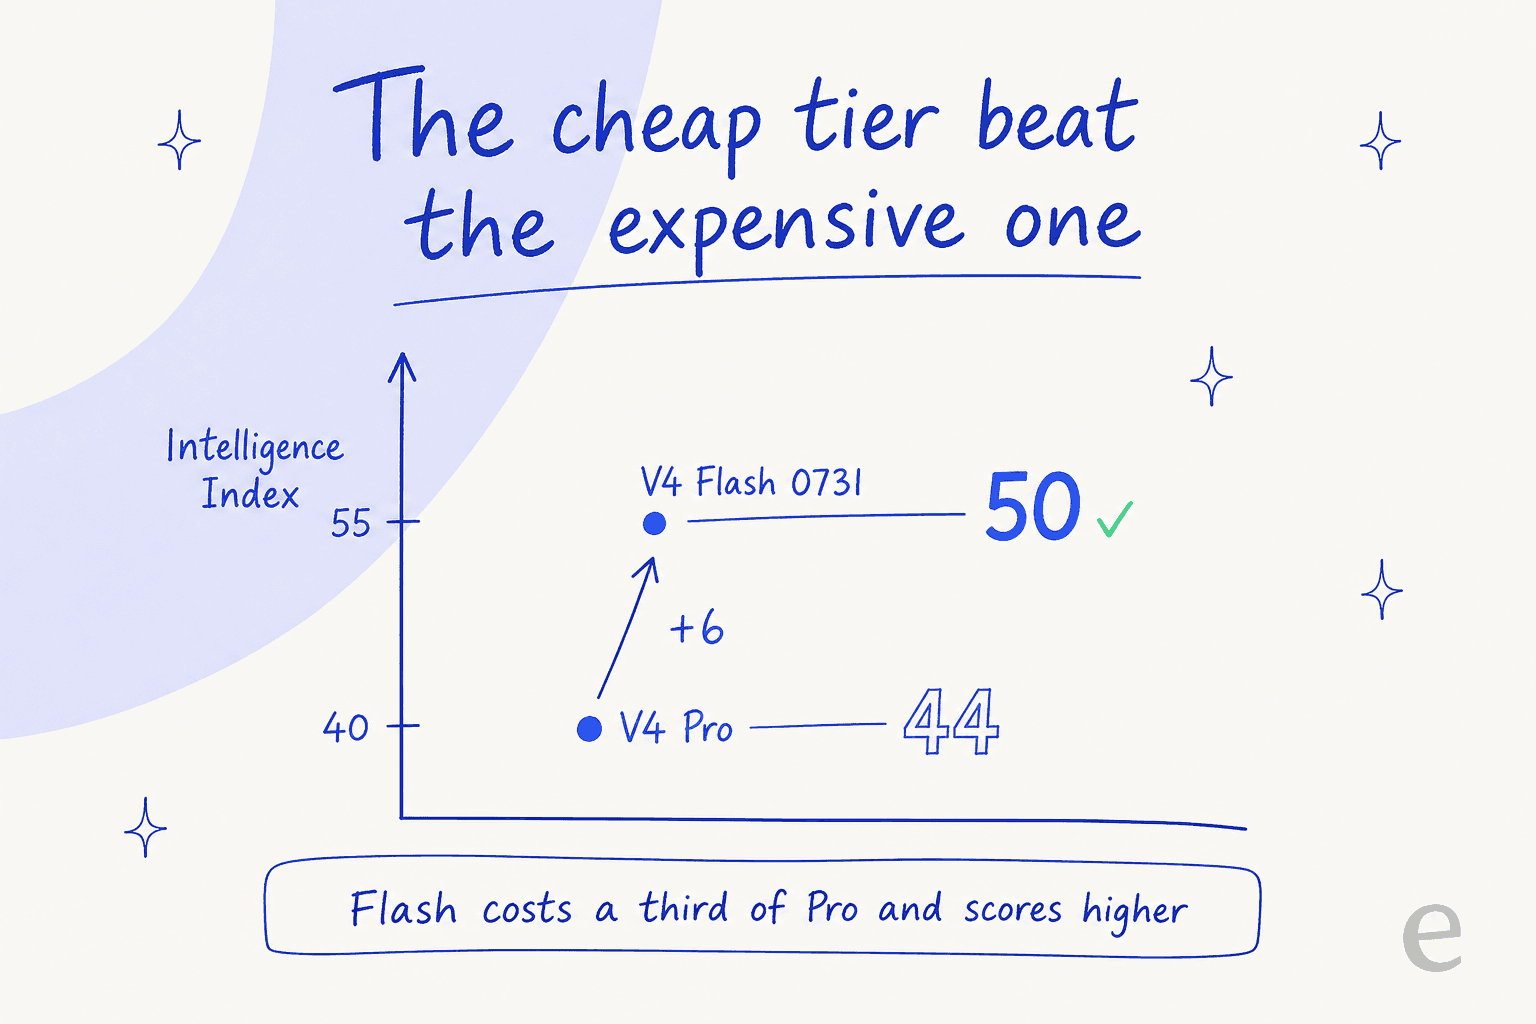
DeepSeek V4 Flash est un MoE de 284B au total et 13B actifs avec un contexte de 1M et, fait inhabituel pour cette classe, de vrais poids ouverts MIT (environ 167GB, avec des dizaines de quantifications communautaires). Le tour de force qui le fait aimer : les tests indépendants montrent le niveau Flash, moins cher, battant en réalité le V4 Pro, plus coûteux, sur des tâches agentiques de longue haleine, un point qu'un ingénieur en chef a bien résumé :
"DeepSeek V4 Flash is the most cost effective model we've tested... Pro is slower and smarter in one-shot reasoning problems, but less effective with tools and therefore less performant in long horizon agentic tasks."
Il y a deux pièges honnêtes. DeepSeek a révisé ses tarifs en août 2026 et applique désormais un supplément heures de pointe/heures creuses, avec des pointes de 01:00-04:00 et 06:00-10:00 UTC : une file américaine ou européenne est donc surtout facturée en heures creuses, mais un traitement par lots programmé pendant les heures de bureau chinoises paie le double. Et il hallucine plus qu'on le voudrait ; un utilisateur l'a dit sans détour :
"DeepSeek V4 hallucinates like crazy and often forgets explicitly mentioned parts of the context."
Points forts : le coût par token réel le plus bas de tous les modèles hébergés ici, poids MIT et un bon profil d'utilisation d'outils.
Points faibles : bavard (environ 210M de tokens de sortie pour exécuter l'Index), texte uniquement (aucune entrée d'image documentée), et les conditions de l'API payante ne disent rien sur l'usage pour l'entraînement, ce n'est donc pas un remplacement direct pour des données clients. Pour la comparaison complète, voyez notre analyse DeepSeek vs Kimi K3.
Tarifs : heures creuses/pointe, entrée sans cache $0.22/$0.44, sortie $0.66/$1.32, entrée avec cache dès $0.007.
Verdict : le roi du rapport qualité-prix, à condition de modéliser les tokens de sortie et de garder les données clients hors du point d'accès officiel.
3. Qwen 3.8 Max, le choix pour rester dans la famille
Idéal pour : ceux qui aiment l'écosystème Qwen mais veulent le modèle phare abouti et hébergé plutôt qu'un aperçu.
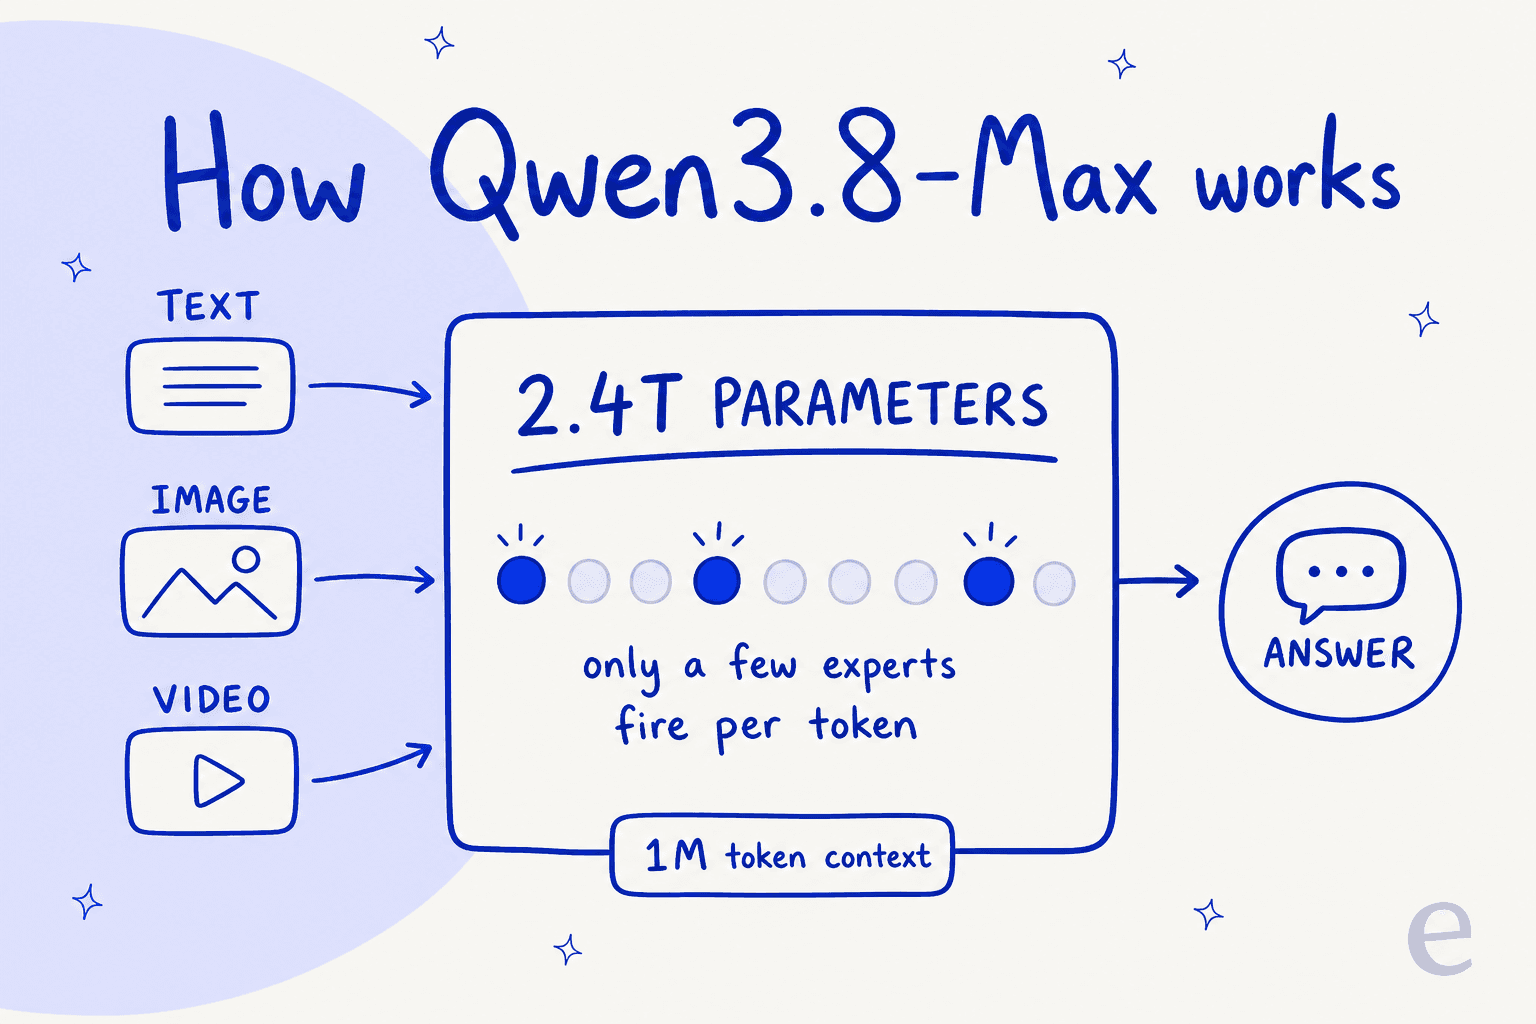
Si Flash Next est l'aperçu de recherche, Qwen 3.8 Max est le produit livré. Il est passé en disponibilité générale le 2 août 2026 : un MoE de 2.4T au total et 95B actifs avec un contexte de 1M, 131,072 de sortie maximale et des extras hébergés absents de la base ouverte (entrée vision, un mode sans réflexion et des outils intégrés). Les poids sont sortis en août eux aussi, mais sous la licence Qwen plutôt qu'Apache.
Sur le classement indépendant, il tient la route : Artificial Analysis le place au rang 6 avec un Intelligence Index d'environ 58 pour environ $1.13 par tâche, et sur LMArena il est dans le top cinq en texte et deuxième en vision. Si vous voulez un seul chiffre, n'en prenez pas ; le score composite automatisé et la préférence humaine pointent dans des directions légèrement différentes, ce qui est en soi un bon rappel de ne pas se fier à un seul benchmark.
Points forts : stable, hébergé, réellement multimodal, et il vous garde dans l'outillage que vous utilisez peut-être déjà avec Flash Next.
Points faibles : un ordre de grandeur plus cher que le niveau Flash, et les poids ouverts n'offrent pas les mêmes fonctions que la version hébergée.
Tarifs : $2 en entrée / $6 en sortie par 1M, avec lectures de cache implicite à $0.25.
Verdict : le choix sans histoires pour les fidèles de Qwen qui ont davantage besoin de stabilité en production que du prix plancher de Flash. Si vous hésitez, notre guide d'accès détaille les voies possibles.
4. Kimi K3, le choix agentique de longue haleine
Idéal pour : les exécutions d'agents complexes en plusieurs étapes où la capacité compte plus que le coût.
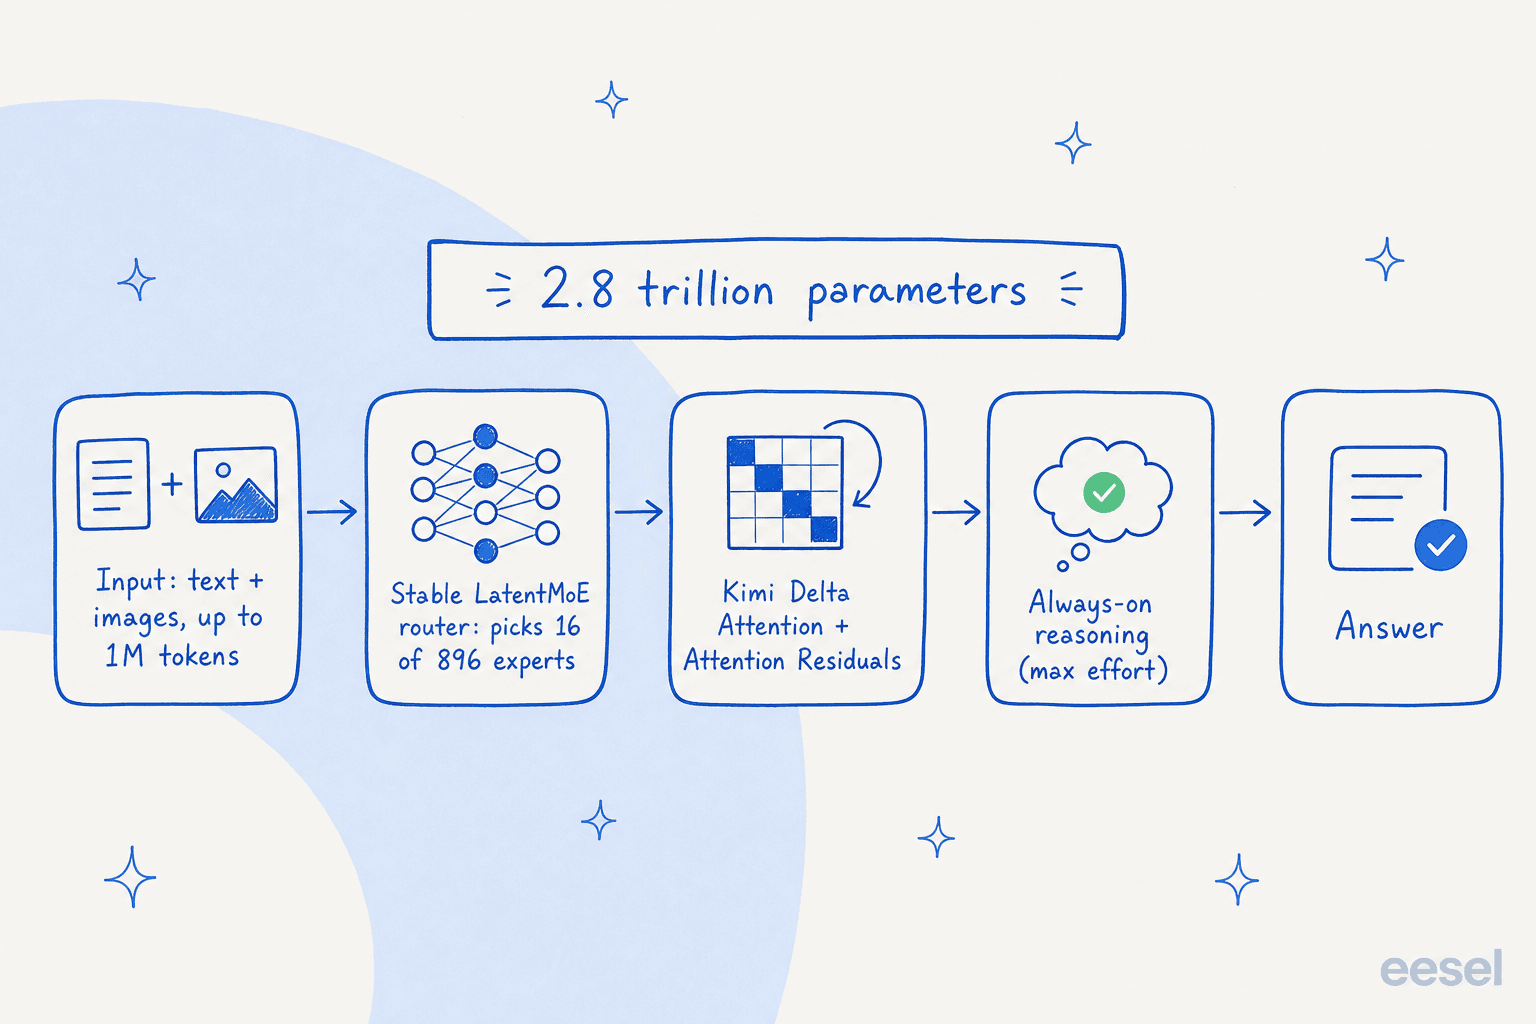
Kimi K3 de Moonshot est le poids lourd de cette liste : 2.8T de paramètres au total dont 104B actifs, un contexte de 1M, la vision native et des poids ouverts sortis à l'heure le 27 juillet 2026. Son Intelligence Index Artificial Analysis de 57 le place quatrième au général, et c'est un modèle agentique et de code vraiment solide.
Le hic, c'est le prix. K3 coûte $3 en entrée / $15 en sortie par 1M, la même fourchette qu'un modèle fermé de pointe et environ 50x le tarif de sortie de DeepSeek V4 Flash. Le raisonnement ne peut en outre pas être désactivé, donc même un appel simple paie la taxe de réflexion ; le niveau d'effort le plus bas obtient un moins bon score et coûte plus par tâche que DeepSeek. Ce n'est pas une alternative économique à Flash Next ; c'est une alternative de capacité.
Points forts : performances agentiques de premier plan, un énorme contexte, poids ouverts et vision native.
Points faibles : tarifs de modèle de pointe, raisonnement toujours actif, et l'API de vision refuse les URL d'images publiques (base64 ou ID de fichier uniquement).
Tarifs : $3 en entrée / $15 en sortie par 1M, entrée avec cache $0.30.
Verdict : sortez K3 quand la tâche est assez difficile pour justifier la facture. Pour le travail quotidien, économique et rapide, c'est le mauvais outil.
5. Gemini 3.7 Flash, le choix multimodal géré
Idéal pour : les équipes qui veulent la fiabilité d'un grand fournisseur, une bonne entrée multimodale et aucun auto-hébergement.
Si toute l'histoire de l'auto-hébergement vous semble un passe-temps pour lequel vous n'avez pas le temps, Gemini 3.7 Flash est la réponse gérée. Il est passé en disponibilité générale le 13 août 2026 et c'est le modèle le plus rapide qu'Artificial Analysis ait mesuré, à 340 tokens/seconde (rang #1 sur 188). Ce qu'il faut savoir à l'achat : le niveau d'effort de raisonnement choisi fait fortement varier coût et qualité. En low, il obtient 50.9 à l'Index pour $0.16 par tâche ; en high, il atteint 56.0 mais grimpe à $0.40. Laisser la valeur par défaut medium revient souvent à payer trop.
Deux réserves le gardent honnête. Google a supprimé le niveau de réflexion minimal qui faisait des anciens Flash le plancher le moins cher pour l'OCR et la classification. Et le taux d'hallucination a régressé à 64.5 % contre 55.6 % pour 3.6 Flash, même si la précision s'est améliorée, exactement le genre de chose que vous voulez repérer avant la mise en production.
Points forts : géré et fiable, débit de premier plan, bons scores en long contexte et en usage d'ordinateur, et un prix promo qui égale aujourd'hui celui de 3.6 Flash.
Points faibles : poids fermés, un taux d'hallucination plus élevé que son prédécesseur et un prix qui double en janvier 2027.
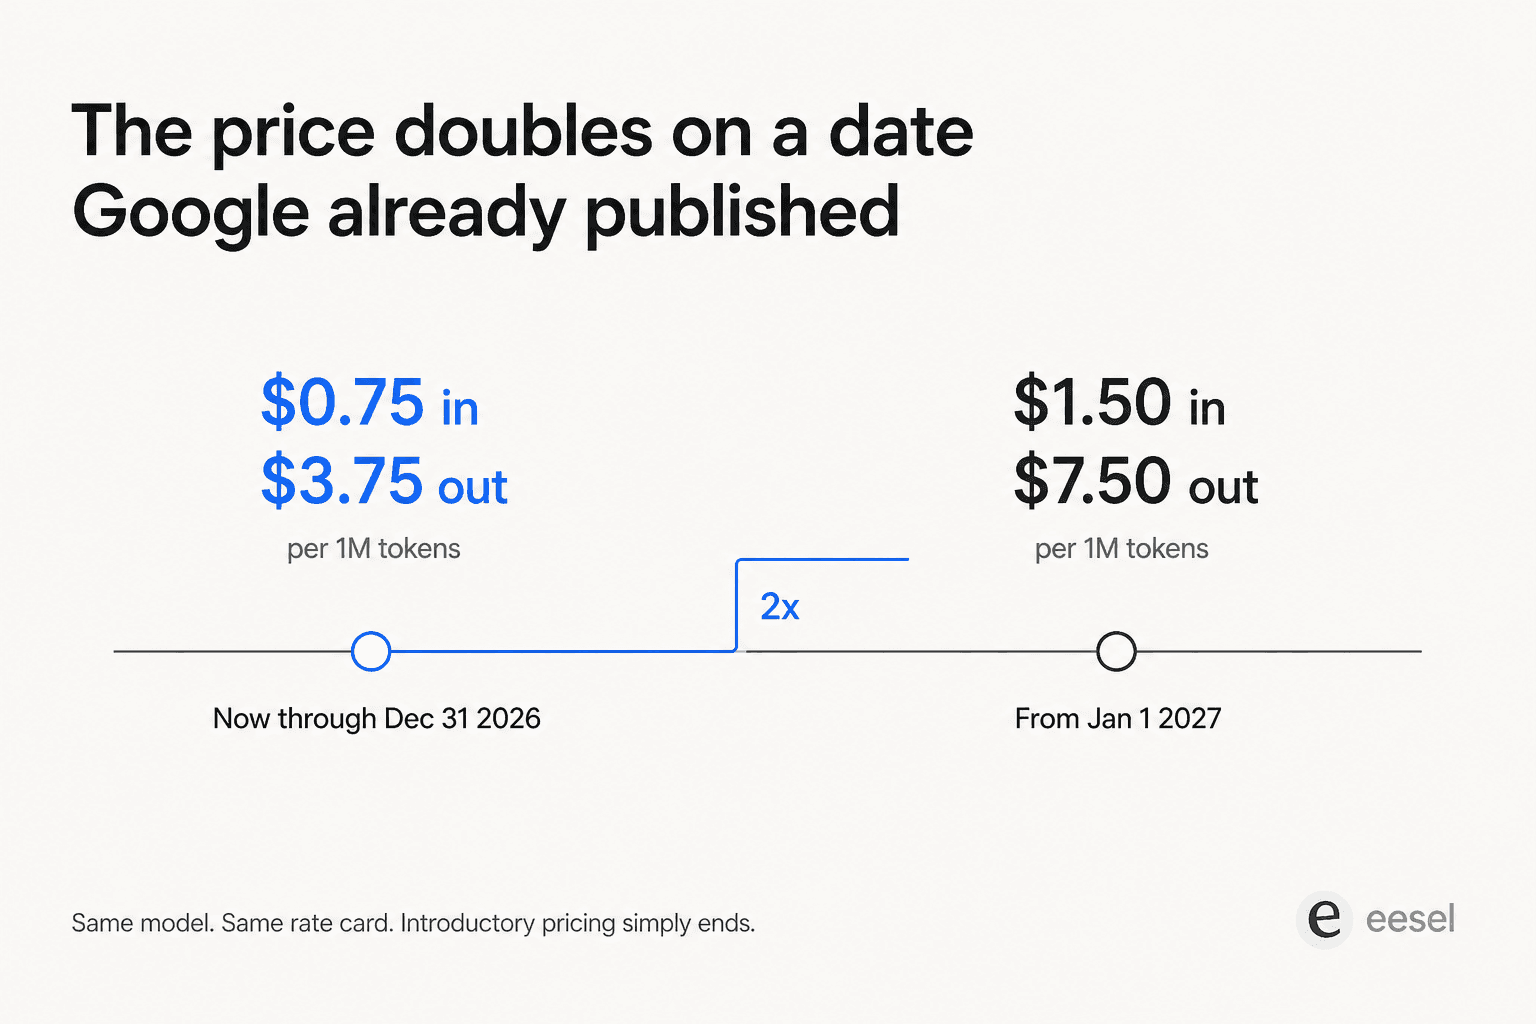
Tarifs : $0.75 en entrée / $3.75 en sortie par 1M en tarif d'introduction jusqu'au 31 décembre 2026, puis $1.50 / $7.50.
Verdict : le choix quand vous préférez payer une plateforme plutôt que de nourrir un GPU. Ne laissez simplement pas le curseur d'effort sur la valeur par défaut.
6. GPT-5.6 Luna, le choix de fiabilité en écosystème fermé
Idéal pour : les équipes déjà standardisées sur OpenAI qui veulent un niveau économique sans quitter leur stack.
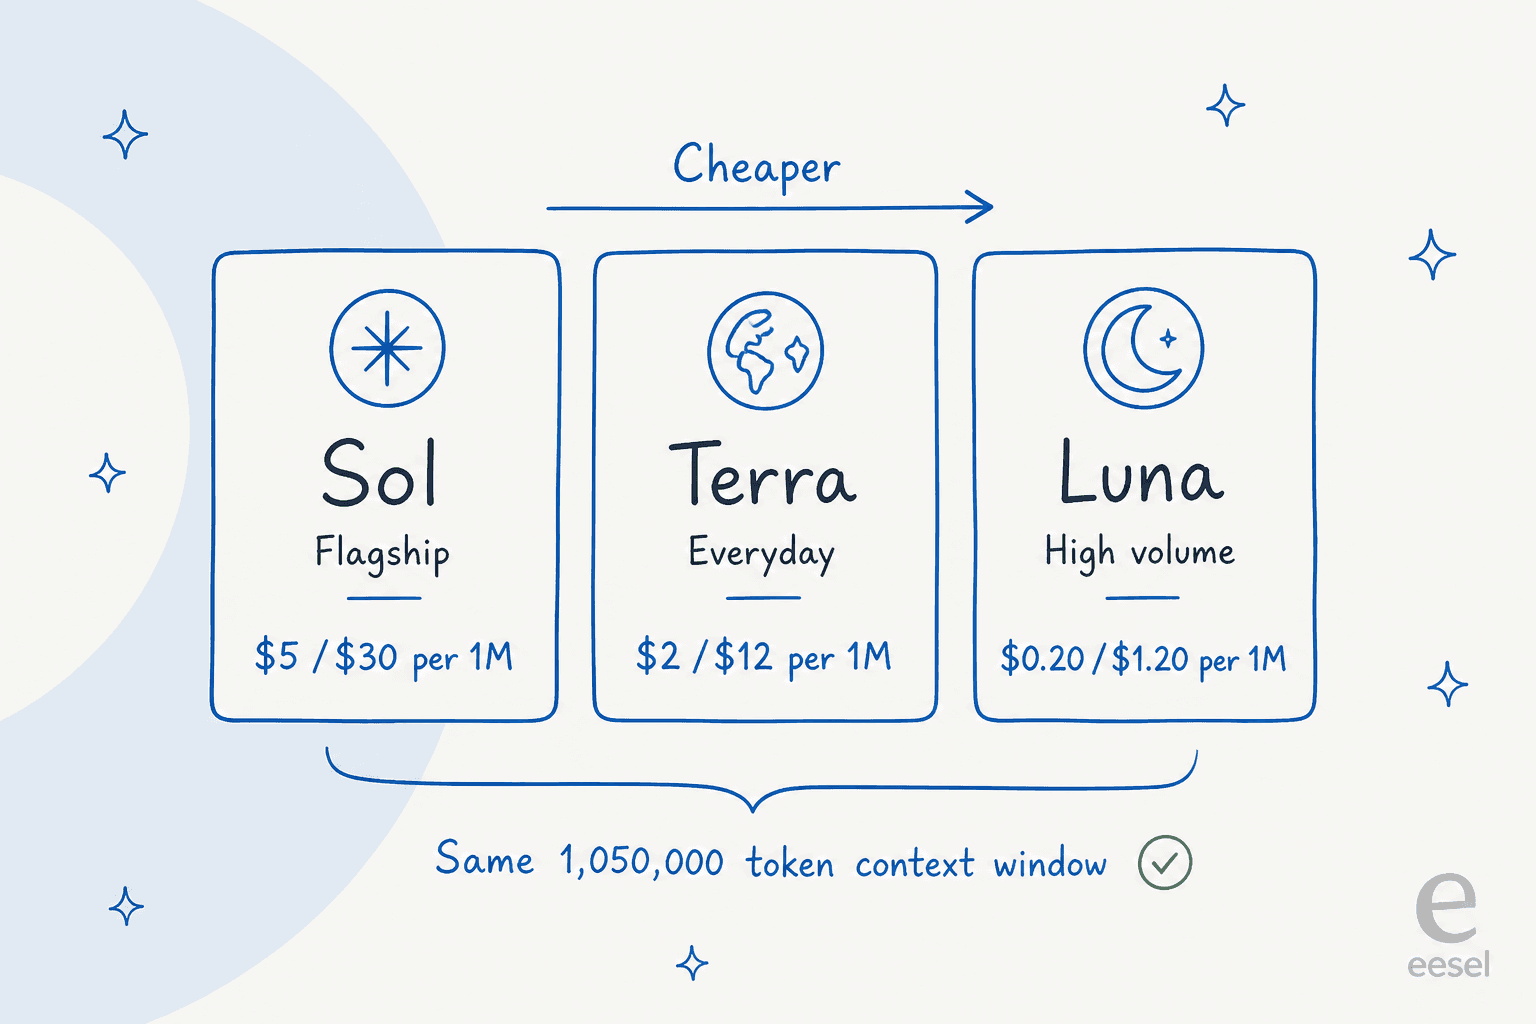
Luna est l'échelon économique de la gamme GPT-5.6 (les deux autres étant Terra et le modèle phare Sol). À $0.20 en entrée / $1.20 en sortie par 1M, il est compétitif sur le prix avec les modèles chinois à poids ouverts tout en vous offrant l'outillage, les SDK et la fiabilité d'OpenAI. Pour une équipe dont l'infrastructure suppose déjà l'API OpenAI, ce coût de changement évité est réel.
Le compromis est celui que porte chaque modèle fermé ici : pas de poids, pas d'auto-hébergement, et OpenAI facture un palier de contexte long qui double le tarif au-delà de la fenêtre de contexte court (Luna passe à $0.40/$1.80). Anthropic et Google ne facturent pas ce palier, donc il vaut la peine de vérifier si vos longueurs de contexte franchissent la limite.
Points forts : un fournisseur de confiance, un écosystème mature et un niveau d'entrée vraiment économique.
Points faibles : poids fermés, un supplément 2x pour le contexte long et moins d'ouverture que les modèles avec lesquels il rivalise sur le prix.
Tarifs : $0.20 en entrée / $1.20 en sortie par 1M en contexte court ; $0.40 / $1.80 en contexte long ; entrée en cache $0.02.
Verdict : le choix économique raisonnable si vous êtes déjà une maison OpenAI et que vous valorisez l'écosystème plus que les poids ouverts.
7. IBM Granite 4.2, le choix entreprise / on-prem
Idéal pour : les entreprises qui ont besoin d'une licence permissive, de matériel courant et d'appels d'outils bien ancrés.
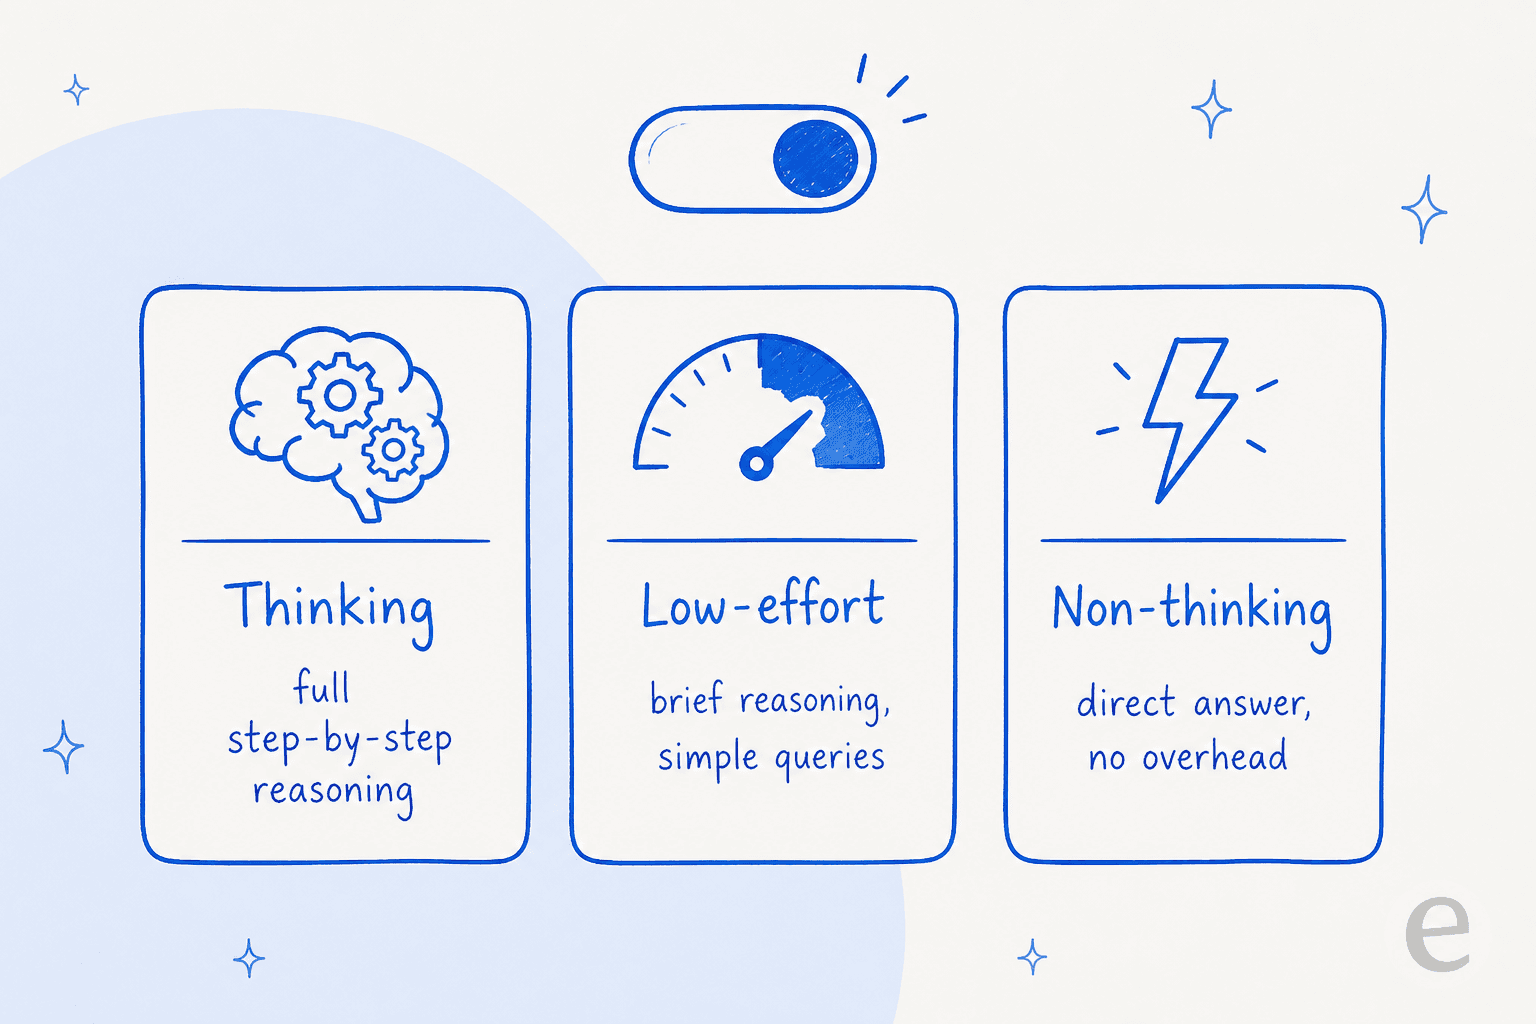
Granite 4.2 est le modèle que vos équipes juridiques et de sécurité valideront réellement. IBM l'a lancé le 25 août 2026 sous la forme de trois modèles denses Apache 2.0 (3B, 8B et un modèle phare de 30B) avec un contexte de 128K et, contrairement à Flash Next, un raisonnement commutable : réflexion complète, effort réduit ou désactivé. Il est réglé pour l'extraction ancrée et les appels d'outils plutôt que pour les victoires en benchmark, et les testeurs apprécient son côté pratique :
"I test drove it yesterday. It's pretty impressive at 8b. Runs on commodity hardware quickly ... Granite has recent training data which is nice."
Soyez lucide sur ce qu'il n'est pas. Il ne domine pas les classements bruts de programmation, et la même communauté le dit directement : "Qwen still wins on raw capability, especially for coding." Il y a aussi une bizarrerie de mémoire : le téléchargement de 5.3GB du modèle 8B gonfle jusqu'à environ 27GB une fois le cache KV chargé, dimensionnez donc votre GPU en conséquence.
Points forts : un vrai Apache 2.0 (pas seulement « poids disponibles »), raisonnement commutable, données d'entraînement récentes et exécution rapide sur du matériel modeste.
Points faibles : il est derrière Qwen en programmation brute, les benchmarks d'IBM se comparent surtout aux Granite précédents plutôt qu'aux leaders chinois, et le gonflement mémoire au chargement surprend.
Tarifs : auto-hébergement gratuit (le 8B est un téléchargement de 5.3GB) ; l'hébergé confirmé le moins cher est le 8B de Replicate à $0.06 en entrée / $0.25 en sortie par 1M.
Verdict : le choix sûr pour l'entreprise. Si la licence et le contrôle on-prem comptent plus que les derniers points de benchmark, Granite est difficile à battre.
8. LongCat 2.0, le joker MoE MIT de grande taille
Idéal pour : les aventuriers qui veulent un très grand MoE sous licence MIT et peuvent supporter l'outillage.
LongCat 2.0 de Meituan est le cousin architectural de la famille DeepSeek : un MoE de 1.6T avec environ 48B actifs par token, de simples poids MIT et des prix promo qui sous-cotent la plupart de cette liste. Il est vraiment capable, avec un SWE-bench Pro auto-mesuré de 59.5 qui dépasse de peu GPT-5.5.
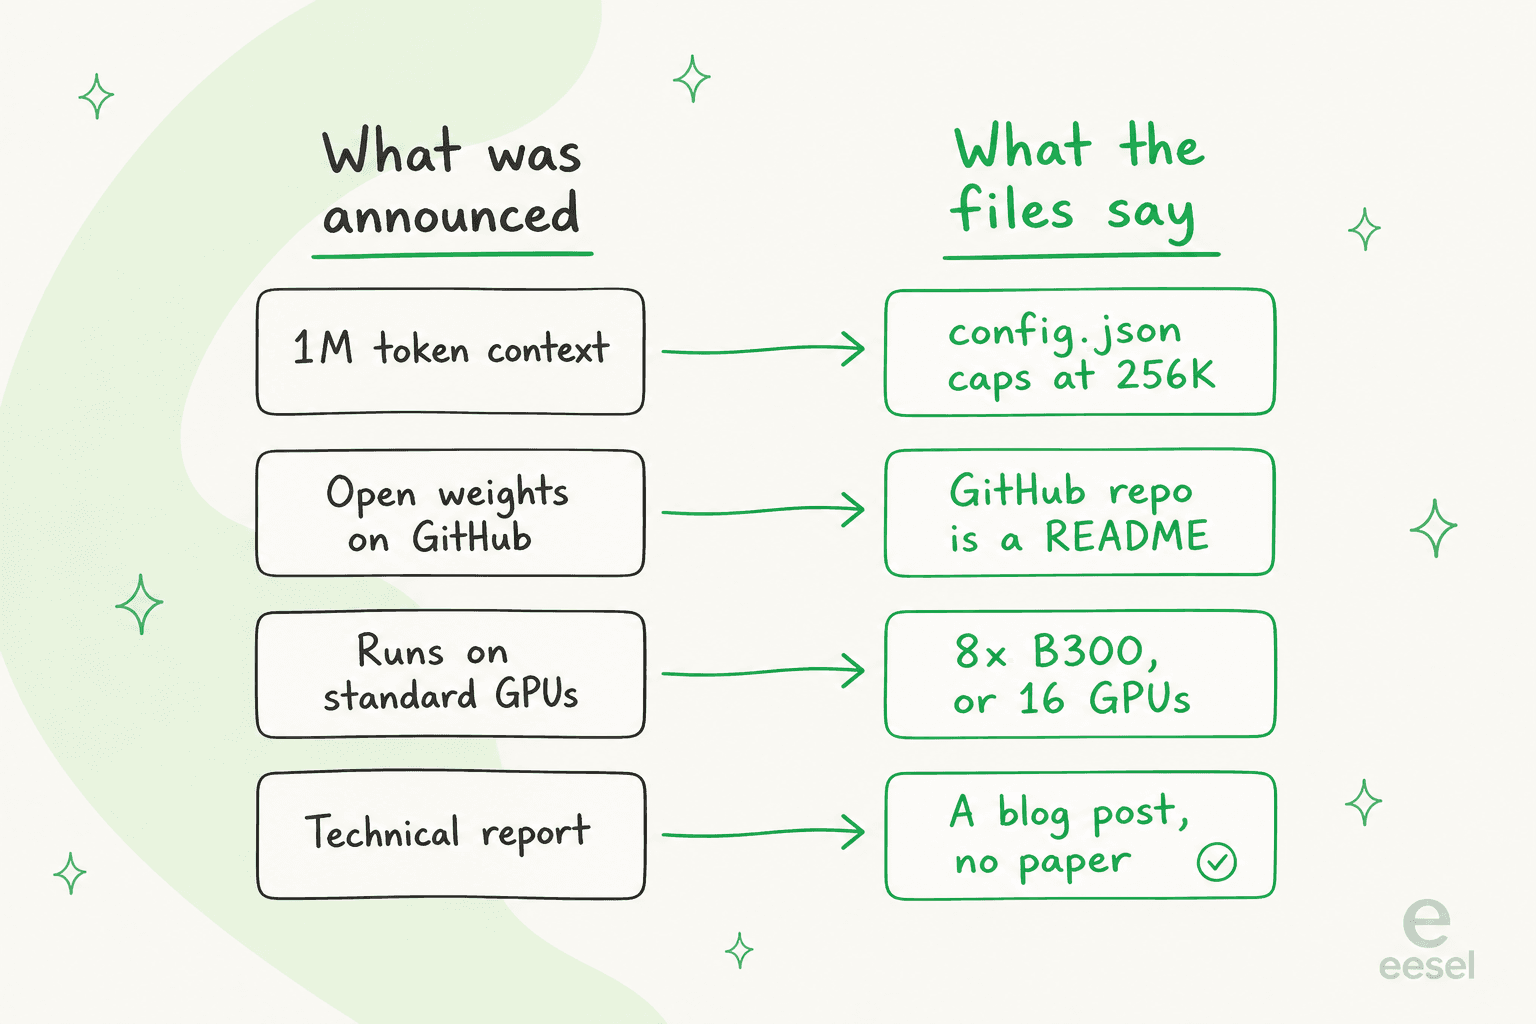
Mais il vient avec le plus d'astérisques de tous ici, et tous sont vérifiables. Le « contexte de 1M » annoncé est une affirmation d'entraînement ; la config livrée plafonne les positions à 256K. Le dépôt GitHub ne contient qu'un README sans article, SGLang est le seul moteur, et l'auto-hébergement exige réalistement 8x GPU B300 puisqu'il n'existe pas de GGUF pour Ollama ou LM Studio. Le paiement hors de Chine continentale passe par Alipay ou WeChat Pay, pas par carte. Et pour le support en particulier, la FAQ de la plateforme est muette sur la conservation des données et l'entraînement, ce qui est le vrai blocage, pas le prix.
Points forts : réellement grand et capable, licence MIT claire et prix promo agressifs.
Points faibles : outillage mince, un vrai contexte de 256K (pas 1M), une empreinte d'auto-hébergement brutale, un paiement peu pratique et aucun engagement sur le traitement des données.
Tarifs : promo $0.30 en entrée / $1.20 en sortie par 1M (tarif public $0.75/$2.95), sans paliers selon la longueur de contexte.
Verdict : un joker fascinant pour les chercheurs, mais les lacunes d'outillage et de données en font le plus difficile de cette liste à mettre en production.
Quelle alternative choisir ?
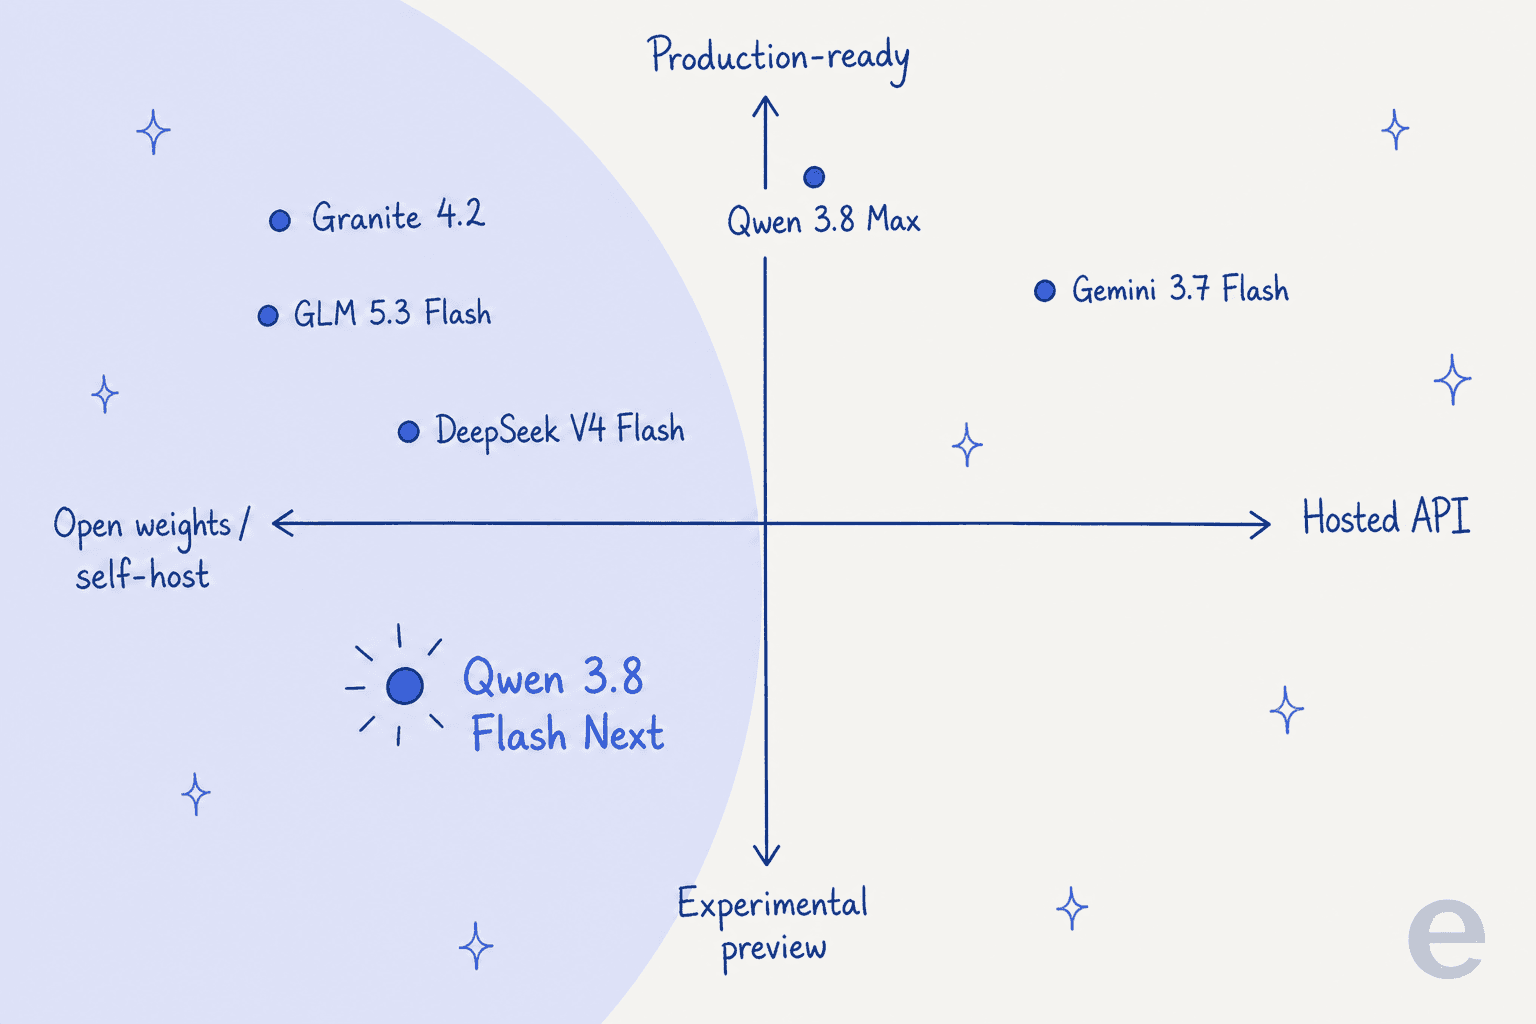
Si vous les confrontez aux deux choses qui vous ont vraiment éloigné de Flash Next, « est-il abouti ? » et « veux-je l'exécuter moi-même ? », la sélection se trie vite.
Décisions rapides :
- Vous voulez la même chose, mais aboutie ? GLM 5.3 Flash.
- Vous voulez la facture réelle la plus basse ? DeepSeek V4 Flash, ou Granite 4.2 auto-hébergé.
- Vous voulez rester dans l'univers Qwen, mais en stable ? Qwen 3.8 Max.
- Vous ne voulez pas toucher à un GPU ? Gemini 3.7 Flash ou GPT-5.6 Luna.
- Besoin d'une licence entreprise et de l'on-prem ? Granite 4.2.
Le schéma derrière tout cela
Voici ce que je dois sans cesse répéter aux équipes qui arrivent sur un article comme celui-ci. Chaque modèle ci-dessus est un composant. Un modèle brut reçoit des tokens et en renvoie. Il ne connaît pas votre politique de remboursement, ne peut pas lire l'historique de commandes d'un client, ne rédigera pas de réponse dans votre helpdesk et ignore si sa réponse assurée est correcte. Le modèle est l'infrastructure ; ce qui fait le travail, c'est l'employé.
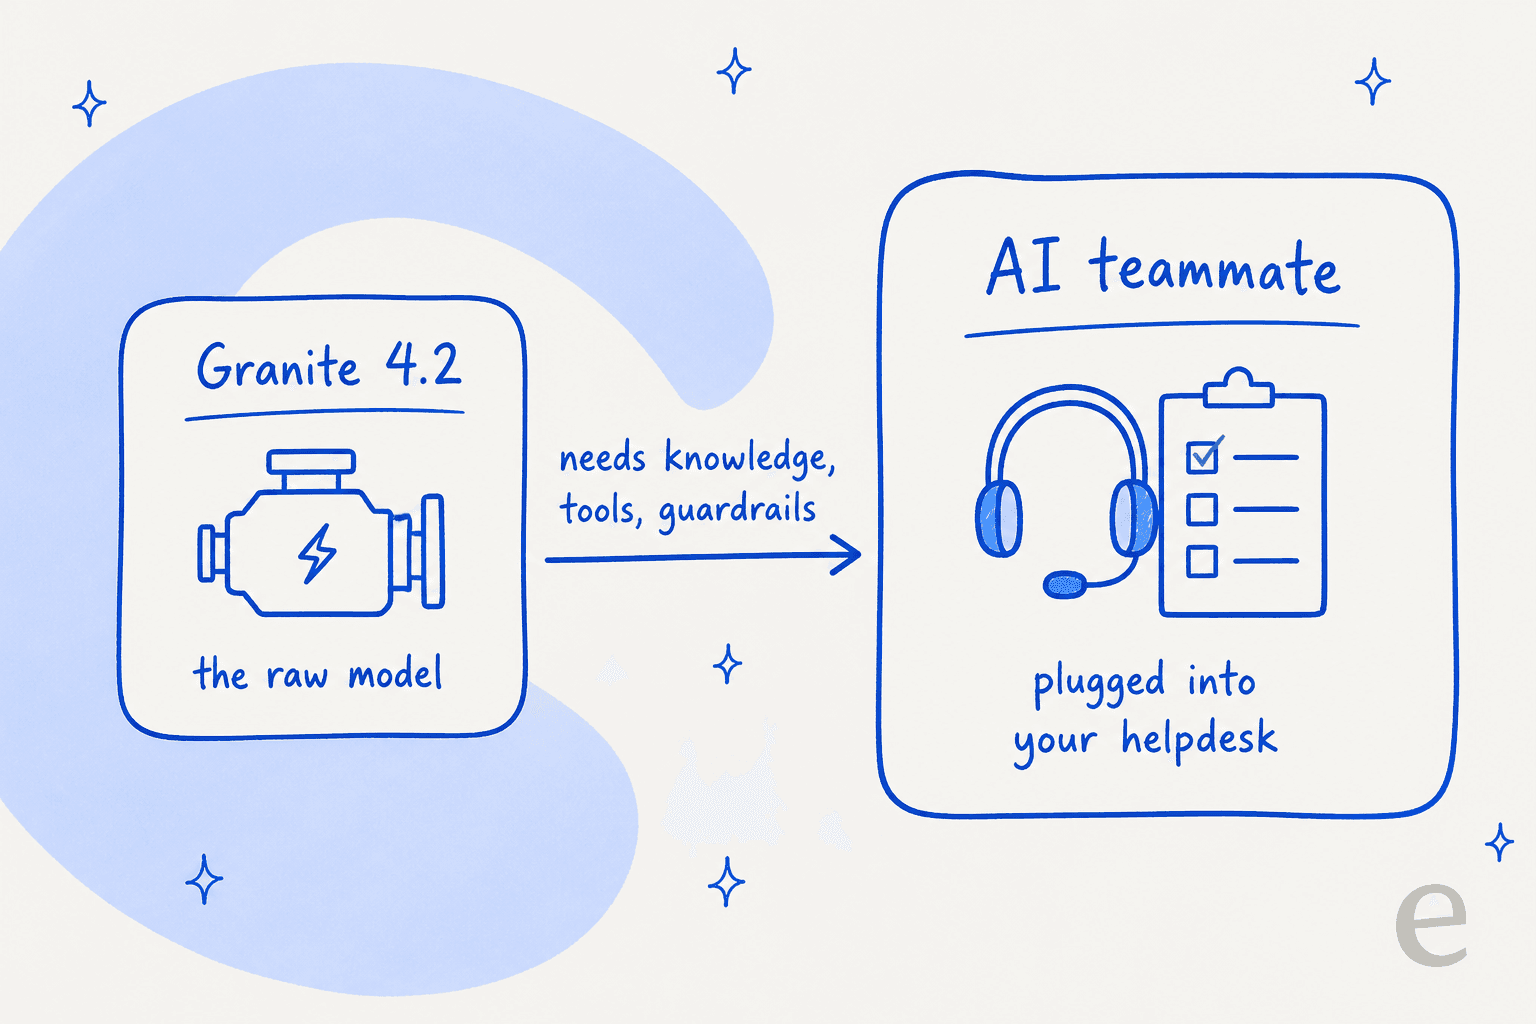
C'est pourquoi « quel modèle économique utiliser pour le support ? » est la mauvaise première question. Choisir le modèle, c'est les 10 % faciles. Les 90 % qui décident si les tickets sont réellement résolus, c'est la couche autour : récupération sur votre base de connaissances, actions dans votre helpdesk, garde-fous et tests sur l'historique réel avant que quoi que ce soit n'atteigne un client. C'est vrai que le modèle en dessous soit Flash Next, GLM 5.3 Flash ou un employé IA que vous construisez en interne.
Essayer eesel
Si vous êtes venu ici pour évaluer un modèle économique pour une charge de support, le conseil honnête est d'arrêter de chercher un modèle et de commencer à tester sur vos propres tickets. Cette couche d'employé, c'est ce que je construis chez eesel : une plateforme de coéquipiers IA où vous recrutez des coéquipiers prêts à travailler pour des missions précises, actuellement un coéquipier IA pour helpdesk et un rédacteur de blog IA. Chacun arrive avec les compétences, les intégrations et le contexte d'entreprise de son rôle, de sorte que le modèle qui tourne dessous devient un détail d'implémentation plutôt que votre problème.

La partie que je soulignerais le plus fort, ce sont les tests, car un tout nouveau modèle en aperçu comme Flash Next est exactement le genre de chose que l'on veut derrière un portail. Le coéquipier helpdesk d'eesel simule chaque déploiement sur vos tickets historiques avant de toucher un client en production, pour que vous voyiez le taux de résolution et les réponses exactes qu'il aurait envoyées sur de vraies conversations passées, puis décidiez quoi automatiser. Choisissez le modèle qui gagne votre benchmark ; prouvez-le simplement d'abord sur vos propres tickets. L'essai est gratuit.