

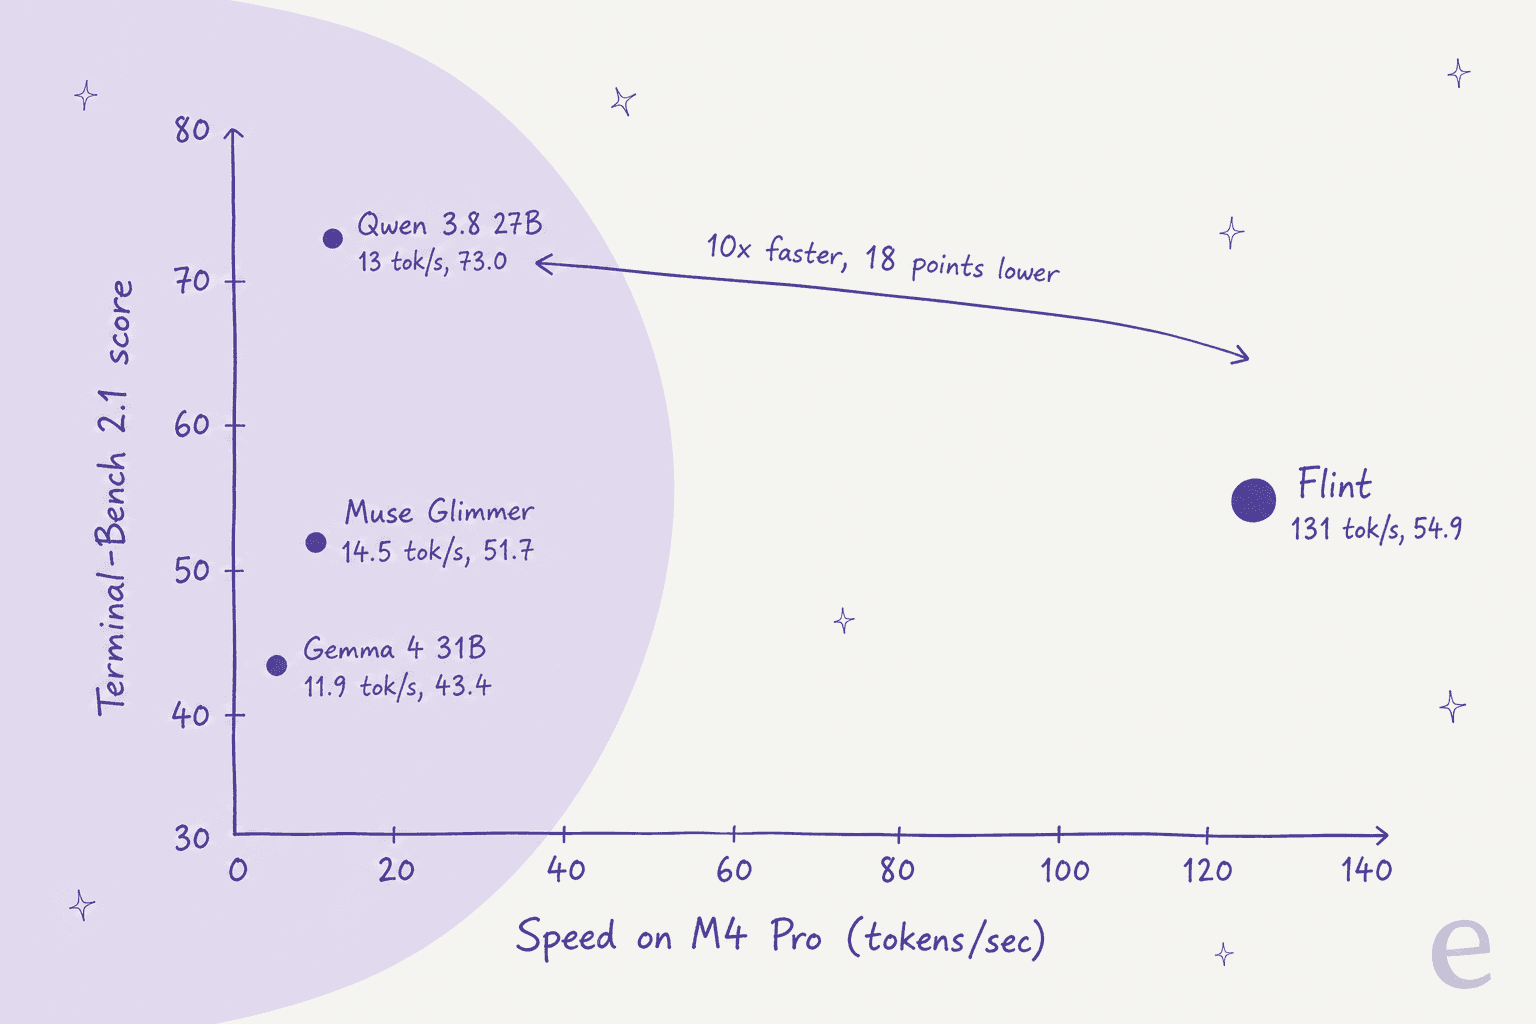
Recursive Flint est le modèle de code le plus rapide que vous puissiez faire tourner aujourd'hui sur un portable, et il est gratuit, mais ce n'est pas le meilleur. Sur un MacBook M4 Pro, il écrit 131 tokens par seconde, soit environ 10x le Qwen 3.8 27B dense, tandis que Qwen 3.8 le bat encore sur quatre des six benchmarks de code du graphique propre à Recursive, dont Terminal-Bench 2.1 de 18 points.
Ma note est de 3,5/5. Choisissez Flint si vous voulez un agent de code hors ligne, sous licence Apache 2.0, qui suit votre rythme, et que vous acceptez de découper le travail en petites étapes explicites. Passez votre chemin si vous avez besoin du modèle local le plus fort par réponse, ou d'une boucle d'outils qui ne trébuche jamais : sur l'endpoint gratuit d'OpenRouter, 17,74 % des appels d'outils sont actuellement en erreur.
Si ce dont vous avez vraiment besoin, c'est d'un agent qui traite une file de support plutôt qu'une base de code, un modèle brut n'est pas la bonne couche. Le coéquipier helpdesk IA d'eesel est l'employé qui se place au-dessus de modèles comme celui-ci, et votre agent de code peut le piloter depuis le terminal avec la CLI eesel.
Qu'est-ce que Recursive Flint ?
Recursive Flint est un modèle de code à mélange d'experts de 40B de paramètres qui en active environ 2,5B par token, publié le 21 octobre 2026 par Recursive. Texte en entrée, texte en sortie, avec raisonnement toujours actif et appels d'outils, et il est conçu pour un seul travail : faire tourner un agent de code qui lit un dépôt, modifie des fichiers et exécute des tests. Voyez-le comme le moteur sous une CLI de code agentique, pas comme une application de chat.
Recursive est le laboratoire dirigé par Richard Socher, également PDG de You.com. Son objectif affiché est une « superintelligence qui s'améliore elle-même de façon récursive », et Flint est le premier test public du système censé y mener : la Eureka Machine, une boucle de recherche automatisée qui propose des idées, les implémente, les teste et choisit quoi essayer ensuite. Recursive affirme qu'une petite équipe de personnes et d'agents a construit Flint de zéro en moins de quatre mois, avec la Eureka Machine travaillant sur les données, les recettes d'entraînement, la quantification et les kernels.
Je construis les intégrations et les API derrière les agents d'eesel, ce qui veut dire que je passe l'essentiel de ma semaine à brancher des modèles dans des boucles d'outils et à regarder où ils cassent. C'est l'angle de cet avis. J'ai lu la fiche du modèle, la documentation de Recursive, le dépôt du moteur rec et les statistiques en direct d'OpenRouter, et j'ai jugé Flint sur ce qu'un modèle de code doit réellement faire : terminer une tâche en plusieurs étapes sans que vous ayez à le surveiller.
Voici les spécifications qui comptent, directement tirées de la fiche du modèle :
| Spécification | Recursive Flint |
|---|---|
| Paramètres totaux | 39,8B |
| Actifs par token | ~2,5B (environ 2,2B sans la tête de sortie) |
| Experts | 256 par couche MoE, 6 routés par token, plus 1 partagé |
| Couches | 49 (2 denses, 47 MoE ; 35 à fenêtre glissante, 14 à attention complète) |
| Contexte | 262 144 tokens documentés ; jusqu'à 512k pris en charge, 256k recommandés |
| Sortie max (hébergé) | 65 536 tokens |
| Date limite des connaissances | Juin 2026 |
| Licence | Apache 2.0 |
| Entrée / sortie | Texte / texte |
Comment un modèle de 40B peut-il tourner aussi vite sur un portable ?
Il tourne vite parce que presque tout reste inactif. Chaque token passe par un routeur qui choisit 6 des 256 experts de chaque couche, plus un expert partagé qui s'active toujours, donc la puce ne lit que l'équivalent d'environ 2,5B de paramètres de poids par token. Un modèle dense de 27B lit les 27B à chaque token.
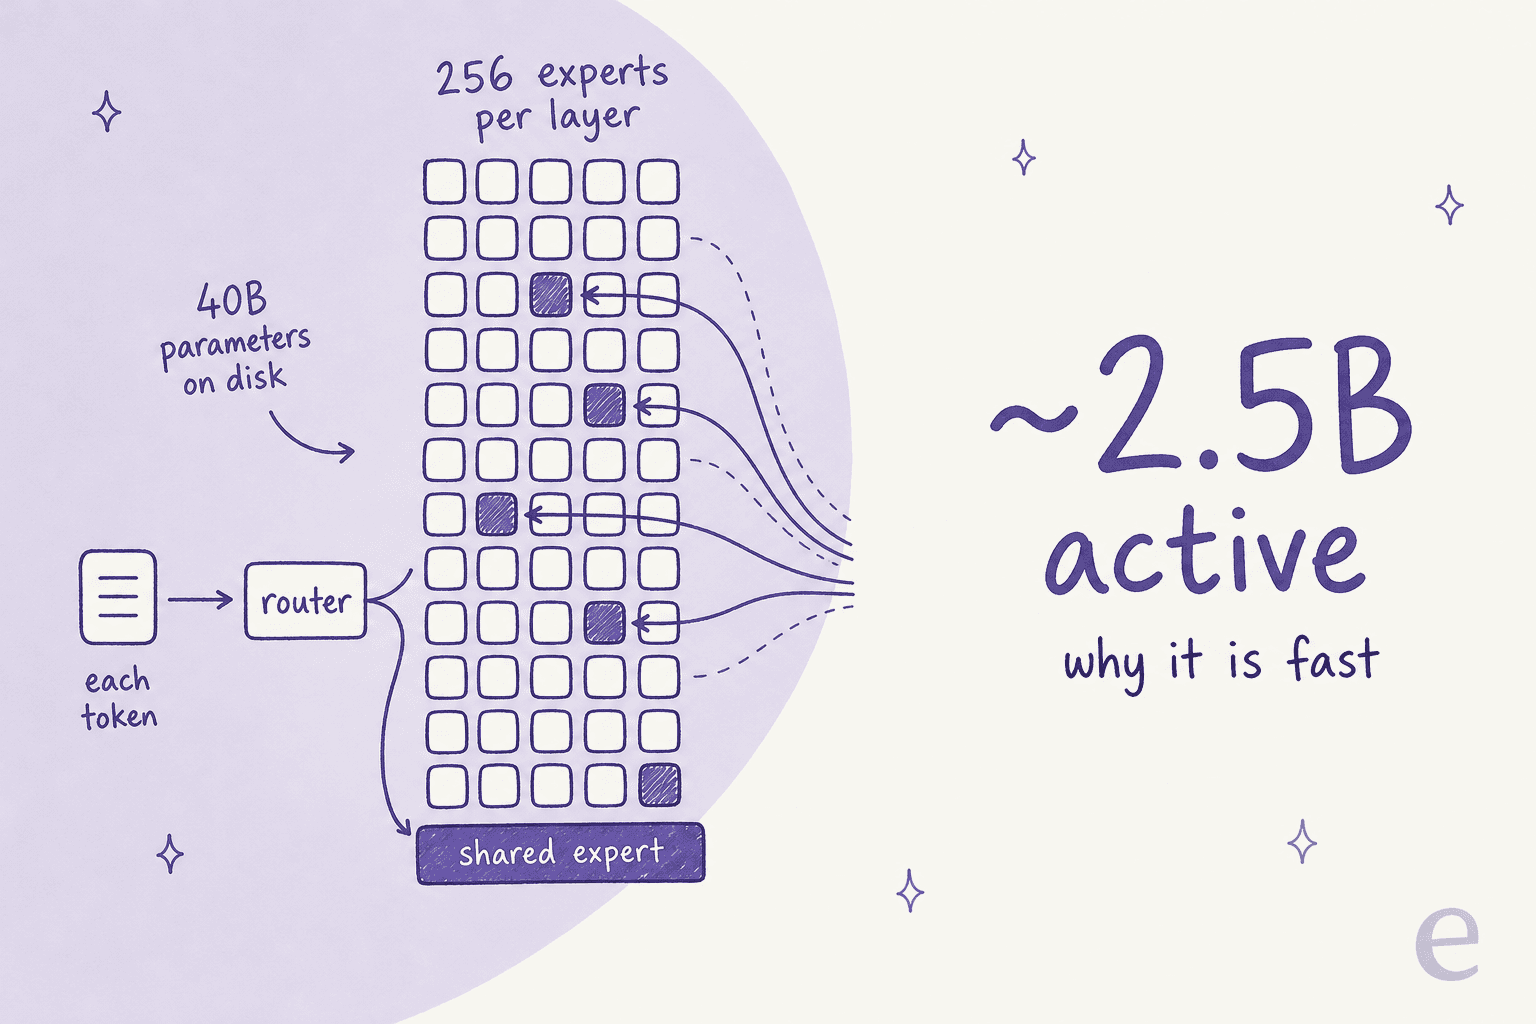
Le plus intéressant, c'est que Recursive ne s'est pas arrêté à l'architecture. Selon le billet de lancement, la Eureka Machine a aussi cherché des recettes de quantification et, contre la pratique courante, comprimé la couche de sortie à 4 bits. Avec seulement 2,5B de paramètres actifs, cette couche de sortie représente une grande part des poids lus par token, donc la réduire apporte une vraie vitesse. Le modèle NVFP4 final se situe à moins de 0,7 point du modèle 16 bits sur les benchmarks de Recursive, et la fiche LM Studio montre l'écart test par test : 53,7 contre 54,9 sur Terminal-Bench, 74,1 contre 74,2 sur SWE-bench Verified.
Ensuite, il a écrit des kernels sur mesure, dont un « mégakernel » Metal qui fusionne toute la passe de décodage sur les puces M4 et M5. C'est pourquoi Recursive livre son propre moteur, rec, au lieu de simplement vous renvoyer vers llama.cpp. J'y reviens plus bas.
Quelle est la vitesse de Recursive Flint en pratique ?
Très élevée. Sur le graphique propre à Recursive pour un Apple M4 Pro avec 48 Go, Flint tourne à 131,22 tokens/s via MLX avec un contexte de 1K tokens, et 87,98 via llama.cpp. Les pairs épars les plus proches sont Laguna XS 2.1 à 68,84 et Qwen 3.6 35B-A3B à 65,55. Les modèles denses aux scores de code comparables bougent à peine : Muse Glimmer à 14,54, Qwen 3.8 27B à 13,01, Gemma 4 31B à 11,92.

Ce sont les chiffres en contexte long qui me convainquent que ce n'est pas un tour de passe-passe sur prompts courts. En moyenne sur des contextes jusqu'à 128K, Flint tient 68,89 tokens/s sur le M4 Pro, alors que Qwen 3.8 27B tombe à 10,11. Un agent de code passe l'essentiel de sa vie au fond d'un long contexte (contenu de fichiers, sortie de tests, son propre raisonnement antérieur), donc la moyenne compte plus que le chiffre phare. Sur la RTX Spark de NVIDIA, la version NVFP4 atteint 155,82 tokens/s en contexte court et 101,95 en moyenne.
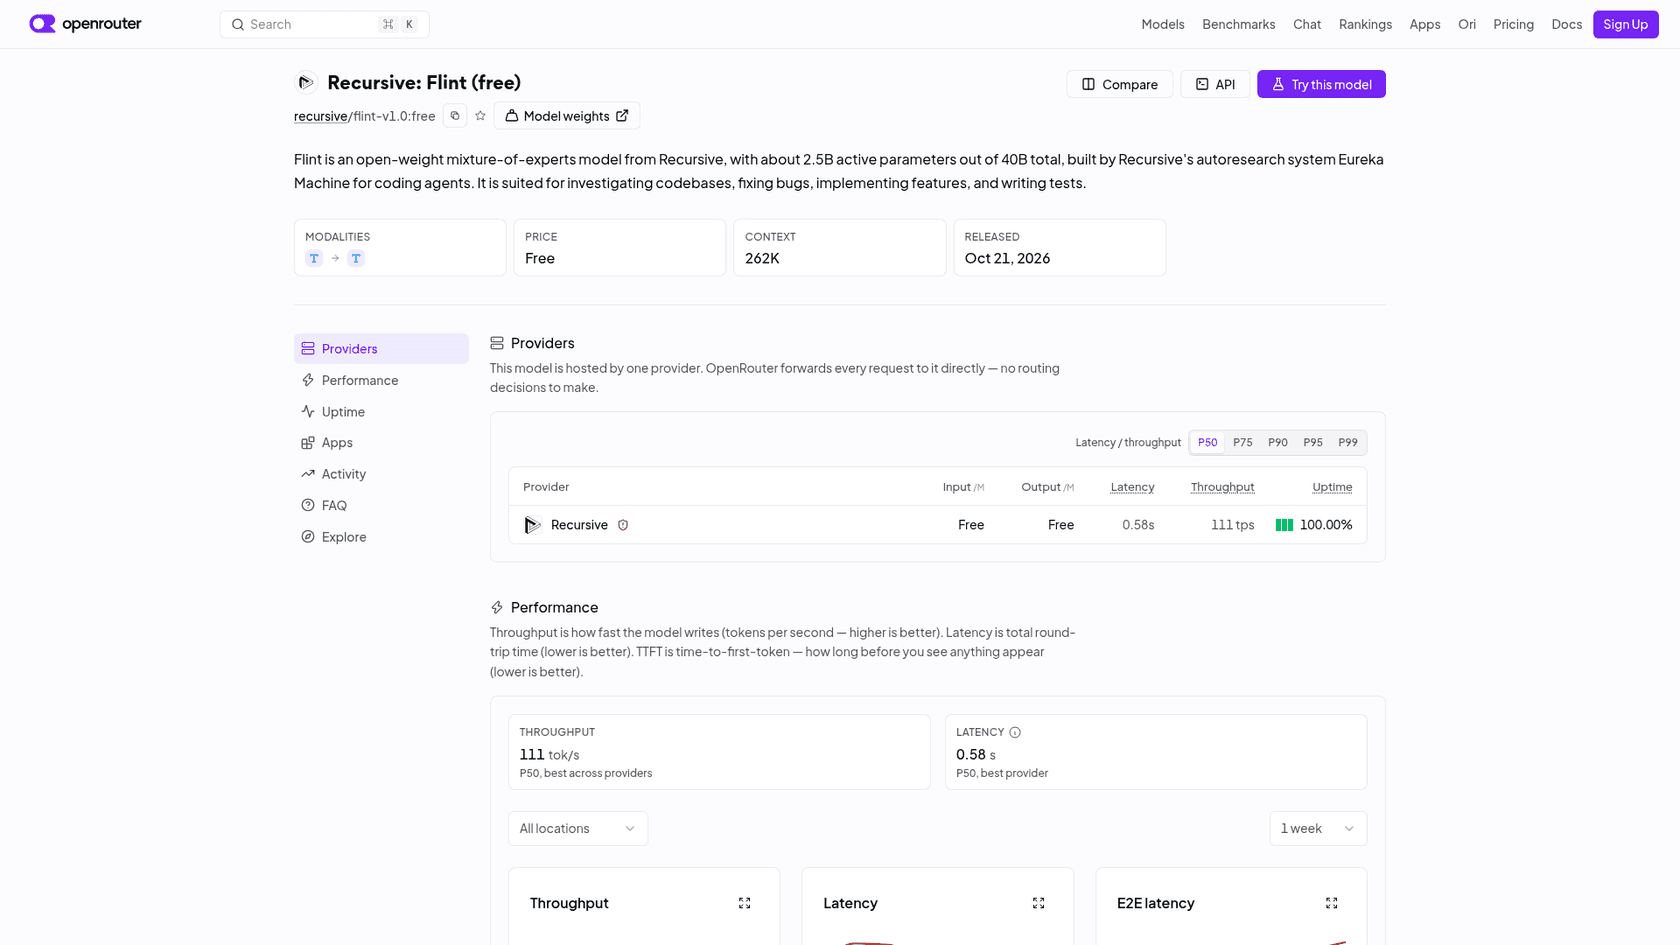
En hébergé, c'est rapide aussi. Les statistiques en direct d'OpenRouter affichent un débit P50 de 111 tokens/s et 0,58 s de latence depuis l'unique endpoint fournisseur de Recursive.
Deux réserves. Ce sont des mesures de Recursive, prefill exclu, donc le temps jusqu'au premier token avec un gros prompt paraîtra plus lent que ne le suggèrent les barres. Et la vitesse n'apparaît que si vous utilisez un runtime qui prend correctement en charge Flint ; la page de dépannage consacre toute une entrée au déchargement sur CPU et au swap mémoire.
Comment Flint se mesure-t-il à Qwen 3.8, Gemma 4 et Muse Glimmer ?
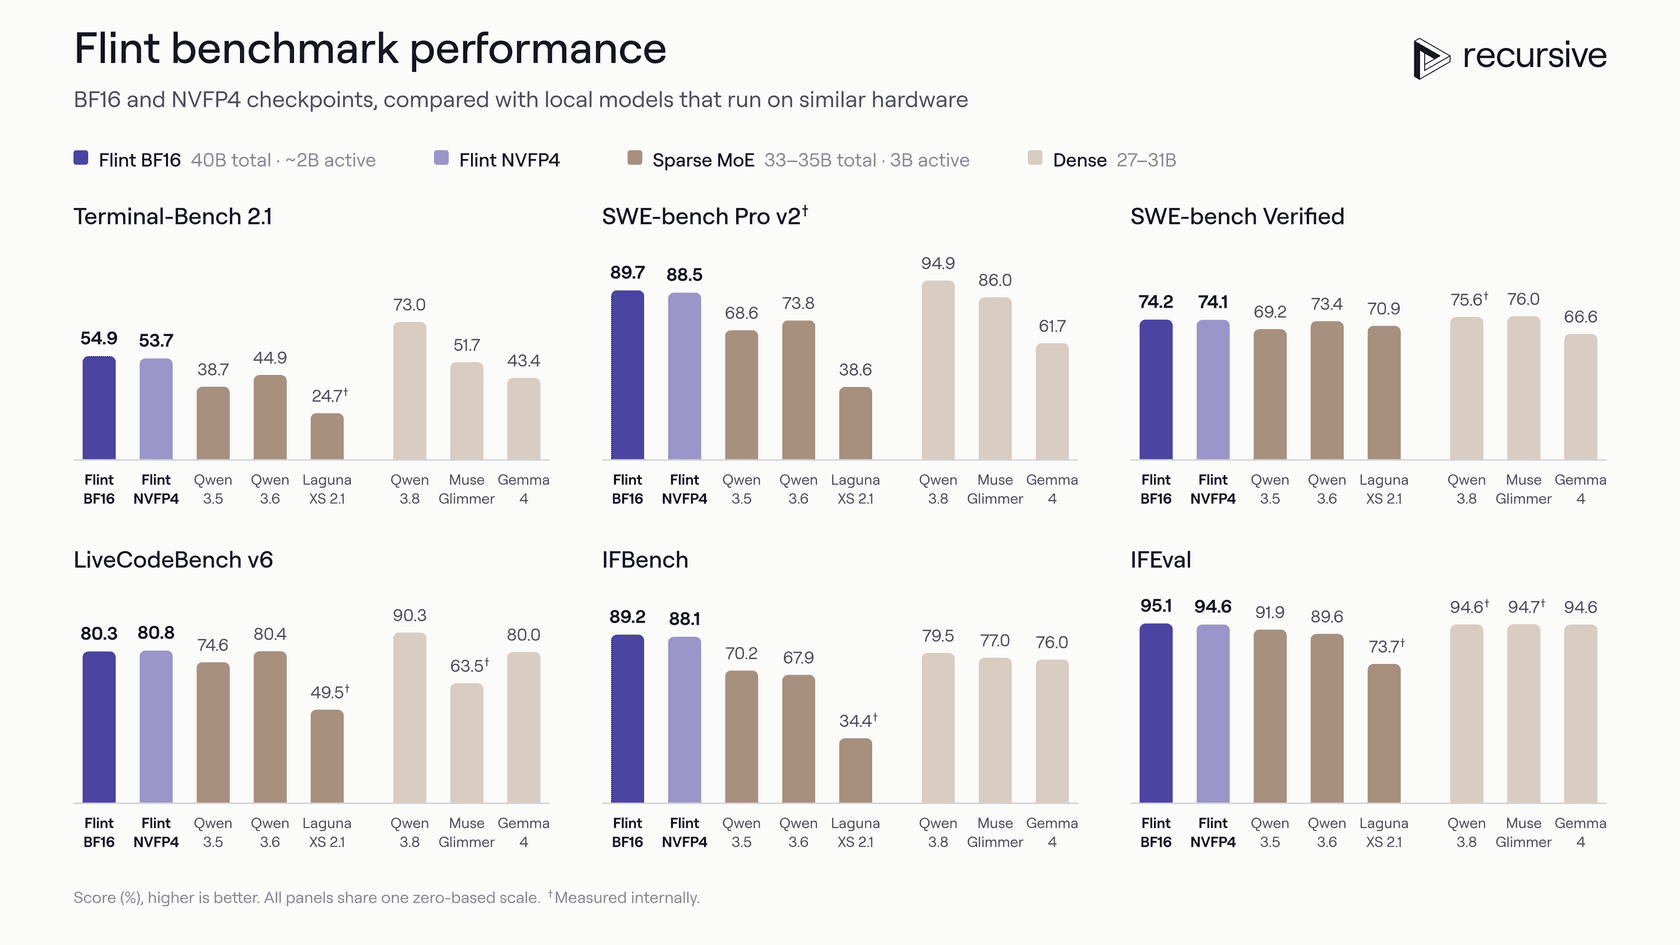
C'est ici que le texte de lancement et le graphique divergent. Recursive affirme que Flint « rivalise avec les performances de code de modèles denses de 25 à 40 milliards de paramètres ». Sur son propre graphique, il est derrière le plus fort d'entre eux, Qwen 3.8 27B, sur la plupart des tests qui comptent pour le code agentique.
| Benchmark | Flint BF16 | Qwen 3.8 27B (dense) | Muse Glimmer (dense) | Gemma 4 (dense) | Qwen 3.6 35B-A3B (MoE) |
|---|---|---|---|---|---|
| Terminal-Bench 2.1 | 54.9 | 73.0 | 51.7 | 43.4 | 44.9 |
| SWE-bench Pro v2 | 89.7 | 94.9 | 86.0 | 61.7 | 73.8 |
| SWE-bench Verified | 74.2 | 75.6 | 76.0 | 66.6 | 73.4 |
| LiveCodeBench v6 | 80.3 | 90.3 | 63.5 | 80.0 | 80.4 |
| IFBench | 89.2 | 79.5 | 77.0 | 76.0 | 67.9 |
| IFEval | 95.1 | 94.6 | 94.7 | 94.6 | 89.6 |
Lu honnêtement, trois choses ressortent :
- Face aux autres modèles MoE de sa taille, Flint gagne nettement. Il bat Qwen 3.6 35B-A3B sur cinq lignes sur six (LiveCodeBench est une égalité à 0,1 point), et de
10points sur Terminal-Bench. C'est l'argument que Recursive met en avant, et il tient. - Face à Qwen 3.8 27B, il perd quatre sur six. L'écart de
18,1points sur Terminal-Bench 2.1 est celui que je pèserais le plus, puisque ce test est le plus proche de « piloter un shell jusqu'à ce que la tâche soit terminée ». - Son point fort, c'est le suivi d'instructions.
89,2sur IFBench, soit près de10points d'avance sur tous les modèles denses du graphique, ce qui cadre avec le conseil de la documentation de lui donner des instructions explicites, étape par étape.
Recursive est transparent sur la méthodologie, ce que j'apprécie. Selon sa fiche de modèle, l'exécution de Terminal-Bench compte comme des échecs les solutions trouvées par recherche web, et la fiche note que les scores des autres modèles publiés par leurs développeurs n'appliquent peut-être pas le même ajustement. Une partie de cet écart pourrait donc venir d'un évaluateur plus strict. Une partie, en revanche, vient simplement d'un modèle dense de 27B qui réfléchit davantage par token.
C'est ça, le vrai compromis. Flint est 10x plus rapide pour une réponse un peu moins bonne. Pour une boucle de code interactive, où vous lisez de toute façon chaque diff, je prendrais souvent ce marché. Pour un agent qui tourne seul pendant la nuit, non.
Où Flint montre-t-il ses limites ?
Les limites sont pour la plupart celles que Recursive documente lui-même, ce qui est bon signe pour le laboratoire, sinon pour le modèle.
Il lui faut une laisse plus courte qu'aux modèles de pointe. Le billet de lancement le dit clairement : « il peut avoir besoin de plus de guidage que les grands modèles de code fermés auxquels vous êtes habitué », et recommande de découper le travail en sous-tâches plus petites avec des instructions explicites. Si vous avez l'habitude de confier un ticket vague à Claude Code ou Cursor et de vous éloigner, attendez-vous à plus d'allers-retours.
Les appels d'outils trébuchent plus qu'on ne voudrait. OpenRouter rapporte un taux d'erreur de 17,74 % sur les appels d'outils pour l'endpoint gratuit. Dans une boucle d'agent de 30 étapes, cela fait plusieurs appels cassés par tâche que votre harnais doit absorber. La documentation pointe des modèles de chat et des parseurs incompatibles comme cause habituelle, et la fiche de modèle demande de conserver reasoning_content dans l'historique, donc une partie du problème se règle de votre côté. Cela reste le premier chiffre que je surveillerais.
Le raisonnement long mange le budget. Le raisonnement est toujours actif. La fiche de modèle recommande au moins 32 768 tokens de sortie pour les problèmes difficiles, et le guide OpenCode suggère 65 536. Si votre harnais plafonne la sortie plus bas, les réponses s'arrêtent avec finish_reason: length en pleine réflexion, le même problème de budget que j'explique dans la fenêtre de contexte de Claude Code.
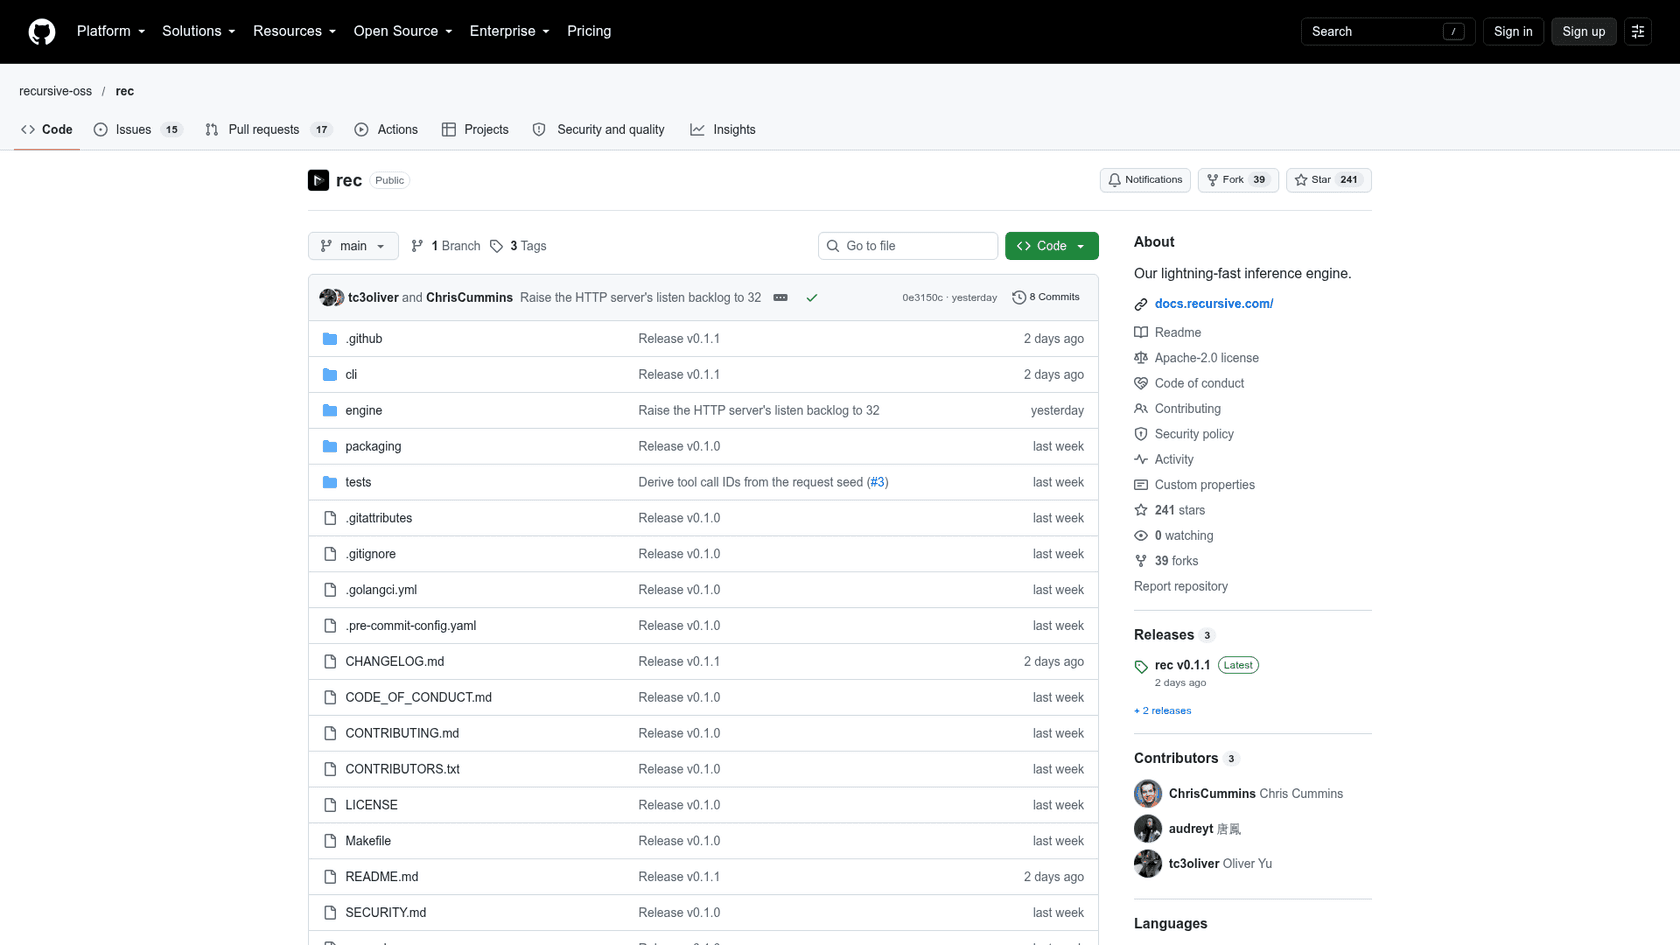
La voie rapide est réservée au Mac, et pas à n'importe quel Mac. rec exige un M4 Pro, M4 Max, M5 Pro ou M5 Max avec au moins 48 Go de mémoire unifiée, selon son README. Une machine de 24 Go peut charger le plus petit GGUF via LM Studio, mais la fiche de LM Studio prévient que le contexte complet de 262K n'est pas garanti de tenir.
Il n'existe pas encore d'API payante avec SLA. L'accès direct à l'API de Recursive est « limité à des partenaires sélectionnés », selon la page des versions. Les offres gratuites d'OpenRouter et d'OpenCode sont soumises à des limites de capacité et de débit. C'est bien pour un essai, pas pour quoi que ce soit que vous facturez à un client.
La réaction de la communauté colle au graphique. Le fil de lancement sur Hacker News était impressionné par la vitesse d'un modèle entraîné de zéro, avec une pointe de « montrez-moi » :
"Pretty amazing for being trained from scratch, to have ~Qwen 3.8 27b quality with such an increase in tok/s performance. Excited to try it out and see how snappy it is."

"not as good as qwen3.8 yet, even the chart says good numbers"
Les deux ont raison. Je me placerais entre les deux : assez proche de Qwen 3.8 pour que la vitesse tranche en travail interactif, pas assez pour qu'elle tranche partout.
Comment exécuter Recursive Flint ?
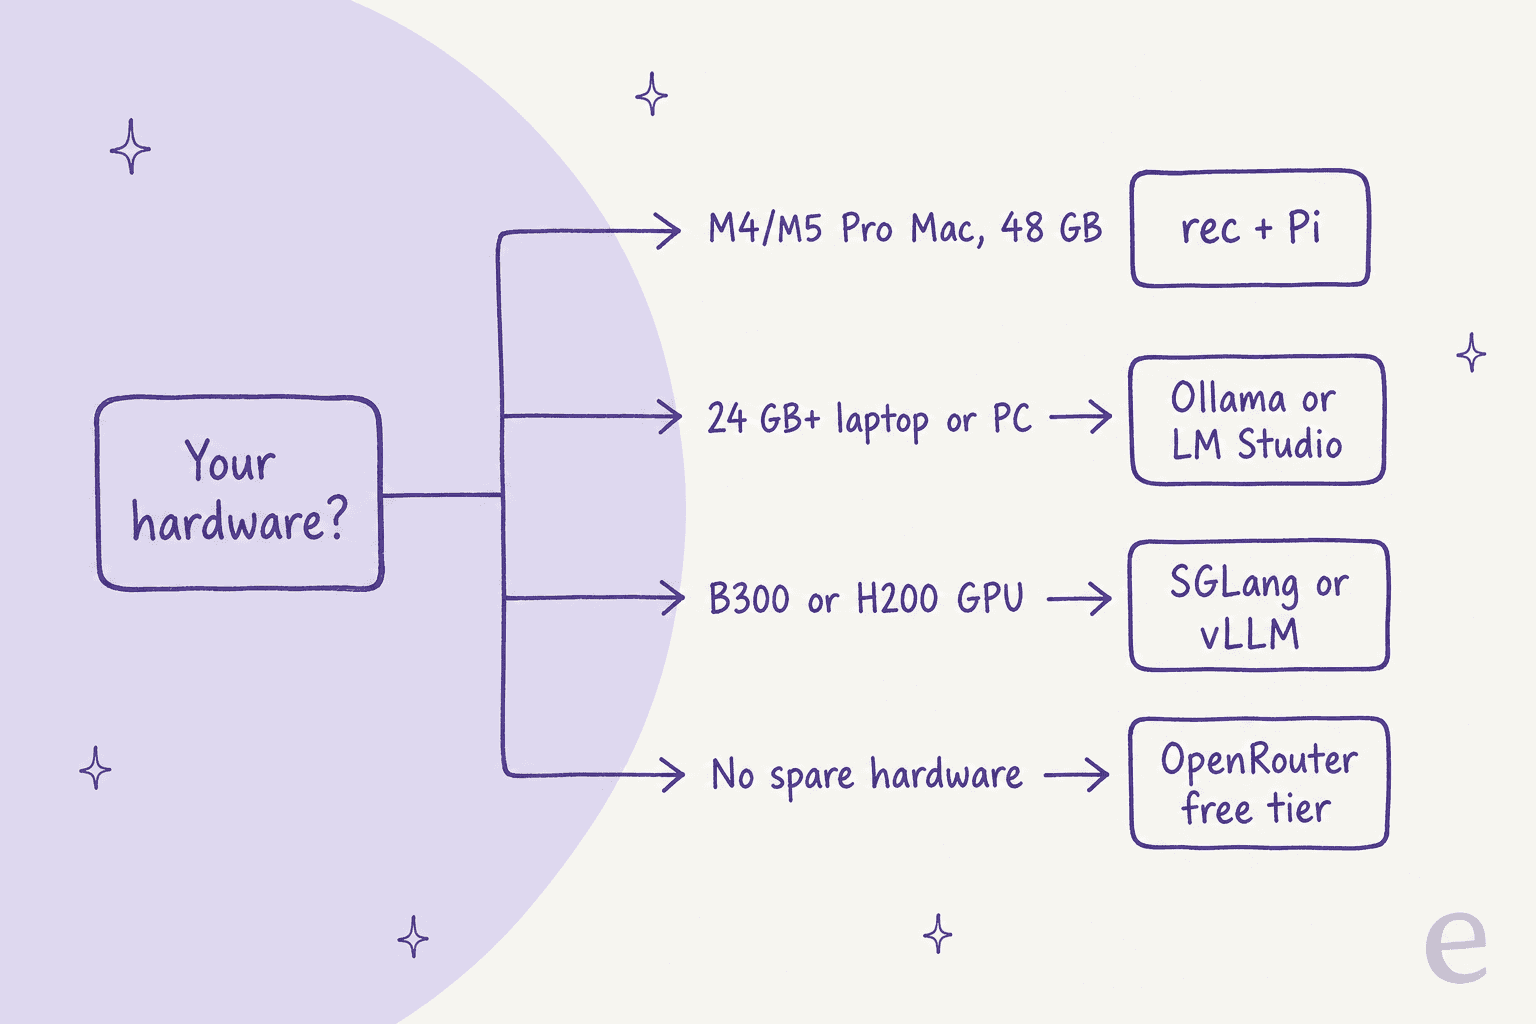
Vous avez quatre voies, et votre matériel en choisit une pour vous.
1. Un Mac compatible : utilisez rec. C'est le moteur propre à Recursive, et son README revendique de 1,4 à 2,6x le débit de llama.cpp sur un M4 Pro. Installez-le avec une seule commande curl, puis lancez rec launch pi depuis le dossier de votre projet. Il télécharge le modèle (environ 30 Go de disque) et le harnais Pi, et démarre un serveur local qui parle à la fois les API compatibles OpenAI et Anthropic. Recursive dit que Flint donne ses meilleurs résultats avec Pi ; rec launch opencode est l'alternative. Un bémol : rec est conçu pour une seule session, donc exécuter plusieurs agents à la fois demande un autre runtime.
2. N'importe quel portable ou PC correct : Ollama ou LM Studio. ollama run flint:40b-a2b-qat-int4 récupère la version 4 bits packagée par Recursive, et ollama launch opencode, pi, codex ou vscode la branche à un harnais, selon le guide Ollama. LM Studio propose un GGUF de 24,20 Go avec un minimum de 24 Go de RAM. Attendez-vous à des vitesses plus proches des barres llama.cpp que de celles de MLX.
3. Un serveur GPU : SGLang ou vLLM. Le dépôt Hugging Face contient le checkpoint BF16 d'environ 80 Go plus un kit de service SGLang qui fait tourner un réplica sur un seul B300 ou H200. Le dépôt a déjà accumulé 93 quantifications communautaires et 14 finetunes, il y a donc de quoi choisir si les versions de Recursive ne conviennent pas à votre stack.
4. Pas de matériel disponible : les offres gratuites hébergées. OpenRouter liste recursive/flint-v1.0:free à coût nul, et le sélecteur de modèles d'OpenCode propose Flint-40B dans son offre gratuite. Les applications les plus actives sur la page d'OpenRouter sont des agents de code : Kilo Code y a fait passer 32,9B tokens en une semaine, Cline 12,2B. Si vous voulez juste voir si le style de Flint vous convient, c'est le test de cinq minutes.
Quelle que soit la voie, la première tâche suggérée par Recursive est bonne : ouvrez un petit dépôt que vous connaissez, demandez à Flint d'expliquer une fonction, ajoutez un test, puis corrigez ce que le test révèle. Vérifiez le diff après chaque étape.
Combien coûte Recursive Flint ?
Rien, côté licence. Les poids sont Apache 2.0, gratuits pour un usage commercial, et les deux voies hébergées sont gratuites aujourd'hui. Le vrai coût, c'est le matériel et l'électricité, et c'est là que Flint fait discrètement économiser : un modèle qui demande un Mac de 48 Go au lieu d'une baie de GPU, et qui tourne à 10x la vitesse de ses pairs denses sur ce Mac, abat plus de travail par heure sur une machine que vous possédez déjà.
| Voie | Prix | Limites |
|---|---|---|
| Poids sur Hugging Face | Gratuit (Apache 2.0) | ~80 Go en BF16 ; versions quantifiées pour Mac et NVIDIA |
| rec sur un Mac | Gratuit | M4/M5 Pro ou Max, 48 Go+, session unique |
| Ollama / LM Studio | Gratuit | 24 Go de RAM minimum pour le plus petit GGUF |
OpenRouter flint-v1.0:free | 0 $ en entrée, 0 $ en sortie | Un fournisseur, limites de capacité et de débit |
| Offre gratuite OpenCode | 0 $ | Limites de capacité et de débit |
| API directe de Recursive | Non publique | Partenaires sélectionnés uniquement |
Comparez avec les modèles de pointe hébergés, où une longue session de code agentique peut coûter des dollars par tâche. Mon détail des tarifs de Kimi K3.1 Pro chiffre son coût par tâche à environ 2,11 $. Si vous exécutez des dizaines de petites tâches bien cadrées par jour, un modèle local gratuit suffisamment bon change vite le calcul.
Qui devrait utiliser Recursive Flint, et qui devrait passer son chemin ?
Voici mon verdict, et le facteur décisif est la part de la réflexion que vous acceptez de faire vous-même.
Utilisez Flint si :
- Vous voulez un agent de code qui fonctionne hors ligne et garde votre code sur votre machine, et vous possédez un Mac M4 ou M5 Pro/Max de 48 Go.
- Vous travaillez de façon interactive, en lisant chaque diff, et préférez un modèle qui répond en quelques secondes à un modèle qui répond un peu mieux en une minute.
- Vous construisez sur des poids ouverts et avez besoin d'une licence commercialement permissive pour le finetuning ou la redistribution, la même raison qui pousse les équipes vers les agents IA open source.
Passez votre chemin, pour l'instant, si :
- Vous voulez le modèle local le plus fort par réponse. Qwen 3.8 en 27B dense gagne toujours sur la plupart des tests de code, à un dixième de la vitesse ; ma liste d'alternatives à Qwen couvre le reste des rivaux de cette famille.
- Vous exécutez de longs agents sans surveillance où un appel d'outil cassé vous coûte toute une exécution.
- Vous avez besoin d'une API payante et supportée avec SLA. Elle n'existe pas encore, donc un outil hébergé comme GitHub Copilot ou Windsurf est l'achat le plus sûr.
Si vous comparez Flint à des options hébergées, mon avis sur Kimi K3.1 Pro et mon avis sur DeepSeek V4 Flash couvrent les alternatives proches, et les outils d'assistants de code IA couvrent les harnais dans lesquels vous les exécuteriez.
Pour d'autres modèles ouverts qui méritent un coup d'œil ce mois-ci, voir Nemotron 3.5 Bolt, LFM3 et Nanbeige 4.3.
La plus grande histoire, c'est le laboratoire, pas le modèle. Un modèle de 40B construit de zéro en moins de quatre mois, avec un système automatisé qui fait une bonne partie de la recherche, voilà l'affirmation à suivre. Le pari de Recursive est que chaque modèle fait de la Eureka Machine une meilleure chercheuse. Si Flint 2 comble l'écart avec Qwen à la même vitesse, cet avis deviendra bien plus positif.
Ce que Flint signifie si vous dirigez une équipe de support
Flint est de l'infrastructure : un modèle sur lequel tourne un agent de code. Même choisir un modèle pour le support est une question à part, que je traite dans mon guide des LLM pour le support client. Si votre problème est une file de support plutôt qu'une base de code, le modèle n'a jamais été la partie difficile. Le difficile, c'est tout ce qui l'entoure : se connecter à Zendesk ou Freshdesk, apprendre de vos anciens tickets, savoir quand passer la main, et prouver qu'il ne donnera pas de réponse fausse avec aplomb avant qu'un client la voie. eesel passe des années à placer des agents IA sur des files de support en production, et la leçon que je vois le plus souvent réapprise est que chaque déploiement doit être simulé sur des tickets historiques avant d'être mis en ligne.
C'est ce que sont les coéquipiers IA d'eesel, et c'est pourquoi j'orienterais un responsable support vers eux avant tout kit d'agents IA : des employés prêts à travailler pour une mission définie, pas un modèle autour duquel on assemble un produit. Le coéquipier helpdesk IA est celui qui convient au support.
SE Ranking, par exemple, fait tourner trois agents eesel sur trois connexions Zendesk, un par produit, et a traité 4 650 conversations en un mois, dont environ 2 100 chats en direct auxquels eesel a répondu en premier. SamCart fait tourner un agent sur les tickets Freshdesk et un autre sur le chat de son site, en répondant à partir de 280 articles du centre d'aide.
Et c'est là que les deux mondes se rejoignent. eesel a une CLI, si bien que le même agent de code que vous feriez tourner sur Flint, Claude Code ou Codex peut piloter votre coéquipier support depuis un terminal : eesel activity pour lire ce que l'agent a fait sur chaque ticket, eesel instructions pour modifier ses règles permanentes, eesel approvals pour valider les actions qu'il attend. Chaque commande affiche du JSON, et --dry-run montre l'appel exact qu'une écriture ferait avant de l'envoyer. La documentation va jusqu'à dire aux agents IA d'utiliser la CLI plutôt que de cliquer dans le tableau de bord. Si vous vous demandez comment cela se compare à une solution maison, j'ai écrit séparément sur les CLI d'agents IA et la voie du serveur MCP.
Essayer eesel
Vous voulez une IA pour votre helpdesk sans la construire sur un modèle brut ? Le coéquipier helpdesk d'eesel se branche en quelques minutes sur Zendesk, Freshdesk ou Gorgias, apprend de vos anciens tickets et de votre centre d'aide, et est testé dessus avant de répondre à qui que ce soit. Chaque action apparaît dans un journal d'activité que vous pouvez lire dans le tableau de bord ou récupérer depuis la CLI. C'est gratuit pour commencer, sans carte.

Comment Recursive Flint se compare-t-il à Qwen 3.8 ?