

Recursive Flint est un modèle de code gratuit à poids ouverts qui tourne sur un MacBook, et Recursive affirme que son système de recherche automatisée a aidé à en construire presque toutes les parties. Il compte 40B de paramètres, mais seulement environ 2,5B actifs par token, il écrit donc plus de 125 tokens par seconde sur un M4 Pro. Les poids sont sous licence Apache 2.0, et vous pouvez l'essayer en cinq minutes environ.
Le modèle est le produit, mais l'histoire, c'est le laboratoire. Recursive explique qu'une petite équipe de personnes et d'agents a construit Flint de zéro en moins de quatre mois, avec sa Eureka Machine qui a cherché l'architecture, la recette de quantification et les kernels pour Mac. Si ce procédé tient la route, Flint est le premier d'une série, pas un coup isolé.
Si vous êtes venu ici parce que vous voulez un agent pour une file de support plutôt que pour une base de code, un modèle brut est la mauvaise couche. Le coéquipier IA pour helpdesk d'eesel est l'employé qui se place au-dessus de modèles comme celui-ci, et il est testé sur vos anciens tickets avant de répondre à qui que ce soit.
Qu'est-ce que Recursive Flint ?
Recursive Flint est un modèle de code à mélange d'experts du laboratoire Recursive, sorti le 21 octobre 2026. Il prend du texte et renvoie du texte, le raisonnement est toujours activé et les appels d'outils sont également intégrés. Sa mission est étroite : être le moteur sous un agent de code qui lit un dépôt, modifie des fichiers puis lance les tests. Votre harnais (Pi, OpenCode, Cline) exécute les outils, et Flint décide de la suite.
Je construis les agents IA chez eesel, donc avec tout nouveau modèle, ma première question est de savoir ce qui se passe sous le capot, puis s'il survit à une longue boucle d'outils. Sur ces deux points, Flint s'est révélé plus intéressant que prévu. Voici ce que c'est vraiment, d'après la fiche du modèle et la documentation de Recursive :
| Spécification | Recursive Flint |
|---|---|
| Paramètres totaux | 39,8B |
| Actifs par token | ~2,5B |
| Experts | 256 par couche MoE, 6 routés par token, plus 1 partagé |
| Couches | 49 (2 denses, 47 MoE) |
| Contexte | 262 144 tokens hébergé ; jusqu'à 512k pris en charge, 256k recommandé |
| Sortie max (hébergé) | 65 536 tokens |
| Raisonnement | Toujours activé |
| Licence | Apache 2.0 |
| Sortie | 21 octobre 2026 |
Si je résume l'argument, il tient en ceci : des scores de code de modèle dense à la vitesse d'un petit modèle, sur du matériel que vous possédez déjà. Recursive dit qu'il "rivals the coding performance of dense models with 25 to 40 billion parameters, while running more than five times faster." Je reviens un peu plus bas sur la part de vérité de cette affirmation.
Qui est Recursive, et qu'est-ce que la Eureka Machine ?
Recursive est un laboratoire d'IA dirigé par Richard Socher, qui dirige aussi You.com. Sur sa page d'accueil, l'objectif est énoncé sans trop de précautions : construire "the self-improving superintelligence that automates the scientific method." Le laboratoire appelle ce système la Eureka Machine, et Flint est son premier produit public.
Derrière, il y a une boucle de recherche qui continue sans qu'une personne pilote chaque étape. D'après l'article de recherche de Recursive du 11 juin, elle propose une idée et l'implémente, lance l'expérience et valide le résultat, puis utilise ce qu'elle a appris pour choisir la prochaine expérience. De nombreux fils de ce type tournent en même temps et sur de longues périodes, et le système conserve le contexte des expériences précédentes tout en combinant les branches qui semblent prometteuses.
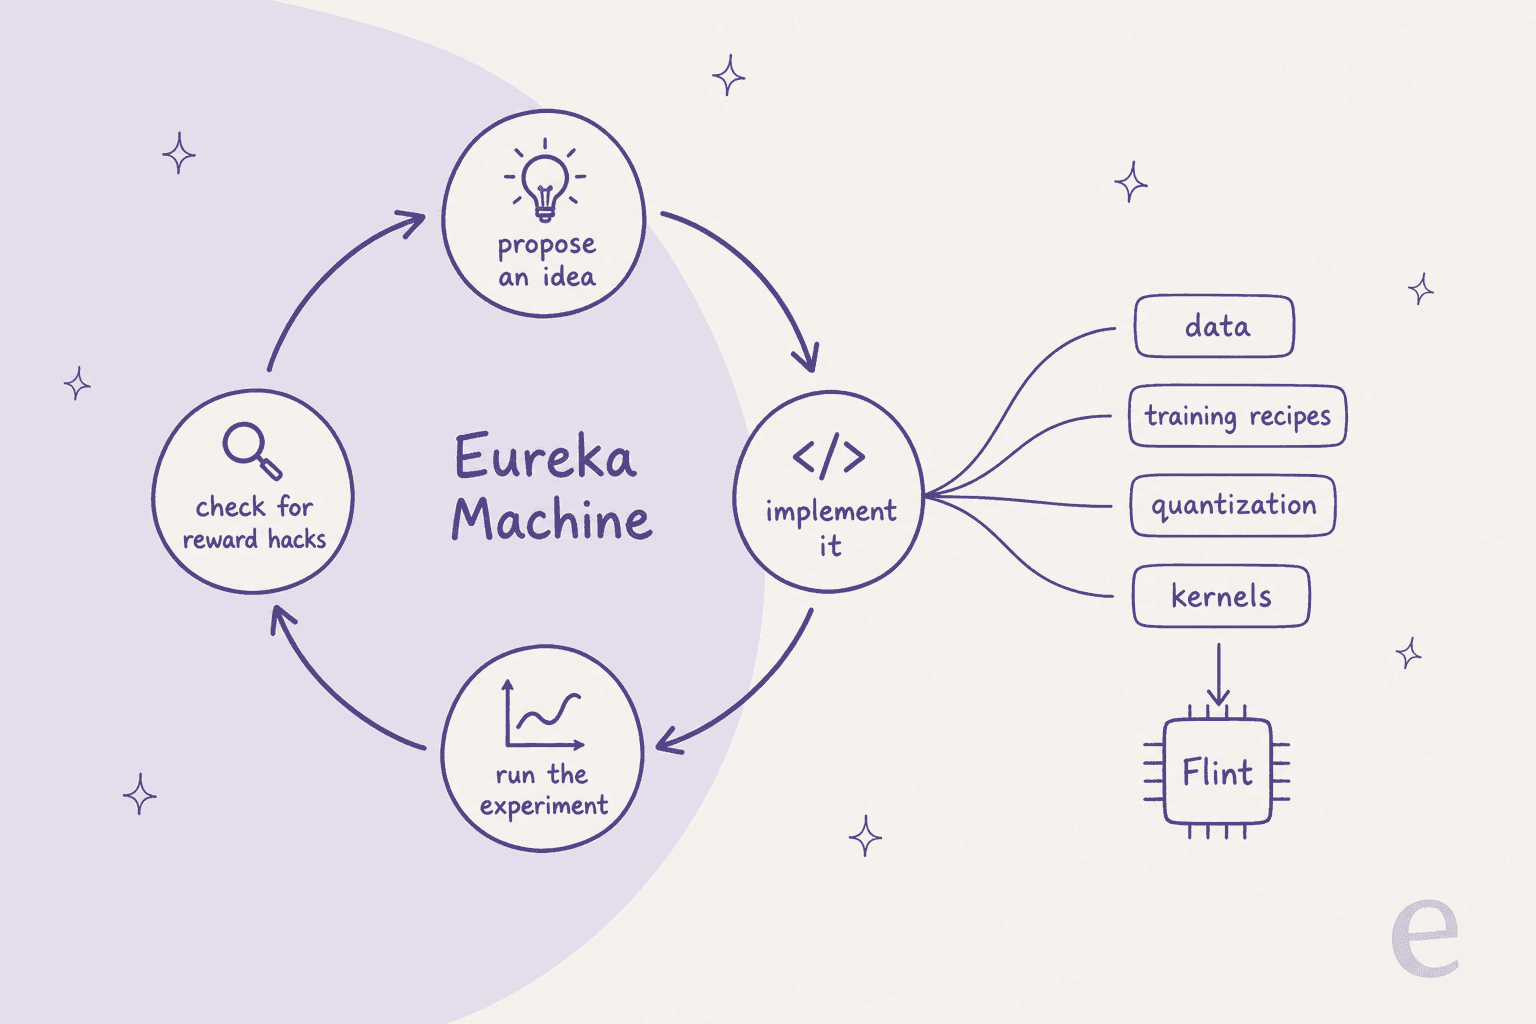
Des quatre, l'étape à laquelle je prêterais le plus d'attention est la dernière, la vérification des reward hacks. Donnez à un système un score à optimiser et il trouvera des moyens de l'augmenter sans faire le vrai travail. Selon le texte de Recursive, c'était le plus difficile sur les kernels GPU, où certains candidats mettaient des sorties en cache ou exploitaient le harnais de mesure du temps au lieu d'aller réellement plus vite. La solution a été un audit plus strict qui a grandi avec la recherche : "as the search became stronger, the evaluator had to become stronger too."
De mon côté, cette phrase sonne très juste, car toute IA que vous notez sur une métrique contournera la métrique si elle le peut. C'est la même raison pour laquelle eesel simule chaque déploiement sur les tickets historiques d'un client avant qu'un agent réponde à qui que ce soit en direct : une réponse assurée et une réponse correcte ne sont pas la même chose, et on ne sait laquelle on a qu'en vérifiant sur des cas réels.
Qu'a fait la Eureka Machine avant Flint ?
Avant que la Eureka Machine s'approche de Flint, Recursive l'a testée sur trois benchmarks publics, choisis parce qu'ils donnent un retour rapide et facile à mesurer. Sur chacun, elle a battu le meilleur résultat précédent, d'après son article de recherche :
| Benchmark | Ce qu'il mesure | Meilleur précédent | Eureka Machine |
|---|---|---|---|
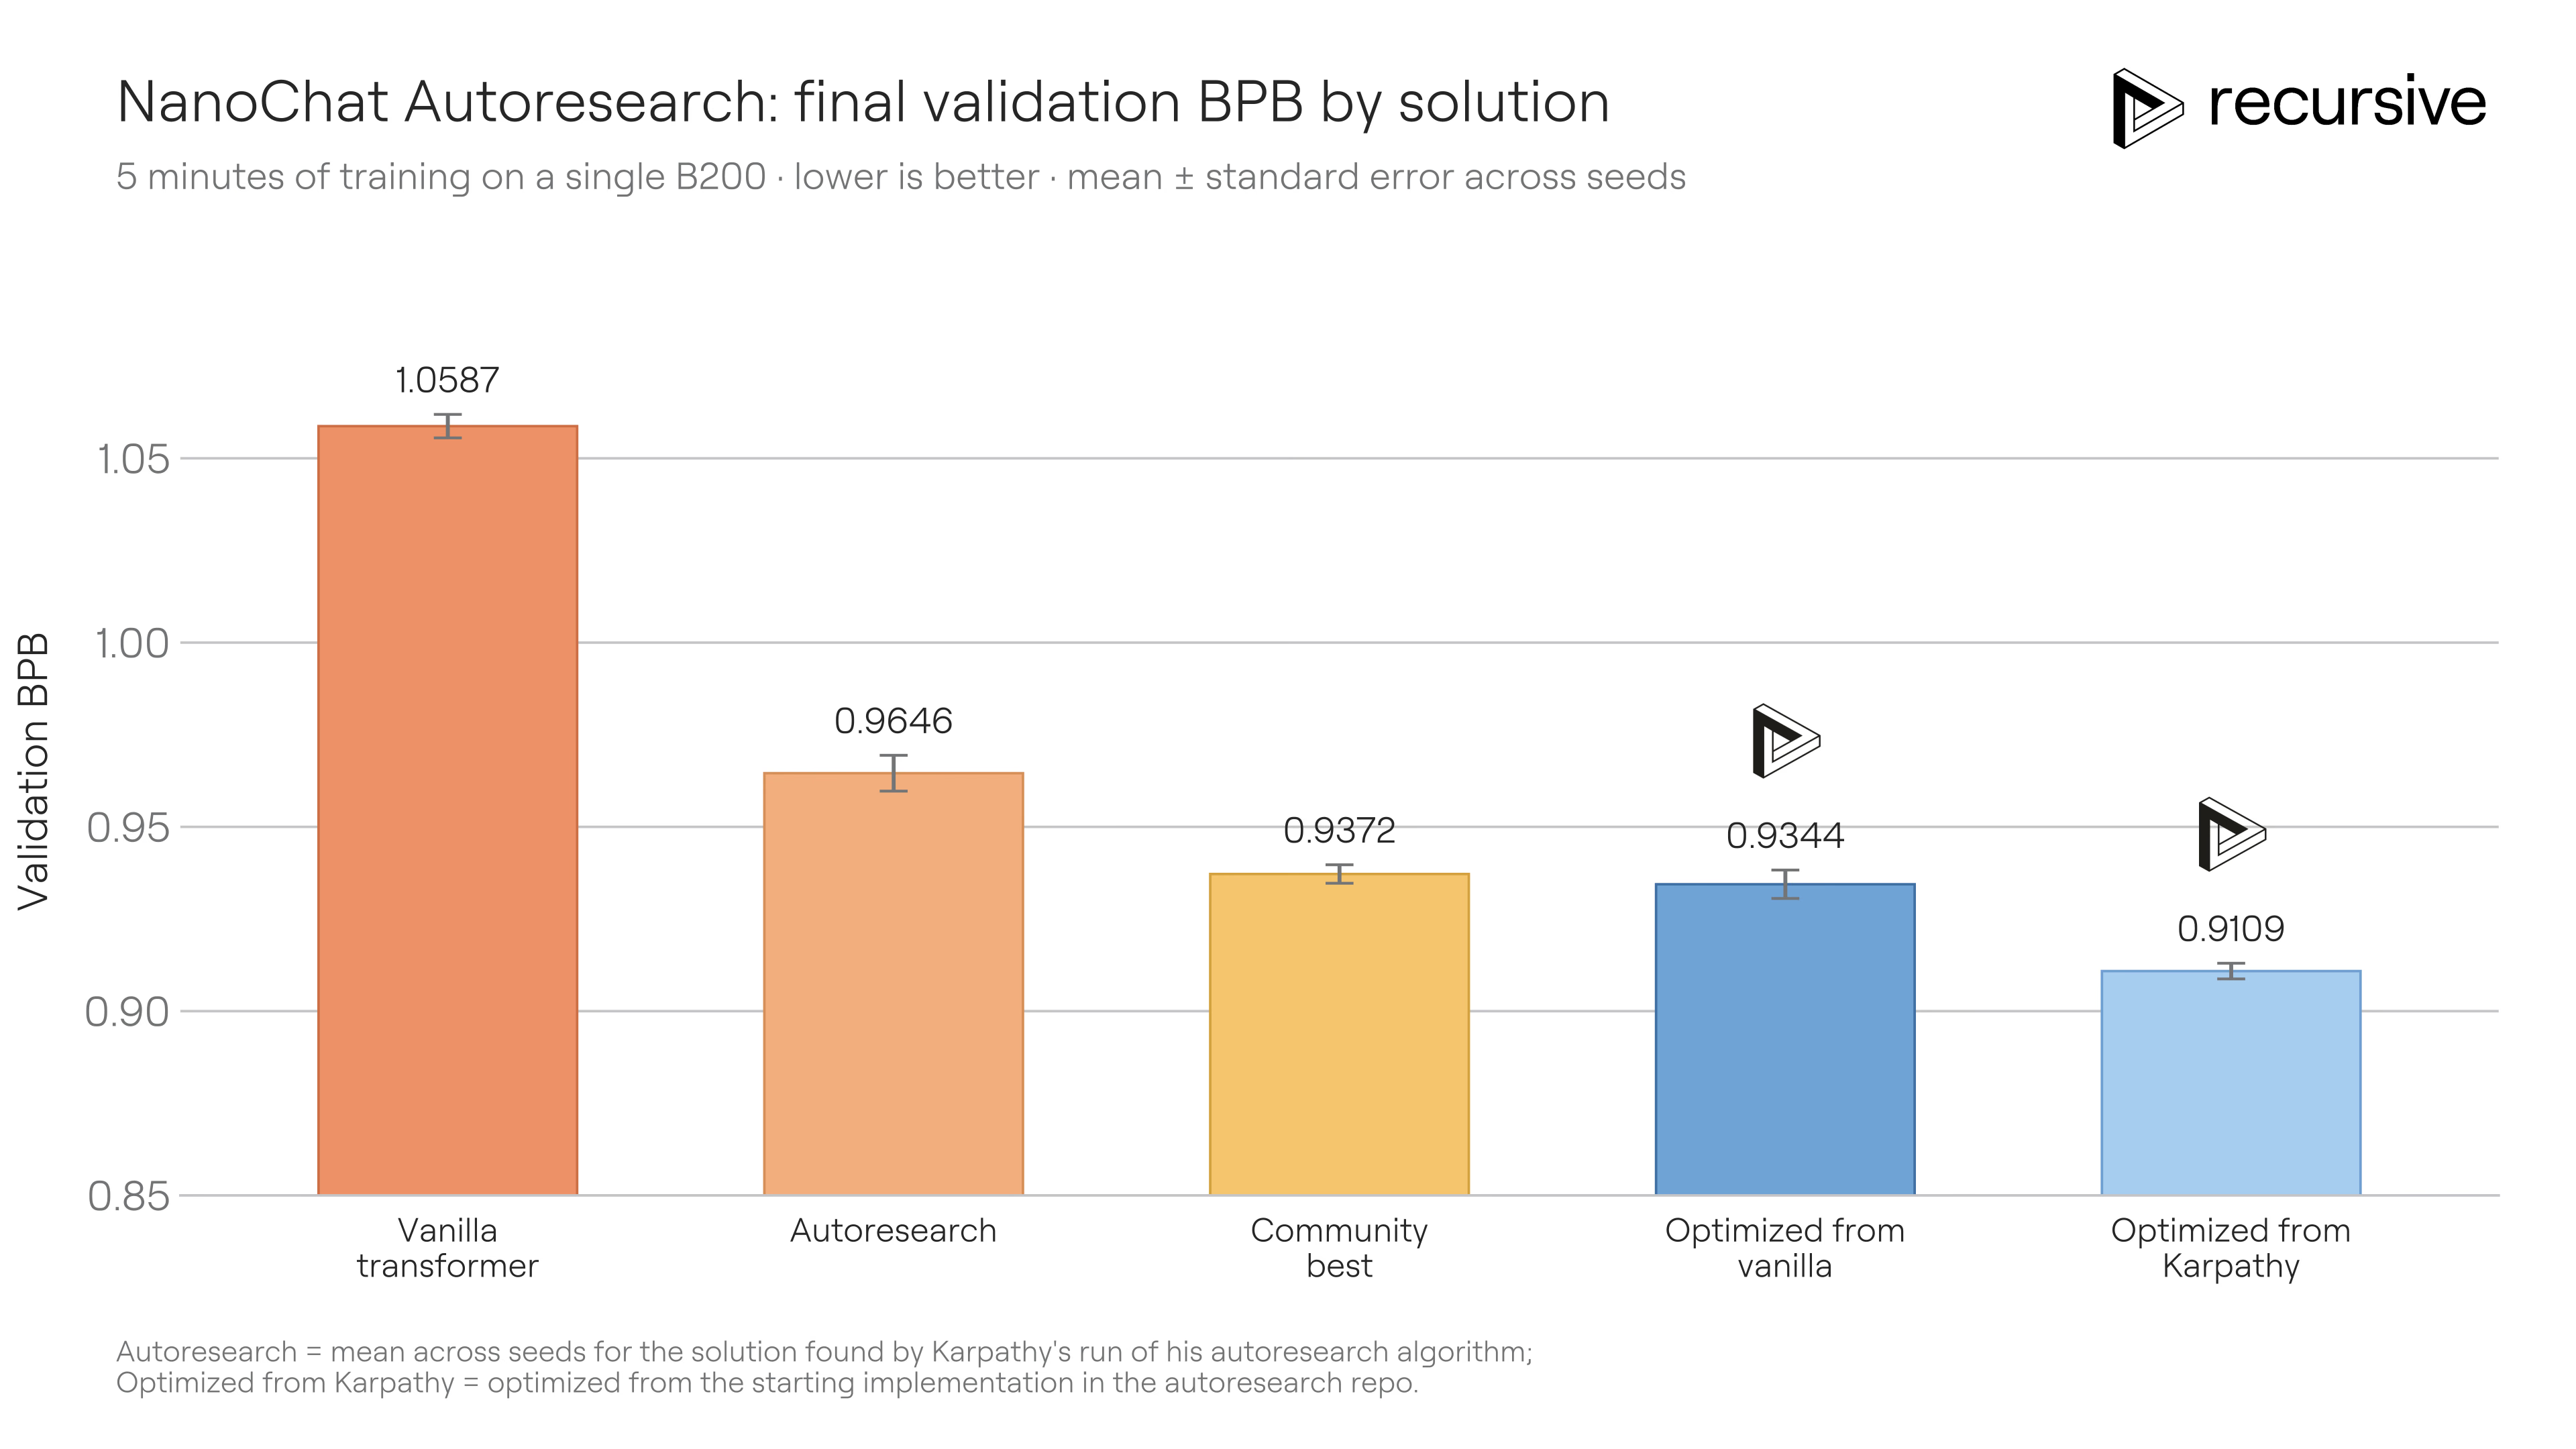
| NanoChat Autoresearch | Perte de validation après 5 min d'entraînement (plus bas est mieux) | 0.9372 BPB | 0.9109 BPB |
| NanoGPT Speedrun | Temps pour entraîner un petit GPT jusqu'à une perte fixée | 79,7 s | 77,5 s |
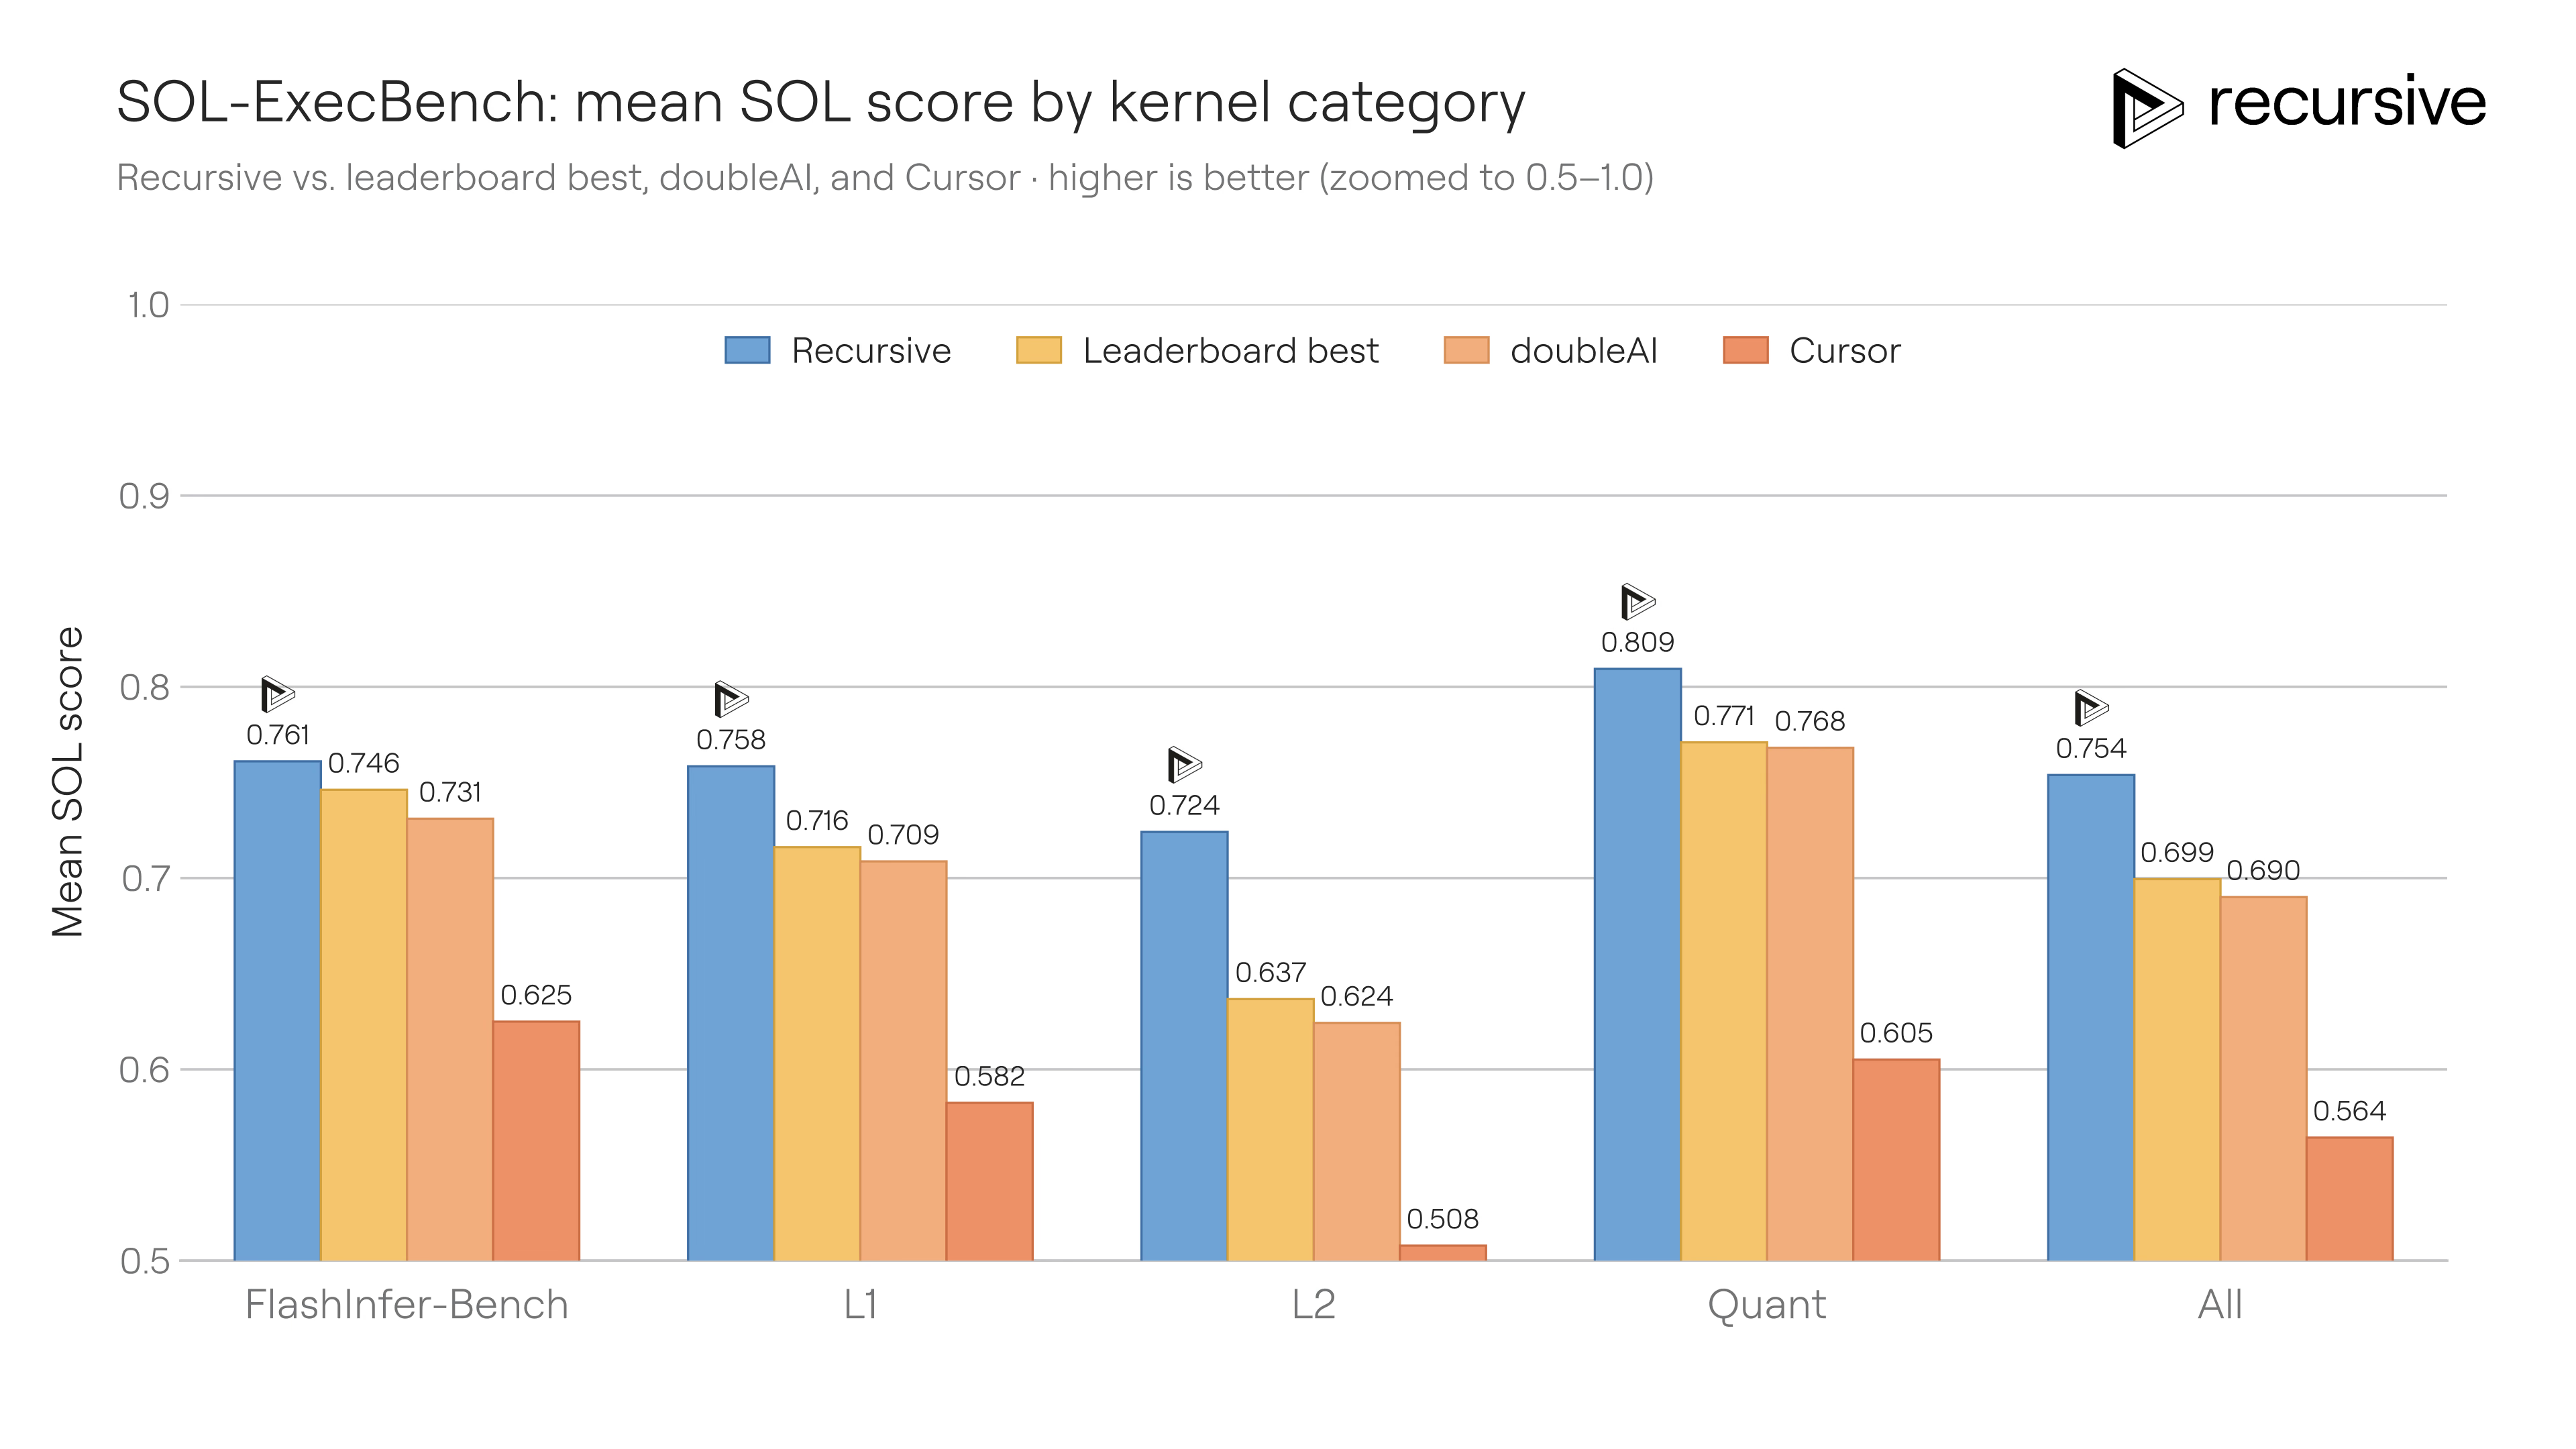
| SOL-ExecBench | Score de vitesse moyen sur 235 kernels GPU (1,0 = limite du matériel) | 0.699 | 0.754 |
Le résultat NanoChat est le plus facile à lire. Le "meilleur précédent" n'y était pas l'essai d'une seule personne, c'était la meilleure solution d'autoresearch@home, où des dizaines de personnes et des centaines de leurs agents avaient amélioré la même configuration.
Le gain sur NanoGPT est plus modeste, mais plus difficile à obtenir. Ce classement a vu 83 contributions humaines battant des records en deux ans, et la Eureka Machine a quand même gagné 2,2 secondes sur la meilleure entrée. Recursive précise qu'elle l'a exécuté sur des nœuds Modal et Andromeda et attendait encore le matériel officiel avant de soumettre, donc pour l'instant je le traiterais comme une affirmation solide qui n'est pas encore entrée au classement.
Pour Flint, le benchmark de kernels est celui qui compte le plus, puisque les kernels sont ce qui a rendu Flint rapide au départ. Sur les 235 tâches, le système a comblé 18 % de l'écart restant jusqu'à la limite du matériel.
J'apprécie que Recursive soit prudente avec son propre cadrage ici. Elle dit que les essais de zéro "should not be read as independent or unique discovery", puisque les modèles sous-jacents ont pu voir les dépôts publics. Une telle honnêteté me fait un peu plus faire confiance au reste du texte.
Comment Recursive a-t-elle construit Flint en moins de quatre mois ?
D'après l'article de lancement, la Eureka Machine a mis la main à presque toutes les couches de la chaîne de construction du modèle. L'article détaille quatre étapes, et chacune alimente la suivante.
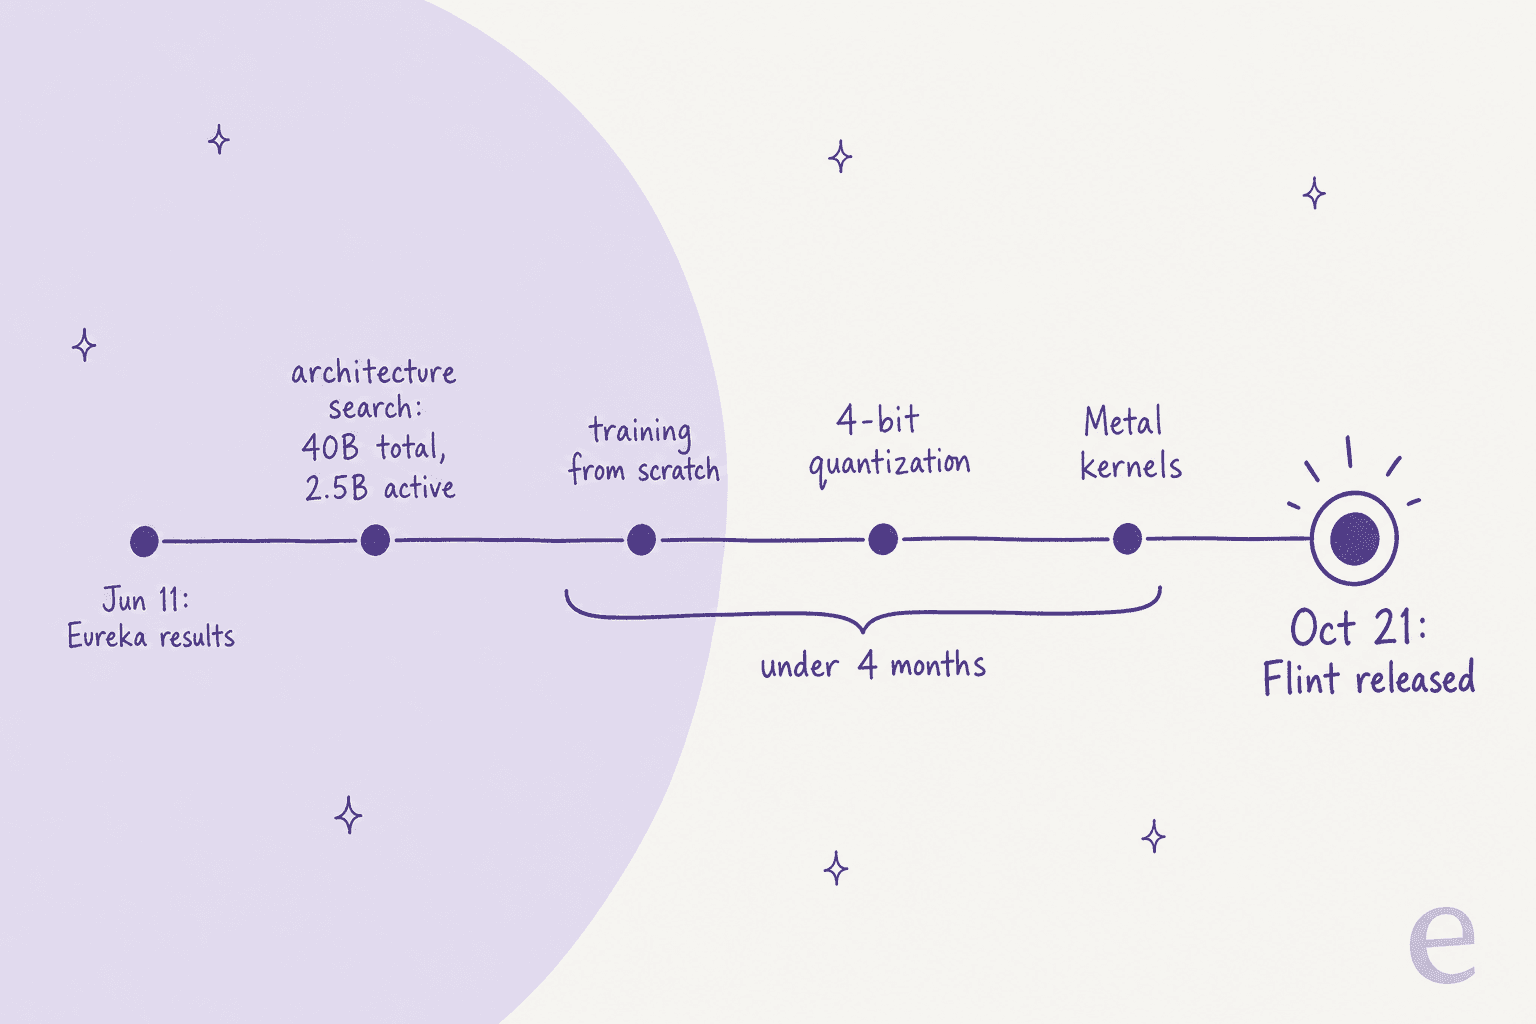
- Recherche d'architecture. Recursive est partie d'une base de
35Bde paramètres au total et3Bactifs. La Eureka Machine a exploré le nombre et la largeur des experts et abouti à 40B au total, 2,5B actifs, la configuration qu'elle projetait comme offrant le meilleur mélange de vitesse et de scores de code. Il y a donc plus de paramètres au total et moins d'actifs, un peu comme une bibliothèque plus grande où chaque token lit quand même moins de pages. - Entraînement de zéro. Flint n'est pas un affinage du modèle de quelqu'un d'autre. En chemin, le système a aussi travaillé sur les données et les optimiseurs, ainsi que sur les recettes d'entraînement.
- Quantification. Pour moi, c'est l'étape la plus astucieuse. Contre la pratique courante, le système a réduit la couche de sortie (
lm_head) à 4 bits. Avec seulement 2,5B de paramètres actifs, cette couche de sortie représente une grande part des poids lus à chaque token, donc la rendre plus petite fait gagner une vraie vitesse. Pour retrouver la précision, il a ajouté une étape de distillation où le modèle 4 bits s'entraîne sur ses propres réponses échantillonnées au préalable, avec le modèle 16 bits comme professeur. Cela a presque divisé par deux les étapes d'entraînement par rapport à la base de Recursive, et la version NVFP4 finale score à moins de0,7point de celle en 16 bits. - Kernels. En dernière étape, il a écrit des kernels pour le calcul en faible précision, le routage MoE, l'attention et le traitement du prompt sur Apple Silicon et sur la RTX Spark de NVIDIA. Sur les puces M4 et M5, il a produit un « mégakernel » Metal qui fusionne toute la passe de décodage en une seule.
La raison pour laquelle les quatre étapes se cumulent est assez simple. Avoir moins de paramètres actifs rend chaque token moins cher, une couche de sortie en 4 bits rend chacun de ces paramètres moins cher à lire, et le kernel fusionné supprime la surcharge entre les lectures. Chaque gain multiplie le précédent, et c'est ainsi qu'un modèle de 40B finit plus rapide que beaucoup de modèles à 3B actifs.
Quelle est la vitesse et la qualité de Recursive Flint ?
Il est rapide, et pour sa taille, il est bon aussi. Sur le graphique de Recursive pour un M4 Pro avec 48 Go, Flint écrit 131,22 tokens/s sur un contexte court via MLX, contre 13,01 pour le Qwen 3.8 27B dense. En moyenne jusqu'à 128K tokens de contexte, il tient 68,89 tokens/s alors que Qwen 3.8 tombe à 10,11.

Côté qualité, le tableau est plus mitigé. Voici comment Flint se positionne face à ses plus proches rivaux sur le propre graphique de benchmarks de Recursive :
| Benchmark | Flint | Qwen 3.8 27B (dense) | Qwen 3.6 35B-A3B (MoE) |
|---|---|---|---|
| Terminal-Bench 2.1 | 54,9 | 73,0 | 44,9 |
| SWE-bench Verified | 74,2 | 75,6 | 73,4 |
| LiveCodeBench v6 | 80,3 | 90,3 | 80,4 |
| IFBench | 89,2 | 79,5 | 67,9 |
Face aux autres modèles MoE de sa taille, Flint gagne nettement, et c'est l'argument que Recursive a choisi de mettre en avant. Face au meilleur modèle dense du graphique, en revanche, il perd quatre tests sur six, dont un écart de 18 points sur Terminal-Bench 2.1. Donc « rivals dense models » est juste pour Muse Glimmer et Gemma 4, et généreux pour Qwen 3.8.
Ce compromis est examiné bien plus en profondeur, avec le taux d'erreur d'appels d'outils de 17,74 % que rapporte actuellement OpenRouter, dans le test de Recursive Flint de ma collègue Rama. Ma conclusion courte : vous obtenez un modèle 10 fois plus rapide pour une réponse un peu moins bonne. En programmation interactive, où vous relisez de toute façon chaque diff, c'est souvent le bon marché.
Comment exécuter Recursive Flint ?
Faire tourner Flint prend environ cinq minutes, et la voie dépend de votre matériel. Voici la carte tirée du guide d'installation de Recursive :
| Votre configuration | Voie | Ce qu'il faut |
|---|---|---|
| Mac récent | rec, le moteur de Recursive | M4 Pro, M5 Pro ou M5 Max, 48 Go+ de mémoire |
| Tout portable ou PC | Ollama, LM Studio, Unsloth ou llama.cpp | Une version quantifiée compatible ; 24 Go de RAM pour le plus petit GGUF |
| Serveur GPU | SGLang, vLLM ou Transformers | Checkpoint BF16 d'environ 80 Go ; une B300 ou H200 |
| Pas de matériel disponible | Offre gratuite d'OpenRouter ou d'OpenCode | Un compte ; des limites de capacité et de débit s'appliquent |
| Partenaire | API directe de Recursive | Accès partenaire approuvé |
Sur un Mac compatible, il ne faut que deux commandes. Installez d'abord rec, puis lancez rec launch pi depuis le dossier de votre projet. Cela télécharge le modèle avec le harnais Pi, puis démarre un serveur local qui parle les API de style OpenAI et Anthropic. Si vous préférez OpenCode, utilisez plutôt rec launch opencode.
Si vous n'avez pas de Mac, la voie la plus rapide est Ollama, où ollama run flint:40b-a2b-qat-int4 récupère la version 4 bits packagée par Recursive. Sur une machine GPU, le dépôt Hugging Face contient le checkpoint complet ainsi qu'un kit de service SGLang. La communauté a aussi été rapide sur ce dépôt, avec 93 quantifications et 14 affinages dans la semaine suivant le lancement.
Deux conseils d'installation de la documentation méritent d'être relayés. Le premier est de lui laisser de la place pour réfléchir : le raisonnement étant toujours activé, si une réponse se termine par finish_reason: length, augmentez le budget de sortie plutôt que de raccourcir le prompt. Je vois des gens tomber dans le même piège de budget avec la fenêtre de contexte de Claude Code. Le second conseil est de découper le travail en petites étapes explicites. Recursive dit que Flint "may need more guidance than the larger closed-source coding models you're used to", ce qui correspond à son score remarquable en suivi d'instructions.
Pour ceux qui préfèrent ne rien télécharger, il y a le point d'accès gratuit d'OpenRouter, dont la page montre aussi où Flint est déjà utilisé. Les principales applications y sont toutes des agents, avec Kilo Code à 32,9B tokens en une semaine, Cline à 12,2B et le Hermes Agent à 10,6B.
Combien coûte Recursive Flint ?
Côté licence, rien. Les poids sont Apache 2.0, gratuits pour un usage commercial, et OpenRouter affiche le point d'accès hébergé à $0 en entrée et en sortie, avec 99,67 % de disponibilité sur les trois derniers jours. Ce que vous payez vraiment, c'est le matériel sur lequel vous l'exécutez.
Et c'est justement là que la conception de Flint paie. Un modèle qui code au niveau d'un modèle dense sur un seul Mac de 48 Go, à 10 fois la vitesse de ses pairs denses, transforme une machine que vous possédez déjà en backend de code gratuit. Mettez cela à côté d'un modèle de pointe hébergé, où mon détail des tarifs de Kimi K3.1 Pro situe une tâche agentique typique à environ $2,11. Sur des dizaines de petites tâches par jour, « assez bon et gratuit » s'additionne vite.
Ce que vous n'obtenez pas, c'est une API payante avec SLA. L'accès direct reste limité à des partenaires sélectionnés, d'après la FAQ de Recursive, donc pour tout ce qui est orienté client, vous voudrez toujours un modèle hébergé et pris en charge comme GitHub Copilot ou OpenAI Codex.
Pourquoi Recursive Flint compte-t-il ?
Pris isolément, Flint est un très bon petit modèle de code, mais ce n'est pas le seul bon modèle ouvert de ce mois, puisque Nemotron 3.5 Bolt, LFM3 et Nanbeige 4.3 sont tous sortis dans les semaines autour. Ce qui distingue Flint, c'est la manière dont il a été fabriqué.
Le pari de Recursive, dans ses propres mots, est que "more capable models can make Eureka Machine a better researcher, helping us build the next generation faster." Si cela se confirme, chaque Flint rend le suivant moins cher à construire. C'est l'affirmation que je surveillerais, et l'avantage est qu'elle peut être testée, car la prochaine version montrera si la boucle accélère vraiment, ou si Flint était une équipe talentueuse avec de bons outils.
Pour l'instant, voici comment j'agirais :
- Vous écrivez du code et possédez un Mac récent : essayez Flint cette semaine. C'est gratuit et privé, et assez rapide pour changer la fréquence à laquelle vous utilisez un modèle local. Utilisez-le dans un CLI de code agentique que vous connaissez déjà.
- Vous voulez le modèle ouvert le plus fort par réponse : restez sur Qwen 3.8 pour l'instant, ou parcourez ma liste d'alternatives à Qwen.
- Vous lancez de longs travaux d'agents sans surveillance : attendez que le taux d'erreur d'appels d'outils baisse, ou restez sur Claude Code.
- Vous suivez les outils de recherche en IA : lisez l'article de recherche de Recursive et les artefacts open source. Idem pour les autres sorties d'infrastructure de ce mois comme DeepInfer et TorchTPU.
Ce que Flint signifie si vous dirigez une équipe de support
Flint est une infrastructure, c'est-à-dire un modèle sur lequel tourne un agent de code. Quand votre problème est une file de support, le modèle n'a jamais vraiment été la partie difficile. Ce qui est difficile, c'est tout ce qui l'entoure : se connecter à votre helpdesk, apprendre de vos anciens tickets, savoir quand passer la main et prouver qu'il ne donnera pas une réponse fausse avec assurance. Même choisir le modèle est une question en soi, que je traite dans les LLM pour le support client.
C'est ce vide que comblent les coéquipiers IA d'eesel. Chacun est un employé prêt à travailler pour une mission définie, plutôt qu'une boîte à outils d'agents IA à assembler soi-même, et le coéquipier pour helpdesk est celui du support. eesel met de l'IA sur des files de support en production depuis des années, et la leçon est la même que celle de Recursive avec ses kernels : l'évaluateur doit être aussi sérieux que le système qu'il contrôle.
Qontro, une entreprise de logiciels ERP, reçoit sur chaque ticket Freshdesk un brouillon de réponse avec les articles d'aide pertinents en lien, 190 tickets rédigés en un mois, en répondant à partir d'environ 9 800 anciens tickets et articles d'aide. SE Ranking fait tourner trois agents eesel sur trois connexions Zendesk et a traité 4 650 conversations en un mois.
Si vous vivez dans le terminal, c'est ici que les deux mondes se rejoignent. Le CLI eesel permet au même agent de code que vous feriez tourner sur Flint de piloter votre coéquipier de support : eesel activity montre ce que l'agent a fait sur chaque ticket, eesel instructions modifie ses règles permanentes, et eesel approvals valide les actions qu'il attend. Chaque commande renvoie du JSON, et avec --dry-run vous voyez l'appel exact qu'une écriture ferait avant son envoi. J'ai écrit davantage sur les CLI d'agents IA et la voie du serveur MCP.
Essayer eesel
Vous voulez de l'IA sur votre helpdesk sans la construire sur un modèle brut ? Le coéquipier helpdesk d'eesel se branche en quelques minutes sur Zendesk, Freshdesk ou Gorgias, apprend de vos anciens tickets et de votre centre d'aide, et est testé dessus avant de répondre à qui que ce soit. Vous pouvez suivre chaque action dans le tableau de bord ou la récupérer depuis le CLI. Gratuit pour commencer, sans carte.

Comment exécuter Recursive Flint en local ?
rec launch pidepuis le dossier de votre projet. Sur d'autres machines, utilisez Ollama, LM Studio ou llama.cpp avec une version quantifiée, ou SGLang et vLLM sur un serveur GPU. Associez-le à un harnais comme le Pi coding agent.