

En bref
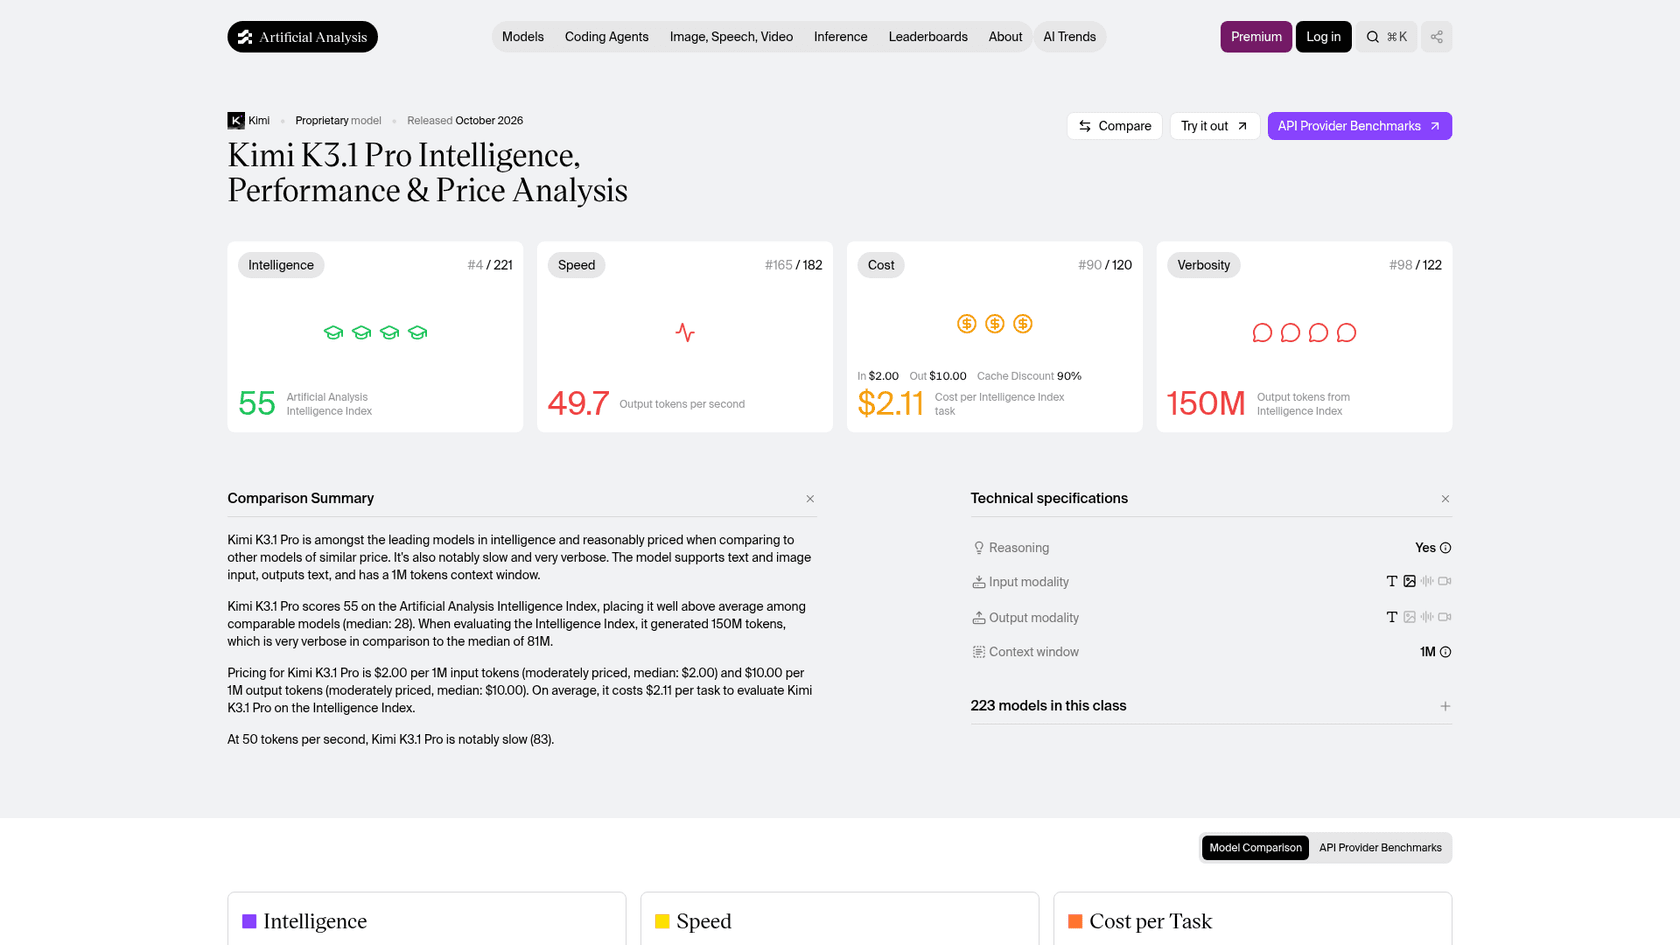
Kimi K3.1 Pro est le modèle à poids ouverts le plus performant annoncé à ce jour, avec un score de 55 sur l’Artificial Analysis Intelligence Index, à 2.5 points de Claude Opus 5.5, pour 2 $ en entrée et 10 $ en sortie par million de tokens. Moonshot l’a lancé le 23 octobre 2026 comme une version de Kimi K3 ayant bénéficié d’un post-entraînement intensif, et le bond est réel : Terminal-Bench 4.0 est passé de 12.6% à 67.2% sur Artificial Analysis.
Le problème, c’est tout ce qui entoure ces scores. Il tourne à environ 50 tokens par seconde, presque en bas de sa catégorie. Les poids sont promis "by Nov 4", donc aujourd’hui, il n’est accessible que par API. Et les premiers abonnés à Kimi Code signalent qu’ils épuisent leur quota de 5 heures en moins d’une heure. La baisse de prix s’applique par token, pas par réponse : ses réponses sont longues, si bien que l’exécution de l’ensemble de l’indice de benchmarks coûte $3,117, contre $3,658 pour K3, soit une économie de 15 %, et non de 33 %.
Si vous choisissez un modèle pour un agent de support IA, le modèle représente la plus petite partie du travail. J’ai passé des années chez eesel à déployer de l’IA sur des files de tickets en production, et le plus difficile n’est jamais le moteur. C’est la connexion au helpdesk, les règles de transfert et les tests sur de vrais tickets passés. SE Ranking utilise cette couche pour trois produits sur Zendesk, soit environ 4,650 conversations par mois.
Qu’est-ce que Kimi K3.1 Pro ?
Kimi K3.1 Pro est le nouveau modèle phare de Moonshot AI, et aussi la première version de sa série K3.1. Moonshot le présente comme "our most capable 3T-class open-weight model to date", avec une fenêtre de contexte de 1 million de tokens. Sous le capot, c’est un modèle à mélange d’experts, avec 2.8T paramètres au total et 104B paramètres actifs, selon le post de lancement sur X.
Il existe en deux variantes : Kimi K3.1 Pro est la version standard, et Kimi K3.1 Pro Highspeed est le même modèle, mais servi "2-3× faster" pour le double du prix. Les deux ont été mis en ligne le même jour, sur kimi.ai, les applications Kimi, Kimi Work, Kimi Code et l’API Kimi.
Moonshot met en avant quatre domaines d’amélioration : le développement, la création 3D, la recherche financière et les tâches d’agents de longue durée. Si vous avez suivi le lancement de Kimi K3 en juillet, voici la version courte : pour les tâches d’agents, K3.1 Pro est le modèle que K3 était censé être.
Qu’est-ce qui a changé par rapport à Kimi K3 ?
Pour être clair, Kimi K3.1 Pro n’est pas un nouveau modèle de base. Moonshot le décrit comme "a post-trained version of Kimi K3, with substantially larger post-training compute", utilisant l’apprentissage par renforcement dans "hundreds of downstream domains". Les poids 2.8T sont donc les mêmes ; ce qui a changé, c’est la quantité d’entraînement consacrée à leur utilisation.
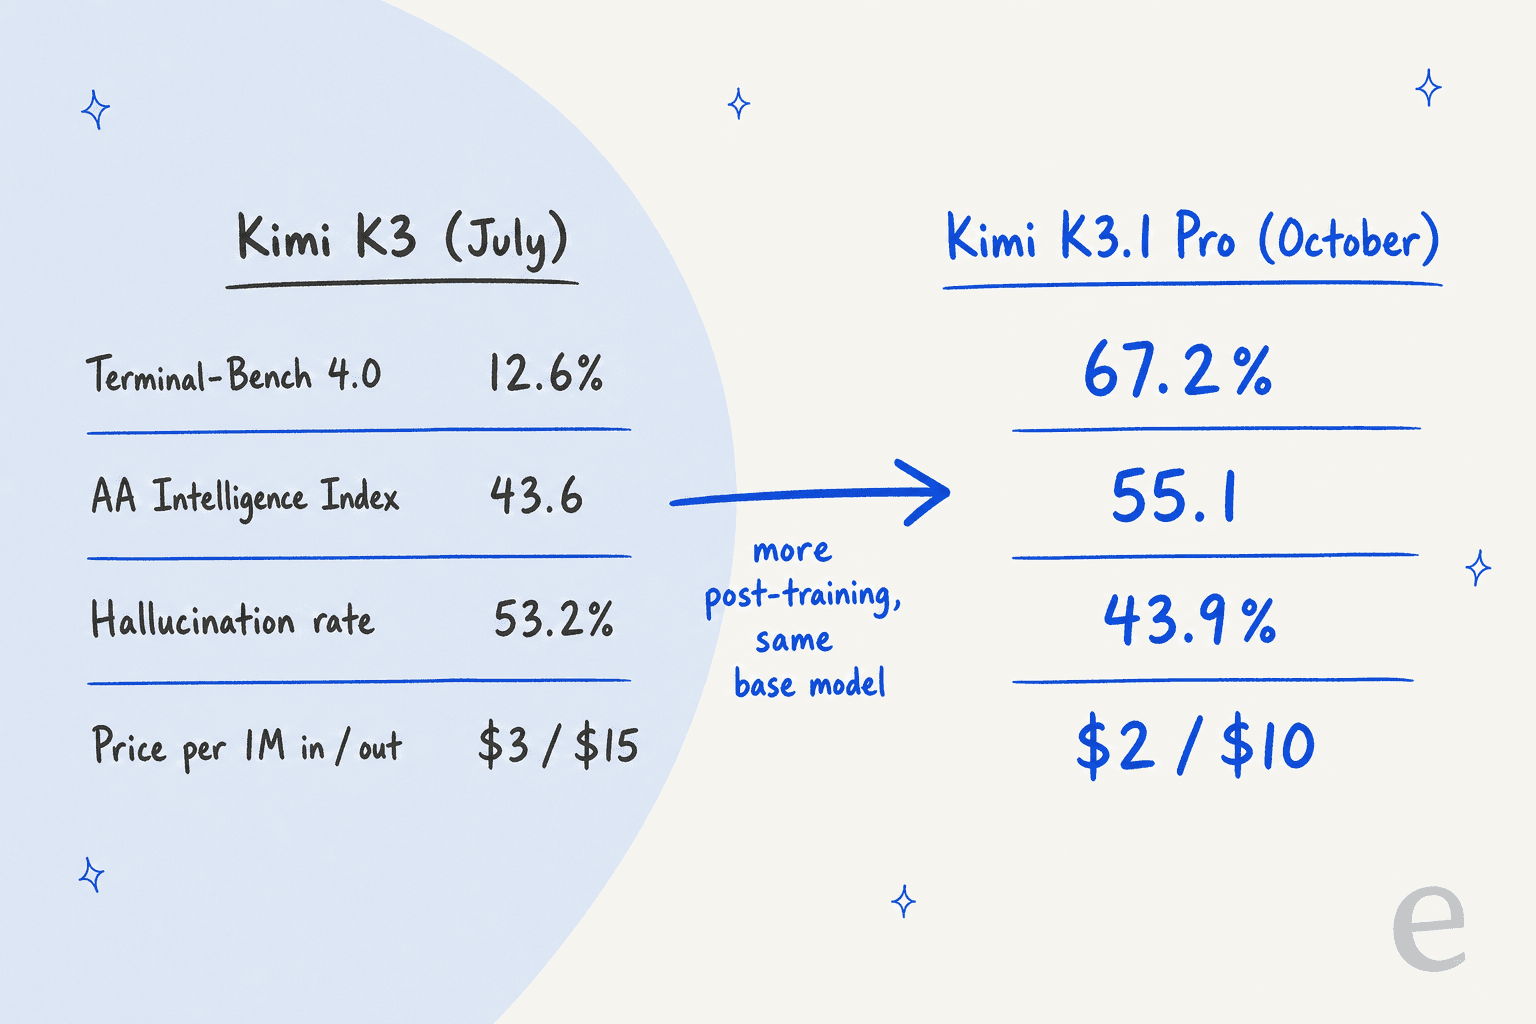
Sur le papier, cela ressemble à une amélioration progressive, mais les chiffres racontent une autre histoire. Sur la page Artificial Analysis de K3.1 Pro, avec des mesures sur la même version de l’indice que Kimi K3 :
| Kimi K3 (Max) | Kimi K3.1 Pro | |
|---|---|---|
| Date de sortie | 16 juillet 2026 | 23 octobre 2026 |
| Intelligence Index (v4.3.2) | 43.6 | 55.1 |
| Terminal-Bench 4.0 | 12.6% | 67.2% |
| Taux d’hallucination (AA-Omniscience) | 53.2% | 43.9% |
| GDPval-AA (Elo) | 1,534 | 1,846 |
| Prix de l’API par 1M (entrée / sortie) | $3 / $15 | $2 / $10 |
| Vitesse de sortie | 54.5 tokens/s | 49.7 tokens/s |
| Poids | Ouverts | Prévus d’ici le 4 novembre |
Le passage de 12,6 % à 67,2 % sur Terminal-Bench est le fait marquant. Ce benchmark vérifie si un modèle peut réellement terminer un travail en plusieurs étapes dans un terminal, et c’est ce que les agents de développement font toute la journée. K3 était un modèle intelligent qui avait du mal à passer à l’action, tandis que K3.1 Pro passe à l’action.
Il y a un piège à surveiller si vous comparez ces résultats à des articles plus anciens : K3 obtenait 57 sur Artificial Analysis en août, mais l’échelle de l’indice a changé depuis. Sur la version actuelle, K3 est à 43.6, donc K3.1 Pro représente un bond de 11.5 points, pas une baisse de 2 points. J’avais fait la même comparaison dans mon avis sur Kimi K3 à l’époque, alors considérez bien ces anciens chiffres comme relevant d’une autre échelle.
Moonshot a aussi fait quelque chose d’assez inhabituel : l’entreprise a volontairement retiré les données d’entraînement liées à la cybersécurité de la version à poids ouverts. Sur son propre benchmark interne d’exploitation de vulnérabilités, le modèle final obtient 81.0, contre 90.5 pour le même modèle entraîné sans cette suppression. La règle énoncée par Moonshot est de ne pas "release open weights that would extend the absolute frontier of cyber capability."
Que vaut Kimi K3.1 Pro sur les benchmarks ?
Sur le graphique de Moonshot regroupant 14 évaluations, Kimi K3.1 Pro arrive premier sur 6 et deuxième sur 5, face à Claude Opus 5.5, GPT-6 Astra, Claude Fable 5.1, DeepSeek V4.1 Flash et GLM-5.3. Tous les modèles ont été exécutés avec un effort de raisonnement maximal.
Voici les principaux résultats, tirés directement du billet de lancement de Moonshot :
| Benchmark | Kimi K3.1 Pro | Opus 5.5 | GPT-6 Astra | Fable 5.1 |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 65.7 | 66.4 | 58.2 | 57.9 |
| SWE Marathon | 51.7 | 46.3 | 42.5 | 45.6 |
| OfficeQA Pro v2 | 64.4 | 62.2 | 54.4 | 54.5 |
| Humanity's Last Exam (avec outils) | 70.0 | 67.7 | 57.2 | 65.6 |
| OSWorld V2.1 | 79.6 | 81.8 | 75.8 | 80.7 |
| GDPval-AA v2.1 (Elo) | 1846 | 1866 | 1573 | 1754 |
| BenchCAD (avec outils) | 92.7 | 96.2 | 95.9 | 92.6 |
| Terminal-Bench-Science 0.1 | 38.1 | 63.3 | 68.1 | 40.0 |
Il y a deux choses à savoir avant de citer ces résultats.
D’abord, les benchmarks de développement ont été exécutés dans l’environnement d’exécution de Claude Code, et non dans celui de Moonshot. C’est un choix raisonnable puisque la plupart des développeurs utilisent cet environnement, mais cela signifie que les résultats montrent comment Kimi se comporte lorsqu’il est piloté comme Claude. Un post de Lisan al Gaib a soulevé exactement cette question le jour du lancement.
Ensuite, les chiffres tiers et ceux du fournisseur ne correspondent pas exactement. Artificial Analysis place K3.1 Pro à 67.2% sur Terminal-Bench 4.0 et Opus 5.5 (Max) à 59.6%, une victoire bien plus nette que les 65.7 contre 66.4 de Moonshot. Plusieurs autres résultats mis en avant (Kimi Code Bench, les tests financiers, Kimi Hallu Bench) proviennent de benchmarks internes de Moonshot. Le chiffre sur lequel je m’appuierais est celui de l’indice indépendant : 55.1, quatrième sur 215 modèles.
Développement et agents de longue durée
Pour le développement, la promesse porte sur des projets complets plutôt que sur de simples correctifs. Selon Moonshot, K3.1 Pro peut créer des jeux dans Unity, Unreal Engine et Godot, et la démonstration choisie est une longue exécution sur le projet open source human-atlas : 167 missions et 420 revues indépendantes pour construire un simulateur de marche pour un modèle corporel comprenant 296 composants squelettiques et 402 composants musculaires. Au final, l’humain simulé est passé d’un effondrement en quelques secondes à une marche de 11.2 secondes.
Sur SWE Marathon, un benchmark de développement sur des tâches de longue durée, il obtient 51.7, contre 46.3 pour Opus 5.5. Si je ne devais suivre qu’un seul résultat, ce serait celui-ci, car c’est sur les tâches longues que l’écart de prix avec Claude ne cesse de s’accumuler.
Modélisation et conception 3D
C’est la partie la plus distinctive de ce lancement. K3.1 Pro écrit des scripts pour Blender et des logiciels de CAO, puis les exécute directement, "without MCP connectors", et Moonshot a créé une fonctionnalité grand public autour de cela, appelée 3D Make.
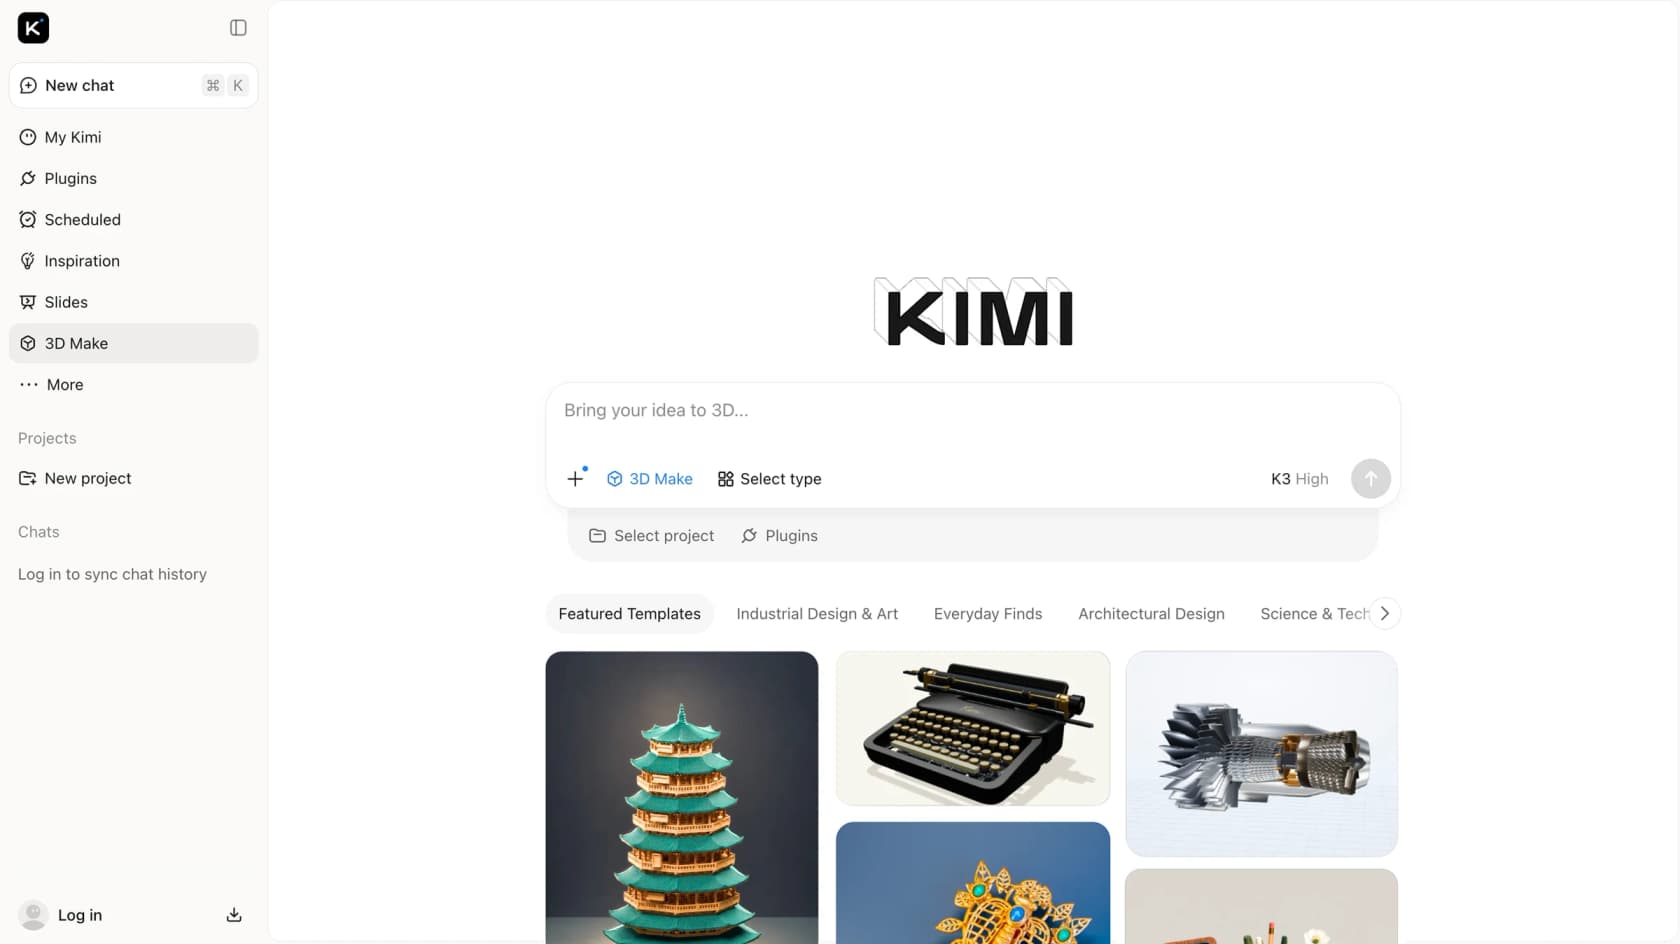
Sur BenchCAD avec outils, il obtient 92.7, derrière Opus 5.5 (96.2) et GPT-6 Astra (95.9). Sans outils, il est presque exactement à égalité avec Opus : 72.8 contre 73.0. Moonshot affirme que son point fort est le travail paramétrique, donc les pièces mécaniques et les modèles architecturaux, ainsi que les produits et le mobilier configurables.
Travaux financiers et exactitude factuelle
L’affirmation de Moonshot pour la finance est "hallucination down by 65%". Cela correspond à peu près à son benchmark interne Kimi Hallu Bench, où la part d’affirmations fausses sur un test difficile avec outils est passée de 23.4% (K3) à 8.3%.
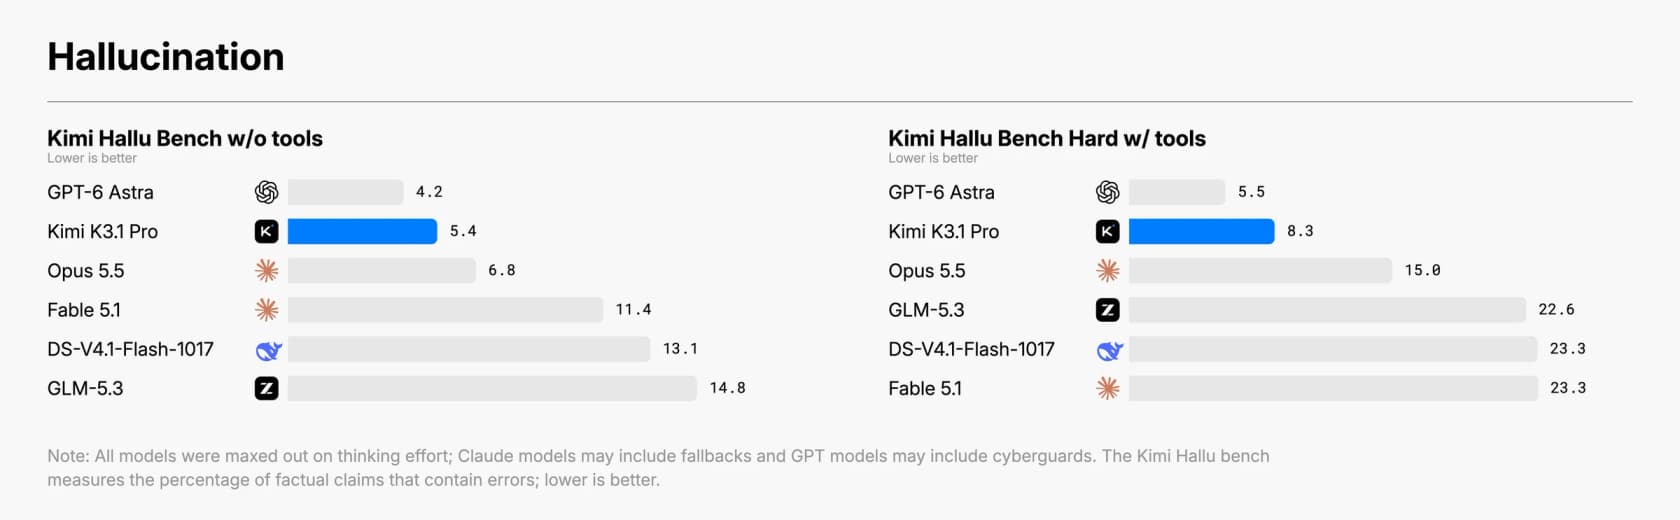
Il faut reconnaître à Moonshot le mérite d’ajouter que ces taux "do not represent overall error rates in daily use." Sur le test indépendant AA-Omniscience, le taux d’hallucination de K3.1 Pro est de 43.9%. C’est mieux qu’Opus 5.5 Max (58.6%), mais loin derrière Gemini 4 Argon (15.1%). Si un chiffre erroné dans un tableur peut vous coûter de l’argent, vous devriez quand même vérifier son travail.
Combien coûte Kimi K3.1 Pro ?
Kimi K3.1 Pro coûte 2 $ par million de tokens d’entrée, 0,20 $ par million de tokens d’entrée en cache et 10 $ par million de tokens de sortie sur l’API Kimi, et Highspeed double ces tarifs. Les prix restent fixes sur l’ensemble du contexte de 1M, avec "no tiering by context length", selon le guide de démarrage rapide de K3.1 Pro.
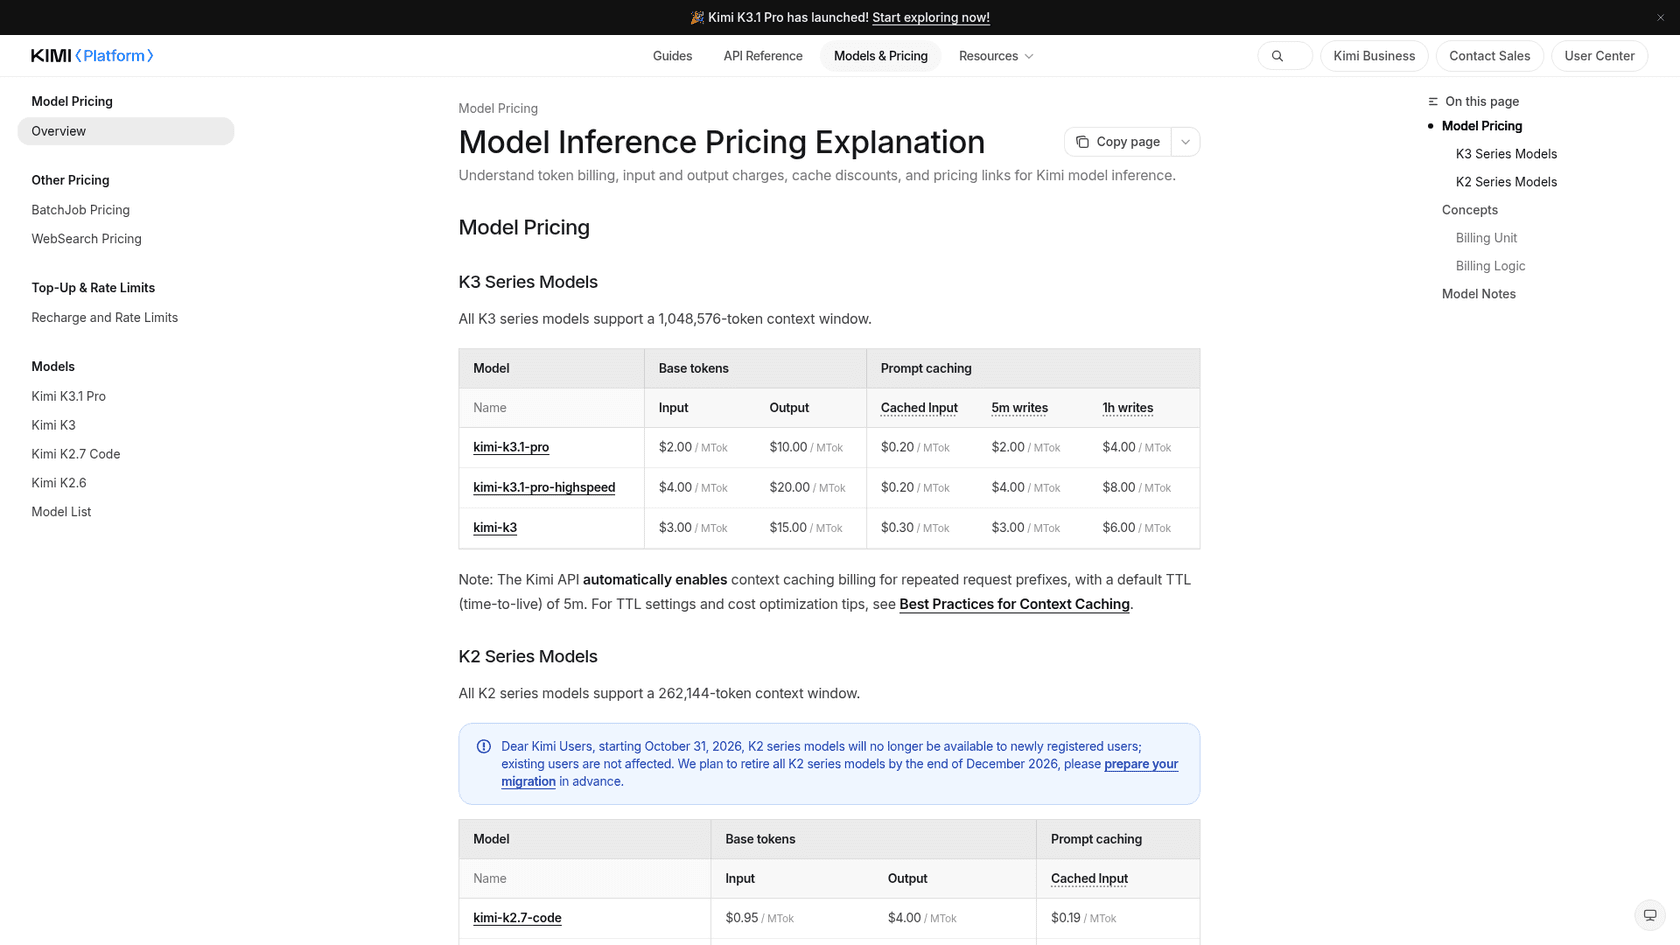
D’après la page de tarification de Kimi, par million de tokens :
| Identifiant du modèle | Entrée | Entrée en cache | Sortie | Écriture en cache (5 min) | Écriture en cache (1 heure) |
|---|---|---|---|---|---|
kimi-k3.1-pro | $2.00 | $0.20 | $10.00 | $2.00 | $4.00 |
kimi-k3.1-pro-highspeed | $4.00 | $0.20 | $20.00 | $4.00 | $8.00 |
kimi-k3 | $3.00 | $0.30 | $15.00 | $3.00 | $6.00 |
Quelques détails de facturation qui changent ce que vous payez réellement :
- La mise en cache est automatique pour les préfixes de prompts répétés, avec une fenêtre par défaut de 5 minutes. Les accès au cache coûtent 90 % de moins. Quand votre agent réutilise un long prompt système, cela finit par compter davantage que le tarif affiché.
- Vous devez recharger votre compte de 1 $ pour débloquer K3.1 Pro, et c’est le total de vos recharges qui détermine votre palier de limite de débit.
- Pas encore de remise pour le traitement par lots. Le tarif par lots à 60 % ne concerne que les anciens modèles K2, qui ne seront plus ouverts aux nouveaux utilisateurs à partir du 31 octobre 2026.
- K3 reste facturé 3 $ / 15 $, donc pour de nouveaux travaux, il n’y a pas vraiment de raison de le conserver.
Pour les prix catalogue suivis par Artificial Analysis, il correspond exactement aux tarifs de Claude Sonnet 5.5, aux tarifs de Gemini 4 Argon et à ceux de GPT-6.1 Sol. Il coûte la moitié des tarifs de Claude Opus 5.5, à 4 $ / 20 $.
Forfaits de l’application Kimi et de Kimi Code
Si vous préférez payer un abonnement plutôt qu’au token, K3.1 Pro est inclus dans les forfaits d’abonnement de Kimi. Les prix ci-dessous proviennent de la page Kimi Code :
| Forfait | Mensuel | Facturation annuelle (par mois) | Accès à K3.1 Pro |
|---|---|---|---|
| Plus | $19 | $15 | Standard |
| Pro | $39 | $31 | Standard et Highspeed |
| Max | $99 | $79 | Standard et Highspeed |
| Ultra | $199 | $159 | Standard et Highspeed |
Highspeed consomme les crédits à un rythme 2x supérieur. Kimi a récemment renommé les forfaits "with pricing unchanged", et Kimi Code partage toujours un quota unique avec le reste de l’abonnement. Avec les nouveaux forfaits, la limite hebdomadaire de Kimi Code a disparu, mais celle sur une fenêtre glissante de 5 heures est restée, et c’est elle qui suscite le plus de plaintes jusqu’ici (nous y revenons plus bas).
Moins cher par token, pas toujours par tâche
Voici la partie que la plupart des articles sur le lancement passent sous silence. Par token, K3.1 Pro coûte un tiers de moins que K3, mais il réfléchit beaucoup et écrit beaucoup. Artificial Analysis le qualifie de "very verbose" : il a utilisé environ 150M tokens de sortie pour exécuter l’indice, contre une médiane de 87M pour des modèles similaires.
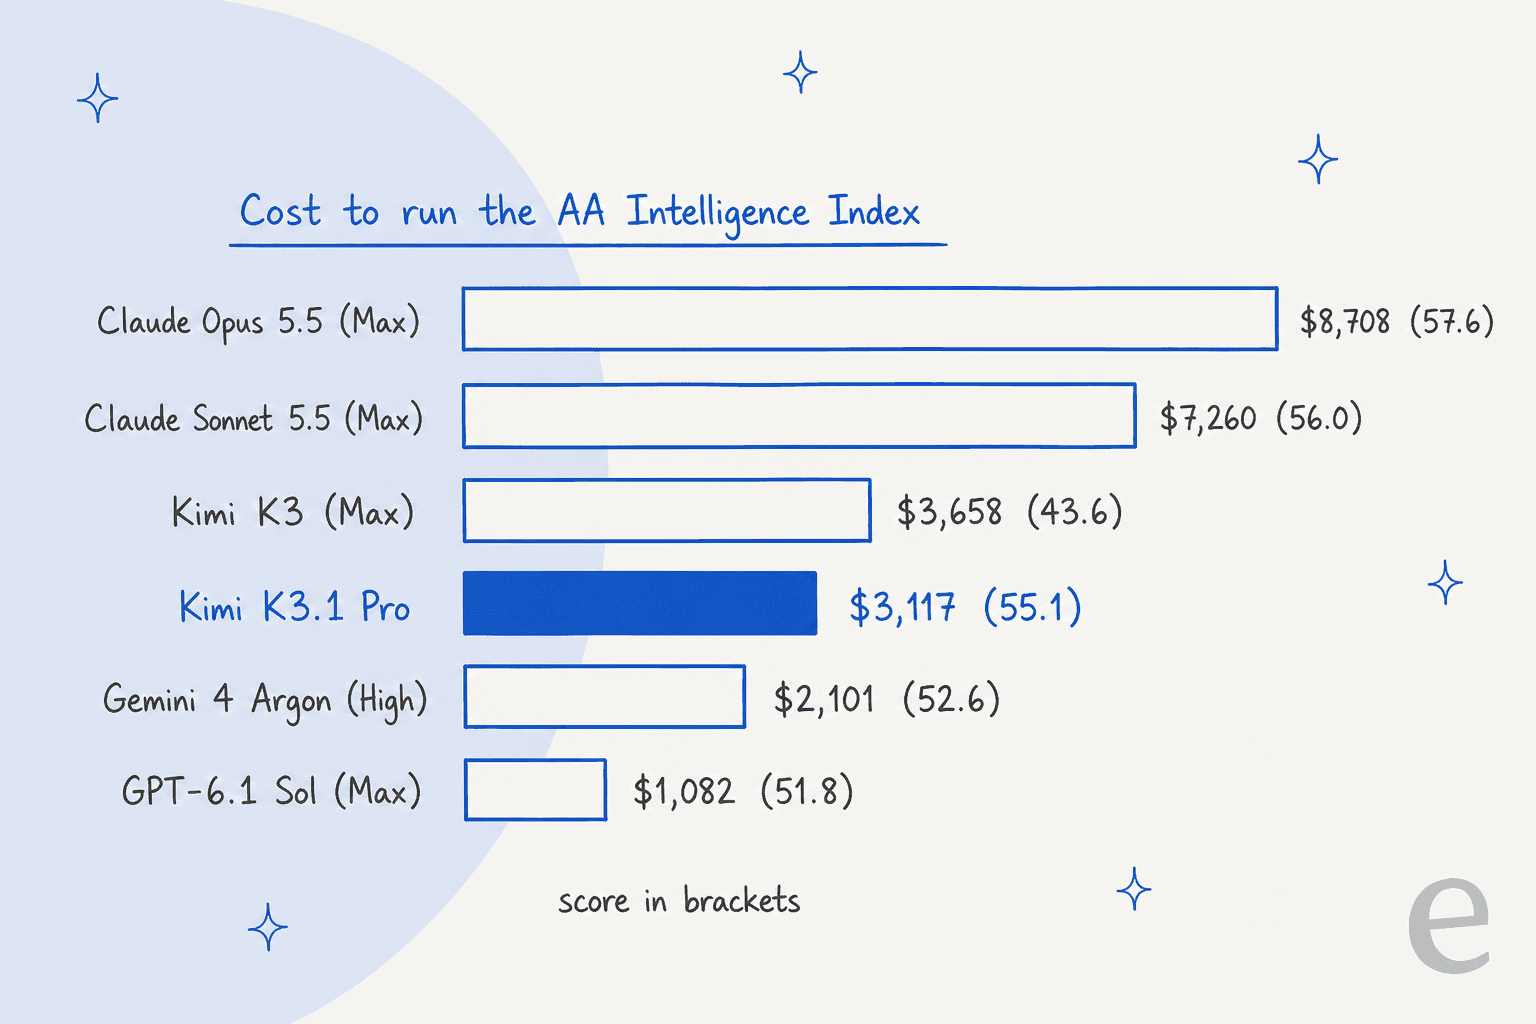
La façon la plus honnête de comparer est donc le coût par travail effectué :
- Face à Claude, c’est une vraie bonne affaire. Il se situe à moins de 2.5 points d’Opus 5.5 (Max) pour
36%du coût d’exécution de l’indice, et coûte bien moins de la moitié de Sonnet 5.5 (Max), qui a consommé416Mtokens. - Face à K3, l’économie est plus faible qu’il n’y paraît.
$3,117contre$3,658, c’est environ 15 % de moins, avec un modèle bien meilleur à la clé. - Face aux options les moins chères, ce n’est pas la bonne affaire. GPT-6.1 Sol (Max) a exécuté l’indice pour
$1,082et Gemini 4 Argon (High) pour$2,101, avec des scores inférieurs de 3.3 et 2.5 points.
Le graphique de Moonshot compare lui-même le modèle à Claude sur Terminal-Bench, où K3.1 Pro avec un effort maximal revient à environ 5 $ par tâche, contre environ 14 $ pour Opus 5.5 :
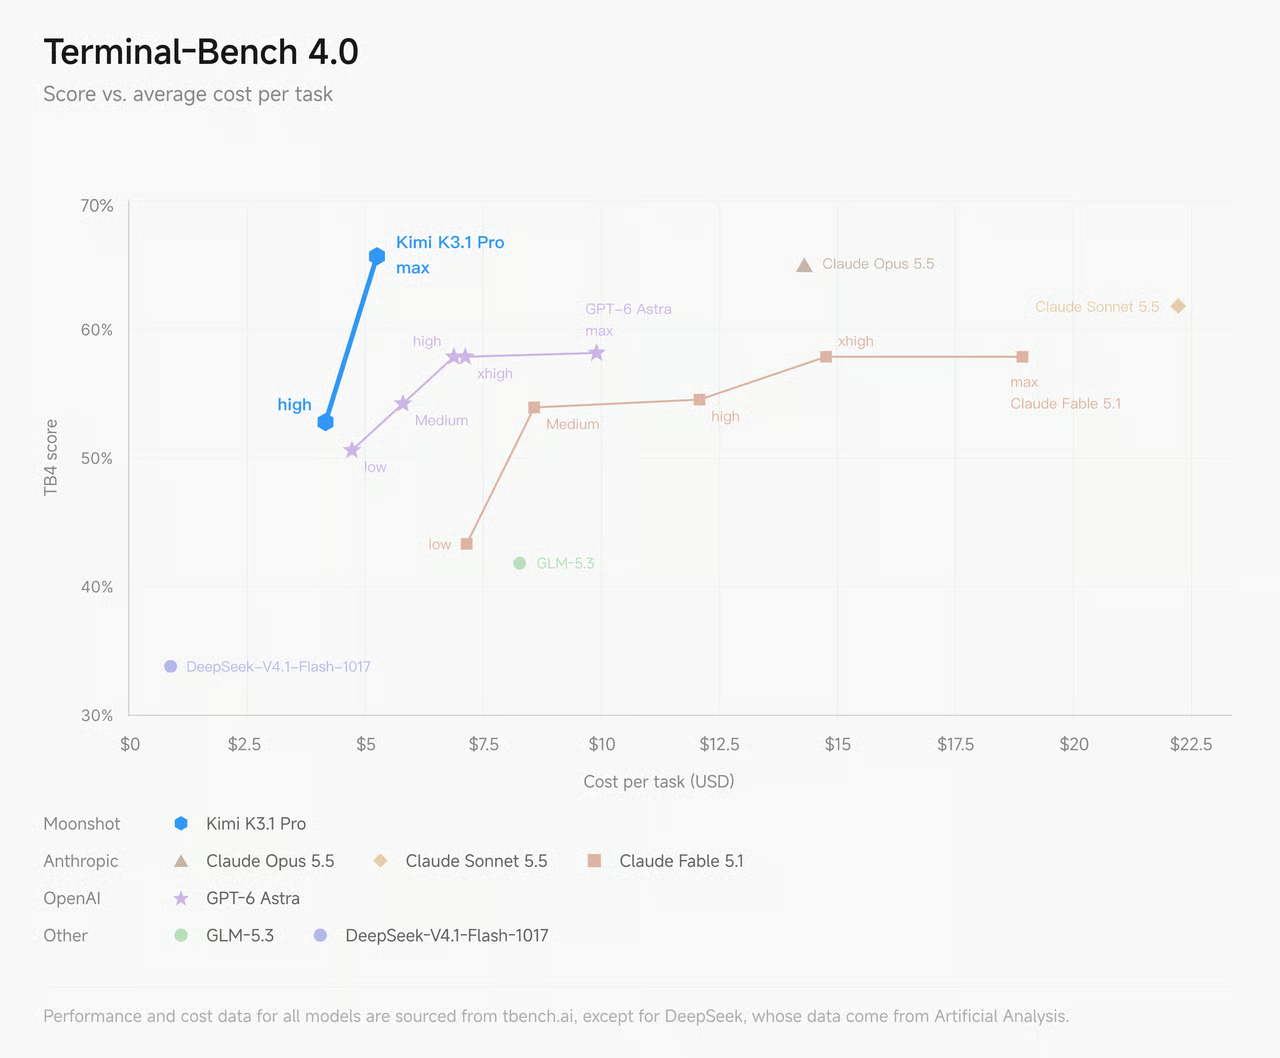
Nathan Lambert, chercheur chez Ai2, a souligné le même compromis le jour du lancement :
"K3.1 is also cheaper than K3 per token, but some benchmarks in the blog show it uses meaningfully more tokens per answer, so it may be about the same price."
Kimi K3.1 Pro est-il open source ?
Pas encore. Moonshot déclare "Full model weights will be released by Nov 4, 2026", et au 27 octobre, il n’existe toujours pas de dépôt Hugging Face pour ce modèle. Pour l’instant, Artificial Analysis le classe comme un modèle propriétaire, et l’API est proposée par 5 fournisseurs, contre 20 pour K3.
Moonshot a déjà fait ses preuves sur ce point : les poids de K3 ont bien été publiés sur Hugging Face, et le dépôt K3 affiche environ 2.78T paramètres en 8 bits. Vous pouvez vous attendre à quelque chose de similaire pour K3.1 Pro, ce qui signifie que l’exécuter vous-même est une tâche pour un cluster de serveurs, pas pour un ordinateur portable.
"a 3T parameter model is still a bit beyond even many enthusiasts for running locally."

Les conditions de licence de K3.1 Pro ne sont pas encore publiées. La licence de K3 autorisait un usage commercial avec certaines restrictions, alors lisez bien la nouvelle avant de construire quoi que ce soit dessus. Si vous avez besoin d’un modèle ouvert que vous pouvez déployer aujourd’hui, DeepSeek V4.1 Flash obtient 45.1 sur le même indice pour une fraction du coût.
Quelle est la vitesse de Kimi K3.1 Pro ?
Il est lent. Artificial Analysis mesure 49.7 tokens de sortie par seconde sur l’API Kimi, ce qui le classe #165 sur 182 modèles, contre une médiane d’environ 83 pour ses pairs. Le délai avant le premier token est correct, à 2.95 secondes. Là où cela fait mal, c’est la durée pendant laquelle il continue d’écrire : une tâche moyenne de l’indice a pris environ 17 minutes.
En pratique, c’est quand même une amélioration par rapport à K3, car K3.1 Pro perd moins de temps à réfléchir. Un développeur a mesuré ceci :
"Biggest gripe with K3 was slow responses, partly due to inefficient thinking. So far K3.1 pro is almost twice as fast as k3 on our benchmark."
La réponse de Moonshot à cela est Highspeed : "2-3× the speed" pour le double du prix. Artificial Analysis ne l’a pas encore évalué, et la réaction le jour du lancement a été mitigée :
"I'll wait for the openweight... btw double the price for 67 TPS... Hardly 'nitro'."
Mon avis : pour des agents en arrière-plan qui tournent pendant une heure pendant que vous faites autre chose, la vitesse compte à peine, donc le modèle standard est le bon choix. Pour tout ce qui fait attendre une personne, comme une fenêtre de chat, payez pour Highspeed ou choisissez un modèle plus rapide.
Que disent les développeurs de Kimi K3.1 Pro ?
Le fil de lancement sur Hacker News a recueilli 1,089 points et 674 commentaires, et les réactions se sont assez nettement divisées. Presque tout le monde s’accorde à dire que c’est une grande avancée par rapport à K3 et le meilleur modèle à poids ouverts annoncé à ce jour, tandis que la plupart de ceux qui codent au quotidien estiment encore que Claude Opus 5.5 garde l’avantage en pratique.
Le plus positif des tests indépendants l’a comparé sur 180 peintures générées par du code :
"It also does this while thinking less (~6.5k reasoning tokens vs ~8k for K3). Kimi K3.1 is roughly 2/3 the cost of Kimi K3 and ~1/3 the cost of Opus 5.5."
Du côté négatif, un testeur l’a confronté à 105 bugs introduits dans deux vrais dépôts, et il y a obtenu 36, contre 41.7 pour Opus 5.5 :
"I'm sorry. Considering the cost, I see no reason to use this model."
Les benchmarks amateurs se situent quelque part entre les deux, à peu près au niveau de Fable 5.1 et Gemini 4 Argon :
"Ran it on my adversarial programming language (KillSwitch) benchmark[1]. Very significant improvement over K3. On par with Gemini 4 Argon and Fable 5.1. Much slower than both though."
Et puis il y a les limites d’utilisation, qui ont occupé davantage le fil que la qualité du modèle :
"Bought the $100/month subscription and hit my 5-hour limit with one prompt on default settings (max effort) in their CLI harness. It might be smart but it's unusable compared to other subscriptions right now."
Si vous prévoyez de l’utiliser via un abonnement Kimi Code, réduisez l’effort de raisonnement avant de juger le forfait. L’API prend en charge low, high et max, et max est la valeur par défaut. Un commentateur qui l’utilisait avec des sous-agents plus légers a indiqué n’avoir consommé que 22 % d’un quota hebdomadaire pendant une session de 8 heures, donc la configuration change beaucoup la donne.
Comment accéder à Kimi K3.1 Pro ?
Il existe quatre voies au total, et celle qui convient dépend de ce que vous construisez.
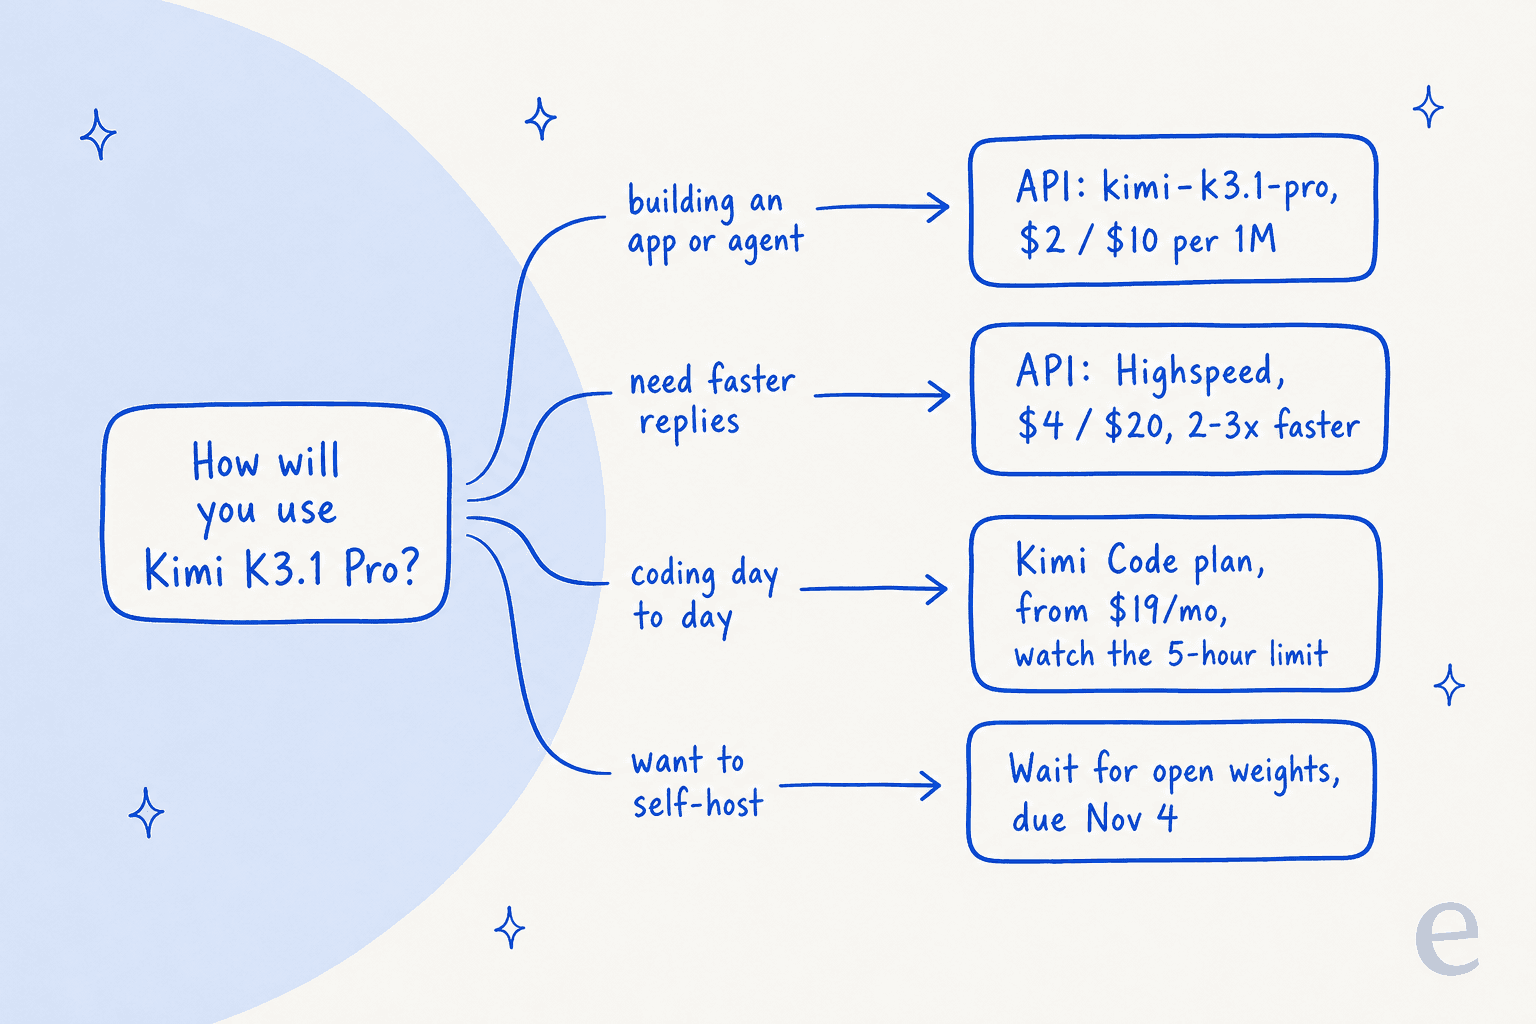
- API Kimi. Utilisez les identifiants de modèle
kimi-k3.1-prooukimi-k3.1-pro-highspeedsur la plateforme API Kimi. Le raisonnement est toujours activé,reasoning_effortacceptelow,highoumax, et la sortie est réglée par défaut sur131,072tokens (réglable jusqu’à la totalité du contexte de 1M). Zero Data Retention est disponible pour les clients de l’API. - OpenRouter. Il y figure sous le nom
moonshotai/kimi-k3.1-pro, avec Moonshot comme seul fournisseur pour l’instant. C’est pratique si vous routez déjà vos requêtes entre plusieurs modèles, et aussi utile lorsque vous le comparez à une offre d’API IA gratuite. - Kimi Code. Vous le sélectionnez avec
/model. C’est le propre agent de développement de Moonshot, disponible sur ordinateur, en CLI et via des extensions IDE, et il concurrence directement Claude Code ainsi que le précédent modèle Kimi K2.7 Code de Moonshot. - Applications Kimi et Kimi Work. C’est la voie grand public, et elle inclut 3D Make. Kimi Work nécessite la version de bureau
3.1.0ou ultérieure. Sur Kimi Enterprise, K3.1 Pro est désactivé par défaut, donc les administrateurs doivent l’activer.
Qui devrait utiliser Kimi K3.1 Pro ?
Voici ma conclusion après avoir parcouru la documentation et les benchmarks, ainsi que les premières centaines de réactions de développeurs.
Choisissez-le si vous exécutez de longues tâches d’agents sans supervision (développement, recherche, travaux financiers reposant beaucoup sur des tableurs), pour lesquelles vous paieriez autrement les tarifs de Claude et dont vous pouvez attendre les résultats. La qualité est proche d’Opus pour environ un tiers du coût d’exécution, et il n’y a pas de supplément pour les longs prompts sur le contexte de 1M. C’est aussi le modèle à surveiller si vous avez besoin d’un modèle de pointe que vous pourrez à terme héberger vous-même.
Passez votre chemin si une personne attend chaque réponse, car à 50 tokens par seconde, le chat en direct et les échanges rapides de développement semblent lents. Vous pouvez aussi l’écarter si vous privilégiez le coût plutôt que la qualité : GPT-6.1 Sol et Gemini 4 Argon terminent le même travail de benchmark pour moins cher. Et si vous le comparez à d’autres modèles ouverts, mon comparatif Qwen 3.8 Max contre K3 et la liste des alternatives à Kimi K3 restent pertinents pour une vue d’ensemble.
Le facteur décisif est de savoir si votre charge de travail est longue et peut attendre, ou courte et interactive, et K3.1 Pro est conçu pour le premier cas.
Ce que Kimi K3.1 Pro signifie pour les équipes de support
Beaucoup de personnes qui lisent des articles de lancement comme celui-ci ont une question plus précise en tête : mon agent de support devrait-il fonctionner avec ce modèle ? Je pense que ce n’est pas la bonne première question. Un modèle comme Kimi K3.1 Pro est un moteur. Pour répondre à des tickets avec lui, il vous faudrait encore le connecter à votre helpdesk et synchroniser votre centre d’aide et vos anciens tickets, puis décider ce qu’il peut faire seul et ce qu’il doit transmettre à une personne, et aussi le tester avant que les clients ne le voient. J’ai vu des bots au ton assuré donner des réponses fausses dans des files de tickets en production, c’est pourquoi eesel simule d’abord chaque déploiement sur les propres tickets historiques de l’équipe.
Cette couche, c’est exactement ce qu’est eesel. Vous recrutez un coéquipier IA pour votre helpdesk, prêt à travailler, qui rejoint votre file existante dans Zendesk, Freshdesk ou Gorgias, apprend à partir de votre documentation et de vos anciens tickets, puis suit les règles de transfert que vous rédigez en anglais courant. Si vous comparez cette catégorie plus largement, mon guide sur les employés IA explique la différence entre recruter un coéquipier et en construire un.

SE Ranking donne une bonne idée de ce que cela représente en production. L’entreprise gère trois produits (SE Ranking, Planable et SE Visible) avec une seule équipe Zendesk, et un agent eesel par produit. Chaque agent effectue des recherches dans environ 16,800 pages de contenu du centre d’aide et du site web avant de répondre, répond au chat en direct dans la langue du client et transmet les remboursements, les prolongations d’essai et les questions de niveau 2 à une personne, avec les informations du client jointes. Entre le 8 août et le 8 septembre 2026, le système a traité environ 4,650 conversations. Rien de tout cela ne dépend du modèle qui a obtenu le meilleur score la semaine dernière.
Si l’approche de Kimi centrée sur les agents vous séduit, la CLI eesel l’applique au support. Vous pouvez utiliser le même coéquipier depuis un terminal, par exemple pour vérifier son travail récent avec eesel activity ou approuver et refuser des actions en attente avec eesel approvals, et vous pouvez aussi modifier ses règles permanentes avec eesel instructions. Les commandes affichent du JSON et les commandes d’écriture prennent en charge --dry-run, ce qui signifie que des scripts et des agents de développement comme Claude Code peuvent le piloter, et il existe aussi un serveur MCP. Je présente cette approche plus largement dans mon guide sur la CLI pour agents IA.
Vous voulez le résultat sans devoir comparer les modèles ? Essayez eesel gratuitement sur votre propre helpdesk et voyez comment il traite les tickets de la semaine dernière, ou parcourez les meilleurs coéquipiers IA pour comparer d’abord les options.
Questions fréquentes
Qu’est-ce que Kimi K3.1 Pro ?
Kimi K3.1 Pro est le modèle phare de Moonshot AI, lancé le 23 octobre 2026. Il repose sur la même base de 2.8T paramètres que Kimi K3, avec un post-entraînement bien plus poussé, une fenêtre de contexte de 1M tokens et une variante Highspeed plus rapide. Il obtient 55 sur l’Artificial Analysis Intelligence Index, proche de Claude Opus 5.5.
Combien coûte Kimi K3.1 Pro ?
Sur l’API Kimi, Kimi K3.1 Pro coûte 2 $ par million de tokens en entrée, 0,20 $ pour les entrées en cache et 10 $ par million de tokens en sortie. La version Highspeed coûte 4 $ et 20 $. C’est un tiers de moins que les tarifs de Kimi K3 et le même prix catalogue que Claude Sonnet 5.5.
Kimi K3.1 Pro est-il open source ?
Pas encore. Moonshot indique que l’intégralité des poids de Kimi K3.1 Pro sera publiée d’ici le 4 novembre 2026. En attendant, il n’est disponible que via l’API et l’application. Avec 2.8T paramètres, il nécessitera un cluster de serveurs, pas un ordinateur portable. Si vous voulez un modèle ouvert que vous pouvez exécuter dès aujourd’hui, ma sélection d’agents IA open source présente les options.
Kimi K3.1 Pro est-il meilleur que Claude Opus 5.5 ?
Selon le propre tableau de Moonshot, Kimi K3.1 Pro remporte 6 des 14 benchmarks et se classe derrière Opus 5.5 sur Terminal-Bench 4.0, avec un écart de 0.7 points. Sur Artificial Analysis, il obtient 55.1 contre 57.6. Les testeurs indépendants estiment pour la plupart qu’Opus reste en tête au quotidien, mais Kimi coûte environ un tiers du prix à l’usage. Mon avis sur Claude Opus 5.5 présente l’autre côté de la comparaison.
Qu’est-ce que Kimi K3.1 Pro Highspeed ?
Kimi K3.1 Pro Highspeed est le même modèle, avec des réponses 2 à 3 fois plus rapides, au double du prix : 4 $ en entrée et 20 $ en sortie par million de tokens. Sur les offres grand public de Kimi, il nécessite le forfait Pro ou supérieur et consomme les crédits deux fois plus vite. C’est surtout utile pour le chat et les cycles de développement où l’attente pénalise le travail, comme dans Claude Code.
Puis-je utiliser Kimi K3.1 Pro pour le support client ?
Oui, mais Kimi K3.1 Pro est un modèle brut : vous devrez donc encore mettre en place vous-même la connexion à votre outil de support, la synchronisation des connaissances, les règles de transfert et les tests. Ses 50 tokens par seconde sont également lents pour le chat en direct. Un collègue prêt à l’emploi pour le support client par IA comme eesel prend en charge cette couche, et mon guide du meilleur modèle d’IA pour les tickets d’assistance compare les moteurs.
Comment utiliser Kimi K3.1 Pro dans Kimi Code ?
Kimi K3.1 Pro est disponible dans Kimi Code à partir du forfait Plus (19 $/mois). Lancez Kimi Code et changez de modèle avec la commande
/model. Surveillez la limite d’utilisation sur une fenêtre glissante de 5 heures, que les testeurs atteignent rapidement avec le niveau d’effort maximal. Pour découvrir d’autres options, consultez ma liste d’assistants de programmation IA.