

En bref
Kimi K3.1 Pro coûte 2 $ par million de tokens d'entrée et 10 $ par million de tokens de sortie sur l'API Kimi, avec les entrées en cache à 0,20 $. La version Highspeed coûte exactement le double, à 4 $ / 20 $. Si vous préférez payer un forfait, le modèle est inclus dans les abonnements Kimi allant de $19 par mois (Plus) à $199 (Ultra), avec Highspeed à partir de l'abonnement Pro à $39.
Le tarif affiché est inférieur d'un tiers à celui de Kimi K3. La facture raconte autre chose : K3.1 Pro réfléchit et écrit beaucoup, donc une tâche d'agent moyenne coûte $2.11, contre $2.00 pour K3 sur Artificial Analysis. Vous payez à peu près la même chose pour un modèle bien meilleur, pas moins cher pour le même modèle. Face à Claude, l'économie est réelle, avec un coût par tâche inférieur à la moitié de celui de Sonnet 5.5 ou d'Opus 5.5 à l'effort maximal.
Deux pièges déterminent l'essentiel des factures : les tokens de sortie et de raisonnement représentent la majeure partie du coût, et les abonnements ont une limite sur une fenêtre glissante de 5 heures que les premiers acheteurs ont atteinte en moins d'une heure. Si ce que vous voulez vraiment, c'est une IA qui répond aux tickets d'assistance, j'ai passé des années chez eesel à faire fonctionner l'IA sur de vraies files de tickets, et la facture de tokens n'est qu'une petite ligne du budget. SE Ranking traite environ 4,650 conversations par mois pour trois produits sur Zendesk sans jamais choisir de modèle.
Combien coûte Kimi K3.1 Pro sur l'API ?
Kimi K3.1 Pro coûte 2,00 $ en entrée, 0,20 $ en entrée mise en cache et 10,00 $ en sortie par million de tokens sur la page des tarifs de l'API Kimi. Moonshot l'a lancé le 23 octobre 2026 sans aucun tarif promotionnel, ce qui laisse penser qu'il s'agit du prix standard et non d'une remise de lancement.
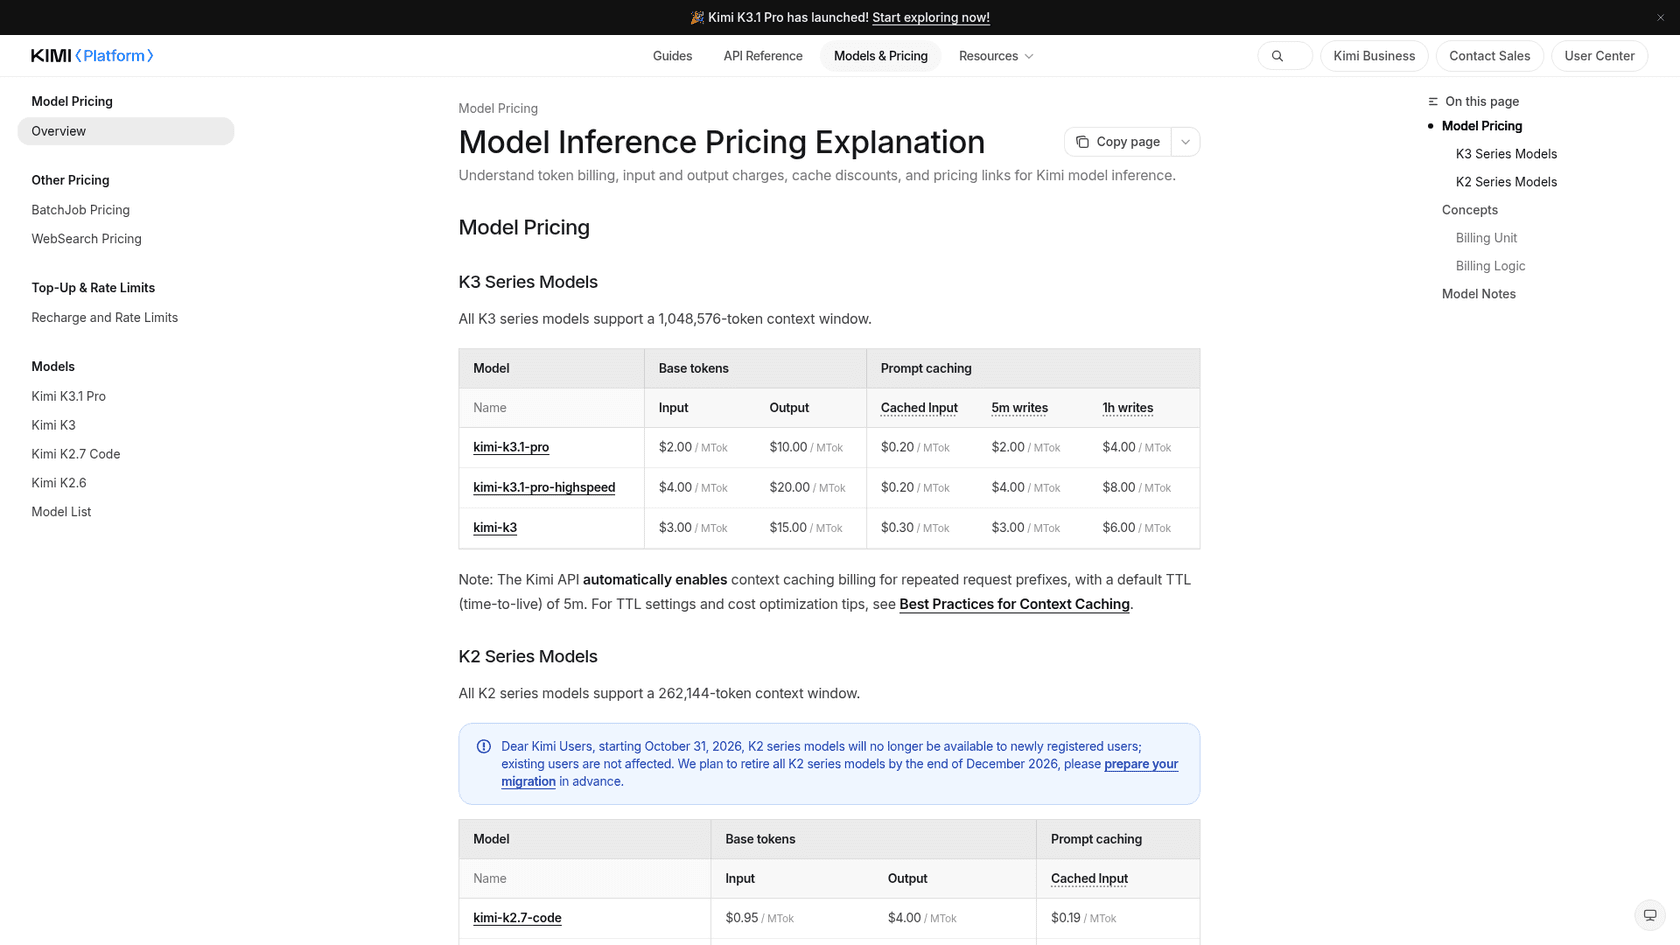
Voici la grille tarifaire complète de la série K3, par million de tokens :
| Identifiant du modèle | Entrée (absence dans le cache) | Entrée en cache (présence dans le cache) | Sortie | Écriture en cache, 5 min | Écriture en cache, 1 heure |
|---|---|---|---|---|---|
kimi-k3.1-pro | $2.00 | $0.20 | $10.00 | $2.00 | $4.00 |
kimi-k3.1-pro-highspeed | $4.00 | $0.20 | $20.00 | $4.00 | $8.00 |
kimi-k3 | $3.00 | $0.30 | $15.00 | $3.00 | $6.00 |
Quelques éléments de cette grille méritent qu'on s'y attarde :
- Pas de supplément pour les longs contextes. Les deux modèles K3.1 Pro acceptent un contexte de
1,048,576tokens, et le guide de démarrage de K3.1 Pro précise qu'il "uses flat pay-as-you-go pricing", sans paliers selon la longueur du contexte. C'est très important si vous lui fournissez des bases de code entières. - Le prix des entrées trouvées en cache ne double pas avec Highspeed. Tout le reste double, mais les entrées en cache restent à
$0.20, donc si vos requêtes réutilisent un long prompt, Highspeed revient en pratique à moins de 2 fois le coût. - K3 est toujours commercialisé à l'ancien prix.
kimi-k3reste à 3 $ / 15 $, et la documentation le qualifie désormais de "previous-generation flagship". Je ne vois pas de nouveau projet pour lequel rester sur K3 aurait du sens, sauf si vous avez besoin de ses poids ouverts dès aujourd'hui.
Qu'est-ce qui compte comme token facturable ?
Chaque token en entrée et chaque token en sortie, raisonnement compris. K3.1 Pro est un modèle de raisonnement dont la réflexion est toujours activée, et reasoning_effort est réglé par défaut sur max selon le guide des clés API de Moonshot. Ces tokens de réflexion sont facturés au tarif de sortie de $10, même si vous ne les voyez jamais dans la réponse.
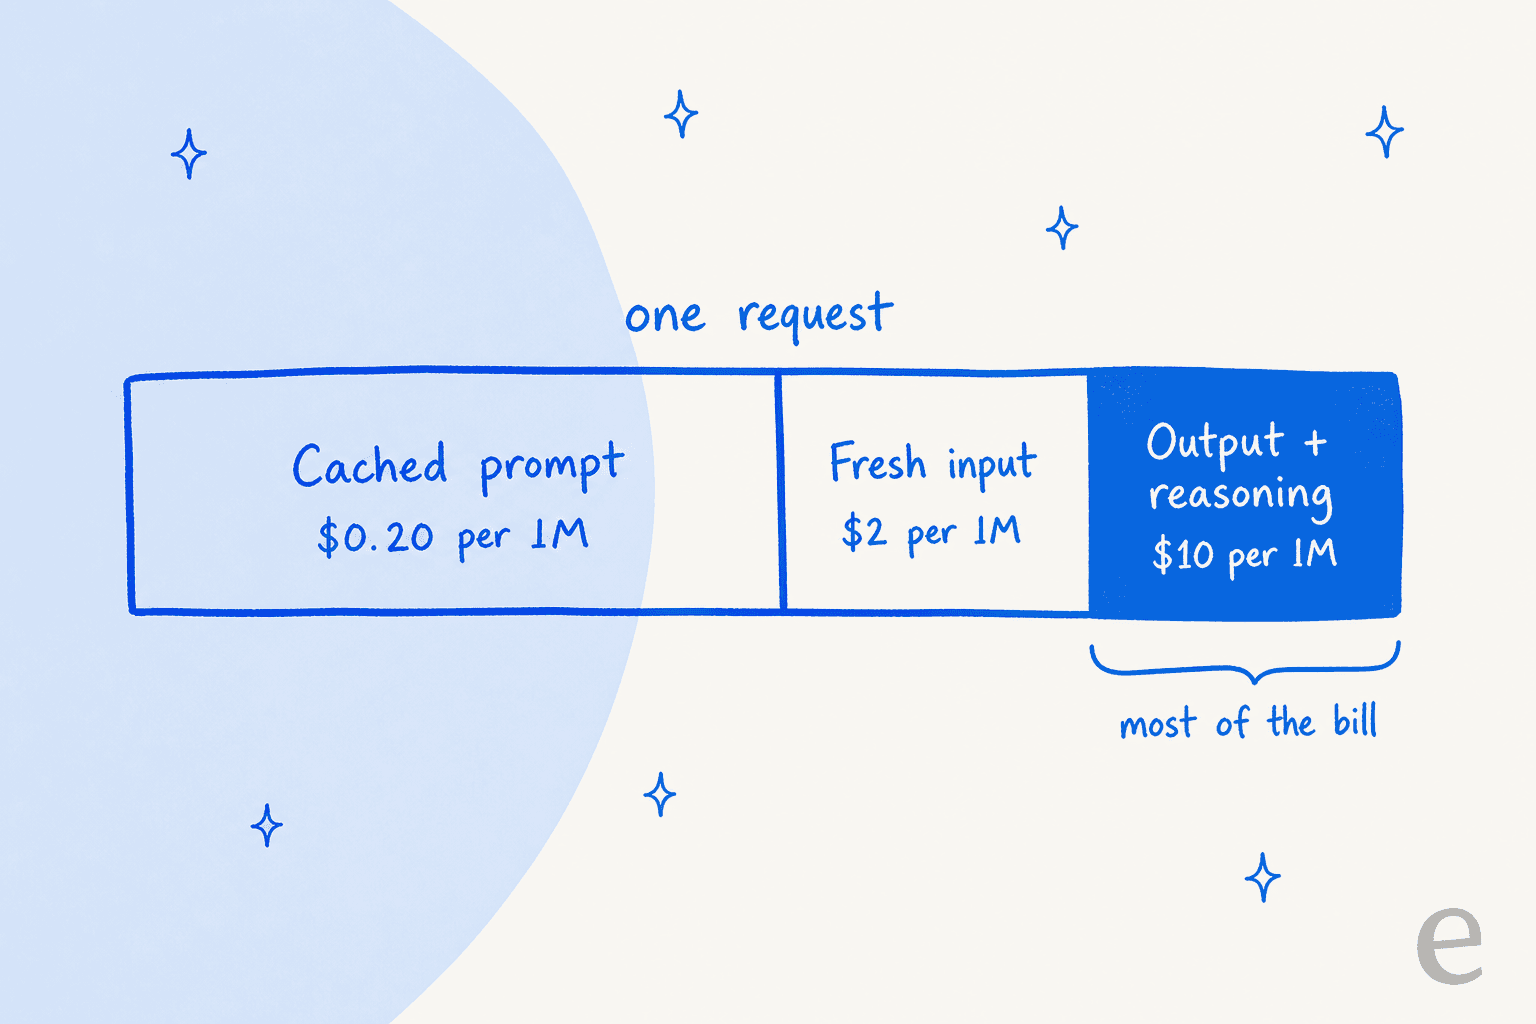
C'est de loin le principal levier sur votre facture. Lors des tests de référence d'Artificial Analysis, une tâche moyenne a produit 55,195 tokens de sortie, dont 34,883 de raisonnement (page du modèle sur AA). À 10 $ par million, cela représente environ 55 cents de sortie par tâche, avant même de compter le moindre token d'entrée.
Comment fonctionne la mise en cache des prompts de Kimi ?
La mise en cache est automatique pour les préfixes de prompts répétés, avec une durée de vie de 5 minutes par défaut. Une entrée trouvée en cache coûte $0.20, soit 90 % de moins qu'une nouvelle entrée. L'écriture dans le cache est facturée séparément, selon sa durée de conservation : $2.00 par million pour le palier de 5 minutes et $4.00 pour celui d'1 heure, que vous choisissez avec prompt_cache_options.ttl (guide de démarrage).
Deux détails piègent souvent les utilisateurs. Les blocs de cache partiels sont facturés comme des entrées absentes du cache, donc un prompt qui change près du début perd l'essentiel de sa réduction. Le palier d'1 heure n'est rentable que lorsque le trafic est trop espacé pour maintenir un cache de 5 minutes actif, ce qui signifie que, pour un agent très sollicité, le réglage par défaut est généralement le moins cher.
Les limites de débit dépendent de votre recharge
K3.1 Pro est débloqué après une recharge réussie d'au moins $1, et le montant cumulé de vos recharges détermine votre palier de limites de débit (Recharges et limites de débit) :
| Palier | Total des recharges | Requêtes simultanées | Requêtes/min | Tokens/min | Tokens/jour |
|---|---|---|---|---|---|
| Tier0 | $1 | 1 | 3 | 500,000 | 1,500,000 |
| Tier1 | $10 | 15 | 100 | 2,000,000 | Illimité |
| Tier2 | $20 | 40 | 100 | 3,000,000 | Illimité |
| Tier3 | $100 | 50 | 200 | 3,000,000 | Illimité |
| Tier4 | $1,000 | 60 | 200 | 4,000,000 | Illimité |
| Tier5 | $3,000 | 100 | 300 | 5,000,000 | Illimité |
Le palier à $1 sert davantage à tester qu'à fonctionner en production. Avec 1,500,000 tokens par jour, moins de 30 tâches d'agent moyennes suffiraient à tout consommer, mais dès que vous versez $10, le plafond quotidien disparaît. Si vous avez déjà eu du mal avec les limites de débit d'OpenAI, cette progression vous semblera familière, avec simplement des seuils beaucoup plus bas.
Pas encore de réduction pour le traitement par lots
L'API Batch de Kimi facture 60 % du tarif standard, mais elle ne prend en charge que kimi-k2.7-code et kimi-k2.6. K3.1 Pro ne figure pas dans cette liste. Ces modèles K2 seront fermés aux nouveaux utilisateurs le 31 octobre 2026 et retirés d'ici la fin décembre, ce qui signifie que les traitements nocturnes qui reposaient sur les tarifs de Kimi K2.7 Code paieront bientôt les tarifs K3.1 sans réduction.
Combien coûte Kimi K3.1 Pro par tâche ?
Sur Artificial Analysis, une tâche moyenne de son Intelligence Index coûte $2.11 avec K3.1 Pro, et l'exécution de l'ensemble de l'indice a coûté $3,117 (page du modèle sur AA). C'est le chiffre que je prendrais comme référence, car il intègre déjà le long raisonnement que le prix par token masque.
AA décrit K3.1 Pro comme "very verbose". Il a utilisé environ 150M de tokens de sortie pour exécuter l'indice, contre une médiane de 87M pour les modèles de sa catégorie de prix. La réduction affichée d'un tiers fond donc assez vite dès que le modèle se met à réfléchir.
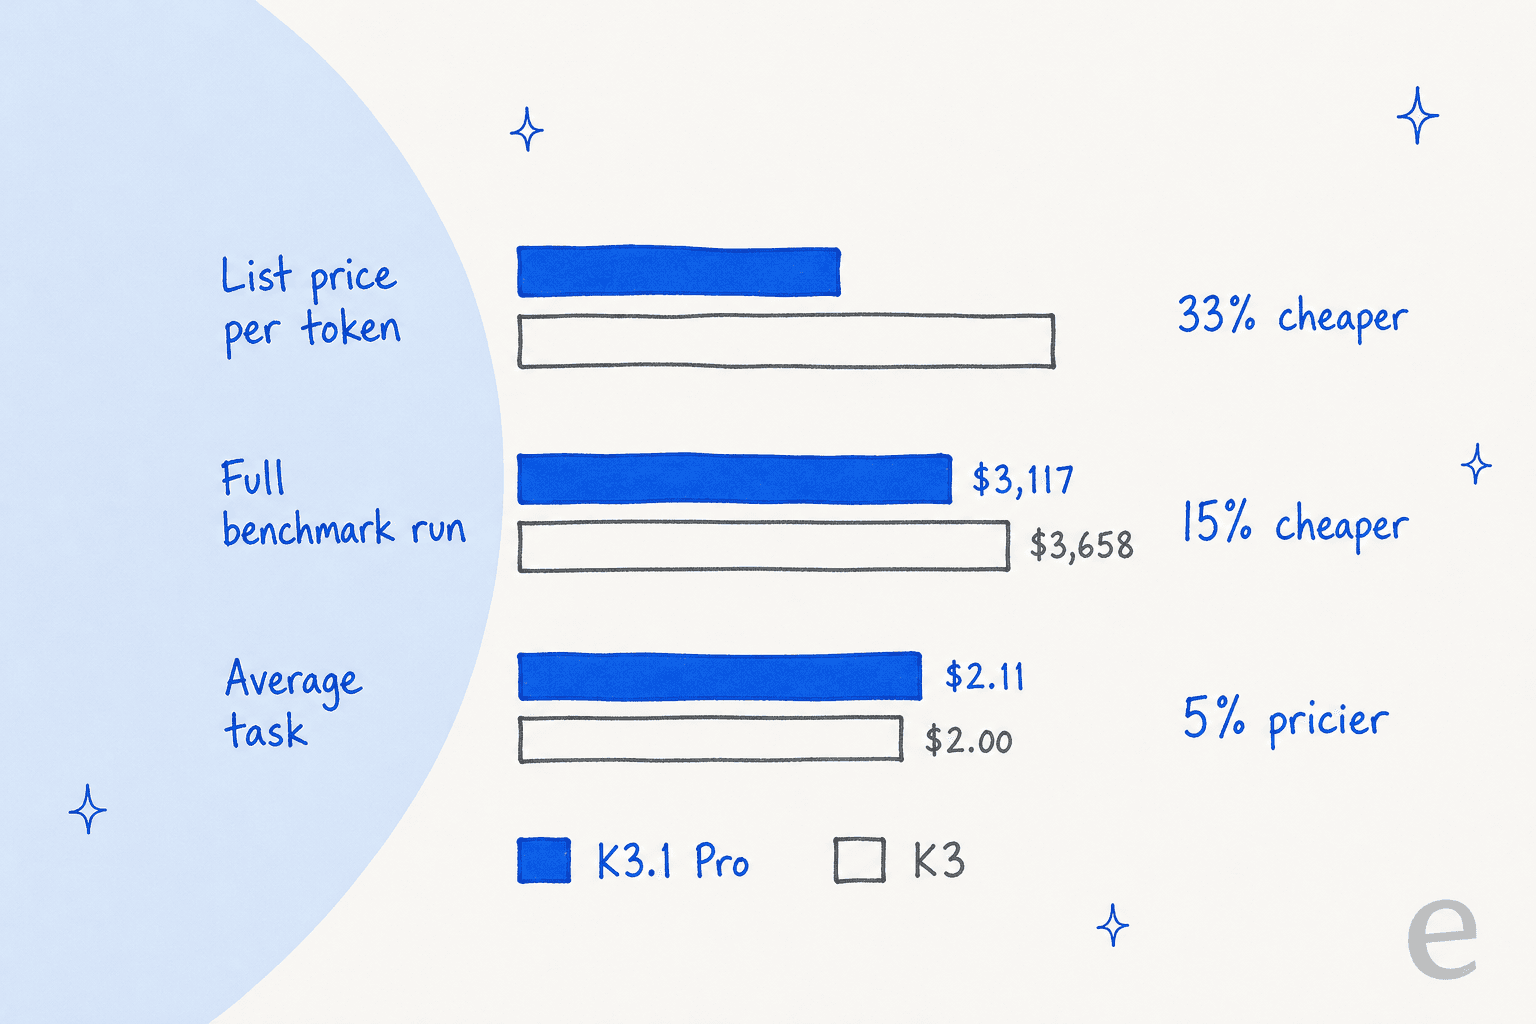
Ces trois chiffres ne se contredisent pas, ils mesurent simplement des choses différentes. L'exécution complète donne plus de poids aux grosses tâches, là où les gains d'efficacité de K3.1 Pro se manifestent. Le chiffre par tâche moyenne est une moyenne simple, dans laquelle ses sorties plus longues sur les petites tâches le placent légèrement au-dessus de K3. Dans tous les cas, le bilan honnête est que vous obtenez un modèle plus intelligent de 11.5 points pour à peu près le même prix, pas le même modèle pour un tiers de moins.
Nathan Lambert, chercheur chez Ai2, l'avait déjà relevé le jour du lancement :
"K3.1 is also cheaper than K3 per token, but some benchmarks in the blog show it uses meaningfully more tokens per answer, so it may be about the same price."
Comment il se compare aux autres modèles de pointe
Voici comment il se positionne face aux modèles avec lesquels les utilisateurs le comparent, toutes les données provenant de la même page d'Artificial Analysis :
| Modèle | Prix affiché (entrée / sortie) | Intelligence Index | Coût par tâche | Coût d'exécution de l'indice | Vitesse de sortie |
|---|---|---|---|---|---|
| Claude Opus 5.5 (Max) | $4 / $20 | 57.6 | $5.98 | $8,708 | 98.1 t/s |
| Claude Sonnet 5.5 (Max) | $2 / $10 | 56.0 | $5.46 | $7,260 | 141.3 t/s |
| Kimi K3.1 Pro | $2 / $10 | 55.1 | $2.11 | $3,117 | 49.7 t/s |
| Claude Fable 5.1 (Max) | $10 / $50 | 53.4 | $7.63 | $13,129 | 69.8 t/s |
| GPT-6 Astra (Max) | $10 / $50 | 52.7 | $3.26 | $5,324 | 66.7 t/s |
| Gemini 4 Argon (High) | $2 / $10 | 52.6 | $1.62 | $2,101 | 79.7 t/s |
| GPT-6.1 Sol (Max) | $2 / $10 | 51.8 | $0.72 | $1,082 | 65.9 t/s |
| DeepSeek V4.1 Flash 1017 (Max) | $0.30 / $1.20 | 45.1 | $0.26 | $445 | 169.3 t/s |
| Kimi K3 (Max) | $3 / $15 | 43.6 | $2.00 | $3,658 | 54.5 t/s |
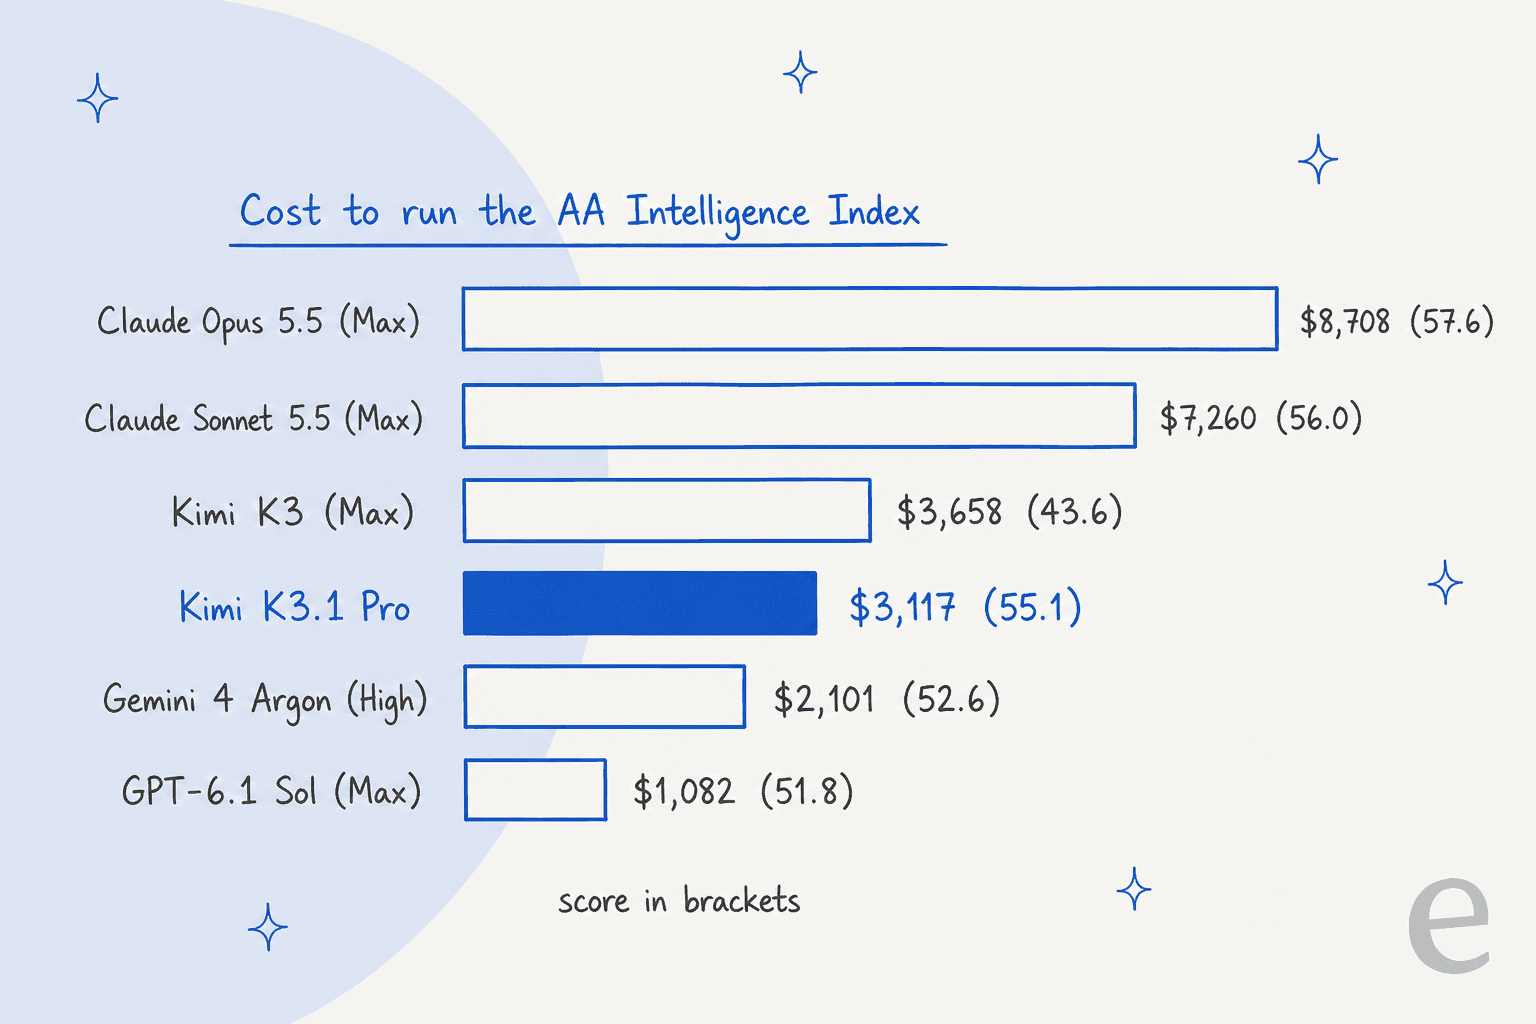
Ma lecture de ce tableau :
- Face à Claude, c'est clairement le meilleur rapport qualité-prix. Son tarif affiché est le même que celui de Sonnet 5.5, mais Sonnet à l'effort maximal a consommé
416Mde tokens de sortie sur l'indice, tandis que K3.1 Pro s'en approche à moins d'un point pour un coût par tâche largement inférieur à la moitié. - Face aux modèles à 2 $ / 10 $ qui reviennent moins cher, ce n'est pas la bonne affaire. GPT-6.1 Sol et Gemini 4 Argon terminent une tâche moyenne pour
$0.72et$1.62, avec environ 3 et 2.5 points de moins sur l'indice. Si le coût par tâche compte plus pour vous que les derniers points de performance, ils prennent l'avantage. - La vitesse est le prix caché. Avec
49.7tokens par seconde, il se classe#165sur 182 modèles. Une tâche moyenne de l'indice a pris environ 17 minutes, ce qui n'apparaît pas sur une facture, mais se remarque très nettement pour la personne qui attend.
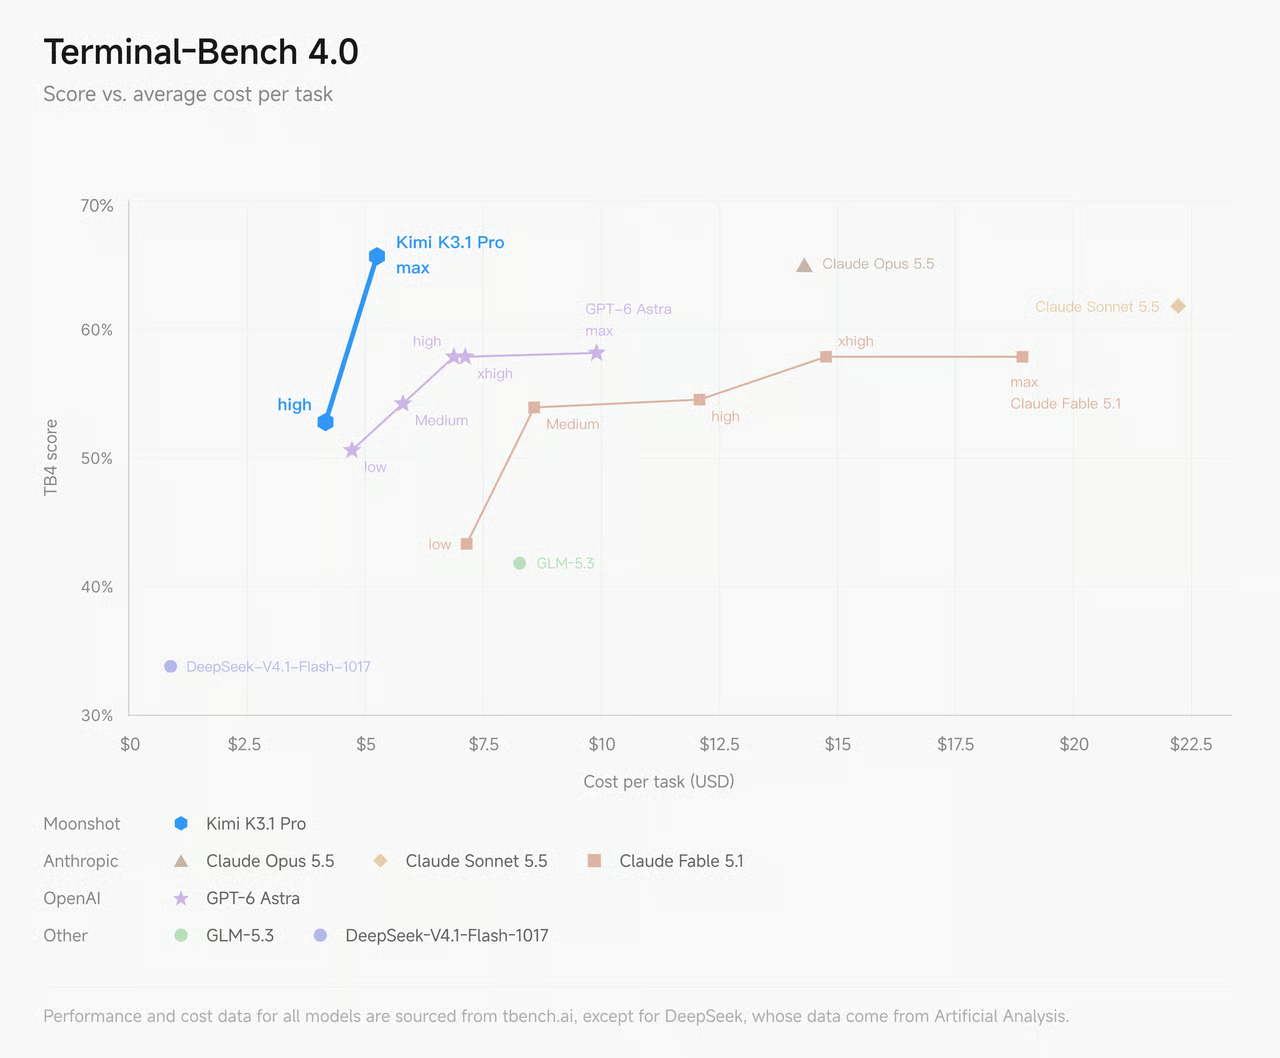
Le propre graphique de Moonshot illustre cet avantage face à Claude sur Terminal-Bench, où il place K3.1 Pro à environ 5 $ par tâche, contre environ 14 $ pour Opus 5.5 :
Un testeur indépendant a constaté le même type d'écart sur une tâche plus petite :
"Kimi K3.1 Pro ties Sonnet 5.5 at 93, for $0.68 and 11 min vs Sonnet's $1.61 and 14 min."

Kimi K3.1 Pro Highspeed vaut-il le double du prix ?
Seulement lorsqu'une personne attend la réponse. Highspeed est le même modèle proposé à "about 2-3× the speed", pour un prix d'entrée et de sortie exactement deux fois plus élevé (guide des clés API). La qualité est identique : vous achetez donc du temps, pas de l'intelligence.
Pour les traitements nocturnes et les agents en arrière-plan, ou tout ce pour quoi personne ne regarde le curseur, K3.1 Pro standard est le choix évident. Pour le chat en direct ou les cycles courts de développement, les 49.7 tokens par seconde du modèle de base paraissent effectivement lents, et Highspeed y remédie. Cette amélioration n'a toutefois pas impressionné tout le monde :
"I'll wait for the openweight... btw double the price for 67 TPS... Hardly 'nitro'."
Il n'existe pas encore de mesure indépendante de la vitesse de Highspeed, Artificial Analysis ne le répertorie pas, donc je considérerais le facteur 2-3x annoncé par Moonshot comme une affirmation à vérifier tant que personne ne l'aura testé.
Combien coûtent les abonnements Kimi qui incluent K3.1 Pro ?
Les abonnements Kimi vont de $19 à $199 par mois et incluent K3.1 Pro dans l'application Kimi et Kimi Work, ainsi que Kimi Code, l'agent de programmation de Moonshot. Les prix ci-dessous proviennent de la page Kimi Code :
| Abonnement | Mensuel | Facturation annuelle (par mois) | Facturation annuelle (total) | Accès à K3.1 Pro |
|---|---|---|---|---|
| Plus | $19 | $15 | $180 | Standard |
| Pro | $39 | $31 | $372 | Standard et Highspeed |
| Max | $99 | $79 | $948 | Standard et Highspeed |
| Ultra | $199 | $159 | $1,908 | Standard et Highspeed |
Dans un abonnement, Highspeed applique "2× credit usage". Kimi a aussi récemment renommé ses abonnements, "with pricing unchanged" selon sa page des avantages de Kimi Code, et les abonnés existants peuvent conserver les anciens noms (Moderato, Allegretto, etc.). Les nouveaux abonnements ont supprimé la limite hebdomadaire de Kimi Code, mais conservé la fenêtre glissante de 5 heures, ainsi qu'une réserve mensuelle de crédits partagée entre Kimi et Kimi Code.
En Chine, la même gamme est tarifée en yuans, de l'abonnement Go à ¥49 (sans Kimi Code) jusqu'à ¥1 399 par mois pour Ultra, selon la page d'aide sur les tarifs des abonnements de Kimi.
Que se passe-t-il lorsque vous atteignez la limite ?
Vous pouvez acheter Extra Usage, une recharge à l'usage partagée entre Kimi et Kimi Code, avec un minimum de ¥25 par recharge. Kimi indique que son prix est "close to the official API pricing", ce qui revient donc à l'API avec un autre mode de paiement.
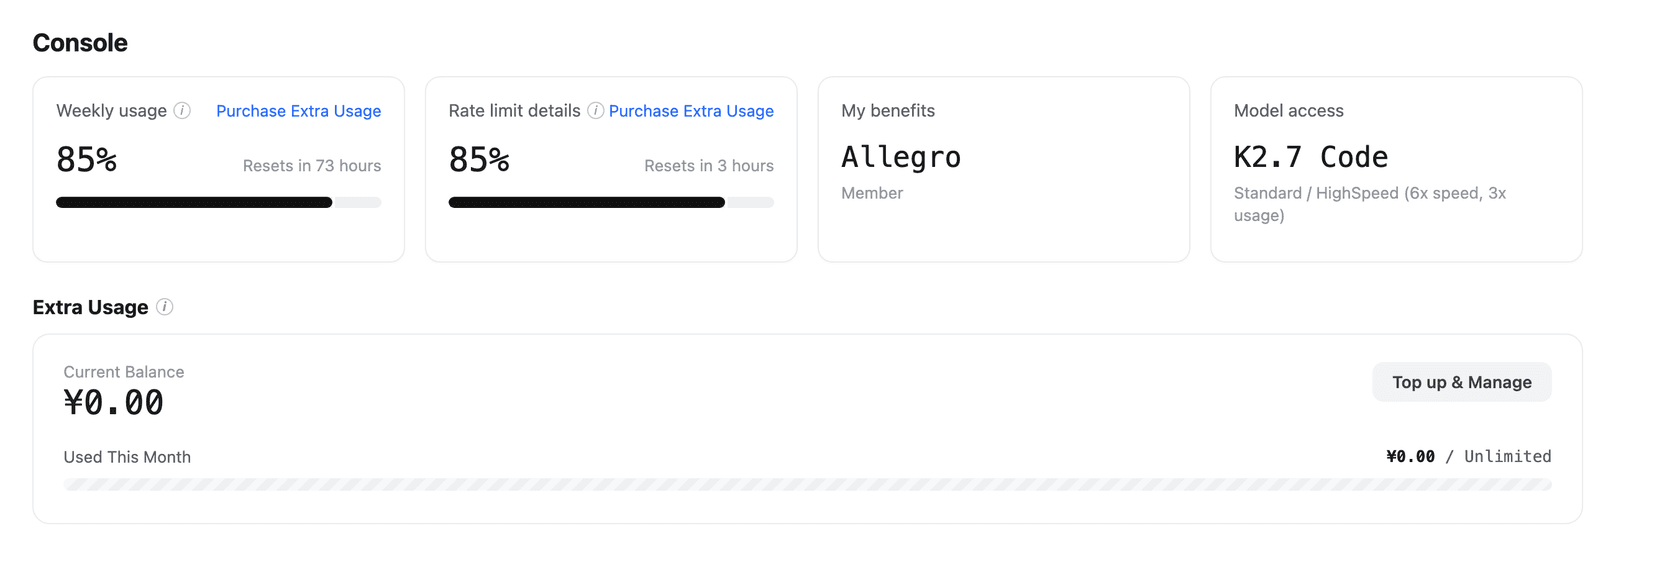
C'est important, car la limite de 5 heures est jusqu'ici la critique la plus insistante à propos de K3.1 Pro. Dans le fil de lancement de 674 commentaires sur Hacker News, le quota revenait plus souvent que la qualité du modèle :
"If you are expecting any sort of usable limits on their subscription plan I suggest adjusting your expectations. I subscribed to $99 a month plan and within 47 minutes with one session (not asking for swarms or anything) was limited by 5-hour quota."
Pour être juste envers Moonshot, le réglage d'effort max par défaut y est pour beaucoup, et un autre utilisateur du même fil a indiqué avoir travaillé pendant 8 heures avec 22 % de son quota hebdomadaire en associant K3.1 Pro à un modèle plus léger pour les sous-agents. Les abonnements fonctionnent, ils n'offrent simplement pas d'emblée autant de marge que certains abonnements de programmation concurrents.
Faut-il utiliser l'API ou un abonnement Kimi ?
Choisissez selon qui appelle le modèle. Si c'est votre application ou votre agent, utilisez l'API : vous payez par token et, après une recharge de $10, il n'y a plus de plafond quotidien. Si c'est vous qui l'appelez, depuis Kimi Code ou l'application Kimi, un abonnement est presque toujours moins cher, tant que vous pouvez composer avec la fenêtre de 5 heures.
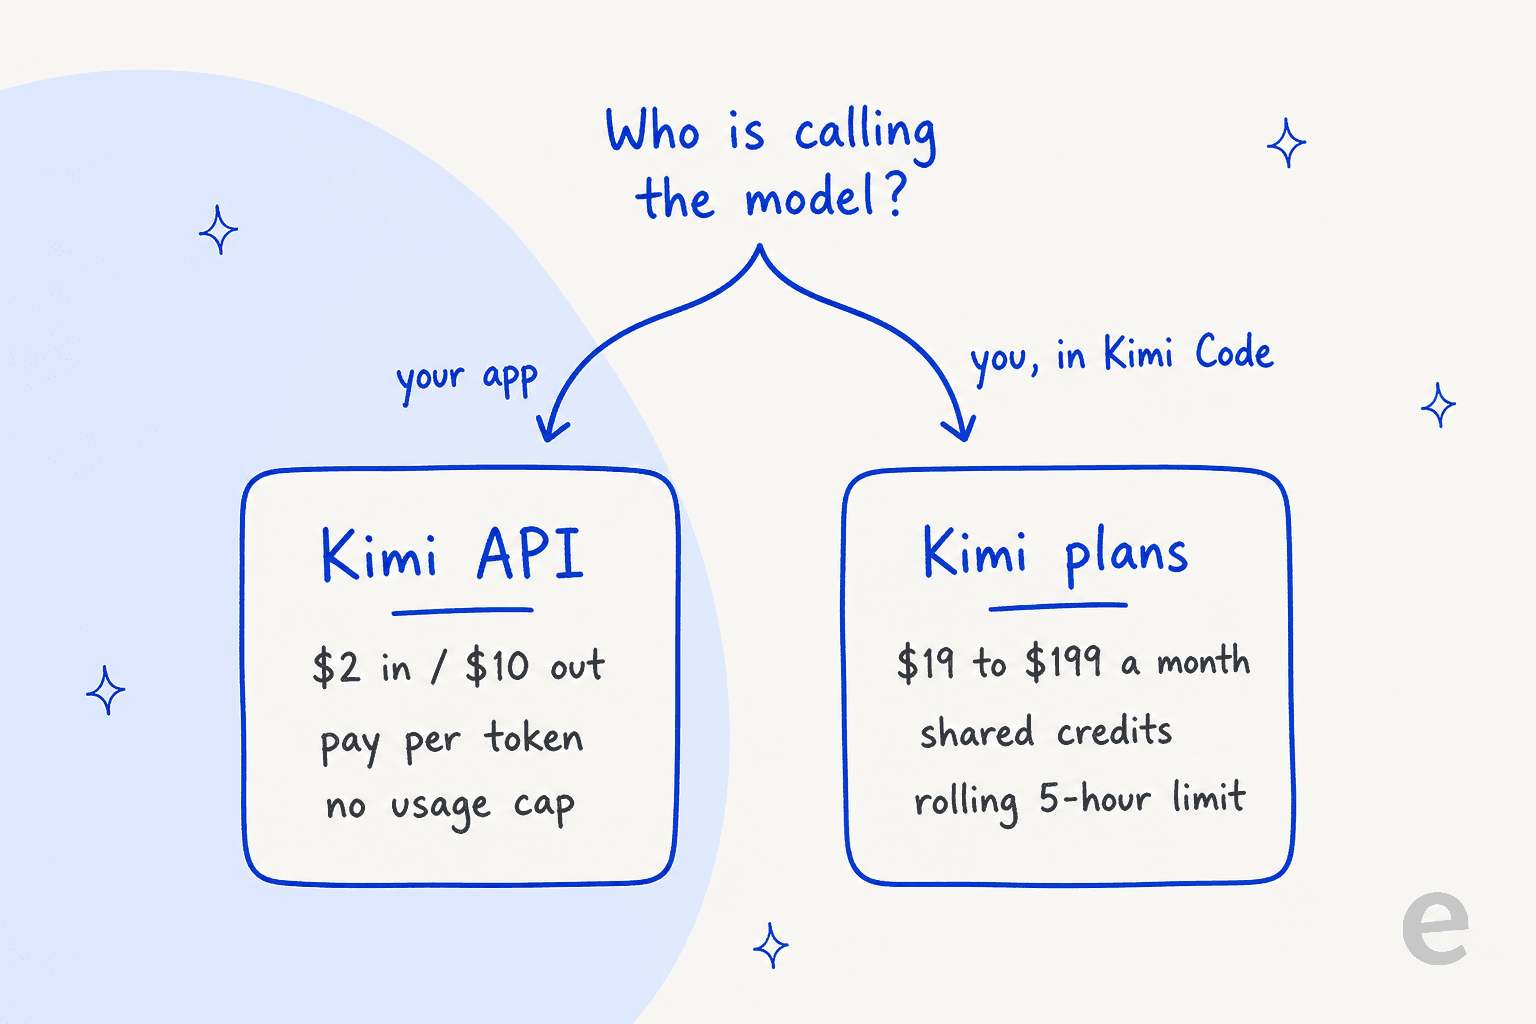
Le calcul explique pourquoi. Un développeur qui exécute 20 tâches d'agent par jour ouvré, à la moyenne d'Artificial Analysis de $2.11 par tâche, dépenserait environ $928 par mois sur l'API (20 × 22 × $2.11). L'abonnement Max à $99 est une aubaine en comparaison, ce qui explique précisément pourquoi Moonshot le rationne avec cette limite glissante. Si vous comparez les abonnements de programmation, mon analyse des tarifs de Claude Code et ma liste d'assistants IA de programmation couvrent les autres options.
Combien coûterait Kimi K3.1 Pro pour ma charge de travail ?
Saisissez vos propres chiffres. Le calculateur ci-dessous utilise les tarifs officiels de l'API Kimi et suppose que la part mise en cache reste active (sans frais d'écriture en cache), il vaut donc mieux considérer le résultat comme un minimum.
Pour vous donner une idée de cas concrets, voici ce que coûtent trois charges de travail courantes sur K3.1 Pro standard, aux tarifs officiels :
| Charge de travail | Par requête | Volume mensuel | K3.1 Pro | Highspeed | Kimi K3 |
|---|---|---|---|---|---|
| Réponses d'assistance | 6 000 entrées en cache + 2 000 nouvelles entrées, 1 500 sorties | 10,000 | $202 | $392 | $303 |
| Questions-réponses sur de longs documents | 200 000 nouvelles entrées, 3 000 sorties | 500 | $215 | $430 | $323 |
| Programmation agentique | Tâche moyenne AA ($2.11) | 440 | ~$928 | s.o. | ~$880 |
Le constat est le même dans les trois cas : la mise en cache des entrées se fait toute seule sur les prompts répétés, et c'est du côté des sorties qu'il faut chercher les économies. Passer reasoning_effort de sa valeur par défaut max à high ou low serait mon premier réglage. Sur K3, AA a mesuré le réglage à faible effort à $1.15 par tâche contre $2.00 au maximum, avec une forte baisse du score, donc testez-le sur vos propres tâches avant de l'adopter. Si vous suivez les dépenses sur plusieurs modèles, un outil de suivi des LLM aide à repérer un agent qui s'emballe avant de le découvrir sur la facture.
Kimi K3.1 Pro vaut-il son prix ?
Pour la programmation agentique et les travaux longs en plusieurs étapes, oui. C'est l'un des modèles les mieux notés que vous puissiez acheter, et son coût par tâche à l'effort maximal est largement inférieur à la moitié de celui de Claude. Ses poids sont aussi promis "by Nov 4", ce qui devrait attirer davantage d'hébergeurs. Pour donner un ordre de grandeur, Kimi K3 est proposé par 20 fournisseurs sur Artificial Analysis, contre 5 pour K3.1 Pro aujourd'hui.
L'offre est moins intéressante dans trois cas :
- Vous voulez terminer vos tâches au moindre coût. GPT-6.1 Sol et Gemini 4 Argon réalisent la tâche moyenne pour moins cher. Sur le seul coût, DeepSeek V4.1 Flash joue dans une autre catégorie, à
$0.26par tâche. - Une personne attend chaque réponse. À 50 tokens par seconde, vous finirez par passer à Highspeed, et l'avantage tarifaire sur Sonnet 5.5 se réduira alors.
- Vous comptez tout faire avec un abonnement Kimi. La fenêtre de 5 heures est serrée à l'effort maximal. Prévoyez un budget Extra Usage, ou attendez quelques semaines pour voir si Moonshot l'assouplit.
Si vous le comparez au reste du marché, ma liste des alternatives à Kimi K3 et mon article sur les tarifs de Qwen 3.8 Max restent pertinents.
Pour l'angle des modèles ouverts, j'ai comparé Qwen 3.8 Max et K3 face à face, et vous trouverez l'analyse complète du modèle dans mon article sur Kimi K3.1 Pro.
Ce que le prix d'un modèle ne dit pas à une équipe d'assistance
Beaucoup de personnes qui étudient les tarifs de modèles comme celui-ci se demandent en réalité s'il faut construire un agent d'assistance dessus. En tant que personne travaillant sur les intégrations d'eesel, je dirais que le tarif par token est la partie facile. Si l'on reprend l'exemple d'assistance ci-dessus, $202 par mois vous achètent des tokens, pas un agent. Il vous faudrait encore connecter votre outil d'assistance, synchroniser votre centre d'aide et vos anciens tickets, rédiger les règles de transfert et tout tester avant qu'un client ne voie une réponse. C'est cette construction qui absorbe l'essentiel du temps et du risque, et c'est pourquoi chaque déploiement d'eesel est d'abord simulé sur les propres tickets historiques de l'équipe.
eesel vous épargne entièrement cette construction. Vous recrutez un coéquipier IA pour l'assistance prêt à travailler, qui rejoint votre file existante dans Zendesk, Freshdesk ou Gorgias et apprend à partir de votre documentation et de vos anciens tickets, puis suit les règles de transfert que vous rédigez en anglais courant. La tarification repose sur des forfaits de crédits fixes plutôt que sur une facturation par token, donc la facture ne fluctue pas lorsqu'un modèle décide de réfléchir davantage. Si vous voulez voir comment les coûts se comparent dans leur ensemble, mon guide du coût par résolution fait les calculs, et l'article sur le meilleur modèle d'IA pour l'assistance compare les moteurs sous-jacents.

SE Ranking illustre bien ce que cela donne en production. L'entreprise gère trois produits (SE Ranking, Planable et SE Visible) avec une seule équipe Zendesk et un agent eesel par produit. Chaque agent effectue ses recherches dans environ 16,800 pages de contenu du centre d'aide et du site web, répond au chat en direct dans la langue du client, et transmet les remboursements, les prolongations d'essai et les questions de niveau 2 à une personne avec les détails joints. Entre le 8 août et le 8 septembre 2026, le système a traité environ 4,650 conversations, sans que rien de tout cela dépende du modèle en tête d'un classement cette semaine-là.
Si vous aimez l'approche de Kimi centrée sur le terminal, l'interface CLI d'eesel apporte la même chose à l'assistance. Vous pouvez consulter le travail récent du coéquipier avec eesel activity, approuver ou refuser les actions en attente avec eesel approvals, et modifier ses règles permanentes avec eesel instructions. La sortie est en JSON et les commandes d'écriture prennent en charge --dry-run, ce qui permet aux scripts et aux agents de programmation comme Claude Code de le piloter en toute sécurité.
Il existe aussi un serveur MCP, et j'aborde cette approche plus largement dans mon guide des CLI pour agents IA.
Essayez eesel
Si vous étudiez les tarifs de Kimi K3.1 Pro pour votre assistance, essayez la version où quelqu'un d'autre a déjà fait le travail de construction. eesel installe un coéquipier IA prêt à travailler dans votre outil d'assistance en quelques minutes et le forme sur vos anciens tickets, tout en vous permettant de le tester sur la file de la semaine dernière avant qu'il ne réponde à qui que ce soit. Essayez eesel gratuitement, ou comparez d'abord les options dans ma liste des meilleurs coéquipiers IA.
Questions fréquentes
Combien coûte Kimi K3.1 Pro ?
Sur l’API Kimi, Kimi K3.1 Pro coûte 2 $ par million de tokens d’entrée, 0,20 $ par million de tokens d’entrée mis en cache et 10 $ par million de tokens de sortie. Aucun supplément pour les longs contextes ne s’applique sur l’ensemble de la fenêtre de 1M de tokens. Ma présentation de Kimi K3.1 Pro couvre le modèle lui-même.
Combien coûte Kimi K3.1 Pro Highspeed ?
Kimi K3.1 Pro Highspeed coûte 4 $ en entrée et 20 $ en sortie par million de tokens, soit exactement le double du modèle standard, pour une vitesse environ 2 à 3 fois supérieure. Le tarif des tokens d’entrée mis en cache reste à 0,20 $. Avec les forfaits grand public de Kimi, Highspeed nécessite le forfait Pro ou supérieur et consomme les crédits deux fois plus vite.
Kimi K3.1 Pro est-il moins cher que Kimi K3 ?
Par token, oui : K3.1 Pro est à 2 $/10 $ contre 3 $/15 $ pour les tarifs de Kimi K3, soit un tiers de moins. Par tâche, les coûts sont presque identiques, car K3.1 Pro écrit davantage. Artificial Analysis l’évalue à 2,11 $ par tâche en moyenne contre 2,00 $ pour K3, tout en lui attribuant un score supérieur de 11.5 points.
Quel forfait Kimi faut-il pour utiliser Kimi K3.1 Pro ?
Le modèle standard Kimi K3.1 Pro est disponible avec le forfait Plus (19 $/mois) et les forfaits supérieurs, tandis que Highspeed nécessite Pro (39 $/mois) ou supérieur. Kimi Code partage le même quota que le reste de l’abonnement. Comparez-le aux tarifs de Claude Code si vous choisissez un forfait pour coder.
Kimi K3.1 Pro propose-t-il une offre gratuite ou une réduction pour le traitement par lots ?
Non. L’API devient accessible après une recharge minimale de 1 $, et la réduction de 60 % de Batch API ne couvre pour l’instant que les anciens modèles K2. Si vous cherchez un moyen gratuit de faire des essais, ma sélection d’API d’IA gratuites répertorie les options actuelles.
Kimi K3.1 Pro est-il moins cher que Claude ?
Au tarif catalogue, il correspond aux tarifs de Claude Sonnet 5.5 à 2 $/10 $ et coûte moitié moins que les tarifs de Claude Opus 5.5. Par tâche, il est bien moins cher que les deux au niveau d’effort maximal : 2,11 $ contre 5,46 $ pour Sonnet 5.5 et 5,98 $ pour Opus 5.5 sur Artificial Analysis.
Combien coûte Kimi K3.1 Pro pour un bot de support client ?
Pour 10 000 réponses par mois avec, pour chacune, un prompt de 6 000 tokens mis en cache, 2 000 nouveaux tokens d’entrée et 1 500 tokens de sortie, les tarifs de Kimi K3.1 Pro reviennent à environ 202 $ par mois en tokens. La connexion au service d’assistance, les tests et les règles de transfert s’ajoutent à cela. Un coéquipier de support client par IA prêt à l’emploi comme eesel inclut cette couche.