

En bref
L’alternative la plus proche de Kimi K3.1 Pro est Claude Sonnet 5.5 : les mêmes 2 $/10 $ par million de tokens, une vitesse de sortie environ trois fois supérieure et un score de benchmark presque identique. Gemini 4 Argon est aussi à 2 $/10 $, mais seulement jusqu’au 30 novembre 2026, puis son tarif double.
Si c’est votre facture qui pose problème, les options moins chères sont Gemini 3.8 Flash (environ $15 pour 1 000 requêtes types contre $40 pour Kimi) et DeepSeek V4.1 Flash (environ $2.70 en heures creuses). Pour des poids ouverts que vous pouvez télécharger dès aujourd’hui, DeepSeek V4.1 Flash et MiMo-V2.6-Pro sont tous deux sous licence MIT.
La surprise, c’est Claude Opus 5.5 : un tarif affiché deux fois plus élevé, mais un coût par tâche terminée plus bas au niveau d’effort High (1,82 $ contre 2,11 $ sur Artificial Analysis). Et si le modèle doit répondre à des tickets d’assistance, vous n’avez peut-être même pas besoin d’en choisir un : un coéquipier IA pour votre service d’assistance comme eesel s’appuie déjà sur des modèles de pointe et est d’abord testé sur vos anciens tickets.
Pourquoi chercher au-delà de Kimi K3.1 Pro ?
Kimi K3.1 Pro est un très bon modèle, et je tiens à le dire avant toute chose. Il obtient 55.1 sur l’Artificial Analysis Intelligence Index, se classant #4 sur 215, à 2 $ en entrée et 10 $ en sortie par million de tokens sur l’API Kimi. Sur Terminal-Bench 4.0, il a obtenu le meilleur score de tous les modèles de cette page, soit 67,2 %.
Alors pourquoi chercher des alternatives une semaine après son lancement ? D’après ce que j’ai lu dans les discussions du lancement et dans les chiffres, quatre raisons reviennent sans cesse :
- Il est lent. Artificial Analysis a mesuré 49.7 tokens de sortie par seconde contre une médiane de 83.1 pour les modèles comparables, ce qui le classe #165 sur 182 en vitesse. Un utilisateur qui attend une réponse dans un chat le ressent.
- Il écrit beaucoup. Il a utilisé 148M de tokens de sortie pour exécuter l’index, contre une médiane d’environ 87M pour les modèles comparables : le faible prix par token finit donc par se répercuter sur la facture. Son coût moyen par tâche de l’index est de
$2.11, un peu plus que les$2.00de Kimi K3. - Les poids ne sont pas encore disponibles. Le guide de démarrage rapide de K3.1 Pro de Moonshot indique qu’ils seront publiés d’ici le 4 novembre. Le jour où j’ai vérifié, il n’y avait aucun dépôt K3.1 Pro sur Hugging Face.
- Moins de façons d’y accéder. L’API Batch de Kimi ne couvre pas K3.1 Pro, et les forfaits grand public atteignent vite leurs limites sur 5 heures, comme l’a expliqué un acheteur :
"If you are expecting any sort of usable limits on their subscription plan I suggest adjusting your expectations. I subscribed to $99 a month plan and within 47 minutes with one session (not asking for swarms or anything) was limited by 5-hour quota."

Aucun de ces points n’est rédhibitoire à lui seul. Mais chacun oriente vers une alternative différente, d’où mon choix de classer cette liste selon votre raison de changer, plutôt que selon un classement unique. Mon avis sur Kimi K3.1 Pro présente le bilan complet si vous hésitez encore à changer.
Comment les ai-je comparés ?
Je développe des agents IA chez eesel, où l’équipe passe depuis des années des modèles de pointe à l’épreuve de véritables files de tickets d’assistance. La leçon que j’en retiens : le prix par token ne vous dit presque rien sur la facture. Ce qui compte, c’est le coût par tâche réussie, autrement dit le montant total dépensé pour un lot de tâches réelles, divisé par le nombre de tâches correctement accomplies. Un modèle dont le tarif affiché est deux fois plus bas, mais qui écrit deux fois plus de tokens ou échoue sur une tâche sur quatre, n’est pas moins cher.
Pour chaque alternative, j’ai donc examiné trois chiffres :
- Le prix catalogue, tiré uniquement de la page tarifaire ou de la documentation du fournisseur.
- Le coût pour 1 000 requêtes pour un appel type de 10 000 tokens d’entrée et 2 000 tokens de sortie, sans mise en cache. C’est un plancher, car les modèles de raisonnement écrivent généralement bien plus de 2 000 tokens.
- Le coût par tâche et le score sur l’Intelligence Index d’Artificial Analysis, qui soumet chaque modèle aux mêmes 10 évaluations. C’est l’indicateur public qui se rapproche le plus du coût par tâche réussie.
J’ai réparti les sept options en trois catégories, comme le font la plupart des acheteurs : un concurrent de même niveau à peu près au prix de Kimi, un modèle moins cher pour les gros volumes et des poids ouverts que vous pouvez héberger vous-même.
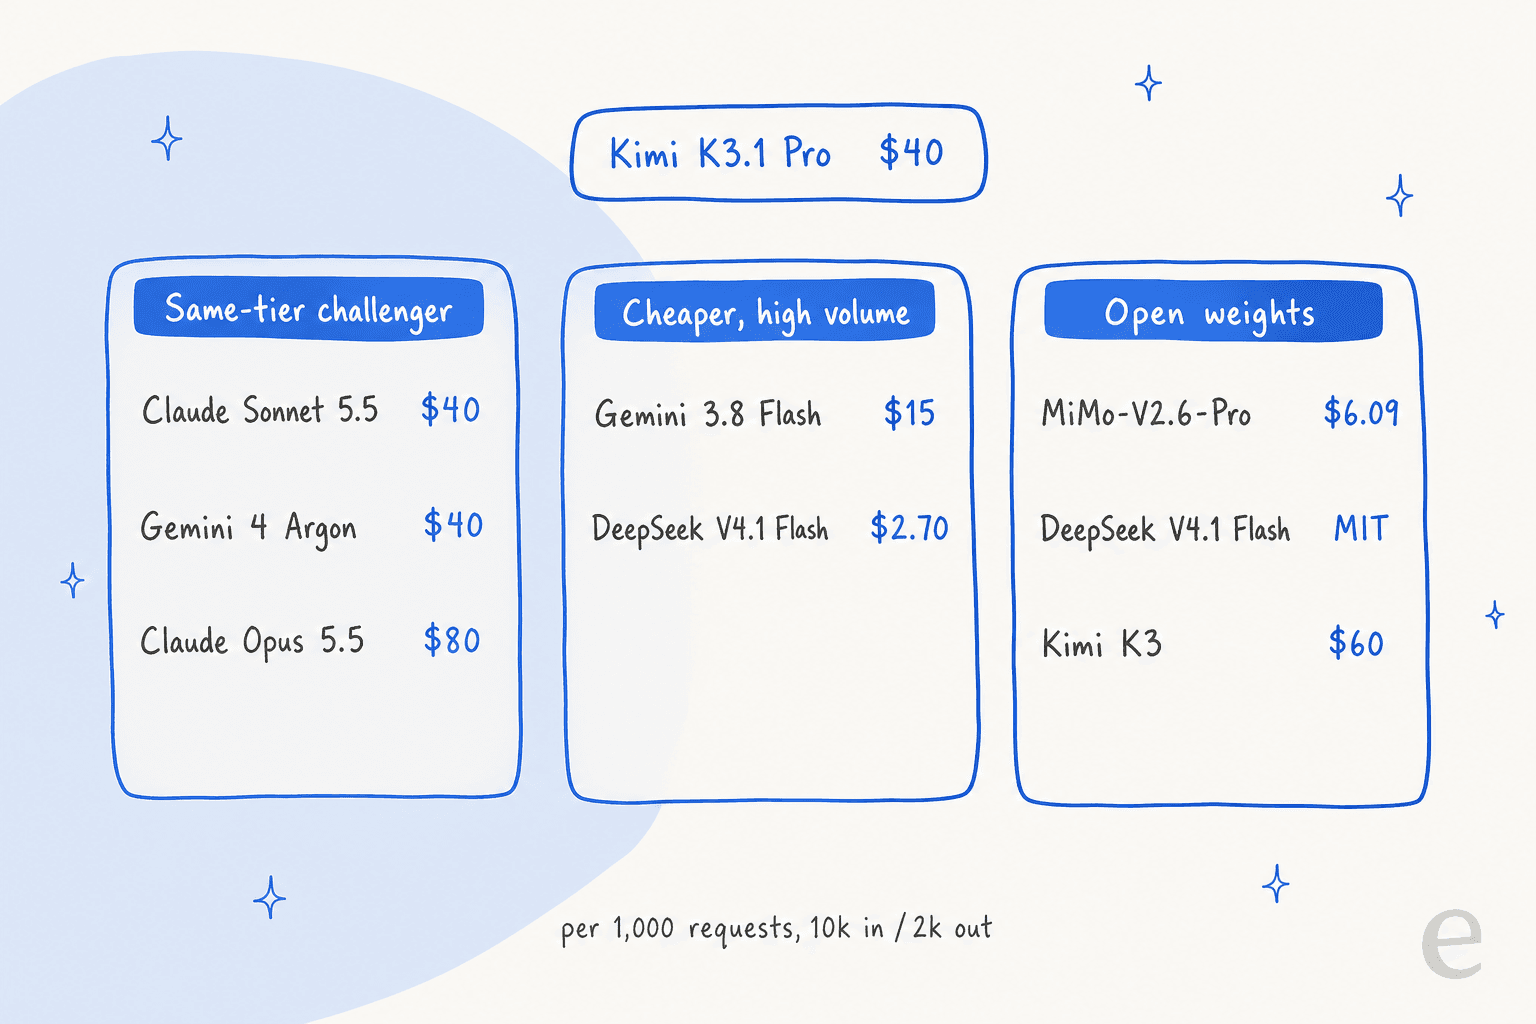
Les alternatives à Kimi K3.1 Pro en un coup d’œil
Tous les prix ci-dessous proviennent de la page du fournisseur. Les colonnes benchmark, vitesse et coût par tâche proviennent d’Artificial Analysis, au niveau d’effort indiqué entre parenthèses.
| Modèle | Catégorie | Entrée / sortie par 1M | Entrée en cache par 1M | Contexte | Sortie maximale | Pour 1 000 requêtes (10k en entrée / 2k en sortie) | AA Intelligence Index | Coût AA par tâche | Vitesse de sortie (t/s) | Poids |
|---|---|---|---|---|---|---|---|---|---|---|
| Kimi K3.1 Pro (référence) | s.o. | 2 $ / 10 $ | 0,20 $ | 1M | 131K par défaut, jusqu’à 1M | 40 $ | 55,1 | 2,11 $ | 49,7 | Promis d’ici le 4 novembre |
| Claude Sonnet 5.5 | Même niveau | 2 $ / 10 $ | 0,10 $ | 1M | 128K | 40 $ | 56.0 (Max), 51.9 (Xhigh) | 5,46 $ (Max), 2,01 $ (Xhigh) | 141.3 (Max) | Fermés |
| Gemini 4 Argon | Même niveau | 2 $ / 10 $ jusqu’au 30 novembre, puis 4 $ / 20 $ | 0,10 $, puis 0,20 $ | 1M | 65K par défaut, jusqu’à 1M | 40 $, puis 80 $ | 52.6 (High) | 1,62 $ (High) | 79.7 (High) | Fermés |
| Claude Opus 5.5 | Même niveau, premium | 4 $ / 20 $ | 0,20 $ | 1M | 128K | 80 $ | 57.6 (Max), 53.6 (High) | 5,98 $ (Max), 1,82 $ (High) | 98.1 (Max) | Fermés |
| Gemini 3.8 Flash | Moins cher | 0,75 $ / 3,75 $ jusqu’au 31 décembre, puis 1,50 $ / 7,50 $ | 0,075 $, puis 0,15 $ | 1M | 65K | 15 $, puis 30 $ | 41 (High) | s.o. | 133.7 (High) | Fermés |
| DeepSeek V4.1 Flash | Moins cher, ouvert | 0,15 $ / 0,60 $ en heures creuses, 0,30 $ / 1,20 $ en heures de pointe | 0,003 $ en heures creuses | 1M | 384K | 2,70 $ en heures creuses, 5,40 $ en heures de pointe | 45.1 (Max) | 0,26 $ (Max) | 169.3 (Max) | MIT |
| MiMo-V2.6-Pro | Poids ouverts | 0,435 $ / 0,87 $ | 0,0036 $ | 1M | Non précisée | 6,09 $ | 46,3 | Environ 0,14 $ | 54,7 | MIT |
| Kimi K3 | Ouvert, même famille | 3 $ / 15 $ | 0,30 $ | 1M | 131K par défaut, jusqu’à 1M | 60 $ | 43.6 (Max) | 2,00 $ (Max) | 54.5 (Max) | Licence Kimi K3 |
Deux choses sautent aux yeux. D’abord, la catégorie de même niveau est bien remplie : trois modèles partagent le tarif de Kimi de 40 $ pour 1 000 requêtes, du moins pour l’instant. Ensuite, la colonne du coût par tâche change l’ordre de la liste. Opus 5.5 au niveau High et Gemini 4 Argon au niveau High terminent tous deux une tâche moyenne pour moins cher que Kimi K3.1 Pro, même si Opus coûte deux fois plus cher par token.
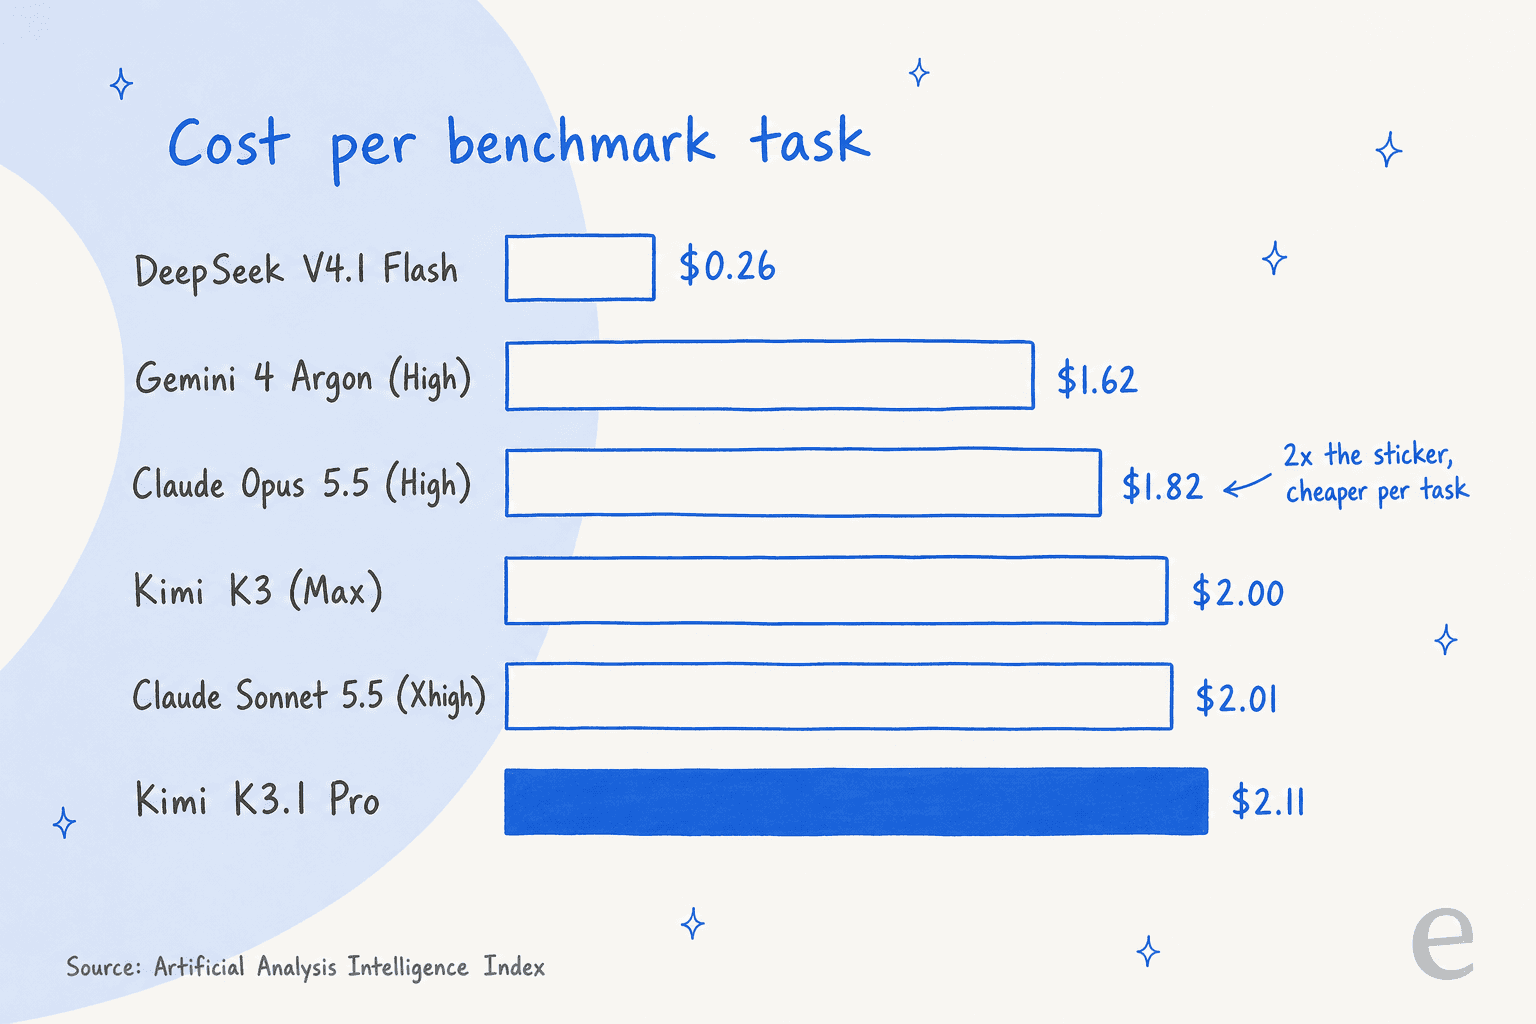
Une réserve sur ce graphique : Kimi K3.1 Pro a tourné à son effort maximal par défaut, tandis qu’Opus et Argon étaient réglés sur High. Mais c’est justement le propos. L’effort est un réglage que vous pouvez ajuster, et la bonne réponse la moins chère vient souvent d’un modèle plus puissant réglé à un niveau inférieur.
Quelle alternative convient à votre produit ?
Choisissez la tâche de votre produit, et la fiche vous indique par où je commencerais les tests comparatifs.
Choisissez une tâche pour voir le modèle que je testerais en premier face à Kimi K3.1 Pro, avec son coût pour 1 000 requêtes de 10k tokens d’entrée et 2k tokens de sortie.
1. Claude Sonnet 5.5
Idéal pour : les équipes qui veulent le prix de Kimi avec une sortie plus rapide et plus régulière. Concurrent de même niveau.
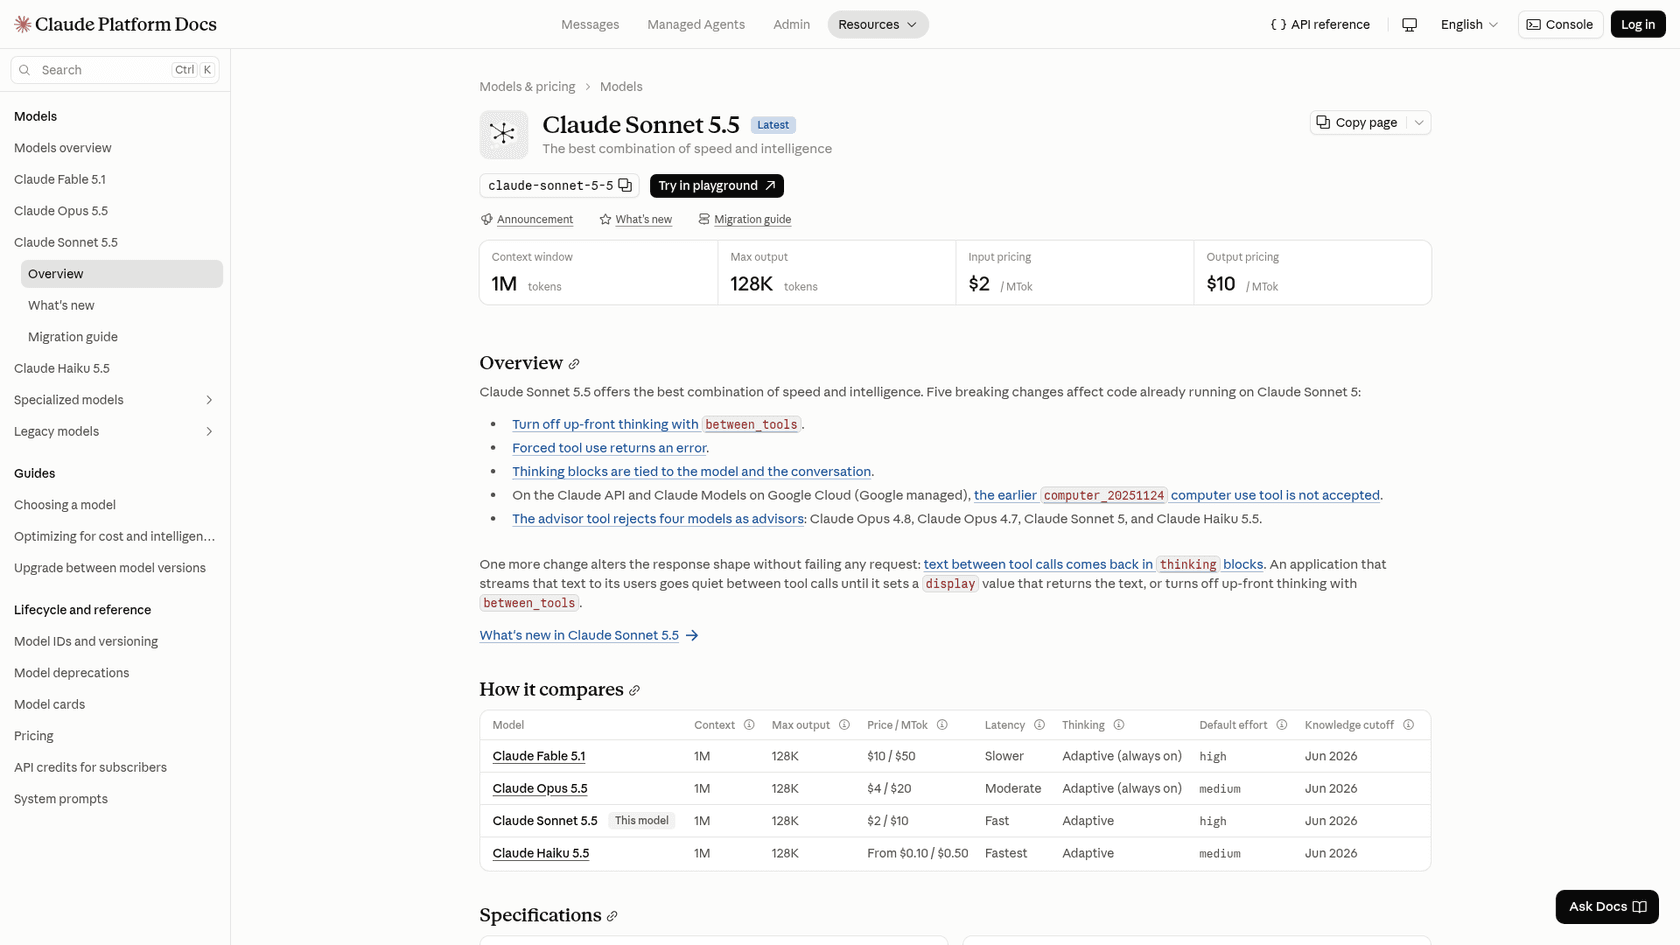
Claude Sonnet 5.5 est le remplacement le plus direct de cette liste. Anthropic le propose exactement au tarif affiché de Kimi K3.1 Pro, soit 2 $ en entrée et 10 $ en sortie par million de tokens, avec une fenêtre de contexte de 1M et une sortie maximale de 128K, d’après sa présentation du modèle.
Pourquoi le choisir plutôt que Kimi K3.1 Pro
- La vitesse. Artificial Analysis a mesuré 141.3 tokens par seconde à l’effort maximal, contre 49.7 pour Kimi.
- Un score légèrement supérieur. 56.0 sur l’Intelligence Index au niveau Max, contre 55.1.
- Des lectures du cache moins chères. La page tarifaire d’Anthropic facture 0,10 $ par million de tokens d’entrée en cache sur Sonnet 5.5, soit la moitié des 0,20 $ de Kimi. Sur un bot d’assistance avec un prompt système long et stable, cela finit par compter.
- Le traitement par lots. Sonnet 5.5 coûte 1 $ / 5 $ sur l’API de traitement par lots d’Anthropic. Celle de Kimi ne couvre pas K3.1 Pro.
Une personne dans la discussion du lancement de K3.1 a testé les deux sur son propre benchmark et constaté une égalité sur la qualité :
"Kimi K3.1 Pro ties Sonnet 5.5 at 93, for $0.68 and 11 min vs Sonnet's $1.61 and 14 min."
Ses limites
Sonnet 5.5 écrit beaucoup à l’effort maximal. Il a utilisé 416M de tokens de sortie pour exécuter l’index, si bien que son coût par tâche au niveau Max est de $5.46, plus du double de Kimi. Au niveau Xhigh, le score descend à 51.9 et le coût à $2.01. Il a aussi introduit cinq changements qui cassent le code existant : l’utilisation forcée d’un outil renvoie une erreur, et le raisonnement ne peut plus être désactivé comme avant, d’après la page de présentation. Si votre bot d’assistance dépend du déclenchement forcé d’un appel d’outil, vérifiez ce point en premier.
Tarifs
| Poste | Prix par 1M de tokens |
|---|---|
| Entrée | 2 $ |
| Sortie | 10 $ |
| Lecture du cache | 0,10 $ |
| Écriture en cache de 5 minutes | 2,50 $ |
| Écriture en cache de 1 heure | 4 $ |
| Entrée / sortie par lots | 1 $ / 5 $ |
Vous trouverez le détail complet dans mon guide des tarifs de Sonnet 5.5.
Mon avis
Choisissez Sonnet 5.5 si la vitesse de Kimi est la raison de votre départ, et utilisez-le en dessous de l’effort maximal. Évitez-le si votre charge de travail consiste en de longues exécutions d’agents à l’effort maximal, où le nombre de tokens plus faible de Kimi l’emporte sur la facture. L’avis sur Sonnet 5.5 détaille ce compromis sur l’effort.
2. Gemini 4 Argon
Idéal pour : les tâches à contexte long et sensibles à l’exactitude, au prix de Kimi, si vous changez avant décembre. Concurrent de même niveau.
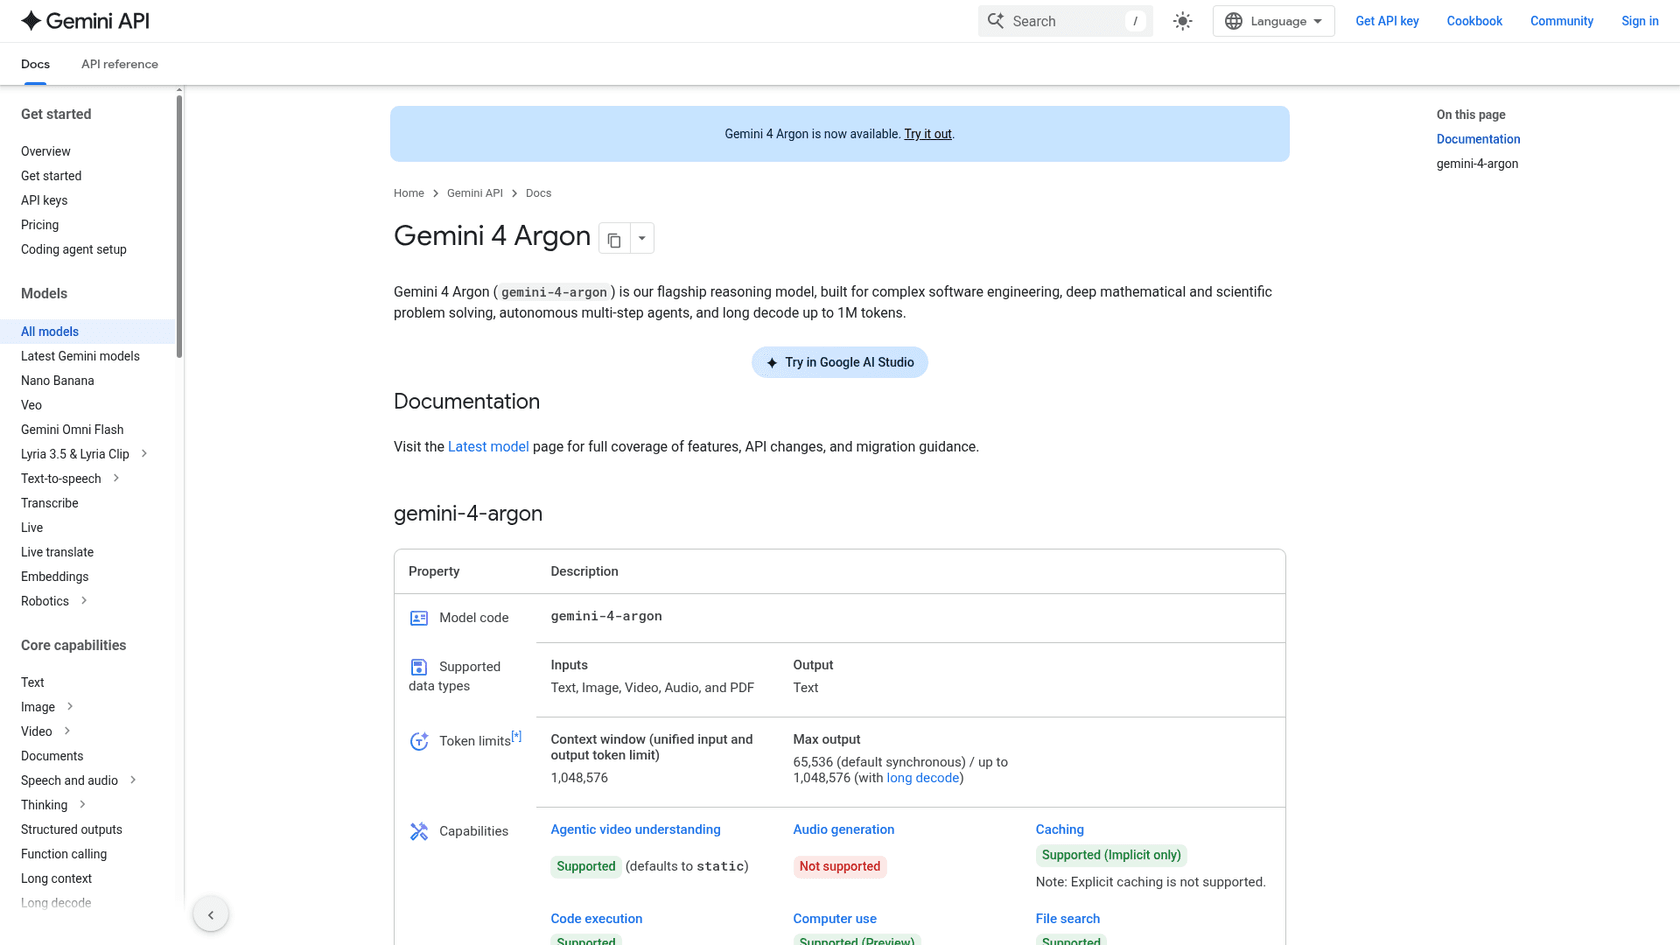
Gemini 4 Argon est le modèle de raisonnement phare de Google, désormais disponible sur l’API Gemini. Pendant les prochaines semaines, il coûte exactement autant que Kimi K3.1 Pro, ce qui en fait le test de même niveau le plus simple à lancer.
Pourquoi le choisir plutôt que Kimi K3.1 Pro
- Moins de réponses inventées. Artificial Analysis situe son taux d’hallucination à 15,1 %, contre 43,9 % pour Kimi K3.1 Pro. Pour tout ce qui s’adresse aux clients, c’est le chiffre auquel j’accorderais le plus d’importance.
- Moins cher par tâche. Au niveau d’effort High, il affichait une moyenne de
$1.62par tâche de l’index pour un score de 52.6. - Des sorties longues. Sa page de modèle indique 65 536 tokens de sortie par défaut et jusqu’à 1 048 576 avec le décodage long.
- Vos données restent exclues de l’entraînement. La page tarifaire de Google indique que l’utilisation de l’offre payante ne sert pas à améliorer ses produits.
Ses limites
Le prix est promotionnel. Google affiche 2 $ / 10 $ jusqu’au 30 novembre 2026, puis 4 $ / 20 $ à partir du 1 décembre, ce qui le place au tarif affiché d’Opus 5.5. La mise en cache explicite n’est pas prise en charge, seule la mise en cache implicite l’est, et il n’y a pas d’offre gratuite. Son score sur l’index, 52.6 au niveau High, est inférieur de 2.5 points à celui de Kimi.
Tarifs
| Poste | Jusqu’au 30 novembre 2026 | À partir du 1 décembre 2026 |
|---|---|---|
| Entrée par 1M | 2 $ | 4 $ |
| Sortie par 1M (raisonnement inclus) | 10 $ | 20 $ |
| Entrée en cache par 1M | 0,10 $ | 0,20 $ |
| Entrée / sortie par lots par 1M | 1 $ / 5 $ | 2 $ / 10 $ |
| Ancrage par recherche | 5 000 gratuits par mois, puis 14 $ pour 1 000 | Identique |
Plus de détails dans mon article sur les tarifs de Gemini 4 Argon.
Mon avis
Choisissez Argon si les mauvaises réponses sont votre plus grand risque, et faites vos calculs au tarif de décembre pour éviter les surprises. Évitez-le si vous avez besoin d’un prix fixe pour l’année à venir. L’avis sur Gemini 4 Argon en dit plus sur ses points forts et ses points faibles.
3. Claude Opus 5.5
Idéal pour : les tâches de programmation et d’agent les plus difficiles, où une exécution ratée coûte plus cher que les tokens. Concurrent premium de même niveau.
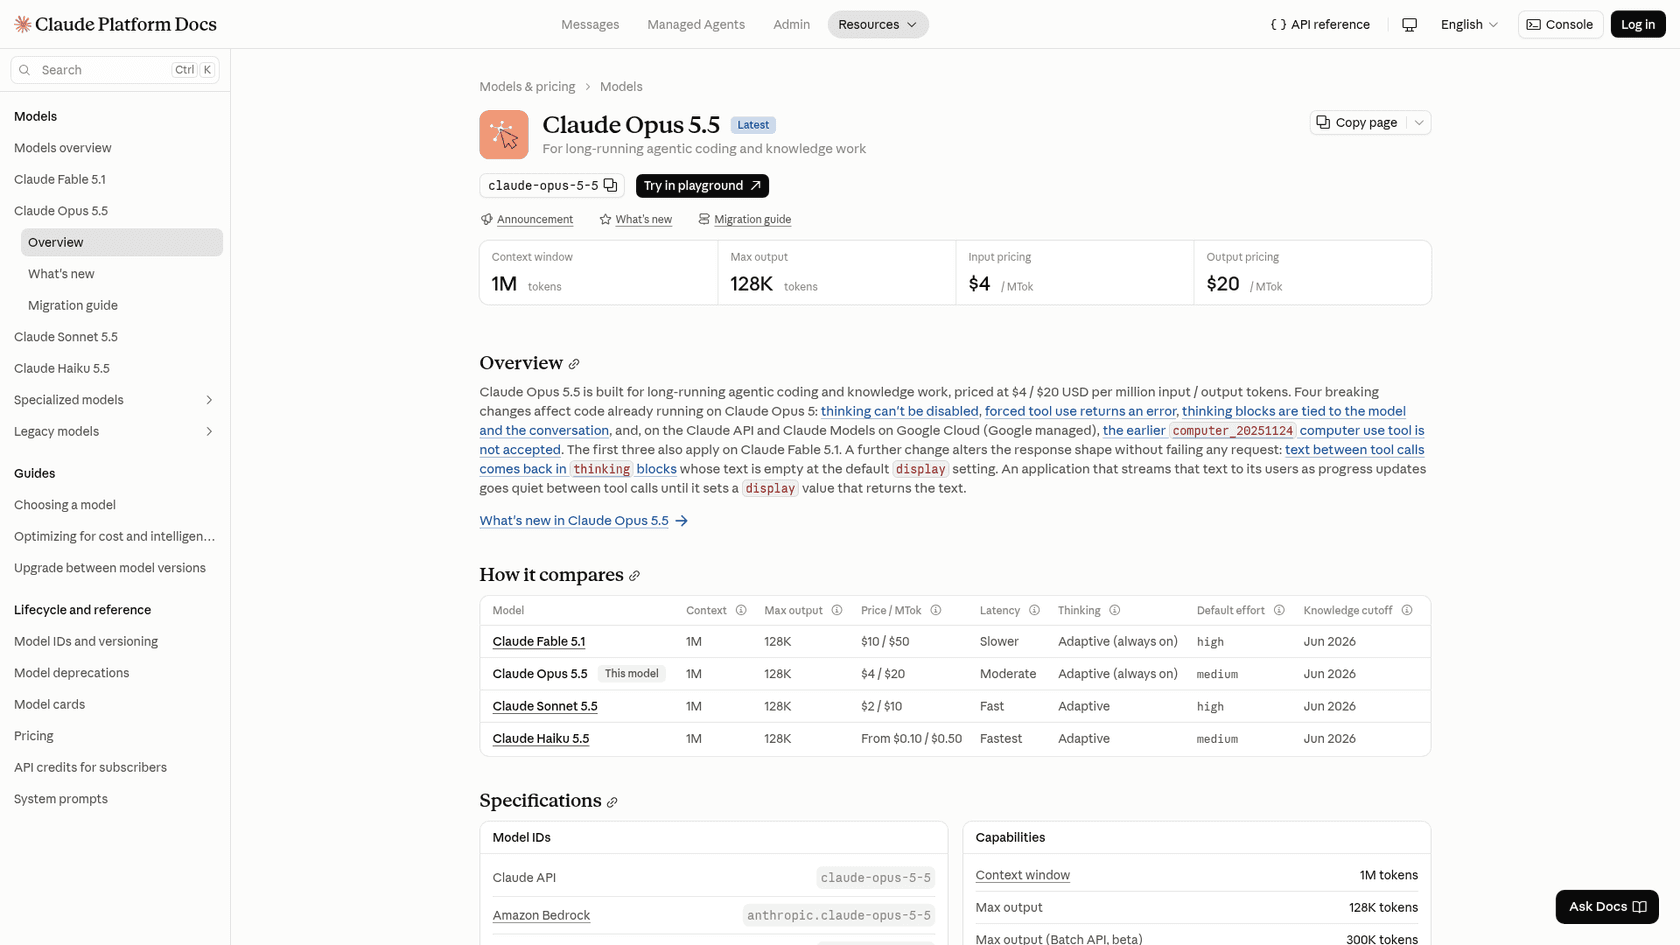
Claude Opus 5.5 est le modèle auquel Kimi K3.1 Pro se mesure. La présentation des modèles d’Anthropic elle-même conseille désormais aux développeurs de commencer par lui pour la plupart des charges de travail, et son effort par défaut est moyen.
Pourquoi le choisir plutôt que Kimi K3.1 Pro
- Le meilleur score de cette sélection. 57.6 sur l’Intelligence Index au niveau Max, en tête du comparatif d’Artificial Analysis.
- Moins cher par tâche au niveau High. 53.6 pour
$1.82par tâche, moins que les$2.11de Kimi. - Les utilisateurs quotidiens le placent toujours devant. Sur X, un testeur a comparé les deux sur 180 peintures générées par code :
"I feel Opus still nails the subtle details better, like in the tractor example below. But I wonder if it matters when you can run Kimi 3x before it costs the same as one Opus?"
Ses limites
Au niveau Max, Opus est l’option la plus chère : $5.98 par tâche et 8 708 $ pour exécuter l’index complet, contre 3 117 $ pour Kimi. Son taux d’hallucination au niveau Max est de 58,6 % sur Artificial Analysis, supérieur aux 43,9 % de Kimi. Et les chiffres de lancement de Kimi lui-même le placent à moins d’un point sur Terminal-Bench 4.0 (65,7 % contre 66,4 %).
Tarifs
| Poste | Prix par 1M de tokens |
|---|---|
| Entrée | 4 $ |
| Sortie | 20 $ |
| Lecture du cache | 0,20 $ |
| Écriture en cache de 5 minutes | 5 $ |
| Écriture en cache de 1 heure | 8 $ |
| Entrée / sortie par lots | 2 $ / 10 $ |
| Entrée / sortie en mode rapide | 8 $ / 40 $ |
Tout provient de la page tarifaire d’Anthropic. L’article sur les tarifs d’Opus 5.5 détaille des factures réelles.
Mon avis
Choisissez Opus 5.5 au niveau High lorsque la qualité de chaque exécution est la contrainte et que vous pouvez régler l’effort vous-même. Évitez-le si votre trafic est volumineux et simple : vous paieriez alors pour du raisonnement que vous n’utilisez pas. Mon avis sur Opus 5.5 passe en revue chaque niveau d’effort.
4. Gemini 3.8 Flash
Idéal pour : le trafic API à gros volume où la réponse n’a pas besoin d’arriver en deux secondes. Catégorie moins chère.
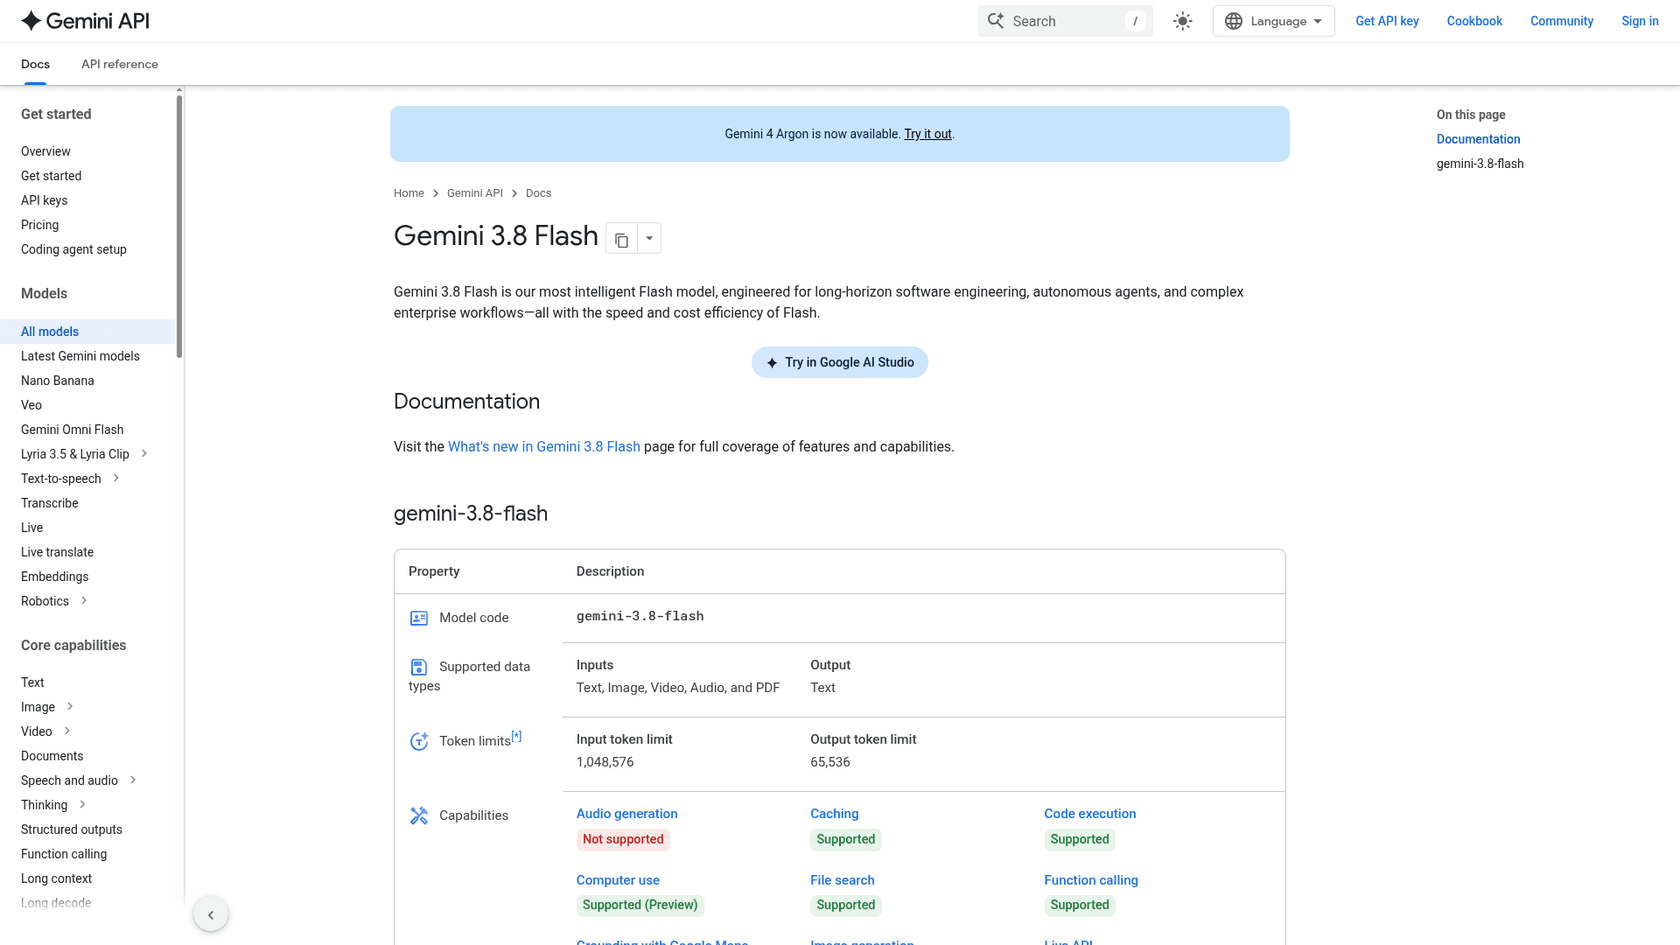
Gemini 3.8 Flash est le modèle fermé le moins cher de cette sélection. Sur la page tarifaire de l’API Gemini, il coûte 0,75 $ en entrée et 3,75 $ en sortie par million de tokens, tokens de raisonnement inclus, jusqu’au 31 décembre 2026.
Pourquoi le choisir plutôt que Kimi K3.1 Pro
- Environ un tiers de la facture. À peu près
$15pour 1 000 requêtes types contre$40pour Kimi. - Une sortie rapide. 133.7 tokens par seconde sur Artificial Analysis.
- Une offre gratuite pour les tests, et du traitement par lots à la moitié du tarif payant.
- Des entrées variées. Texte, image, vidéo, audio et PDF en entrée, d’après sa page de modèle.
Ses limites
Ses capacités sont un cran en dessous : 41 sur l’Intelligence Index au niveau High, contre 55.1 pour Kimi. Artificial Analysis a aussi mesuré un délai de 28,78 secondes avant le premier token, bien au-dessus de la médiane de 3,90 secondes de sa tranche tarifaire : un utilisateur qui fixe une fenêtre de chat le remarquera donc. Et le prix double le 1 janvier 2027, passant à 1,50 $ / 7,50 $.
Tarifs
| Poste | Jusqu’au 31 décembre 2026 | À partir du 1 janvier 2027 |
|---|---|---|
| Entrée par 1M | 0,75 $ | 1,50 $ |
| Sortie par 1M (raisonnement inclus) | 3,75 $ | 7,50 $ |
| Entrée en cache par 1M | 0,075 $ | 0,15 $ |
| Entrée / sortie par lots par 1M | 0,375 $ / 1,875 $ | 0,75 $ / 3,75 $ |
| Offre gratuite | Oui | Oui |
Mon article sur les tarifs de Gemini 3.8 Flash contient des exemples chiffrés.
Mon avis
Choisissez 3.8 Flash pour les tâches en arrière-plan : étiquetage, résumés, agents exécutés la nuit. Évitez-le pour le chat en direct tant que vous n’avez pas mesuré vous-même l’attente avant le premier token. L’avis sur Gemini 3.8 Flash aborde ce problème de latence.
5. DeepSeek V4.1 Flash
Idéal pour : la facture la plus basse de cette liste, avec des poids ouverts comme solution de repli. Catégorie moins chère et poids ouverts.
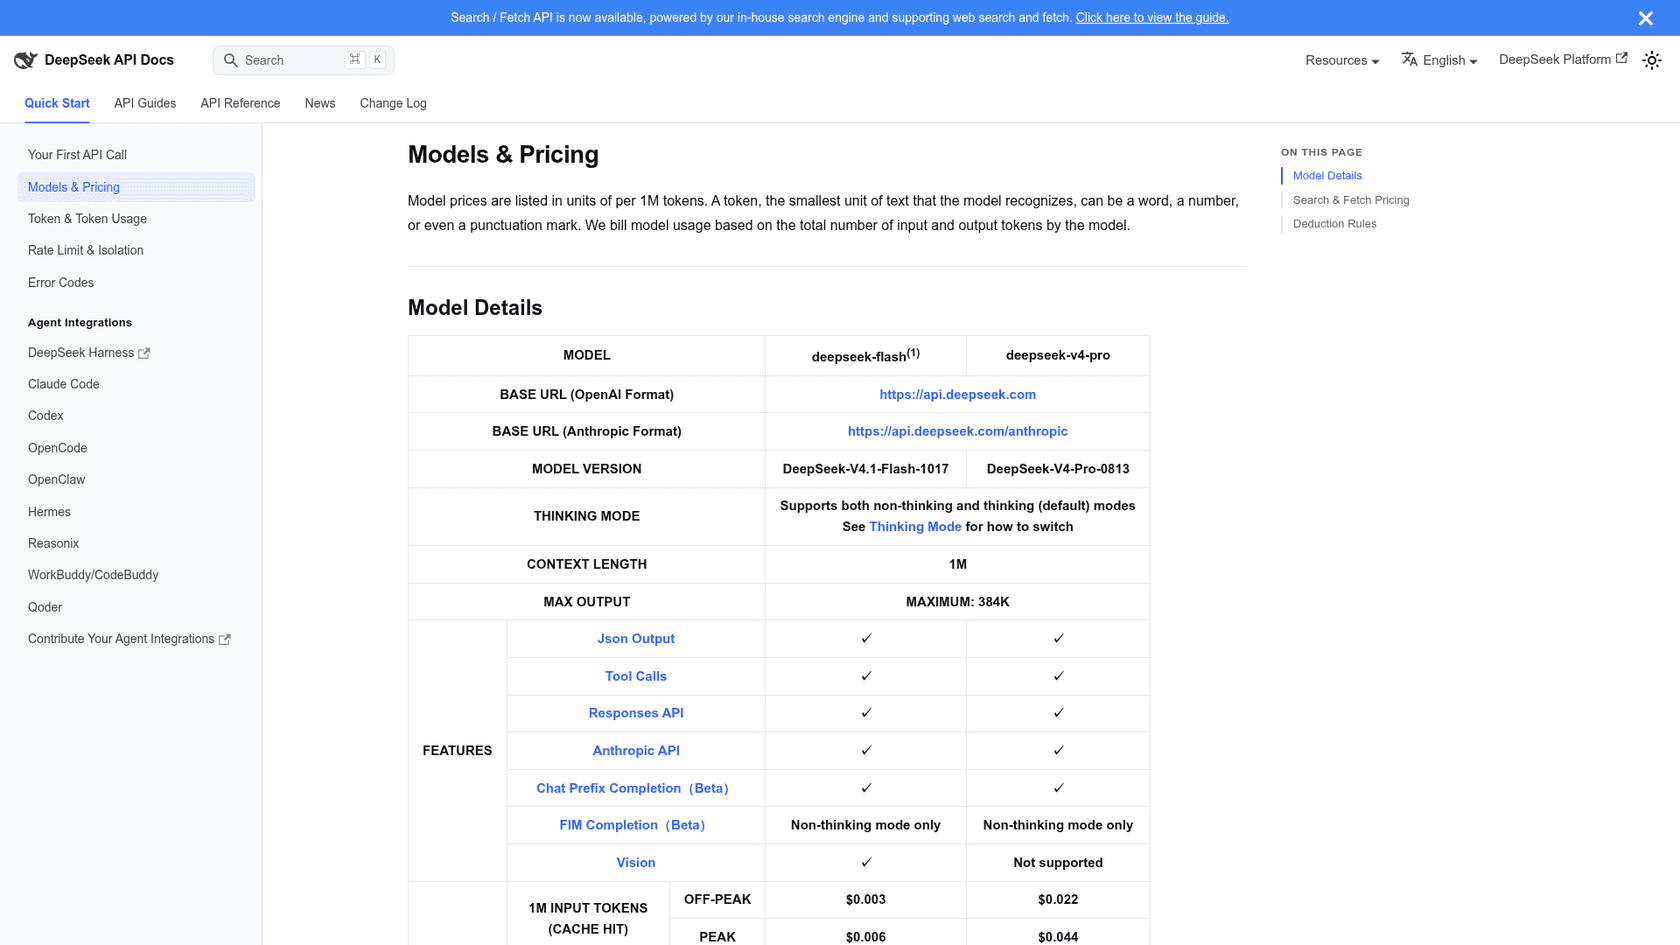
DeepSeek V4.1 Flash affiche le prix plancher de ce groupe. Sur la page Modèles et tarifs de DeepSeek, le modèle deepseek-flash (désormais la version 1017) coûte 0,15 $ en entrée et 0,60 $ en sortie par million de tokens en heures creuses.
Pourquoi le choisir plutôt que Kimi K3.1 Pro
- Environ 15x moins cher par requête. À peu près
$2.70pour 1 000 requêtes types en heures creuses, contre$40. - Environ 8x moins cher par tâche.
$0.26par tâche d’Artificial Analysis, contre$2.11, pour un score de 45.1. - Rapide. 169.3 tokens par seconde, le plus rapide de cette sélection.
- Des poids ouverts dès maintenant. Sous licence MIT sur Hugging Face, avec environ 763B de paramètres.
Sur le benchmark de correction de bugs réels d’un testeur, il a même terminé devant :
"So I tested Kimi K3.1 Pro on real work. 2 repos. 105 replanted bugs. Find and fix what you can. The results: DeepSeek V4.1 Flash 1017 (max): 42.7 Muse Wonder Full 1.0 (max): 42 Opus 5.5 (max): 41.7 Kimi K3.1 Pro (max): 36 Muse Spark 1.3 (max): 32.2 I'm sorry. Considering the cost, I see no reason to use this model."
Ses limites
Son score sur l’index est inférieur de 10 points à celui de Kimi : si les tâches coûtent peu, c’est donc en partie parce que les réponses sont plus simples. Les prix doublent pendant les heures de pointe (de 01:00 à 04:00 et de 06:00 à 10:00 UTC en semaine). Et pour les données clients, les conditions de l’API de DeepSeek ne publient ni accord de traitement des données ni option de conservation nulle : demandez donc un examen juridique avant d’y envoyer des tickets d’assistance.
Tarifs
| Poste | Heures creuses par 1M | Heures de pointe par 1M |
|---|---|---|
| Entrée, cache trouvé | 0,003 $ | 0,006 $ |
| Entrée, cache non trouvé | 0,15 $ | 0,30 $ |
| Sortie | 0,60 $ | 1,20 $ |
| API Search ou Fetch | 0,75 $ pour 1 000 requêtes | Identique |
Plus de détails dans mon guide des tarifs de DeepSeek V4.1 Flash et dans l’avis sur la mise à jour 1017.
Mon avis
Choisissez DeepSeek V4.1 Flash pour les gros volumes où un modèle à 45 points suffit, et dirigez les tâches difficiles ailleurs. Évitez-le pour les données clients réglementées, sauf si vous hébergez vous-même les poids.
6. MiMo-V2.6-Pro
Idéal pour : des poids ouverts provenant d’un second fournisseur, à un prix d’API très bas. Catégorie poids ouverts.
MiMo-V2.6-Pro est le modèle à mille milliards de paramètres de Xiaomi, publié avec des poids sous licence MIT en septembre. L’annonce de lancement de Xiaomi le décrit comme le modèle open source le plus puissant disponible à sa sortie, avec un score de 46 sur l’index d’Artificial Analysis.
Pourquoi le choisir plutôt que Kimi K3.1 Pro
- Environ un sixième du prix par requête. 0,435 $ en entrée et 0,87 $ en sortie par million de tokens selon les tarifs internationaux de Xiaomi, soit environ
$6.09pour 1 000 requêtes types. - Une facture minuscule pour l’index complet. Artificial Analysis a dépensé environ
$207pour exécuter tout son index sur MiMo-V2.6-Pro, contre$3,117sur Kimi K3.1 Pro. - Des poids que vous pouvez télécharger dès aujourd’hui, sous licence MIT, sur Hugging Face.
- Une API de traitement par lots à moitié prix, ce que Kimi ne propose pas pour K3.1 Pro.
Ses limites
Il obtient 46.3, soit neuf points de moins que Kimi. Il est tout aussi lent (54.7 tokens par seconde), avec un délai de 3,29 secondes avant le premier token. Xiaomi vend un mode UltraSpeed avec une sortie jusqu’à 20x plus rapide, mais à 10x le prix (4,35 $ / 8,70 $). Et avec environ 1.02T de paramètres, l’auto-hébergement nécessite toujours un cluster multi-GPU.
Tarifs
| Poste | Temps réel par 1M | Traitement par lots par 1M |
|---|---|---|
| Entrée, cache trouvé | 0,0036 $ | 0,0018 $ |
| Entrée, cache non trouvé | 0,435 $ | 0,2175 $ |
| Sortie | 0,87 $ | 0,435 $ |
| Entrée / sortie UltraSpeed | 4,35 $ / 8,70 $ | Non proposé |
Plus de détails dans mon analyse des tarifs de MiMo V2.6.
Mon avis
Choisissez MiMo-V2.6-Pro si vous voulez des poids ouverts et une API hébergée bon marché chez le même fournisseur, et si vos tâches n’exigent pas un raisonnement du niveau de Kimi. Évitez-le pour tout usage sensible à la latence, sauf si vous payez pour UltraSpeed. L’avis sur MiMo V2.6 présente les benchmarks.
7. Kimi K3
Idéal pour : rester chez Moonshot tout en utilisant des poids déjà publics. Poids ouverts, même famille.
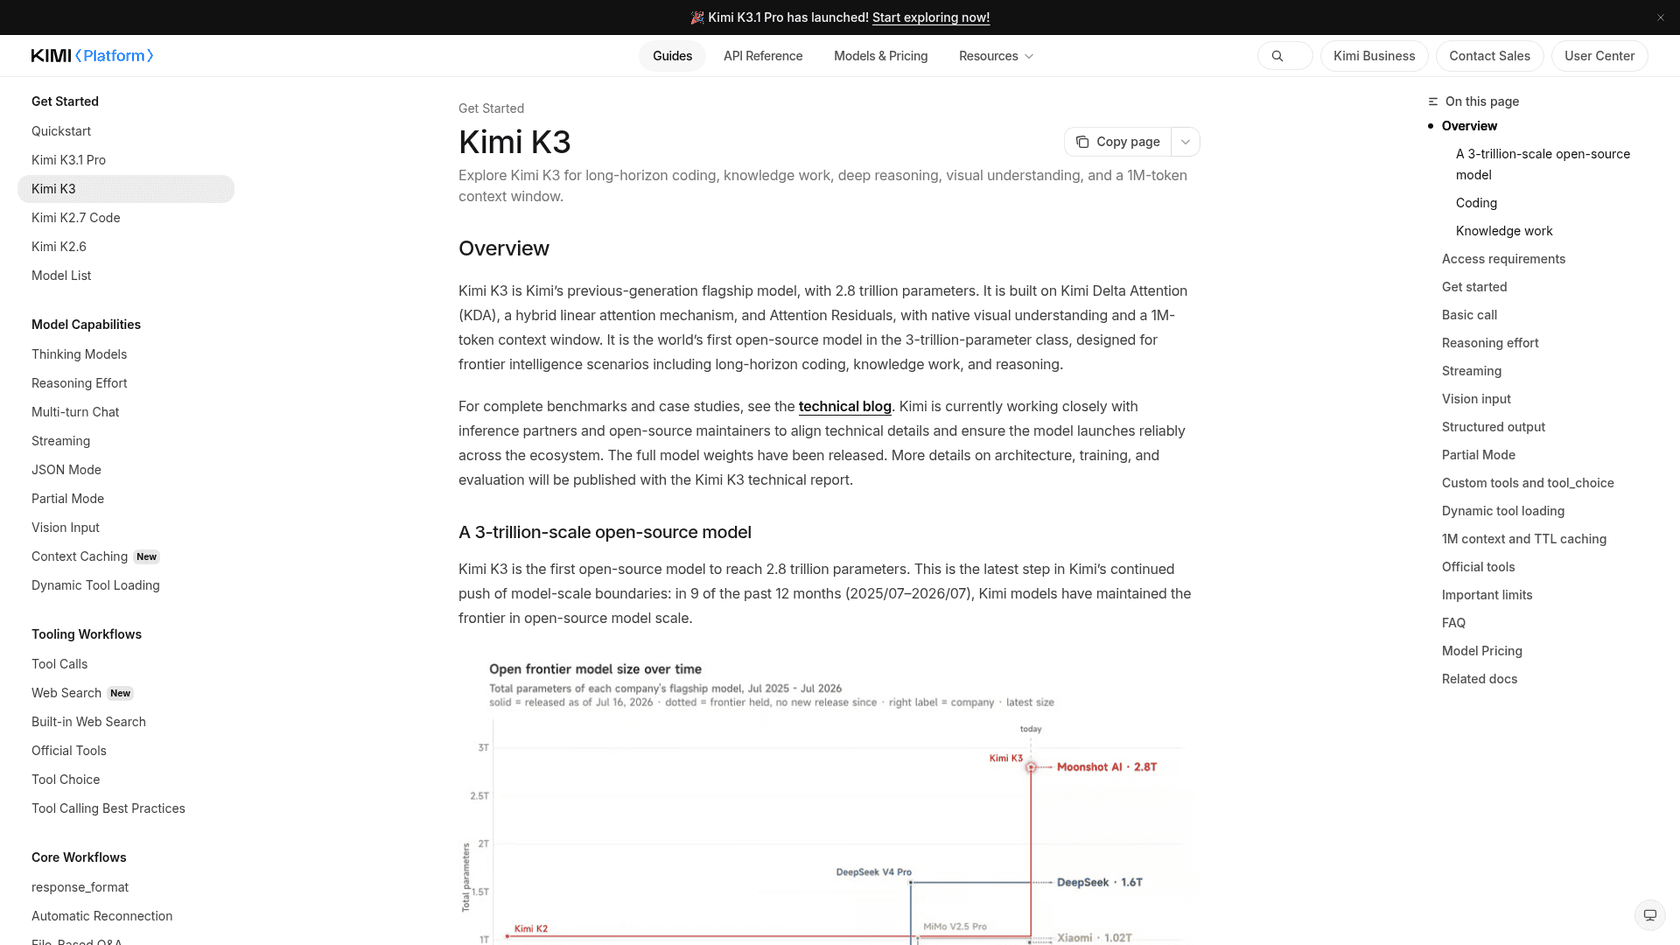
Kimi K3 est le modèle de base de K3.1 Pro. Le guide de démarrage rapide de Moonshot le qualifie désormais de "previous-generation flagship", et ses poids sont déjà sur Hugging Face.
Pourquoi le choisir plutôt que Kimi K3.1 Pro
- Des poids aujourd’hui, pas d’ici le 4 novembre. Environ 2.78T de paramètres dans le dépôt public.
- La même API, les mêmes outils. Si vous avez construit votre solution sur l’API Kimi, toute la migration se résume à changer l’identifiant du modèle.
- Le même coût par tâche.
$2.00par tâche d’Artificial Analysis, contre$2.11pour K3.1 Pro.
Ses limites
Honnêtement, il y a peu de raisons de le choisir pour de nouveaux usages hébergés. Il coûte plus cher par token (3 $ / 15 $), obtient 43.6 contre 55.1, et n’a atteint que 12,6 % sur Terminal-Bench 4.0 contre 67,2 % pour K3.1 Pro. Sa licence ajoute aussi des conditions pour les produits de très grande taille et les entreprises d’hébergement de modèles. Si vous avez seulement besoin des poids de K3.1 Pro, attendre une semaine ou deux est probablement le meilleur choix.
Tarifs
| Poste | Prix par 1M de tokens |
|---|---|
| Entrée, cache non trouvé | 3 $ |
| Entrée, cache trouvé | 0,30 $ |
| Sortie | 15 $ |
| Écriture en cache de 5 minutes | 3 $ |
| Écriture en cache de 1 heure | 6 $ |
D’après la page tarifaire de Kimi. Mon article sur les tarifs de Kimi K3 retrace l’historique.
Mon avis
Choisissez K3 uniquement si vous avez besoin de poids Kimi ouverts cette semaine. Sinon, restez sur K3.1 Pro ou choisissez parmi les six options ci-dessus. L’avis sur Kimi K3 et mon comparatif DeepSeek vs Kimi K3 l’examinent plus en profondeur.
Combien coûtent 1 000 requêtes sur chacun ?
Voici la même requête type, 10 000 tokens en entrée et 2 000 en sortie sans mise en cache, facturée au tarif catalogue de chaque fournisseur. C’est le chiffre qui sert de point de départ à la plupart des estimations de coût.
| Modèle | Entrée / sortie par 1M | Coût par requête | Coût pour 1 000 requêtes |
|---|---|---|---|
| DeepSeek V4.1 Flash (heures creuses) | 0,15 $ / 0,60 $ | 0,0027 $ | 2,70 $ |
| DeepSeek V4.1 Flash (heures de pointe) | 0,30 $ / 1,20 $ | 0,0054 $ | 5,40 $ |
| MiMo-V2.6-Pro | 0,435 $ / 0,87 $ | 0,0061 $ | 6,09 $ |
| Gemini 3.8 Flash (jusqu’au 31 décembre) | 0,75 $ / 3,75 $ | 0,015 $ | 15 $ |
| Gemini 3.8 Flash (à partir du 1 janvier 2027) | 1,50 $ / 7,50 $ | 0,030 $ | 30 $ |
| Kimi K3.1 Pro | 2 $ / 10 $ | 0,040 $ | 40 $ |
| Claude Sonnet 5.5 | 2 $ / 10 $ | 0,040 $ | 40 $ |
| Gemini 4 Argon (jusqu’au 30 novembre) | 2 $ / 10 $ | 0,040 $ | 40 $ |
| Kimi K3 | 3 $ / 15 $ | 0,060 $ | 60 $ |
| Claude Opus 5.5 | 4 $ / 20 $ | 0,080 $ | 80 $ |
| Gemini 4 Argon (à partir du 1 décembre) | 4 $ / 20 $ | 0,080 $ | 80 $ |
| Kimi K3.1 Pro Highspeed | 4 $ / 20 $ | 0,080 $ | 80 $ |
Maintenant, la mise en garde. Les modèles de raisonnement s’arrêtent rarement à 2 000 tokens de sortie. Sur l’index d’Artificial Analysis, Kimi K3.1 Pro a écrit 55 195 tokens de sortie par tâche, dont la majeure partie pour le raisonnement. C’est pourquoi la colonne du coût par tâche dans le tableau récapitulatif compte plus que celle-ci, et pourquoi vous devriez refaire ce calcul sur votre propre trafic avant de changer.
Voici comment je procéderais : prenez 100 requêtes réelles de votre produit, faites-les passer par deux ou trois de ces modèles et évaluez les réponses. Divisez ensuite les dépenses de chaque modèle par le nombre de réponses que vous utiliseriez réellement. Vous obtenez votre coût par tâche réussie, et c’est le seul chiffre qui tranche le choix. Mon guide des tarifs de Kimi K3.1 Pro reprend le même calcul pour Kimi seul.
Une équipe d’assistance doit-elle vraiment choisir un modèle ?
Si votre produit est un bot d’assistance, toute cette liste se situe un niveau trop bas. Un modèle, c’est de l’infrastructure. Ce qui répond à vos clients, c’est tout ce qui est construit autour : quels anciens tickets il lit, quelles règles il suit, quand il passe la main à une personne et comment vous le vérifiez avant sa mise en service.
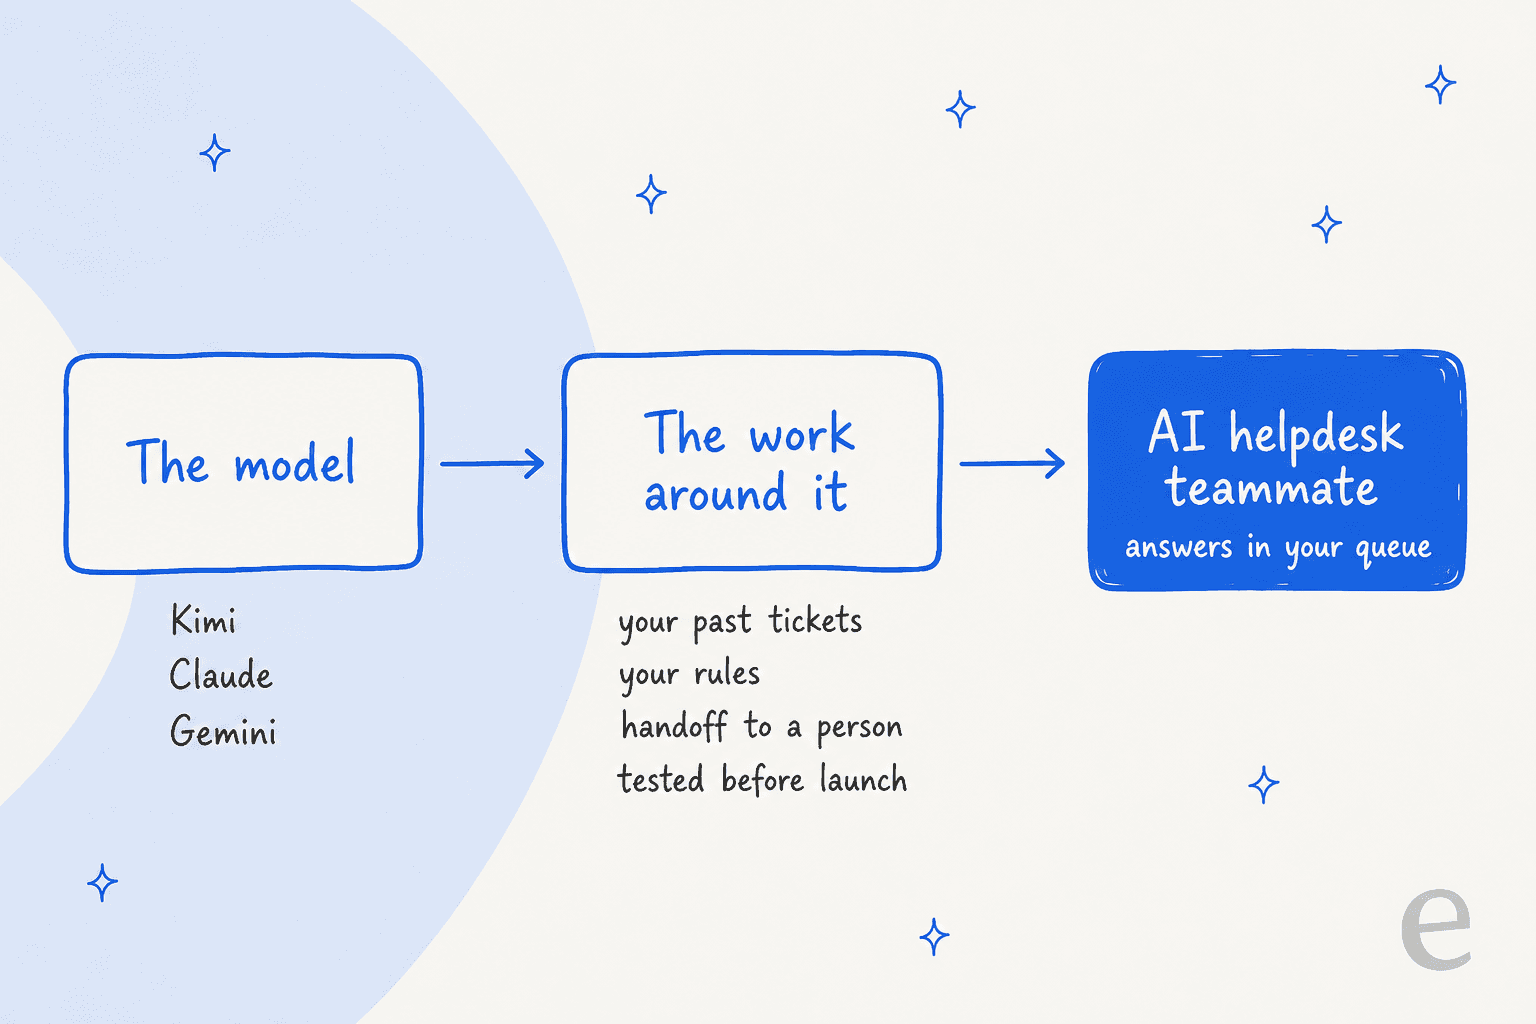
C’est sur cette partie que je passe mes journées chez eesel. J’ai vu un modèle sûr de lui donner des réponses fluides mais fausses dans une vraie file de tickets : c’est pourquoi chaque déploiement d’eesel commence désormais par rejouer des centaines d’anciens tickets et évaluer les brouillons par rapport à ce que l’équipe a réellement envoyé. Le choix du modèle compte toujours. Ce n’est simplement pas la décision qui fait réussir ou échouer un bot d’assistance.
Qontro, une entreprise néo-zélandaise de logiciels ERP, en est un bon exemple. Elle a connecté Freshdesk à eesel en juillet 2026 et chargé environ 9 800 anciens tickets et articles d’aide. Entre le 8 août et le 8 septembre, eesel a rédigé des réponses pour environ 190 tickets, en effectuant au passage environ 400 recherches dans la base de connaissances. Les pannes, les pertes de données et la facturation sont directement confiées à une personne. L’équipe compare chaque brouillon à ce qu’elle a envoyé et utilise les écarts pour améliorer le centre d’aide. Personne chez Qontro n’a eu à organiser un test comparatif de modèles pour en arriver là.
Pour les développeurs qui préfèrent rester dans un terminal, la CLI eesel pilote le même coéquipier. npx @eesel/cli init chat-bubble --site https://your-site.com configure un agent doté d’une bulle de chat sur votre site web qui lit vos pages, et eesel chat vous permet de le tester depuis la ligne de commande. Chaque commande renvoie du JSON, de sorte qu’un agent de programmation comme Claude Code ou Cursor peut effectuer la configuration pour vous. Mon article sur les CLI d’agents IA explique pourquoi c’est important.
Essayez eesel pour votre file de tickets d’assistance
Si vous envisagiez Kimi K3.1 Pro ou l’un de ces modèles pour répondre aux tickets clients, essayez d’abord l’autre voie. eesel est un coéquipier IA pour votre service d’assistance qui rejoint votre outil existant, apprend à partir de vos anciens tickets et de votre centre d’aide, et est testé sur votre historique avant de répondre à qui que ce soit. Il fonctionne avec Freshdesk, Zendesk et d’autres outils, et l’offre gratuite comprend 100 crédits, un ticket ou une conversation comptant pour un crédit (voir les tarifs).
Essayez eesel gratuitement, ou découvrez comment les équipes l’utilisent pour l’assistance SaaS. Pour une vue plus large de cette catégorie, ma sélection des meilleurs logiciels d’assistance IA compare les principales options.
Questions fréquentes
Quelle est la meilleure alternative à Kimi K3.1 Pro ?
Pour la plupart des équipes, c’est Claude Sonnet 5.5 : les mêmes tarifs de 2 $ en entrée et 10 $ en sortie par million de tokens, une vitesse de génération environ trois fois supérieure sur Artificial Analysis et un score d’indice légèrement plus élevé au niveau d’effort maximal. Si le coût par tâche terminée compte plus que le tarif affiché, testez Claude Opus 5.5 au niveau d’effort High, pour lequel Artificial Analysis a mesuré un coût de 1,82 $ par tâche contre 2,11 $ pour Kimi K3.1 Pro. Mon avis complet sur Sonnet 5.5 donne tous les détails.
Existe-t-il une alternative moins chère à Kimi K3.1 Pro ?
Oui. DeepSeek V4.1 Flash coûte 0,15 $ en entrée et 0,60 $ en sortie par million de tokens en heures creuses, ce qui revient à environ 2,70 $ pour 1 000 requêtes de 10 000 tokens en entrée et 2 000 en sortie, contre 40 $ pour Kimi K3.1 Pro. Gemini 3.8 Flash coûte environ 15 $ pour les mêmes 1 000 requêtes jusqu’au 31 décembre 2026. Consultez le guide des tarifs de DeepSeek V4.1 Flash et le détail des tarifs de Kimi K3.1 Pro.
Quelles sont les alternatives à Kimi K3.1 Pro à poids ouverts ?
DeepSeek V4.1 Flash et MiMo-V2.6-Pro proposent tous deux leurs poids sous licence MIT sur Hugging Face, et le modèle plus ancien Kimi K3 dispose de poids ouverts sous sa propre licence. Moonshot annonce que les poids de Kimi K3.1 Pro seront publiés d’ici le 4 novembre 2026, mais ils n’étaient pas sur Hugging Face lors de ma vérification. Ma présentation de MiMo V2.6 couvre l’option de Xiaomi.
Claude Sonnet 5.5 est-il meilleur que Kimi K3.1 Pro ?
Au niveau d’effort maximal, Sonnet 5.5 obtient un score de 56.0 sur l’Artificial Analysis Intelligence Index contre 55.1 pour Kimi K3.1 Pro, au même tarif catalogue, et génère environ 141 tokens par seconde contre 50. Kimi coûte moins cher par tâche terminée au niveau d’effort maximal (2,11 $ contre 5,46 $), car Sonnet produit davantage de tokens. Mes articles sur mon avis sur Kimi K3.1 Pro et les tarifs de Sonnet 5.5 approfondissent le sujet.
Quelle alternative à Kimi K3.1 Pro est la meilleure pour l’assistance client ?
Pour un bot d’assistance, la vitesse et les réponses incorrectes comptent plus que les meilleurs scores aux tests de performance. Gemini 4 Argon affichait le taux d’hallucination le plus faible de ce groupe sur Artificial Analysis (15,1 %), et Claude Sonnet 5.5 est rapide. Si vous ne souhaitez pas créer de bot du tout, un agent d’assistance IA comme eesel s’appuie déjà sur des modèles de pointe et apprend de vos anciens tickets.
Dois-je attendre les poids ouverts de Kimi K3.1 Pro ?
Uniquement si vous prévoyez de l’héberger vous-même. Le modèle compte 2.8 billions de paramètres au total, donc l’exécuter vous-même nécessite un grand cluster de GPU. Si vous l’appelez via une API, les poids ne changent pas grand-chose pour vous ; le tarif de la version hébergée est déjà de 2 $ en entrée et 10 $ en sortie par million de tokens. La présentation de Kimi K3.1 Pro suit cette publication.
Comment comparer le coût des alternatives à Kimi K3.1 Pro ?
Comparez le coût par tâche réussie, pas le prix par token. Prenez la dépense totale pour un lot de test composé de vos propres tâches et divisez-la par le nombre de tâches que chaque modèle a terminées correctement. Un modèle au tarif affiché plus bas peut tout de même être moins rentable s’il produit davantage de tokens ou échoue plus souvent. C’est pourquoi j’indique le coût par tâche mesuré par Artificial Analysis à côté des tarifs par token. Le guide du coût du service client par IA illustre la même idée pour l’assistance.