

Les alternatives à Microsoft-Decision-1 en un coup d'œil
| Modèle | Éditeur | Entrée par 1M de tokens | Sortie | Contexte par appel | Images | Comment l'exécuter | Poids et licence | Decision Index v0.3.1 (Full) | Notes sur les données et la conformité | Quota gratuit |
|---|---|---|---|---|---|---|---|---|---|---|
| Microsoft-Decision-1 (référence) | Microsoft | $0.042 | Gratuite | 32,768 | Non | Azure Foundry, OpenRouter | Fermé | Non listé | SLA Azure ; régions non publiées | Azure général $200, 30 jours |
| Jev 1.13 | TypeSafe | $0.042 | Gratuite | 64k par requête, 32k d'état + la plus longue question | Non | TypeSafe API, Cloudflare Workers AI | Fermé | 60.11 (référence, 2e ex aequo) | Zéro rétention de données sur la fiche Cloudflare | Aucun documenté |
| OpenAI Decisions API | OpenAI | $0.10 | Gratuite | 1,050,000 (2x le prix d'entrée au-delà de 272K) | Oui | OpenAI API, bêta publique | Fermé | Non listé | ZDR et HIPAA pour les clients éligibles, résidence des données aux États-Unis et dans l'UE | Aucun |
| Clef-flash | Cloudflare | $0.038 | Gratuite | 24,576 | Oui | Workers AI, ou auto-hébergé | Ouvert, Apache 2.0 | 47.61 (#33) | Conditions du compte Cloudflare | 10,000 neurons Workers AI par jour |
| Clef | Cloudflare | $0.24 | Gratuite | 65,536 | Oui | Workers AI, ou auto-hébergé | Ouvert, Apache 2.0 | 53.08 (#19) | Conditions du compte Cloudflare | 10,000 neurons Workers AI par jour |
| Perplexity Decider v1.1 | Perplexity | Le coût de votre GPU | n/d | 8,192 par décision | Oui | Auto-hébergé, environ 49 GiB de poids | Apache 2.0, téléchargement authentifié | 62.75 (#1) | Reste sur votre infrastructure | Téléchargement gratuit |
| Rune 26B-A4B v3 | Surogate (Invergent) | Le coût de votre GPU | n/d | 262k | Oui | Auto-hébergé avec le moteur surogate | Apache 2.0, formulaire de contact | 57.43 (#10) | Reste sur votre infrastructure | Téléchargement gratuit |
| Strands Decider 2B | AWS Strands Labs | Le coût de votre GPU | n/d | Testé à 4,096 | Optionnel, non entraîné | Auto-hébergé, tient sur une 3090 | Apache 2.0 | 21.75 (#84) | Reste sur votre infrastructure | Téléchargement gratuit |
| eesel (pas un modèle) | eesel | $299 par mois pour 500 tickets ou chats | n/d | Ticket entier et historique | Oui | Se branche sur votre helpdesk | Produit hébergé | n/d | HIPAA sur Enterprise | 100 crédits gratuits |
Les prix et le contexte proviennent de la documentation de chaque éditeur, vérifiée le 11 octobre 2026. Les scores du Decision Index proviennent du classement Jev Decision Index, version 0.3.1, mis à jour le 10 octobre.
Pourquoi regarder au-delà de Microsoft-Decision-1 ?
J'ai décrit ce que fait le modèle dans mon aperçu de Microsoft-Decision-1 et ce qu'il coûte dans le détail des tarifs. C'est une belle sortie. Le tableau de Microsoft lui-même donne 83.5 % de précision moyenne sur 36 benchmarks avec une médiane de 85 ms sur Foundry. Mais quelques lacunes reviennent sans cesse :
- Pas de poids ouverts. C'est un Qwen3.5-9B post-entraîné, mais la page Hugging Face que Microsoft utiliserait renvoie une 404. On le loue ou on ne l'utilise pas. Si vous appréciiez la famille Qwen pour l'auto-hébergement, celui-ci est fermé.
- Texte seul, 32K de contexte. Les captures d'écran, les formulaires scannés et les fils très longs demandent un autre modèle.
- Documentation Azure maigre. Il est en GA dans le catalogue, mais n'a pas encore de ligne sur la page de tarifs Foundry d'Azure, ni de régions, quotas ou tarif batch publiés. Les équipes qui achètent via les modèles Azure veulent généralement cela avant de s'engager.
- Pas encore de score indépendant. Il ne figure pas au Jev Decision Index, donc tous les chiffres de précision à ce jour viennent de Microsoft elle-même.
Ce dernier point a motivé l'essentiel des réactions le jour du lancement. La réponse la plus en vue sous le post de lancement de Satya Nadella était sans détour :
"How is Jev not ranked? That's literally the #1 model people are going to compare this to."
Microsoft a ensuite mis à jour le post pour ajouter Jev au tableau de précision et de calibration. La question sous-jacente reste pourtant la bonne. Les modèles de décision forment désormais un domaine encombré, et le modèle de décision que vous choisissez doit dépendre de l'endroit où il tourne et de ce qu'il lit, pas des graphiques du jour du lancement.
Comment j'ai choisi ces alternatives
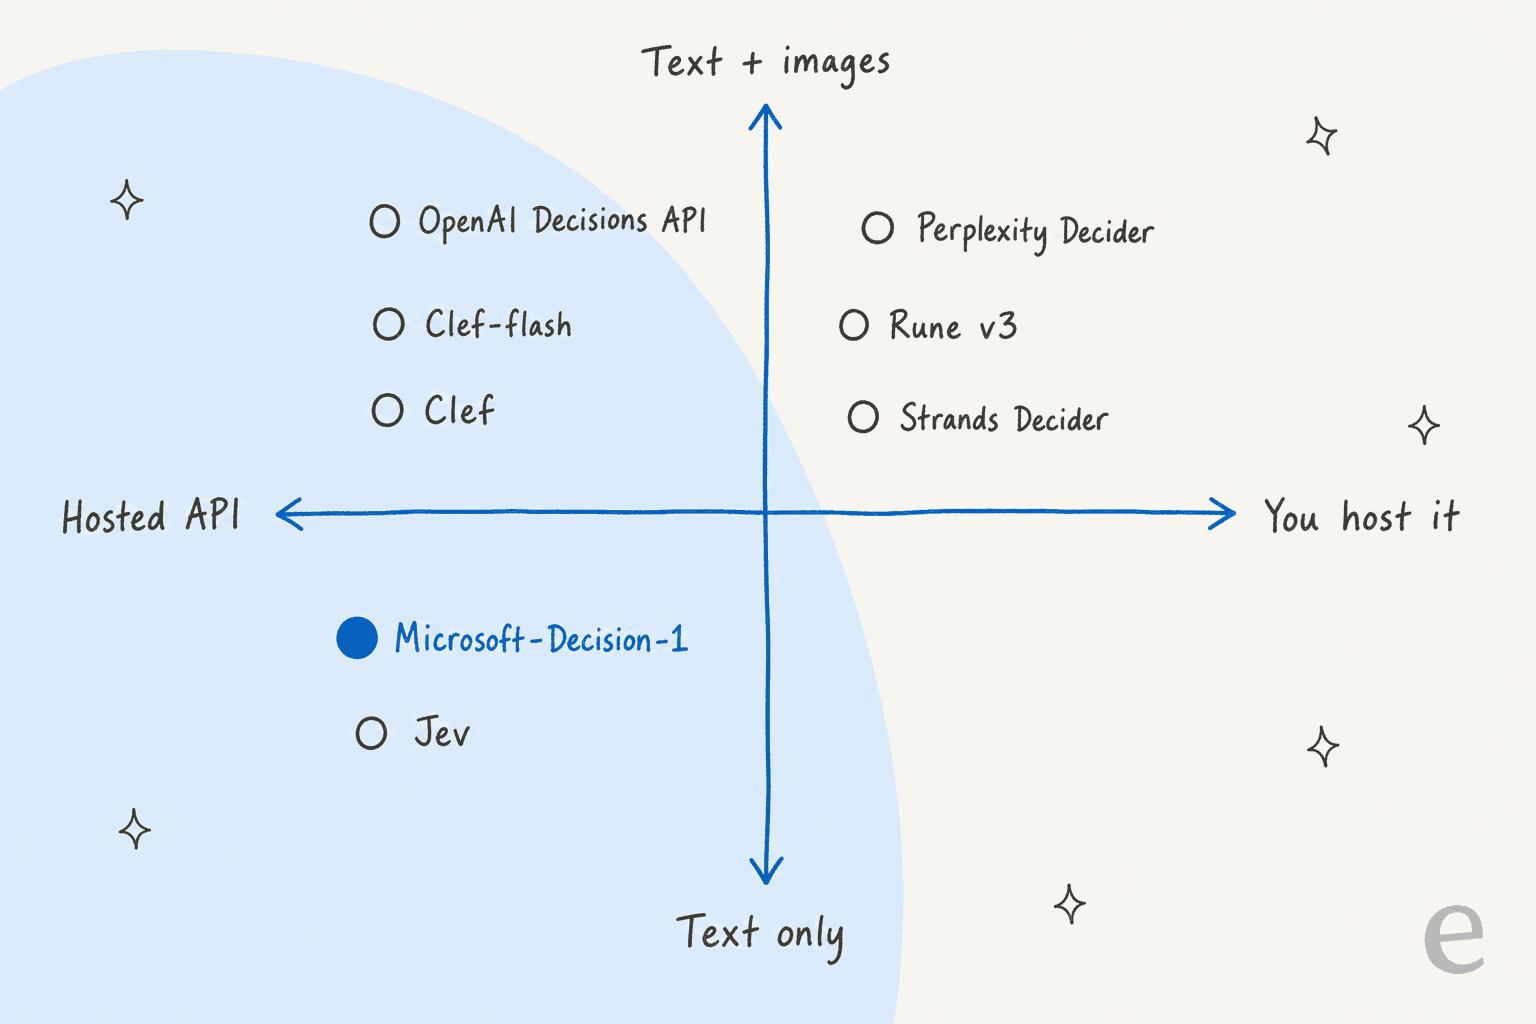
Je viens du côté de la recherche. Mon travail chez eesel consiste surtout à comprendre ce que les acheteurs demandent vraiment quand ils tapent une requête, et "Microsoft-Decision-1 alternatives" deux jours après le lancement se découpe nettement en prix, hébergement et type d'entrée. J'ai donc retenu les modèles qui font le même travail : vous envoyez un état plus des options de réponse fixes, et vous recevez des probabilités calibrées en un seul passage.
Chaque modèle ci-dessous figure soit dans le tableau comparatif de Microsoft, soit au Decision Index, soit dans les deux. J'ai laissé de côté les modèles de chat généralistes avec mode JSON, car le function calling sur un gros modèle suit une tout autre courbe de coût. Chaque fiche utilise les mêmes cinq intertitres pour que vous puissiez comparer d'un coup d'œil.
Combien de texte chacun peut-il lire par appel ?
Le contexte est la caractéristique qui bloque en premier dans le support. Un seul ticket avec l'historique de commande, un extrait de politique et trois échanges peut dépasser 10,000 tokens.
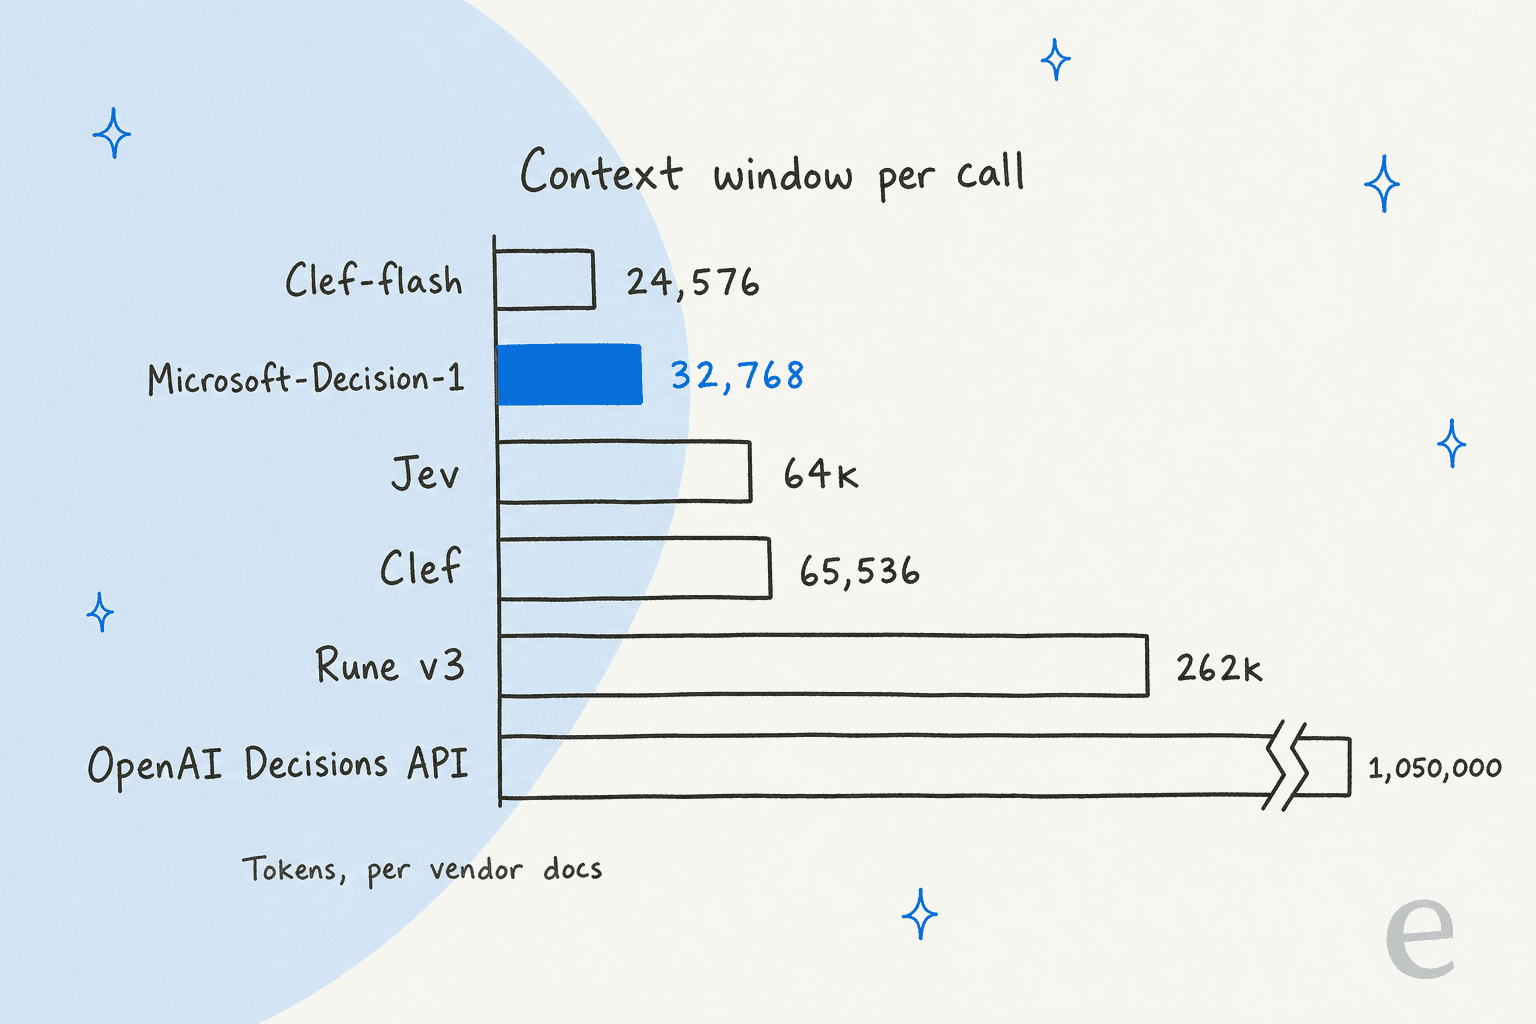
Perplexity Decider est absent de ce graphique volontairement. Sa fiche indique que le texte et toutes les images d'une décision doivent tenir dans 8,192 tokens, et les entrées plus longues sont rejetées plutôt que tronquées. Meilleur score, plus petite fenêtre.
1. Jev 1.13 (TypeSafe)
Ce que c'est
Jev est le modèle qui a lancé la catégorie. TypeSafe le sert via un seul endpoint, POST /v1/systemone, et il note chaque question envoyée par rapport à un état partagé, en parallèle. Je l'ai couvert en détail dans mon aperçu de Jev.
Là où il bat Microsoft-Decision-1
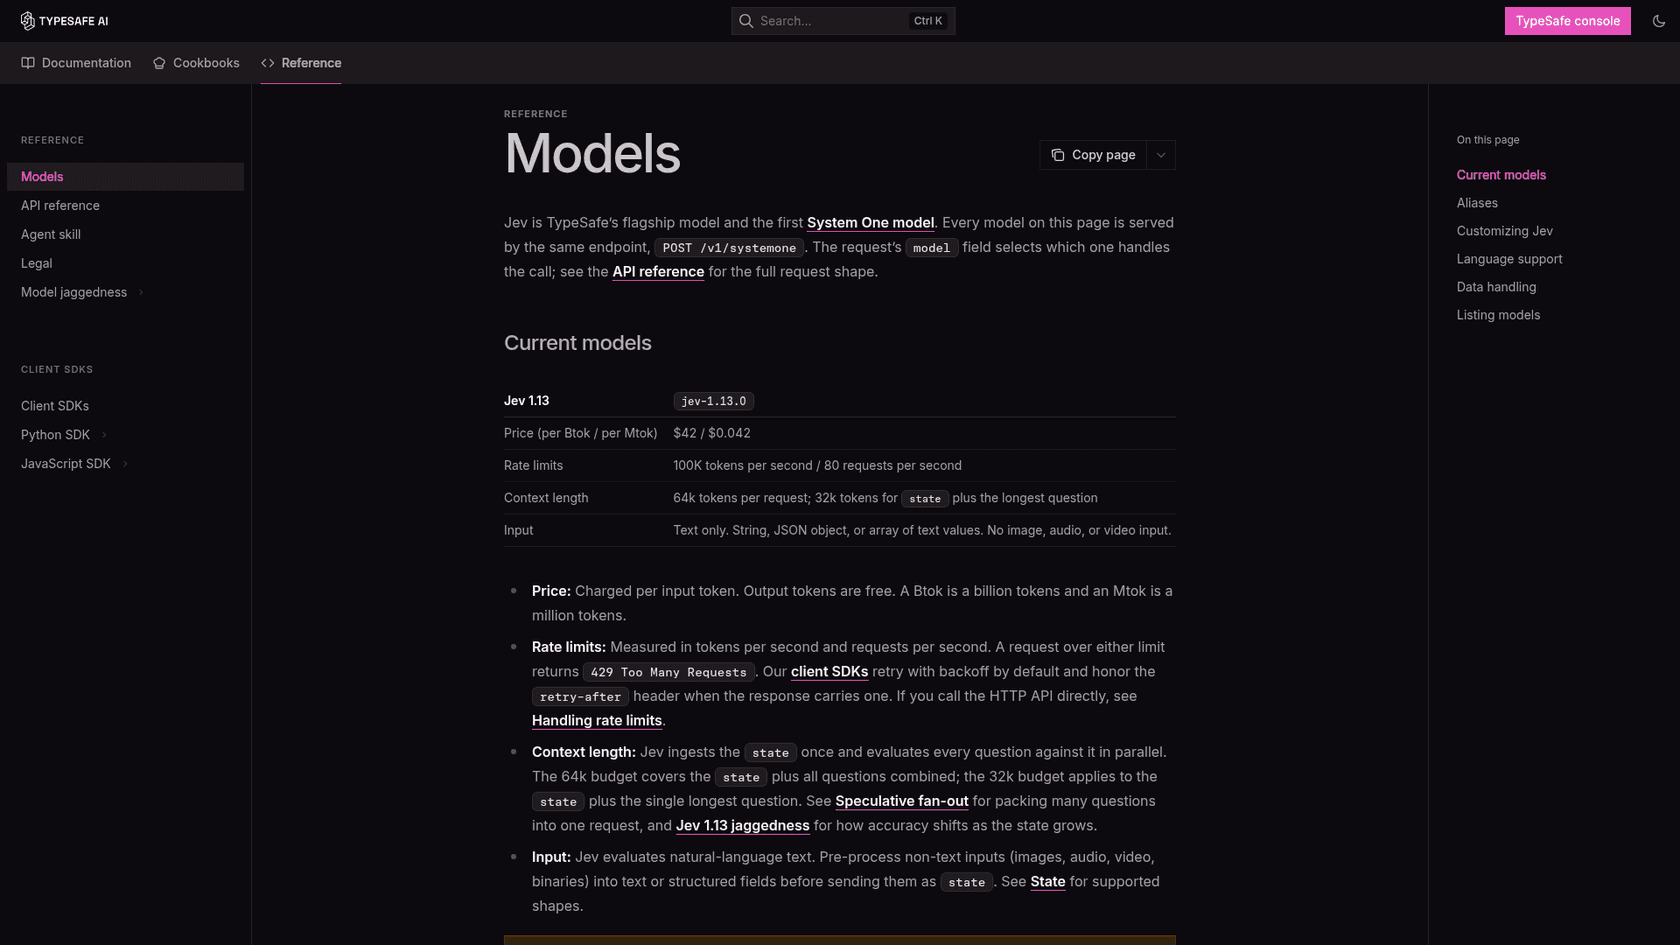
- Des requêtes plus grandes. Jev accepte 64k tokens par requête, dont 32k pour l'état plus la plus longue question, d'après la page des modèles de TypeSafe. Microsoft plafonne à 32,768.
- Une meilleure calibration. Même dans le tableau de Microsoft, Jev obtient 93.7 en calibration contre 92.2 pour Microsoft.
- Plus d'endroits où l'acheter. Outre l'API de TypeSafe, Jev est sur Cloudflare Workers AI au même prix, avec entrée en cache gratuite et zéro rétention de données.
Là où il déçoit
- Texte seul, comme Microsoft. Les images doivent d'abord être converties en texte.
- TypeSafe prévient que "Rate limits are adjusting dynamically" et peuvent changer sans préavis. La limite actuelle est de 100K tokens et 80 requêtes par seconde.
- Le tableau de Microsoft le place légèrement derrière en précision, 82.3 % contre 83.5 %.
Un testeur de Hacker News a passé les deux dans sa propre suite le lendemain du lancement :
"In my minimal suite it was cheaper (by 0.72x) but higher latency (283ms vs 369ms p50) than Jev. Results were very comparable across all scenarios I measure, first of these that I have tested that actually justifies its existence as a commercial release."

Même prix catalogue, factures différentes : les tokenizers comptent différemment, testez donc sur vos propres tickets.
Tarifs
$0.042 par million de tokens en entrée, sortie gratuite, aucun palier gratuit documenté. Mon article sur les tarifs de Jev calcule le coût par décision, et Jev Ultrafast couvre le palier rapide.
Idéal pour
Les équipes qui veulent une alternative à Microsoft-Decision-1 au même prix et avec la même forme d'API, des entrées plus longues et sans dépendance à Azure.
2. OpenAI Decisions API (gpt-6-luna)
Ce que c'est
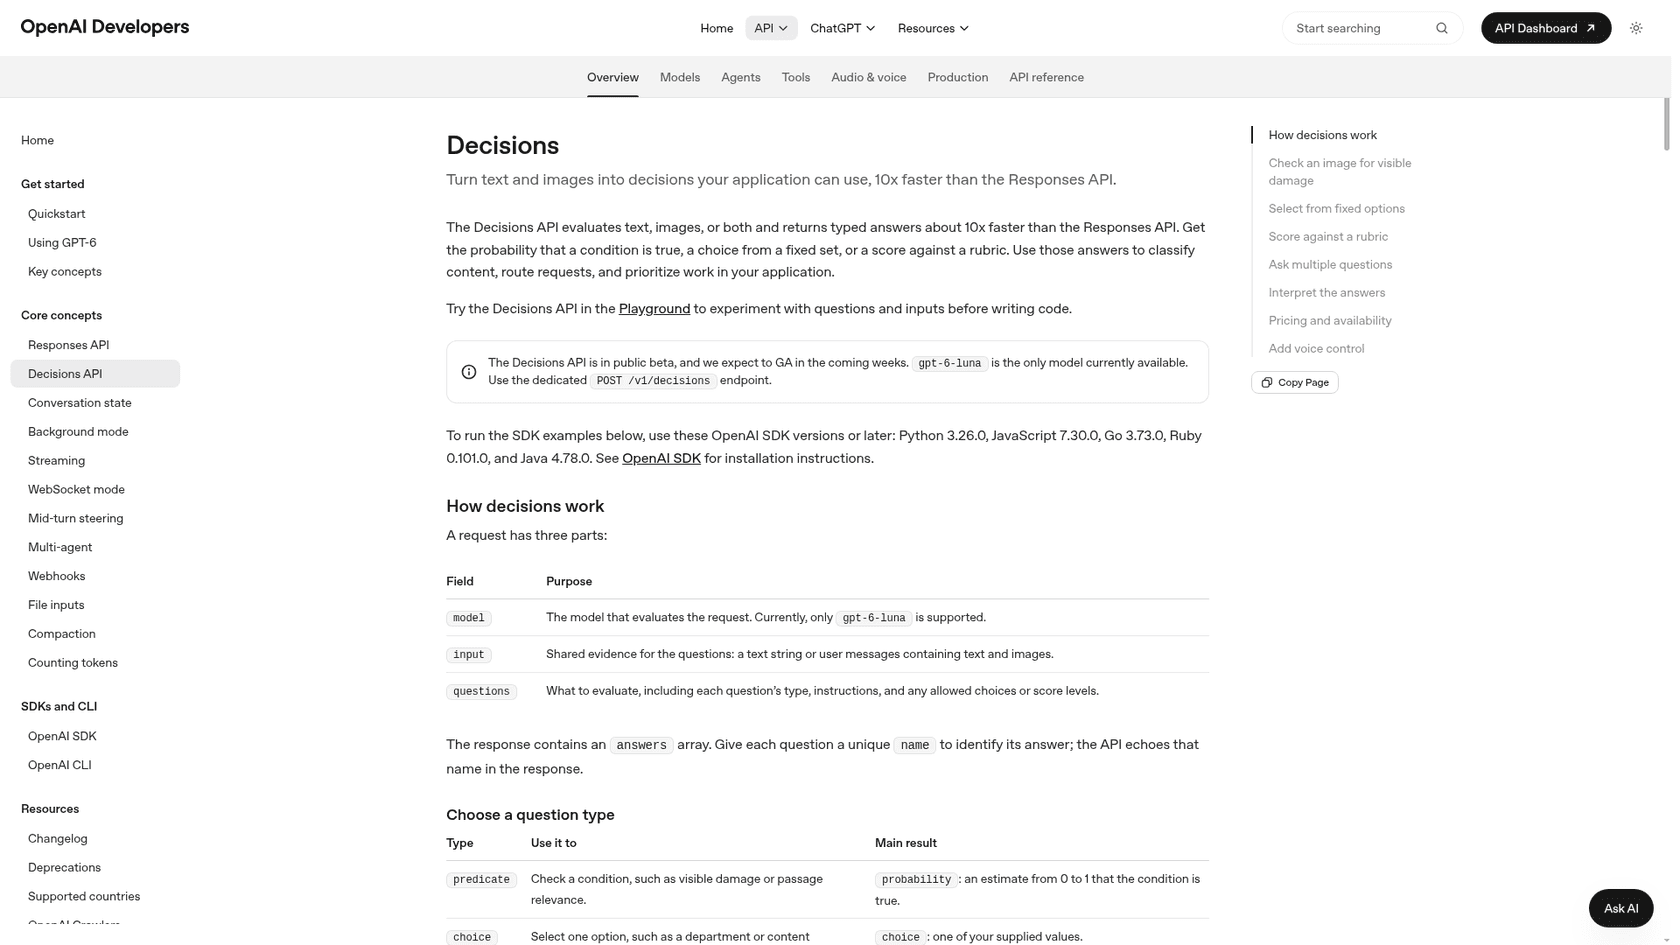
La version d'OpenAI de la même idée, sortie en bêta publique le 6 octobre. Vous appelez POST /v1/decisions avec gpt-6-luna, une entrée de texte et d'images et une liste de questions de type predicate, choice ou score. Mon guide de la Decisions API contient le pas-à-pas.
Là où il bat Microsoft-Decision-1
- Les images. Il lit texte et images en un seul appel. Les images doivent être des data URLs base64 en ligne.
- Un contexte énorme. Il hérite de la fenêtre de 1,050,000 tokens de GPT-6 Luna, donc tout l'historique d'un ticket tient.
- Options de conformité. Le guide d'OpenAI cite Zero Data Retention et HIPAA pour les clients éligibles, ainsi que la résidence des données aux États-Unis et dans l'UE.
Là où il déçoit
- Il coûte environ 2,4x plus par token que Microsoft.
- Toujours en bêta. OpenAI dit attendre la GA "in the coming weeks".
- Les prompts de plus de 272K tokens sont facturés à 2x l'entrée, et des majorations de traitement régional s'appliquent.
- OpenAI ne publie aucune latence en millisecondes, seulement "about 10x faster than the Responses API". Le tableau de Microsoft l'a mesuré à 300 ms de médiane et 79.4 % de précision.
Tarifs
$0.10 par million de tokens en entrée, sans frais de sortie, de lecture de cache ni d'écriture de cache. Ce tarif figure dans le guide Decisions, pas encore sur la page principale des tarifs de l'API OpenAI. Plus de détails dans mon article sur les tarifs de Luna.
Idéal pour
Les équipes déjà sur OpenAI qui doivent faire noter des captures d'écran ou de longs fils, ou qui ont besoin des documents HIPAA en règle.
3. Cloudflare Clef-flash
Ce que c'est
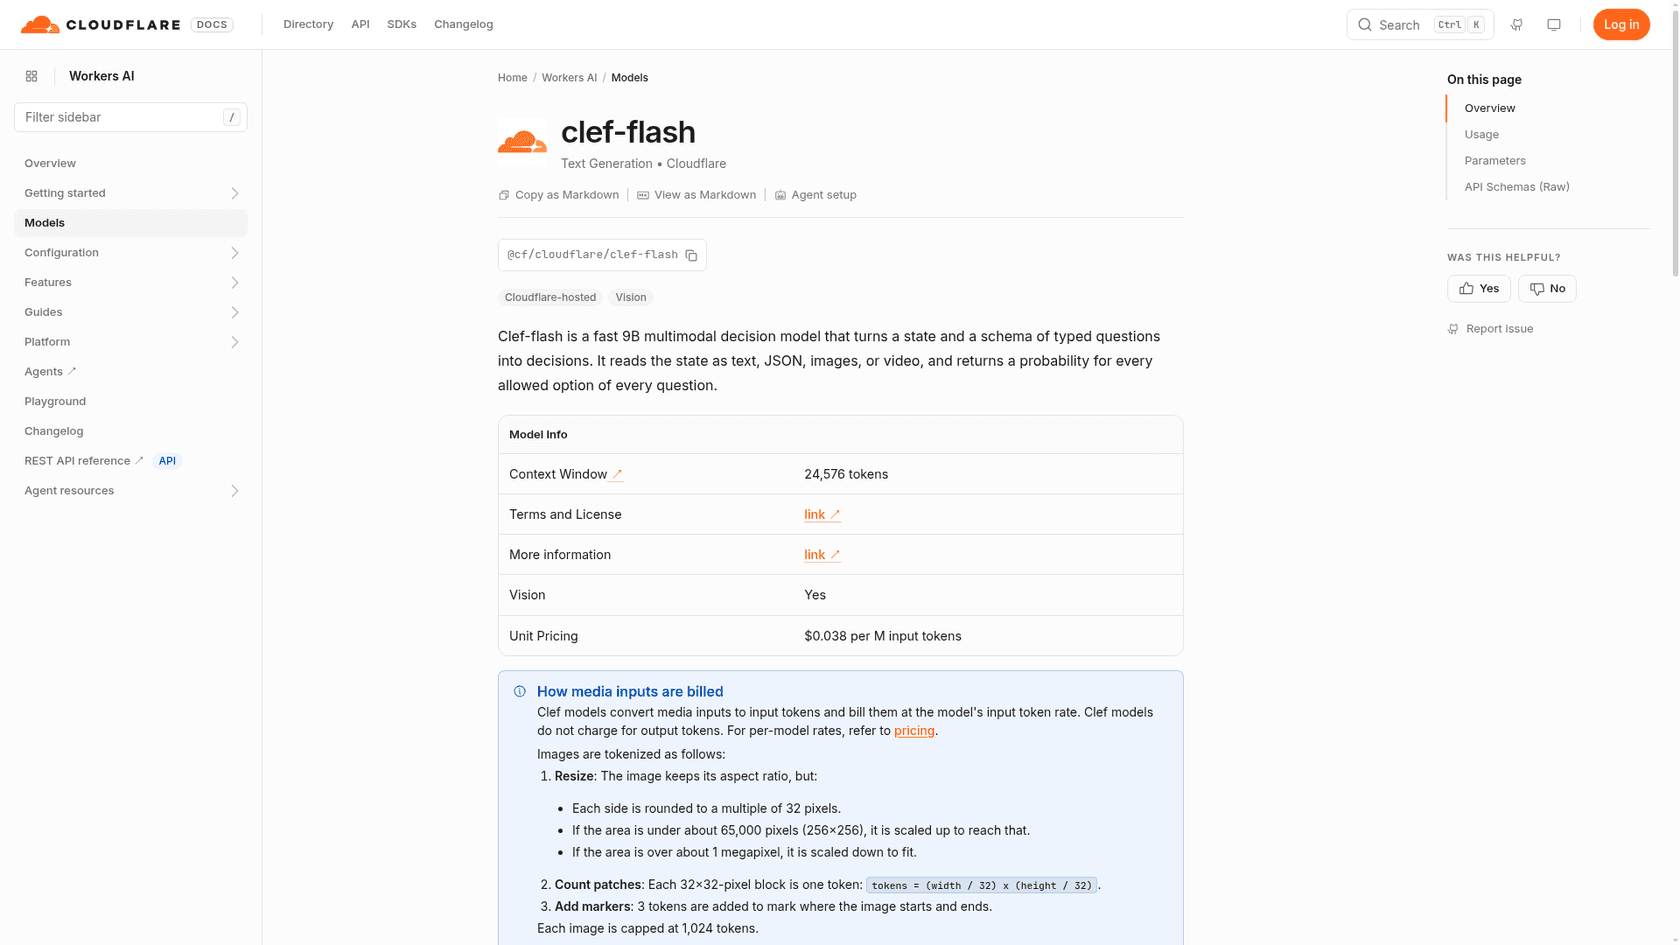
Le petit modèle de décision de Cloudflare, un 9B construit sur la même base Qwen3.5-9B que celui de Microsoft. Il tourne sur Workers AI sous le nom @cf/cloudflare/clef-flash, et les poids sont sur Hugging Face sous Apache 2.0. Mon aperçu de Clef couvre les deux tailles de Clef.
Là où il bat Microsoft-Decision-1
- Le tarif hébergé le moins cher. $0.038 par million de tokens en entrée, contre $0.09 il y a une semaine.
- Les images. La page de Cloudflare indique la prise en charge de la vision, avec les images facturées comme tokens d'entrée.
- Un quota quotidien gratuit. Workers AI offre 10,000 neurons par jour sur les forfaits Free et Paid. D'après mes calculs, cela représente environ 2.9M de tokens d'entrée Clef-flash par jour.
- Poids ouverts, de sorte que vous pouvez le rapatrier en interne plus tard.
Là où il déçoit
- La fenêtre de contexte a rétréci à 24,576 tokens avec la baisse de prix, plus petite que celle de Microsoft.
- Il se classe 33e au Decision Index (47.61), bien derrière Clef et Jev.
- Il n'est pas dans le tableau comparatif de Microsoft, il n'y a donc aucun benchmark commun entre les deux.
Tarifs
$0.038 par million de tokens en entrée et aucun frais de sortie. Au-delà des neurons gratuits, Workers AI facture $0.011 par 1,000 neurons.
Idéal pour
La classification de texte ou d'images à gros volume, où le coût par appel compte le plus et où les entrées restent courtes.
4. Cloudflare Clef
Ce que c'est
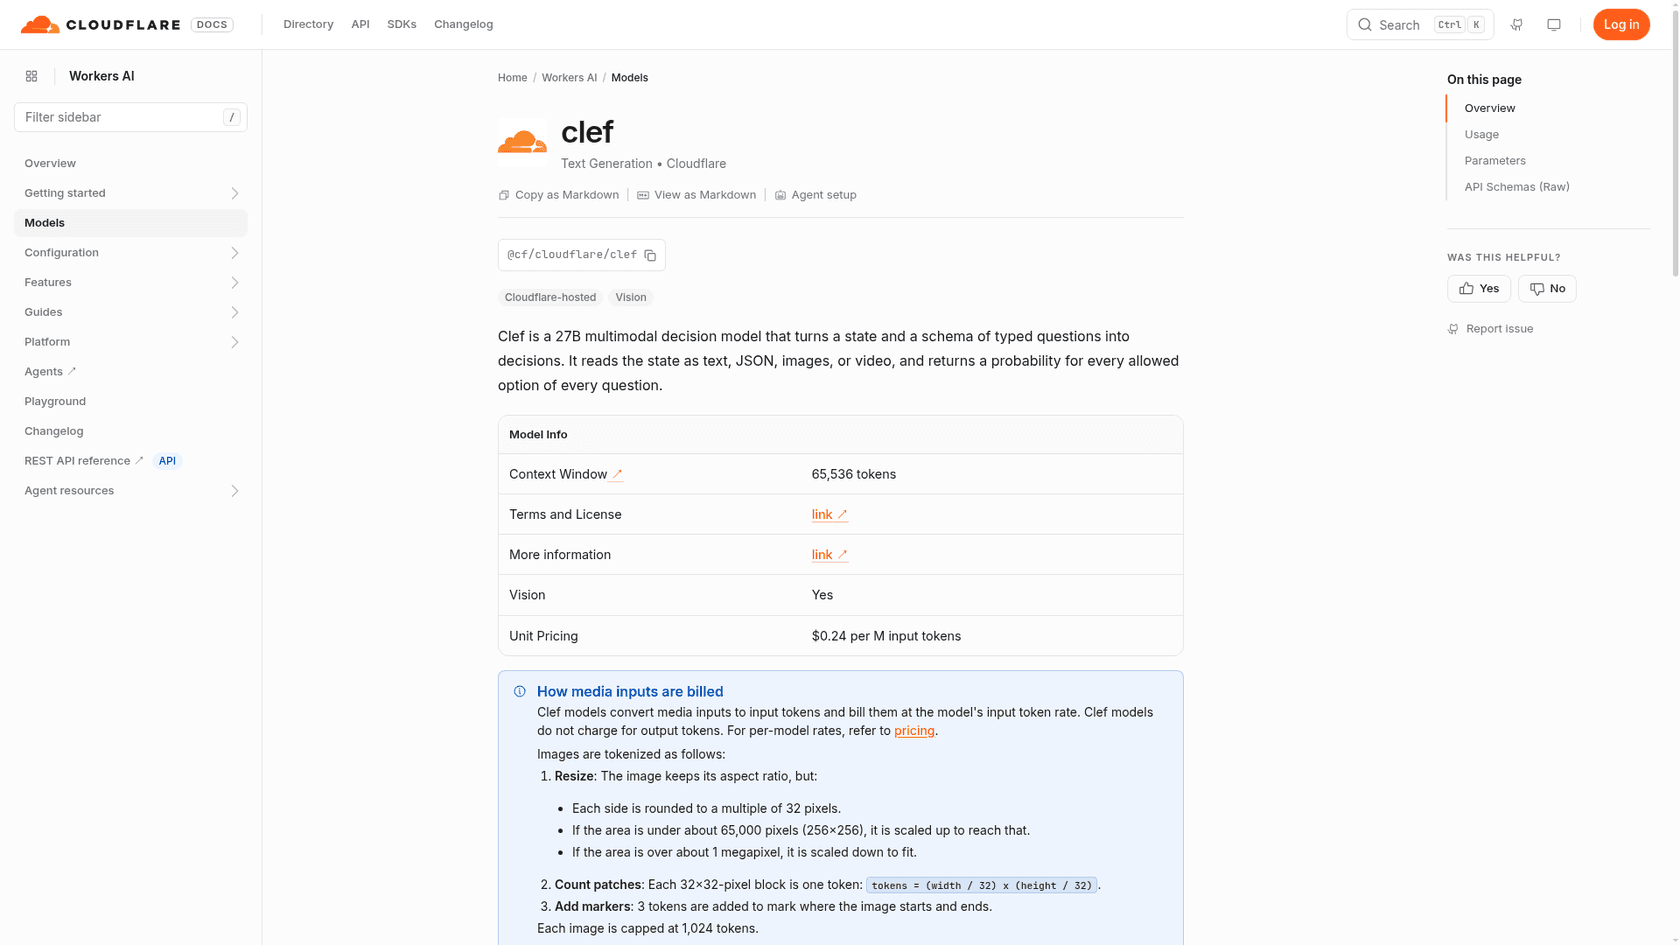
Le Clef plus gros : un modèle de décision multimodal de 27B post-entraîné à partir de Qwen3.8-27B, hébergé sur Workers AI et publié sous Apache 2.0.
Là où il bat Microsoft-Decision-1
- Deux fois plus de contexte. 65,536 tokens.
- Images et vidéo dans l'état, d'après la fiche du modèle de Cloudflare.
- Un score indépendant. Il figure au Decision Index à 53.08 Full, et son score sur les seuls benchmarks publics, 61.71, est le chiffre public le plus élevé parmi les options hébergées ici.
Là où il déçoit
- À $0.24 par million de tokens en entrée, il coûte près de 6x le tarif de Microsoft.
- Son score au test privé le fait tomber à la 19e place, le chiffre public le flatte donc.
- La médiane déclarée par Cloudflare était de 209 ms, plus lente que les 85 ms revendiqués par Microsoft.
Tarifs
$0.24 par million de tokens en entrée, aucun frais de sortie et les mêmes 10,000 neurons gratuits par jour (environ 458K tokens d'entrée Clef). Mon article sur les tarifs de Clef détaille le calcul.
Idéal pour
Les équipes sur Cloudflare qui ont besoin d'entrées multimodales plus longues et paieront plus cher par appel pour cela.
5. Perplexity Decider v1.1 (27B)
Ce que c'est
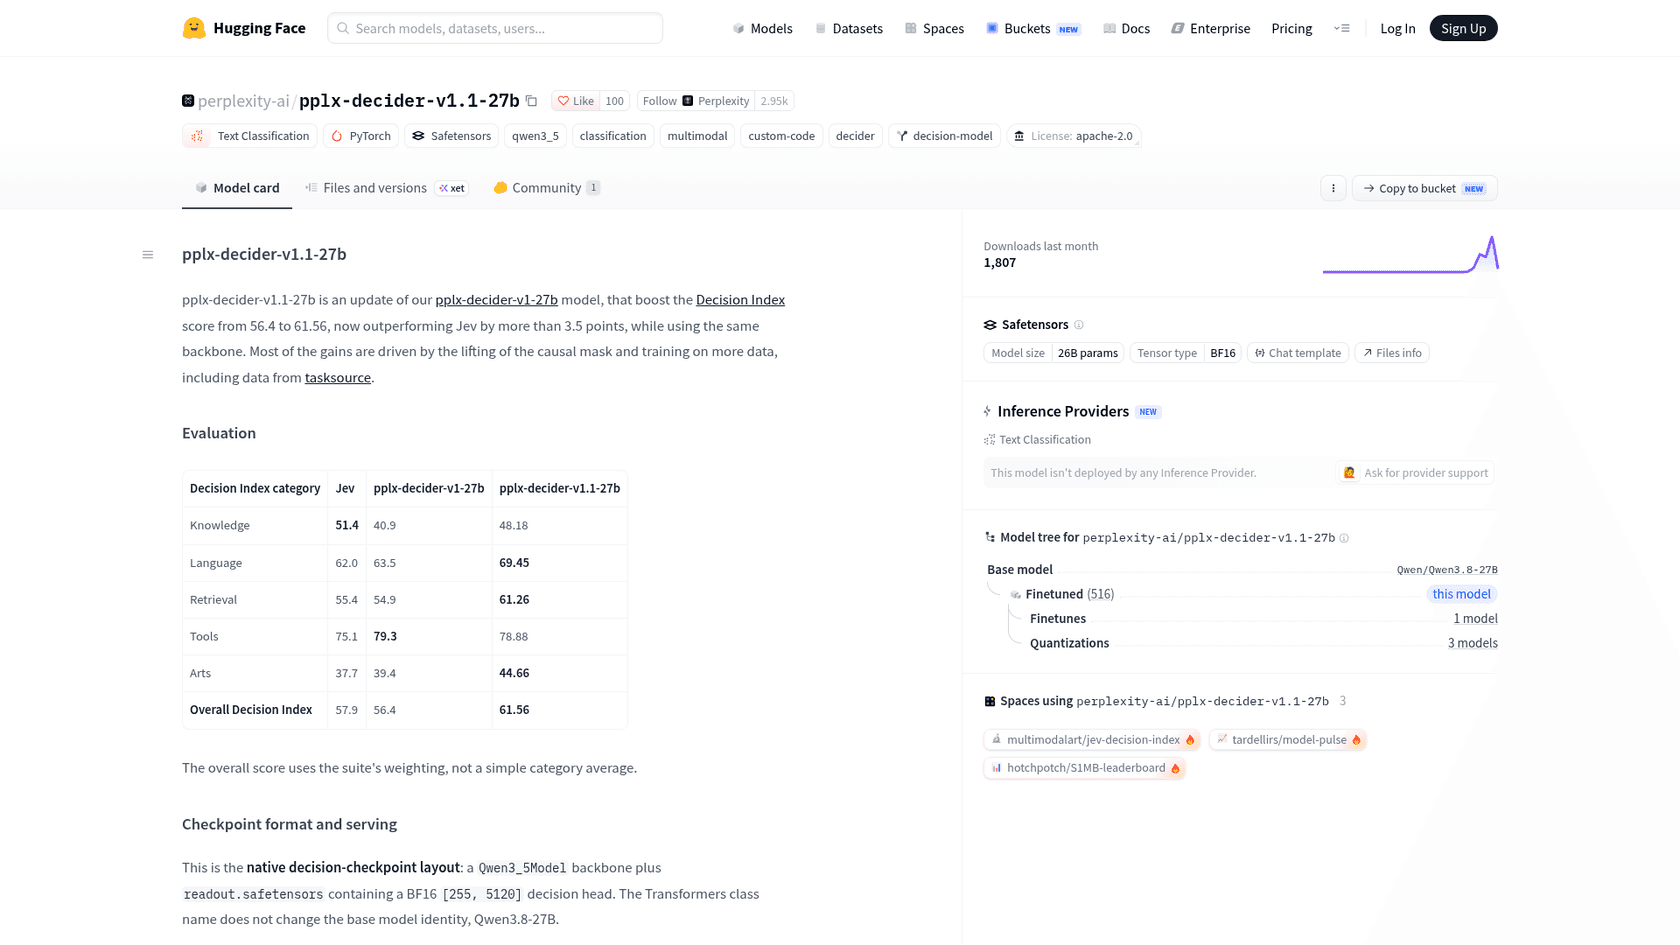
Le modèle de décision ouvert de Perplexity, un fine-tuning complet de Qwen3.8-27B avec une tête de décision séparée. Perplexity dit que la v1.1 doit l'essentiel de son amélioration à "the lifting of the causal mask" et à davantage de données d'entraînement. Vous le téléchargez depuis Hugging Face et l'exécutez avec le code fourni.
Là où il bat Microsoft-Decision-1
- Le meilleur score indépendant. Il se classe premier au Decision Index v0.3.1 avec 62.75, devant les 60.11 de Jev.
- Les poids vous appartiennent. Apache 2.0, rien ne quitte vos serveurs.
- Les images, passées sous forme de chemins de fichier, d'images PIL ou d'URLs base64.
Là où il déçoit
- Limite stricte de 8,192 tokens par décision, texte et images confondus.
- Il vous faut un GPU CUDA avec la place pour environ 49 GiB de poids plus la mémoire de travail, et un compte Hugging Face authentifié pour le télécharger.
- Pas d'API hébergée : la fiche indique qu'aucun fournisseur d'inférence ne le sert.
- L'inférence causale par défaut ne reproduit pas la configuration évaluée, vous devez donc utiliser le code de Perplexity ou un export soigné.
Tarifs
Téléchargement gratuit. Votre coût, c'est le temps de GPU. Sur le coût, un commentateur de Hacker News l'a bien résumé :
"Open weight model pricing isn't really up to the company that built them (unless they are also serving them, in which case their API price may differ). It's really up to the serving cost and/or pricing of whoever is actually serving the model."
Idéal pour
Les équipes ML avec de la capacité GPU disponible qui veulent le modèle ouvert le plus précis et gardent des entrées courtes.
6. Surogate Rune 26B-A4B v3
Ce que c'est
Le modèle de décision ouvert d'Invergent, un fine-tuning complet de Gemma 4 26B-A4B (8 experts sur 128 actifs par token). Il répond aux questions choice, noul et score et il est servi le plus vite par le moteur open source surogate.
Là où il bat Microsoft-Decision-1
- Des entrées longues. La fiche revendique un contexte de 262k, huit fois celui de Microsoft.
- Les images, avec la tour de vision conservée. Le test d'images d'Invergent lui-même a donné 83.4 % à 1,120 tokens d'image.
- Réflexion optionnelle. Avec
"thinking": true, les questions dont il n'est pas sûr sont raisonnées avant la réponse. Invergent estime que cela relève son index d'environ 1.8 point, à environ 5 secondes par question avec réflexion. - Dans le tableau de Microsoft, il a obtenu 79.7 %, proche du Luna d'OpenAI.
Là où il déçoit
- Les téléchargements sont derrière un formulaire de coordonnées.
- Ses probabilités par défaut sont trop confiantes. La fiche recommande de lire les réponses à la température 2 pour corriger la calibration.
- Invergent a mesuré une médiane de 388 ms par requête sur une RTX PRO 6000, plus lente que ce que revendique Microsoft.
- 10e au Decision Index (57.43), derrière Perplexity et Jev.
Tarifs
Téléchargement gratuit sous Apache 2.0. Vous payez le matériel.
Idéal pour
Les auto-hébergeurs qui ont besoin d'entrées longues ou riches en images et savent régler eux-mêmes le serving.
7. Strands Decider (AWS Strands Labs)
Ce que c'est
Un petit modèle de décision ouvert de Strands Labs d'AWS, conçu pour les étapes d'agents comme le choix d'outils, les garde-fous et le routage. Le modèle de référence est un 2B sur Qwen3.5, et quatre tailles Gemma 4 ont suivi les 10 et 11 octobre. J'ai couvert le lancement dans mon article sur Strands Decider.
Là où il bat Microsoft-Decision-1
- Tourne sur du matériel modeste. Le 2B a atteint une médiane de 115 ms sur une seule RTX 3090 dans le test de Strands lui-même.
- Gratuit et ouvert, Apache 2.0, et il s'intègre dans le harnais Strands plus large pour les agents.
- Entrée d'images optionnelle avec
--vision, même si Strands précise que rien n'a été entraîné sur des images.
Là où il déçoit
- La précision est bien plus faible. Le tableau de Microsoft montre 54.8 % sur seulement 23 des 36 benchmarks, et le Decision Index le classe 84e (21.75).
- Il a été testé avec des fenêtres de 3,072 et 4,096 tokens.
- Il n'existe aucune API hébergée nulle part, Bedrock compris.
Tarifs
Gratuit. Votre propre GPU ou CPU.
Idéal pour
Des garde-fous d'agents locaux et peu coûteux et le choix d'outils, quand la vitesse sur petit matériel compte plus que la précision maximale.
8. eesel (si vous voulez la décision et le travail)

Ce que c'est
Pas un modèle. Les sept options ci-dessus sont de l'infrastructure. eesel est l'employé : un coéquipier de helpdesk IA qui rejoint votre file Zendesk, Freshdesk ou Gorgias, prend la décision de routage, puis rédige la réponse ou exécute l'action. Il apprend de vos anciens tickets et de votre centre d'aide.
Là où il bat Microsoft-Decision-1
- Aucun pipeline à construire. Pas de seuils, de webhooks ni de code de liaison avec l'API du helpdesk.
- Il agit sur la réponse. Étiquettes, priorité, escalade et la réponse elle-même.
- Les actions risquées peuvent attendre une validation, afin qu'un humain donne son accord avant toute action irréversible.
Là où il déçoit
- Bien plus cher par ticket qu'un simple appel de modèle, parce qu'il inclut le travail.
- Il vit dans votre helpdesk. Si vous avez besoin de décisions dans le chemin de code de votre propre application, utilisez un modèle.
Tarifs
Les forfaits d'eesel démarrent à $299 par mois pour 500 crédits, où un ticket ou un chat vaut un crédit quelle que soit sa durée. 5,000 crédits coûtent $1,749 par mois. Il y a un démarrage gratuit avec 100 crédits et sans carte.
Idéal pour
Les équipes support dont le vrai objectif est d'avoir des tickets triés et traités, pas un modèle à brancher.
Quelle alternative à Microsoft-Decision-1 choisir ?
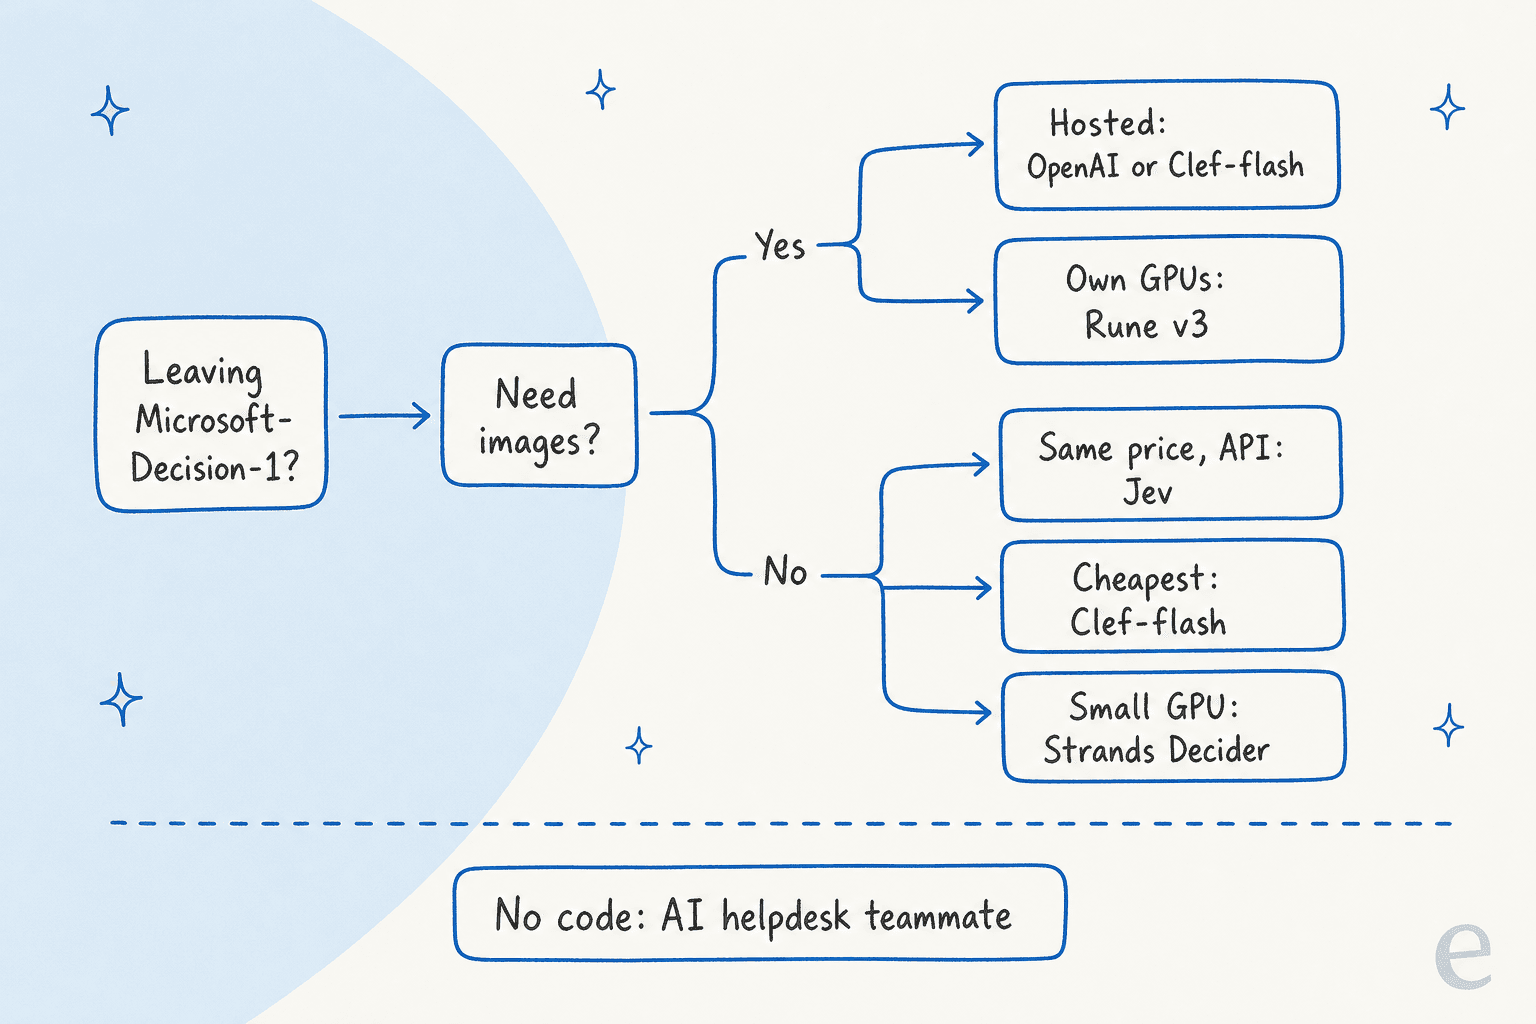
Ma version courte :
- Même travail, sans Azure : Jev au même prix. Comparez les deux d'abord sur vos propres données.
- La facture la plus basse : Clef-flash, si vos entrées tiennent dans 24,576 tokens.
- Images ou fils très longs : la Decisions API d'OpenAI en hébergé, Rune v3 en auto-hébergé.
- La meilleure précision ouverte : Perplexity Decider v1.1, si 8,192 tokens suffisent.
- Petit et local : Strands Decider pour les garde-fous d'agents.
Pour les équipes support, le cas d'usage est presque toujours la classification des tickets et le routage. C'est là que le score de probabilité fait ses preuves : vous n'automatisez que ce dont le modèle est sûr. Sur de vraies files, le plus difficile vient après. Dans un exemple tiré de nos propres données, l'IA d'une entreprise d'infrastructure Web3 a rapproché une approche commerciale à froid issue d'une liste de contacts d'anciens tickets Zendesk, l'a classée comme spam et a rédigé un refus poli en note interne au lieu d'essayer d'y répondre. Un modèle de décision vous donne l'étiquette "spam". Quelqu'un doit encore lire l'historique et écrire la note.
Surveillez aussi les faux positifs dans l'étiquetage. Un taux d'erreur de 1 % est peu coûteux par appel et cher quand il envoie un remboursement aux ventes. Mon comparatif de la meilleure IA pour le tri compare des outils qui gèrent cela nativement.
Oubliez le modèle, gardez la décision
Si vous comparez des alternatives à Microsoft-Decision-1 parce que vous voulez des tickets routés, étiquetés et priorisés, vous n'avez peut-être pas besoin d'un modèle du tout. eesel fonctionne comme une nouvelle recrue pour votre helpdesk : il se branche sur Zendesk ou Freshdesk en quelques minutes, lit vos anciens tickets, prend les mêmes décisions de tri qu'un modèle de décision, puis répond au client. Vous pouvez le simuler sur des tickets historiques avant qu'il ne touche un ticket en direct.
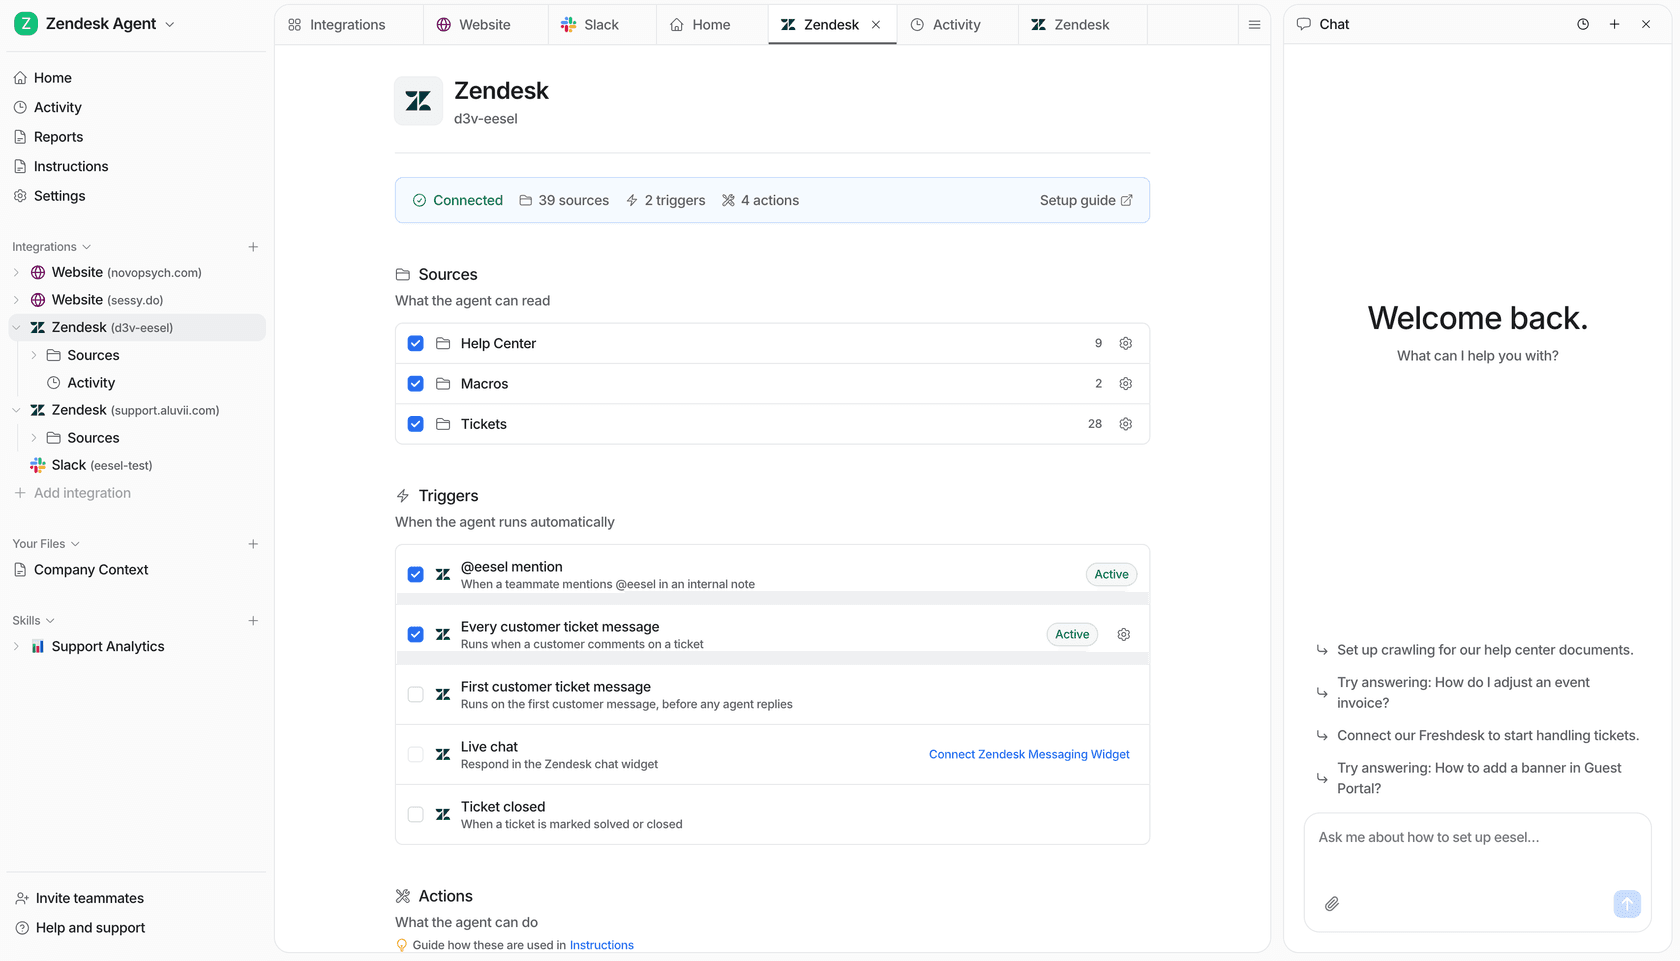
Si vous préférez le piloter par le code, la CLI eesel exécute le même coéquipier que le tableau de bord. Chaque commande affiche du JSON, de sorte que vous, un script ou un agent de code comme Claude Code, Codex ou Cursor pouvez le configurer. eesel integrations connecte votre helpdesk, eesel automations enable <platform> <key> --instructions "..." écrit une règle de tri en mots simples, et eesel approvals liste les actions en attente à approuver ou refuser. Plus de détails sur l'intérêt de tout cela dans mon article sur la CLI d'agent.
Essayez eesel gratuitement avec 100 crédits et pointez-le sur une semaine de vos tickets. S'il les route aussi bien que votre pipeline de décision, vous vous serez épargné la construction.
Questions fréquentes
Quelles sont les meilleures alternatives à Microsoft-Decision-1 ?
Le remplaçant le plus proche est Jev de TypeSafe, qui coûte le même prix, $0.042 par million de tokens en entrée. La Decisions API d'OpenAI ajoute les images et une très grande fenêtre de contexte, Clef-flash de Cloudflare est l'option hébergée la moins chère à $0.038, et Perplexity Decider, Rune v3 et Strands Decider sont des alternatives à poids ouverts à Microsoft-Decision-1 que vous exécutez vous-même.
Existe-t-il une alternative moins chère à Microsoft-Decision-1 ?
Oui. Clef-flash de Cloudflare affiche $0.038 par million de tokens en entrée contre $0.042 chez Microsoft, avec une sortie gratuite des deux côtés. Les modèles à poids ouverts ne coûtent rien à télécharger, mais vous payez le GPU. Mon détail des tarifs de Clef couvre le quota quotidien gratuit sur Workers AI.
Jev est-il meilleur que Microsoft-Decision-1 ?
Dans le tableau de 36 benchmarks de Microsoft, Microsoft-Decision-1 obtient 83.5 % de précision moyenne contre 82.3 % pour Jev, tandis que Jev score plus haut en calibration (93.7 contre 92.2). Les prix sont identiques. Jev lit 64k tokens par requête contre 32,768 chez Microsoft. Mon test de Jev détaille son comportement en pratique.
Existe-t-il une alternative open source à Microsoft-Decision-1 ?
Microsoft n'a pas publié les poids, vous ne pouvez donc pas l'héberger vous-même. Perplexity Decider v1.1, Surogate Rune 26B-A4B v3, les modèles Clef de Cloudflare et Strands Decider d'AWS sont tous publiés sous Apache 2.0. Perplexity Decider v1.1 est actuellement en tête du Decision Index de la communauté.
Quelle alternative à Microsoft-Decision-1 prend en charge les images ?
La Decisions API d'OpenAI, Cloudflare Clef et Clef-flash, Perplexity Decider et Rune v3 acceptent tous les images. Microsoft-Decision-1 et Jev ne gèrent que le texte. Si des captures d'écran apparaissent dans votre flux de tri des tickets, cela suffit à réduire la liste.
Ai-je besoin d'un modèle de décision pour router les tickets de support ?
Seulement si vous intégrez le routage dans votre propre produit ou pipeline. Si l'objectif est que les tickets soient triés et traités dans votre helpdesk, un agent de helpdesk IA fait la décision et le travail sans code. Mon guide pour automatiser le tri des tickets détaille les deux voies.
Comment Microsoft-Decision-1 se compare-t-il à la Decisions API d'OpenAI ?
OpenAI facture $0.10 par million de tokens en entrée sur
gpt-6-luna, soit environ 2,4 fois le tarif de Microsoft, également avec sortie gratuite. En échange, vous obtenez les images, une fenêtre de 1,050,000 tokens et des options ZDR et HIPAA pour les clients éligibles. L'API est toujours en bêta publique. Voir mon article sur les tarifs de la Decisions API.