

Qu'est-ce que Microsoft-Decision-1 ?
Microsoft-Decision-1 est un modèle de notation de décisions. Vous lui remettez un texte (Microsoft et OpenRouter l'appellent le state) et une ou plusieurs questions avec un ensemble fixe de réponses. Il renvoie une probabilité pour chaque réponse. C'est toute l'interface.
Microsoft l'a annoncé le 9 octobre 2026 dans un article de son blog Command Line signé Achint Srivastava, VP de l'ingénierie logicielle au sein du bureau du CTO. L'article dit qu'il est conçu pour « le routage, la classification, la priorisation, la vérification et le contrôle des flux de travail » (Microsoft). Satya Nadella a publié le lancement le même jour, en disant que Microsoft le teste déjà en interne sur la réponse aux incidents, le contrôle qualité et la découverte scientifique (Satya Nadella sur X).
Si la catégorie est nouvelle pour vous, mon explication sur les modèles de décision donne le contexte. En bref : TypeSafe Jev a lancé la catégorie en septembre 2026, Cloudflare, AWS et OpenAI ont suivi en quelques semaines, et Microsoft-Decision-1 est la première entrée d'un hyperscaler qui vend le modèle sur son propre cloud.
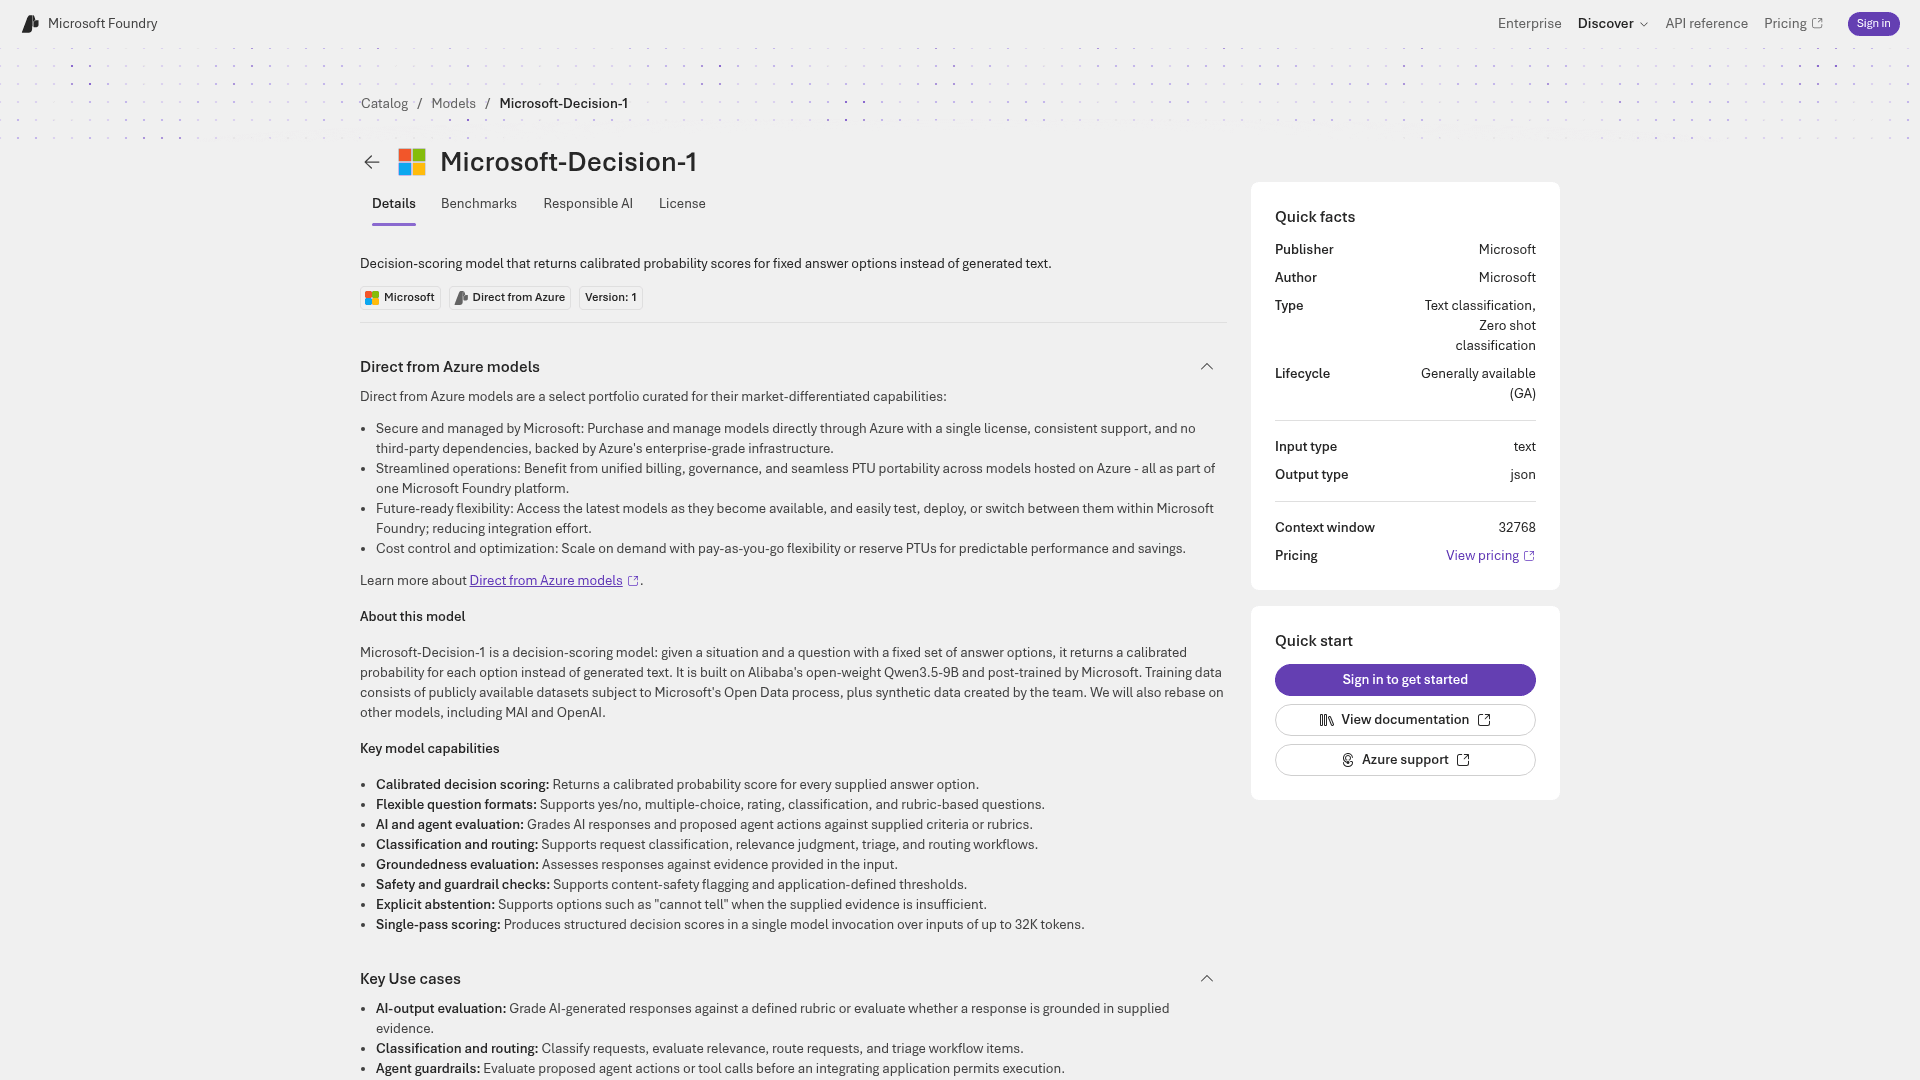
Ce qu'il n'est pas compte autant que ce qu'il est. La fiche du modèle de Microsoft indique qu'il n'est « pas conçu pour la génération de texte, les questions ouvertes, la conversation, la traduction ou le résumé » (catalogue Foundry). Il ne peut écrire ni une réponse, ni un résumé, ni une ligne de code. Il choisit.
Comment fonctionne Microsoft-Decision-1 ?
Je passe mes journées à construire le côté agents d'eesel, c'est donc la partie que j'ai cherchée en premier. La mécanique est plus simple que l'article de lancement ne le laisse croire.
Microsoft a pris le Qwen3.5-9B à poids ouverts d'Alibaba et l'a post-entraîné « pour une notation de décisions rapide, en une seule passe », et dit qu'il « le rebasera bientôt sur d'autres modèles, dont Microsoft AI (MAI) et OpenAI » (Microsoft). Les données d'entraînement sont « des jeux de données publics soumis au processus Open Data de Microsoft, plus des données synthétiques créées par l'équipe » (catalogue Foundry). La base Qwen est la même famille que celle de Clef-flash de Cloudflare et de Strands Decider d'AWS.
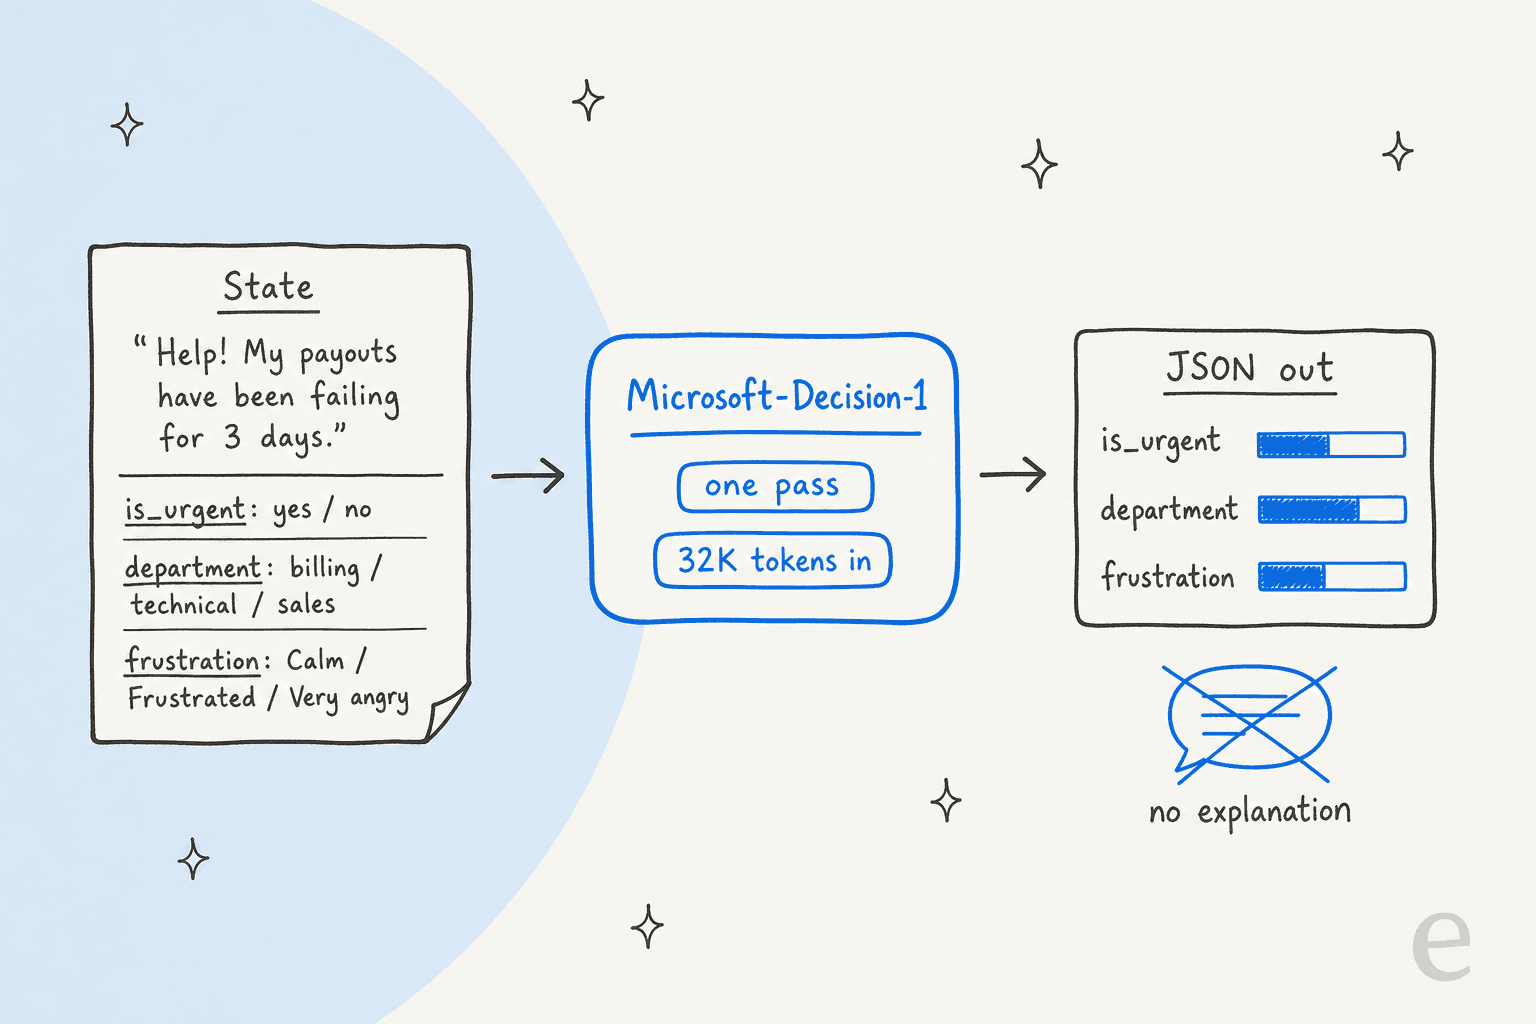
Concrètement, trois choses se passent en un appel :
- Il lit l'état et chaque question une seule fois. Jusqu'à 32 768 tokens de texte entrent. Microsoft appelle cela la « notation en une seule passe » (catalogue Foundry).
- Il note chaque réponse autorisée. Au lieu d'écrire « billing » lettre par lettre, il attribue une probabilité à billing, technical et sales en même temps.
- Il renvoie du JSON et s'arrête. Il n'y a pas de justification. La fiche dit clairement que le modèle « ne génère ni explications ni justifications ».
Les types de questions correspondent à ce que les utilisateurs de Jev connaissent déjà. Sur OpenRouter, une requête peut porter plusieurs questions nommées sur le même état (OpenRouter) :
| Type de question | Ce qu'elle demande | Ce qui revient | Exemple de support |
|---|---|---|---|
noul | Est-ce vrai ? | Une probabilité de 0 (non) à 1 (oui) | « Ce message exprime-t-il de l'urgence ? » |
choice | Quelle option convient ? | Le choix plus une probabilité par option | « Facturation, technique ou ventes ? » |
score | Où sur cette échelle ? | Une position sur une grille ordonnée | « Calme, Frustré ou Très en colère ? » |
Le catalogue de Microsoft liste quelques extras : notation par grille des réponses d'IA et des actions d'agents, vérifications d'ancrage par rapport aux éléments fournis, contrôles de sécurité et « abstention explicite », c'est-à-dire une option comme « impossible à dire » quand les éléments sont minces (catalogue Foundry). Ce dernier point est sous-estimé. Un modèle qui peut dire « pas assez d'éléments ici pour décider » est bien plus facile à placer devant une vraie file.
Voici la requête d'exemple d'OpenRouter, légèrement abrégée. C'est un ticket de support, ce qui indique qui Microsoft et OpenRouter voient comme premiers acheteurs :
const decision = await openrouter.alpha.decisions.create({
  decisionsRequest: {
    model: "microsoft/microsoft-decision-1",
    state: "Help! My payouts have been failing for 3 days.",
    questions: {
      is_urgent: {
        type: "noul",
        instructions: "Does this message convey urgency?",
        criteria: { true: "Explicitly time-sensitive", false: "No urgency expressed" }
      },
      department: {
        type: "choice",
        instructions: "Which team should handle this?",
        criteria: {
          billing: "Payments, invoicing, refunds",
          technical: "Bugs, outages, integrations",
          sales: "Pricing, upgrades, new accounts"
        }
      },
      frustration: {
        type: "score",
        instructions: "How frustrated is the customer?",
        criteria: ["Calm", "Frustrated", "Very angry"]
      }
    }
  }
});
Votre code lit ensuite les réponses et décide quoi faire, par exemple escalader quand is_urgent dépasse 0,8 et que le service est la facturation. Cette logique de seuils est tout l'intérêt. Comparez avec le mode JSON d'un LLM généraliste, où vous payez chaque token de sortie et obtenez quand même une étiquette sans confiance honnête associée.
Comment accéder à Microsoft-Decision-1 ?
Il y a deux portes, et elles se comportent différemment.
Microsoft Foundry, « Direct from Azure ». Le catalogue présente Microsoft-Decision-1 en Version 1 avec un cycle de vie « Generally available (GA) », du texte en entrée, du JSON en sortie et une fenêtre de contexte de 32 768 tokens (catalogue Foundry). La documentation Microsoft Learn le range parmi les modèles vendus directement par Azure, qui « sont facturés via votre abonnement Azure, couverts par les accords de niveau de service Azure et pris en charge par Microsoft » (Microsoft Learn). Si vous achetez déjà des modèles Azure OpenAI, c'est le circuit d'achat habituel.
La Decisions API d'OpenRouter. Pas besoin de compte Azure. L'identifiant du modèle est microsoft/microsoft-decision-1, il tourne sur POST https://openrouter.ai/api/alpha/decisions, et OpenRouter prévient que « les SDK de chat completions ne fonctionneront pas avec lui » (OpenRouter). Azure est le seul fournisseur derrière, donc chaque requête atterrit quand même sur l'infrastructure de Microsoft.
| Microsoft Foundry | OpenRouter | |
|---|---|---|
| Statut | GA, Version 1 | En ligne depuis le 9 octobre 2026 |
| Compte | Abonnement Azure | Clé OpenRouter |
| Facturation | Votre facture Azure | Crédits OpenRouter |
| SLA | Les SLA Azure s'appliquent | Pas un SLA Azure |
| Forme de la requête | Pas encore documentée publiquement | Decisions API documentée |
| Mises à jour du modèle | Version 1 dans le catalogue | « Les poids sont mis à jour en continu tandis que la forme de l'API reste la même » |
| Vitesse mesurée | 85 ms p50, test de Microsoft | 0,19 s p50 du meilleur fournisseur, mesure d'OpenRouter |
Deux lignes de ce tableau changeraient ma façon de le mettre en production. D'abord, Foundry est le foyer de production le plus sûr, mais le format de requête n'est pas encore public. Un utilisateur de Hacker News qui l'a déployé le premier jour a écrit :
« Je ne regarde peut-être pas au bon endroit, mais je ne trouve pas à quoi ressemble la forme de l'API. J'ai même déployé ce modèle via Foundry et il n'indique pas quoi envoyer ni quoi attendre en retour. »

Quand j'ai vérifié le 11 octobre, il n'y avait toujours pas de page pratique Learn pour le modèle. Ensuite, la note d'OpenRouter selon laquelle les poids sont mis à jour en continu signifie qu'un seuil réglé le mois dernier peut dériver sans prévenir. Si vous routez sur confidence > 0.9, revérifiez après les mises à jour.
Que prétendent les benchmarks de Microsoft ?
L'article de lancement de Microsoft s'ouvre sur une comparaison de 36 benchmarks couvrant 147 137 questions « tenues aveugles à l'entraînement » (Microsoft). Voici le cœur du tableau publié :
| Modèle | Précision moyenne | Latence médiane | Calibration (100 = parfaite) |
|---|---|---|---|
| Microsoft-Decision-1 | 83.5% | 85 ms p50, 125 ms p95 | 92,2 |
| Jev 1.13.0 | 82,3 % | 240 ms | 93.7 |
| Quyet-1.0-Large | 81,9 % | 380 ms | 93,1 |
| GPT-6 Luna Decisions | 79,4 % | 300 ms | 89,9 |
| H2O-Lightning-4B v1.1 | 77,2 % | 210 ms | 91,8 |
| Strands-Decider 2B (23 des 36 benchmarks) | 54,8 % | Non mesurée | Non noté |
| GPT-6 Sol (référence) | Non classé | 3,01 s | Non noté |
Source : l'annonce de Microsoft. Microsoft indique aussi que le modèle change sa réponse dans 1,3 % des perturbations en moyenne, avec zéro changement quand les options sont reformulées, inversées ou mélangées. Les tests de sécurité ont couvert 5 250 requêtes sur 11 benchmarks.
Lisez les notes avant de citer ces chiffres. La latence de chaque concurrent vient de la médiane ajustée de JevBench v1.6.1, vérifiée le 7 octobre. Les 85 ms de Microsoft-Decision-1 ont été « mesurées via Foundry dans la même région ». Ce n'est pas la même course. Et Microsoft arrive troisième en calibration, 1,5 point derrière Jev, ce qui compte plus que l'avance en précision si vous comptez agir automatiquement au-dessus d'un seuil de confiance.
Jev ne figurait pas dans le tableau au départ. La réponse la plus aimée sous le post de lancement de Nadella, avec 335 mentions « j'aime », disait :
« Comment Jev n'est-il pas classé ? C'est littéralement le modèle n°1 auquel les gens vont comparer celui-ci. »
L'annonce porte désormais une note de la rédaction disant qu'elle « a été mise à jour par rapport à l'original pour ajouter les benchmarks de Jev en précision et en calibration ». Bravo à Microsoft pour l'avoir corrigé vite. Mon test de Jev en dit plus sur le modèle auquel il est comparé.
Les résultats internes sont plus minces mais intéressants. Microsoft dit que son équipe Copilot l'a trouvé « compétitif avec GPT5.6 Luna et 100 fois plus rapide », et que son équipe XBOX Research a fait passer plus de 10 000 retours dessus à « plus de 14 fois plus vite et 200 fois moins cher » que GPT-6 Sol (Microsoft). Ce sont des équipes de Microsoft qui notent le modèle de Microsoft, je les traiterais donc comme des signaux d'usage, pas comme une preuve.
Qu'a-t-on mesuré de façon indépendante ?
Pas grand-chose pour l'instant, ce qui est normal deux jours après le lancement. Voici tout ce que j'ai pu vérifier hors de Microsoft.
OpenRouter publie sa propre latence pour chaque modèle qu'il sert. Sur trois jours, il a mesuré un p50 du meilleur fournisseur de 0,19 seconde, un p50 moyen de 0,27 seconde et un p99 de 0,67 seconde, avec 99,90 % de disponibilité (OpenRouter).
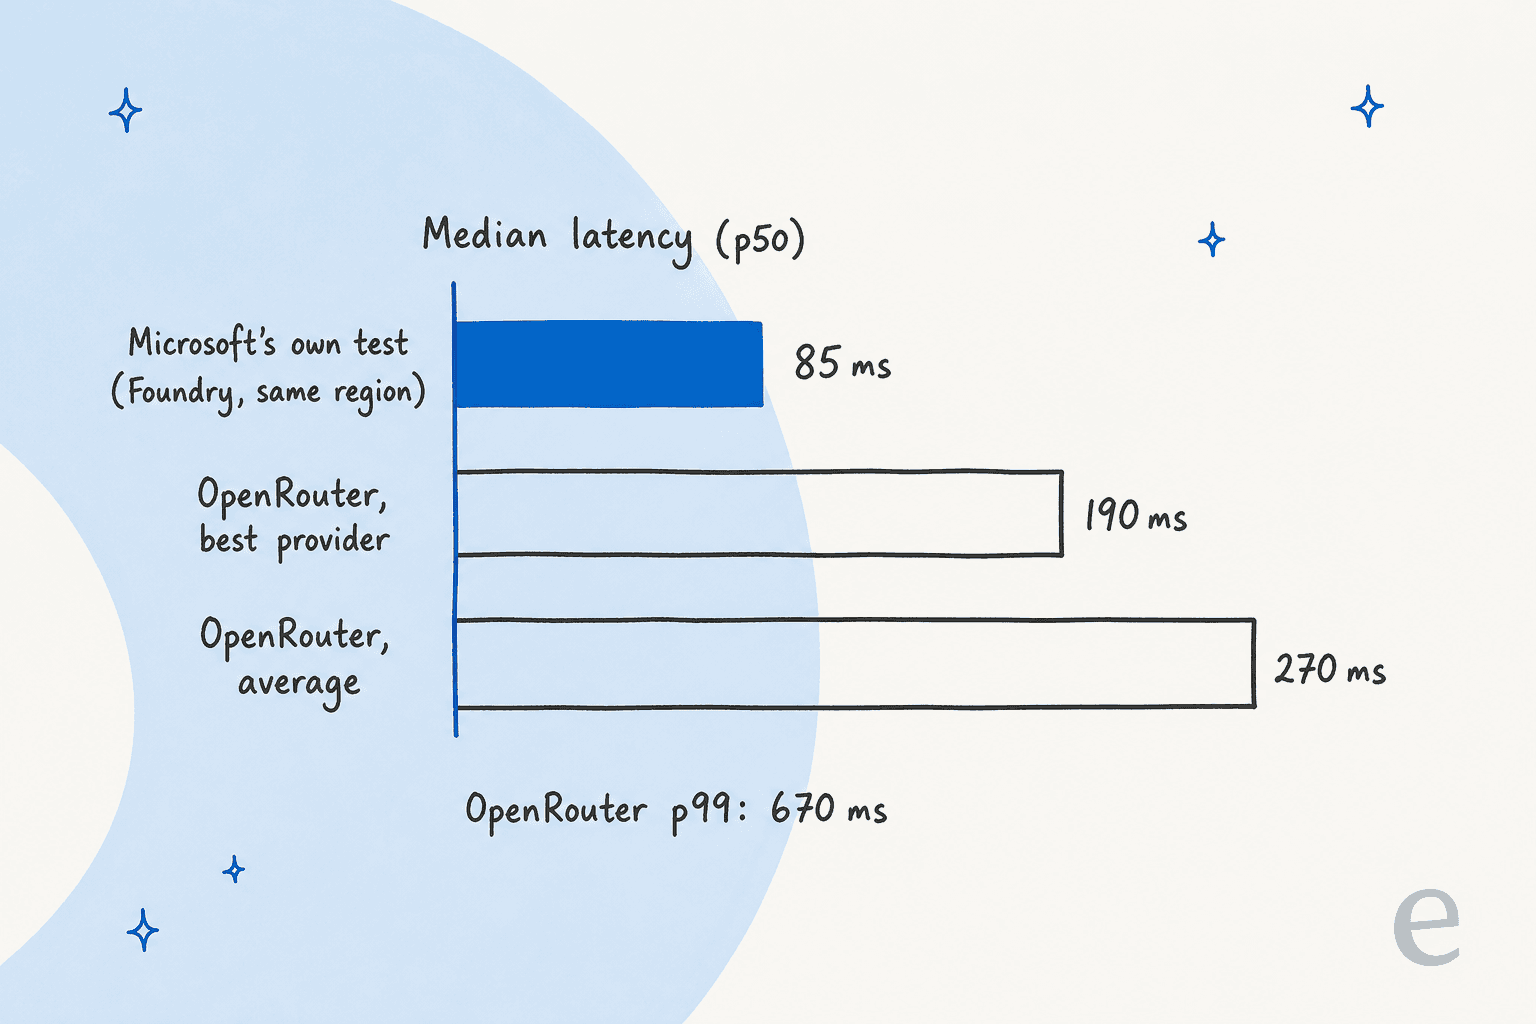
Cet écart ne signifie pas que le chiffre de Microsoft est faux. Il est mesuré à côté du modèle, alors que celui d'OpenRouter inclut un saut par un routeur. Mais si vous l'appelez via l'internet public, comptez environ 200 à 300 ms, pas 85. Pour un seul appel de routage sur un ticket, c'est encore instantané. Pour un agent qui enchaîne 20 décisions, le calcul de Microsoft s'applique : « ajouter seulement 100 millisecondes à chacune de 20 décisions séquentielles ajoute deux secondes à l'ensemble du flux de travail ».
La seule comparaison pratique que j'ai trouvée vient d'un commentateur de Hacker News qui l'a opposé à Jev :
« Dans ma suite minimale, il était moins cher (de 0,72x) mais avec une latence plus élevée (283 ms contre 369 ms p50) que Jev. Les résultats étaient très comparables dans tous les scénarios que je mesure, le premier de ceux que j'ai testés qui justifie vraiment son existence en tant que version commerciale. »
C'est la petite suite d'une seule personne, mais cela colle à la forme de l'histoire : des réponses à peu près au niveau de Jev, à un prix au niveau de Jev.
Ce qui manque : le Jev Decision Index tenu par la communauté est passé à la v0.3.1 le 10 octobre avec 117 entrées, et Microsoft-Decision-1 n'en fait pas partie. Jev est à 60,11 sur le nouveau score Full de ce classement, il y a donc une barre claire qui attend. L'usage est aussi débutant. Les classements de décisions d'OpenRouter cette semaine montrent Jev 1.13 à 999M de requêtes, GPT-6 Luna Decisions à 11,7M et Microsoft-Decision-1 hors du top 10.
Quelles sont les limites et les inconnues ?
C'est la section que je lirais deux fois avant une mise en production. Certaines sont des choix de périmètre délibérés et d'autres de simples lacunes de la documentation de la semaine de lancement.
- Pas d'explications. Il renvoie des scores, jamais des raisons. Si un responsable du support demande « pourquoi ceci est-il allé à la facturation ? », le modèle ne peut pas le dire.
- Texte uniquement, contexte de 32K. Pas d'images ni de captures d'écran, contrairement à Clef ou à la Decisions API d'OpenAI. Un long fil d'e-mails avec historique cité peut atteindre le plafond.
- Pas de poids ouverts. L'URL Hugging Face renvoie une 404, l'auto-hébergement et le fine-tuning ne sont donc pas possibles.
- Pas de régions, limites de débit ni quotas publiés. Il est absent de la page de disponibilité régionale d'Azure, et l'onglet de licence du catalogue ne s'affichait pas pour les visiteurs non connectés, je n'ai donc pas pu lire les conditions de licence.
- Pas encore dans la grille tarifaire d'Azure. Le tarif de 0,042 $ figure dans l'annonce et sur OpenRouter, mais la page de tarification de Foundry Models n'a pas de ligne pour lui. J'ai détaillé ce que cela signifie dans mon article sur les tarifs de Microsoft-Decision-1.
- Usages hors périmètre. Microsoft dit qu'il « ne doit pas être utilisé comme seule base pour des décisions touchant au crédit, à l'emploi, au logement, à l'assurance, à l'éducation, à la santé, aux droits légaux » (catalogue Foundry).
Le premier point a suscité le commentaire le plus acéré du fil HN, qui a atteint 195 points et 65 commentaires :
« Utiliser la sortie d'un modèle de "décision" sans aucune visibilité sur le raisonnement d'une décision donnée me semble très confiant. »
Je suis d'accord, avec une nuance. Le modèle n'a pas besoin de s'expliquer si vous journalisez ce qu'il a vu, ce qu'il a choisi et avec quelle confiance, et envoyez les cas à faible confiance à un humain. C'est la même discipline que j'appliquerais pour empêcher les hallucinations de l'IA dans un bot de support : tester sur l'historique réel, verrouiller les décisions risquées, garder une trace.
Comment Microsoft-Decision-1 se compare-t-il à Jev, Clef et les autres ?
Microsoft-Decision-1 arrive dans un domaine très peuplé. La version rapide de qui est qui, vérifiée le 11 octobre 2026 :
| Modèle | Éditeur | Prix d'entrée par 1M | Contexte | Entrées | Poids ouverts | Où l'exécuter | Jev Decision Index v0.3.1 |
|---|---|---|---|---|---|---|---|
| Microsoft-Decision-1 | Microsoft | 0,042 $, sortie gratuite | 32 768 | Texte | Non | Foundry, OpenRouter | Non listé |
| Jev 1.13 | TypeSafe | 0,042 $, sortie gratuite | 64K par requête | Texte | Non | API TypeSafe, Workers AI, OpenRouter | 60,11 (2e ex æquo) |
| Clef | Cloudflare | 0,24 $ | 65 536 | Texte, JSON, images, vidéo | Oui, Apache 2.0 | Workers AI | 53,08 (19e) |
| Clef-flash | Cloudflare | 0,038 $ | 24 576 | Texte, JSON, images, vidéo | Oui, Apache 2.0 | Workers AI | 47,61 (33e) |
| OpenAI Decisions API | OpenAI | 0,10 $, sortie gratuite | 1 050 000 de GPT-6 Luna | Texte, images | Non | API OpenAI, bêta publique | Non listé |
| Strands Decider 2B | AWS Strands Labs | Gratuit à auto-héberger | Exécuté à 3 072 à 4 096 | Texte | Oui, Apache 2.0 | Votre propre matériel | 21,75 (84e) |
Sources : la documentation de chaque éditeur (par exemple la page Clef de Cloudflare et le guide Decisions d'OpenAI) et les données du Decision Index du 10 octobre.
Quelques points ressortent. Microsoft a aligné exactement le prix de Jev, et seul Clef-flash est moins cher par token. Clef et l'API d'OpenAI acceptent les images, pas Microsoft. Et OpenAI appelle son type oui/non predicate plutôt que noul, passer de l'un à l'autre n'est donc pas un simple changement d'URL. J'ai traité les coûts de cette API dans mon détail des tarifs de la Decisions API.
La comparaison de prix dans l'article même de Microsoft a suscité des critiques. Le graphique de coûts de Microsoft place Microsoft-Decision-1 à environ 11 $ par million de textes classés contre environ 2 434 $ pour GPT-6 Sol. Un commentateur HN a relevé ce qui manque :
« Microsoft ne compare le prix du sien qu'à GPT Sol(!), pas à GPT Terra, ni à GPT Luna (sur lequel repose le clone de Jev d'OpenAI), et certainement pas à Jev (4/10 du coût de Luna). »
Remarque juste. Face à un modèle généraliste comme GPT-6 Luna, tout modèle de décision paraît bon marché. Face à ses vrais pairs, Microsoft-Decision-1 est au même prix, pas moins cher. Si vous pesez tout le champ, mon tour d'horizon des alternatives à Jev passe modèle par modèle.
Microsoft-Decision-1 est-il le bon choix pour votre usage ?
Choisissez la situation la plus proche de la vôtre.
Si la vitesse brute est votre critère principal, mon article sur Jev Ultrafast couvre l'offre à faible latence de TypeSafe, le concurrent le plus proche de l'argument de vitesse de Microsoft.
Que signifie Microsoft-Decision-1 pour les équipes de support ?
Le support est le cas d'usage vers lequel tout le monde se tourne en premier, et à juste titre. Le tri des tickets est un tas de petites questions bornées à réponses fixes. La classification d'intention est une question choice. L'urgence et l'analyse de sentiment sont des scores sur une échelle fixe. « Un humain devrait-il voir ceci ? » est un oui/non, le cœur de l'escalade par IA. Microsoft-Decision-1 peut répondre à tout cela en un appel pour une fraction de centime.
Voici ce que je voudrais que chaque responsable du support sache avant de s'enthousiasmer : le tri est la partie qui marche déjà bien.
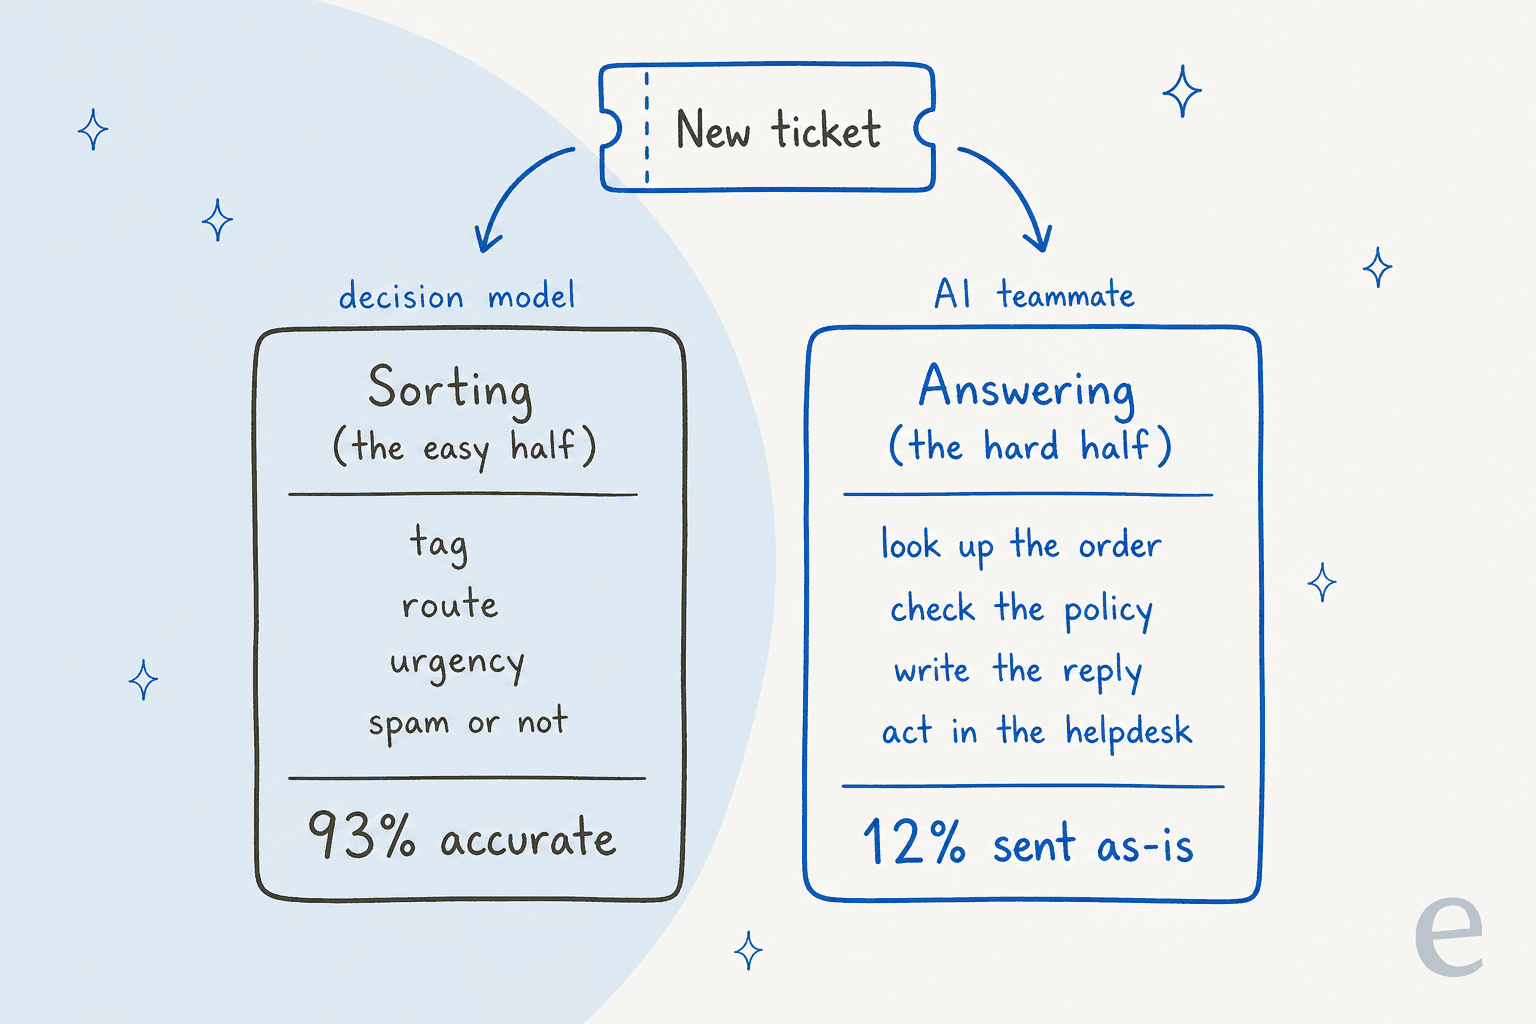
Ces chiffres viennent d'un essai à validation croisée que j'ai vu, sur du trafic Zendesk réel dans une entreprise de e-commerce. Le tri par IA était précis à 93% et a attrapé 100% du spam, qui représentait 22% de la boîte de réception, avec zéro faux positif. Les réponses rédigées allaient dans la bonne direction 88% du temps. Mais seulement 12 % sont parties sans modification, et 7 % contenaient une erreur factuelle. L'étiquette était facile. La réponse était le vrai travail.
Cela rejoint ce que les acheteurs d'eesel disent vouloir. Une responsable CX qui gère 7 000 tickets par mois l'a formulé ainsi lors d'un appel :
« L'IA ne pourra jamais répondre à 100 % des questions, mais si elle essaie et répond juste "désolé, je ne sais pas", je ne peux pas aller vérifier mes 7 000 tickets pour voir si l'IA a vraiment bien répondu. »
Ce qu'elles demandent, c'est d'abord une décision assurée (est-ce un cas que je peux traiter ?), puis une action. Un modèle de décision fournit la première partie sous forme de nombre. Transformer ce nombre en étiquette dans Zendesk, en réaffectation, en remboursement retenu pour approbation et en réponse dans la voix de votre marque, c'est tout ce qui entoure le modèle. C'est pourquoi je traiterais Microsoft-Decision-1 comme un composant pour les équipes qui construisent leur propre routage de tickets par IA, pas comme un outil de support en soi.
Si vous le construisez vous-même, un ordre raisonnable est :
- Commencez par les questions auxquelles vos trieurs répondent déjà. Équipe, urgence, spam, niveau de priorisation des tickets. Écrivez-les comme des questions
choiceetscoreavec les mêmes libellés que votre helpdesk. - Rejouez un mois d'anciens tickets. Comparez les choix du modèle à ce que votre équipe a réellement fait, par libellé, pas en une seule moyenne.
- Fixez un seuil par question. Routez automatiquement au-dessus, envoyez à un humain en dessous, et journalisez les deux.
- Gardez des règles simples là où elles marchent. Si « remboursement » dans l'objet signifie toujours facturation, les règles de routage Zendesk sont gratuites et ne dérivent jamais.
- Décidez qui écrit la réponse. C'est la partie qu'un modèle de décision ne sait pas faire, et celle que vos clients voient réellement.
Pour un panorama plus large des options, mon tour d'horizon des outils de tri par IA compare ce qui est intégré aujourd'hui dans chaque helpdesk, et le guide pour automatiser le tri des tickets déroule la mise en place de bout en bout.
Essayez eesel pour le tri des tickets et les réponses
Microsoft-Decision-1 est une infrastructure : un moyen rapide et peu coûteux pour votre code de prendre une décision. eesel est l'employé qui prend la décision puis fait le travail. Le coéquipier helpdesk IA rejoint votre file existante via l'intégration Zendesk, Freshdesk ou Gorgias. Il étiquette, route et escalade, puis rédige la réponse à partir de votre centre d'aide et de vos anciens tickets.
La répartition à laquelle cet article revient sans cesse est déjà intégrée. Chaque automatisation a un réglage « Puissance du modèle », avec « un modèle plus léger pour les tâches simples comme l'étiquetage ou le routage » et le modèle habituel pour la rédaction (documentation eesel). Chaque action peut être réglée sur Auto, Approbation requise ou Désactivée, et les événements que l'agent décide d'ignorer sont journalisés avec une raison. Avant que quoi que ce soit ne passe en production, vous pouvez simuler l'agent sur vos propres anciens tickets et voir où il aurait coïncidé avec les réponses de votre équipe.

Si vous préférez le configurer depuis un terminal, la CLI eesel exécute le même coéquipier que le tableau de bord. Chaque commande affiche du JSON, de sorte que Claude Code, Codex ou Cursor peuvent piloter toute la configuration. Une commande comme eesel automations enable <platform> <key> --instructions "..." met en place une règle de tri en mots simples, eesel approvals liste les actions retenues à approuver ou refuser, et --dry-run vérifie une écriture avant qu'elle n'ait lieu. J'ai expliqué pourquoi c'est important dans mon article sur la CLI d'agent.
La tarification est un forfait mensuel fixe de crédits : un ticket vaut un crédit quel que soit le travail qui s'y déroule, à partir de 299 $ par mois pour 500 crédits, et vous recevez 100 crédits gratuits pour essayer sans carte. Connectez votre helpdesk, pointez-le sur les tickets du mois dernier et voyez comment il les trie et ce qu'il aurait répondu. Essayez eesel.
Questions fréquentes
Qu'est-ce que Microsoft-Decision-1 ?
Microsoft-Decision-1 est un modèle de décision que Microsoft a lancé le 9 octobre 2026. Vous lui donnez un texte et un ensemble d'options de réponse fixes, et il renvoie une probabilité calibrée pour chaque option en JSON au lieu d'écrire du texte. C'est l'un des membres d'un groupe en pleine croissance de modèles de décision conçus pour les appels de routage, de classification et de vérification.
Sur quoi repose Microsoft-Decision-1 ?
Microsoft indique avoir post-entraîné le modèle à poids ouverts Qwen3.5-9B d'Alibaba pour noter les décisions en une seule passe, et prévoit de le rebaser plus tard sur des modèles Microsoft AI (MAI) et OpenAI. La famille Qwen se trouve aussi sous Clef-flash de Cloudflare et Strands Decider d'AWS.
Combien coûte Microsoft-Decision-1 ?
Microsoft-Decision-1 coûte 0,042 $ par million de tokens d'entrée et les tokens de sortie sont gratuits, soit le même tarif affiché que Jev. La page de tarification Foundry d'Azure n'a pas encore de ligne pour lui. Pour le calcul des coûts du concurrent, consultez mon détail des tarifs de Jev.
Microsoft-Decision-1 est-il meilleur que Jev ?
Dans le propre tableau de 36 benchmarks de Microsoft, Microsoft-Decision-1 atteint en moyenne 83,5 % de précision contre 82,3 % pour Jev 1.13.0, tandis que Jev obtient un meilleur score de calibration (93,7 contre 92,2). Aucun classement indépendant n'a encore noté Microsoft-Decision-1, considérez donc cette avance comme une affirmation. Mon test de Jev explique ce que Jev fait bien.
Microsoft-Decision-1 peut-il trier des tickets de support ?
Oui. Les décisions d'urgence, d'équipe et de sentiment sont exactement les questions à options fixes pour lesquelles il est conçu, et la requête d'exemple d'OpenRouter est un message de support. Il faut toutefois encore quelque chose pour appliquer l'étiquette, déplacer le ticket et rédiger la réponse, ce qui est le travail d'un coéquipier helpdesk IA. Voir comment automatiser le tri des tickets pour le déroulé complet.
Microsoft-Decision-1 explique-t-il ses décisions ?
Non. La fiche du modèle de Microsoft indique qu'il ne traite que du texte et ne génère ni explications ni justifications. Si vous avez besoin d'une raison pour chaque décision, pour une piste d'audit ou une escalade vers un humain, vous devez journaliser vous-même les entrées et les options, ou utiliser un LLM pour cette étape.
Les poids de Microsoft-Decision-1 sont-ils ouverts ?
Non. Il n'existe pas de dépôt Hugging Face pour Microsoft-Decision-1, et Microsoft n'a publié ni licence ni option d'auto-hébergement. Si vous avez besoin de poids ouverts, Clef de Cloudflare et Strands Decider d'AWS sont sous licence Apache 2.0.
Comment utiliser Microsoft-Decision-1 ?
Il y a deux voies : le déployer depuis le catalogue Microsoft Foundry, où il est vendu directement par Azure et facturé sur votre abonnement Azure, ou l'appeler via la Decisions API d'OpenRouter avec l'identifiant de modèle microsoft/microsoft-decision-1. Les SDK de chat completions ne fonctionnent pas avec lui, prévoyez donc une requête typée, comme pour TypeSafe Jev.