

J’attribue à Kimi K3.1 Pro la note de 3,5 sur 5 : il raisonne presque aussi bien que Claude Opus 5.5, avec un score de 55.1 à l’Artificial Analysis Intelligence Index (#4 sur 215), à 2 $ en entrée et 10 $ en sortie par million de tokens. Pour les longues tâches d’agent que vous pouvez laisser tourner sans surveillance, c’est actuellement le meilleur rapport qualité-prix près du sommet du classement.
Il perd des points sur son fonctionnement, pas sur son intelligence. Il est lent, à environ 50 tokens par seconde, il rédige de longues réponses qui grignotent l’avantage du prix bas, les poids ouverts sont promis "by Nov 4" mais ne sont pas encore disponibles, et des abonnés à Kimi Code disent épuiser leur quota de 5 heures en moins d’une heure. Utilisez-le via l’API pour les tâches qui peuvent attendre ; évitez-le dès qu’une personne attend le résultat.
Si vous êtes ici pour choisir un modèle destiné à un agent de support, le modèle est la partie la moins importante de la décision. Je développe les intégrations et les API d’eesel, et après des années à faire fonctionner de l’IA sur de vraies files de tickets de support, ce qui détermine la qualité, c’est la configuration autour du modèle. SamCart utilise eesel sur ses tickets Freshdesk et le chat de son site web, avec des réponses tirées de 280 articles du centre d’aide, sans jamais se soucier du modèle qui dominait le classement cette semaine-là.
Qu’est-ce que Kimi K3.1 Pro ?
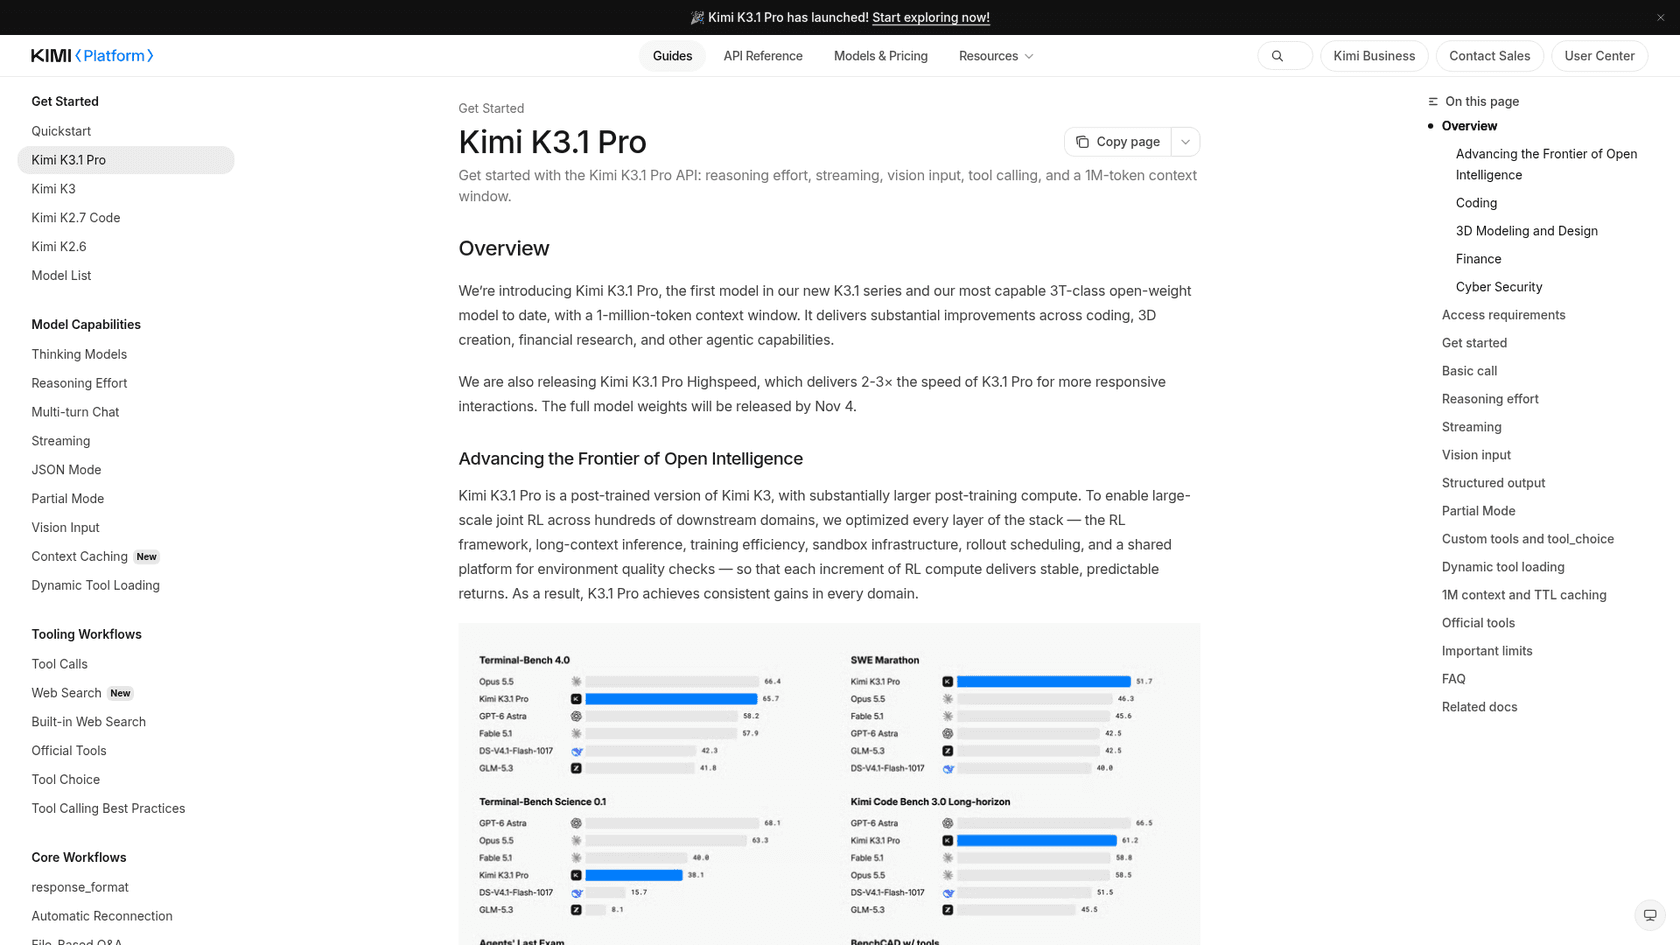
Kimi K3.1 Pro est le modèle phare de Moonshot AI, lancé le 23 octobre 2026. Moonshot le décrit comme "a post-trained version of Kimi K3, with substantially larger post-training compute" dans son article de lancement : il repose donc sur la même base de 2.8T paramètres que Kimi K3 (104B actifs, mélange d’experts), avec beaucoup plus d’entraînement supplémentaire, ainsi qu’une fenêtre de contexte de 1M tokens.
Il est disponible dans l’application Kimi, Kimi Work, Kimi Code et l’API Kimi, et c’est désormais le modèle par défaut dans la fenêtre de chat sur kimi.com. Si vous voulez tous les détails du lancement (benchmarks, comparaison avec K3, moyens d’accès), ma présentation de Kimi K3.1 Pro les couvre. Cet article donne mon verdict, dans le même format que mon précédent avis sur Kimi K3.
Comment ai-je testé et noté Kimi K3.1 Pro ?
J’ai lu l’article de lancement de Moonshot, le guide de démarrage rapide de l’API et la page des tarifs, puis j’ai passé en revue les résultats indépendants d’Artificial Analysis et la première vague de tests pratiques, dont le fil Hacker News de 674 commentaires. Le modèle a quatre jours, je ne vais donc pas prétendre l’avoir utilisé en production pendant des mois. Ce que je peux faire, c’est le noter sur les critères qui déterminent s’il vaut la peine de construire une solution dessus.
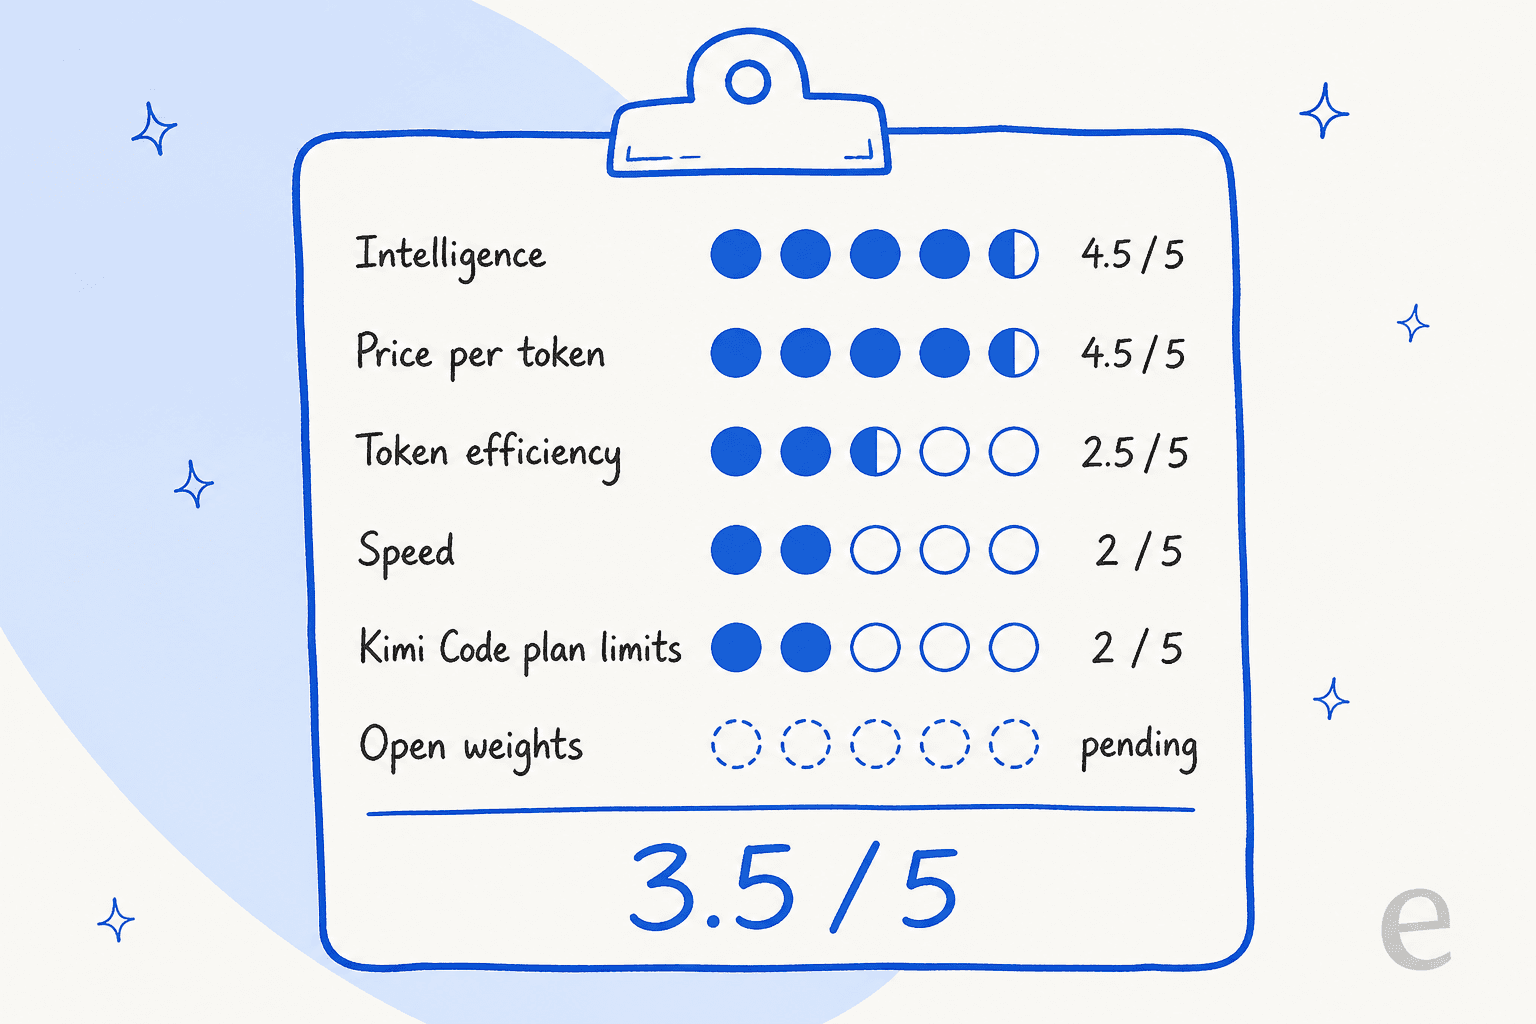
| Catégorie | Note | Pourquoi |
|---|---|---|
| Intelligence | 4,5/5 | 55.1 à l’indice AA, 2.5 points derrière Opus 5.5 (Max) |
| Prix par token | 4,5/5 | 2 $ / 10 $, un tiers moins cher que K3, sans supplément pour les longs contextes |
| Efficacité en tokens | 2,5/5 | 150M tokens de sortie pour exécuter l’indice AA contre une médiane de 87M chez les modèles comparables |
| Vitesse | 2/5 | 49.7 tokens par seconde, rang 165 sur 182 |
| Limites des forfaits Kimi Code | 2/5 | Plusieurs abonnés disent atteindre le plafond de 5 heures en moins d’une heure |
| Poids ouverts | En attente | Promis pour le 4 novembre, non publiés au 27 octobre |
| Note globale | 3,5/5 | Un moteur puissant, mais des contraintes d’utilisation encore gênantes |
Quels sont les points forts de Kimi K3.1 Pro ?
En bref : jamais un laboratoire non américain ne s’était autant approché du sommet du classement, et ce à un prix de milieu de gamme. Voici où cela se voit.
Un raisonnement proche des meilleurs pour 2 $ et 10 $
Sur Artificial Analysis, K3.1 Pro obtient 55.1, contre 57.6 pour Claude Opus 5.5 (Max) et 56.0 pour Claude Sonnet 5.5 (Max). Il se place au-dessus de GPT-6 Astra (Max) à 52.7 et de Gemini 4 Argon (High) à 52.6. Sur la même version de l’indice, Kimi K3 obtient 43.6 : cette version représente donc un bond de plus de 11 points à partir du même modèle de base.
C’est le prix qui rend cela intéressant. K3.1 Pro est affiché à 2 $ en entrée, 0,20 $ en entrée mise en cache et 10 $ en sortie par million de tokens sur l’API Kimi, soit un tiers de moins que les tarifs de Kimi K3 et le même tarif catalogue que Sonnet 5.5. Il a exécuté l’intégralité de l’indice Artificial Analysis pour $3,117, contre $8,708 pour Opus 5.5 (Max).
Les longues tâches d’agent et le travail bureautique
C’est là que l’entraînement supplémentaire se remarque. Artificial Analysis a mesuré 67.2% sur Terminal-Bench 4.0, le meilleur résultat de tous les modèles représentés sur sa page K3.1 Pro, contre 12.6% pour K3. Dans les propres tests de Moonshot, il arrive en tête sur SWE Marathon (51.7 contre 46.3 pour Opus 5.5) et sur OfficeQA Pro v2 (64.4 contre 62.2), un benchmark consacré à la finance et aux documents bureautiques.
Il invente aussi moins de choses que K3. Sur le test interne Hallu Bench de Moonshot, le taux d’hallucination par affirmation sur les questions difficiles avec outils est passé de 23.4% à 8.3%. C’est un test de Moonshot, donc je lui accorde un poids limité, mais le chiffre indépendant va dans le même sens : le taux d’hallucination d’AA est de 43.9% pour K3.1 Pro, contre 53.2% pour K3 et 58.6% pour Opus 5.5 (Max).
Les premiers retours pratiques concordent. Un développeur est passé directement de K3 à ce modèle :
"Using it now via API (3.1 Pro on Open Router) in a HITL setup (Cline in VSCode). Off-hand it's quite good. I've been using K3 for the past few months almost exclusively for coding work and have been stunned by how good it is. Excited to see how far 3.1 Pro can be pushed."

Une fenêtre de contexte de 1M à tarif uniforme
Le guide de démarrage rapide indique que K3.1 Pro applique une tarification uniforme à l’usage, sans paliers selon la longueur du contexte : un prompt de 900 000 tokens coûte donc autant par token qu’un prompt court. L’entrée mise en cache est facturée 0,20 $ par million, soit une réduction de 90 %, avec un cache de 5 minutes par défaut et une option de 1 heure. Pour les agents qui relisent une grosse base de code ou un long contrat à chaque échange, cela représente de réelles économies.
Quelles sont les limites de Kimi K3.1 Pro ?
Tout ce qui lui a coûté des points se situe autour du modèle, pas dans le modèle lui-même. Voici les cinq problèmes qui pourraient changer ma décision de construire une solution dessus aujourd’hui.
Il est lent
Artificial Analysis a mesuré 49.7 tokens de sortie par seconde sur la propre API de Moonshot, au rang 165 sur 182, et l’a qualifié de "notably slow". Une tâche moyenne de son indice de benchmarks a pris 1,011 secondes, soit environ 17 minutes. La solution de Moonshot est Kimi K3.1 Pro Highspeed, qui, selon l’entreprise, fonctionne à "2-3× the speed" pour exactement le double du prix (4 $ / 20 $).
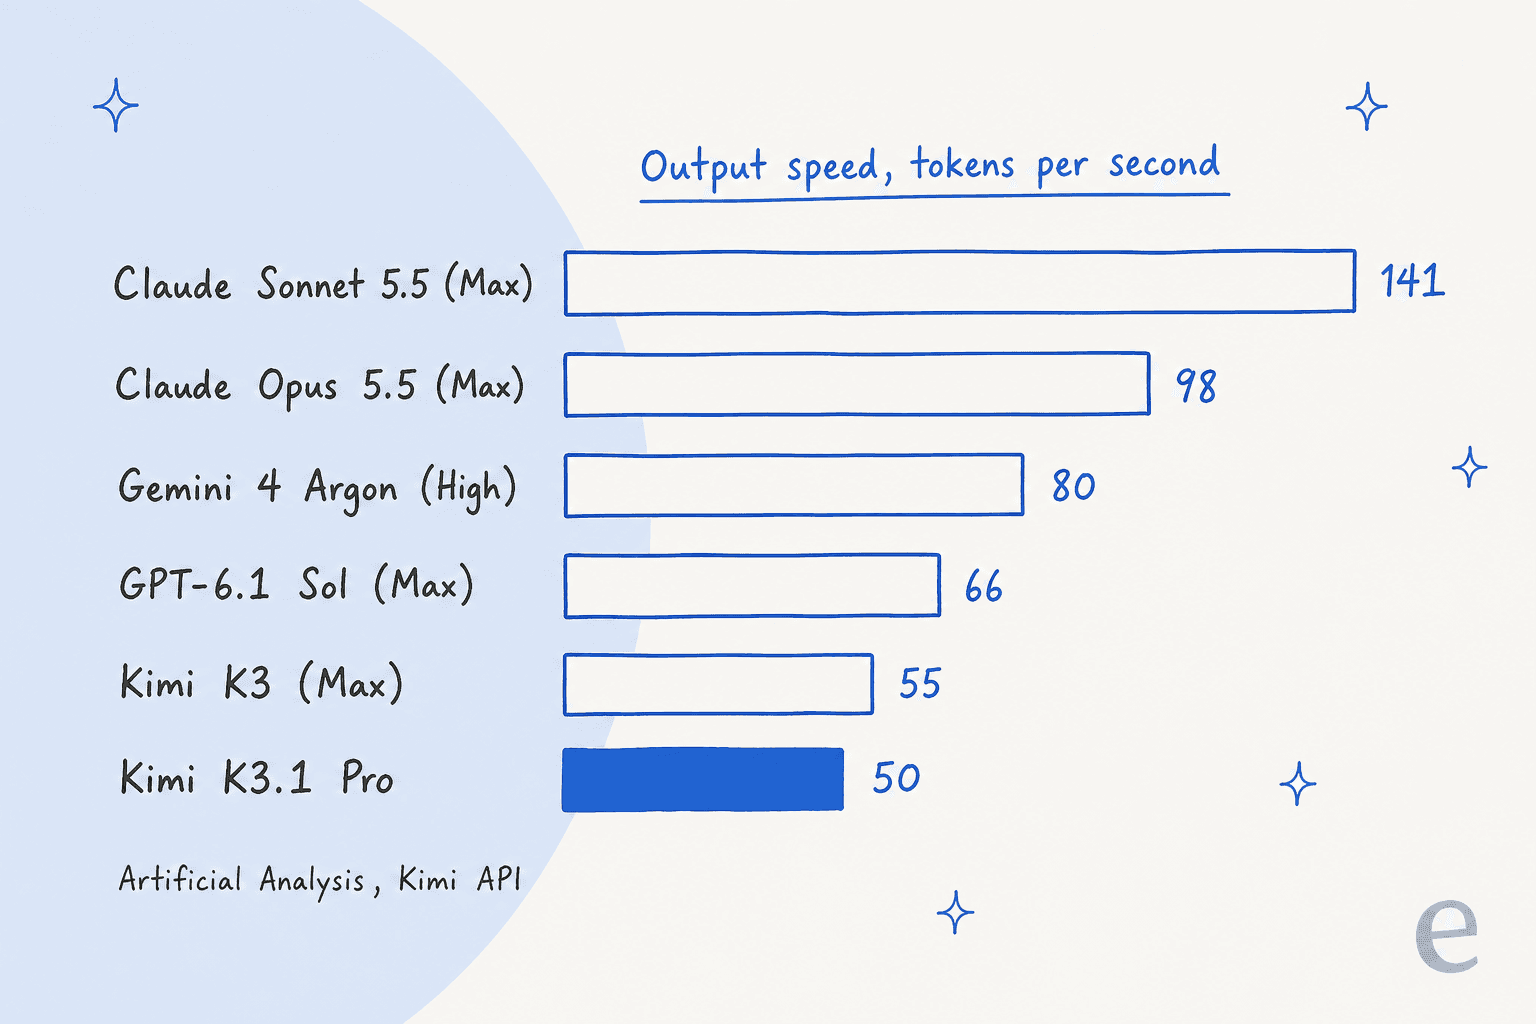
Sonnet 5.5 coûte autant par token et génère ses réponses en streaming presque trois fois plus vite. Pour un traitement par lots qui tourne toute la nuit, 50 tokens par seconde n’ont pas d’importance. Pour une fenêtre de chat qu’une personne regarde en attendant, si.
Il écrit beaucoup
K3.1 Pro a utilisé 150M tokens de sortie pour exécuter l’indice Artificial Analysis, contre une médiane de 87M chez les modèles comparables. L’essentiel correspond au raisonnement : 34,883 tokens de raisonnement par tâche en moyenne. La réduction du prix par token ne se répercute donc pas entièrement sur la facture. Par tâche, il a coûté en moyenne $2.11 contre $2.00 pour K3, alors que K3 est affiché à 3 $ / 15 $. Je détaille ce calcul dans l’article sur les tarifs de Kimi K3.1 Pro.
"So their base price is 1/5th of Opus 5.5 per token, but if you want "highspeed" it's 2x that and then I guess it generates 2x the number of tokens as well? That might suggest that Opus is competitively priced after all."
Le levier dont vous disposez est reasoning_effort. L’API prend en charge low, high et max, et la page des clés API indique max comme valeur par défaut. Tous les résultats de benchmarks ci-dessus ont été obtenus avec max : réduire l’effort revient donc à sacrifier du score pour économiser des tokens.
Les quotas de Kimi Code s’épuisent vite
La plainte la plus forte dans le fil de lancement ne porte pas sur la qualité, mais sur le quota. La page Kimi Code de Kimi affiche Plus à 19 $, Pro à 39 $, Max à 99 $ et Ultra à 199 $ par mois, et Highspeed nécessite Pro ou un forfait supérieur et consomme deux fois plus de crédits. Les nouveaux forfaits conservent une fenêtre glissante de 5 heures ainsi qu’une réserve mensuelle de crédits partagée avec l’application Kimi.
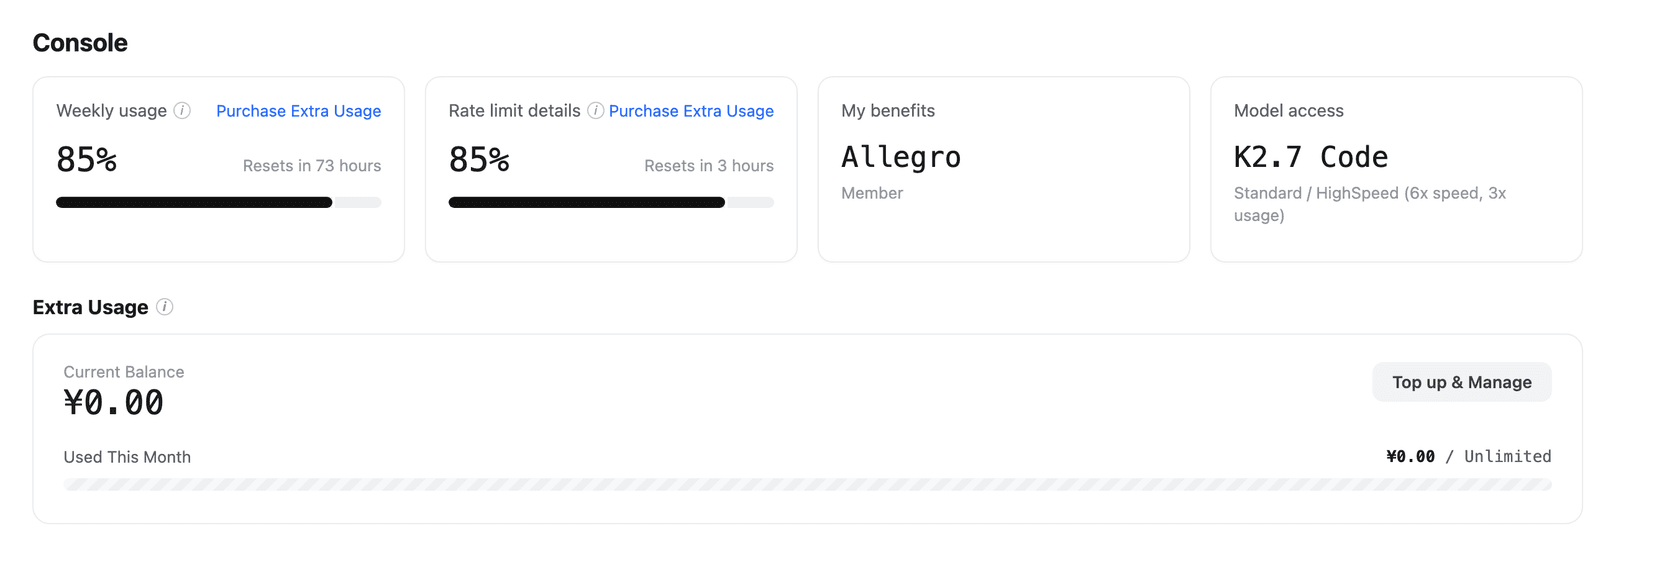
"If you are expecting any sort of usable limits on their subscription plan I suggest adjusting your expectations. I subscribed to $99 a month plan and within 47 minutes with one session (not asking for swarms or anything) was limited by 5-hour quota."
Tout le monde n’a pas atteint la limite, et l’effort maximal par défaut explique en partie la situation, puisqu’il consomme les tokens plus vite. Malgré tout, si vous venez de Claude Code et vous attendez à la même marge d’utilisation par dollar, testez le forfait mensuel pendant une semaine avant de payer pour un an.
Les poids ne sont pas encore disponibles
Moonshot décrit K3.1 Pro comme son "most capable 3T-class open-weight model", et l’article comme le guide de démarrage rapide indiquent que l’ensemble des poids sera publié d’ici le 4 novembre. Le 27 octobre, l’API des modèles Hugging Face ne renvoyait aucun dépôt K3.1 sous le compte de Moonshot, et Artificial Analysis indique pour l’instant une licence propriétaire.
Cela compte pour deux raisons. Vous ne pouvez pas encore l’auto-héberger ni l’affiner, et seul Moonshot l’héberge : la fiche OpenRouter affiche deux points de terminaison, tous deux appartenant à Moonshot. Artificial Analysis recense 5 fournisseurs d’API pour K3.1 Pro contre 20 pour K3. Même lorsque les poids seront disponibles, un modèle de 2.8T paramètres nécessite une grappe de serveurs, pas une station de travail.
Certains benchmarks mis en avant sont internes
Plusieurs des affirmations les plus fortes de Moonshot proviennent de tests internes : Kimi Code Bench, Hallu Bench, les benchmarks financiers et l’évaluation de cybersécurité. Ses benchmarks de programmation ont été exécutés dans l’environnement de test de Claude Code, ce qu’un compte X très suivi a remis en question le jour du lancement. Les résultats indépendants d’Artificial Analysis restent solides, donc je ne pense pas que ces benchmarks soient sans valeur. Je ferais simplement confiance aux résultats indépendants en premier.
Comment Kimi K3.1 Pro se compare-t-il à Claude, GPT et Gemini ?
Tous les chiffres ci-dessous proviennent de la page K3.1 Pro d’Artificial Analysis, mesurés sur la propre API de chaque fournisseur, ce qui permet une comparaison à conditions équivalentes.
| Modèle | Indice AA | Prix entrée / sortie (par 1M) | Vitesse (tokens/s) | Coût par tâche | Coût d’exécution de l’indice | Terminal-Bench 4.0 |
|---|---|---|---|---|---|---|
| Claude Opus 5.5 (Max) | 57.6 | 4 $ / 20 $ | 98.1 | $5.98 | $8,708 | 59.6% |
| Claude Sonnet 5.5 (Max) | 56.0 | 2 $ / 10 $ | 141.3 | $5.46 | $7,260 | 63.6% |
| Kimi K3.1 Pro | 55.1 | 2 $ / 10 $ | 49.7 | $2.11 | $3,117 | 67.2% |
| Claude Fable 5.1 (Max) | 53.4 | 10 $ / 50 $ | 69.8 | $7.63 | $13,129 | 52.0% |
| GPT-6 Astra (Max) | 52.7 | 10 $ / 50 $ | 66.7 | $3.26 | $5,324 | 59.1% |
| Gemini 4 Argon (High) | 52.6 | 2 $ / 10 $ | 79.7 | $1.62 | $2,101 | 57.1% |
| GPT-6.1 Sol (Max) | 51.8 | 2 $ / 10 $ | 65.9 | $0.72 | $1,082 | 56.1% |
| DeepSeek V4.1 Flash 1017 (Max) | 45.1 | 0,30 $ / 1,20 $ | 169.3 | $0.26 | $445 | 33.8% |
| Kimi K3 (Max) | 43.6 | 3 $ / 15 $ | 54.5 | $2.00 | $3,658 | 12.6% |
Deux choses sautent aux yeux. D’abord, parmi les modèles qui obtiennent 55 ou plus, K3.1 Pro est de loin le moins cher à utiliser. Ensuite, ce n’est pas le modèle intelligent le moins cher dans l’ensemble : GPT-6.1 Sol et Gemini 4 Argon se situent à trois ou quatre points près, pour une fraction du coût par tâche. Le créneau idéal de K3.1 Pro, c’est « presque au niveau de Claude, pour un tiers de la facture Claude », pas « le moins cher qui fait le travail ».
Sur le ressenti, les testeurs s’accordent pour la plupart à dire qu’Opus conserve un avantage que les benchmarks ne captent pas :
"I feel Opus still nails the subtle details better, like in the tractor example below. But I wonder if it matters when you can run Kimi 3x before it costs the same as one Opus?"
"TLDR: Kimi is a good model, especially for visual work, but I still find Opus 5.5 more useful for general-purpose tasks and white-collar work."
Si vous le comparez précisément à d’autres modèles ouverts, mes comparatifs Qwen 3.8 Max vs K3 et DeepSeek V4 Flash vs K3 décrivent toujours le paysage général, et la liste des alternatives à Kimi K3 constitue une bonne sélection de départ.
Que vaut l’API de Kimi K3.1 Pro pour développer une solution ?
Côté intégration, le domaine dans lequel je passe mes journées, c’est une API bien conçue avec quelques pièges. Les identifiants des modèles sont kimi-k3.1-pro et kimi-k3.1-pro-highspeed, et la documentation couvre le streaming, l’entrée visuelle, les appels d’outils, la sortie structurée et une fonctionnalité "Dynamic tool loading".
Ce que je voudrais savoir avant d’écrire une ligne de code :
- L’accès se débloque après une recharge de 1 $, et votre limite de débit dépend du montant total de vos recharges. Au palier de 1 $, vous disposez de
3requêtes par minute ; il faut$10cumulés pour atteindre100RPM, selon la page des limites de débit. - Il n’y a pas de réduction pour le traitement par lots sur K3.1 Pro. L’API de traitement par lots de Kimi coûte 60 % du tarif standard, mais elle ne couvre que les modèles de la série K2.
- Le raisonnement est toujours activé, et
max_completion_tokensvaut131,072par défaut. Prévoyez un budget pour les longues réponses. - Zero Data Retention est disponible pour les clients de l’API, selon l’article de lancement.
- Les modèles K2 sont en cours de retrait. Les nouveaux utilisateurs perdent l’accès à K2 à partir du 31 octobre 2026, et l’arrêt de tous les modèles K2 est prévu d’ici la fin décembre. Si vous utilisez Kimi K2.7 Code, vous devrez donc migrer de toute façon.
Si vous cherchez surtout un modèle capable pour créer des prototypes à petit prix, ma sélection d’API d’IA gratuites mérite un coup d’œil avant de recharger un compte où que ce soit.
Qui devrait utiliser Kimi K3.1 Pro ?
Choisissez-le si vous exécutez de longues tâches sans surveillance où la qualité compte et où personne n’attend : sessions de programmation agentiques, rapports de recherche, travail financier reposant largement sur des tableurs, traitement de documents sur d’immenses contextes. Vous obtenez une qualité proche d’Opus pour environ un tiers du coût d’exécution, sans supplément pour les longs contextes.
Évitez-le si une personne attend chaque réponse. À 50 tokens par seconde, le chat en direct et les échanges rapides de programmation semblent lents, et Highspeed double le prix pour y remédier. Évitez-le aussi si votre priorité est le coût : GPT-6.1 Sol et Gemini 4 Argon accomplissent les mêmes tâches de benchmark pour moins cher. Et si vous avez besoin de poids que vous pouvez exécuter vous-même aujourd’hui, restez sur K3 jusqu’à ce que le 4 novembre confirme que Moonshot tient sa promesse.
Le facteur décisif, c’est la patience. K3.1 Pro est conçu pour les tâches que vous lancez avant de passer à autre chose.
Une équipe de support devrait-elle faire fonctionner son agent IA sur Kimi K3.1 Pro ?
Cette question revient chaque fois qu’un nouveau modèle prend la tête d’un classement, et je pense que ce n’est pas la bonne première question à poser. Kimi K3.1 Pro est une infrastructure. Pour répondre à un seul ticket avec lui, il vous faudrait encore le connecter à votre outil de support, synchroniser votre centre d’aide et vos anciens tickets, décider de ce qu’il fait seul et de ce qu’il transmet à une personne, puis le tester avant qu’un client ne voie une réponse. eesel est l’employé qui s’appuie sur des modèles comme celui-ci.
Le problème de vitesse touche aussi le support plus durement que la plupart des usages. Un client dans une fenêtre de chat n’attendra pas qu’un modèle écrive 35 000 tokens de raisonnement. Pour le support, un modèle rapide avec une bonne recherche d’informations fait généralement mieux qu’un modèle plus intelligent, mais plus lent.
Et dans le support, les mauvaises réponses ne viennent généralement pas du modèle. Un exemple tiré des propres appels commerciaux d’eesel : une équipe de support en télématique automobile utilisant Zendesk a vu son bot dire aux clients "yes, we support your car model" pour des marques non prises en charge, parce que sa base de connaissances indiquait "we support all models". Aucun bond dans un classement ne corrige cela. La solution consiste à empêcher les hallucinations au niveau des connaissances et à simuler l’agent sur de vrais tickets passés avant le lancement. C’est pourquoi eesel teste d’abord chaque déploiement sur l’historique des tickets de l’équipe.
C’est cette couche que prend en charge le coéquipier IA de support d’eesel. SamCart montre à quoi cela ressemble en pratique. L’entreprise utilise eesel sur ses tickets Freshdesk et sur le chat de son site web, avec un agent distinct pour chaque canal, tous deux répondant à partir des mêmes 280 articles de son centre d’aide. Sur Freshdesk, l’agent envoie la première réponse uniquement tant qu’aucune personne n’est assignée, se met en retrait dès qu’un coéquipier prend le ticket en charge, et ajoute une étiquette au ticket pour le transfert lorsqu’un vendeur demande à parler à un humain. L’espace de travail fait désormais fonctionner 4 agents, dont un pour un deuxième produit lancé par SamCart en 2026.
Si c’est l’approche centrée sur l’agent et le terminal d’outils comme Kimi Code qui vous attire, la CLI d’eesel l’apporte au support. Vous pilotez le même coéquipier depuis un terminal : eesel activity pour consulter ce qu’il a fait, eesel approvals pour approuver ou refuser les actions en attente, eesel instructions pour modifier ses règles permanentes. Les commandes affichent du JSON et les commandes d’écriture prennent en charge --dry-run, ce qui permet aux scripts et aux agents de programmation de le piloter en toute sécurité. Un serveur MCP est également disponible. J’approfondis le sujet dans mon guide de la CLI d’agent IA.
Essayez eesel
Si vous cherchez un modèle parce que vous voulez qu’une IA réponde aux tickets de votre support, sautez une étape. Le coéquipier IA de support d’eesel se connecte à Freshdesk, Zendesk ou Gorgias, apprend à partir de votre centre d’aide et de vos anciens tickets, et vous montre comment il aurait répondu aux tickets du mois dernier avant de toucher à un ticket réel.
Essayez eesel gratuitement sur votre propre file de tickets, ou comparez-le d’abord aux autres meilleurs coéquipiers IA. Si vous hésitez encore entre recruter une IA et en créer une, mon article explicatif sur l’employé IA présente la différence.
Questions fréquentes
Kimi K3.1 Pro est-il performant ?
Oui, pour les bonnes tâches. Dans mon évaluation de Kimi K3.1 Pro, je lui donne 3,5 sur 5 : il obtient 55.1 sur l’Artificial Analysis Intelligence Index, proche de Claude Opus 5.5, à 2 $/10 $ par million de tokens. Il perd des points pour sa génération lente, ses réponses longues et les limites des forfaits dans Kimi Code. La présentation de Kimi K3.1 Pro couvre son lancement en détail.
Kimi K3.1 Pro est-il meilleur que Claude Opus 5.5 ?
Pas dans l’ensemble. Opus 5.5 (Max) obtient 57.6 sur Artificial Analysis contre 55.1, et il est environ deux fois plus rapide. Kimi K3.1 Pro l’emporte sur le coût : il a exécuté l’ensemble des benchmarks de l’indice pour 3 117 $ contre 8 708 $ pour Opus 5.5 (Max). Mon avis sur Claude Opus 5.5 présente l’autre côté de cette comparaison.
Combien coûte Kimi K3.1 Pro ?
Sur l’API Kimi, il coûte 2 $ par million de tokens d’entrée, 0,20 $ pour les entrées en cache et 10 $ par million de tokens de sortie. La version Highspeed est à 4 $ et 20 $. Les forfaits de l’application Kimi vont de 19 $ à 199 $ par mois. Vous trouverez le détail complet dans mon guide des tarifs de Kimi K3.1 Pro.
Pourquoi Kimi K3.1 Pro est-il si lent ?
Artificial Analysis a mesuré 49.7 tokens de sortie par seconde sur l’API Kimi, soit la place 165 sur 182, et le modèle rédige aussi de longs raisonnements avant de répondre. Une tâche de benchmark prenait en moyenne environ 17 minutes. Kimi K3.1 Pro Highspeed est 2-3x plus rapide pour un prix deux fois plus élevé. Si la vitesse compte avant tout, Claude Sonnet 5.5 tourne à 141 tokens par seconde pour le même tarif catalogue.
Kimi K3.1 Pro est-il open source ?
Pas encore. Moonshot annonce que l’intégralité des poids sera publiée d’ici le 4 novembre 2026, mais au 27 octobre, il n’y avait ni dépôt Hugging Face ni licence. Kimi K3 est le modèle ouvert que vous pouvez télécharger aujourd’hui, et ma liste d’agents IA open source présente d’autres options.
Kimi K3.1 Pro vaut-il le coup pour coder ?
Pour les longues tâches de programmation sans supervision, oui : il a obtenu 67,2 % sur Terminal-Bench 4.0 sur Artificial Analysis et 51.7 sur SWE Marathon dans les tests de Moonshot. Pour la programmation en binôme en direct, la lenteur de génération gêne le travail, et les utilisateurs de Kimi Code signalent qu’ils atteignent vite la limite de 5 heures. Comparez-le à Claude Code avant de vous abonner.
Puis-je utiliser Kimi K3.1 Pro pour un agent IA de support client ?
Vous pouvez, mais le modèle ne représente qu’une petite partie du travail. Il vous faut encore une connexion à votre outil de support, des règles de transfert et des tests sur vos anciens tickets, et à 50 tokens par seconde, les réponses en chat en direct sembleraient lentes. Un agent IA de support prêt à l’emploi comme eesel gère cette couche pour vous : c’est ainsi que SamCart prend en charge les premières réponses sur Freshdesk.