En bref
Claude Sonnet 5.5 coûte 2 $ par million de tokens en entrée et 10 $ par million de tokens en sortie, comme Sonnet 5 et exactement la moitié de Claude Opus 5.5 sur l'entrée, la sortie, les écritures de cache et le Batch. Il n'y a aucun supplément de contexte long sur toute la fenêtre de 1M, et il est inclus dans le forfait Claude gratuit.
Le piège, c'est la seule ligne qui n'est pas à moitié prix. Les lectures de cache coûtent 0,20 $ par million sur Sonnet 5.5 comme sur Opus 5.5. Dans les tests d'Artificial Analysis, les lectures de cache représentaient 40 % de la facture de Sonnet 5.5 en effort maximal, et avec ce réglage il coûtait 7,60 $ par tâche contre 5,98 $ pour Opus 5.5. En effort Low et Medium, Sonnet 5.5 est l'option économique et rapide qu'il prétend être. Au-delà de High, Opus 5.5 en Medium donne en général le même score pour moins cher.
Chez eesel, j'écris le code d'intégration qui envoie ces appels d'API, donc je lis les grilles tarifaires par la ligne qui finit sur la facture. Si vous chiffrez Sonnet 5.5 pour une file de support, eesel fait tourner des modèles comme celui-ci dans un collègue de helpdesk IA facturé par ticket traité, de sorte que le curseur d'effort n'apparaît jamais sur votre facture.
Tarifs de Claude Sonnet 5.5 en un coup d'œil
Claude Sonnet 5.5 a été lancé le 28 septembre 2026, et Anthropic a laissé le prix inchangé. Voici la grille complète de l'API tirée de la documentation tarifaire de Claude, par million de tokens, à côté de ses deux plus proches cousins :
| Prix par 1M de tokens | Claude Sonnet 5.5 | Claude Opus 5.5 | Claude Haiku 4.5 |
|---|---|---|---|
| Entrée | $2 | $4 | $1 |
| Sortie (réflexion incluse) | $10 | $20 | $5 |
| Écriture de cache de 5 minutes | $2.50 | $5 | $1.25 |
| Écriture de cache de 1 heure | $4 | $8 | $2 |
| Lecture de cache | $0.20 | $0.20 | $0.10 |
| Batch entrée / sortie | $1 / $5 | $2 / $10 | $0.50 / $2.50 |
| Fast mode | Non proposé | $8 / $40 | Non proposé |
| Fenêtre de contexte | 1M | 1M | 200K |
| Sortie max | 128K (300K en bêta Batch) | 128K (300K en Batch) | 64K |
| Supplément contexte long | Aucun | Aucun | n/a |
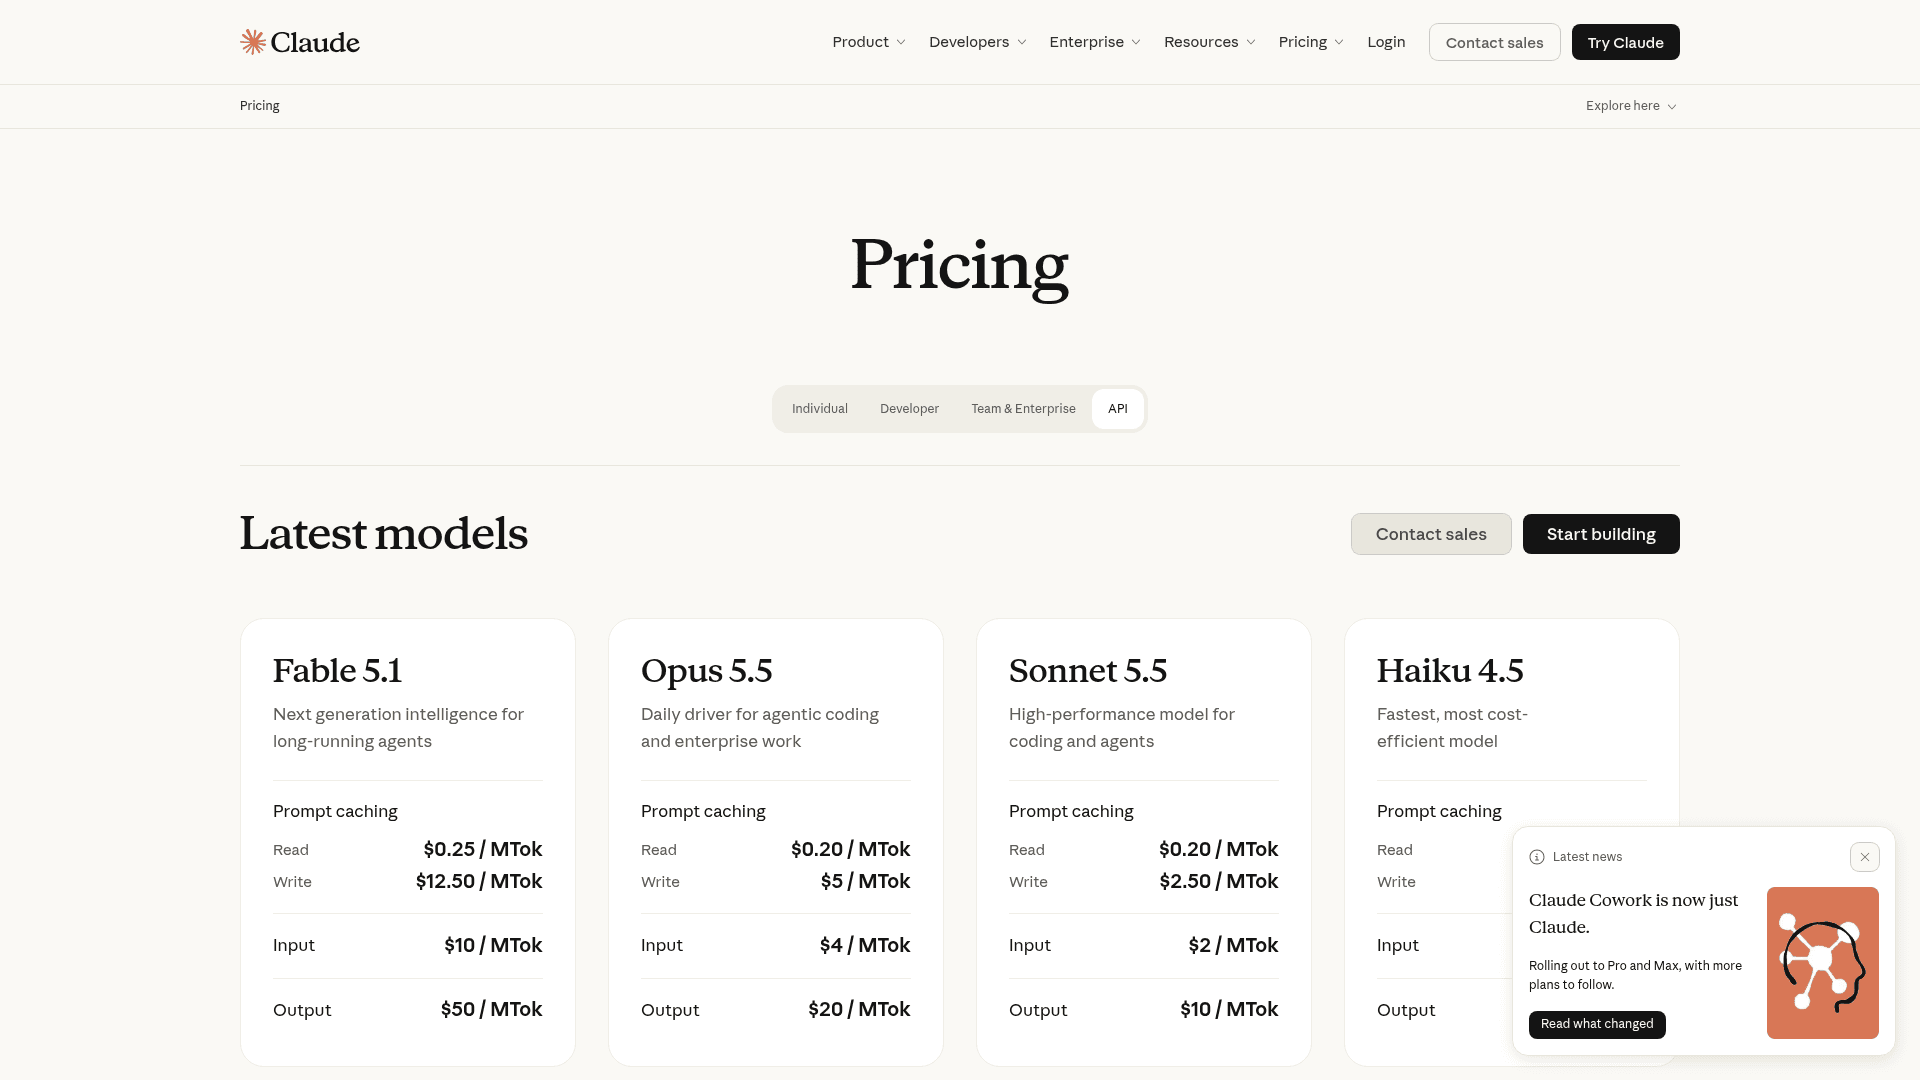
Quelques détails de ce tableau comptent plus qu'il n'y paraît :
- La réflexion est facturée comme de la sortie. Sonnet 5.5 utilise une réflexion adaptative, donc chaque token de raisonnement coûte 10 $ par million, comme la réponse.
- L'effort par défaut de l'API est
high, d'après la présentation du modèle. Les applications Claude et Claude Code utilisent Medium par défaut. Ce seul réglage change votre facture plus que tout le reste de cette page. - Le prompt minimal pouvant être mis en cache fait 512 tokens, donc même un court prompt système de support peut être mis en cache.
- Le tokenizer est inchangé depuis Sonnet 5, donc le même texte produit le même nombre de tokens. Toute économie vient du fait que le modèle écrit moins, pas d'un comptage plus généreux.
Si vous venez de la génération précédente, rien n'a bougé sur l'étiquette par rapport aux tarifs de Sonnet 5, et il reste en dessous des 3 $ et 15 $ de Claude Sonnet 4.6. L'argument d'Anthropic, c'est que la facture baisse quand même, parce que le modèle termine le même travail avec moins de tokens.
La moitié du prix d'Opus sur toutes les lignes sauf une
Voici la partie que la plupart des résumés tarifaires sautent. Sonnet 5.5 coûte exactement la moitié de Claude Opus 5.5 sur l'entrée, la sortie, les écritures de cache et le Batch. Sur les lectures de cache, il n'est pas moins cher du tout.
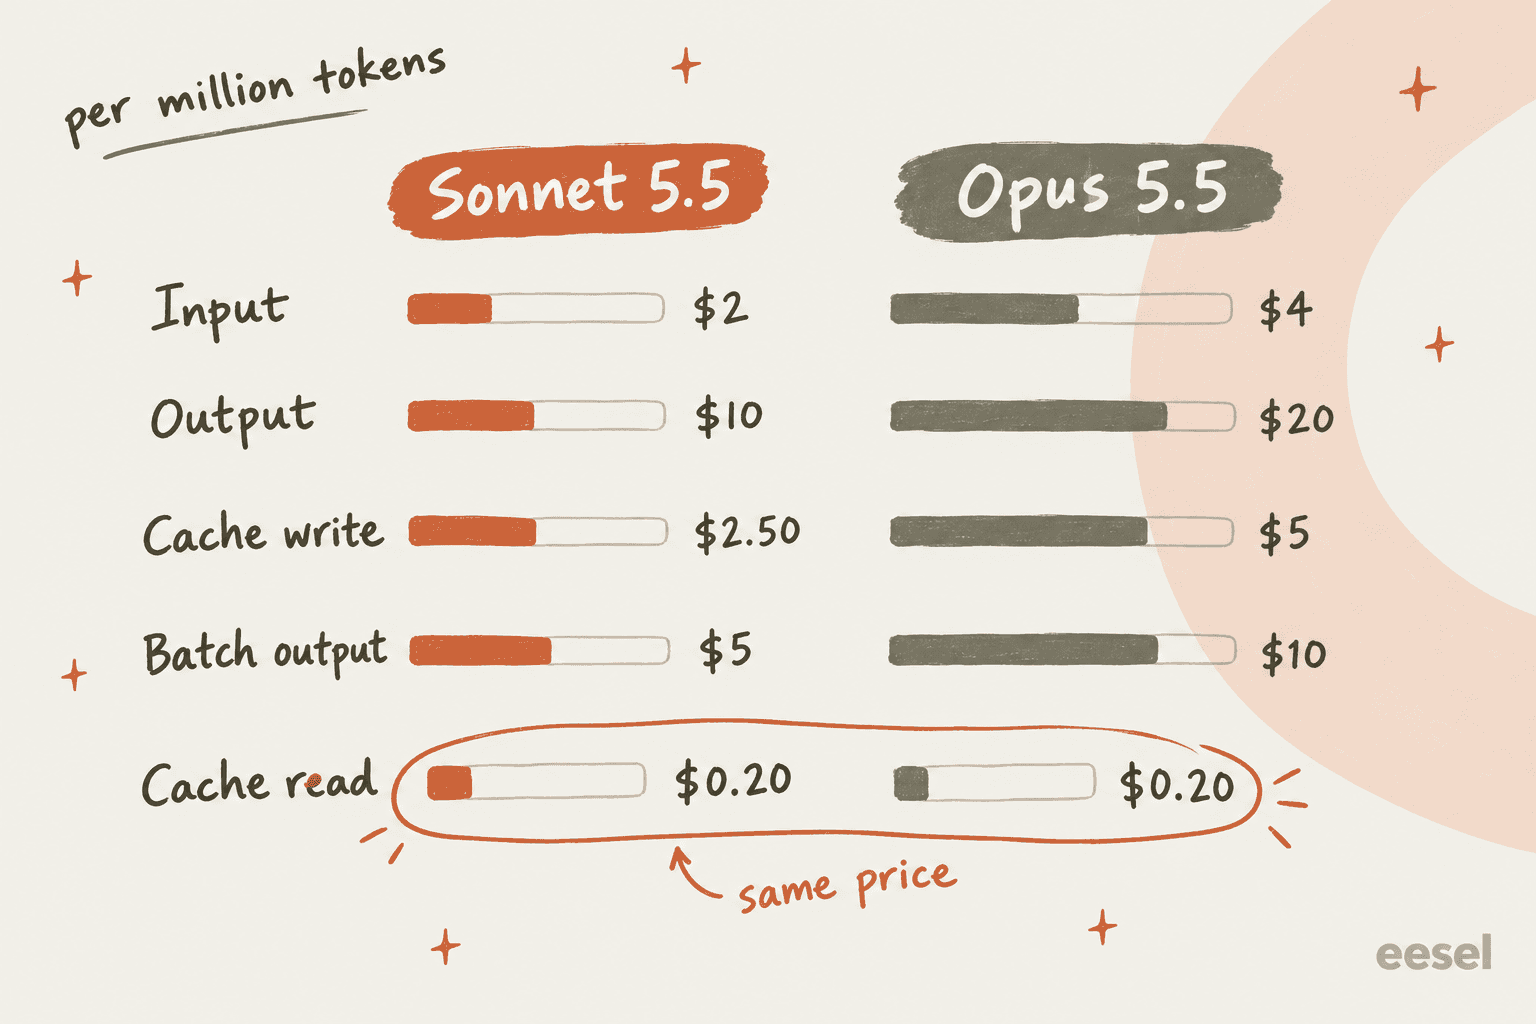
Cela vient du fait qu'Opus 5.5 a reçu un cache exceptionnellement bon marché. Son multiplicateur de lecture de cache est de 0,05x de l'entrée, là où Sonnet applique le 0,1x standard, d'après le tableau du prompt caching. L'entrée d'Opus coûte 4 $, donc 0,05x donne 0,20 $. L'entrée de Sonnet coûte 2 $, donc 0,1x donne aussi 0,20 $. Le même chiffre par deux chemins.
Pour un chatbot qui envoie un prompt et reçoit une réponse, cela ne change presque rien, mais pour un agent, cela compte beaucoup. Chaque tour d'une boucle d'agent renvoie toute la conversation jusque-là, et avec le cache activé, l'essentiel de ce renvoi est facturé en lectures de cache. Plus la session dure, plus cette ligne grossit, et c'est la seule ligne où choisir le plus petit modèle ne vous fait rien économiser.
La communauté l'a repéré dès le jour du lancement :
"Cache read is the same as Opus as well where most agentic workflow cost comes from. Not quite sure where this fits well."

Ce que coûte réellement une exécution réelle
Une grille tarifaire donne le prix d'un token. Elle ne dit pas combien de tokens un modèle dépense pour terminer un travail, et c'est là que Sonnet 5.5 devient intéressant. Artificial Analysis a fait tourner son Intelligence Index à chaque niveau d'effort et a publié le coût mesuré par tâche.
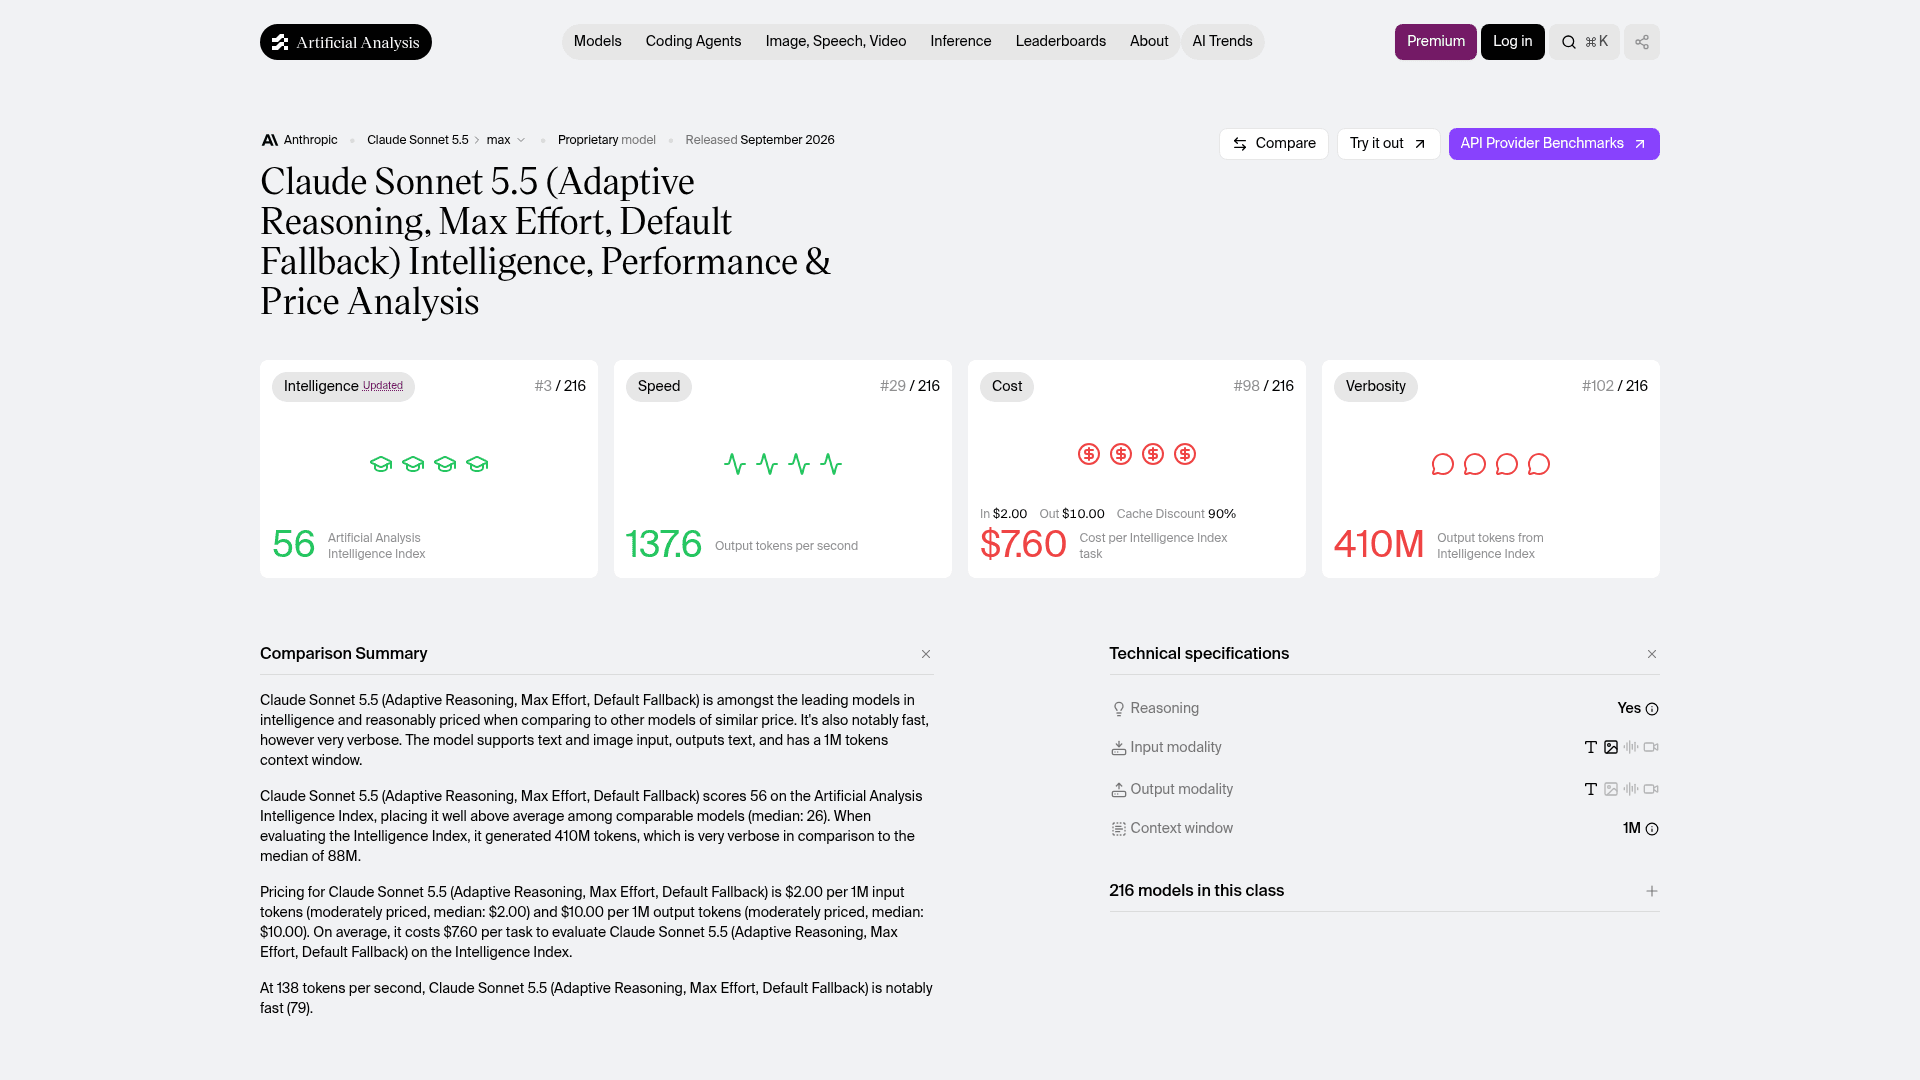
La page est franche sur le coût. En effort maximal, Sonnet 5.5 a généré 410M de tokens de sortie sur l'ensemble de l'index contre une médiane de classe de 88M, et le propre résumé d'AA le qualifie de "very verbose". Voici l'échelle complète de la page Sonnet 5.5 d'AA, à côté des lignes correspondantes de sa page Opus 5.5 :
| Effort | Score Sonnet 5.5 | Coût par tâche Sonnet 5.5 | Tokens de sortie par tâche | Score Opus 5.5 | Coût par tâche Opus 5.5 |
|---|---|---|---|---|---|
| Low | 36 | $0.41 | 13.9k | 42 | $0.55 |
| Medium | 41 | $0.59 | 19.5k | 51 | $1.34 |
| High | 47 | $1.08 | 34.5k | 54 | $1.82 |
| Xhigh | 52 | $2.74 | 73.7k | 56 | $3.46 |
| Max | 56 | $7.60 | 192.8k | 58 | $5.98 |
En lisant la colonne Sonnet de haut en bas, le coût double à peu près à chaque palier au-dessus de Medium, puis presque triple de Xhigh à Max. En lisant en travers, la tendance s'inverse autour de High. Sonnet 5.5 en effort maximal coûte 27 % de plus par tâche qu'Opus 5.5 au maximum, avec deux points de score en moins. Il a utilisé 193k tokens de sortie par tâche là, contre 119k pour Opus.
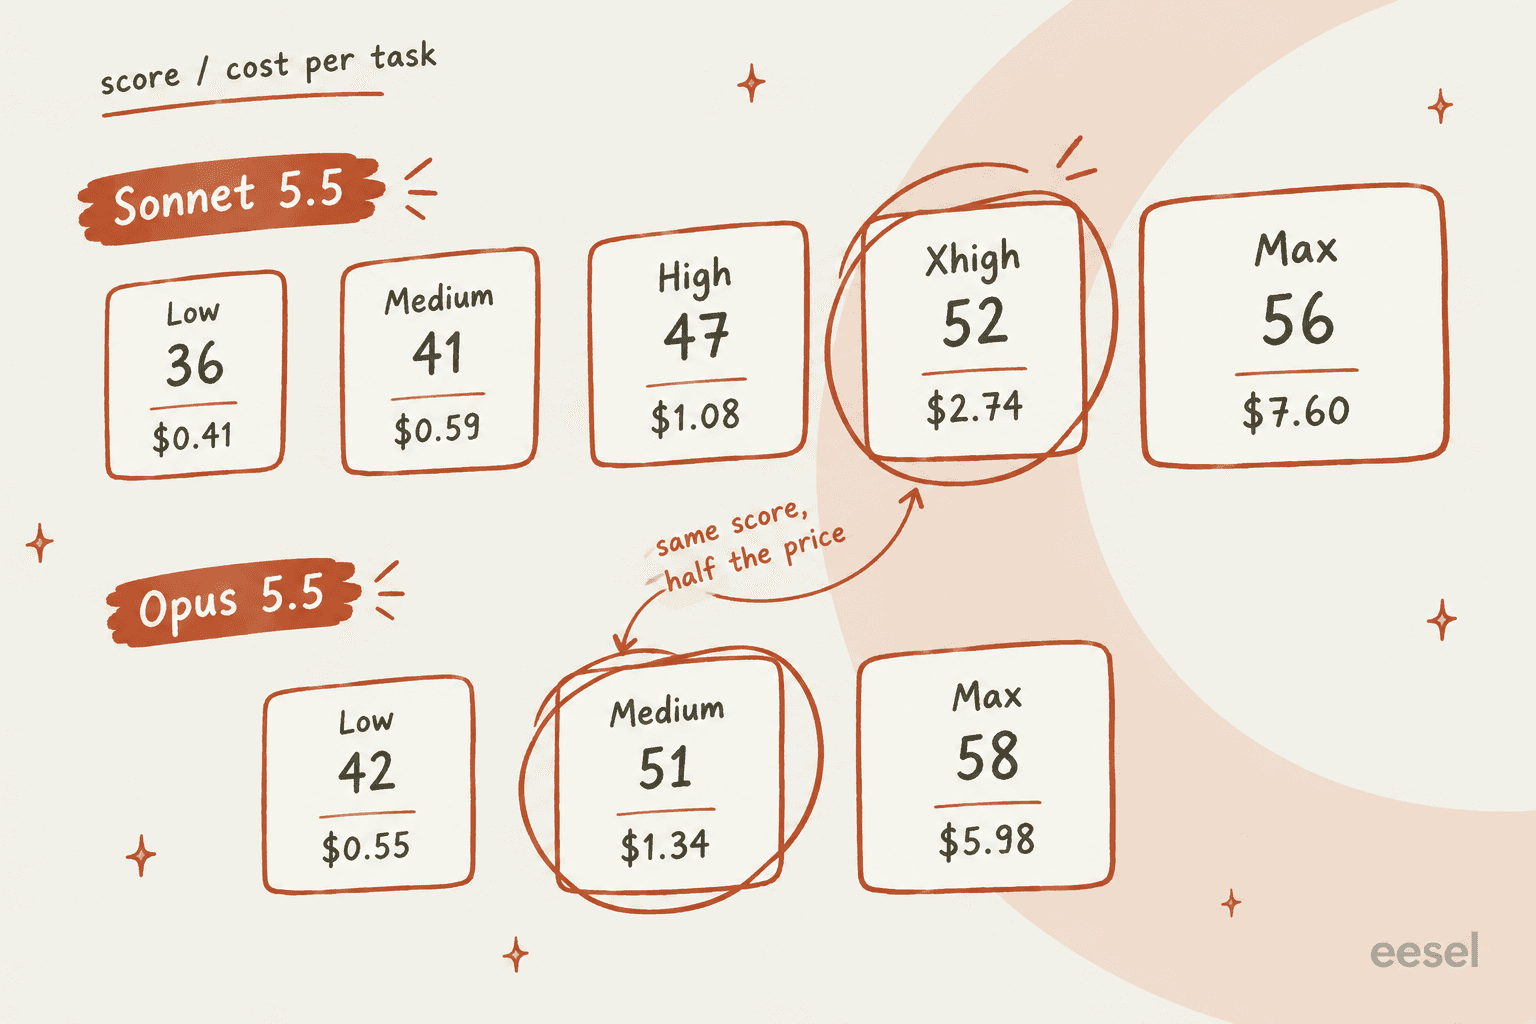
La paire sur laquelle je m'attarderais, c'est Sonnet Xhigh contre Opus Medium. Ils obtiennent 52 et 51, et Opus coûte 1,34 $ contre 2,74 $ pour Sonnet. Si vous vous retrouvez à pousser Sonnet 5.5 au-delà de High pour obtenir la qualité voulue, vous finissez par payer plus que ce que coûterait le plus gros modèle à son réglage par défaut.
C'est aussi la lecture honnête de l'affirmation d'Anthropic « jusqu'à 30 % de moins par tâche ». L'annonce de lancement dit que Sonnet 5.5 "complements Opus 5.5 best when running at lower effort settings, where it costs less per task. At higher settings, it can perform comparably at a similar cost." Les chiffres d'AA le confirment exactement.
Où passe l'argent sur une facture d'agent
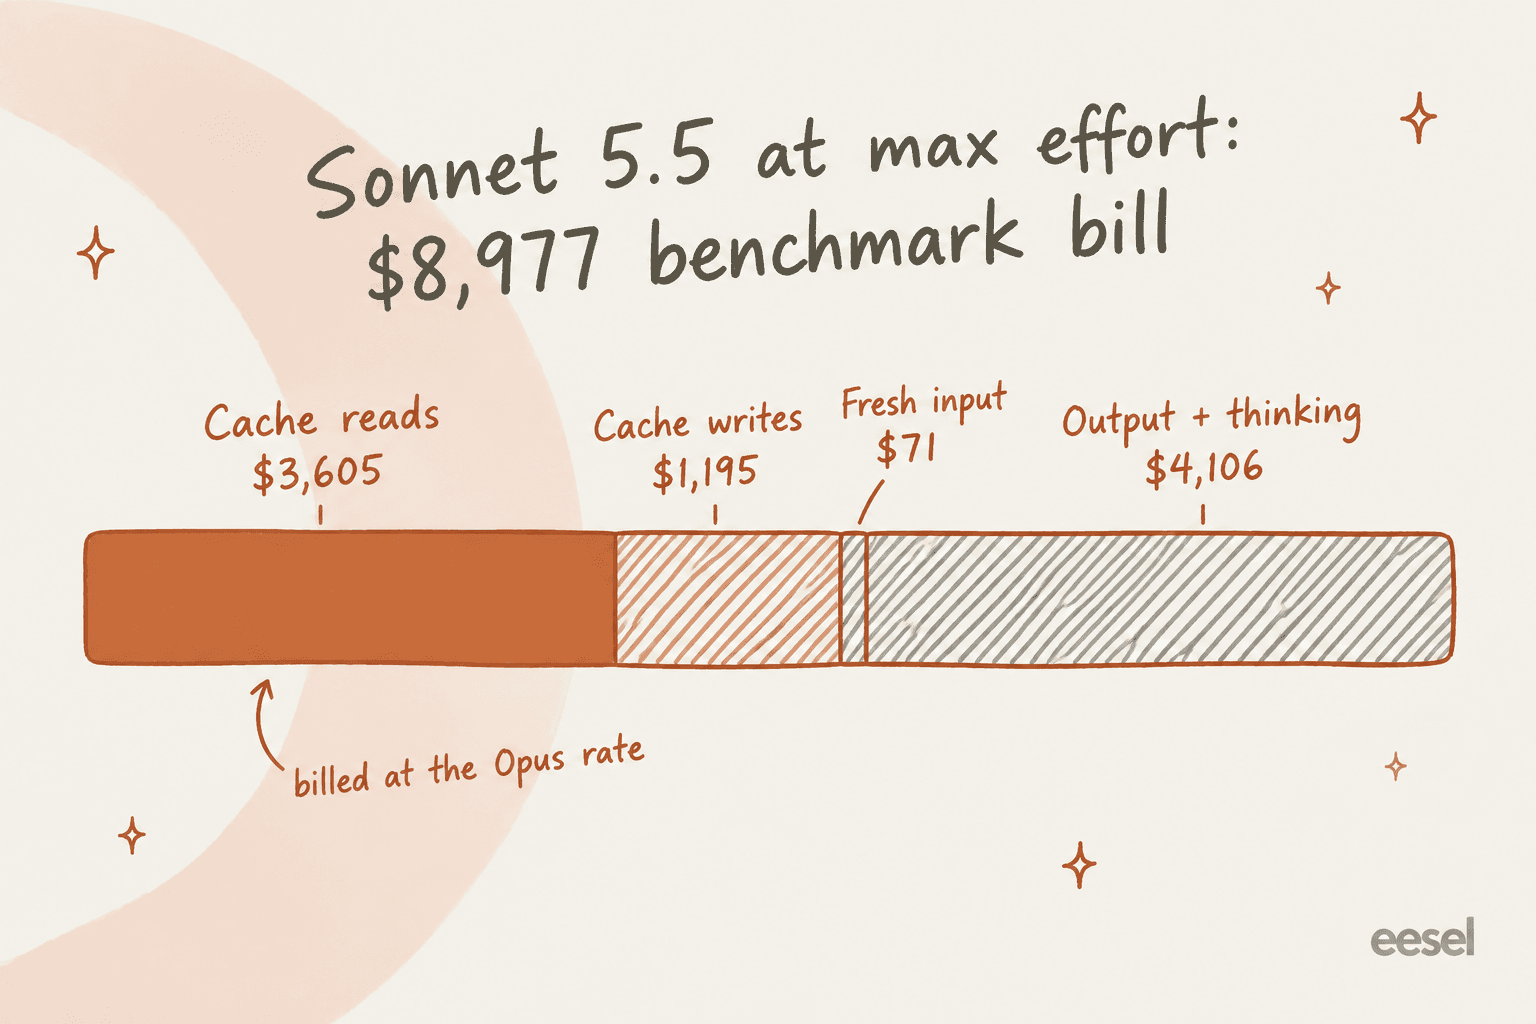
AA répartit aussi le coût de chaque exécution par type de token, et c'est ici que la ligne des lectures de cache vue plus haut cesse d'être théorique. Pour l'exécution complète de l'Intelligence Index en effort maximal, la facture de Sonnet 5.5 s'est élevée à 8 977 $ :
| Poste | Sonnet 5.5 en Max | Part | Sonnet 5.5 en Medium | Part |
|---|---|---|---|---|
| Lectures de cache | $3,605 | 40% | $180 | 26% |
| Écritures de cache | $1,195 | 13% | $155 | 22% |
| Entrée fraîche | $71 | 1% | $70 | 10% |
| Sortie et réflexion | $4,106 | 46% | $295 | 42% |
| Total | $8,977 | $701 |
Deux choses sautent aux yeux. L'entrée fraîche, la ligne que la plupart des gens imaginent en pensant « tokens d'entrée », est presque nulle, car presque tous les tokens d'entrée d'une exécution d'agent sont une lecture ou une écriture de cache. Et les lectures de cache, la ligne sans remise Sonnet, passent d'un quart de la facture en Medium à 40 % en Max, parce qu'une réflexion plus longue signifie plus de tours et plus de relectures.
En mettant les deux modèles côte à côte sur la même exécution, l'écart se réduit, ce qui raconte la même histoire que l'ancienne comparaison Opus 5 vs Sonnet 5. En Medium, l'exécution de l'index avec Sonnet 5.5 a coûté 701 $ contre 1 627 $ pour Opus 5.5, soit 43 % de la facture d'Opus. En Max, Sonnet a coûté 8 977 $ contre 8 708 $ pour Opus. La moitié du prix affiché, 3 % de plus sur la facture.
Exemples chiffrés pour trois types de charge
Les benchmarks correspondent à la charge de travail de quelqu'un d'autre, voici donc le calcul à partir de la grille pour trois cas courants, en utilisant uniquement les prix publiés. Considérez les nombres de tokens comme illustratifs, et saisissez les vôtres dans le calculateur ci-dessous.
1. Un bot de réponse au support. Chaque réponse envoie 8 000 tokens d'entrée, dont 6 000 de prompt système et d'articles d'aide en cache, et reçoit 1 500 tokens en retour, réflexion comprise.
- Sonnet 5.5 : 0,004 $ d'entrée fraîche + 0,0012 $ de lectures de cache + 0,015 $ de sortie = environ 2 centimes par réponse, soit 202 $ pour 10 000 tickets
- Opus 5.5 : 0,008 $ + 0,0012 $ + 0,03 $ = environ 3,9 centimes, soit 392 $ pour 10 000
- Haiku 4.5 : 0,002 $ + 0,0006 $ + 0,0075 $ = environ 1 centime, soit 101 $ pour 10 000
La sortie domine ici, donc la moitié de prix de Sonnet sur la sortie se répercute presque entièrement. C'est le cas où Sonnet 5.5 est clairement le meilleur achat face à Opus. Pour une vue plus large de ce que coûte le support par IA au-delà du modèle, consultez le guide du coût du service client par IA.
2. Une longue session d'agent. Imaginez un agent de code ou d'exploitation qui fait 30 tours, relit un contexte de 60 000 tokens depuis le cache à chaque tour, ajoute 3 000 tokens frais et en écrit 2 000 par tour.
- Sonnet 5.5 : 0,36 $ de lectures de cache + 0,18 $ d'entrée fraîche + 0,60 $ de sortie = 1,14 $
- Opus 5.5 : 0,36 $ + 0,36 $ + 1,20 $ = 1,92 $
Supposons maintenant que Sonnet ait besoin de 40 tours là où Opus en a besoin de 25, ce qui va dans le sens des nombres de tokens d'AA à effort élevé. Sonnet passe à 0,48 $ + 0,24 $ + 0,80 $ = 1,52 $, et Opus à 0,30 $ + 0,30 $ + 1,00 $ = 1,60 $. Le modèle « à moitié prix » n'est plus qu'à 8 centimes du modèle cher.
3. Un job Batch de nuit. Vous extrayez des champs de 10 000 documents à 20 000 tokens d'entrée et 1 000 tokens de sortie chacun, et rien ne nécessite de réponse en temps réel.
- Sonnet 5.5 en Batch : 200 $ d'entrée + 50 $ de sortie = 250 $
- Opus 5.5 en Batch : 400 $ + 100 $ = 500 $
- Haiku 4.5 en Batch : 100 $ + 25 $ = 125 $
Il n'y a ni relectures de cache ni boucle d'agent, donc le rapport de 2x tient assez proprement. Le Batch se cumule aussi avec le prompt caching, d'après la documentation tarifaire.
Estimez votre propre facture mensuelle
Renseignez le nombre de tokens par tâche pour votre charge de travail et voyez ce que coûte chaque modèle par mois. Les écritures de cache sont laissées de côté par souci de simplicité, car avec un cache chaud elles pèsent peu dans une charge régulière.
Si le preset d'agent vous surprend, c'est la ligne des lectures de cache à l'œuvre. Avec 1,8M de tokens en cache par session, Sonnet et Opus paient les mêmes 0,36 $ pour les relectures, et seule la ligne de sortie les sépare encore.
L'effort est le bouton du prix, et le défaut de l'API est high
Anthropic vous laisse régler l'effort par requête, et c'est le levier le plus important sur une facture Sonnet 5.5. Simon Willison a lancé le même prompt SVG à chaque niveau et a publié les coûts dans le fil du lancement :
| Effort | Coût d'un prompt | Durée |
|---|---|---|
| Low | 1,6 centime | 10s |
| Medium | 1,8 centime | 11s |
| High | 2,3 centimes | 17s |
| Xhigh | 5,7 centimes | 41s |
| Max | $1.28 | 15m 40s, et il a échoué |
En Max, le modèle a, selon ses mots, "burned through 128,000 thinking tokens (taking 15 minutes to do that) and ran out before it had produced the final SVG". Cela représente un bond de coût de 80x de Low à Max pour un résultat moins bon.
Mon conseil pratique, en tant que personne qui intègre ces appels dans du code de production :
- Réglez l'effort explicitement à chaque requête. Le défaut de l'API est
high, pas le Medium des applications, donc une intégration naïve démarre un cran au-dessus de la zone économique. - Commencez à Low pour le travail courant comme la classification, l'étiquetage et les réponses courtes, puis montez uniquement là où vos évaluations montrent un vrai écart.
- Considérez Xhigh et Max comme un signal pour changer de modèle. Au-delà de High, Opus 5.5 en Medium tend à battre Sonnet en score comme en prix.
- Relancez vos tests d'effort si vous migrez depuis Sonnet 5. Anthropic a recalibré les niveaux dans la page des nouveautés, donc les anciens réglages ne se transposent pas.
Le gain est important en bas du cadran. AA a mesuré Sonnet 5.5 en Medium avec un score de 41 pour 0,59 $ par tâche, contre Claude Sonnet 5 en Max avec un score de 38 pour 5,09 $. C'est un meilleur résultat pour environ un neuvième du coût, ce qui est l'argument de mise à niveau qu'Anthropic vend, et il tient la route.
Remises, options et petits postes
Au-delà de l'effort, quatre modificateurs font bouger le prix par token, tous tirés de la documentation tarifaire de Claude :
| Modificateur | Effet sur Sonnet 5.5 | Remarques |
|---|---|---|
| Prompt caching | Lectures à $0.20 (0,1x), écritures à $2.50 (5 min) ou $4 (1 heure) | Rentabilisé dès une lecture sur le cache de 5 minutes |
| API Batch | 50 % de remise : $1 en entrée, $5 en sortie | Se cumule avec le caching ; 300K de sortie avec un header bêta |
| Inférence réservée aux États-Unis | 1,1x sur chaque catégorie de token | Activée avec inference_geo: "us" |
| Fast mode | Non disponible | Opus 5.5 uniquement, à $8 / $40 |
Les frais d'outils s'ajoutent aux tokens. La recherche web coûte 10 $ pour 1 000 recherches, le web fetch n'a pas de frais supplémentaires, et l'exécution de code est gratuite quand elle est utilisée avec la recherche ou le fetch web, sinon 1 550 heures de conteneur gratuites par mois puis 0,05 $ de l'heure. Sonnet 5.5 ajoute 286 tokens de prompt système dès que des outils sont présents. Les sessions Claude Managed Agents ajoutent 0,08 $ par heure de session en cours en plus des tarifs standard de tokens.
Un coût facile à manquer : l'usage forcé d'outils (tool_choice réglé sur any ou sur un outil nommé) renvoie désormais une erreur 400 sur Sonnet 5.5, d'après les notes de migration. Ce n'est pas un prix, mais si votre bot de support en dépendait, la reprise du travail est un vrai coût du changement. L'article de référence détaille les cinq changements incompatibles.
Claude Free, Pro, Max, Team et Enterprise
Si vous utilisez Sonnet 5.5 dans les applications Claude plutôt que via l'API, vous payez par siège, pas par token. D'après la page tarifaire de Claude :
| Forfait | Prix | Accès à Sonnet 5.5 | Remarques |
|---|---|---|---|
| Free | $0 | Oui | Anthropic dit "anyone can chat with Claude using Sonnet 5.5" |
| Pro | $17/mois facturé annuellement, $20 au mois | Oui | Ajoute Opus et des crédits d'usage |
| Max 5x / 20x | À partir de $100/mois | Oui | 5x ou 20x l'usage de Pro, accès prioritaire |
| Team standard | $20/siège/mois en annuel, $25 au mois | Oui | Pour 2 à 150 personnes |
| Team premium | $100/siège/mois en annuel, $125 au mois | Oui | 5x l'usage du siège standard |
| Enterprise | $20/siège/mois plus l'usage aux tarifs de l'API | Oui | L'usage est facturé aux tarifs de tokens ci-dessus |
Deux choses changent le calcul ici. Sur Free et Pro, Sonnet est le modèle que la plupart des gens utiliseront réellement, et les utilisateurs gratuits ont désormais Sonnet 5.5. Sur Enterprise, le prix du siège n'est que le début, car l'usage est facturé aux mêmes tarifs d'API que tout cet article. Le guide des tarifs de Claude et le détail de Claude Pro couvrent les limites d'usage, et le guide des tarifs de Claude Code couvre le côté développeur, où l'effort Medium est le défaut.
Un développeur a bien résumé le partage entre abonnement et API le jour du lancement :
"Sonnet 5.5 might not be useful or necessary in a Claude Code session but it could be good value in the API when you pay per token."
Bedrock, Google Cloud et Foundry
Sonnet 5.5 est arrivé sur tous les grands clouds dès le premier jour, sous le nom anthropic.claude-sonnet-5-5 sur Amazon Bedrock et claude-sonnet-5-5 sur Google Cloud et Microsoft Foundry, d'après la présentation du modèle. La façon dont vous êtes facturé dépend de la porte que vous empruntez :
- Amazon Bedrock et Google Cloud sont exploités par des partenaires. Ils vous facturent directement à leurs propres tarifs publiés, alors consultez les tarifs de Bedrock avant de supposer la parité. Google publie aussi ses propres tarifs Vertex AI.
- Claude Platform on AWS et Claude in Microsoft Foundry sont exploités par Anthropic. Ils valorisent votre usage aux prix standard d'Anthropic, appliquent toute remise négociée et convertissent en Claude Consumption Units à 0,01 $ l'unité, facturées à l'heure a posteriori via la marketplace.
- L'inférence réservée aux États-Unis applique le même multiplicateur de 1,1x sur l'API directe, Claude Platform on AWS et les déploiements US Data Zone de Foundry.
Si vous faites déjà tourner Claude via un cloud, le guide Bedrock et le guide Vertex AI couvrent la configuration.
Comment Sonnet 5.5 se positionne face à GPT-6 Sol et Gemini 3.8 Flash
La comparaison la plus frappante n'est pas au sein de la gamme d'Anthropic. GPT-6 Sol a une grille affichée identique : 2 $ en entrée, 10 $ en sortie, 0,20 $ en entrée en cache, 2,50 $ en écriture de cache, d'après le détail des tarifs de GPT-6 Sol.
| Par 1M de tokens | Claude Sonnet 5.5 | GPT-6 Sol | Gemini 3.8 Flash |
|---|---|---|---|
| Entrée | $2 | $2 | $0.75 (passe à $1.50 le 1er janv. 2027) |
| Sortie | $10 | $10 | $3.75 (passe à $7.50) |
| Lecture de cache | $0.20 | $0.20 | $0.075 |
| Prime contexte long | Aucune jusqu'à 1M | Tarif supérieur au-delà de 272K en entrée | Aucune |
| Coût par tâche AA (réglage) | $1.08 (high) | $1.05 (max) | Non comparable |
| AA Intelligence Index | 47 (high) | 48 (max) | Non comparable |
Les lignes AA sont révélatrices. Sonnet 5.5 en High et GPT-6 Sol en max atterrissent à presque le même score pour presque le même coût par tâche. La différence se joue plutôt aux marges : Sonnet n'a pas de supplément de contexte long, donc un agent de support qui charge une grosse base de connaissances dans le contexte ne franchit pas de falaise tarifaire, alors que Sol le fait au-delà de 272K. Les chiffres AA de Gemini venaient d'une version antérieure de l'index, je les ai donc écartés de la comparaison directe, et les tarifs de Gemini 3.8 Flash doublent en janvier. La comparaison des trois API va plus loin si vous choisissez un fournisseur plutôt qu'un modèle.
Pour les tickets de support en particulier, le classement dépend moins du prix que de la fiabilité sur vos propres données, c'est pourquoi le classement des modèles pour tickets de support place la précision en premier.
Ce que les développeurs disent du prix
La réaction du jour du lancement sur Hacker News portait surtout sur sa position face à Opus. Le point de vue sceptique :
"I feel like sonnet is priced too close to opus right now. If Sonnet 5.5 were half its current price it would make sense to use."
Le point de vue mesuré, qui correspond à l'échelle AA ci-dessus :
"Per the charts, there is largely no point to using Sonnet 5.5 at high+ as opus low generally will give similar performance at similar or lower cost."
Et le point de vue enthousiaste, d'un utilisateur qui le compare au modèle phare d'OpenAI à un réglage plus bas :
"Sonnet 5.5 medium scores better than gpt 5.6 Sol high and is less than 1/5 the cost Absolutely bonkers"

Le schéma sur lequel les gens revenaient sans cesse était une configuration partagée : Sonnet 5.5 en Low ou Medium pour le travail à gros volume en tant que sous-agent, avec Opus 5.5 pour orchestrer ou finir les parties difficiles. Si aucune de ces options ne convient, le panorama des alternatives à Claude couvre d'autres pistes. Cela correspond à la tarification, puisque la remise de Sonnet est réelle sur les appels à forte sortie et contexte court, et s'estompe sur les longues boucles chargées en cache.
Claude Sonnet 5.5 vaut-il 2 $ et 10 $ ?
Oui, en effort Low et Medium, et je n'hésiterais pas là-dessus. Il bat le meilleur score de Sonnet 5 pour une fraction du coût, il coûte moitié moins qu'Opus sur la ligne de sortie qui domine les charges de type chat, et il n'a pas de supplément de contexte long. Pour un bot de réponse au support, un classifieur, une étape de rédaction ou un job Batch de nuit, c'est mon choix par défaut.
C'est un achat moins convaincant dans deux cas. Si votre charge est une longue boucle d'agent, les lectures de cache rongent la remise car elles coûtent pareil sur les deux modèles. Et si vous avez besoin de Xhigh ou Max pour obtenir la qualité voulue, Opus 5.5 en Medium est généralement moins cher pour le même score. Testez d'abord Sonnet en Low, mesurez, puis décidez si l'écart vaut 1,34 $ par tâche.
Si le travail est une file de support, un coût de plus doit entrer dans le calcul : planifier une dépense qui varie avec l'effort et le volume. Un acheteur lors des appels commerciaux d'eesel a atteint 200 interactions en une seule journée de test et s'est immédiatement inquiété du coût par interaction à grande échelle. Les factures au token rendent cette inquiétude plus difficile à lever, car le même ticket peut coûter 1,6 centime ou 1,28 $ selon un réglage.
Essayez eesel pour une facture fixe par ticket
Sonnet 5.5 est le moteur. Si ce que vous voulez, ce sont des tickets traités, eesel est l'employé : un collègue de helpdesk IA qui se branche sur Zendesk, Freshdesk, Gorgias et vos autres outils, apprend de vos anciens tickets et de votre centre d'aide, et vous laisse le simuler sur des tickets historiques avant qu'il ne réponde à un vrai client. Vous ne choisissez jamais de niveau d'effort et ne surveillez pas les lectures de cache. Les tarifs d'eesel sont un forfait mensuel fixe de crédits où un ticket ou un chat traité vaut un crédit, à partir de 299 $ pour 500 crédits, avec un niveau gratuit de 100 crédits pour essayer.
Si vous travaillez dans un terminal, la CLI d'eesel pilote le même collègue. Vous pouvez connecter des intégrations et modifier ses instructions permanentes, mais aussi approuver ou refuser des actions et lire son journal d'activité en JSON. Des agents de code comme Claude Code peuvent aussi l'exécuter, via le serveur MCP du workspace.

Essayez eesel et voyez ce que coûte votre file par ticket plutôt que par token.
Questions fréquentes
Combien coûte Claude Sonnet 5.5 par million de tokens ?
Claude Sonnet 5.5 est-il plus cher que Claude Sonnet 5 ?
Claude Sonnet 5.5 coûte-t-il la moitié de Claude Opus 5.5 ?
Quelle est la façon la moins chère d'utiliser Claude Sonnet 5.5 ?
Puis-je utiliser Claude Sonnet 5.5 gratuitement ?
Claude Sonnet 5.5 facture-t-il un supplément pour le contexte long ?
Combien coûte Claude Sonnet 5.5 sur Amazon Bedrock ou Google Cloud ?
Combien coûterait Claude Sonnet 5.5 pour un bot de support client ?


Article by
Rama Adi
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.