

En bref
Le tarif de Claude Haiku 5.5 est de 0,10 $ par million de tokens en entrée et 0,50 $ par million de tokens en sortie, comme GPT-6 Luna et 90 % de moins que Haiku 4.5. Ce prix ne tient que tant que le prompt d'une requête reste à 100 000 tokens ou moins. Au-delà, chaque ligne de la facture est multipliée par 5 (0,50 $ en entrée, 2,50 $ en sortie), les tokens en cache comptent dans le seuil, et Haiku 5.5 est le seul modèle Claude actuel tarifé ainsi.
Deux autres éléments font bouger le coût réel par tâche. Le nouveau tokenizer transforme le même texte en environ 30 % de tokens de plus qu'avec Haiku 4.5, et l'effort détermine la quantité de raisonnement que vous payez : exécuter la même suite de benchmarks a coûté 34 $ en Low et 330 $ en Max. Le Batch divise tout par deux, et les lectures de cache coûtent un dixième de l'entrée.
Pour une équipe de support, Haiku 5.5 est un moteur de tri très économique si vous gardez les prompts courts. Étiqueter 20 000 tickets par mois coûte environ 12 $, alors qu'un bot de réponse qui charge 120k tokens de contexte par ticket coûte environ 1 300 $. Si vous préférez ne pas contourner le seuil à coups d'ingénierie, le coéquipier IA pour helpdesk d'eesel fait le tri et les réponses dans votre helpdesk pour 299 $ fixes par mois pour 500 tickets.
Les tarifs de Claude Haiku 5.5 en un coup d'œil
Voici ce que j'ai remarqué en regardant ce que les gens cherchent après le lancement d'un modèle. La requête est « tarifs Claude Haiku 5.5 », mais l'extrait affiché par Google répond déjà 0,10 $ et 0,50 $, donc ce que la personne demande vraiment, c'est combien lui coûtera un mois, et pour Haiku 5.5 cela dépend d'un chiffre plus que de tout autre : la longueur de vos prompts.
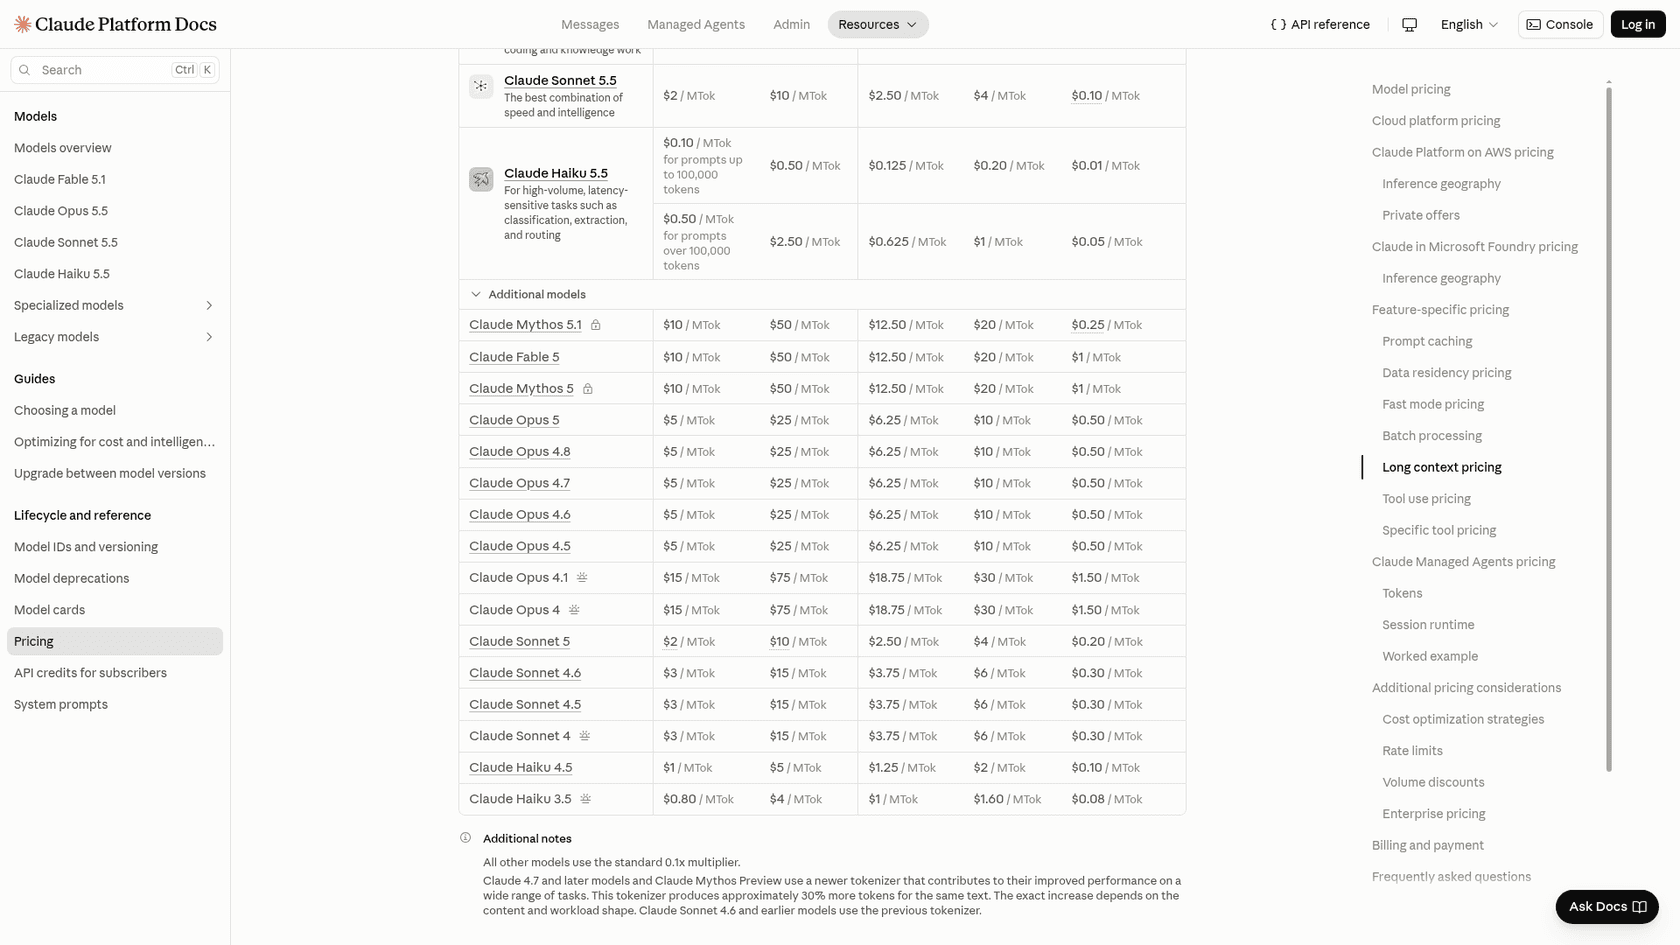
Claude Haiku 5.5 a été lancé le 7 octobre 2026, avec l'identifiant de modèle claude-haiku-5-5. Voici la grille tarifaire complète de l'API issue de la documentation tarifaire d'Anthropic, par million de tokens :
| Poste | Prompt jusqu'à 100 000 tokens | Prompt au-delà de 100 000 tokens |
|---|---|---|
| Entrée | 0,10 $ | 0,50 $ |
| Sortie (raisonnement compris) | 0,50 $ | 2,50 $ |
| Lecture de cache (succès ou renouvellement) | 0,01 $ | 0,05 $ |
| Écriture de cache de 5 minutes | 0,125 $ | 0,625 $ |
| Écriture de cache d'1 heure | 0,20 $ | 1,00 $ |
| Entrée en Batch | 0,05 $ | 0,25 $ |
| Sortie en Batch | 0,25 $ | 1,25 $ |
Et voici où il se place à côté des modèles auxquels vous le compareriez vraiment :
| Modèle | Entrée | Sortie | Lecture de cache | Prompts longs |
|---|---|---|---|---|
| Claude Haiku 5.5 | 0,10 $ | 0,50 $ | 0,01 $ | 5x sur chaque ligne au-delà de 100k |
| Claude Haiku 4.5 | 1,00 $ | 5,00 $ | 0,10 $ | Fixe, plafond de contexte de 200k |
| Claude Sonnet 5.5 | 2,00 $ | 10,00 $ | 0,10 $ | Fixe jusqu'à 1M |
| Claude Opus 5.5 | 4,00 $ | 20,00 $ | 0,20 $ | Fixe jusqu'à 1M |
| Claude Fable 5.1 | 10,00 $ | 50,00 $ | 0,25 $ | Fixe jusqu'à 1M |
Certaines choses n'apparaissent pas dans le tableau, et mieux vaut les signaler. Il n'existe pas de Fast mode pour Haiku 5.5 (il ne couvre que les modèles Opus), et le guide de migration indique que Priority Tier n'est pas non plus pris en charge. L'inférence réservée aux États-Unis ajoute 1,1x sur chaque catégorie de token, comme sur les autres modèles Claude 4.6 et suivants. Pour la vue d'ensemble de tous les modèles d'Anthropic, mon guide Anthropic API pricing la détaille.
Le seuil de 100k s'applique par requête, et le cache ne vous fait pas passer dessous
Tous les autres modèles Claude actuels incluent désormais la fenêtre de contexte complète de 1M à un seul prix. La page tarifaire le dit assez directement : les modèles Claude 4.6 et suivants « (except Claude Haiku 5.5) » facturent une requête de 900k tokens au même tarif par token qu'une de 9k. Haiku 5.5 est ici l'exception, et la documentation énonce trois règles qui décident de votre facture.
- La longueur du prompt compte chaque token d'entrée. Cela inclut les lectures de cache et aussi les écritures de cache, pas seulement le texte neuf.
- Chaque requête est tarifée séparément. Une requête longue ne fait pas basculer vos autres requêtes dans une tranche supérieure, et les requêtes précédentes gardent le prix auquel elles ont été facturées.
- Une requête au-dessus du seuil paie les tarifs plus élevés sur tout. L'entrée et la sortie passent au tarif 5x, et le cache aussi, même quand l'essentiel du prompt est un succès de cache.
Cette troisième règle est celle que l'on rate le plus souvent. Le cache ne cache pas les tokens au compteur. Si votre agent traîne 120 000 tokens d'historique dans une requête, il paie 0,05 $ par million pour la partie en cache au lieu de 0,01 $, puis 2,50 $ par million pour sa sortie au lieu de 0,50 $.
Voici ce que cela donne sur une seule requête. Un prompt de 90k tokens avec 1 000 tokens de sortie coûte 0,0095 $. Ajoutez 20 000 tokens de prompt et la même requête coûte 0,0575 $.
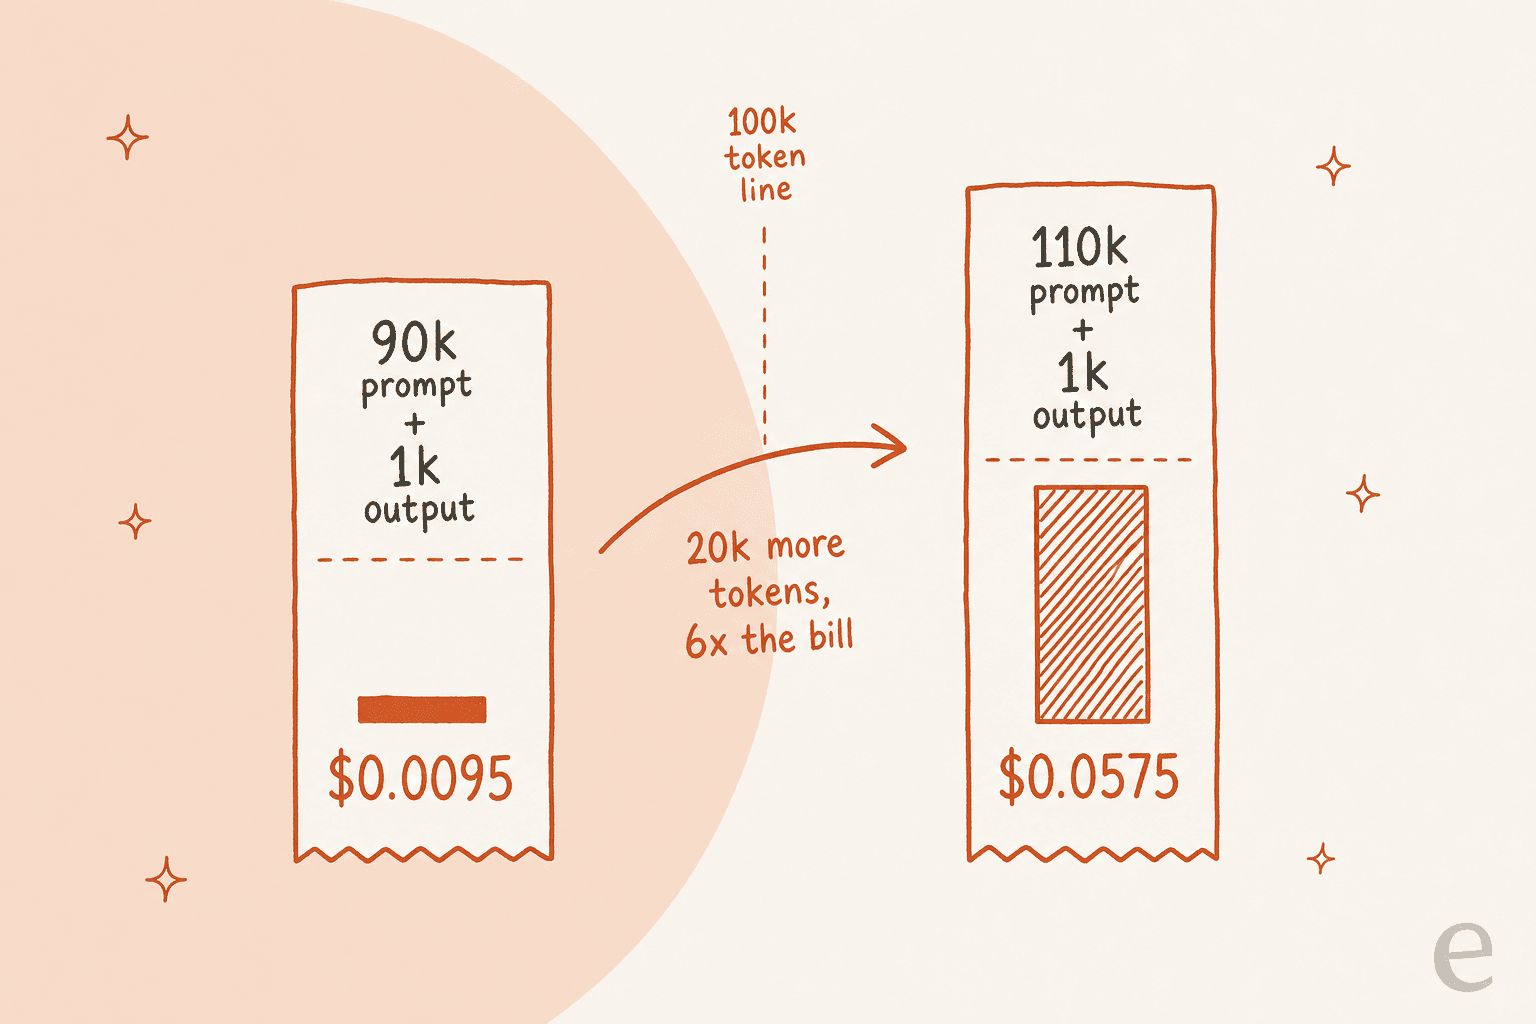
Donc 20k tokens de plus rendent une requête environ 6 fois plus chère. Pas 22 % de plus, ce à quoi le seul nombre de tokens laisserait s'attendre. Le fil de lancement sur Hacker News l'a relevé en quelques minutes :
"100k tokens is an absurdly low cutoff and it is only applicable to Haiku and not Sonnet or Opus. It's a low enough cutoff that it will be quickly exceeded if you are doing anything with Agents; for typical generation or Jev-like classifiers, it's a good value and as noted in this article, that is apparently the vast majority of Haiku use."

Le passage sur la « grande majorité » vient d'Anthropic elle-même. Son article de lancement indique que les prompts jusqu'à 100 000 tokens représentaient environ 90 % des requêtes vers Haiku 4.5. Si votre trafic ressemble à cela, le seuil gêne rarement, mais si vous faites tourner des agents, c'est la première chose à mesurer.
Vos tokens ont grossi d'environ 30 %
Le deuxième coût caché se trouve dans le tokenizer. La page what's new d'Anthropic indique que le même texte en entrée produit environ 30 % de tokens de plus sur Haiku 5.5 que sur Haiku 4.5. Simon Willison a mesuré un long prompt sur son compteur de tokens Claude et a obtenu environ 1,25x, ce qu'il a qualifié de « a hidden price increase ».
Cela change pas mal la remise affichée. Par mot de texte, et non par token :
| Comparaison avec Haiku 4.5 | Baisse du prix catalogue | Baisse par mot, à 1,3x de tokens |
|---|---|---|
| Prompts jusqu'à 100k tokens | 90 % | environ 87 % |
| Prompts au-delà de 100k tokens | 50 % | environ 35 % |
Cela déplace aussi le seuil lui-même. D'après mes calculs, 100 000 tokens Haiku 5.5 contiennent à peu près le texte qui faisait 77 000 tokens sur Haiku 4.5. Tout prompt Haiku 4.5 de plus de 77k tokens environ passera au-dessus du seuil après la migration, et le guide de migration vous dit de recompter les prompts avec model réglé sur claude-haiku-5-5 précisément pour cette raison.
L'écart avec OpenAI est encore plus grand. Un commentateur estimait que 100K tokens Claude valent environ « ~60-65K modern GPT tokens », donc le même document atteint le seuil de Haiku bien avant d'atteindre celui de 272k de GPT-6 Luna. Le chiffre net d'Anthropic elle-même, qui tient déjà compte du tokenizer, est que Haiku 5.5 coûte « around 75% less to run » que Haiku 4.5 en moyenne. C'est le chiffre honnête pour planifier, pas les 90 %. Haiku 4.5 est toujours indiqué comme actif sur la page des dépréciations, avec un retrait pas avant le 15 octobre 2026, donc vous avez le temps de mesurer avant de migrer. Si vous l'utilisez dans Claude Code, mon guide Claude Code Haiku couvre le changement.
L'effort est l'autre curseur du prix
Haiku 5.5 est le premier Haiku doté d'un réglage d'effort, et la valeur par défaut de l'API est medium. Les tokens de raisonnement sont facturés comme sortie, et on ne peut pas désactiver complètement le raisonnement au-dessus de high, donc l'effort décide combien de ces tokens de sortie à 0,50 $ vous achetez par réponse.
Artificial Analysis a exécuté son Intelligence Index à chaque niveau. Le coût de l'exécution complète est la façon la plus nette de voir l'écart :
| Effort | Intelligence Index | Coût d'exécution de l'index | Tokens de sortie utilisés |
|---|---|---|---|
| Low | 29,4 | 34,31 $ | 32M |
| Medium (défaut de l'API) | 34,5 | 56,36 $ | 54M |
| High | 37,8 | 94,07 $ | 97M |
| Xhigh | 41,2 | 157,58 $ | 180M |
| Max | 43,4 | 330,25 $ | 440M |
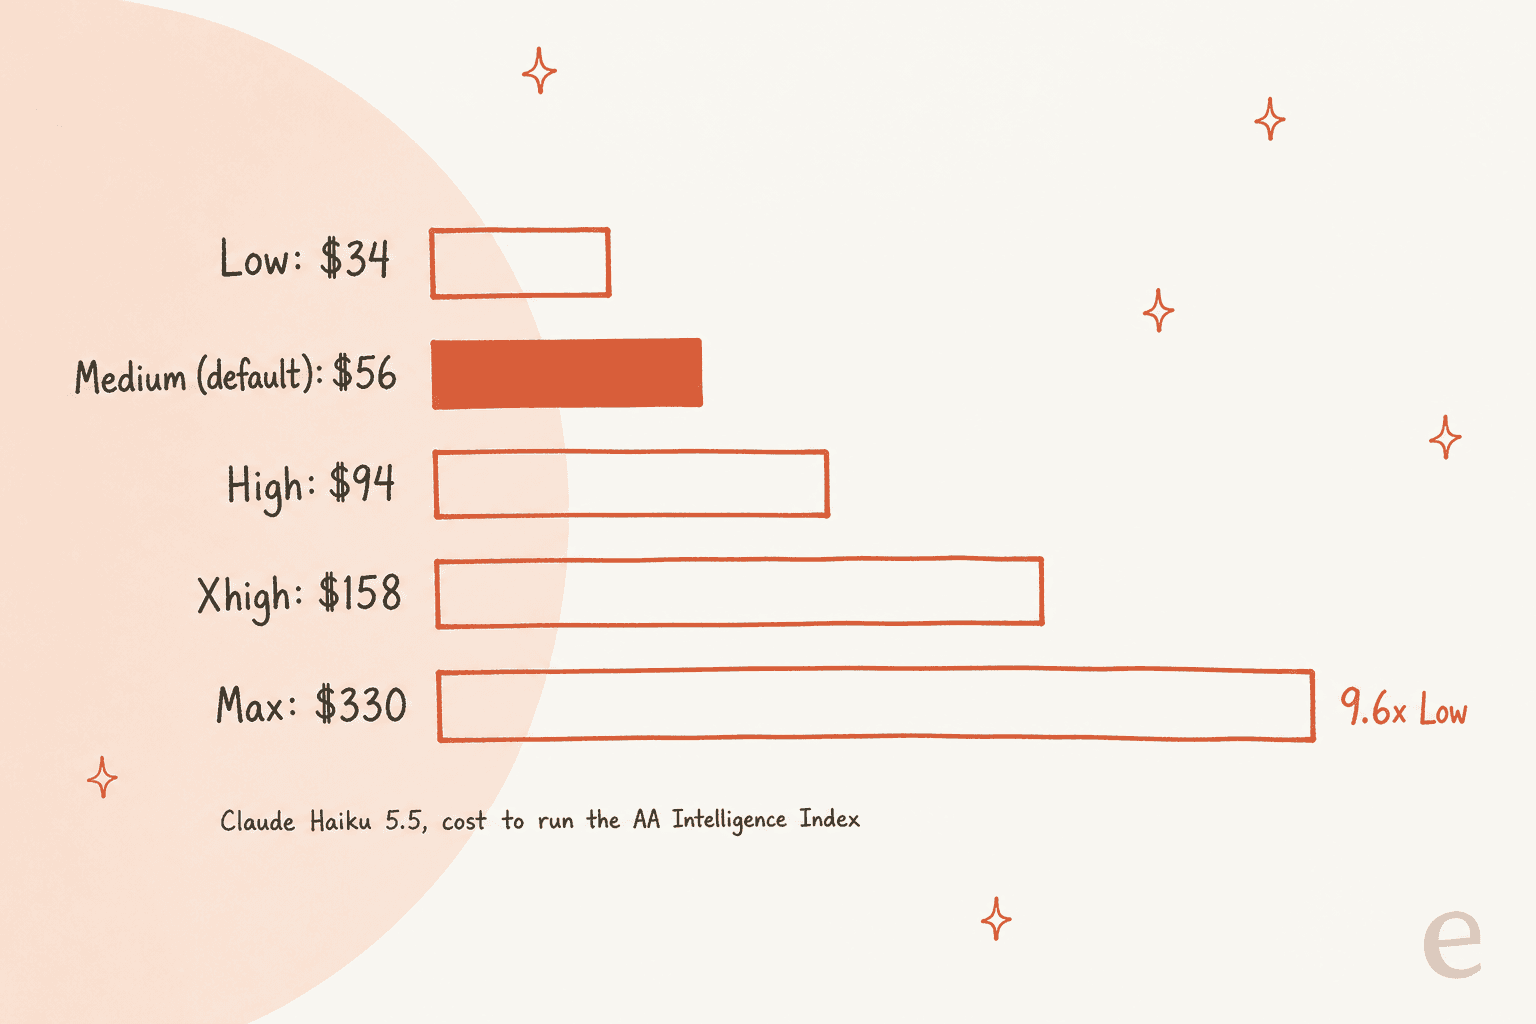
Max coûte 9,6 fois ce que coûte Low pour le même ensemble de tâches, pour un gain de 14 points sur l'index. AA a mesuré environ 162k tokens de sortie par tâche en Max et a qualifié le modèle de « very verbose ». Au prix catalogue, cela fait 0,21 $ par tâche en Max, et ces chiffres utilisent le tarif sous 100k, car AA précise qu'il ne reflète pas encore la tarification par paliers.
Un test plus modeste montre la même allure. Simon Willison a dessiné son pélican habituel à chaque niveau : Low a coûté 0,0936 cent et pris 7 secondes, tandis que Max a pris 5 minutes 9 secondes et coûté 3,3826 cents. Medium et tout ce qui est au-dessus ont réussi le cadre du vélo.
Mon avis est simple. Pour étiqueter et router des tickets, ou faire de courts résumés, commencez à Low et ne montez que lorsqu'un jeu de test montre une perte de précision. Pour une réponse qui doit raisonner sur une politique, Medium est le défaut pour une raison. Je paierais rarement Max sur Haiku.
Un commentateur de HN a lu les chiffres d'AA comme plaçant Haiku au niveau Max à parité de coût par tâche avec GPT-6.1 Sol en medium, un modèle bien plus puissant. À ce stade, mieux vaut passer à Sonnet 5.5 avec un effort plus bas. Mon guide de sélection de modèle explique quand monter en gamme.
Ce que paie réellement une équipe de support
Le tri du support est la charge de travail que l'article de lancement d'Anthropic nomme directement, avec la classification et le routage ainsi que « live customer support ». C'est aussi là que j'ai vu le modèle le moins cher faire le travail le plus utile. Lors d'un essai eesel sur du trafic Zendesk réel d'une boîte e-commerce d'environ 1 000 tickets par mois, 22 % des tickets entrants étaient du spam, et le passage de tri a atteint 93 % de précision avec 100 % de détection du spam et zéro faux positif. C'est un travail qu'un petit modèle devrait assumer, et il n'a pas besoin de longs prompts. Mon comparatif de la meilleure IA pour le tri de tickets couvre les outils conçus pour cela, et le guide du coût de l'IA pour le service client place la facture du modèle à côté du reste du budget.
Voici deux charges de travail à 20 000 tickets par mois, chacune tarifée à partir de la grille. Les nombres de tokens sont des hypothèses, remplacez-les par les vôtres dans le calculateur plus bas. Les écritures de cache sont omises, car un cache chaud en dépense peu.
Étiquetage et routage de tickets (sous le seuil)
Chaque requête embarque un prompt système de 2 500 tokens avec votre liste d'étiquettes plus un ticket de 1 500 tokens, puis renvoie environ 400 tokens avec l'étiquette et une courte raison.
| Configuration | Par ticket | Par mois (20 000 tickets) |
|---|---|---|
| Haiku 5.5, sans cache | 0,0006 $ | 12,00 $ |
| Haiku 5.5, prompt système en cache | 0,000375 $ | 7,50 $ |
| Haiku 5.5, cache plus Batch | environ 0,00019 $ | environ 3,75 $ |
| Haiku 4.5, même texte (moins de tokens) | 0,0046 $ | 92 $ |
| Sonnet 5.5, sans cache | 0,012 $ | 240 $ |
À cette échelle, la facture du modèle est quasiment une erreur d'arrondi. Ce qui coûte de l'argent, c'est tout ce qui l'entoure, comme le brancher au helpdesk, écrire les règles d'étiquettes, puis vérifier les étiquettes qu'il rate. Les guides sur la classification de tickets par IA, le routage de tickets et la connexion de Claude à votre helpdesk couvrent ce volet.
Rédiger des réponses avec le contexte de la base de connaissances (au-dessus du seuil)
Maintenant un bot de réponse. Chaque requête charge 80 000 tokens d'articles du centre d'aide et de macros qui restent identiques d'un ticket à l'autre, plus 40 000 tokens d'historique du ticket et de données de commande, et rédige une réponse de 2 000 tokens avec son raisonnement. Cela fait 120k tokens de prompt, donc au-dessus du seuil.
| Configuration | Par ticket | Par mois (20 000 tickets) |
|---|---|---|
| Haiku 5.5, prompt de 120k, sans cache | 0,065 $ | 1 300 $ |
| Haiku 5.5, prompt de 120k, 80k en cache | 0,029 $ | 580 $ |
| Haiku 5.5, réduit à 95k, sans cache | 0,0105 $ | 210 $ |
| Haiku 5.5, réduit à 95k, 80k en cache | 0,0033 $ | 66 $ |
| Sonnet 5.5, prompt de 120k, 80k en cache | 0,108 $ | 2 160 $ |
| GPT-6 Luna, prompt de 120k, 80k en cache | 0,0058 $ | 116 $ |
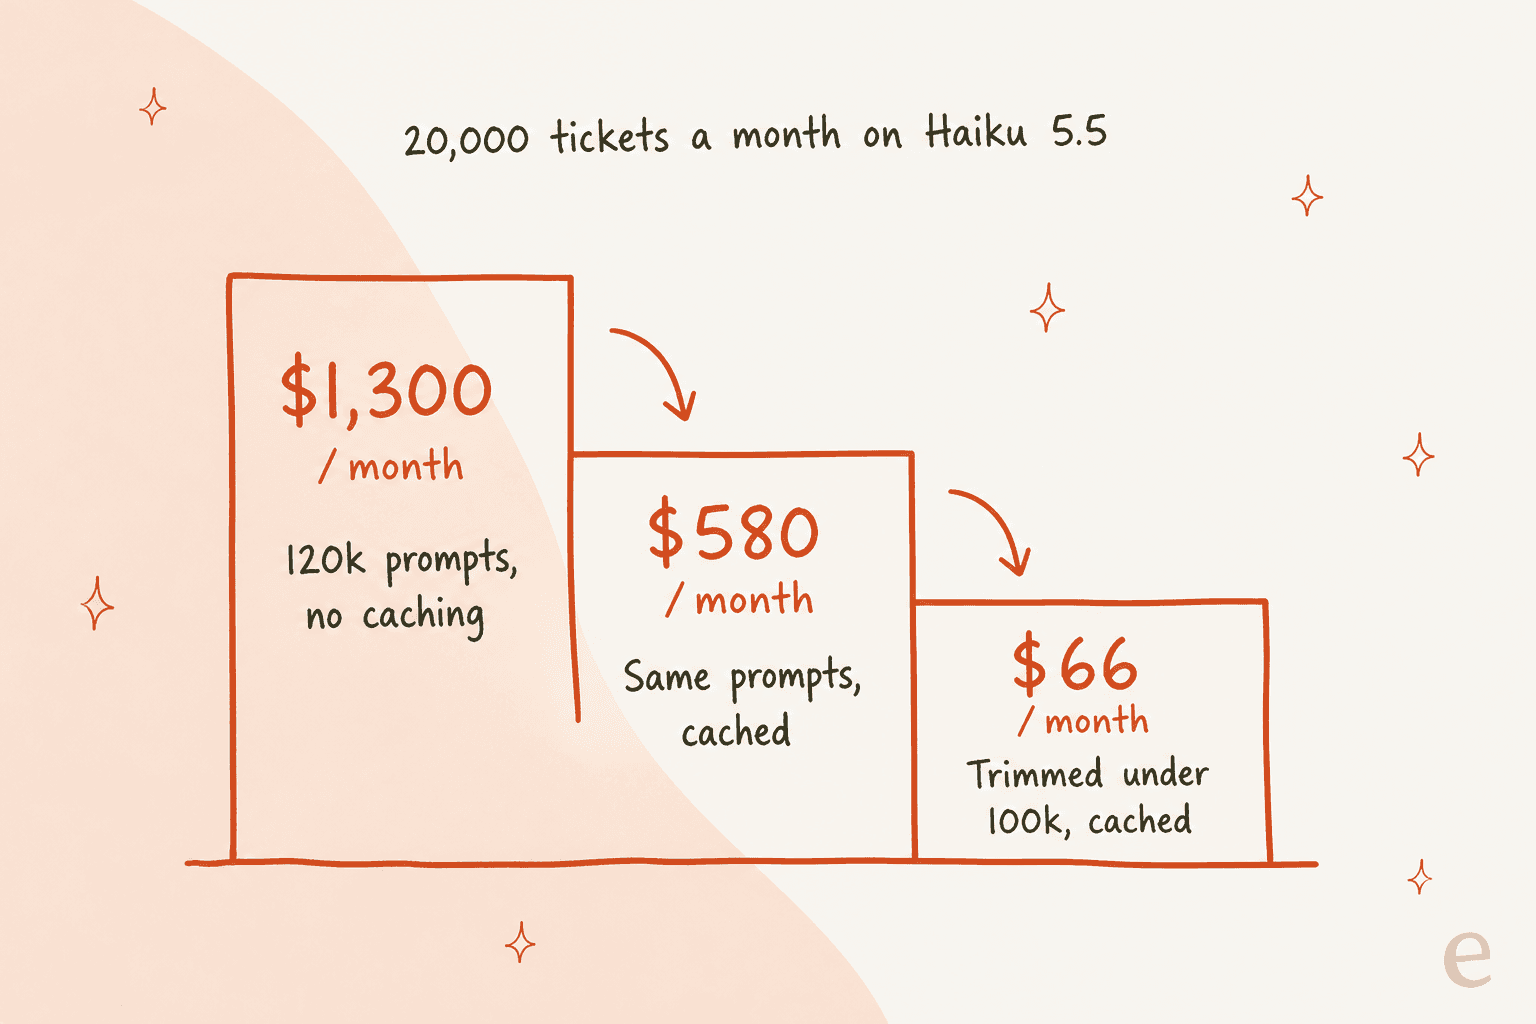
Le cache seul réduit la facture de plus de moitié. Raccourcir le prompt de 25k tokens la réduit encore de 9 fois, de 580 $ à 66 $. Ce raccourcissement, c'est généralement juste la recherche d'information qui fait son travail : récupérer les cinq articles d'aide les plus pertinents plutôt qu'une catégorie entière, et résumer l'ancien historique du ticket au lieu de le coller. Haiku est lui-même bon pour cette étape de résumé, au tarif économique.
La ligne Luna utilise les mêmes nombres de tokens, ce qui flatte Claude, puisqu'OpenAI compte moins de tokens pour le même texte. Le prix de Luna n'augmente qu'à partir de 272k tokens, donc sur ce profil il reste bien en dessous de Haiku. Plus de détails dans la comparaison ci-dessous et dans mon analyse des tarifs GPT-6 Luna.
Estimez votre propre facture Haiku 5.5
Choisissez un préréglage ou saisissez vos chiffres. La barre montre où se situe votre prompt par rapport au seuil de 100k, puis les lignes comparent la même charge sur Haiku 4.5 et Sonnet 5.5, avec GPT-6 Luna également présent.
Deux choses à essayer. Réglez le prompt du préréglage Reply à 99 000 puis à 101 000, et observez le saut du chiffre mensuel. Activez ensuite Batch, qui divise chaque ligne par deux mais ne convient qu'au travail qui peut attendre jusqu'à 24 heures, par exemple l'étiquetage nocturne d'un arriéré ou les résumés hebdomadaires de tickets.
Batch, cache et les petits postes
Voici les leviers qui s'ajoutent au prix de base, d'après la documentation tarifaire :
| Levier | Effet sur Haiku 5.5 | À surveiller |
|---|---|---|
| Batch API | 50 % de remise sur l'entrée et la sortie, pour les deux tranches | Asynchrone, donc pas pour le chat en direct |
| Écriture de cache de 5 minutes | 1,25x l'entrée, rentabilisée après une lecture de cache | Le cache expire si le trafic est faible |
| Écriture de cache d'1 heure | 2x l'entrée, rentabilisée après deux lectures de cache | Utile pour un trafic diurne régulier |
| Lecture de cache | 0,1x l'entrée (0,01 $ ou 0,05 $) | Compte toujours dans le seuil de 100k |
| Inférence réservée aux États-Unis | 1,1x sur chaque catégorie de token | Le routage mondial est le défaut |
| Prompt système d'utilisation d'outils | 286 tokens d'entrée en plus (auto, none) | En baisse par rapport aux 496 de Haiku 4.5 |
| Recherche web | 10 $ pour 1 000 recherches, plus les tokens | Les résultats ajoutent des tokens d'entrée |
| Jeu d'outils d'utilisation du navigateur | Environ 6 600 tokens d'entrée par requête | Les captures d'écran sont facturées comme entrée image |
Les modificateurs se multiplient, donc une lecture de cache dans un job Batch coûte la moitié du prix du cache. Sur un modèle aussi bon marché, la surcharge des outils compte plus qu'il n'y paraît. Un agent d'utilisation du navigateur démarre chaque requête avec environ 6 600 tokens de plus vers le seuil avant d'avoir lu la moindre page.
Haiku 5.5 face à Haiku 4.5, Sonnet 5.5 et les rivaux d'entrée de gamme
Le prix par token n'est que la moitié de la comparaison. Les tokenizers diffèrent, et la quantité que chaque modèle écrit par tâche aussi. Ce tableau place les prix catalogue à côté du coût par tâche de l'Intelligence Index d'AA, qui intègre la verbosité :
| Modèle | Entrée / sortie par 1M | Point de changement de prix | Coût par tâche selon AA |
|---|---|---|---|
| Claude Haiku 5.5 | 0,10 $ / 0,50 $ | 5x au-delà de 100k de prompt | 0,21 $ (Max) |
| GPT-6 Luna | 0,10 $ / 0,50 $ | 2x en entrée, 1,5x en sortie au-delà de 272k | 0,07 $ (Max) |
| Gemini 3.5 Flash-Lite | 0,30 $ / 2,50 $ | Aucun indiqué | 0,19 $ |
| GLM-5.3 Flash | 0,15 $ / 0,50 $ | Aucun indiqué | 0,25 $ |
| DeepSeek V4.1 Flash | 0,15 $ à 0,30 $ / 0,60 $ à 1,20 $ | Les heures de pointe coûtent 2x | Non mesuré |
| Claude Haiku 4.5 | 1 $ / 5 $ | Plafond de contexte de 200k | Non mesuré |
| Claude Sonnet 5.5 | 2 $ / 10 $ | Fixe jusqu'à 1M | Non mesuré |
Les prix proviennent de la page tarifaire de chaque fournisseur, et la grille complète d'OpenAI se trouve dans mon guide OpenAI API pricing.
Si Gemini 3.8 Flash vous tente, gardez en tête que la page tarifaire de Google double son prix le 1er janvier 2027.
La comparaison réelle la plus nette que j'aie trouvée venait d'un développeur qui a exécuté la même tâche de classification sur les deux :
"I compared the costs between luna and haiku for some classification work. Luna comes out a fair amount cheaper due to more efficient tokenization and less outputs."
Ses chiffres : Haiku 5.5 a utilisé 11 893 643 tokens d'entrée et coûté 0,42 $ en synchrone, tandis que GPT-6 Luna a utilisé 7 903 468 tokens d'entrée pour le même travail et coûté 0,31 $. Même prix catalogue, pourtant la facture de Haiku est ressortie 35 % plus haute. Le benchmark d'analyse de données de Plotly racontait la même chose, Luna faisant « a bit better » pour environ 30 % du coût de Haiku.
Alors pourquoi payer plus pour Haiku ? La vitesse, et dans certains tests aussi la qualité. AA a mesuré de 137 à 243 tokens de sortie par seconde selon les niveaux d'effort, et un commentateur a rapporté qu'OpenRouter affichait environ le double du débit de Luna. Anthropic en fait son modèle le plus rapide à vitesse standard, d'où le support client en direct cité comme cas d'usage. Un bot lent vous coûte plus en temps d'agents humains que n'importe quelle ligne de tokens. Mon article sur les alternatives à Haiku 5.5 détaille quand changer, et la comparaison des trois API explique comment choisir un fournisseur.
Face aux propres modèles d'Anthropic, le cran supérieur compte davantage. Sonnet 5.5 coûte 20 fois le prix d'entrée de Haiku à prompts courts, mais seulement 4 fois celui de Haiku au-dessus du seuil, et il n'a aucun seuil. Si la plupart de vos requêtes se situent entre 100k et 400k tokens, passez les deux dans le calculateur ci-dessus avant de présumer que Haiku l'emporte. L'analyse des tarifs Sonnet 5.5 (et l'ancien Sonnet 5 pricing) couvre aussi la baisse le même jour de la lecture de cache, de 0,20 $ à 0,10 $, qui rend Sonnet 5.5 environ 20 % moins cher sur la plupart des tâches d'agents selon Anthropic.
Utiliser Haiku 5.5 avec un forfait Claude ou des crédits API
Si vous voulez seulement discuter avec Haiku, vous ne payez pas du tout au token, et mon guide des tarifs Claude compare les forfaits en détail. La page des forfaits Claude liste Haiku sur Free, Pro, Max et Team. Pro coûte 17 $ par mois en facturation annuelle (20 $ en mensuel), Max démarre à 100 $, et les sièges Team coûtent 20 $ en Standard ou 100 $ en Premium par siège en facturation annuelle.
Le nouvel angle, ce sont les crédits API. Avec Haiku 5.5, Anthropic a commencé à offrir aux abonnés Max et Team un crédit mensuel pour la Claude Platform :
| Forfait | Crédit API mensuel |
|---|---|
| Max 5x | 100 $ |
| Max 20x | 200 $ |
| Team, siège Standard | 20 $ par siège |
| Team, siège Premium | 100 $ par siège |
| Plafond du pool Team | 500 $ par mois |
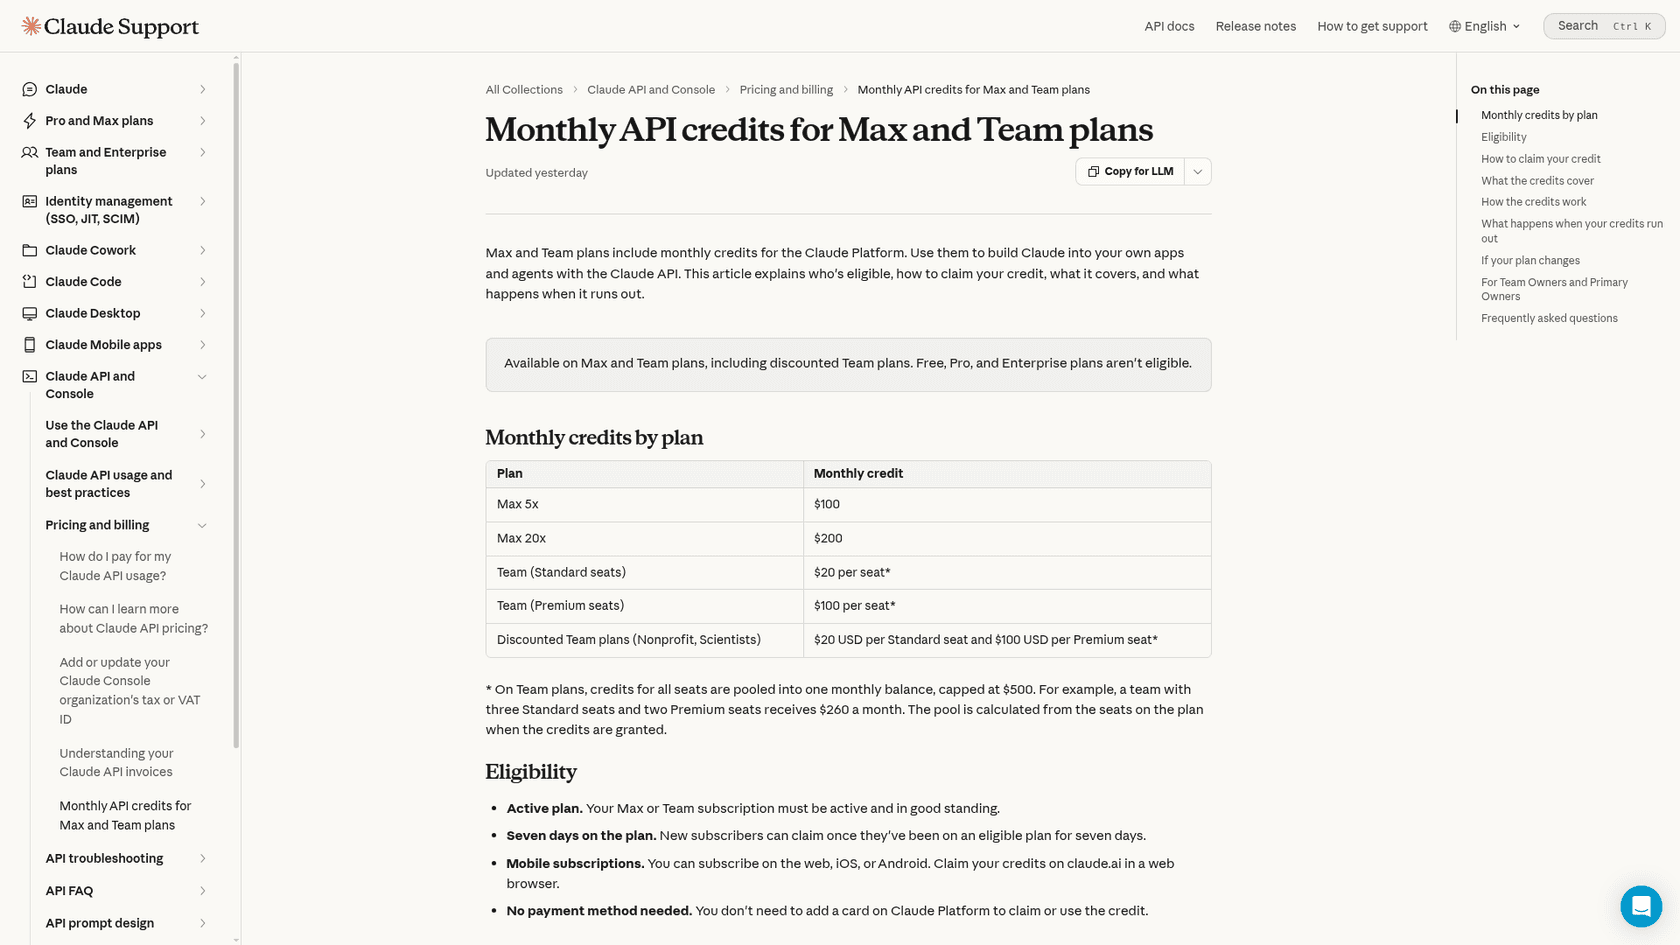
L'article d'aide donne les règles. Free, Pro et Enterprise ne sont pas éligibles, et il faut être sur le forfait depuis sept jours. Les crédits ne se reportent pas, ce qu'il faut garder en tête, et ils couvrent l'API ainsi que les Batches, Managed Agents et l'Agent SDK, de même que claude -p avec une clé API. Ils ne couvrent ni Claude Code en mode interactif ni l'usage sur Bedrock, Vertex AI ou Foundry.
Sur Haiku 5.5, ce crédit va loin. D'après mes calculs, 100 $ achètent environ 1 milliard de tokens d'entrée à prompts courts ou 200 millions de tokens de sortie par mois. La charge d'étiquetage en cache ci-dessus tournerait environ un an avec un mois de crédit Max 5x. Un projet perso ou un outil interne peut tenir entièrement dans le crédit, tant qu'il reste sous le seuil.
Ce que disent les développeurs du prix
Le fil de lancement s'est divisé autour d'une question : votre travail tient-il dans 100k tokens ?
"noticeably smarter remains to be seen in practice. For now, Haiku is a bit more expensive than Luna on < 100k token, but I just don't have any agentic work below 100k, so this is going to be 5x more expensive than shown on these charts."
L'autre camp voit le seuil comme un compromis acceptable pour le travail de sous-agents :
"I would mostly use Haiku in task or explorer subagents. I'm not saying I stay under that on every task, but I do have quite a few sessions that cap out well below that, so that price difference would be very meaningful."
Et un commentateur a lu toute la structure comme une manœuvre tarifaire plutôt qu'une limite technique :
"I'd consider the 100k a "promotional price" to match Luna's token pricing while delivering noticeably more intelligence."
Ce dernier point est de la spéculation, et Anthropic n'a pas dit que cela changerait. C'est tout de même une bonne raison de ne pas bâtir un modèle de coûts qui ne fonctionne que si Haiku reste à 0,10 $ pour des prompts de toute taille.
Claude Haiku 5.5 vaut-il le coup à ce prix ?
Pour des tâches courtes à fort volume, oui, clairement. Classification et étiquetage, routage, extraction, courts résumés : tout cela tient sous 100k tokens, coûte des centimes pour mille appels et tourne vite en plus. En venant de Haiku 4.5, c'est la baisse de coût la plus facile de la gamme Claude, environ 87 % par mot de texte. Si vous utilisez Claude pour Zendesk ou un script de tri maison, c'est le modèle à migrer en premier. Le guide Claude pour le support client détaille la mise en place.
Pour les agents à long contexte, c'est plus serré. Au-dessus du seuil, Haiku coûte un quart de Sonnet 5.5 par token, sans plafond sur le nombre de fois où vous le franchissez, et GPT-6 Luna reste moins cher jusqu'à 272k. Mesurez la taille de vos prompts avant de migrer, puis concevez la recherche d'information pour rester sous le seuil si possible.
Le tableau complet de la qualité est dans mon test de Haiku 5.5, où le fil HN compte aussi des développeurs qui signalent des régressions par rapport à Haiku 4.5 sur leurs propres évaluations. Un modèle moins cher qui demande de réécrire les prompts n'est pas moins cher tant que cette réécriture n'est pas faite.
Confiez la file de tri à eesel
Si vous étudiez le prix de Haiku 5.5 à cause de votre file de support, la facture de tokens est la plus petite partie du travail, un point que mon analyse des économies de coûts du support par IA illustre avec des chiffres réels. Il vous faut encore l'intégration au helpdesk et les règles d'étiquettes, puis un moyen de tester sur des tickets passés, et quelqu'un qui surveille ce qu'il rate. C'est ce travail qu'eesel vous retire des mains.
Le coéquipier IA pour helpdesk d'eesel rejoint le helpdesk que vous avez déjà, comme Zendesk, Freshdesk ou Gorgias, apprend de vos tickets passés, puis étiquette et route les tickets, rédige des réponses ou y répond.
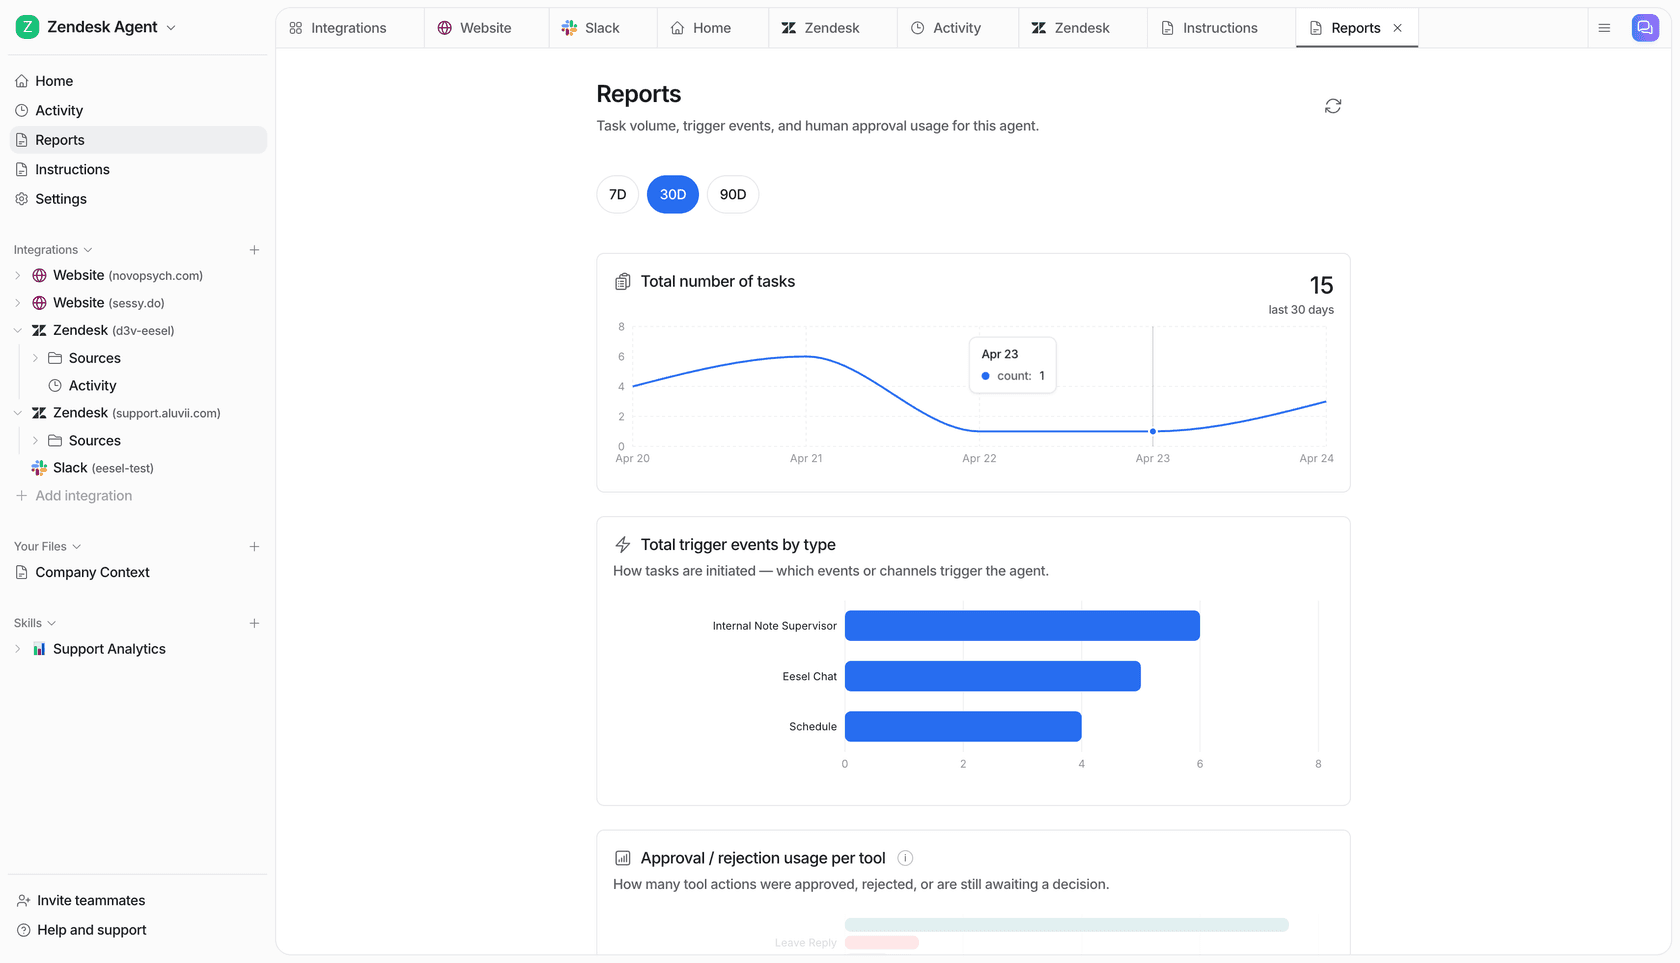
Avant qu'il ne touche un vrai client, je le ferais tourner sur vos tickets historiques, et cette simulation est intégrée. Vous pouvez suivre ce qu'il fait dans la vue des rapports :
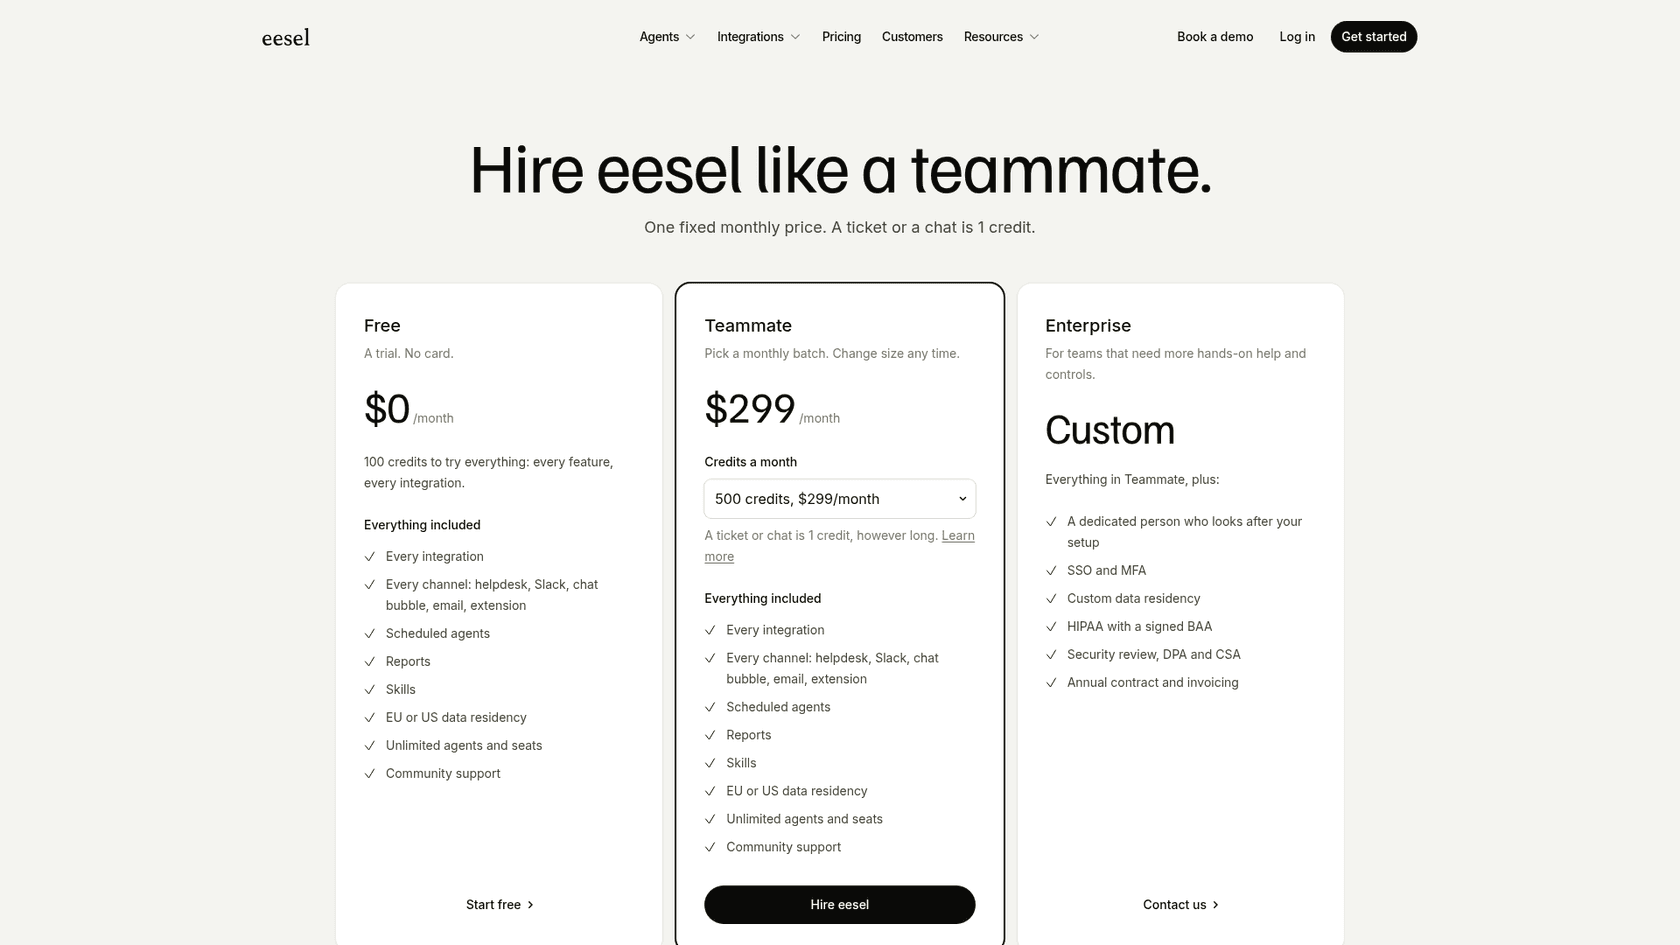
La tarification est l'opposé d'un compteur de tokens. Un ticket ou un chat vaut un crédit quelle que soit sa durée, donc un fil de 120k tokens coûte autant qu'une question de deux lignes. Les forfaits démarrent à 299 $ par mois pour 500 crédits et montent jusqu'à 1 749 $ pour 5 000, avec un essai gratuit de 100 crédits et sans carte. La prévisibilité compte plus qu'on ne le croit. Un utilisateur d'essai d'eesel, sur Gorgias, a vu son agent gérer 12 chats de test sans problème, puis a demandé à résilier dès qu'il est arrivé sur la page de facturation. Comparez avec des outils facturés à l'usage comme Zendesk AI pricing, où la facture bouge à chaque résolution.
Pour être franc sur l'adéquation : si vous n'avez besoin que d'un script d'étiquetage et que vous avez des ingénieurs, l'API brute de Haiku 5.5 à 12 $ par mois est moins chère, et vous devriez l'utiliser. eesel a du sens quand vous voulez le coéquipier complet, du tri aux réponses, sans construire vous-même le pipeline. Si vous préférez automatiser le support depuis la ligne de commande, la CLI d'eesel pilote le même coéquipier, de sorte que vous ou un agent de code pouvez scripter ses instructions et ses validations, ainsi que le journal d'activité. Essayez eesel gratuitement sur un échantillon de vos vrais tickets et voyez ce que donne le tri avant d'écrire une ligne de code.