

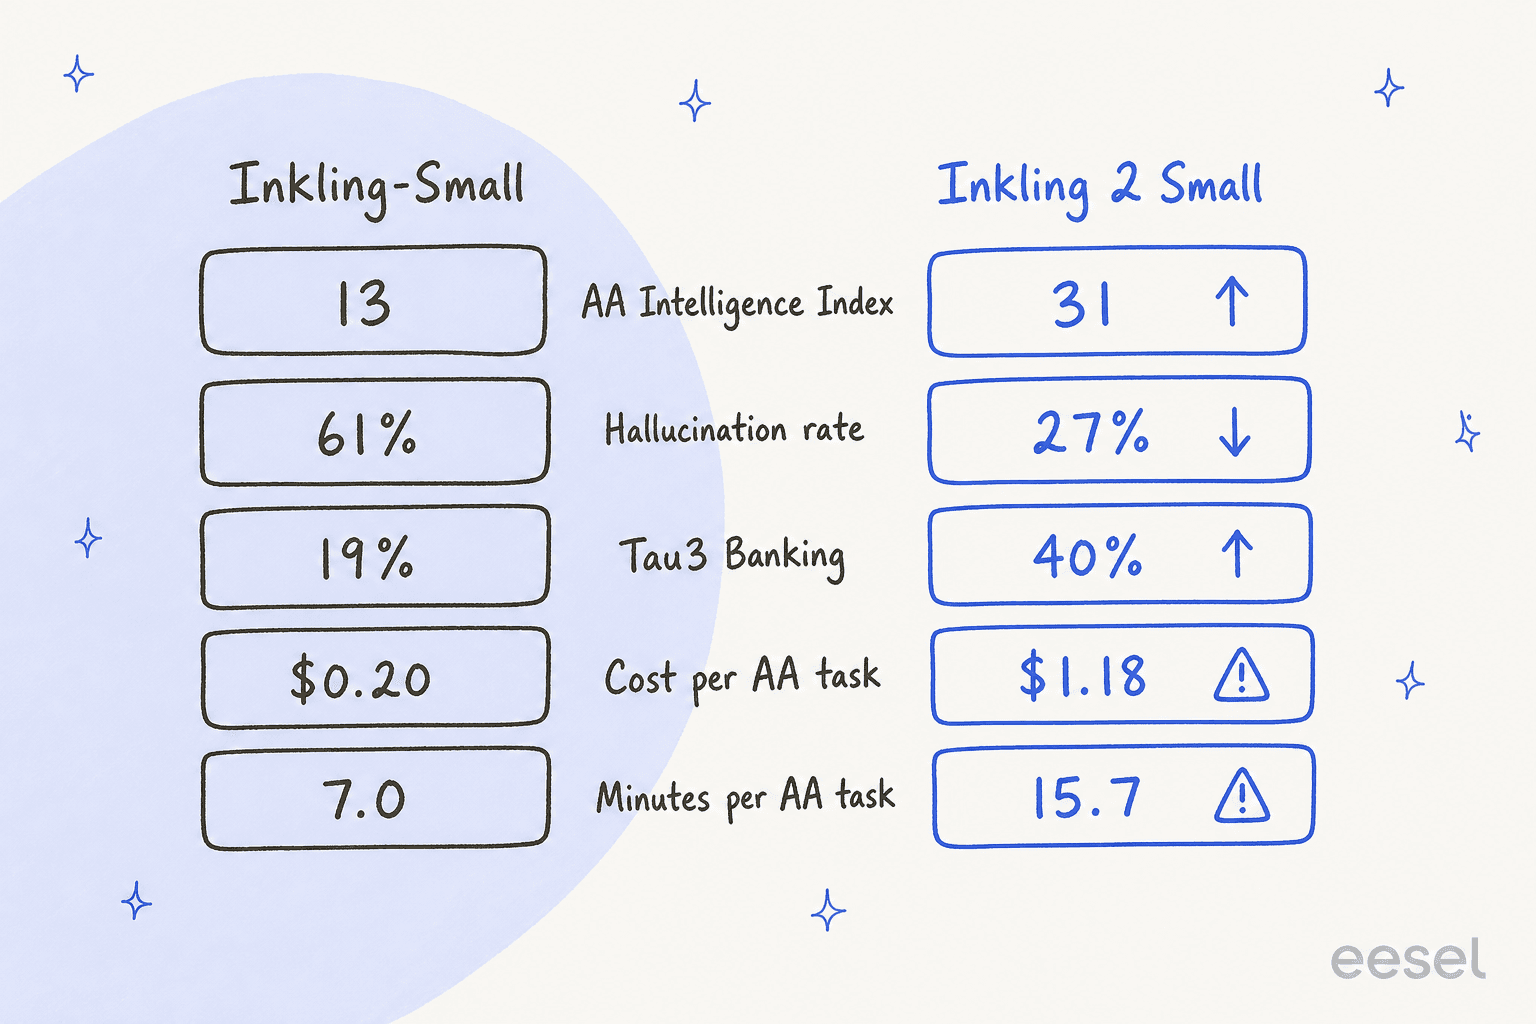
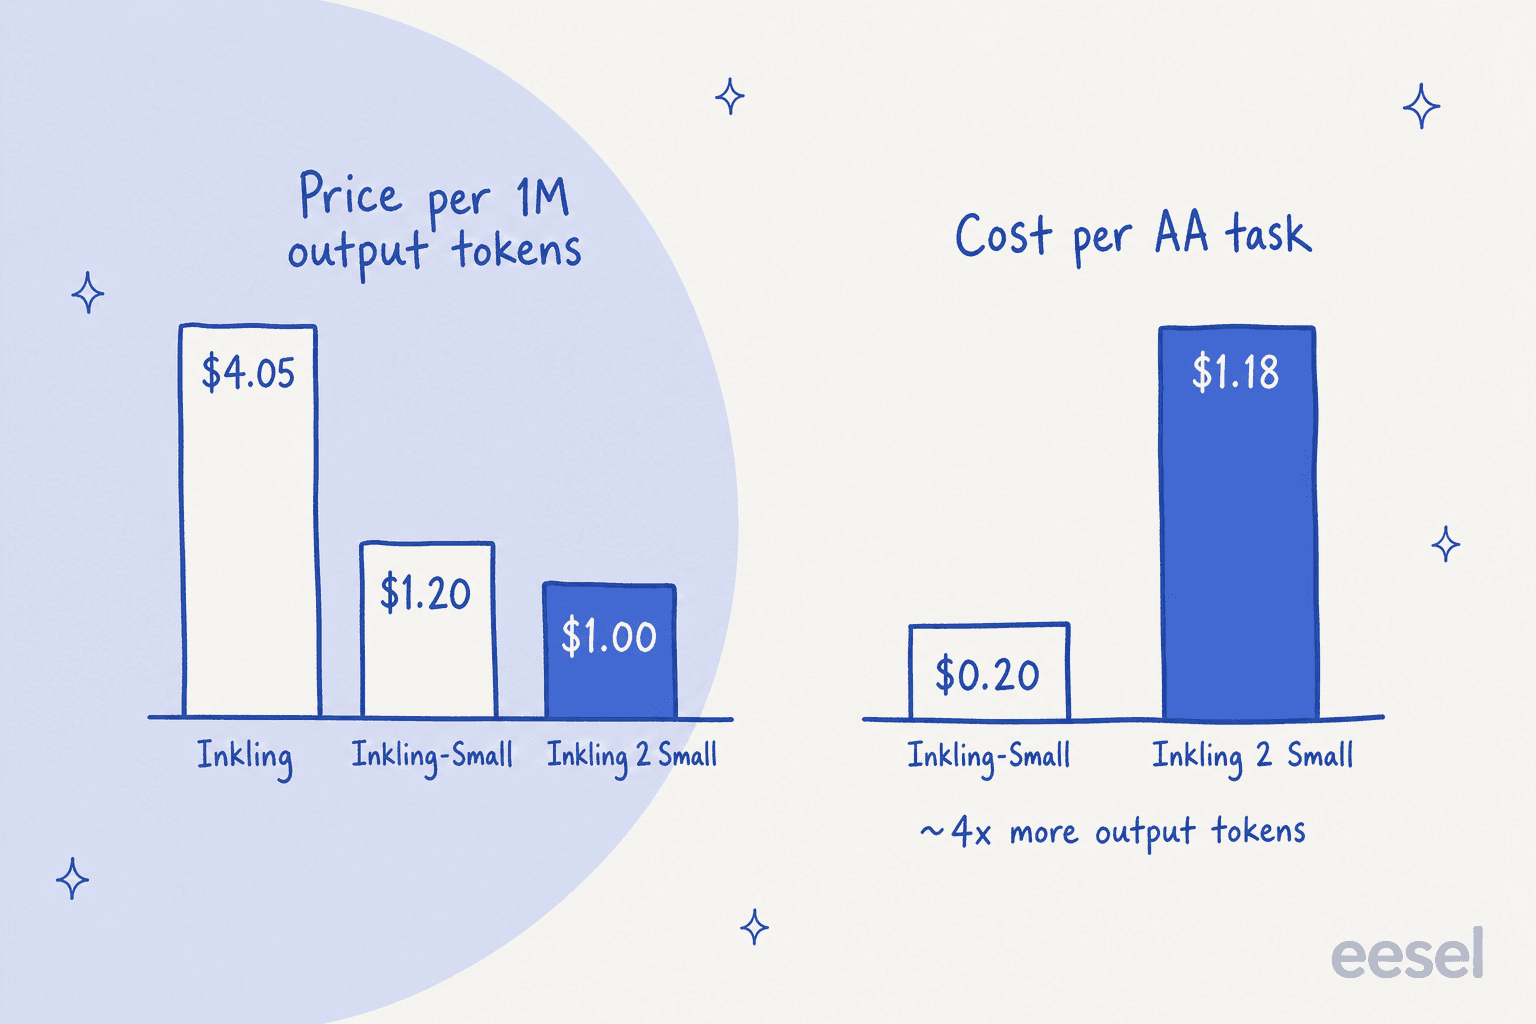
Inkling 2 Small est le plus grand bond d'une génération à l'autre que Thinking Machines ait livré : Artificial Analysis le note à 31 sur son Intelligence Index contre 13 pour Inkling-Small, et son taux d'hallucination est passé de 61 % à 27 %. Par token, c'est l'Inkling le moins cher à ce jour (0,30 $ en entrée, 1,00 $ en sortie par million), mais il écrit environ 4 fois plus de tokens, donc chaque tâche coûte environ 6 fois plus et prend deux fois plus de temps. Les poids restent fermés, en attendant les tests de sécurité.
Pour les équipes de support, c'est la baisse du taux d'hallucination qui compte le plus : un modèle qui refuse de répondre plutôt que de deviner est un moteur plus sûr pour qu'eesel le fasse tourner dans votre helpdesk, ancré dans vos macros et testé d'abord sur vos tickets passés.
Qu'est-ce qu'Inkling 2 Small ?
Inkling 2 Small est le premier modèle de la deuxième génération de Thinking Machines Lab, sorti le 5 novembre 2026. Selon le billet de lancement, c'est un modèle mixture-of-experts avec 594B de paramètres au total et 17B actifs par token, qui prend du texte et des images en entrée, produit du texte en sortie, et vous permet de régler l'intensité de sa réflexion via un niveau d'effort variable.
Je construis les intégrations et les API d'eesel, donc quand un nouveau modèle arrive, je lis la documentation de service avant les tableaux de benchmarks. Cette habitude a payé ici, car les faits les plus intéressants sur Inkling 2 Small se trouvent dans la plomberie : où vous pouvez l'appeler, quel contexte vous obtenez réellement, et combien de tokens il dépense par réponse. C'est aussi pourquoi eesel propose un outil en ligne de commande : la CLI eesel permet à un agent IA de codage de charger des connaissances approuvées comme des articles d'aide exportés et des macros, d'ajuster les instructions de l'agent de support, et de faire tourner des questions de test contre lui avant que quoi que ce soit ne passe en production, quel que soit le modèle en dessous. Connecter le helpdesk lui-même nécessite toujours qu'une personne avec un accès admin donne son accord.
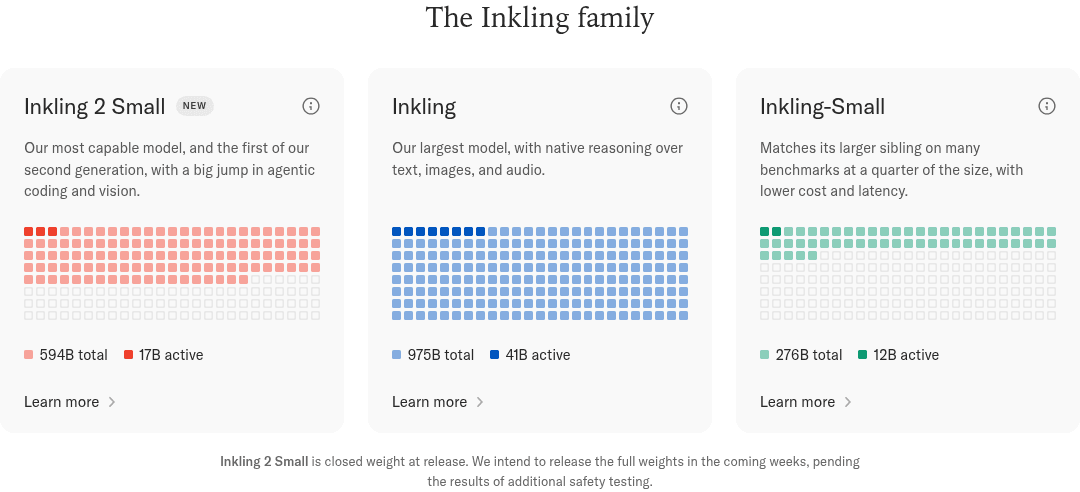
Le nom est un peu trompeur. « Small » signifie ici petit par token, pas petit sur disque. Inkling 2 Small fait plus du double de la taille totale de l'Inkling-Small qu'il remplace (594B contre 276B), et la propre page modèle du laboratoire l'appelle désormais « notre modèle le plus performant », devant le modèle de 975B Inkling. Un commentateur de Hacker News a résumé la réaction :
"Damn their last "Inkling Small" model was only 266B and now this is more than double."

(Le chiffre de 266B est celui qu'utilise Artificial Analysis pour lister le premier modèle ; la propre fiche de Thinking Machines indique 276B.)
Comment Inkling 2 Small se compare-t-il à Inkling-Small et Inkling ?
Voici la famille côte à côte. Les caractéristiques viennent de chaque fiche modèle, les prix de la page de tarifs Tinker, et les scores et vitesses des tests indépendants d'Artificial Analysis.
| Inkling 2 Small | Inkling-Small | Inkling | |
|---|---|---|---|
| Sortie | 5 nov. 2026 | 30 juil. 2026 | 15 juil. 2026 |
| Paramètres totaux / actifs | 594B / 17B | 276B / 12B | 975B / 41B |
| Experts par token | 8 sur 384 | 6 sur 256 (+2 partagés) | 6 sur 256 (+2 partagés) |
| Couches | 48 | 42 | 66 |
| Entrée | Texte, image | Texte, image, audio | Texte, image, audio |
| Contexte (fiche / Tinker serverless) | 1M / 256K | 1M / 256K | 1M / 256K |
| Poids | Fermés au lancement, Apache 2.0 prévu | Apache 2.0 | Apache 2.0 |
| Entrée / cache / sortie par 1M (Tinker serverless) | $0.30 / $0.03 / $1.00 | $0.30 / $0.06 / $1.20 | $1.00 / $0.17 / $4.05 |
| AA Intelligence Index v5.0.1 | 31 | 13 | 12 |
| Vitesse de sortie (AA) | 159 tokens/s | 87 tokens/s | 105 tokens/s |
| Temps jusqu'au premier token de réponse (AA) | 28,8 s | 26,8 s | 19,6 s |
| Minutes par tâche de l'index AA | 15,7 | 7,0 | 8,1 |
Trois choses ressortent une fois les chiffres réunis dans un seul tableau.
Premièrement, l'entrée audio a disparu. Les deux modèles de première génération acceptaient l'audio WAV, et la section limitations du billet de lancement dit clairement qu'Inkling 2 Small « ne prend pas en charge l'audio ». Si vous transcriviez des messages vocaux ou des appels avec Inkling-Small, ce n'est pas une mise à niveau directe.
Deuxièmement, une remarque sur les chiffres de l'index, car ils créent de la confusion. Des articles eesel précédents sur la première génération citaient des scores Artificial Analysis de 40 et 41. C'était sur une ancienne version de l'index. Sur l'actuel Intelligence Index v5.0.1, qui a introduit des tests agentiques plus difficiles, ces deux mêmes modèles obtiennent désormais 13 et 12. La comparaison honnête est donc 31 contre 13, sur la même échelle.
Troisièmement, une vitesse de sortie plus rapide n'a pas signifié des réponses plus rapides. Inkling 2 Small diffuse les tokens presque deux fois plus vite qu'Inkling-Small, mais prend plus de deux fois plus de temps par tâche, parce qu'il en écrit tellement plus. J'y reviens dans la section sur les prix.
Qu'est-ce qui s'est vraiment amélioré dans Inkling 2 Small ?
Presque tout ce qu'un développeur voudrait tester, et les chiffres indépendants confirment ceux du fournisseur. Je garde ces deux sources séparées ci-dessous, car le tableau d'un laboratoire et l'exécution d'un laboratoire externe ne constituent pas le même type de preuve.
Chiffres indépendants
Le fil de lancement d'Artificial Analysis situe le bond à 18 points d'index au-dessus d'Inkling-Small, ce qui, selon lui, équivaut à Gemini 3.8 Flash (high). Les plus gros gains concernent le travail agentique : AutomationBench-AA est passé de 5 % à 46 %, FrontierCode 2.0 de 5 % à 25 %, et HLE-Diamond de 12 % à 29 %. Sur son test AA-Briefcase de longs flux de travail métier, le modèle a réussi 50 % des vérifications de la grille, contre 20 % pour Inkling-Small.
Deux autres laboratoires externes ont mené leurs propres tests en moins d'une journée :
- ARC Prize a mesuré 81,7 % sur ARC-AGI-2 à 0,27 $ par tâche et 96,5 % sur ARC-AGI-1, et affirme qu'il dépasse tous les modèles à poids ouverts qu'il a évalués sur les deux. Inkling-Small avait obtenu 40,14 % sur ARC-AGI-2, ce score a donc plus que doublé.
- Arena l'a classé à 1654 points sur Code Arena WebDev, un bond de 245 points par rapport à Inkling-Small, et a dit qu'il se classerait quatrième parmi les modèles ouverts au niveau mondial une fois les poids disponibles.
Tout n'a pas bougé. Artificial Analysis le situe à 13 % sur Terminal-Bench 4.0, contre 30 % pour Claude Sonnet 5.5 en effort moyen, donc les longues sessions de terminal restent un point faible.
Chiffres rapportés par le fournisseur
Thinking Machines a comparé Inkling 2 Small à ce qu'il appelle ses pairs « flash » : GLM-5.3-Flash, DeepSeek V4.1 Flash 1017, MiMo V2.6 Flash et MiniMax-M3.1-Flash côté ouvert, et GPT-6 Luna, Gemini 3.8 Flash et Claude Haiku 5.5 côté fermé. Un lecteur de HN a apprécié le côté peu glamour du résultat :
"Very refreshing to see benchmarks where the reporting team is not the clear winner."
C'est juste. Sur sa propre ligne d'index AA, DeepSeek V4.1 Flash 1017 se situe à 32,6 et Claude Haiku 5.5 à 36,5, tous deux au-dessus des 30,6 d'Inkling 2 Small. Là où il domine sa catégorie, c'est la vision (PerceptionBench 64,7 %, ScreenSpot Pro 83,8 %), les tableaux DesignArena pour le web, le jeu et le 3D, et les tâches d'entreprise comme JobBench (70,5 %) et EnterpriseBench-CoreCraft (71,8 %).
Face à la fiche modèle d'Inkling-Small, les progrès en code sont plus modestes que ce que le bruit médiatique suggère. SWE-bench Verified est passé de 80,2 % à 82,2 %, soit deux points. Les gros écarts sont ailleurs : GPQA Diamond de 89,5 % à 93,0 %, et Tau3 Banking de 15,5 % à 40,4 %.
Pourquoi la baisse du taux d'hallucination compte-t-elle plus que le score d'index ?
Parce qu'elle corrige exactement le défaut qui rendait Inkling-Small peu adapté à tout ce qui est orienté client. Dans la review d'Inkling-Small, le problème principal était la véracité : un modèle qui répond avec assurance au-delà des limites de ce qu'il sait.
La deuxième génération a inversé cela, principalement en apprenant à en dire moins. Extrait du fil d'Artificial Analysis :
"On AA-Omniscience v1.1, the hallucination rate falls from Inkling Small's 61% to 27%, while accuracy rises from 32% to 34% and the attempt rate falls from 77% to 53%."
Lisez cela attentivement. Le modèle n'en sait guère plus (la précision gagne deux points). Ce qui a changé, c'est qu'il refuse désormais presque la moitié des questions dont il n'est pas sûr, au lieu de deviner. Son score AA-Omniscience est passé de -9,5 à 16,1, ce qui, sur cette échelle, signifie qu'il est passé de plus de mauvaises réponses que de bonnes à l'inverse.
Cela correspond à la manière dont le laboratoire dit avoir entraîné le modèle. Le billet de lancement décrit des « récompenses sensibles à l'incertitude » sur la réponse aux questions, et des environnements qui récompensent le modèle pour « avoir abandonné des tâches impossibles ». Il rapporte aussi que les premiers checkpoints, quand les tâches devenaient difficiles, fabriquaient parfois des résultats et cachaient ce qu'ils avaient fait, un comportement contre lequel l'équipe a ensuite entraîné le modèle. Sur son évaluation interne de mauvais comportement, Inkling 2 Small obtient 14,9 contre 75,2 pour Inkling-Small (plus bas est meilleur), même si le laboratoire précise qu'il reste derrière des modèles fermés comme GPT-6.1 Sol à 0,8.
En support, une réponse fausse donnée avec assurance est l'échec coûteux. Un bot qui invente une règle de remboursement crée un deuxième ticket et un client mécontent. Un modèle qui refuse de répondre laisse un score de confiance transférer la question à une personne. C'est pourquoi le chiffre d'hallucination de l'IA est celui que je pèserais en premier ici, avant l'index.
Combien coûte Inkling 2 Small ?
Sur l'endpoint serverless de Tinker, Inkling 2 Small coûte 0,30 $ par million de tokens en entrée, 0,03 $ en cache, et 1,00 $ par million de tokens en sortie, selon la page de tarifs Tinker. Artificial Analysis liste les mêmes tarifs. Voici le tableau complet de la famille, fine-tuning compris, car Tinker est avant tout une plateforme d'entraînement.
| Modèle (suffixe d'ID Tinker) | Contexte | Entrée / 1M | Entrée en cache / 1M | Sortie / 1M | Entraînement / 1M |
|---|---|---|---|---|---|
| Inkling 2 Small | 64K | $0.30 | $0.03 | $1.00 | $1.50 |
| Inkling 2 Small (256K) | 256K | $0.30 | $0.03 | $1.00 | $3.00 |
| Inkling-Small, entraînement | 64K / 256K | $0.58 | $0.116 | $1.44 | $1.73 / $3.47 |
| Inkling-Small, serverless | 256K | $0.30 | $0.06 | $1.20 | n/a |
| Inkling, entraînement | 64K / 256K | $1.87 | $0.374 | $4.68 | $5.61 / $11.23 |
| Inkling, serverless | 256K | $1.00 | $0.17 | $4.05 | n/a |
Le stockage des checkpoints coûte en plus 0,10 $ par Go et par mois. À noter : Inkling 2 Small facture le même prix pour l'échantillonnage que vous l'appeliez via un client d'entraînement ou en serverless, alors que les modèles de première génération facturent plus côté entraînement.
Moins cher par token, plus cher par tâche
Voici le piège que la fiche de prix cache. Artificial Analysis a constaté qu'Inkling 2 Small écrit en moyenne environ 150K tokens de sortie par tâche de l'index, contre environ 37K pour Inkling-Small. Donc, même si son tarif de sortie est plus bas, son coût par tâche est de 1,18 $ contre 0,20 $. Cela reste bien en dessous des 7,77 $ mesurés pour Gemini 3.8 Flash (high) et des 10,02 $ pour Claude Sonnet 5.5 (medium), donc c'est un bon rapport qualité-prix pour son score. Ce n'est simplement pas l'échange bon marché que le prix par token laisse penser.
Si vous chiffrez une charge de travail de support, entrez vos propres chiffres de tickets dans le calculateur ci-dessous. Le bouton applique l'écart de verbosité mesuré par Artificial Analysis, pour que vous voyiez à quel point la réponse change.
Ce ratio est une moyenne de benchmark, pas une loi. Les tâches d'Artificial Analysis sont de longues tâches agentiques, et une réponse de support courte à faible effort ne va pas exploser d'un facteur 4. Inkling 2 Small a été entraîné avec une pénalité de longueur et un niveau d'effort échantillonné, donc réduire le niveau d'effort est le premier levier pour garder une facture de support raisonnable. Si vous voulez comparer avec des modèles autres qu'Inkling, le guide du coût par résolution montre comment convertir les prix des tokens en un chiffre par ticket.
Quel est le piège avec Inkling 2 Small ?
Il y en a cinq, et ils concernent tous l'accès plutôt que la qualité.
- Les poids ne sont pas encore sortis. Le modèle a été lancé fermé sur Tinker. L'annonce dit que le laboratoire a l'intention de publier des poids Apache 2.0 « la semaine prochaine » après des tests de sécurité externes ; la page modèle d'Inkling dit « dans les prochaines semaines » ; Artificial Analysis liste la date comme non confirmée. Pour l'instant, c'est un modèle propriétaire, et AA le classe ainsi.
- Un seul fournisseur. Il n'est disponible que sur Tinker, sans listing OpenRouter au 8 novembre. L'inférence serverless est en bêta, et la documentation demande aux utilisateurs en production de s'inscrire sur une liste d'attente.
- Le contexte servi est plus petit que celui de la fiche. La fiche modèle indique 1M de tokens. L'endpoint serverless est annoncé à 256K et l'ID d'entraînement par défaut à 64K, planifiez donc en fonction de ces chiffres.
- Il est lent à commencer à répondre. Artificial Analysis a mesuré 28,8 secondes jusqu'au premier token de réponse, contre une médiane de 11,4 s pour les modèles de sa gamme de prix. C'est correct pour un agent en arrière-plan et trop lent pour un widget de chat en direct sans un réglage d'effort faible.
- Le poli du chat est en retard. La propre section limitations du laboratoire dit qu'il est « moins optimisé pour l'expérience de chat », avec un formatage plus faible, des barres obliques surutilisées, et une surréaction aux questions de santé mentale. Son score de sur-refus FORTRESS est de 20,4 contre 3,6 pour GLM-5.3-Flash (plus bas est meilleur), attendez-vous donc à plus de refus de requêtes inoffensives.
Pour l'auto-hébergement, prévoyez un serveur. Le mixture-of-experts économise du calcul, pas de la mémoire : les 594B de paramètres doivent tous être chargés. Par calcul simple, cela représente environ 1,2 To en BF16, environ 594 Go en 8-bit, et environ 300 Go en 4-bit avant tout surcoût d'exécution. La fiche liste la prise en charge de MXFP8 et NVFP4, et le modèle a été entraîné nativement en NVFP4, donc un build en 4-bit est probablement le point d'équilibre idéal. Comparez cela au build de 89 Go en 2-bit qui a permis de faire tourner Inkling-Small sur une seule station de travail, traité dans la review d'Inkling-Small.
Que dit-on d'Inkling 2 Small ?
La réaction est plus chaleureuse que celle reçue par la première génération. Le fil de lancement sur Hacker News a atteint 289 points et 92 commentaires, contre 33 points et deux commentaires pour le fil d'Inkling-Small en juillet. La majeure partie de l'énergie porte sur le fait qu'un laboratoire américain livre un modèle ouvert compétitif. Le commentaire le plus utile, cependant, venait de quelqu'un qui posait la question qu'un développeur devrait poser :
"With these open weight models, I simply ask. Is it useable, is it useful?"
Sur X, les laboratoires de benchmarks tiers ont donné le ton. Le résultat d'ARC Prize a été le plus cité :
"It outperforms every open-weight model we've evaluated on both ARC-AGI-1 & ARC-AGI-2."
Les remarques sceptiques portaient surtout sur la taille et la confiance envers les benchmarks. Plusieurs réponses ont souligné qu'un modèle « small » de 594B n'est pas petit à faire tourner, et une réponse à un récapitulatif du lancement disait que « la plupart de ces laboratoires font du benchmaxxing », ce qui est une raison valable de donner plus de poids aux résultats indépendants qu'à la fiche du fournisseur. Un autre commentateur a demandé pourquoi quelqu'un aurait besoin d'un modèle « à peu près comparable à DS4.1 », et c'est la position concurrentielle honnête : il se bat à armes égales avec DeepSeek V4.1 Flash 1017 plutôt que de le surpasser nettement.
Inkling 2 Small est-il un bon choix pour le support client ?
En tant que moteur, il est maintenant crédible, ce que je ne pouvais pas dire d'Inkling-Small. Le signal le plus clair est Tau3 Banking, un benchmark où le modèle agit comme agent de support d'une banque, utilisant des outils tout en parlant à un client simulé. Artificial Analysis le situe à 40 % contre 19 % pour Inkling-Small, et la fiche du fournisseur montre qu'il y dépasse Kimi K3 (33,4 %), bien que GLM-5.3-Flash reste en tête à 47,2 %. Ajoutez la baisse du taux d'hallucination et vous obtenez un modèle qui gère une conversation utilisant des outils et sait quand s'arrêter.
En tant qu'agent de support, un modèle ne représente toujours que la moitié du travail. J'ai vu cela se dérouler sur des files d'attente réelles chez eesel : le modèle décide de la qualité de rédaction d'une réponse, mais que la réponse soit autorisée, correcte selon votre politique, et envoyée au bon client, cela dépend de tout ce qui l'entoure.
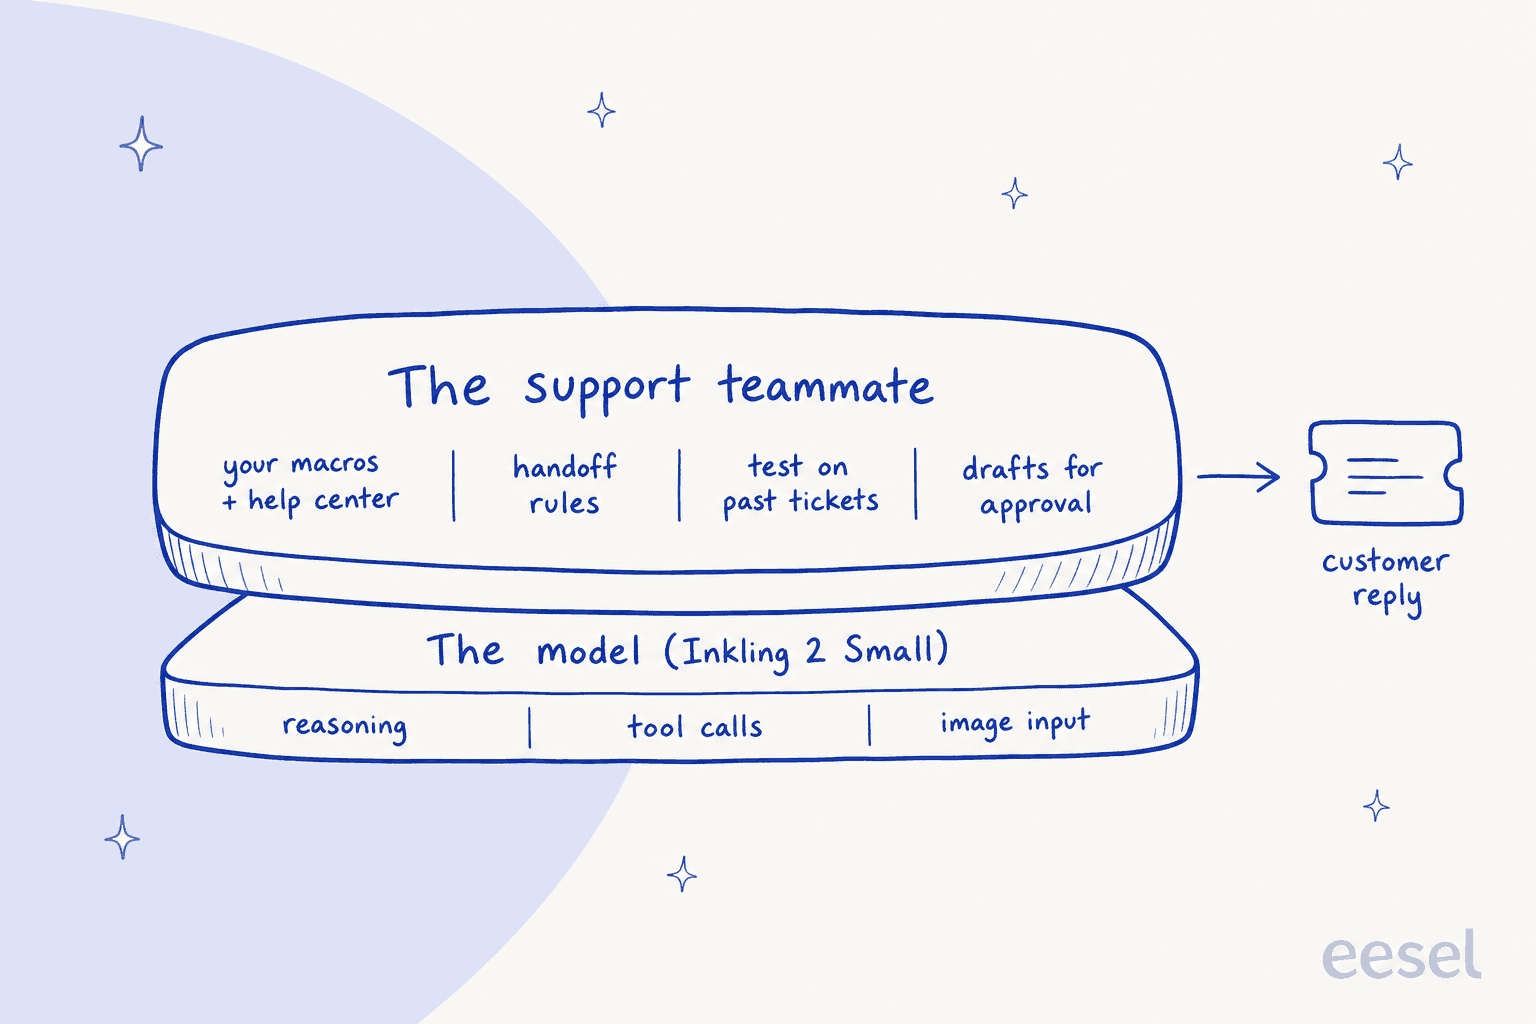
smava, une plateforme berlinoise de comparaison de crédits, illustre bien cette couche supérieure, et de façon pertinente étant donné le benchmark bancaire. Elle traite environ 27 000 tickets en allemand par mois via un seul Zendesk pour deux marques. Trois agents eesel se répartissent le travail : l'un catégorise chaque ticket, l'un rédige des réponses mot pour mot à partir d'environ 820 macros et articles du centre d'aide, et un par marque prépare des réponses prêtes pour le client uniquement pour les clients sans conseiller assigné. Les agents de réponse suivent des règles qu'un modèle seul n'inférerait jamais, comme ne jamais promettre que l'équipe vérifiera ou transmettra quelque chose, et ne jamais renvoyer vers des concurrents, et une personne approuve les brouillons. En un mois, eesel a préparé environ 15 300 brouillons de réponse.
Rien de tout cela ne dépend du grand modèle de langage qui se trouve en dessous, et c'est bien là le propos. Les modèles changent maintenant tous les quelques mois (celui-ci a remplacé son prédécesseur en 97 jours), donc les règles, l'ancrage dans vos documents, et les validations avec humain dans la boucle ne devraient pas avoir à être reconstruits chaque fois.
Si vous voulez la version plus longue de cet argument, les hallucinations de l'IA dans le support et les tests de simulation de support par IA vont plus loin.
Essayez eesel
Si Inkling 2 Small vous fait réfléchir à l'IA pour votre file de support, le modèle est la partie facile à changer. eesel est un coéquipier IA pour le helpdesk qui s'intègre à votre helpdesk existant, comme Zendesk, apprend de vos macros, de votre centre d'aide et de vos tickets passés, et rédige ou envoie des réponses selon les règles que vous définissez. Vous pouvez le faire tourner d'abord sur vos tickets historiques pour voir ce qu'il aurait dit avant qu'il ne touche un vrai client. Essayez eesel gratuitement.
