

Les tarifs de la Gemini Decisions API sont simples : 0,10 $ par million de tokens d'entrée, et 0 $ pour la sortie car le modèle n'en écrit jamais. Un ticket de 600 tokens avec trois questions coûte environ 0,00008 $, et un enregistrement d'appel de 10 minutes environ 0,0015 $. Le tarif correspond à celui de l'OpenAI Decisions API et vaut environ 2,4 fois celui de TypeSafe Jev par token, tu paies donc un supplément pour l'entrée audio, vidéo et PDF. Les vrais coûts sont ailleurs : pas de caching, pas de batch, un palier gratuit qui entraîne le modèle sur tes données, et un plafond Tier 1 de 50 000 requêtes par jour. Pour les équipes de support, le tri est désormais presque gratuit ; rédiger la réponse reste la partie chère, et c'est le travail que fait le coéquipier IA d'eesel. Avec la CLI eesel, un agent de code peut importer tes règles de routage et tes macros, puis lancer des tickets de test avant que quoi que ce soit ne passe en production.
Combien coûte la Gemini Decisions API ?
Gemini Decision 1 (gemini-decision-1) a un seul prix sur le palier payant : 0,10 $ par million de tokens d'entrée, pour le texte, les images, la vidéo, l'audio et les PDF indifféremment. La sortie est indiquée comme « Non applicable (0 token de sortie) » sur les deux paliers. C'est toute la grille tarifaire.
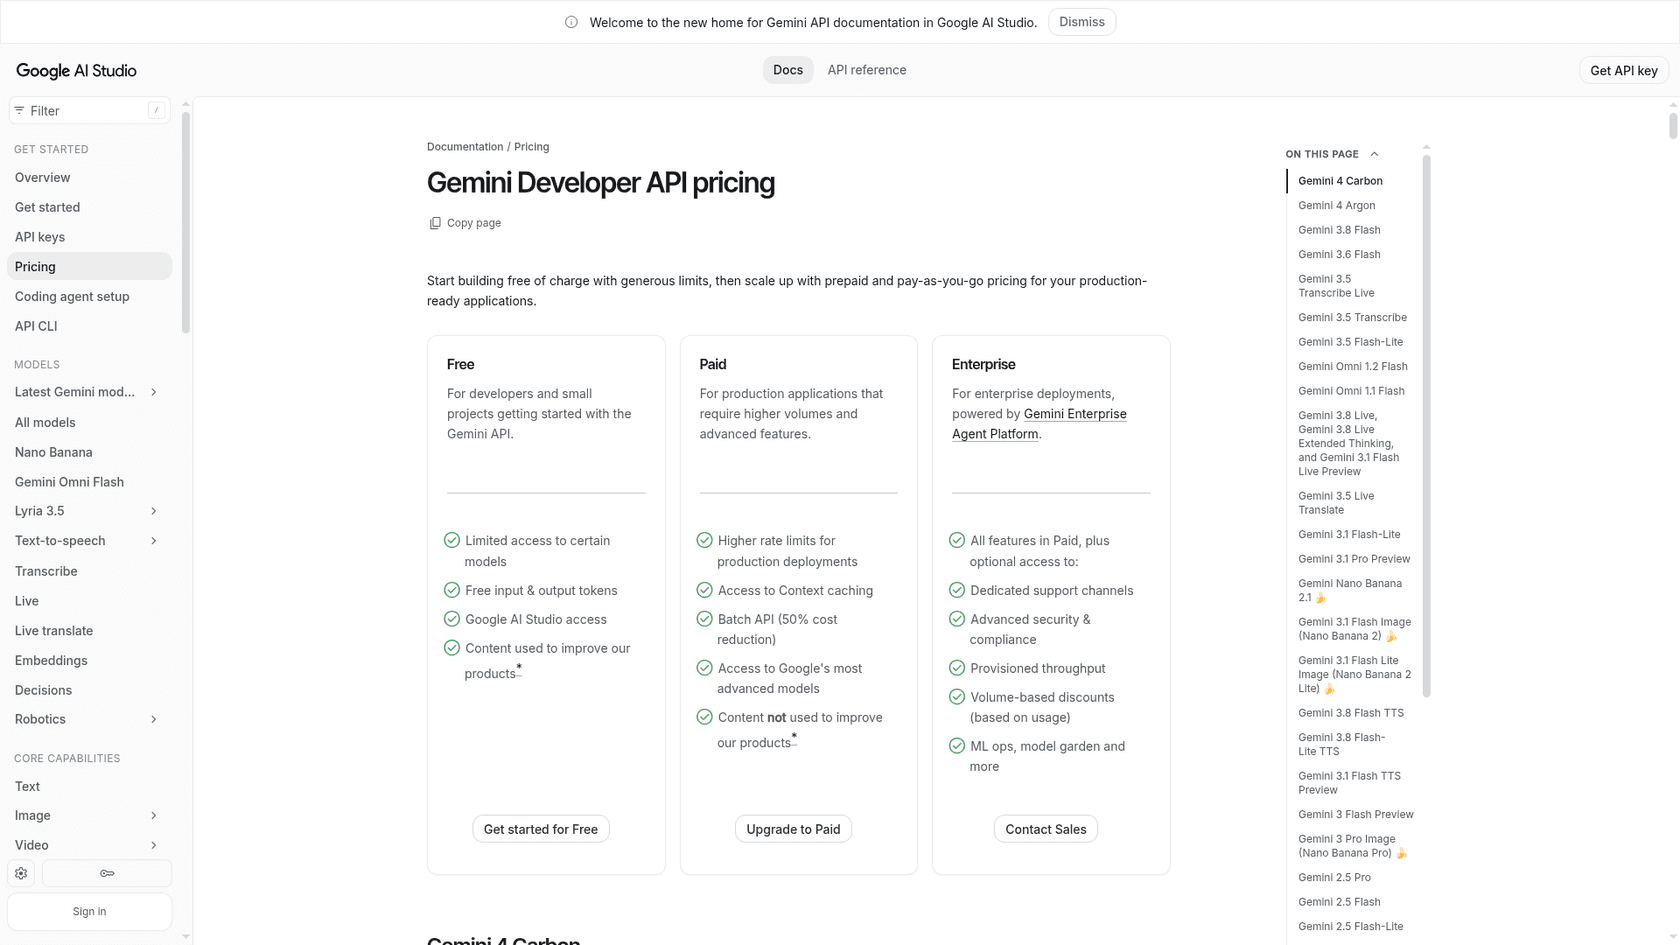
Voici la ligne complète de la page de tarifs de Google, vérifiée le 12 novembre 2026 :
| Élément | Palier gratuit | Palier payant (par 1M de tokens) |
|---|---|---|
| Entrée (texte, image, vidéo, audio, PDF) | Gratuit | 0,10 $ |
| Sortie | 0 token de sortie | 0 token de sortie |
| Context caching | Non disponible | Non disponible |
| Batch API | Non supporté | Non supporté |
| Utilisé pour améliorer les produits de Google | Oui | Non |
La règle de facturation qui rend ça bon marché : l'entrée partagée est facturée une fois par requête, peu importe le nombre de questions posées. Chaque question en plus n'ajoute que ses propres tokens d'instruction et de critère. Si tu as lu mon explication sur la Gemini Decisions API, tu sais qu'une requête peut porter de 1 à 1 000 questions sur la même entrée, donc dix vérifications sur un ticket coûtent un peu plus qu'une seule, pas dix fois plus.
Je fais du SEO pour eesel depuis deux ans, et la recherche derrière cette page vient de quelqu'un avec un tableur ouvert, qui essaie de décider si un modèle de décision vaut le coup d'être branché. Le reste de cet article, c'est donc ce tableur : coût par élément, les limites qui plafonnent ton volume, et les coûts que la grille tarifaire laisse de côté.
Combien coûte une décision, en réalité ?
Les tarifs par million sont difficiles à ressentir, voici donc ce que le prix signifie par élément. Le calcul pour le texte est simple. Pour les médias, j'ai utilisé le tableau de résolution média de Google pour ses modèles actuels, puisque Decision 1 accepte les mêmes réglages low, medium, high et ultra_high sur les blocs image et vidéo.
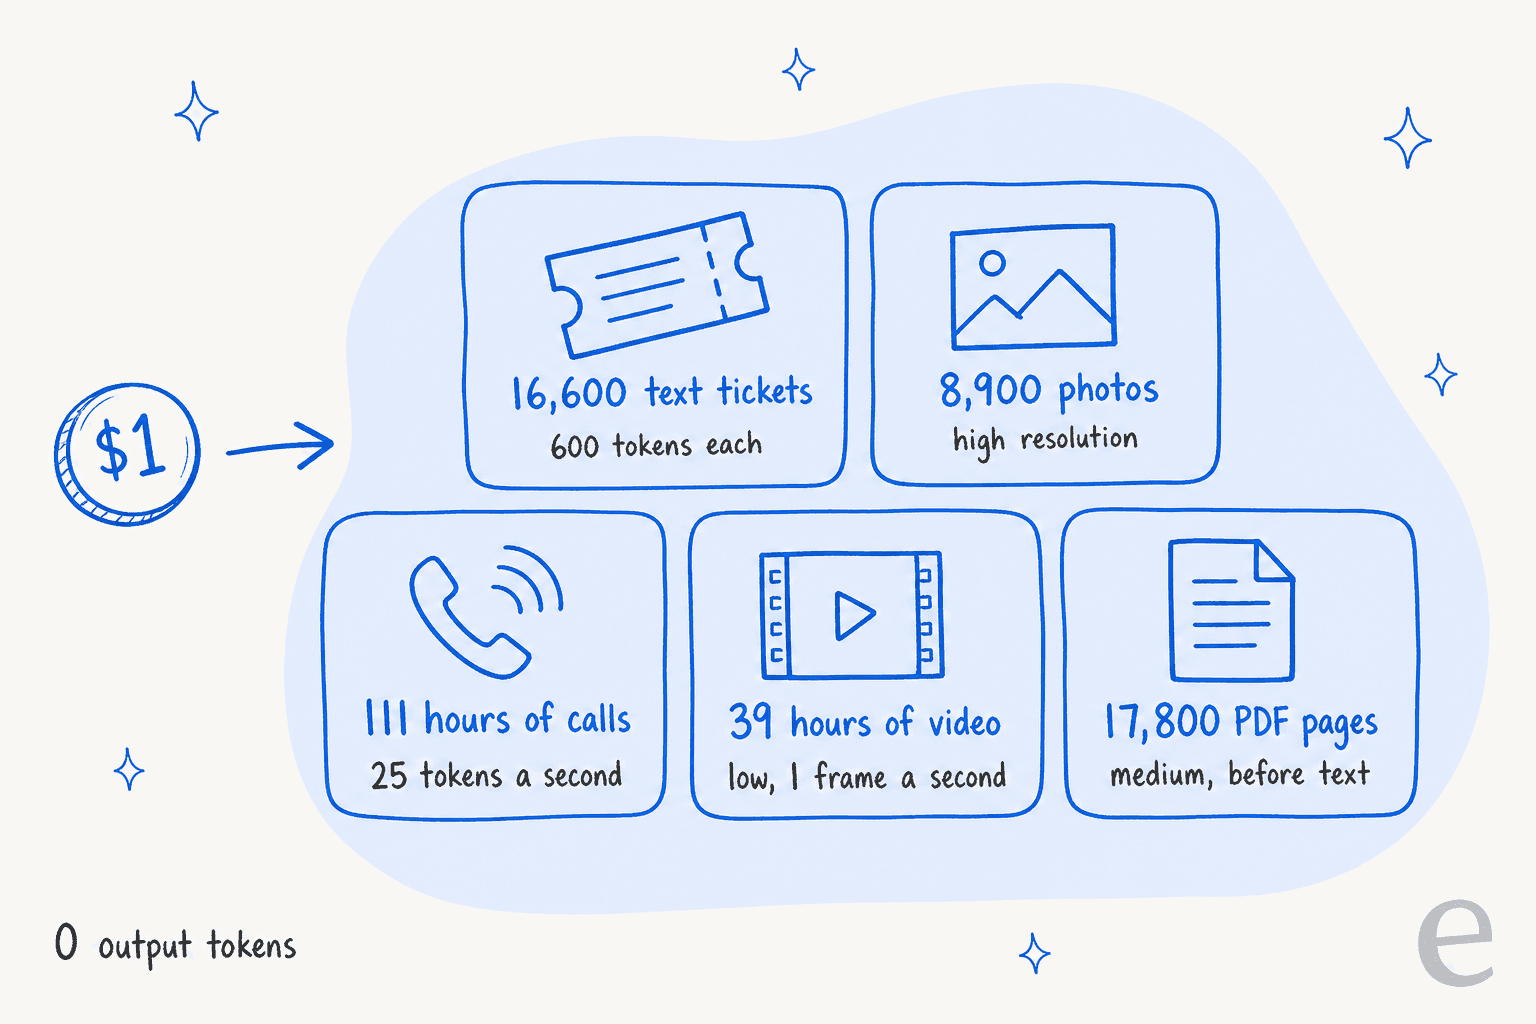
| Entrée | Tokens (approx.) | Coût par élément | Coût par 10 000 |
|---|---|---|---|
| Ticket de support, 600 tokens + 3 questions | ~780 | 0,000078 $ | 0,78 $ |
| Photo, haute résolution | ~1 120 | 0,000112 $ | 1,12 $ |
| Photo, basse résolution | ~280 | 0,000028 $ | 0,28 $ |
| Enregistrement d'appel de 1 minute | ~1 500 (25 par seconde) | 0,00015 $ | 1,50 $ |
| Enregistrement d'appel de 10 minutes | ~15 000 | 0,0015 $ | 15,00 $ |
| Vidéo de 60 secondes avec son, par défaut | ~6 000 | 0,0006 $ | 6,00 $ |
| Dossier PDF de 5 pages, résolution moyenne | ~2 800 plus sa couche de texte | ~0,0003 $ | ~3,00 $ |
| Requête complète de 262 144 tokens | 262 144 | 0,026 $ | 262 $ |
Les tokens de question sont mon estimation d'environ 60 par question. Les chiffres médias sont approximatifs ; le champ usage.input_tokens_by_modality de la réponse donne le compte exact, les frames vidéo et les images de page PDF étant comptés comme des tokens image.
Trois choses se dégagent de ce tableau :
- Le tri de texte est une erreur d'arrondi. Même une grosse file ne coûte qu'un montant à un chiffre par mois à classifier.
- La résolution est ton plus gros levier sur les images. Faire passer une photo de
highàlowréduit son coût de 75 %. Pour « y a-t-il des dommages visibles ? » c'est généralement suffisant ; pour lire un numéro de série, non. Google indique lui-même que la qualité des PDF « sature généralement àmedium». - L'audio est la bonne surprise. Un message vocal de 10 minutes coûte 0,0015 $ à évaluer, sans facture de transcription séparée. Ça ouvre la porte à des vérifications de sentiment ou d'escalade sur des appels que personne n'aurait payé un LLM pour lire avant.
Que donne vraiment le palier gratuit ?
Le palier gratuit ne coûte rien, mais les limites et les conditions sur les données décident qui peut l'utiliser. Selon la page de rate limits de Google, Gemini Decision reçoit gratuitement 200 requêtes par minute, 50 000 tokens par minute et 10 000 requêtes par jour.
C'est largement suffisant pour construire et tester. À 780 tokens par ticket, la limite de tokens permet environ 64 tickets par minute, et le plafond quotidien couvre 10 000. Une file très active pourrait presque tourner là-dessus.
Ne le fais pas. Sur le palier gratuit, le tableau tarifaire de Google indique que ton contenu est « utilisé pour améliorer nos produits ». Les tickets clients portent des noms, des numéros de commande, et parfois des données de paiement ou de santé. Ça appartient au palier payant, où ça ne sert pas à l'entraînement, en plus des vérifications habituelles de tes garde-fous IA. Le palier payant coûte aussi si peu aux volumes de tri que le palier gratuit t'économise au mieux quelques dollars.
Comment fonctionnent les paliers de rate limit ?
Les limites payantes montent par paliers, selon ce que tu as dépensé au total sur Google Cloud et depuis combien de temps tu as payé pour la première fois. Sortir du palier gratuit veut dire lier un compte de facturation et prépayer au moins 5 $ de crédits, selon la doc de facturation de Google.
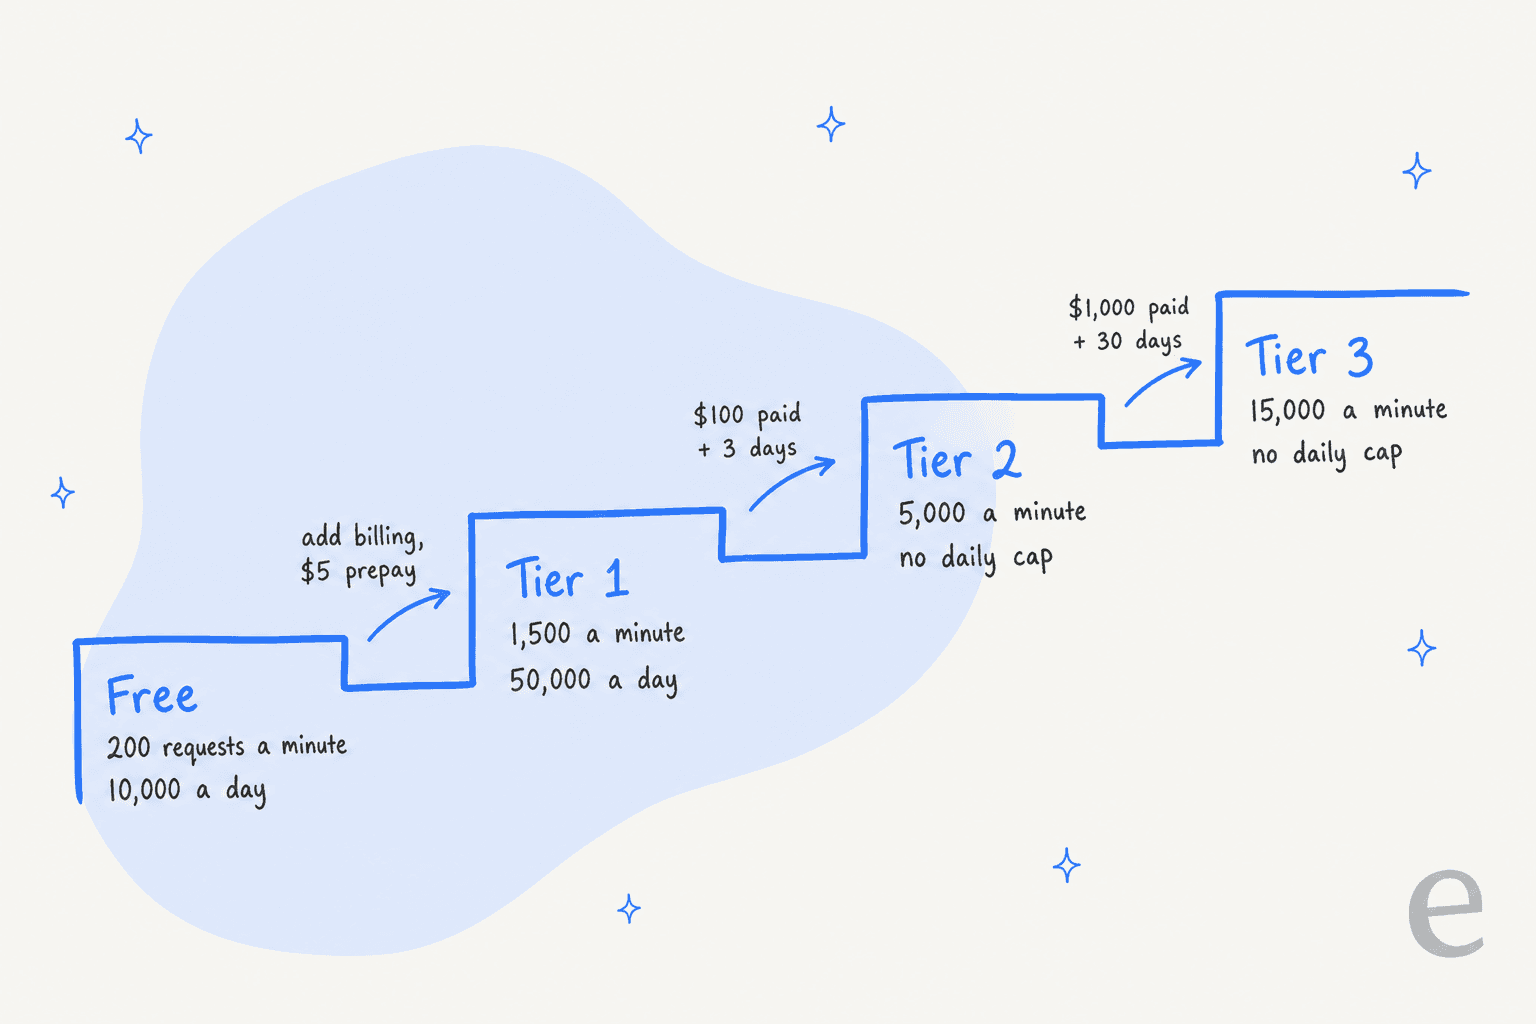
| Palier | Comment y arriver | Requêtes/min | Tokens/min | Requêtes/jour | Plafond de facturation mensuel |
|---|---|---|---|---|---|
| Free | Par défaut | 200 | 50 000 | 10 000 | n/a |
| Tier 1 | Lier la facturation, prépayer 5 $+ | 1 500 | 1 000 000 | 50 000 | 250 $ |
| Tier 2 | 100 $ payés + 3 jours | 5 000 | 4 000 000 | Illimité | 2 000 $ |
| Tier 3 | 1 000 $ payés + 30 jours | 15 000 | 10 000 000 | Illimité | 20 000 $ à 100 000 $+ |
La partie étrange, c'est l'écart entre la dépense et les limites. Tier 2 demande 100 $ de dépense cumulée sur Google Cloud, mais à 0,10 $ par million de tokens, 100 $ représentent un milliard de tokens de décisions. Si Decision 1 est la seule chose que tu paies chez Google, tu pourrais rester sur Tier 1 longtemps. Le plafond de 50 000 requêtes par jour est celui qui coince vraiment : une file avec 60 000 tickets par jour n'y rentre pas, peu importe le peu de tokens que chacun utilise.
Si tu dépenses déjà sur Google Cloud, tu démarreras probablement plus haut. Sinon, il y a un formulaire d'augmentation de rate limit, et ça vaut le coup de le déposer avant le lancement plutôt qu'après ton premier 429.
Comment se compare-t-elle en prix aux autres modèles de décision ?
En prix par token, Gemini se situe au milieu de la catégorie des modèles de décision. Voici le tarif publié par chaque fournisseur, appliqué aux mêmes 10 000 tickets de 780 tokens chacun :
| Modèle | Entrée par 1M | Sortie | 10 000 tickets | Lit |
|---|---|---|---|---|
| Gemini Decision 1 | 0,10 $ | 0 $ | 0,78 $ | Texte, images, audio, vidéo, PDF |
| OpenAI Decisions API | 0,10 $ | 0 $ | 0,78 $ | Texte, images intégrées |
| TypeSafe Jev | 0,042 $ | 0 $ | 0,33 $ | Texte |
| Microsoft-Decision-1 | 0,042 $ | 0 $ | 0,33 $ | Non précisé |
| Cloudflare Clef | 0,24 $ | Pas de prix de sortie | 1,87 $ | Texte, JSON, images, vidéo |
| Cloudflare Clef-flash | 0,038 $ | Pas de prix de sortie | 0,30 $ | Texte, JSON, images, vidéo |
| Gemini 3.5 Flash-Lite (sortie structurée) | 0,30 $ | 2,50 $ | ~3,84 $ | Texte, images, audio, vidéo, PDF |
Chiffres de Gemini et Flash-Lite vérifiés le 12 novembre 2026. Tarifs concurrents tirés de la page de chaque fournisseur, vérifiés pour la dernière fois le 11 octobre 2026. Flash-Lite suppose environ 20 tokens de sortie par réponse et aucun token de réflexion.
Pour les tickets en texte brut, Jev, le modèle de Microsoft et Clef-flash coûtent tous moins de la moitié. La différence ne représente toutefois que des centimes à ce volume, donc ça ne compte qu'à très grande échelle. Le prix de Gemini prend son sens quand tes entrées ne sont pas que du texte : aucun autre modèle de décision hébergé de ce tableau n'accepte l'audio et les PDF nativement, et payer d'abord un service séparé de speech-to-text ou d'OCR coûterait plus que la décision elle-même.
La comparaison avec Flash-Lite est celle que la plupart des utilisateurs de Gemini rencontreront vraiment. Google affirme que Decision 1 est « près de 5 fois moins cher » que Flash-Lite sur sa suite de benchmarks, et mon exemple tombe à environ 4,9 fois. Un commentateur sur Hacker News a résumé le compromis de prix de façon juste au lancement :
"Its bit more expensive than other other Decision Models in the same lane. However, it can accept Audio and Video as input as well and for those specific cases it can be extremely useful."

Si tu réfléchis au reste de la gamme de Google, mes analyses des tarifs de Gemini 4 Carbon et des tarifs de Gemini 3.8 Flash couvrent le côté génératif.
Calcule ta propre facture mensuelle
Entre tes propres volumes. Le calculateur additionne texte, photos, appels et PDF au tarif payant de Google, et vérifie le résultat face aux paliers de rate limit.
Quels coûts ne sont pas sur la grille tarifaire ?
Le prix par token est la partie facile. Voici ce qui change vraiment ce que tu paies, ou si une requête passe tout court :
- Jamais de caching. Un contexte partagé long, comme un document de politique ou un catalogue produit envoyé avec chaque ticket, est facturé en entier à chaque requête. Avec les modèles génératifs Gemini, tu obtiendrais une entrée cachée à une fraction du prix. Ici, garde le contexte partagé court ou déplace-le dans le code.
- Pas de Batch API ni de palier Flex. Les traitements de nuit coûtent le même prix que le trafic en direct. Sur les modèles qui supportent le batch, la page de tarifs de Google affiche une remise de 50 %.
- Les crédits prépayés expirent. Selon le plan de prépaiement de Google, les crédits non utilisés « expirent après 12 mois » et ne sont pas remboursables. Quand ton solde atteint 0 $, toutes les clés API de ce compte de facturation s'arrêtent d'un coup avec un HTTP 402. Active le rechargement automatique, sinon ton tri arrête de router en silence.
- Des dépassements pendant le délai de facturation. Google avertit que les données de facturation peuvent accuser environ 10 minutes de retard, donc tu peux dépasser le plafond de dépense d'un projet avant qu'il ne s'active. Aux prix de Decision 1, c'est généralement négligeable, mais ça compte si un bug boucle des requêtes.
- Les blocages de sécurité renvoient des erreurs, pas des réponses. Les entrées qui déclenchent les filtres de sécurité de Google reviennent en HTTP 400. Il te faudra un chemin de repli, en général envoyer le ticket à une personne via tes règles normales d'escalade.
Vient ensuite le coût d'ingénierie, qui est le gros morceau. L'API te donne des probabilités. Tu écris toujours les seuils, la logique de routage, le banc de test et le code qui réécrit les étiquettes dans ton helpdesk. Le fil Hacker News a résumé les cas d'usage comme « Routage, classification, remplacement du LLM-as-judge », ce qui est juste, et chacun de ces cas est un projet, pas un interrupteur.
Qu'est-ce que ça change pour le budget d'une équipe de support ?
Pour le routage de tickets, le coût du modèle est pratiquement tombé à zéro. Ça change où va l'argent dans le support avec IA, pas s'il y en a.
Voici une vérification d'échelle réelle. smava, un comparateur de prêts allemand, envoie environ 27 000 tickets Zendesk par mois via eesel sur deux marques. En un mois, eesel a catégorisé 14 600 d'entre eux, écrivant langue, éligibilité de réponse et catégorie dans les champs Zendesk, et a préparé 15 300 brouillons de réponse à partir de 820 macros et articles synchronisés. Si on ne tarifait que l'étape de catégorisation sur Decision 1 avec mon estimation de 780 tokens, les 27 000 tickets reviendraient à environ 2,11 $ par mois.
Les autres chiffres de cette histoire, c'est là où se trouve le vrai travail. Rédiger 15 300 réponses en allemand qui disent exactement ce que dit une macro approuvée, dans la finance réglementée, n'est pas un travail pour un modèle de décision. Garder séparé le contenu de deux marques non plus. C'est pourquoi je présenterais la Gemini Decisions API comme un moyen bon marché de rendre ta couche de tri plus intelligente, pas comme un remplacement de la partie qui répond aux clients. Pour une vue complète de ce que coûte le support avec IA, mon analyse du coût du service client IA couvre ça, et les tarifs Zendesk AI montrent ce qu'un fournisseur de helpdesk facture pour les mêmes tâches.
Le coéquipier IA pour helpdesk d'eesel fait les deux moitiés directement dans ta file existante : il étiquette et route les tickets dans Zendesk, Freshdesk ou HubSpot, puis rédige ou envoie la réponse à partir de ton propre contenu d'aide.
SamCart fait tourner un agent sur les tickets Freshdesk et un autre sur le chat de son site, répondant à partir de 280 articles du centre d'aide. Chaque déploiement est d'abord simulé sur des tickets historiques, parce qu'une étiquette fausse bon marché reste fausse.
La Gemini Decisions API vaut-elle le coup ?
Oui, si tu as des ingénieurs et que tes entrées vont au-delà du texte brut. À 0,10 $ par million de tokens avec une sortie gratuite, la facture modèle pour le tri, les vérifications de politique ou le contrôle qualité des réponses est proche de rien, et le support audio et PDF t'évite une étape séparée de transcription ou d'OCR.
Paie pour elle si tu évalues des appels, des photos ou des documents, tu as besoin de plus de 32K tokens de contexte, ou tu fais beaucoup de vérifications sur la même entrée. Regarde ailleurs si tes tickets sont en texte brut et le volume est énorme (les alternatives à Jev et Clef-flash sont moins chers par token), tu comptes sur des remises de caching ou de batch, ou tu en as besoin sur Vertex AI dès aujourd'hui. Si rien dans la gamme de Google ne convient, mon tour d'horizon des alternatives à Gemini couvre d'autres fournisseurs.
Et si ce que tu veux, c'est le tri plus la réponse, sans construire la plomberie toi-même, compare les outils de mon tour d'horizon meilleure IA de tri, ou lis comment router les tickets avec la détection d'intention.
Essaie eesel quand l'étiquette n'est pas la partie difficile
Gemini peut te dire qu'un ticket est un problème de facturation pour une fraction de centime. eesel prend le relais dans Zendesk, Freshdesk ou HubSpot : il remplit les champs, route le ticket, et rédige la réponse que ton équipe aurait écrite, testée sur tes anciens tickets avant de passer en production. smava l'utilise pour trier et rédiger 27 000 tickets allemands par mois. Regarde les tarifs eesel, ou essaie eesel gratuitement.
Questions fréquentes
Combien coûte la Gemini Decisions API ?
Les tarifs de la Gemini Decisions API sont de 0,10 $ par million de tokens d'entrée sur le palier payant, et la sortie coûte toujours 0 $ car le modèle ne génère aucun token de sortie. Le palier gratuit est sans frais pour le prototypage. C'est le même tarif que l'OpenAI Decisions API, et environ 2,4 fois ce que facture TypeSafe Jev par token.
La Gemini Decisions API est-elle gratuite ?
Oui, sur le palier gratuit. Google indique un prix d'entrée gratuit, avec des limites de 200 requêtes par minute, 50 000 tokens par minute et 10 000 requêtes par jour. La contrepartie, c'est que les données du palier gratuit peuvent servir à améliorer les produits de Google, donc n'y envoie pas de tickets clients. Mon guide plus large sur les tarifs de Gemini couvre les autres modèles.
Combien coûte un appel à la Gemini Decisions API ?
Un ticket de support typique de 600 tokens avec trois questions courtes atteint environ 780 tokens d'entrée, soit environ 0,00008 $. Même une requête au maximum qui remplit toute la fenêtre de 262 144 tokens coûte environ 0,026 $. Pour une installation complète de tri de tickets, la facture du modèle est rarement le chiffre qui compte.
La Gemini Decisions API supporte-t-elle le batch ou le context caching ?
Non. Gemini Decision 1 ne supporte ni la Batch API ni le context caching, et il n'y a pas de palier Flex ou Priority, donc chaque token est facturé au tarif standard à chaque fois. Avec les tarifs de Gemini 3.5 Flash-Lite, tu peux au moins cacher l'entrée à 0,03 $ par million.
Quelles sont les rate limits de la Gemini Decisions API ?
Palier gratuit : 200 par minute, 50 000 tokens par minute, 10 000 par jour. Tier 1 : 1 500 par minute, 1M de tokens par minute, 50 000 par jour. Tier 2 : 5 000 par minute et 4M de tokens, sans plafond quotidien. Tier 3 : 15 000 par minute et 10M de tokens. Les paliers supérieurs se débloquent après 100 $ puis 1 000 $ de dépense cumulée.
La Gemini Decisions API est-elle moins chère que Gemini Flash-Lite pour la classification ?
Oui, et largement. Flash-Lite facture 0,30 $ en entrée et 2,50 $ en sortie par million de tokens, et la sortie structurée veut dire que tu paies chaque étiquette écrite. Dans mon exemple à 10 000 tickets, Decision 1 coûte environ 0,78 $ par mois contre environ 3,84 $ pour Flash-Lite. Google affirme lui-même que c'est près de 5 fois moins cher. Mon guide sur la classification de tickets par IA explique comment ces étiquettes sont utilisées.
Puis-je acheter la Gemini Decisions API via OpenRouter ou Vertex AI ?
OpenRouter liste google/gemini-decision-1 au même tarif de 0,10 $ en entrée et sortie gratuite, avec Google AI Studio comme seul fournisseur. Vertex AI n'est pas encore disponible ; Google dit que le support de Gemini dans Google Cloud arrive bientôt. Si tu as besoin d'un cloud que tu paies déjà, compare avec les tarifs de Microsoft-Decision-1 sur Azure.
Comment les images, l'audio et la vidéo sont-ils facturés sur la Gemini Decisions API ?
Ils sont facturés comme des tokens d'entrée au même tarif de 0,10 $ par million. Le tableau de résolution média de Google place une image à environ 1 120 tokens en haute résolution et 280 en basse, l'audio à 25 tokens par seconde, et la vidéo à 70 tokens par frame en basse résolution. Un appel de 10 minutes représente environ 15 000 tokens, soit 0,0015 $. C'est une grande raison pour laquelle elle convient aux tâches d'IA multimodale.