

Ce qu'est vraiment la Cloudflare Web Search API
L'argumentaire de l'article de lancement, signé Michelle Chen, Sam Else et Gabriel Massadas, commence par un aveu amusant. Quand un agent a besoin d'une page en direct, il devine généralement l'URL et la récupère avec curl, ce qui explique tous ces 404 dans les journaux d'agents. La recherche web donne à l'agent un vrai point de départ : envoyer une requête, obtenir une liste de résultats, les transmettre au modèle.
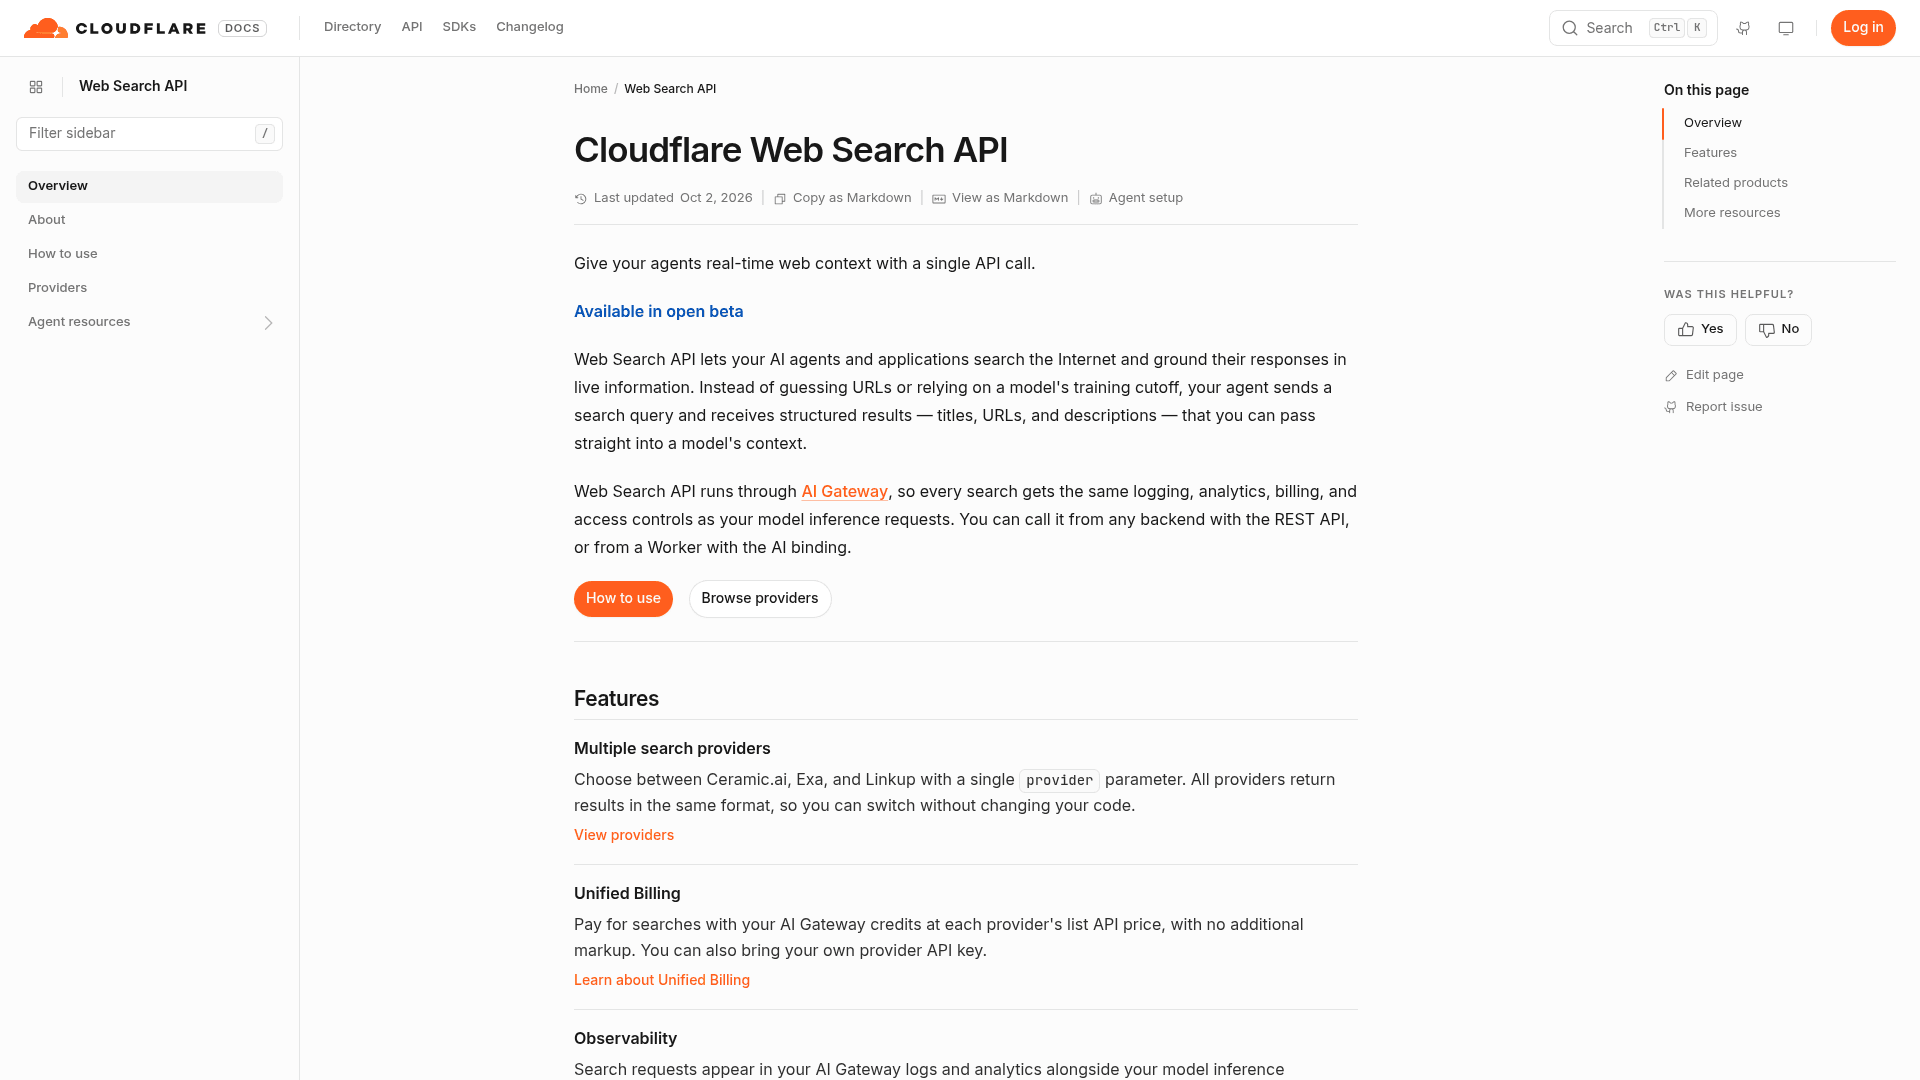
Sous le capot, c'est une couche de routage, pas un moteur de recherche. La page About de Cloudflare liste quatre étapes pour chaque requête :
- Acheminer la requête via l'AI Gateway que vous nommez.
- Transmettre la requête au fournisseur choisi, ou à Ceramic.ai si vous n'en avez pas choisi.
- Normaliser la réponse dans un format unique : URL, titre et, en option, description, image, favicon et date de dernière modification.
- Journaliser la requête et la facturer à votre compte.
C'est tout le produit aujourd'hui, et je le dis comme un compliment. Si vous faites déjà passer vos appels de modèles par AI Gateway, la recherche apparaît désormais dans les mêmes journaux, sur le même budget, sous les mêmes règles d'accès. Cloudflare dit aussi que des outils côté serveur arrivent, si bien que la recherche web finira intégrée au plan de contrôle plutôt que d'être un outil à brancher soi-même.
Le lancement est tombé pendant la Birthday Week et a clairement fait mouche. Le fil Hacker News a atteint 590 points et 284 commentaires, plus que le lancement du navigateur Kitesurf. L'annonce de Cloudflare sur X a reçu une réponse qui résume pourquoi les gens s'y intéressent :
"search in the same gateway as the model calls is the nice part. wiring exa into my agent tonight"
Comment une requête circule
Avant de parler d'argent, il est utile de voir les pièces mobiles, car chaque décision intéressante se trouve dans l'une d'elles.
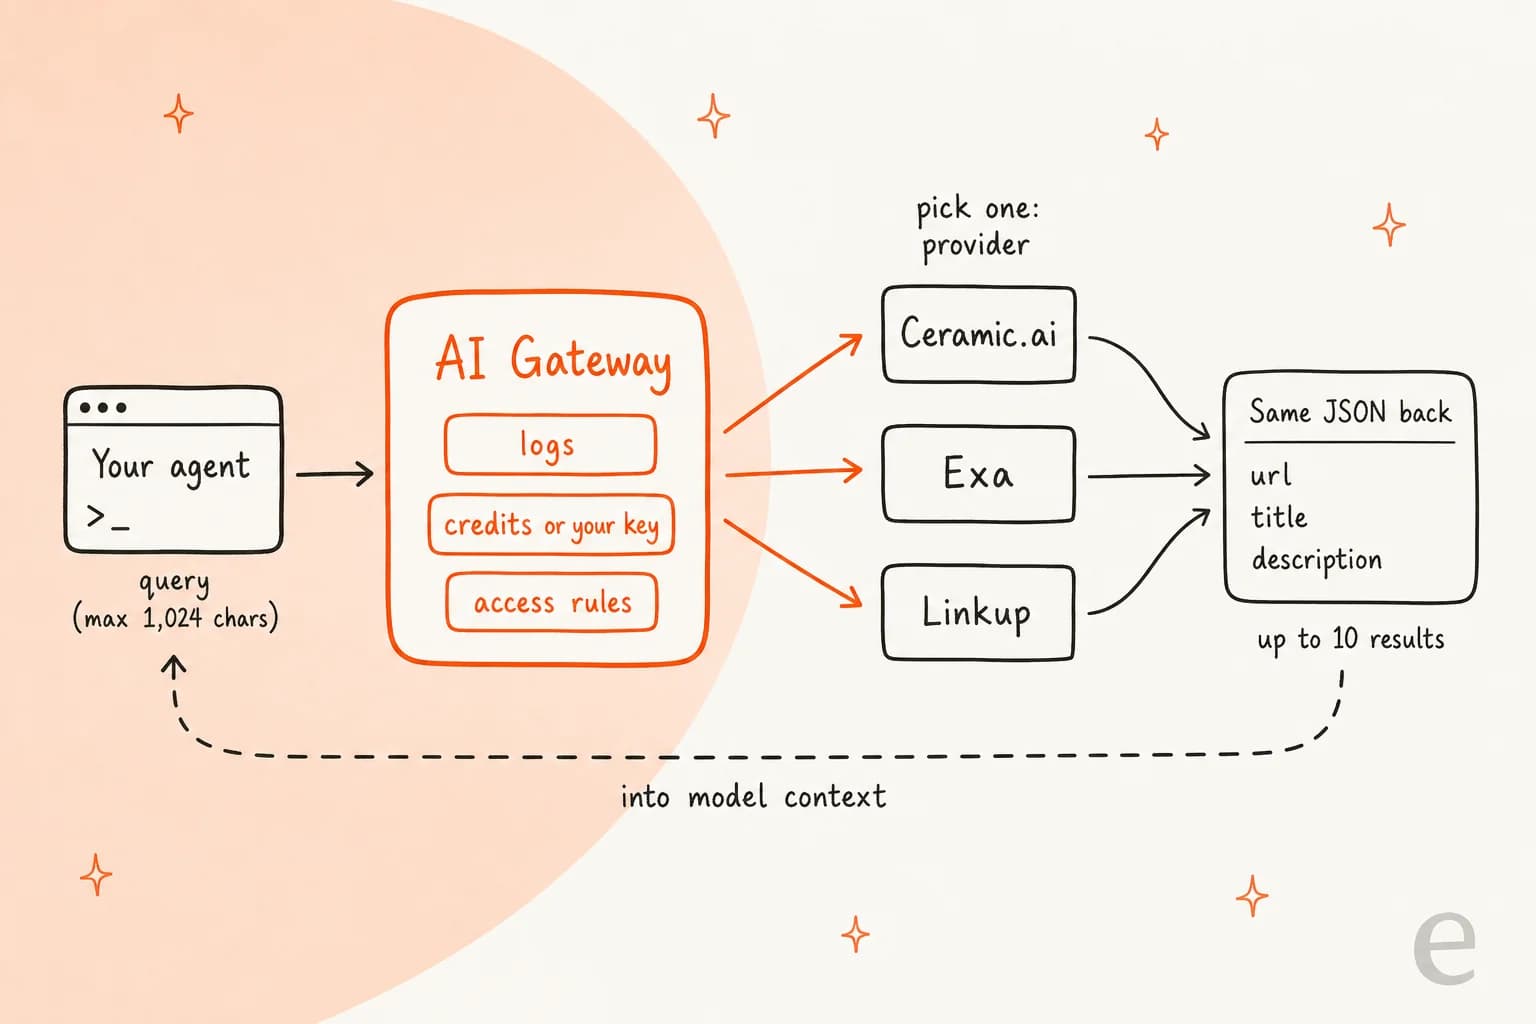
Vous pouvez l'appeler de deux façons, toutes deux documentées sur la page d'utilisation :
- REST :
POST https://api.cloudflare.com/client/v4/accounts/{account_id}/ai/websearch/, authentifié avec un jeton d'API Cloudflare disposant des permissions Workers AI Read et AI Gateway Read. - Binding Workers :
env.AI.websearch({ gatewayId, query, provider, limit }), qui renvoie uneResponsestandard sur laquelle vous appelez.json().
La requête a très peu de réglages, ce qui en dit long sur la conception :
| Paramètre | Ce qu'il fait | Limites |
|---|---|---|
query | Le texte de recherche | 1 à 1 024 caractères |
provider | Quel moteur l'exécute | ceramic (par défaut), exa, linkup |
limit | Combien de résultats reviennent | 1 à 10, 10 par défaut |
byokAlias | Utiliser une clé de fournisseur stockée sur votre gateway | Échoue avec une erreur 400 si elle n'est pas configurée |
gateway.id | Par quel AI Gateway passer | Chaque compte a default |
Il n'y a pas de filtre de date, pas de liste de domaines autorisés, pas de paramètre de pays et pas d'option « récupérer la page complète ». Chaque fournisseur fonctionne dans un mode fixe : Exa utilise son type de recherche auto avec des extraits en guise de description, et Linkup utilise la profondeur fast avec des résultats bruts, d'après la page des fournisseurs. Si vous avez besoin des modes plus profonds d'Exa ou de Linkup, vous les appelez directement.
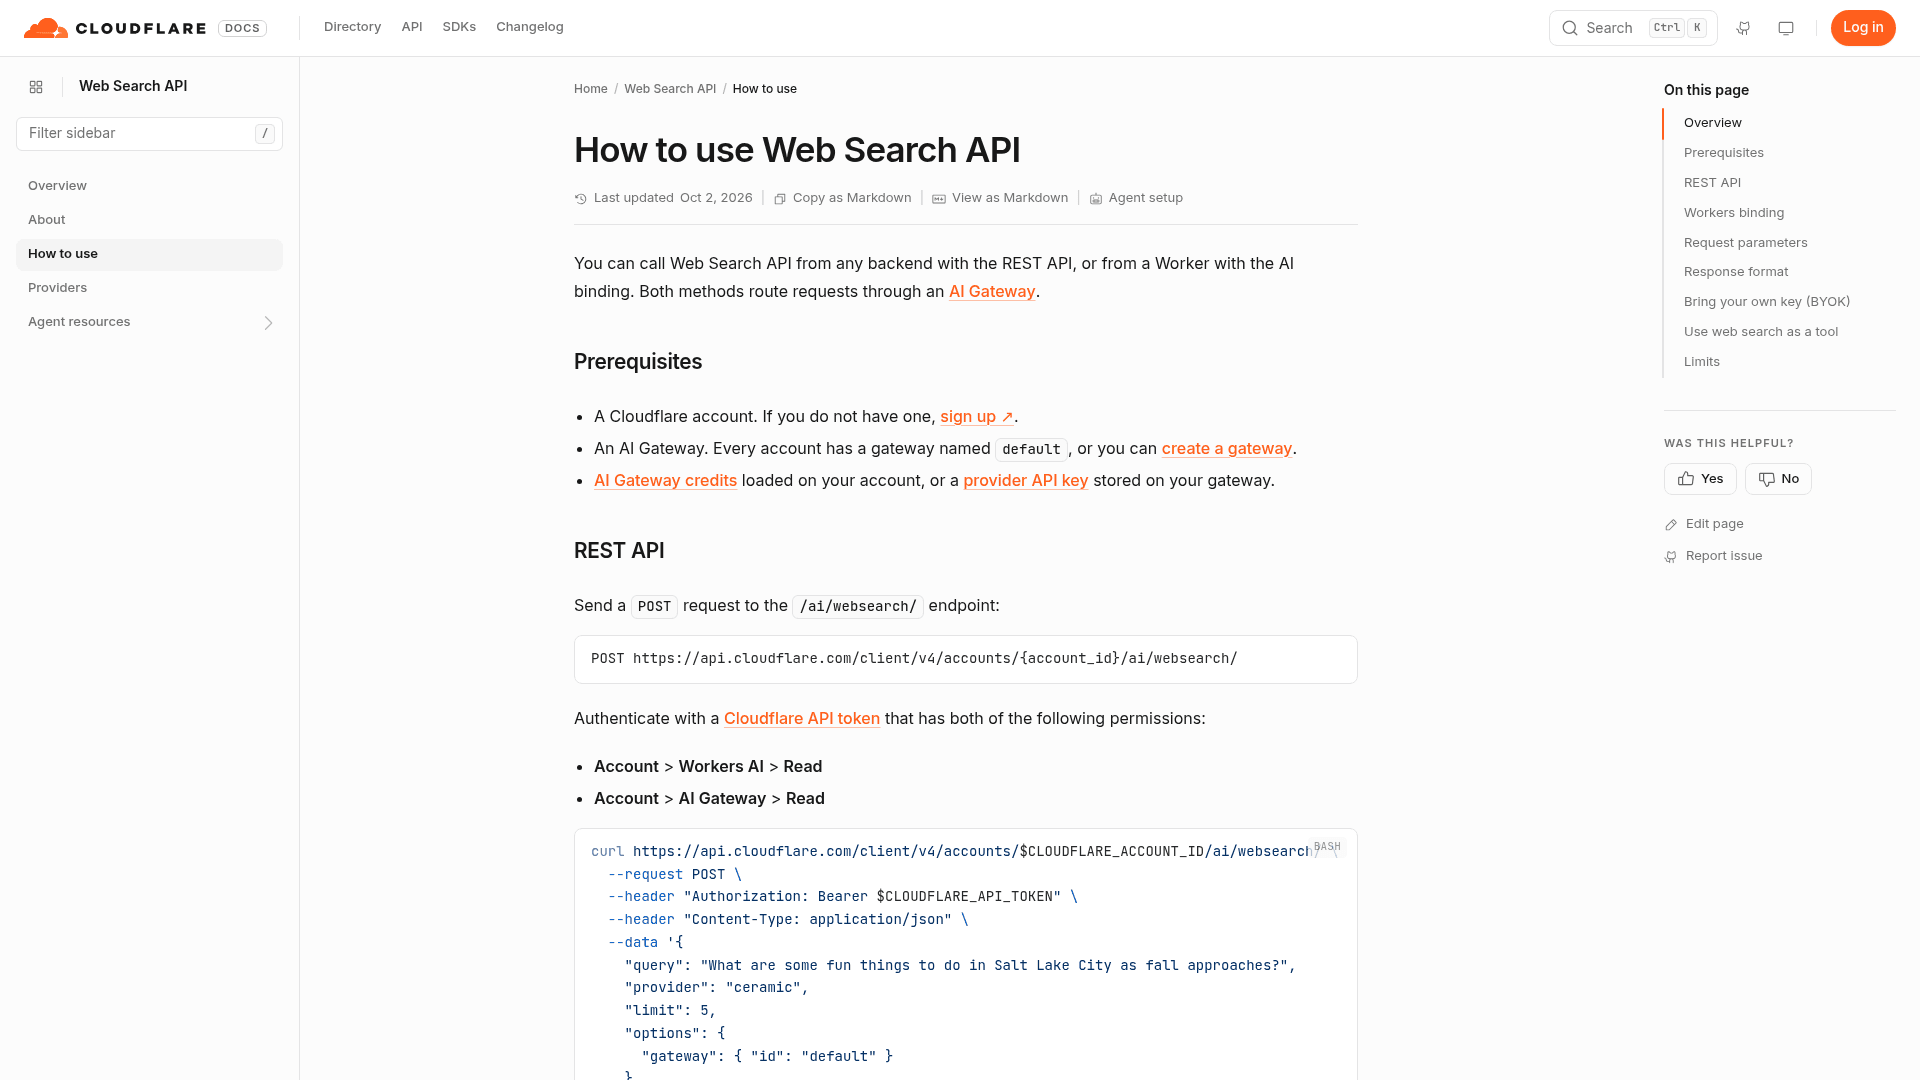
La réponse est volontairement mince : un tableau items et un bloc metadata avec votre requête, un identifiant de requête et latencyMs. Cette minceur est le but. Elle se glisse directement dans la fenêtre de contexte d'un modèle sans que vous écriviez un parseur par fournisseur, et la documentation de Cloudflare inclut un exemple complet pour la brancher comme outil web_search pour un modèle comme Gemma 4 tournant sur Workers AI.
Pourquoi le paramètre fournisseur est la vraie décision de prix
Voici le tableau qui compte. Tous les chiffres ci-dessous proviennent de la page des fournisseurs de Cloudflare, consultée le 8 octobre 2026 :
| Fournisseur | Valeur de provider | Prix pour 1 000 requêtes | Zero Data Retention | Ce que vous obtenez |
|---|---|---|---|---|
| Ceramic.ai (par défaut) | ceramic | 0,25 $ | Oui | Index propre de plus de 40 Md de pages, descriptions jusqu'à 8 000 caractères |
| Linkup | linkup | 5,00 $ | Oui | Profondeur fast, résultats bruts sourcés, pas de réponse générée |
| Exa | exa | 7,00 $ | Non | Type de recherche auto, extraits pertinents pour la requête en guise de description |
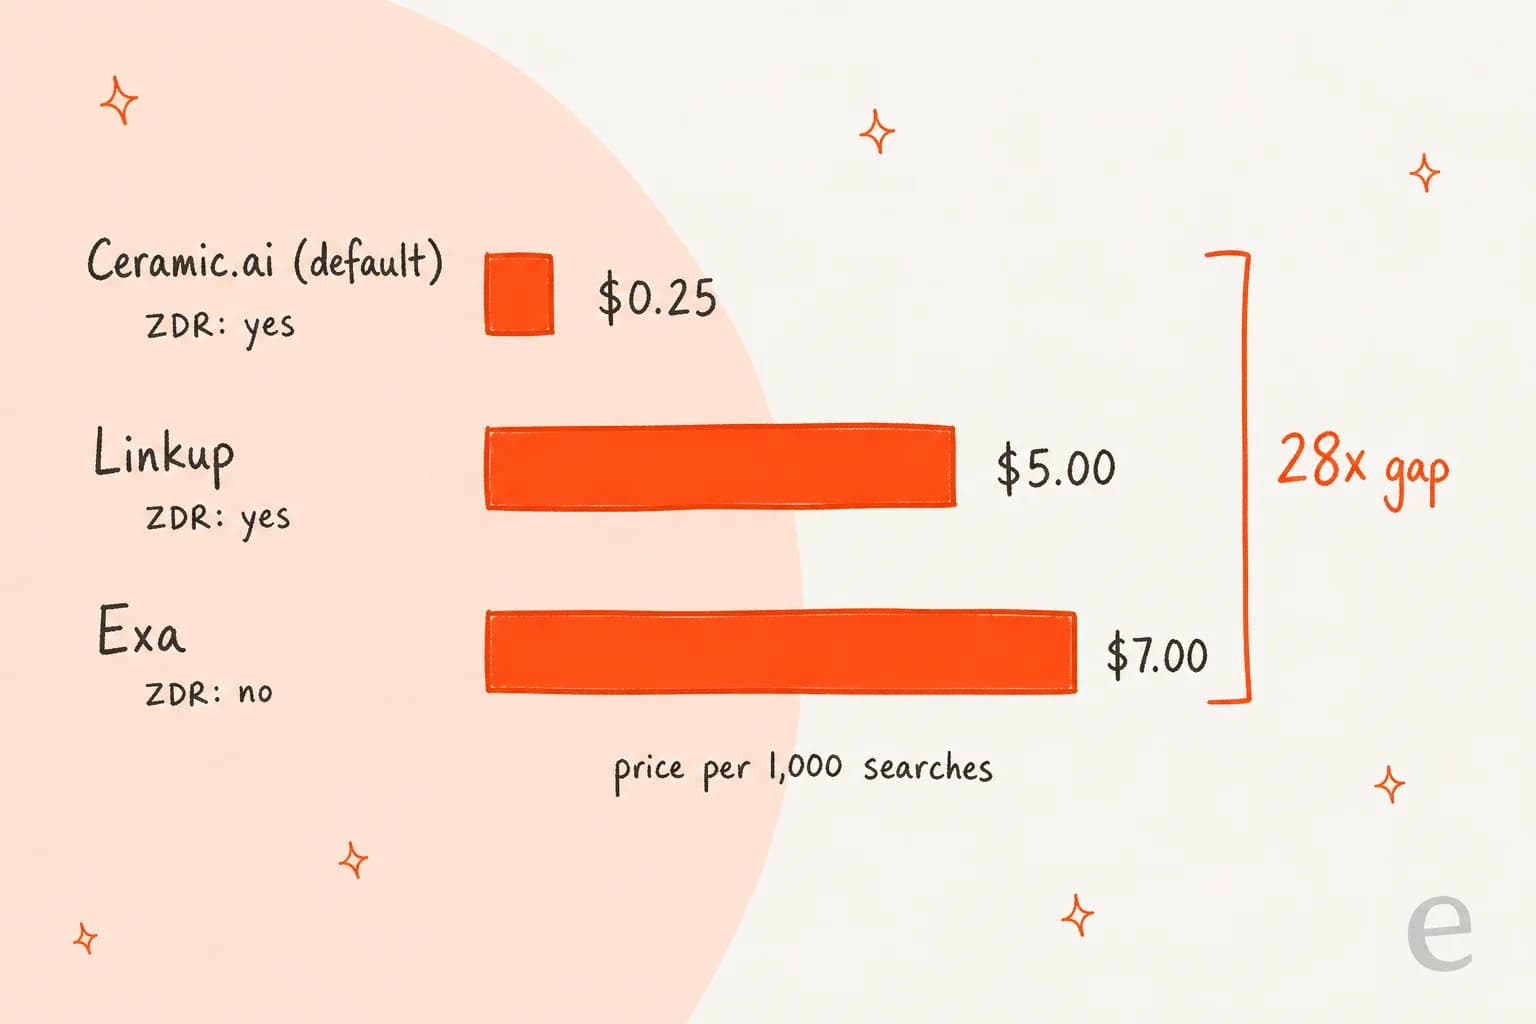
Exa coûte 28 fois ce que coûte Ceramic pour la même forme de requête, et passer de l'un à l'autre se fait en changeant une chaîne. C'est excellent pour expérimenter et dangereux pour les budgets, car rien dans votre code ne change quand un collègue remplace ceramic par exa dans un fichier de configuration. Un commentateur de HN qui a posté la liste de prix a posé la bonne question :
"Does anyone have insights on the quality differences? Web search API pricing for AI agent usecases has always felt so expensive for what it is, but I have no grounding on the economics of running a web index."

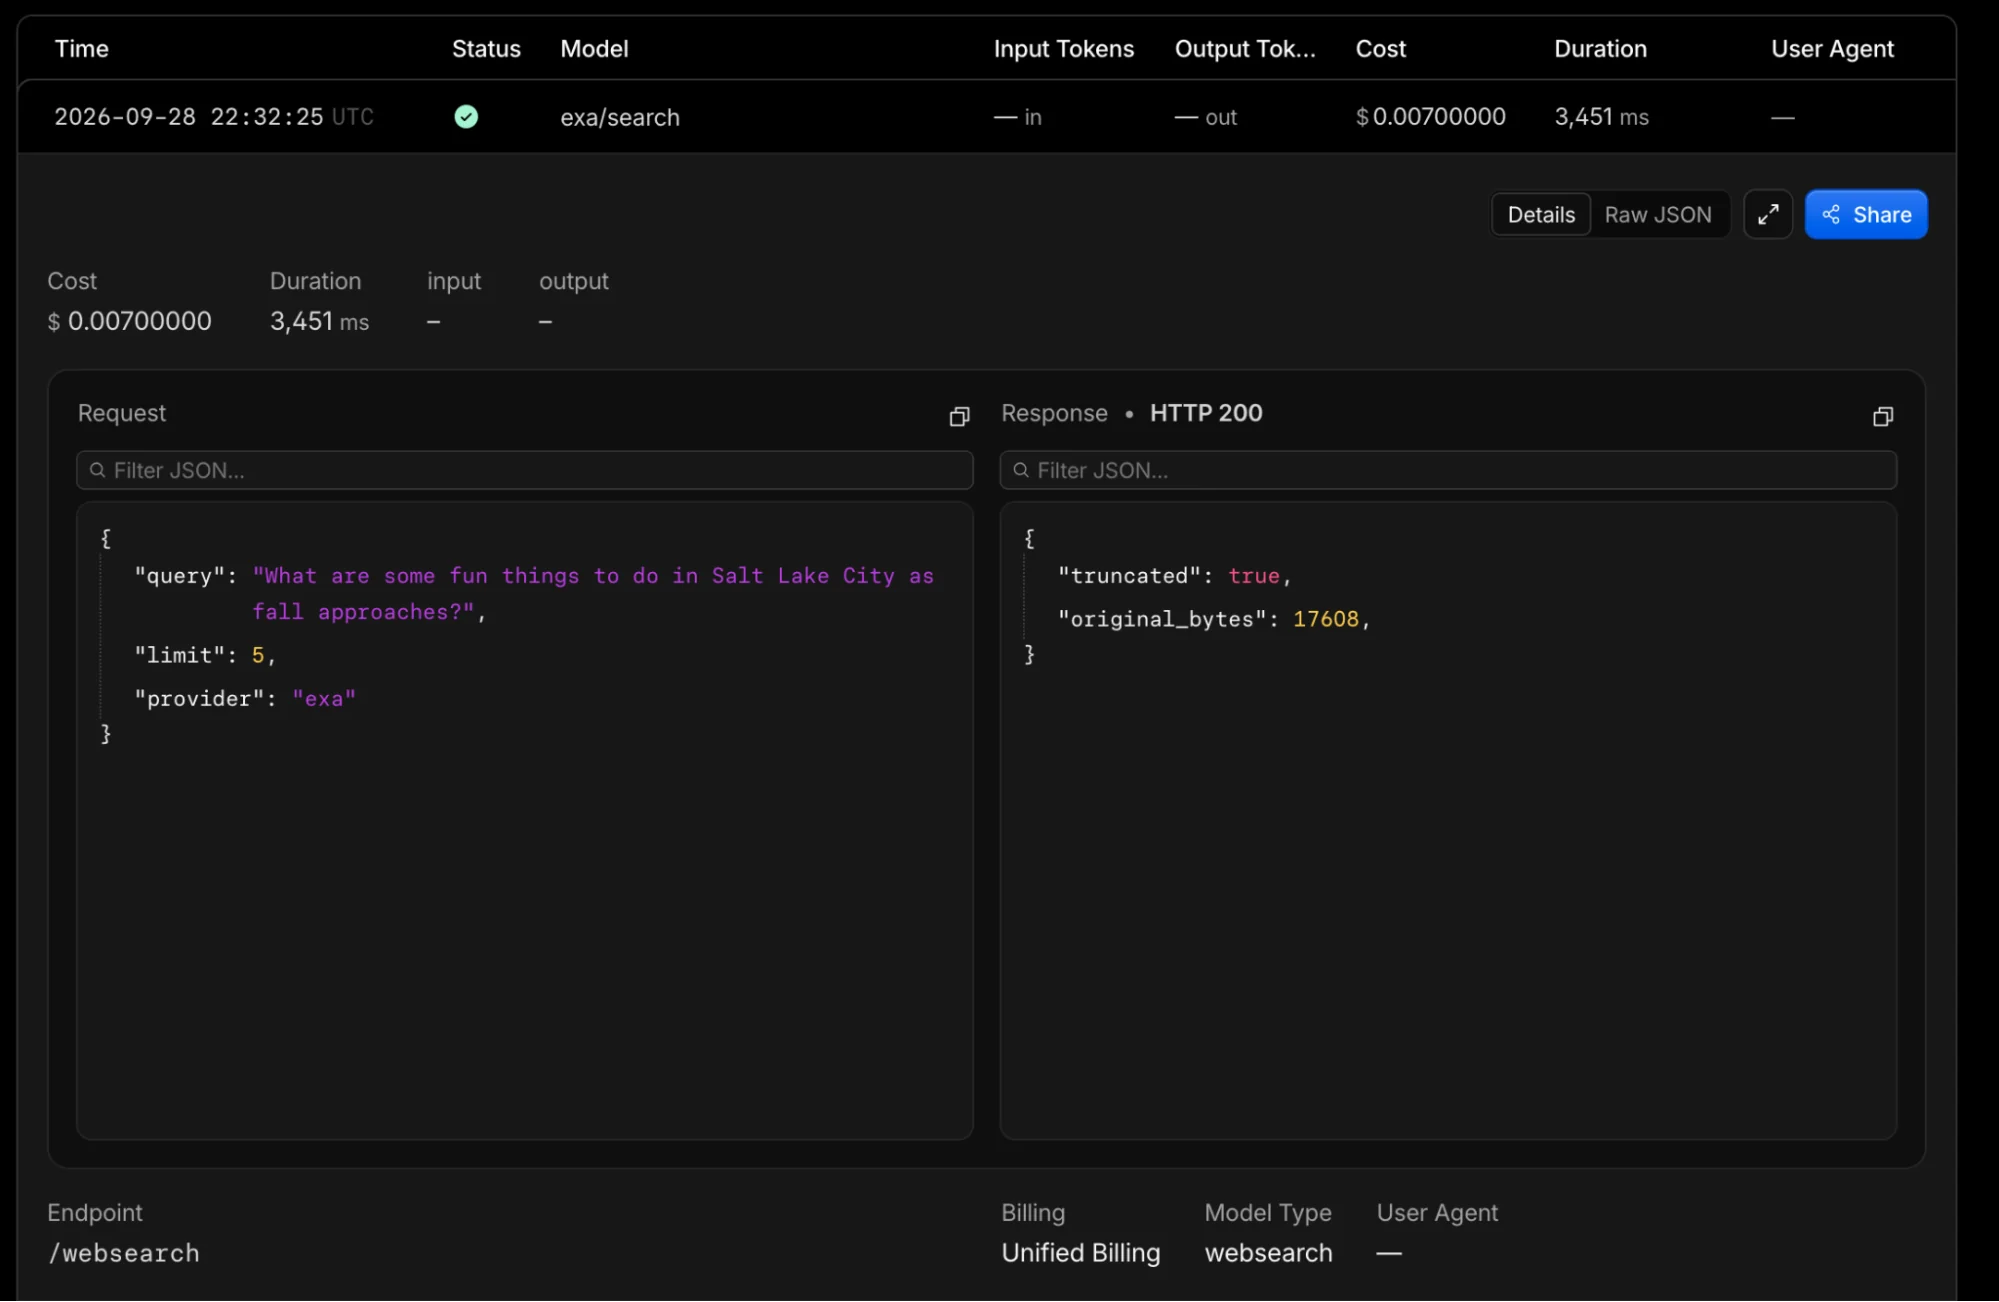
L'article de lancement de Cloudflare inclut une capture de journal qui rend le coût par recherche très concret : un seul appel exa/search facturé 0,007 $, soit exactement 7,00 $ pour 1 000.
La mention « sans majoration », lue de près
Cloudflare dit que les recherches sont facturées "at each provider's list API price, with no additional markup." C'est vrai par recherche. Mais les crédits AI Gateway proviennent de Unified Billing, et cette page indique que des frais de 5 % s'appliquent à tous les crédits achetés : une recharge de 100 $ est un débit de 105 $. Donc si vous payez avec des crédits, votre tarif effectif est environ 5 % au-dessus du prix catalogue. Si vous apportez votre propre clé, le fournisseur vous facture directement et les frais de crédits ne s'appliquent pas à ces recherches.
Voici ce que cela donne à des volumes réels, en supposant une recherche par requête :
| Recherches par mois | Ceramic.ai (catalogue / via crédits) | Linkup (catalogue / via crédits) | Exa (catalogue / via crédits) |
|---|---|---|---|
| 10 000 | 2,50 $ / 2,63 $ | 50,00 $ / 52,50 $ | 70,00 $ / 73,50 $ |
| 100 000 | 25,00 $ / 26,25 $ | 500,00 $ / 525,00 $ | 700,00 $ / 735,00 $ |
| 1 000 000 | 250,00 $ / 262,50 $ | 5 000,00 $ / 5 250,00 $ | 7 000,00 $ / 7 350,00 $ |
Les 5 % sont une erreur d'arrondi à côté du choix du fournisseur. À un million de recherches par mois, choisir Exa plutôt que Ceramic représente 6 750 $ au prix catalogue ; les frais de crédits en plus font 350 $ au maximum. Les agents ne cherchent d'ailleurs que rarement une seule fois par tâche. Une boucle de recherche qui lance cinq recherches par question d'utilisateur transforme 200 000 questions en un million de recherches, et c'est ainsi qu'une fonctionnalité « bon marché » se retrouve en revue financière. Si vous voulez saisir vos propres chiffres, ce calculateur fait la multiplication :
Ce que Cloudflare a normalisé, et ce qu'elle n'a pas normalisé
C'est l'angle que la plupart des articles manquent, à mon sens. Cloudflare a fait en sorte que les trois fournisseurs paraissent identiques au niveau de l'API. Ils ne le sont pas sur ce qui compte pour une équipe produit.
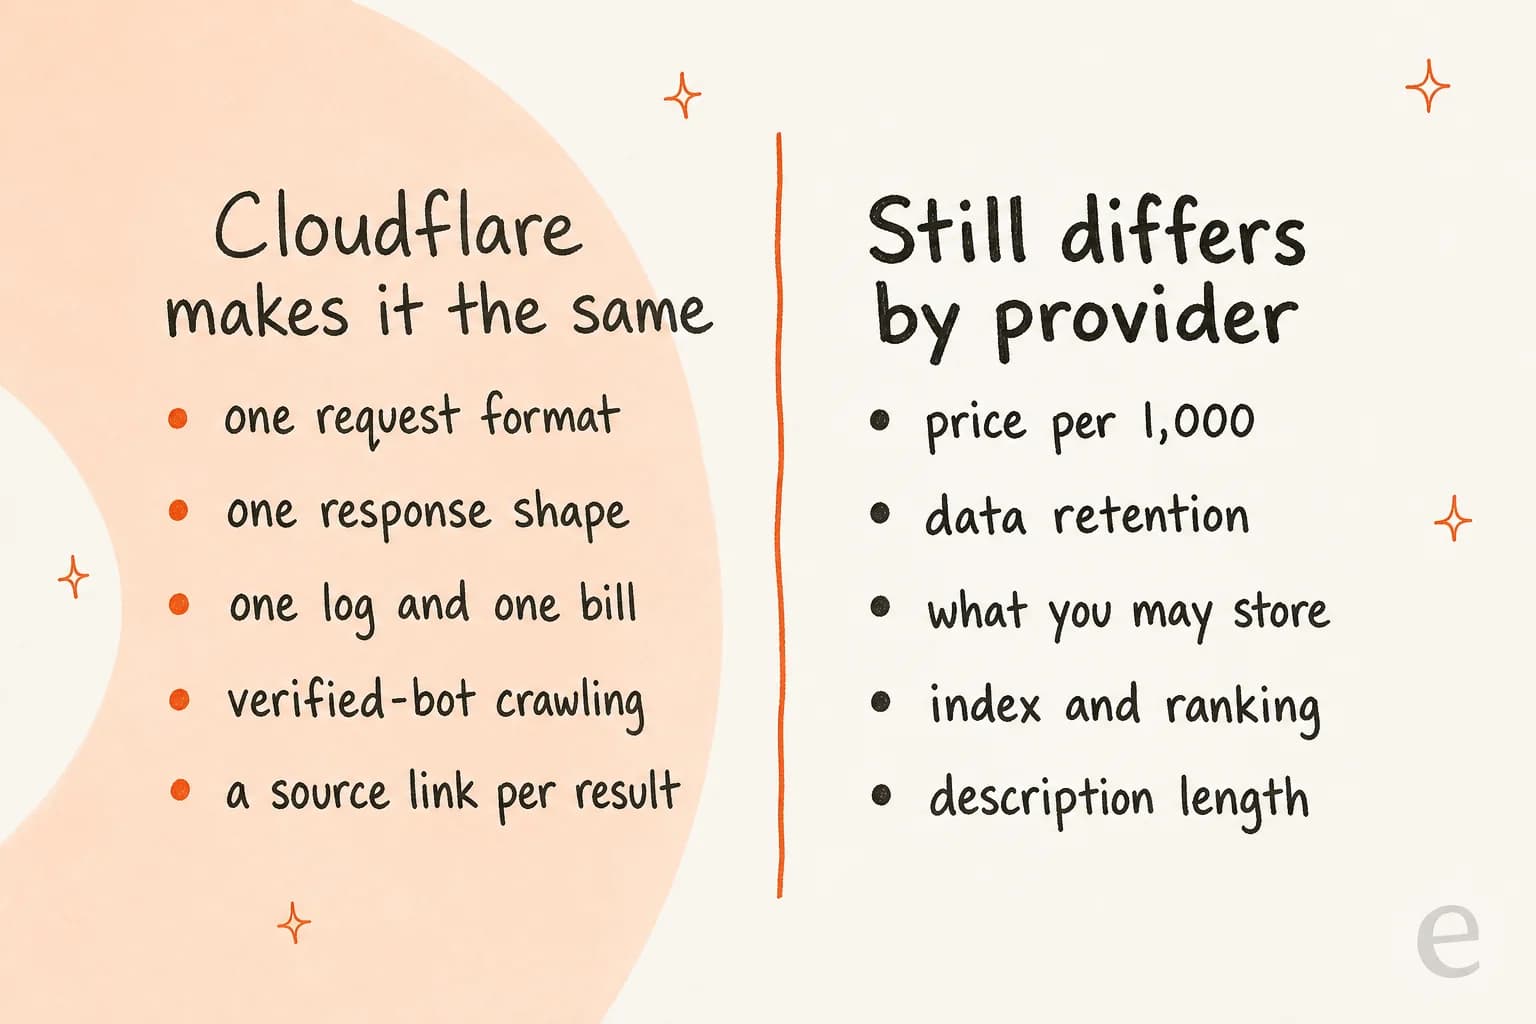
Un message sur X le dit mieux que moi :
"The catch is that a unified endpoint also makes search providers look interchangeable when result quality, coverage, ranking, and failure modes probably won’t be."
Trois écarts méritent d'être vérifiés avant la mise en production.
La conservation des données dit deux choses différentes
L'entrée du changelog dit "all three support Zero Data Retention for requests made through Cloudflare." La page des fournisseurs, mise à jour le même jour, indique Exa avec "Zero Data Retention: No." Les deux pages disaient encore cela quand j'ai vérifié le 8 octobre. Un lecteur de HN l'a remarqué en quelques heures, et quelqu'un d'Exa a répondu :
"Thanks for raising this! We're looking into this discrepancy (I work at Exa)."
Tant que les deux ne concordent pas, je planifierais comme si le tableau des fournisseurs avait raison. Si vos requêtes contiennent des noms de clients, des numéros de commande ou quoi que ce soit venant d'un ticket, cela fait de Ceramic ou Linkup les choix les plus sûrs. Notez aussi que le réglage ZDR de Unified Billing ne contrôle pas la journalisation d'AI Gateway ; c'est un interrupteur distinct.
Ce que vous pouvez stocker dépend des conditions de chaque fournisseur
Cloudflare a unifié le JSON. Elle n'a pas unifié la licence. Simon Willison a soulevé la question que devrait se poser tout produit doté d'un bouton « partager cette conversation » :
"My number one question about search APIs is always if they allow you to store and resyndicate results you get from them."
Il a ensuite cité les conditions d'utilisation de Ceramic, qui vous interdisent de conserver, de mettre en cache ou de stocker la sortie au-delà de ce qui est "reasonably necessary to display such Output to your authorized end users in the ordinary and real-time course of use." Si votre agent écrit des résultats de recherche dans une transcription enregistrée, une base de connaissances ou un cache, lisez les conditions du fournisseur que vous choisissez. Exa et Linkup renvoient vers leurs propres conditions depuis le même tableau des fournisseurs.
La qualité des résultats n'est pas un paramètre
Le fournisseur le moins cher est celui par défaut, et la documentation présente Ceramic comme conçu pour "low-latency, low-cost search." Les premiers testeurs ont trouvé son index inégal :
"Tried one query on ceramic.ai (the default provider for cloudflare web search api): "qwen-3.8 flash next and rtx 5090 best inference setup" ... 0 results ... same query on google and ddg both yield proper results."
Une anecdote n'est pas un benchmark, et le responsable de l'index d'Exa a fait remarquer à juste titre, dans le même fil, que la qualité de la recherche varie selon le type de requête. Mais c'est un rappel que un ensemble de résultats vide est une issue normale que votre agent doit gérer, pas un cas limite. Plus loin, j'explique pourquoi c'est important.
Web Search API face aux autres façons de donner la recherche à un agent
Cloudflare a désormais deux choses appelées « web search », ce qui a troublé quelques lecteurs. L'ancienne page de recherche web d'AI Gateway, mise à jour en juin, couvre le proxy de l'outil de recherche propre à chaque éditeur de modèles. La nouvelle API est un produit distinct.
| Option | Où s'exécute la recherche | Qui choisit les résultats | Fonctionne avec n'importe quel modèle ? |
|---|---|---|---|
| Cloudflare Web Search API | Ceramic.ai, Exa ou Linkup | Vous recevez des résultats bruts et décidez ce que vous transmettez | Oui, y compris les modèles ouverts |
Outils natifs via AI Gateway (Anthropic web_search_20250305, OpenAI web_search_preview, xAI web_search, Alibaba enable_search) | Dans l'appel de l'éditeur du modèle | Le modèle | Seulement les modèles pris en charge par cet éditeur |
| API centrées sur la recherche via le proxy AI Gateway (Perplexity, Parallel) | Le fournisseur | L'endpoint propre du fournisseur | Appel séparé, format propre au fournisseur |
| Appeler directement un fournisseur de recherche | Le fournisseur | Vous | Oui, avec une intégration par fournisseur |
Si vous utilisez l'API d'Anthropic ou l'API d'OpenAI et que leur recherche intégrée vous convient, les outils natifs demandent moins de plomberie. La Web Search API trouve sa place quand vous faites tourner des modèles ouverts, comme Kimi K3 ou les modèles derrière DeepSeek Harness, qui n'ont pas de partenaire de recherche propre. Un commentateur de HN l'a deviné exactement : les grands agents de code viennent avec des partenaires de recherche, et les modèles ouverts ont besoin de recherche quelque part.
Beaucoup de développeurs ont demandé « pourquoi ne pas appeler les fournisseurs directement ? » La réponse honnête du fil, ce sont les achats et les budgets, pas la technique. Un commentateur a décrit comment il a donné à un agent un seul jeton Cloudflare avec des plafonds de dépenses plutôt que de monter un proxy par service :
"Instead I put my API keys to cloudflare, set limits, and gave the agent the CloudFlare token, and in minutes it could contact tens of services."
Cela correspond à ce que Cloudflare documente : des plafonds de dépenses par gateway, définis par modèle, fournisseur ou métadonnées personnalisées. Si votre équipe paie déjà Cloudflare, ajouter la recherche est une ligne de budget, pas une nouvelle évaluation de fournisseur. Sinon, une intégration directe avec Exa ou un outil d'extraction comme Firecrawl peut être tout aussi rapide. Le paysage bouge aussi sous les pieds de tout le monde : la Custom Search JSON API de Google est fermée aux nouveaux clients, et les clients existants ont jusqu'au 1er janvier 2027 pour migrer.
Où cela convient à un agent de support, et où non
Mon biais, d'emblée. Je travaille dans le SEO depuis deux ans, et la première chose que cela enseigne, c'est que l'intention de recherche décide de tout. Un client qui demande « puis-je retourner ceci après 30 jours ? » ne demande pas à internet. Il vous le demande à vous. La bonne source est votre politique de retour, pas les 10 premiers résultats pour « politique de retour 30 jours ».
Cela compte à cause d'un échec que j'ai vu de près. J'ai vu des clients payants d'eesel dont le bot répondait à de vrais clients avec des affirmations inventées quand la recherche dans la base de connaissances revenait vide ; une réponse a sorti « Oxygen » du tableau périodique. La solution n'était pas plus de recherche. C'était un repli strict : quand vos propres sources n'ont rien, passer la main à un humain plutôt que de laisser le modèle combler le vide avec ce qu'il trouve. Une API de recherche web générale agrandit ce vide au lieu de le réduire, car le modèle dispose maintenant de tout internet pour se tromper avec assurance. Les schémas sont décrits dans le guide d'eesel sur les hallucinations de l'IA en support.
Pour le support, je classerais donc les sources ainsi :
- Votre centre d'aide, vos macros et vos anciens tickets. C'est ce que la génération augmentée par la recherche devrait signifier pour le support.
- Votre propre site web et la documentation produit, limités à votre domaine.
- Le web ouvert, en dernier, pour les questions qui portent vraiment sur le monde extérieur : une panne de service d'un transporteur, une réglementation publique, le changelog d'une intégration tierce.
La Cloudflare Web Search API est un outil raisonnable pour ce troisième groupe. Elle ne remplace pas les deux premiers, et Cloudflare ne la présente pas ainsi.
Comment eesel se place à côté d'une API de recherche
La recherche web est de l'infrastructure. eesel est l'employé. Cloudflare donne à votre agent un moyen de chercher des informations ; eesel vous donne un collègue prêt à travailler qui sait déjà où se trouvent vos réponses. Le collègue helpdesk IA rejoint votre file existante dans des outils comme Zendesk, apprend de votre centre d'aide et de vos anciens tickets, rédige ou envoie des réponses et escalade quand il n'a pas de réponse fondée. L'équipe actuelle comprend aussi un rédacteur de blog IA pour les équipes de contenu.

Si vous êtes du genre d'équipe à lire les changelogs de Cloudflare pour le plaisir, vous aimerez probablement la CLI eesel. Elle fait tourner le même collègue depuis un terminal, et tout ce que vous y configurez apparaît dans le tableau de bord. Les commandes correspondent bien à l'idée de « vos sources d'abord » :
npx @eesel/cli init chat-bubble --site https://your-site.comcrée un agent qui commence à lire votre propre site, sans compte nécessaire pour un espace d'essai de 7 jours.eesel integrations connect website --url ...oueesel integrations connect <platform>ajoute votre helpdesk ou vos docs comme connaissances, eteesel files upload ./refund-policy.pdfajoute une politique précise.eesel chat "what's our refund policy?"teste la réponse avant qu'un client ne la voie.eesel approvalsliste les actions en attente d'un humain, de sorte qu'une écriture que l'agent veut faire attend une validation.
Chaque commande affiche du JSON et chaque erreur revient avec un hint, si bien qu'un agent de code comme Claude Code ou Codex peut exécuter toute la configuration et lire ses propres résultats. eesel mcp token transforme aussi l'espace de travail en serveur MCP, ce qui est la façon dont je le connecterais à un agent qui utilise déjà Cloudflare pour la recherche. C'est le même schéma que j'ai traité dans CLI pour le support client : un terminal, des scripts et des agents pilotant un seul collègue.
Là où eesel n'est pas le bon choix : si vous construisez un agent de recherche généraliste qui vit de données web publiques, il vous faut une API de recherche comme celle de Cloudflare, pas un collègue helpdesk.
Mon verdict sur la Cloudflare Web Search API
C'est un produit propre, petit et honnête. Trois choses que je ferais avant de m'y fier :
- Fixer
providerexplicitement, même si vous voulez Ceramic. Un défaut que vous n'avez pas écrit est un défaut que quelqu'un changera sans remarquer un écart de facture de 28 fois. - Considérer la colonne ZDR comme non tranchée pour Exa tant que le changelog et la page des fournisseurs ne concordent pas, et lire les conditions de stockage du fournisseur que vous gardez.
- Gérer volontairement l'absence de résultats. Renvoyer « je ne sais pas » ou passer la main, plutôt que de laisser le modèle improviser. C'est la seule habitude qui empêche l'ancrage de l'IA de devenir de l'hallucination d'IA.
Si vous construisez déjà sur Cloudflare, c'est le moyen le plus simple que j'aie vu de donner une recherche en direct à un modèle ouvert avec une seule facture et un seul journal. Si vous évaluez la recherche pour un agent en contact avec les clients, commencez par vos propres connaissances et ajoutez le web en dernier recours. Pour en savoir plus sur la pile d'agents de Cloudflare, voyez mes notes sur les modèles de décision de Clef et les alternatives à Kitesurf, ou parcourez le champ plus large des moteurs de recherche IA.
Essayez eesel pour des réponses de support fondées
Si vous vous intéressez à une API de recherche web parce que votre bot de support répond sans rien savoir, la solution est généralement plus proche. Le collègue helpdesk IA d'eesel apprend de votre centre d'aide, de vos macros et de vos anciens tickets, et escalade vers votre équipe quand il n'a rien de fondé à dire. Vous pouvez le tester sur votre propre base de connaissances avant qu'il ne touche un ticket en direct, et consulter les offres sur la page des tarifs. Essayez eesel gratuitement.
Questions fréquentes
Qu'est-ce que la Cloudflare Web Search API ?
Combien coûte la Cloudflare Web Search API ?
Quel fournisseur la Cloudflare Web Search API utilise-t-elle par défaut ?
provider, chaque requête va chez Ceramic, qui est aussi l'option la moins chère et exploite son propre index de plus de 40 milliards de pages. C'est un choix par défaut raisonnable côté coût, mais testez-le sur vos propres requêtes avant de lui faire confiance pour ancrer des réponses.La Cloudflare Web Search API prend-elle en charge la non-conservation des données (zero data retention) ?
Puis-je utiliser ma propre clé d'API Exa ou Linkup ?
byokAlias dans la requête. Si vous indiquez l'alias et qu'il n'est pas configuré, la requête échoue avec une erreur 400 au lieu de facturer discrètement vos crédits Cloudflare. C'est le même schéma que Cloudflare utilise pour les clés de modèles, que j'aborde dans mon explication sur les clés d'API OpenAI.Combien de résultats la Cloudflare Web Search API renvoie-t-elle ?
limit va de 1 à 10 et vaut 10 par défaut, et la requête elle-même est limitée à 1 024 caractères. Chaque résultat comporte une URL et un titre, plus une description et, en option, une image, un favicon et la date de dernière modification lorsque le fournisseur les renvoie, ce qui garde le coût de la fenêtre de contexte prévisible.La Cloudflare Web Search API convient-elle aux agents de support client ?
En quoi la Web Search API diffère-t-elle de la recherche web native d'AI Gateway ?
web_search_20250305 d'Anthropic et web_search_preview d'OpenAI, où la recherche s'exécute à l'intérieur de l'appel au modèle. La Web Search API est un endpoint distinct qui renvoie des résultats bruts que vous contrôlez, issus d'un fournisseur que vous choisissez, ce qui permet de l'utiliser avec n'importe quel modèle, y compris les modèles ouverts sur Workers AI.