

Gemini 4 Hydrogen coûte 1,50 $ par million de tokens en entrée et 7,50 $ par million de tokens en sortie, de façon fixe sur toute sa fenêtre de contexte de 1M. Cette étiquette de prix n'est pas ce qui décide de votre facture. C'est le niveau de réflexion : sur Artificial Analysis, une tâche coûte 0,29 $ en low et 3,16 $ en xhigh, soit 11 fois plus avec le même tarif. Batch et Flex réduisent le tarif de moitié, Priority ajoute 80 %, et Carbon et Argon doublent le 1er décembre, ce qui fait de Hydrogen le modèle Gemini 4 bon marché par défaut de Google. Pour des réponses de support, c'est moins d'un centime par ticket, et eesel garde ça hors de votre facture avec des forfaits fixes.
J'ai vérifié la page de tarifs de Google le 13 novembre 2026, le lendemain du lancement. Si vous préférez ne pas gérer du tout la plomberie du modèle, la CLI eesel permet à un agent de code de téléverser des connaissances approuvées et de lancer des questions de test contre un coéquipier eesel avant que quoi que ce soit ne passe en direct. Connecter le helpdesk lui-même nécessite toujours l'approbation d'un administrateur.
Les sections ci-dessous ne traitent que de l'aspect financier. Mon aperçu de Gemini 4 Hydrogen couvre le modèle et le test de Hydrogen couvre ses performances.
Quel est le tableau de tarifs complet de Gemini 4 Hydrogen ?
Voici chaque prix de Hydrogen publié par Google, par million de tokens. Google facture chaque token traité par le modèle, y compris les tokens de réflexion, donc la réflexion est tarifée comme de la sortie.
| Palier | Entrée | Sortie (réflexion incluse) | Entrée en cache | Données utilisées pour améliorer les produits Google |
|---|---|---|---|---|
| Palier gratuit | Gratuit | Gratuit | Gratuit | Oui |
| Standard (payant) | 1,50 $ | 7,50 $ | 0,075 $ | Non |
| Batch | 0,75 $ | 3,75 $ | 0,0375 $ | Non |
| Flex | 0,75 $ | 3,75 $ | 0,0375 $ | Non |
| Priority | 2,70 $ | 13,50 $ | 0,135 $ | Non |
| Contributor (aperçu privé sur invitation) | 0,75 $ | 3,75 $ | 0,0375 $ | Oui |
Trois détails de ce tableau comptent plus que les chiffres en gros titre :
- Un seul prix sur toute la fenêtre. Pas de surcoût après 200K tokens. Le billet de lancement de Google dit lui-même que Hydrogen est "priced flat across its entire 1 million-token context window", donc un document long coûte le même prix par token qu'un chat court.
- Le cache n'est qu'implicite. L'entrée en cache coûte 95 % moins cher (0,075 $), mais Google indique que le cache explicite n'est pas supporté, donc vous ne pouvez pas fixer un cache vous-même. Gardez votre préfixe de prompt stable et espérez un hit.
- Batch et Flex n'ont pas de palier gratuit. Le palier gratuit est limité en débit, et Google dit qu'il utilise ces données pour améliorer ses produits.
L'identifiant du modèle est gemini-4-hydrogen. Il a quatre niveaux de réflexion (low, medium, high et xhigh) et high est le niveau par défaut, ce qui passe souvent inaperçu. Si vous ne fixez pas de niveau, vous payez le tarif de 1,87 $ de la section suivante, pas celui de 0,80 $.
Combien coûte une tâche à chaque niveau de réflexion ?
C'est là que se décide la vraie facture. Artificial Analysis fait passer chaque modèle par le même ensemble de tâches et enregistre ce que coûte chaque exécution, tokens de réflexion inclus. Pour Hydrogen, les quatre niveaux se présentent ainsi :
| Niveau de réflexion | Score d'index | Coût par tâche | Temps par tâche | Coût par point d'index |
|---|---|---|---|---|
| low | 27 | 0,29 $ | 1,3 min | 0,011 $ |
| medium | 41 | 0,80 $ | 3,7 min | 0,020 $ |
| high (par défaut) | 51 | 1,87 $ | 8,3 min | 0,037 $ |
| xhigh | 54 | 3,16 $ | 13,0 min | 0,059 $ |
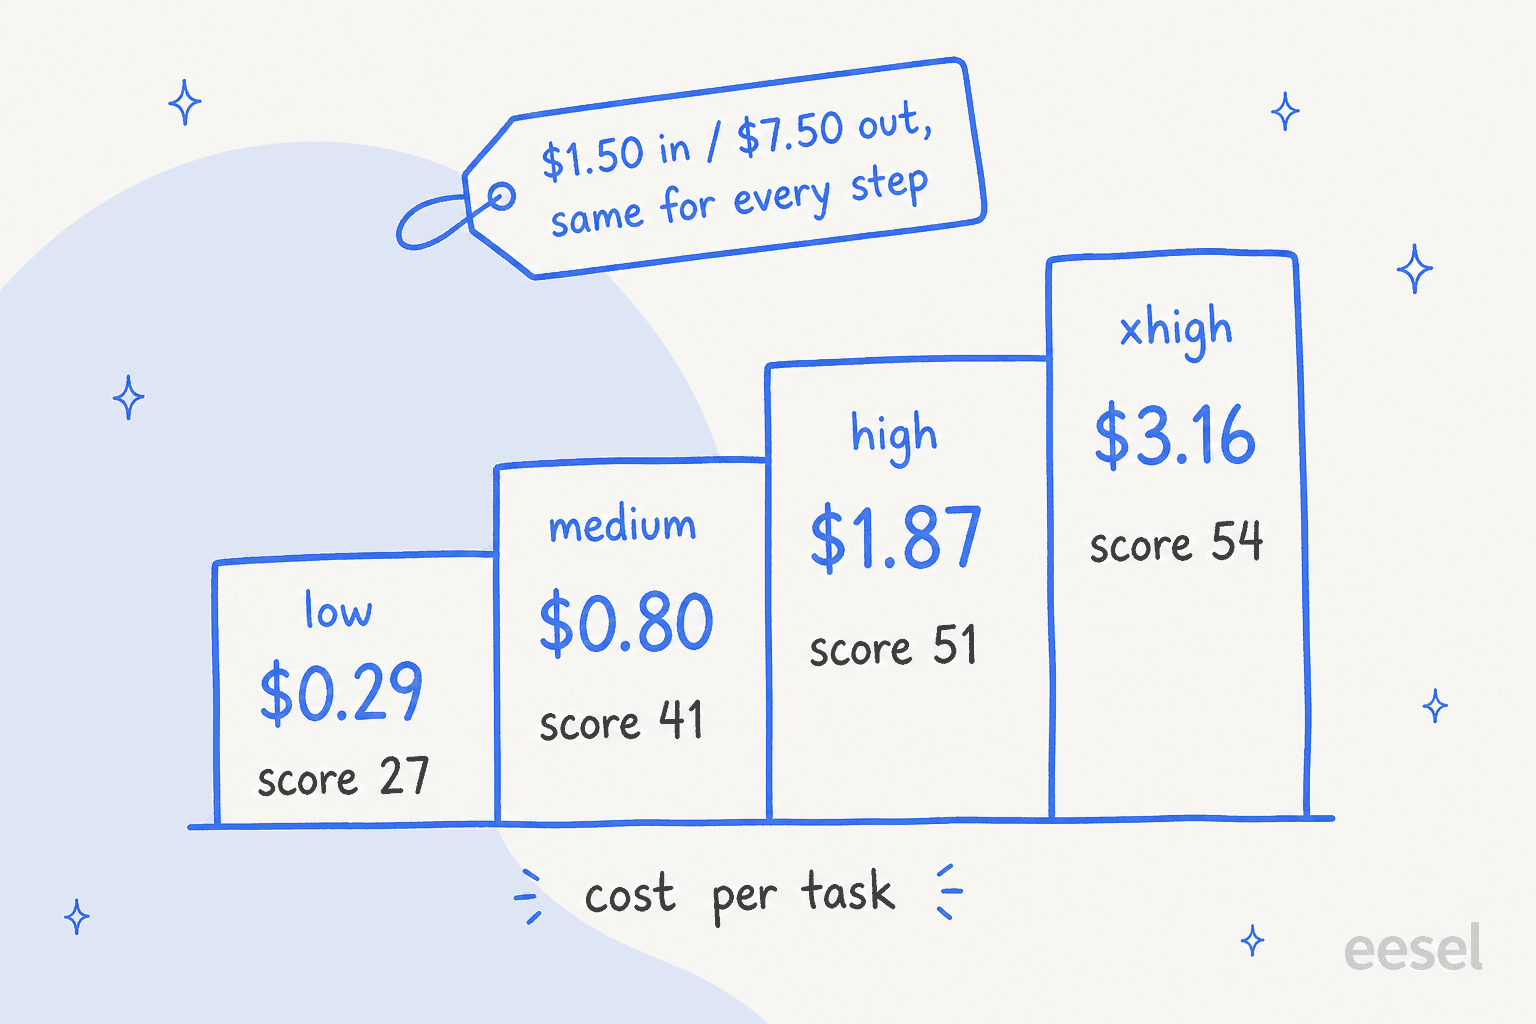
Le prix du token ne bouge jamais, et le coût par tâche varie malgré tout par 11. La raison, c'est la longueur de la sortie : Artificial Analysis compte environ 110M de tokens de sortie sur tout son index en high et environ 304M en xhigh, et qualifie xhigh de "very verbose". La sortie est le côté coûteux du tarif, à 7,50 $ par million.
Trois choses que je retiendrais du tableau :
- Medium est le point efficace. Il obtient 80 % du score de high (41 contre 51) pour 43 % du coût (0,80 $ contre 1,87 $).
- Xhigh est un luxe. Passer de high à xhigh achète 3 points de plus pour 1,29 $ de plus par tâche, une hausse de prix de 69 %.
- Le défaut n'est pas l'option économique. Choisissez le niveau avant de choisir le palier, car une remise de palier de 50 % est plus petite que l'écart entre low et high.
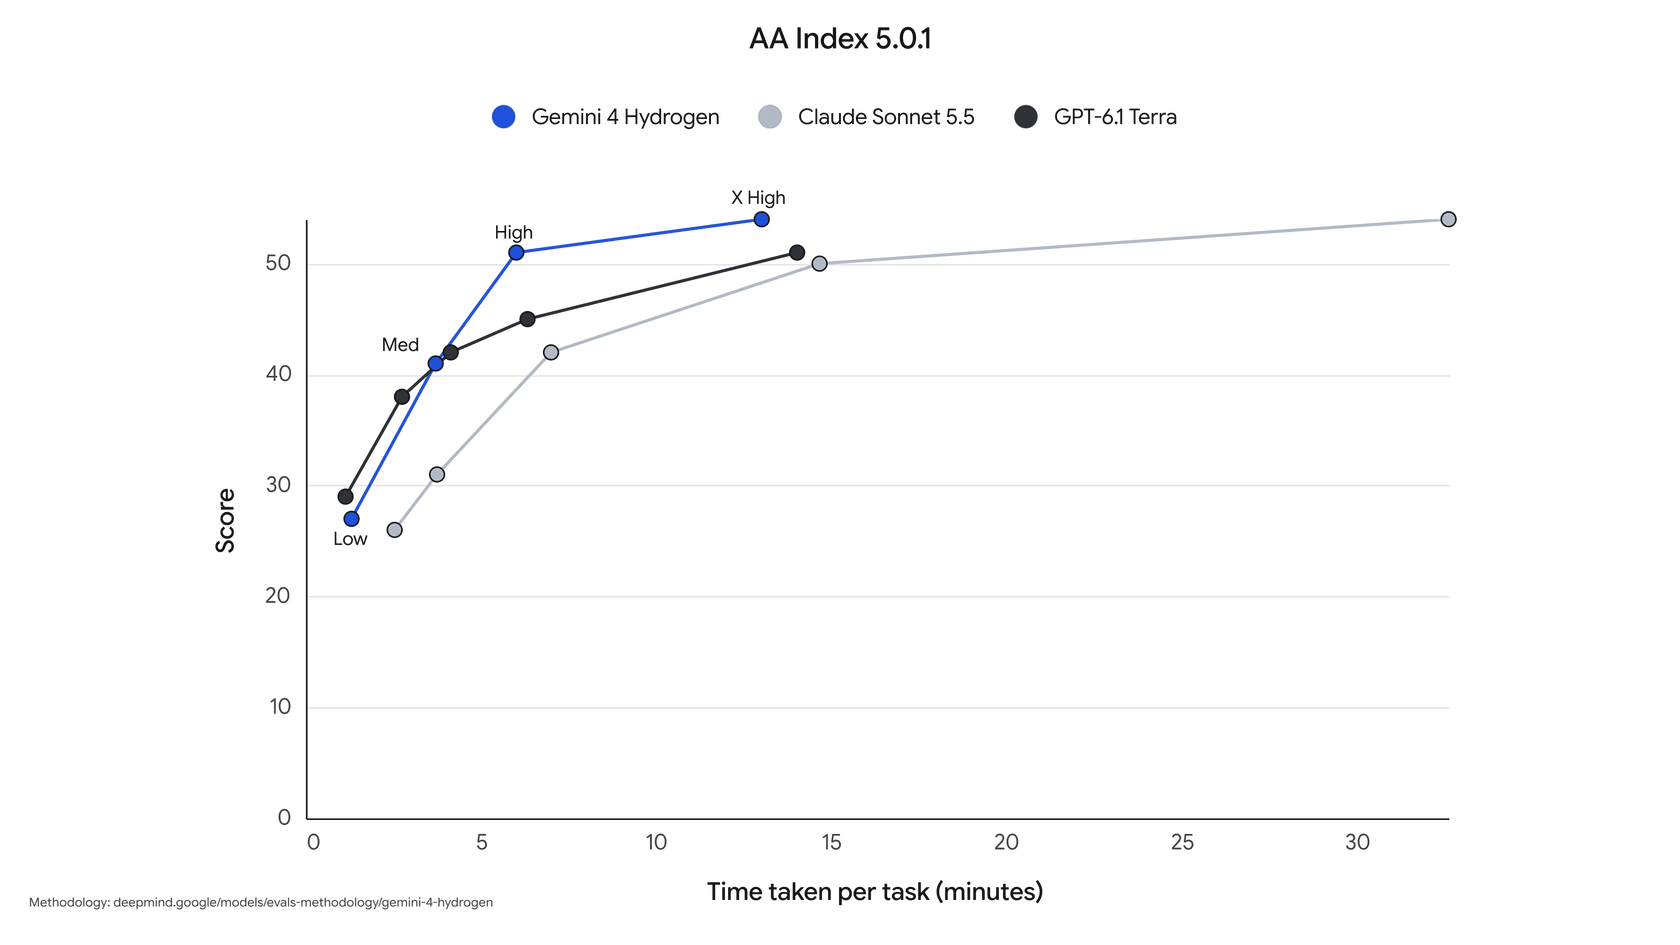
Pour contexte, Artificial Analysis situe GPT-6.1 Terra à 51 pour 0,96 $ par tâche et Claude Sonnet 5.5 à 55 pour 10,02 $. Hydrogen en high égale donc le score de Terra à environ deux fois le coût, tandis que Sonnet 5.5 coûte plus de cinq fois plus pour quatre points de plus. Gemini 3.8 Flash score 31 pour 7,77 $ par tâche, à son prix promotionnel actuel. Un utilisateur précoce sur Hacker News a mesuré quelque chose de similaire face à ce modèle :
"My use case benchmarks 37% more expensive per task but 40-60% of the total time per task (median and p90 had the same improvement)."

Leurs chiffres viennent de leur propre évaluation en raisonnement medium, donc traitez-les comme un seul point de données et non comme une règle. Cela dit, cela correspond à ce que j'attendrais : Hydrogen est plus rapide et moins cher par point, mais pas toujours moins cher par tâche.
Quel palier utiliser : Standard, Batch, Flex, Priority ou Contributor ?
Chaque palier est un multiplicateur sur le tarif Standard, donc le choix dépend surtout de ce que votre travail peut tolérer.
- Standard (1,50 $ / 7,50 $) est le défaut pour tout ce qui est interactif, comme un chat de support.
- Batch et Flex (0,75 $ / 3,75 $) coûtent moitié prix. Utilisez-les pour le travail qui peut attendre : étiquetage nocturne de tickets, backfills, évaluations. Vérifiez la documentation de Google sur les conditions de latence de chaque voie avant d'y engager un flux visible par les clients.
- Priority (2,70 $ / 13,50 $) coûte 80 % de plus que Standard. Cela n'a de sens que là où une réponse lente vous coûte de l'argent.
- Contributor (0,75 $ / 3,75 $) égale Batch en prix, avec "speed and reliability equivalent to Standard", mais c'est un aperçu privé sur invitation uniquement et Google utilise vos données. Pour tout ce qui contient des détails clients, je ne le ferais pas.
Voici comment ce multiplicateur se traduit sur le coût par tâche d'Artificial Analysis. C'est mon propre calcul, en supposant que les chiffres d'Artificial Analysis sont au tarif Standard et que chaque partie de la facture d'une tâche évolue avec le tableau :
| Niveau de réflexion | Standard | Batch / Flex | Priority |
|---|---|---|---|
| low | 0,29 $ | 0,145 $ | 0,52 $ |
| medium | 0,80 $ | 0,40 $ | 1,44 $ |
| high | 1,87 $ | 0,94 $ | 3,37 $ |
| xhigh | 3,16 $ | 1,58 $ | 5,69 $ |
En lisant une colonne de haut en bas, le niveau de réflexion est le plus gros levier. Passer de high sur Standard (1,87 $) à medium sur Standard (0,80 $) économise plus que de passer high à Batch (0,94 $), et vous pouvez faire les deux. Medium sur Batch coûte 0,40 $ par tâche, environ un cinquième du défaut.
Qu'est-ce qui change le 1er décembre et le 1er janvier ?
Le prix de Hydrogen lui-même ne change pas. Celui de ses voisins, si, et cela redistribue la place de Hydrogen dans la gamme Gemini. Tous les chiffres ci-dessous sont les prix publiés par Google par million de tokens, entrée / sortie.
| Modèle | Jusqu'au 30 nov. 2026 | Du 1er au 31 déc. 2026 | À partir du 1er janv. 2027 |
|---|---|---|---|
| Gemini 4 Hydrogen | 1,50 $ / 7,50 $ | 1,50 $ / 7,50 $ | 1,50 $ / 7,50 $ |
| Gemini 4 Carbon | 2,00 $ / 10,00 $ | 4,00 $ / 20,00 $ | 4,00 $ / 20,00 $ |
| Gemini 4 Argon | 2,00 $ / 10,00 $ | 4,00 $ / 20,00 $ | 4,00 $ / 20,00 $ |
| Gemini 3.8 Flash | 0,75 $ / 3,75 $ | 0,75 $ / 3,75 $ | 1,50 $ / 7,50 $ |
Ni Carbon ni Argon n'ont de palier gratuit. Deux conséquences en découlent :
- À partir du 1er décembre, Carbon et Argon coûtent 2,67 fois Hydrogen en sortie. Aujourd'hui, c'est seulement 1,33 fois. C'est la date où beaucoup de décisions du type "je prends directement le plus gros ?" basculent, car le billet de lancement de Google dit que Hydrogen dépasse Argon sur l'index Artificial Analysis à son niveau par défaut, 51 contre 50.
- À partir du 1er janvier, Hydrogen et Gemini 3.8 Flash ont le même prix en entrée et en sortie. Google qualifie Hydrogen de "Recommended upgrade from Gemini 3.8 Flash and earlier Gemini 3 and 2.5 models". L'entrée en cache de Hydrogen reste à 0,075 $, tandis que celle de 3.8 Flash passe à 0,15 $, mais 3.8 Flash supporte le cache explicite et Hydrogen non.
Aujourd'hui, c'est le 13 novembre, donc le 1er décembre est à environ deux semaines et demie et le 1er janvier à environ sept. Certains développeurs avaient déjà lu le nouveau prix comme une hausse, et quelqu'un sur Hacker News a décrit l'effet en cascade sur une charge de travail en 3.8 Flash :
"costs are already high for our workload on 3.8 Flash (which in itself was already a 40% increase compared to 3.7 flash due to being more verbose and thinking more) and this now doubles cost once again."
Ce lecteur a raison de dire que Hydrogen coûte le double du prix actuel de 3.8 Flash. Ce que le calendrier ajoute, c'est que ce doublement s'arrête le 1er janvier, quand 3.8 Flash rattrape. Si vous êtes sur 3.8 Flash et que votre facture va augmenter le 1er janvier de toute façon, tester Hydrogen maintenant ne coûte aucun regret, et en medium cela peut très bien revenir moins cher par tâche. Pour le tableau complet de ce modèle, voir mon test de Gemini 3.8 Flash et l'article sur Gemini 3.5 Flash-Lite pour le bas de gamme.
Qu'est-ce qui peut encore apparaître sur une facture Hydrogen ?
Les tokens ne font pas toute la facture. Trois autres postes valent la peine d'être connus avant de passer en production :
- Grounding de recherche. Le grounding avec Google Search n'est disponible que sur Standard et Priority. Vous obtenez 5 000 requêtes de recherche gratuites par mois, partagées entre tous les modèles Gemini 3 et plus récents, puis 14 $ pour 1 000, avec un plafond de 1 500 requêtes par jour. Google avertit qu'une requête client peut déclencher plusieurs requêtes de recherche facturées. Le grounding Maps a le même tarif de 14 $ pour 1 000 après 5 000 gratuites.
- Le grounding compte aussi dans les tokens. Google facture les instructions d'outils internes et les déclarations de fonction comme des tokens quand le grounding est actif.
- Pas de cache explicite. Comme vous ne pouvez pas fixer un cache, votre taux de hit dépend du maintien de prompts stables octet pour octet au début. Pour l'exemple de support ci-dessous, passer de 0 % à 70 % d'entrée en cache fait passer la facture mensuelle de 105 $ à 65 $.
Une mise en garde sur le palier gratuit : il est utile pour prototyper, mais Google utilise ces données, donc gardez les vrais messages clients hors de ce palier. Les limites de débit sont sur la page des limites de débit de Google.
Calculateur de coûts de Gemini 4 Hydrogen
Entrez votre propre volume et vos propres comptages de tokens. Le widget tarife le même travail sur chaque palier de Hydrogen et montre Carbon et Argon des deux côtés du 1er décembre, et Gemini 3.8 Flash des deux côtés du 1er janvier. La part en cache est la portion de votre entrée qui atteint le cache implicite.
Que coûte Hydrogen sur des charges de travail réelles ?
Voici les chiffres pour un agent de réponse au support. Les comptages de tokens sont mes propres hypothèses illustratives, indiquées pour que vous puissiez mettre les vôtres : chaque ticket lit 4 000 tokens dont 1 200 (30 %) atteignent le cache, et écrit 600 tokens réflexion incluse, sur 10 000 tickets par mois.
Le calcul sur Standard. L'entrée fraîche fait 2 800 tokens à 1,50 $ par million, soit 0,0042 $. L'entrée en cache fait 1 200 tokens à 0,075 $ par million, soit 0,00009 $. La sortie fait 600 tokens à 7,50 $ par million, soit 0,0045 $. Cela fait un total de 0,00879 $ par ticket, ou 87,90 $ pour 10 000 tickets.
| Option | Coût mensuel pour 10 000 tickets | Par rapport à Hydrogen Standard |
|---|---|---|
| Hydrogen Standard | 87,90 $ | référence |
| Hydrogen Batch / Flex (ou Contributor) | 43,95 $ | 0,5x |
| Hydrogen Priority | 158,22 $ | 1,8x |
| Carbon ou Argon jusqu'au 30 nov. | 117,20 $ | 1,33x |
| Carbon ou Argon à partir du 1er déc. | 234,40 $ | 2,67x |
| Gemini 3.8 Flash jusqu'au 31 déc. | 44,40 $ | 0,51x |
| Gemini 3.8 Flash à partir du 1er janv. | 88,80 $ | 1,01x |
Trois leçons à en tirer :
- Dans cette configuration, le mois entier reste sous 100 $. Sur Hydrogen, c'est assez bon marché pour que le modèle soit rarement votre vrai coût de support, ce qui correspond à ce que j'ai trouvé en tarifant Carbon pour la même forme de ticket.
- Le niveau de réflexion peut submerger le palier. Si un niveau plus élevé signifie 2 400 tokens de sortie au lieu de 600 (mon hypothèse, pas un chiffre de Google), la facture Standard monte à 222,90 $. À 6 000 tokens de sortie, c'est 492,90 $. C'est une hausse de 10 fois en sortie qui donne une hausse de 5,6 fois au total, donc un seul réglage coûte plus que toutes les remises de palier combinées.
- Le grounding peut rivaliser avec les tokens. Si chaque ticket déclenche une requête Google Search facturée, alors 10 000 tickets utilisent 5 000 requêtes gratuites et 5 000 payantes : 5 000 x 14 $ pour 1 000 = 70 $. C'est proche de la facture de tokens de 87,90 $, et cela suppose que le quota gratuit n'est pas déjà épuisé par d'autres modèles Gemini 3 ou plus récents dans votre projet.
Un agent exécutant des tâches dans le style Artificial Analysis. 100 tâches par mois en medium, c'est 80 $ sur Standard et 40 $ sur Batch. En xhigh, c'est 316 $ sur Standard, 158 $ sur Batch et 569 $ sur Priority. Même modèle, même tarif, et un écart de 14 fois entre medium sur Batch (40 $) et xhigh sur Priority (569 $).
Pour les lecteurs qui pèsent les modèles plutôt que les paliers, mon article sur le meilleur modèle IA pour les tickets de support et les guides sur les tarifs de Claude Sonnet 5.5 et les tarifs de GPT-6.1 Terra suivent la même logique par tâche.
Si vous voulez le reste du terrain Google, mon guide sur les alternatives à Gemini le couvre.
Quel forfait Google inclut Hydrogen ?
Tous les chemins vers Hydrogen ne sont pas une facture au token. Si vous êtes une personne et non une API, un abonnement peut être l'entrée la moins chère. Voici ce que Google liste sur sa page d'abonnements pour les États-Unis :
| Forfait | Prix | Accès à Hydrogen |
|---|---|---|
| Free | 0 $ par mois | L'app Gemini sélectionne automatiquement Hydrogen "when it's the appropriate model for the prompt" |
| Google AI Plus | 4,99 $ par mois | Inclut Hydrogen, 2 fois l'usage Free |
| Google AI Pro | 19,99 $ par mois | Accès à Hydrogen ; le modèle phare est Argon |
| Google AI Ultra | 99,99 $ ou 199,99 $ par mois | "Highest access to Gemini 4 Hydrogen", plus Carbon (5 ou 20 fois les limites Pro) |
| Gemini Enterprise Business | à partir de 21 $ par poste par mois, jusqu'à 300 postes | Palier Business |
| Gemini Enterprise Standard / Plus | à partir de 30 $ par poste par mois | Palier Business |
Dans Google Antigravity, l'outil de code, il existe un forfait individuel gratuit, mais Hydrogen y est réservé aux abonnés payants de Google AI Pro et Ultra. Le mode Orchestrator de Google, où Carbon planifie et Hydrogen fait le travail dans une seule session, est réservé à Ultra. Google affirme qu'en Terminal-Bench il a atteint un succès proche de Carbon en utilisant 24 % moins de quota et en terminant 19 % plus vite. Pour en savoir plus sur le forfait le plus haut, mon guide Google AI Ultra donne le détail. Les entreprises qui veulent une tarification à la consommation d'API passent plutôt par Google Cloud.
Les forfaits et les tokens de l'API sont facturés séparément : un abonnement Pro ne paie pas les tokens de votre agent en production.
Gemini 4 Hydrogen vaut-il son prix ?
Oui, avec trois conditions.
- Fixez le niveau délibérément. Commencez à
mediumpour tout ce qui n'est pas une tâche de raisonnement difficile, et montez seulement quand le score supplémentaire justifie le coût supplémentaire. Le laisser au défauthighcoûte 2,3 fois plus pour dix points. - Utilisez Batch ou Flex pour tout ce qui peut attendre. La moitié prix est l'économie la plus nette du tarif.
- Vérifiez le calendrier. Si vous décidez entre Hydrogen et Carbon ou Argon, le saut du 1er décembre tranche en faveur de Hydrogen, sauf si vous avez besoin du score le plus élevé. Si vous êtes sur 3.8 Flash, le 1er janvier rend le changement gratuit en termes de prix.
Je ne choisirais pas Hydrogen comme l'option la moins chère du marché, puisque GPT-6.1 Terra obtient le même score de 51 pour 0,96 $ par tâche, et je le testerais sur vos propres tickets avant de changer quoi que ce soit. Les guides sur les tarifs de l'API OpenAI et les tarifs de l'API Anthropic sont les deux autres listes de prix que je garderais à côté de celle-ci.
Que signifient les tarifs de Hydrogen pour une équipe de support ?
Moins que ce que les gros titres suggèrent. Un centime par ticket ne décide pas si le support par IA est rentable. Ce qui décide, c'est si les réponses sont correctes, et les hallucinations dans le support sont le coût à prévoir. Il en va de même pour les règles de transfert, les connaissances que lit l'agent, et la façon dont il s'intègre au helpdesk que vous utilisez déjà. Ces coûts se trouvent dans le coût du service client IA autour du modèle, et aucun ne diminue parce qu'un niveau de réflexion est plus bas. Le chiffre à suivre, c'est le coût par résolution, pas le coût par token.
Voici deux clients eesel, car tous deux montrent où va vraiment l'effort :
- smava, un comparateur de prêts berlinois, fait tourner trois agents eesel sur un seul Zendesk pour deux marques. En un mois, il a traité environ 27 000 tickets, catégorisé environ 14 600 et préparé environ 15 300 brouillons de réponse à partir d'environ 820 macros et articles du centre d'aide. Si je tarifais chacun de ces tickets comme un seul appel de la forme 4 000 en entrée, 600 en sortie ci-dessus, Hydrogen Standard coûterait environ 237 $ par mois. Le chiffre de tokens réel est plus élevé, car plusieurs agents et de nombreuses recherches tournent par ticket, mais le travail qui comptait était d'écrire les règles pour une équipe financière réglementée, pas de choisir un modèle.
- MentorShow, une plateforme française d'apprentissage en ligne, fait tourner eesel à l'intérieur de HubSpot. Entre le 8 août et le 8 septembre 2026, eesel a lu environ 1 200 conversations et tickets, exécuté 837 recherches dans la base de connaissances et rédigé 432 brouillons en français, anglais ou espagnol. MentorShow a indiqué à eesel qu'il reçoit entre 5 000 et 13 000 tickets par mois. La partie difficile a été neuf types de tickets à ignorer, une fiche membre à lire et une liste de choses à ne jamais promettre.
Aucune des deux équipes n'a eu à choisir un niveau de réflexion ou à surveiller une date de prix le 1er décembre. C'est la différence pratique entre un modèle et un coéquipier.
Essayer eesel
Si vous tarifez Gemini 4 Hydrogen parce que vous voulez que l'IA réponde aux tickets, vous pouvez vous passer de la plupart de ces calculs. Hydrogen est de l'infrastructure ; eesel est l'employée. Le coéquipier IA de helpdesk d'eesel apprend de vos anciens tickets et de votre centre d'aide, se teste lui-même sur vos vrais anciens tickets par simulation avant de répondre à qui que ce soit.
Il se connecte à Zendesk, Freshdesk et aux autres helpdesks que vous utilisez déjà.
La tarification est un forfait de crédits mensuel fixe où un ticket ou un chat coûte un crédit quel que soit le nombre de réponses nécessaires, à partir de 299 $ par mois pour 500 crédits. Toutes les fonctionnalités et des sièges illimités sont inclus, et vous pouvez commencer gratuitement avec 100 crédits et sans carte. Quand Google change un prix le 1er décembre, votre facture reste où elle est. Essayez eesel sur une partie de votre file et voyez comment il gère vos propres tickets.