

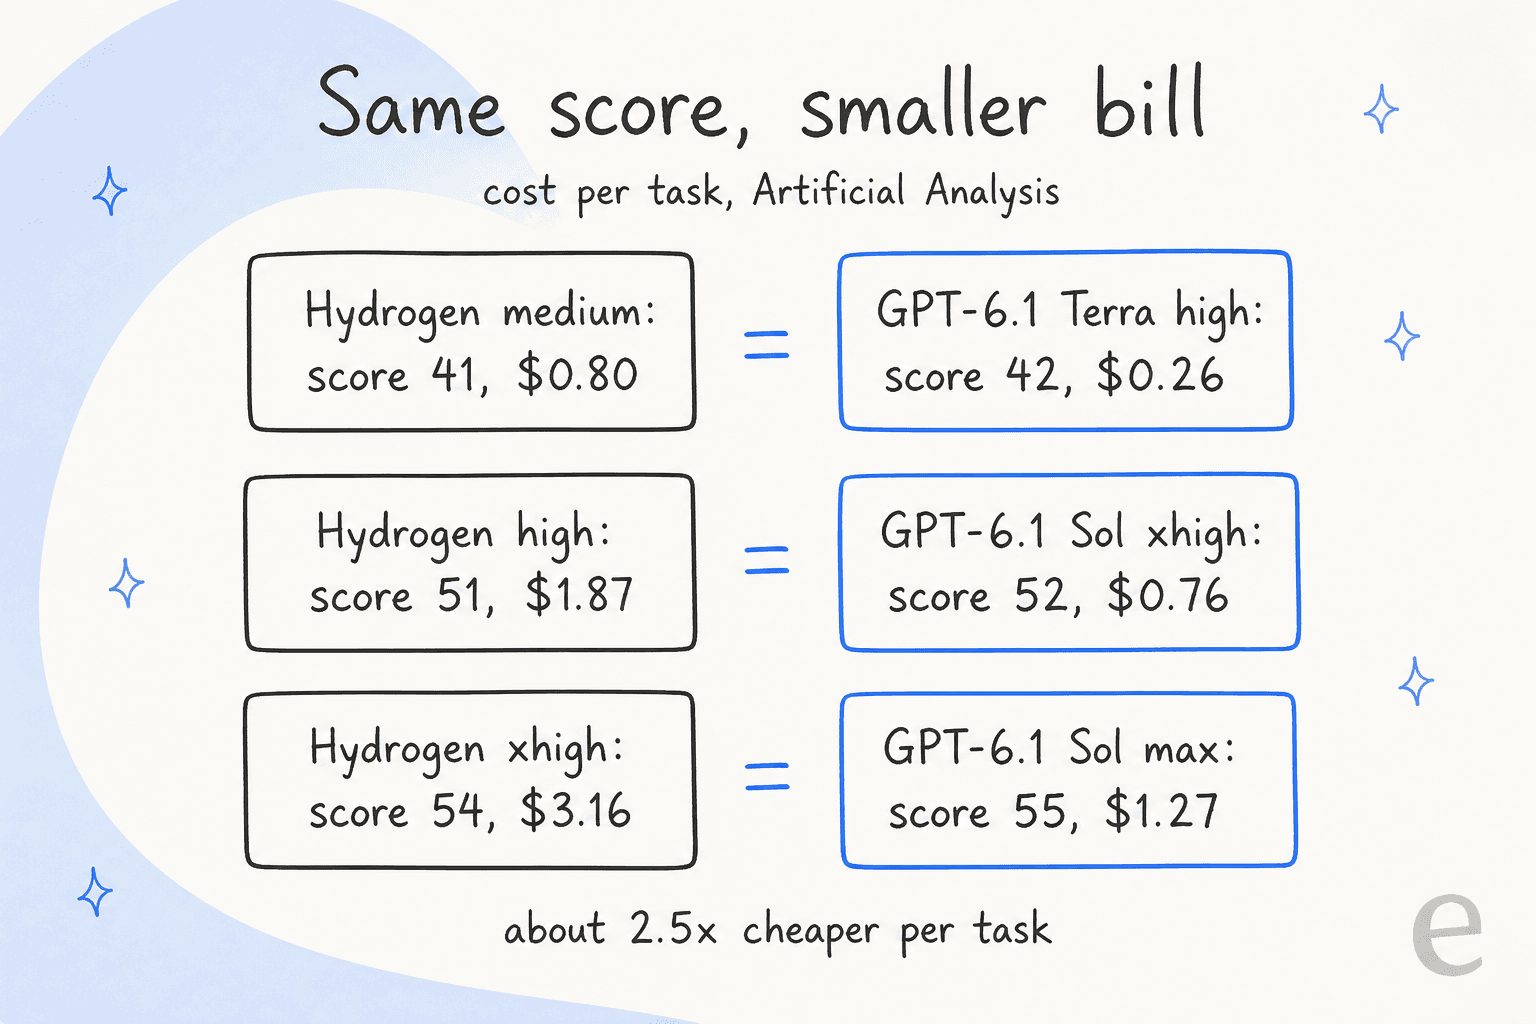
La meilleure alternative à Gemini 4 Hydrogen pour la plupart des développeurs est GPT-6.1 Sol à l'effort xhigh. Il coûte plus cher par token qu'Hydrogen, mais Artificial Analysis le note à 52 pour $0,76 par tâche, tandis qu'Hydrogen à son niveau par défaut high obtient 51 pour $1,87. Hydrogen réfléchit beaucoup avant de répondre, et vous payez pour chacun de ces tokens.
Choisissez Claude Sonnet 5.5 pour les agents de code et d'utilisation d'ordinateur, DeepSeek V4.1 Flash pour la facture la plus petite, et Gemini 4 Carbon seulement pour les problèmes les plus difficiles. Si vous construisez un agent de support, eesel est un coéquipier helpdesk déjà prêt qui s'appuie sur des modèles comme ceux-ci, et son CLI permet à un agent de code de charger vos articles d'aide et de tester ses réponses avant la mise en ligne.
Pourquoi regarder au-delà de Gemini 4 Hydrogen ?
Je commence par le bon côté, parce qu'il y en a beaucoup. Gemini 4 Hydrogen a été lancé le 12 novembre 2026 à $1,50 par million de tokens en entrée et $7,50 par million en sortie, à prix plat sur toute sa fenêtre de 1 million de tokens. Il a un niveau gratuit à débit limité, il prend du texte, des images, de l'audio, de la vidéo et des PDF, et avec une réflexion basse ou moyenne il est rapide : 1,3 et 3,7 minutes par tâche de l'Intelligence Index sur Artificial Analysis. Google le rapporte aussi 2,5 fois plus rapide que Gemini 3.8 Flash dans son réglage par défaut, selon le billet de lancement.
Les développeurs continuent de chercher ailleurs, et d'après mon expérience c'est pour une de ces quatre raisons :
- La facture grimpe vite avec une réflexion élevée. Le prix du token ne change jamais, mais le coût par tâche, lui, change. Artificial Analysis place Hydrogen à
$0,29par tâche en low,$0,80en medium,$1,87en high (le défaut) et$3,16en xhigh. C'est un écart de 11 fois sur le même modèle, parce qu'AA le décrit comme "very verbose" au niveau le plus haut. - Code et utilisation d'ordinateur sont en retard sur Claude. La propre fiche modèle de Google place Sonnet 5.5 devant sur Terminal-Bench 4.1 (
63,9%contre57,0%) et OSWorld-2.1 (83,9%contre77,6%). - La migration casse des choses. Selon les notes de migration de Google, Hydrogen ignore
temperature,top_pettop_k, rejette le niveau de réflexionminimal, abandonne le cache de contexte explicite, et peut renvoyerMALFORMED_FUNCTION_CALLsi vous lui demandez d'écrire des appels d'outils en JSON brut sans déclarer d'outils. - Les prix de Google continuent de bouger. Plus de détails plus bas, car cela change les calculs pour quiconque est sur Gemini 3.8 Flash.
Le fil de lancement sur Hacker News a bien résumé le compromis :
"My TL;DR is: seems like a better choice than Sonnet in areas outside of coding, and at high reasoning it's smarter than Terra but somewhat more expensive."

Qu'arrive-t-il ensuite aux prix de Gemini ?
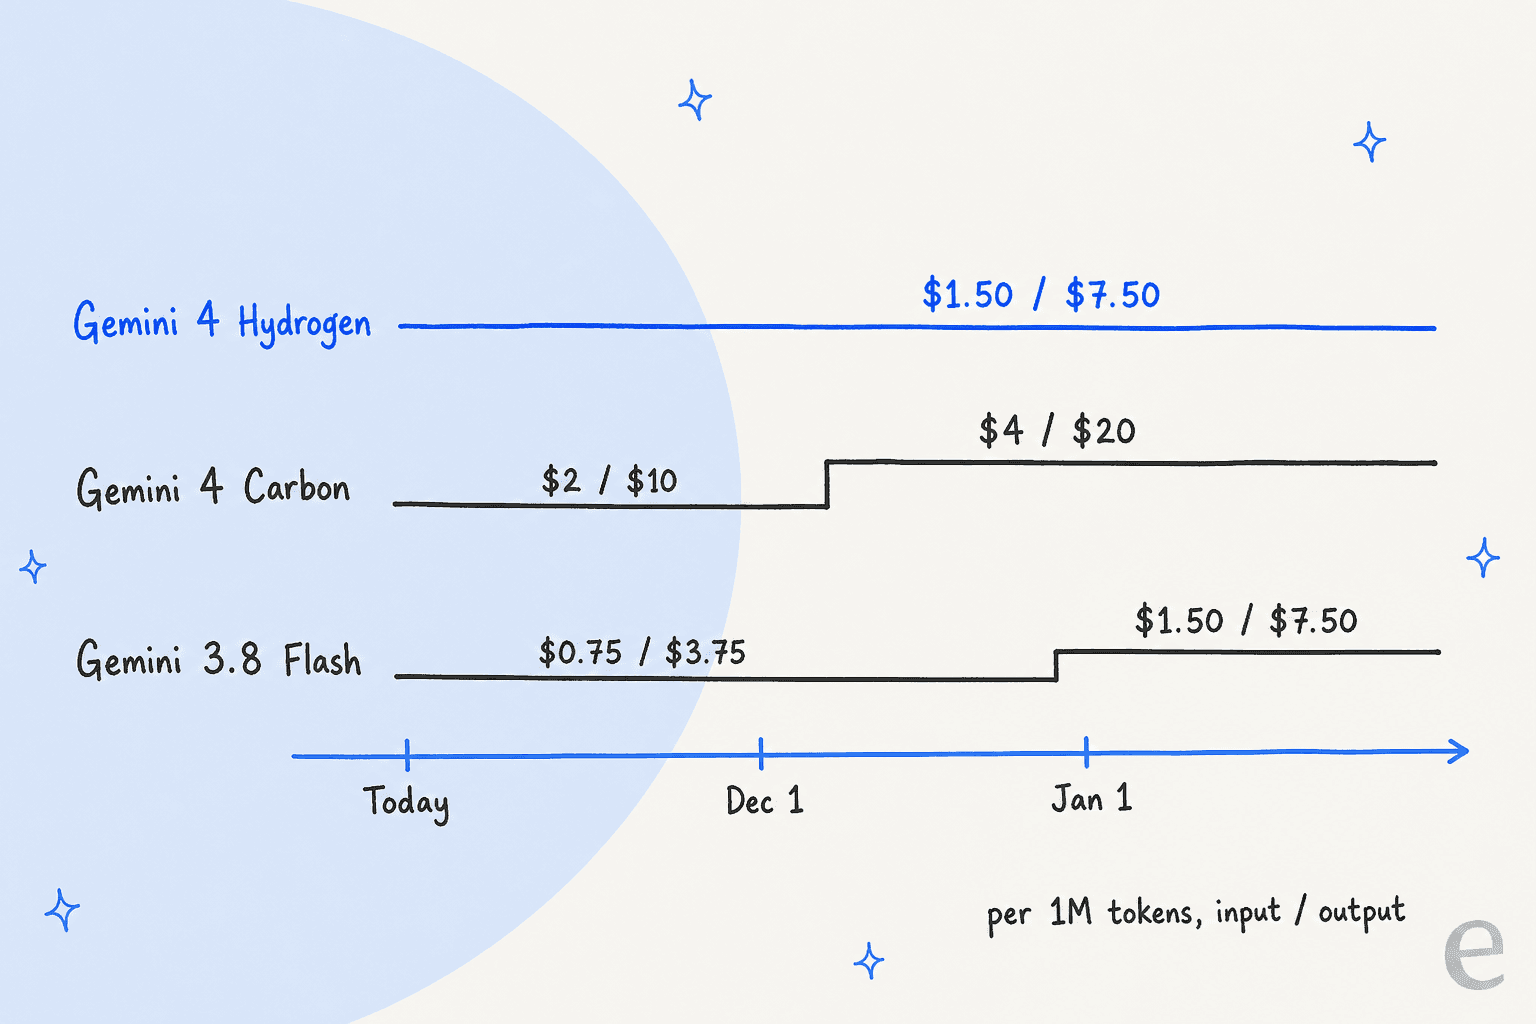
Deux changements de prix de Google arrivent dans les sept prochaines semaines. Gemini 4 Carbon passe de $2/$10 à $4/$20 le 1er décembre 2026, et Gemini 3.8 Flash passe de $0,75/$3,75 à $1,50/$7,50 le 1er janvier 2027, les deux selon la page de tarifs de l'API Gemini. À partir de janvier, Flash et Hydrogen auront le même prix de liste, ce pourquoi Google présente Hydrogen comme la mise à niveau recommandée.
Un utilisateur de Flash dans le fil de lancement avait déjà fait ce calcul :
"If this is Google's strategy we'll have to migrate to Luna, because costs are already high for our workload on 3.8 Flash"
J'entends la même inquiétude chez les équipes de support. Une équipe hardware B2B à qui j'ai parlé s'était fait avoir quand les prix d'un fournisseur d'IA précédent avaient "plus que doublé", et a demandé un contrat annuel juste pour fixer le tarif. Le risque de prix est une vraie raison de garder un second modèle prêt.
Comment j'ai choisi et fixé ces prix
Je construis les intégrations et API qui connectent les agents IA d'eesel aux helpdesks, donc je passe beaucoup de temps à échanger des modèles sous un agent en cours d'exécution. Voici la leçon qui revient sans cesse : un token bon marché peut produire une tâche chère. C'est pourquoi chaque choix ci-dessous est jugé sur :
- Le prix de liste par million de tokens, relevé le 13 novembre 2026 sur la propre page de tarifs de chaque fournisseur.
- Le coût par tâche, le score et le temps par tâche d'Artificial Analysis, qui fait tourner la même suite Intelligence Index sur chaque modèle et enregistre ce que chacun a réellement dépensé, tokens de réflexion inclus. Je note le niveau d'effort entre parenthèses, parce qu'un modèle peut se retrouver n'importe où sur le tableau selon ce réglage.
- Une facture mensuelle pour un acheteur : un agent qui envoie 1 million de requêtes par mois, chacune avec 2 000 tokens en entrée et 300 en sortie. Cela fait 2 milliards de tokens en entrée et 300 millions en sortie, avant mise en cache ou tokens de réflexion. C'est un plancher, pas une prévision.
J'ai aussi lancé une recherche ChatGPT toute fraîche avec la question qu'un développeur taperait. Sa liste restreinte était Claude Sonnet 5.5, GPT-6.1 Terra, GPT-6.1 Sol, Claude Opus 5.5 et DeepSeek, et elle a dit que le chiffre à surveiller est le "coût par tâche réussie". J'ai gardé les cinq, puis ajouté Gemini 4 Carbon, Kimi K3.1 Pro et GPT-6 Luna pour couvrir les options même fournisseur, poids ouverts et budget.
Les alternatives à Gemini 4 Hydrogen comparées
| Modèle | Entrée / sortie par 1M | Entrée en cache | Contexte | Poids ouverts | Score AA (niveau) | Coût AA par tâche | Temps AA par tâche | Facture mensuelle (acheteur exemple) |
|---|---|---|---|---|---|---|---|---|
| Gemini 4 Hydrogen (référence) | $1.50 / $7.50 | $0.075 | 1M | Non | 51 (high) | $1.87 | 8.3 min | $5,250 |
| GPT-6.1 Sol | $2 / $10 | $0.10 | 1.05M | Non | 52 (xhigh) | $0.76 | 9.8 min | $7,000 |
| GPT-6.1 Terra | $1 / $5 | $0.05 | 1.05M | Non | 42 (high) | $0.26 | 4.2 min | $3,500 |
| Claude Sonnet 5.5 | $2 / $10 | $0.10 | 1M | Non | 55 (max) | $10.02 | 33.0 min | $7,000 |
| Claude Opus 5.5 | $4 / $20 | $0.20 | 1M | Non | 48 (medium) | $2.45 | 7.2 min | $14,000 |
| Gemini 4 Carbon | $2 / $10, puis $4 / $20 à partir du 1er déc. | $0.10 | 1M | Non | 58 (medium) | $4.68 | 23.8 min | $7,000, puis $14,000 |
| DeepSeek V4.1 Flash | $0.15 / $0.60 hors pointe | $0.003 | 1M | Oui (MIT) | 33 (max) | $0.60 | 15.1 min | $480 |
| Kimi K3.1 Pro | $2 / $10 | $0.20 | 1M | Oui | 46 | $3.68 | 38.3 min | $7,000 |
| GPT-6 Luna | $0.10 / $0.50 | $0.01 | 1.05M | Non | 28 (max) | $0.15 | 11.6 min | $350 |
Lisez les trois dernières colonnes avant la première. Au prix de liste, Hydrogen semble moins cher que Sol. Par tâche, Sol fait un travail légèrement meilleur pour environ 40% du coût, et dans un temps similaire. Les scores, coûts et temps viennent de la page Artificial Analysis de chaque modèle du 13 novembre 2026.
Combien chacun vous coûterait-il par mois ?
Indiquez combien de tâches d'agent vous exécutez par mois, et choisissez une taille. Le calculateur multiplie par le coût par tâche Artificial Analysis de chaque modèle, il inclut donc les tokens de réflexion que la facture au prix de liste ci-dessus laisse de côté. Les tâches d'AA sont de longs travaux agentiques, traitez donc les totaux comme un moyen de comparer les modèles entre eux, pas comme votre facture exacte.
1. GPT-6.1 Sol
Idéal pour : les développeurs qui veulent un travail de niveau Hydrogen pour moins cher par tâche, et peuvent vivre avec la forme d'API d'OpenAI.
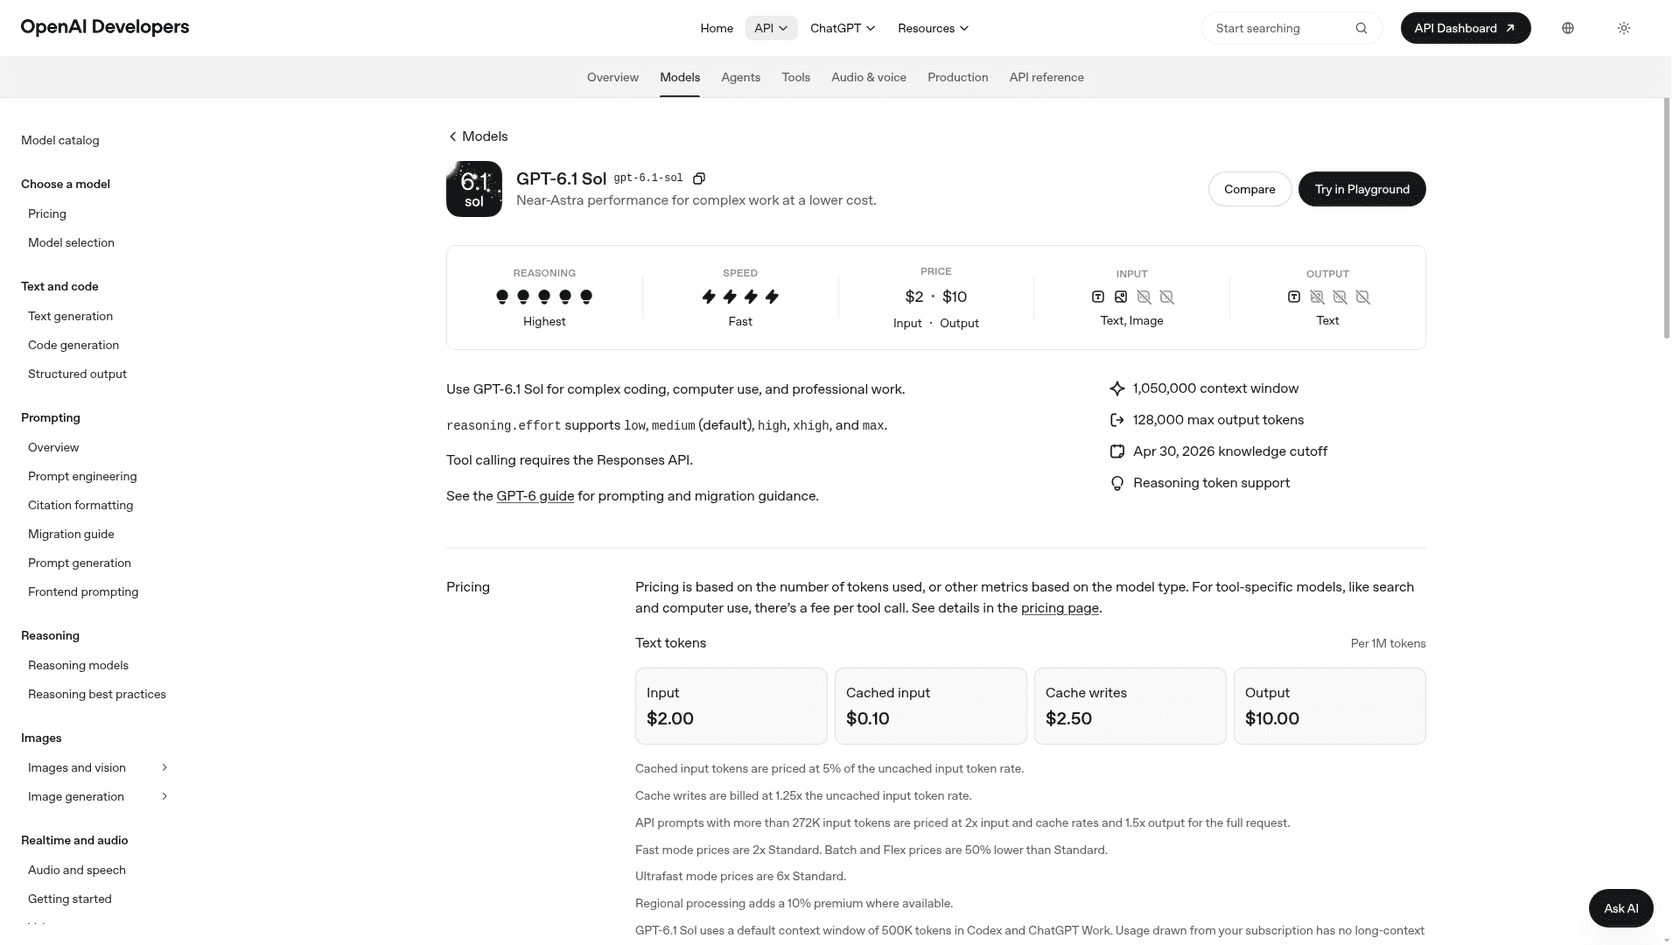
GPT-6.1 Sol est le deuxième échelon d'OpenAI, sous GPT-6 Astra. OpenAI le décrit comme "Near-Astra performance for complex work at a lower cost", et par tâche c'est la chose la plus proche d'une mise à niveau directe depuis Hydrogen sur cette liste.
Avantages
- À xhigh, il obtient
52pour$0,76par tâche en9,8minutes. Hydrogen à high obtient51pour$1,87en8,3minutes. - À max, il obtient
55pour$1,27, moins cher qu'Hydrogen à xhigh (54,$3,16). - Cinq niveaux d'effort, de
lowàmax, vous pouvez donc l'ajuster comme vous ajusteriez le niveau de réflexion d'Hydrogen.
Inconvénients
- Les appels d'outils exigent la Responses API, une intégration pensée pour Gemini a donc besoin d'un vrai travail.
- Pas de niveau gratuit, et les prompts de plus de 272K tokens en entrée coûtent 2x l'entrée et 1,5x la sortie pour toute la requête.
- Sa date limite de connaissances est le 30 avril 2026.
Tarifs : $2 en entrée, $0,10 en cache, $10 en sortie par million de tokens sur la page de tarifs OpenAI. Batch et Flex coûtent la moitié.
Mon avis : si vous alliez mettre Hydrogen sur xhigh, essayez d'abord Sol à xhigh. Par tâche, c'est le chemin le moins cher vers le même score. L'avis sur GPT-6.1 Sol a un test pratique sur un ticket de support.
2. GPT-6.1 Terra
Idéal pour : le travail rapide et bon marché là où Hydrogen en low ou medium est déjà suffisant.
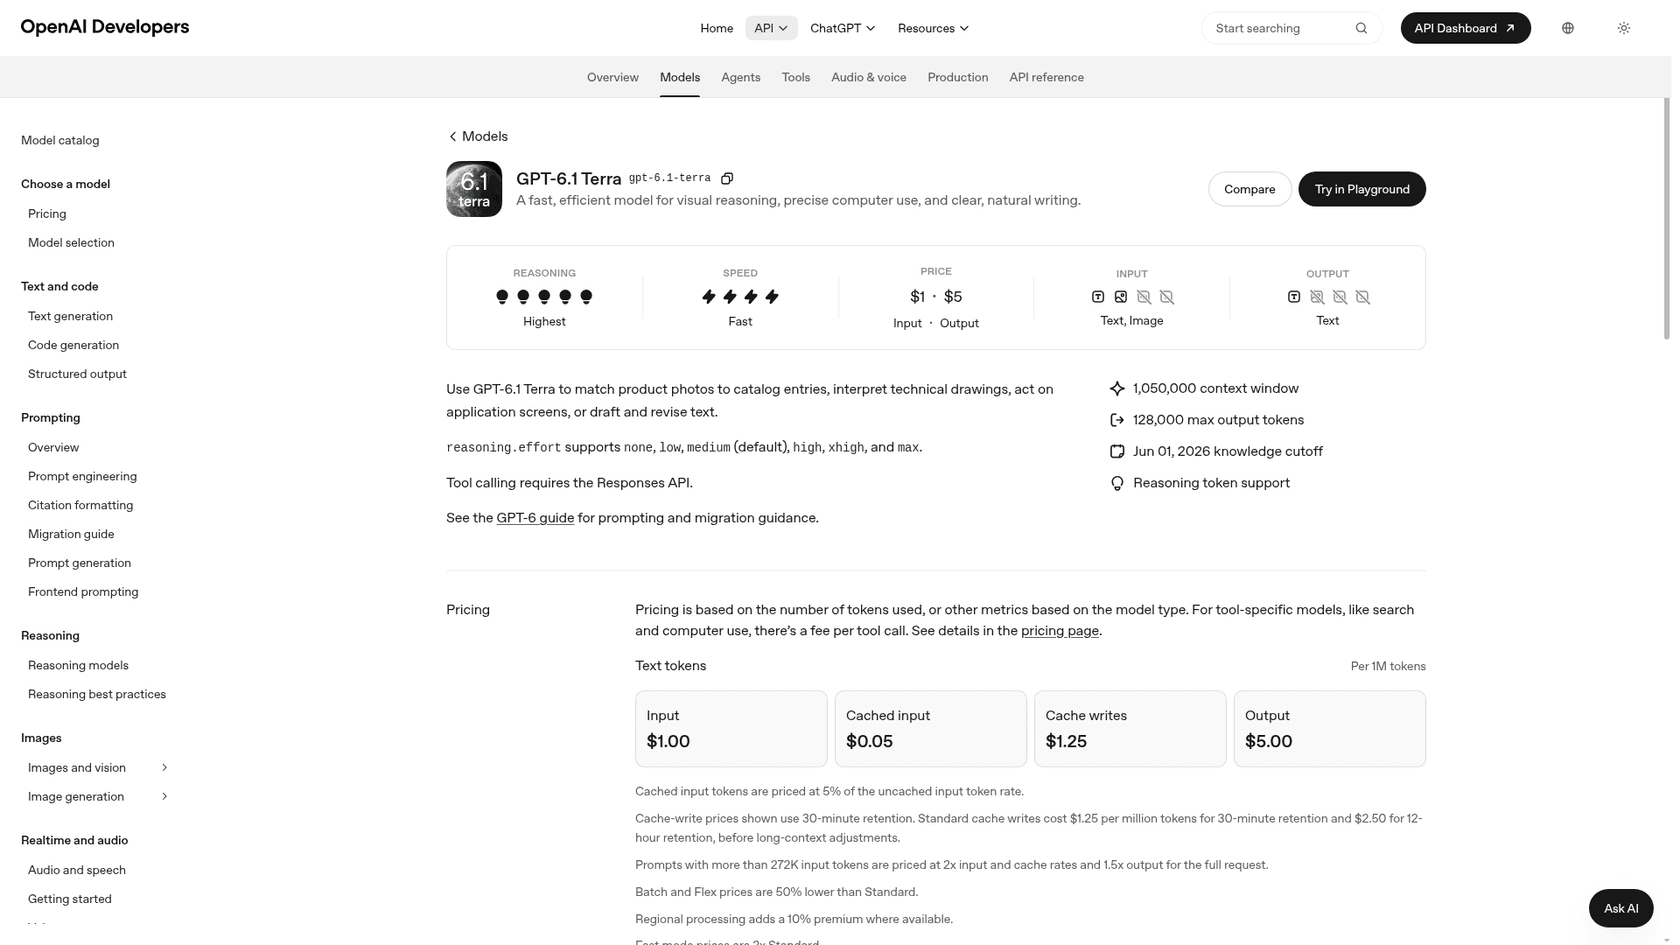
GPT-6.1 Terra est un échelon sous Sol, et c'est le rival le plus direct d'Hydrogen. Google l'a même mis dans son propre tableau comparatif, où Hydrogen le bat sur 8 des 9 lignes partagées.
Avantages
- À high, il obtient
42pour$0,26par tâche en4,2minutes. Hydrogen en medium obtient41pour$0,80en3,7minutes. C'est environ un tiers du coût pour le même score. - Il a un niveau d'effort
nonepour une voie rapide sans réflexion, qu'Hydrogen n'offre pas. - Le prix de liste est un tiers plus bas que celui d'Hydrogen, en entrée comme en sortie.
Inconvénients
- Le tableau de Google place Hydrogen devant sur SWE-sweep (
13,5%contre5,8%) et AutomationBench (76,1%contre60,2%). - Le pousser à max (
51,$0,96,14,2minutes) est plus lent qu'Hydrogen à high. - Même exigence de Responses API pour les appels d'outils que Sol.
Tarifs : $1 en entrée, $0,05 en cache, $5 en sortie par million de tokens, selon la page de tarifs OpenAI.
Mon avis : l'échange pour un trafic à fort volume et difficulté moyenne. Pour les tâches difficiles, montez vers Sol plutôt que de pousser Terra au maximum. L'avis sur GPT-6.1 Terra montre comment il s'est comporté sur de vrais tickets.
3. Claude Sonnet 5.5
Idéal pour : les agents de code, le travail en terminal et l'utilisation d'ordinateur.
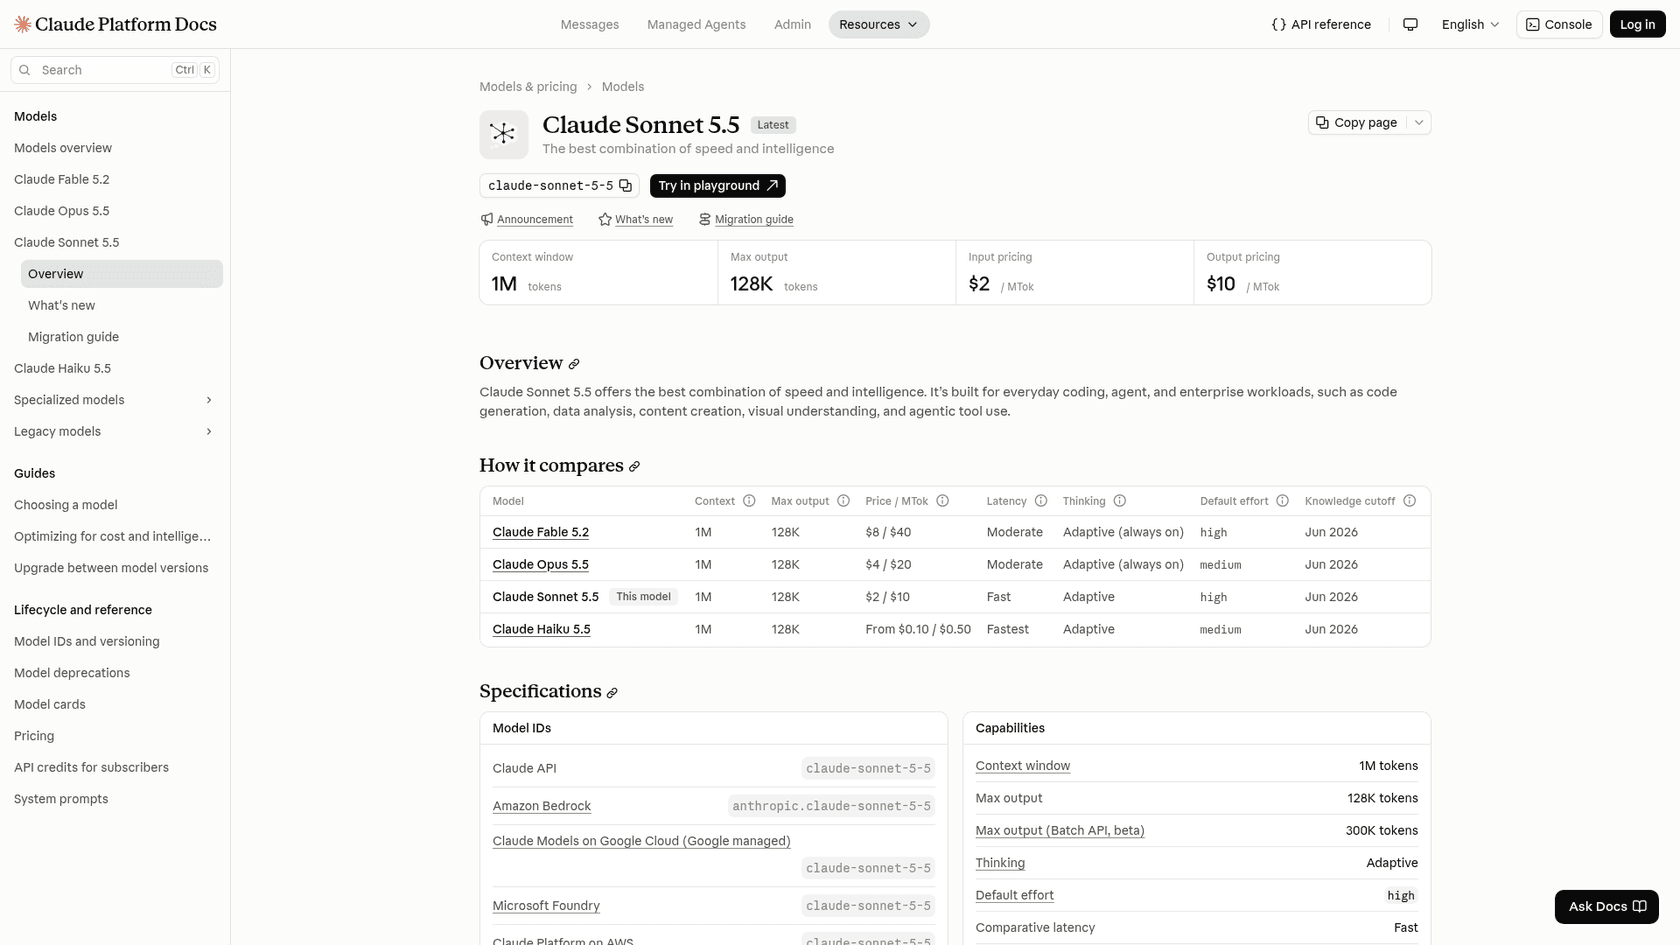
Claude Sonnet 5.5 est le modèle intermédiaire d'Anthropic, qu'Anthropic appelle "the best combination of speed and intelligence". ChatGPT l'a classé meilleure alternative à Hydrogen, et les propres chiffres de Google expliquent pourquoi il est dans la conversation.
Avantages
- Il bat Hydrogen sur les deux lignes agent qui comptent le plus pour les outils de code : Terminal-Bench 4.1 (
63,9%contre57,0%) et OSWorld-2.1 (83,9%contre77,6%), selon la fiche modèle de Google. - À max, il obtient
55, au-dessus du meilleur score d'Hydrogen (54à xhigh). - Prix plat sur toute la fenêtre de 1M, et lectures de cache à
$0,10.
Inconvénients
- À max, il coûte
$10,02par tâche et prend33minutes sur Artificial Analysis. En medium, il tombe à$0,78, mais le score tombe à31. - Hydrogen gagne les lignes SWE-sweep (
13,5%contre3,1%) et HLE-Diamond (58,8%contre53,3%) de Google. - API stricte : un
temperaturenon par défaut et untool_choiceforcé renvoient tous les deux une erreur, couvert dans l'avis sur Sonnet 5.5.
Tarifs : $2 en entrée, $0,10 lecture en cache, $10 en sortie par million de tokens sur la page de tarifs Anthropic. Batch divise par deux.
Mon avis : choisissez-le quand l'agent écrit du code ou pilote un ordinateur. Pour le travail de connaissance générale, Hydrogen est le meilleur achat, ce qui correspond à ce qu'a conclu le fil HN.
4. Claude Opus 5.5
Idéal pour : les agents de longue durée où bien faire les choses compte plus que la facture.
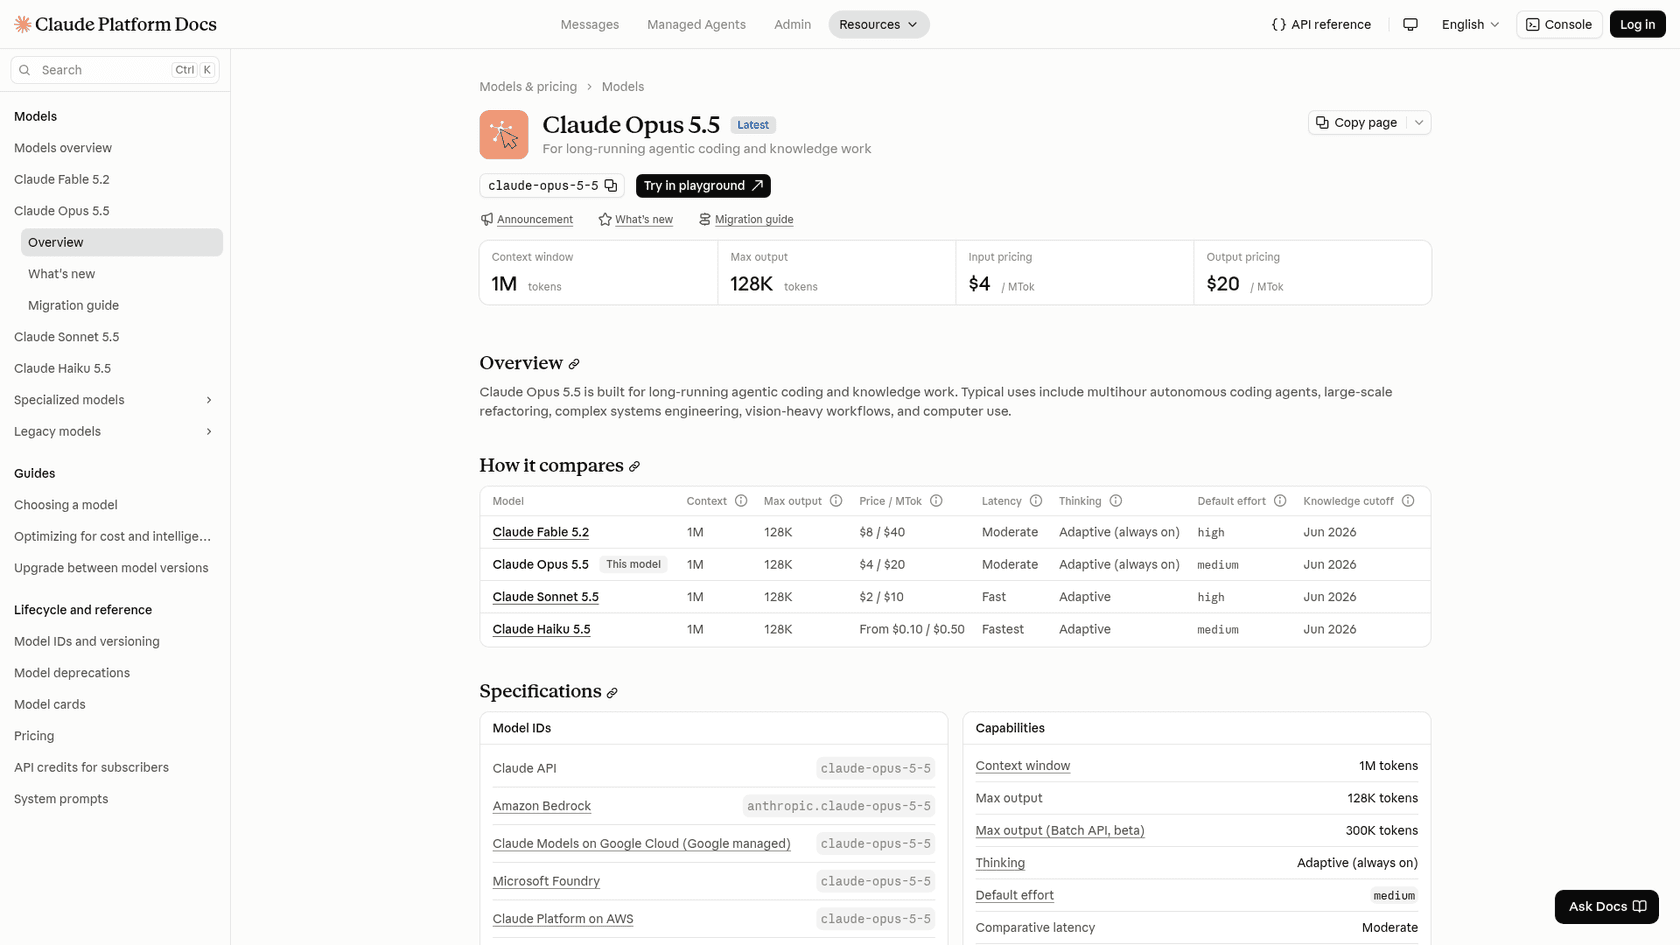
Claude Opus 5.5 est le grand modèle d'Anthropic, construit "for long-running agentic coding and knowledge work". C'est ici le choix le plus cher par token, il appartient donc à cette liste comme cible d'escalade, pas comme choix par défaut.
Avantages
- À max, il obtient
59sur Artificial Analysis, le deuxième meilleur score de cette comparaison après Carbon à high. - En medium, son niveau par défaut, il obtient
48pour$2,45en7,2minutes. - Les lectures de cache coûtent
$0,20, seulement 5% du prix d'entrée, ce qui aide les agents qui renvoient un long prompt système.
Inconvénients
- Prix de liste de
$4/$20, donc la facture exemple est de$14 000, presque 3 fois celle d'Hydrogen. - À max,
$10,04par tâche et25,2minutes. - La réflexion est toujours activée, ce qu'Anthropic liste comme "Adaptive (always on)", et elle est facturée comme de la sortie.
Tarifs : $4 en entrée, $0,20 lecture en cache, $20 en sortie par million de tokens sur la page de tarifs Anthropic. Le mode Fast est à $8/$40.
Mon avis : un planificateur, pas un exécutant. Laissez Opus planifier ou réviser, et laissez quelque chose de moins cher faire les étapes. L'avis sur Opus 5.5 a les chiffres par niveau d'effort.
5. Gemini 4 Carbon
Idéal pour : les équipes qui restent chez Google et ont besoin de plus de raisonnement qu'Hydrogen n'en donne.
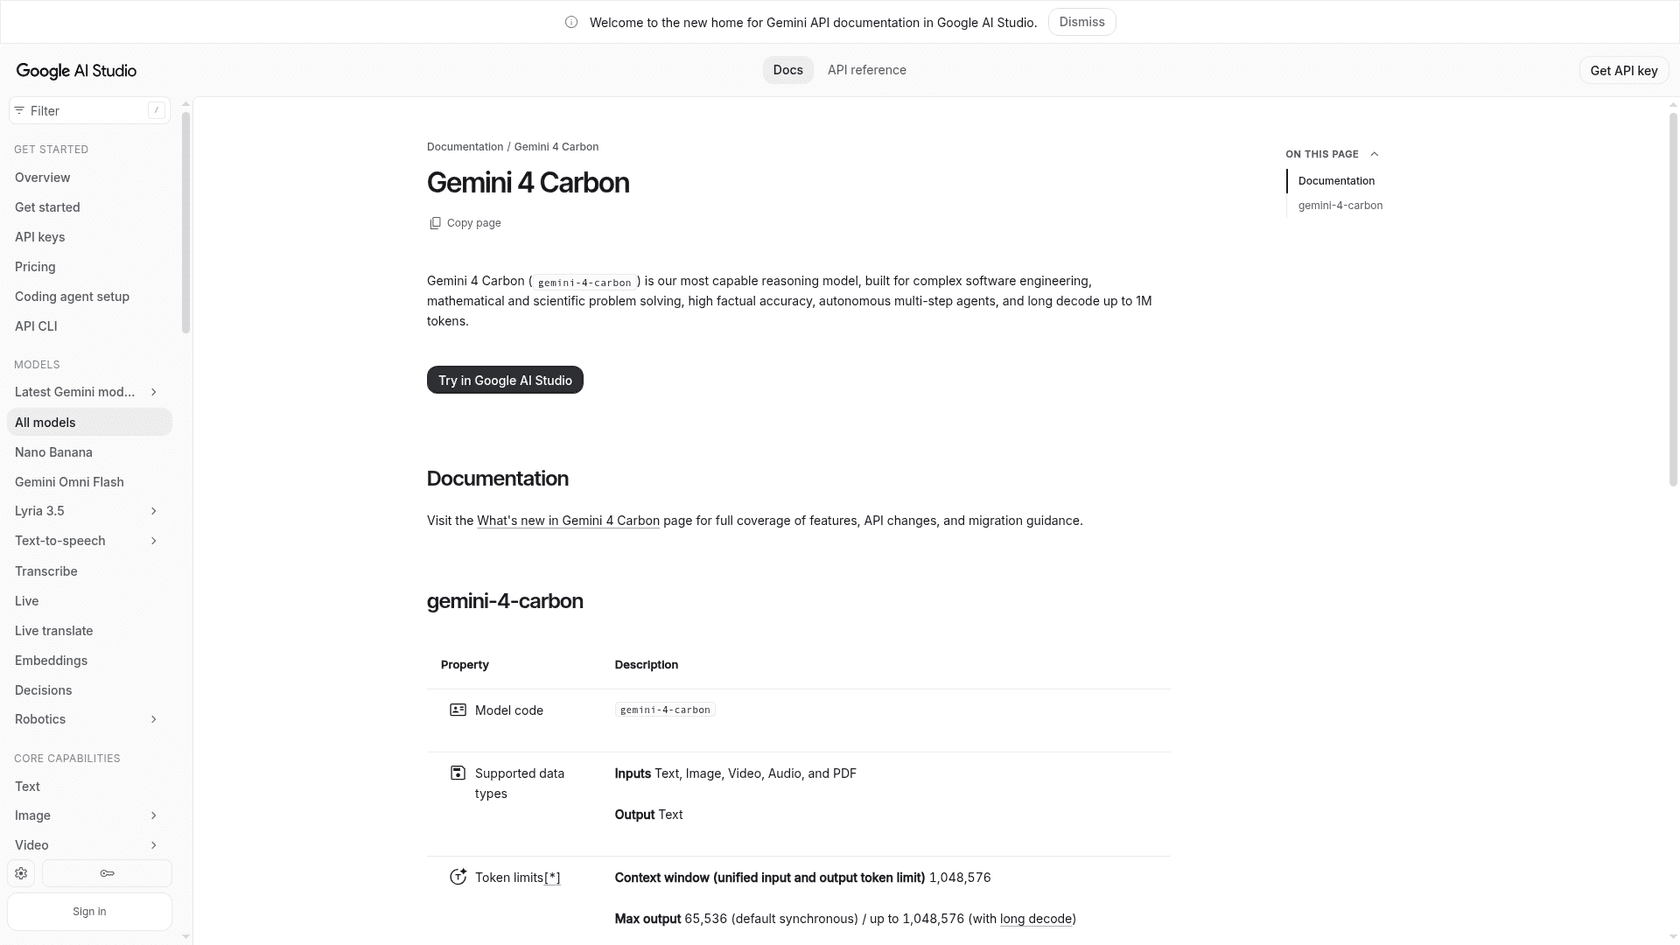
Gemini 4 Carbon est le grand frère d'Hydrogen et a atteint la disponibilité générale le 10 novembre 2026. Même API et mêmes entrées, c'est donc le changement qui demande le moins de travail de toute la liste.
Avantages
- En medium, il obtient
58sur Artificial Analysis, et60à high, le meilleur score de cette comparaison. - Vous gardez le SDK Gemini, le Search grounding et les entrées multimodales que vous avez déjà construites.
- L'Orchestrator dans Antigravity de Google associe Carbon pour la planification à Hydrogen pour l'exécution, ce qui montre la répartition prévue.
Inconvénients
$4,68par tâche en medium,$5,48en high, et de23,8à27,4minutes par tâche.- Le prix double à
$4/$20le 1er décembre 2026, et il n'y a pas de niveau gratuit. - Il est par défaut en medium et plafonne à high, donc pas de xhigh.
Tarifs : $2 en entrée, $0,10 en cache, $10 en sortie par million de tokens jusqu'au 30 novembre 2026, puis $4/$0,20/$20, selon la page de tarifs de l'API Gemini. Plus de détails dans l'avis sur Gemini 4 Carbon.
Mon avis : orientez vos 10% les plus difficiles ici et gardez Hydrogen pour le reste. Tout envoyer à Carbon après le 1er décembre est une grosse facture pour quelques points de score.
6. DeepSeek V4.1 Flash
Idéal pour : la facture la plus basse, et les équipes qui veulent des poids ouverts.
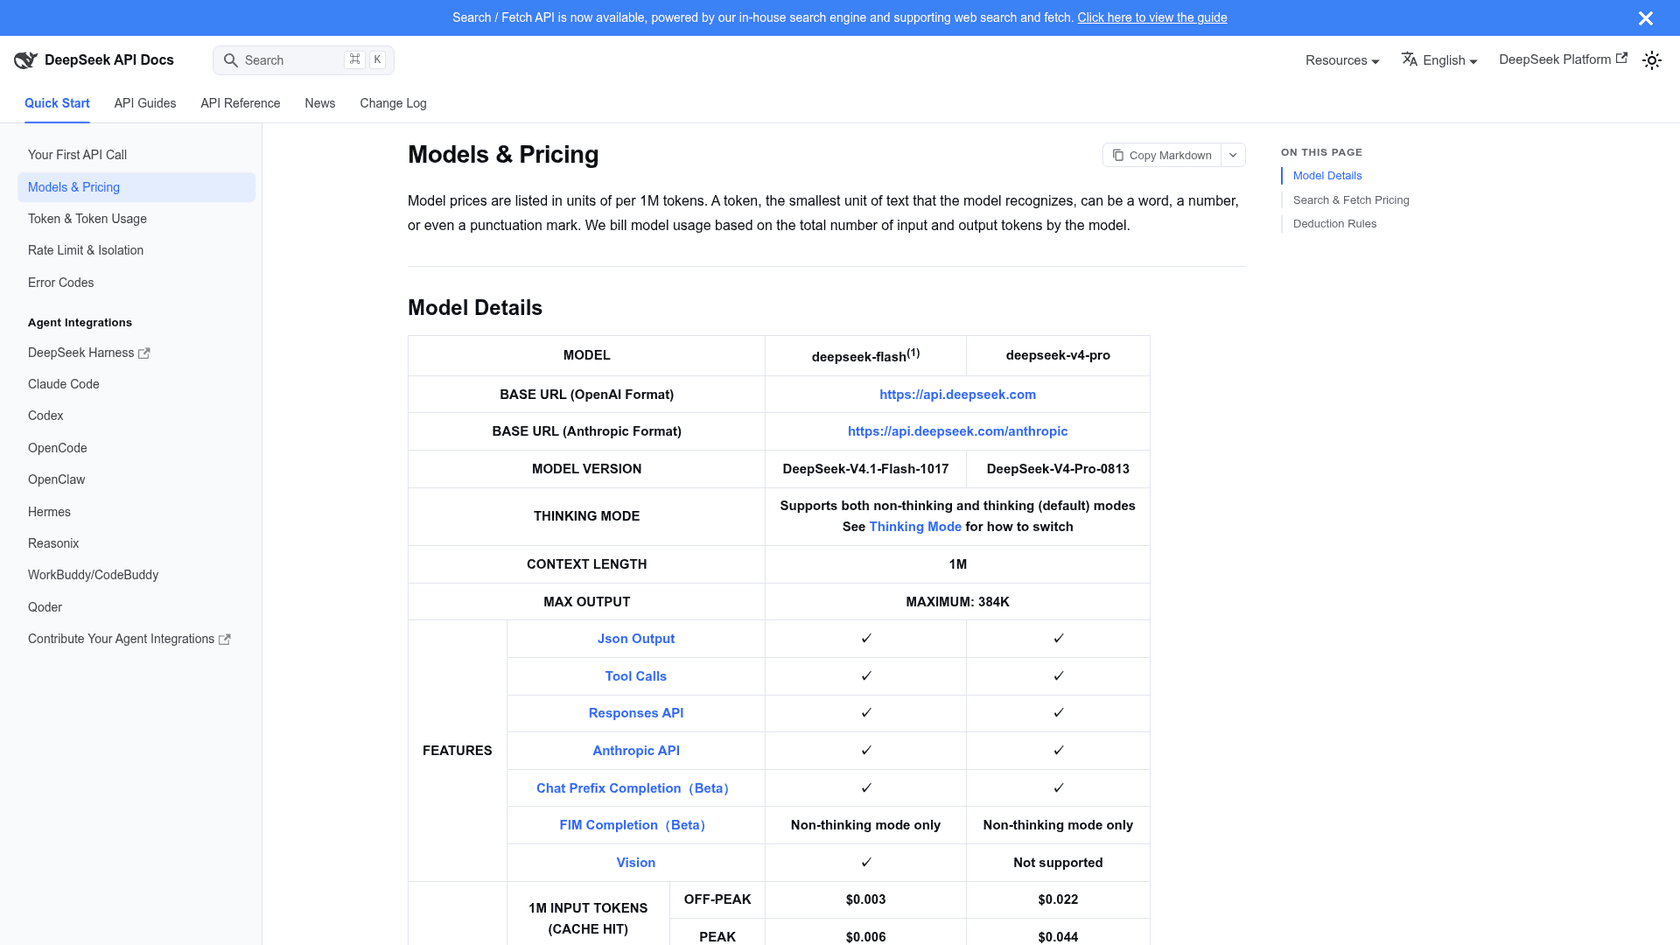
DeepSeek V4.1 Flash est appelé deepseek-flash sur l'API de DeepSeek, et l'ancien nom deepseek-v4-flash redirige désormais vers lui aussi. C'est le seul modèle ici qui coûte moins d'un dixième du prix de liste d'Hydrogen.
Avantages
$0,15/$0,60par million de tokens hors pointe, donc la facture exemple est de$480contre$5 250pour Hydrogen.- Poids sous licence MIT, vous ou un hébergeur pouvez donc le faire tourner hors de Chine.
- Entrée vision, appels d'outils, sortie JSON, et points d'accès au format OpenAI comme au format Anthropic.
Inconvénients
- Il obtient
33à max sur Artificial Analysis, bien en dessous d'Hydrogen en medium (41). - Les heures de pointe (
01:00à04:00et06:00à10:00UTC, en semaine) doublent le prix. - Sur la propre plateforme de DeepSeek, vos données vont à une entreprise basée en Chine, vérifiez donc cela avec vos règles de données d'abord.
Tarifs : $0,15 en entrée, $0,003 en cache touché, $0,60 en sortie par million de tokens hors pointe ; $0,30/$0,006/$1,20 en pointe, selon la page de tarifs DeepSeek.
Les benchmarks ne racontent pas toute l'histoire ici. Un développeur ayant fait des tests d'agents face à face a publié ceci :
"Right now DeepSeek Flash 4.1 Flash has a 64% win rate against GPT 6.1 Sol. Small data still, but it has 33 wins vs. 18 losses"
Mon avis : vaut un test comparatif pour tout travail à fort volume avant de payer les tarifs d'Hydrogen. Le guide des tarifs DeepSeek V4.1 Flash couvre les calculs des heures de pointe.
7. Kimi K3.1 Pro
Idéal pour : les équipes qui ont besoin d'un grand modèle à poids ouverts et peuvent attendre les réponses.
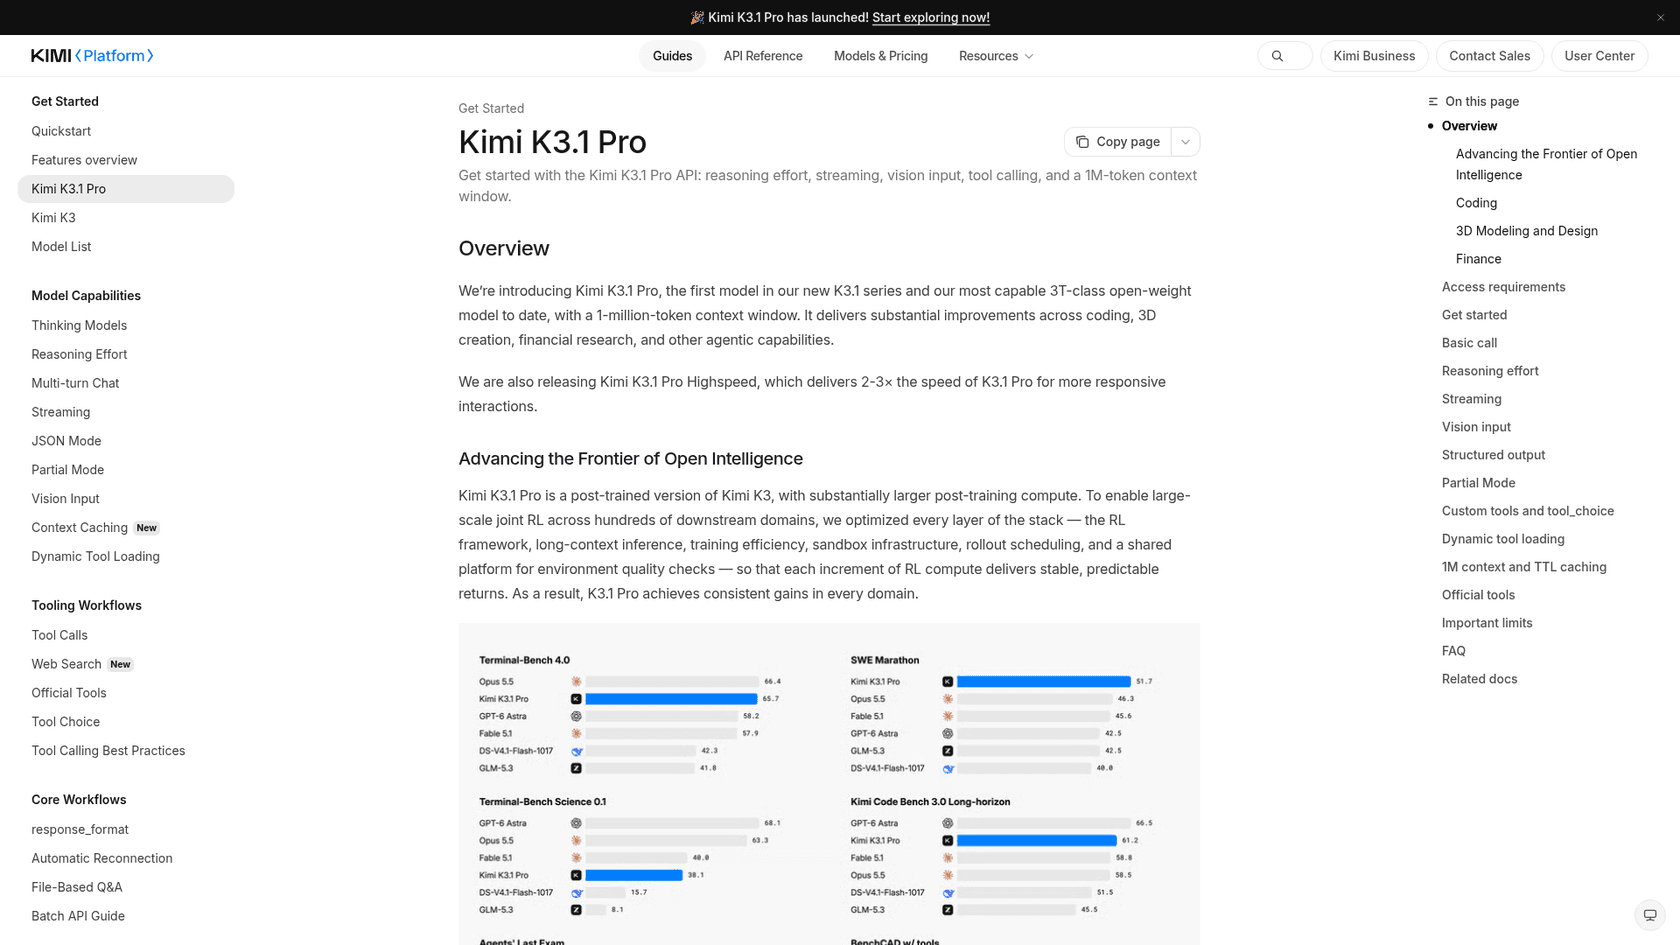
Kimi K3.1 Pro est le vaisseau amiral de Moonshot AI, décrit dans sa documentation comme "our most capable 3T-class open-weight model to date". Ses poids sont désormais sur Hugging Face.
Avantages
- Artificial Analysis le classe premier sur 28 modèles à poids ouverts de sa catégorie de taille, à
46. - Contexte de 1 048 576 tokens, entrée image, et inférence par lots à 60% du prix standard.
- Une version Highspeed (
$4/$20) tourne 2 à 3 fois plus vite, selon Moonshot.
Inconvénients
$3,68par tâche et38,3minutes sur Artificial Analysis, ce qui le marque comme lent et cher pour un modèle à poids ouverts.- AA a mesuré un temps jusqu'au premier token de réponse de
172secondes à environ31tokens par seconde. - Même prix de liste de
$2/$10que Sol, avec un score plus bas.
Tarifs : $2 en entrée, $0,20 en cache touché, $10 en sortie par million de tokens sur la page de tarifs Moonshot.
Mon avis : un choix quand les poids ouverts sont l'exigence, pas une économie par rapport à Hydrogen. Si vous ne voulez que le moins cher, DeepSeek gagne. L'avis sur Kimi K3.1 Pro va plus loin.
8. GPT-6 Luna
Idéal pour : le tri, l'étiquetage et le routage au prix le plus bas possible.
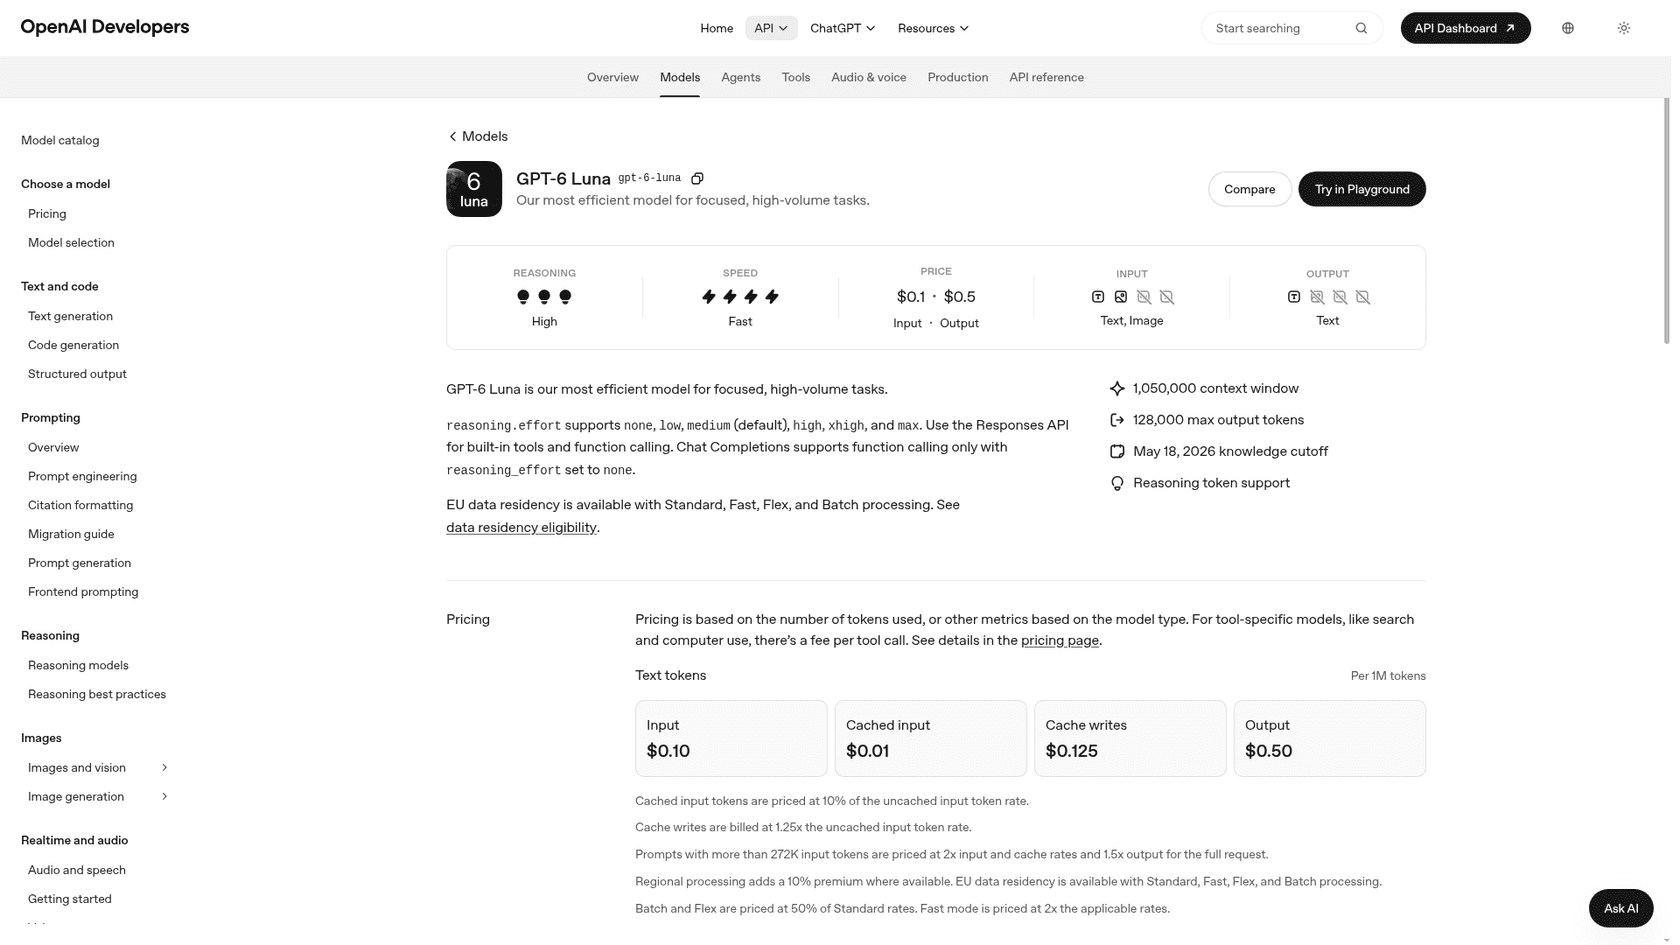
GPT-6 Luna est le plus petit modèle d'OpenAI, "our most efficient model for focused, high-volume tasks". C'est là que les utilisateurs de Gemini 3.8 Flash ont d'abord regardé quand Hydrogen est arrivé au double du prix actuel de Flash.
Avantages
$0,10/$0,50par million de tokens, donc la facture exemple est de$350.$0,15par tâche à l'effort max sur Artificial Analysis, le moins cher de cette liste.- Prend en charge le function calling de Chat Completions quand l'effort est sur
none, ce qui facilite le portage de code de routage simple.
Inconvénients
- Il obtient
28à max, bien en dessous d'Hydrogen même en medium. - Même surcoût de prompt long que les autres modèles OpenAI au-delà de 272K tokens en entrée.
- Pas un modèle pour un travail d'agent à plusieurs étapes à lui seul.
Tarifs : $0,10 en entrée, $0,01 en cache, $0,50 en sortie par million de tokens sur la page de tarifs OpenAI.
Mon avis : la porte d'entrée d'une configuration routée, pas un remplacement complet d'Hydrogen. Laissez-le trier les requêtes et faire remonter les difficiles.
Quelle alternative à Gemini 4 Hydrogen choisir ?
Partez de la raison pour laquelle vous partez, pas du classement. Chaque raison pointe vers un modèle différent :
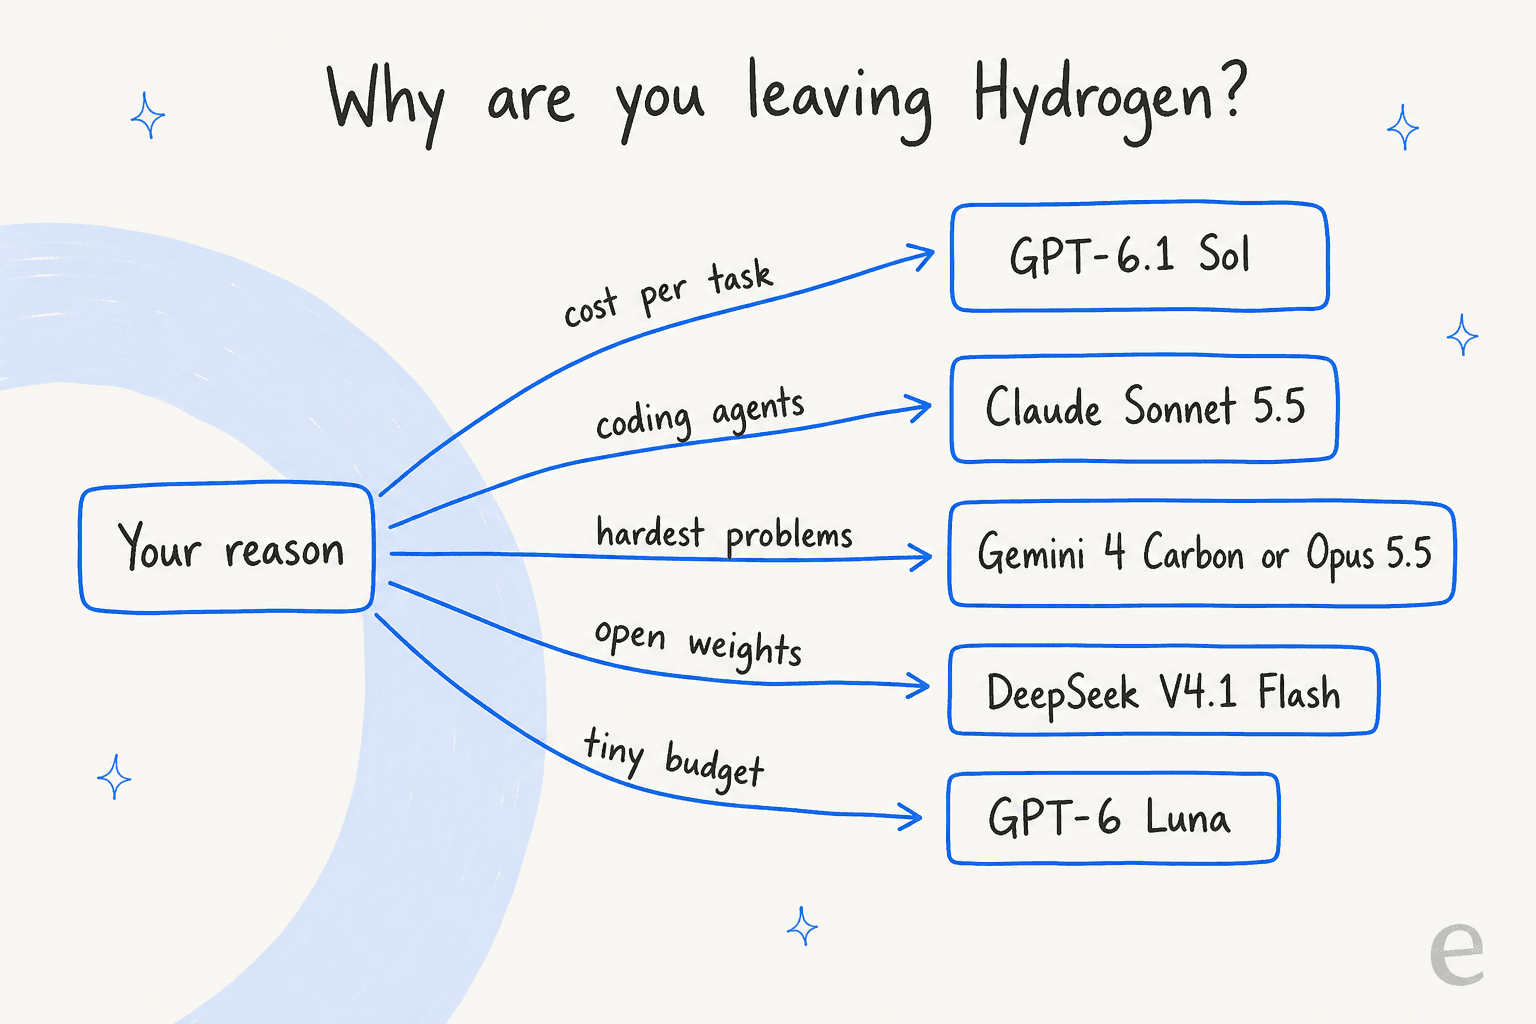
| Si votre raison est... | Choisissez | Pourquoi |
|---|---|---|
| La facture en high ou xhigh | GPT-6.1 Sol | 52 pour $0.76 contre 51 pour $1.87 chez Hydrogen |
| Travail rapide et bon marché de niveau moyen | GPT-6.1 Terra | 42 pour $0.26 contre 41 pour $0.80 chez Hydrogen medium |
| Agents de code ou d'utilisation d'ordinateur | Claude Sonnet 5.5 | Gagne Terminal-Bench 4.1 et OSWorld-2.1 sur le propre tableau de Google |
| Problèmes les plus difficiles, en restant chez Google | Gemini 4 Carbon | 58 en medium, même API |
| Problèmes les plus difficiles, tout fournisseur | Claude Opus 5.5 | 59 à max, prix bas de lecture en cache |
| Facture la plus basse | DeepSeek V4.1 Flash | $480 contre $5,250 sur la facture exemple |
| Poids ouverts haut de gamme | Kimi K3.1 Pro | Meilleur modèle à poids ouverts de sa catégorie sur AA |
| Tri et routage | GPT-6 Luna | $0.15 par tâche |
Vous n'avez pas non plus à en choisir un seul. Un commentateur du fil de lancement a décrit la configuration que je recommanderais pour la plupart des agents :
"I have found it a good subagent workhorse for code implementation, with some higher level model doing the spec and review."
C'est Hydrogen comme exécutant et quelque chose comme Carbon ou Opus comme planificateur, la même répartition que Google a intégrée dans Orchestrator. Si la facture est le problème, échangez l'exécutant contre Sol ou Terra et gardez la structure.
Comment tester une alternative avant de changer ?
Les benchmarks classent les modèles sur les tâches de quelqu'un d'autre. Avant de déplacer du trafic de production, lancez les vôtres :
- Récupérez 50 à 100 requêtes réelles de vos journaux, y compris les gênantes.
- Testez chaque candidat sur deux niveaux d'effort, parce que le niveau fait bouger le coût plus que le modèle.
- Mesurez le coût par tâche réussie, en comptant les nouvelles tentatives, pas le coût par million de tokens.
- Vérifiez les pièges de migration : Hydrogen ignore les réglages d'échantillonnage, Claude rejette un
temperaturenon par défaut, et OpenAI veut la Responses API pour les appels d'outils. Un prompt réglé pour l'un ne se transfère pas sans changement. - Gardez un modèle de secours branché, pour que le prochain changement de prix ou la prochaine panne soit un changement de configuration, pas une réécriture.
Le propre conseil de Google pour Hydrogen dit la même chose : lancez vos évaluations "at all four levels" avant de vous fixer sur un seul.
Si le modèle est pour une file de support
Beaucoup de gens qui comparent des alternatives à Hydrogen construisent en réalité un bot de support. Je passe des années à connecter des agents IA à des helpdesks en direct, et le modèle est rarement ce qui casse en premier ; les règles qui l'entourent, si. Les échecs que je vois sont un bot qui promet quelque chose qu'il ne peut pas faire, ou qui ne transfère pas quand il le devrait. Un modèle plus gros ne corrige pas cela. Des règles claires d'escalade et des réponses ancrées dans votre propre centre d'aide et vos tickets passés, si, et c'est aussi comme ça que vous gardez les hallucinations IA basses, quel que soit le modèle qui écrit les mots.
SE Ranking est un bon exemple de cette couche. L'entreprise fait tourner trois produits sur Zendesk avec un agent eesel par produit, répondant à partir d'environ 16 800 pages de connaissances, et a traité 4 650 conversations en un mois. Remboursements, prolongations d'essai et demandes de parler à une personne vont à l'équipe avec les détails déjà réunis. Swiftreg, un vendeur de plaques d'immatriculation privées, répond à environ 2 100 tickets Zendesk par mois à partir de données de commande en direct, selon des règles écrites par sa propre équipe. Aucune des deux configurations ne dépend du modèle le plus rapide cette semaine.
Si vous préférez travailler depuis un terminal, le CLI eesel contrôle le même coéquipier que le tableau de bord. Un agent de code comme Claude Code peut charger des connaissances approuvées, comme des articles d'aide exportés et des réponses enregistrées, ajuster les instructions de l'agent, et poser des questions de test pour vérifier les réponses avant que quoi que ce soit ne passe en direct. Connecter le helpdesk lui-même a toujours besoin de quelqu'un avec un accès admin pour l'approuver, et des connaissances chargées ne sont pas la même chose que des connaissances testées, donc l'étape de test reste.
Essayer eesel
Hydrogen, Sol et Sonnet sont des moteurs. Si ce que vous construisez est de l'automatisation de support, eesel est le coéquipier helpdesk IA qui fait le travail sur des modèles comme ceux-ci. Il se connecte au helpdesk que vous utilisez déjà, que ce soit Zendesk, Freshdesk ou un autre, apprend de vos tickets passés, de vos macros et de votre centre d'aide, et suit les règles de transfert que vous fixez. Avant de répondre à qui que ce soit, vous pouvez le faire tourner sur vos vrais tickets passés et comparer ses réponses à ce que votre équipe a envoyé.
Le prix est un forfait crédits mensuel fixe : un ticket ou un chat est un crédit, à partir de $299 par mois pour 500 crédits. Il n'y a pas de frais par token, donc votre facture ne bouge pas quand Google ou OpenAI changent les leurs. Vous pouvez essayer eesel gratuitement avec 100 crédits pendant 7 jours sur une partie de votre file.