

Pourquoi j'ai lu ce lancement de près
Je construis des fonctionnalités et des agents IA chez eesel, et une demande revient sans cesse sur notre feuille de route : lire l'image. Dans les appels commerciaux d'eesel cette année, les équipes de support de produits techniques réclamaient toujours une IA capable de lire les images et schémas de leurs PDF et les photos que les clients joignent aux tickets. Une marque DTC de compléments, avec environ 7 000 tickets par mois, nous a dit qu'une partie de ses connaissances produit vivait dans des vidéos Loom que personne n'avait transcrites.
La plupart des modèles de vision gèrent cela en écrivant une légende pour l'image, puis en raisonnant sur la légende. Cela marche jusqu'à ce que le détail qui compte n'ait pas figuré dans la légende. Glimpse est le premier modèle que je vois conçu précisément pour corriger cela, alors j'ai parcouru le billet de lancement, la fiche du modèle chez Together AI, les conditions de la plateforme et les réactions du jour du lancement. Voici ce qui tient et ce qui mérite une note de bas de page.
Qu'est-ce qu'Elorian Glimpse ?
Glimpse est ce qu'Elorian appelle "a new category of visual thinking model: a system that reasons about the physical world from what it sees." En termes simples, c'est un modèle de raisonnement multimodal réglé pour les tâches où la réponse est dans l'image et difficile à mettre en mots : à quelle vitesse quelque chose bouge, si un plan est un seul panoramique continu ou deux coupes, combien de ces objets sont réellement ouverts.
L'entreprise derrière est petite et bien soutenue. Elorian dit avoir 55 millions de dollars de financement auprès de Striker Ventures, Menlo Ventures et Altimeter, avec NVIDIA et Jeff Dean parmi les autres soutiens. Le cofondateur et PDG Andrew Dai a passé près de 12 ans chez Google Brain et DeepMind. Elorian dit avoir construit Glimpse "as a small team with only a few hundred GPUs, post-trained on an open weights base model."
Voici la fiche technique, avec les manques signalés :
| Caractéristique | Elorian Glimpse |
|---|---|
| Sortie | 16 octobre 2026 (Together indique le 15 octobre) |
| Statut | Préversion de recherche |
| Entrées | Texte, image, vidéo |
| Sortie | Texte |
| Modèle de base | Un modèle à poids ouverts non nommé, post-entraîné par Elorian |
| Poids | Non publiés |
| Prix (API Elorian) | $0.60 / 1M en entrée, $3.00 / 1M en sortie, sans cache |
| Fenêtre de contexte, limites de débit | Non publiées |
| Accès | Chat gratuit, API Elorian, déploiement dédié chez Together AI |
| Benchmarks indépendants | Aucun pour l'instant (absent d'Artificial Analysis) |
La page de Together AI le classe aussi sous Chat, Reasoning, Vision et Video, et affiche Dedicated comme seul type de déploiement. Cela compte pour le budget, j'y reviens.
Comment fonctionne la "pensée visuelle" ?
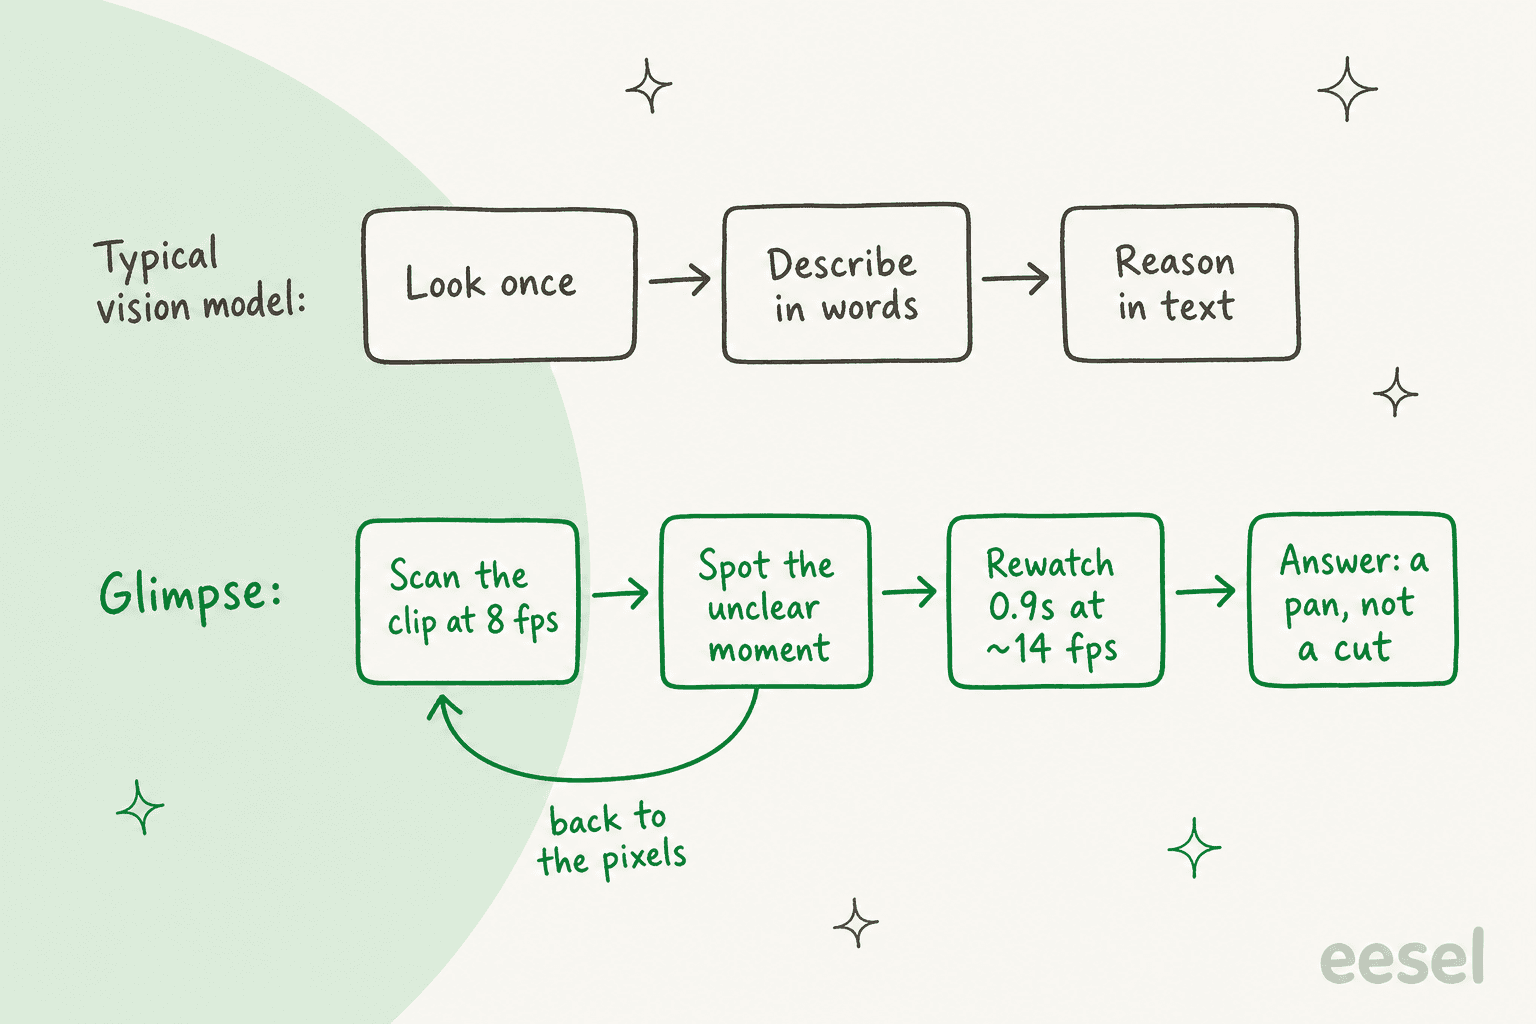
L'argument d'Elorian est que les modèles de vision actuels raisonnent en deux temps : d'abord traduire l'image en langage, puis raisonner en texte. "No matter how advanced the subsequent reasoning, this chain is fragile", dit sa page d'accueil, parce qu'une grande part du détail visuel ne se décrit ni précisément ni brièvement.
Glimpse fait entrer l'image dans le raisonnement lui-même. Il "can reason in visual space, revisiting and refining internal visual representations as thinking unfolds." Concrètement, le billet de lancement montre trois gestes que le modèle fait en pleine réponse : zoomer dans une région, revoir un court intervalle à une cadence d'images plus dense et suivre un élément dans le temps.
Le meilleur exemple est un clip de deux oiseaux qui quittent une poignée de porte pendant que la caméra pivote. Pour déterminer si le plan coupe ou panoramique, Glimpse cartographie d'abord les 6,13 secondes entières à 8 images par seconde, puis revoit la fenêtre de 0,9 seconde qui décide de la réponse à environ 14 images par seconde. Le regard supplémentaire ne va que là où la réponse est incertaine, et c'est toute l'idée.
Deux autres choix de conception méritent d'être connus :
- L'usage d'outils est entraîné. Selon la fiche du modèle chez Together, Glimpse est "trained end to end to use multimodal tools that write code, transform images, and watch videos." C'est proche dans l'esprit de la vision agentique de Gemini, où le modèle recadre des images et exécute du code dessus.
- Il peut répartir le travail entre des sous-agents. Glimpse "can spawn and coordinate subagents that exchange text, visual artifacts, and internal representations." Faire circuler des artefacts visuels entre agents, et pas seulement des résumés texte, est la partie inhabituelle. Si vous avez utilisé des sous-agents dans Claude Code, imaginez le même schéma avec des images dans la transmission.
L'interface de chat rend tout cela visible. Pendant que vous lui parlez, la plateforme affiche ce qu'Elorian appelle le "visual scratch space" : les zooms, les revisionnages et les éléments suivis, en direct.
Là où il devient précis : compter
Compter paraît trivial jusqu'à ce qu'on ajoute des objets qui se ressemblent. L'exemple d'Elorian demande "How many open pliers are there?" sur une photo qui contient aussi des pinces fermées et des ciseaux. La bonne réponse, selon la référence relue d'Elorian, est quatre. Les pinces fermées sont le bon outil dans le mauvais état, et les ciseaux ont deux poignées et une charnière mais sont un autre outil.
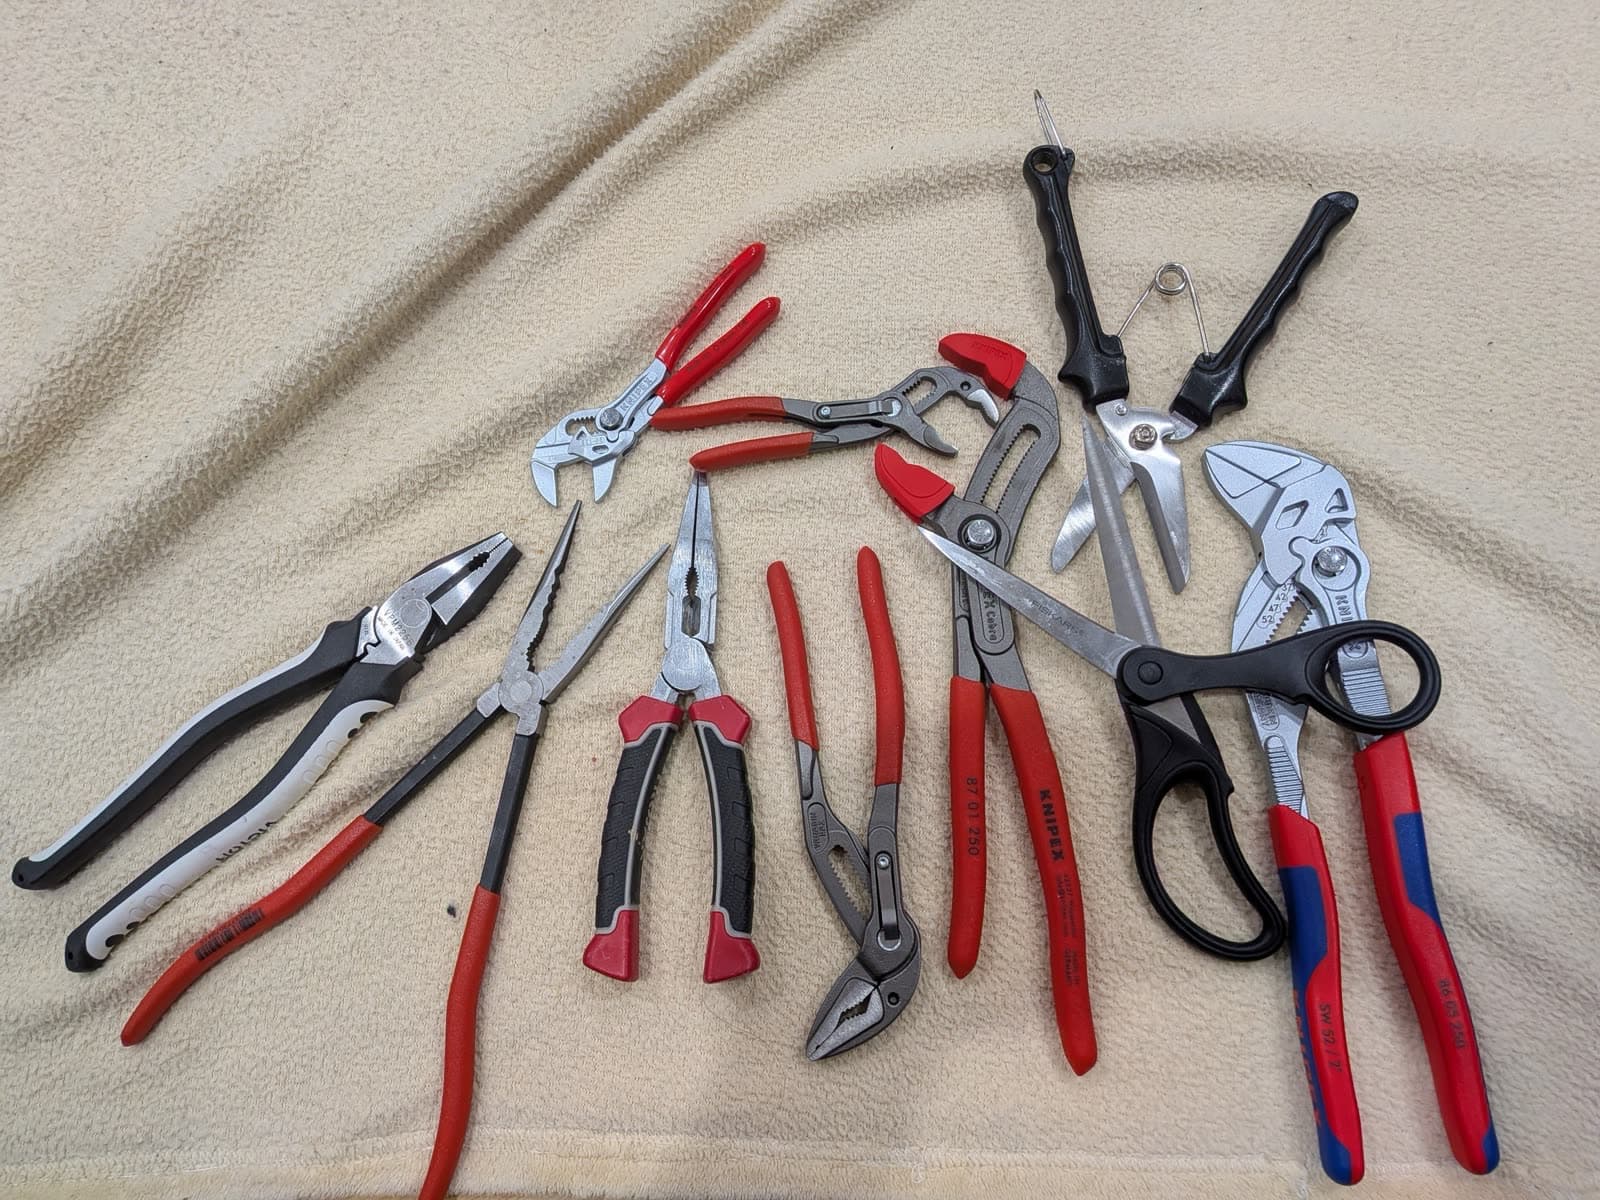
Une remarque honnête : Elorian présente celui-ci comme une réponse de référence relue, "not a recorded model trace." Les traces enregistrées dans le billet sont les clips du train et des oiseaux, les images du robot et le comptage sur le chantier. Cette distinction passe facilement inaperçue et mérite d'être gardée en tête quand vous partagez les démos.
Quel est vraiment le niveau de Glimpse ?
Tous les chiffres ci-dessous viennent d'Elorian, obtenus avec l'effort de réflexion maximal et l'environnement d'outils natif de chaque modèle. Personne d'indépendant ne l'a encore testé : il n'y a pas de page Artificial Analysis pour Glimpse au 19 octobre. Avec cette réserve, voici le tableau du lancement.
| Test | Ce qu'il mesure | Glimpse | GPT-6 Astra | GPT-6.1 Sol | Opus 5.5 | Gemini 3.8 Flash |
|---|---|---|---|---|---|---|
| WGO Bench | Événements de manipulation robotique | 42.70 | 39.42 | 38.91 | 12.34 | 33.99 |
| ERQA | Raisonnement spatial incarné | 83.75 | 83.75 | 82.45 | 82.20 | 81.20 |
| BabyVision | Raisonnement visuel fin | 95.36 | 97.68 | 97.16 | n/a | 83.25 |
| HSS | Compréhension de scènes, image + vidéo | 46.36 | 53.6 | 46.6 | 49.81 | 41.6 |
| CharXiv-R | Raisonnement sur graphiques scientifiques | 92.90 | 92.10 | 92.60 | 93.40 | 91.80 |
| UGC-VideoCap | Légendes de vidéos courtes | 82.66 | 80.32 | 80.41 | 76.35 | 78.33 |
| DREAM-1K | Légendes vidéo denses | 76.04 | 79.05 | 77.93 | 72.05 | 70.00 |
| TOMATO | Raisonnement temporel fin | 93.60 | 96.02 | 89.02 | 72.44 | 83.02 |
| Video-MME v2 | Questions sur vidéo avec sous-titres | 56.68 | 64.06 | 65.27 | n/a | 59.58 |
| E.T. Bench | Compréhension d'événements | 63.55 | n/a | 59.79 | n/a | 63.45 |
| FSC-147 | Comptage à vocabulaire ouvert | 83.36 | 82.02 | 82.69 | 73.78 | 67.06 |
| CountQA | Comptage sur images de produits | 82.66 | 86.42 | 86.42 | 82.20 | 81.09 |
Le gras marque le meilleur score de chaque ligne. En le lisant face à GPT-6 Astra, un schéma apparaît :
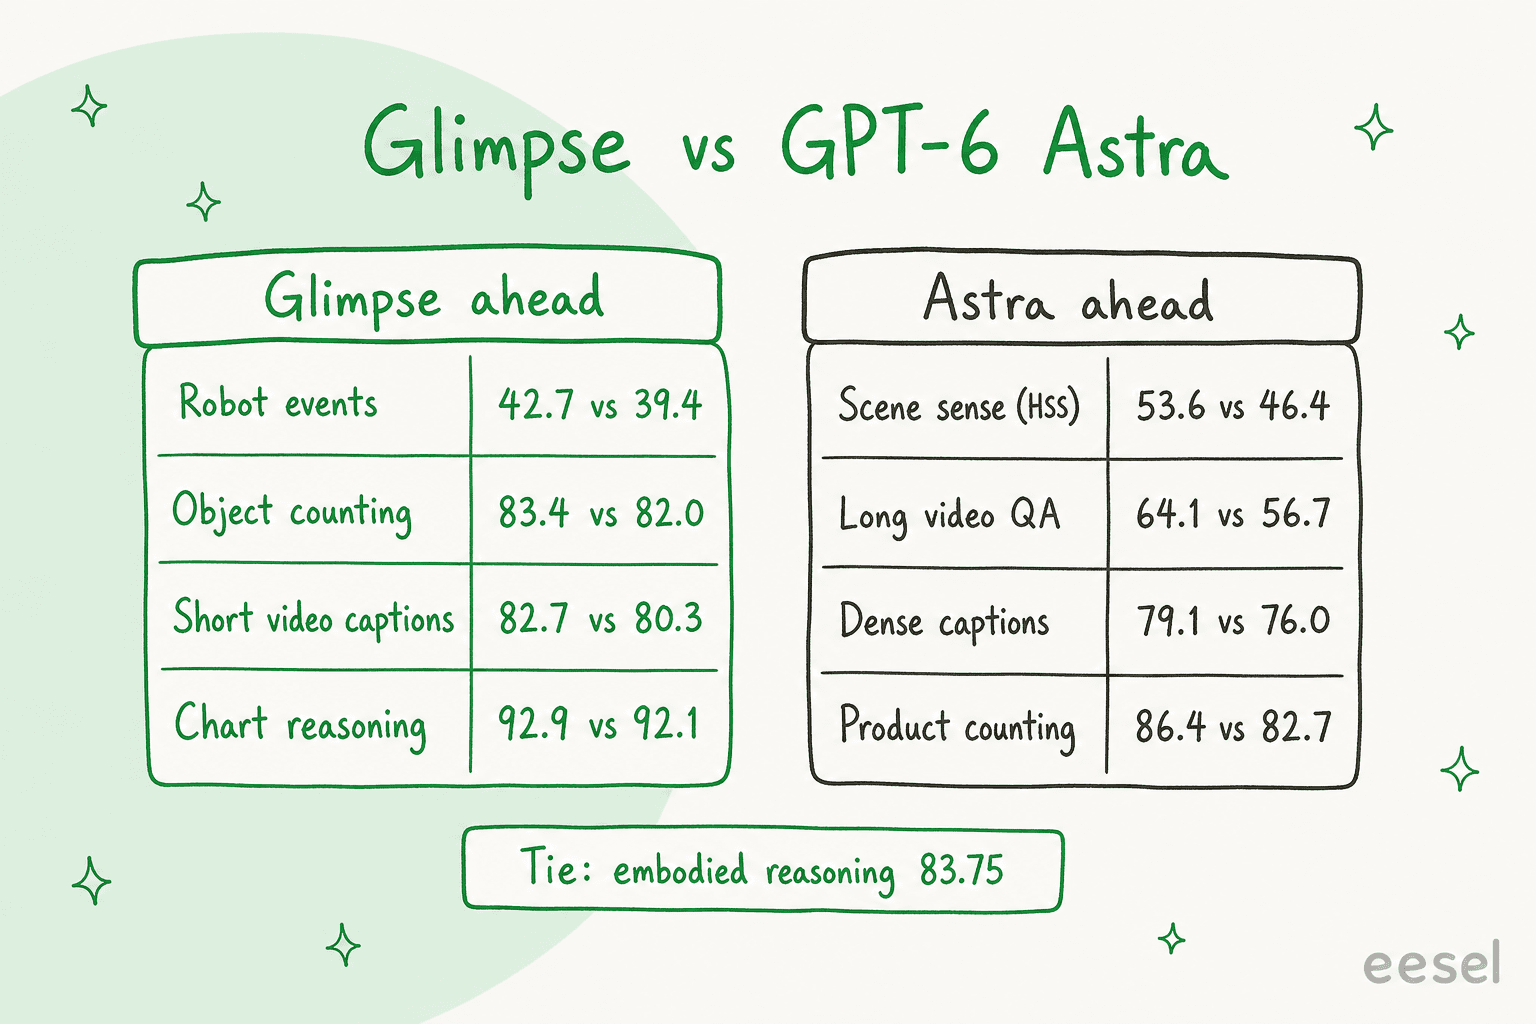
Les victoires de Glimpse sont petites (0,8 point sur le raisonnement sur graphiques, 1,3 sur le comptage) et ses défaites plus grandes (7,2 points sur HSS, 7,4 sur Video-MME v2). Le titre honnête n'est donc pas "bat Astra". C'est proche d'Astra sur la plupart des tests visuels pour environ un seizième du prix. C'est tout de même important, et c'est ainsi qu'Elorian le formule elle-même : "frontier-level performance at the level of (and sometimes exceeding)" Astra et Claude Opus 5.5.
Il bat aussi nettement la gamme économique. Face à Gemini 3.8 Flash, son rival le plus proche en prix, Glimpse gagne 11 des 12 lignes, et sur WGO Bench il obtient 42.70 contre 33.99.
Un mot sur le benchmark HSS
HSS, abréviation de Humanity's Sixth Sense, est un nouveau test qu'Elorian a construit avec Scale AI. Il compte 522 questions ouvertes (288 images et 234 clips vidéo) sur ce qu'une scène suggère sans le montrer : de quel côté souffle le vent, si un livre tiendrait sur une étagère, si les gens sont des visiteurs ou de l'équipe. Une réponse ne compte que si elle remplit chaque point d'une grille écrite par des humains.
Les humains obtiennent 93,1. Le meilleur modèle du classement d'Elorian, GPT 6 Astra, obtient 53,6, et Glimpse 46,36. Deux choses sont à garder en tête ensemble : c'est un benchmark utile parce qu'il vise une vraie lacune, et c'est le benchmark d'Elorian lui-même, donc traitez-le comme n'importe quel test conçu par un fournisseur. Bravo à Elorian de publier un test que son propre modèle ne gagne pas. Que Scale AI soit partenaire donne un peu plus de poids au jeu de questions.
Combien coûte Elorian Glimpse ?
La grille tarifaire est courte, car Elorian n'en a publié qu'une ligne :
| Voie | Entrée | Sortie | Notes |
|---|---|---|---|
| API Elorian | $0.60 / 1M de tokens | $3.00 / 1M de tokens | Sans cache ; aucun prix publié pour le cache, le batch ou les paliers de contexte |
| Chat Elorian | Gratuit | Gratuit | Connexion avec Google ou e-mail ; Wall St Engine a signalé une liste d'attente au lancement |
| Together AI | Contacter les ventes | Contacter les ventes | Déploiement dédié uniquement, pas de tarif serverless par token |
| Entreprise | Contacter les ventes | Contacter les ventes | Via l'équipe commerciale d'Elorian |
Pour situer, voici comment le tableau de lancement d'Elorian aligne les prix de sortie des modèles comparés :
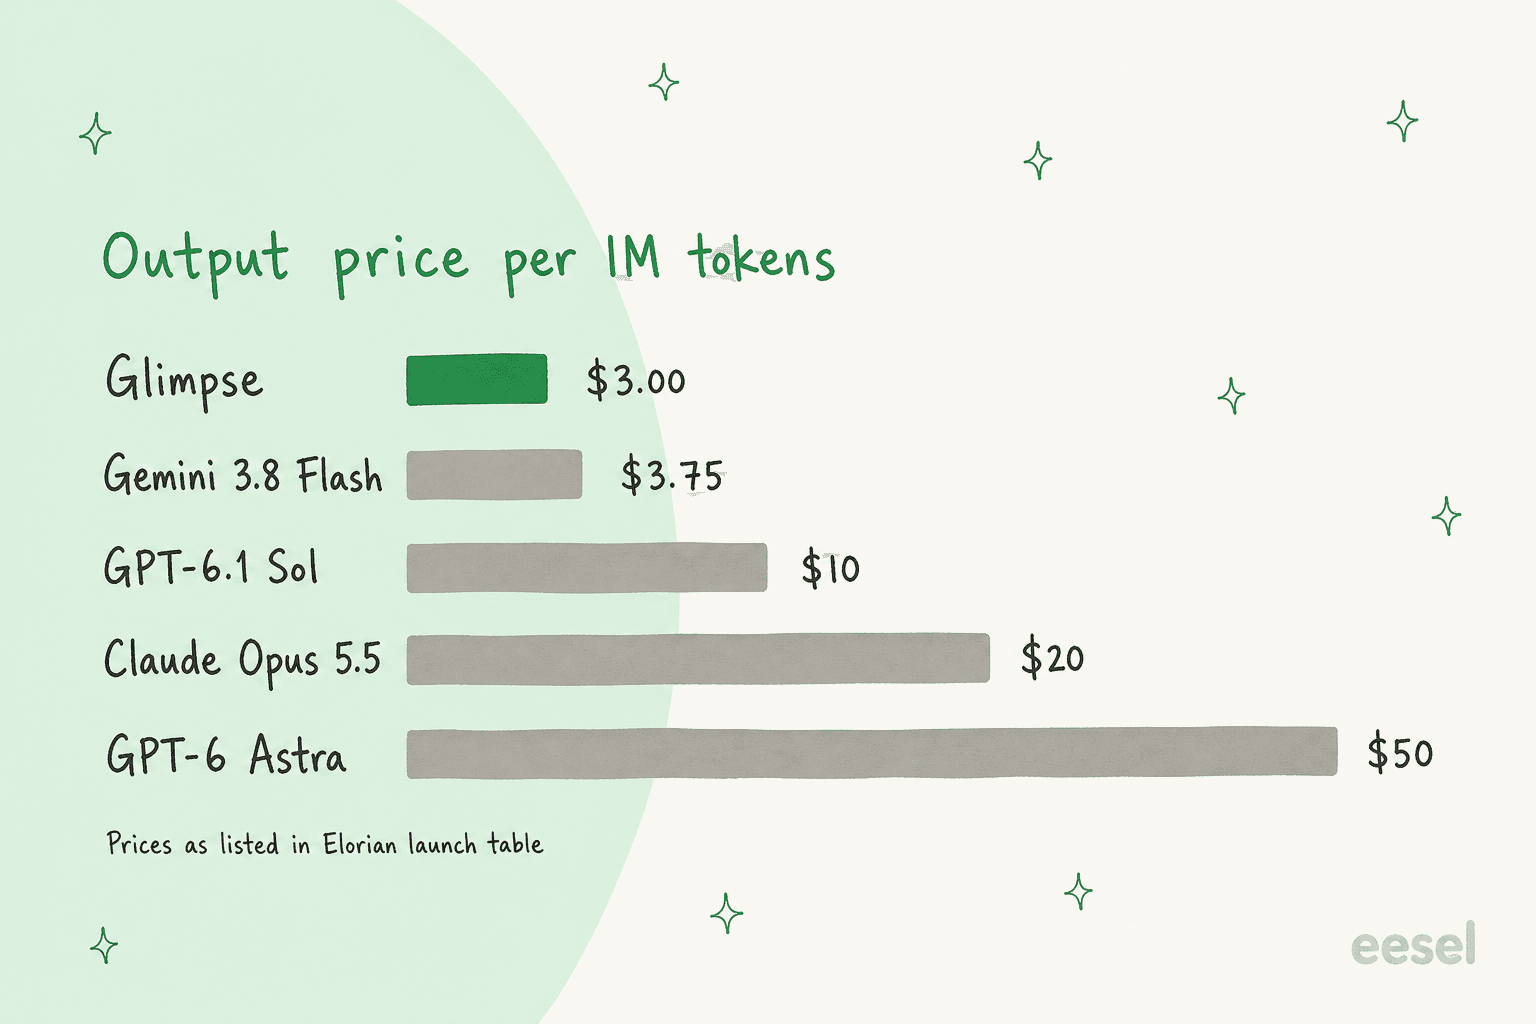
Ces prix de concurrents sont ceux qu'Elorian a listés ; mes analyses GPT-6 Astra pricing et Opus 5.5 pricing couvrent les grilles complètes, cache compris. Elorian affirme que Glimpse est 94 % moins cher qu'Astra et 20 % moins cher que le tarif de lancement de Gemini 3.8 Flash, en entrée comme en sortie.
Deux choses changent la facture réelle :
- Glimpse réfléchit avec beaucoup de tokens. Elorian le dit elle-même : "Looking that closely takes time, and tokens. Token efficiency is our next highest focus." Un faible tarif par token sur un modèle qui raisonne longuement peut quand même coûter plus par tâche que prévu : testez donc sur vos propres clips avant de budgétiser.
- Les chiffres par tâche paraissent meilleurs que ceux par token. Dans la démo de planification robotique d'Elorian, l'épisode entier a coûté $0.035 avec Glimpse contre $0.249 avec Astra, soit environ 7 fois moins. L'investisseur Brian Zhan a calculé ce que cela donne pour un robot qui vérifie ses caméras toutes les 2 secondes : 1 800 appels par heure de robot, là où "the same budget on Astra buys one check every 14s."
Chez Together, la mention déploiement dédié seul signifie que vous payez des GPU réservés, pas à l'appel. Cela convient à une équipe avec un volume stable et une raison de garder le trafic sur une infrastructure qu'elle utilise déjà ; mon guide Together AI pricing explique comment les endpoints dédiés sont facturés. Pour un premier test, l'API Elorian est plus simple. Une ventilation complète des coûts par scénario viendra dans un billet distinct sur les prix de Glimpse.
À quoi sert-il vraiment ?
Elorian et Together listent les mêmes trois groupes de cas d'usage, et ils correspondent aux points où les benchmarks sont les plus solides.
Données et planification en robotique. Glimpse peut étiqueter des enregistrements de téléopération, nommer et encadrer des objets, et découper un épisode en événements de prise et dépose horodatés. Il peut aussi servir de planificateur à une politique robotique vision-langage-action, en vérifiant les caméras pour décider quand une étape est terminée. Dans la démo de lancement, il planifiait pour la politique π0.5 de Physical Intelligence sur une tâche LIBERO. Si la robotique est votre domaine, comparez-le à Gemini Robotics 2 et Gemini 4 Argon for robotics de Google.
"Most teleop footage sits unlabelled because segmenting every step by hand is slow and expensive."
La vidéo à grande échelle. Des légendes denses qui captent les mouvements fins et les dynamiques émotionnelles, l'étiquetage de vidéos courtes et sociales pour la recherche, et le suivi ou le comptage d'objets dans des images tournées à la main. La démo des chiots d'Elorian garde le numéro de chaque chiot quand la caméra s'éloigne puis revient, ce qui est la partie difficile du comptage en vidéo.
L'inspection scientifique et opérationnelle. Lire des graphiques et des données de laboratoire, compter du matériel et des stocks en séparant les objets qui se ressemblent, et raisonner sur les conséquences physiques à partir d'une photo. La démo du chantier d'Elorian compte les véhicules d'une cour et renvoie les horodatages sur lesquels elle s'est appuyée, le genre de piste de preuves qu'un auditeur voudrait.
Que disent les premiers utilisateurs ?
Les réactions au lancement sur X portaient surtout sur le processus visible. L'annonce d'Andrew Dai a recueilli plus de 5 700 mentions J'aime :
"Spent years watching models ace a single image and completely whiff on anything that moves or changes angle. Today we're fixing that."
Un testeur en accès anticipé a fait un test de comptage sur un tableau et a aimé la façon dont le modèle a travaillé, pas seulement la réponse :
"Glimpse broke the image into four sections, zoomed in to examine the details, and analyzed the visual clues before reaching its final answer: 5 horses."
La critique la plus incisive est venue dans les réponses, et c'est la bonne question à poser à toute démo :
"Counting is the easy thing to check, but the footage use is where it gets hard. Asking why something changed means tracking the same object across frames and tying it to a cause, and that is where a lot of vision models start guessing. I'd want to see it on a long clip where the key change happens off to one side of the frame."
À noter : plusieurs des publications de lancement les plus enthousiastes, dont le fil sur la robotique de Brian Zhan et la publication "1/16 the price of Astra" de Striker, viennent des investisseurs d'Elorian. Elles sont utiles pour les calculs, mais ce ne sont pas des avis neutres. Je mettrai ce billet à jour quand des testeurs indépendants publieront des résultats sur de longs clips.
Où Glimpse est limité
Rien de tout cela n'est rédhibitoire pour un premier modèle, mais il faut le savoir avant de construire dessus :
- C'est une préversion de recherche. Les mots d'Elorian elle-même. Attendez-vous à des changements du modèle, des limites et du prix.
- Pas encore de benchmarks indépendants. Chaque score est un passage d'Elorian, à effort maximal, sur un tableau qui inclut un benchmark qu'Elorian a construit.
- Des bases manquantes. Pas de fenêtre de contexte, de sortie maximale, de limites de débit, de prix d'entrée en cache ni de palier batch publiés. Pour un acheteur d'API, cela décide si ça marche en production.
- Pas de poids. Il repose sur une base à poids ouverts, mais Glimpse lui-même est fermé. Si vous devez auto-héberger de la vision, Nemotron 3.5 Super VL et l'expérience de vision de DeepSeek V4 Flash sont les options ouvertes.
- Entraîne sur vos envois par défaut. Les conditions d'Elorian lui accordent une licence sur le contenu soumis pour "train, test, evaluate, and improve" ses modèles. Les utilisateurs payants peuvent s'y opposer par e-mail ; les conditions ne donnent pas cette option aux utilisateurs gratuits. Les mêmes conditions interdisent aussi d'utiliser les sorties pour entraîner ou évaluer un autre modèle.
- Texte seulement en sortie. Il lit les images et la vidéo mais renvoie du texte, et Elorian dit que les sorties d'action pour robots restent "work ahead."
Glimpse est-il utile pour le support client ?
C'est la question qui m'importe le plus, alors je serai direct. La partie vision est un vrai atout. Les clients envoient des photos de produits abîmés, des captures d'écran de messages d'erreur et des enregistrements d'écran de bugs. Un modèle texte voit "voir pièce jointe" et rien d'autre. Un modèle capable de compter, comparer et suivre ce qui a changé dans un clip pourrait transformer ces pièces jointes en réponses.
Mais pour une équipe de support aujourd'hui, Glimpse est un composant, pas une solution. Il n'y a pas d'intégration helpdesk, pas de fenêtre de contexte publiée pour les longs fils de tickets, et avec l'entraînement par défaut sur les envois, vous voudriez un forfait payant avant qu'une photo de client s'en approche. Les helpdesks ajoutent aussi leur propre lecture d'images, comme Gorgias AI Agent Vision, et la gestion des pièces jointes a ses limites, comme les limites de taille des pièces jointes de Zendesk.
La leçon qu'eesel a apprise à la dure vaut pour tout nouveau modèle : on ne peut pas faire confiance à un modèle pour se surveiller lui-même sur une file en direct. Une réponse fausse mais assurée sur la photo d'un produit abîmé est pire qu'une réponse humaine lente. C'est pourquoi chaque déploiement d'eesel est simulé sur des tickets historiques avant que l'IA réponde à un vrai client. Mon guide du best support ticket model explique comment choisir la couche modèle, et la AI ticket classification est un premier travail moins risqué pour tout nouveau modèle.
Qui devrait essayer Elorian Glimpse ?
Voici comment je déciderais :
- Les équipes de robotique qui étiquettent des enregistrements ou vérifient le travail d'une politique. C'est là que Glimpse est le plus fort dans le tableau d'Elorian et le moins cher par vérification. Essayez-le en premier.
- Les équipes qui étiquettent ou légendent de la vidéo courte à grande échelle. Bon score UGC-VideoCap et prix de sortie bas. Lancez-le sur vos propres clips.
- L'inspection et le comptage de stocks. Bon en comptage ouvert, plus faible en comptage sur images de produits (CountQA) : testez donc avec vos vraies photos de produits.
- Les questions sur vidéos longues. Astra et GPT-6.1 Sol obtiennent nettement plus sur Video-MME v2. Commencez par là si la précision compte plus que le coût.
- Tout ce qui exige des poids, des contrats ou des limites publiées. Attendez. Regardez les modèles ouverts ou les autres options de Together jusqu'à ce que Glimpse sorte de la préversion.
Si vous suivez le paysage plus large des nouveaux modèles capables de vision ce mois-ci, Meta Muse Wonder, Reflection AI Beam et GLM-5.3-Flash sont les autres lancements dont j'ai parlé.
Essayer eesel
Glimpse est de l'infrastructure : un modèle, une API et une facture au token. Pour l'utiliser sur des tickets de support, il vous faudrait encore construire la connexion au helpdesk, la recherche dans votre centre d'aide, les règles d'escalade et les tests. eesel est l'employé. Notre coéquipier IA pour le helpdesk rejoint votre file existante dans Zendesk, Freshdesk, Gorgias et d'autres helpdesks, apprend de vos tickets et documents passés, et vous pouvez le rejouer sur des centaines de vos tickets historiques avant qu'il réponde à un seul client. C'est dans ce rejeu que vous repérez la réponse fausse mais assurée sur la photo d'un client avant que le client ne le fasse.
Si vous préférez travailler depuis un terminal, comme vous le feriez pour tester un nouveau modèle, la CLI eesel pilote ce même coéquipier. eesel instructions lit et modifie ses règles permanentes, eesel approvals liste les actions en attente d'un humain, et eesel activity montre chaque exécution et pourquoi il a agi ainsi, de sorte qu'un agent de code comme Claude Code puisse gérer votre coéquipier de support comme il gère votre dépôt. Si vous écrivez du contenu plutôt que de répondre à des tickets, la même équipe compte un rédacteur de blog IA.

Le démarrage est gratuit, sans carte. Essayez eesel sur les tickets du mois dernier et voyez ce qu'il aurait répondu, avant de chiffrer le moindre endpoint dédié. Les forfaits sont sur la page des tarifs.