

Qu'est-ce qu'Eleven v4 ?
Eleven v4 est la quatrième génération du modèle vocal d'ElevenLabs, l'une des entreprises de voix IA les plus connues, et la société le qualifie de « the first in a new generation of models » sur sa page de documentation Eleven v4.
L'article de lancement explique qu'il repose sur une architecture entièrement nouvelle, qui lit un script comme le ferait un comédien de doublage, en tenant compte de qui parle et de ce qui vient de se passer avant de décider comment une réplique doit sonner.
Je construis des agents IA chez eesel (la plateforme de coéquipiers IA), et l'équipe met depuis des années de l'IA sur de vraies files de support. Quand un lancement comme celui-ci arrive, je veux surtout savoir une chose : qu'est-ce qui change pour quelqu'un qui doit le mettre en production ? Réponse courte : v4 est un vrai progrès, mais c'est aussi une migration, pas un simple remplacement.
D'après la référence des modèles, il existe deux variantes :
- Eleven v4 (
eleven_v4) : le modèle de qualité. Limite de 10 000 caractères (environ 10 minutes d'audio), dialogue multi-locuteurs, servi via l'API Text to Dialogue. - Eleven v4 Turbo (
eleven_v4_turbo) : le modèle temps réel, avec une latence d'inférence médiane d'environ 100 ms, servi via le WebSocket Text to Dialogue et dans ElevenAgents.
D'après le changelog du 28 septembre, vous pouvez utiliser les deux dès aujourd'hui dans ElevenCreative (l'application web), ElevenAgents, ainsi que via l'API. ElevenLabs a aussi publié une courte présentation pour les développeurs, si vous préférez la vidéo.
Qu'est-ce qui a vraiment changé par rapport à v3 ?
L'expressivité et la précision du clonage font les gros titres. Mais les détails sur lesquels vous planifiez vraiment se trouvent dans la documentation, alors j'ai constitué ce comparatif à partir de la page des modèles et de la page des tarifs de l'API.
| Eleven v3 | Eleven v4 | Eleven v4 Turbo | |
|---|---|---|---|
| Idéal pour | Interprétations dramatiques | Livres audio, voix off, doublage | Agents vocaux, applications interactives |
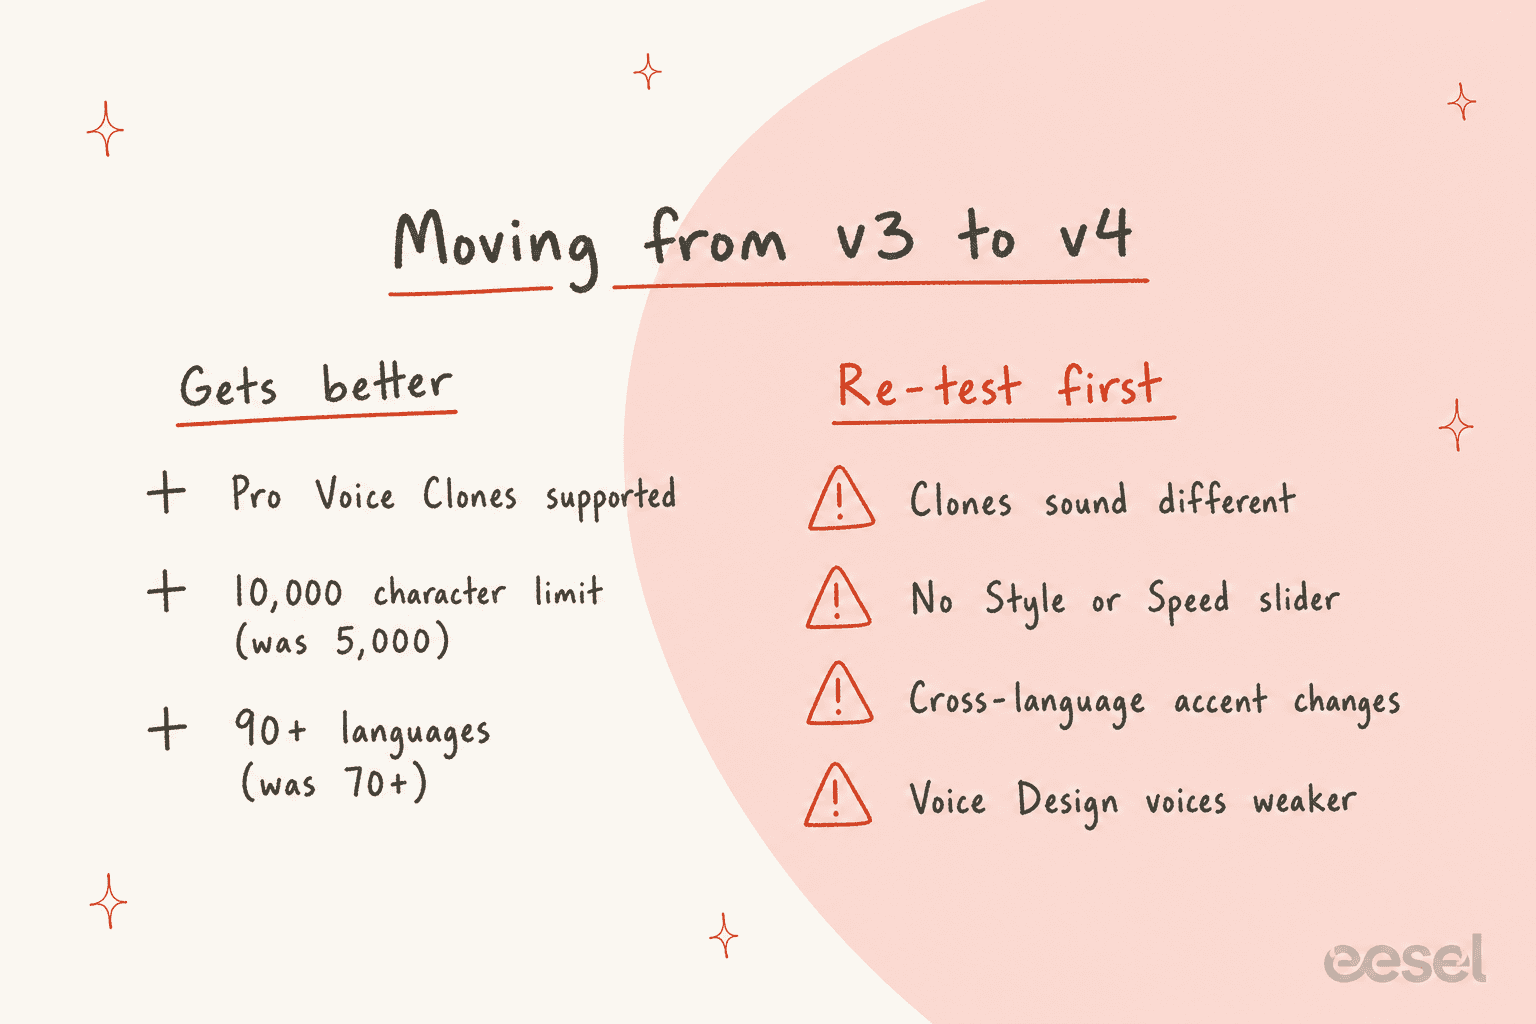
| Langues | 70+ | 90+ | 90+ |
| Limite de caractères par requête | 5 000 | 10 000 | Streaming |
| Latence | Pas en temps réel | Pas en temps réel | ~100 ms d'inférence médiane |
| Prix catalogue API pour 1 000 caractères | 0,08 $ | 0,08 $ | 0,04 $ |
| Professional Voice Clones | Pas entièrement optimisés | Pris en charge | Pris en charge |
| Curseurs Style et Speed | Oui | Non | Non |
| SSML | Non | Non | Non |
| Elo sur l'arène (Artificial Analysis) | 1174 | 1321 | 1334 |
Certains de ces points méritent plus de place qu'une cellule de tableau.
Les Professional Voice Clones sont de retour. D'après la page de bonnes pratiques de v3, les PVC n'étaient pas entièrement optimisés pour v3, ce qui explique pourquoi les équipes disposant d'un clone professionnel coûteux restaient souvent sur des modèles plus anciens. Le guide des bonnes pratiques oriente désormais ces voix directement vers v4. Il y a cependant une réserve. La documentation indique que la prise en charge des PVC « is currently rolling out to everyone », donc certains comptes peuvent encore attendre.
Les clones instantanés demandent moins d'audio. L'article de lancement indique que les Instant Voice Clones capturent une voix à partir de « just 10 seconds of audio », même si la documentation recommande toujours une à deux minutes pour obtenir un résultat solide.
Le format long est plus stable. ElevenLabs affirme que le request stitching (enchaîner des générations pour former un morceau plus long) est « significantly more reliable », et ce sont les producteurs de livres audio travaillant dans Studio qui le remarqueront le plus.
Il ne reste que deux curseurs. Stability et Similarity restent dans v4. Style et Speed disparaissent, donc la direction d'acteur se fait désormais dans le script lui-même, sous forme de balises audio comme [whispers] ou [sighs].
Pourquoi Turbo est le choix de la plupart des gens
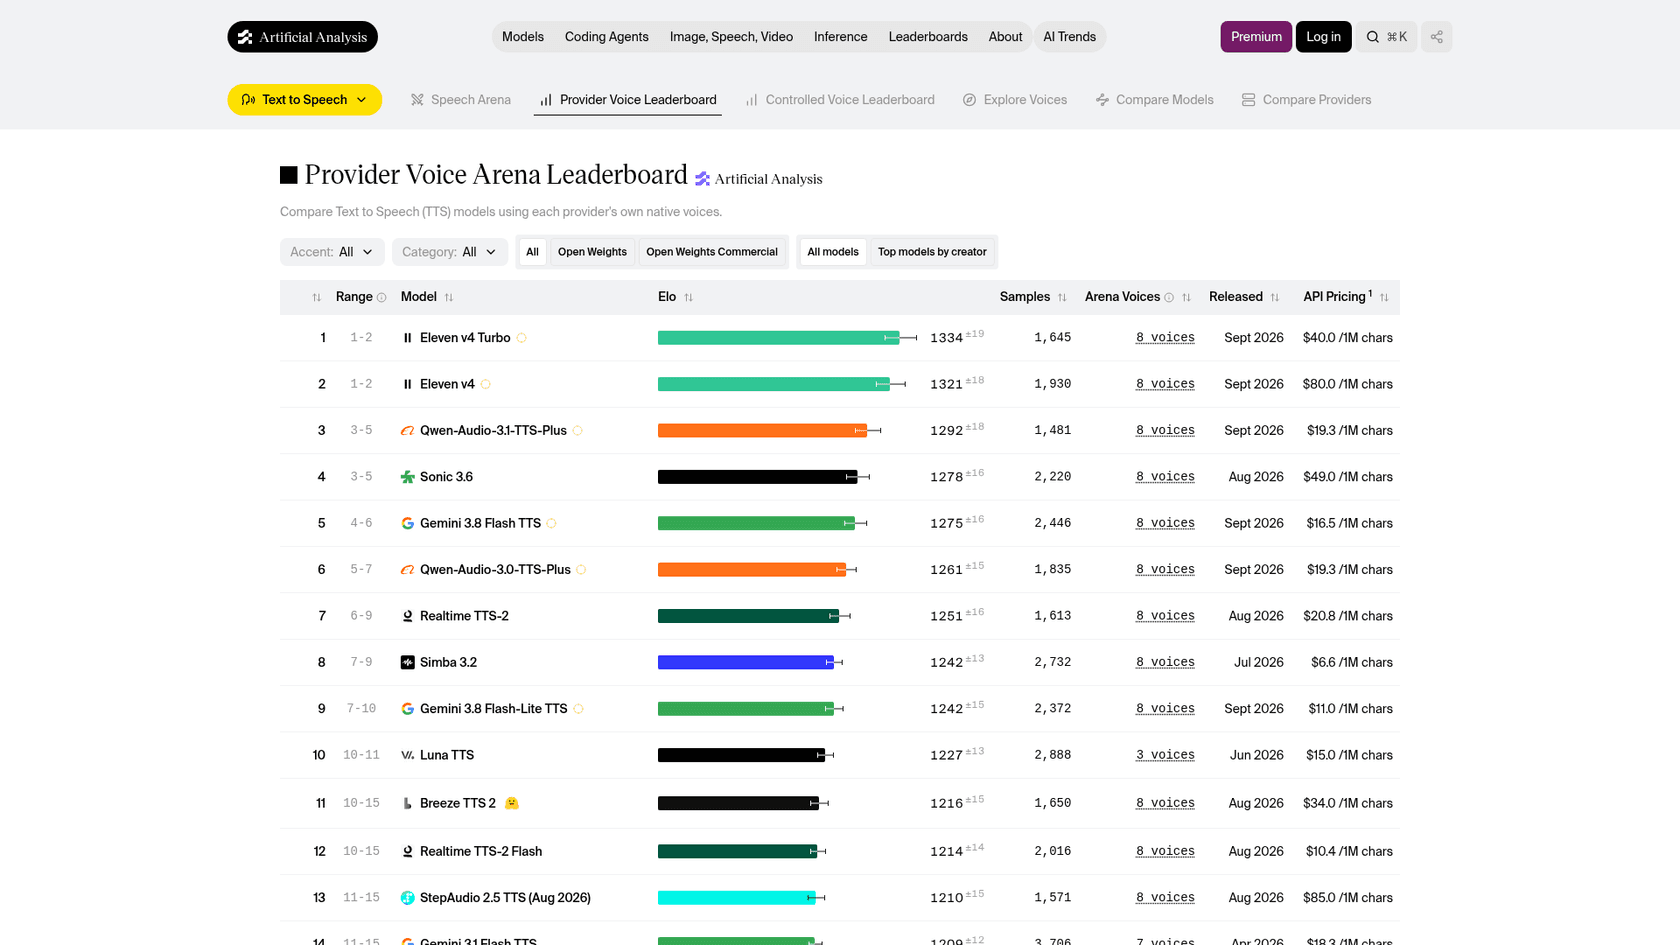
C'est la partie qui m'a surpris. On s'attendrait à ce que le modèle « qualité » batte le modèle « rapide » sur la qualité. Sur la Provider Voice Arena d'Artificial Analysis, où les auditeurs choisissent le plus naturel de deux extraits sans savoir quel modèle les a produits, c'est l'inverse :
- Eleven v4 Turbo : 1334 Elo sur 1 645 votes, 40 $ par million de caractères.
- Eleven v4 : 1321 Elo sur 1 930 votes, 80 $ par million de caractères.
- Qwen-Audio-3.1-TTS-Plus : 1292 Elo, 19,30 $ par million de caractères.
- Cartesia Sonic 3.6 : 1278 Elo, 49 $ par million de caractères.
- Gemini 3.8 Flash TTS : 1275 Elo, 16,50 $ par million de caractères.
Les deux modèles v4 se chevauchent dans leurs intervalles de confiance (tous deux se situent dans la tranche de rang « 1-2 »), donc la lecture honnête est que Turbo égale le modèle complet en naturel sur les extraits courts pour moitié moins cher. Le modèle complet justifie son prix sur ce que l'arène ne teste pas, comme la limite de 10 000 caractères et le maintien du contexte de scène sur un long script. Assembler un chapitre entier sans dérive en est une autre.
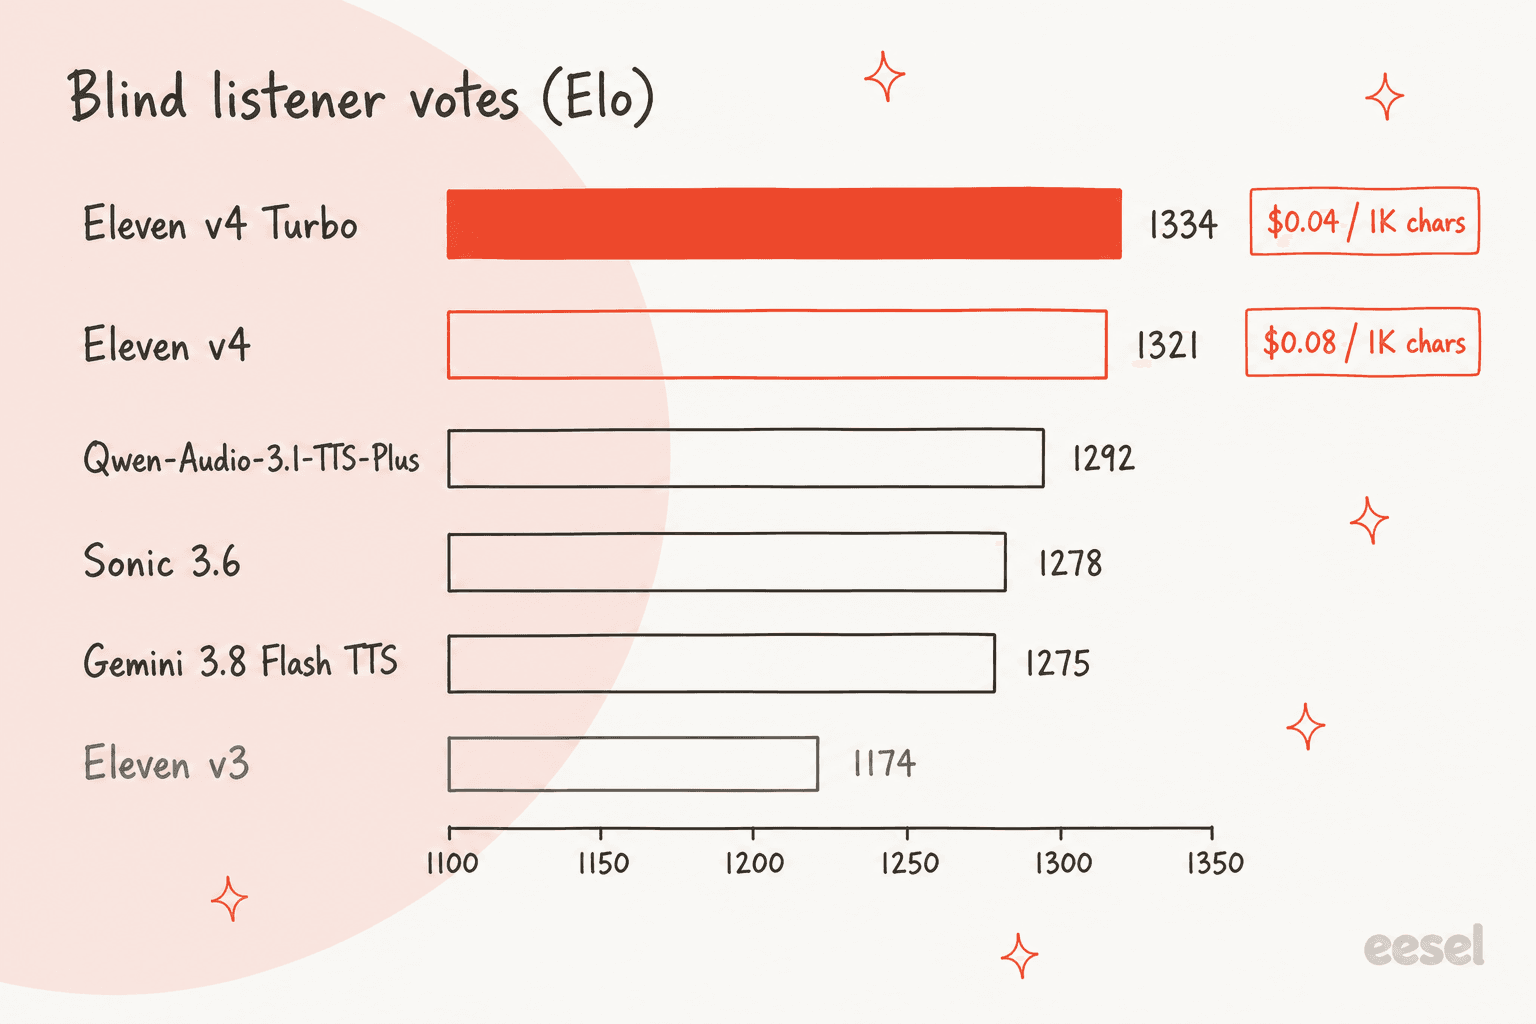
L'écart avec v3 tient aussi, et ce n'est pas un arrondi marketing. v3 est à 1174 sur le même classement, 147 points derrière v4, et sur une échelle Elo, cela signifie que les auditeurs préfèrent v4 la plupart du temps. Les tests internes d'ElevenLabs affirment que v4 a été préféré par ~75 % des auditeurs face à Cartesia Sonic 3.6, Inworld TTS-2 et deux modèles TTS Gemini 3.8, selon les notes de bas de page de l'article de lancement. Je traiterais cela comme une affirmation du fournisseur et m'appuierais sur les chiffres de l'arène comme vérification indépendante.
Ma règle empirique : Turbo par défaut, et le modèle complet seulement quand une seule requête doit porter plusieurs minutes de narration continue.
Vous comparez des fournisseurs ? Mes articles Cartesia Sonic 3 vs ElevenLabs et l'avis sur Gemini 3.8 Flash TTS couvrent les deux noms suivants de ce classement.
L'article sur les tarifs de Gemini 3.8 Flash TTS explique pourquoi Google casse les prix de tout le monde. Une liste plus large se trouve dans alternatives à ElevenLabs.
Quel modèle Eleven convient à votre projet ?
Choisissez ce que vous construisez. Les prix sont les tarifs catalogue de l'API pour 1 000 caractères.
Comment l'accent natif change les voix multilingues
La documentation le présente comme l'un des plus gros changements de v4. C'est aussi celui qui risque le plus de surprendre un client existant.
Une voix clonée sur v3 emportait son accent dans les autres langues. v4 sépare deux cas. Si la langue de sortie correspond à la langue propre de la voix, l'accent est conservé ; sinon, v4 produit une parole fluide avec un accent natif de la langue cible. La documentation donne cet exemple : clonez un locuteur coréen, générez de l'anglais, et vous obtenez un anglais naturel, pas de l'anglais avec un accent coréen.
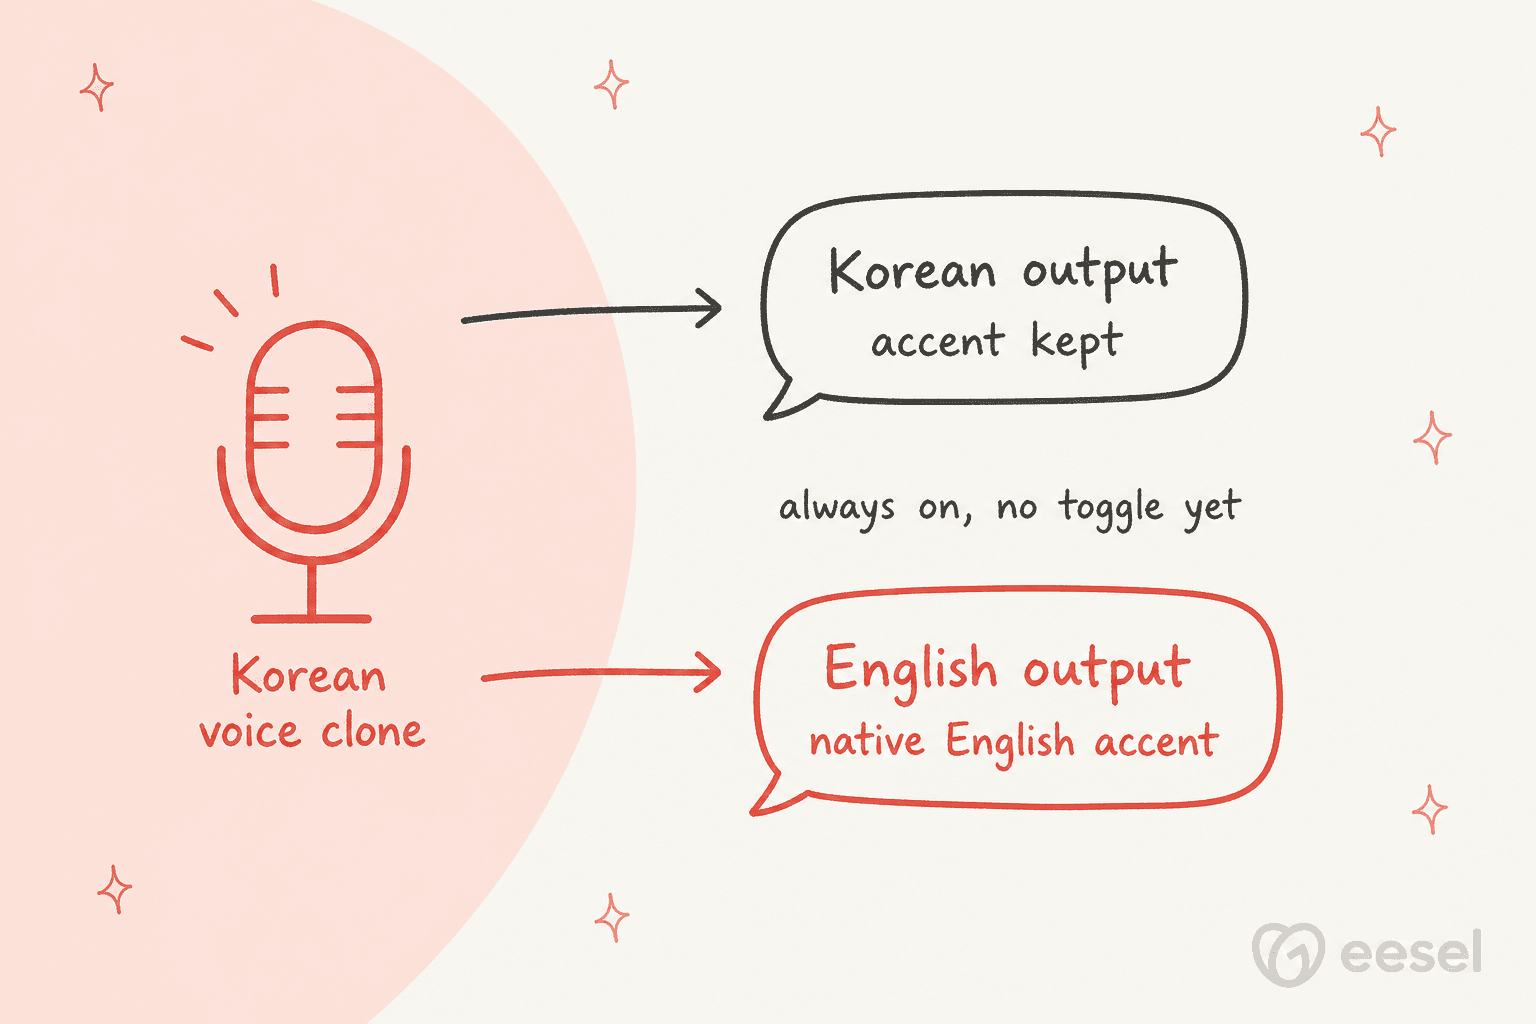
C'est une grosse amélioration pour le doublage, et pour les agents qui servent des appelants dans plusieurs langues, puisqu'une même voix de marque peut désormais sonner locale partout. Mais si votre voix est l'accent, c'est une régression. ElevenLabs reconnaît franchement qu'une option pour le désactiver est « still a research project », sans calendrier.
Tous les premiers utilisateurs ne trouvent pas que cela fonctionne comme décrit. Dans le fil du subreddit officiel, un commentateur a rencontré le problème inverse :
"In English it's good but the American accent bleeds terribly into other languages."

Quelqu'un d'autre voulait que le contrôle de l'accent soit défini au niveau de la voix plutôt que ligne par ligne. Pour qui produit une longue série, c'est une demande légitime :
"I want accent/dialects to be encoded at the voice level, not have to prompt for it in every single line. It is really impossible to keep a stable idiolect that way and generic [Scottish] or whatever can still come out a million ways."
Concrètement : si vous assurez un support client multilingue avec un agent vocal, générez un script de test dans chacune de vos principales langues avant de basculer. D'après l'article sur Turbo dans les agents, les plus grands progrès concernent le japonais, le portugais brésilien, le mandarin et le cantonais, ce qui en fait de bons candidats pour commencer.
Mes voix clonées sonneront-elles pareil ?
Probablement pas, et ElevenLabs le dit lui-même. v4 reproduit la voix source plus précisément (timbre, cadence, volume, jusqu'aux défauts d'enregistrement), donc un clone v4 « may sound quite different from its Eleven v3 version », d'après la FAQ de v4. Il y a aussi une phrase dans la documentation que tout responsable audio devrait lire deux fois : la précision et la préférence personnelle ne sont pas toujours la même chose.
Cela a deux conséquences en cascade :
- Votre audio d'entraînement compte davantage. v4 copie fidèlement les plosives, les sifflantes dures et même les variations de volume. Les extraits de démonstration de la page de documentation sont laissés bruts exprès pour le montrer. Si votre clone provient d'un enregistrement bruité, réenregistrez avant d'accuser le modèle.
- Les voix de la bibliothèque peuvent changer sans prévenir. Les utilisateurs d'ElevenReader (l'application d'écoute) ont remarqué des voix qui changeaient en plein livre. Certains ont adoré, d'autres non.
"In ElevenReader it genuinely blew me away. I didn't even know the update was coming, but suddenly my narrator sounded like an actual real human was reading my book to me."
Les créateurs qui avaient réglé une voix pour une diction précise et sobre l'ont vécu à l'inverse :
"I'm actually having big issues with v4 its super expressive but for my niche its too damn theatrical and you cannot make certain voices be straight/monotone while speaking..."
Il y a un astérisque plus discret pour les voix Voice Design (celles générées à partir d'une description textuelle). La documentation indique qu'elles fonctionnent sur v4 mais « may not be as performative or sound as good as with earlier models ».
Comment fonctionnent les balises audio et le prompting dans v4 ?
Comme les curseurs Style et Speed ont disparu, la direction doit venir du script. Vous écrivez des balises au fil du texte, comme [whispers], [sighs], [laughs harder], ou des indications sonores comme [door slams] et [light rain], et v4 les suit « more reliably than v3 », d'après la page d'accueil de v4. ElevenLabs propose aussi une liste de balises audio avec plus de 50 exemples.
Quelques notes du guide de prompting qui peuvent vous éviter une ou deux régénérations :
- Pas de SSML. Ni v4 ni v3 ne prennent en charge les balises de pause SSML, ce qui change la donne si vous venez d'une ancienne API vocale. Utilisez des points de suspension et des sauts de ligne, ou des balises comme
[short pause]ou[long pause]. - Les balises peuvent être lues comme des effets sonores. v4 génère des effets sonores en plus des voix, donc une balise vague peut ressortir comme un bruit. La documentation suggère quelque chose de plus descriptif, comme
[low, gravelly voice]. - Les balises fonctionnent mieux dans la tessiture de la voix. Une voix qui n'a jamais chuchoté dans ses données d'entraînement peut quand même suivre
[whispering], mais « the result may not be optimal ». - La prononciation IPA est désormais native. Vous placez les symboles IPA entre barres obliques directement dans le texte, sans balises XML de phonèmes. C'est pratique pour les noms de médicaments, de produits ou de lieux qu'un agent vocal de support doit prononcer correctement.
Parmi toutes les plaintes que j'ai vues, l'absence du curseur Speed revenait le plus souvent. Un créateur a écrit que v4 « does seem to be speaking much faster (there isn't a slider in the voice settings to control that) » dans le même fil Reddit, et le modérateur du subreddit l'a transmis comme retour. Tant que cela ne change pas, le rythme se gère à l'écriture, avec des phrases plus courtes et des balises de pause explicites.
Combien coûte Eleven v4 ?
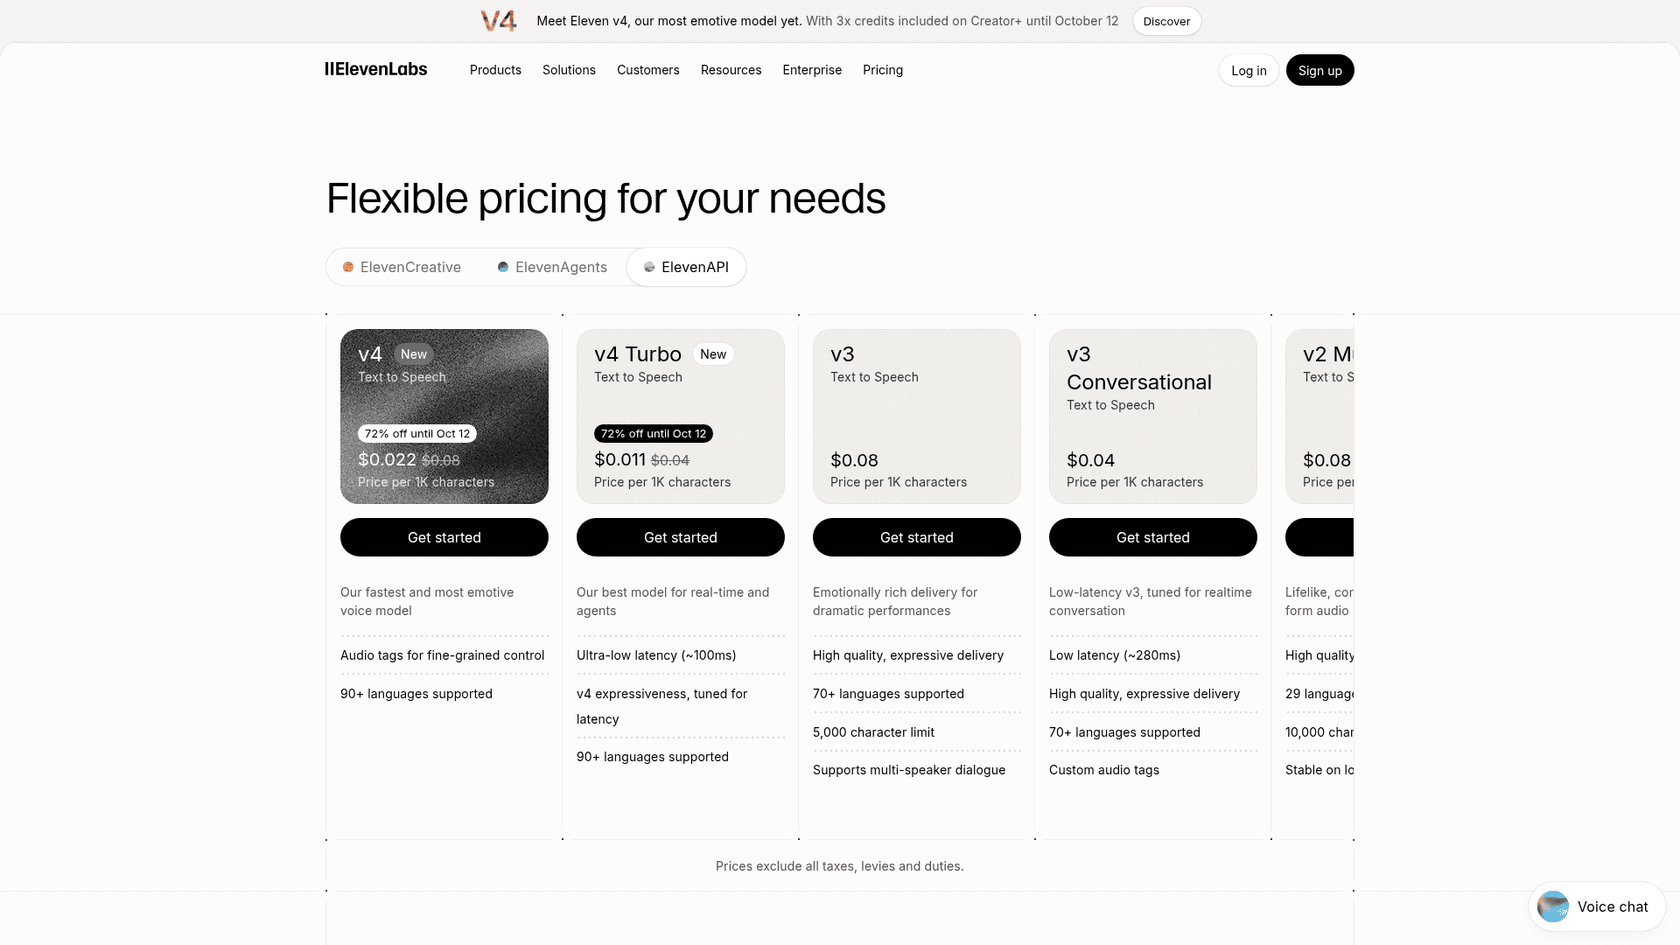
Au tarif catalogue de l'API, Eleven v4 coûte autant que v3, et Turbo équivaut à v3 Conversational. Pour l'instant, il y a aussi une remise de lancement de 72 % jusqu'au 12 octobre 2026, d'après la page des tarifs de l'API.
| Modèle | Prix catalogue pour 1 000 caractères | Prix de lancement (jusqu'au 12 oct.) | Latence | Limite de caractères |
|---|---|---|---|---|
| Eleven v4 | 0,08 $ | 0,022 $ | Pas en temps réel | 10 000 |
| Eleven v4 Turbo | 0,04 $ | 0,011 $ | ~100 ms | Streaming |
| Eleven v3 | 0,08 $ | n/a | Pas en temps réel | 5 000 |
| Eleven v3 Conversational | 0,04 $ | n/a | ~280 ms | Streaming |
| Flash v2.5 | 0,04 $ | n/a | ~75 ms | 40 000 |
Dans l'application web, v4 puise dans le même pool de crédits mensuels que tout le reste. Les offres actuelles sur la page des tarifs d'ElevenCreative sont Free (0 $, 10 000 crédits), Starter (6 $, 30 000), Creator (22 $, 121 000), Pro (99 $, 600 000), Scale (299 $, 1,8 M) et Business (990 $, 6 M). La FAQ des tarifs indique environ 1 crédit par caractère pour Text to Speech. Il y a aussi une promotion de lancement pour les offres Creator et supérieures : l'utilisation de v4 jusqu'à 2 fois vos crédits TTS mensuels ne compte pas sur votre solde dans les applications web et mobile. Curieusement, la bannière et la section promotionnelle de cette page ne s'accordent pas sur 2x ou 3x, donc je vérifierais votre propre solde avant de planifier là-dessus. Mon guide des tarifs d'ElevenLabs passe en revue chaque palier, et l'article sur les avis sur ElevenLabs rapporte ce que les utilisateurs payants disent du système de crédits.
Un exemple chiffré. Un utilisateur de Reddit a demandé combien coûterait un livre audio de 8 heures, voici le calcul. La documentation estime 10 000 caractères à environ 10 minutes d'audio, ce qui place 8 heures à environ 480 000 caractères :
- Eleven v4 sur l'API au tarif catalogue : 480 × 0,08 $ = 38,40 $
- Eleven v4 au prix de lancement : 480 × 0,022 $ = 10,56 $
- Eleven v4 Turbo au tarif catalogue : 480 × 0,04 $ = 19,20 $
- Dans l'application : environ 480 000 crédits, ce qui tient dans les 600 000 de l'offre Pro à 99 $/mois.
Les agents vocaux ne sont pas facturés au caractère. La tarification d'ElevenAgents fonctionne à la minute d'appel, avec des offres de Free (15 minutes) à Business (990 $ pour 12 375 minutes), des minutes supplémentaires à 0,08 $ pièce et le LLM facturé séparément. J'ai détaillé le même calcul dans le comparatif des meilleurs agents vocaux IA.
Faut-il mettre Eleven v4 Turbo sur votre ligne de support ?

ElevenLabs vise clairement Turbo vers le service client. L'article de lancement d'ElevenAgents parle d'agents qui sonnent « apologetic about a missed delivery, brisk when someone just wants a confirmation », et l'équipe Agentforce Voice de Salesforce est citée sur la page de v4 pour avoir salué les « faster, more natural responses » de Turbo.
Il arrive aussi dans un mois chargé : GPT-Live-1 d'OpenAI, Grok Voice Think Fast 2 de xAI et Decagon Voice 3 visent tous les mêmes appels de support.
Salesforce a aussi sa propre histoire avec son agent vocal IA. Pour les appelants, c'est une vraie amélioration, car un robot monotone qui récite une politique de remboursement fait partie des raisons pour lesquelles les gens appuient sur zéro pour joindre un humain. Ce qu'un lancement de TTS ne peut pas corriger, c'est la réponse elle-même. La voix lit ce que l'agent a produit, et une voix merveilleusement compatissante qui confirme le mauvais délai de remboursement reste fausse, sauf qu'elle sonne désormais plus convaincante.
Des années à observer l'IA sur de vraies files de support mènent à la même leçon. La justesse vient de ce que l'agent sait (votre centre d'aide, vos macros et vos anciens tickets) et du fait de le tester avant vos clients, c'est pourquoi chaque déploiement eesel est d'abord simulé sur des tickets historiques. Si vous présélectionnez des plateformes vocales, mes guides sur les agents IA de centre d'appels, Retell AI et Vapi comparent la façon dont chacune gère les connaissances et le transfert, ainsi que les intégrations de helpdesk.
Mon comparatif du support vocal les met toutes côte à côte.
La voix représente aussi une part plus petite du support qu'on ne le croit. La plupart des équipes reçoivent encore l'essentiel de leur volume par tickets et chat, c'est donc là que les problèmes de qualité des réponses apparaissent en premier. Si vous êtes déjà sur Zendesk, ses agents IA vocaux et une couche de support client IA pour la file de tickets peuvent partager les mêmes connaissances.
Essayez eesel pour les réponses derrière la voix
eesel est une plateforme de coéquipiers IA, et le coéquipier IA de helpdesk est celui conçu pour ce problème précis. Il rejoint votre file Zendesk, Freshdesk ou Gorgias existante, apprend de vos anciens tickets et de votre centre d'aide, puis rédige ou envoie des réponses dans le ton de votre équipe. Avant qu'il ne touche un vrai client, vous pouvez le faire tourner en simulation sur vos tickets historiques pour voir ce qu'il aurait répondu.
Pour être honnête sur le périmètre : eesel est aujourd'hui centré sur le texte, il traite les tickets et le chat, pas l'audio téléphonique. Une équipe de support qui utilise eesel m'a dit qu'une prise en charge de l'enregistrement vocal « would significantly increase our usage », ce qui explique pourquoi c'est sur notre radar. Si vous associez une plateforme vocale à Eleven v4 Turbo, eesel couvre le côté tickets des mêmes connaissances, et la CLI eesel (plus de détails dans ce guide sur la CLI pour agents IA) permet à un script ou à un agent de code comme Claude Code de mettre à jour ces connaissances et de tester les réponses depuis le terminal, pour que les deux canaux restent synchronisés. Les offres démarrent gratuitement avec 100 crédits sur la page des tarifs, et chaque ticket ou chat traité consomme un crédit.
Essayez eesel et voyez comment il gère les tickets du mois dernier avant de décider quoi que ce soit.
Questions fréquentes
Qu'est-ce qu'Eleven v4 ?
eleven_v4 pour le contenu et eleven_v4_turbo pour le temps réel, couvre plus de 90 langues et réintroduit la prise en charge des Professional Voice Clone qui manquait à v3.