

SeedRealtime est le modèle natif audiovisuel full-duplex de ByteDance Seed, annoncé le 5 août 2026. Audio, vidéo et texte entrent dans une seule architecture, si bien que le modèle observe votre caméra, vous entend et parle, tout cela dans la même boucle, sans détecteur d'activité vocale séparé pour décider quand son tour commence. Les démonstrations pratiques portent sur la résolution de référents plutôt que sur la vitesse : il détermine quel graphique vous visiez avec « ce graphique de tout à l'heure ».
Voici la partie que la couverture du lancement a laissée de côté. ByteDance a publié exactement un chiffre à ce sujet, une évaluation humaine interne selon laquelle les problèmes de rythme conversationnel ont diminué de moitié par rapport à des « modèles en cascade » non nommés. Il n'y a ni article technique, ni poids ouverts, ni tableau de benchmarks, ni API, ni prix. Il est aussi absent du classement voix-à-voix d'Artificial Analysis, où figurent à la fois Qwen d'Alibaba et StepFun, ce qui en fait une absence de soumission de ByteDance plutôt qu'une absence de la Chine.
Et voici le point gênant : l'axe sur lequel SeedRealtime s'optimise est justement celui que le secteur a déjà presque résolu. Le meilleur score en dynamique conversationnelle est de 98,4 %. Le meilleur score pour résoudre réellement une tâche de support est de 56,5 %. Si vous cherchez quelque chose à mettre sur une file d'attente en production, je passe depuis plus de trois ans à observer des agents IA traiter de vrais tickets de support chez eesel, et ce qui décide si un déploiement survit n'a jamais été l'élégance avec laquelle le bot prend son tour de parole.
Ce qu'est vraiment SeedRealtime
SeedRealtime est classé sous GenMedia dans l'index des modèles de Seed, à côté de Seedance, Seedream et Seeduplex. La version en une phrase de ByteDance : un LLM natif audiovisuel full-duplex capable de « comprendre conjointement l'audio, le visuel et le temporel », d'identifier de quel objet de la pièce vous parlez, et de répondre sans attendre un signal net de fin de tour.
« Full-duplex » mérite d'être décortiqué, car le terme est utilisé de façon vague. Un modèle vocal half-duplex fonctionne comme un talkie-walkie : vous parlez, il attend, vous vous arrêtez, il répond. Un modèle full-duplex écoute pendant qu'il parle, il peut donc être coupé, remarquer que vous vous êtes tu, ou décider de rester silencieux parce que vous parliez à quelqu'un d'autre dans la pièce. La majeure partie du secteur a atteint le full-duplex audio au cours des deux dernières années, GPT Realtime inclus. L'affirmation de SeedRealtime est que le flux vidéo se trouve dans la même boucle duplex plutôt que d'être greffé comme un canal secondaire.
Le billet de lancement organise les capacités en trois parties, et chacune demande une chose différente à un modèle :
- Compréhension audiovisuelle conjointe. Résoudre un homophone à partir de ce qui est affiché à l'écran, suivre un référent visuel à travers plusieurs tours de parole, et associer une voix à une personne pour savoir qui a dit quoi.
- Interaction proactive. Agir face à un changement dans la scène plutôt que seulement en réponse à une question, et glisser des appels d'outils au milieu d'une phrase.
- Minutage conversationnel. Décider quand intervenir, faire une pause ou se retenir, et filtrer les conversations parallèles et le bruit de fond plutôt que de traiter chaque son comme une entrée.
Sept vidéos de démonstration accompagnent l'annonce : identifier les locuteurs autour d'une table de dîner, traduire un menu du Sichuan, rappeler à quelqu'un au musée du Hebei qu'il est resté debout trop longtemps, corriger l'extraction d'un espresso, repérer une section de l'article ResNet, résister aux faux déclenchements dans le bruit de l'aéroport de Daxing, et accompagner la prononciation d'un enfant au milieu du brouhaha ambiant. C'est une bonne bande-démo. C'est aussi, comme je vais le montrer, toute la base de preuves publiée.
En quoi l'architecture diffère d'une chaîne vocale en cascade
La plupart des assistants vocaux que vous avez utilisés fonctionnent comme une course de relais. La reconnaissance vocale transforme votre audio en texte, un modèle de vision décrit séparément l'image de votre caméra, un modèle de langage lit les deux transcriptions, et un moteur de synthèse vocale lit la réponse à voix haute. Un détecteur d'activité vocale se place en dehors de toute la chaîne et décide quand votre tour s'est terminé.
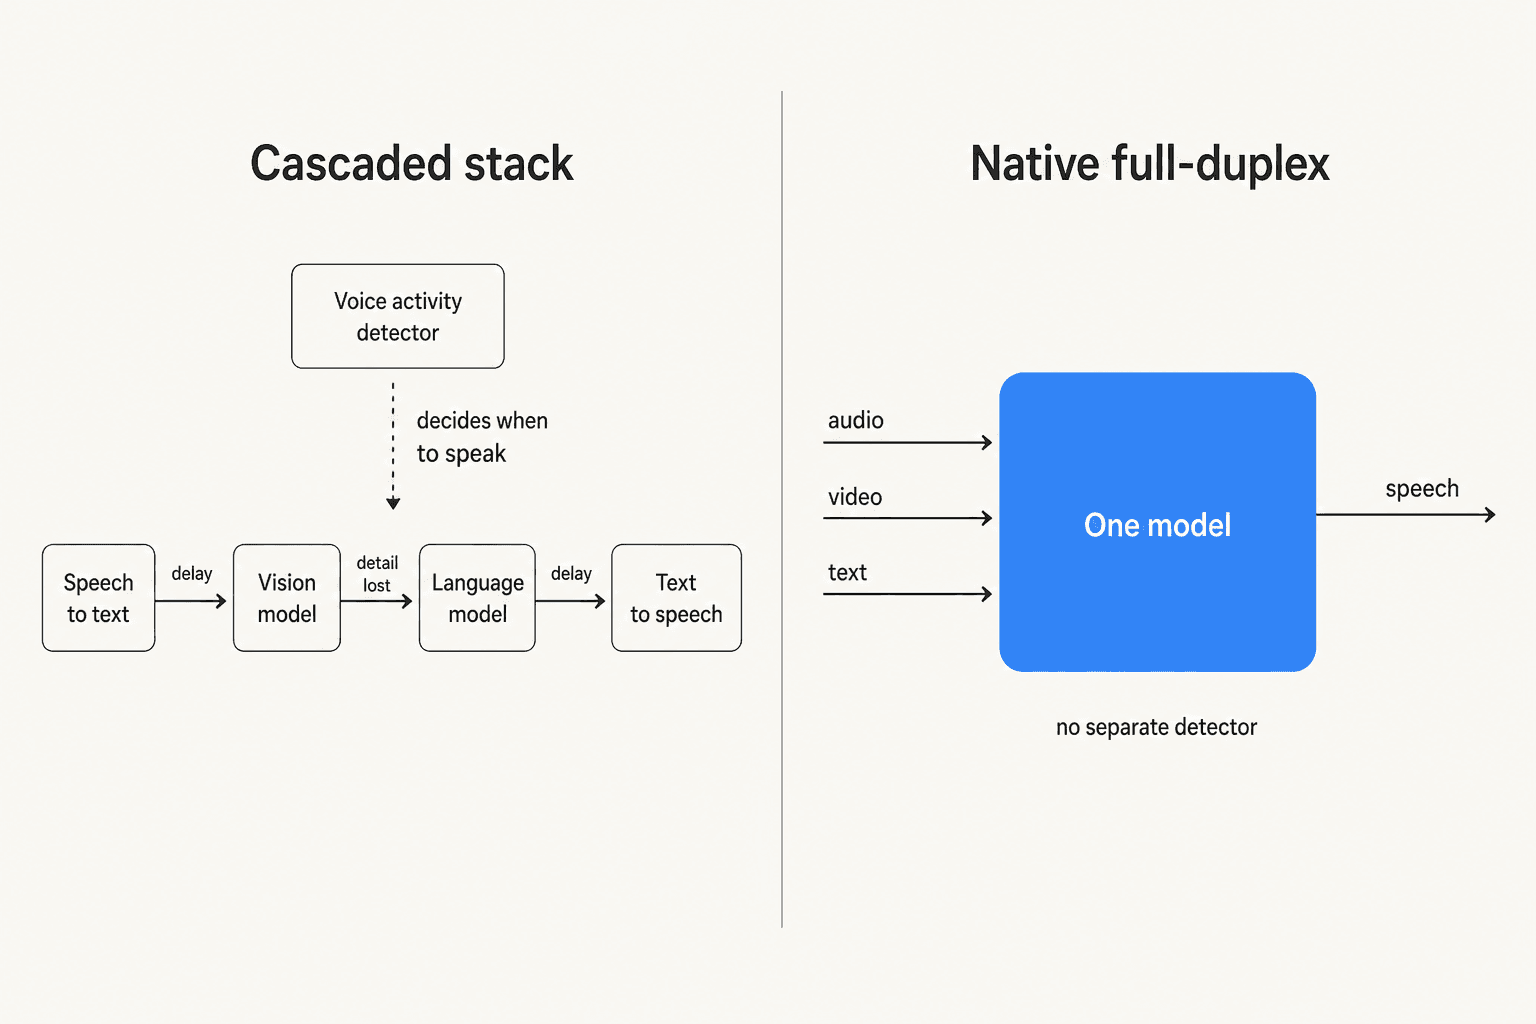
Ce design a deux coûts, et ByteDance les nomme tous les deux. Chaque jointure ajoute du délai, et chaque jointure jette de l'information. Le ton, l'hésitation, le fait que vous pointiez du doigt quelque chose en parlant : rien de tout cela ne survit au passage par une transcription. Le pari de SeedRealtime est que la perception, la compréhension, la prise de décision et l'expression se déroulent toutes à l'intérieur d'un seul modèle sur des flux continus, si bien que rien n'a besoin d'être aplati en texte en chemin. La faible latence vient d'une entrée audiovisuelle découpée en blocs, d'une génération en streaming, de la quantification et de l'optimisation de l'inférence, et non d'une astuce unique.
Le détail architectural le plus pointu est celui qui reçoit le moins d'attention : il n'y a pas de détecteur d'activité vocale externe. La prise de tour de parole est une décision que le modèle prend à partir du signal multimodal lui-même. C'est pourquoi la démo du musée fonctionne tout court, puisque « cette personne est debout depuis un moment » n'est pas une phrase que quelqu'un a prononcée à voix haute. C'est aussi pourquoi la démo de l'aéroport compte plus qu'il n'y paraît, car un modèle qui décide seul de ses tours peut aussi se tromper, et les faux déclenchements dans une pièce bruyante sont le mode de défaillance.
Un compte de récapitulatif sur X a formulé le contraste avec OpenAI avec plus de précision que la plupart de la couverture en anglais :
"除了有视觉能力外,跟GPT-Live的委派推理方式不同的是 SeedRealtime将声音、画面、时序与表达纳入到同一个模型实时决策,听、看、理解、推理、说话全在一个模型里"
La traduction : au-delà de l'ajout de la vision, la différence avec l'approche de raisonnement délégué de GPT Live est que SeedRealtime place le son, l'image, le minutage et l'expression dans un seul modèle qui décide en temps réel, si bien qu'entendre, voir, comprendre, raisonner et parler vivent tous au même endroit. C'est une description juste du design, et elle provient d'un compte qui résume l'annonce plutôt que de l'avoir testée.
Le seul chiffre que ByteDance a publié
Je suis parti à la recherche d'un tableau de benchmarks et j'ai trouvé une phrase. La seule affirmation quantitative de tout le lancement est que l'évaluation humaine de bout en bout a montré que les problèmes de rythme conversationnel avaient diminué de moitié par rapport aux modèles en cascade, accompagnés de réductions qualitatives des interruptions, de la latence et des faux déclenchements.
Prenez cette affirmation au sérieux, et elle reste maigre sur tous les axes qui permettraient de la vérifier. Aucun nombre d'évaluateurs. Aucune taille d'échantillon. Aucun jeu d'évaluation nommé. Aucun protocole. Et la référence est la catégorie générique « modèles en cascade », pas un concurrent nommé que vous pourriez aller mesurer vous-même. Je ne dis pas que c'est faux. Je dis que c'est une affirmation du fournisseur, et qu'elle devrait être présentée comme telle chaque fois qu'elle est répétée.
Deux autres chiffres circulent dans la couverture, et les deux sont des pièges. Les « 2 à 3 secondes » de la démo de l'espresso sont le conseil du modèle sur l'extraction de l'espresso, pas un chiffre de latence système. Et l'identifiant arXiv qui a circulé comme étant l'article de SeedRealtime, 2508.02193, appartient à autre chose entièrement : Seed Diffusion, un modèle de code à diffusion à états discrets, sans aucun lien avec l'audio ou la vidéo.
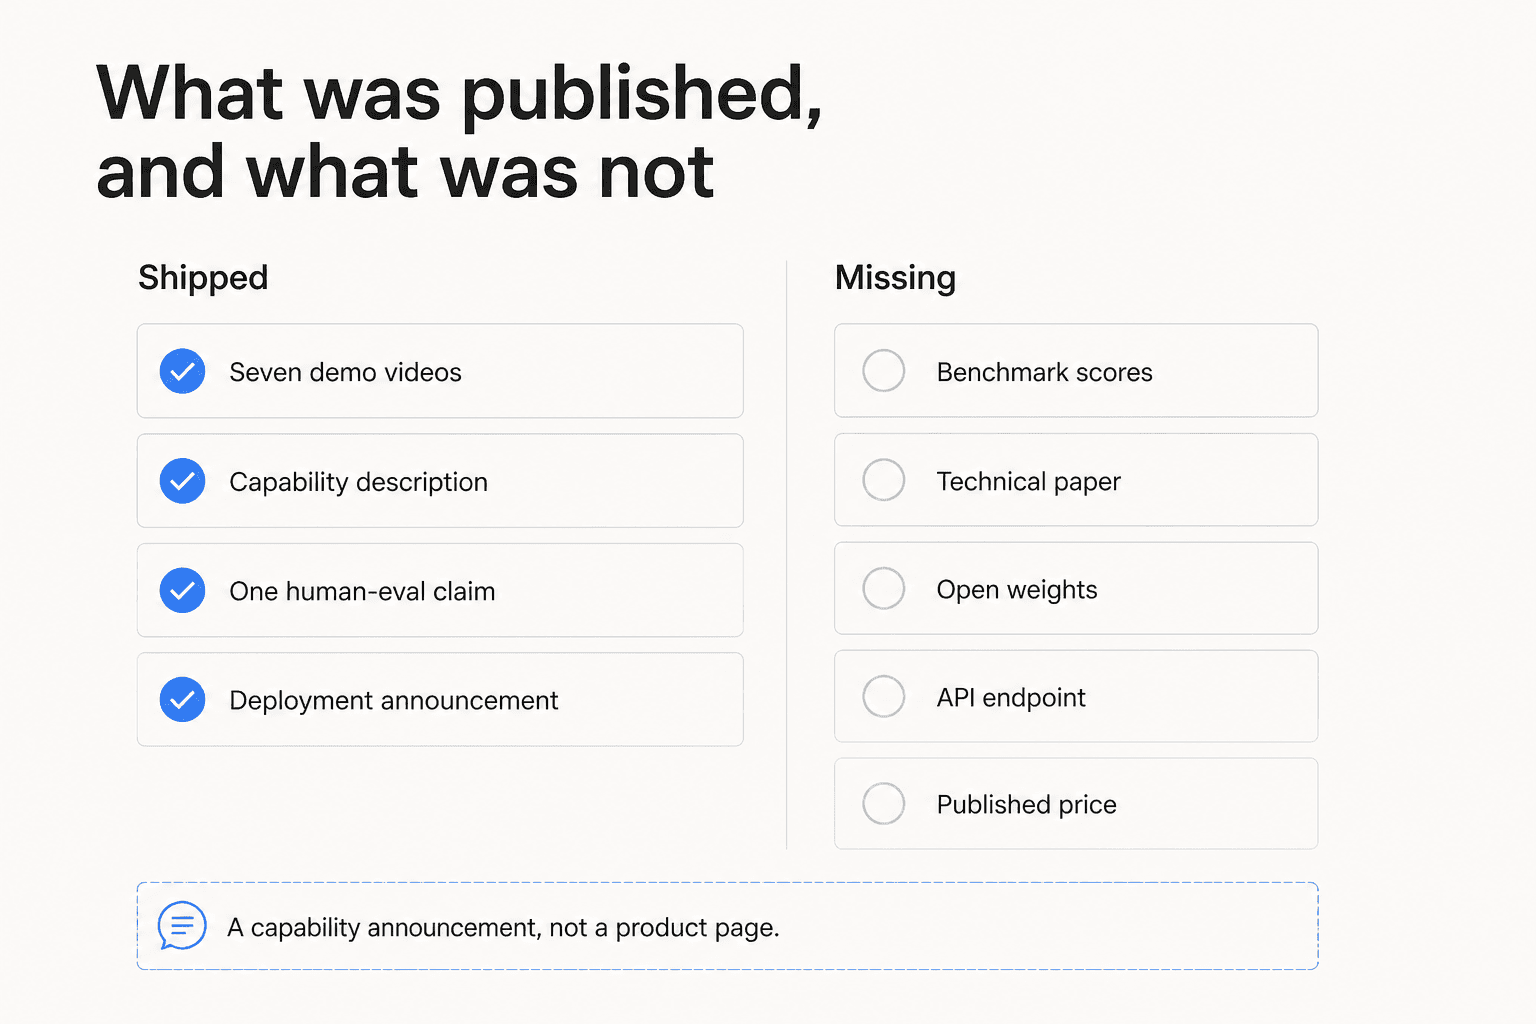
Il n'existe pas d'article SeedRealtime. Une recherche en texte intégral sur arXiv renvoie zéro résultat, avec des recherches témoins qui fonctionnent bien dans la même session. Le signal le plus révélateur vient de l'intérieur même de l'équipe : le chercheur Seed Panwang Pan liste SeedRealtime parmi ses propres travaux sélectionnés avec des liens Project, ModelCard et Blog, et aucun lien vers un article, alors que toutes les autres entrées de cette page en ont un. Les poids sont fermés, sans dépôt ni dans l'organisation GitHub ByteDance-Seed ni sur Hugging Face.
C'est un choix, pas une norme. Kimi K3 est sorti avec un tableau de benchmarks complet. DeepSeek V4 Flash aussi. Qu'un laboratoire chinois publie des scores vérifiables n'a rien d'exceptionnel en 2026.
Le benchmark que personne n'a fait tourner
Voici la découverte qui a redéfini tout l'article pour moi. SeedRealtime n'apparaît nulle part dans le classement voix-à-voix d'Artificial Analysis. Aucun modèle de ByteDance, Doubao, Seed ou Volcengine non plus, sur cinq graphiques et un tableau récapitulatif de 36 lignes, extrait le 18 août 2026. Alibaba Cloud et StepFun y figurent tous les deux, et Qwen domine actuellement deux des trois benchmarks composants, donc « laboratoire chinois, donc absent » n'est pas l'explication.
Cela compte à cause de ce que mesurent les deux benchmarks phares.
Full Duplex Bench évalue la mécanique d'une conversation en direct : ne pas interrompre pendant une pause, prendre correctement son tour, gérer un utilisateur qui coupe la parole, et continuer à travers un « mmh ». C'est exactement ce dont parle l'affirmation de rythme de SeedRealtime. Le plafond est de 98,4 %, détenu par Qwen Audio 3.0 Realtime Plus, et la famille actuelle GPT Realtime se situe dans la bande de 91 à 96 %. Le haut de ce graphique est compressé, ce qui est la façon polie de dire que, parmi les leaders, la dynamique conversationnelle ne distingue plus personne. Gemini 3.1 Flash Live, à 74,3 %, est le seul modèle de pointe qu'il distingue encore.
𝜏-Voice évalue autre chose : la proportion de scénarios de service client reproduits résolus en agissant comme agent de support. Un simulateur d'utilisateur vocal appelle le modèle avec un changement de vol, un paiement contesté, une panne télécom. Chaque tâche a un seul état final valide en base de données, et la notation compare l'état final à la vérité terrain. Cela mesure si le travail a été fait, pas si le modèle a paru serviable. Le plafond y est de 56,5 %, détenu par Grok Voice Think Fast 2.0 High.
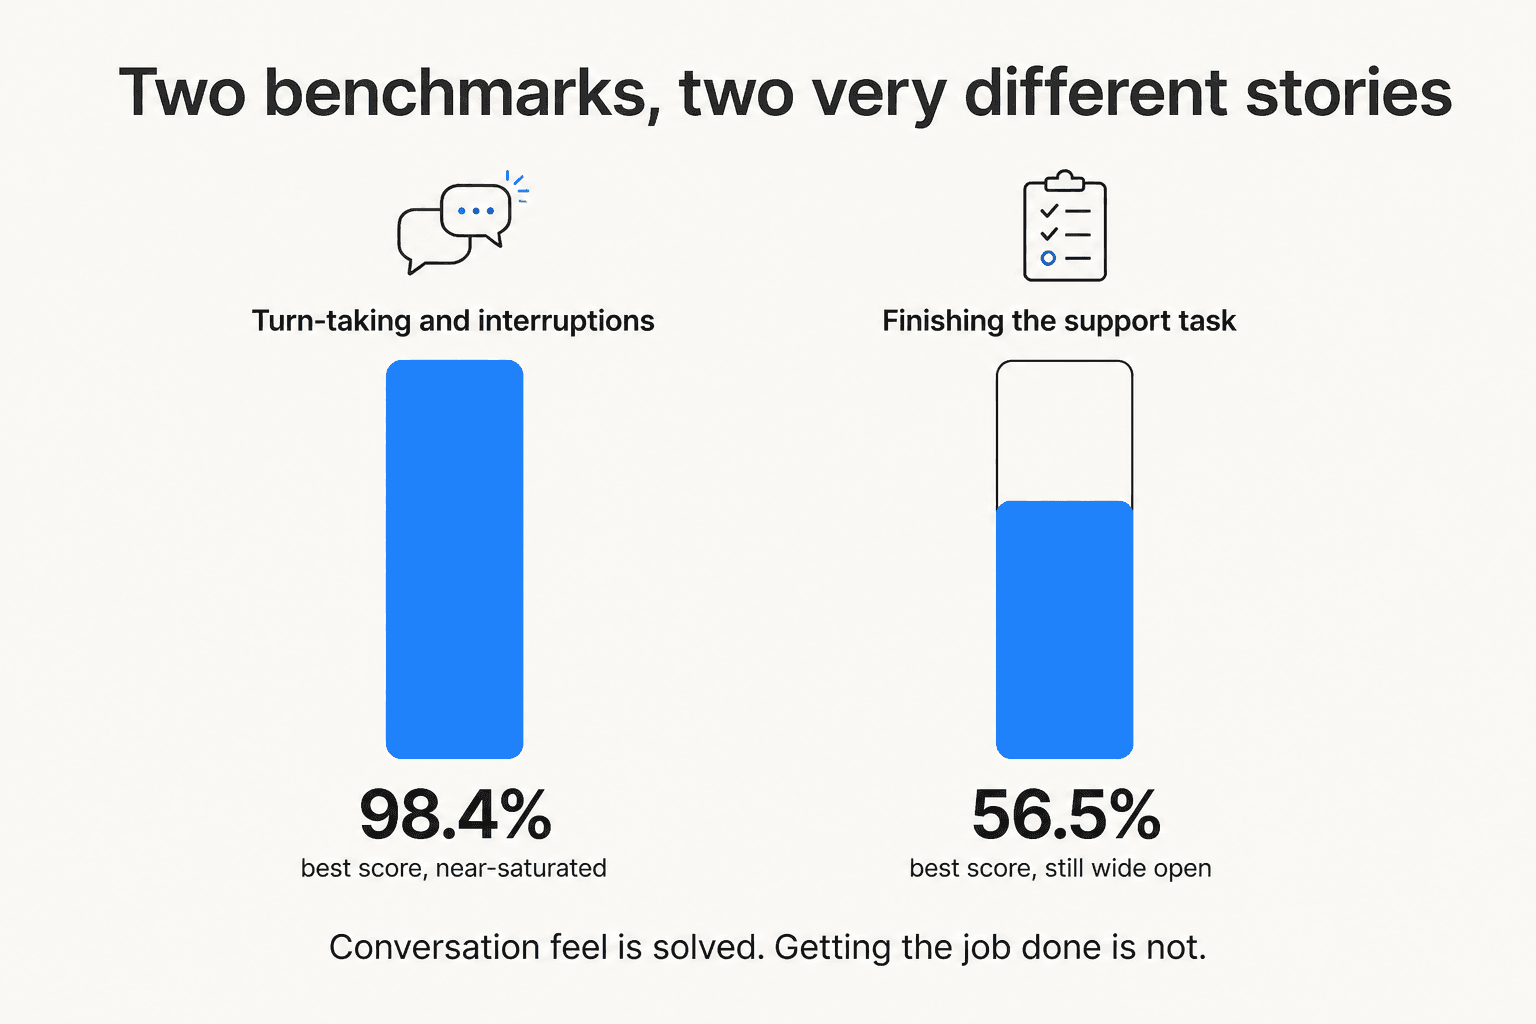
Prenez le temps d'absorber cet écart. Le meilleur agent vocal disponible échoue sur environ 43 % des tâches de support reproduites, tandis que presque tous les modèles de pointe gèrent le rythme de la conversation presque parfaitement. Le secteur a résolu la façon dont une IA vocale sonne, pas si elle termine le travail. Classement complet, pour les modèles mesurés :
| Modèle | Indice S2S | Raisonnement vocal | Dynamique conversationnelle | 𝜏-Voice (tâches accomplies) | Temps jusqu'au premier audio |
|---|---|---|---|---|---|
| Qwen Audio 3.0 Realtime Plus | 84,1 % | 99 % | 98,4 % | 54,6 % | 1,54 s |
| Grok Voice Think Fast 2.0 High | 82,9 % | 97 % | 95,1 % | 56,5 % | 0,70 s |
| GPT-Realtime-2.1 High | 79,1 % | 96 % | 95,7 % | 45,7 % | 1,21 s |
| Qwen Audio 3.0 Realtime Flash | 76,3 % | 96 % | 96,9 % | 35,9 % | 1,55 s |
| Gemini 3.1 Flash Live High | 69,5 % | 97 % | 74,3 % | 37,7 % | 2,99 s |
| Deepslate Opal | 62,8 % | 85 % | 85,7 % | 17,5 % | 0,44 s |
| SeedRealtime | non évalué | non évalué | non évalué | non évalué | non publié |
Notez où se situe le modèle le plus rapide. Deepslate Opal répond en 0,44 seconde et résout 17,5 % des tâches. La latence a cessé d'être le goulot d'étranglement depuis un moment, c'est la même conclusion à laquelle je suis arrivé sous un angle différent dans mon comparatif des modèles pour les tickets de support.
Ce qu'en disent les gens qui l'ont vraiment utilisé
Le signal de la communauté sur ce lancement est maigre et déséquilibré, et c'est en soi instructif. Reddit n'a rien : r/LocalLLaMA discutait activement des options full-duplex pendant la même période et n'a jamais mentionné SeedRealtime, ce qui est attendu quand il n'y a pas de poids à télécharger. Hacker News a une soumission à 1 point et 0 commentaire. LinkedIn, c'est à peu près dix republications du même titre de récapitulatif. C'est X qui porte la vraie réaction.
La voix la plus crédible appartient à quelqu'un qui travaille sur les modèles vocaux au quotidien, et elle fait aussi office de plainte sur l'accès :
"why aren't more people talking about this?? audio-visual native FDX model is impressive, especially its ability to proactively detect and interact with the user based on visual cues.
GPT Live 1 is pure audio-only and doesn't have this capability.
has anyone tried it on Doubao? i don't have a Chinese phone number but really want to try 🥹"
Le compte qui a révélé la nouvelle en anglais a dit la même chose en moins de mots : « I wish it would be testable globally 😬 ».
Le seul témoignage d'usage substantiel que j'ai trouvé est en chinois, et ce qu'il salue n'est pas ce que vend le titre :
"测试让豆包陪我一起看一个Youtube视频,画面出现个人,直接问这人是谁,竟然答对了!画面有个一闪而过的图表,问:"刚才有个图表,你能给我解读下吗?"。它竟然知道我指的是哪个图,并完整解释。"
Il a fait regarder une vidéo YouTube à Doubao avec lui, a demandé qui était une personne à l'écran et a obtenu la bonne réponse, puis a posé une question sur un graphique apparu un instant, et le modèle a su de quel graphique il parlait et l'a expliqué entièrement. C'est de la résolution de référents, pas de la vitesse, et c'est l'affirmation la plus précise et vérifiée que quiconque ait faite sur ce modèle. Une suite montre quelqu'un pointant du doigt un bouton sur un amplificateur physique et obtenant une réponse sensée.
Deux réserves sont apparues, toutes deux venant de comptes isolés à faible audience, à lire donc comme des avis individuels plutôt que comme une tendance de fond. Alex Volkov de ThursdAI, sur le cadrage « gratuit dans Doubao » : « Free or charge... holy surveilance » (la faute de frappe est dans l'original). Et une remarque méthodologique plus acérée sur la démo du dîner :
"holding onto four names through overlapping crosstalk is a harder party trick than watching and listening at the same time, most "multimodal" demos never actually test the crosstalk part."
C'est le bon instinct. Le cas des conversations qui se chevauchent est le cas intéressant, et une bande de démonstration n'est pas un test adversarial.
Peut-on construire dessus ? Le piège des trois noms de modèles
C'est là que la plupart des articles se trompent, donc autant être précis. ByteDance a trois modèles temps réel aux noms prêtant à confusion, et seuls deux d'entre eux sont en vente.
| Modèle | Ce que c'est | Utilisable aujourd'hui ? |
|---|---|---|
| SeedRealtime | Full-duplex audiovisuel natif : audio, vidéo et texte dans un seul modèle | Non. Uniquement dans l'application Doubao. Pas d'API, pas de prix. |
Seeduplex (豆包实时语音模型 3.0, modèle 1.2.6.1) | Full-duplex natif purement vocal, écoute pendant qu'il parle, détection de fin de tour adaptative | Oui, via WebSocket |
| Doubao-Seed-RealtimeVoice (O2.0 / SC2.0) | Half-duplex plus ancien, voix-à-voix purement audio | Oui, mais sa documentation est désormais classée comme héritée |
La version simple : la seule chose que vous pouvez acheter est purement vocale. La vision, qui rend SeedRealtime intéressant, n'est pas en vente. J'ai vérifié la spécification de facturation vocale de Volcengine, qui liste chaque référence vocale achetable, la liste de prix des modèles Ark, et le tableau de prix des produits Doubao. SeedRealtime n'a aucune ligne sur aucun d'entre eux, ni en prépayé ni en postpayé. Toute référence à sa disponibilité se situe côté application.
La documentation de Volcengine note aussi que les versions O et SC de l'ancien modèle ont arrêté leur itération indépendante, leurs capacités convergeant vers la ligne 2.0. Donc si vous démarrez aujourd'hui, c'est Seeduplex qu'il faut utiliser comme base.
Ce que coûte vraiment Seeduplex
Le modèle temps réel que l'on peut acheter est facturé au token, pas à la minute, et uniquement en postpayé. C'est la seule référence vocale sans aucun forfait de ressources prépayé dans toute l'échelle de remises de Volcengine, ce qui signifie que vous payez le tarif catalogue quel que soit votre volume. Tarifs ci-dessous, convertis à 6,74 ¥ pour un dollar (USD/CNY 6,7411, 17 août 2026) ; Volcengine facture uniquement en yuans.
| Compteur | Prix (CNY) | Environ en USD |
|---|---|---|
| Entrée, texte | 10 ¥ / M de tokens | 1,48 $ / M |
| Entrée, audio | 80 ¥ / M de tokens | 11,87 $ / M |
| Entrée, mise en cache (texte ou audio) | 5 ¥ / M de tokens | 0,74 $ / M |
| Sortie, texte | 80 ¥ / M de tokens | 11,87 $ / M |
| Sortie, audio | 300 ¥ / M de tokens | 44,51 $ / M |
Volcengine publie la conversion audio-vers-token, ce qui rend la comparaison avec un tarif à la minute possible : l'audio en entrée tourne à environ 6,25 tokens par seconde, l'audio en sortie à environ 25 tokens par seconde. Faites le calcul et la forme de la facture devient évidente.
| Unité dérivée | CNY | USD |
|---|---|---|
| 1 minute de parole utilisateur, en entrée | 0,030 ¥ | 0,0045 $ |
| 1 minute de parole du modèle, en sortie | 0,450 ¥ | 0,067 $ |
| 1 heure de dialogue, répartition égale, audio seul | 14,40 ¥ | 2,14 $ |
| 1 heure de parole continue du modèle | 27,00 ¥ | 4,01 $ |
Ces lignes dérivées sont mon propre calcul à partir de la conversion annoncée par ByteDance, pas un tarif à la minute publié, et une facture réelle sera plus élevée car chaque tour de parole porte aussi des tokens de texte et le contexte qui s'accumule. L'exemple calculé par Volcengine lui-même fixe le prix d'un seul échange de 40 secondes à 0,0974 ¥, environ 0,014 $.
Pour situer si c'est cher : OpenAI affiche l'audio de GPT Realtime à 32 $ par million de tokens en entrée et 64 $ par million en sortie, tandis que le Gemini 3.1 Flash Live de Google se situe à 3,00 $ en entrée et 12,00 $ en sortie par million, soit environ 0,005 $ et 0,018 $ par minute. ByteDance se situe entre les deux en entrée et au-dessus de Google en sortie, et mon comparatif des prix de Gemini donne la grille complète de Google. Les prix de GPT Realtime Mini couvrent le palier moins cher d'OpenAI.
Le levier est juste là, dans le tableau. L'audio en sortie coûte quinze fois plus par seconde que l'audio en entrée, donc la plus grande chose que vous contrôlez est la quantité de parole du modèle. Une réserve sur la grille tarifaire elle-même : le tableau indique le texte en sortie à 80 ¥ par million de tokens, mais l'exemple calculé sur la même page le compte à 30 ¥, et seul 30 ¥ se recoupe avec le total annoncé. Traitez cette ligne comme non résolue jusqu'à ce que vous ayez vu une vraie facture.
Les détails d'accès qui déterminent si c'est utilisable pour vous
Le coût est la partie facile. Le reste est plein de friction, et ça vaut la peine de la lister clairement, car rien de tout cela n'apparaît dans l'annonce.
- WebSocket uniquement, à
wss://openspeech.bytedance.com/api/v3/duplex/realtime/dialogue, avec un unique en-têteX-Api-Keyetmodelfixé à1.2.6.1. - Dans le style d'OpenAI-Realtime, mais pas compatible OpenAI. Les noms d'événements sont repris (
session.create,conversation.item.create,response.cancel), mais c'est le point de terminaison de Volcengine avec l'authentification de Volcengine. Familier à lire, mais pas un remplacement direct, ce qui est une situation différente de celle décrite dans mon guide sur l'API Realtime et WebRTC. - Des plafonds que l'argent ne permet pas de dépasser. 60 sessions par minute, 100 000 tokens par minute, et le modèle temps réel est absent du tableau d'options de concurrence qui couvre la synthèse vocale et la reconnaissance vocale. Relever les limites passe par les ventes.
- Pensé d'abord pour le chinois, et la documentation le dit. Une page indique un support du chinois et de l'anglais ; la section des limitations sur la même page indique que le modèle de bout en bout n'a qu'un bon support du chinois et ne garantit pas la qualité dans les autres langues. Quatre voix chinoises premium, trois voix en anglais américain disponibles seulement sur une ancienne version du modèle.
- En pratique, un compte en Chine continentale. Tarification uniquement en yuans, une région fixe cn-beijing, une activation de service explicite, et une modération de contenu activée par défaut.
- Le contexte est de 12K au total, couvrant le prompt système plus l'historique de la conversation.
Pour une équipe de support hors de Chine, cette liste est la réponse. Ce n'est pas encore une décision de plateforme.
Ce que cela signifie si vous voulez mettre de l'IA sur une file d'attente de support
Je construis des agents IA pour les helpdesks, laissez-moi donc être direct sur pourquoi rien de tout cela ne change ma semaine.
La raison pour laquelle un déploiement de support échoue n'est presque jamais que la prise de tour de parole de l'IA semblait rigide. C'est que l'IA a répondu avec assurance et à tort, ou qu'elle a répondu à un ticket qu'elle aurait dû transférer à un humain, ce qui est un problème de conception de l'escalade. Un client, une équipe danoise de télématique automobile sur Zendesk traitant environ 200 tickets par mois et montant vers 2 000, est tombé exactement là-dessus : leur base de connaissances disait qu'ils supportaient tous les modèles, donc le bot confirmait joyeusement la prise en charge de marques de voitures qui n'étaient même pas dans la base. Rien dans un rythme conversationnel plus fluide ne règle cela. Un meilleur retrieval et ancrage, si.
La deuxième raison, c'est le contrôle, et c'est de loin l'objection la plus commune que j'entends. Un responsable CX d'une marque de compléments alimentaires DTC sur Gorgias et Shopify, traitant environ 7 000 tickets par mois pour 30 000 commandes, me l'a formulé ainsi :
"The AI will never be able to answer 100% of the questions, but if it tries and just answers 'sorry I don't know this,' I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer, then the point is a little bit gone. I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
C'est un problème de 𝜏-Voice en habits de tous les jours. Il parle des 43 %. Un modèle qui obtient 98,4 % en dynamique conversationnelle et 56,5 % en accomplissement des tâches est, de son point de vue, un collègue très poli qui se trompe quatre fois sur dix et ne le dit jamais. C'est pourquoi le levier utile, ce sont les seuils de confiance et un chemin d'escalade clair, pas un modèle plus rapide.
Donc une lecture pratique de SeedRealtime, si vous travaillez dans le support :
- N'attendez pas. Pas d'API, pas de prix, pas de benchmark, une application chinoise seulement. Ce n'est pas une option d'achat.
- Surveillez l'axe de la vision, pas l'axe du duplex. Résoudre « ce graphique de tout à l'heure » à partir de ce qui est affiché à l'écran est une vraie nouvelle capacité, et elle arrivera d'abord dans le support par partage d'écran et le dépannage visuel, pas dans les files d'attente téléphoniques.
- Jugez chaque modèle vocal sur l'accomplissement des tâches. Demandez à chaque fournisseur son score 𝜏-Voice. S'il n'y en a pas, voilà la réponse. Mon panorama de l'IA pour le support vocal passe en revue ceux qui sont mesurés, et l'IA qui répond aux appels de support couvre le côté opérationnel.
- Commencez là où se trouve le volume. La plupart des files d'attente restent majoritairement textuelles, et le seul tri des tickets rapporte plus qu'un pilote vocal, pour une fraction du risque. La déflexion de tickets est l'autre chose à faire en premier.
Pour le panorama plus large, le comparatif des meilleurs logiciels de helpdesk IA couvre ce qui sort vraiment cette année.
Si vous en êtes encore à comprendre ce que font ces agents, logiciel de service client IA est l'introduction à la catégorie.
Essayer eesel
Si vous évaluez tout cela pour une vraie file d'attente de support, la question qui décide vraiment du résultat n'est pas quel modèle regarde votre caméra. C'est de savoir si la chose sera juste sur vos tickets, en utilisant votre centre d'aide et vos conversations passées, avant qu'un client ne la rencontre.
C'est la partie autour de laquelle eesel est construit. Il se connecte au helpdesk que vous utilisez déjà, apprend de vos macros existantes et de votre historique de tickets plutôt que d'avoir besoin d'une nouvelle base de connaissances, et rejoue vos vrais tickets passés en simulation pour que vous voyiez le taux de résolution et les réponses exactes avant que quoi que ce soit ne passe en production. Vous définissez les types de tickets qu'il touche et où il transfère, si bien que le problème du « laissez le reste tranquille » évoqué plus haut devient un réglage plutôt qu'un espoir. C'est gratuit à essayer, et vous pouvez voir des résultats simulés sur votre propre historique dès cet après-midi.

La voix full-duplex arrivera un jour dans le support, et quand ce sera le cas, les modèles qui gagneront seront ceux capables de prouver un chiffre d'accomplissement des tâches. En attendant, c'est le travail peu spectaculaire consistant à ancrer un agent de support IA dans vos propres connaissances qui fait le taux de résolution.