

La meilleure alternative à Qwen 4 Max pour la plupart des tâches de code et d'agents est Claude Sonnet 5.5, à 2 $/10 $ par million de tokens, avec Claude Opus 5.5 pour les tâches difficiles et DeepSeek V4.1 Flash (0,15 $/0,60 $ hors pointe) pour le travail en masse. Mais vérifiez un point avant de changer : Alibaba a lancé le GA qwen4-max le 16 novembre, à 1,50 $/4,50 $. Si la préversion vous plaisait, changer un seul ID de modèle coûte moins cher que n'importe quel autre changement.
Si la préversion faisait tourner un bot de support, eesel fait ce travail sans que vous ayez à choisir un modèle, et la CLI eesel permet à un agent de code de charger votre documentation d'aide et de tester des réponses avant la mise en ligne.
Que se passe-t-il pour Qwen 4 Max le 25 novembre ?
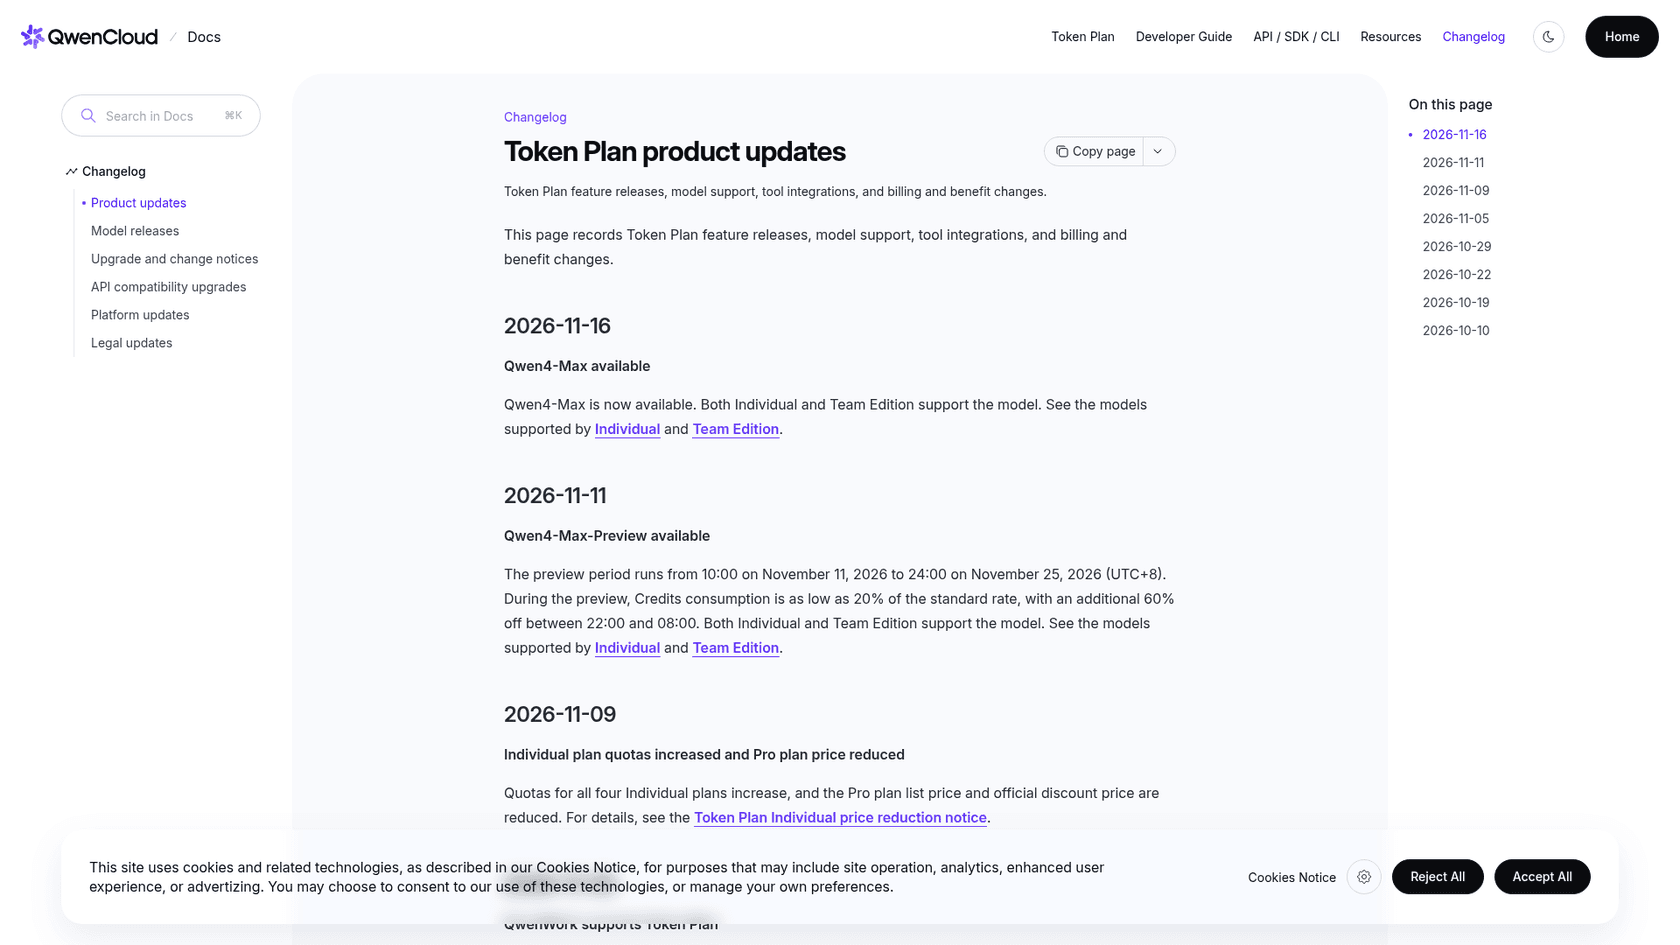
La préversion s'arrête. Le changelog Token Plan d'Alibaba indique que qwen4-max-preview tourne du 11 novembre 10h00 au 25 novembre 2026 24h00 (UTC+8), et la documentation Token Plan précise que le modèle sera retiré à la fin de la préversion. Tout agent, script ou configuration Claude Code qui pointe encore vers cet ID cesse de fonctionner le 26.
Ce que la plupart des articles manquent, c'est l'entrée suivante du même changelog. Le 16 novembre, Alibaba a mis qwen4-max en disponibilité générale (GA) sur Token Plan Personal, Token Plan Team et l'API à l'usage. La question n'est donc plus « Qwen ou autre chose », mais « le Qwen GA, ou quelque chose de mieux pour ma charge de travail ».
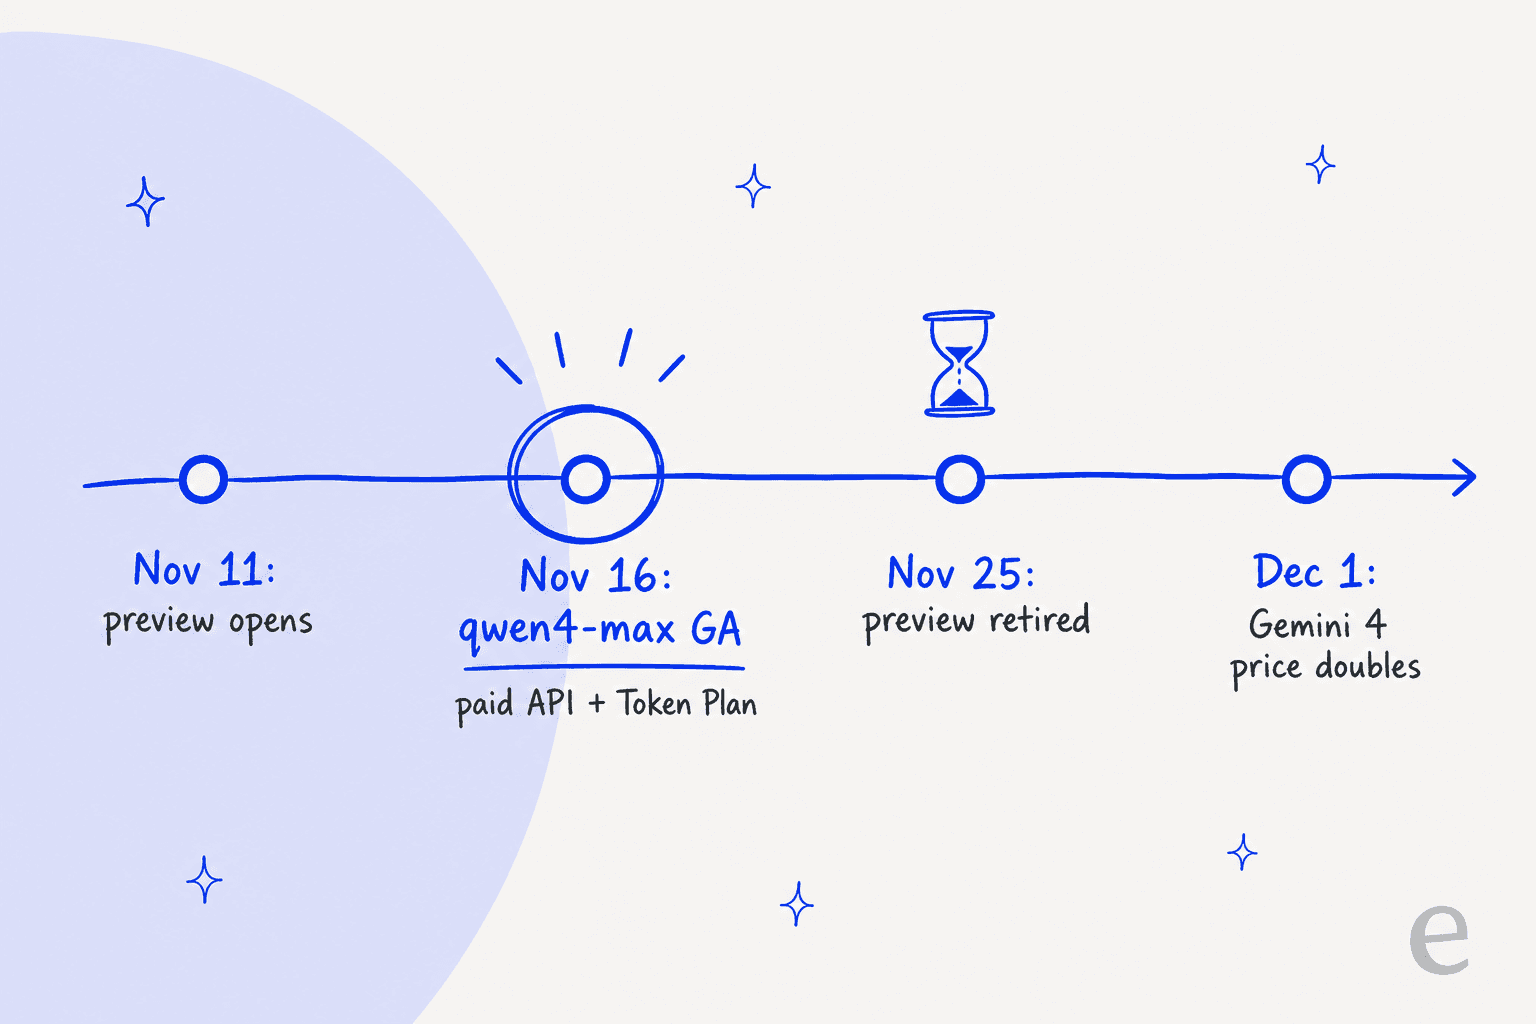
Cette dernière échéance compte aussi. Deux des alternatives ci-dessous, Gemini 4 Argon et Gemini 4 Carbon, ont des prix de lancement qui doublent le 1er décembre, donc une décision prise sur la grille tarifaire de cette semaine peut changer deux fois en deux semaines.
Je suis Alicia, et je conçois des fonctionnalités et des agents IA chez eesel. Nous faisons tourner des modèles derrière de vraies files de support depuis des années, et la leçon de chaque migration forcée est la même : le modèle vers lequel vous passez compte moins que le fait de l'avoir testé d'abord sur votre propre travail. Chaque choix ci-dessous vient avec le prix pour un acheteur défini, pour que vous puissiez les comparer sur un seul chiffre avant de tester.
Devriez-vous simplement passer au qwen4-max GA ?
Pour la plupart des personnes qui aimaient la préversion, oui. Voici ce qui change entre les deux modèles, tiré de la documentation Qwen4-Max d'Alibaba :
| qwen4-max-preview | qwen4-max (GA) | |
|---|---|---|
| Statut | Retiré après le 25 nov. | Disponibilité générale depuis le 16 nov. |
| Où vous pouvez l'utiliser | Token Plan uniquement | Token Plan Personal, Token Plan Team, API à l'usage |
| Prix | Crédits à 20 % du tarif standard (8 % la nuit) | 1,50 $ entrée / 4,50 $ sortie par 1 M de tokens (Singapour) |
| Fenêtre de contexte | 1 M de tokens | 1 M de tokens |
| Réflexion + réponse max | 393 216 tokens | 262 144 tokens |
| Effort de raisonnement | low, medium, xhigh | low, high (par défaut), xhigh |
| Outils de code | Claude Code via Token Plan | Claude Code, Codex, OpenCode |
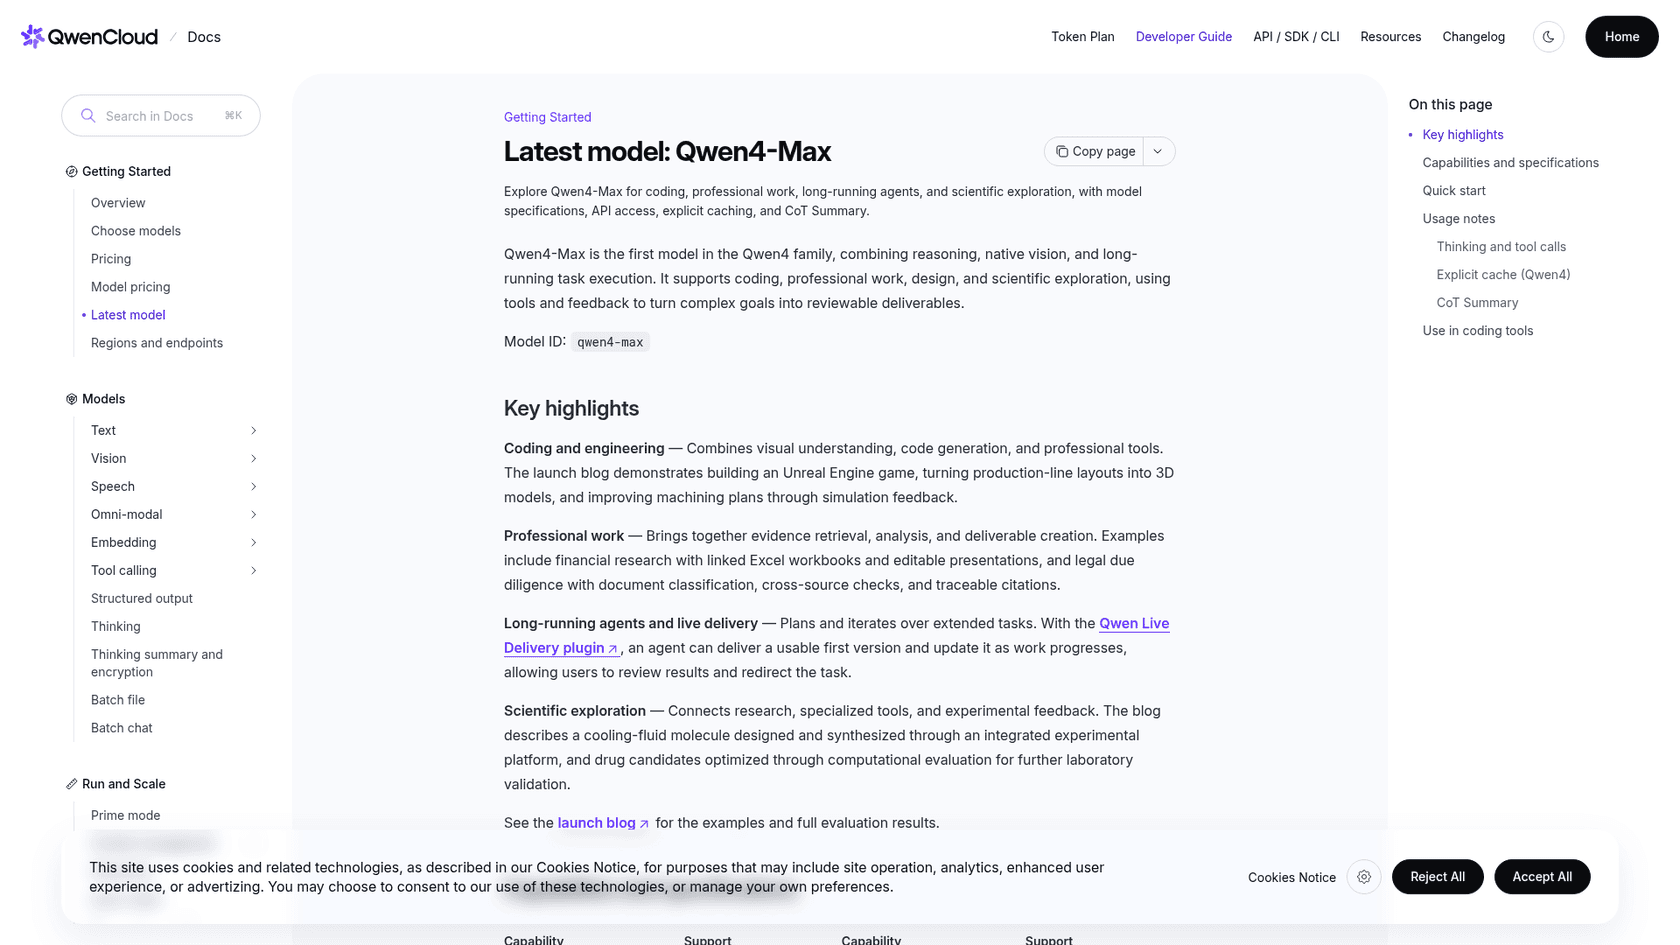
Trois choses ressortent. D'abord, le modèle GA est moins cher que Qwen3.8-Max : Alibaba affiche qwen3.8-max à 2 $/6 $ à Singapour contre 1,50 $/4,50 $ pour qwen4-max, le fleuron le plus récent est donc aussi le moins cher. Ensuite, le modèle GA ajoute un cache explicite avec un TTL de 5 minutes ou 1 heure et des lectures de cache à 0,075 $. Enfin, vous perdez la réduction de la préversion. Les utilisateurs de Token Plan ne payaient que 20 % du tarif standard de crédits pendant la préversion, et 8 % la nuit, selon l'aperçu de Token Plan. Cet accord ne se poursuit pas, attendez-vous donc à ce que les crédits s'épuisent plusieurs fois plus vite pour le même travail.
La migration elle-même tient en une ligne. Dans la configuration Claude Code que nous avons documentée la semaine dernière, l'emplacement Opus pointait vers qwen4-max-preview ; remplacez-le par qwen4-max et gardez la même clé et le même point de terminaison Token Plan. Si la sortie est tronquée, vérifiez max_completion_tokens, car le modèle GA plafonne réflexion plus réponse à 262 144 tokens.
Quand devriez-vous partir plutôt ? Quand la préversion n'a jamais mérité sa place. Alibaba n'a toujours pas publié de résultats de benchmarks indépendants dans sa documentation au-delà du blog de lancement, et le ressenti de la communauté pendant la préversion était mitigé :
"No benchmarks yet. The smaller Qwen models are extremely popular for people running things locally, yet I don't know absolutely anyone running Qwen Max."

"It's preview; Qwen4-max-preview. It's not disappointing at all, at least so far in my one-shots, but more testing is going on and i'll have a clear answer."
Si vous étiez sur la préversion surtout pour la réduction de 80 %, ou si vous avez besoin d'un fournisseur hors d'Alibaba Cloud, continuez votre lecture.
Comment j'ai choisi et tarifé ces alternatives
J'ai choisi des modèles qui couvrent les trois mêmes usages pour lesquels les gens utilisaient la préversion de Qwen 4 Max : le code agentique dans des outils comme Claude Code, le travail à contexte long sur une fenêtre de 1 M, et l'appel d'outils dans des agents multi-étapes. Chaque prix vient de la page tarifaire propre au fournisseur, vérifiée le 17 novembre 2026.
Pour rendre les prix par token comparables, j'ai tarifé chaque modèle pour un acheteur : un développeur qui utilise 10 M de tokens en entrée et 1 M en sortie par mois, au tarif public standard, sans remise de cache ni de lot. Cela correspond à peu près à un mois chargé de travail d'agent en solo. Le cache change beaucoup la donne pour les boucles d'agents, donc le calculateur plus bas vous permet d'ajouter votre propre taux de succès de cache.
Alternatives à Qwen 4 Max en un coup d'œil
| Modèle | Idéal pour | Entrée / sortie par 1 M | Lecture de cache par 1 M | Coût mensuel (10 M en entrée, 1 M en sortie) | Contexte | Poids ouverts | Option d'abonnement | Changement de prix à venir |
|---|---|---|---|---|---|---|---|---|
| Claude Sonnet 5.5 | Modèle de code au quotidien | 2 $ / 10 $ | 0,10 $ | 30 $ | 1 M | Non | Plans Claude | Non |
| Claude Opus 5.5 | Tâches d'agents difficiles | 4 $ / 20 $ | 0,20 $ | 60 $ | 1 M | Non | Plans Claude | Non |
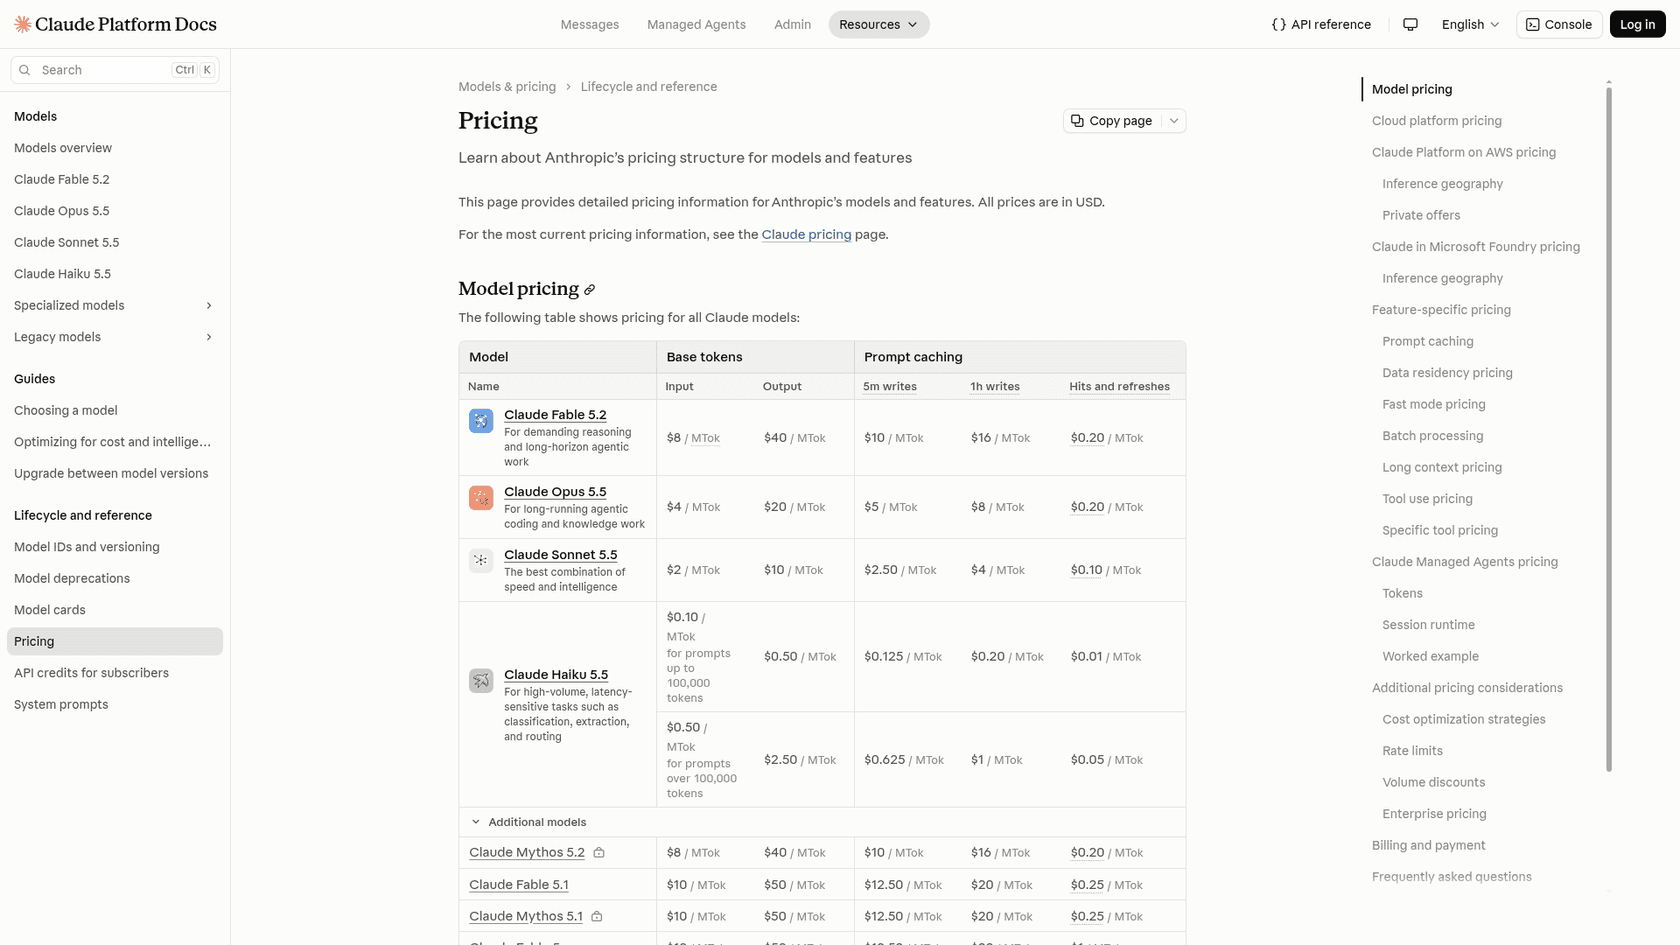
| Claude Fable 5.2 | Les tâches les plus difficiles | 8 $ / 40 $ | 0,20 $ | 120 $ | 1 M | Non | Crédits d'usage sur Pro | Non |
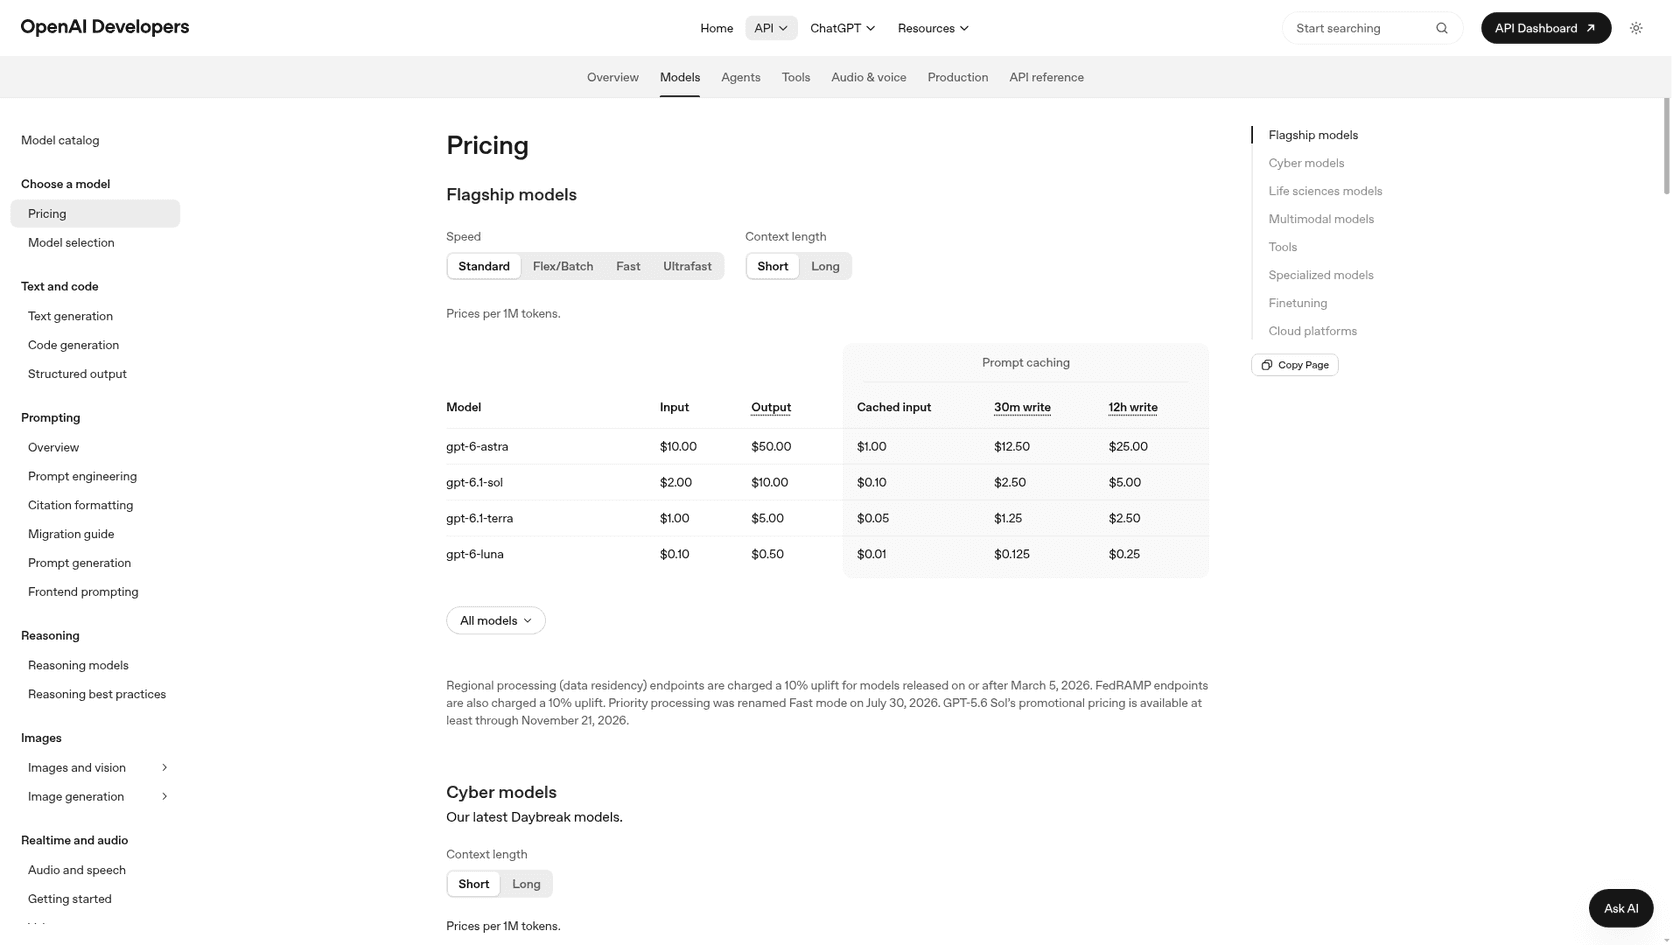
| GPT-6.1 Terra | Travail de frontière à bas coût | 1 $ / 5 $ | 0,05 $ | 15 $ | Au-delà de 272K coûte 2x l'entrée | Non | Plans ChatGPT | Non |
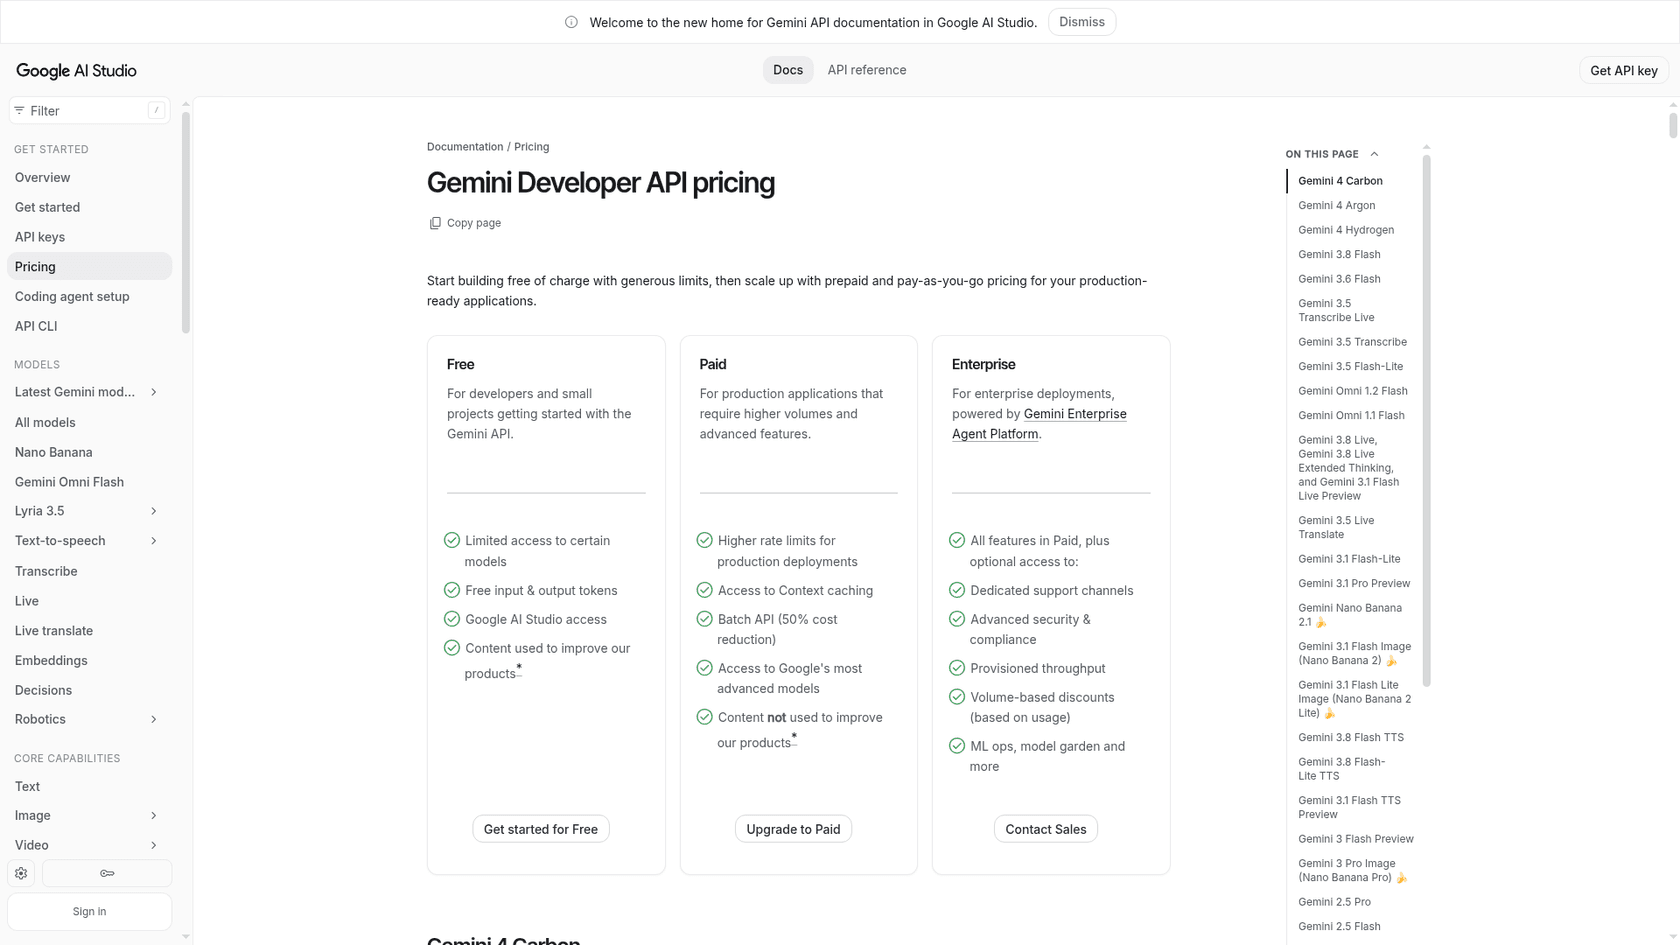
| Gemini 4 Argon | Travail rapide avec Gemini 4 | 2 $ / 10 $ | 0,10 $ | 30 $ (60 $ dès le 1er déc.) | 1 M | Non | Non | Double le 1er déc. |
| Gemini 4 Carbon | Agents de long terme | 2 $ / 10 $ | 0,10 $ | 30 $ (60 $ dès le 1er déc.) | 1 M | Non | Non | Double le 1er déc. |
| DeepSeek V4.1 Flash | Travail en masse et économique | 0,15 $ / 0,60 $ hors pointe | 0,003 $ | 2,10 $ (4,20 $ en pointe) | 1 M | Oui | Aussi sur Token Plan | Non |
| Kimi K3.1 Pro | Option de frontière non américaine | 2 $ / 10 $ | 0,20 $ | 30 $ | 1 M | Non | 19 $ à 199 $/mois | Non |
| Qwen3.8-Max | Rester sur Token Plan | 2 $ / 6 $ | 0,25 $ | 26 $ | 1 M | Non | Token Plan | Non |
| qwen4-max (GA, pour référence) | Même modèle, inchangé | 1,50 $ / 4,50 $ | 0,075 $ | 19,50 $ | 1 M | Non | Token Plan | Non |
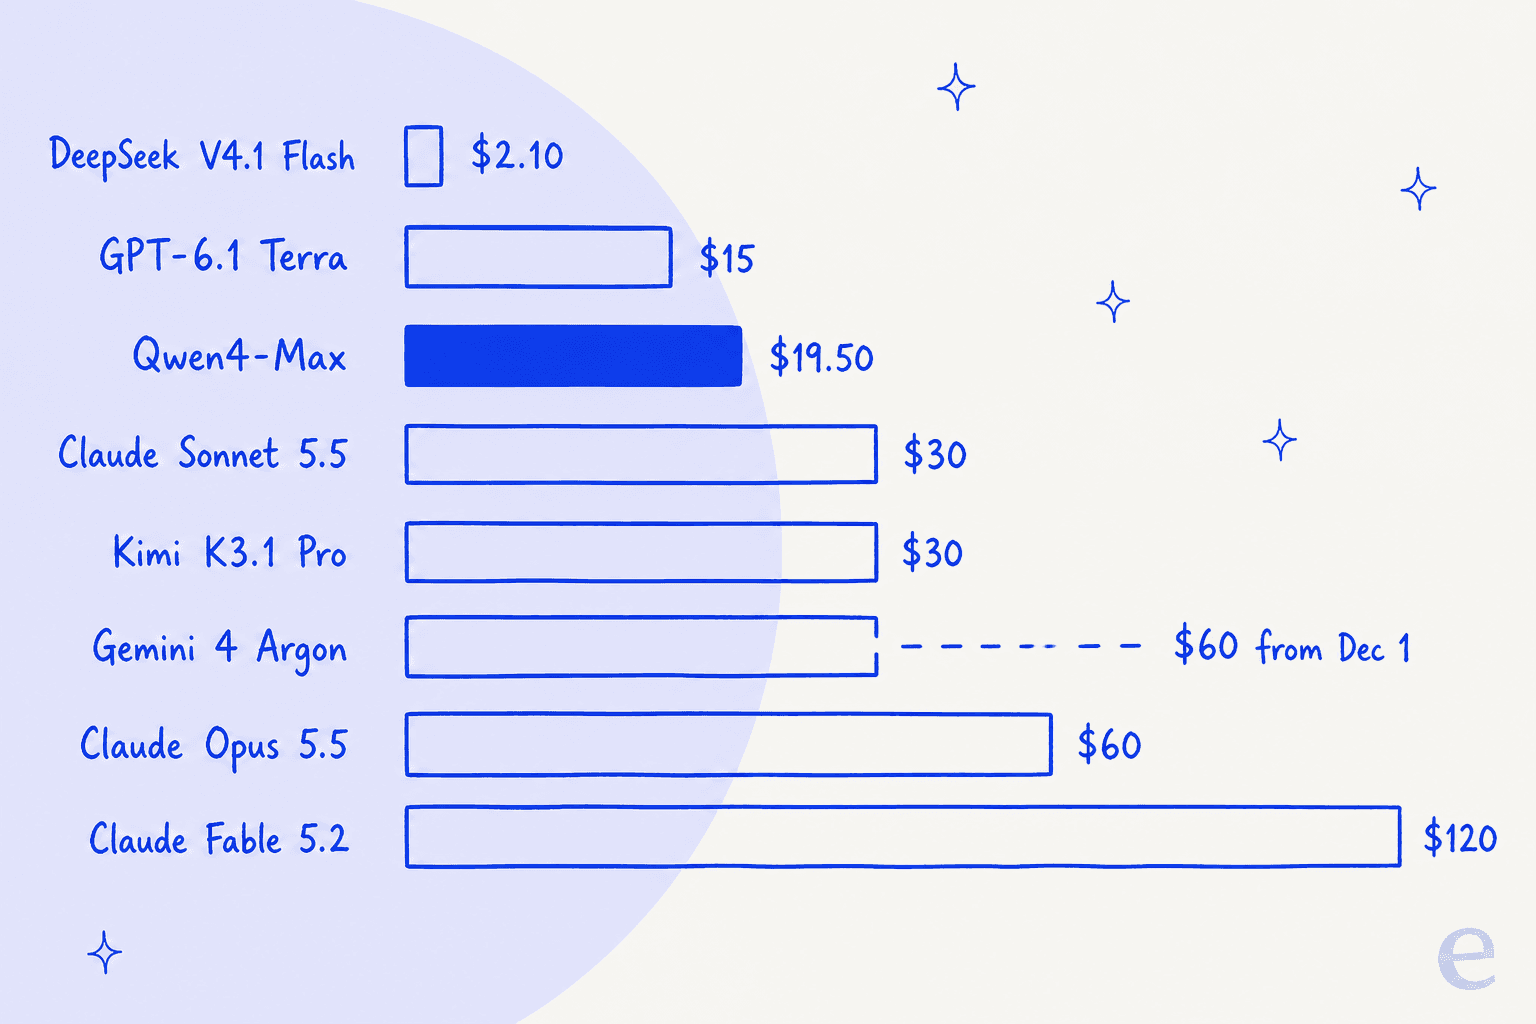
Le graphique est la surprise que la plupart des personnes qui changent n'attendent pas : seules deux alternatives sont moins chères que le GA Qwen 4 Max au tarif public. Tout le reste coûte plus cher par mois, donc un changement doit se justifier par la qualité, le risque fournisseur ou l'outillage, pas par les économies.
Calculez votre propre coût mensuel
L'acheteur 10 M/1 M est un repère. Entrez votre propre volume et votre taux de succès de cache ci-dessous. L'entrée en cache est facturée au tarif de lecture de cache de chaque fournisseur ; les remises d'écriture de cache et de lot sont laissées de côté pour garder la comparaison simple.
Essayez un taux de succès de cache de 70 %, normal pour un agent qui renvoie le même prompt système et le même contexte de dépôt à chaque tour. Claude Sonnet 5.5 passe de 30 $ à environ 16,70 $, et qwen4-max passe à environ 9,53 $, donc l'écart se réduit à environ 7 $.
Pourquoi quitter Qwen 4 Max ?
Pour être honnête envers Alibaba, le modèle GA corrige la plupart des problèmes de la préversion : il a un vrai prix par token, une API à l'usage, et le support dans Claude Code, Codex et OpenCode. Les raisons pour lesquelles les gens partent malgré tout sont plus précises :
- La réduction était l'attrait. À 20 % du tarif standard, la préversion était quasi gratuite pour les gros utilisateurs. Un commentateur de HN a résumé l'attrait ainsi : "By November 25th, Beijing time daytime (8am-22pm) -80%, and at night (Western daytime) even -92%!" (linzhangrun, Hacker News). Aux tarifs GA, les autres modèles redeviennent compétitifs sur le prix.
- Peu de preuves publiques. Aucune entrée indépendante de classement n'était disponible pour
qwen4-maxau moment de ma vérification, donc les équipes qui ont besoin de chiffres avant la production ont peu de matière. - Concentration chez un fournisseur. Token Plan Personal est vendu depuis Singapour et, selon notre article sur les tarifs, est pensé pour un usage interactif, pas pour l'automatisation backend. Si vous avez besoin d'un second fournisseur de toute façon, c'est un bon moment pour en choisir un.
- Un plafond de sortie plus court. Le plafond réflexion plus réponse du modèle GA, à 262 144 tokens, est inférieur aux 393 216 de la préversion, ce qui compte pour les générations très longues en un seul coup.
La façon dont la plupart des gens devraient voir les choses, ce n'est pas un remplacement unique mais trois emplacements. ChatGPT a donné le même conseil quand je lui ai posé exactement cette question : un modèle quotidien, un modèle d'escalade et un modèle économique.
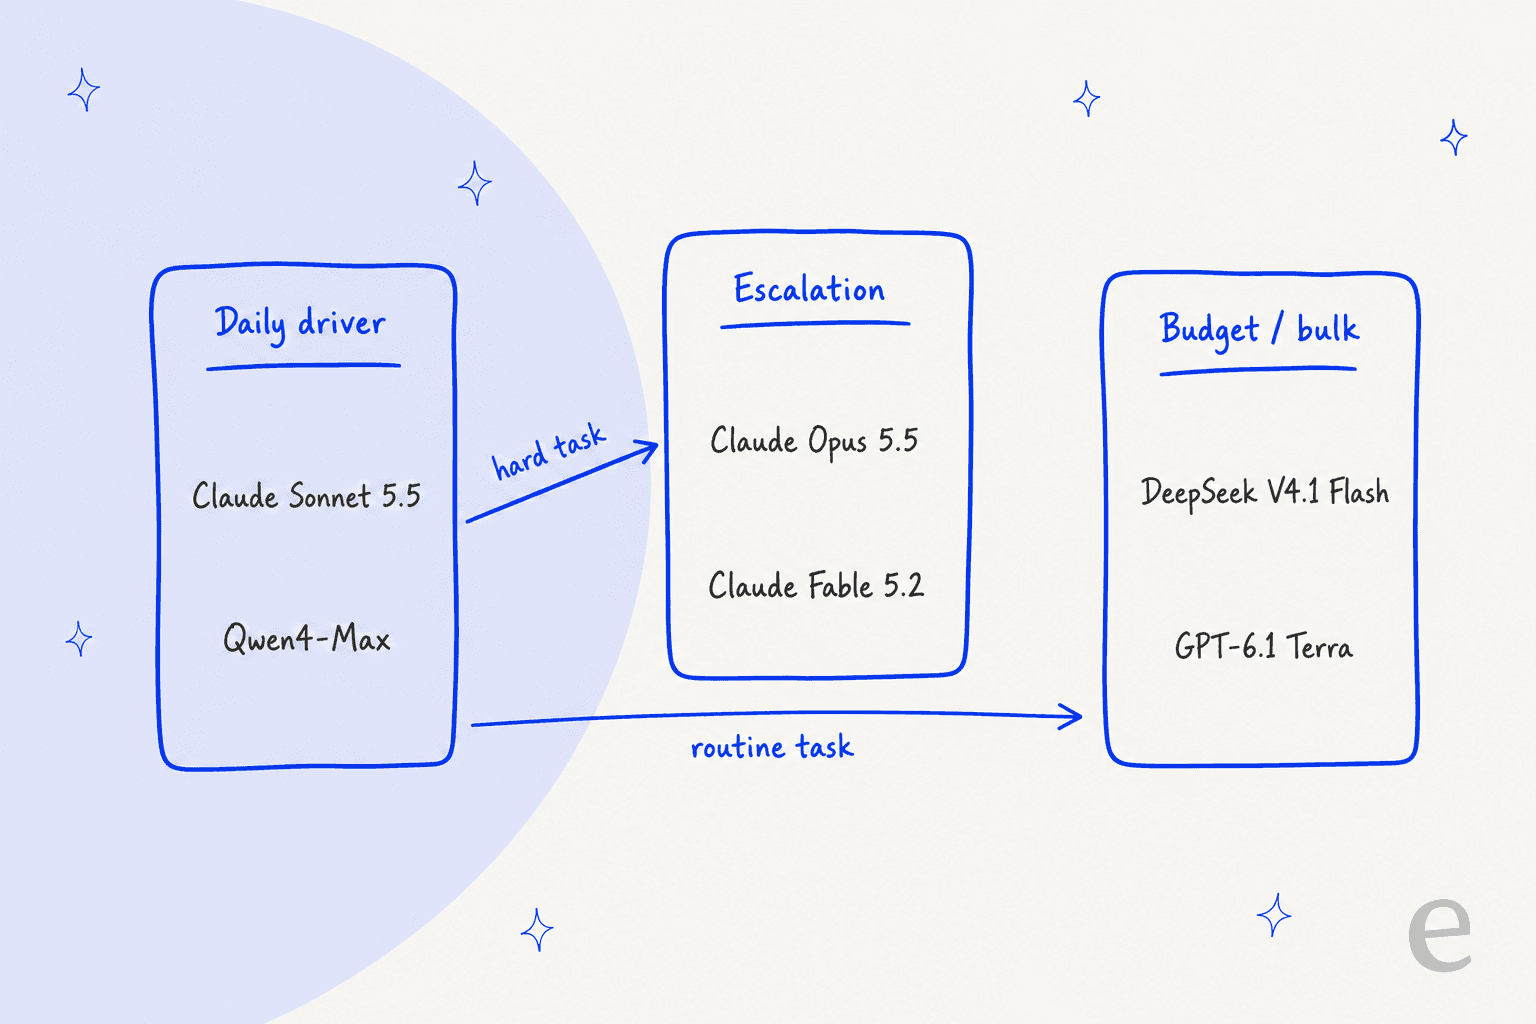
1. Claude Sonnet 5.5
Idéal pour : votre modèle de code et d'agents au quotidien, surtout dans Claude Code.
Ce qu'il fait bien
Sonnet 5.5 est le remplacement le plus proche de la façon dont la plupart des gens utilisaient la préversion de Qwen 4 Max : un bon codeur agentique avec une fenêtre de contexte de 1 M de tokens. La page Sonnet d'Anthropic dit qu'il tourne 30 % plus vite et coûte jusqu'à 30 % moins cher que Sonnet 5 pour la plupart des tâches. Si votre configuration était Claude Code pointant vers le point de terminaison d'Alibaba, c'est le modèle autour duquel Claude Code a été conçu, donc l'appel d'outils et les modifications de fichiers se comportent comme le harnais s'y attend.
Avantages
- Même prix de
2 $/10 $sur toute la fenêtre de 1 M, sans surcoût de contexte long - Lectures de cache à
0,10 $par million, moins cher qu'Opus 5.5 et Fable 5.2 - Inclus dans le plan Claude gratuit pour l'usage en chat
Inconvénients
- À effort maximal, Artificial Analysis l'a mesuré à
7,60 $par tâche, plus que les5,98 $d'Opus 5.5, selon notre analyse des tarifs de Sonnet 5.5 30 $par mois pour l'acheteur 10 M/1 M, environ 50 % de plus que le GAqwen4-max
Tarifs
2 $ en entrée et 10 $ en sortie par million de tokens, 0,10 $ pour les lectures de cache, selon la page tarifaire d'Anthropic. Pour l'acheteur 10 M/1 M : 10 x 2 $ + 1 x 10 $ = 30 $ par mois.
Notre avis : choisissez Sonnet 5.5 par défaut si vous voulez un modèle qui fonctionne simplement dans Claude Code. Gardez-le en effort Low ou Medium, et escaladez vers Opus 5.5 plutôt que de monter Sonnet à Max.
2. Claude Opus 5.5
Idéal pour : les 10 % de tâches les plus difficiles : refactorisations sur tout un dépôt, débogage délicat, longues exécutions autonomes.
Ce qu'il fait bien
Opus 5.5 est l'emplacement d'escalade. Anthropic affirme sur sa page Opus qu'il performe au niveau de Claude Fable 5.1 sur la plupart des tâches et coûte 40 % moins cher à faire tourner qu'Opus 5, en partie parce qu'il finit avec moins de tokens et de tours. Ce dernier point compte pour les agents : le prix par token n'est que la moitié de la facture, et la critique d'Opus 5.5 détaille à quel point le nombre d'étapes baisse.
Avantages
- Moins d'étapes par tâche, donc la facture réelle est plus basse que ne le suggère la grille tarifaire
- L'API par lot réduit les deux tarifs de moitié, à
2 $/10 $ - Mode rapide disponible quand la latence compte
Inconvénients
4 $/20 $représente 2,7 fois le prix d'entrée du GA Qwen 4 Max et 4,4 fois celui de sortie60 $par mois pour l'acheteur 10 M/1 M si vous faites tout passer par lui
Tarifs
4 $ en entrée, 20 $ en sortie, 0,20 $ pour les lectures de cache par million de tokens, selon la page tarifaire d'Anthropic. Pour l'acheteur 10 M/1 M : 40 $ + 20 $ = 60 $. Plus de détails dans notre guide tarifs d'Opus 5.5.
Notre avis : ne faites pas d'Opus votre choix par défaut. Dirigez vers Opus 5.5 en effort Medium les tâches où Sonnet ou Qwen se bloquent, et vous obtenez la majeure partie de la qualité pour une fraction de la facture tout-Opus.
3. Claude Fable 5.2
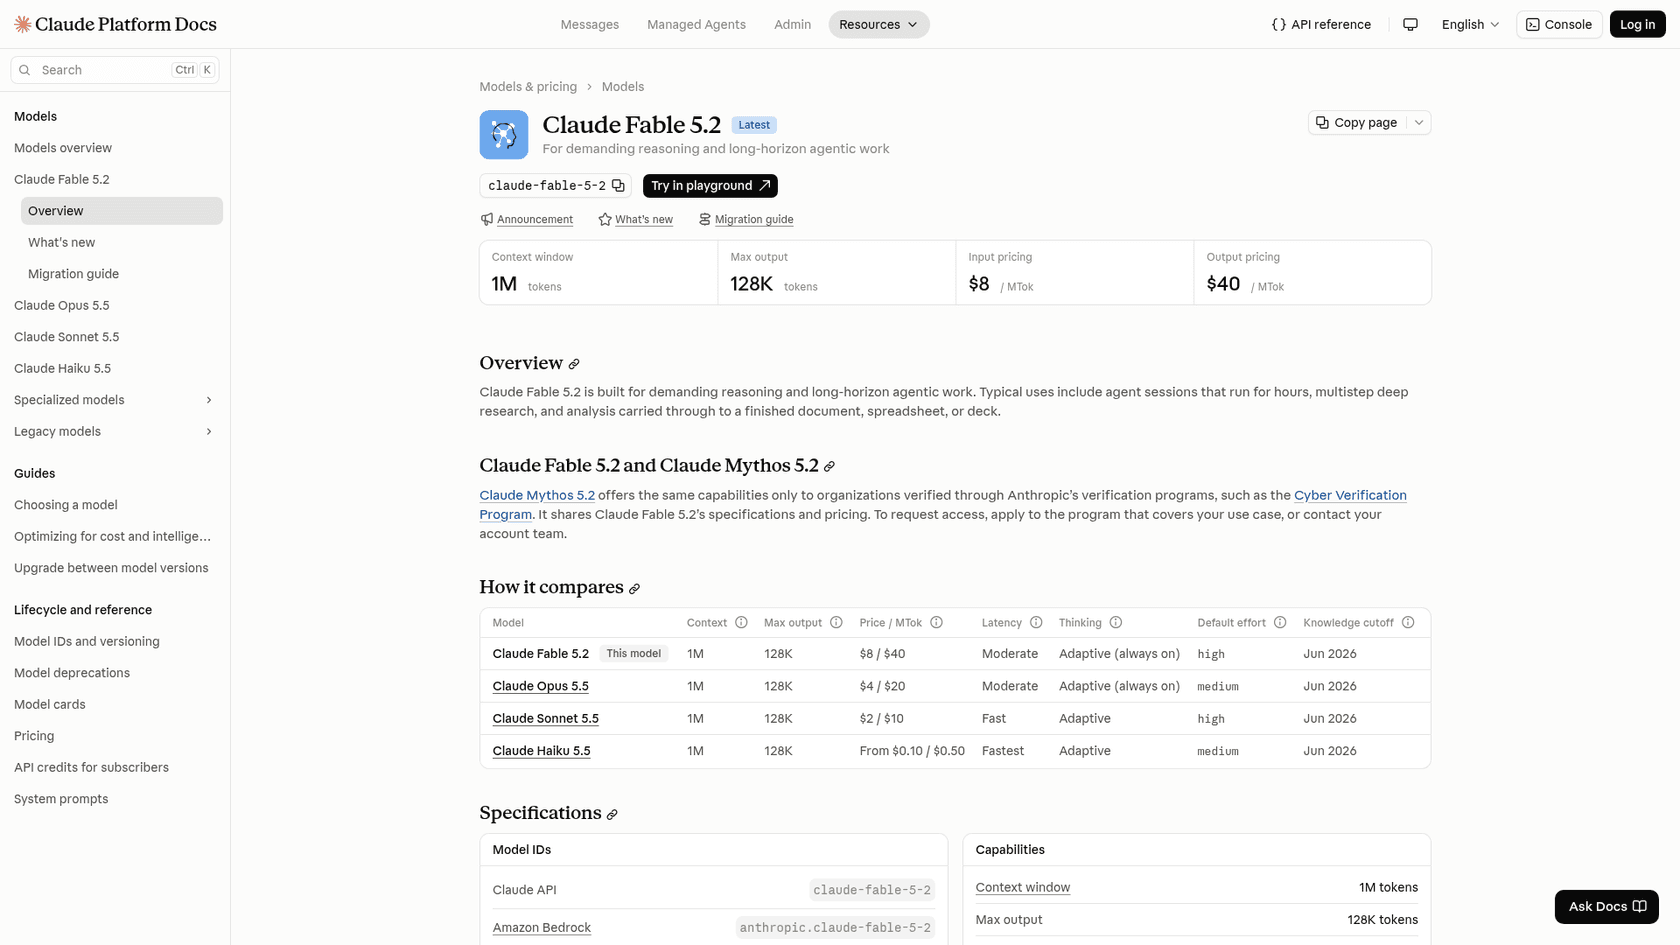
Idéal pour : les tâches d'agents les plus difficiles et les plus longues, où une exécution ratée coûte plus que les tokens.
Ce qu'il fait bien
Fable 5.2 se situe au-dessus d'Opus 5.5, et la réponse de ChatGPT à ma question a noté qu'il mène le classement de code qu'il a vérifié. Le fait utile, c'est le coût, pas le rang : Anthropic a mesuré que Fable 5.2 en High égale Opus 5.5 en Max pour environ la moitié du coût par tâche, comme le détaille notre analyse tarifs de Fable 5.2. Donc pour les tâches où vous pousseriez Opus à Max, Fable en High peut être le choix le moins cher.
Avantages
- Le modèle le plus fort de cette liste pour le travail de long terme
- Lectures de cache à
0,20 $, comme Opus 5.5 - Peut battre Opus sur le coût par tâche à qualité équivalente
Inconvénients
- Tarif de
8 $/40 $, le plus cher par token ici - Limites de débit séparées et plus basses qu'Opus et Sonnet
- Sur le plan Pro, il tourne sur des crédits d'usage, pas sur l'allocation normale
Tarifs
8 $ en entrée, 40 $ en sortie par million de tokens, selon la page tarifaire d'Anthropic. Pour l'acheteur 10 M/1 M : 80 $ + 40 $ = 120 $.
Notre avis : un spécialiste, pas un modèle du quotidien. Utilisez-le là où vous feriez sinon tourner Opus à Max, et lisez la critique de Fable 5.2 avant de lui confier des exécutions sans supervision.
4. GPT-6.1 Terra
Idéal pour : les équipes qui veulent un modèle de frontière bon marché d'un second fournisseur.
Ce qu'il fait bien
Terra est la seule alternative qui bat le GA Qwen 4 Max sur le prix sans descendre vers un modèle de classe Flash. À 1 $/5 $, il coûte la moitié par token de GPT-6.1 Sol, et Artificial Analysis l'a situé à 0,05 $ par tâche en effort faible et 0,40 $ en maximal, selon notre article tarifs de Terra. Si vous voulez un modèle OpenAI dans votre rotation, c'est celui par lequel commencer.
Avantages
15 $par mois pour l'acheteur 10 M/1 M, moins cher queqwen4-max- Entrée mise en cache à
0,05 $, une réduction de 95 % - Batch et Flex réduisent le prix de moitié, à
0,50 $/2,50 $
Inconvénients
- Les prompts de plus de 272K tokens facturent toute la requête à
2 $en entrée et7,50 $en sortie - Pas le bon choix si vous avez besoin de toute la fenêtre de 1 M à tarif fixe
Tarifs
1 $ en entrée, 5 $ en sortie, 0,05 $ en entrée mise en cache par million de tokens, selon la page tarifaire d'OpenAI. Pour l'acheteur 10 M/1 M : 10 $ + 5 $ = 15 $.
Notre avis : le meilleur rapport qualité-prix si vos prompts restent sous 272K. Pour un contexte sur tout un dépôt, Sonnet 5.5 ou qwen4-max gardent un tarif fixe sur tout le 1 M.
5. Gemini 4 Argon
Idéal pour : le travail rapide avec Gemini 4, si vous pouvez vivre avec le changement de prix de décembre.
Ce qu'il fait bien
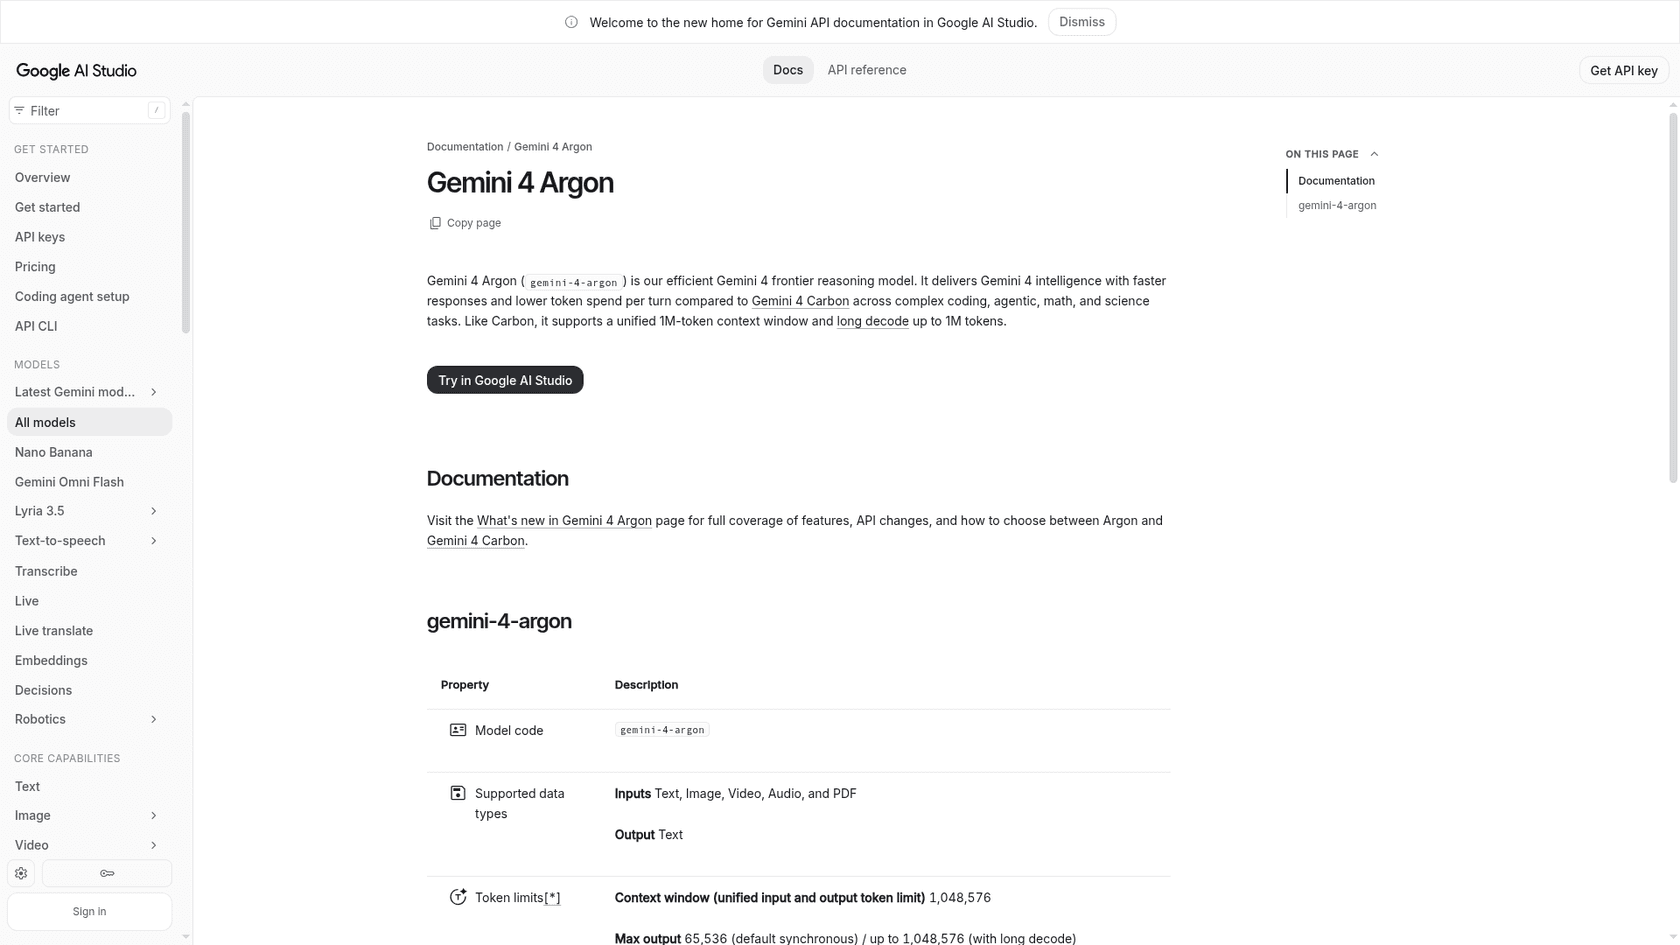
La page tarifaire de Google décrit Argon comme le modèle efficient de Gemini 4, avec des réponses plus rapides et une dépense de tokens par tour plus faible que Carbon sur les tâches de code, d'agents, de maths et de science. Sa fenêtre de contexte est de 1 048 576 tokens, la même classe que Qwen 4 Max. La liste restreinte de ChatGPT suggérait Argon pour le travail courant et Carbon pour les tâches autonomes difficiles, ce qui correspond au positionnement de Google.
Avantages
2 $/10 $avec0,10 $d'entrée mise en cache jusqu'au 30 novembre- Contexte de 1 M, avec un décodage long allant jusqu'à 1 M de tokens en sortie selon la documentation
- Même compte Google et même clé d'API que les autres modèles Gemini
Inconvénients
- Le prix double à
4 $/20 $le 1er décembre 2026 - Pas de palier gratuit pour ce modèle
- Cache implicite uniquement ; le cache explicite n'est pas pris en charge
Tarifs
2 $ en entrée et 10 $ en sortie jusqu'au 30 novembre, puis 4 $ et 20 $ dès le 1er décembre, selon la page tarifaire de Google. Pour l'acheteur 10 M/1 M : 30 $ maintenant, 60 $ à partir de décembre. Voir notre guide tarifs d'Argon pour le calcul du coût par tâche.
Notre avis : budgétisez à 4 $/20 $, pas sur la promotion. À ce prix, il coûte autant qu'Opus 5.5, donc testez les deux sur votre charge de travail avant de vous engager.
6. Gemini 4 Carbon
Idéal pour : les agents de long terme et le raisonnement le plus difficile sur la pile de Google.
Ce qu'il fait bien
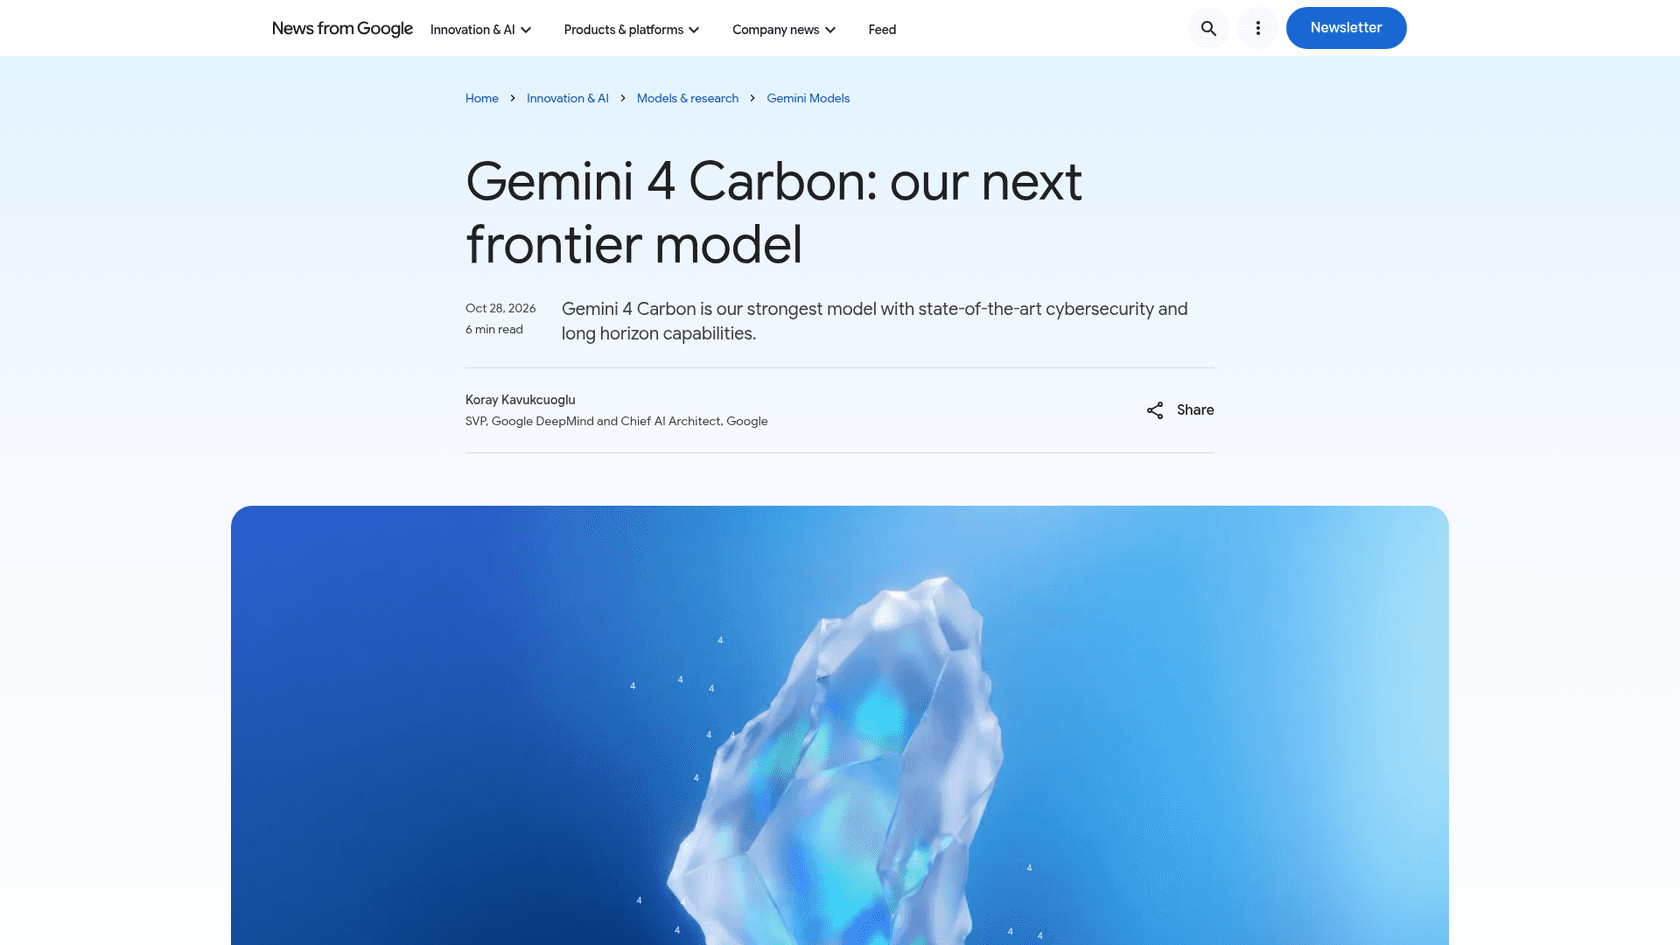
Carbon est le modèle de raisonnement le plus capable de Google, conçu pour l'ingénierie logicielle complexe, les agents autonomes multi-étapes et le décodage long jusqu'à 1 M de tokens, selon la page tarifaire. Le chiffre intéressant : sur Artificial Analysis, Carbon coûtait 7,76 $ par tâche au tarif public contre 7,68 $ pour Argon, tout en obtenant 59 points contre 50. Même facture, neuf points de plus.
Avantages
- Même prix qu'Argon, donc vous ne payez rien de plus pour le modèle plus fort
- Contexte de 1 M et jusqu'à 1 M de tokens en sortie
Inconvénients
- Le même doublement de prix le 1er décembre qu'Argon
- Écrit beaucoup de tokens par tâche, donc le coût par tâche grimpe
Tarifs
2 $/10 $ jusqu'au 30 novembre, 4 $/20 $ dès le 1er décembre, selon la page tarifaire de Google. Pour l'acheteur 10 M/1 M : 30 $, puis 60 $. Détails dans notre article tarifs de Carbon.
Notre avis : si vous passez à Gemini, allez vers Carbon plutôt qu'Argon pour le travail d'agents. La critique de Carbon a le détail des benchmarks.
7. DeepSeek V4.1 Flash
Idéal pour : les étapes d'agents routinières à fort volume, où le prix compte plus que la qualité de pointe.
Ce qu'il fait bien
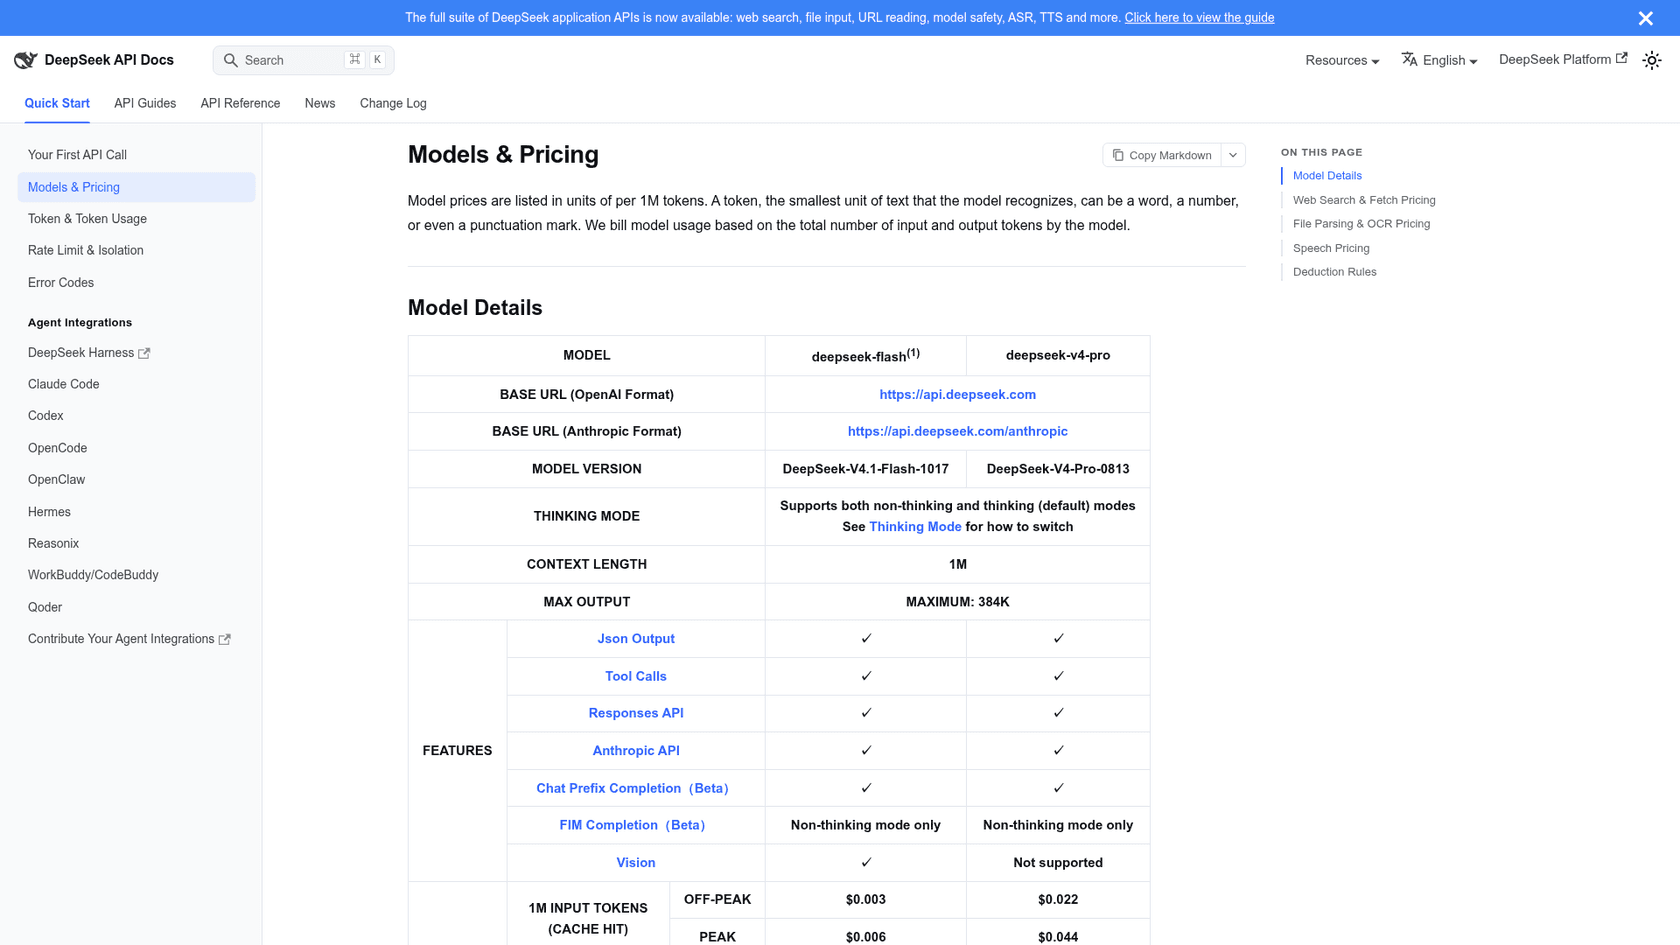
DeepSeek V4.1 Flash est, de loin, le modèle sérieux le moins cher de cette liste. Sur la page tarifaire de DeepSeek, le modèle deepseek-flash (DeepSeek-V4.1-Flash-1017) coûte 0,15 $ en entrée et 0,60 $ en sortie hors pointe, avec une fenêtre de contexte de 1 M et jusqu'à 384K en sortie. Il prend en charge les appels d'outils, la sortie JSON, la vision et aussi bien le format d'API OpenAI qu'Anthropic, donc il s'intègre dans des configurations type Claude Code. Et si vous voulez rester sur la facture d'Alibaba, la documentation Token Plan liste aussi deepseek-v4.1-flash, avec 50 % de réduction la nuit.
Avantages
2,10 $par mois pour l'acheteur 10 M/1 M hors pointe- Succès de cache à
0,003 $par million - Disponible sur Token Plan en plus de l'API propre de DeepSeek
Inconvénients
- Les heures de pointe (01h00 à 04h00 et 06h00 à 10h00 UTC, jours de semaine) doublent chaque tarif
- Un modèle de classe Flash, donc gardez un modèle plus fort pour les tâches difficiles
Tarifs
0,15 $ en entrée (cache manqué), 0,003 $ (cache réussi), 0,60 $ en sortie par million de tokens hors pointe ; doublé en pointe, selon DeepSeek. Pour l'acheteur 10 M/1 M : 1,50 $ + 0,60 $ = 2,10 $ hors pointe, 4,20 $ en pointe. Voir notre guide tarifs de V4.1 Flash.
Notre avis : l'emplacement économique. Dirigez ici le travail en masse comme résumer des logs, écrire des tests et faire des modifications simples, et gardez Sonnet 5.5 ou qwen4-max pour tout ce qui demande du jugement.
8. Kimi K3.1 Pro
Idéal pour : les développeurs qui veulent un modèle de frontière non américain solide avec une option à tarif fixe.
Ce qu'il fait bien
Kimi K3.1 Pro est le choix évident si ce que vous aimiez chez Qwen, c'était d'avoir un modèle capable hors des grands labos américains. Le guide de démarrage de Moonshot le décrit comme un modèle de classe 3T avec une fenêtre de contexte de 1 M, et l'API parle aussi bien le format OpenAI qu'Anthropic, donc il fonctionne dans Claude Code. Selon notre analyse tarifs de K3.1 Pro, il affichait en moyenne 2,11 $ par tâche sur Artificial Analysis, moins de la moitié du coût par tâche de Sonnet 5.5 ou Opus 5.5 en effort maximal.
"So their base price is 1/5th of Opus 5.5 per token, but if you want "highspeed" it's 2x that and then I guess it generates 2x the number of tokens as well? That might suggest that Opus is competitively priced after all."
Avantages
2 $/10 $par token, ou des plans à tarif fixe de19 $à199 $par mois- Variante highspeed environ 2 à 3 fois plus rapide
- Moonshot cite des gains importants en code, création 3D et recherche financière
Inconvénients
- Écrit beaucoup de tokens, donc les économies par tâche sont plus faibles que ne le suggère le tarif affiché
- Les plans d'abonnement ont une limite glissante de 5 heures que les premiers acheteurs atteignent vite
Tarifs
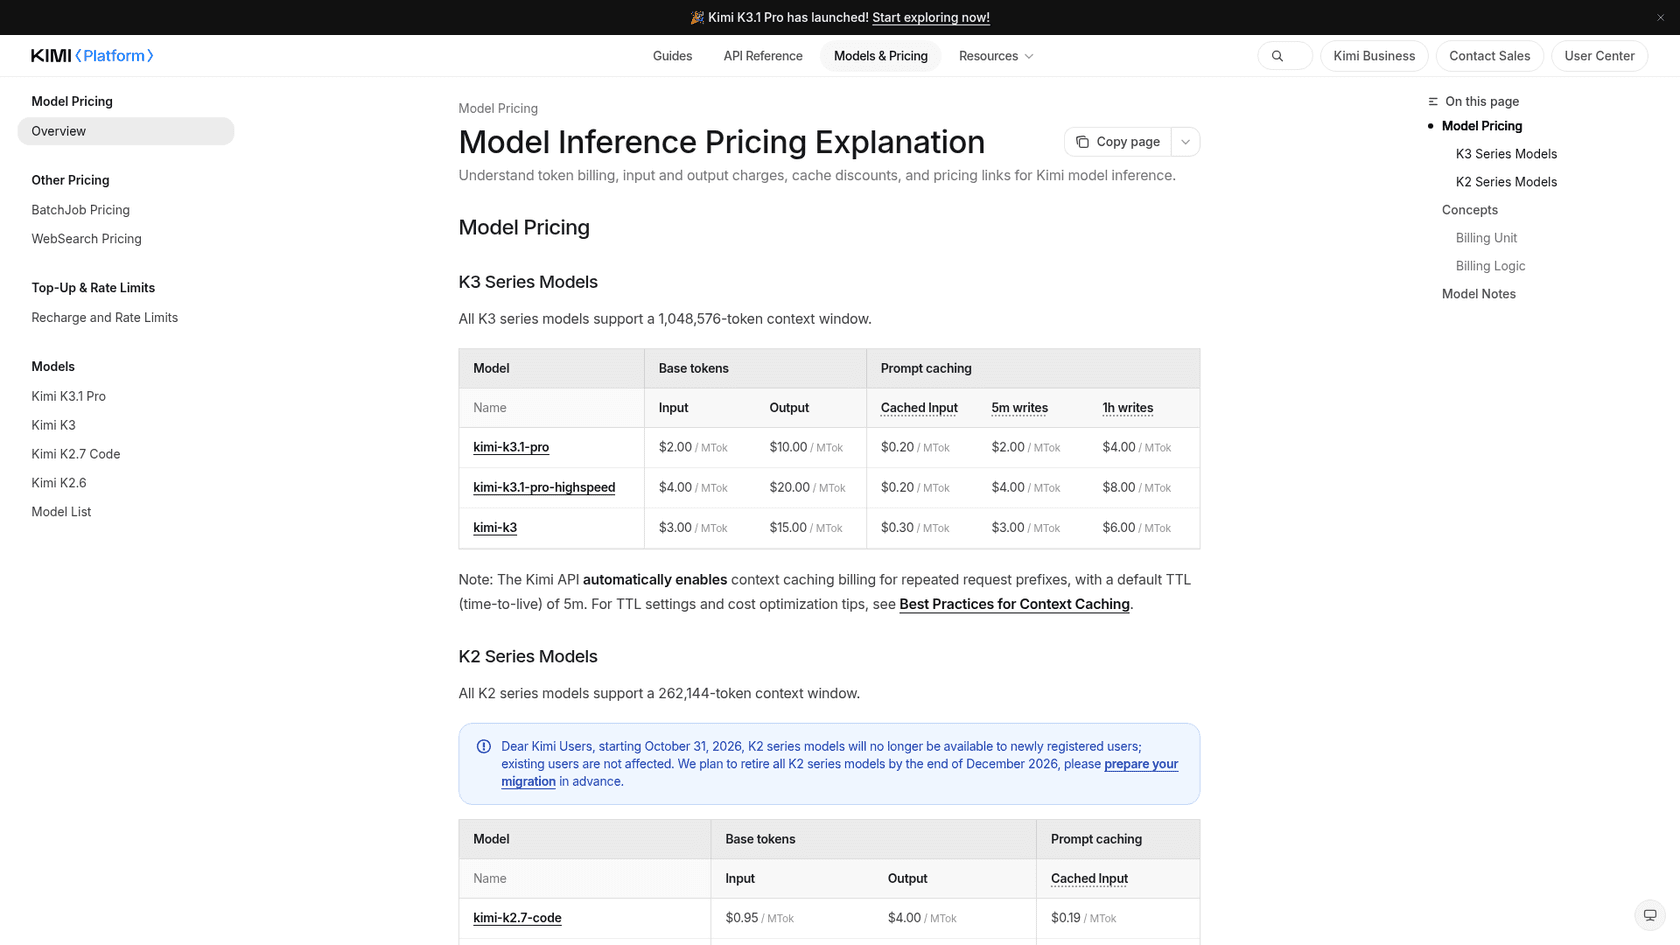
2 $ en entrée, 10 $ en sortie, 0,20 $ d'entrée mise en cache par million de tokens ; Highspeed 4 $/20 $, selon la page tarifaire de Kimi. Pour l'acheteur 10 M/1 M : 30 $.
Notre avis : un bon second fournisseur si vous voulez éviter à la fois Alibaba et les labos américains. Lisez la critique de K3.1 Pro avant d'acheter un plan d'abonnement pour un usage intensif d'agents.
9. Qwen3.8-Max
Idéal pour : les utilisateurs de Token Plan qui veulent un fleuron Qwen plus ancien, mieux documenté, avec une réduction de nuit.
Ce qu'il fait bien
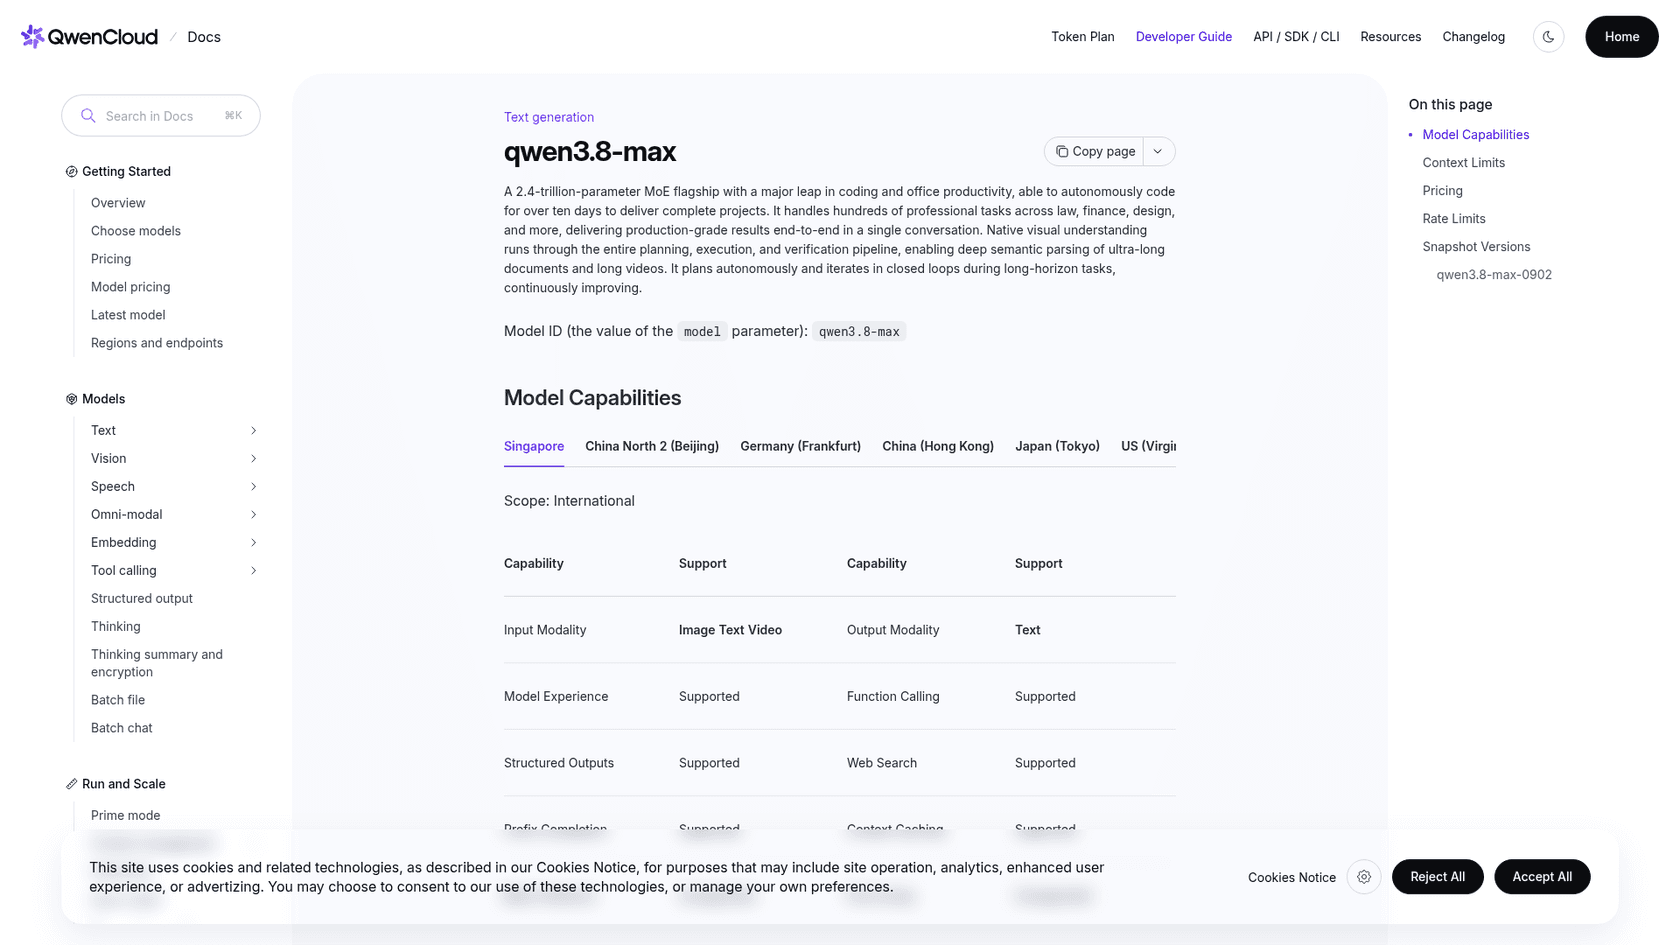
Qwen3.8-Max est la solution de repli au sein de la famille. Alibaba le décrit comme un fleuron MoE de 2,4 billions de paramètres capable de coder de façon autonome sur de longues périodes, et il tourne sur le même Token Plan que Qwen 4 Max, donc vos clés et points de terminaison ne changent pas. Sur Token Plan, il profite toujours d'une réduction de 60 % entre 22h00 et 08h00 UTC+8, ce qui correspond aux heures de travail aux États-Unis. Notre critique de Qwen3.8-Max détaille comment il a tenu après son lancement.
Avantages
- Aucun changement de configuration à part l'ID du modèle si vous êtes déjà sur Token Plan
- La réduction de nuit continue de tourner sur Token Plan
- Des mois d'usage communautaire derrière lui
Inconvénients
- Plus cher que le GA
qwen4-maxsur l'API à l'usage (2 $/6 $contre1,50 $/4,50 $) - Une génération plus ancienne que le modèle qu'il remplace
Tarifs
2 $ en entrée et 6 $ en sortie par million de tokens à Singapour, 1,65 $ et 4,951 $ à Pékin, selon la page qwen3.8-max d'Alibaba. Pour l'acheteur 10 M/1 M : 26 $.
Notre avis : ça ne vaut le coup que sur Token Plan, pour la réduction de nuit. Sur l'API, le GA qwen4-max est plus récent et moins cher, il y a donc peu de raison de revenir en arrière.
Quelle alternative à Qwen 4 Max correspond à votre configuration ?
Votre réponse dépend surtout d'où vous faisiez tourner la préversion :
- Claude Code sur Token Plan : changez d'abord l'ID du modèle vers
qwen4-max. Si les résultats déçoivent, déplacez l'emplacement Opus vers Claude Opus 5.5 et l'emplacement Sonnet vers Claude Sonnet 5.5. - Votre propre agent sur une API : ajoutez un second fournisseur. Sonnet 5.5 ou GPT-6.1 Terra comme modèle quotidien, DeepSeek V4.1 Flash pour les appels en masse.
- Surtout pour la réduction : DeepSeek V4.1 Flash hors pointe est ce qui se rapproche le plus du prix de la préversion.
- Exécutions autonomes de long terme : Claude Fable 5.2 ou Gemini 4 Carbon, testés côte à côte avant le 1er décembre.
- Un bot de support ou destiné aux clients : ne mettez aucun modèle de préversion devant des clients. C'est le cas d'un agent géré, dont il est question ensuite.
| Si vous avez besoin de | Choisissez | Coût mensuel (10 M en entrée, 1 M en sortie) |
|---|---|---|
| Le moins de changement | qwen4-max (GA) | 19,50 $ |
| Le meilleur modèle de code au quotidien | Claude Sonnet 5.5 | 30 $ |
| Les tâches les plus difficiles | Claude Opus 5.5 ou Fable 5.2 | 60 $ ou 120 $ |
| Le prix le plus bas | DeepSeek V4.1 Flash | 2,10 $ hors pointe |
| Un second fournisseur économique | GPT-6.1 Terra | 15 $ |
| Un modèle de frontière non américain | Kimi K3.1 Pro | 30 $ |
Et si la préversion faisait tourner votre file de support ?
Alors l'ID du modèle n'a jamais été le vrai problème. Une préversion de deux semaines qui se retire à une date fixe est l'exemple le plus clair de pourquoi les équipes support ne devraient pas câbler un modèle brut directement dans leur support : chaque changement du fournisseur devient votre migration, votre nouveau test et votre risque.
C'est le vide que comble eesel. Les modèles comme ceux ci-dessus sont de l'infrastructure ; eesel est l'employée. Son coéquipier IA pour le support se connecte à Zendesk ou Freshdesk, apprend de vos tickets passés et de votre centre d'aide, et est testé sur des conversations historiques avant de répondre à un vrai client. Quand un meilleur modèle sort, le changement se fait du côté d'eesel.
Deux clients montrent ce que cela donne en pratique :
- SE Ranking gère trois produits depuis une seule équipe Zendesk, avec un agent eesel par produit qui parcourt environ 16 800 pages de contenu d'aide. Il a traité environ 4 650 conversations en un mois, et rien de tout cela ne dépendait du modèle utilisé.
- OroSoft fabrique des logiciels de négoce de métaux précieux et soutient ses clients via Freshdesk. eesel rédige des réponses à partir de 6 100 tickets passés et 20 fichiers de centre d'aide et de référence, indique quel ticket ou article il a utilisé, et signale une personne quand il ne trouve pas de quoi appuyer une réponse.
Essayez eesel
Si vous testiez la préversion de Qwen 4 Max pour répondre aux clients, eesel vous donne cet agent sans le changement de modèle : il rejoint votre support en quelques minutes, rédige ou envoie des réponses à partir de votre propre contenu d'aide, et vous voyez comment il aurait répondu à vos tickets passés avant sa mise en ligne. Les plans démarrent à 299 $ par mois sur la page tarifaire d'eesel, avec 100 crédits gratuits pour l'essayer. Un agent de code peut piloter la configuration via la CLI eesel, en téléchargeant des articles d'aide approuvés et en posant des questions de test, tandis que connecter le support lui-même nécessite toujours l'approbation d'un administrateur.
Essayez eesel gratuitement, ou lisez d'abord comment fonctionne l'IA pour Zendesk.