

Qwen 4 Max est le prochain modèle phare d'Alibaba, et aujourd'hui tu ne peux y accéder que comme qwen4-max-preview dans l'abonnement Token Plan, à partir de 3 $ par mois pour les nouveaux utilisateurs, jusqu'au 25 novembre 2026. C'est un modèle de raisonnement multimodal avec un contexte de 1M et une sortie maximale de 393 216 tokens. C'est la configuration qui fait trébucher : la config Claude Code d'Alibaba elle-même place Qwen 4 Max dans le slot Opus et le routeur auto dans le slot principal, donc tu n'appelles peut-être pas Qwen 4 Max si tu ne choisis pas Opus. Pour de l'IA sur les tickets de support, eesel tourne au contraire sur des modèles stables, et son CLI eesel laisse un agent de code charger des articles d'aide et tester des réponses avant tout.
Qu'est-ce que Qwen 4 Max ?
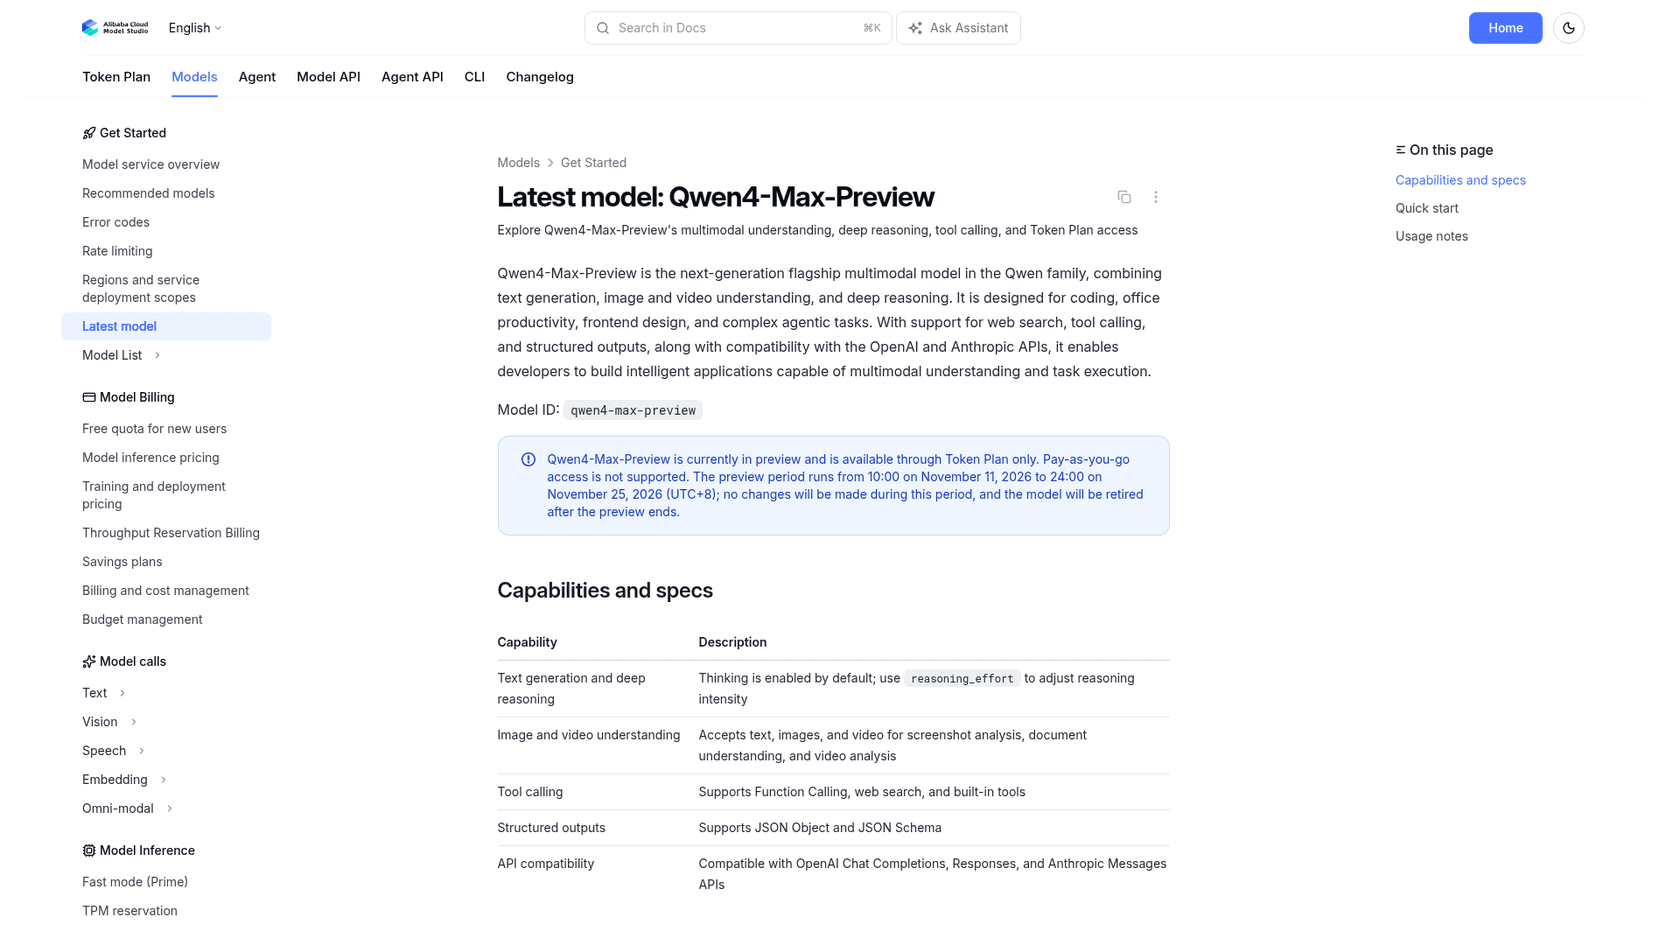
Qwen 4 Max est le premier modèle de la génération Qwen 4 d'Alibaba, sorti le 11 novembre 2026 sous la forme d'un aperçu nommé qwen4-max-preview. La documentation du modèle d'Alibaba le décrit comme le modèle multimodal phare de nouvelle génération de la famille Qwen, visant le code, le travail de bureau, le design frontend et les tâches d'agents.
Je construis des intégrations à plein temps chez eesel, donc quand un nouveau modèle sort, ma première question est banale : qu'est-ce que je mets dans la config, et qu'est-ce qui casse quand je le fais ? Ce billet répond à ça. Si tu veux mon avis sur la qualité du modèle, c'est dans l'avis sur Qwen 4 Max de mon collègue.
Voici tout ce qu'Alibaba a confirmé jusqu'à présent :
| Caractéristique | Qwen 4 Max preview |
|---|---|
| ID du modèle | qwen4-max-preview (alias qwen4.0-max-preview, les factures montrent l'alias) |
| Entrée | Texte, images et vidéo |
| Longueur de contexte | 1M de tokens |
| Sortie max | 393 216 tokens, partagés entre le raisonnement et la réponse |
| Raisonnement | Activé par défaut ; low, medium ou xhigh (par défaut) |
| Outils | Function calling, recherche web, outils intégrés |
| Sortie structurée | JSON Object et JSON Schema |
| Formats d'API | OpenAI Chat Completions, Responses, Anthropic Messages |
| Accès | uniquement Token Plan, pas de paiement à l'usage |
| Disponibilité | 11 nov., 10h00 au 25 nov., 24h00, 2026 (UTC+8), puis retiré |
Il n'y a pas de nombre de paramètres, pas de poids ouverts, pas de fiche modèle et pas de tableau de benchmarks. C'est normal pour un aperçu de deux semaines, mais ça veut dire que c'est un modèle à essayer, pas un modèle sur lequel planifier.
Où se situe Qwen 4 Max dans la gamme Qwen ?
Qwen 4 Max se trouve au sommet de la gamme hébergée d'Alibaba, un cran au-dessus de Qwen 3.8 Max. La liste des modèles de Token Plan les place côte à côte, ce qui donne l'image la plus claire de ce que tu peux réellement appeler aujourd'hui :
| ID du modèle sur Token Plan | Ce qu'Alibaba en dit | Statut |
|---|---|---|
qwen4-max-preview | Raisonnement, compréhension visuelle, texte | Aperçu, retiré le 25 nov. |
qwen3.8-max | Raisonnement, compréhension visuelle, texte | Sorti |
qwen3.8-flash | Raisonnement, compréhension visuelle, texte | Sorti |
qwen3.7-max | Raisonnement, texte | Sorti |
qwen3.7-plus | Raisonnement, compréhension visuelle, texte | Sorti |
qwen3.6-flash | Raisonnement, compréhension visuelle, texte | Sorti |
auto | Choisit un modèle par requête | Routeur de la plateforme |
Le même plan inclut aussi DeepSeek V4.1 Flash, DeepSeek V4 Pro, GLM 5.3 et GLM 5.2, plus des modèles d'image, de vidéo et de voix. Un seul abonnement te donne donc Qwen 4 Max à côté d'une poignée de modèles avec lesquels le comparer sur la même tâche, ce qui est le meilleur usage de l'aperçu.
Ce qui manque, c'est la partie que beaucoup aiment le plus chez Qwen : les modèles plus petits qu'on fait tourner en local. Le niveau Max est hébergé uniquement, et l'aperçu sort sans poids ouverts. Si tu fais tourner Qwen sur ton propre matériel, les modèles Qwen 4 plus petits sont ceux à surveiller, et Qwen 3.8 Flash Next est le choix actuel en attendant.
Combien coûte Qwen 4 Max ?
Il n'y a pas de prix par token pour Qwen 4 Max. Tu paies un abonnement Token Plan en crédits, et Alibaba ne publie pas le taux de crédit standard pour un appel à Qwen 4 Max, seulement la remise d'aperçu qui s'applique. Les niveaux de la Personal Edition viennent de la documentation Token Plan :
| Plan | Prix catalogue | Prix nouvel utilisateur | Crédits mensuels | Agents simultanés |
|---|---|---|---|---|
| Lite | 6 $/mois | 3 $/mois | 20 000 | 1-2 |
| Essential | 10 $/mois | 5 $/mois | 45 000 | 2-3 |
| Standard | 18 $/mois | - | 80 000 | 3-4 |
| Pro | 43 $/mois | - | 200 000 | 6-8 |
Le prix nouvel utilisateur dure jusqu'à 23h59 le 30 novembre 2026 (UTC+8), pour les comptes qui n'ont jamais acheté d'abonnement Personal. Les packs supplémentaires coûtent 15 $ pour 20 000 crédits, jusqu'à cinq à la fois. Pendant l'aperçu, Qwen 4 Max consomme les crédits à 20 % du tarif standard, et à 8 % entre 22h00 et 8h00 heure de Pékin, ce qui correspond à la journée de travail américaine.
Deux choses dans les conditions valent la lecture avant de payer. La Personal Edition ne peut pas être désabonnée, choisis donc la période la plus courte. Et les crédits non utilisés ne sont pas reportés au mois suivant. Pour un essai de deux semaines, le plan Lite à 3 $ suffit à la plupart des gens. Si tu veux un modèle avec une grille tarifaire sur laquelle planifier un budget, les tarifs Qwen 3.8 Max sont à 2 $ en entrée et 6 $ en sortie par 1M de tokens.
Comment obtenir l'accès à Qwen 4 Max ?
Tu obtiens l'accès en trois étapes, selon le guide de démarrage rapide de Token Plan d'Alibaba : s'abonner, générer une clé, et pointer son outil vers le bon endpoint.
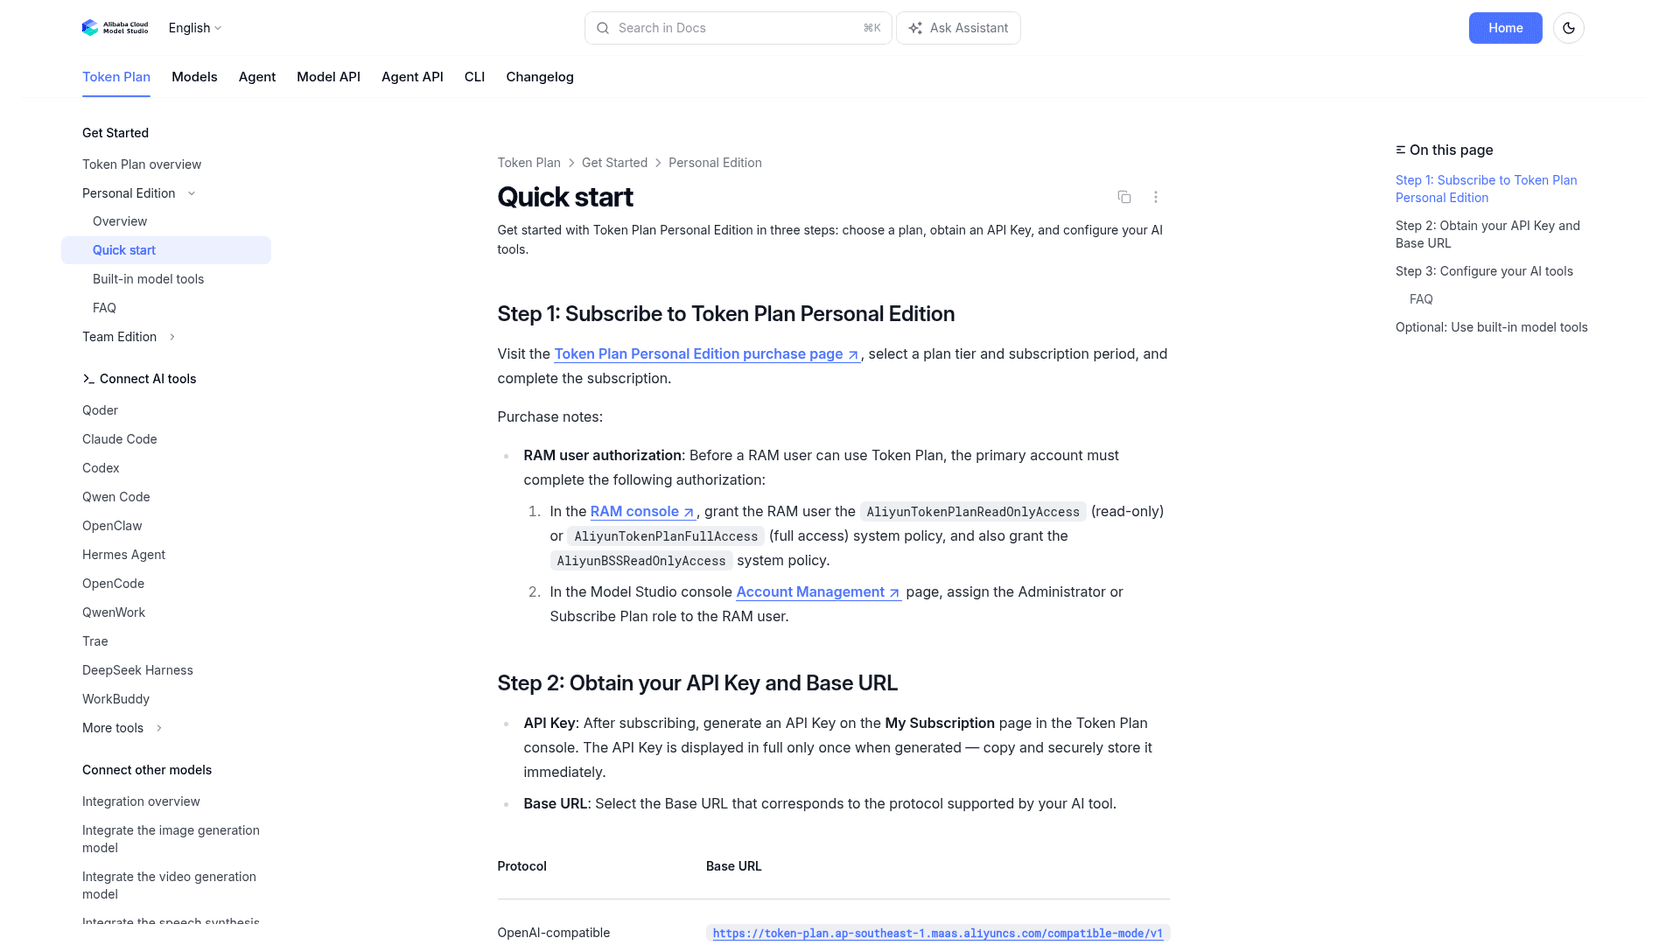
- Abonne-toi à Token Plan Personal (région Singapour uniquement) et choisis un niveau.
- Génère une clé API sur la page My Subscription. Elle n'est affichée en entier qu'une seule fois, copie-la donc immédiatement. Les clés Token Plan commencent par
sk-sp-. - Utilise l'URL de base de Token Plan pour le protocole de ton outil :
| Protocole | URL de base |
|---|---|
| Compatible OpenAI | https://token-plan.ap-southeast-1.maas.aliyuncs.com/compatible-mode/v1 |
| Compatible Anthropic | https://token-plan.ap-southeast-1.maas.aliyuncs.com/apps/anthropic |
Mets ensuite l'ID du modèle sur qwen4-max-preview.
La clé et l'endpoint doivent correspondre
C'est l'erreur qui coûte de l'argent réel. Alibaba fait tourner trois canaux de facturation distincts, Token Plan, Coding Plan et paiement à l'usage, chacun avec ses propres clés et URL de base. La FAQ Token Plan dit qu'utiliser l'endpoint général dashscope-intl.aliyuncs.com ou une clé Coding Plan route les appels vers le paiement à l'usage à la place, et ces frais ne peuvent pas être compensés par des crédits ni remboursés.
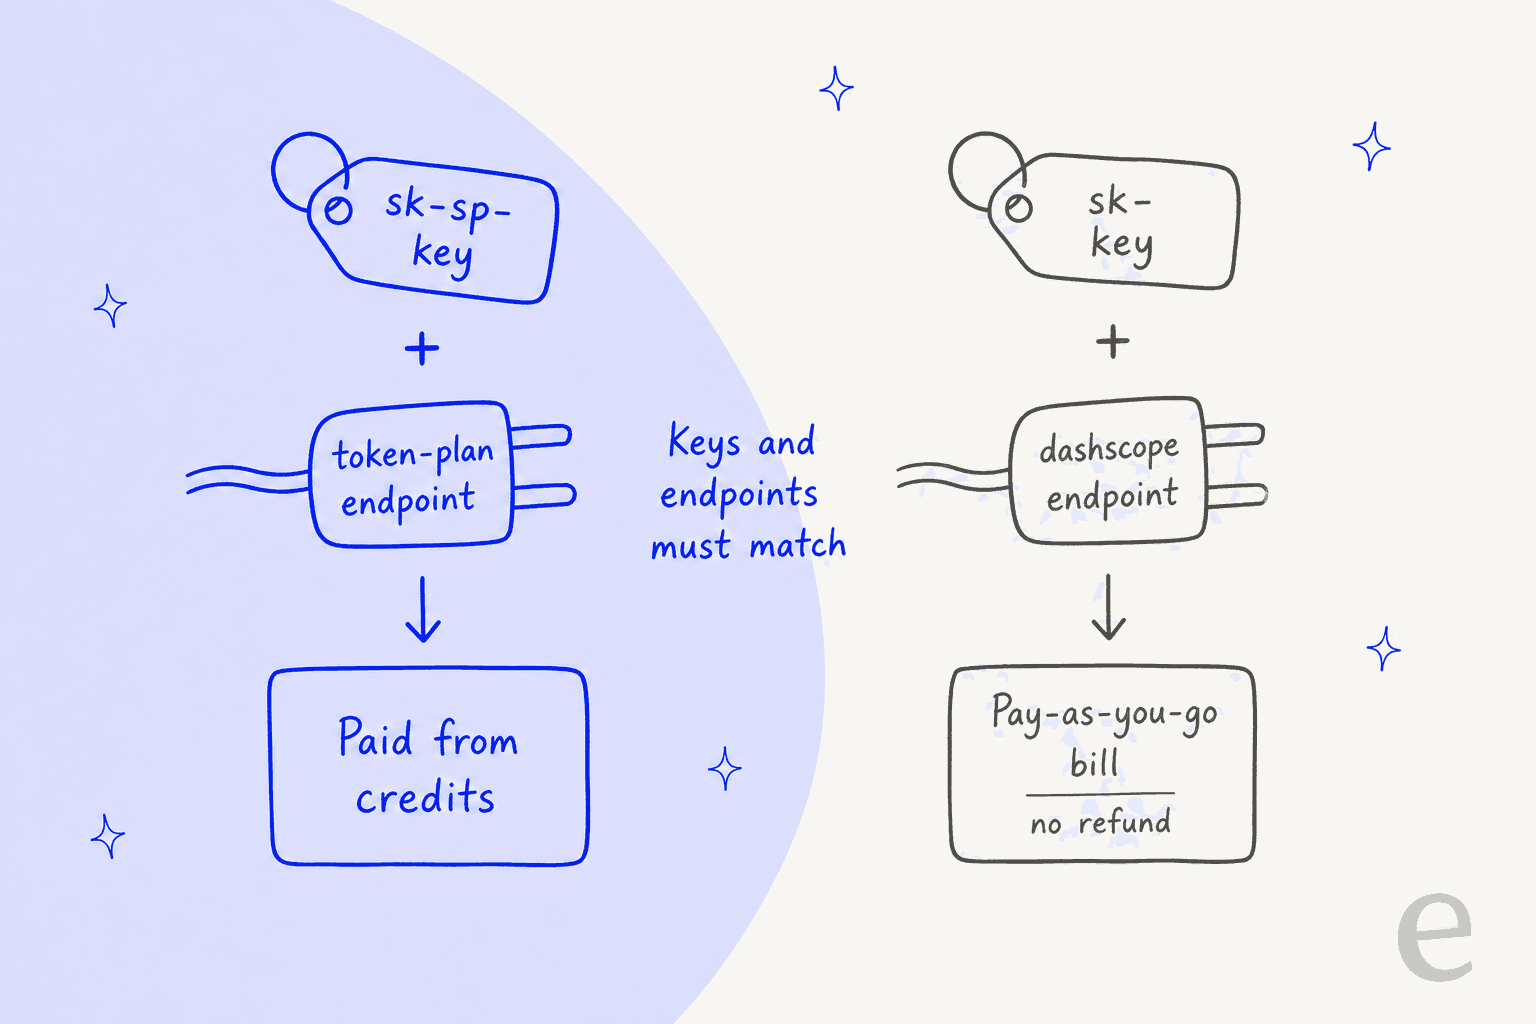
Si tu as déjà utilisé Qwen via Alibaba, la config de ton outil contient probablement encore une ancienne clé sk- et l'URL DashScope. Change la clé, l'URL, ainsi que le nom du modèle.
Comment faire tourner Qwen 4 Max dans Claude Code ?
Tu le fais tourner en pointant Claude Code vers l'endpoint Anthropic de Token Plan et en associant un slot de modèle à qwen4-max-preview. Le guide Claude Code d'Alibaba donne cette config pour la CLI :
export ANTHROPIC_AUTH_TOKEN="YOUR_API_KEY"
export ANTHROPIC_BASE_URL="https://token-plan.ap-southeast-1.maas.aliyuncs.com/apps/anthropic"
export ANTHROPIC_MODEL="auto"
export ANTHROPIC_DEFAULT_HAIKU_MODEL="qwen3.6-flash"
export ANTHROPIC_DEFAULT_SONNET_MODEL="qwen3.8-flash"
export ANTHROPIC_DEFAULT_OPUS_MODEL="qwen4-max-preview"
export CLAUDE_CODE_SUBAGENT_MODEL="auto"
export CLAUDE_CODE_MAX_CONTEXT_TOKENS="983616"
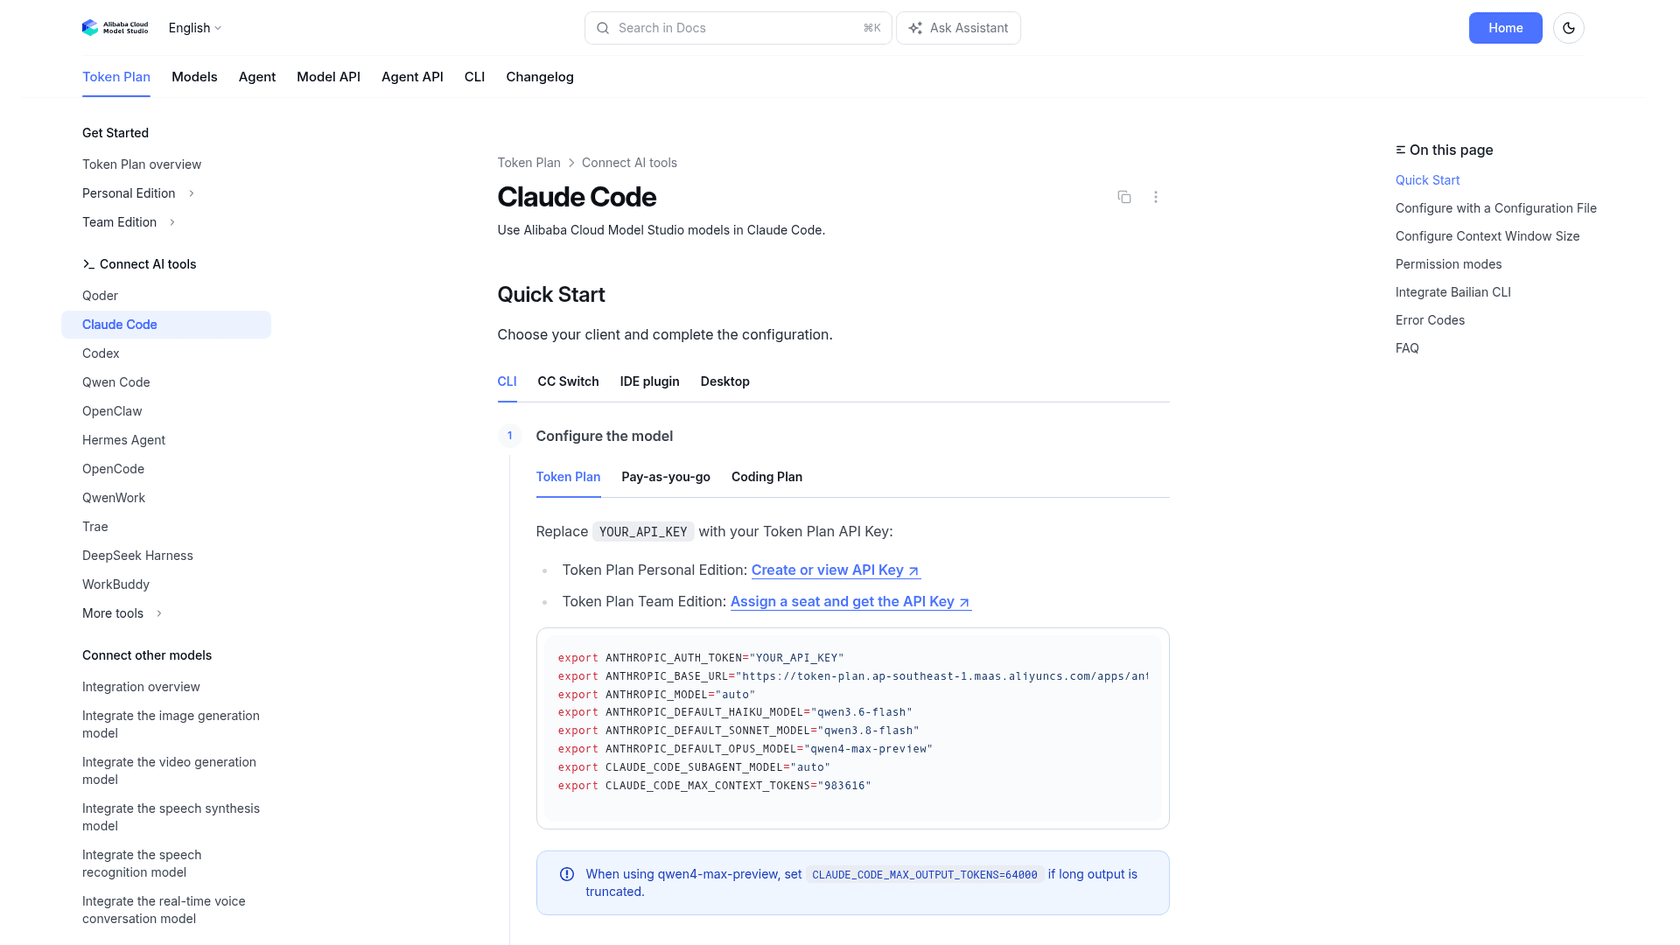
Lis ce bloc attentivement, car il ne fait pas ce que la plupart attendent. Le modèle principal est auto, le routeur d'Alibaba, et les sous-agents aussi. Qwen 4 Max n'occupe que le slot Opus.
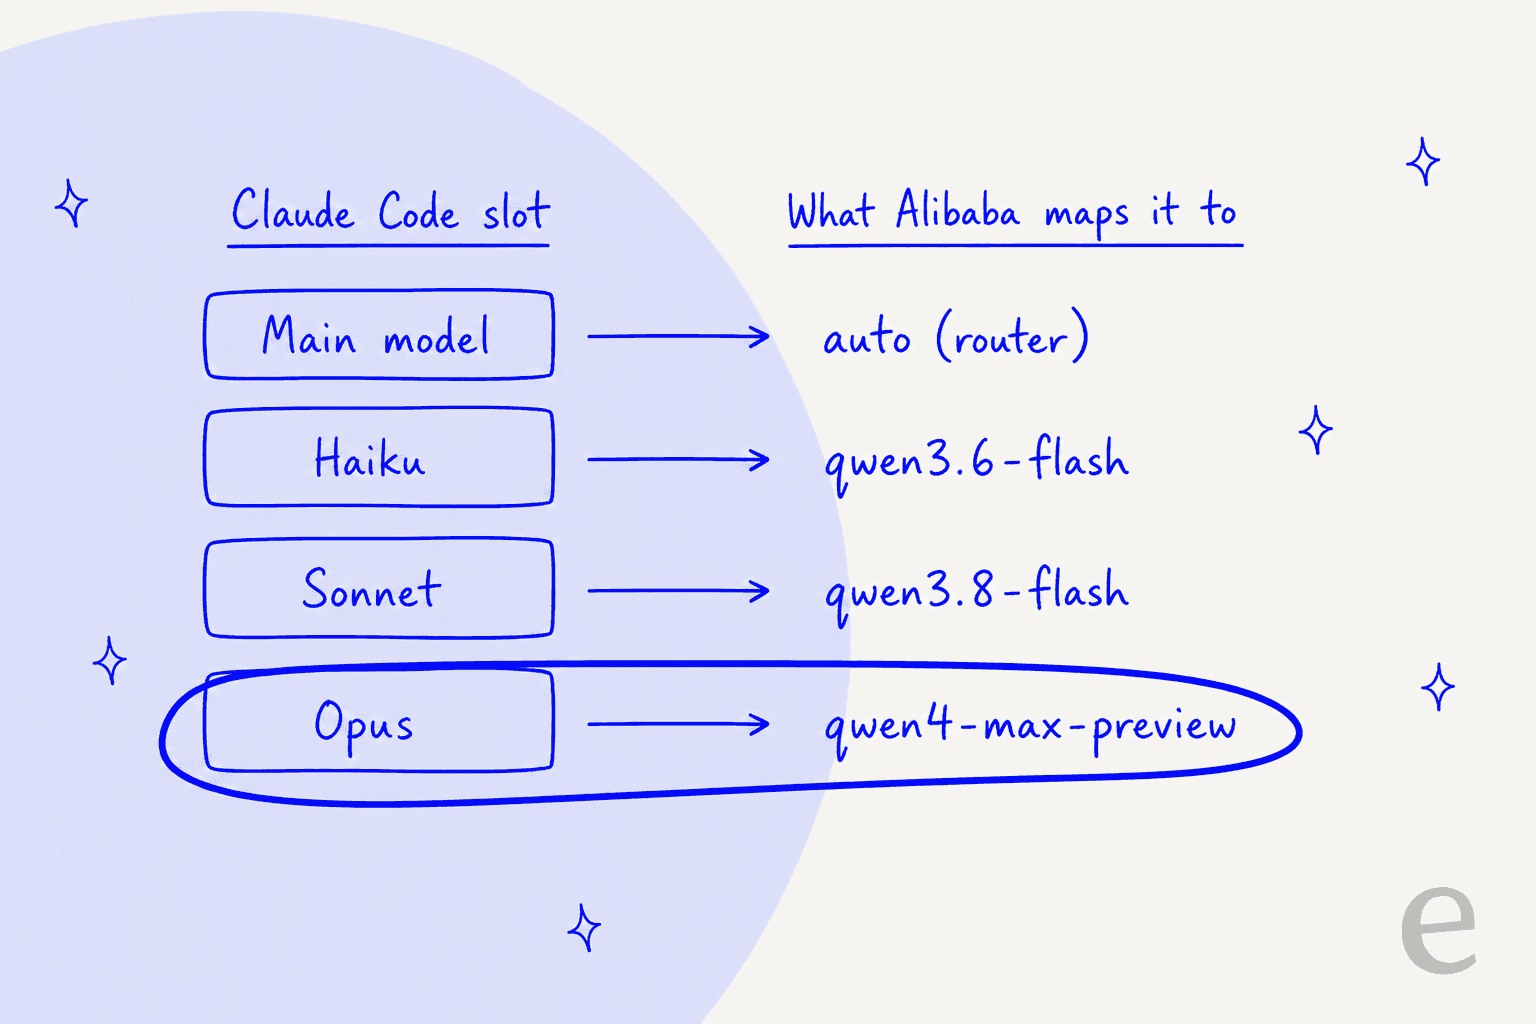
Donc si tu colles ça et démarres une session, tes prompts vont vers ce que auto choisit, pas vers Qwen 4 Max. Pour vraiment tester le nouveau modèle, bascule avec /model opus dans la session, ou mets ANTHROPIC_MODEL="qwen4-max-preview" toi-même. Si tu compares des modèles, fais la deuxième option, pour que chaque tour de ton test tourne sur le même modèle. Mon guide de sélection de modèle dans Claude Code explique comment fonctionnent les slots.
Trois autres réglages comptent :
- Longueur de sortie. La doc note que si une longue sortie est tronquée avec
qwen4-max-preview, metsCLAUDE_CODE_MAX_OUTPUT_TOKENS=64000. - Contexte.
CLAUDE_CODE_MAX_CONTEXT_TOKENS="983616"laisse Claude Code utiliser la majeure partie de la fenêtre de 1M. Voir mon guide de la fenêtre de contexte de Claude Code pour ce que ça change. - Persistance. Ces exports ne durent que pour le terminal actuel. Pour une config durable, les mêmes clés vont sous
envdans~/.claude/settings.json, comme couvert dans mon guide de configuration de Claude Code.
Lance claude -p "Hello" pour vérifier la connexion. Pour Claude Code Desktop, le guide d'Alibaba le fait passer par une passerelle locale appelée CC Switch plutôt que par des variables d'environnement.
Qwen Code, Cursor et autres outils
Qwen Code utilise l'endpoint compatible OpenAI. Le fichier ~/.qwen/settings.json d'exemple d'Alibaba liste qwen4-max-preview comme sa propre entrée fournisseur nommée "Qwen4.0 Max Preview", tu le choisis donc par son nom plutôt que par une association de slot. Cursor, OpenAI Codex, OpenCode, OpenClaw, Cline, Qoder et Hermes Agent ont aussi des guides Token Plan. Pour chacun, vérifie deux choses : l'URL de base est une URL token-plan, et l'ID du modèle est exactement qwen4-max-preview.
Qu'est-ce qui change pour les développeurs qui l'appellent directement ?
Deux comportements sont nouveaux avec ce modèle, et les deux peuvent casser une config qui fonctionnait avec des modèles Qwen plus anciens.
max_tokens couvre maintenant aussi le raisonnement. L'avis de compatibilité d'Alibaba dit qu'à partir de qwen4-max-preview, max_tokens équivaut à max_completion_tokens sur Chat Completions, il limite donc le raisonnement et la réponse finale ensemble. Le raisonnement est activé sur xhigh par défaut. Si tu as dimensionné max_tokens pour la réponse seule, le raisonnement consomme le budget et la réponse revient tronquée. Les modèles Qwen plus anciens gardent l'ancien comportement, c'est pour ça que ça piège les gens quand ils changent d'ID de modèle.
Le raisonnement doit être renvoyé. Chat Completions active preserve_thinking par défaut. La documentation du modèle demande de renvoyer le raisonnement précédent dans le champ reasoning_content de chaque message assistant, pas dans content. Aussi, ne mets pas reasoning_effort et thinking_budget en même temps.
Encore une chose : les outils intégrés (recherche web, recherche d'images, scraping web, interpréteur de code) ne fonctionnent que via la Responses API, pas Chat Completions, selon le guide de démarrage rapide. Si ton outil parle Chat Completions, tu ne les auras pas.
Vérification de la config Qwen 4 Max
Coche ce qui est vrai pour ta config. Ce qui reste décoché est probablement la raison pour laquelle ça ne fonctionne pas.
Que ne peux-tu pas faire avec Qwen 4 Max ?
Tu ne peux pas construire un produit dessus, pour deux raisons qui n'ont rien à voir avec son intelligence.
Premièrement, c'est temporaire. La doc dit qu'aucun changement n'est apporté pendant l'aperçu et que le modèle est retiré à sa fin. Tout ce qui appelle qwen4-max-preview cesse de fonctionner après le 25 novembre.
Deuxièmement, Token Plan l'interdit. Les conditions d'abonnement disent que le plan est uniquement pour un usage interactif dans des outils de code et d'agents, et ne doit pas être utilisé pour "des scripts d'automatisation, des backends d'applications personnalisées, ou tout scénario d'appel par lots non interactif." La FAQ ajoute que les tâches planifiées en arrière-plan comptent aussi, et que partager une clé peut la faire suspendre. Donc un chatbot de support, un classificateur de tickets ou une API de support client IA connectée à cette clé enfreint les règles dès le premier appel.
Les premiers utilisateurs le voient déjà comme un essai routier. Un commentateur de Hacker News a résumé l'affaire en une ligne :
"By November 25th, Beijing time daytime (8am-22pm) -80%, and at night (Western daytime) even -92%!"

Et côté qualité, il n'y a pas encore de consensus. Un post X largement partagé l'a qualifié de "décevant" en se basant sur ce que l'auteur lui-même a admis être des rumeurs, et une réponse de quelqu'un qui le teste vraiment a contredit :
"It's preview; Qwen4-max-preview. It's not disappointing at all, at least so far in my one-shots, but more testing is going on and i'll have a clear answer."
Mon conseil : teste-le sur une tâche que tu as déjà résolue avec ton modèle habituel, comme Claude Fable 5.2 ou GPT-6.1 Terra, et juge-le là-dessus. Un modèle figé de deux semaines est honnête à tester et mauvais à construire dessus.
Qu'est-ce que Qwen 4 Max signifie pour les équipes de support ?
Pour une équipe de support, Qwen 4 Max est un modèle à essayer à son bureau, pas un modèle à mettre sur sa file. Les conditions et la date de retrait tranchent la question.
La leçon plus large se répète à chaque semaine de lancement. Un modèle est le moteur, pas l'agent. Ce qui rend l'IA utile sur les tickets, c'est la couche autour : ton centre d'aide, tes tickets passés, les règles sur quand transférer à une personne, et des tests contre de vraies conversations avant que quoi que ce soit n'atteigne un client. C'est le travail pour lequel le coéquipier IA d'eesel pour le helpdesk est conçu. Il rejoint la file que tu gères déjà dans Zendesk ou Freshdesk, apprend de ton historique, et est d'abord simulé contre des tickets passés.
OroSoft est un bon exemple de la partie grounding. L'entreprise fabrique des logiciels pour le commerce de métaux précieux et soutient ses clients via Freshdesk. Quand un agent mentionne eesel sur un ticket, il rédige une réponse à partir de 6 100 tickets passés et 20 fichiers de centre d'aide et de référence, indique quel ticket ou article il a utilisé, et laisse une note demandant une personne quand il ne trouve pas de quoi étayer une réponse. smava, un comparateur de prêts allemand, fait tourner eesel sur deux marques Zendesk et a traité 27 000 tickets en un mois.
Aucun des deux dispositifs ne change quand un nouveau modèle sort, et c'est bien le but. Si tu es curieux de voir comment un modèle gère ton propre contenu de support, mes guides sur connecter Claude à ton helpdesk, les transferts d'agent IA et éviter les hallucinations sont un meilleur point de départ qu'une clé d'aperçu.
Faut-il configurer Qwen 4 Max cette semaine ?
Oui, si tu vis dans un agent de code et veux deux semaines pas chères avec un Qwen à contexte de 1M. Le plan Lite à 3 $, le tarif de crédit à 20 % et le tarif de nuit à 8 % rendent l'essai presque gratuit, tant que tu règles correctement le slot du modèle et fais correspondre ta clé à l'endpoint de Token Plan.
Non, si tu as besoin d'un modèle pour une application, un bot ou un budget. Utilise Qwen 3.8 Max en paiement à l'usage pour ça, et reviens quand Alibaba sortira le Qwen 4 Max complet avec un prix et des scores. Pour un regard plus large sur la famille, mon aperçu de Qwen et mes alternatives à Qwen couvrent le reste.
Essaie eesel pour de l'IA sur ta file de support
Si ce que tu veux vraiment, c'est de l'IA qui répond aux clients, eesel est un coéquipier IA pour le helpdesk qui se branche sur le helpdesk que tu utilises déjà, apprend de tes tickets passés et de ton centre d'aide, et est testé sur des conversations historiques avant de toucher une conversation en direct. OroSoft l'utilise pour rédiger des réponses Freshdesk fondées qui citent le ticket d'où elles viennent. Tu peux voir les tarifs ou essayer eesel gratuitement.
Questions fréquentes
Qu'est-ce que Qwen 4 Max ?
qwen4-max-preview, un modèle de raisonnement multimodal avec un contexte de 1M de tokens et une sortie maximale de 393 216 tokens. Il est sorti le 11 novembre 2026 et sera retiré après le 25 novembre. L'avis sur Qwen 4 Max couvre ce que l'aperçu peut et ne peut pas te dire.Qwen 4 Max est-il gratuit ?
L'API Qwen 4 Max est-elle disponible ?
Combien de temps Qwen 4 Max est-il disponible ?
qwen4-max-preview cesse alors de fonctionner. Mon tour d'horizon des outils de suivi des LLM t'aide à surveiller la sortie complète.Comment configurer Qwen 4 Max dans Claude Code ?
ANTHROPIC_BASE_URL sur l'endpoint Anthropic de Token Plan, place ta clé sk-sp- dans ANTHROPIC_AUTH_TOKEN, et associe ANTHROPIC_DEFAULT_OPUS_MODEL à qwen4-max-preview. La config d'Alibaba met le modèle principal sur auto, choisis donc Opus avec /model pour être sûr d'utiliser Qwen 4 Max. Mon guide des variables d'environnement de Claude Code explique chaque variable.Quelle est la différence entre Qwen 4 Max et Qwen 3.8 Max ?
max_tokens couvre désormais le raisonnement et la réponse ensemble. Qwen 3.8 Max est déjà sorti, a des scores indépendants et coûte 2 $ en entrée et 6 $ en sortie par 1M de tokens à l'usage. Voir mon détail des tarifs Qwen 3.8 Max.
Comment utiliser Qwen 4 Max ?
sk-sp-, pointe ton outil vers l'URL de base de Token Plan et mets l'ID du modèle surqwen4-max-preview. Les outils compatibles incluent Claude Code, Cursor, Qwen Code et OpenClaw.